
ニュースレター
GPTに食らいつく
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
過去10年のAIが教えてくれた教訓が一つあるとすれば、それは計算資源を拡大すればより良いモデルができるということだ。素晴らしい話に聞こえる。競合があなたの10倍の計算資源を持っていると気づくまでは。
これが、中国企業やオープンモデルの企業の多くが置かれている状況である。フロンティアの企業に比べて、彼らは「計算資源が乏しい(compute-poor)」。昨年だけでも、Anthropicが計算資源に費やした額はMiniMaxとZhipu AIの合計の10倍を超えており、OpenAIとの差はさらに大きい。
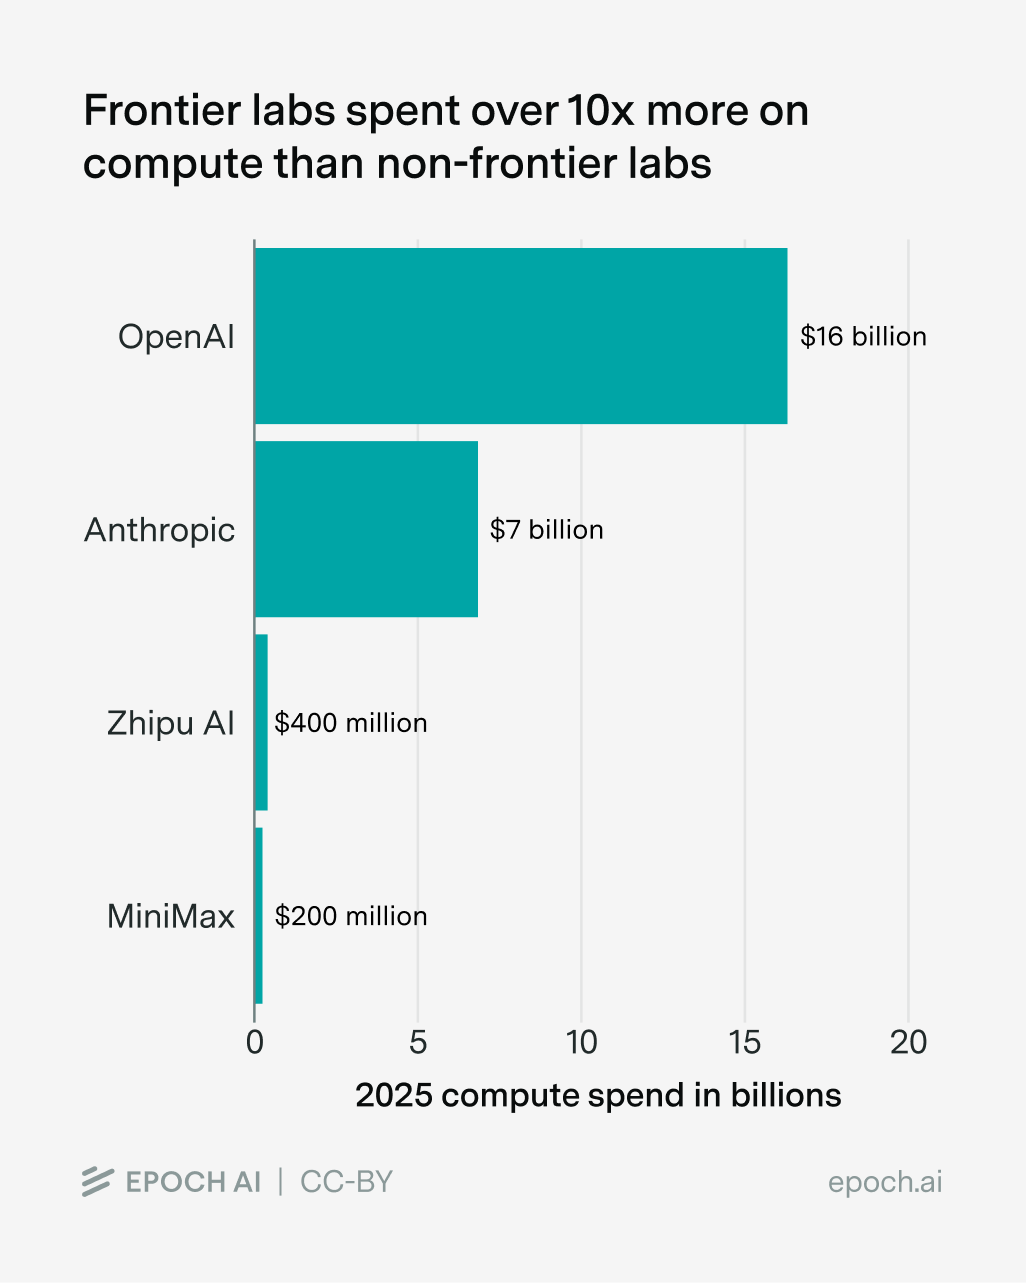
データはEpochのAI企業のデータとData Insightsによる。
AIの専門家でなくても、これが大きなハンディキャップだとわかる。計算資源が少なければ、実験を回すのも、より大きなモデルを学習させるのも、多くのユーザーにサービスを提供するのも難しくなる。
だが、計算資源に乏しいAIラボには切り札がある。フロンティア級の計算資源がなくても、手持ちの計算資源をより効率的に使うことで、実力以上の戦いを挑める。DeepSeekが学習計算量のごく一部しか使わずに(少なくとも一部のベンチマークでは)OpenAIに迫り、株式市場を大混乱に陥れたのは、まさにそうしたやり方によるものだった。1
大きな問いはこうだ。こうした効率の向上は、計算資源に乏しいラボが本当に競争できるほど、ひょっとすると計算資源に富むラボを一気に追い越せるほど、大きいのだろうか?
Epoch AI の最新情報を受け取る 購読する
効率の向上を分解する
これを見極めるには、計算資源に乏しいラボが計算効率を高めようとする方法を調べる必要がある。私の見るかぎり、主な方法は三つある。
- 計算資源に富むラボよりも速く、新しいアルゴリズムを開発し、データを改善する
- フロンティアのラボのイノベーションを再現する
- 計算資源に富むラボのモデルの能力を利用する。たとえば、競合のモデルが生成した合成データで学習する
この三つのうち、フロンティアを追い越すチャンスを与えてくれるのは一つ目だけで、残りの二つは主に追い上げに役立つ。とはいえ、追い上げも重要でありうる。後でフロンティアを追い越しやすくなるからだ。したがって理論上は、三つの方法のどれもが競争にとって大きな意味を持ちうる。
実際に大きな意味を持つかどうかは、一つの重要な条件にかかっている。その方法が効率を非対称に高めるかどうか、つまり計算資源に富むラボよりも、乏しいラボをはるかに大きく助けるかどうかである。なにしろ、同じ工夫から双方が同じだけ恩恵を受けるなら、計算資源の10倍の差は10倍の差のままだ。では、それぞれの方法がどこまで持ちこたえるかを見ていこう。
方法1:計算資源に富むラボより速くイノベーションを起こす
計算資源に乏しい企業は、計算資源に富むフロンティアの企業に資金量では勝てないとしても、頭脳では勝てるかもしれない。こうしたラボには、新しいアルゴリズムのイノベーションを次々に生み出す優秀な研究者が多いことがよくある。DeepSeekのMLAやGRPOがその例で、どちらも研究のセンスの良さを示している。
計算資源がボトルネックになっていることも、こうしたラボを効率化へと駆り立て、計算資源を劇的に節約するような、リスクの高いアルゴリズム上の「ムーンショット」を試させる。対照的に、フロンティアのラボは実績のあるレシピに固執しがちかもしれない。学習の実行が何倍も大きければ、失敗するリスクを取るコストも何倍も大きくなるからだ。
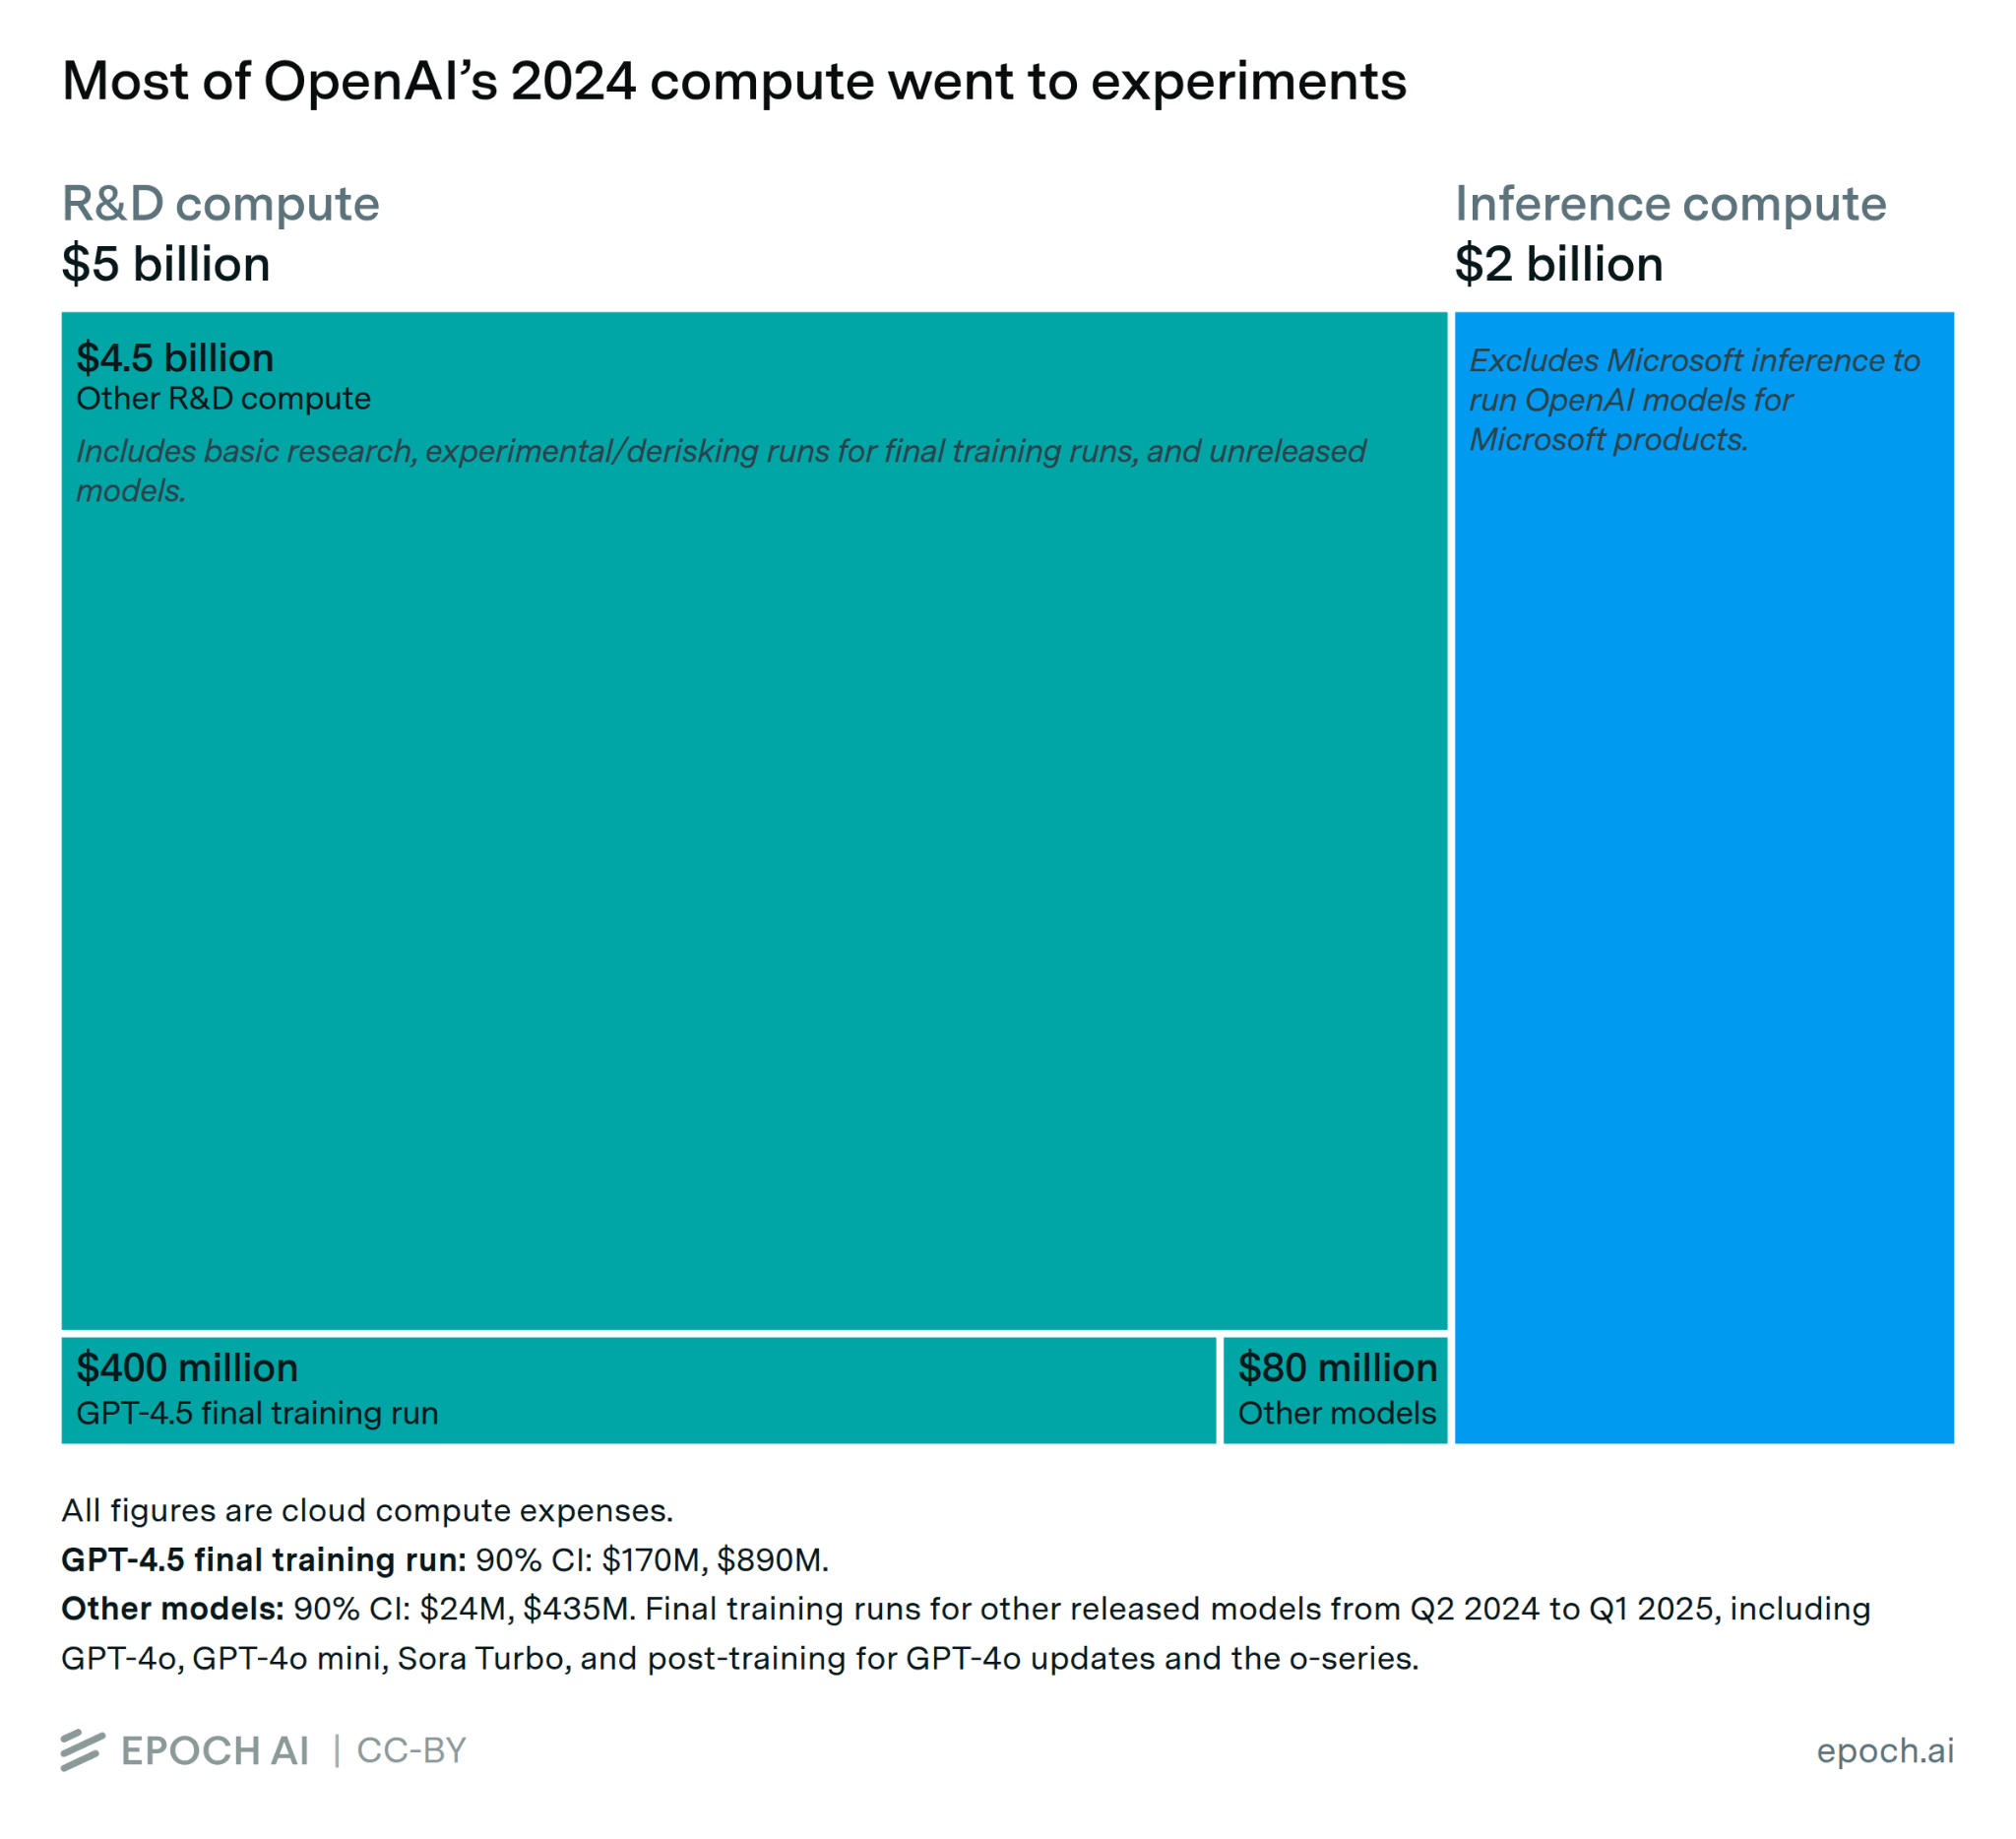
しかし、計算資源に富むラボにはそれなりの効率上の強みがある。たとえば、実験を回すには多くの計算資源が必要なことが多い。アルゴリズムがうまくスケールするかを試す場合などである。AIラボの計算資源への支出の大半が実験に回っているのはそのためだ。
また、前回のエッセイで説明したように、Transformerのような一部のイノベーションは、学習計算量を拡大するほど大きな効率の向上をもたらす。そのため、こうしたイノベーションは計算資源に乏しい側よりも富む側に恩恵を与える。
そのうえ、人材を抱えているのは計算資源に乏しいラボだけではない。計算資源に富むラボにも人材はいるし、おそらく最高の人材がいる。彼らはトップ中のトップに法外な報酬を払え、他のラボから研究者を引き抜くこともよくある。2若手のポジションにもより多く払っているようだ。たとえば、OpenAIやAnthropicの若手研究者の給与は、購買力を考慮しても、DeepSeekのおよそ2倍である。3米国の機関に渡った中国のAI研究者の大多数がそのまま米国に残る傾向があるのも、これが一因だろうと私は推測している。また聞いた話では、中国のAI研究者は(少なくとも今のところ)米国を最も働きたい場所とみなしている。
実際のところ、最も注目すべきイノベーションの多くが最も多くの計算資源を持つ者から生まれてきたのは、このためだと私は考えている。たとえば、現代のTransformerベースのLLM、スケーリング則、推論モデルといったイノベーションは、OpenAIとGoogleが開発した。どちらも、まぎれもなく「計算資源に富む」部類に入る組織である。4
だから私には、計算資源に乏しいラボが富むラボよりもはるかに速く新しいソフトウェアのイノベーションを見つけると期待すべき理由が見当たらない。それどころか、逆のほうがありそうだと思う。5
方法2:フロンティアのラボのイノベーションを再現する
新しいソフトウェアのイノベーションの開発でフロンティアのラボに勝てないなら、それを再現すればよいのではないか? フロンティアのAIラボの知識(アルゴリズムなど)は、計算資源に乏しいラボに「波及(spill over)」しうる。そうなれば、乏しいラボは、そもそもイノベーションを見つけるための多額の研究開発費を払わなくても、競争にとどまれる。これは大きな意味を持つだろう。研究費は、AI企業がまだ黒字化していない主な理由だからだ。さらに、新しいイノベーションによって、あるいは計算資源の差を縮めることによって、フロンティアを追い越しやすくもなる。
これにはいくつかの経路がありうる。AI研究者どうしの噂話、計算資源に富むラボから乏しいラボへの研究者の移籍、あるいは計算資源に乏しいラボの研究者が公開情報をもとにフロンティアのラボのイノベーションを再構成する、といったものだ。
「1マイル4分の壁」効果があるなら、特に大きく速い波及が起こりうる。あるAIラボがブレークスルーを達成すると、他のラボも自分たちにもできると気づき、再実装に力を注ぐのである。
これがすでに起きている証拠はある。たとえば、フロンティアのラボのブレークスルーを大筋で再実装した事例がある。公開情報は限られていたにもかかわらず、6学術研究者の小さなチームは、AlphaFold 2の公開から7か月以内にその再現にかなり近づいた。7推論モデルも一例だ。OpenAIが最初の推論モデル(o1)を公開した後、いくつもの異なるAIラボが数か月以内に後に続き、ときには数分の一の学習計算量しか使わなかった。8
しかし、こうした力学は差を埋めるほど大きいのだろうか? いくつかの理由から、おそらくそうではない。
まず、イノベーションの経済学者たちは、こうした波及効果が大きな意味を持つと考えているようだ。9だがその彼らでさえ、こうした波及が計算資源の10倍の差を補えるほど強いとは言わないだろう。10
さらに、計算資源に乏しい企業が、クローズドなモデルのイノベーションの再実装方法を公開と同時に知ったとしても、終わるまでに(たとえば)3か月かかる新しい学習を始める必要がある。その3か月の間に、計算資源に富むラボはさらに先へ進む。しかもこれは、推論モデルやAlphaFold 2の場合のように、実際に何がうまくいくのかを突き止めるのにかかる時間を無視した話だ。実際、MiniMaxやZhipu AIのような企業は、最終的な学習よりも実験用の計算資源に今もはるかに多くを費やしている。つまり、波及だけでは実験用の計算資源のコストを省くには足りないということだ。11
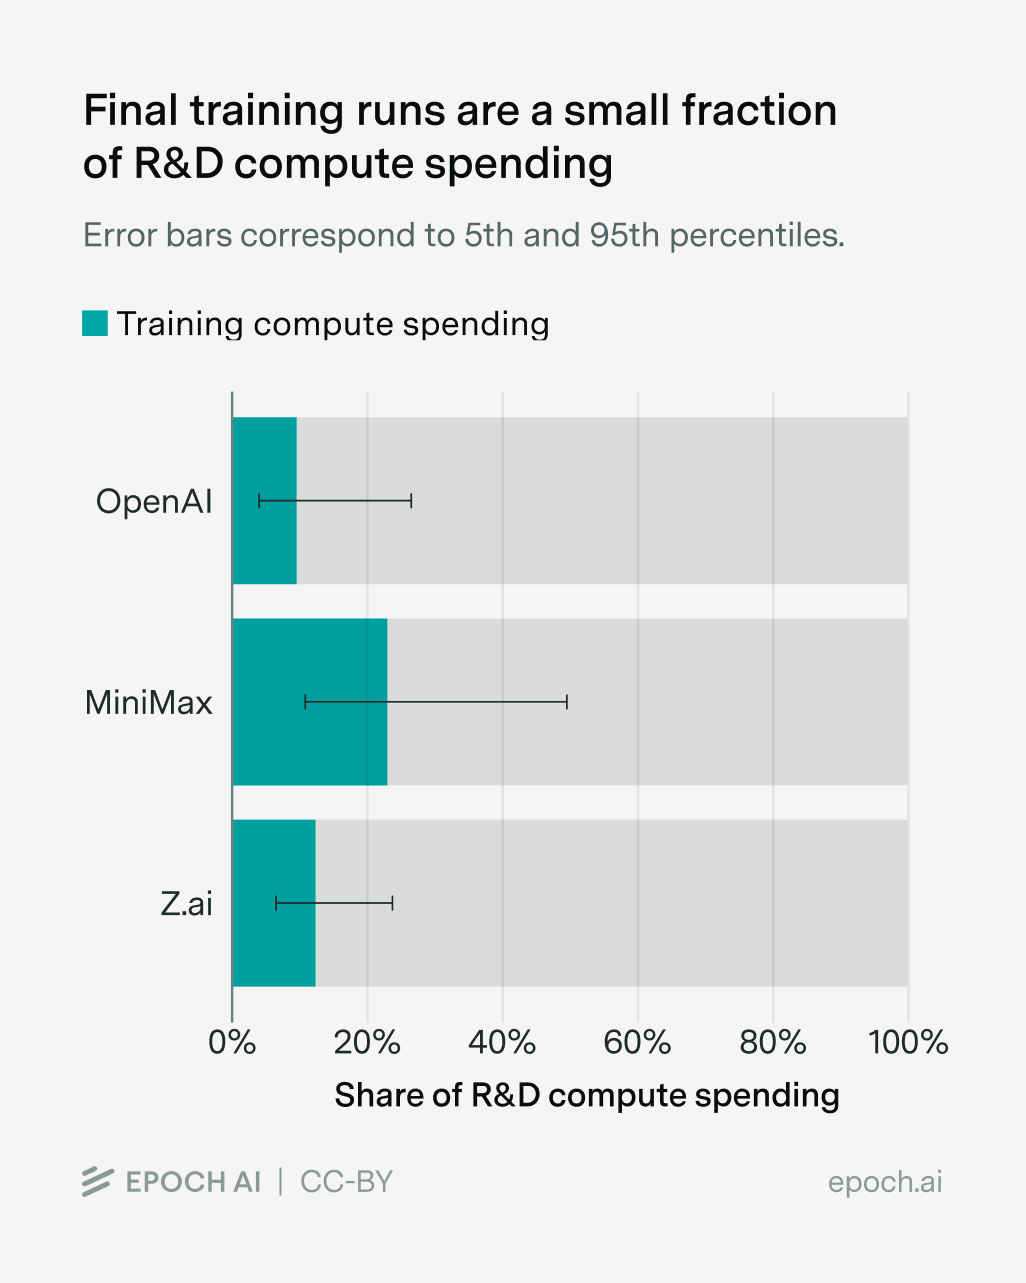
そして最後に、こうした波及の仕組みは、計算資源に乏しいラボにそれほど有利ですらない。乏しい側が富む側をまねできるのと同じく、富む側も乏しい側をまねできる。乏しい側のモデルがオープンなら、なおさらだ。大手のAIラボが今も学術文献を追っているのには理由がある。また、研究者は計算資源に富むラボから比較的乏しいラボへ移ること(たとえばOpenAIからMistral AIへ)がよくあるが、逆方向の移籍もある。計算資源に乏しい学術界から計算資源に富む産業界へ移る人々については特にそうだ。
だからここでも、イノベーションを「まねる」ことが、計算資源に富む側よりも乏しい側の計算効率をずっと大きく高めるという見方には懐疑的だ。少なくとも、計算資源の10倍の差を埋めるのに足りるとは思えない。
方法3:フロンティアモデルの能力を利用する
計算資源に富むラボはすでに高価なフロンティアモデルを開発し、人々に使わせている。ならば、それを使って計算資源に乏しいラボのモデルを改善すればよいのではないか?
実際には、ここで最大の「威力」を発揮するのは、おそらくフロンティアモデルに大量の出力を生成させ、そのデータで学習することだろう。これは(不正確にも)「蒸留」と呼ばれることが多く、12フロンティアモデルの能力をより小さなモデルに移せる。最近の注目すべき例として、AnthropicがDeepSeek、Moonshot、MiniMaxを、Claudeの出力から蒸留したとして非難した件がある。13
問題は、蒸留が実際にどれほどの違いを生むのかである。証拠はまだらだが、数字に目を凝らすと、企業が数倍の計算効率の向上を得られる可能性がかすかにうかがえると私は思う。
証拠の一つは、DeepSeek-R1をQwen2.5のモデルに蒸留したときに起きることである。14
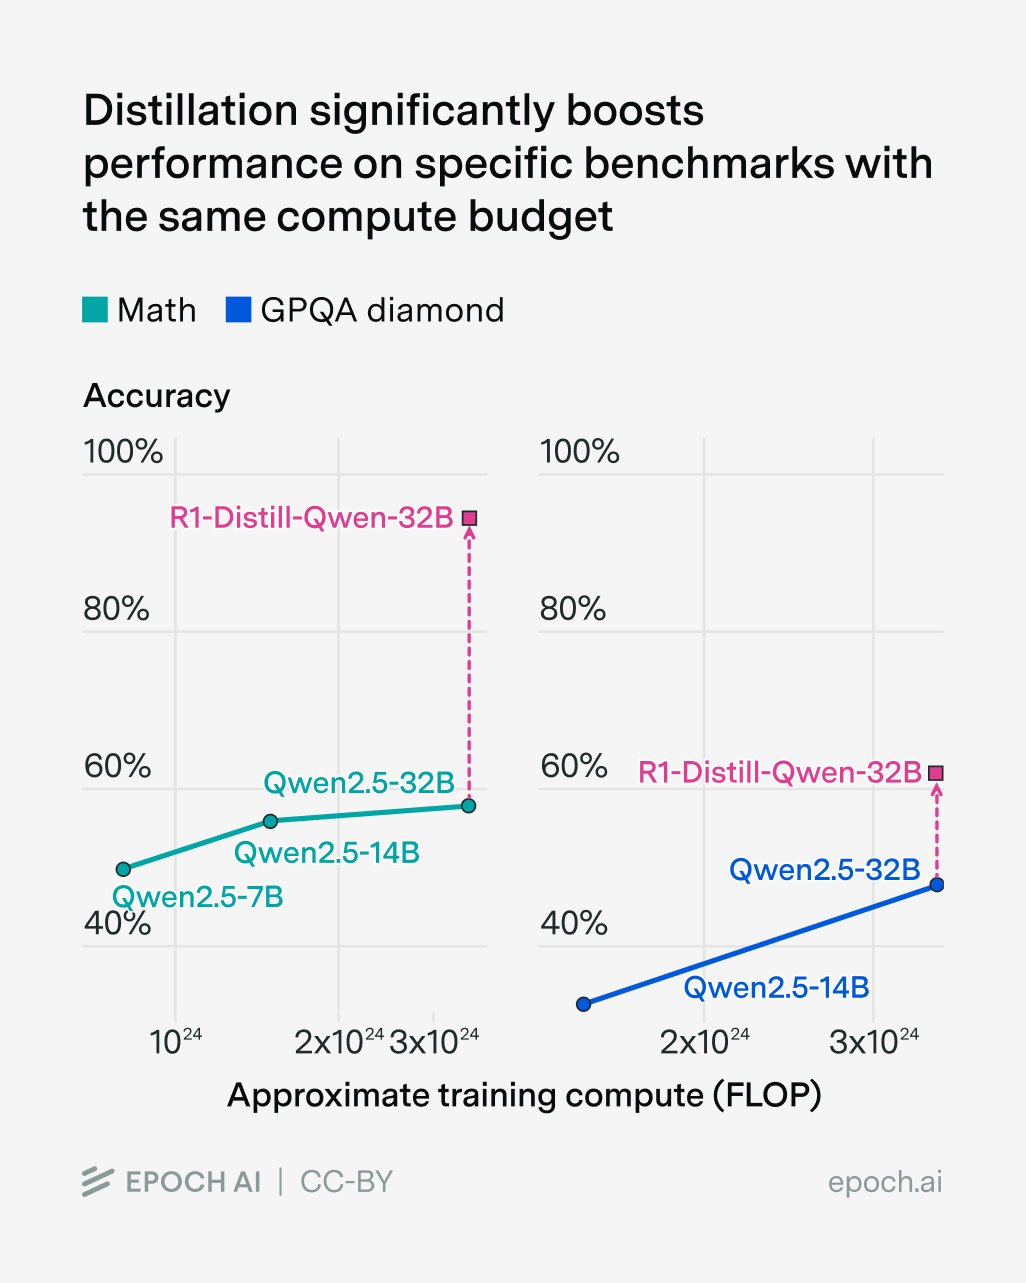
MATHとGPQA Diamondでは、とてつもない効率の向上が見られる。必要な事前学習の計算量は、GPQAでは数分の一、MATHでは何桁も少なくなる。そのため一見すると、蒸留はフロンティアとの計算資源の10倍の差を越えるうえで非常に大きな意味を持ちうるように見える。
問題は、これが特定のベンチマークに頼りすぎていることだ。MATHとGPQAで効率の向上が劇的に違うのは怪しい。では、幅広いベンチマークにわたって能力を保つとしたらどうだろうか?15ここでも証拠はお粗末である。
- Olmo 3は、6分の1のトークン数で、同規模の最良のオープンモデルを複数のベンチマークで上回った。これには蒸留を含むパイプラインが使われていたので、この論文での効率の向上の上限と解釈できる。
- 実行速度から判断すると、OpenAIのminiモデルのパラメータ数は、蒸留元のモデルの数分の一だった可能性が高い。それでいて、さまざまなベンチマークでの性能はわずかに劣るだけとも言え、一対一の比較でも僅差で負ける程度だ。たとえば、人間の投票者がGPT-5-miniよりGPT-5を選んだのは約56%だった。(とはいえ、この見方はやや楽観的だと思う。miniモデルがかなり劣る他のベンチマークもある。)
これらの例がどこまで比較可能なのかは、私にもはっきりしない。正確な効率の向上は、どれだけのデータを使ったか、ベンチマークがどれだけ網羅的か、などに左右される。厄介なことに、両者は異なる指標に基づいてもいる。一方はデータを減らすのに役立ち、もう一方はパラメータを減らすのに役立つもので、それが計算資源の節約にどう対応するのかは正確にはわからない。それでも、幅広いベンチマークや領域を考慮した場合でも、数倍の計算効率の向上を得られる可能性があることを、これらの例は弱く示唆していると思う。
しかも、これを実現するのに多くのデータは要らない。DeepSeek-R1は約40億トークンで蒸留できる。16比較すると、MiniMaxはClaudeとのやり取りから1,000億トークンのデータを得られた可能性がある。17Nathan Lambertは、これだけのデータがあれば「モデルの事後学習を意味のある形で改善」できると指摘しており、私にもおおむね妥当に思える。したがって、計算資源に乏しいAIラボがどうやってフロンティアについていこうとしうるかの説明として、これまで見てきた候補の中ではおそらくこれが最も説得力がある。18
とはいえ、心に留めておくべき注意点がいくつかある。第一に、蒸留がどこまでうまくいくかには限界がある。モデルが小さくなるほど、能力を蒸留するのはずっと難しくなる。これは、DeepSeek-R1をさまざまなバージョンのQwen2.5に蒸留した場合に見てとれる。モデルが小さくなるにつれて、AIME、MATH、GPQAなどのベンチマークでの性能が下がるのである。
| モデル | モデルの規模(アクティブパラメータ数) | AIME | MATH | GPQA |
|---|---|---|---|---|
| DeepSeek-R1 | 370億 | 79.8% | 97.3% | 71.5% |
| R1-Distill-Qwen-32B | 320億 | 72.6% | 94.3% | 62.1% |
| R1-Distill-Qwen-14B | 140億 | 69.7% | 93.9% | 59.1% |
| R1-Distill-Qwen-7B | 70億 | 55.5% | 92.8% | 49.1% |
| R1-Distill-Qwen-1.5B | 15億 | 28.9% | 83.9% | 33.8% |
もっと具体的に言えば、蒸留したモデルが100分の1の大きさでありながら、「教師」モデルと同じ幅広い能力を捉えられたとしたら、私はかなり驚くだろう。
第二の注意点は、蒸留したモデルのほうが「ベンチマーク最適化(benchmaxxed)」されやすいかもしれないことだ。つまり、特定のベンチマーク群に向けて最適化されていて、全般的にはそれほどうまくいかない。たとえば、OpenAIの「mini」モデルは、多くの知識の想起を伴う課題で成績が劣ることが多い。
第三に、計算資源に富むフロンティアのラボは、最も強力なモデルを自社内や選ばれた顧客だけにとどめることができ、そうなれば計算資源に乏しい側が蒸留でついていくのは難しくなる。
第四に、そして最後に、さまざまな環境でモデルが推論能力を身につける過程を、蒸留だけで説明しきるのは難しい。Nathan Lambertが指摘するように、それには通常、より強いモデルからの純粋な蒸留ではなく、モデルが自らの試行錯誤から学ぶ大規模な強化学習(RL)が必要になる。したがって、蒸留が推論能力の向上に役立つのは確かだが、計算資源に乏しいラボもおそらくRL環境の基盤を整え、RLによる学習を自ら行う必要があるだろう。
全体として、フロンティアモデルの能力を利用することは、計算資源に富むラボに比べて乏しいラボの効率を、おそらく意味のある形で高める。ただ、それで計算資源の10倍の差を完全に埋められるところまではいかないだろう、と私は弱く推測している。おそらく差を数分の一に縮める程度だろう。
まとめ
三つの方法についての私の結論は次のとおりだ。
- 新しいソフトウェアのイノベーションを生み出す:計算資源に乏しいAIラボに非対称に有利だとは思えない。むしろ富む側に有利かもしれない。
- フロンティアのラボのイノベーションを再現する:波及は双方向に起きることが多く、全般に、その効果が計算資源の10倍の差を補えるほど大きいという見方には懐疑的だ。
- フロンティアモデルの能力を蒸留する:計算資源に乏しい側が、数分の一の計算資源で、フロンティアの幅広い能力にかなり近づける助けになりうる。計算資源を10分の1に抑えられるほどではないだろうが、意味のある効率の向上ではあり、特定の狭い能力だけを気にするなら、はるかに大きな節約が得られる。
だから、すべてを合わせると、計算資源に乏しいラボは、フロンティアで競争できるほどに計算資源の10倍の不利を埋め合わせることはおそらくできないと思う。計算資源の差はあまりに大きく、ほとんどの方法は、富む側に比べて乏しい側をそれほど大きく助けはしない。
だが、推論モデルのような大きなアルゴリズム上のブレークスルーがあればなおさら、その可能性を完全に排除することはできない。それに当然ながら、私の意見はかなり限られた証拠に基づいている。私の立場を支持する、あるいは否定する良いデータや議論を知っている人がいたら、ぜひ聞かせてほしい。
これはAIの未来にとって何を意味するか
ここまで主に、フロンティアに比べて計算資源がおよそ10分の1しかない「計算資源に乏しい」AIラボについて話してきた。この見方は、蒸留やイノベーションの再現などによる効率の向上を分析するのに役立ち、AIの競争で誰が「勝つ」かを決める支配的な要因が計算資源であることを示すのにも役立つ。だが、まだ大きな問いに答える必要がある。そうした「計算資源に乏しい」ラボとは、具体的に誰なのか?
計算資源に乏しい=中国のAIラボ?
「計算資源に乏しい」AIラボの一つの種類は、少なくとも現時点では、中国のAI企業である。たとえば先に見たように、2025年にMiniMaxとZhipu AIが合わせて使った計算資源は、Anthropicの10分の1に満たなかった。
では、中国のラボは脇役に追いやられ、米国のAI企業と競争できない運命にあるのだろうか? 必ずしもそうではない。米国と中国のAIラボがどれだけの計算資源を手に入れられるかによるからだ。計算資源の差が縮まれば、フロンティアと競争しやすくなる。広がれば、その逆になる。
これはもちろん、大きな未解決の問いにかかっている。計算資源の差は時間とともにどう変わっていくのか? これまでのところ、差は大きくは広がっていないと私は思う。だからこそ、Epoch能力指数(ベンチマークのスコアを凝った方法で集計したもの)で測った能力で、中国のラボはフロンティアから大きく引き離されていないのだと思う。
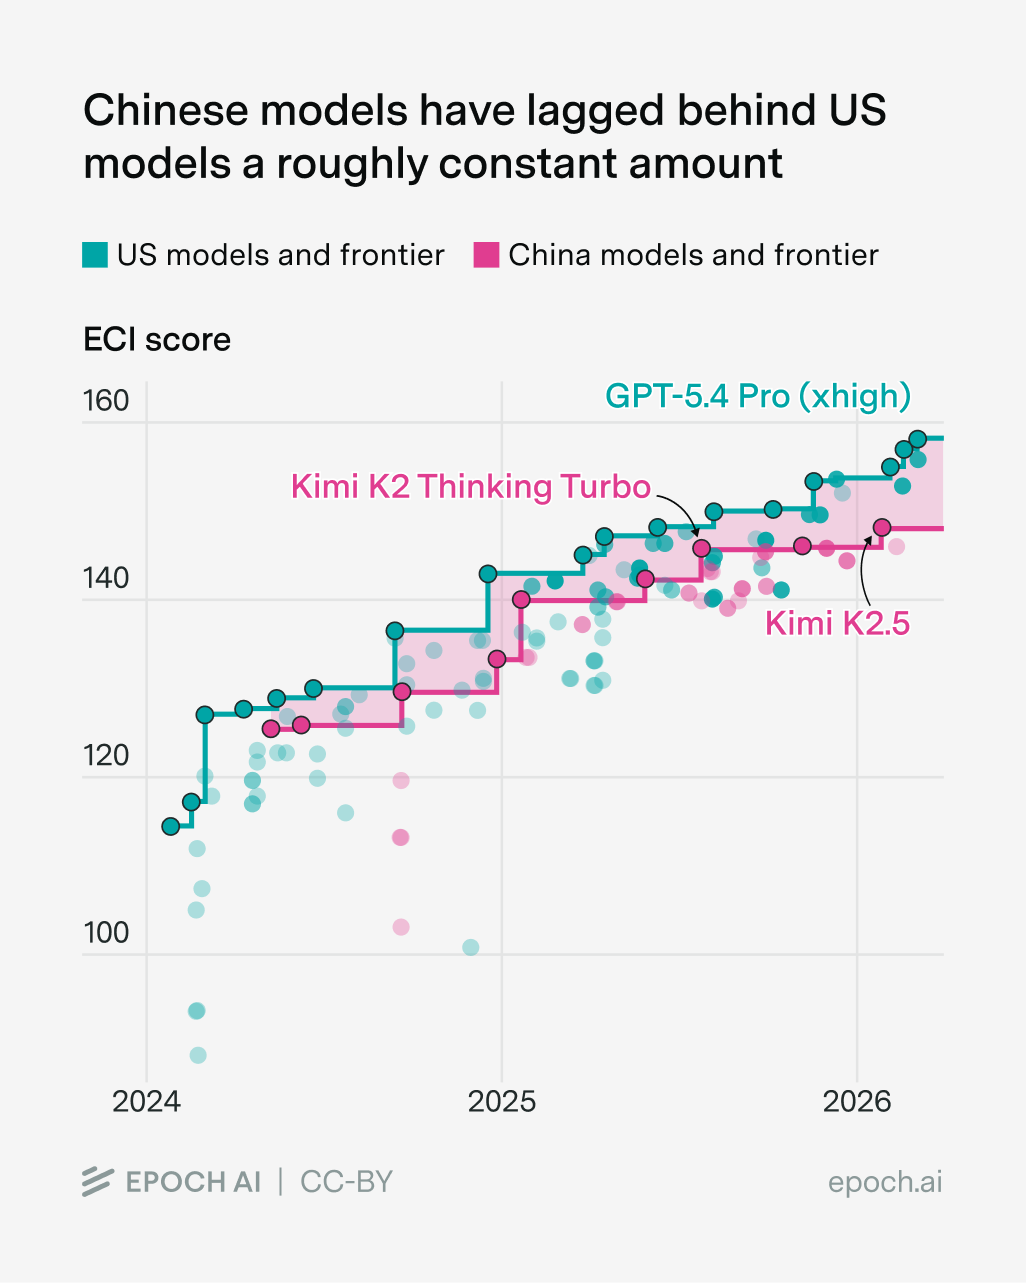
しかし、この解釈には少し議論の余地がある。たとえば、学習計算量の差は、劇的ではないにせよ広がってきた。
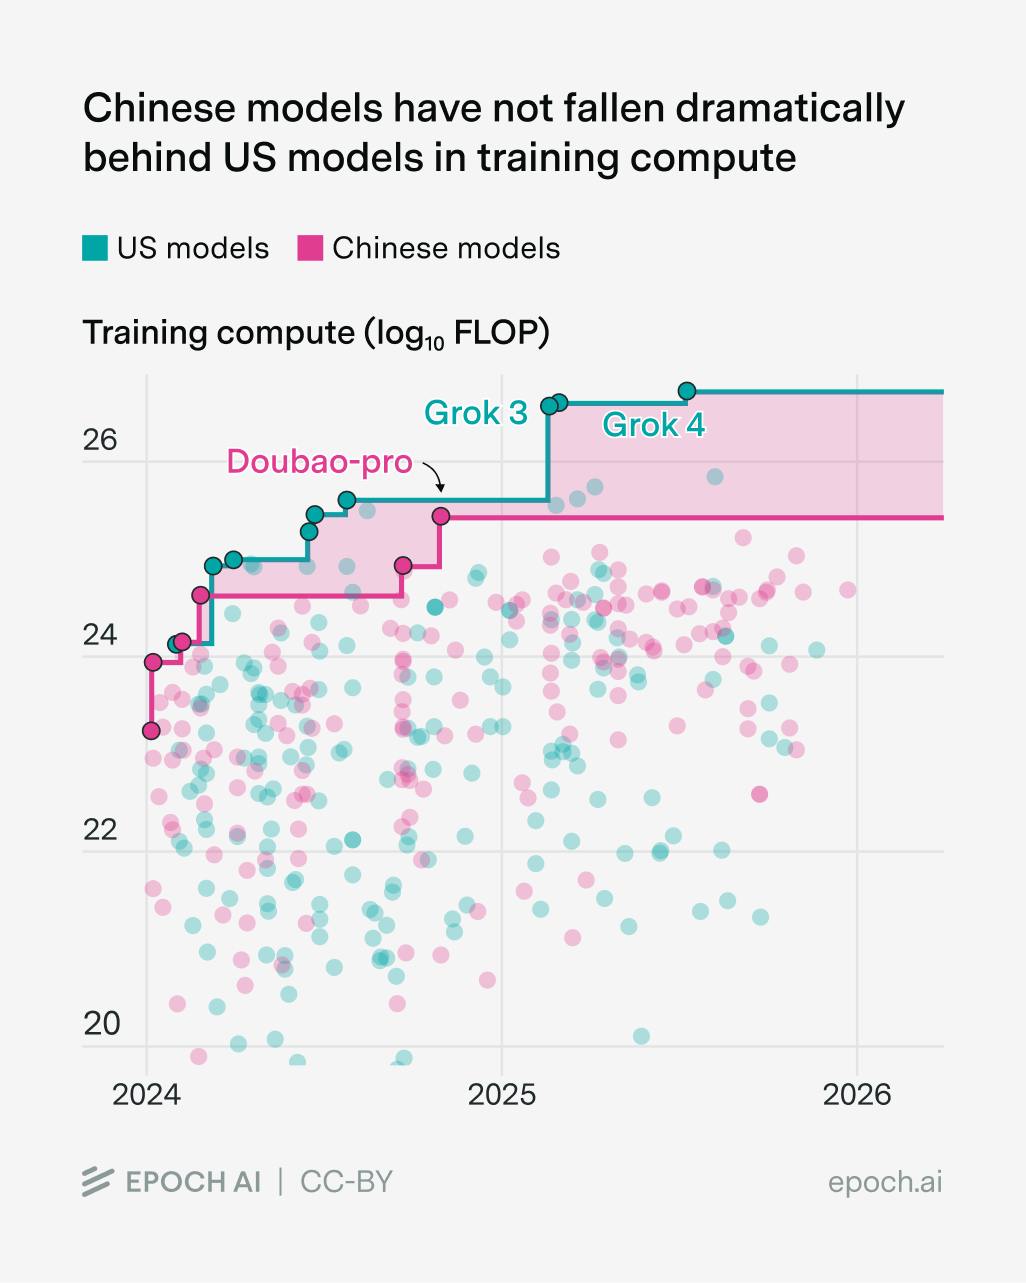
だが、いくつかの理由から、これはかなりわかりにくい。
- 米国と中国の最良のモデルが、常に最も多くの計算資源で学習されているわけではない。たとえば、Grok 3と4もおそらく規模の割に効率が悪いし、Doubao Proも同じだろうと私は推測している。
- これは、全体の計算資源の予算ではなく、学習計算量を見ている。このエッセイで私が主に話してきたのは前者だが、残念ながらそれについては十分なデータがない。
- もう一つわかりにくいのは、各AIラボが推論の手法を突き止めようと奔走していたことだ。推論は、他の大半のイノベーションに比べてはるかに大きな効率の向上をもたらす。
全体として、計算資源全体の差は時間がたってもあまり変わっておらず、だから能力の差もあまり変わっていないのだろう、と私は弱く推測している。
しかし、差が広がると考える理由もいくつかある。これを書いている今、米国のハイパースケーラーは、最盛期のマンハッタン計画やアポロ計画をしのぐ規模のデータセンター建設を進めている。その一環として、フロンティアのラボは間もなく、それぞれ数百億ドルを要し、数百万基のGPUを収めるデータセンターを持つようになる。対照的に、中国のAI企業は輸出規制に足を引っ張られ、国産AIチップの生産でも後れを取っている。これは短期的に計算資源の差を広げ、ひいては米国と中国のAIモデルの能力の乖離につながりうる。一部の指標ではすでにそうなっており、Zhipu AIのCEOであるTang Jieも最近、次のように述べた。
「実のところ、[米国と中国のAIの]差は広がっているのかもしれない。」
一方で、中国のAIラボは、チップの密輸や、クラウドを通じたレンタルによって、より多くの計算資源を手に入れ続けられるかもしれない。また、先の未来を見るほど、中国が国産AIチップの生産で追いつく可能性は高まる。
そこで私の見立てでは、米中のAI競争の全体像は次のようになる。短期(たとえば2〜3年)では、輸出規制と国産チップ生産の急拡大の難しさのために、差が大きく縮まる可能性は低いと思う。しかし長期では、不確実性が高まる。予測の難しいチップの輸出規制による。チップの密輸やレンタルがどれだけ難しいかによる。中国がどこまで本気でAGIを推し進め、計算資源の保有量を拡大したいと考えるかにもよる。そして、中国の最新の五か年計画からは、風向きがこの方向に変わりつつある兆しがうかがえる。
さらに、事態をいっそう不確実にする予測不能な要素がもう一つある。フロンティアのAI企業は、競合に比べて最良のAIをより多く動かし、自社のAI研究を加速できるのである。今のところ、こうした恩恵は目に見えるかもしれないが、ゲームを一変させるほどではない。だが、今後数年でおそらくそれは変わるだろう。そうなれば、計算資源の差が変わらなくても、計算資源に富む側と乏しい側の能力の差が広がりうる。
計算資源に乏しい=オープンモデル?
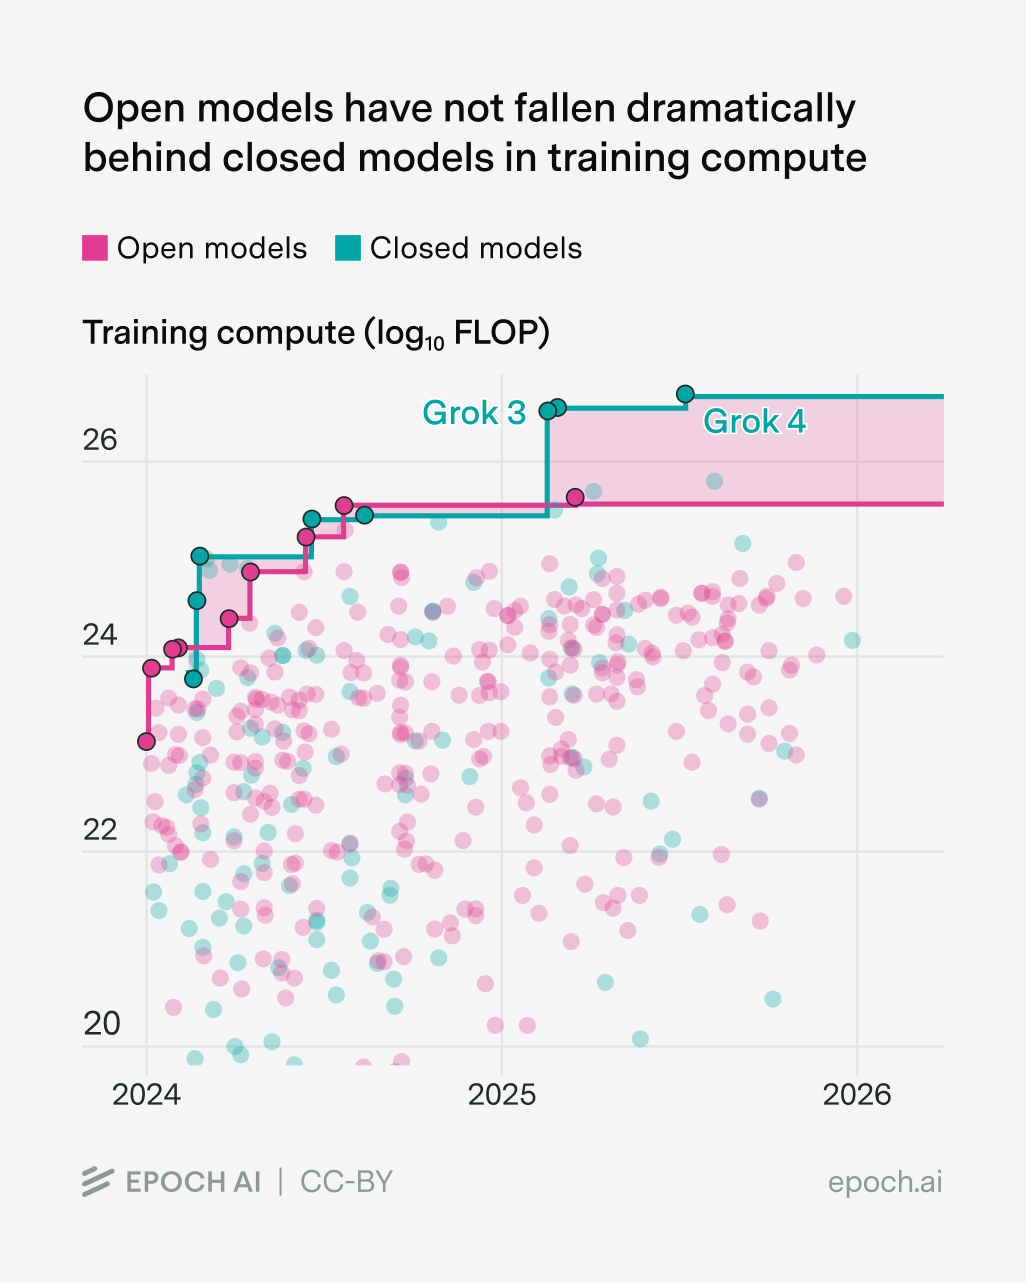
「計算資源に乏しい」AIラボのもう一つの種類は、オープンモデルを開発するラボである。中国のAI企業と同じく、その学習計算量はフロンティアからそれほど大きく引き離されてはいないが、差は広がってきた……
……そして能力の差は、ほぼ一定の遅れのように見える。
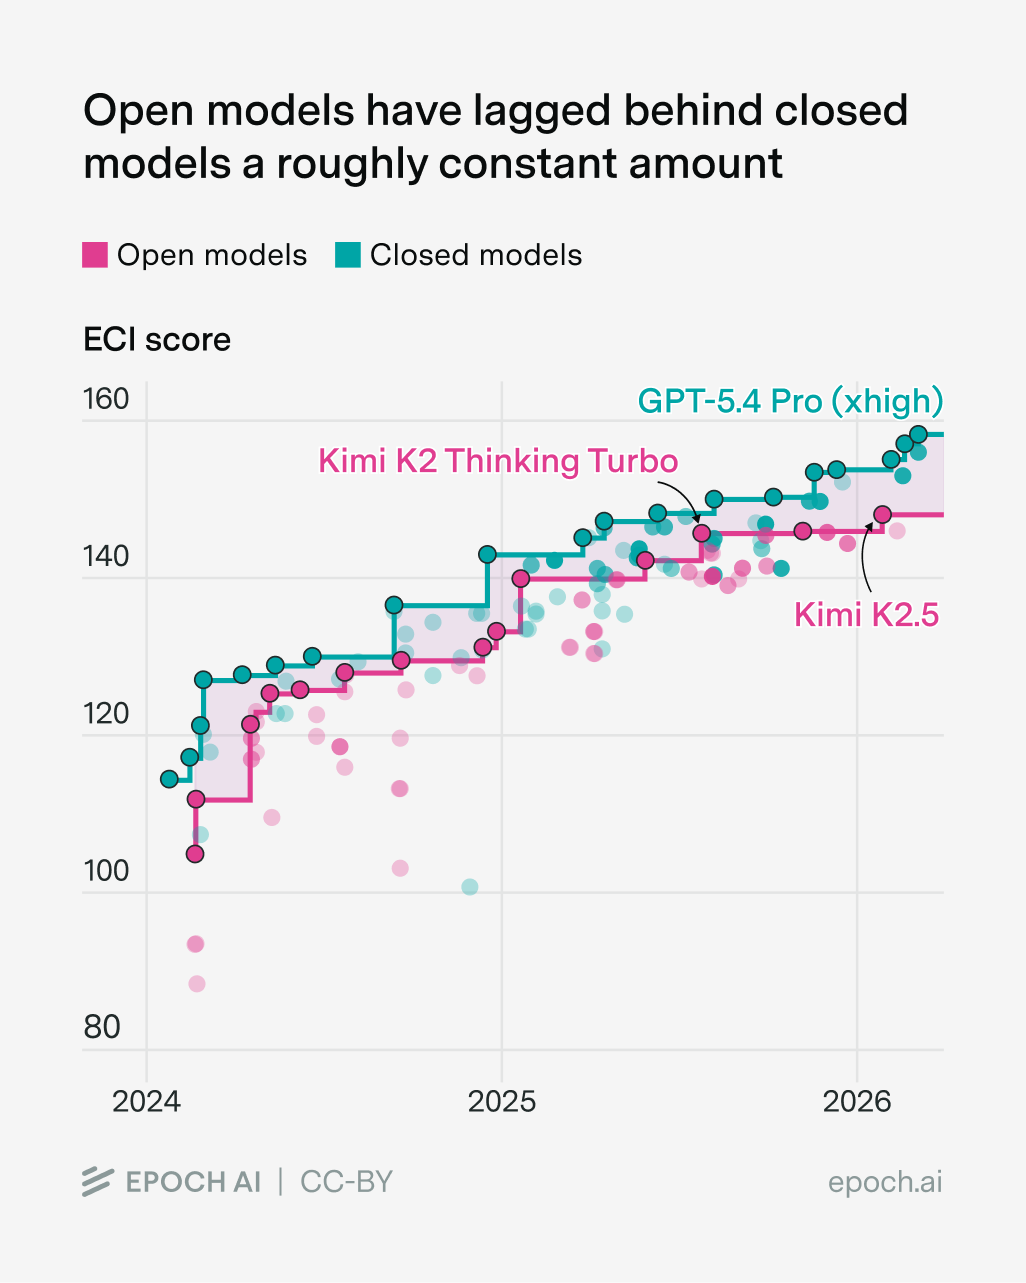
これはそれほど意外ではないかもしれない。オープンモデルのラボと中国のAI企業はかなり重なっているので、両者の課題の多くが同じであっても不思議はない。たとえば、オープンモデルのラボとフロンティアの企業との計算資源の差が時間とともにどう変わるかは、中国のラボで見たのと同じく、大きな未解決の問いである。
しかし、フロンティアでのオープンモデルの未来は、別の「オープン」な問い(しゃれではない)にかかっている。将来のAIモデルはオープンウェイトになるのだろうか?
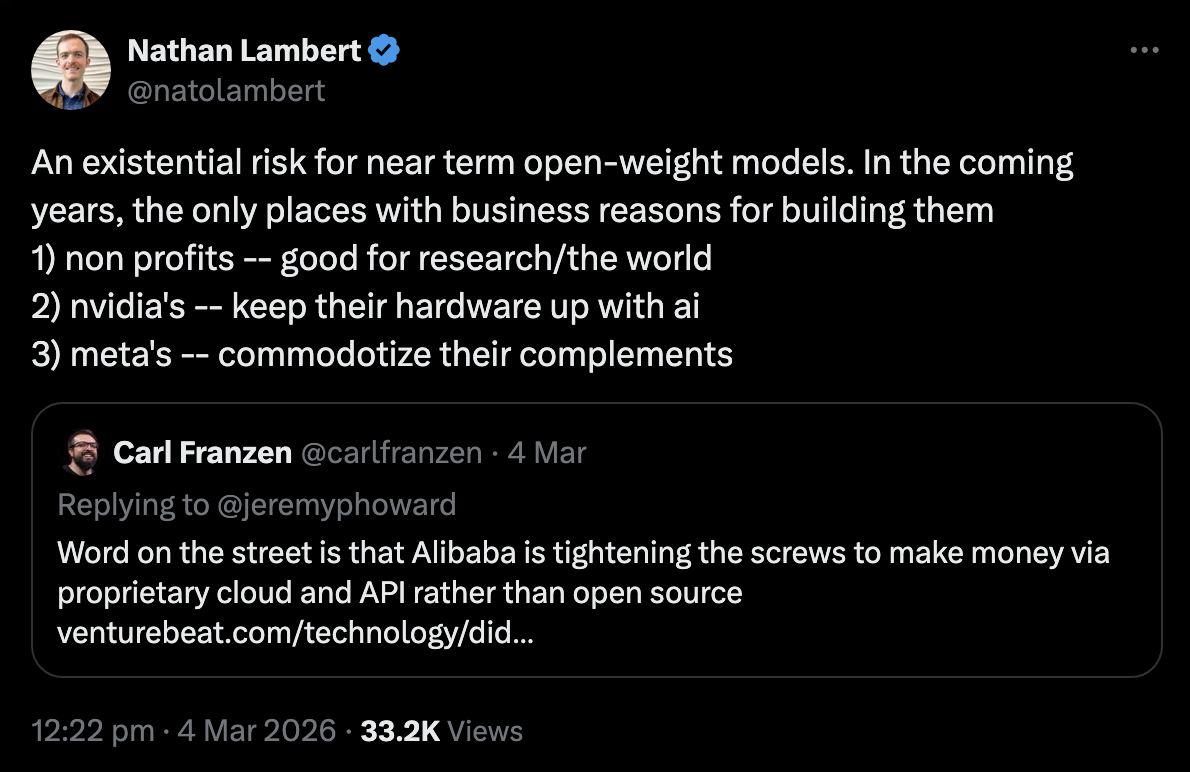
これはおそらく、計算資源の拡大についての問いよりもさらに答えにくい。一つの問題は、企業がオープンモデルを公開するかどうかで方針をころころ変えるらしいことだ。たとえば、Alibabaは最近、クローズドな公開へとさらに傾きつつある兆しを見せている。19
だが、私のお気に入りの例は何といってもMetaだ。2024年7月、Mark Zuckerbergは「Open Source AI is the Path Forward(オープンソースAIこそ進むべき道)」というエッセイを書いた。彼はオープンモデルを支持する論拠をいくつも挙げた。プライバシー、AIモデルが多くの目で精査されることによる安全性、そして幅広いAIコミュニティを活用してMetaのモデルを改善することなどである。ところが今や、Metaはこの戦略から手を引きつつあるようだ。まず、オープンウェイトのLlama 4 Behemothをやめてクローズドなモデルに切り替える議論があったと報じられ、今度は次世代の「Avocado」モデルがクローズドウェイトで公開されるとされる。「Open Source AI was the Path Forward(オープンソースAIこそ進むべき道だった)」という記事を書いた人までいる。(公開直前の追記:どうやらMetaは今、次世代のAIモデルのオープン版を「いずれ」提供する予定らしいので、オープンソースAIは「いずれ」進むべき道になるのかもしれない。)
逆方向に動くラボもある。DeepSeek-R1がオープンウェイトのモデルとして公開された後、いくつかの中国のラボが後に続いた。たとえばBaiduは、ERNIE 4.5でクローズドなモデルへのこだわりを捨て、この決定を後押しした要因としてDeepSeekを挙げた。20
要するに、オープンモデルとフロンティアの能力の差は、どのラボが「オープン」を選ぶかに大きく左右される。そしてそれは、政府の戦略、企業のCEOの思想、そしてNathan Lambertが指摘するように、ビジネス上のインセンティブなどに左右される。
結論
では、ここまでの議論から何がわかったのか? 私にとっての主な教訓はこうだ。能力のフロンティアでどの企業が競争できるかを決める最大の要因は計算資源である。効率も重要だが、10分の1の計算資源を補うにはおそらく足りない。
一見すると、これは中国やオープンモデルのラボにとって暗い見通しのようだが、私はそれほど白黒はっきりした話ではないと思う。というのも、将来、「計算資源に乏しい」というレッテルが彼らにきれいに当てはまるとは限らないからだ。今日、彼らが「計算資源に富む」フロンティアのラボと競争するのは難しいかもしれない。だが将来は、彼らがどれだけの計算資源を持つか、そしてどのラボが「オープン」か「クローズド」かを選ぶかによって決まるだろう。
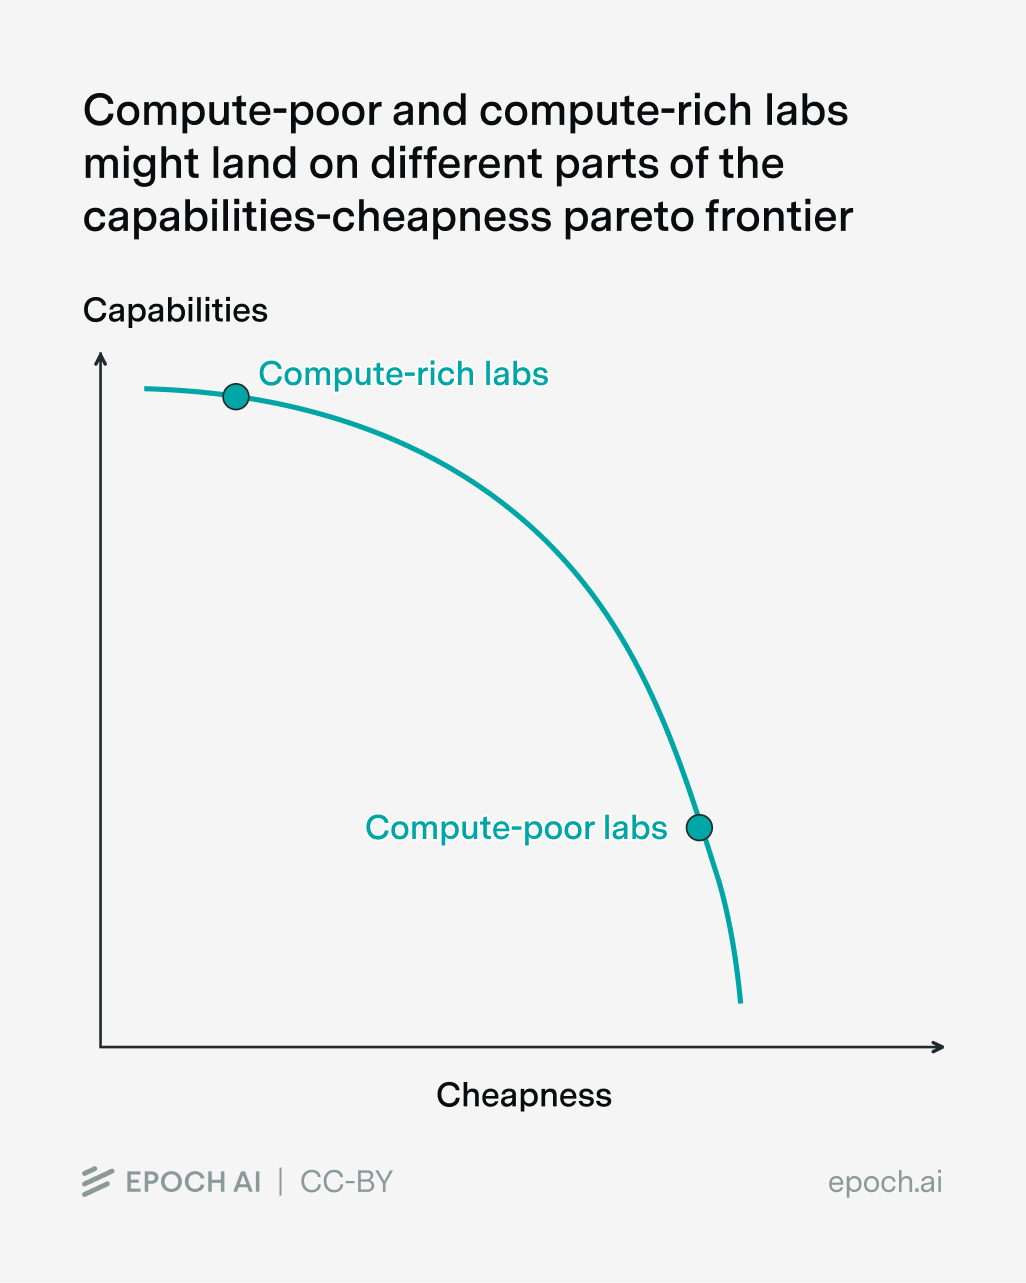
さらに、私はこの分析全体を能力のフロンティアでの競争という枠組みで組み立ててきたが、厳密に言えば、それはこうしたAIラボの唯一の優先事項ですらないかもしれない! たとえば、中国のモデルは単に、「能力対安さ」のパレートフロンティアの別の部分を見つけているだけだと考えることもできる。
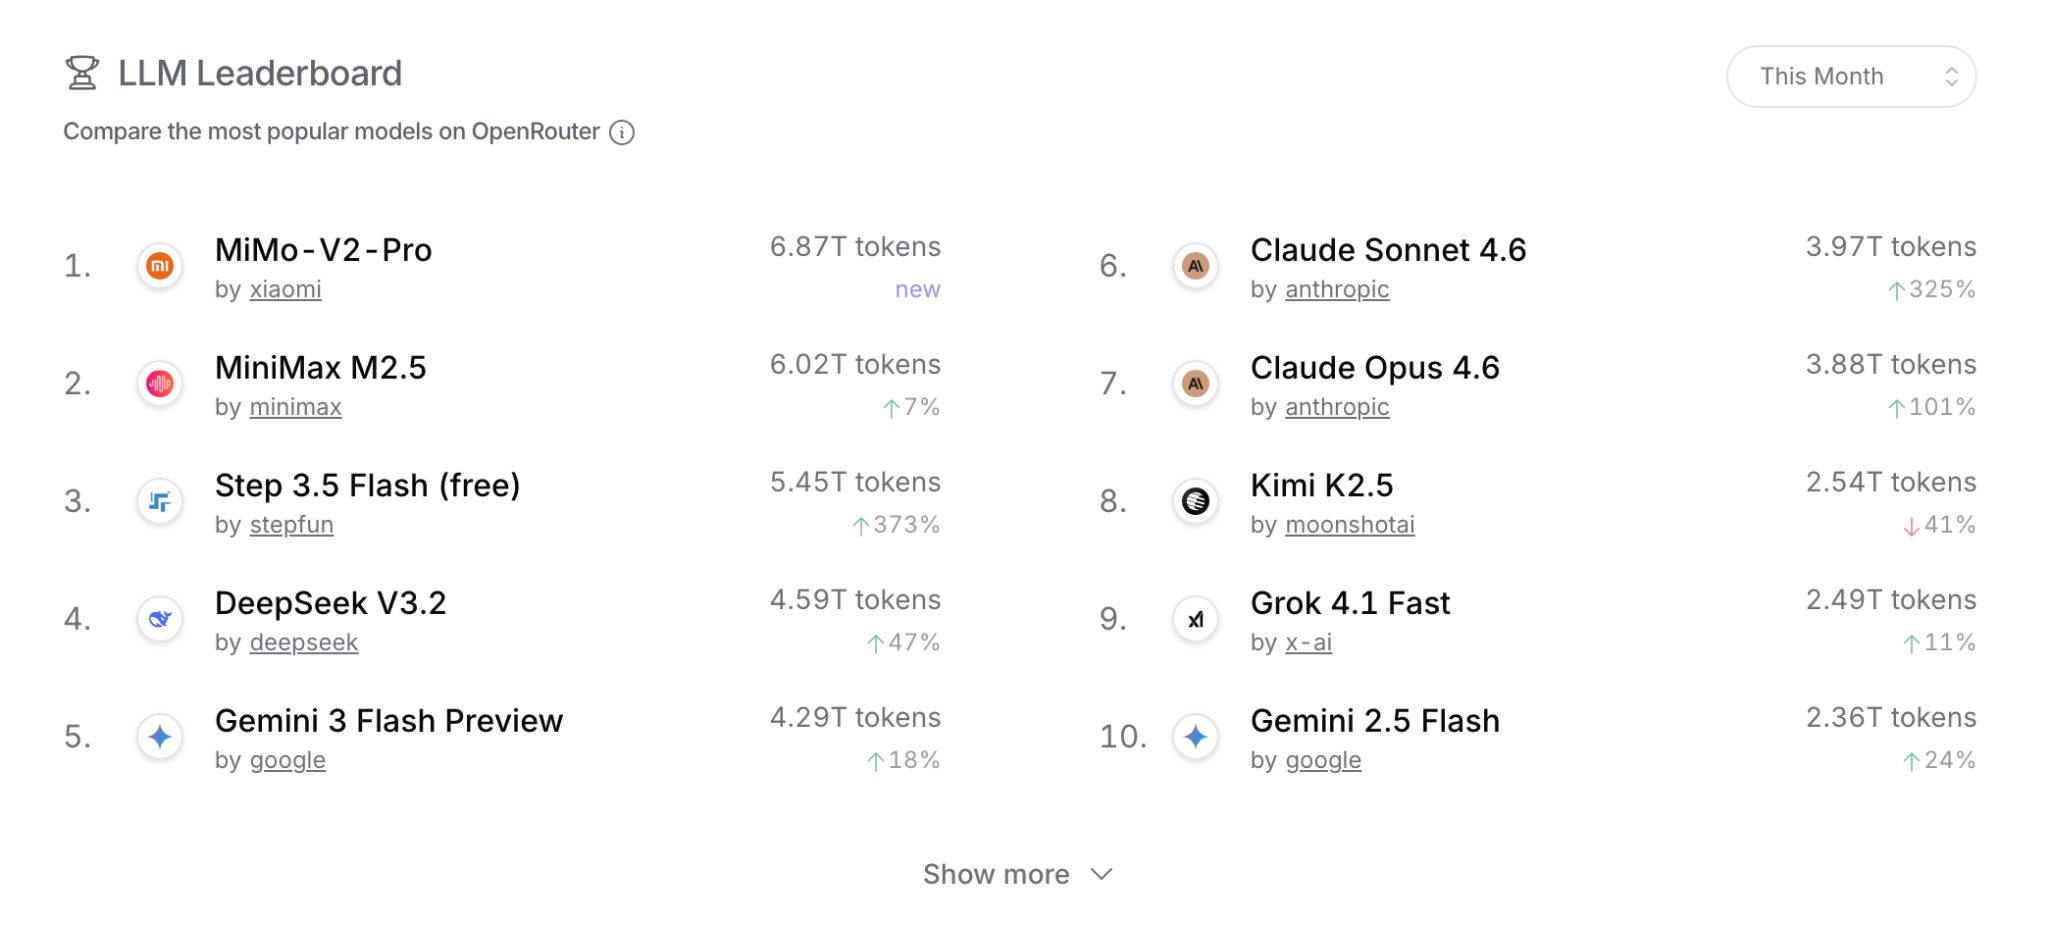
実際、OpenRouterでのトークン使用量を見ると、最も人気のある言語モデルの多くが実は中国製だと気づくだろう(ただし、これはちょっと誤解を招く。たとえば、Claudeを使う人のほとんどは、おそらくOpenRouter経由では使っていない)。
私はたまたま、世界がAGIの構築にどんどん近づくにつれて、生の能力という次元での競争がきわめて重要になると考えている。だが、重要なのはそれだけではないし、AIラボによっては、そもそも同じものを目指して「競争」してさえいない可能性も大いにある。
この記事についてフィードバックと支援をいただいたJS Denain、Jaime Sevilla、David Owen、Ben Cottier、Luke Emberson、Lynette Bye、Stefania Guerraに感謝したい。
注
-
注目すべきことに、Epochの同僚たちは、DeepSeek-R1の学習に4 x 10^24 FLOPが使われたと推計している。一方、o1については、ベースモデルがGPT-4oで事後学習の計算コストが比較的小さいと仮定した、あくまで推測にもとづく概算で4 x 10^25 FLOPである。とはいえ、DeepSeek-R1が非常に安上がりだったという主張の多くは誇張されていることも言っておく価値がある。↩
-
もっとも、大規模な採用攻勢の後でMeta Superintelligence Labsがどうなるかは、まだ見届ける必要があるだろう。↩
-
たとえば、OpenAIやAnthropicの若手リサーチサイエンティストの稼ぎは、年35万ドル前後であることが多い。対照的に、DeepSeekの若手研究者の稼ぎは月5万〜10万人民元ほどで、米ドルに換算すると年10万〜20万ドルになる(年間報酬は12か月分ではなく14か月分である点に注意。年末やボーナスなどで、給与2か月分に相当する追加の支払いがあるためだ)。↩
-
そもそもこうしたイノベーションを生み出すのに、多くの計算資源が必ずしも必要だったわけではない、という反論はありうるかもしれない。だが仮にそうだとしても、実際にはそれらのイノベーションが計算資源に富むAIラボによって開発されたことは、やはり示唆に富む。↩
-
だが、この点で私が間違っているとしても、計算資源の10倍の差は大きく、それを補えるような独自のソフトウェアのイノベーションが見つかることはまれだ。一つの例外は推論モデルかもしれないが、注目すべきことに、これを発明したのはOpenAIである。とても計算資源に乏しいAIラボとは言えない!↩
-
私の理解では、知られていたのは主にモデルのアーキテクチャについての大まかな詳細だった。RoseTTAFoldは、AlphaFold 2がアテンションと同変(equivariant)な構造モジュールを用いて、MSA(多重配列アラインメント)からエンドツーエンドで予測を行うことは知ったうえで開発された。しかし、具体的なアーキテクチャ、損失関数、学習上の工夫は知られておらず、それらが明らかになったのは、AlphaFold2の論文がRoseTTAFoldと同じ日(2021年7月15日)に公表されたときだった。↩
-
「かなり近づいた」と書いたのは、彼らの試み(RoseTTAFold)がAlphaFold 2の性能に完全には及ばないからだ。WebPlotDigitizerで数値を読み取ると、CASP14コンペティションの「平均TMスコア」の指標で、AlphaFold 2の90.2%に対し、RoseTTAFoldは80.3%である。一方で、RoseTTAFoldの計算量は数分の一だったかもしれない。論文の補足資料によれば、64基のNVIDIA V100 GPUで4週間学習された。16ビット精度と30%の利用率を仮定すると、これは1.4e21 FLOPになる。対照的に、私の同僚たちはAlphaFold 2に3e21 FLOPが必要だったと推計しており、これは約2倍である。AlphaFold 2とRosettaFoldの性能が学習計算量を増やしたときにどうスケールするかは知らないが、全体としてはAlphaFold 2のほうが計算効率が高かったのではないかと推測している。↩
-
注意点がある。人づてに聞いたところでは、Anthropicは実はo1の発表から2週間ほどで推論モデルを再実装できたらしく、私にはそれほど突飛な話には聞こえない。ただ、これがo1と他の推論モデルとの時間差について何を意味するのかはよくわからない。おそらくOpenAIは、発表のしばらく前にo1の開発を「終えて」いたのだろう。↩
-
ここで言っているのは、同じ地域の企業からの波及(「地理的な波及」)ではなく、同じ産業の企業間の波及(「技術的な波及」)である点に注意。どちらも重要で、実際、地理的な波及のほうは、他のAI企業に比べて、ベイエリアに集まる計算資源に富むAIラボにおそらく偏って有利に働く。↩
-
ここで見ている指標とは直接比較できないが、効果の大きさの感覚はつかめる。ある論文によれば、似た技術に取り組む他社が研究開発費の総額を10%増やすと、自社の時価総額も2〜3%増える。10分の1の計算資源で競争できることを意味するような話には聞こえない!↩
-
もし足りるなら、Kenneth Arrowが論じたように、フロンティアのラボが研究開発を行う動機をそぐことにもなるだろう。↩
-
厳密に言えば、これは用語の誤用である。本来の定義での蒸留とは、「教師」モデルが最終的に生成した出力だけでなく、ありうるすべての出力にわたる教師モデルの確率分布全体を使って、より小さなモデルを学習させることを指す。↩
-
別の証拠として、「スロップ・フォレンジクス」で、どのモデルどうしが関係しているか(ひいては、どのモデルがフロンティアモデルから能力を受け継いだか)を突き止める方法がある。これは、どの単語や言い回しが一部のモデルで不釣り合いに頻繁に現れるかを調べ、そのモデルの「指紋」を拾い出すものだ。そのうえで指紋どうしを比べてモデル間の関係を見ると、進化系統樹のようなものが得られる。出力をじっくり眺めると、DeepSeekはOpenAIのモデルの合成データでの学習から、Geminiの合成出力での学習に切り替えたと結論づけることもできる。ただ、この種の証拠でどこまで考えを改めるべきかはよくわからない。たとえば、AnthropicのモデルがDeepSeekのモデルのデータで学習されているかもしれない、という説も耳にしたことがある! では、全体像はどうなっているのだろうか?↩
-
ここでは、最終的な出力トークンだけでなく、トークン上の確率分布にアクセスするという、より正確な定義での「蒸留」を使っている点に注意。↩
-
ここでの制約は、元のベンチマーク性能の約95%と、さまざまな領域にわたる幅広い能力を保つことである。特定のベンチマーク群での能力だけを保つなら、おそらくそれよりずっとうまくやれる。↩
-
MiniMaxは、データを集めるためにClaudeと少なくとも1,000万回のやり取りをしたとされる。Nathan Lambertが示唆するように、各「やり取り」が約1万トークンだったとすると、合計で1,000億トークンになる。↩
-
蒸留の種類によっては、はるかに多くのデータを伴うものもある。たとえば、一部のLlama 4モデルは「共蒸留(codistillation)」で学習された。これは、まだ自ら学習中のはるかに大きなモデルと並行して小さなモデルを学習させるもので、小さなモデルは大きなモデルと同じだけのデータを見ることになる。この種の蒸留を、計算資源に乏しいラボがフロンティアモデルに外部からアクセスするだけで再現するのは、おそらくはるかに難しい。↩
-
私の見るかぎり、Alibabaが今はクローズドなモデルしか公開していない、というわけではない。大半のモデルはオープンだが、最良のモデルはクローズドという混合型の体制をとっている。これもまったく新しいことではなく、2024年半ばからそうなっている。↩