
ニュースレター
AIの進歩はまもなく加速する
原題:AI progress is about to speed up
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
AIは、他の産業の基準と比べて進歩が驚くほど速い分野である。過去2年間だけでも、GPT-4 のようなモデルと比べて目覚ましい能力の向上とコストの低下が見られた。これは、他のほとんどどんな分野でも前例のないものだっただろう。しかし観察者の間には、GPT-4 のリリース以降、進歩が予想より遅いという感覚が広くある。
これは主に、それ以降、計算資源の伸びが緩やかだったためだと思う。そのため、計算規模の大幅な拡大よりも、アルゴリズムの進歩とデータの質の向上による改善を目にしてきたのである。フロンティアモデルの学習にかかる計算コストについての私たちの記事から引いた次の図は、このことをはっきり示している。
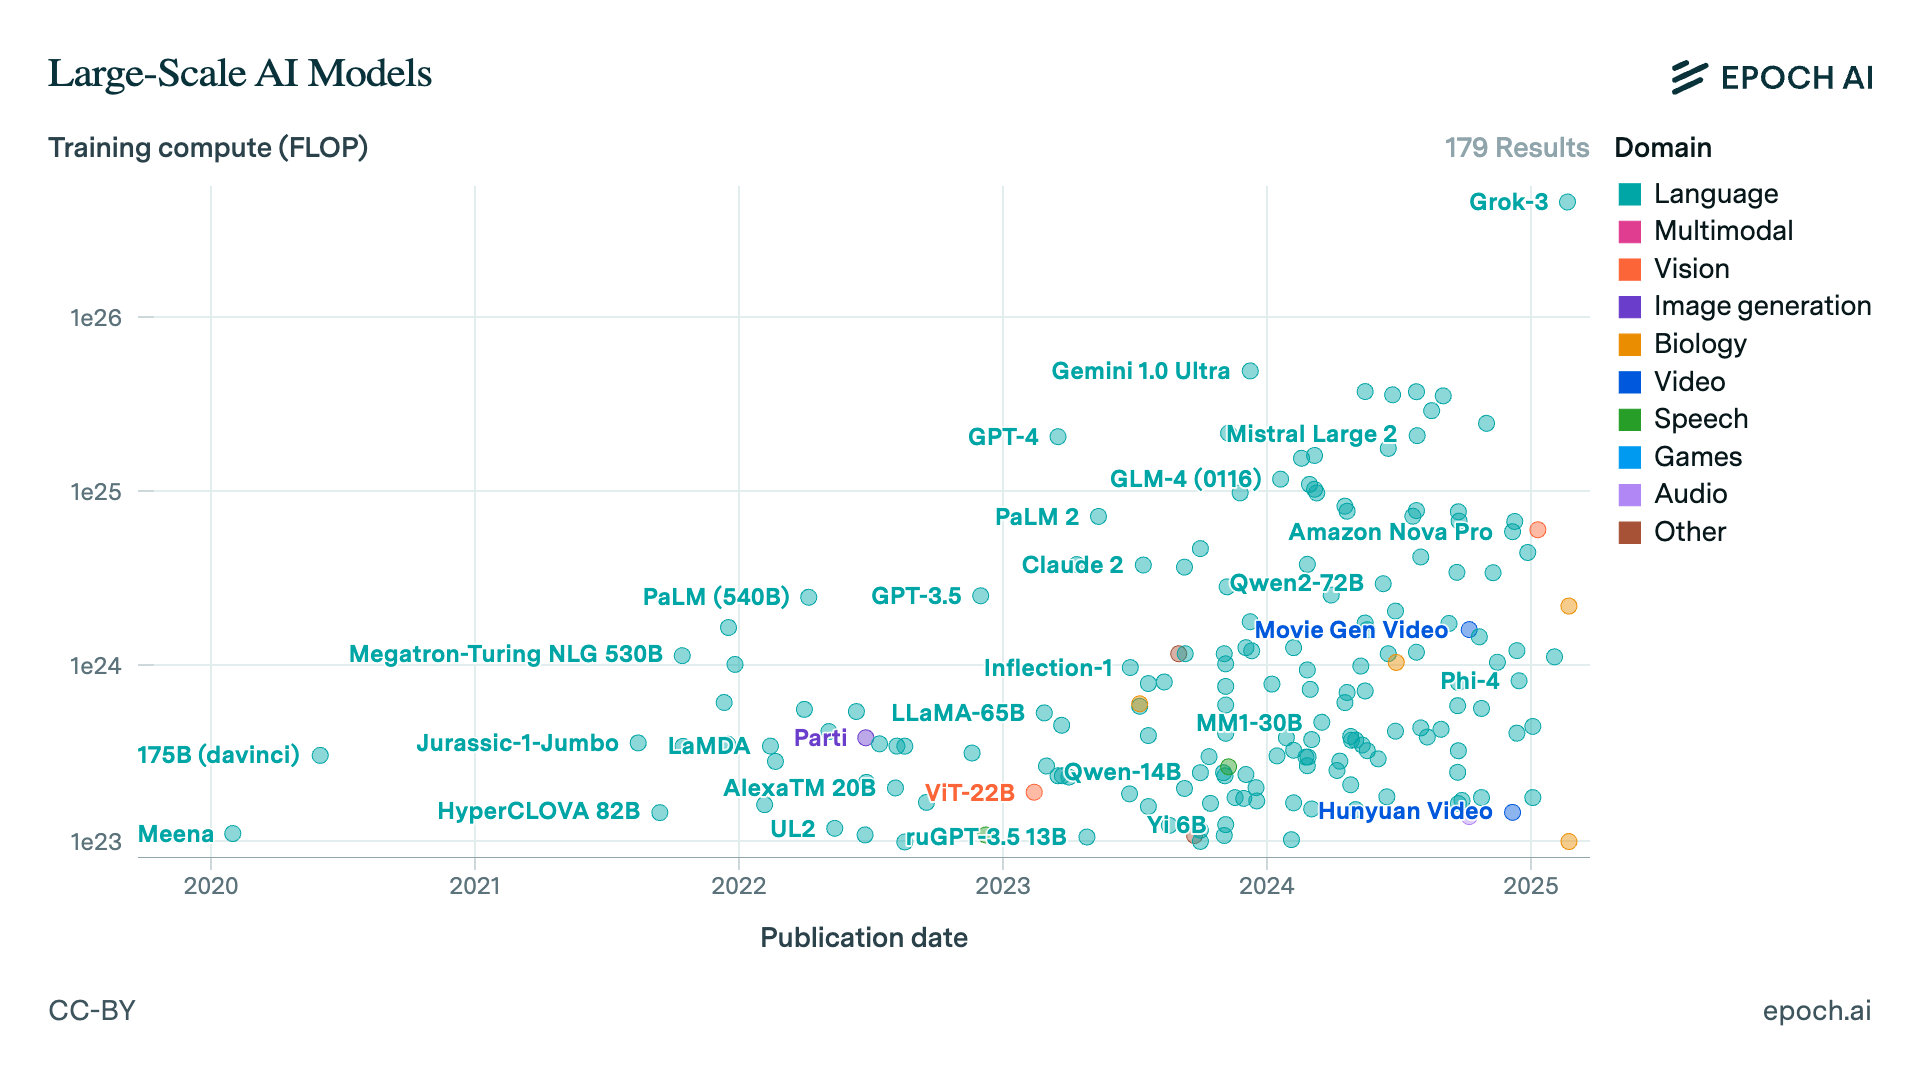
2023年3月の GPT-4 のリリースが際立っているのは、GPT-4 がそれ以前のモデルの10倍の計算規模に相当していたからだ。それ以降、この規模の拡大は二度と起きていない。現在利用できるフロンティアモデルは、Grok 3 を除いて、どれも GPT-4 と同程度かそれ以下の計算予算で学習されている。たとえば Anthropic の CEO である Dario Amodei は最近、Claude 3.5 Sonnet の学習コストが数千万ドルだったことを認めた。GPUの価格性能比のトレンドに基づけば、これは GPT-4 のおよそ2倍の計算量で学習された可能性が高いことを意味する。
Grok 3 を皮切りに、フロンティアの研究所が今年リリースする次世代のモデルはこの壁を破り、GPT-4 から1桁を超える規模の拡大、推論の強化学習(RL)についてはおそらく2桁の拡大に相当するものになるだろう。スケーリングのこれまでの経験に基づけば、これは少なくとも GPT-3.5 から GPT-4 への飛躍と同じくらい大きな、性能の大幅な飛躍につながると予想すべきである。
この来たるべき規模の拡大について、重要な問いがいくつかある。
-
具体的に、まもなく登場する次世代モデルには、さまざまな分野でどのような能力を期待すべきか。
-
これまでに登場した最初の「新世代」モデルである Grok 3 を見て、年末までに期待できる能力についての見方をどう改めればよいか。
-
AIへの支出は、なぜ特定の時期に大きく増えては数年間横ばいになるという、断続的な拡大のしかたをするように見えるのか。GPT-4 のリリース以降の支出の伸びの鈍化は、学習計算量の拡大が「壁に突き当たった」兆候であり、したがって次世代モデルから大きな性能向上は期待できないと見るべきなのか。
Epoch AI の最新情報を受け取る 購読する
新しいモデルに何を期待すべきか
大局的には、まもなく登場する新世代のモデルは、約10万台の H100 で、おそらく8ビット量子化を使って学習され、典型的な学習計算量は約3e26 FLOPになると予想している。これらのモデルは当初、総パラメータ数で GPT-4o よりおそらく1桁大きくなる。そのため、最初にリリースされたときには、APIのトークン価格はおそらく2〜3倍に上がり、短いコンテキストでのデコード速度は約2倍遅くなるだろう。ただし、推論実行用のクラスタが新しいハードウェアに切り替わり、アルゴリズムの進歩も続くので、これらは年の後半には改善するだろう。
業界全体は、以前よりやや遅いペースかもしれないが、成長を続けるだろう。OpenAI の2025年の売上高についての私の予測の中央値は約120億ドル(OpenAI 自身の予測と一致)で、そのうち約45億ドルは年の最後の四半期のものになる。売上高の成長は全体として、主にエージェントとしての能力(エージェンシー)の向上と、長いコンテキストにわたって一貫性を保つ能力の向上によって牽引されると予想する。Deep Research や Operator のような製品には、すでにその兆しがいくつか見られる。これらは、複雑な推論能力の向上より重要であるように見えるが、今日利用できる具体的なベンチマークではあまりうまく測れていない。
アルゴリズムの進歩の速さについて私たちが推定した値の上限をとり、GPT-4 の登場以降5か月ごとに効率が倍増してきたと仮定すると、計算量の10倍の拡大は、モデルの質への影響の点で、およそ17か月分のアルゴリズムの進歩に相当する。さらに2025年末までにもう10か月分のアルゴリズムの進歩がある。つまり、2025年末までに見られる進歩の合計は、2年分を超えるアルゴリズムの進歩に相当し、計算支出がほぼ横ばいだった GPT-4 以降に見てきた進歩を上回ることになる。
どの分野でどれだけ能力が向上しそうかをもっと詳しく見るなら、進歩が見込まれるのは明らかに、現在のモデルがすでにある程度の能力を示している分野である。私の基本的な予想は、AIがすでに能力の兆しを示しているタスクは「解決」されるが、これまでぱっとしなかった能力の進歩はより遅い、というものだ。つまり、プログラミング、数学、複雑な推論、短い創作文といったタスクでは大きな進歩を予想している。
一方、意味のあるエージェンシーと、長いコンテキストにわたる一貫性は、引き続き課題となるだろう。過去2年間、これらの面ではかなり限られた改善しか見られず、さらに2年進歩しても、おそらく手の届くところには来ないからだ。複雑な推論タスクと違って、エージェンシーと長いコンテキストにわたる一貫性はどちらも動物の進化のより早い段階で生じ、進化の歴史の中で強い選択圧を受けてきた。そのためモラベックのパラドックスによれば、これらの面で人間並みの能力に近づくのは、基本的にはより難しいと予想すべきである。
以下に、各分野についての私の予想をより詳しく示す。
プログラミング
コードベースのいくつかのファイルや関数に関わる GitHub の課題(issue)の解決のように、それだけで完結したプログラミングタスクの大半を上手にこなせるAIが登場するだろう。しかし、複雑なソフトウェアプロジェクトを作って管理するのには苦労するはずだ。ここでも他の分野と同様に、AIシステムの実効的なコンテキストウィンドウが短いことが、ソフトウェアエンジニアリングの仕事を本当に自動化するうえでの障害であり続けると思う。とはいえ、期待できる性能向上は、Cursor のような生産性向上ツールにとって非常に有益なはずだ。
具体的には、純粋な競技プログラミングでは、AIシステムがおそらく大差をつけて人間を超え、SWEBench Verified は飽和に近づく(年末時点の最高水準についての私の中央値は90%)と予想している。一方で、たとえば Rust とほぼ同じくらい複雑な言語のコンパイラをゼロから書いたり、通常の条件下で Steam で10万ドルを超える売上を上げられるようなオリジナルのビデオゲームを開発したりすることは、AIにはまだできないだろう。
数学
推論時の計算(test-time compute)というパラダイムに計算資源が十分につぎ込まれて飽和するにつれて、o3 のような推論モデルの能力をさらに質的に大きく超える飛躍が見られるだろう。2025年末時点の FrontierMath の最高水準についての私の中央値は約75%である。モデルは数学研究で人間を意味のある形で手助けできるほど有能になると予想するが、独自の数学研究を自ら行うことまではできないだろう。そこでは、先に述べたコンテキストとエージェンシーの問題が引き続きボトルネックになるからだ。
狭い分野の文献に深く通じていることが成功に必要なタスクでは、AIシステムはやはり苦労すると予想している。最先端の数学研究の大きな部分はまさにそういうものなので、それもあってAIシステムの有用性は限られたままだと思う。
エージェント
この分野では大きな進歩が見られるだろうが、現在のエージェント(OpenAI の Operator など)があまりにお粗末なので、年末時点のエージェントもまだかなりぱっとしないものだと思う。今のところ、Operator は最も単純なコンピュータ操作のタスクにさえ苦労している。しかし年末までには、以下のようなタスクの例を完全に自律的に、確実にこなせるシステムが登場すると思う。
-
指定した場所の近くで一定の条件を満たすレストランを探し、予約する(ウェブサイトから予約できる場合)。
-
2015年以降の Computer Chess Rating List(CCRL)で最強のチェスエンジンのイロレーティングのグラフを、少なくとも月に1つのデータ点を含めて作成する。CCRL は過去のデータを扱いやすい形式で保存していないので難しいが、たとえば Internet Archive を使えばできる。
-
過去90日間に米証券取引委員会(SEC)に四半期報告書を提出した企業のうち、時価総額が1,000万ドルから5,000万ドルの間で、直近の貸借対照表で現金および現金同等物が1,000万ドルを超える企業をすべて列挙する。
一方、2025年末になってもAIエージェントの手に届かないままだと予想するタスクの例を三つ挙げる。
-
典型的な一人用のビデオゲームを最初から最後までプレイする(特定のゲームだけでなく、たとえば2025年に Steam で発売されたゲームの80%超について)
-
ユーザーのコンピュータ上の自明でない問題を、ユーザーに代わって直接解決する。たとえば「私の Ubuntu の仮想マシンがインターネットに接続できない理由を突き止め、ホストマシンへのリモートデスクトップ接続を使って問題を直して」といったもの。
-
自明でない写真や動画の編集タスクをこなす。たとえば「標準的な動画編集ソフトを使って、この動画の BGM を曲Xから曲Yに変えて」といったもの。
一般に、エージェントがこなせるようになるのは、私が遅れをとると予想している能力にあまり依存しないタスクである。その能力とは、低遅延での高度な視覚処理、長いコンテキストにわたる一貫性、そしてAIエージェントがいつどの行動をとるべきかを導く、詳細で複雑な内部モデルを保持することである。たとえば人間にとってポケモンのゲームをクリアするのは簡単だが、AIエージェントはこのタスクにこの先しばらく苦労すると予想している。
Grok 3 をどう見るべきか
私が進歩の加速を予想する論拠は、来たるべき計算規模の拡大に基づいているので、Grok 3 の能力を検討する価値はある。学習計算量が1e26 FLOPを優に超えるモデルとしては、これが最初にリリースされたものだからだ。
Grok 3 からは、スケーリングについて強気の論も弱気の論も立てられる。強気の論は、Grok 3 は確かにベースモデルとして最高水準にあり、2番手のモデルとの間には意味のある差がある、というものだ。そしてこれは、学習計算量が約3e26 FLOPの「次世代モデル」という位置づけを考えれば予想どおりである。弱気の論は、Grok 3 と Claude 3.5 Sonnet のようなモデルとの差は、GPT-4 と GPT-3.5 の差よりずっと小さいように見える、というものだ。どちらもおよそ1桁の計算量の差に相当するにもかかわらず、である。
正しい解釈は、xAI が OpenAI や Anthropic のような研究所、さらにはおそらく DeepSeek にさえ、アルゴリズムの効率で後れをとっている、ということだと思う。Grok 2 が GPT-4 と同程度の計算量を使いながらフロンティアモデルではなかったのはこのためである。Grok 3 が最高のフロンティアモデルより1桁多い学習計算量を使いながら「いくらか優れている」程度にとどまっているのも、同じ理由による。
スケーリングだけの効果を切り出すための正しい比較は、研究所を固定したまま、異なる規模のモデルを比べることである。xAI についてこれを行い、Grok 2 と Grok 3 を比べると(Grok 3 のライブ配信での発言から、これは10〜15倍の計算規模の拡大にあたることがわかっている)、性能に非常に大きな差が見られる。したがって、OpenAI と Anthropic の次世代のベースモデルについて予想すべきなのは、Grok 3 が Grok 2 から向上したのと同じくらい、4o や Sonnet から向上するということである。Grok 3 の進歩の一部は xAI がアルゴリズムの最先端との差を縮めたことによるので、これはおそらくやや誇張されているが、それでもおおむね妥当な見当だと思う。
これに加えて、Grok 3 は American Invitational Math Exam(AIME)のような推論タスクで DeepSeek R1 よりいくらか優れているにすぎない。ここから、xAI は複雑な推論のための強化学習の拡大に、まだ大きな資源を投じていないと考えられる。これは一つには、強化学習はより逐次的であり、したがってGPUを買い増すことで拡大するのが難しいためだと思う。しかし、強化学習の計算支出を数千万ドル規模まで適切に拡大する方法を xAI が見つければ、Grok 3 からでさえ、まだ多くの性能を引き出せるはずだ。
以上をまとめると、Grok 3 は、今年のAIの進歩について弱気になる理由よりも、強気になる理由を多く与えていると思う。
これまで支出がもっと速く伸びなかったのはなぜか
GPT-4 のリリース以降、モデルの学習計算への支出が伸びていないことを、スケーリングの収穫が逓減している証拠と受け取る人もいる。証拠としては、これはかなり弱いと思う。大きなリリースの合間に支出の伸びが鈍ると考える説得力のある理由はほかにたくさんあり、支出の伸びが同じように停滞した時期は以前にも、たとえば GPT-3 のリリース後にあったからだ。
減速が予想される最も重要な理由は、アルゴリズムの着実な改善のトレンドがあるために、研究所には新しい学習実行に踏み切る前に待つ誘因があることだ。同じ計算資源でも後で使えばより大きな成果が得られるからである。すぐに追い越されると予想される、より原始的な学習実行を行うよりも、蒸留、推論実行、実験などに計算資源を使うほうが、投資の見返りが大きいことが多い。ソフトウェアの進歩が続くにつれて、ある時点で、古いモデルを中心に築かれたエコシステムに投資を続けることの限界的な価値が下がり、能力の大きな飛躍をもたらす大規模な学習の拡大を試みることの価値が高まる。
さらに、1桁の規模の拡大を実行するたびに、ハードウェアとソフトウェアの両面である程度のエンジニアリングが必要になる。それがなければ、学習実行はそもそも統率できないか、満足のいく結果をもたらさない。必要な作業には時間がかかり、規模の拡大を正しく行う方法を見つけるまでの過程で、学習実行に失敗することもフロンティアの研究所では珍しくない。
研究所は、こうした規模の拡大に必要なハードウェアも確保しなければならない。これは容易ではない。モデルを学習するクラスタに必要な初期の設備投資は、モデルそのものの学習コストの10倍になることが多いからだ。これは、クラスタ内のGPUの償却期間が数年程度であるのに対して、学習実行は数か月程度しかかからないためである。したがって、GPU時間にGPU時間あたりのコストを掛けて測った学習コストが3億ドルのモデルには、30億ドル以上の設備投資が必要になる。
OpenAI や Anthropic のように自前の計算資源を持たないフロンティアの研究所は、ハイパースケーラーのパートナーと契約を交渉する必要がある。パートナーの側は、こうした規模の拡大に必要な計算資源へのアクセスを提供する前に、それまでのAIシステムで目覚ましい結果を見たいと考えるかもしれない。加えて、ハイパースケーラー自身も、必要なデータセンターの容量を整備する時間を要する。整備の速さが際立っていた xAI でさえ、10万台の H100 からなるクラスタを稼働させるのに4か月かかった。
これらすべてを考え合わせ、さらに多くの要因(たとえばハードウェアへのアクセスの確保)が研究所の間で相関していることも踏まえれば、スケーリングがまったく問題なく機能しているとしても、もっと早い時期にもっと大胆な学習実行が見られなかったのはそれほど意外ではない。2年ほどの「休止」を説明しうる実際的な要因が、ただ数多くあるのだ。
結びに
以上で私が描いた像は、数学や競技プログラミングのような心躍るスキルでは大きな進歩が見られるが、エージェンシーや一貫性のような地味なスキルでは進歩が小さい、というものだ。モラベックのパラドックスのために、AIがあらゆる面で人間の能力に匹敵できるようになるまで、これは一般的なパターンとして続くと考えている。
さらに、あえて直観に反する予測をするなら、2025年以降、AIシステムの経済的価値の大半は、実はこうしたより平凡なタスク、つまり現在ベンチマークや評価であまり注目されていないタスクから生まれるだろう。長いコンテキストでの性能、計画を立てて状況の変化に合わせて修正する能力、コンテキスト内での失敗からすばやく学んでそれを直す全般的な能力などの小さな改善のほうが、AI研究所が評価やデモで好んで取り上げる数学、プログラミング、質疑応答などの能力よりも、売上高の成長を牽引するだろう。長期的には、AIの売上高の大半は企業向けの用途から生まれると予想している。そうした用途は、こうした平凡な能力にこそ依存して、人間の労働を部分的または完全に自動化するものである。ただし2025年は、消費者向けの用途が飽和するにはおそらく早すぎる。
だからといって、2025年がAIにとって心躍る年にならないというわけではない。それどころか、2023年をも上回る、これまでで最も心躍る年になるかもしれない。しかし、その興奮は主に、今年見られる本当の売上高の成長にとっては実は周辺的な能力によって生み出されると思う。AIの能力に実際に何が起きているかを追い続けるには、押し寄せる誇大宣伝に気を取られず、経済的に極めて重要でありながら能力の向上がずっと小さかった、根底にある中核的なスキルにもっと注目することをお勧めする。