
ニュースレター
DeepSeekはTransformerのアーキテクチャをどう改良したのか?
原題:How has DeepSeek improved the Transformer architecture?
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
DeepSeekは先ごろDeepSeek v3を公開した。このモデルは現在、オープンウェイトのモデルの中でベンチマーク性能が最高水準にあり、同時にモデルの学習をかなり詳しく説明した技術報告書も公開された。見事なことに、DeepSeekはこの最高水準の性能を、学習用ハードウェアの稼働時間でわずか280万H800時間を使うだけで達成した。MFU(モデルFLOP利用率)を40%と仮定すると、これは約4e24 FLOPに相当する。同程度の性能のLlama 3.1 405Bと比べて、学習計算量はおよそ10分の1である。
今回は、DeepSeekが報告書で強調しているアーキテクチャ上の重要な改良のいくつかを取り上げ、それらが素のTransformerと比べて性能の向上につながると考えられる理由を説明する。技術報告書の全文にはアーキテクチャ以外の詳細もたっぷり含まれている。中規模の学習を取り仕切るときに解決しなければならない工学上の問題をよりよく知りたいなら、ぜひ読むことを勧める。
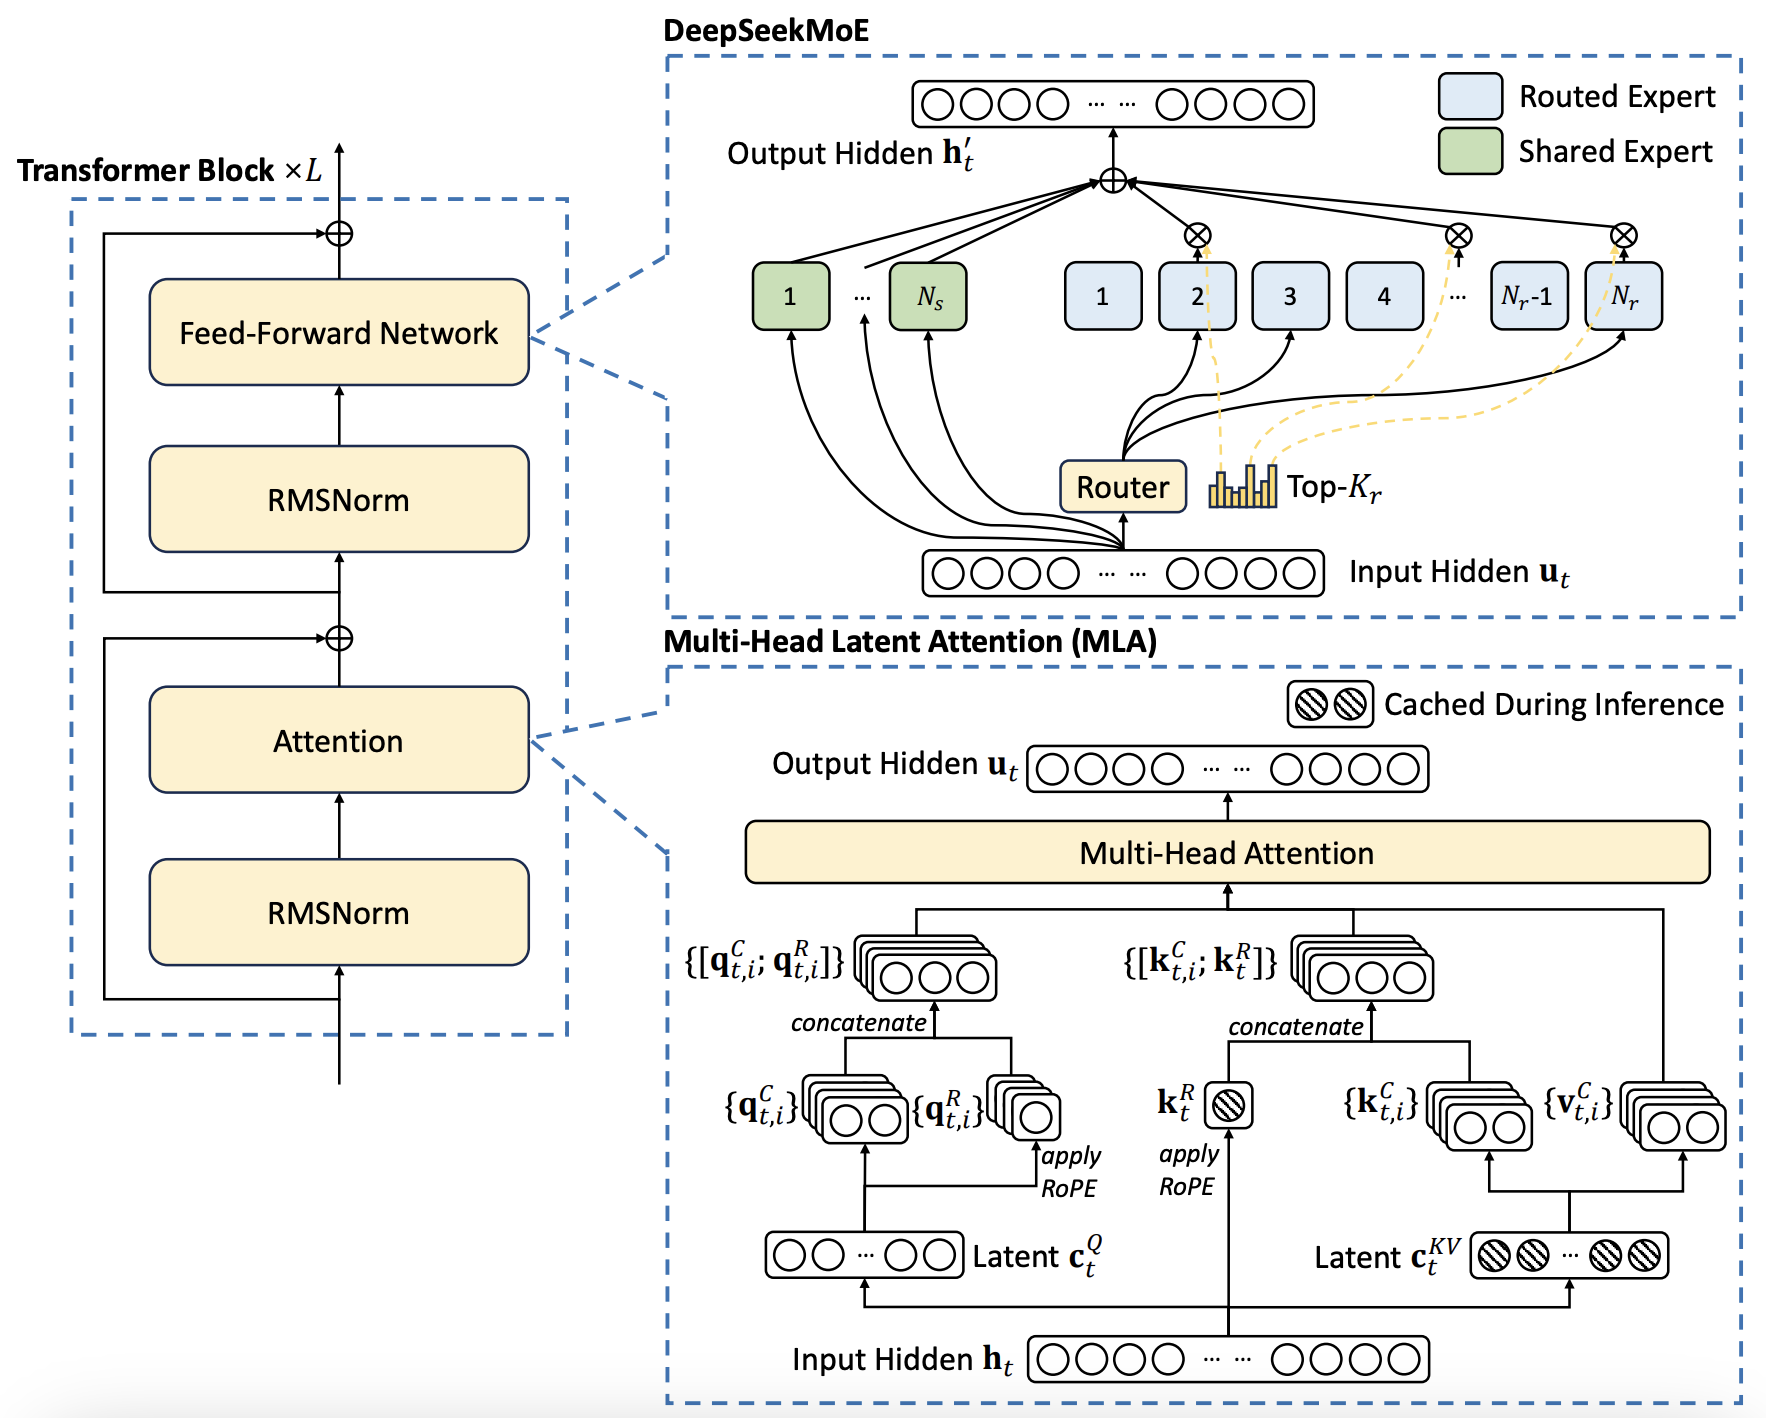
図1:DeepSeek v3のアーキテクチャと、その最も重要な二つの改良であるDeepSeekMoEとマルチヘッド潜在アテンション(MLA)。マルチトークン予測は図示していない。DeepSeek v3の技術報告書より。
Epoch AI の最新情報を受け取る 購読する
マルチヘッド潜在アテンション(MLA)
マルチヘッド潜在アテンション(略してMLA)は、長いコンテキストでの推論実行にとって、DeepSeekのモデルで最も重要なアーキテクチャ上の革新である。この手法はDeepSeek v2で初めて導入されたもので、グループ化クエリアテンションやマルチクエリアテンションといった従来の手法より優れたやり方でKVキャッシュのサイズを減らす。
まず、KVキャッシュとは何なのかを簡単に説明する。ご存じの方は、次の小節まで読み飛ばしてかまわない。
KVキャッシュとは何か、なぜ重要なのか
推論実行の際にTransformerを使ってトークンを順に生成するとき、次にどのトークンを出力するかを決めるには、過去のすべてのトークンの文脈を見る必要がある。素朴なやり方は、新しいトークンを生成するたびに、過去のすべてのトークンを含めて順伝播を行うことである。しかし、過去のトークンはすでに一度処理されているので、これは非効率だ。前に一度得て捨てた結果を、また計算し直しているだけだからである。
この再計算を避けるには、過去のすべてのトークンについてTransformerの関連する内部状態をキャッシュしておき、後のトークンでそれが必要になったときにキャッシュから結果を取り出すのが効率的である。過去のトークンが後のトークンに影響を与える経路は、アテンション機構におけるキーとバリューのベクトルだけなので、これらのベクトルをキャッシュすれば足りる。キー・バリューキャッシュ、略してKVキャッシュという名前はここから来ている。
これはコンテキスト長が短いうちはうまくいくが、長くなると費用がかさみ始める。キャッシュの読み出しはただではないからである。これらのベクトルはすべてGPUの広帯域メモリ(HBM)に保存しておき、計算に使う必要があるときにテンソルコアに読み込まなければならない。各トークンが過去の文脈をすべて知る必要があるなら、トークンを一つ生成するたびに、過去のKVキャッシュ全体をHBMから読み出さなければならないということになる。
標準的なマルチヘッドアテンション機構を使う素のTransformerでは、過去のトークン1個あたりのKVキャッシュのパラメータ数は次のように表せる。
2 × アテンションヘッドの次元 × アテンションヘッドの数 × Transformerブロックの数
たとえばGPT-3には、それぞれ128次元のアテンションヘッドが96個あり、ブロックが96個あった。したがって、トークン1個あたり236万パラメータのKVキャッシュが必要になる。KVキャッシュのパラメータ1個あたり2バイトの精度なら、4.7 MBである。
GPT-3は長いコンテキストウィンドウに対応していなかったが、仮に対応していたとすると、コンテキスト長10万でトークンを1個追加で生成するたびに470 GBのメモリ読み出しが必要になる。H100のHBM帯域幅3.3 TB/sを前提にすると、これはH100の稼働時間でおよそ140ミリ秒に相当する。H100 1基あたり1時間2ドルとすると、生成トークン100万個あたりの価格は80ドルになる。これは、Claude 3.5 Sonnetの顧客向け価格(Anthropic自身にとっての原価をかなり上回っている可能性が高い)の約5倍の高さである。この素朴な費用は、たとえば投機的サンプリングによって下げられるが、おおよその目安としては十分である。
この大まかな計算から、10万以上のコンテキスト長を扱う場合に、KVキャッシュのサイズを減らす方法を見つけることがなぜ決定的に重要なのかが分かる。オープンソースのモデルでこれまで最も広く使われてきた方法は、グループ化クエリアテンションである。このアーキテクチャでは、キーとバリューのヘッドの各組に複数のクエリヘッドを割り当て、事実上クエリヘッドをグループにまとめる。手法の名前はここから来ている。これにより、KVキャッシュのサイズは、選んだグループの大きさ分の1になる。Llama 3.3 70BやMistral Large 2などのモデルでは、グループ化クエリアテンションによってKVキャッシュのサイズがおよそ1桁小さくなっている。
グループ化クエリアテンションを上回る
グループ化クエリアテンションやKVキャッシュの量子化といった手法の根本的な問題は、KVキャッシュのサイズを減らすためにモデルの質を犠牲にすることである。これに対しDeepSeekは、少なくとも社内の実験では、質を犠牲にすることなくKVキャッシュのサイズを減らす方法を見つけた。
DeepSeekは、残差ストリームからキーとバリューのベクトルを計算する過程を二段階にすることでこれを実現している。素のTransformerでは、キーとバリューのベクトルは、残差ストリームのベクトルに次の形の行列を直接掛けて計算する。
(ヘッドの数 · ヘッドの次元)×(モデルの次元)
DeepSeekの方法は、要するにこの行列を低ランクに制約するものである。潜在次元を一つ選び、この行列を二つの行列の積として表す。一つは潜在次元×モデル次元の行列、もう一つは(ヘッドの数 · ヘッドの次元)×潜在次元の行列である。そして推論実行の際には、完全なキーとバリューではなく、潜在ベクトルだけをキャッシュする。潜在次元を小さくすれば、KVキャッシュのサイズを縮められる。
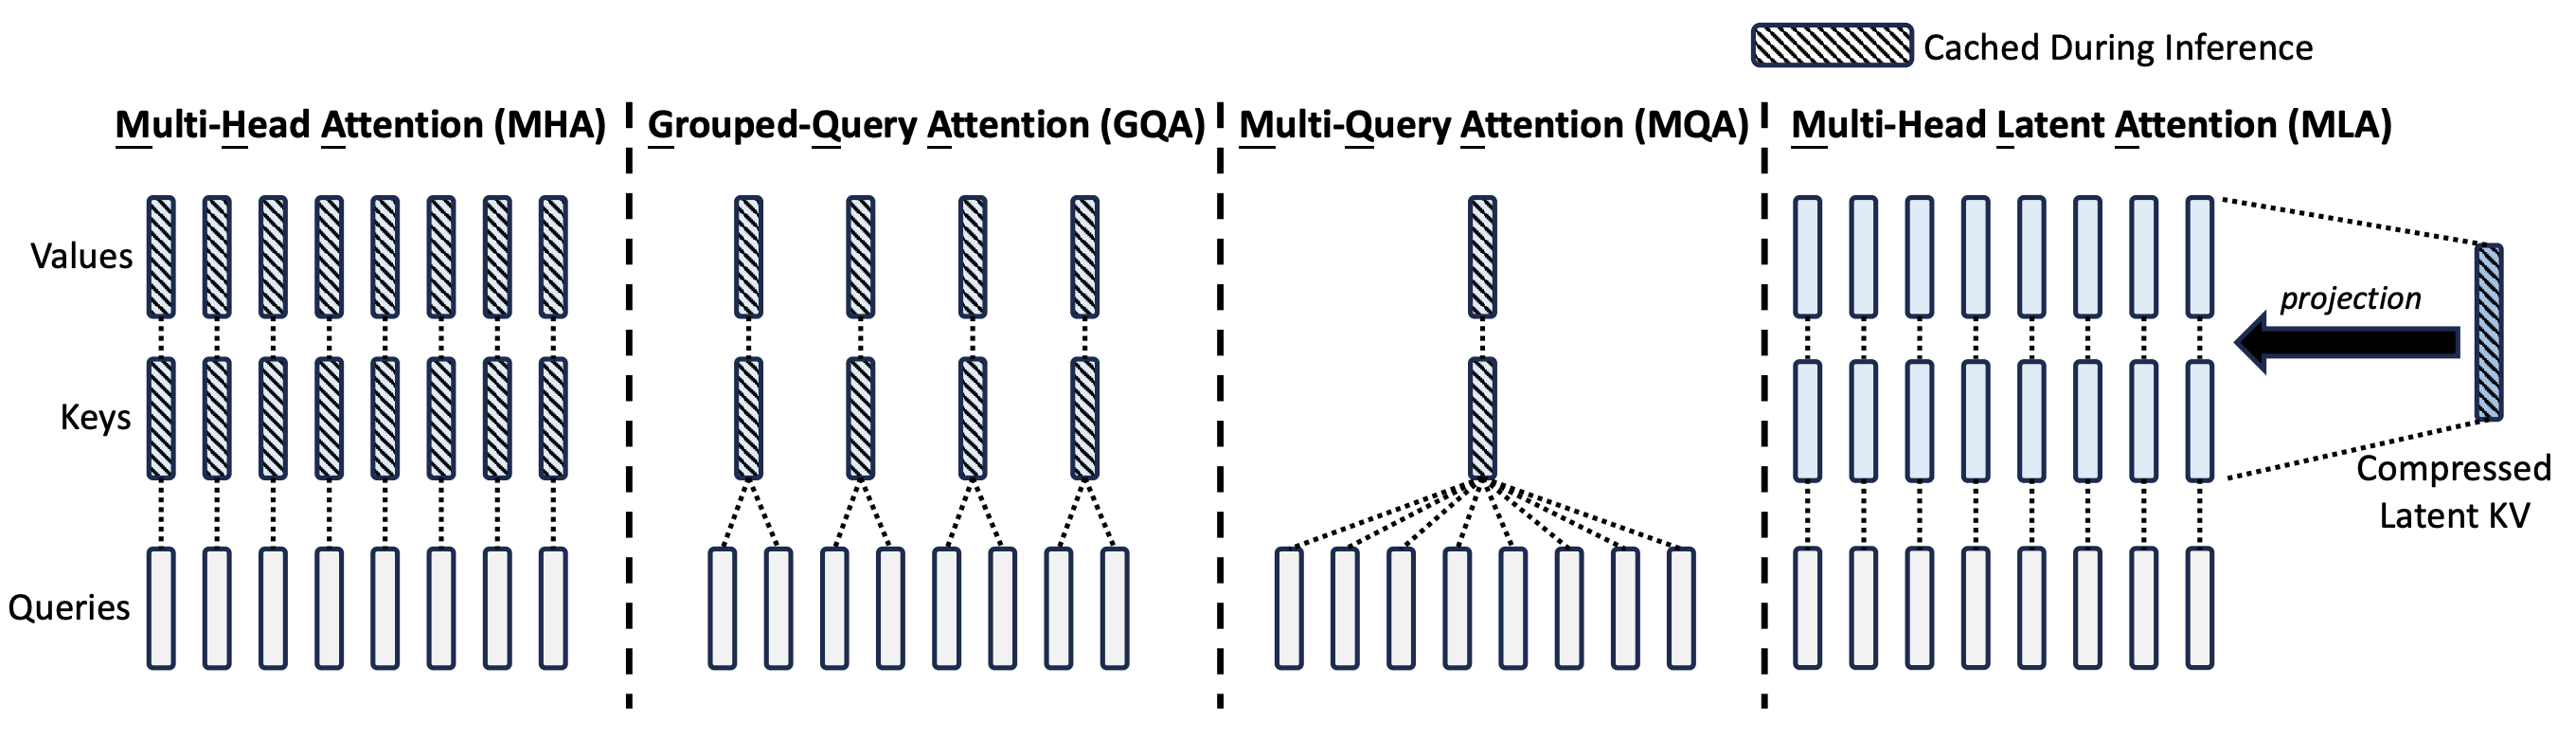
図2:DeepSeek v2の技術報告書にあるマルチヘッド潜在アテンションの図。
素朴に考えると、これでは問題は解決しないはずである。新しいトークンを生成するたびに、実際のキーとバリューを再計算しなければならないからである。結局のところ、アテンションを機能させるのに必要なのは、潜在ベクトルではなく完全なベクトルなのだから。マルチヘッド潜在アテンションは、実はそうではないという巧妙な観察に基づいている。潜在ベクトルから元の次元のキーとバリューのベクトルを計算する行列の掛け算を、それぞれクエリの射影とアテンション後の射影に統合できるからである。
低ランク圧縮がこれほど効果的なのは、異なるアテンションヘッドが知る必要のある情報のあいだに、重なりがたくさんあるからである。すべてのヘッドのキーとバリューをまとめて積み重ねたものではなく、個々のヘッドのキーとバリューのベクトルに低ランク圧縮をかけた場合、この手法は、最初から小さなヘッドの次元を使うのと同じことになり、何の得もない。異なるヘッドが同じ情報にアクセスする必要があることを活かす点が、マルチヘッド潜在アテンションの仕組みの要である。
グループ化クエリアテンションのような手法も同じ重なりを活かそうとするが、グループにまとめたアテンションヘッドがすべてクエリに似た応答をするよう強いるため、その活かし方は効果的でない。言い換えれば、情報を共有することが、ある限られた意味で同一の振る舞いをすることと抱き合わせになってしまう。これは明らかに望ましくない性質である。一方、低ランク圧縮では、同じ情報を異なるヘッドがまったく違うやり方で使える。理論上は、これが学習に有益な正則化の効果をもたらすことさえありうる。実際DeepSeekは、技術報告書でそうした効果が見られたと報告している。
私はこれを、後から見れば当たり前に思えるが、思いつくにはアテンションヘッドが実際に何をしているかをよく理解している必要がある、という種類の革新の一つだと見ている。この方法を一度見れば、グループ化クエリアテンションより悪くなりようがなく、おそらく大幅に良いことはすぐに分かる。しかし、これを試してみようという発想に至るのは、また別の話である。
混合エキスパートの革新
素のTransformerに対する改良で最も広く採用されたものの一つが、混合エキスパート(MoE)モデルの導入である。このモデルは、Transformerのフィードフォワードブロックを複数の別々のエキスパートに分け、各トークンを文脈に応じて少数のエキスパートに送るルーティングの仕組みを加える。これにより、モデルは個々のトークンで活性化させるより多くのパラメータを持てる。ある意味で、モデルがどれだけ知っているかを、個々のトークンを処理する演算の費用から切り離せるのである。現在MoEだと知られているモデルで最も影響力が大きいのは、おそらく初代のGPT-4である。
エキスパートのルーティングのアルゴリズムは次のように動く。どの層でも、アテンションブロックを出たところで、出力として残差ストリームのベクトルが得られる。各エキスパートには同じ次元のエキスパートベクトルが対応しており、現在の残差ストリームとの内積が最も大きいエキスパートを調べることで、どのエキスパートを活性化させるかを決める。
この方法の問題は、離散的な値をとる、かなりたちの悪い不連続な関数をモデルの中核に持ち込むことである。連続的な入出力関係を実装する素のTransformerとは、まったく対照的である。そのせいで、MoEの学習では勾配降下法による最適化がうまく働かず、しばしば「ルーティングの崩壊」が起こる。ルーティングの崩壊とは、モデルが知識と計算を利用可能なすべてのエキスパートに行き渡らせず、どのトークンに対しても同じ少数のエキスパートばかりを活性化させる状態から抜け出せなくなることである。
ルーティングの崩壊を直感的に理解するために、エキスパートが全部で16個あり、トークンごとに2個が活性化するGPT-4のようなモデルを学習させる場合を考えてみよう。ここで、ランダムな初期化の都合で、たまたまそのうち2個のエキスパートが最初に最も良い性能を示したとする。すると勾配降下法は、これらのエキスパートを選ぶ傾向を強める。その結果、更新の際の勾配信号のほとんどがこれらのエキスパートに集まり、これらは良くなっていく一方で、他のエキスパートは取り残される。そのため他のエキスパートは選ばれないままになり、正のフィードバックループが生じて、他のエキスパートは決して選ばれず、学習もされなくなる。
根本的な問題は、勾配降下法が局所的に最良の方向に進むだけだということである。ニューラルネットワークの学習で出会う非常に高次元の最適化問題では、ふつうはこれでうまくいく。しかしニューラルネットワークの振る舞いがこれほど不連続だと、問題空間が高次元であっても失敗から救われないことがある。
こうした学習の難しさに対処するのは簡単ではない。DeepSeek v3は、いくつかの異なる革新を組み合わせてこれに対処している。以下、一つずつ説明する。
補助損失を使わない負荷分散
ルーティングの崩壊を避ける一般的な方法は、ある程度大きなバッチの中で各エキスパートがほぼ同じ回数ずつ活性化されるという「均衡のとれたルーティング」を強制することである。そのために、あるバッチでエキスパートのルーティングがどれだけ偏っていたかを測る項を学習の損失に加える。この項は「補助損失」と呼ばれ、これを導入すればモデルが均衡のとれたルーティングに向かうのは直感的にもうなずける。しかしDeepSeek v3の技術報告書は、こうした補助損失は、均衡のとれたルーティングを保証してくれても、モデルの性能を損なうと指摘している。
DeepSeekの代案は、エキスパートごとのバイアス項をルーティングの仕組みに加え、エキスパートとの親和度に足し合わせることである。このバイアス項は勾配降下法では更新せず、学習の間ずっと、負荷の均衡が保たれるように調整し続ける。あるエキスパートが本来あるべき回数ほど選ばれていなければ、選ばれるようになるまで、勾配ステップごとにそのバイアス項を一定の小さな量だけ少しずつ引き上げればよい。技術報告書によれば、この方法は、適切な負荷の均衡を保ちながら、補助損失に頼るよりも良い性能を達成する。
共有エキスパート
ルーティングの崩壊に対処する上の方法には、深刻な問題がある。最適に学習されたMoEは均衡のとれたルーティングを持つはずだと、何の根拠もなく仮定していることである。しかし、これは疑わしい仮定である。
その理由を理解するために、どんな大規模言語モデルでも、頻繁に使う情報は少量で、めったに使わない情報が大量にある可能性が高いことを考えてみよう。たとえば、LLMに対する英語の依頼のほとんどすべてで、モデルは英語の話し方を知っている必要がある。しかし、1510年のフランス国王が誰だったかを知っている必要のある依頼は、ほとんどない。したがって、最適なMoEは、頻繁にアクセスされて「共通の情報」を蓄える少数のエキスパートと、まれにしかアクセスされずに「専門的な情報」を蓄える他のエキスパートを持つ、ということは大いにありうる。
均衡のとれたルーティングを強制すると、このようなルーティングの構成は実現できなくなり、情報を異なるエキスパートに重複して持たせなければならない。一方、均衡のとれたルーティングを強制しなければ、ルーティングの崩壊のリスクに直面する。このジレンマから逃れるために、DeepSeekはエキスパートを二種類に分ける。共有エキスパートとルーティングエキスパートである。共有エキスパートには、何があっても常にトークンが送られる。共有エキスパートは、エキスパートとの親和度の計算からも、ルーティングの偏りに対する損失項からも除外される。均衡のとれたルーティングを保証することに気を配るのは、ルーティングエキスパートについてだけである。
ここで鍵となる観察は、「ルーティングの崩壊」とは、個々のエキスパートが選ばれる確率が1か0のどちらかになる極端な状況だということである。素朴な負荷分散は、分布を一様にしようとすることで、つまりどのエキスパートも同じ確率で選ばれるようにすることで、これに対処する。しかし、関心がルーティングの崩壊を避けることだけなら、特に一様分布を目標にする理由はない。DeepSeek v3は代わりに、各エキスパートが、確実に選ばれる(確率1)か、トークンごとにある一定の確率 p > 0 で選ばれるかのどちらかになる分布を目標にしている。
私は、この分布でさえ最適ではなく、もっと良い分布を選べばもっと良いMoEモデルが得られる可能性が高いと思っている。それでも、単に一様分布を強制するのに比べれば、すでに大きな改善である。
マルチトークン予測
DeepSeek v3が素のTransformerに加えた最後の変更は、モデルの1回の順伝播で複数先のトークンまで予測できるようにしたことである。これにより、学習時に厳密な次トークン予測ではなくマルチトークン予測の目的関数を使えるようになる。DeepSeekは、アブレーション実験でこの変更による性能向上を示している。
基本的な考え方は次のとおりである。まず、次トークン予測のための通常の順伝播を行う。素のTransformerと同じく、最後の残差ストリームのベクトルを使い、アンエンベディングとソフトマックスを通して次のトークンの確率を生成する。しかし素のTransformerと違い、このベクトルを後続のTransformerブロックにも入力し、そのブロックの出力を使って2つ先のトークンを予測する。これは好きなだけ繰り返せるが、DeepSeek v3は学習時に2トークン先までしか予測しない。
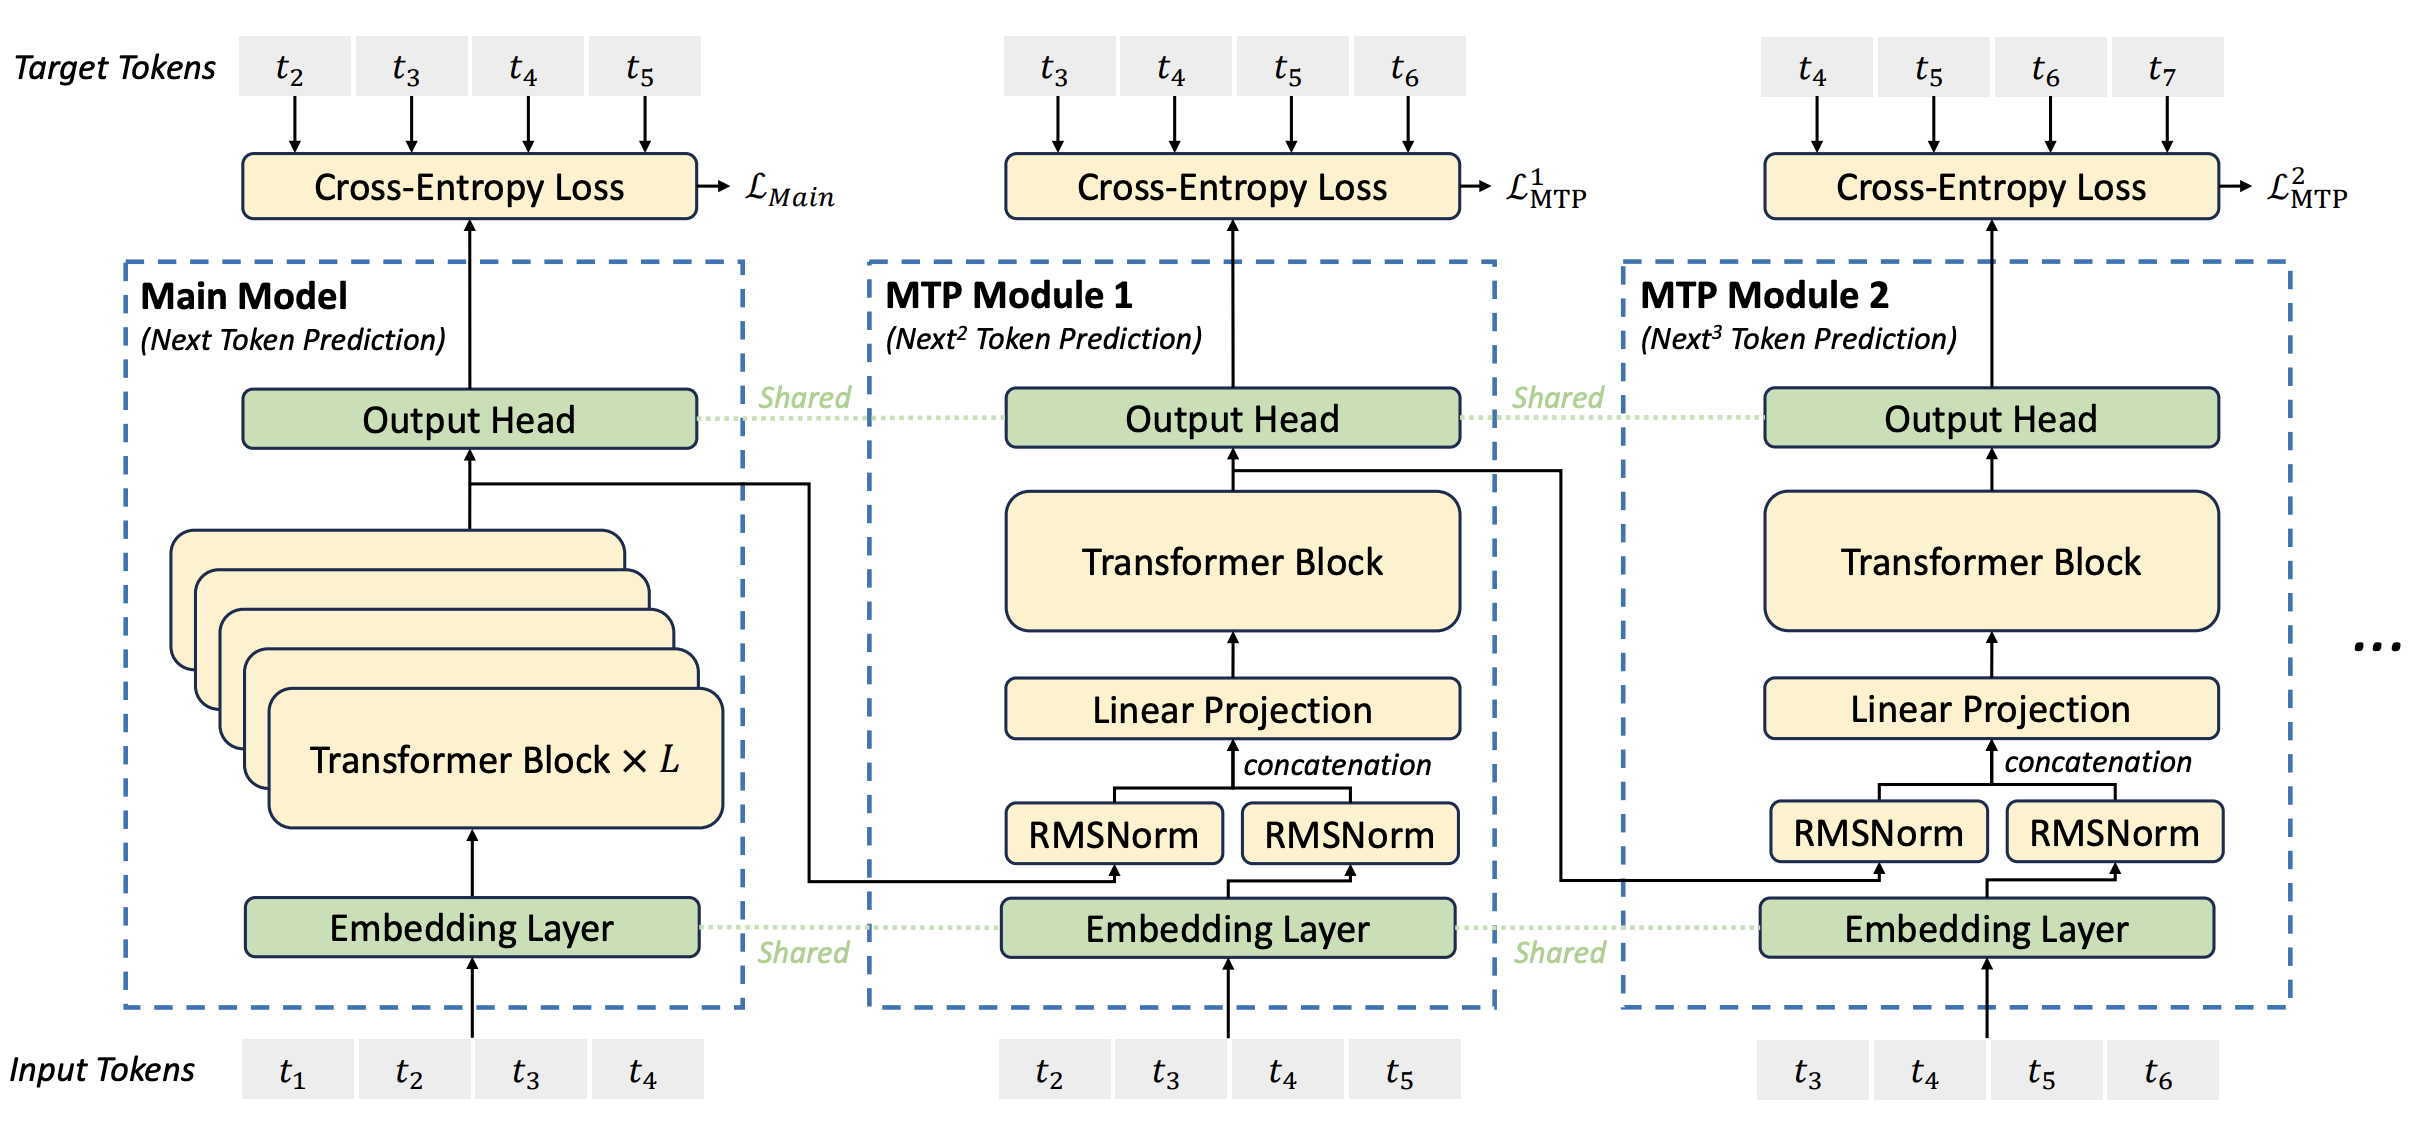
図3:DeepSeek v3のマルチトークン予測の構成。技術報告書より。
DeepSeekは、これらの先のトークンについての予測を学習の目的関数に組み込むために、学習の損失に交差エントロピーの項を追加している。その重みはハイパーパラメータとして上下に調整できる。これによって、学習中に信号を得るための目標が一つ増えるだけでなく、モデルを使ってモデル自身の投機的デコーディングを行うこともできる。順伝播のたびにいくつかのトークンを生成し、それをモデルに見せて、提案された続きをどの時点から棄却すべきかを判断させればよい。
DeepSeek v3は2つ先のトークンまでしかマルチトークン予測を使っておらず、技術報告書が示す2トークン目の予測の採択率は85%から90%である。これはかなり見事な数字で、上で述べた投機的デコーディングの構成を使えば、トークンあたりの価格を一定に保ったまま、推論実行の速度(利用者1人あたり毎秒のトークン数)をほぼ2倍にできるはずである。Llama 3 405BをLlama 3 70Bでデコードするときに得られる採択確率と比べて悪くは見えず、むしろ良いかもしれない。
2つ先より先のトークンまで予測していたらどんな結果が得られたのか、興味がある。たとえば、後続のトークンが一つ増えるごとに採択率が相対的に15%下がるのだとすれば、さらに数トークン先まで予測することで、この投機的デコーディングの構成からもう少し利得を絞り出せるかもしれない。
結論
私は、DeepSeekによる改良の多くを「後から見れば当たり前」のものだと見ている。もし事前に誰かに尋ねられていたら、良いアイデアだと答えただろうという種類の革新である。しかし前にも述べたように、だからといって、そもそもそのアイデアを思いつくのが簡単だということにはならない。
DeepSeekのチームは研究の「センスが良い」という感想を、多くの人から聞いてきた。これらのアーキテクチャ上の改良だけを見ても、その評価は正しいと思う。どの改良も、ありうるアイデアを総当たりで探索した結果として見つかったようには見えない。むしろ、Transformerがどう動くのか、そのアーキテクチャのさまざまな欠点にどう対処できるのかを理解した研究者が、注意深く考え出したもののように見える。
同じような改良が次にどこで見つかりそうかを推測しなければならないとしたら、計算資源の優先配分がおそらく有望だろう。現在のTransformerは、どのトークンを処理・予測しているかにかかわらず、トークンあたり同じ量の計算資源を使う。これは直感的に非効率に思える。モデルは、難しい予測をしているときにはもっと考え、易しい予測をしているときにはあまり考えないようにするべきである。ある程度までは、テスト時の計算量を可変にしてスケーリングすることで推論実行の構成に組み込めるが、ベースモデルのアーキテクチャに直接組み込む方法もあるはずだと私は考えている。