
レポート
深層学習モデルの学習計算量を推定する
原題:Estimating training compute of deep learning models
より多くの計算資源を使って学習した機械学習モデルは、性能が高く、より高度な能力を持つ(たとえばKaplan et al., 2020やHoffmann et al., 2022を参照)。そのため、機械学習モデルを正確に比較するには、計算資源の使用量を推定し、報告することが欠かせない。
計算資源の使用量は、一般に、システムの最終版を学習させるのに必要な浮動小数点演算回数(FLOP)で測られる。これを推定するには、二つの方法がある。a) アーキテクチャと学習データの量に関する情報を使う方法と、b) 使用したハードウェアと学習時間に関する情報を使う方法である。
以下に、これらの方法を示す二つの計算ツールを用意した。
誤りを見つけた場合や、ハードウェアの仕様について不足している情報を提供したい場合は、こちらのフォームに記入してほしい。確認のうえ対応する。
はじめに
本稿では、AIシステムの学習に使われた計算量を推定する方法を、例を交えて説明する。説明する手順は二つある。一つはネットワークのアーキテクチャと処理した学習バッチの数に基づく方法、もう一つはハードウェアの構成と学習時間に基づく方法である。
本稿は主にAI and Computeに基づいている。その著者らは、この二つの方法を使って、節目となったいくつかのAIシステムの学習計算量を推定した。本稿では、これらの方法をより詳しく説明する。
最終的な目標は、システムの学習に使われた浮動小数点演算回数(FLOP)として推定値を出すことである。ほかの単位もあり、よく使われる二つの単位を下の表で取り上げる。
積和演算(multadd)/ FMA 学習中に行われる乗算と加算の組(multadd)の回数で測る著者もいる。多くの場合、計算の大部分は積和演算が占め、積和演算1回は2 FLOPなので、積和演算の回数を2倍すればFLOPを推定できることが多い。 ややこしいことに、積和演算を1 FLOPと数えるプロファイラもある。積和演算は通常、ハードウェアでは融合積和演算(FMA)という単一の命令として実装されているからである。GPUの仕様のピーク性能の数字は通常FMAを2 FLOPと数えるので1、本稿でもその慣例に従う。 | ペタフロップス・日 もう一つよく使われるのが、ペタフロップス・日で測る方法である。これは、毎秒1ペタFLOPの速度で動くマシンが1日に行える浮動小数点演算の回数、つまり1e20 FLOPに等しい。 機械学習モデルの学習計算量がペタFLOP・日の水準に達したと初めて報告されたのは2016年ごろなので、この単位はそれ以降のモデルを扱うときに適している。 |
方法1:モデル内の演算回数を数える
一つ目の方法はかなり単純で、次のようにまとめられる。
ここで、ops_per_forward_passは順伝播1回の演算回数、ops_per_backward_passは逆伝播1回の演算回数、n_passesは学習中に行われる完全なパス(完全なパスには逆伝播と順伝播の両方が含まれる)の回数である。
n_passesは、エポック数と事例数の積に等しい。
事例数が直接書かれていない場合は、エポックあたりのバッチ数と各バッチの大きさの積 n_examples = n_batches * batch_size として計算できることがある。
ops_per_backward_passとops_per_forward_passの比は比較的安定しているので、これを fp_to_bp_ratio = ops_per_backward_pass / ops_per_forward_pass とまとめると、次の式が得られる。
fp_to_bp_ratioの値は2:1と推定する(下の囲みを参照)。したがって、最終的な式は次のようになる。
この式は経験則である。アーキテクチャや学習の細部によってはずれることがある2。実際には妥当な近似であることが分かっている3。
逆伝播と順伝播の演算回数の比
逆伝播を計算するには、各層について、重みに関する勾配と、誤差を逆伝播させるための、層の入力に関する各ニューロンの誤差勾配を計算する必要がある。これらの演算はどちらも、その層の順伝播の演算回数とほぼ同じ計算量を要する。したがって、fp_to_bp_ratioは約2:1となる。
重みの更新は無視できることが多い。大きなバッチサイズを使い、多数のパスで累積した勾配を使って重みをまとめて更新するのが一般的だからである。CNNのように重みを共有する場合も同様である。
より正確な関係は次の表のとおりである。
最も計算量の多い層 | 重みの更新の計算量 | 逆伝播と順伝播の比 |
最初の層 | バッチサイズが大きい、または計算量の多い畳み込み層がある | 1:1 |
最初の層 | バッチサイズが小さく、かつ計算量の多い畳み込み層がない | 2:1 |
それ以外の層 | バッチサイズが大きい、または計算量の多い畳み込み層がある | |
それ以外の層 | バッチサイズが小さく、かつ計算量の多い畳み込み層がない | 3:1 |
逆伝播と順伝播の演算回数の比について詳しくは、(Hobbhahn and Sevilla, 2021)を参照してほしい。
一般的な層の順伝播の計算量とパラメータ数
残るのは、順伝播1回あたりの演算回数の計算である。著者が親切にも論文でこの情報を示してくれていることもある。しかし多くの場合は示されておらず、アーキテクチャから推定する必要がある。
その助けとして、一般的なニューラルネットワークの層について、パラメータ数と、その層の順伝播に必要な浮動小数点演算回数の推定値を表にまとめた。
多くの層では、順伝播のFLOPがパラメータ数のほぼ2倍に等しいことに注意してほしい。このことから、パラメータ数が分かっていて、パラメータの共有がないことも分かっているなら、演算回数を近似するもう一つの妥当な方法が得られる。逆に、順伝播の演算回数からパラメータ数を推定することもできる。
ただし、この規則には例外が多い。たとえば、CNNはパラメータを共有するのでパラメータ数が少なく、単語埋め込みは演算をまったく行わない。
より正確な経験則は、順伝播の演算回数はモデルの結合の数のおよそ2倍だというものである。これはCNNでも成り立つ。
さらに、アーキテクチャのパラメータ数と順伝播のFLOPを自動的に計算するのに使えるソフトウェアツールもある。こうしたプロファイラの使用については付録Aを参照。
層 | パラメータ数 | 浮動小数点演算回数 | |
|---|---|---|---|
| 個のニューロンから個のニューロンへの全結合層 | + ≈ | + + ≈ | |
重み バイアス 非線形関数 | |||
| 形状のテンソルに、個の形状のフィルタを、ストライドS・パディングPで適用するCNN | + ≈ | + + ≈ | ただし
|
重み バイアス 非線形関数 | |||
| 形状のテンソルに、個の形状のフィルタを、ストライド・パディングで適用する転置CNN | + ≈ | + + ≈ | ただし
|
重み バイアス 非線形関数 | |||
| 大きさの入力を受け取り、大きさの出力を生成する、バイアスベクトル付きのRNN | + ≈ | + + ≈ | |
重み バイアス 非線形関数 | |||
| 大きさの入力を受け取り、大きさの出力を生成する、バイアスベクトル付きの完全ゲート型GRU | + + ≈ | [ + + ] + ≈ | |
更新ゲート リセットゲート 候補 重み バイアス 非線形関数 ゲートの結合 | |||
| 大きさの入力を受け取り、大きさの出力を生成する、バイアスベクトル付きのLSTM | + + + ≈ | [ + + ] + ≈ | |
忘却ゲート 入力ゲート 候補 出力ゲート 重み バイアス 非線形関数 ゲートの結合 | |||
| 語彙数、埋め込み次元の単語埋め込み |
| 0 | |
| 系列長、入力の大きさ、キーの大きさ、出力の大きさの自己注意(セルフアテンション)層 | + + ≈ | + + + + + ≈ | |
クエリ キー 値 アテンション ソフトマックス 出力 | |||
| 系列長、入力の大きさ、キーの大きさ、ヘッド出力の大きさ、出力の大きさ、アテンションヘッド数のマルチヘッドアテンション層 | ( + + )+≈ | ( + + + + L + )+ ≈ | |
クエリ キー 値 アテンション ソフトマックス 出力 マルチアテンション | |||
表1:一般的なニューラルネットワークの層のパラメータ数と演算回数4。
例:CNN-LSTM-FCNモデル
たとえば、次のようなCNN-LSTM-FCNアーキテクチャがあるとする。
- 入力は形状[400x400x5]の画像の系列である。
- 各入力系列の平均の長さは画像20枚である。
- CNNは形状5x5x5のフィルタを16個持ち、ストライド2・パディング2で適用される
- LSTMは多対一の層で、出力ユニットは256個、バイアスベクトルを持つ
- 全結合層の出力ユニットは10個である
- 学習は10エポックで、各エポックは、1バッチ128系列のバッチ100個からなる。

図1:例に挙げた多対一のCNN-LSTM-FCNの図。出典。
この場合、ネットワークのうち再帰的な部分はCNNとLSTMで、全結合層は再帰的でない部分である。
CNNは400*400*5の入力を受け取り、幅と高さが H’=W’=(W−K+2P)/S]+1=[(400−5+2*2+1)/2]=200 で16チャネルの出力を生成する。CNNの順伝播は全体で約 2*H2*W2*C*D/S2 = 2*4004*5*16/22 =1.024e12 FLOP かかる。
入力をLSTMに渡す前に、CNNの出力は200*200*16=640000ユニットの入力に並べ替えられる。すると、LSTMの系列のトークンあたりの演算回数は約 4*2*(N+M)*M=4*2*(640000+256)*256~=4*2*640000*256=1.310e9 FLOP となる。最後に、全結合層は約 2*N*M=2*256*10=5120 FLOP かかる。
ネットワークの再帰的でない部分は再帰的な部分に比べて非常に小さいので、演算回数の合計は次のように近似できる。
training_compute ~= ops_per_forward_pass_recurrent * 3 * n_epochs * n_batches * batch_size * avg_tokens_per_sequence ~= 1.024e12 FLOP * 3 * 10 * 100 * 128 * 20 = 7.86432e+18 FLOP.
アーキテクチャが複雑すぎる場合や、一部の層の詳細が分からない場合は、学習時間と学習に使ったハードウェアから演算回数を推定する方法を使うとよいだろう。これについては次の節で扱う。
例:Transformer
Attention is all you needのTransformerアーキテクチャを見てみよう。

図2:例に挙げたTransformerアーキテクチャの図。出典。
- 入力はトークンの系列で、平均の長さは20、語彙数は30,000である。
- 各トークンは埋め込まれ、大きさ1024のベクトルとして表現される。
- エンコーダ層とデコーダ層はそれぞれ6層ある。
- エンコーダとデコーダの各組には、合計3つのマルチヘッドアテンション(MHA)副層と、2つの全結合(FCN)副層がある。
- 最後に、最終の線形層とソフトマックスがある。
各MHA副層のパラメータは次のとおりである。
- 入力の大きさ W=64
- ヘッド出力の大きさ N=64
- キーの大きさ D=64
- ヘッド数 H=16
- 最終出力の大きさ M=1024
したがって、MHA副層1つのトークンあたりのFLOPは 2*H*(W*(2*D+N)+L*(D+N)+N*M) = 2*16*(64*(2*64+64)+20*(64+64)+64*1024) ~= 2.6e6 となる。各FCN副層は、入力の大きさ1024、出力の大きさ1024で、4096ユニットの隠れ層を1つ持つ。したがって、各副層のトークンあたりのFLOPは 2*2*N*M = 4 * 1024 * 4096 = 1.7e7 となる。
Add & Norm副層を考慮しないとすると(無視できるほど小さい)、エンコーダ・デコーダのスタック全体のトークンあたりのFLOPは合計 6 * (3 * 2.6e6 + 2 * 1.7e7) ~= 2.5e8 となる。最終の線形層(行列積)のトークンあたりのFLOPは 2 * 1024 * 3e4 = 6.1e7 である。最後のソフトマックスも無視できるので、系列全体の順伝播1回はトークンあたり 2.5e8 + 6.1e7 = 3.1e8 FLOP かかる。
論文によれば、25,000トークンのバッチを使い、300,000ステップ学習させている。したがって、学習のFLOPの合計は 2.5e4 * 3e5 * 3 * 3.1e8 = 6.97e18 FLOP となる。
方法2:GPU時間
順伝播の計算量を詳しく把握する代わりに、報告されている学習時間とGPUの機種の性能を使って学習計算量を推定することもできる。
GPU日は、1基のGPUが学習に使われた日数の累計を表す。学習が5日間続き、合計4基のGPUが使われたなら、20 GPU日になる。
この指標には、使った計算ハードウェアを考慮しないという明らかな欠点がある。現在の20 GPU日は、10年前の20 GPU日より多くのFLOPに相当する5。
この節では、これを補正する方法を見ていく。最終的な推定値は次のようになる。
GPU時間からFLOPを推定する
ステップ1:論文を読む
論文や参考資料から、次の情報を抜き出す。
- GPU日の数
- 使われた計算システム / GPU
- 迷ったら、同じ年の論文で最もよく使われたシステムか、同じ年の計算システムのFLOP/sの幾何平均を使うとよい。
- 学習で使われた数値表現:FP32、FP16、BF16、INT8など
- 迷ったら、既定ではFP32とすることを勧める。ほとんどのフレームワークで既定の選択肢だからである。ただし、近年はFP16が主流になりつつある。
どの数値表現が使われているか
計算ハードウェアの仕様書を調べると、計算性能は通常、FP32、FP32、FP16、bfloat16、int16、int8といった数値表現ごとに分けて示されている。では、どの性能指標を選べばよいのか。
理想的には、学習で使われた数値表現が論文に書かれている。そうでなければ、次の二つの経験則に頼ることを勧める。
1. モデルはいつ学習されたのか
学習された年と使われたフレームワークによっては、フレームワークが、より優れたFP16を使って学習処理を最適化してくれていたかもしれない。2020年半ば以降、PyTorchは対応するハードウェアでこれを自動的に行う。
2019年より前の研究でFP16が使われることはまれなので、既定ではFP32とすることを勧める。
2. 誰がモデルを学習させたのか、モデルはどれくらい大きいのか
大きなモデルの学習にはより多くの計算資源が必要で、コストも高くなる。そのため、運用を最適化する動機が生まれる。しかし、この最適化は簡単ではない。コストの高さと最適化の難しさから、大きなモデルは通常、企業から生まれてきた。企業には運用を支援できる専任の機械学習エンジニアがいる。
したがって、企業による大きなモデルについては、既定で計算性能が最も高い数値表現(FP16またはbfloat16)を使うことにする。
あくまで個人的な聞き取りだが、何人かの博士課程の学生に尋ねたところ、ほとんどは学習の最適化を積極的には試みていなかった。答えはおおむね「学習ボタンを押して待つだけ」というものだった。したがって、学習に使われたフレームワークの既定の設定(バージョン、つまり発表年によって異なる)を参照することを勧める。
NVIDIAのテンソルコア
NVIDIAは仕様書にテンソルコアの性能を記載していることが多い。テンソルコアの性能は通常、FP16の計算で、高度に並列化されたアーキテクチャを最大限に活用した場合を指す。
しかし、これには多くの場合、特定のアーキテクチャ上の特徴やハイパーパラメータの特別な選び方が必要になる。たとえば、特定のテンソルの次元が8の倍数であることなどである。
アーキテクチャがこの条件に合っていることはまれだと考えられるので、既定ではおそらくやはり通常のFP16の計算性能を使うか、利用率の係数を下げることにする。
ステップ2:ハードウェアの仕様を読む
GPUやシステムの計算性能を仕様から抜き出して把握する。Googleでそのシステムを検索し、メーカーの仕様書を開く。
仕様書には通常、数値表現ごとのピーク性能が記載されている(これについては下の利用率の囲みで詳しく述べる)。ほとんどのGPUには、メモリ帯域幅やシステムアーキテクチャの異なる複数の種類がある。一般には、モデルがサーバークラスターで学習されたと仮定して、PCIe版ではなく、たとえばNVLink版を使うことを勧める。
NVIDIA A100の例を示す。

図3:NVIDIA A100 Tensor Core GPUの仕様書。出典。アスタリスクはスパース性を前提とした性能を示す(スパース性は推論実行にしか関係しない)。
使われたハードウェアや、記載されたハードウェアの仕様が見つからない場合は、各年の平均的な計算能力の推定値をまとめた私たちのシートを参照することを勧める。年ごとのピーク性能のグラフも下の囲みにある。
ハードウェアの機種が分からない場合にGPUの性能を補完する
学習に使ったGPUの機種を著者が報告していないことは、思いのほか多い。著者が使っていそうなハードウェアを推測できる手がかりがない場合は(たとえば、GoogleはTPUを使う傾向がある)、欠けているハードウェアの性能値を、その年に発表され、私たちの収録基準を満たす論文で使われたGPUのピーク性能の平均値で補完する。
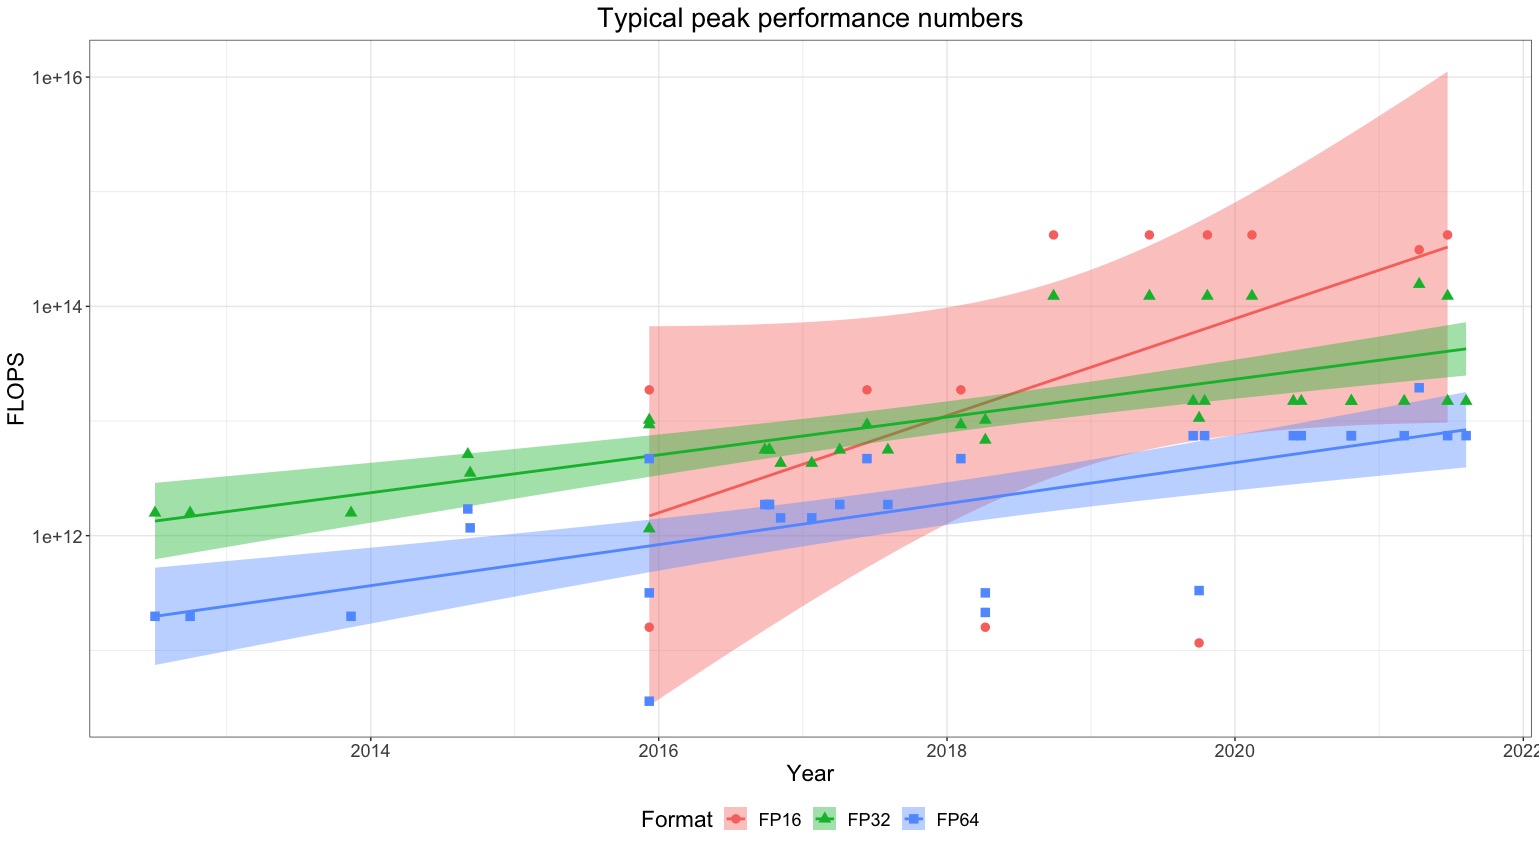
図4:よく使われるハードウェアの典型的なピーク性能の推移。
具体的には、欠けているハードウェアの値を、次の表の値で補完することを勧める。この表は、私たちのデータセットにある35本の論文のハードウェア使用状況の分析に基づいている。
年 | FP64の平均性能(FLOP/s) | FP32の平均性能(FLOP/s) | FP16の平均性能(FLOP/s) |
2012 | 1.98E+11 | 1.58E+12 | na |
2013 | 1.98E+11 | 1.58E+12 | na |
2014 | 9.54E+11 | 3.35E+12 | na |
2015 | 5.08E+11 | 4.96E+12 | 9.43E+12 |
2016 | 2.81E+12 | 6.83E+12 | na |
2017 | 2.26E+12 | 5.82E+12 | 1.87E+13 |
2018 | 2.91E+12 | 9.37E+12 | 1.10E+14 |
2019 | 3.89E+12 | 6.79E+13 | 4.20E+14 |
2020 | 7.45E+12 | 5.81E+13 | 4.20E+14 |
2021 | 1.05E+13 | 6.47E+13 | 3.66E+14 |
元データは私たちのシート(サブシート「PAPERS AND HARDWARE MODELS」)にある。
ステップ3:推定する
論文から抜き出した情報とハードウェアの仕様を使って、学習計算量の推定値を計算できる。
仕様書にはピーク性能が記載されているので、利用率が完全ではない(< 100%)と仮定して補正する必要がある。大規模言語モデルには0.3、その他のネットワークには0.4の利用率を使うことを勧める。
GPUの利用率について
仕様書の性能値は通常、理論上のピーク性能であり、完全な利用と最適に分散された作業負荷を前提としている。これはさまざまな理由で現実的ではない。
- データ量の多い用途では、制約となるのは処理速度ではなくメモリ帯域幅である。その結果、処理速度は利用できる帯域幅によって頭打ちになる。
- 複数のGPUを使う場合、データはネットワークを通じて伝搬し、メモリの異なる階層(ネットワーク接続のように、より遅延の大きいもの)を通らなければならない。
- メモリへのアクセス速度は、処理性能と同じペースでは向上してこなかった。これはプロセッサとメモリの速度差として知られている。その結果、小さなモデル(とくに単一の処理装置のメモリに収まるもの)については、より高い利用率を想定できる。一方、メモリの内容をネットワークを通じて伝搬させる必要がある大きなモデルについては、より低い利用率を想定すべきである。
- すべての作業負荷を最適に並列化して、GPUのさまざまなコアを完全に活用できるわけではない。最適に分散させるには、特定のバッチサイズや層の大きさなどが必要になる。
その結果、とくに複数のGPUを使う設定では、利用率は1よりはるかに低く、たとえば0.3程度になる。しかし、GPU 1基の単純な設定でさえ、利用率が0.75を超えることはまずない。
実際の利用率の推定値のデータ点は次のとおりである。
- さまざまな畳み込みニューラルネットワークを単一のGPUで使った私たちの実験では、30%から75%の利用率が観測された。
- OpenAIは「AI and Compute」で33%の利用率を想定した。複数のGPUを使う構成を想定している。
- NVIDIA、スタンフォード大学、Microsoftの研究者チームは、分散システムで大規模言語モデルを学習させて43%から52%の利用率を達成している。この論文は利用率を最大化しようと積極的に試みている。したがって、2021年より前は、大規模言語モデルを複数のGPUで学習させる設定で0.5を超える利用率を達成するのは難しかったかもしれない。とはいえ、トップクラスの研究所での利用率は急速に向上しているという証拠もある。GSPMDは大規模環境で62%もの利用率を達成したと報告されており、最近GoogleがLaMDAを56.5%の利用率で学習させる際にも使われた。
- EleutherAIのStella Rose Bidermanは、A100 GPUで大規模言語モデルを学習させる場合、0.4程度の利用率は達成可能だろうと述べている。
- 変革的AIのタイムラインに関する報告書の草稿の付録では、「本気で最適化しない」場合には10%の利用率を、実際に最適化を試みる大規模プロジェクトでは、妥当な目安として25%を想定している。これらは主観的な推定値として示されている。
- (Patterson et al, 2021)の図5で、著者らはGPUの使用率を、GPT-3の25%からGShardの39%までと報告している。
利用率を測るには、通常、プロファイラを使う。プロファイラはアーキテクチャにフックを掛け、ネットワークのすべてのFLOPを推定して理論上の推定値を出そうとする。しかし実際には、低レベルの最適化処理によって、学習手順は理論上の設定とは異なるものに変わる。そのため、真のFLOPの値は推定値と異なることがある。
さらに、プロファイラの推定値は非常に不正確になりうることも分かった。数えすぎたり数え漏らしたりしがちで、一部の演算は実装されておらず無視される。プロファイラの推定値は慎重に扱うことを勧める。詳しくはこちらの記事を参照してほしい。
指標と利用率についてのさらなる議論は、Lennartの「Compute Research Questions and Metrics - Transformative AI and Compute [4/4]」を参照してほしい。
例:Image GPT
例として、Image GPTの学習計算量を推定する方法を示す。
ブログ記事には次のように書かれている。
「[..]iGPT-Lは約2500 V100日学習させた[…]」
残念ながら、ブログ記事にも論文にも数値表現についての情報は見当たらない。しかし、このモデルの大きさ、発表時期、作成者(企業)を考慮して、FP16の性能を仮定する。
次に、NVIDIA V100の仕様を調べる必要がある。仕様書はGoogleで検索すれば簡単に見つかる:NVIDIA V100の仕様。

図5:NVIDIA V100 GPUの仕様書(出典)。
仕様書には、このGPUの3つの種類が載っている。NVIDIA NVLinkのシステムインターフェースは通常データセンターで使われるので、モデルを作成したのが企業であると仮定して、既定ではこれを選ぶことを勧める。ただし、性能の差は(私たちの推定に比べれば)かなり小さいので、どの種類を選ぶかはそれほど重要ではない。
テンソルコア(FP16)の性能は125 TFLOPS(TFLOP/s)である。しかし、テンソル性能をフルに活用するには、FP16に加えて、ネットワークアーキテクチャのさまざまな特性が必要になる。詳しくはこちらを参照。利用率を決める際にはこれを考慮すべきである。
既定では30%から40%の利用率を仮定する。しかし、テンソルコアの性能をフルに引き出すには特別な条件が必要なので、30%を選ぶ。
GPU時間から計算量を推定する例をさらに知りたい場合は、ブログ記事AI and Computeの付録を参照してほしい。
結論
本稿では、ニューラルネットワークモデルの学習計算量をFLOPで推定する二つの方法を説明した。一つは順伝播の演算回数を数える方法、もう一つはGPU時間に基づく方法である。
一般には、可能であれば一つ目の方法を既定とすることを勧める。GPUの利用率は推定しにくいので、こちらのほうが正確だからである。理想的には、両方の方法で推定して比べ、妥当性を確かめるとよい6。
本稿では、いくつかの新しい知見を示した。
- ニューラルネットワークの順伝播と逆伝播の演算回数の比の精密な推定
- 再帰性が計算量の推定にどう影響するかの分析
- 一般的なニューラルネットワークの層のパラメータ数と順伝播のFLOPの表
- よく共有される指標であるGPU日から学習計算量のFLOPを推定する方法
- 各年のGPU 1基の平均的な計算能力についての、現時点での最善の推定値の共有
本稿が、スケーリング則を学び始める読者の助けとなり、学習計算量の推定を標準化するための参考資料となることを願っている。
謝辞
計算量とGPUの利用率の推定に関する質問に答えてくださったSylvain Viguier、Sasha Luccioni、Matthew Carrigan、Danny Hernandez、Girish Sastry、Stella Rose Bidermanに感謝する。
Jean-Stanislas DenainはGPUに関するデータの収集を手伝ってくれた。
本レポートにコメントをくださったGwern BranwenとJojo Leeに感謝する。
本レポートの小さな誤りを見つけてくださったAngelina Liに感謝する。
参考文献
- Alammar, Jay. 2018. “The Illustrated Transformer.” 2018年6月27日.https://jalammar.github.io/illustrated-transformer/.
- Amodei, Dario, and Danny Hernandez. 2018. “AI and Compute.” OpenAI. 2018年5月15日.https://openai.com/blog/ai-and-compute/.
- Chen, Mark, Alec Radford, Rewon Child, Jeff Wu, Heewoo Jun, David Luan, and Ilya Sutskever. n.d. “Generative Pretraining from Pixels,” 13.
- Cotra, Ajeya. 2020. “Draft Report on AI Timelines.” 2020年9月19日.https://www.alignmentforum.org/posts/KrJfoZzpSDpnrv9va/draft-report-on-ai-timelines.
- Dumoulin, Vincent, and Francesco Visin. 2018. “A Guide to Convolution Arithmetic for Deep Learning.” ArXiv:1603.07285 [Cs, Stat], January.http://arxiv.org/abs/1603.07285.
- Narayanan, Deepak, Mohammad Shoeybi, Jared Casper, Patrick LeGresley, Mostofa Patwary, Vijay Anand Korthikanti, Dmitri Vainbrand, et al. 2021. “Efficient Large-Scale Language Model Training on GPU Clusters Using Megatron-LM.” ArXiv:2104.04473 [Cs], August.http://arxiv.org/abs/2104.04473.
- NVIDIA. 2020. “NVIDIA V100 Datasheet.” 2020年1月.https://images.nvidia.com/content/technologies/volta/pdf/volta-v100-datasheet-update-us-1165301-r5.pdf.
- ———. n.d. “NVIDIA A100 | Tensor Core GPU.”
- NVIDIA Documentation. n.d. “Training With Mixed Precision - 4. Optimizing For Tensor Cores.” Concept. Training. 2022年1月19日閲覧.http://docs.nvidia.com/deeplearning/frameworks/mixed-precision-training/index.html.
- Olah, Christopher. 2015. “Understanding LSTM Networks – Colah’s Blog.” 2015年8月27日.https://colah.github.io/posts/2015-08-Understanding-LSTMs/.
- Patterson, David, Joseph Gonzalez, Quoc Le, Chen Liang, Lluis-Miquel Munguia, Daniel Rothchild, David So, Maud Texier, and Jeff Dean. n.d. “Carbon Emissions and Large Neural Network Training,” 22.
- Phi, Michael. 2020. “Illustrated Guide to LSTM’s and GRU’s: A Step by Step Explanation.” Medium. 2020年6月28日.https://towardsdatascience.com/illustrated-guide-to-lstms-and-gru-s-a-step-by-step-explanation-44e9eb85bf21.
- Salvator, Dave. 2020. “What Is Sparsity in AI Inference and Machine Learning? | NVIDIA Blog.” The Official NVIDIA Blog. 2020年5月14日.https://blogs.nvidia.com/blog/2020/05/14/sparsity-ai-inference/.
- Srivastava, Nitish, Geoffrey Hinton, Alex Krizhevsky, Ilya Sutskever, and Ruslan Salakhutdinov. n.d. “Dropout: A Simple Way to Prevent Neural Networks from Overfitting,” 30.
- TensorFlow Documentation. n.d. “Mixed Precision | TensorFlow Core.” TensorFlow. 2022年1月19日閲覧.https://www.tensorflow.org/guide/mixed_precision.
付録
付録A:プロファイラ
ここで論じた二つの方法に加えて、プロファイラを使うこともできる。プロファイラは、関心のある指標を測定するための分析ツールである。実行されたFLOPの数を測定することは理論的にも技術的にも可能だが、私たちが試したプロファイラ(NVIDIA Nsight、PyTorchのメインパッケージとautograd)は、いずれも学習についての私たちの要件を満たせなかった7。その多くは推論実行のプロファイリングに重点を置いている8。
したがって、(i) 既存のプロファイラはどれも必要な基準を満たしておらず、(ii) すでに発表されたモデルの計算量を入手できるデータから推定する方法が必要なので、本稿の二つの方法を選ぶ。
順伝播だけを測定するプロファイラ、たとえばPyTorchのfvcore、ptflops、pthflopsは、きちんと機能する。問題が生じたのは、順伝播以外のものを測定しようとしたときだけだった。
付録B:二つの方法による推定値の比較
二つの方法の推定値が互いに整合しているかを確かめるため、両方の推定が可能ないくつかのモデルについて、両方の推定値を計算した。結果(下図を参照)から、推定値はおおむね非常に近いことが確認できる(差は最大でも1.7倍である)。

これらの推定の詳細はこちらにある。
付録C:事前学習とアーキテクチャ探索
大規模なデータセットで大きなモデルを事前学習させ、その後、より小さなデータセットでファインチューニングするのは一般的である。同様に、研究者が学習に使う最終的なアーキテクチャを見つけるまでに、システムの複数のバージョンを手作業で学習・調整するのもよくあることである。
事前学習の計算量は、学習計算量の合計の一部として数えることを勧める。
しかし、調整のための実行は数えないことを勧める。
それらも重要ではあるが、再現性の観点から最も重要なのは、最終的なアーキテクチャの事前学習とファインチューニングである。また、実際問題として、適切なアーキテクチャを探す間に以前のバージョンの学習に使われた計算量の情報が報告されることはめったにない。
付録D:再帰型モデル
再帰型モデルでは、再帰の種類によって式がより複雑になる。
再帰ユニットに合わせた調整 | |
 | これは最も簡単な場合である。すべての部分が入力トークンごとに繰り返されるので、n_passesを、学習系列の集合に含まれるトークン数の平均に等しい係数で調整するだけでよい。 n_passes = n_epochs * n_batches * batch_size * avg_tokens_per_sequence training_compute = ops_per_forward_pass * 3.5 * n_epochs * n_examples |
  | この場合は、ネットワークの再帰的な部分と再帰的でない部分を区別する必要がある。 training_compute = ops_per_forward_pass_recurrent * 3.5 * n_epochs * n_batches * batch_size * avg_tokens_per_sequence + ops_per_forward_pass_non_recurrent * 3.5 * n_epochs * n_examples = (ops_per_forward_pass_recurrent * avg_tokens_per_sequence + ops_per_forward_pass_non_recurrent)* 3.5 * n_epochs * n_examples 多くの場合、ネットワークの再帰的な部分と再帰的でない部分のどちらかが演算回数の大半を占める。その場合は、式を適宜近似できる。 たとえば、再帰的でない部分が比較的小さければ、計算量は次のように近似できる。 training_compute ~= ops_per_forward_pass_recurrent * avg_tokens_per_sequence * 3.5 * n_epochs * n_examples |
 | エンコーダ・デコーダのアーキテクチャは、一対多と多対一のアーキテクチャの組み合わせとして扱える。 training_compute = (ops_per_forward_pass_encoder * avg_tokens_per_input + ops_per_forward_pass_decoderavg_tokens_per_output) 3.5 * n_epochs * n_examples |
付録E:ドロップアウト
方法1では、fp_to_bp_ratioを求めるために、順伝播と逆伝播のパラメータあたりのFLOPを数えて学習計算量を求めた。しかし実際には、この値は正則化の手法によって変わる可能性が高い。この節では、とくにドロップアウトの影響を考える。ドロップアウトでは、個々のニューロンの値を確率pで0にする(「ドロップアウトさせる」)。これにより、実質的にパラメータの少ない、間引かれたネットワークが得られる。

[画像の出典: Srivastava et al](a) はドロップアウトのない標準的なニューラルネットワーク、(b) は間引かれたネットワークで、×印のユニットが「ドロップアウト」されている。
明らかに、pの値によっては、これで順伝播のFLOPがかなり大きく減ることがありうる。では、正確にはどれだけ減るのだろうか。標準的なニューラルネットワークでは、順伝播はアフィン変換であり、層あたりのニューロン数が十分に多ければ、計算量の大半は内積が占める。
ここで、記号は通常の意味を持つ(たとえばSrivastava et alを参照)。ドロップアウトを使う場合、ニューロンの値は代わりにベルヌーイ分布から抽出された確率標本となる。
ここではアダマール積(要素ごとの積)を表す。ニューロンの数がパラメータ数に比べて小さいと仮定すれば、最初の二つのステップ(無作為抽出とアダマール積)の寄与は無視でき、パラメータあたりおよそ2 FLOPとなる。
逆伝播では何が起きるだろうか。アーキテクチャは間引かれたネットワークのままで、先ほどの考察がそのまま当てはまる。(先ほどと同じ仮定のもとで)誤差逆伝播ではパラメータあたり5 FLOPかかる。したがって、ドロップアウトを使っても、fp_to_bp_ratioはほぼ同じ2.5という値になると予想される。ただし、標準的なニューラルネットワークに比べて、わずかに上方修正されるかもしれない。
ドロップアウト後もfp_to_bp_ratioが同じであることに加えて、ops_per_forward_passもあまり変わらないことに注意してほしい。これは、ドロップアウトが通常、上の式のように、ドロップアウトさせるニューロンに0を掛けることで実装されているからである(たとえばTensorFlowのドロップアウトの実装を参照)。したがって、ドロップアウトは(ニューロンが本当にネットワークから取り除かれるなら予想されるように)演算回数を減らすのではなく、実際にはわずかに増やす。ただし、その増加はおそらく大きくない。このことから、ドロップアウトが計算量に及ぼす影響はごく小さいと予想すべきである。
推論実行の計算量もほとんど変わらず、増えるとしてもわずかである。一般には、ニューロンの結合に対応する重みに、そのニューロンがドロップアウトされた確率pを掛けることで実装される。これは、標準的なニューラルネットワークと同じだが、テスト時に初期計算がいくらか追加されたものに相当する。追加の計算の数は(ドロップアウトされるニューロンの数に応じて)パラメータ数以下である。

[画像の出典: Srivastava et al] (a) 学習中のドロップアウトの実装。ニューロンは確率pでドロップアウトされる。これは、ドロップアウトされる場合はニューロンの値に0を、そうでない場合は1を掛けることで実装される。 (b) テスト時の同じニューロン。出ていく結合の重みにpが掛けられる。
要するに、L1ノルムを使うといった他の正則化の方法のほうが、学習計算量により大きな影響を及ぼす可能性が高いと思われる。
注
-
NVIDIAは自社のウェブサイトで、「CUDAデバイスの単精度浮動小数点演算のピーク性能は、CUDAコアの数にグラフィックスのクロック周波数を掛け、さらに2を掛けたものとして定義される。2倍になるのは、融合積和演算(FFMA)命令を使って二つの演算を同時に実行できるからである」と述べている。私たちはこの記述を、NVIDIAがFMA=2FLOPという前提を使っているという意味に解釈する。↩
-
付録Eで、ドロップアウトが学習計算量に及ぼす影響を論じる。広く使われているドロップアウトの実装では、順伝播の演算回数にも逆伝播の演算回数にも影響しないことが分かった。↩
-
参考文献:A guide to convolution arithmetic for deep learning、Illustrated Guide to LSTMs and GRUs、Understanding LSTMs、The Illustrated Transformer ↩
-
これは「移動日数」という尺度にたとえられるかもしれない。最終的に関心があるのは距離、つまり量なので、徒歩、馬、自動車といった移動手段に応じて調整することになる。とくに計算ハードウェアについては、長年にわたって計算能力が大幅に向上してきたので、この点は重要である。↩
-
Mariusが記事「ニューラルネットワークのFLOPを実験的に測定するには」で詳しく説明している。順伝播のプロファイリングは比較的容易だが、逆伝播を加えたとたん、ほとんどのプロファイラは誤った推定値を出す。↩
-
推論実行は総計算量、ひいてはコストの大部分(70%〜90% (Patterson et al. 2021))を占めるので、推論実行を最適化するためにプロファイラを使うことへの関心は強い。↩