
ニュースレター
推論モデルによるアルゴリズムの改善を定量化する
原題:Quantifying the algorithmic improvement from reasoning models
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
1年ほど前、OpenAIは世界初の「推論モデル」であるo1を発表した。o1は、その前身とみられるGPT-4oに比べ、問題を解くときに多段階の推論を行うようにより強く最適化されている。そのため、一般的な数学・科学のベンチマークで大幅に高い成績を収めたのは、おそらく驚くにはあたらない。
o1は、GPQA diamond(博士レベルの科学の多肢選択問題)とMATH level 5(高校の数学コンテストの問題)で、GPT-4oをはるかに上回る。1 データはEpoch AIのベンチマーク・ハブによる。
この性能向上は、それだけでもすでに大きな出来事だった。だがもっと重要なのは、それがどのように達成されたかである。この向上は学習計算量を大幅に増やして達成されたわけではなかった。そうではなく、アルゴリズムの大きな革新の副産物だったのである。o1は「推論訓練」の期間を経ており、そこでは思考の連鎖(chain-of-thought)を推論の過程の記録でファインチューニングし、強化学習で最適化した。これによってモデルは、利用者の問いに答える前に、より長い時間「推論」に費やせるようになる。
では、このアルゴリズムの革新の重要性はどうすれば定量化できるだろうか。一つの方法は、その重要性を、仮想的な学習計算量の増加に置き換えて解釈することである。具体的には、事前学習の計算量を増やすとベンチマークの成績が上がるという、経験的に頑健な関係を利用する。この関係を使えば、重要な問いを立てられる。GPT-4oがo1の成績に並ぶには、事前学習の計算量があとどれだけ必要だったか、という問いである。2 私たちはこれを「計算量換算利得」(compute-equivalent gain、CEG)と呼んでいる。これは、アルゴリズムの革新による寄与を定量化する標準的な方法である。
Epoch AI の最新情報を受け取る 購読する
GPQA、MATH、Mock AIMEでは、初期の推論モデルが10倍程度の計算量換算利得をもたらした
このアルゴリズムの改善を定量化するには、何らかのベンチマークでのモデルのスコアのデータセットが必要になる。具体的には、まず特定のモデル系列(OpenAIのGPTシリーズなど)について学習計算量とベンチマークの成績のデータを集める。次に、この事前学習の計算量を成績に対応づけるシグモイド関数を当てはめる。
続いて、一方がもう一方に推論訓練を施した対応版になっているモデルの組を選ぶ(たとえばo1-highはGPT-4oの推論版である)。3 推論モデルの成績をとり、当てはめたシグモイド関数を使って、その成績を出すのに必要な「事前学習の計算量」に相当する量を逆算する。最後に、この学習計算量の換算値を非推論モデルの学習計算量で割って、CEGを求める。
GPQA diamondの場合、この方法で求めると、o1の推論訓練はGPT-4oに対しておよそ9倍のCEGをもたらしたと考えられる。次に、利用できるデータが最も多いベンチマークであるOTIS Mock AIMEとMATH level 5でも同じ手順を繰り返し、さらにOpenAIのほかのもっともらしい推論モデル/非推論モデルの組も調べる。以下では、基準となる非推論モデルをGPT-4oとし、対応する推論モデルをo1-preview、o1-medium、o1-high、o3-highとした場合の推定CEGを示す。
ここで挙げた推論モデル/非推論モデルの組のうち、最も推測の度合いが強いのは、おそらくGPT-4oとo3の組である。たとえば、o3はGPT-4.1をもとにしていた可能性も十分にある。それでも、対応する非推論モデルをGPT-4oとする仮定もありうると考えるので、その場合に示唆されるCEGを示した。なお、Mock AIMEでのo1-highの成績のデータはない。
このほか、ほかのモデル系列でも同じ分析を試みたが、利用できるデータが足りないことがボトルネックになった。Qwen、DeepSeek、Grokといったモデル系列では、よいスケーリング曲線を当てはめられるだけのデータ点がない。4 Llamaのようなほかのモデル系列には推論モデルとはっきり言えるものがなく、Geminiのモデル系列については計算量の推定値がない。
とはいえ、CEGの推定をどうにか引き出せそうなケースがもう一つある。AnthropicのClaudeのモデル系列である。ただし、これにはいくらか行間を読む必要がある。Claude 3.7 Sonnetが、実のところClaude 3.5 Sonnetに推論訓練を施しただけのものだと仮定しなければならないのである。5 この仮定はもっともらしいと私たちは考えている。Anthropicは、「拡張思考」(テスト時スケーリング)を使わないClaude 3.7 Sonnetを「Claude 3.5 Sonnetのアップグレード版」と説明しているからである。
Claude 3.5 Sonnet(2024年10月版)からClaude 3.7 Sonnetに移行したときのCEG。拡張思考を使う場合と使わない場合の両方を示した。拡張思考を使う版にはトークン予算を記しており、たとえば「Claude 3.7 Sonnet (16K thinking)」は出力トークン1万6,000の予算をもつ。
この場合も、GPT-4oとその推論訓練版の場合とおおむね同じようなCEGが得られた。つまり1倍から100倍のあいだで、中心推定値は約10倍である。6 これはかなり大きい。たとえば、少なくともこれらのベンチマークに関しては、TransformerやMixture-of-Expertsのアーキテクチャといった革新よりも大きい可能性がある。また、これまでに事後学習の段階で導入されてきた多くのアルゴリズム上の改良と同程度に見える。ただし、特定のベンチマークにとどまらず、より幅広く適用できるかもしれず、より全般的なパラダイムシフトでもある。
Claudeのモデルからはもう一つ、推論訓練とテスト時スケーリングがそれぞれCEGにどれだけ寄与しているかも推し量れる。拡張思考を使うモデルへの三つの移行それぞれのCEGを、拡張思考を使わないモデルへの移行のCEGで割るのである。7 計算すると、CEGへの寄与は推論訓練とテスト時スケーリングでおおよそ半々になる。上のグラフでは、3.5 Sonnetから3.7 Sonnetへの棒の高さが、ほかの棒のおよそ半分になっていることにあたる。
これらの推定値はどこまで信用できるか
推論モデルによるCEGの大まかな推定値はいくつか得られたが、私たちの方法論にはかなり疑わしい点がいくつかあり、そのせいで推定値を解釈しにくくなっている。
第一に、推論モデルが非推論モデルより成績がよいのは、推論訓練のためだけではなく、テスト時により長く考えるためでもある。したがって、CEGの総量も、学習と拡張思考それぞれの寄与の割合も、どれだけテスト時スケーリングを行ったかによって変わる。実際、出力トークンの予算が大きい3.7 Sonnetの版ほどCEGが大きくなる傾向があり、実際の使用でも平均してより多くのトークンを使う傾向がある。たとえばClaude 3.7 Sonnetは、Claude 3.5 Sonnetの2〜3倍ほどのトークンを出力し、拡張思考を行うと、3.7 Sonnetの出力トークンは推論の量に応じて10〜20倍に増える。
出力トークンの平均数のデータは、Epochのベンチマーク評価の実行結果による。
もう一つの問題は、ほかのアルゴリズムの改善を無視していることである。推論モデルがなくても、事前学習でのアルゴリズムの進歩によって、モデルが一定の成績に達するのに必要な計算量は減っていく。そうなれば、計算量と成績のあいだに当てはめたシグモイド関数も変わる。特に、そのせいで推論によるCEGを過小評価するおそれがある。
これらの問題は、もともとある不確実性をさらに増やすだけである。たとえば、分析に使えるデータが大きく不足しているうえ、手元のデータが汚染されている可能性もある。さらに、推論モデル/非推論モデルの組の解釈にも議論の余地がある。たとえば、Claude 3.7 Sonnetが本当に「Claude 3.5 Sonnetに推論訓練を施しただけのもの」なのかどうか、といった点である。要するに、これらの推定値はきわめて不確かである。それでも、少なくとも一部のベンチマークでは、非常に大きなアルゴリズムの改善があったことを示すかなり強い証拠になっていると私たちは考えている。
一般的なベンチマークの多くで、推論によって成績が向上した
前節では、CEGがベンチマークによってばらつくことを見た。たとえばClaude 3.7 Sonnet (64K thinking)のCEGは、Mock AIMEではGPQA diamondの4倍だった。では、CEGのばらつきは実際にどれほど大きいのだろうか。
少なくとも、推論訓練やテスト時スケーリングの恩恵をほとんど受けていない一部のタスクがあり、そこではCEGが事実上1になると予想すべきだろう。8 たとえばOpenAIは、報じられたところによれば、個人的な文章の執筆や文章の編集では、o1-previewがGPT-4oに比べてほとんど改善しないことを確認している。
しかし、ほとんど恩恵が見られないベンチマークのタスクの割合は、おそらくかなり小さいと私たちは考えている。そのことを確かめるには、Epochのベンチマーク・ハブにあるすべてのベンチマークを調べ、推論モデル/非推論モデルのすべての組の成績を特定すればよい。9 推論モデルと非推論モデルの成績をそれぞれ平均すれば、どのベンチマークが推論の効きやすいものだったかがわかる。
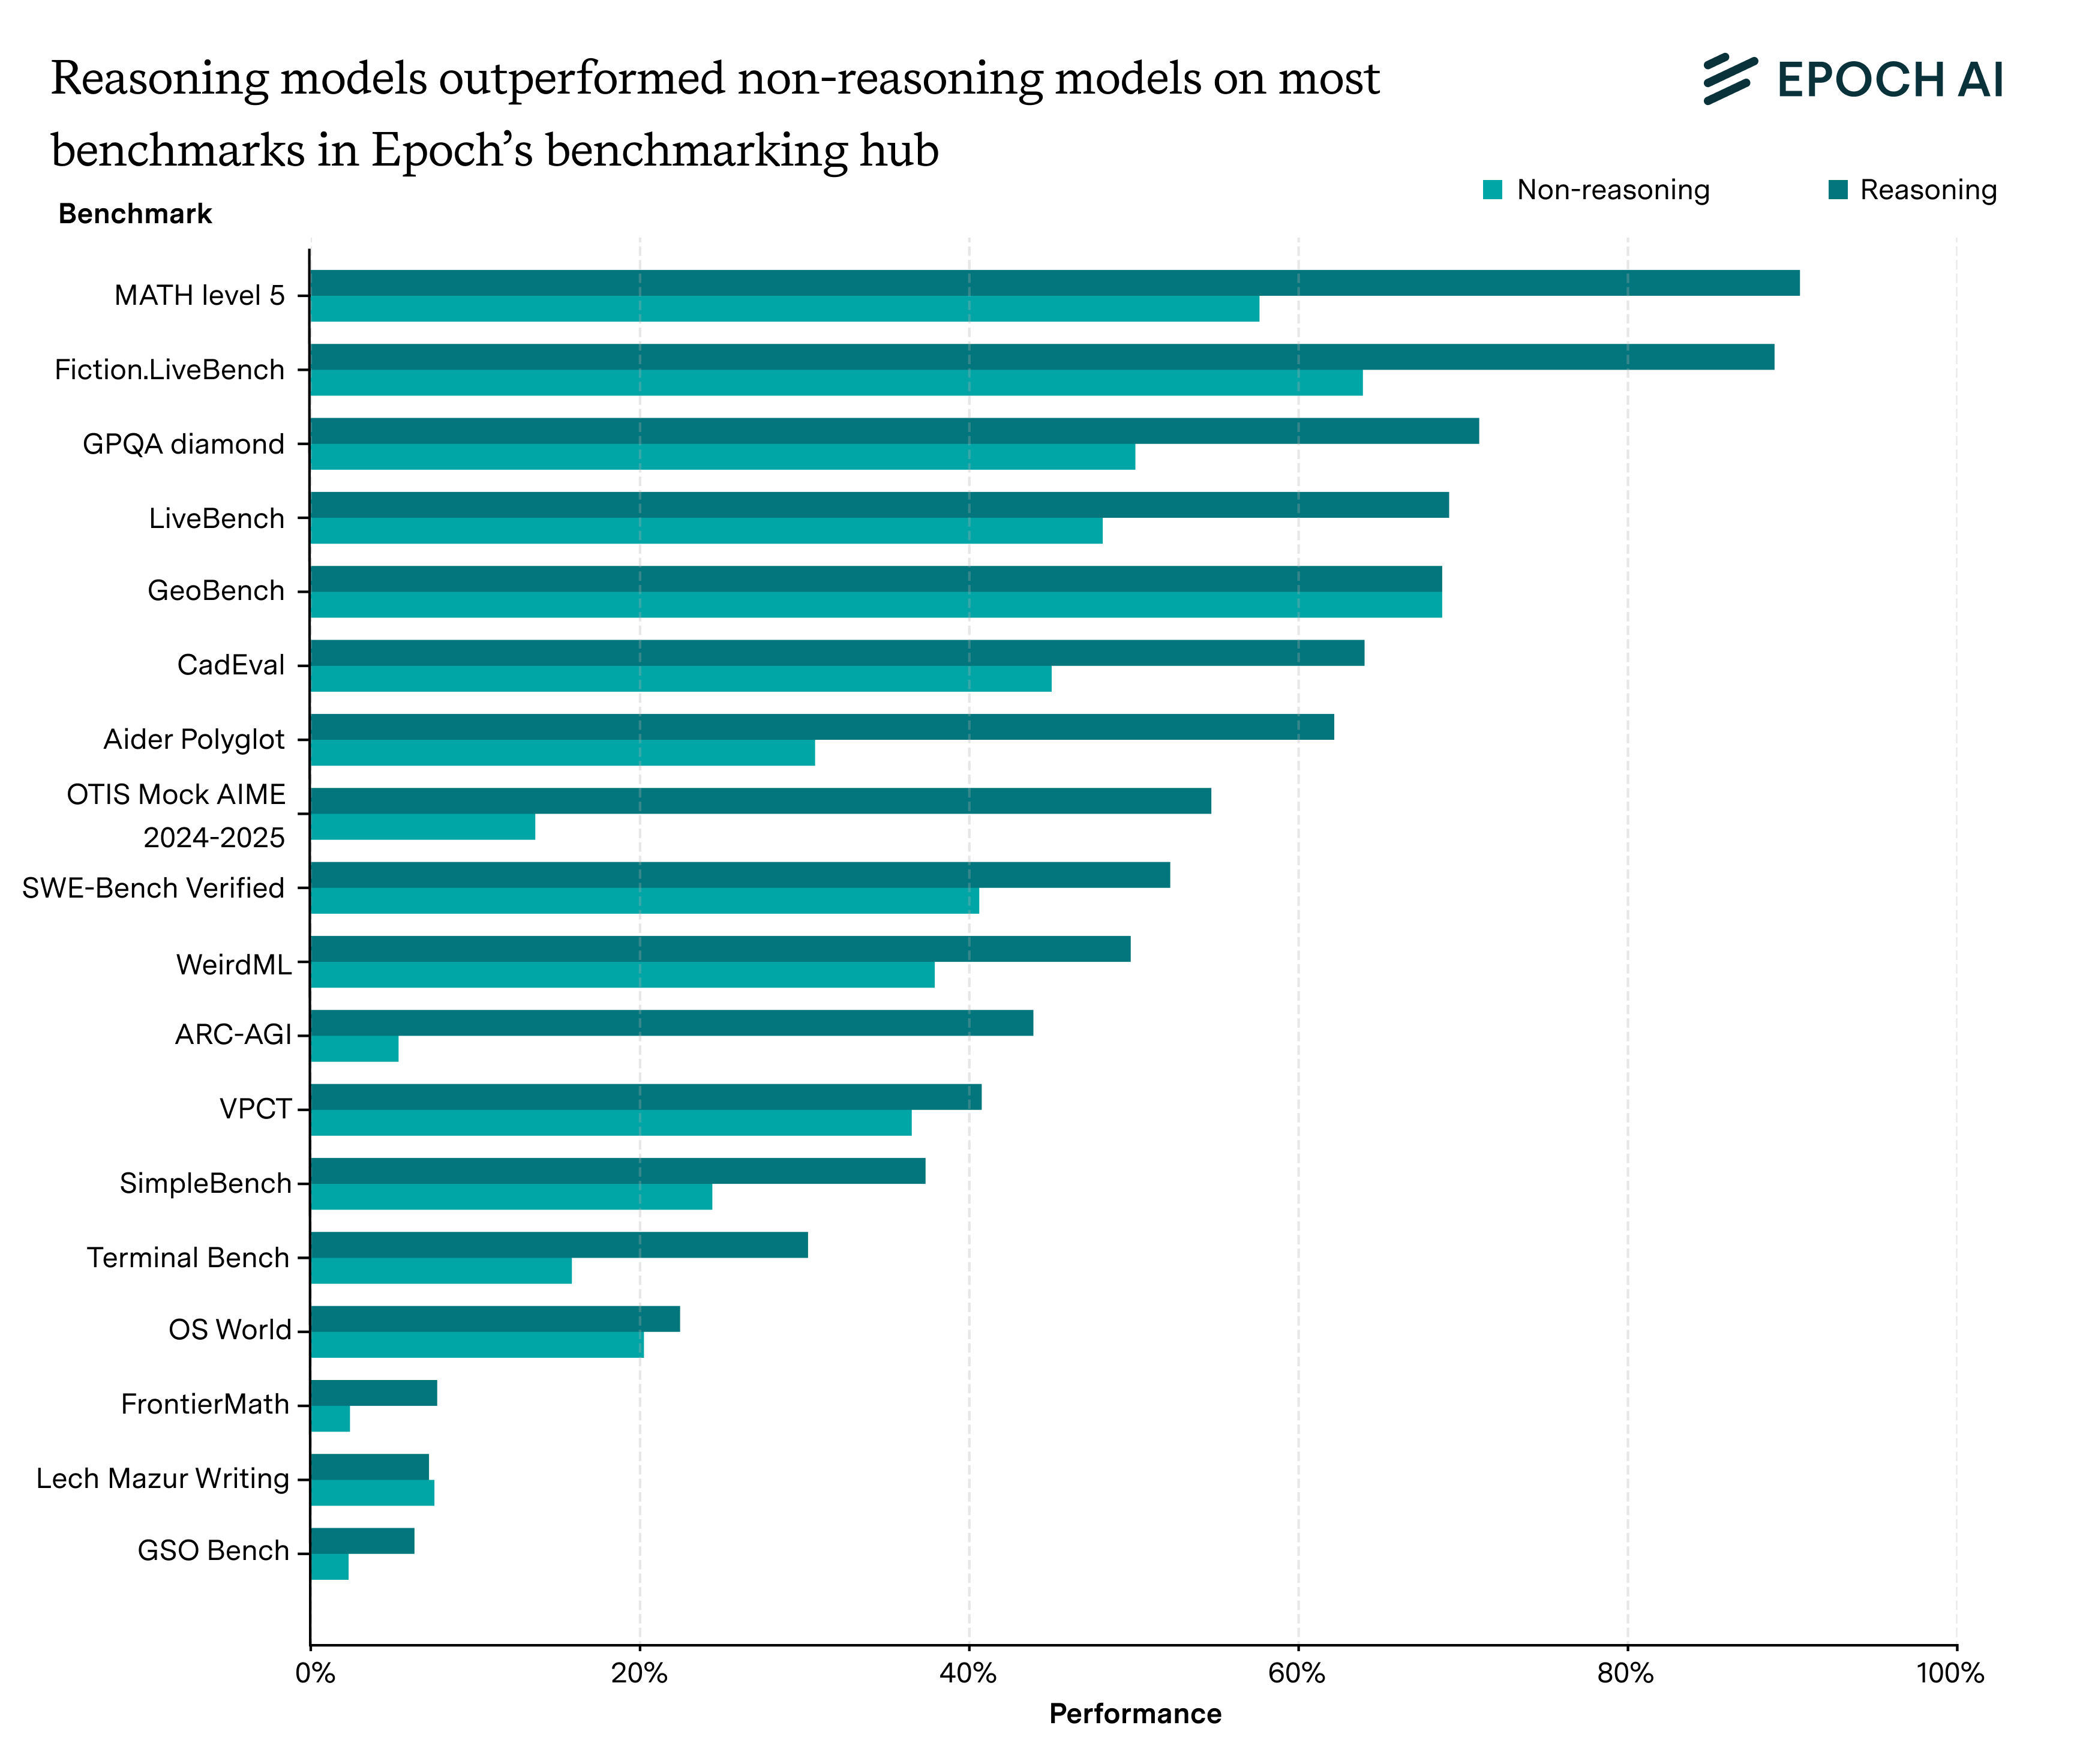
わかったのは、組の成績がそろっているこれらのベンチマークのうち、改善が実質ゼロだったのはかなり小さな割合(約10%)にとどまるということである。10 それ以外のほとんどのケースでは、推論訓練とスケーリングによる総計算コストのわずかな増加で、そのベンチマークの成績が5ポイント超改善した。
推論による改善を考えるもう一つの方法は、推論モデルと非推論モデルの成績の推移を見ることである。Mock AIMEのようなベンチマークでは、非推論モデルの進歩はかなり遅いように見え、推論モデルがそれを大きく上回っている。対照的に、GeoBenchやLech MazurのWritingのようなベンチマークでは、推論による改善はほとんど見られないようである。
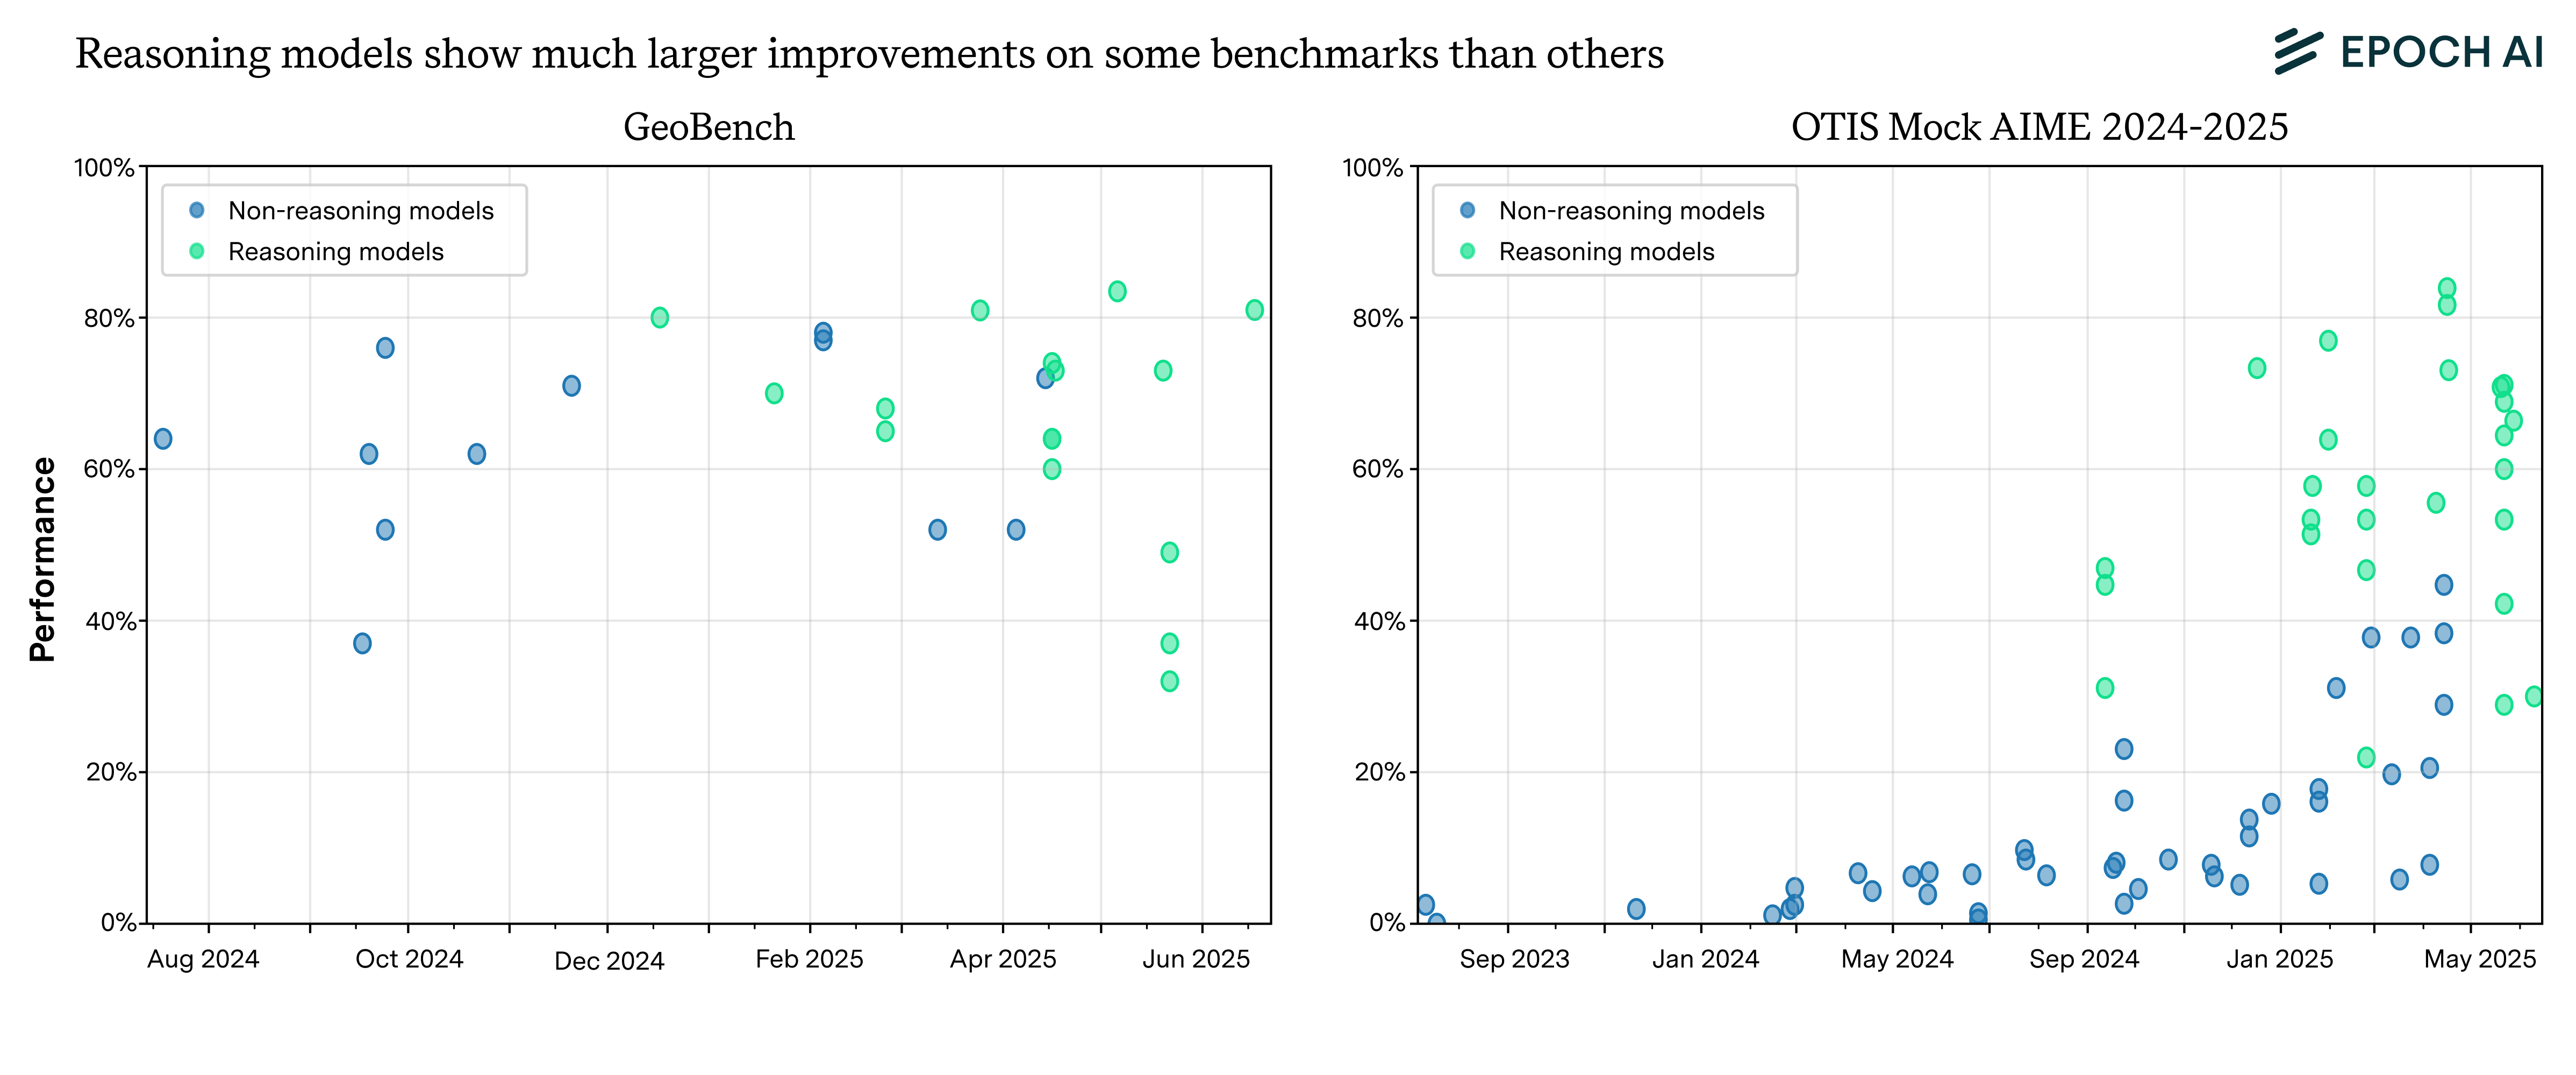
推論モデルは、GeoBenchではほとんど改善していないように見えるが、OTIS Mock AIME 2024-2025では非推論モデルのトレンドを大きく上回っている。
では、これらのベンチマークはMock AIMEと何がそれほど違うのだろうか。考えられる理由の一つは、今のモデルをこうしたベンチマークに向けて最適化するのが難しいことである。Mock AIMEは数学の試験で、モデルの出力をかなりはっきりと検証できる。そのため、改善のための明確な学習シグナルを与えやすい。加えて、AI研究所はおおむね、AIの数学の能力を伸ばすことに多大な労力を注いできた。対照的に、Lech MazurのWritingベンチマークでは、筋が通っていて引き込まれる創作小説を書くことが求められる。これは評価するのも学習させるのも難しそうなタスクである。GeoBenchでは写真が撮られた場所の緯度と経度を当てる。こちらは一つにはマルチモーダルの能力がボトルネックになっているのかもしれず、また数学に比べて最適化の対象にされてこなかった可能性が高い。
だが、この説明が正しいと確信するのは難しい。VPCTのように同じくマルチモーダルの能力が必要なベンチマークでも、推論モデルは平均して目立って成績がよい。AidanBenchは、自由回答形式の創造的な答えを生成する能力を測るが、現在のリーダーボードでは、o1、o3-mini-medium、o3-mini-high、Gemini 2.5 ProがGPT-4.5を上回っている。GPT-4.5は文章力の高さで知られ、おそらくより多くの計算量で学習されているにもかかわらず、である!
個人的には、検証のしやすさとマルチモーダル性をめぐるこうした論点は、方向としてはおそらく正しいと考えている。一般的な言語モデルのベンチマークのほとんどでは何らかの改善が見られるはずだとも考えている。それでも、特定のベンチマークで推論がどれだけ役立つかを前もって言うのは難しい。
汎化とテスト時スケーリングをめぐる大きな未解決の問い
では、これらすべてはAIの進歩にとって何を意味するのだろうか。
それは、推論訓練とスケーリングをさらに進めたときのリターンに大きく左右される。私たち個人としては、このリターンは今後1年もかなり高いままだと考えている。スケーリングの余地はまだあるように見えるし、推論のパラダイムがまだ生まれたばかりであることを考えれば、手の届きやすい成果の多くはまだ摘み取られていない可能性が高い。
それほどはっきりしないのは、こうした手の届きやすい成果のうち、どれだけが異なるタスクへの汎化に関わるかである。私たちが調べたベンチマークのほとんどで推論モデルが非推論モデルを上回っていることから、推論モデルは現実世界の幅広いタスクで大いに役立つと結論づけたくなる。それはもっともらしく思えるが、確信するのは難しい。ベンチマークは、答えが決まっていて検証しやすいタスクで構成されがちだからである。11 その結果、選択バイアスが生じる。こうしたタスクこそ、推論モデルが最も得意とするものなのだ!
それでも、幅広いベンチマークで推論による改善が見られるのは、軽く見てよいことではない。これまでの事後学習による改良のかなりの部分は、多くの場合(常にではないが)狭い範囲のタスクやベンチマークにしか効かなかった。それに比べれば、影響の及ぶ範囲はやはり広い。
しかも、推論が大きな効果をもつタスクの範囲を広げようとする本格的な取り組みが進んでいる。たとえば、国際数学オリンピックをめぐるOpenAIの最近の取り組みでは、検証の難しいタスクで言語モデルを汎用的なやり方で改善する手法が開発された。また、同様の取り組みや手法は、タスクの範囲をさらに広げられることを示す概念実証にすでになっている、と言ってよいかもしれない。
それでも私たちは、推論のリターンは検証しやすいタスクのほうが高いと予想しており、これまで見てきたのもそのとおりの結果である。さらに、数学やプログラミングのような比較的検証しやすいタスクには、今後も多大な労力が注がれ続けるだろう。こうしたタスクでのAIの成功を、私たちは見事だと感じがちだからである。プログラミングの場合は、経済的な価値もある!
したがって、現在の証拠に基づく私たちの今の印象は、少なくとも今後1年は、推論によるアルゴリズム上のリターンが高い状態が続くというものである。推論は現在、かなり幅広いタスクで何らかの恩恵をもたらしているとみられるが、そのリターンは数学やプログラミングのような領域ではるかに大きい。推論の恩恵は広がっていくだろうが、それでも検証がしやすい領域に偏って恩恵をもたらすと私たちは予想している。ただし、その範囲と速さはまだわからない。
注
-
なお、ここでいうGPT-4oは2024年11月版であり、2024年5月版や8月版ではない。後者の二つの版のGPT-4oは、Epochの評価で、GPQA diamondとMATH level 5のどちらでも約49%のスコアだった。 ↩
-
なお、CEGがきわめて大きい場合、それが示す事前学習の計算量は、まったくの架空の想定になってしまうおそれがある。たとえばGrok 4より何桁も大きい最先端の事前学習を本当に支えられるだけの事前学習データは(現時点では)存在しない。合成データを使うこともできるが、そうすればおそらくスケーリングのふるまいは大きく変わる。 ↩
-
ここで取り上げる推論モデルは、非推論モデルより20%未満多い計算量で学習されている可能性が最も高い。 ↩
-
これらのモデル系列にはほかにも問題がある。たとえば、DeepSeek-V3からDeepSeek-R1への移行のCEGは推定しにくい。V3は、DeepSeek-V2.5をもとにしたDeepSeek-R1の一つの版から部分的に蒸留されているからである。さらにDeepSeek-R1には、「推論訓練」には含まれないかもしれない教師ありファインチューニングのような手法も含まれている。たとえCEGを推定できたとしても、こうした問題のために、得られたCEGは解釈しにくくなるだろう。 ↩
-
なお、ここでいうのはClaude 3.5 Sonnetの2024年10月版である。これは、2024年6月の最初のClaude 3.5のリリースと区別するため、非公式に「Claude 3.6」と呼ばれることもある。 ↩
-
興味深いことに、GPTのモデルではCEGがMATHよりMock AIMEで大きいが、Claudeのモデルでは逆になっている。 ↩
-
推論モデルの成績が非推論モデルより悪ければ、CEGは1を下回ることさえある! ↩
-
なお、この図の作成に使ったデータには、まだ公開していないEpochの内部データが含まれている。 ↩
-
もちろん、これは単に選択バイアスの結果かもしれない。ただし、ベンチマーク・ハブに収録するベンチマークは、ふつうAIの進歩にとっての重要性や、経済的影響との関連性を基準に選んでいることに注意してほしい。 ↩
-
言うまでもなく、ベンチマークのタスクは、現実世界のタスクの雑然とした性質を反映していないかもしれない。 ↩