
論文
言語モデルの推論実行の経済学
原題:Inference economics of language models
はじめに
AIモデルの能力が広がり、テスト時の計算資源をスケールさせるという最近のパラダイムが本格化するにつれて、AIの推論実行(インファレンス)への需要は大きく伸びた。OpenAI や Anthropic などの主要なAI企業の推論実行による売上は、年3倍以上のペースで伸びている。しかもその間、両社のモデルは2023年と比べて小さく、安くなり続けている。
数年前、言語モデルが十分に速いかどうかの基準は「人間が読む速さ」だった。利用者に応答するときに毎秒10トークンを生成できれば、それで十分だったのだ。今では、モデルが複雑な問題について長く推論するよう求められ、手の込んだエージェント的なループの中に組み込まれるようになり、この基準は時代遅れになった。推論実行のためにモデルをより速く提供することの利点は、かつてなく大きい。それなのに、言語モデルを大規模に高速で提供するにはどうすればよいか、またトークンあたりの価格を上げる代わりにどれだけ速度を上げられるかを調べた研究はほとんどない。
本日、こうした問いに答える助けとなる、LLMの推論実行の経済学のモデルを公開する。このモデルを使ってみると、大規模な推論実行について、あまり広く知られていない重要な事実が数多く見えてくる。
モデルの仕組み
このモデルの基本的な考え方は、Transformer のフォワードパスにかかる時間を四つの要素に分解することである。
- 演算時間:GPUのコアが実際の加算と乗算の演算を行うのにかかる時間。
- メモリの読み書き時間:高帯域幅メモリ(HBM)からコアに情報を読み込むのに必要な時間。より詳細な手法ならHBMだけでなくメモリ階層全体をモデル化するところだが、ここではそうしていない。
- ネットワークの送受信時間:各GPUが受け取る情報の量を、その受信専用のネットワーク帯域幅で割って計算する。
- レイテンシ:カーネルの起動やGPUの集団通信などの操作で、その大きさに関係なくかかる固定の時間。たとえば、NVIDIA Collective Communication Library(NCCL)の LL128 プロトコルによる all-reduce は、DGX H100 マシン上で、たとえ大きさが1バイトしかないテンソルを集約する場合でも、30マイクロ秒の基本レイテンシがある。
Transformer のアーキテクチャと、その推論実行を複数のGPUにまたがって並列化する構成が決まっていて、過去のコンテキスト長とバッチサイズも分かっていれば、この分解を使って、特定の入力に対するフォワードパスをどれだけ速く行えるかを計算できる。ただし、四つの要素を単純に足し合わせればよいわけではない。たとえばメモリの読み書き時間は演算時間と重ねられるからだ。そこで、どの要素をどの要素と重ねられるかについて妥当な仮定を置いて、最終的な答えを出す。
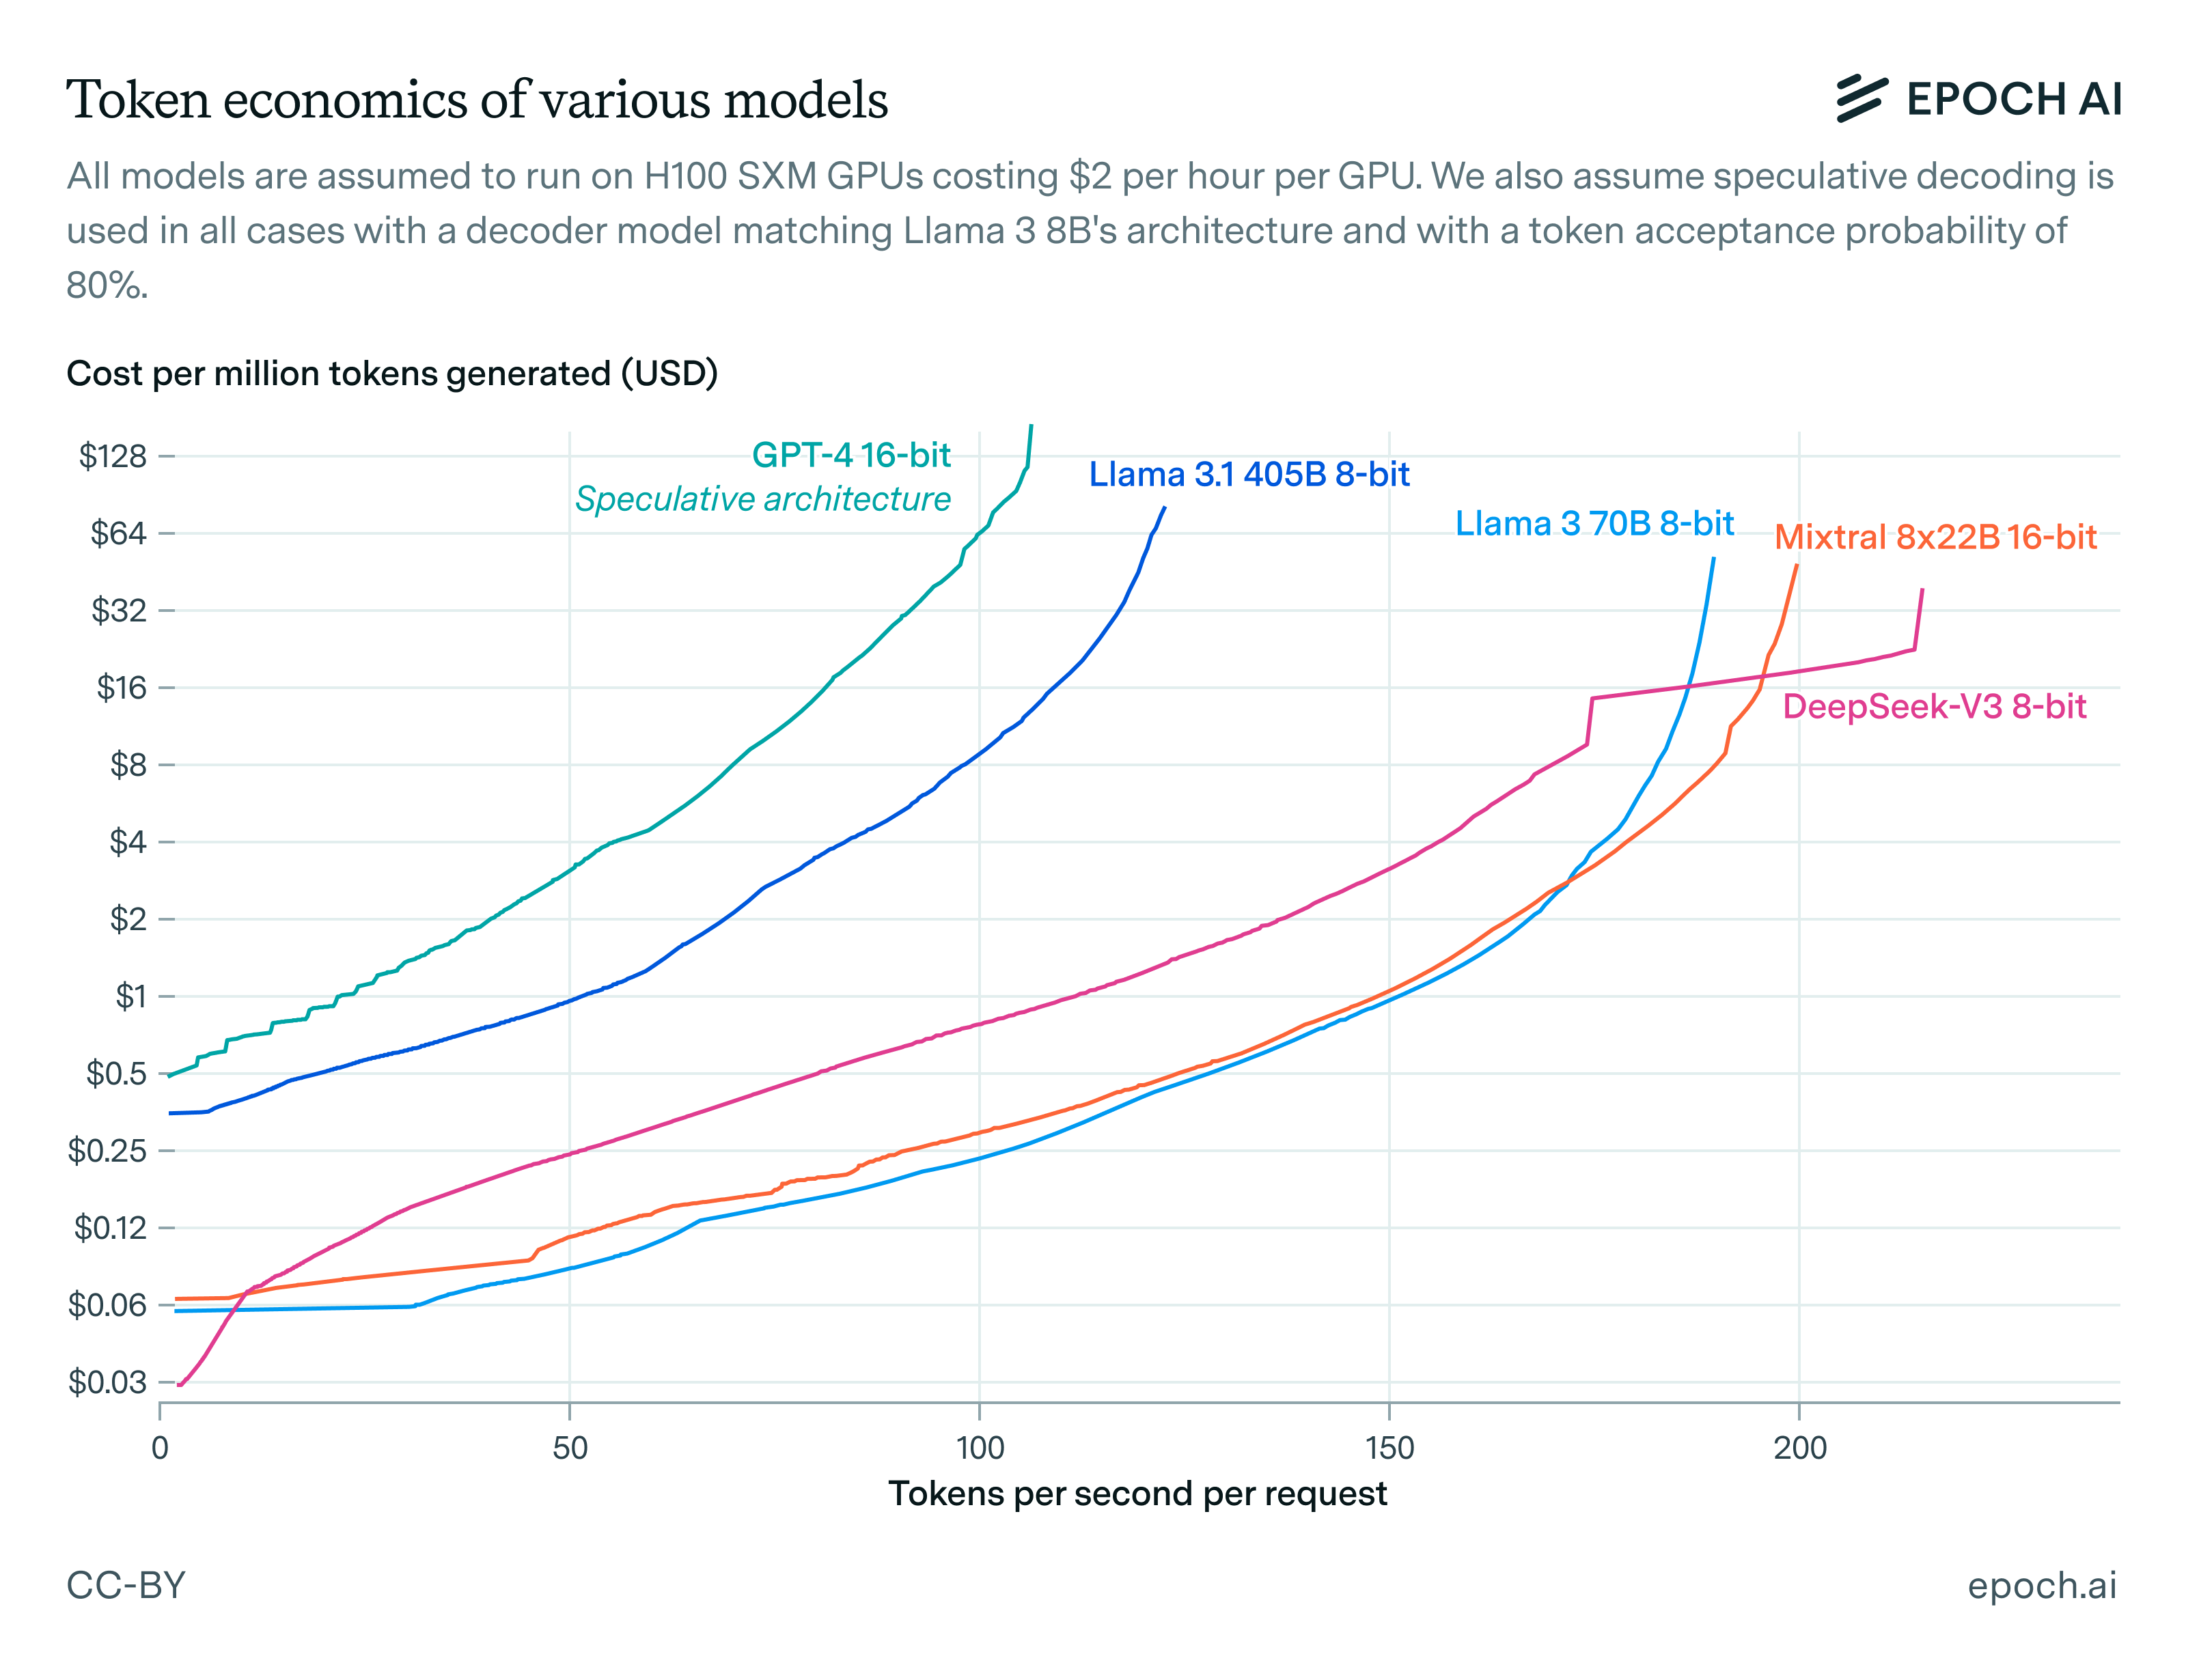
次に、あるモデルのアーキテクチャについて、ありうる推論実行の構成をすべて格子探索し、一定のコストで最高の速度が出る構成、あるいは同じことだが一定の速度で最低のコストになる構成を突き止める。これらの点をすべて結ぶと、推論実行のためにモデルを提供するとき、速度とコストを最適にトレードオフする方法が分かる。言い換えれば、推論実行の経済学のパレートフロンティアが得られる。
モデルから分かること
ネットワークのレイテンシは、LLMの高速な推論実行にとって決定的なボトルネックである。ネットワークの帯域幅の限界のほうがよく論じられるが、それが支配的になるのは、10 MBを超えるテンソルに対してGPUの集団通信を使う場合だけである。モデルの次元が1万で活性化が16ビットなら、そのためにはGPUあたりのバッチサイズが500以上でなければならない。高速な推論実行のためにこれほど大きなバッチサイズを使う理由はまったくない。そのため、高速な推論実行でのネットワーク通信の時間を支配するのは、帯域幅ではなくレイテンシである。
もしレイテンシの制約を気にしなくてよいなら、フォワードパスをより多くのGPUに並列化することで、トークンあたりのコストを2倍にするごとに推論実行の速度を4倍にすることを際限なく続けられる。これは以前、Steinhardt (2022) が指摘したとおりである。したがって、LLMが現状よりはるかに速く提供されていない理由を理解するうえでは、実際にはレイテンシの制約が効いているという点が決定的に重要になる。
密な Transformer を推論実行のために提供できるトークン生成速度は、おおよそパラメータ数の平方根に反比例し、モデルの提供に使うGPUのメモリ帯域幅の立方根に比例してスケールする。これらの大まかなスケーリング則は、経験的によく当てはまるように見えるだけでなく、ネットワーク帯域幅は無限だがネットワークのレイテンシはゼロでないと仮定する簡単なモデルからも導ける。厳密とはほど遠いが、推論実行の速度を「桁」の水準で大まかに比べるには役に立つ。
実際には、データ並列化ではなくパイプライン並列化を使う唯一の理由は、大きなモデルをGPUの高帯域幅メモリに収めることである。なぜなら、ある数の段からなるパイプラインがある場合、パイプラインのすべての段を稼働させ続けて空き(バブル)を避けるには、バッチをその数だけの小さな部分に分ける必要があるからだ。そのため、パイプラインの連続する段の間で余計な通信が必要になる分、パイプライン並列化はたいていデータ並列化の劣化版になってしまう。
パイプライン並列化はメモリの制約が効いているときにしか役に立たないので、デコードの速度が遅いときにしか役に立たない。より正確に言えば、GPUの高帯域幅メモリの中身全体を読み出すのにかかる時間よりも速くモデルを提供している場合、パイプライン並列化を使ってモデルを提供するのは一般に非効率になる。H100 の場合、この速度は理論上およそ (80 GB)/(3.3 TB/s) = 24 ms/トークン、つまり毎秒42トークンである。
投機的デコーディングを使えば、コストを増やすことも性能を下げることもなく、大きなモデルでの推論実行の速度を2倍にできる。投機的デコーディングは演算やネットワーク帯域幅のコストには役立たないが、高速なデコードではこれらのコストは制約になっていない。推論実行の速度を制約しているのはむしろメモリ帯域幅とネットワークのレイテンシであり、投機的デコーディングを使って大きなモデルの1回のフォワードパスで多くのトークンを生成すれば、どちらも複数のトークンに分散される。経験的には、その効果は一定のコストでトークン生成速度を2倍にするほど大きくなりうる。
結論
推論モデルやAIエージェントによって、安く速い推論実行がますます重要になっている。それなのに、大規模な言語モデルの推論実行はこれまで不透明な分野であり、信頼できる研究はほとんど発表されてこなかった。この研究が、このテーマについての一般の理解を深め、広く見られる誤解を解く助けになることを願っている。