
ニュースレター
AI進歩の原動力のうち、最も理解されていないもの
原題:The least understood driver of AI progress
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
AIのソフトウェアの進歩は、誰もがなんとなく知ってはいるが、その重要性を本当に理解している人は世界にほんの一握りしかいない、という類いのものだ。これまでのAIをめぐる最も白熱した論争の多くが、この点に大きく左右されていることを考えてみてほしい。DeepSeek は、より少ない学習計算量で、なぜわずか数か月のうちに OpenAI の o1 に追いついたように見えたのか。世界はいつAGIを開発するのか。そして、AI研究を自動化したら、Situational Awareness や AI 2027 が描くように、AIの進歩はとてつもなく加速するのか。
これらの問いにあなたがどういう立場をとっているかは知らない。だが確かに言えるのは、ソフトウェアの進歩を理解せずに、これらについて根拠のある意見をもつことはできないということだ。そこで、知っておくべき最も重要なことを、基礎から始めて現在の研究の最前線まで説明する記事を書くことにした。
主な要点は次のとおりで、記事の各節に一つずつ対応している。
- AIのソフトウェアの進歩とは、同じ水準の能力に達するのに必要な学習計算量を減らすことである。その手段は、より良いアルゴリズムやデータだ。これは一般に(私自身も含めて)「アルゴリズムの進歩」と呼ばれるが、後で見るように、この呼び名はおそらく少し的外れである。
- ほぼすべての証拠が、ソフトウェアの進歩が非常に速いことを示している。同じ能力に達するのに必要な学習計算量は、毎年数分の一に減っている。10分の1以下に減っている可能性さえある。だが、既存の推定値には途方もない不確実性もある。限られた観測データと、疑わしい統計上の仮定に依存しているからだ。こうした仮定の一部を緩めるだけで、推定値によっては1桁近く変わりうる!
- 最近の証拠は、これらの推定値が、私たちが思っていたものを測っていないかもしれないことを示唆している。ソフトウェアの進歩はしばしば、新しいアルゴリズム上の工夫を次々に見つけ、それが積み重なって効率を大幅に高める過程として語られてきた。だが実際には、ソフトウェアの進歩の大半はデータの質の改善によるものかもしれない(だから「アルゴリズムの進歩」は的外れな呼び名かもしれない)。さらに、測定された効率向上の多くは、多数の新しいアルゴリズムの発見ではなく、ほんの一握りの「規模依存」のアルゴリズム上の変更を規模拡大したことから来ているのかもしれない。規模依存の工夫とは、学習計算量の規模が大きいほど効果が大きくなる工夫のことだ。これら二つの効果は、先行研究ではほとんど考慮されていなかった。
- AI研究の自動化が、AIが再帰的に自らを改良する「ソフトウェア知能爆発」につながりうると主張する人もいる。これまでの分析は、それがありうるが不確かであることを示唆している。しかし、こうした分析の一部はソフトウェアの進歩を控えめに見積もりすぎており、それを補正すると爆発はより起こりやすく見える。一方で、これらの分析は規模依存の工夫も無視している。規模依存の工夫は計算資源のボトルネックとなる。学習計算量も同時に拡大しなければ、ソフトウェアの速い進歩は得にくいかもしれず、そうだとすれば爆発は起こりにくくなる。差し引きの効果ははっきりしない。計算資源のボトルネックの議論は示唆に富むが実証的な証拠は心もとなく、自動化されたAI研究者がそれを乗り越えられそうな理由もある。
- AIのソフトウェアの進歩には、まだ大きな未解決問題がある。事後学習での進歩の速さや、計算資源のボトルネックの強さなどだ。これらの問いを前進させるのは難しいだろうが、AIのソフトウェアの進歩はあまりにも重要なので、それでも答えを探る価値はあると思う。
では、詳しく見ていこう。
Epoch AI の最新情報を受け取る 購読する
I. AIのソフトウェアの進歩:手持ちの資源でより多くを成し遂げる
まず、「AIのソフトウェアの進歩」とは何を指すのか。いくつかの例はおそらくご存じだろう。AIの分野がLSTMからTransformerに移行したのはソフトウェアの進歩だった。OpenAI が、ユーザーに応答する前に時間をかけて考える最初の推論モデルを公開したのも、ソフトウェアの進歩だった。話は単純に思える。より良いアルゴリズムとデータ(「ソフトウェア」)があれば、より良いAIシステムを学習できる、ということだ。1 ソフトウェアの進歩には他の種類もある(推論実行の効率化など)が、この記事では主に学習を扱う。
では、「より良い」ソフトウェアとは厳密には何を意味するのか。これまで、この定義はAIのスケーリングという観点からなされてきた。そこでは、学習計算量を増やすことが能力を高める主な手段である。そのうえで、ソフトウェアの進歩をこれとの関係で定義する。より良いソフトウェアがあれば、同じ水準の能力に達するのに必要な計算資源が少なくて済む、というわけだ。2
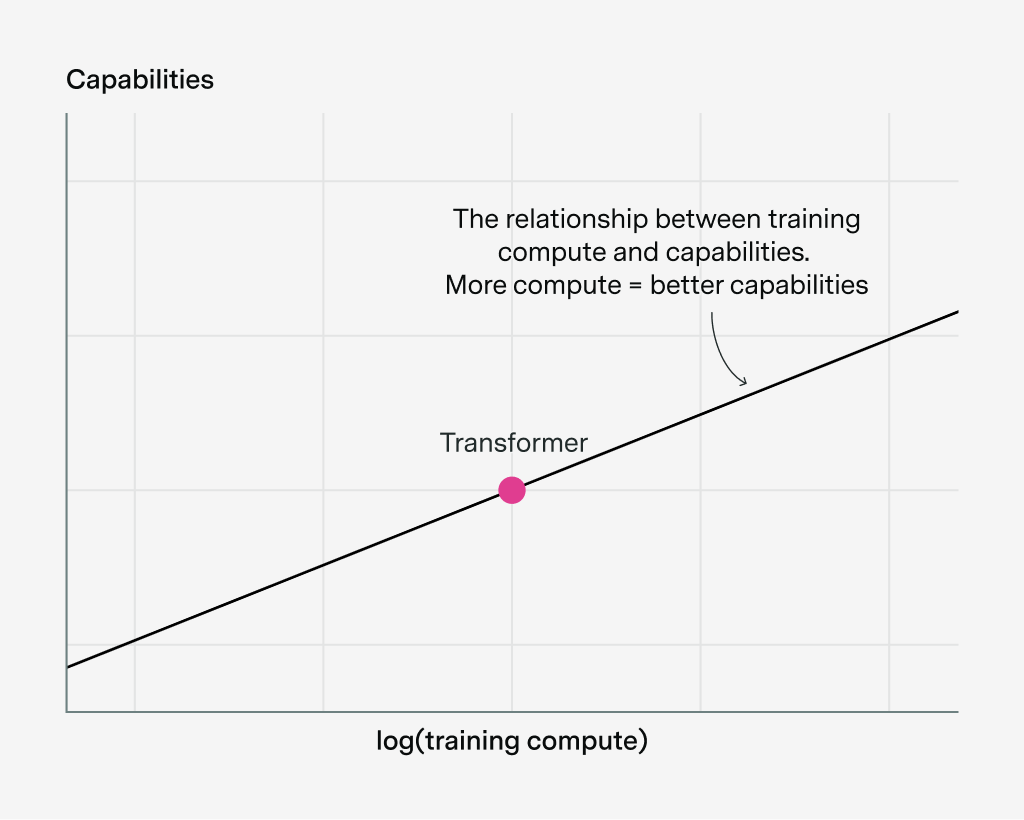
どういうことかを見るために、ある量の計算資源でTransformerを学習するとしよう。下図の赤い点がそれだ。学習計算量を変えていくと、学習計算量と能力の関係が得られ、それを直線として描くことができる。3
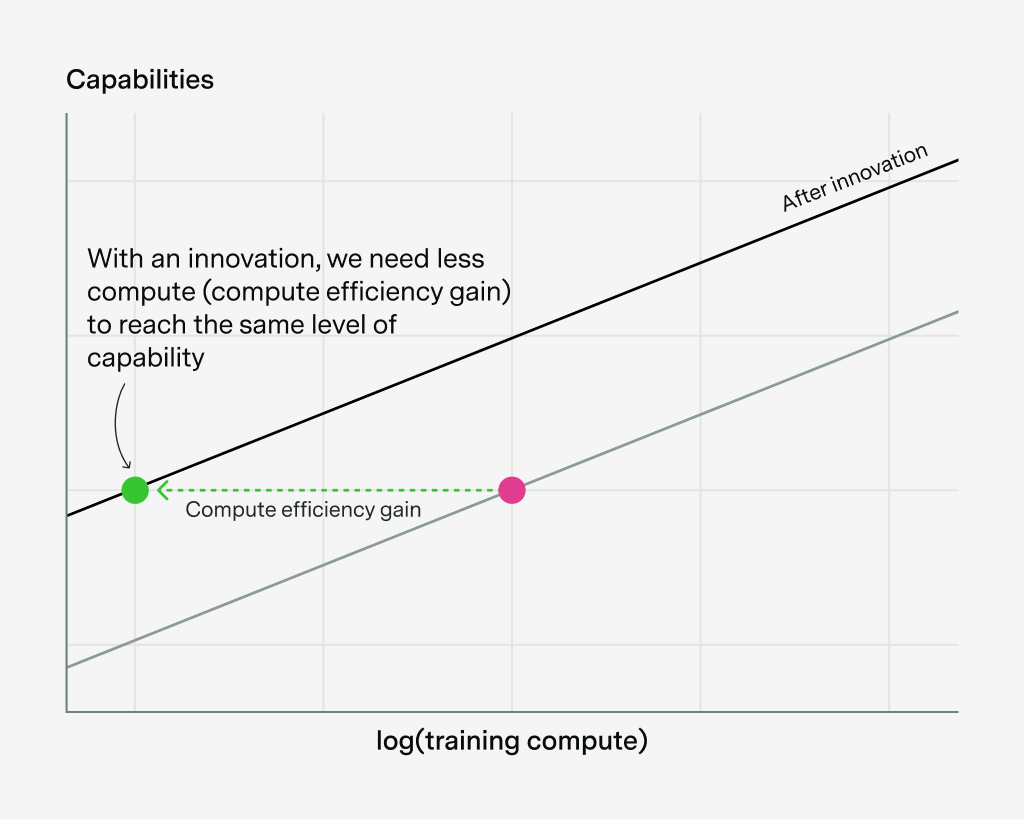
ここで、新しいソフトウェア上の工夫を導入する。たとえば回転位置埋め込み(rotary embeddings)や学習データのフィルタリングだ。このソフトウェアの進歩の定義では、これによってある能力に達するのに必要な学習計算量が減る。そのため、この曲線はある倍率だけ左に移る。それが図の「計算効率の向上」である。
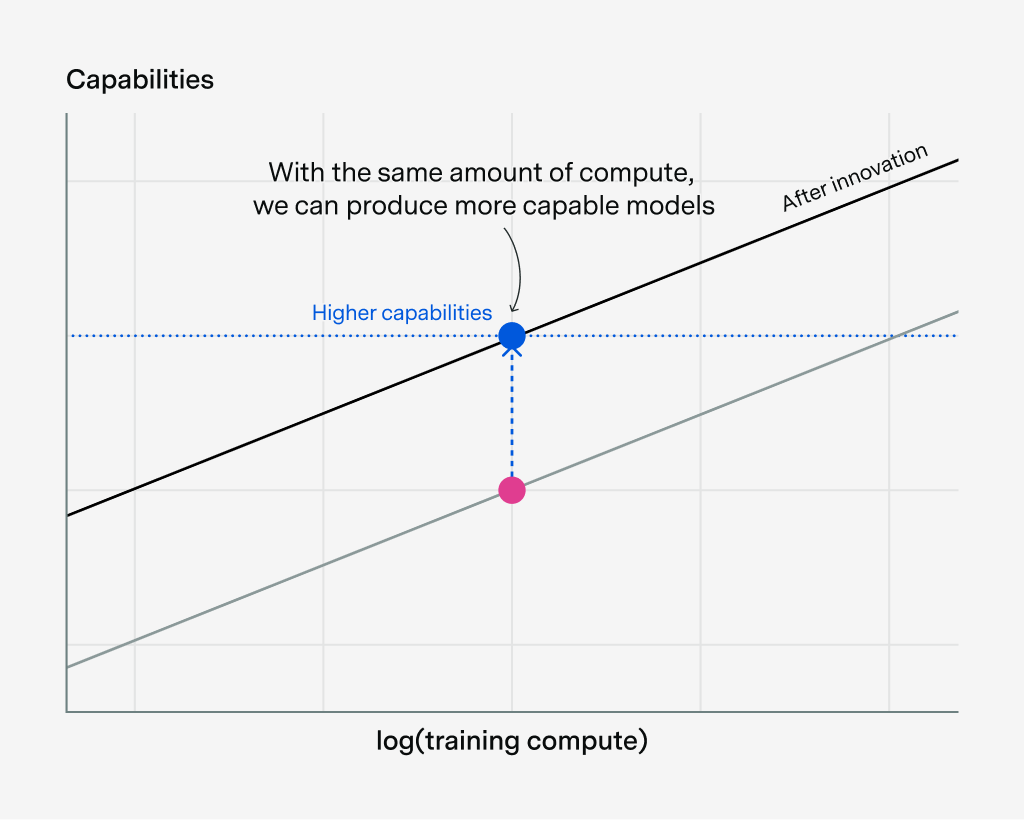
さらに、このアルゴリズムによる移動は、同じ量の計算資源でより多くのことができることも意味する。青い水準の能力に達するのだ。
もし元のTransformerでその青い水準の能力に達しようとしていたなら、「計算効率の向上」の倍率だけ多くの学習計算量が必要だっただろう。
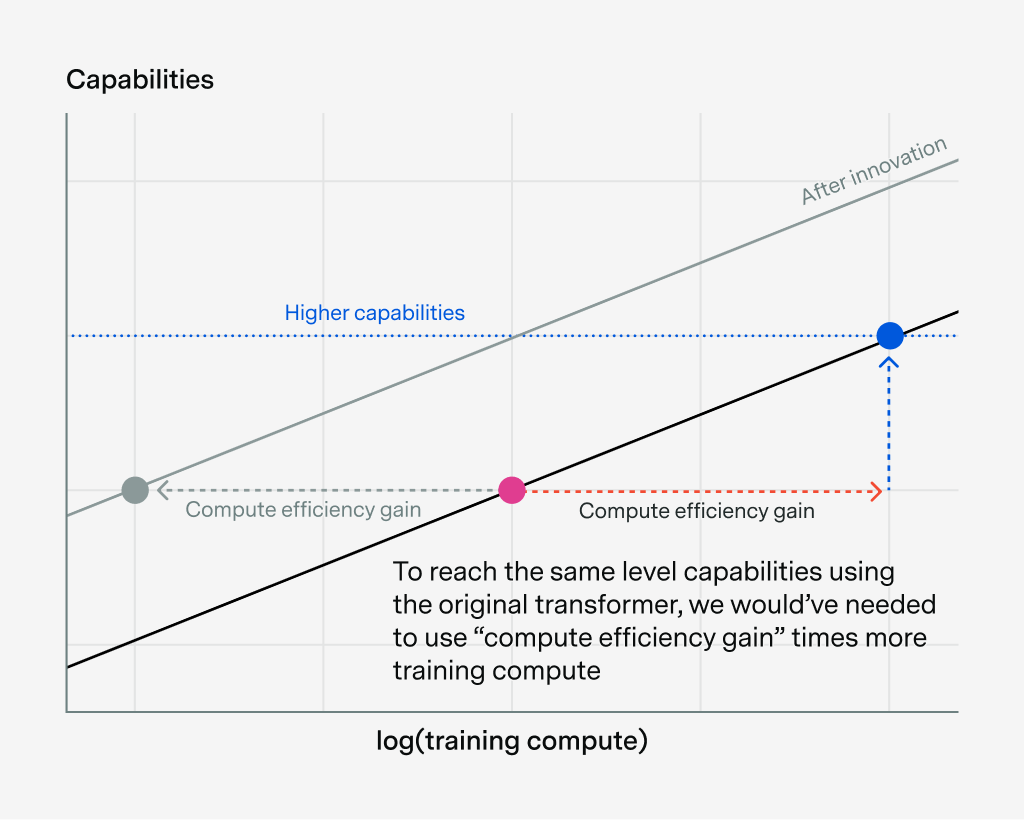
研究者がしばしば「実効計算量」=「計算効率の向上」×学習計算量と定義するのはこのためだ。ソフトウェア上の工夫のおかげで、私たちは実質的により大きな計算資源の予算を手にし、それを使ってより高い水準の能力に達せる。いま手元にある計算資源で、より多くのことができるのである。4
もちろん、この描像は単純化しすぎている。たとえば、直線が平行であると仮定している(これについては後で詳しく述べる)。だが、単純化しすぎているとはいえ、ソフトウェアの進歩を理解することがなぜこれほど重要なのかを明らかにする助けにはなると思う。たとえば、AIのソフトウェアの進歩が本当に速いなら、フロンティアの研究所は、今日のソフトウェアで必要な量よりはるかに少ない計算資源でAGIを構築できるかもしれず、それはAGIがずっと早く構築されることを意味しうる。さらに、こうした工夫を多くの主体が容易に再現できるなら、その含意はもっと広がる。ある研究所がアルゴリズム上の大きなブレークスルーを達成すると、ほどなくして別の研究所が追いつく。フロンティアのLLMが初心者の生物兵器開発を手助けできるほど高性能になると、ほどなくしてその初心者たちは、そうしたLLMを自分で学習できるだけの計算資源を手にするだろう。これを非常に不安に思う人がいるのも無理はない!
だが、こうした含意が実際に成り立つかどうかは数字しだいだ。実際のところ、ソフトウェアの進歩はどれほど速いのか。この理論的な枠組みが正しければ、これは今後数年のAIがどのような姿になるかを考えるうえで、最も重要な問いの一つになりうる。そこで、証拠を見ていこう。
II. AIのソフトウェアの進歩はどれほど速いのか
この問いに答えるため、AIのソフトウェアの進歩の推定値を文献から探した。その一部には私自身も関わっている。5 事前学習の場合、進歩は非常に速く、年に数倍という桁に見える。
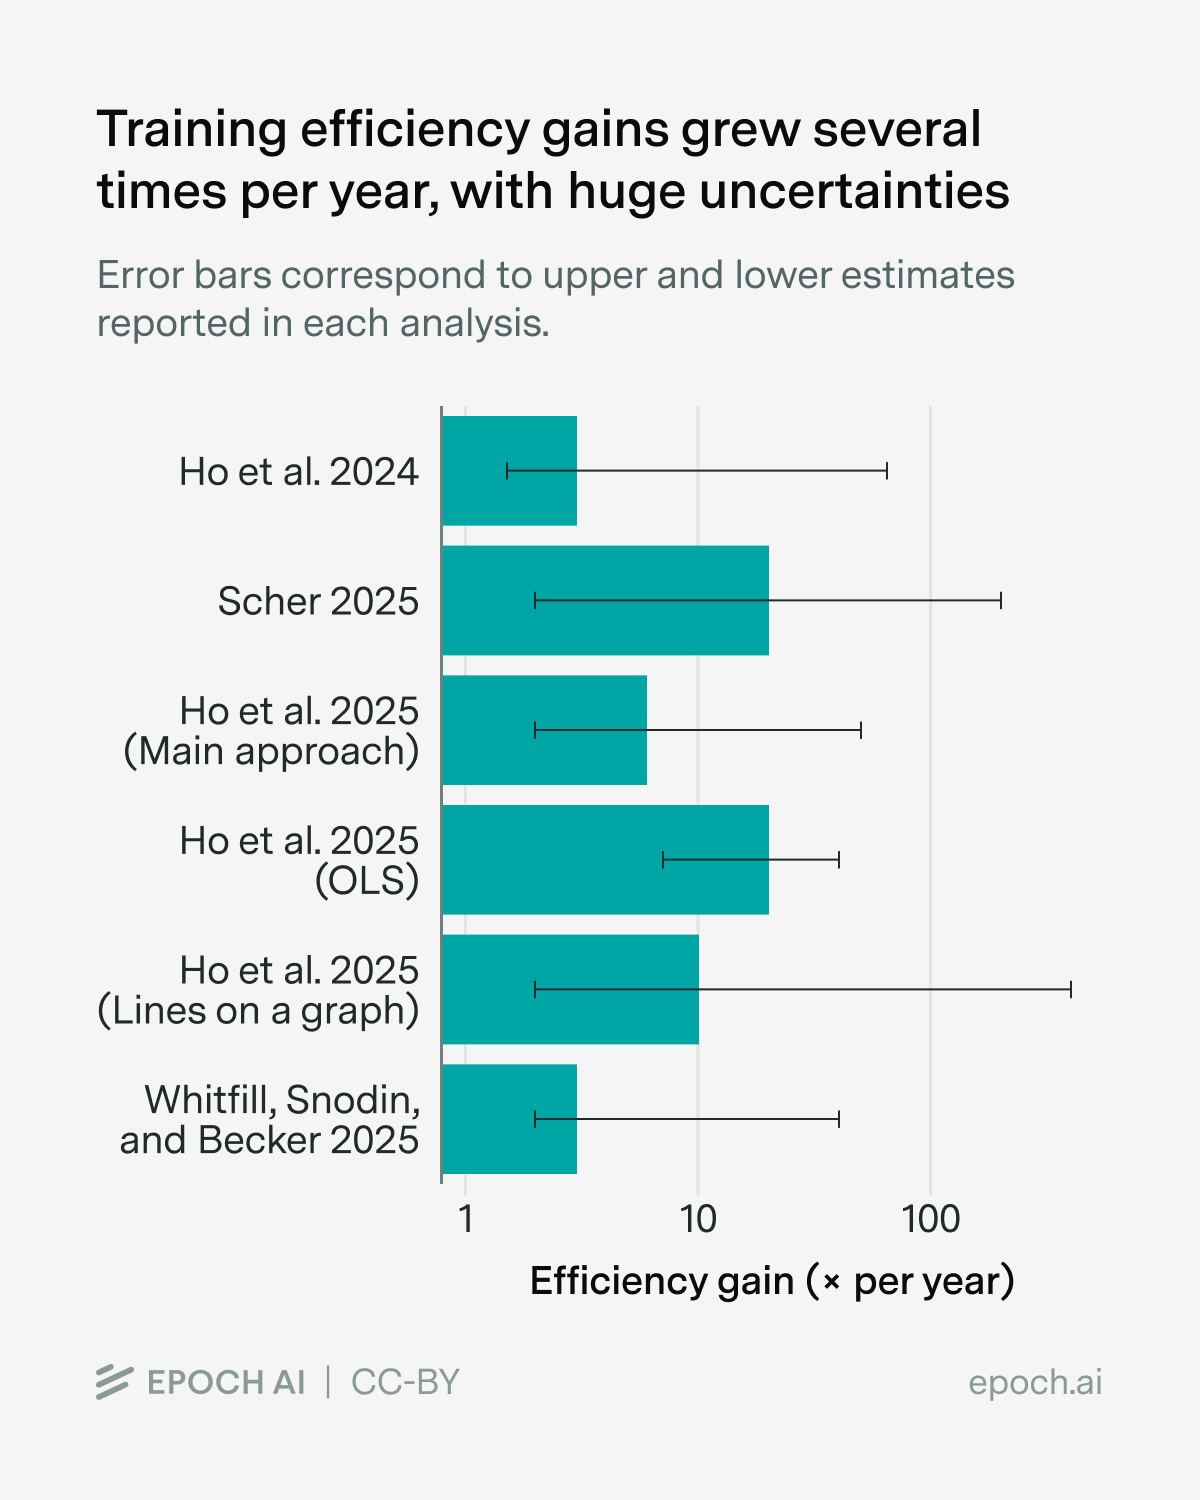
全データと出典は付録に掲載している。
繰り返すが、これは同じ能力に達するのに必要な学習計算量が、毎年数分の一になることを意味する。ものすごく速い! だが、これらの具体的な数字はあまり信用すべきではないと思う。問題だらけだからであり、それは目を凝らさなくても見えてくる。まず、上のグラフの誤差範囲はほとんど滑稽なほど広い。推定値ごとに見ると、年1.1倍程度から年300倍にまで及んでいる! 特定の数字ではなく「年に数倍」と言っているのはこのためだ。推定値の範囲からするとかなりありそうに思えるが、確信を示しすぎたくはない。
なぜこれらの推定値はこれほど不確かなのか。最大の理由は、質の高いデータが世の中に十分にないことだと思う。上のグラフの推定値はすべて観測的な手法にもとづいている。既存のAIモデルのデータセットを作り、そこから推定値を逆算しようとする手法だ。そのためには、データセットの各モデルについて三つの材料が必要になる。(1) 学習計算量の推定値、(2) その「能力」の尺度、(3) いつ公開されたかの記述である。6 だが実際には、学習計算量が分からないことが多い。また、長期間使われ続ける能力の指標を見つけるのも難しい。ベンチマークのようなものはすぐに飽和してしまい、長期的な傾向を捉えられないからだ。そのため、手元に残るデータは望むより少なく、不確実性は望むより大きくなる。7
こうした不確実性は、進歩の速さを推定する方法によってさらに大きくなる。たとえば、私が「グラフに線を引く」手法と呼んでいるものがある。ある能力水準を選び、それをより少ない学習計算量で達成するモデルを時系列で見つけ、必要な計算量がどれほどの速さで減るかを測る手法だ。8 次のような図になる(手法の名前はここから来ている)。
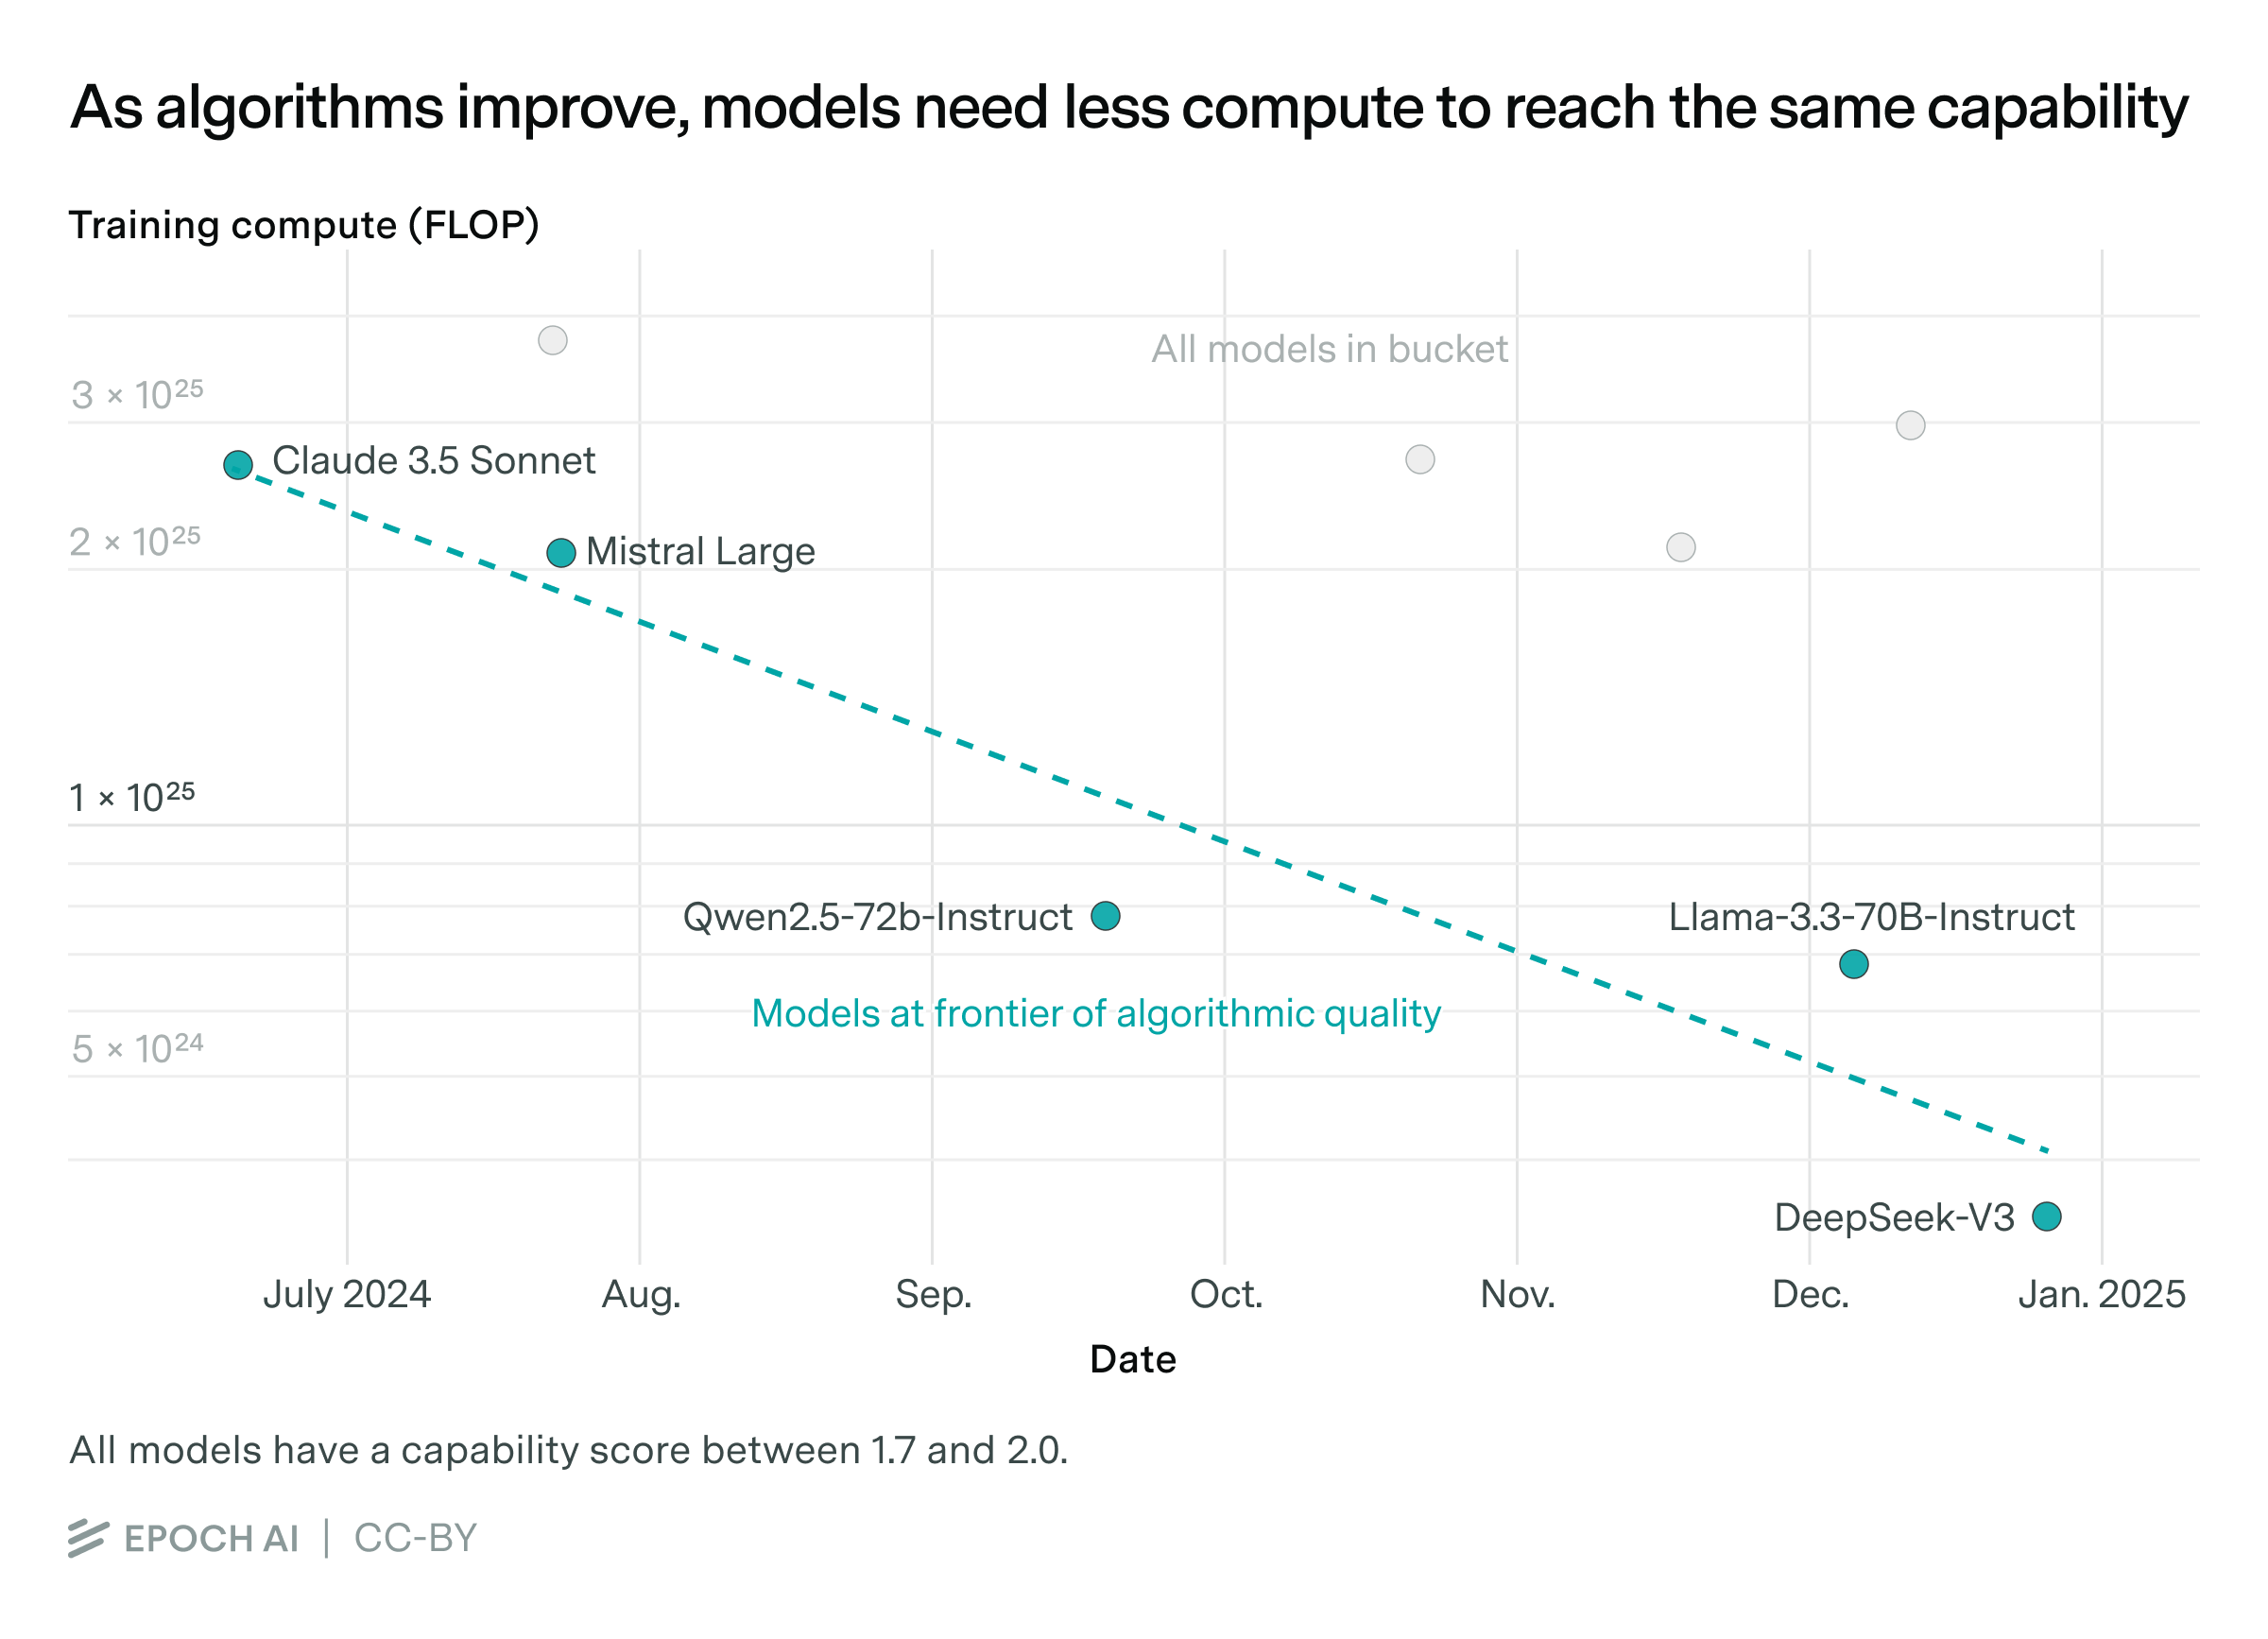
(出典)AIのソフトウェアの進歩の速さを推定する「グラフに線を引く」手法。進歩の速さは直線の傾きで表される。
残念ながら、大きなデータセットがないため、これらの「グラフ上の線」はほんの数個のデータ点で当てはめられており、推定値はかなりばらつく。そのため、ときに年30,000倍や、さらには年といった、ばかげたほど速い推定値が出ることもある!9 こうした例は明らかに疑わしい外れ値として扱い、複数のグラフ上の線にわたる中央値の傾向に注目することはできる。それでも、この手法に対する私の信頼はいくらか揺らぐ。
ソフトウェアの進歩の速さを推定するもう一つの方法を、私は「凝った統計」手法と呼んでいる。計算資源、能力、時間を結びつけるより複雑なモデルを用意し、そのパラメータをデータに当てはめ、そこから推定値を逆算するという考え方だ。主な違いは、この関係がどのような形をしているかをより明示的に定める点にある。「グラフに線を引く」手法はその点についてやや判断を保留している。そのため、仮定した関係が間違っていれば、推定値が狂う可能性がある。
とはいえ、二つの手法の弱点はおおむね共通している。たとえば、私自身の論文の一つでは、ソフトウェアの進歩を、時間だけに依存して指数関数的に伸びるものとしてモデル化した。そうすることで、ある時点の「ソフトウェアの質」がすべての研究所で同じだと暗黙に仮定していた。これは明らかに誤りだ。アルゴリズムやデータが他より優れた研究所もある。Parker Whitfill は、このせいで推定値が大幅に速くも遅くも偏りうると論じた。たとえば、伸び率は私の論文の推定より最大で9倍遅いかもしれないという! 私にとっては残念なことに、これはかなり痛烈な反論になりうる。
こうした不確実性を脇に置いても、これまで示した推定値にはまだ多くの問題がある。たとえば、どの推定値も事後学習でのソフトウェアの改善を十分には捉えていない。10 推論のための事後学習が今やフロンティアモデルで大流行していることを考えると、これはとりわけひどい欠落だ。だが悲しいことに、公開されている事後学習の計算量のデータは、伸びの傾向を確実に割り出せるほど十分にはない。11
最後に挙げる問題は、「能力」をどう測るかに関わる。通常はAIのベンチマークを見るが、モデルは「ベンチマーク最適化(bench maxxing)」によって、現実の用途には汎化しない形でベンチマークの成績だけを上げられてしまう。そのため、こうした指標だけでソフトウェアの進歩を測ると、伸び率を過大に見積もることになる。簡単に測れるものでだけ大きく向上していて、それ以外ではそれほどでもないとしたら? 私の推測では、これによって速い進歩にやや懐疑的になるべきだが、それほど大きくではない。モデルがある程度は汎化しているのを実際に目にしているからだ。これ以上正確に言う方法が分かればよいのだが。12
さて、既存のソフトウェアの進歩の推定値には無数の問題と不確実性があり、その一部はかなり致命的かもしれない。では、どうすればよいのか。これほど的外れである可能性があるのなら、そもそもこれらの数字を信用すべきなのだろうか。
ソフトウェアの進歩が「年に数倍」であるという見方には、それでもかなりの根拠があると思う。一つには、上の推定値は異なる手法にもとづいているのに、どれもこうした速い伸び率がありうることを示唆している。それが単なる偶然とは考えにくい。また、フロンティアのAI企業が報告したコンピュータビジョンの数字とも整合しており、Dario Amodei の見解とも一致する。さらに、具体的な事例を見ることもできる。昨年の一例を挙げよう。これは年2〜5倍の伸び率を示唆している。
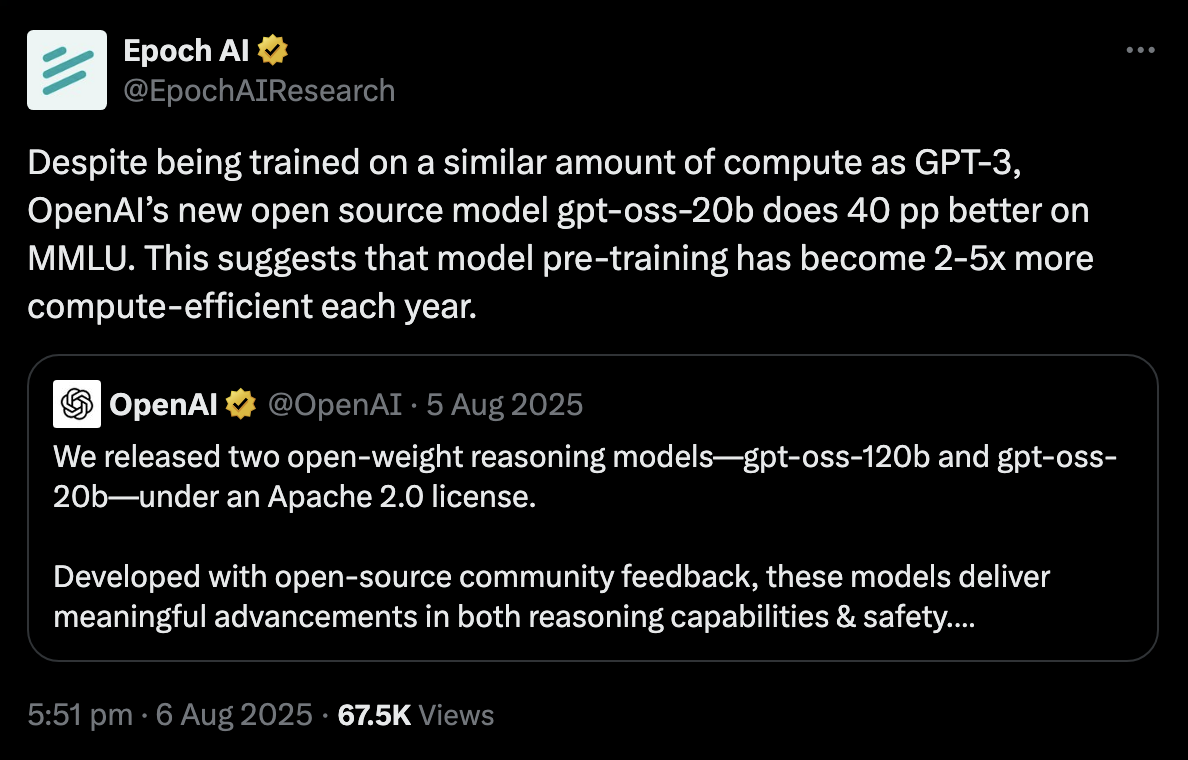
(出典)gpt-oss-20b は、学習計算量は同じなのに、MMLU で GPT-3 を大きく上回る。推論モデルではない GPT モデルについて事前学習の計算量と MMLU の成績の関係を見れば、ここからアルゴリズムの改善の速さを逆算できる。計算すると、およそ年2〜5倍になる。
全体として、証拠はかなりお粗末に見える。そのため、「ソフトウェアの進歩は年3倍だ」といった特定の数字を自信をもって宣言するのは理にかなわないと思う。だが、ソフトウェアの進歩が本当に年に数倍かもしれないと考え、大きな不確実性を添えた最善の推測を示すだけの証拠はあると思う。
そこで、私の最善の推測を示そう。すべての学習計算量(事後学習を含む)を考慮すると、ソフトウェアの進歩はおよそ年10倍であり、80%信用区間はおそらく年2倍から年50倍になる。ただ、繰り返しになるが、これはその日の気分や朝食に何を食べたかで変わりかねない類いの数字だ。
III. ソフトウェアの進歩を推し進めるものは何か(あるいは、いま見た推定値がすべて誤解を招く理由)
もう少し考えてみると、これらの推定値はかなり怪しく見えてくる。モデルのアーキテクチャや学習アルゴリズムは、年10倍といった進歩の速さを正当化できるほど本当に変わったのだろうか。
GPT-2 と DeepSeek-V3 を考えてみよう。この二つのモデルは公開時期がほぼ6年離れており、年10倍なら計算効率に100万倍の差があることになる。これは常軌を逸しているように思える。とりわけ、アルゴリズムの水準ではそれほど違って見えないからだ。たしかに DeepSeek-V3 は混合エキスパート(mixture of experts)モデルで、Attentionの変種や異なる位置エンコーディング方式などを使っている。だが、それで100万倍という差をどう説明するというのか。
もっともらしい要因が二つあり、どちらも重要な役割を果たしていると思う。一つは、こうした改善がより良いアルゴリズムだけから来ているのではなく、その大部分がより良いデータから来ているということだ。私の知るかぎり、この立場を支持する最良の議論は Beren Millidge によるもので、彼はいくつかの証拠を挙げている。
- 私たちは、雑多で整理されていないウェブデータから、高度に処理され、しばしば合成されたデータへと移行してきた。こうしたデータは、モデルに得意になってほしいタスクに強く狙いを定めている。そこには、性能を上げるためにデータをフィルタリングしたり、適切なデータの配合を見つけたりする手法が含まれうる。
- 研究者は、より良い学習データを得るために膨大な労力を注いできた。たとえば Surge AI は昨年8月時点で10億ドルを超える売上高を上げており、Scale AI もおそらく似たような状況だった。付け加えるなら、これは OpenAI と Anthropic がデータ関連の費用に数十億ドルを費やしていることとも合致する。そこには強化学習(RL)環境も含まれる。RL環境は、今やAIの時代精神のまさに一部となっている。
私の考えでは、ここで最も説得力があるのは合成データ(と蒸留)についての点だ。これらは、はるかに少ない学習計算量でモデルが一定の能力に達するのを助けうる手法である。13 私が昨年共著した記事から、分かりやすい例を引こう。
蒸留による効率向上は劇的になりうる。この手法の初期の実証例である DistilBERT は、パラメータを40%減らしつつ教師モデルの能力の97%を保ち、元の BERT モデルの学習に投じられた計算資源のわずか3%しか必要としなかった。
言い換えれば、この例では蒸留によって、能力をほぼ同じに保ちながら学習計算量を30〜40分の1程度に減らすことができた。14 合成データはこれをさらに押し進めうる。Millidge が挙げる好例が Phi シリーズのモデルだ。したがって、こうした向上を積み重ねれば、ソフトウェア効率の何桁もの改善をこれで説明できそうなことが、なんとなく見えてくる。15 だが、私はまだ完全には確信していない。前節で挙げた研究のうちいくつかは、蒸留モデルや合成データを意図的に除外(しようと)しているのに、ばかげたほど速いソフトウェアの進歩を見いだしているからだ。数字のつじつまが合うと、まだ完全には納得できていない。
ここで、超高速のソフトウェアの進歩についての第二の説明に移る。すなわち、ソフトウェアの改善が学習計算量の規模に依存するという説明だ。どういうことかを見るため、先にソフトウェアの進歩を説明するために描いた図に戻ろう。
この図では、ソフトウェアの改善を左への平行移動として描いている。だが、平行でなかったらどうだろう。たとえばこのように、傾きが変わったら?
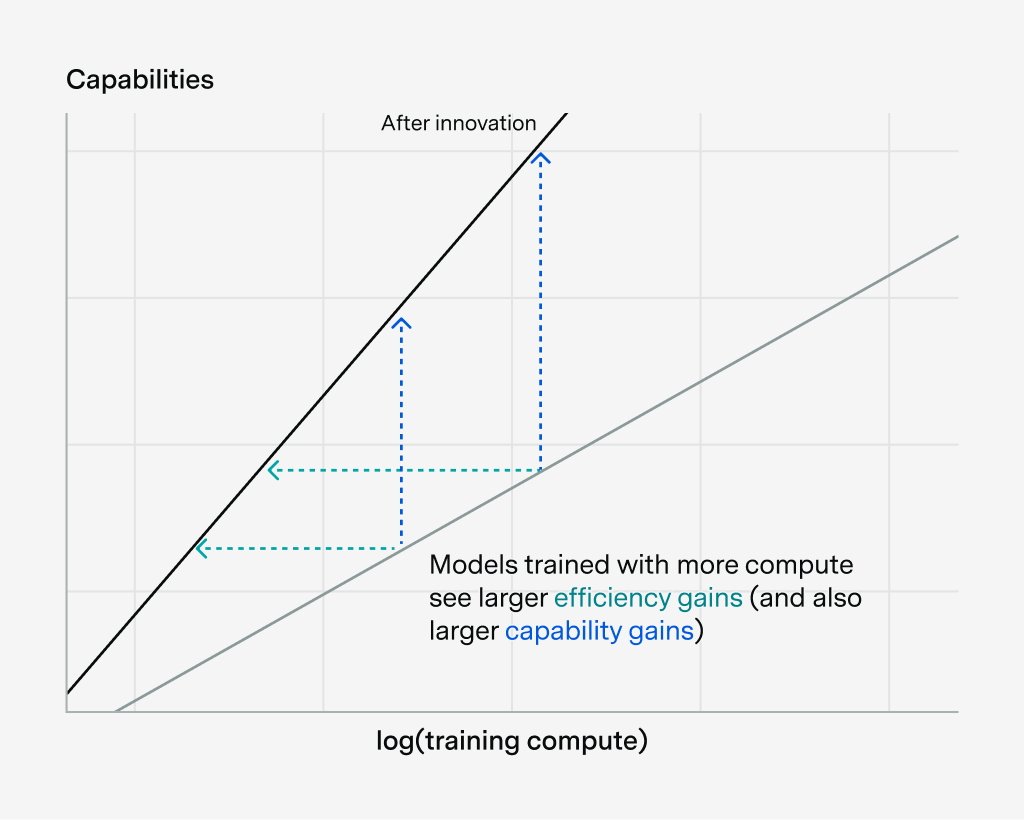
これは、ソフトウェアの進歩が学習計算量の規模にどう依存しうるかを示している。この場合、より多くの計算資源で学習したモデルほど効率の向上が大きい(能力の向上も大きい)。
もちろん、直線の傾きが緩やかになることもありうるし、直線である必要もない。たとえば、log(学習計算量) に対して収穫逓減があるかもしれない。だが重要なのは、計算効率の向上の大きさが規模によって変わりうるという点だ。
では、これでソフトウェアの進歩の非常に速い推定値をどう説明できるのか。考え方はこうだ。ソフトウェアの改善によって直線の傾きが急になったのかもしれない。そして、私たちは学習計算量を拡大してきたので、規模が大きいほど大きくなるこの向上の恩恵を受けている。そのため、ソフトウェアの進歩を測ると、これが急速な効率向上として現れる。
これを最も直接的に裏づける証拠は、論文 On the Origin of Algorithmic Progress in AI である。16 そこから一例を挙げよう。現代的なTransformerアーキテクチャ(紫)と旧式のLSTM(緑)のスケーリングを比べたものだ。
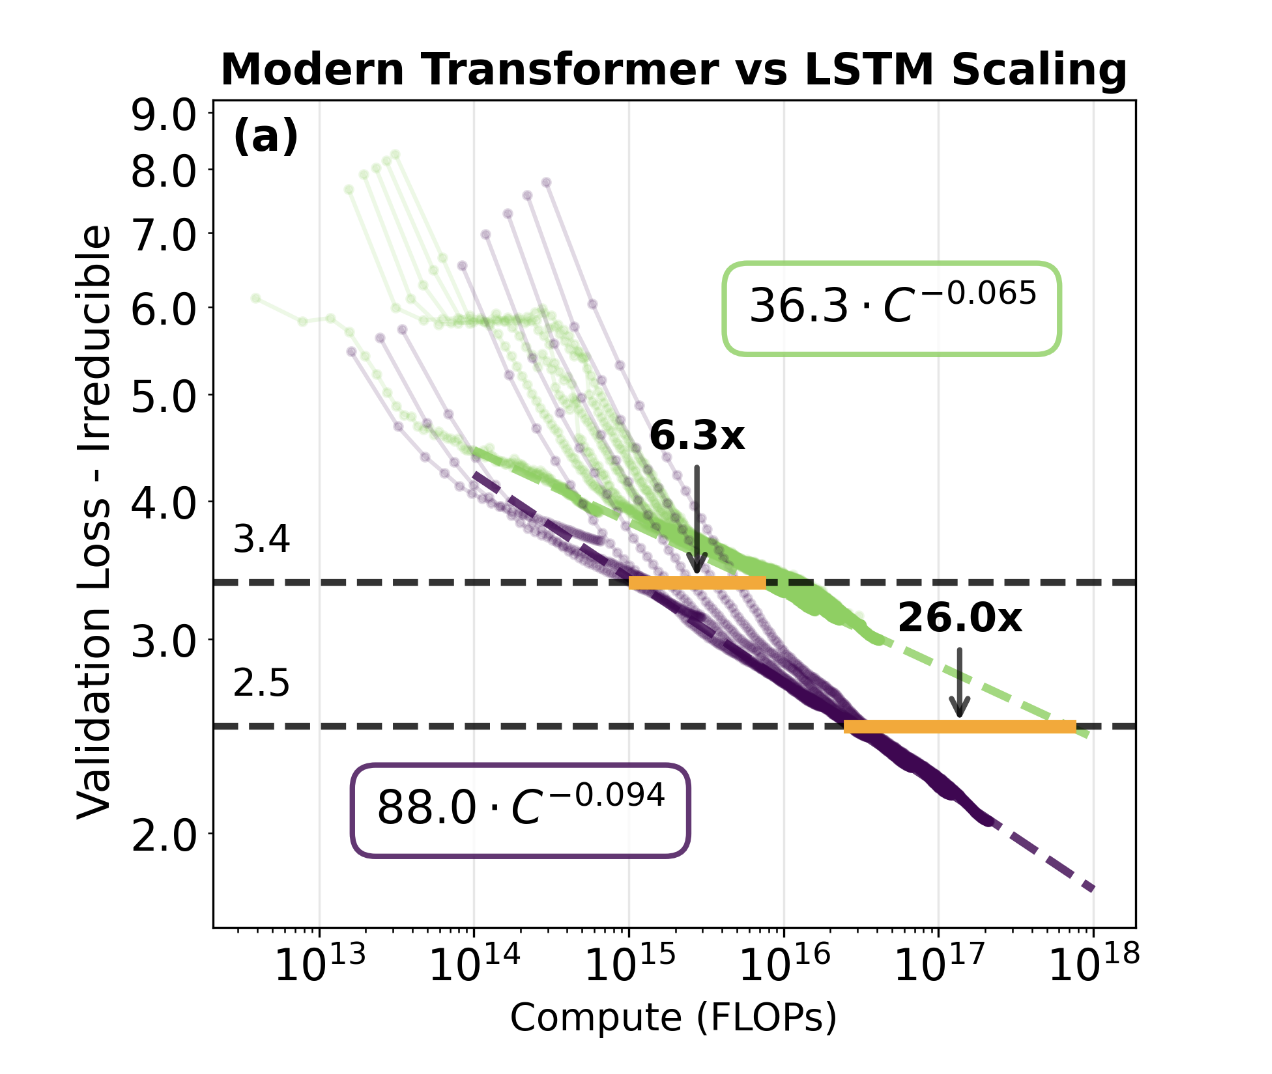
これは、これまでお見せしてきた模式的な簡略図とかなりよく噛み合う。主な違いはy軸が反転していることで、「検証損失」が低いほど能力が高いことを意味する。Transformerのほうがスケーリングの傾きが急で、学習計算量の規模とともに効率の向上が大きくなっているのが分かる。 FLOP では効率の向上は6.3倍だが、 FLOP では26倍になる。
そして、学習計算量を拡大するにつれて、この向上は大きく伸びる。紫の直線を単純に FLOP まで外挿すると、効率の向上は全体で20,000倍を超える! 数字をもっと丁寧に計算すると、 FLOP の規模では年2.23倍の改善になる。こう考えると、年に数倍の計算効率の向上が測定されうることも理解しやすくなる。17
私の考えでは、これらの結果は、測定されたソフトウェアの進歩がこれほど速い理由についての「規模依存」の議論にかなりの重みを与える。直感的にもうなずける面があると思う。一部のAIアーキテクチャが他よりうまくスケールするという証拠は、しばらく前から出ていたからだ。
だが、これも決定打となる議論だとは思わない。まず、一本の論文を重視しすぎたくない。年2.23倍という推定値は、先に示した私の最善の推測である年10倍よりもかなり低い。もっとも、著者らがより幅広い工夫を調べたり、より大きな計算規模を考慮したりすれば、これは変わるかもしれない。18 この研究には疑わしい点もある。たとえば、 FLOP から FLOP(LSTMでは FLOP 未満)のスケーリング実験を使って、 FLOP に至るまでの効率の改善を推し量っている。つまり、5桁も先まで果敢に外挿しているのだ。これが問題なのは、規模依存についての結果そのものが、どの計算規模を見ているかに依存するかもしれないからだ。なんともメタな話である。19 理想を言えば、このような実験をより大きな計算規模で行い、さらに、より良いデータと事後学習による向上も実験的に考慮できれば素晴らしい。どちらも、この論文が素通りしている点である。20
全体として、データの質の改善と規模依存のどちらも重要な役割を果たしていると私は考える。どちらの説明でも、数字のつじつまが完全に合うかははっきりしない。また、どちらの説明にも説明しきれない観察がある。たとえば、この1年、学習計算量がさほど伸びないまま能力は向上している。これはおそらく、規模依存の工夫よりもデータの質の改善によってうまく説明できると思う(ただし、両者は互いに排他的ではない。より良いデータそのものがスケーリングの傾きを変えうるからだ)。
これは、既存のソフトウェアの進歩の推定値がほぼすべて誤解を招くものだったことを意味する。アルゴリズムの改善によるものと思われていた効率向上の多くは、実際にはより良いデータから来ていた。そして、多数の新しいアルゴリズムを次々に発明したことによると思われていた効率向上の多くは、ほんの一握りのアルゴリズム上の工夫を規模拡大したことから来ていた可能性がある!
実際、先に見たLSTMとTransformerの間の20,000倍の向上を分解してみると、そのとおりになっているように見える。
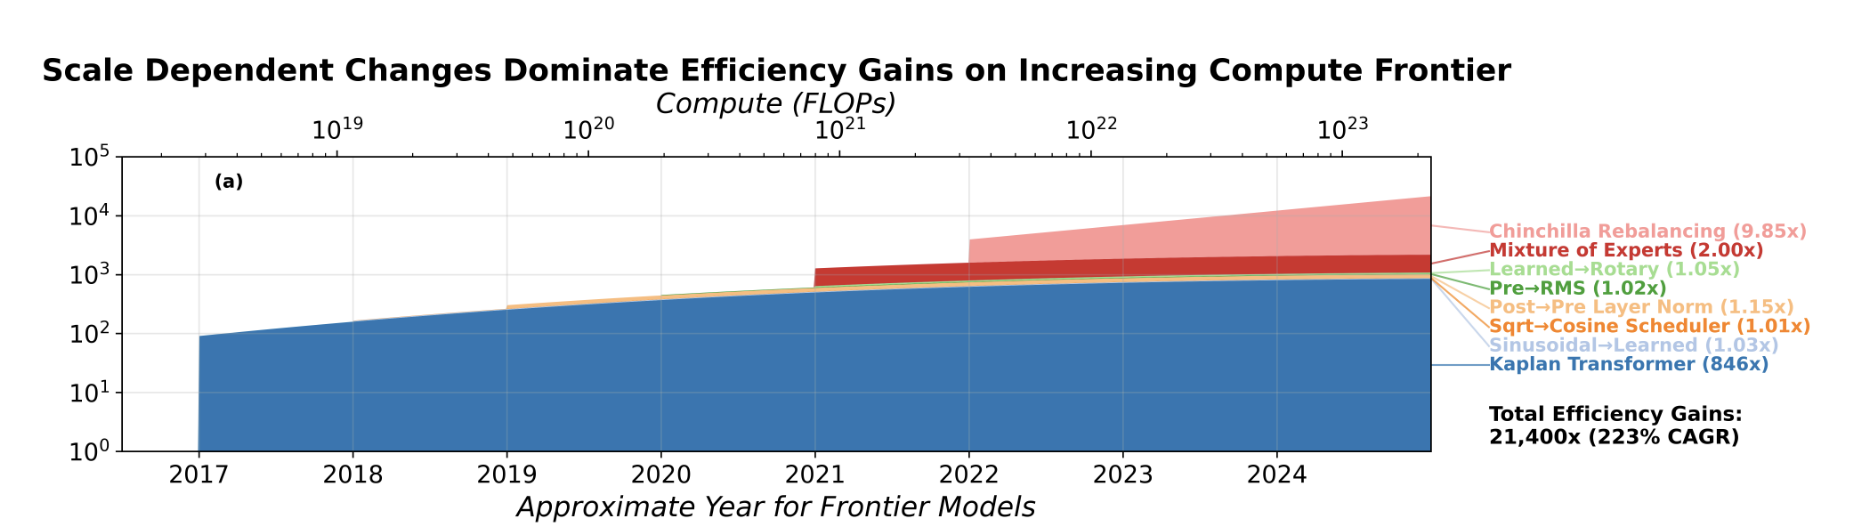
なお、この論文は、学習計算量のフロンティアとして、Epoch の「注目すべきAIモデル(Notable AI models)」データセットの深層学習時代のトレンド線を使っている。2024〜2025年の「計算資源のフロンティア」が \(10^{23}\) FLOP 近くになっているのはこのためである。
ここから、効率向上の大半が二つの規模依存の工夫から来ていたことが分かる。(1) LSTMから Kaplan 型 Transformer への移行と、(2)「Chinchilla による配分の見直し」である。21 その他の工夫は規模に依存しないようで、全体への寄与もごくわずかだ。曲線をほとんど左に動かさず、傾きも変えない。したがって、速いソフトウェアの進歩が測定されても、それは単に私たちが急速に規模を拡大しているからにすぎないのかもしれない。さらなる工夫を生み出すこととは、あまり関係がないのかもしれないのだ。
IV. これがソフトウェア知能爆発の論争にどう影響するか
ここまで見てきたことはすべて、AIをめぐる最も重要な論争の一つにかかわってくる。すなわち、ソフトウェア知能爆発はどれほど起こりやすいのか、という論争だ。その考え方はこうである。AI研究を自動化すると、22 急速なフィードバックループが生じる。AIが賢くなる(あるいは数が増える)と、その研究活動がAIのソフトウェアの進歩をさらに推し進め、AIはいっそう賢くなる(あるいは数が増える)。以下、それが繰り返される。23
これが非常に重要なのは、もしそれが本当なら、わずか数年のうちにAIと社会に途方もない変化をもたらしうるからだ。「途方もない」とはどういうことか。これについての意見はさまざまだが、しばしば挙げられるのは、ほとんどのがんの根絶、1世紀分の技術進歩を10年に凝縮すること、あるいは人類の絶滅といったものだ。懸かっているものが大きい、などと言えば、今世紀最大の控えめな言い方になるだろう。
では、私たちが見てきた結果、つまりソフトウェアの進歩の速さとその原動力についての結果は、この論争にどう影響するのか。手短に答えると、ソフトウェア知能爆発についての既存の分析の一部はソフトウェアの進歩を控えめに見積もりすぎており、しかも、ほぼすべての分析が誤った仮定にもとづいている。
その理由を見るため、ソフトウェア知能爆発を研究する際に通常使われるモデルを考えよう。これはAI研究の労力とAIのソフトウェアの進歩を結びつけるものだ。両者を結びつける中心的なパラメータが「AIソフトウェアの研究開発(R&D)の収穫」であり、研究の労力の増加をどれだけうまくソフトウェアの進歩に変えられるかを表す。24
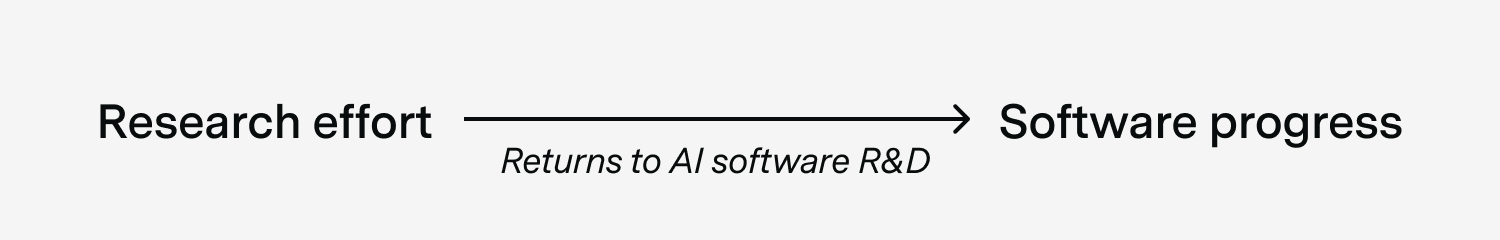
このパラメータには重要な閾値がある。1より大きければ、ソフトウェア知能爆発が起こる。そして実際、文献の推定値は、そうなっているかもしれないことを示唆している(ただし非常に不確かである)。
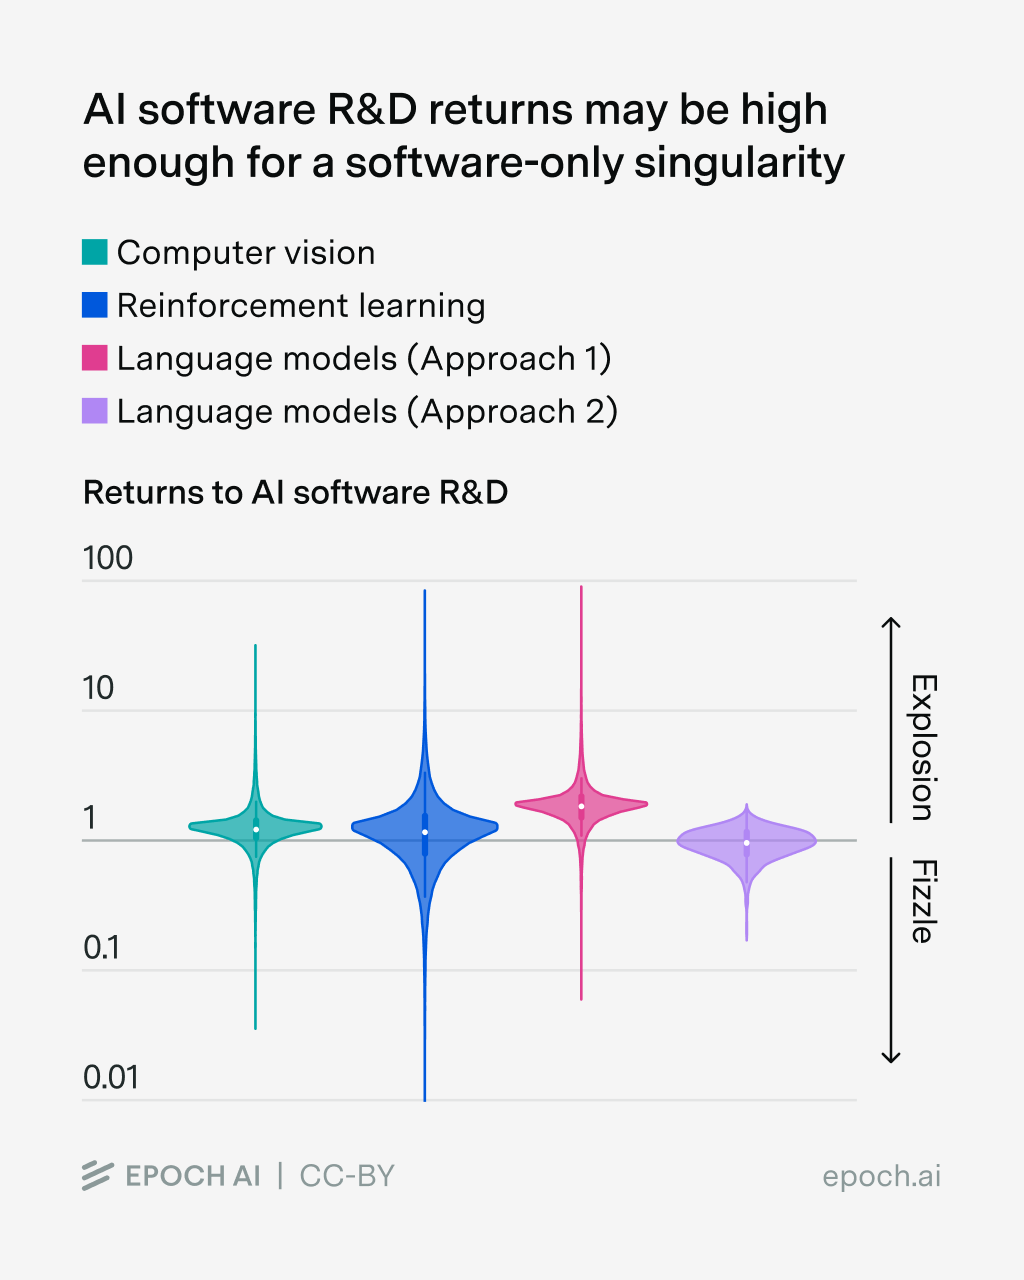
(出典)AIソフトウェアのR&Dの収穫の推定値は非常に不確かだが、1をまたいでいる。これは知能爆発がありうることを示唆しているが、AIが自らを改良するフィードバックループが単に尻すぼみに終わることもありうる。
しかし、Daniel Eth と Tom Davidson が指摘したように、これらの推定値は、年3倍というソフトウェアの進歩の控えめすぎる推定値に依拠している(これは先に見た Ho et al. 2024 の推定値である)。私はいま、ソフトウェアの進歩は年10倍に近いと考えている。したがって、この変更によってこのパラメータの推定値は数倍に増えるはずで、25 ソフトウェア知能爆発はずっと起こりやすく見えることになる。
だが一方で、これらが大幅な過大評価だと考える十分な理由もある。ソフトウェア知能爆発の既存のモデルは、ソフトウェアの進歩の多くが学習計算量の拡大から来うることを考慮していないからだ。思い出してほしい。LSTMと現代的なTransformerの間で観測された効率向上の大半をもたらしたのは、人間が新しい工夫を大量に発見したことではなく、たった二つの工夫について学習計算量を拡大したことだった。
既存のモデルはそうではなく、研究の労力だけが重要だと仮定するか、研究の労力と実験に使う計算資源の組み合わせに依存すると仮定している。26 だが私の知るかぎり、学習計算量の拡大がソフトウェアの進歩の源泉であることを明示的に考慮したモデルはなく、そのため研究の労力の重要性を大きく過大評価している可能性がある。
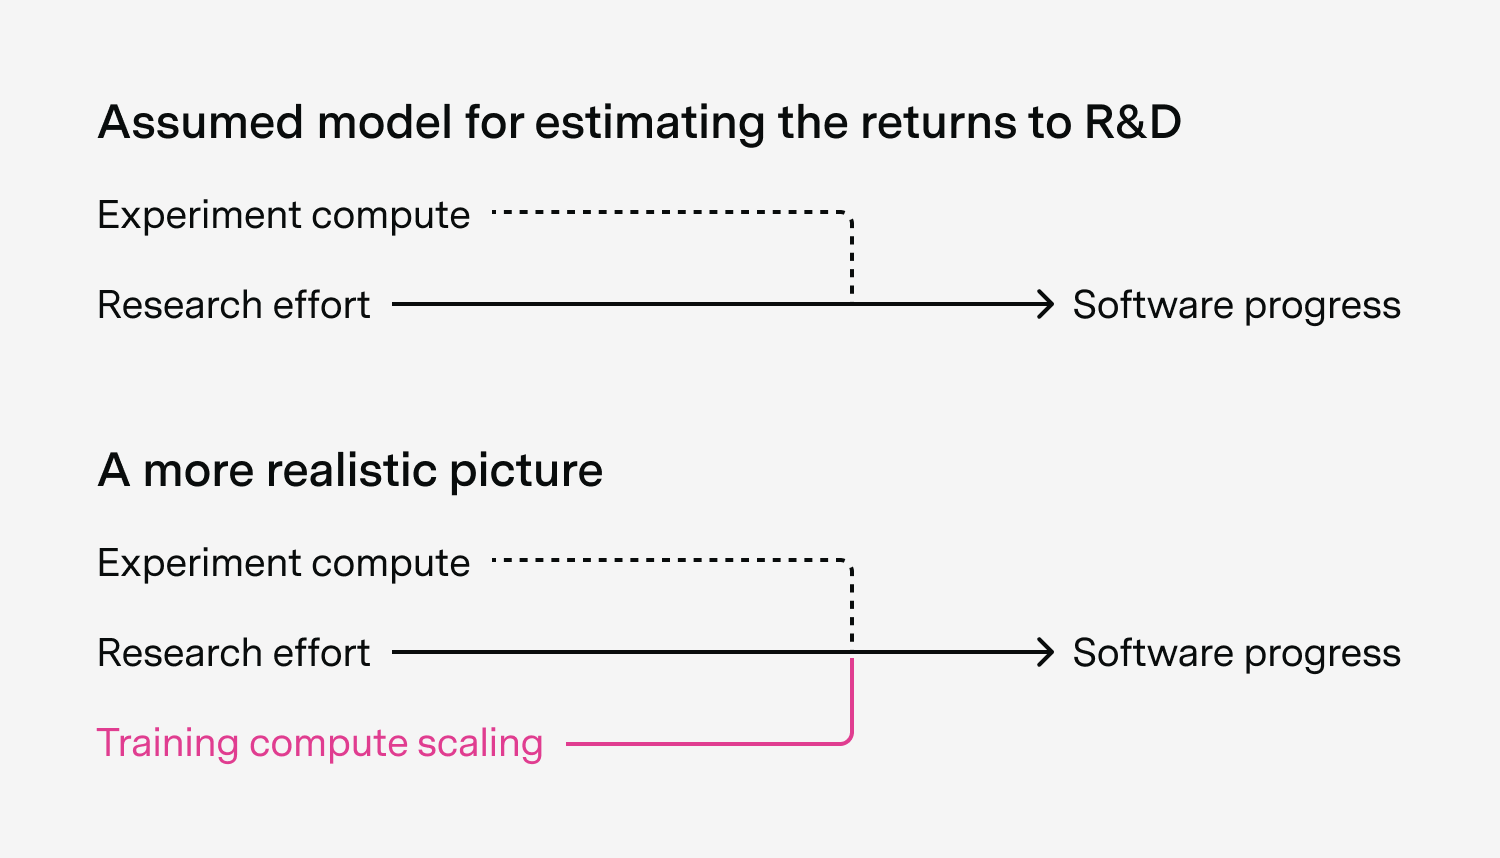
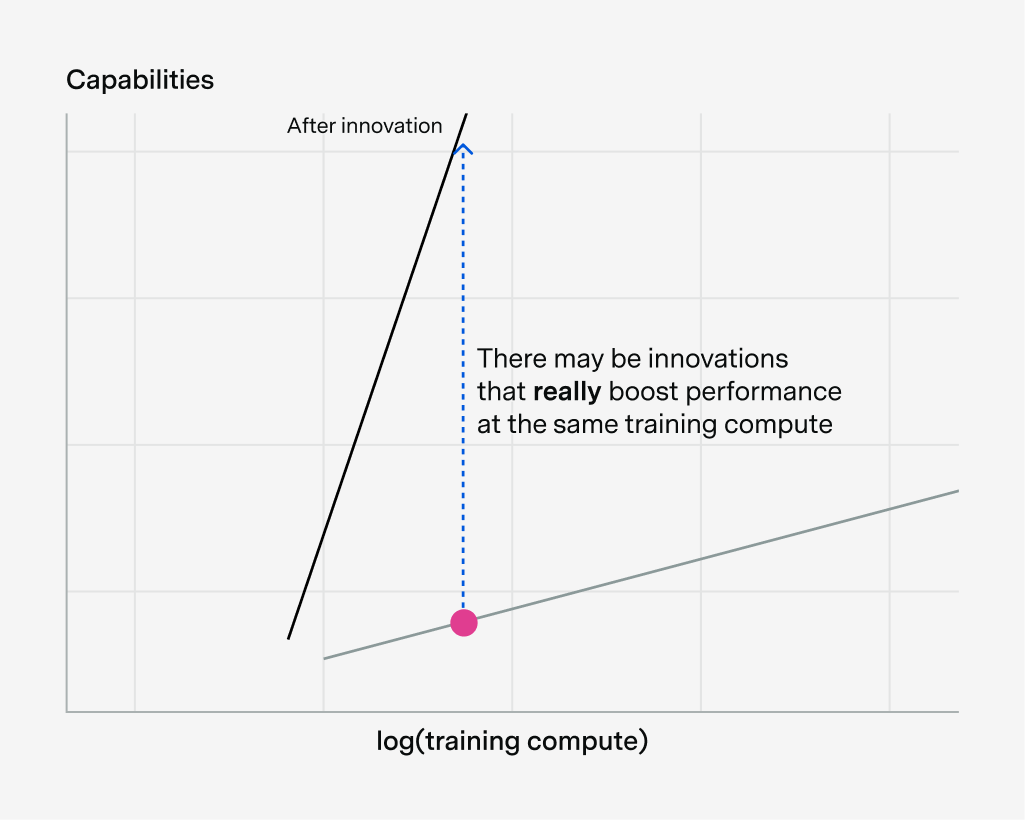
これは事実上、既存の推定値がソフトウェアR&Dの収穫を過大評価していることを意味し、ソフトウェア知能爆発をずっと起こりにくく見せる。これは「計算資源のボトルネック」と考えることもできる。学習計算量も同時に拡大しなければ、超高速のソフトウェアの進歩を実現するのは難しい、ということだ。
この学習計算量のボトルネックは乗り越えられると考える理由もいくつかある。たとえば原理的には、同じ学習計算量で性能を本当に大きく押し上げ、それによってソフトウェアの大きな進歩をもたらす工夫があるかもしれない。それは、小さな規模ではあまり良く見えなくても、非常にうまくスケールするソフトウェア上の工夫という形をとりうる。
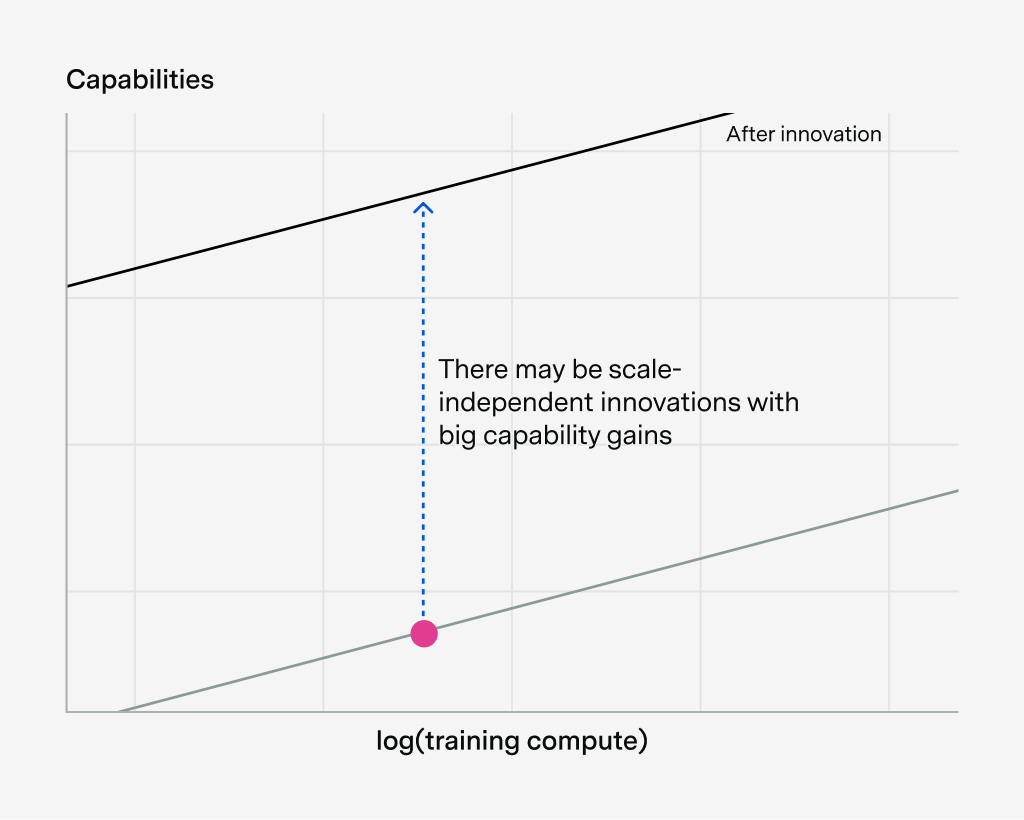
あるいは原理的には、能力を大きく向上させる、規模に依存しない工夫を大量に見つけることもできるかもしれない。
そしてもちろん、規模依存と規模非依存の改善を組み合わせて、能力を大きく向上させることもできる。これらが容易であれば、学習計算量をあまり増やさずに能力を急上昇させることができるだろう。
個人的には、これらはおそらくかなり難しいと言いたくなる。そうでなければ、なぜ私たちはまだこうした工夫を見つけていないのか。だが理論的に排除することはできないし、いつでもこう言い返せる。「あなたにはこうした工夫が見つけられないかもしれないが、データセンターの中に天才たちの国があれば、きっと見つけるはずだ! AGIが Von Neumann+++ ほど賢かったら何が起こるかは言うまでもない……」。
さらに、学習計算量のボトルネックの強さは、AIのソフトウェアの急速な進歩についての「規模依存」の説明に左右される。だが、データの質の改善によって推し進められるソフトウェアの進歩には、それほど当てはまらないかもしれない。より良いRL環境を構築するだけで、ソフトウェア知能爆発が起こりうるのかもしれない! それがどの程度可能かは分からないし、原理的にはデータの質に関する工夫も規模依存でありうる。それでも、これは非常に重要な考慮事項だと思う。
ソフトウェア知能爆発とそのボトルネックをめぐる論争には、ここで扱うには長すぎる論点がほかにもたくさんある。だが全体として、要点はこうだと思う。ソフトウェア知能爆発についての先行研究の一部は、ソフトウェアの進歩の古い推定値にもとづいており、そのせいで「爆発」がより起こりやすく見えている。一方で、ほぼすべての既存研究は大きな欠陥のあるモデルにももとづいており、そのせいで「爆発」が起こりにくく見えている。個人的には、この問題を調べる前よりも、ソフトウェア知能爆発は起こりにくいと今は考えている。ただし、ボトルネックはそれを完全に排除できるほど強くはないとも思う。
V. 結論
ここまで見てきた主な点をまとめよう。
- ソフトウェアの改善とは、同じ能力に達するのに必要な学習計算量を減らすこと、言い換えれば、手持ちの学習計算量でより多くを成し遂げることである。
- ソフトウェアは非常に速く進歩しており、効率の向上は年に数倍のペースで伸びている。だが、データの制約と統計上の仮定のために、これらの推定値には途方もなく大きな誤差範囲がある。
- これらの数字はいくらか誤解を招くものでもあるかもしれない。測定された進歩の多くは、アルゴリズム上の工夫ではなくデータの質の改善によって推し進められている可能性がある。そして、測定された効率向上の大きな割合は、新しいアルゴリズムを絶えず発見したことではなく、ほんの一握りの規模依存の工夫を規模拡大したことを反映している可能性が高い。
- 効率の改善の大半がほんの一握りの規模依存の工夫から来ていたのなら、ソフトウェア知能爆発の既存のモデルには欠陥があるかもしれない。過小評価されていたソフトウェアの進歩を補正すると爆発はより起こりやすく見えるが、規模依存の工夫に由来する学習計算量のボトルネックを考慮すると、逆の方向に押し戻される。
これだけの背景がそろったので、ようやく、この記事の冒頭で挙げた三つの問いに答える材料が手に入った。
問:DeepSeek は、より少ない計算資源で学習されたにもかかわらず、なぜわずか数か月のうちに OpenAI の o1 に追いついたように見えたのか。
答:ソフトウェアが本当に年に数倍のペースで改善しているなら、DeepSeek が数か月後に o1 に迫れたのはそれほど不思議ではない。蒸留が大いに使われていたなら、なおさらだ。27 Peter Wildeford がこちらでより詳しく説明している。問:世界はいつAGIを開発するのか。
答:確かなことは誰にも分からないが、ソフトウェアの進歩がきわめて重要である可能性は高い。たとえば、AGIの到来時期を予測する最も有名なモデルの一つに Ajeya Cotra の生物学的アンカー(bioanchors)モデルがある。当初、その予測の中央値は2050年前後だった。だが Scott Alexander が指摘するように、Cotra はAIのソフトウェアの進歩を過小評価していたため、この予測は10年以上遅すぎたのかもしれない(Cotra の最新の推定はおそらく2030年代のどこかである)。問:AI研究を自動化したら、Situational Awareness や AI 2027 が描くように、AIの進歩はとてつもなく加速するのか。
答:その答えは、要するに第IV節である。つまり、本当のところは誰にも分からないが、二つの小問に答えることで自分の意見を形づくることはできる。(1)「AIソフトウェアのR&Dの収穫はどれほどか」、(2)「計算資源はソフトウェア知能爆発の大きなボトルネックになるのか」である。私は、計算資源のボトルネックは強いだろうと推測しているので、答えは「いいえ」に傾いている。だが、意見が分かれる余地はかなり大きいと思う。28
これらの問いが、AIのソフトウェアの進歩がなぜこれほど重大なのかを改めて示す助けにもなればと思う。これらは、AI企業間の競争について、そして史上最も影響力のある技術となるであろうものを開発したときに世界に何が起こるかについての、根本的な問いである。そして、その答えはソフトウェアの進歩の速さと性質によって大きく左右されうる。問題は、私たちがそれをあまりにも理解できておらず、不確実性を絞り込めないことだ。
では、どうすべきか。手始めに、ソフトウェアの進歩がどれほど重要かを、人々に本当に理解してほしい。そのうえで、それをよりよく理解するために、できるかぎりのことを試みればよい。たとえば、より大きな計算規模でアブレーション実験を行う、研究者が計算資源のボトルネックに直面したときにソフトウェアの進歩がどうなるかを調べる、事後学習でのソフトウェアの進歩を推定する、といったことだ。それに、AI研究者の中には、こうした問題の一部にすでに良い答えをもっている人もいるかもしれない。私に何が分かるだろう?
不確実性を減らすのは非常に難しいだろうと思う。だが少なくとも私の考えでは、このテーマは挑戦してみる価値があるほど重要である。
有益なフィードバックと支援をいただいた Aaron Scher、JS Denain、Josh You、Luke Emberson、Jaime Sevilla、David Owen、Parker Whitfill、Hans Gundlach、Brendan Halstead、Joshua Turner、Eli Lifland、Alex Fogelson、Lynette Bye に感謝する。そもそもこの記事を書くきっかけを与えてくれた Aaron には特に感謝したい。
付録:ソフトウェアの進歩の推定値
下の表は、第II節の冒頭の棒グラフの作成に使ったすべての推定値に加え、事後学習についてのいくつかの追加の推定値を示している。29
| 文献 | 段階 | ソフトウェア効率の改善 | 手法 |
|---|---|---|---|
| Ho et al. 2024 | 事前学習 | 年3倍(95%信頼区間:1.5倍〜64倍) | 統計モデル、グラフに線を引く手法 |
| Scher 2025 | 主に事前学習 | 中央推定値は年16倍。あらゆる点を考慮した推測では年20倍(80%信頼区間:2倍〜200倍) | グラフに線を引く手法 |
| Ho et al. 2025 | 主に事前学習 | 主な手法では年6倍(95%信頼区間は、モデルファミリーによって2倍〜50倍)。OLSを使った別の手法では年20倍(95%信頼区間:7倍〜40倍)。「直接観察」による手法では中心推定値が年10倍で、推定値の範囲は年2倍〜400倍。 | 統計モデル、グラフに線を引く手法 |
| Whitfill, Snodin, and Becker 2025 | 主に事前学習 | 年3倍(95%信頼区間:2倍〜40倍) | 統計モデル |
| Davidson et al. 2023 | 事後学習 | 事後学習のアルゴリズム上の個々の工夫で、通常5倍〜30倍 | 概算(BOTEC) |
| Anthropic RSP | 事後学習 | 年3倍(根拠の示されていない非公式の推定) | 不明 |
| Ho and Berg 2025 | 事後学習 | GPQA や MATH などのベンチマークで、初期の推論モデルによりおよそ10倍の効率向上 | グラフに線を引く手法 |
注
-
これを「アルゴリズムの進歩」と呼ぶこともあるが、ここでは、こうした改善がより良いデータによるものである可能性も含めておきたい。 ↩
-
学習計算量に注目する以外にも「ソフトウェアの進歩」を定義する方法はあり、それについては記事の後半で触れる。 ↩
-
ここでは「能力」を、言いたいことを簡単に示すための抽象的な概念として使っているにすぎない。もっと具体的なものがほしければ、Epoch能力指数や log(METR のタイムホライズン) を考えればよい。ベンチマークの成績のようなものを考えることもできるが、その場合、直線的な関係という仮定はあまり意味をなさない。 ↩
-
この実効計算量の定義は、蒸留モデルを含めるといくらか破綻する。計算効率の向上の大部分が、既存のより大きなモデルのデータを使えることから来ているからだ。特に、 FLOP までのモデルしか学習していない場合、蒸留は曲線を左に動かすが、同じ FLOP でより高い能力に到達できるようにはしない。 ↩
-
この記事では主にLLMを扱う。LLMは最も目立つAIシステムであり(たとえば ChatGPT は今ではおそらく週間アクティブユーザーが10億人近くに達している)、「AGI」に向けて前進している主な種類のモデルだからだ。 ↩
-
厳密に言えば、Ho et al. 2024 は学習計算量(パラメータ数とデータ量の積に関係する)ではなく、パラメータ数とデータ量のデータを使っている。 ↩
-
観測データだけから反実仮想についてのデータを得るのも難しい。たとえば観測データからは、当時使えた手法で GPT-4 を10倍に規模拡大したら何が起こるかは、実のところ分からない。実験を行えばこれを明らかにしようと試みることはできるが、それはまったく別の手法である。 ↩
-
具体的には、単一の能力水準ではなく、能力の狭い範囲を考える。そうしないと、該当するモデルが一つも見つからないからだ! ↩
-
30,000倍という数字は、この記事の「Results table」で、能力の閾値を45としたものから来ている。年の改善は、次の問題から生じている。GPT-5 は Grok 4 の約1か月後に公開され、同程度の性能を達成しながら学習計算量はおよそ5分の1だった。これは年倍の速さを意味する。だが、これが本当にソフトウェアの真の進歩を反映しているかは明らかではない。 ↩
-
Whitfill, Snodin, and Becker 2025、Ho et al. 2025、Scher 2025 は事後学習による向上も一部含んでいるが、Ho et al. 2024 は明示的に事前学習だけを対象としている。実際には、どの論文も大部分は事前学習を反映しているのかもしれない。事後学習でのソフトウェアの進歩をきちんと推定するには事後学習の計算量のデータが必要だが、それがほとんど公開されていないからだ。 ↩
-
私が知っている主な推定値は Anthropic の責任あるスケーリング方針(Responsible Scaling Policy)にあるもので、偶然にもこれも年3倍である。残念ながら、この数字は真剣に受け取られることを意図したものには見えない。Anthropic はこれを「非公式の推定」と呼び、根拠も示していない。 ↩
-
ちなみに、これは Ajeya Cotra が生物学的アンカーの報告書でソフトウェアの進歩の推定値を下方修正した理由の一つであり、Tom Davidson もテイクオフの速さについての研究で似た議論を用いている。 ↩
-
これは、「学習計算量」を厳密にどう測るかによる。たとえば、モデルの蒸留も合成データの生成も、小さなモデルの開発を助けるために大きなモデルを使うことが多い。だが通常、学習計算量を数えるときには小さなモデルだけに注目し、大きなモデルの学習に必要な計算資源を無視する。そのうえで、この(過小な)学習計算量の推定値を使ってソフトウェアの進歩を測ると、大きな効率向上が拾われてしまう。 ↩
-
これはおそらくフロンティアモデルにはあまり当てはまらないが、それが普遍的に正しいかは確信がない。たとえば、o3 が一部 GPT-4.5 から蒸留された可能性もいくらかあると思う。 ↩
-
興味深いことに、共著者と私は言語モデルのソフトウェアの進歩を分解しようと試み、その大部分が(パラメータ効率ではなく)データ効率の改善から来ていることを見いだした。これはこの仮説と整合する。だが、これはかなり弱い証拠だと思う。信頼区間が非常に広く、最適化の設定を少しいじると、逆に向上の大半がパラメータ効率から来ていると示唆する当てはめになることもあったからだ。ただし、全体の計算効率についての結果はずっと安定しているように見えた。 ↩
-
強化学習でもソフトウェアの進歩が規模に依存することを示すもう一つの例が、Khatri et al. 2025 の図2である。強化学習のアルゴリズムの改善が学習曲線の傾きをどう変えるかを示している。 ↩
-
残念ながら、既存の推定値はこれをほとんど考慮していない。「凝った統計」手法は規模依存を仮定によって排除しがちで、「グラフに線を引く」手法にはそれを確実に見分けるだけの質の高いデータがない。私は二つの例外しか知らない。これらは効率への寄与をごく細かく考慮しようとしている。 ↩
-
今のところの私の印象では、(規模依存を無視した)既存の推定値の数字とこの論文の数字を直接比べる明快な方法はない。両者は少し違うものを測っているからだ。この論文はむしろ、ソフトウェアの進歩が年に数倍という推定値に、もっともらしい根拠を与えるものである。 ↩
-
この論文の筆頭著者(Hans Gundlach)と話した印象では、このプロジェクトはかなり計算資源に制約されており、それで実験の規模が小さかったようだ。誰か彼らにもっと計算資源をあげてほしい! ↩
-
具体的には、この論文は事後学習による改善を考慮しておらず、データの改善については(実験で考慮するのではなく)文献の推定値を使っている。 ↩
-
後者は、Transformerでの Kaplan のスケーリング則から Chinchilla のスケーリング則への移行を指す。Chinchilla は学習データ量とパラメータ数の比率を変えることで、同じ計算資源でより高い性能を得る。 ↩
-
この見方の支持者は、AI研究が完全に自動化されるよりずっと前から、AIが大幅な高速化をもたらすとも考えているのだと思う。だが本当の超高速のフィードバックループが生じるのは、AIがAIのR&Dを完全にこなせるようになり、連鎖の中に残る最後の人間のボトルネックが取り除かれたときだ。 ↩
-
なお、AIの数が増える場合には推論実行の効率の改善がかかわる。これは、先に論じた学習の効率の推定値とは別のものである。 ↩
-
専門的に言えば、このパラメータは、累計の研究の労力を2倍にしたときに計算効率がどう変わるかを表す。累計の研究の労力を2倍にしたときに計算効率も2倍になるなら、R&Dの収穫は1である。4倍になるなら、収穫は2である。一般に、出力が 倍になるなら、収穫は である。 ↩
-
一つ注意点がある。最近の事後学習の台頭以前に、ソフトウェアの進歩がどれほどの速さだったのかは、私にはよく分からない。近年、進歩が加速した可能性はあると思う。 ↩
-
そもそも、なぜ実験用の計算資源を含めるのか。考え方はこうだ。工夫を規模拡大してみなければ、それがどう機能するかは分からない。そのため、これを試すための大規模なスケーリング実験に大量の計算資源が必要になる。したがって、これは計算資源の大きなボトルネックになり、フロンティアの研究所のAI研究者の主張もこれを裏づけているように見える。たとえば、GPT-4.5 の事前学習に携わった Alex Paino は、多くのソフトウェア上の工夫が「小さな規模では良く見えるが、大きな規模では良く見えない」と述べている。関連して、RLHF や推論のための学習のような工夫は、GPT-2 のような小さなモデルでは時間の無駄だった可能性が高いが、GPT-4 や GPT-5 の規模ではきわめて重要になったと考えられる。どちらのアイデアも、より小さな規模で生まれえた(あるいは実際に生まれていた)が、それが実際に機能するかを確かめるには規模拡大が欠かせなかった。 ↩
-
もっとも、Nathan Lambert が最近論じたように、米国と中国のモデルの追い上げは蒸留だけで説明できるものでもない。 ↩
-
「とてつもなく加速する」が何を意味するかにもよる。AIの進歩が加速することは間違いないと思うが、「1年でソフトウェアの進歩が5桁」といったことには、より懐疑的だ。それでも、おそらく15%程度の確率は与えるだろう! ↩
-
なお、Parker Whitfill が Ho et al. 2024 のコードにバグを見つけたが、数字はあまり変わらなかった。また、この研究について報告した信頼区間は更新後のデータを使って計算したため、元の論文に示した数字よりも広くなっている(ただし、元の中心推定値は変わらない)。 ↩