
お知らせ
2025年のデータインサイトと Gradient Updates トップ10
原題:Top 10 Data Insights and Gradient Updates of 2025
はじめに
2025年、私たちはAIの急速な進展に遅れないよう、一般に向けた発信を強化した。
データインサイトは、AIの主要な傾向と指標について、短く、視覚的で、それだけで完結する調査を届けるものである。
Gradient Updates は、個々の著者による最先端の論評を発表する場である(Substack のニュースレターとしても配信している)。必ずしも Epoch AI 全体の見解を代表するものではない。
この1年で、データインサイトを36本、Gradient Updates を37本公開した。
ここでは、2025年に特に人気のあったデータインサイトと Gradient Updates のトップ10を紹介する。1
人気のデータインサイト
LLMの推論実行価格は急速に下落しているが、その速さは課題によって大きく異なる
🠊 要点:2023年4月から2025年3月にかけて、同等の性能水準でのトークンあたりの価格は、10分の1未満にまで下がった。
🠊 なぜ重要か:APIのコスト低下は、市場の競争が激しくなり効率が大きく向上したことを示しており、顧客にとってAIが手頃なものになっている。この傾向が続けば、今日存在するどんなAIの能力も、まもなくごく安く使えるようになるだろう!
最先端(フロンティア)のAI性能は、1年以内に家庭用ハードウェアで手の届くものになる
🠊 要点:GPQA、MMLU、AA Intelligence、LMArena を含む複数の性能指標で測ると、家庭用GPUで動かせる最良のオープンモデルは、AIのフロンティアから1年以内しか遅れていない。
🠊 なぜ重要か:パソコンで動かせるオープンモデルは、何十億もの人々が利用できる。フロンティアモデルのリードが比較的小さいことから、モデルの能力が一定のままでは市場での優位を保つのは難しいと考えられる。企業は、より良いモデルを開発し続けるか、より良い連携機能などほかのサービスで抜きん出るよう迫られる。この傾向はAI政策に直接関わる。フロンティアに現れた能力は、どれも1年足らずのうちに広く制限なく利用できるようになる可能性が高く、規制の選択肢を難しくしている。
OpenAIの2024年の計算資源の大半は実験に使われた
🠊 要点:メディアの報道によれば、2024年に OpenAI が保有していた計算資源の大半は、推論実行や学習実行ではなく、さらなる開発を可能にする実験の実行に使われた。
🠊 なぜ重要か:AIの開発は資本集約的である。したがって、この分野の先頭を走る企業は、実験に使う大量の計算資源を利用できると予想される。この発見からは、現在AIにかかるコストの大半が、直接の学習や展開ではなく実験に関わるものだとも考えられる。
NVIDIAチップによる計算資源のストックは10か月ごとに倍増している
🠊 要点:NVIDIA のチップによる導入済みのAI計算資源の量は、2020年以降、毎年2倍を超えて増えている。新しい旗艦チップは、発売から3年以内に既存の計算資源の大半を占めるようになる。
🠊 なぜ重要か:計算資源は、AIの開発と展開にとって根本的な投入要素である。現在のAI開発のペースを保つには指数関数的に多くの計算資源が必要であり、それが NVIDIA やほかのメーカーのチップへの持続的な需要を生んでいる。
GPT-5とGPT-4は、いずれもベンチマークで前世代から大きく飛躍した
🠊 要点:GPT-4 と GPT-5 はどちらも、直前のモデルの性能を大きく上回った。
🠊 なぜ重要か:GPT-5 が公開されたとき、既存のモデルと比べて性能の向上がわずかだったことに失望した人もいた。だがこれは、能力の伸びが鈍ったというより、この2年でモデルの公開の頻度が高くなったことで、よりよく説明できる。
人気の Gradient Updates
ChatGPTはどれだけのエネルギーを使うのか?
🠊 要点:Josh は GPT-4o への1回の問い合わせにかかる平均的なエネルギーを推定し、それが電球を5分間点灯させるより少ないことを見いだした。この推定はのちに Sam Altman によって裏づけられ、Google が報告した Gemini のプロンプト1回あたりのエネルギーとも近い値である。
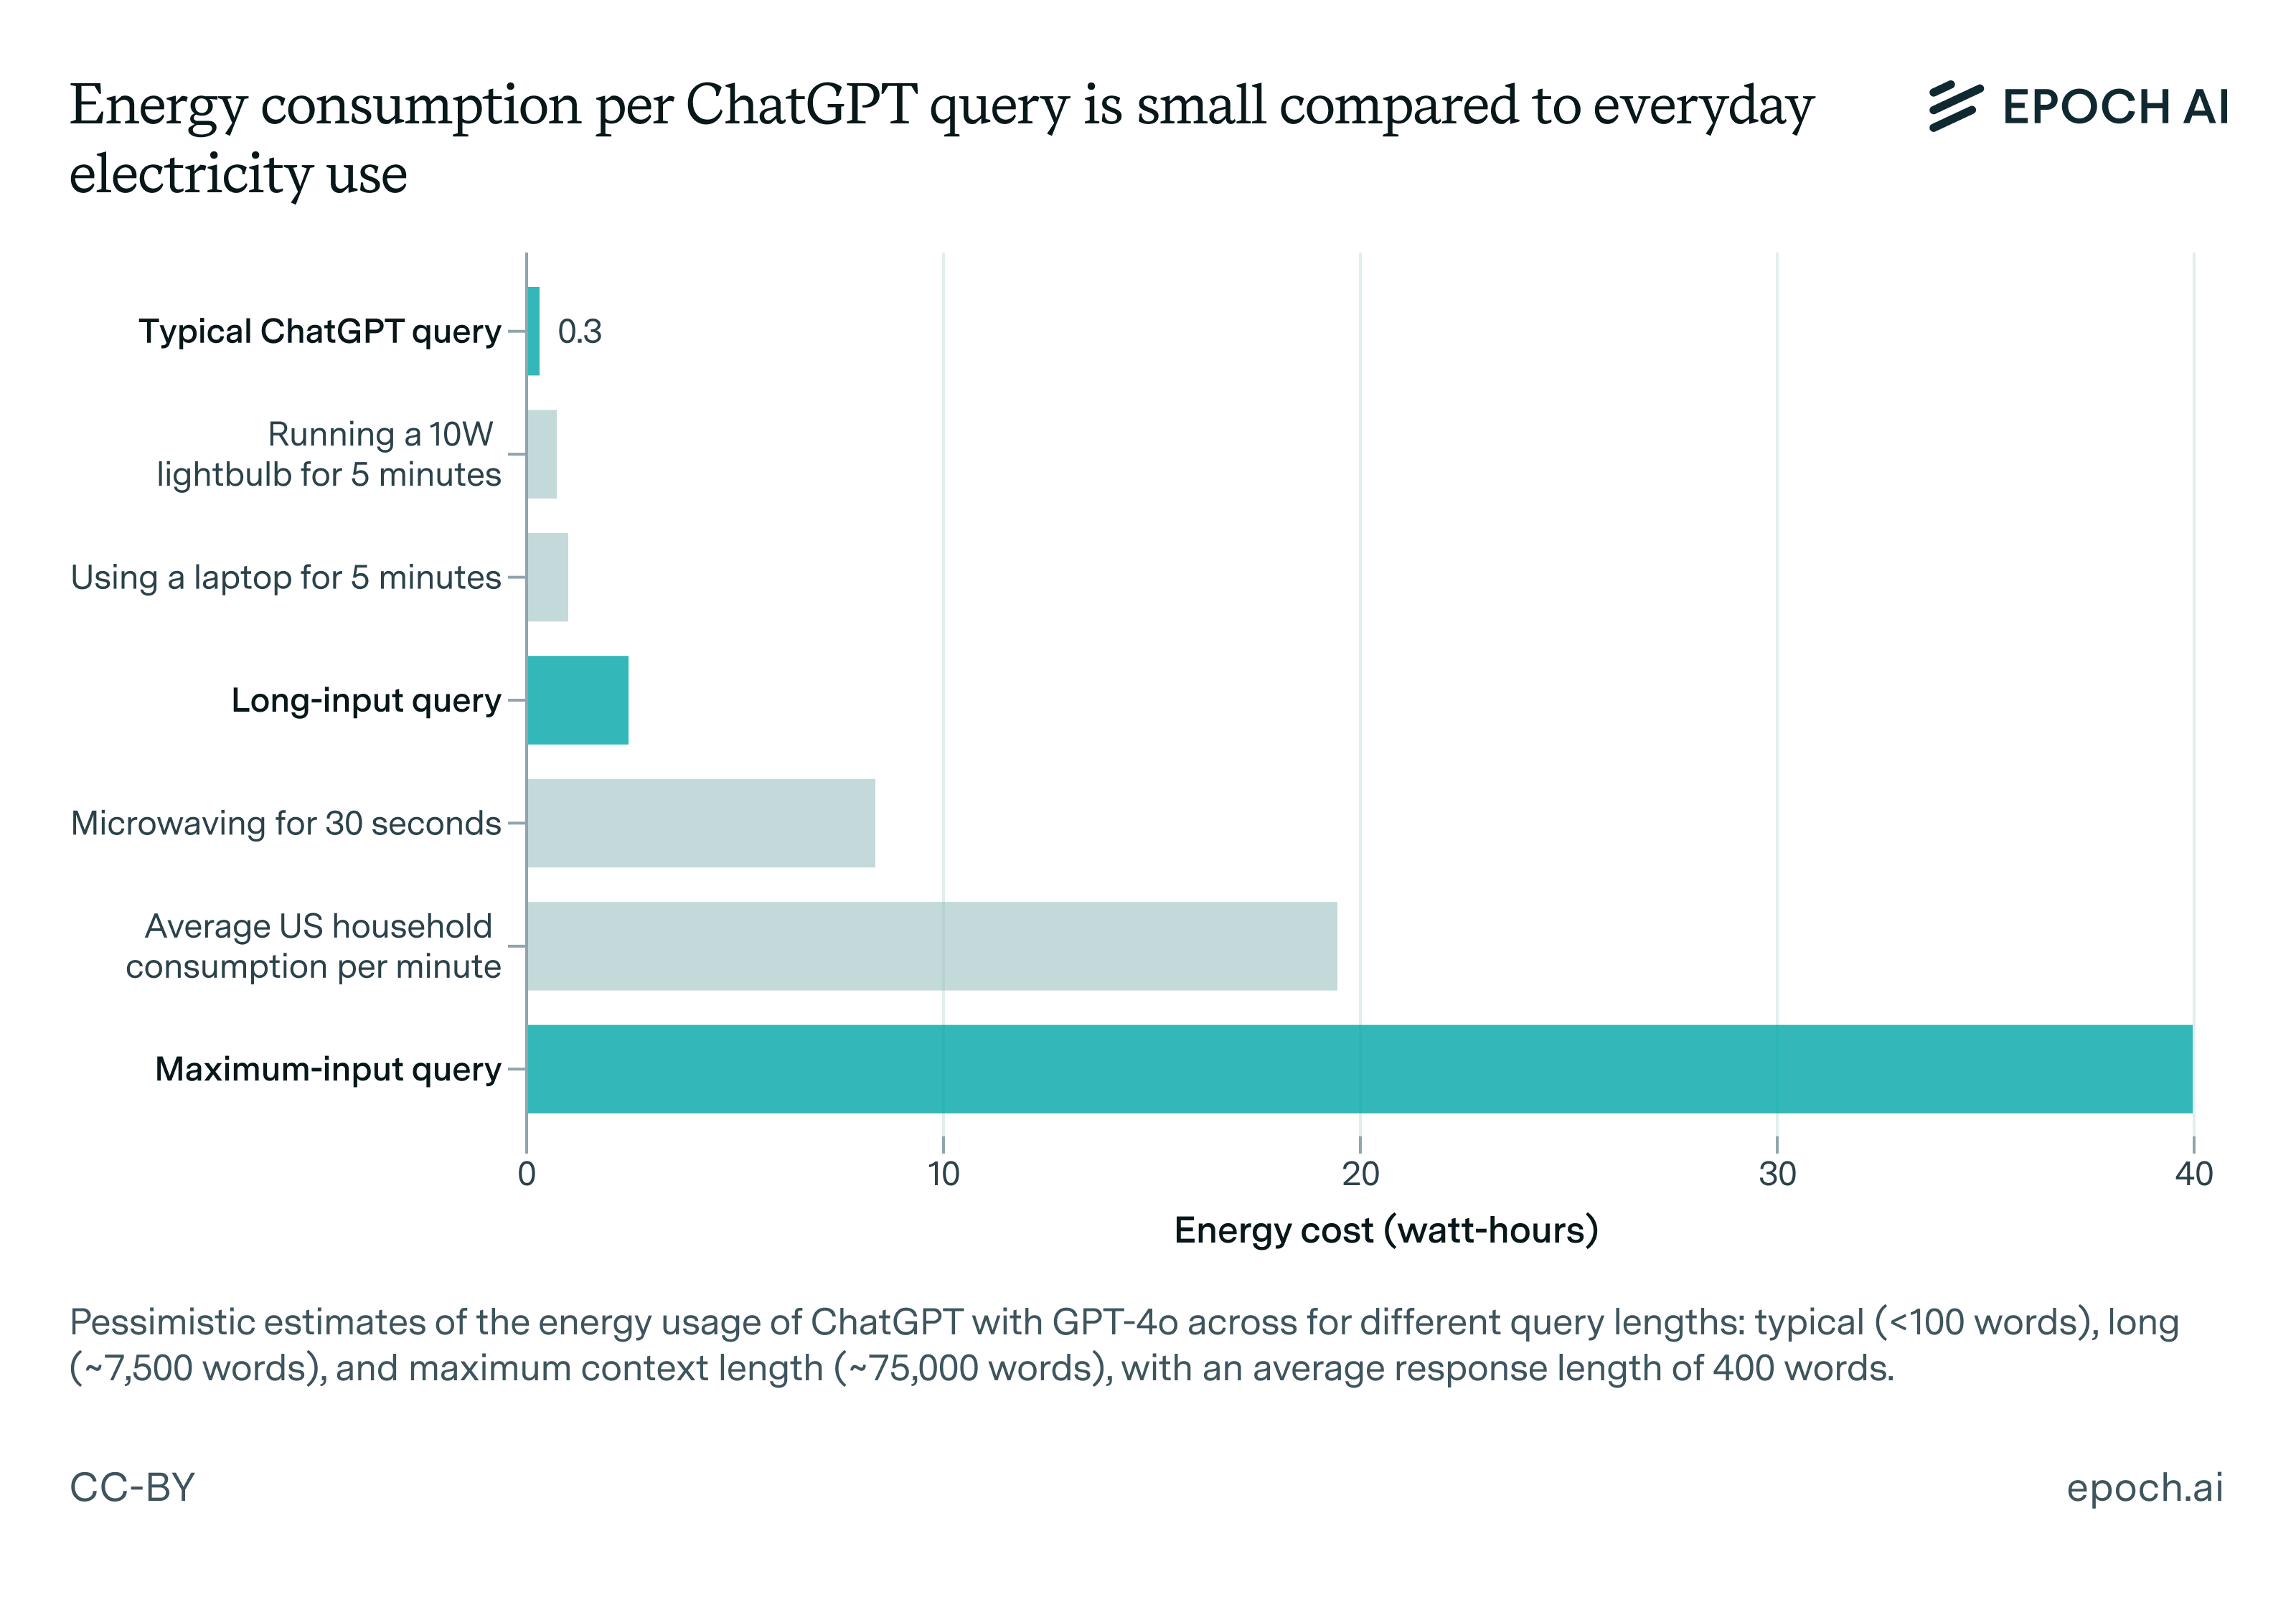
🠊 なぜ重要か:AIのエネルギー使用を懸念する人は多い。この記事はそのコストを定量化して懸念を文脈の中に位置づけ、当時のAIのエネルギー使用がほかの家庭での活動と比べてそれほど大きくないことを示した。ただし、AIのエネルギー使用はその後も指数関数的に増え続けており、将来はより大きな問題になるかもしれない。
DeepSeekはTransformerのアーキテクチャをどう改良したのか?
🠊 要点:この記事は、DeepSeek v3 の論文のチームが導入した三つの手法を取り上げた。これらの手法によって、彼らは次点のオープンモデルである Llama 3 の10分の1の計算資源で、当時最良のオープンソースの事前学習済みモデルを公開できた。その手法とは、マルチヘッド潜在アテンション(MLA)、Mixture-of-Experts(MoE)アーキテクチャの革新、マルチトークン予測である。
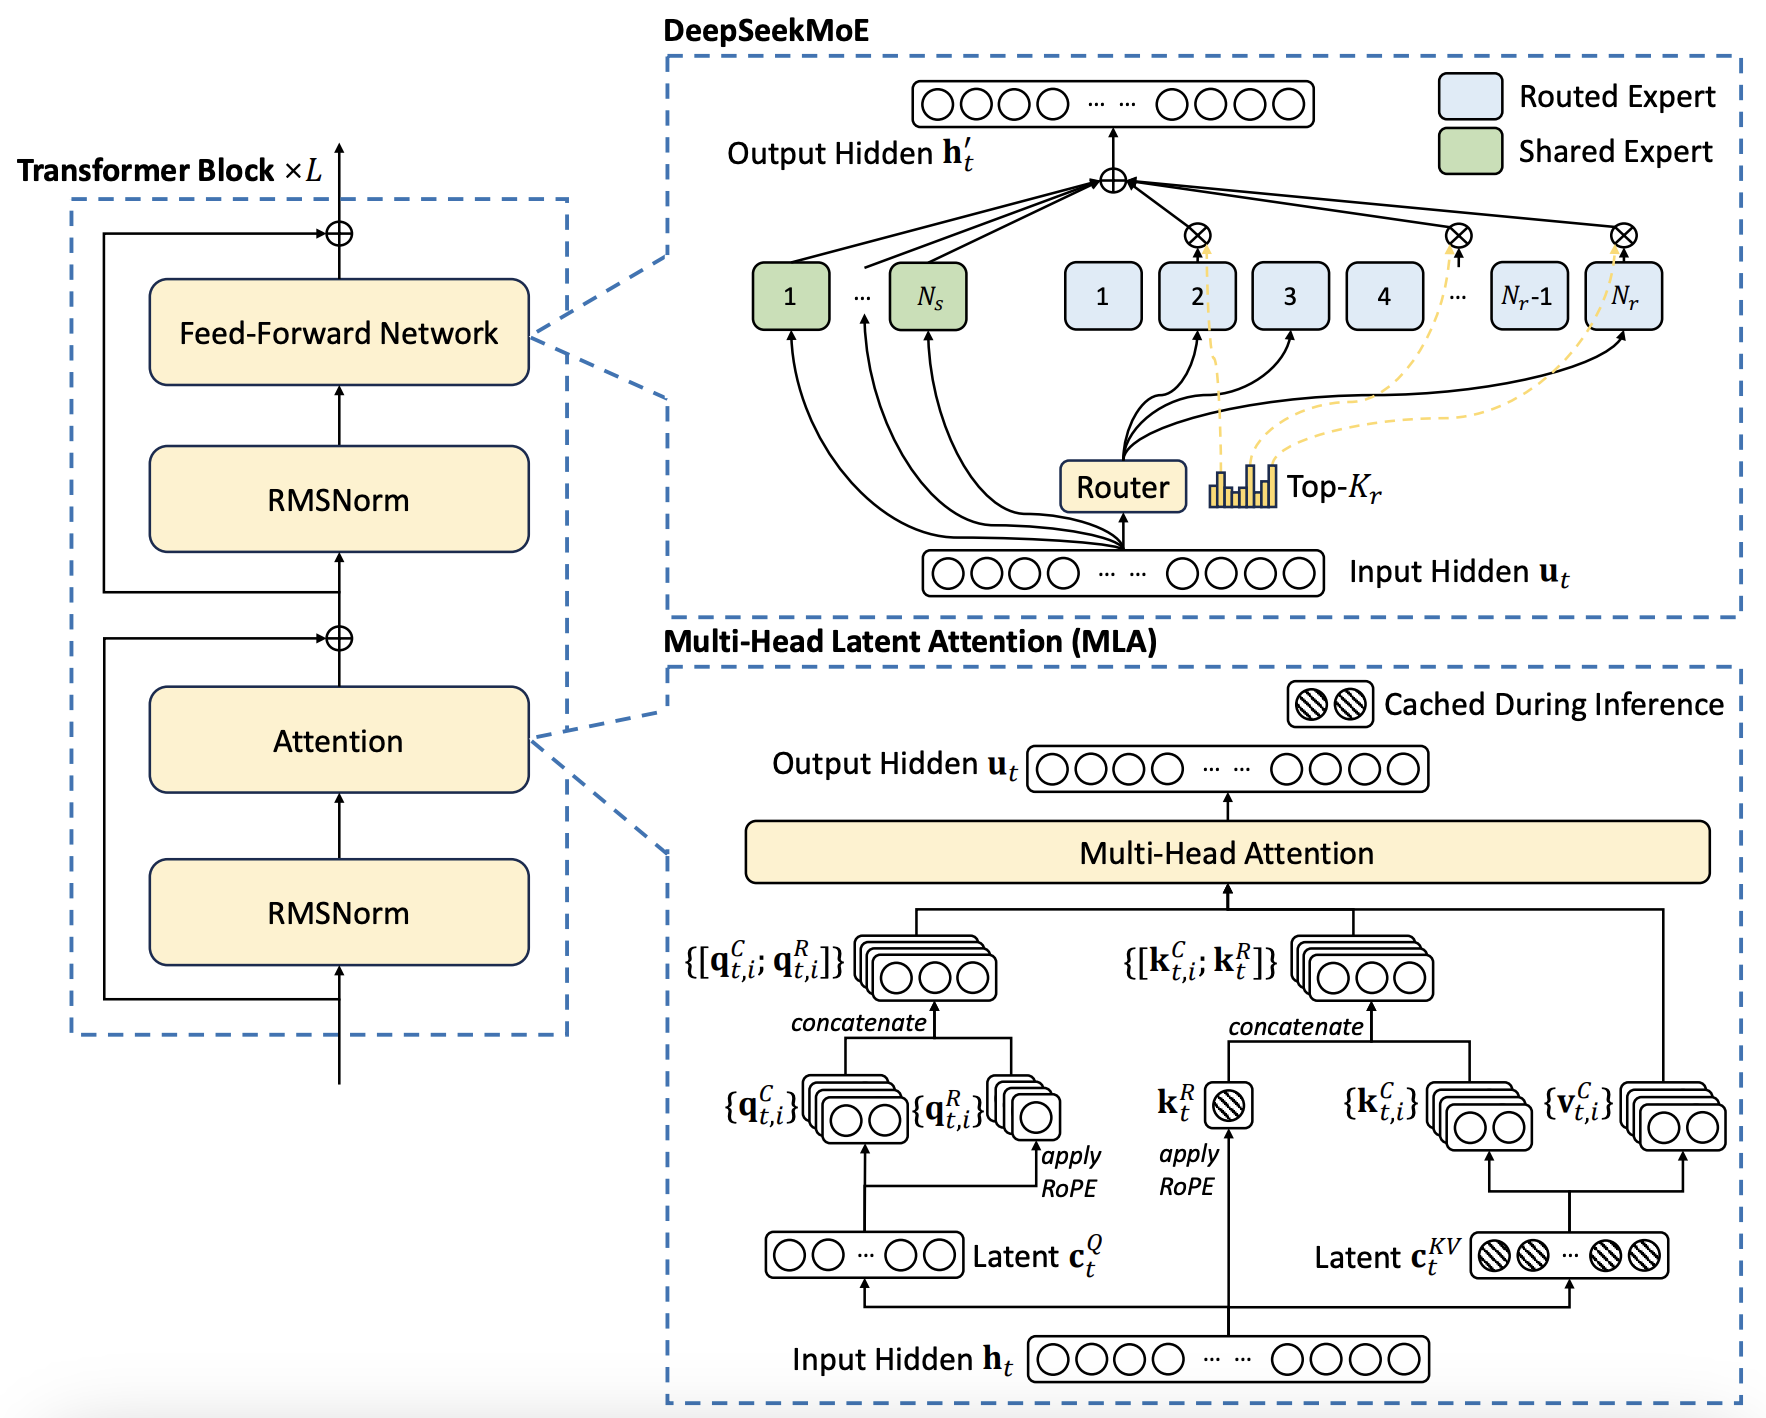
🠊 なぜ重要か:この記事の公開から3日後、DeepSeek は推論モデル R1 を公開して、はるかに広い注目を集めた。このモデルは、開発コストがおそらくごく一部でありながら、OpenAI の o1 に匹敵する性能を示した。彼らが導入した革新は、学習の計算効率のパターンをよく表している。新しい学習手法とデータの改善によって、モデルの開発コストが年々3分の1になっていくというパターンである。
推論モデルはどこまでスケールできるか?
🠊 要点:Josh は、RLによる推論の学習に使われる計算資源の伸びを論じた。OpenAI や Anthropic などの研究所は2025年初め、RLのスケーリングのペースは1〜2年以上は続けられないと述べていた。すぐに自社の計算インフラの限界に突き当たるからである。
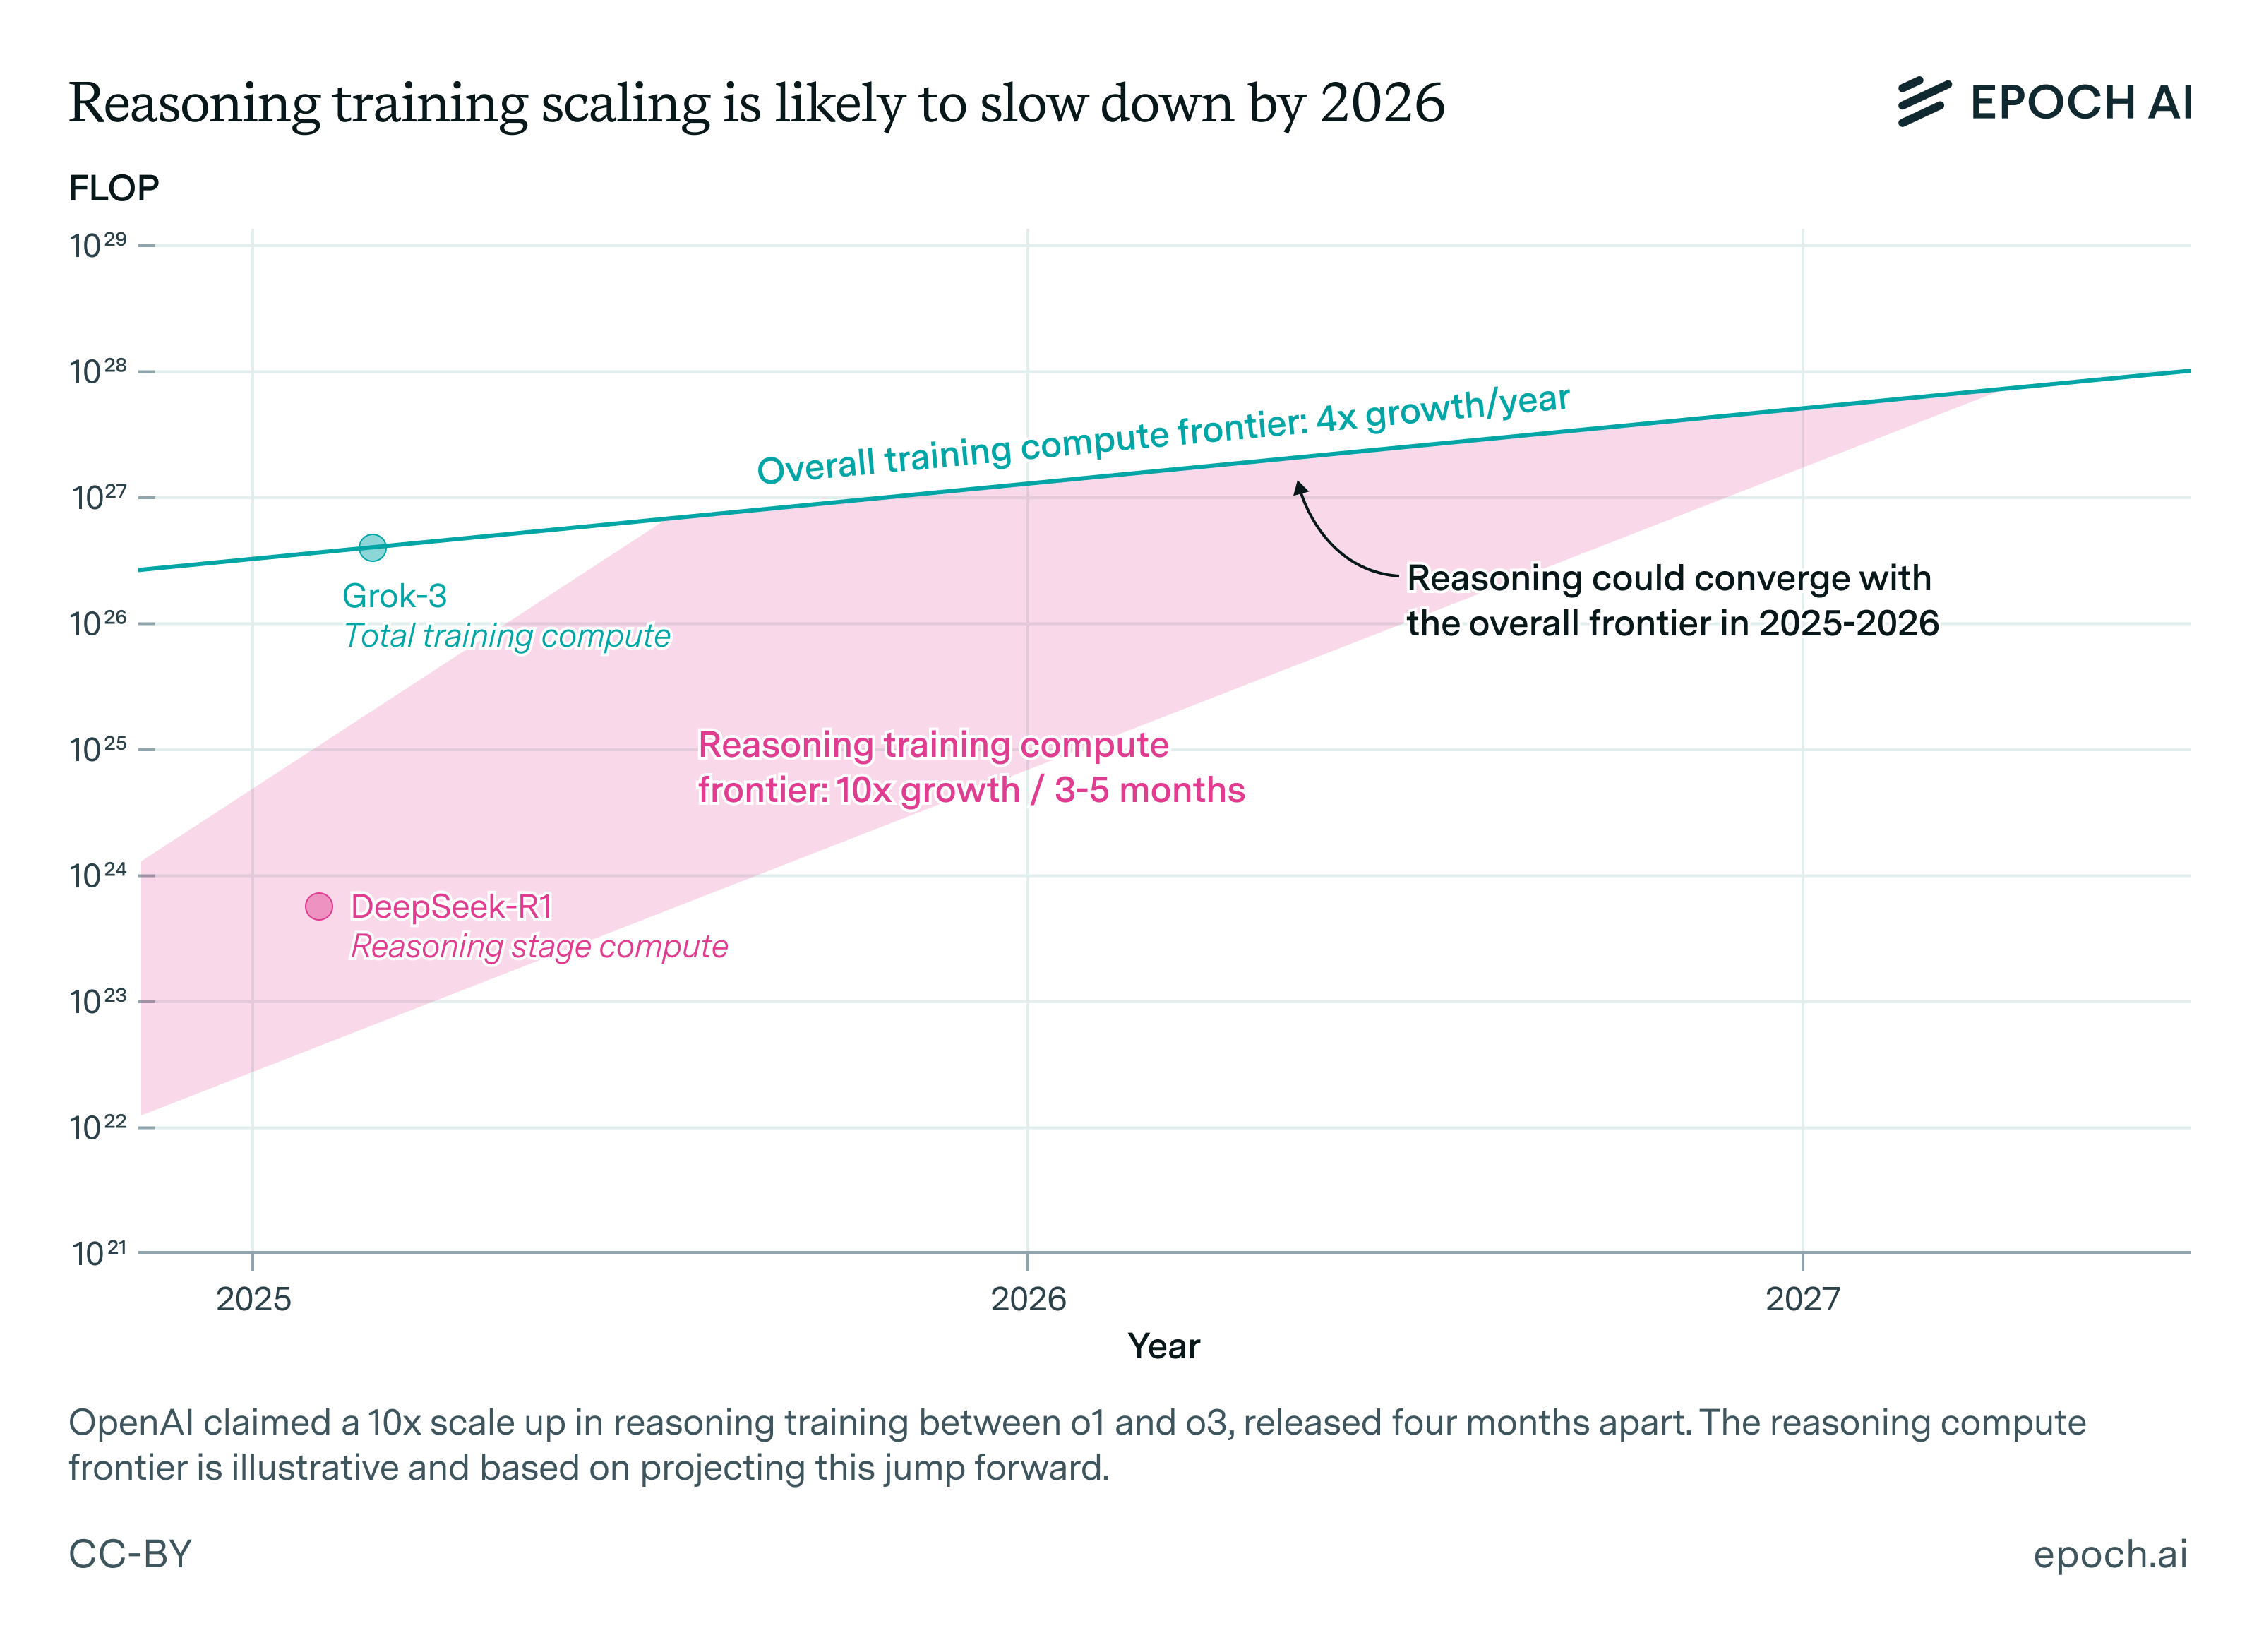
🠊 なぜ重要か:推論は、モデルの学習をスケールさせるきわめて重要な軸となり、数学やソフトウェア工学などで優れた成果をもたらしている。推論の成長には限界があることから、2024年と2025年の並外れた能力の伸びは、まもなく鈍るかもしれない。
「AIマンハッタン計画」はどこまで大きくなりうるか?
🠊 要点:Arden と Anson は、マンハッタン計画やアポロ計画での相対的な支出と比べて、米国の国家的なAIプロジェクトがどれほどの規模になりうるかを推定した。その結果、GPT-4 の1万倍の規模の学習実行が可能になりうると結論づけた。
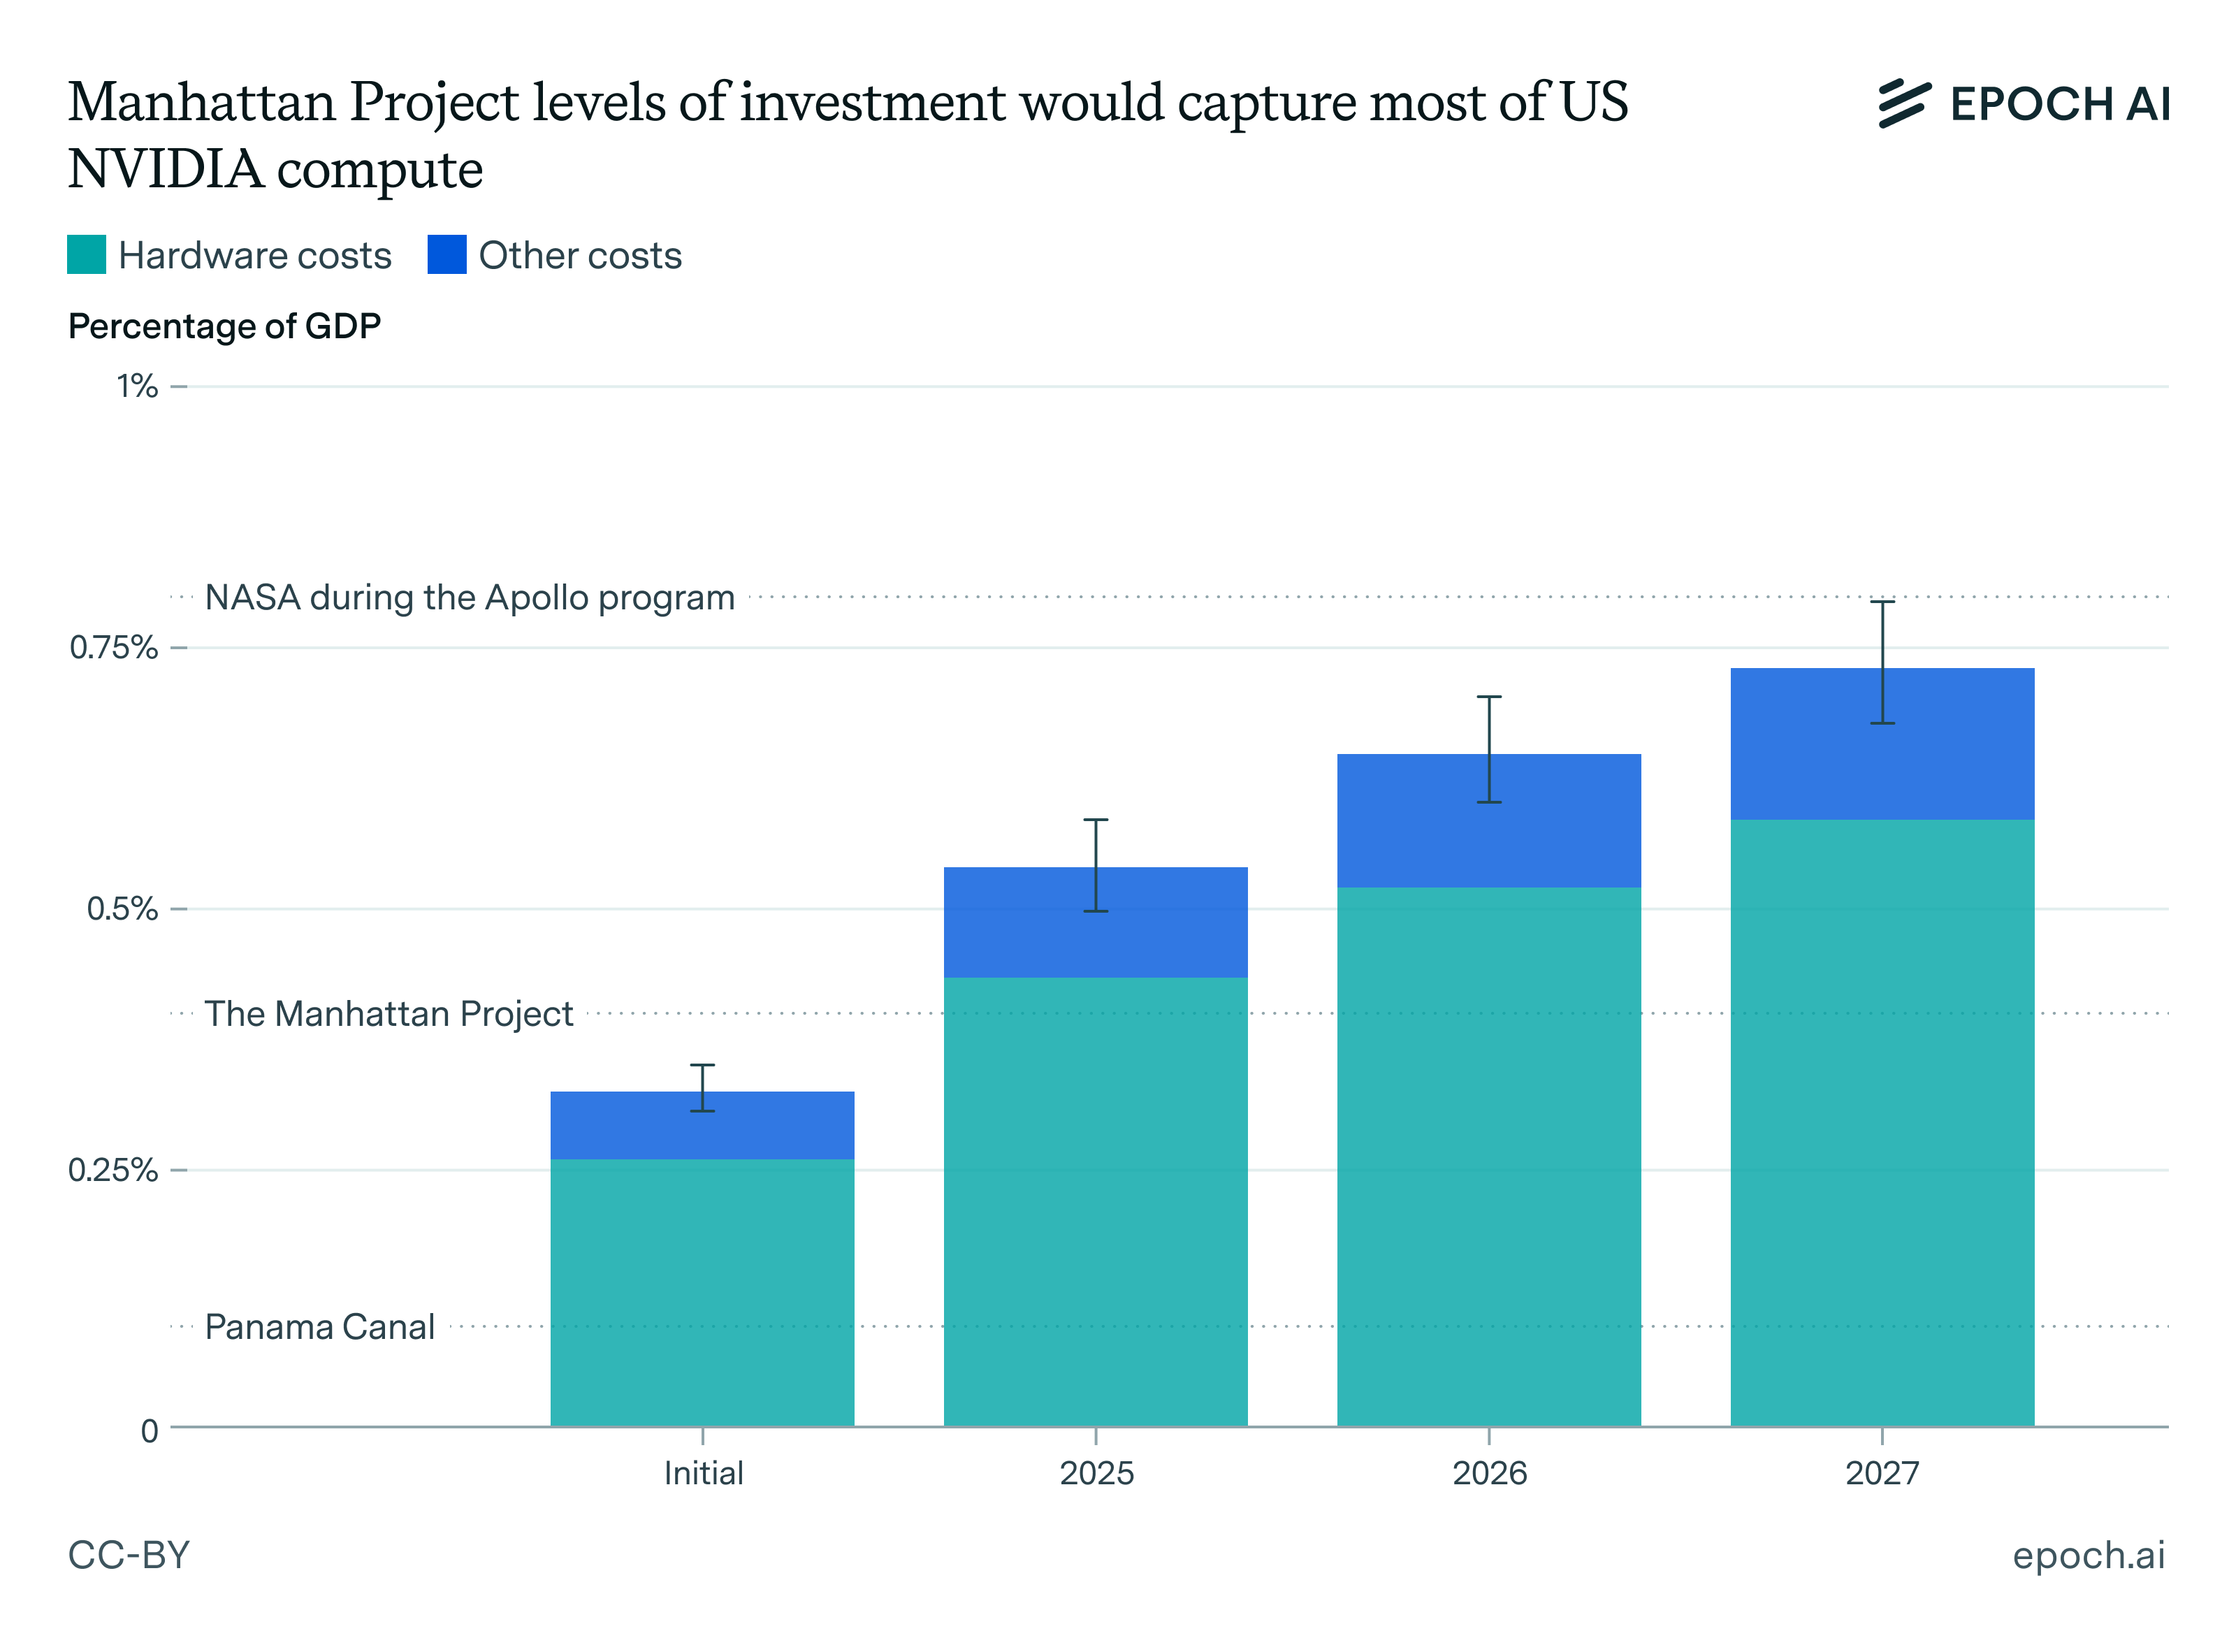
🠊 なぜ重要か:2024年11月、米中経済・安全保障調査委員会は議会への最重要の勧告として、「汎用人工知能の能力の獲得を競うことに特化した、マンハッタン計画のようなプログラムを設立し、資金を出す」ことを挙げた。この試算は、そうした国家プロジェクトがとりうる規模を具体的にとらえる手がかりになる。
AIがもたらす価値の大半は、研究開発ではなく幅広い自動化から生まれる
🠊 要点:Ege と Matthew は、AIが生み出す価値の大半は、研究開発を加速する能力ではなく、経済全体で多くのタスクを自動化する能力によってもたらされると論じた。関連して、1988〜2020年の期間に研究開発活動が生産性の伸びに寄与したのは、ささやかな程度にすぎなかったと言える。
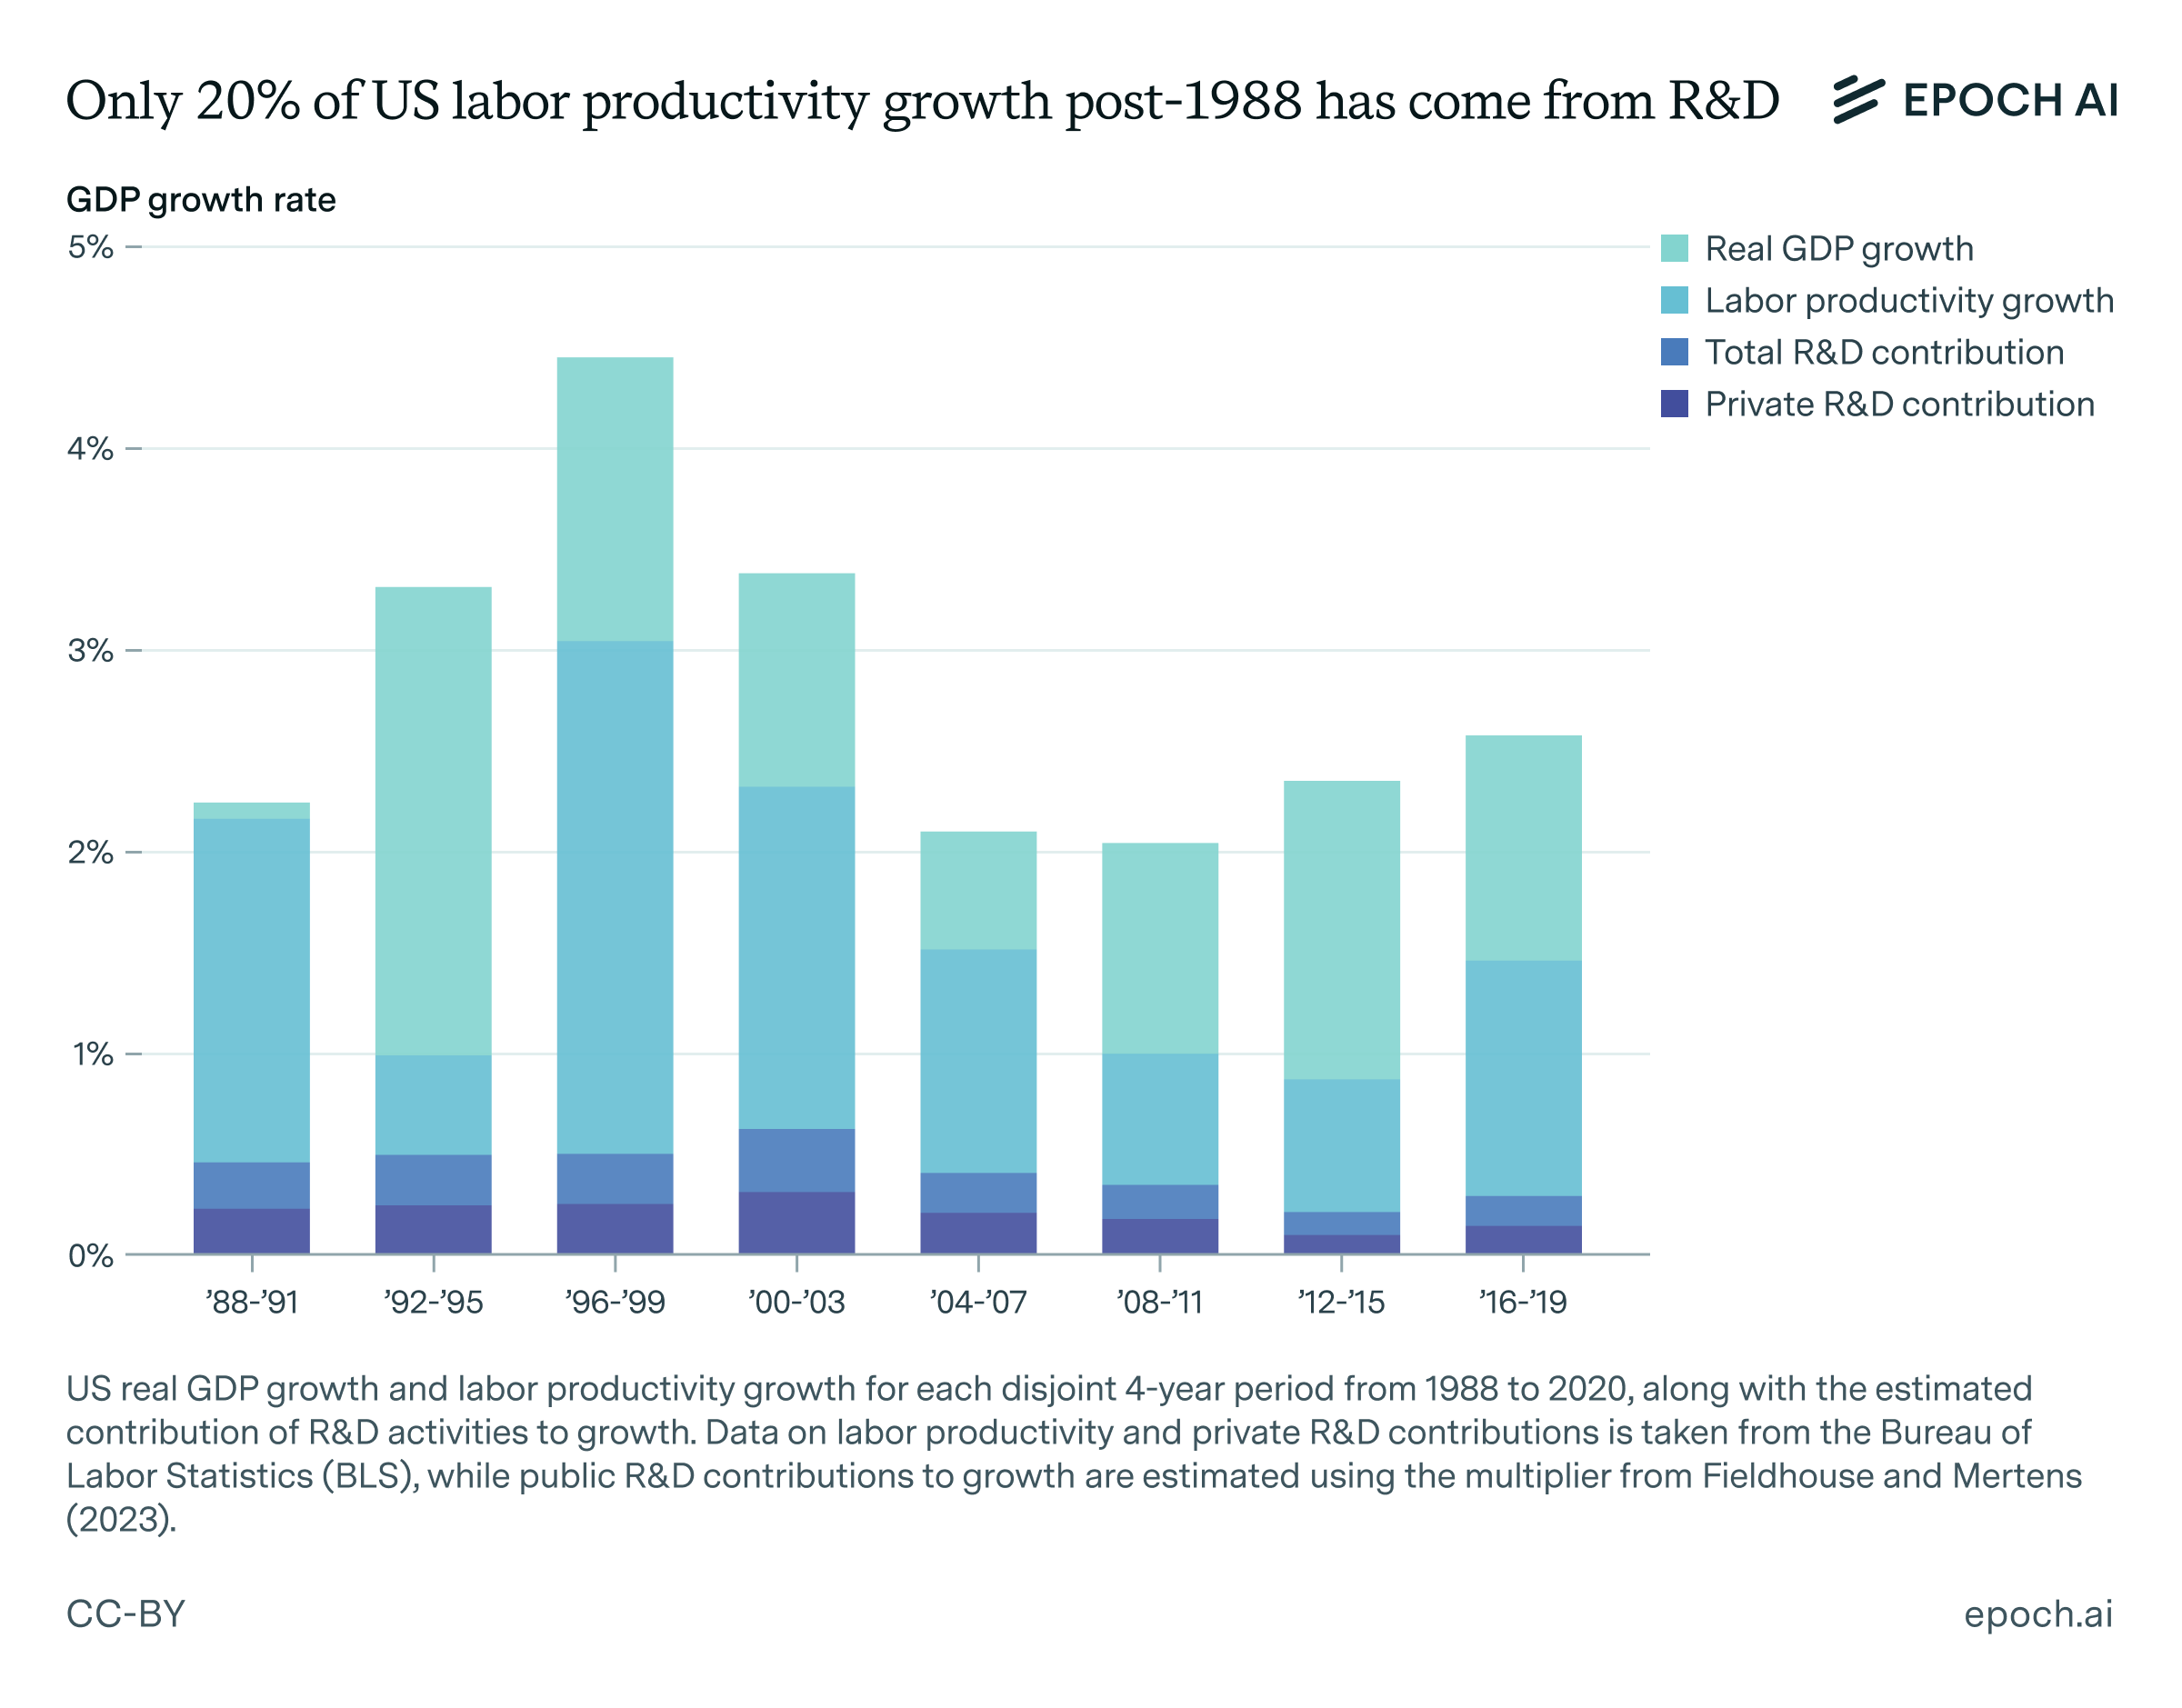
🠊 なぜ重要か:Sam Altman、Demis Hassabis、Dario Amodei が示したものなど、AIによる爆発的成長をめぐる多くの筋書きは、研究開発の自動化を成長の重要なてことして想定している。この見方に立てば、AIの影響は急速で目立ち、局所的なものになりうる。AIが研究開発の自動化に残る最後の障害を突然自動化し、AI企業の中で急速に大きな進歩を遂げるかもしれない、というわけだ。だがむしろ、AIが社会に影響を与えるのは主に、さまざまな組織が効率を高めようとAIを導入していく、数年から数十年続く広く緩やかな過程によってなのかもしれない。
私たちがデータインサイトと Gradient Updates を始めたのは、進行中の動きについてタイムリーな情報を届けるためである。
これらが急速に受け入れられたことをうれしく思う。私たちのWebサイトだけで、これらの新しい形式は50万回近く閲覧され、合計の閲覧時間は5,000時間近くに達した。また、Twitter での関連投稿は600万回を超えるインプレッションと25万件を超えるエンゲージメントを得た。これらはAIをめぐる議論の材料として広く使われてきた。
この1年の私たちの成果のどれかが役に立ったなら、ぜひ2025年 Epoch AI インパクト調査にご回答いただきたい! 来年も同じ情熱をもって、AIの傾向を世界に伝えるという使命への取り組み方を改善していく。
良い休暇を!
注
-
順位はWebサイトのページビューで決めた。これらの経路を通じたエンゲージメントのほうが多いので、ソーシャルメディアのインプレッションのほうが良い指標だったとも言える。Webサイトの閲覧数を選んだのは、手軽さのためと、定着した価値と見つけやすさの代理指標としてである。 ↩