
ニュースレター
推論モデルはどこまでスケールできるか?
原題:How far can reasoning models scale?
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
OpenAI の o3 のような推論モデルは登場から1年もたっていないが、能力はすでに急速に向上しており、OpenAI の研究者はこの進歩が続くと非常に楽観的に見ている。1 しかし、推論モデルの学習に使われる手法があとどれだけスケールできるのかははっきりしない。
この問いを調べてみた結果、私は推論の学習にはまだ拡大の余地があるが、OpenAI をはじめとするフロンティアAI開発企業が何桁も拡大できる見込みは低いと考えている。
推論の学習が、o1 から o3 への飛躍と同じく数か月ごとに10倍のペースで拡大し続ければ、遠からず、おそらく1年以内に、学習計算量全体のフロンティアに達する。その時点で拡大のペースは鈍り、学習計算量全体の伸び率である年約4倍に収束する。推論モデルの進歩も、そこから鈍化するかもしれない。
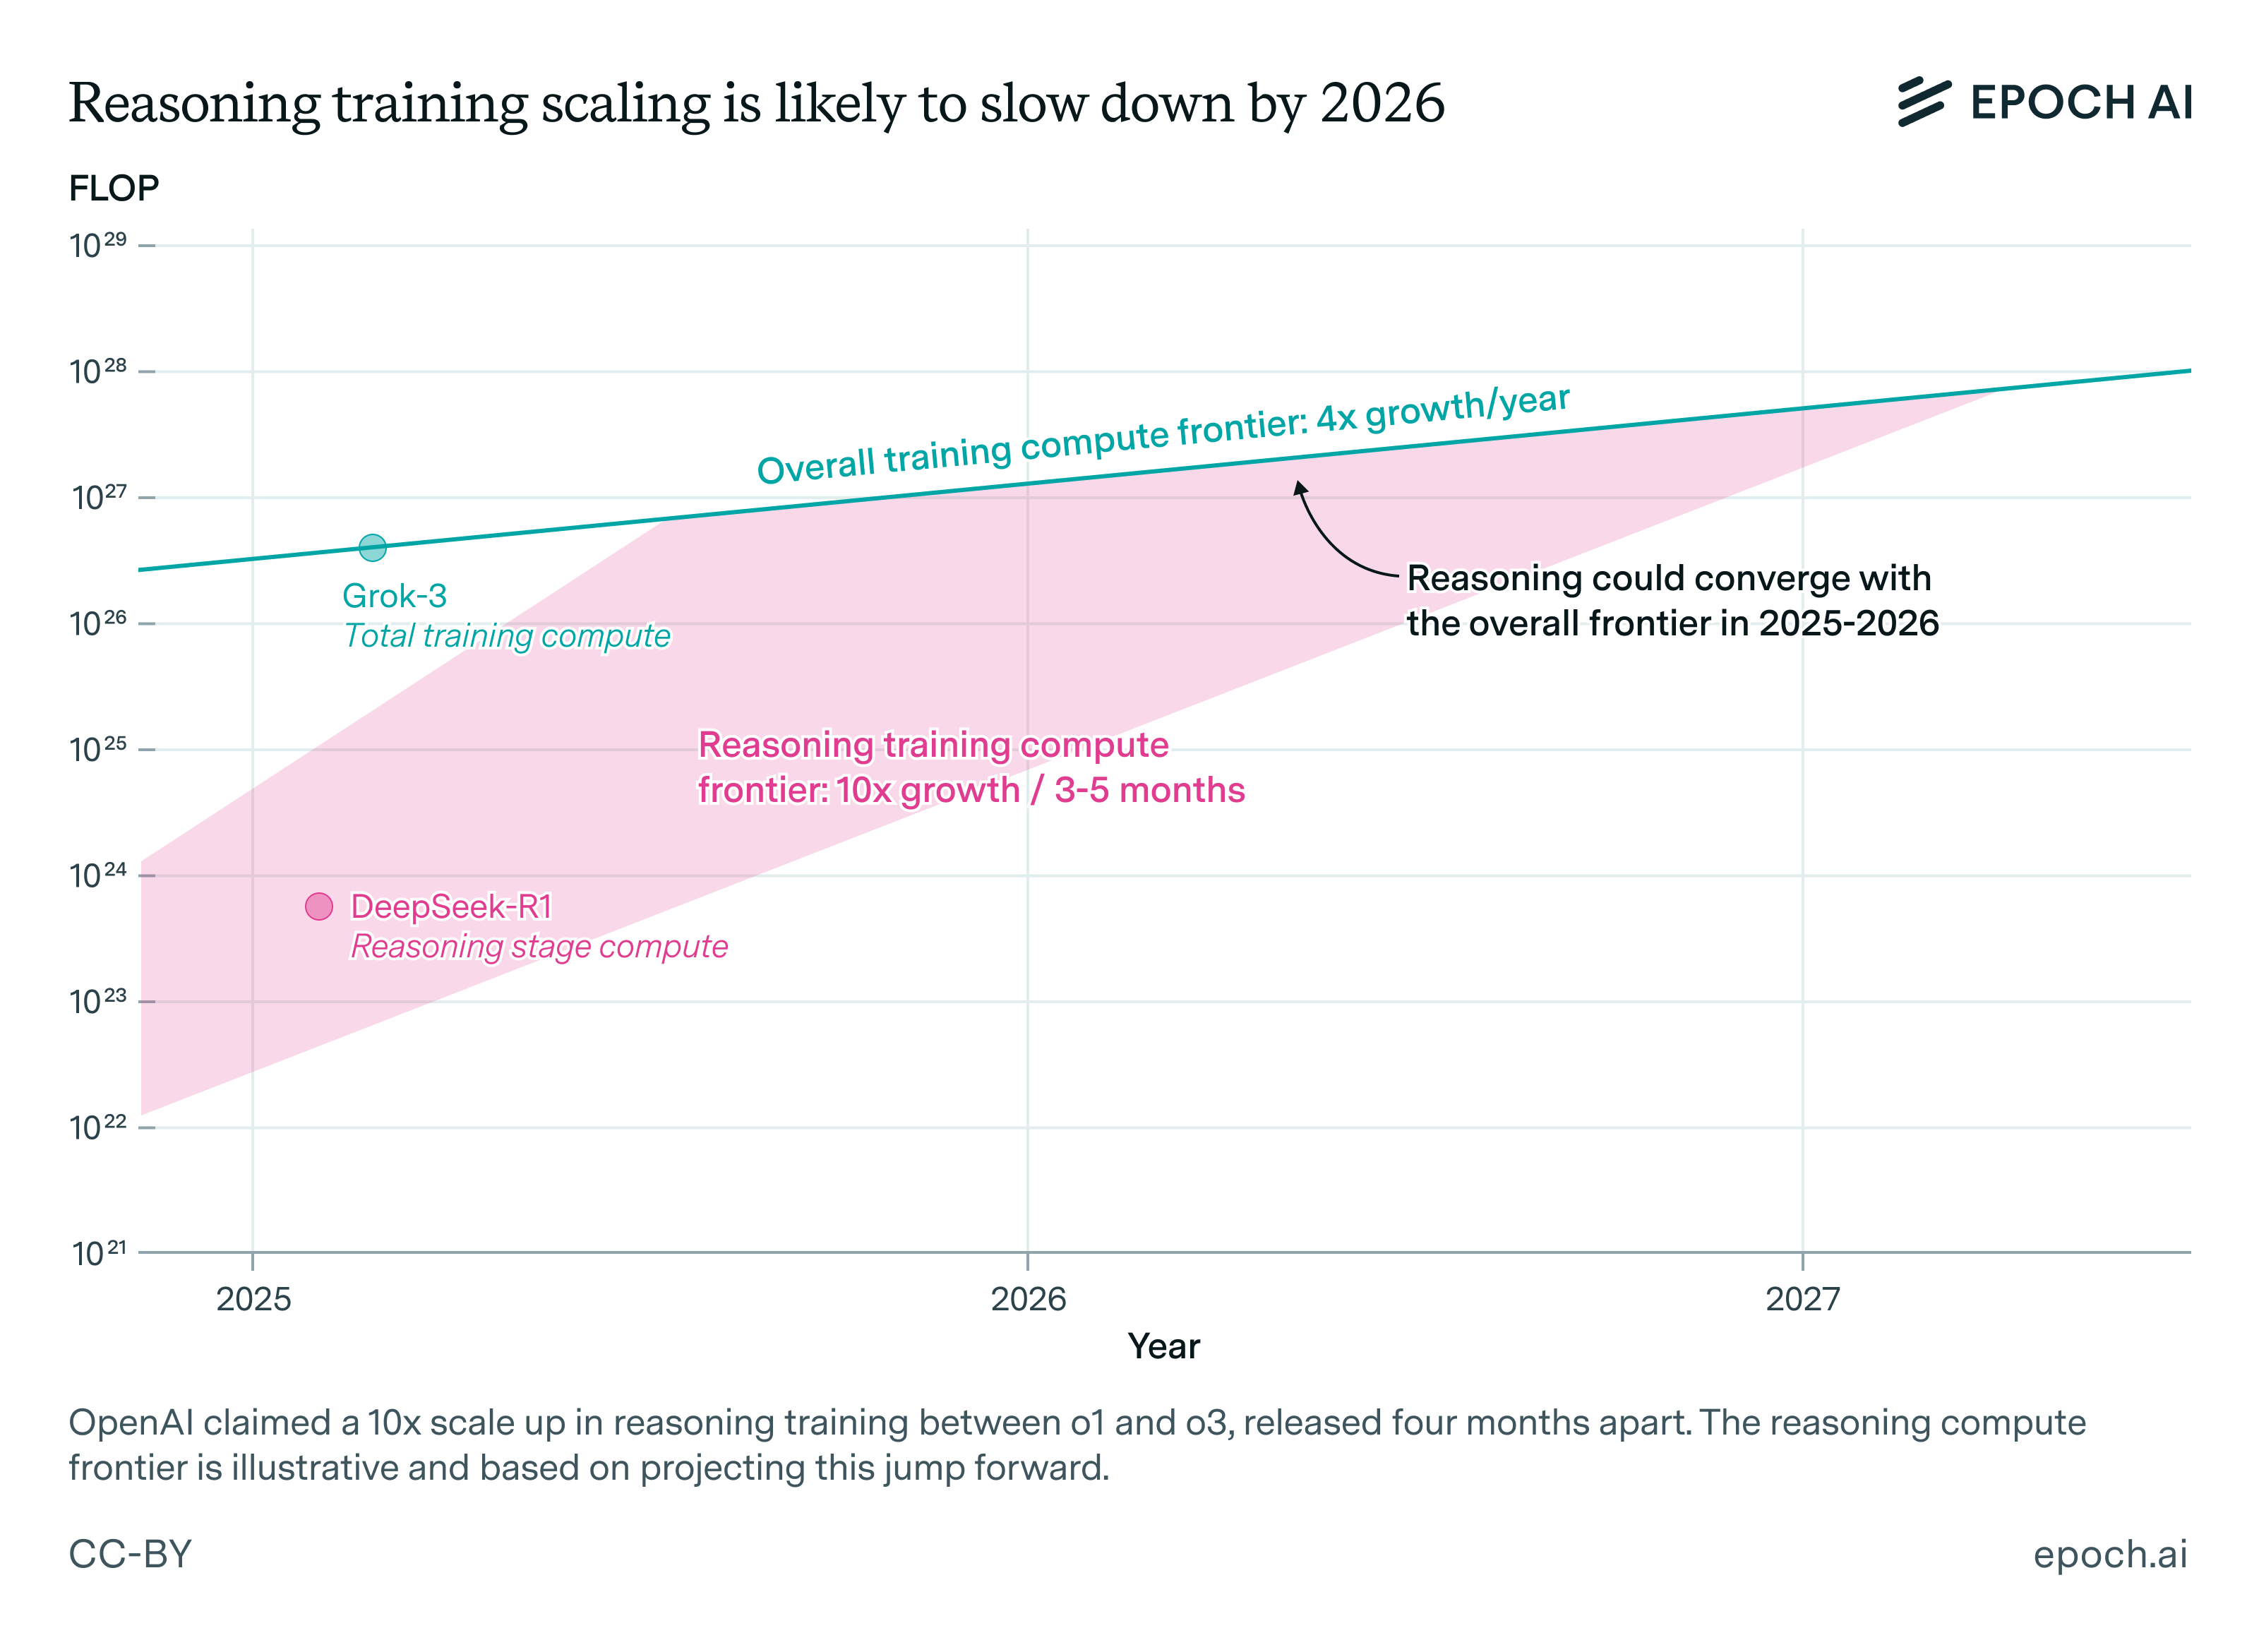
図1:o1 と o3 の間の飛躍と同程度の拡大が続いた場合に、推論の計算量の伸びがたどりうる軌跡の例。
Epoch AI の最新情報を受け取る 購読する
最先端の推論の学習にはどれだけの計算量が使われているか?
OpenAI の o3 などの推論モデルは、「事前学習」と呼ばれる工程で人間由来の膨大なデータを学習した従来型のLLMから開発された。その後、強化学習の段階に進み、難しい問題に対する解答にフィードバックを受けることで、推論の能力を高める。2 この第2段階を、本稿では「推論の学習」と呼ぶ。
歴史的に、学習計算量の拡大はAIの進歩のきわめて重要な要素だった。したがって、とくに推論の学習に現在どれだけの計算量が使われているのか、それがどこまで拡大できるのか、そしてそれがこれらのモデルの今後の向上に何を意味するのかを確かめておく価値がある。
残念ながら、推論モデルはAI業界で広く採用されているのに、その推論の学習に使われた計算量についての公開情報は乏しい。わかっているのは次のことである。
- OpenAI は、o3 の学習計算量は o1 の10倍だと述べている。これはほぼ確実に推論の学習の計算量を指している。o3 は o1 のわずか4か月後に公開された。
- o1 の推論の学習の計算量はわからないが、これと同等と言ってよいモデルである DeepSeek-R1 の学習計算量は推定してある。
- Microsoft の Phi-4-reasoning や Nvidia の Llama-Nemotron など、他のいくつかの推論モデルについても情報がある。
- Anthropic の Dario Amodei による、手がかりになりそうな発言がある。
以下、順に見ていく。
o1 から o3 への拡大
OpenAI は、AIME ベンチマークでの o3 と o1 の成績を、推論の学習に使われた計算量である可能性が最も高い量に対してプロットしたこのグラフを公開している。これによると、o3 の最終版は o1 の10倍の計算量で学習された。
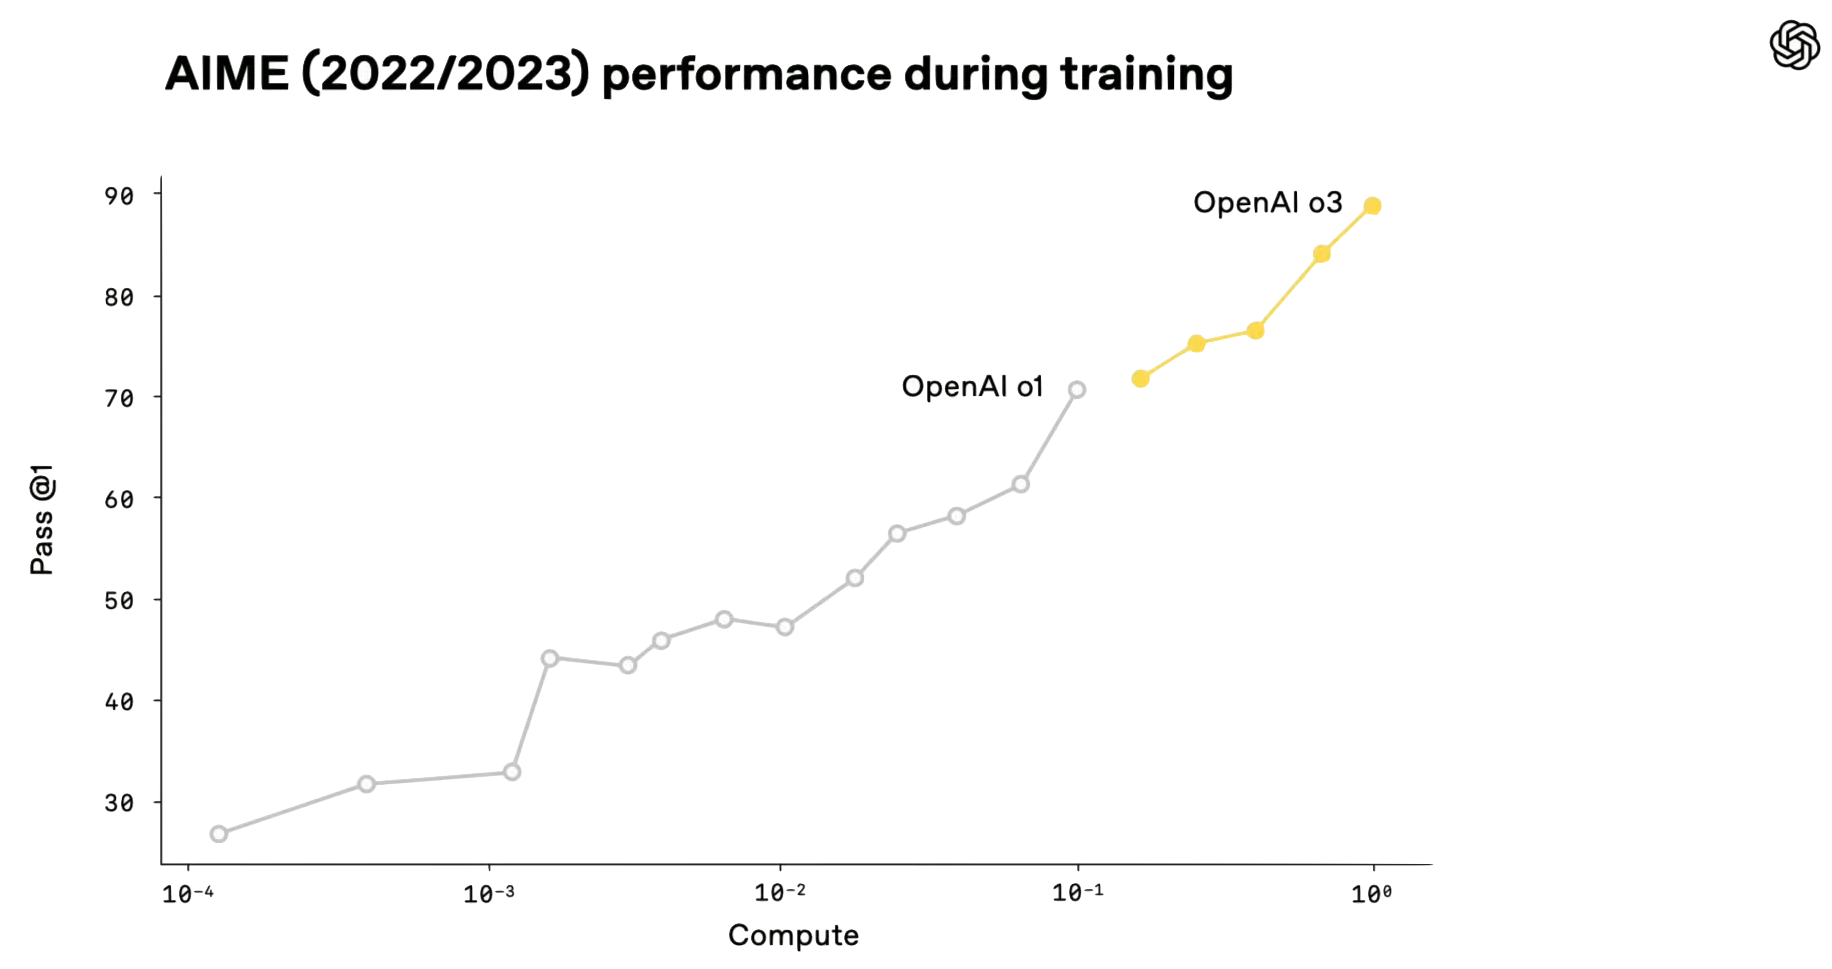
図2:OpenAI による o3 発表のライブ配信(18:45)より。発表者はグラフに示された以上の詳細を口頭で説明しなかった。
x軸は、総計算量ではなく推論の学習の計算量を示している可能性が高い。o1 の最初の版は o3 より計算量が4桁少ないのに AIME で約25%の得点を挙げており、x軸が総計算量を意味するならそれは考えにくいからである。3 また、x軸が総計算量だとすると、OpenAI が事前学習の段階を大きく途中で切り上げた o1 を何バージョンも学習したことになり、このグラフはあまり意味をなさない。
o3 が o1 の10倍の推論の計算量で学習されたのなら、その計算量は絶対値でどの程度なのか。確かな情報はないが、他の推論モデルやAI業界の内部関係者の発言に手がかりを探すことはできる。
DeepSeek-R1 からわかること
フロンティアAI開発企業の多くは、推論モデルの学習方法をあまり明らかにしていない。主な例外は DeepSeek とその推論モデル R1 である。
このニュースレターの以前の号で、Ege Erdil は、DeepSeek-R1 の強化学習による推論の学習には約6e23 FLOP(費用は約100万ドル)が使われ、約2兆トークンの生成が必要だったと推定した。これは DeepSeek-R1 のベースモデルである DeepSeek-V3 の事前学習の費用の約20%にあたる。
この推定には不確実な点が多いが、DeepSeek-R1 は o1 と非常によく似たベンチマークスコアを持つ推論モデルなので、参考になる。o1 の計算量を推定する際の基準として使うのは妥当かもしれない。
ただし、DeepSeek-R1 の推論の計算量は、さまざまな理由で o1 とは異なる可能性がある。両者のパラメータ数はおそらく異なる(どの程度違うかはわからない)。4 また、両者の推論の学習の段階が計算効率の点でどう違うかもわからない。5
他の推論モデルからわかること
学習の詳細が公開されている推論モデルとしては、ほかに Nvidia の Llama-Nemotron Ultra 253B と Microsoft の Phi-4-reasoning がある。
- Llama-Nemotron Ultra の強化学習による推論の段階には14万H100時間、約1e23 FLOP がかかった。元のベースモデルの事前学習の費用の1%未満である。6
- Phi-4-reasoning の推論の段階ははるかに小規模で、生成したのは約4億6,000万トークン、計算量は1e20 FLOP 未満、事前学習の計算コストの0.01%未満だった。7
どちらも優れたベンチマークスコアを持ち、Llama-Nemotron のスコアは DeepSeek-R1 や o1 に匹敵する。
しかし、合成データの存在があるため、これらの推定は o1 や o3 のようにフロンティアを押し上げた推論モデルについてはあまり参考にならないかもしれない。Llama-Nemotron と Phi-4-reasoning では、強化学習の段階の前に教師ありファインチューニングが行われ、質の高い推論過程の例で学習している。その多くは、他の推論モデルが生成した合成データだった。8
何が結論できるか?
全体として、これらが o1 や o3 の学習計算量をどれだけ明らかにするのかははっきりしない。
一つの教訓は、少なくとも強化学習の段階については、Phi-4 のように推論の学習の計算量が比較的小さいモデルもありうるということだ。だからといって o3 も同じくらい少ない計算量で学習されたことにはならないが、推論モデルがベンチマークで好成績を挙げたことだけから推論の計算量の規模を判断するのは難しい、とは言える。
また、昔ながらの教師ありファインチューニングも推論モデルの開発で大きな役割を果たしうる。このように手法が多様なので、学習の詳細が公開されていないモデルについて推論の学習の規模を推測するのは難しい。何を「推論の計算量」や「推論の学習」に数えるべきかもあいまいになる。推論モデルの最先端での向上をもたらしている主な要因はおそらく強化学習による学習なので、そこに注目すべきだろう。ただ、この点にはあまり自信がない。
既存の推論モデルがどの程度の計算量を使っているかについて、最後の手がかりとなるのは、o1 と DeepSeek-R1 の公開、o3 の発表を受けて、Anthropic の CEO である Dario Amodei が2025年1月に書いたエッセイである(強調は筆者)。
重要なのは、この種の強化学習は新しいため、私たちはまだスケーリング曲線のごく初期の段階にいるということだ。第2段階、つまり強化学習の段階に費やされている金額は、どのプレーヤーでも少ない。10万ドルの代わりに100万ドルを費やすだけで、大きな成果が得られる。各社はいま、第2段階を数億ドル、数十億ドルの規模へと急ピッチで拡大しようとしている。しかし、私たちが独特の「交差点」にいることを理解するのが肝心である。強力な新しいパラダイムがスケーリング曲線の初期にあり、それゆえ短期間に大きな成果を上げられるのだ。
10万ドルや100万ドルという数字が、o1、o3、DeepSeek-R1 のような特定のモデルの学習費用についての Amodei の見積もりを反映しているのか、単なる一般的な仮定の話なのかは、私にはわからない。また、Anthropic 以外のモデルの計算量について Amodei が抱いている見方は、おそらく Anthropic 自身のデータに基づく推測にすぎない。しかし、これまでの推論モデルの学習費用が「数億ドル」を大きく下回ると彼が考えていることは明らかである。数億ドルなら1e26 FLOP を超える。9
全体として、これらの推定と手がかりからすると、o1 の推論の計算量は、そしておそらく o3 のものも、これまでで最大規模の学習実行の規模をまだ下回っている。
ただし、計算量全体のフロンティアである1e26 FLOP 超から何桁も遅れているわけではないだろう。推論の段階で1e23 FLOP を超える計算量で学習されたモデルの例が2つ(DeepSeek-R1 と Llama-Nemotron Ultra)あるからだ。o1、とくに o3 は、さらに多くの計算量で学習されたかもしれない。
推論の計算量の規模はAIの進歩に何を意味するか?
推論モデルの現在の計算量の規模は、近い将来のAIの進歩に重要な意味を持つ。推論の学習の規模がまだ比較的小さいなら、短期間のうちに、規模の面でも実際の能力の面でも急速な拡大が見られるかもしれない。
o3 は o1 の10倍の計算量を使い、しかも o1 より大幅に高い能力を持つことがわかっている。標準的な数学、科学、コーディングのベンチマークでのスコアも向上している。METR のエージェント型ソフトウェア・コーディングタスク群でも、o3 は o1 よりはるかに優れている。
事前学習のスケーリング則とは違い、推論の学習のスケーリング則についての厳密な研究を私は知らない。しかし OpenAI は、古典的な対数線形のスケーリング則によく似たスケーリング曲線を示している(下の図3と上の図2を参照)。DeepSeek-R1 の論文の2番目の図も、推論の学習のステップ数とともに正答率がおおむね対数線形に上がることを示している。ここから、少なくとも数学とコーディングのタスクでは、推論の学習を増やしたときの性能の伸び方は事前学習と同じようなものだと考えられる。したがって、今後数回の拡大で、劇的かつ急速な向上が見られるかもしれない。
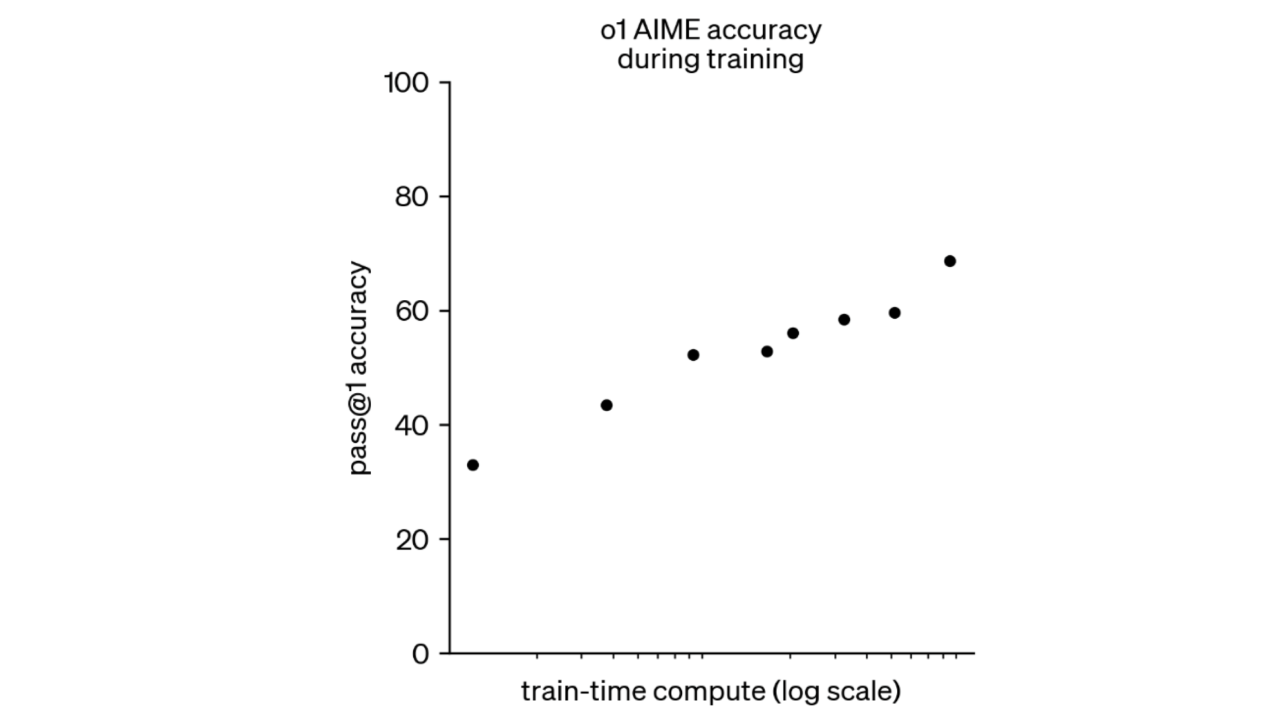
図3:学習計算量に対する o1 の AIME の成績。出典:OpenAI
推論の計算量が学習計算量全体の規模に達すれば、その伸び率は(o1 から o3 への飛躍のような)数か月ごとに10倍ではなく、全体の伸び率である現在年約4倍に収束する。
したがって、推論の学習が全体のフロンティアより数桁(たとえば3桁未満)低いだけなら、この伸び率は1年ほどのうちに鈍化しうる。10
推論は本当にスケールできるのか?
もちろん、推論の拡大は、単にGPUを多く割り当てれば済むほど簡単ではない。データの制約で拡大が止まる可能性もある。推論の学習では難しい問題に答えるようモデルを学習させるが、適した問題が無限にあるわけではない。拡大を続けるのに十分な多様な問題を見つける、書く、あるいは合成で生成するのは難しいかもしれない。
推論の学習が、数学やコーディング以外の、もっと境界のあいまいな領域にどれだけ汎化するかもきわめて不確かである。11 ほかにも予期しない問題が起こりうる。
関連する問題として、推論モデルの開発にかかる総計算コストが、本番の学習実行の直接の学習コストをはるかに上回るかもしれないことがある。どの問題、報酬モデル、その他の手法が実際に機能するかを確かめるために、AI研究所が多数の実験を並行して行わなければならない場合には、そうなりうる。
本稿ではここまで推論の学習の直接のコストを推定しようとしてきたが、実のところ、OpenAI が推論モデルの学習計算量をどう測っているのかはわからない。また、比較的透明性の高い開発企業についてさえ、研究コストの情報はまったくない。
推論のパラダイムが成熟するにつれて、これらのコストはおそらくある程度収束していく。研究コストがあるからといって、直接の計算量の規模と能力の関係が成り立たなくなるわけでもない。しかし、研究に恒常的な上乗せのコストが必要なら、推論モデルは期待されるほどにはスケールしないかもしれない。
逆に、計算量の伸びが鈍化したあとも、推論モデルが急速に向上し続ける可能性もある。これまでの推論モデルの進歩の大部分は、実はデータやアルゴリズムの革新によるものだったのかもしれない。とはいえ、計算量の急速な拡大は推論モデルの進歩のきわめて重要な要素である可能性があるので、注意深く追う価値がある。
参考までに言えば、OpenAI の研究者たちは(上で触れた Dario Amodei とともに)、推論モデルを急速に拡大してさらなる向上をもたらせると、現時点で自信を示している。こうした内部関係者は次の世代の推論モデルを直接知っているので、o3 が規模の面でも能力の面でも天井に達していない可能性はきわめて高いと私は考える。
注
-
o1-preview を最初の推論モデルとみなした場合である。ただし、先駆けと言えるものもある。o1-preview は「推論モデル」という言葉を広め、それまでのフロンティアからベンチマークスコアを大きく伸ばした最初のモデルだった。 ↩
-
推論モデルも非推論モデルも、能力や性格を形づくるために RLHF など他の形の事後学習も経る。 ↩
-
AIME は難しい数学コンテストで、フロンティアモデルも2024年後半までは苦戦していた。したがって、全体でそれほど少ない計算量しか使っていないモデルは、AIME をほとんど解けない可能性が高い。とくに、それが小型で効率的なモデルではなく、フルサイズの o1 モデルのチェックポイントであればなおさらである。AIME を模したテストである OTIS Mock AIME の私たちのベンチマーク結果も参照。 ↩
-
o1 の推論実行コストははるかに高いので、おそらく o1 のほうが大きい。そうであれば、トークン量が同じでも推論の学習の費用は高くなる。 ↩
-
DeepSeek のほうが学習効率が高いかもしれない。OpenAI より計算資源へのアクセスが限られているので、効率を高める方向に圧力がかかるからである。しかし、OpenAI は推論モデルを切り開いた企業で、報道によれば2023年から推論モデルに取り組んでいるので、OpenAI のほうが効率的かもしれない。 ↩
-
Nvidia によれば、強化学習による推論の段階には14万H100時間かかった。H100 は16ビットで毎秒約1e15 FLOP、8ビットで2e15 FLOP/s を処理できる。Nvidia によれば、生成は FP8、重みの更新は BF16 で行われた。16ビットの数値を使い、稼働率を30%と仮定すると(大規模な学習では30〜40%になることが多いが、強化学習による推論の学習の稼働率は異なるかもしれない)、14万H100時間は1.5e23 FLOP になる。Llama-Nemotron Ultra はもともと Llama 3.1 405B から開発されたもので、Llama 3.1 405B は4E25 FLOP で学習された。 ↩
-
技術レポートによれば、Phi-4 は強化学習の90ステップで学習され、各ステップで64問それぞれについて8本の軌跡を生成した。平均の応答長が1万トークンなら、これはわずか 90648*10000 = 4億6,000万トークンである。パラメータ1個・トークン1個あたり6 FLOP という目安を使うと、強化学習の計算量はおよそ 6 * 14b * 460m = 4e19 FLOP になる。1万トークンは図7のトークン長のグラフを見た目で読んだ中央値だが、これが実際の平均かどうかははっきりしない。 ↩
-
Llama-Nemotron は DeepSeek-R1 が生成したデータで、Phi-4-reasoning は o3-mini のデータで学習された。 ↩
-
DeepSeek-V3(3e24 FLOP)の学習にかかった計算コストを償却ベースで見ると、GPU1時間あたり2ドルという標準的なクラウド価格で約600万ドルだった。したがって数億ドルはその約100倍の規模、つまり1e26 FLOP 程度になる。 ↩
-
これを図1に示した。現在のフロンティアが DeepSeek-R1 付近にあり、3〜5か月ごとに10倍のペースで伸び続けるなら、推論の学習の計算量はおそらく2026年までに全体のフロンティアに収束する。 ↩
-
この点についての詳しい議論は、Matthew Barnett による Gradient Updates の過去の号と、Helen Toner のブログ記事を参照。 ↩