
ニュースレター
ChatGPTはどれだけのエネルギーを使うのか?
原題:How much energy does ChatGPT use?
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
調査と計算に多大な協力をしてくれたAlex ErbenとEge Erdilに感謝する。今号で「私たち」と書く箇所は、共同での判断を指す。
ChatGPTのクエリ1件を処理するには約3ワット時の電力が必要で、これはGoogle検索の10倍にあたる、という主張がよく引用される。1 この数字は、AIが環境や気候変動、電力網に与える影響を懸念する文脈で持ち出されることが多い。
しかし私たちは、クエリ1件あたり3ワット時というこの数字は過大評価である可能性が高いと考える。今号では、同様の方法論を用いつつ、最新の事実とより明確な仮定に基づいてこの問題を検討し直す。その結果、GPT-4oを使う典型的なChatGPTのクエリの消費電力量はおそらく約0.3ワット時であり、従来の推定の10分の1であることがわかった。この違いは、2023年初めと比べてモデルとハードウェアの効率が上がったことと、元の推定がトークン数をあまりに悲観的に見積もっていたことによる。
参考までに言えば、0.3ワット時は、LED電球やノートパソコンが数分間に消費する電力量よりも少ない。チャットを頻繁に使う人でも、ChatGPTのエネルギーコストは、先進国の住民の電力消費全体から見ればごく一部にすぎない。米国の平均的な世帯2は年間10,500キロワット時、1日あたり28,000ワット時超の電力を使っている。3
この0.3ワット時という推定は、実は比較的悲観的な(つまりエネルギーコストを高めに見積もる側に寄せた)ものであり、多くの、あるいは大半のクエリは実際にはさらにずっと少ないエネルギーで済んでいる可能性がある。ただし、これは用途によって異なる。入力が長いクエリや、出力が長いクエリ(推論モデルを使う場合など)は、0.3ワット時よりかなり多くのエネルギーを使うかもしれない。また、将来のモデルの学習と推論実行は、今日ChatGPTを使うよりはるかに多くのエネルギーを消費するかもしれない。
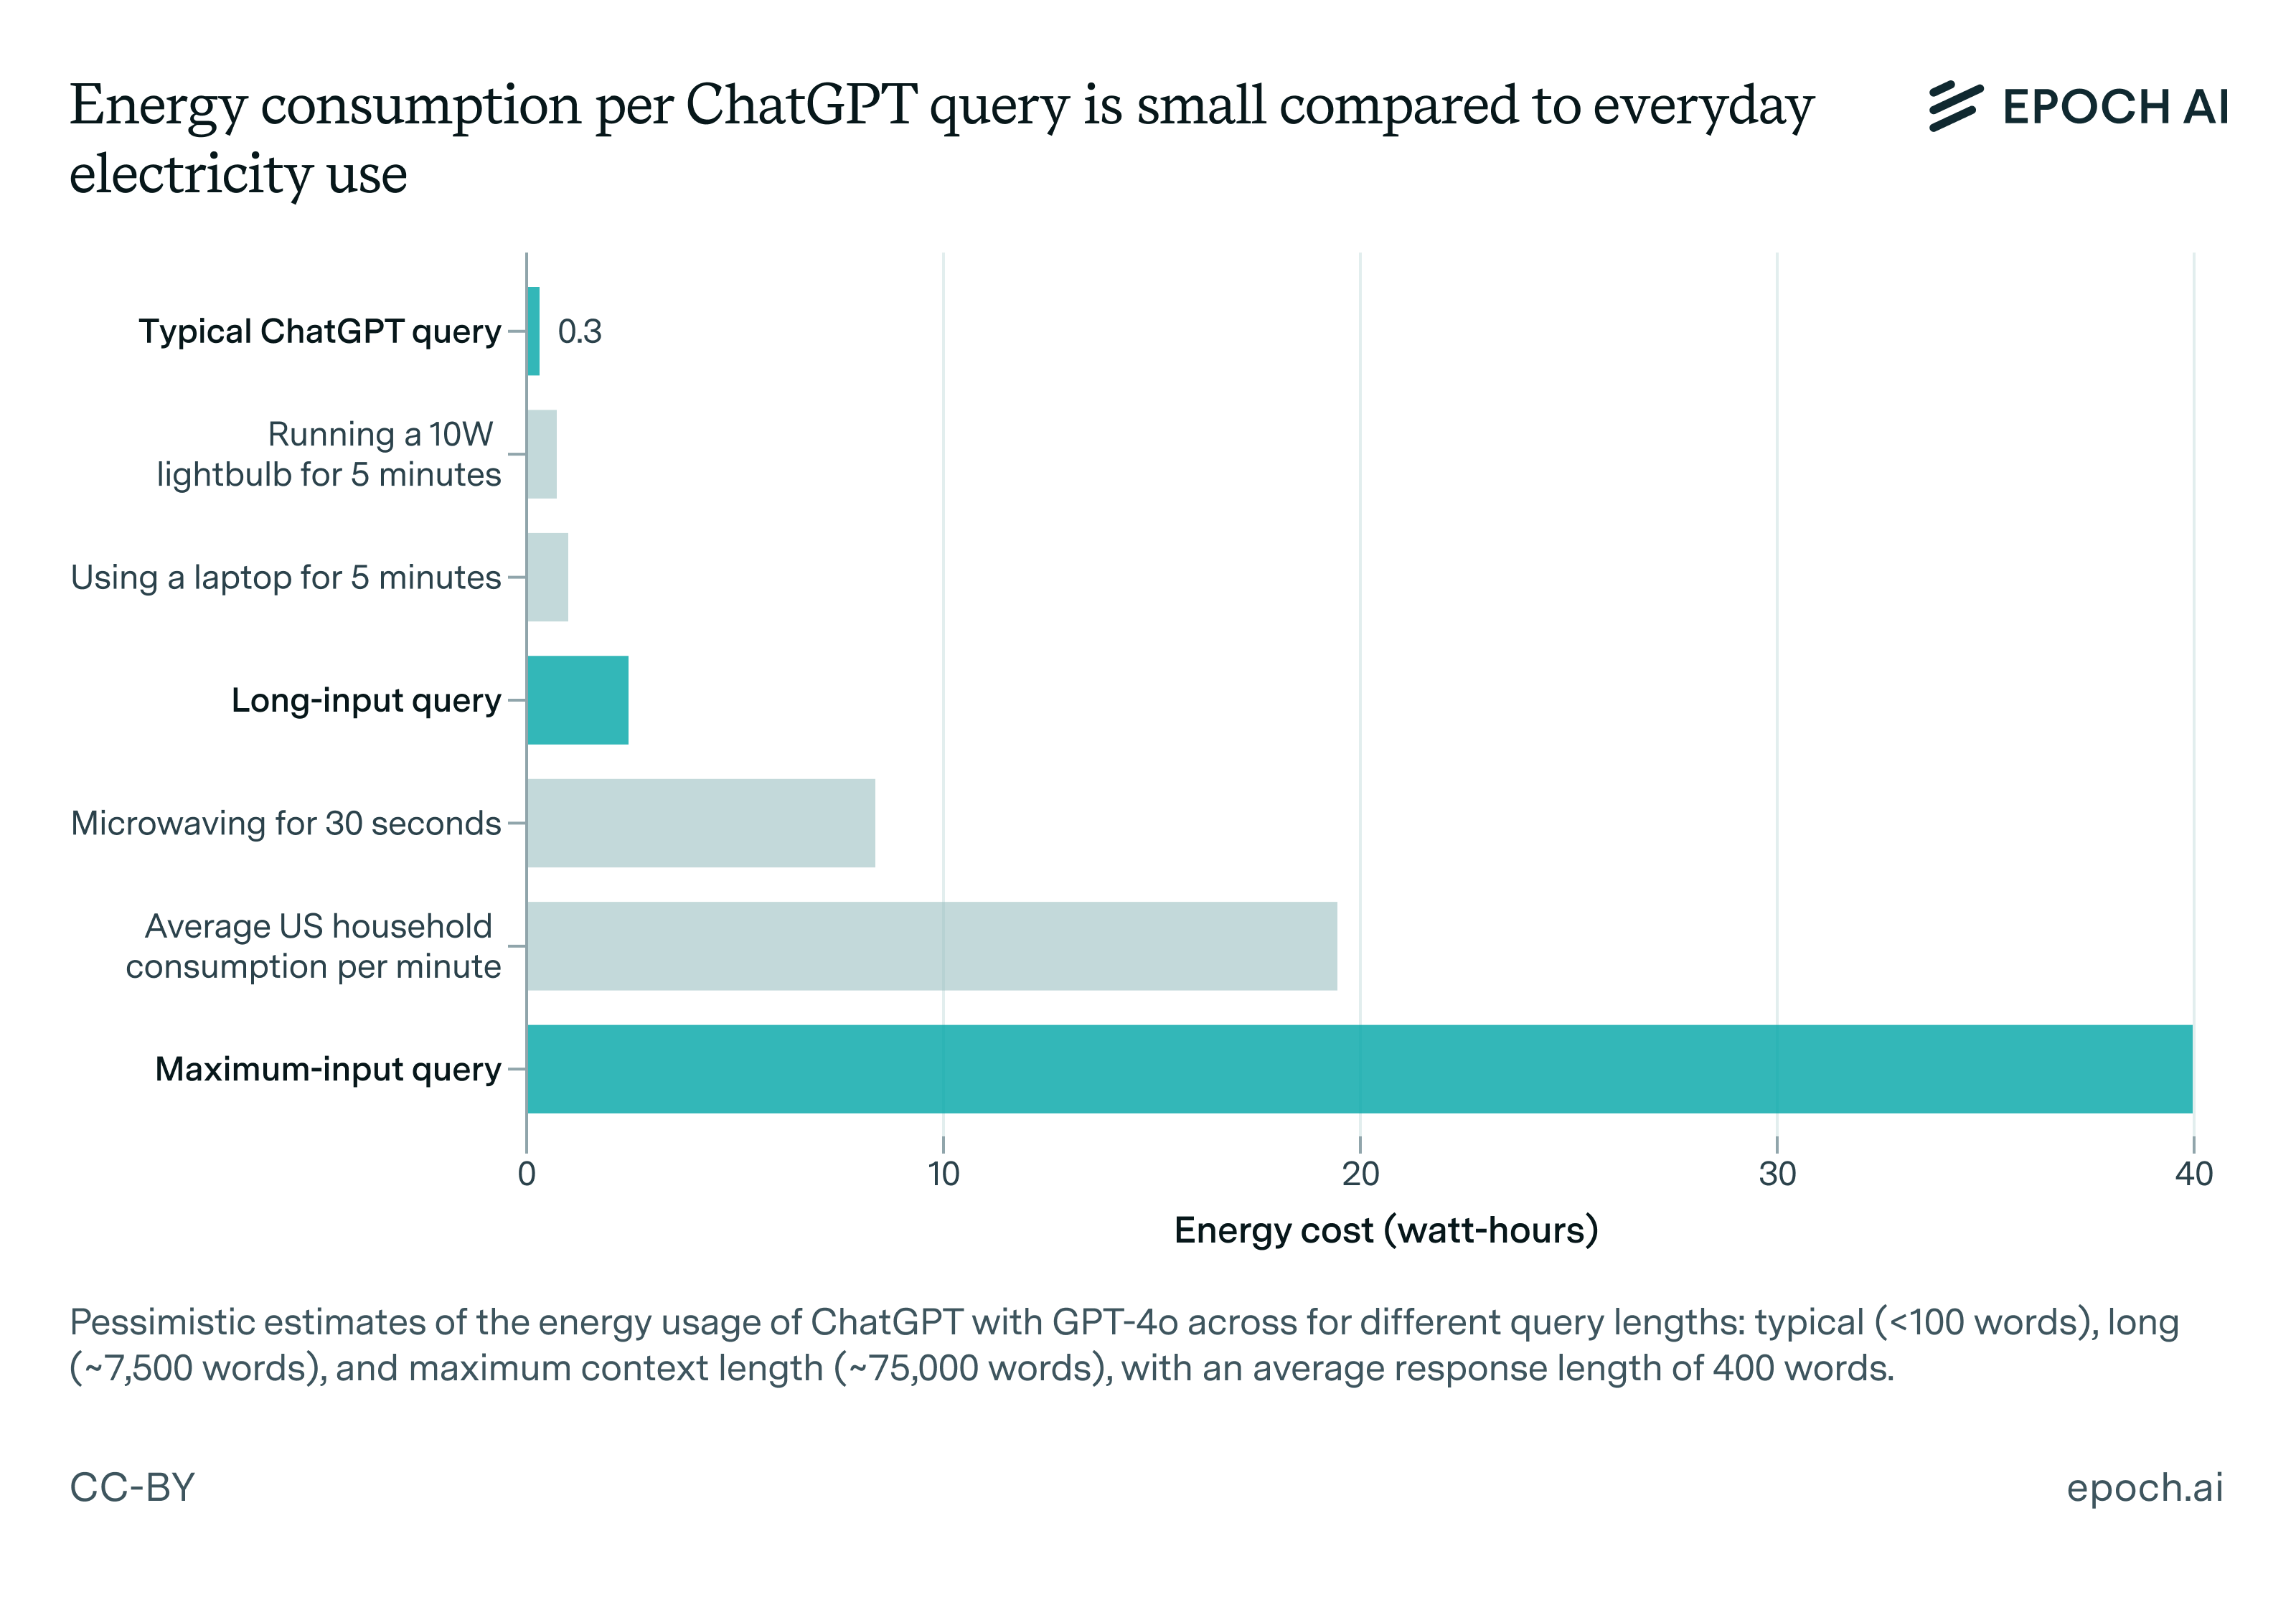
日常的な電力使用の出典については、こちらのスプレッドシートを参照してほしい。
Epoch AI の最新情報を受け取る 購読する
クエリ1件のエネルギーコストを推定する
ChatGPTをはじめとするチャットボットは、大規模言語モデル(LLM)で動いている。これらのモデルを動かす(これを推論実行(インファレンス)とも呼ぶ)には計算資源が必要であり、その計算を処理するチップとデータセンターは、おおむね必要な計算量に比例して電力を消費する。
以下では、ChatGPTのクエリ1件の計算コストとエネルギーコストを推定する手順を、要点に絞って順に説明する。すべての仮定の根拠を示した詳しい版は付録にある。
-
ChatGPTは実際には複数の異なるモデルで動いているが、ここではGPT-4oを基準のモデルとする。これが今もOpenAIの主力の汎用モデルだからである。OpenAIの新しい推論モデル(o1、o3-mini、そして近く公開されるo3)はおそらくより多くのエネルギーを必要とするが、少なくとも現時点では、利用はそれほど多くないと思われる。特に、OpenAIの新製品Deep Researchは、利用回数に制限があり月額200ドルのプランが必要だが、通常のChatGPTのクエリよりはるかに多くの計算資源を使うことは確実である。一方、GPT 4o-miniはGPT-4oより小さく安価である。これらの他のモデルについては、後の節で詳しく論じる。
-
LLMはトークンと呼ばれる単位で出力を生成する。OpenAIの場合、1トークンは平均で0.75語にあたる。浮動小数点演算回数(FLOP)は計算量を測る標準的な単位であり、1トークンを生成するには、モデルのアクティブパラメータ1つにつき約2 FLOPが必要になる。私たちは以前、GPT-4oの総パラメータ数を約2,000億(おそらく1,000億〜4,000億の間)と推定した。また、GPT-4oは混合エキスパート(mixture-of-experts)モデルである可能性が非常に高く、その場合、すべてのパラメータが同時に使われるわけではない。悲観的に総パラメータ数の高いほうの推定値をとり、一度に使われるのがその¼だと仮定すると、アクティブパラメータは1,000億となる。つまり、1トークンの生成には2 * 1,000億 = 2,000億FLOPが必要になる。
-
私は、典型的なクエリ1件あたりの出力トークン数を500トークン(約400語、タイプした文章でおよそ1ページ分)と仮定する。これはやや悲観的な値である。たとえばChiangらは、チャットボットの会話のデータセットで平均応答長が261トークンだったと報告している。また、この仮定はテキストでの会話を前提にしている。GPT-4oの高度な音声モードでの会話にどれだけのトークンが必要かは不明であり、画像生成のコストもここでは考慮しない。
-
以上から、出力500トークンのGPT-4oのクエリには500 * 2 * 1,000億 = 1e14 FLOPが必要になる。入力が長いクエリにはさらに追加のコストがかかるが、これについては後で論じる。
次に、必要なAIチップの消費電力をもとに、この計算のエネルギーコストを求める。
-
OpenAIはChatGPTの推論実行にNvidia H100 GPUを使っていると仮定する。H100の定格電力は700ワットだが、サーバーとデータセンターのオーバーヘッドがあるため、H100クラスタはGPU 1基あたり最大約1500 Wを消費しうる。4
-
H100は最大で毎秒989兆(9.89e14)FLOPを実行できる。この速度なら、クエリ1件の処理にかかるH100の稼働時間は1e14 / 9.89e14 ~= 0.1秒となる(ただし実際には多数のクエリがバッチでまとめて並列処理されるので、生成の開始から終了までにかかる時間はこれよりずっと長い)。
-
しかし、GPUは実際には最大のFLOP/秒を達成できない。私は推論実行クラスタの典型的な利用率の大まかな推定値として10%を用いる。これにより、クエリの処理に必要なGPUの数は10倍になり、ChatGPTのクエリ1件の処理にはH100の稼働時間がおよそ1秒必要になる。
-
その反面、実際にはGPU 1基あたりの平均消費電力は1500 Wを下回る。文献にある推定の一つは、推論実行用のGPUが平均してピーク電力の70%程度を消費する可能性を示している。5
まとめると、クエリ1件あたりH100の稼働時間1秒、H100 1基あたり1500ワット、電力利用率70%から、エネルギーは1050ワット秒となり、クエリ1件あたり約0.3ワット時になる。広く引用される3ワット時という推定の約10分の1である!
最後に考慮すべき要素は、入力トークンの処理コストである。手で入力した簡単な質問なら無視できるが、入力が非常に長い場合、入力の処理は出力の生成コストと比べて無視できない大きさになる。チャットボットの用途には、大きな文書やコードベースなどのデータをアップロードするものもあり、GPT-4oは最大128,000トークンの入力ウィンドウに対応している。
付録では、10kトークンの長い入力(短い論文や長めの雑誌記事程度)があると、クエリ1件あたりのコストは約2.5 ワット時まで大きく増えると推定している。100kトークン(およそ200ページ分の文章)という非常に長い入力なら、40ワット時近いエネルギーが必要になる。なお、この入力処理は最初に一度だけかかるコストなので、長い文書をアップロードした後にチャットで長くやりとりしても、メッセージごとにこのコストがかかるわけではない。さらに、入力が非常に長くなったときに入力処理のコストが膨らむ度合いは、ほぼ確実に大幅に抑えられる。ただ、OpenAIがすでにそうした改善を取り入れているかどうかはわからない。6
なぜ私たちの推定は他と違うのか
3ワット時という元の推定は、多くのさまざまな研究者やメディアに広く引用されてきたが、その出所はAlex de Vries(2023)である。
私たちの推定が異なる最大の理由は、典型的なチャットボットの使い方における出力トークン数について、より現実的な仮定を用いていることである。また、より新しく効率の高いチップ(A100ではなくNVIDIA H100)と、アクティブパラメータがいくらか少ないモデルを前提にしている。
元の推定でDe Vriesは、ChatGPTの推論実行の計算コストについて、SemiAnalysisによる2023年2月の推定を引用している。この計算は、GPT-3.5のパラメータを1,750億(私たちが仮定したGPT-4oのアクティブパラメータ数は1,000億)とし、A100 HGXサーバー(より新しいH100より効率が低い)で動かすことを前提としていた。そして最も重要な点として、クエリ1件あたり入力4000トークン、出力2000トークンを仮定していた。これは1500語に相当し、典型的なクエリとはかけ離れている可能性が高い(参考までに言えば、付録を除いた今号のニュースレターの約半分の長さである)。De Vriesはさらに、A100サーバーのGPU 1基あたりの最大電力800 Wを使ってこの計算コストをエネルギーに換算しているが、私たちはサーバーがピーク電力の70%を消費すると仮定している。
加えて、Luccioniらは、GPT-4oと同程度の規模のモデルであるBLOOM-176Bについて、クエリ1件あたり約4 Whのエネルギー消費を測定した。しかしこれは、2022年に研究目的で運用されたモデルの数値である。彼らのクラスタが処理したリクエストは比較的少なく、利用率もおそらく低かった。また、LLMの商用運用ならどこでも標準となっている基本的な推論実行の最適化であるバッチ処理も使っていなかった(この論文の詳細は付録を参照)。
GPT-4o以外のモデルはどうか
私たちはGPT-4oを基準のモデルとしているが、ChatGPTの中にも、他社のチャットボット製品にも、ほかに数多くのモデルがある。OpenAIはGPT-4o-miniを提供しており、そのAPI価格がGPT-4oの10分の1未満であることからすると、パラメータ数7、ひいてはエネルギーコストもかなり小さい可能性が高い。対照的に、OpenAIのo1やo3といった推論モデルは、動かすのにかなり多くのエネルギーを消費するかもしれない。
o1のパラメータ数(およびトークンあたりのコスト)は不明だが、長い思考の連鎖(chain-of-thought)を生成するため、クエリあたりの計算コストとエネルギーコストはおそらく高い。月額200ドルのo1 proでは、このコストはさらに高くなる。o1 proは同じo1モデルを使いながら、推論実行の計算量をさらに増やしているからである。
ここで特に注目したいのが、新たに公開されたo3-miniである。高性能でありながら十分に高速なので、今後数か月で、特に画像・ファイルのアップロードや音声モードといった新機能が加われば、GPT-4oの利用をかなりの程度奪う可能性がある。o3-miniのパラメータ数も公表されていないが、「小型」モデルとうたわれており、APIでのトークンあたりの価格はGPT-4oの44%にすぎない。したがって、o3-miniのトークンあたりのエネルギーコストがGPT-4oより低い可能性は十分にあるが、長い推論の連鎖によってその差は容易に打ち消されうる。
私はOpenAIのAPI8を使ってo3-miniとo1を非公式に試してみたところ、どちらもGPT-4oの約2.5倍のトークンを生成した。これは私自身のチャットからとった少数のサンプルに基づくものであり、より厳密な分析があれば役に立つだろう。9 全体として、o3-miniのクエリがGPT-4oのクエリより多くのエネルギーを使うのか少ないのかは現時点では不明だが、o1のクエリはおそらくより多くのエネルギーを必要とする。
現在、「o」シリーズのモデルの利用は、4oや4o-miniよりはるかに少ないことはほぼ確実である。4oと4o-miniは無料で使え、10 速度も速く、機能も多い(たとえば執筆時点で、o1とo3-miniにはPDFのアップロードや音声モードがない)。また、簡単な質問への回答やメールの下書きなど、今日のチャットボットの用途の大半には、o1の優れた推論能力は必要ない。推論モデルへの移行によって、平均的なチャットボット利用者のエネルギーコストが大きく増える可能性はある。しかしそうなったとすれば、それはおそらく、AIの使い道が今日と比べてはるかに難しく複雑な問題へと移ったことを意味する。o3を使ったOpenAIの新製品Deep Researchは、その初期の兆しである。
OpenAIとChatGPT以外にも、MetaのAIアシスタント(Metaの製品はマルチモーダルなので、おそらくLlama 3.2の11Bか90Bで動いている)、AnthropicのClaude(Claude 3.5 Sonnetで動いており、私たちはそのパラメータ数を4,000億と推定している)、GoogleのGemini(パラメータ数非公表のGemini「Flash」と「Pro」モデルで動いている)といった主要なチャットボット製品がある。これらのモデルすべての詳細はわからないが、エネルギーコストはおそらくいずれもGPT-4oか4o-miniのどちらかとおおむね同程度だろう。最後に、私たちが最近取り上げたDeepSeek-V3とその推論版であるR1は、総パラメータ6,710億のうちアクティブパラメータがわずか370億で高い性能を出しているので、トークンあたりのエネルギー消費がGPT-4oより少ない可能性は十分にある。
今後、AIチャットボットのエネルギーコストがどう変わっていくかは不明である。時間とともに上がることも下がることも十分ありうるし、用途によって大きく分かれるかもしれない。能力を一定とすれば、言語モデルはハードウェアとアルゴリズムの両面の改善によって、時間とともにエネルギー効率が高くなる。AI業界とテック業界は、より効率の高いハードウェアを開発し、小型モデルの能力を絶えず高め、マルチトークン予測のような推論実行の最適化を考案してきた。これらはいずれもエネルギーコストを押し下げる。11 しかし、消費者がますます複雑なタスクをこなす、ますます強力なチャットボットやアシスタントへと移っていけば、より大きなモデルや、より多くの推論トークンを生成するモデルによって、こうした効率の向上が食いつぶされるかもしれない。12
学習とその他の上流コスト
ChatGPTなどのLLM製品を使うコストのほかに、そうした製品を作り出すまでにかかる上流のエネルギーコストも考えておきたい。
最もわかりやすいのは、モデルの学習に必要なエネルギーである。GPT-4oと同程度の現世代のモデル13の学習は、それぞれ約20〜25メガワットの電力を消費し、約3か月続いた。これは米国の住宅約20,000戸分の電力をまかなえる量である。ChatGPTの利用者は3億人いるので、GPT-4oの学習に使われたエネルギーは利用者1人あたりで見ればそれほど大きくない。同じ記事は、ChatGPTの利用者が1日に10億件のメッセージを送っているとも述べている。私たちの0.3 Whという推定を使うと、ChatGPTの推論実行全体には約12.5 MWの電力が必要ということになる。これはGPT-4oの学習に(一時的に)必要な電力と同程度だが、言語モデルは通常、学習期間よりも長く使われる(GPT-4oは公開から9か月たっている)。
GPUなどのハードウェアを動かす直接のエネルギーコストに加えて、それらを製造する上流のエネルギーコスト、いわゆる「内包」エネルギーが気になる人もいるだろう。これを完全に計上するのは難しいが、内包エネルギーのコストは直接のエネルギーコストよりずっと小さい可能性が高い。
Luccioniらは、パラメータ数1,760億のLLMであるBLOOMの学習に使われたサーバーとGPUの内包炭素排出量を調べ、内包排出量(学習期間に応じて按分したもの)を約11.2トンCO2と推定した。これは、モデルの学習で排出された24.7トンCO2の半分未満である。14 しかも、内包エネルギーと学習エネルギーの比はさらに小さい。学習による排出はフランスのクリーンな電力によるもので、その炭素強度はほとんどの国の電力の5分の1から10分の1程度だからである。15 したがって、内包エネルギーのコストは直接のエネルギーコストのごく一部だった可能性が高い。
もう一つのデータとして、世界のAIチップの大部分を製造しているTSMCは、2023年に合計240億kWhを消費した。これは平均消費電力に直すと2.7ギガワットに相当する。これは、TSMCが昨年製造したGPUの消費電力とほぼ同じ規模である(ごく大まかに言って、GPU 1基あたり1 kWで、年間数百万基が製造されている)。しかし、GPUは何年も使われるので、稼働中のGPU全体の消費電力は、おそらくTSMCの工場すべてを合わせたものより大きい。さらに、TSMCが消費する2.7 GWの多くは、実際にはAI以外のチップの製造に使われている。全体として、AIチップの製造にかかるエネルギーは、それを動かすのにかかるエネルギーよりおそらくずっと少ないということになる。
こうした上流コストをすべて厳密に測るのは難しいが、入手できる情報から判断すると、ChatGPTの推論実行にかかる直接のコストと同程度か、それ以下である可能性が高い。そして学習については、このコストは最初に一度かかるだけであり、AIモデルは学習後にすり減るわけではないので、ChatGPTを使う限界エネルギーコストには影響しない。
考察
妥当で、やや悲観的な仮定のもとでは、典型的なテキストの質問に対するGPT-4oのクエリは約0.3ワット時を消費する。ただし、入力が非常に長いクエリでは2.5〜40ワット時まで大きく増える。下のグラフに示すように、これは日常の電力使用量から見て、無視できる程度から小さな割合までのどこかにあたる。
この推定には、パラメータ数、利用率、その他の要因のいずれについても大きな不確実性がある。より幅広い仮定に基づく推定や、その他の日常的な電力使用の出典は、こちらのスプレッドシートで見られる。私はどの仮定でも悲観的な側(エネルギーコストが高くなる側)に寄せるよう努めたが、パラメータ数、利用率、出力トークン数について異なる仮定をとれば、コストは1〜4ワット時の範囲にもなりうるし、約0.1ワット時まで下がることもありうる。そして繰り返しになるが、GPT-4oのコンテキストウィンドウを上限まで使えば、エネルギーコストは数十ワット時にもなりうる。ただし、入力に対するこの増え方は、より優れたアルゴリズムで改善できる。
OpenAIをはじめとする主要AI企業がもっと透明性を高めれば、よりよい推定ができるだろう。理想を言えば、ChatGPTなどの人気AI製品を実際に動かしているデータセンターの実測データを使えるとよい。企業秘密の問題があるため、AI企業がこれを公開するのは難しいかもしれない。だが私には、この話題をめぐる世間の混乱(今日AIを使うエネルギーコストについての誇張された印象の多くを含む)も、AI開発者の利益にはならないように思える。
より大きな視点で見ると、一部の推定では、AIのエネルギー使用量は2030年までに16、米国の電力の10%程度という、かなり目を見張る水準に達する可能性がある。17 このため私は、特に長期的に見て、AIが環境とエネルギーに与える全体的な影響への懸念を退けるつもりはない。それでも、典型的なLLMチャットボットを使う現時点の限界コストが、ほかの日常的な電力の使い道と比べてかなり低いことは、重要な事実である。
付録
1. 計算コスト
LLMの推論実行の計算コストを求めるには、モデルの規模と生成されるトークンを考える必要がある。LLMはトークンと呼ばれる単位でテキストを生成する(OpenAIの場合、1トークンは平均で0.75語にあたる)。1トークンを生成するには、モデルのパラメータ1つにつき2回の浮動小数点演算(FLOP)が必要になる(加えて入力の処理にもいくらかの計算が必要で、これについては後で論じる)。なお、投機的デコーディングやマルチトークン予測のように、このトークン生成のコストを減らしうる高度な手法は無視している。OpenAIがそれらを使っているかどうかわからないからである。
ChatGPTのモデルのパラメータ数はどれくらいか。執筆時点で、ChatGPTの利用者はGPT-4o、GPT-4o mini、o1、o1-mini、o3-miniを含む複数のモデルから選べる。
GPT-4oは有料会員向けの全機能を備えたモデルで、GPT-4o-miniはより安価で性能の低い派生版である(無料利用者はGPT-4oを限られた範囲でしか使えず、4o-miniはより多く使える)。一方、o1とo3はOpenAIの新しい「推論」モデルで、おそらくはるかに多くの計算資源とエネルギーを必要とするが、一般的な利用者の間での利用もおそらくずっと少ない。
私は典型的なChatGPTの利用の基準としてGPT-4oを用いる。ただし、GPT-4o miniのほうが利用が多く、しかも必要な計算量ははるかに少ないかもしれない。18 残念ながら、GPT-4oや他のモデルの正確なパラメータ数はわからないが、私たちは以前、GPT-4oの総パラメータ数を2,000億と推定した。この推定は2倍程度ずれている可能性がある。
また、GPT-4oは混合エキスパート(MoE)モデルである可能性が高く、その場合、すべてのパラメータが同時に使われるわけではない。そう考えられるのは、計算効率の高さから、MoEがフロンティアモデルの標準的な手法になっているとみられるからである。たとえば、GPT-4は報道によればMoEモデルであり、Gemini 1.5 ProもMoEであり、V3やR1を含むほぼすべてのDeepSeekのモデルもMoEである。
MoEモデルの総パラメータ数とアクティブパラメータ数の比は、MistralのMixtral 8x7Bと8x22Bの約3.6対1から、総パラメータ6,710億に対して370億のDeepSeek-V3の20対1近くまで幅がある。そこで私たちは4対1の比を用い、GPT-4oの総パラメータを4,000億、アクティブパラメータを1,000億と仮定する。仮にGPT-4oが密な(dense)モデルだったとしても、この値はGPT-4oの総パラメータ数についての私たちの推定の下限と整合する。19 全体として、これはGPT-4oのアクティブパラメータについての私たちの最善の推測より悲観的な値だが、ここには大きな不確実性がある。
次に、これにChatGPTがクエリ1件あたりに生成するトークン数を掛ける必要がある。これは用途によって大きく異なるが、Chiangらは、LLMのチャットの大規模なデータセットで平均応答長が269トークンだったと報告している。私たちは悲観的にこれを500トークンに引き上げる。これは約400語、シングルスペースでタイプした文章で約半ページに相当する。あなたのChatGPTの使い方でこれよりずっと長い、または短い応答が出ることが多いなら、最終的な推定値を比例して調整すれば、自分自身のフットプリントがわかる。
以上をまとめると、出力500トークンのクエリには500 * 2 * 1,000億 = 1e14 FLOPが必要になる。
2. 計算のエネルギーコスト
次に、この量の計算を行うためのエネルギーコストを求める必要がある。
Google以外の企業にとって主力のAIチップはNVIDIAのH100 GPUなので、ChatGPTの推論実行にはH100が使われていると仮定する。OpenAIは今も古くて効率の低いA100をいくらか使っているかもしれないが20、いずれはより効率の高いBlackwellチップにも移行するだろう。H100の定格電力21は700ワットだが、サーバーとデータセンターのオーバーヘッドがあるため、H100クラスタはGPU 1基あたり最大約1500 Wを消費しうる。たとえば、H100の一般的なサーバー構成であるH100を8基搭載したDGXサーバーの最大消費電力は10.2 kW(GPU 1基あたり1275 W)であり、データセンターのレベルでさらに10〜20%のオーバーヘッドがかかる。
H100は最大で毎秒989兆(9.89e14)FLOPを実行できる。これはスパース性なしの16ビットFLOPを前提とした値である。ただし、オープンモデルの推論実行を提供する事業者の多くは8ビットで推論実行を行っており、H100は16ビットFLOPの2倍の8ビットFLOPを実行できる。なお、NVIDIAのH100の仕様書はスパース時のFLOP/sを記載しているので、私たちはそれらの数値をすべて2で割っている。
ChatGPTを動かすH100がこのピーク性能を達成するなら、クエリへの回答に必要な1e14 FLOPの処理にかかるH100の稼働時間は2e14 / 9.89e14 = 0.1秒になる(実際には、サーバーは多数のリクエストをバッチでまとめて並列処理するので、生成の開始から終了まではそれよりずっと長くかかる)。
0.1秒に1500ワットを掛けると、エネルギーコストは150ワット秒、すなわち約0.041ワット時となり、よく引用される3ワット時という推定よりはるかに低い。しかしこれは楽観的すぎる。GPUは実際には最大性能の100%を出せないからである。計算利用率、すなわち実際の計算量を理論上の最大値で割った値で補正する必要がある。利用率が低いと、クエリの処理に必要なGPUの数が増え、エネルギーコストも増える。
LLMの推論実行では、どれくらいの利用率が達成されているのか。確かなことを知るのは難しいが、10%は大まかながら妥当な仮定である。推論実行時の利用率がAIモデルの学習時(30〜50%であることが多い)より低いことはわかっている。推論実行ではメモリ帯域幅がボトルネックになるからである。22
もう一つの根拠は、オープンウェイトモデルのトークンあたりの価格である。オープンモデルはパラメータ数がわかっており、オープンモデルのAPIをホストする事業は競争が激しい(誰でもオープンモデルをダウンロードしてAPIを提供できるため)。そのためAPI提供事業者の利幅は小さいとみられ、その価格はモデルを提供する実際のコストを示す手がかりになる。
このことから、利益率0%と仮定すれば、トークン価格をもとに利用率を推定できる。
- Llama 3.1 405Bのパラメータは4,050億なので、1トークンあたり2 * 405B = 810B(8e11)FLOP、100万トークンあたり8e17 FLOPが必要になる。
- H100はピーク時に2000テラFLOP/s(オープンモデルの提供事業者で標準的なFP8のFLOP)、つまり1時間あたり7.2e18 FLOPを実行できる。H100のレンタル料は1時間あたり約2ドルなので、利用率100%なら、API提供事業者は1ドルあたり3.6e18 FLOPを得られる。
- つまり、GPUが利用率100%で動いていれば、Llama 3.1 405Bのトークン100万個を生成する計算コストは8e17 / 3.6e18ドル、すなわち22セント程度になる。
- 実際には、Artificial Analysisがまとめた価格によると、Llama 3.1 405Bの価格は出力トークン100万個あたり平均3.50ドルであり、10倍以上高い。
これらのAPIを運営するうえで最大のコストがGPUのレンタル料であることはほぼ確実なので、提供事業者は利用率100%の場合と比べて約10倍のGPUを必要としていると考えられる。つまり利用率はおよそ10%であり、必要なGPUの数、ひいては私たちのエネルギー推定も10倍になる。
最後に考慮すべきなのは、GPUクラスタの平均消費電力がピーク時の消費電力より低くなることである。推論実行中の計算利用率が低いことを考えると、なおさらそうである。具体的な実測データがない限り、OpenAIのサーバーの実際の消費電力を知ることはできないが、他のモデルについて推論実行の消費電力を測定した文献はいくつかある。
Microsoft Azure23の研究者チームであるPatelらは、複数のLLMについて推論実行の消費電力の実験を行い、GPUの消費電力は通常、熱設計電力(TDP)の60〜80%程度で、プリフィル(prefill)段階で入力トークンを処理するときには100%まで跳ね上がることを見いだした(図6)。Luccioniらも推論実行の消費電力を測定し、平均消費電力はTDPの約25%にすぎないことを見いだした。しかし、Luccioniらの環境はChatGPTのものとは大きく異なっていた。たとえば、処理したのは1時間あたりわずか558件のリクエストで、しかもバッチ処理なしで処理されていた。対照的に、Patelらは電力利用率を最大化することを意図して「途切れない流れ」で推論実行のリクエストを送ったので、その約70%という結果は、やや悲観的ではあっても、大規模な運用をよりよく表している可能性がある。この数字を使うと、ユーザー需要の変動でGPUがときどき遊休状態になる可能性を、悲観的に無視することになる。FLOPのスループットが10%であることを考えれば遊休は十分にありうる結果であり、そうなれば消費電力はさらに下がるだろう。
計算利用率10%と電力利用率70%を合わせると、先ほどの素朴なエネルギー推定は7倍になる(まず10%で割る、つまり10倍してから、70%を掛ける)。これを先ほどの結果に当てはめると、出力500トークンのGPT-4oのクエリは0.041 * 7 ~= 0.3ワット時となる。広く引用される3 Whという推定の10分の1近くである!
3. 入力トークンのエネルギーコスト
言語モデルにとって、長い入力の処理は高くつくことがある。Transformerモデルには、入力中のすべてのトークンどうしの関係を表すアテンション機構がある。プリフィル段階では、モデルは入力を処理し、アテンションで使われる2つの行列(キー行列とバリュー行列、KとVと呼ばれる)の値を計算する。これらはKVキャッシュに保存される。
このアテンション処理のコストは、モデルの次元数、モデルの深さ、入力長の2乗の積に比例して増える。GPT-4oのパラメータ数を仮定すれば、そのパラメータ数になるようなモデルの深さと各層の次元数について妥当な推定値を求めることができ、そこから任意の入力長に対するアテンション計算のFLOPコストを推定できる。長い入力があるときはトークン生成にも追加のコストがかかるが、非常に長い入力ではこのコストは比較的小さい。
入力が大きい場合、プリフィルのコストは入力長の2乗に比例して増えるので、この方法では長い入力の計算コストとエネルギーコストは高くなる。入力1万トークン、出力500トークンでは総コストは約2.4ワット時に増え、入力10万トークン、出力500トークンでは約40ワット時のエネルギーがかかる。なお、KVキャッシュがあるので、これは最初に一度かかるコストであり、アップロードした文書のような非常に長い入力から始まる複数ターンのチャットの会話で、このコストが何度もかかることはない。
計算の全体は、こちらのColabノートブックで見られる。
重要なことに、2乗で増えるとすれば、100万トークン以上の入力では計算コストとエネルギーコストが非常に高くなるはずである。100万トークンの入力の処理は、10万トークンの処理と比べて総コストが約100倍になる。しかし、Google DeepMindはGemini 1.5以来、100万〜200万トークンのコンテキストウィンドウを提供しており、これはほぼ確実に、2乗での増え方を改善する技術革新によって可能になったものである。さらに、より効率の高いアテンション機構も文献で提案されている。したがって、入力長に対する入力コストの増え方を改善できることはわかっているが、OpenAIがどの技術革新を取り入れているのか、そもそも取り入れているのかどうかはわからない。
注
-
Google検索との比較は、検索1回あたり0.3 Whを消費するという、2009年にGoogleが出したかなり古い推定に基づいている。今日のGoogle検索のエネルギーコストを推定することは本稿の範囲外である。チップとデータセンターの効率向上によって今日では低くなっていることも十分にありうるし、Google検索が時とともに複雑になったために(さらに/あるいは、Google検索に今ではAI OverviewsのようなAI機能があるために)高くなっていることもありうる。 ↩
-
世帯の使用量は総使用量より少ない。たとえば、自分が持っている物の製造に使われたエネルギーは、家の中で消費されたわけではないからである。 ↩
-
これがどれほどのエネルギー量なのかについての参考になる背景や、AIの水使用についての議論は、Andy Masleyのこのエッセイで読める。 ↩
-
H100の一般的なサーバー構成であるH100を8基搭載したDGXサーバーの最大消費電力は10.2 kW(GPU 1基あたり1275 W)である。さらにデータセンターのレベルで10〜20%のオーバーヘッドがかかる。 ↩
-
これは推論実行のリクエストが途切れなく届くと悲観的に仮定しており、需要の変動でGPUが遊休状態になる可能性を無視している。 ↩
-
Google DeepMindは、Geminiモデルで200万トークンの入力ウィンドウを実現するために、入力に対するコストの増え方をほぼ確実に改善している。ただし、OpenAIがこの種の技術革新をすでに取り入れているかどうかは私たちにはわからない。 ↩
-
パラメータ数はAPI価格に比例するとは限らない。OpenAIはモデルごとに異なる利益率を設定しうるし、トークン生成速度を落とせばモデルをより安く提供できるからである(GPT-4o-miniは「mini」モデルとしては比較的遅い)。 ↩
-
推論の連鎖の全体は利用者には見えないが、APIなら生成されたトークン数がわかるので、APIを使う必要があった。 ↩
-
私はGPT-4o、o1、o3-miniに自分のチャット履歴から5つの質問を投げ、平均応答長がo3で1374トークン、o1で1392トークン、GPT-4oで540トークンであることを確かめた(reasoning effortはChatGPTの既定値であるmediumにしたが、ChatGPTのシステムプロンプトは使わなかった)。つまり、o1とo3-miniはどちらも2.5倍をわずかに上回るトークンを生成した。一方、DeepSeek-R1はこれらの質問に平均1794トークンを返した。これは推論モデルがはるかに多くのトークンを生成しうることを大まかに確かめただけであり、代表的な平均値と受け取るべきではない。 ↩
-
o3-miniも無料で使えるが、おそらく厳しい回数制限がある。 ↩
-
推論モデルの人気が高まっている兆しとしては、DeepSeekの新しい推論モデルであるDeepSeek R1がAppleのApp Storeで1位になったことや、o3-miniが無料利用者にも提供されていることが挙げられる。 ↩
-
GPT-4oの学習に使われたGPUの数はわからないが、Llama 3.1や初代GPT-4など、同程度の規模だと考えられるモデルについてはわかっている。 ↩
-
これは推論実行ではなく学習の数値である。しかし、彼らはコンピュータ機器の耐用期間全体の内包排出量を学習期間の長さで按分しているので、クラスタが推論実行のクエリ1件を処理するごく短い時間で按分した内包排出量と、そのクエリのエネルギーコストとを比べても、結論は大きくは変わらない。 ↩
-
フランスの電力の大半は原子力でまかなわれている。LuccioniらはBLOOMの学習について炭素強度を1 kWhあたり57グラムCO2と仮定しており、これは他のほとんどの国の電力より5〜10倍クリーンである。また、内包排出の大部分はおそらくフランス国外で生じたものである。 ↩
-
これは現在の約0.3%からの増加である。Goldman Sachsは、2024年にAIデータセンターが約11テラワット時の電力を消費すると推定しており、これは米国の総消費量4兆kWhの約0.3%にあたる(計算はこちら)。 ↩
-
OpenAIのAPIで10倍以上安いことからすると、GPT-4o miniはかなり小さい。ただし、無料利用者のメッセージ上限が不透明なので、実際に4o-miniのほうが4oより典型的なのかどうかはわからない。 ↩
-
この2つの論点(GPT-4oがMoEかどうかと、その総パラメータ数)は完全に独立ではない。GPT-4oは2024年半ばの水準で非常に高性能なモデルだったことがわかっており、アクティブパラメータ数が少なくなるほどそれを実現するのは難しくなるからである。 ↩
-
H100が2022年末に登場して以来、NVIDIAの売上は劇的に伸びているので、H100のほうがはるかに多く使われている可能性が高い。 ↩
-
正式には「熱設計電力」と呼ばれ、GPUのピーク消費電力にほぼ等しい。 ↩
-
MicrosoftはOpenAIの主要な計算資源の提供元である。ただし、この論文はOpenAIのモデルを試験したわけではなく、ましてやChatGPTの商用運用を試験したわけでもない。 ↩