
ニュースレター
「AIマンハッタン計画」はどこまで大きくなりうるか?
原題:How big could an “AI Manhattan Project” get?
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
この1年で、AIの国家プロジェクトが実現する可能性は着実に高まってきた。
11月には、米中経済・安全保障調査委員会が、議会への最重要の提言として「汎用人工知能(AGI)の能力の獲得を目指して競争する、マンハッタン計画のようなプログラムを設立し、資金を提供すること」を挙げた。ここ数か月は、米国エネルギー省も繰り返しAIをマンハッタン計画になぞらえ、このプロジェクトの成功をその権限を使って後押しする意向を示しており、最近は次のような投稿をした。

しかし、「AIのためのマンハッタン計画」とは実際には何を意味するのだろうか。はっきりとは分からないが、人々が言わんとしていることの本質の多くは、次の3つの特徴で捉えられると考えている。
- 米国政府が始めるプロジェクトである
- 民間部門のAI資源(計算資源など)が統合される
- 計算資源への投資の総額が、米国のGDPに占める割合で、マンハッタン計画やアポロ計画の最盛期と同程度に達する
これらの中核的な性質に加え、この分析では主に、このスケーリングを妨げる物理的なボトルネックを取り上げる。つまり、AIマンハッタン計画には十分な投資と政治的支援があると仮定する。
本稿では、米国でそのようなプロジェクトが行われれば、電力の制約を考慮しても、2027年末までに 2e29 FLOP の学習実行が可能になりうると論じる。これは現時点で最も計算量の多いモデルのおよそ500倍であり、GPT-4 の1万倍にあたるスケールアップである。1
これまでの研究では、通常の条件下でのスケーリングのボトルネックと、国家プロジェクトについて、それぞれ個別に検討されてきた。本稿では、国家プロジェクトがスケーリングにとって何を意味するのかを調べる。その際、近い将来にスーパーコンピュータとエネルギーをどこまでスケールできるかについての、より新しい証拠(xAI の Colossus クラスター、Stargate、NVIDIA の売上高など)を用いる。
はっきりさせておくと、本稿は政策提言ではなく、国家プロジェクトが実現すると予測しているわけでもない。また、秘密保持の程度や民間部門への依存の程度についても、厳密には特定していない。そうではなく、そのような可能性が現実味を帯びている以上、「AIマンハッタン計画」がAIのスケーリングにとって何を意味するのかを明らかにすることが目的である。
Epoch AI の最新情報を受け取る 購読する
国家プロジェクトはどれだけの計算資源を集められるか?
最盛期のマンハッタン計画の費用はGDPの0.4%で、これは現在の約1,220億ドルにあたる。同様に、アポロ計画の最盛期には、米国のGDPの約0.8%(現在の約2,440億ドル)がNASAに充てられた。では、この金額でどれだけの計算資源を買えるのだろうか。
一つの方法は、現在のGPUの価格性能比を見ることである。たとえば H100 GPU は現在、FP16 精度で約 2.2e10 FLOP/s/ドルの性能を持つ。今後3年間にわたって毎年2,440億ドルの投資があれば、100日間の学習実行はおよそ 1.2e29 FLOP になるはずである。2これは GPT-4 の 2.1e25 のおよそ1万倍であり、予定より約2年早い。
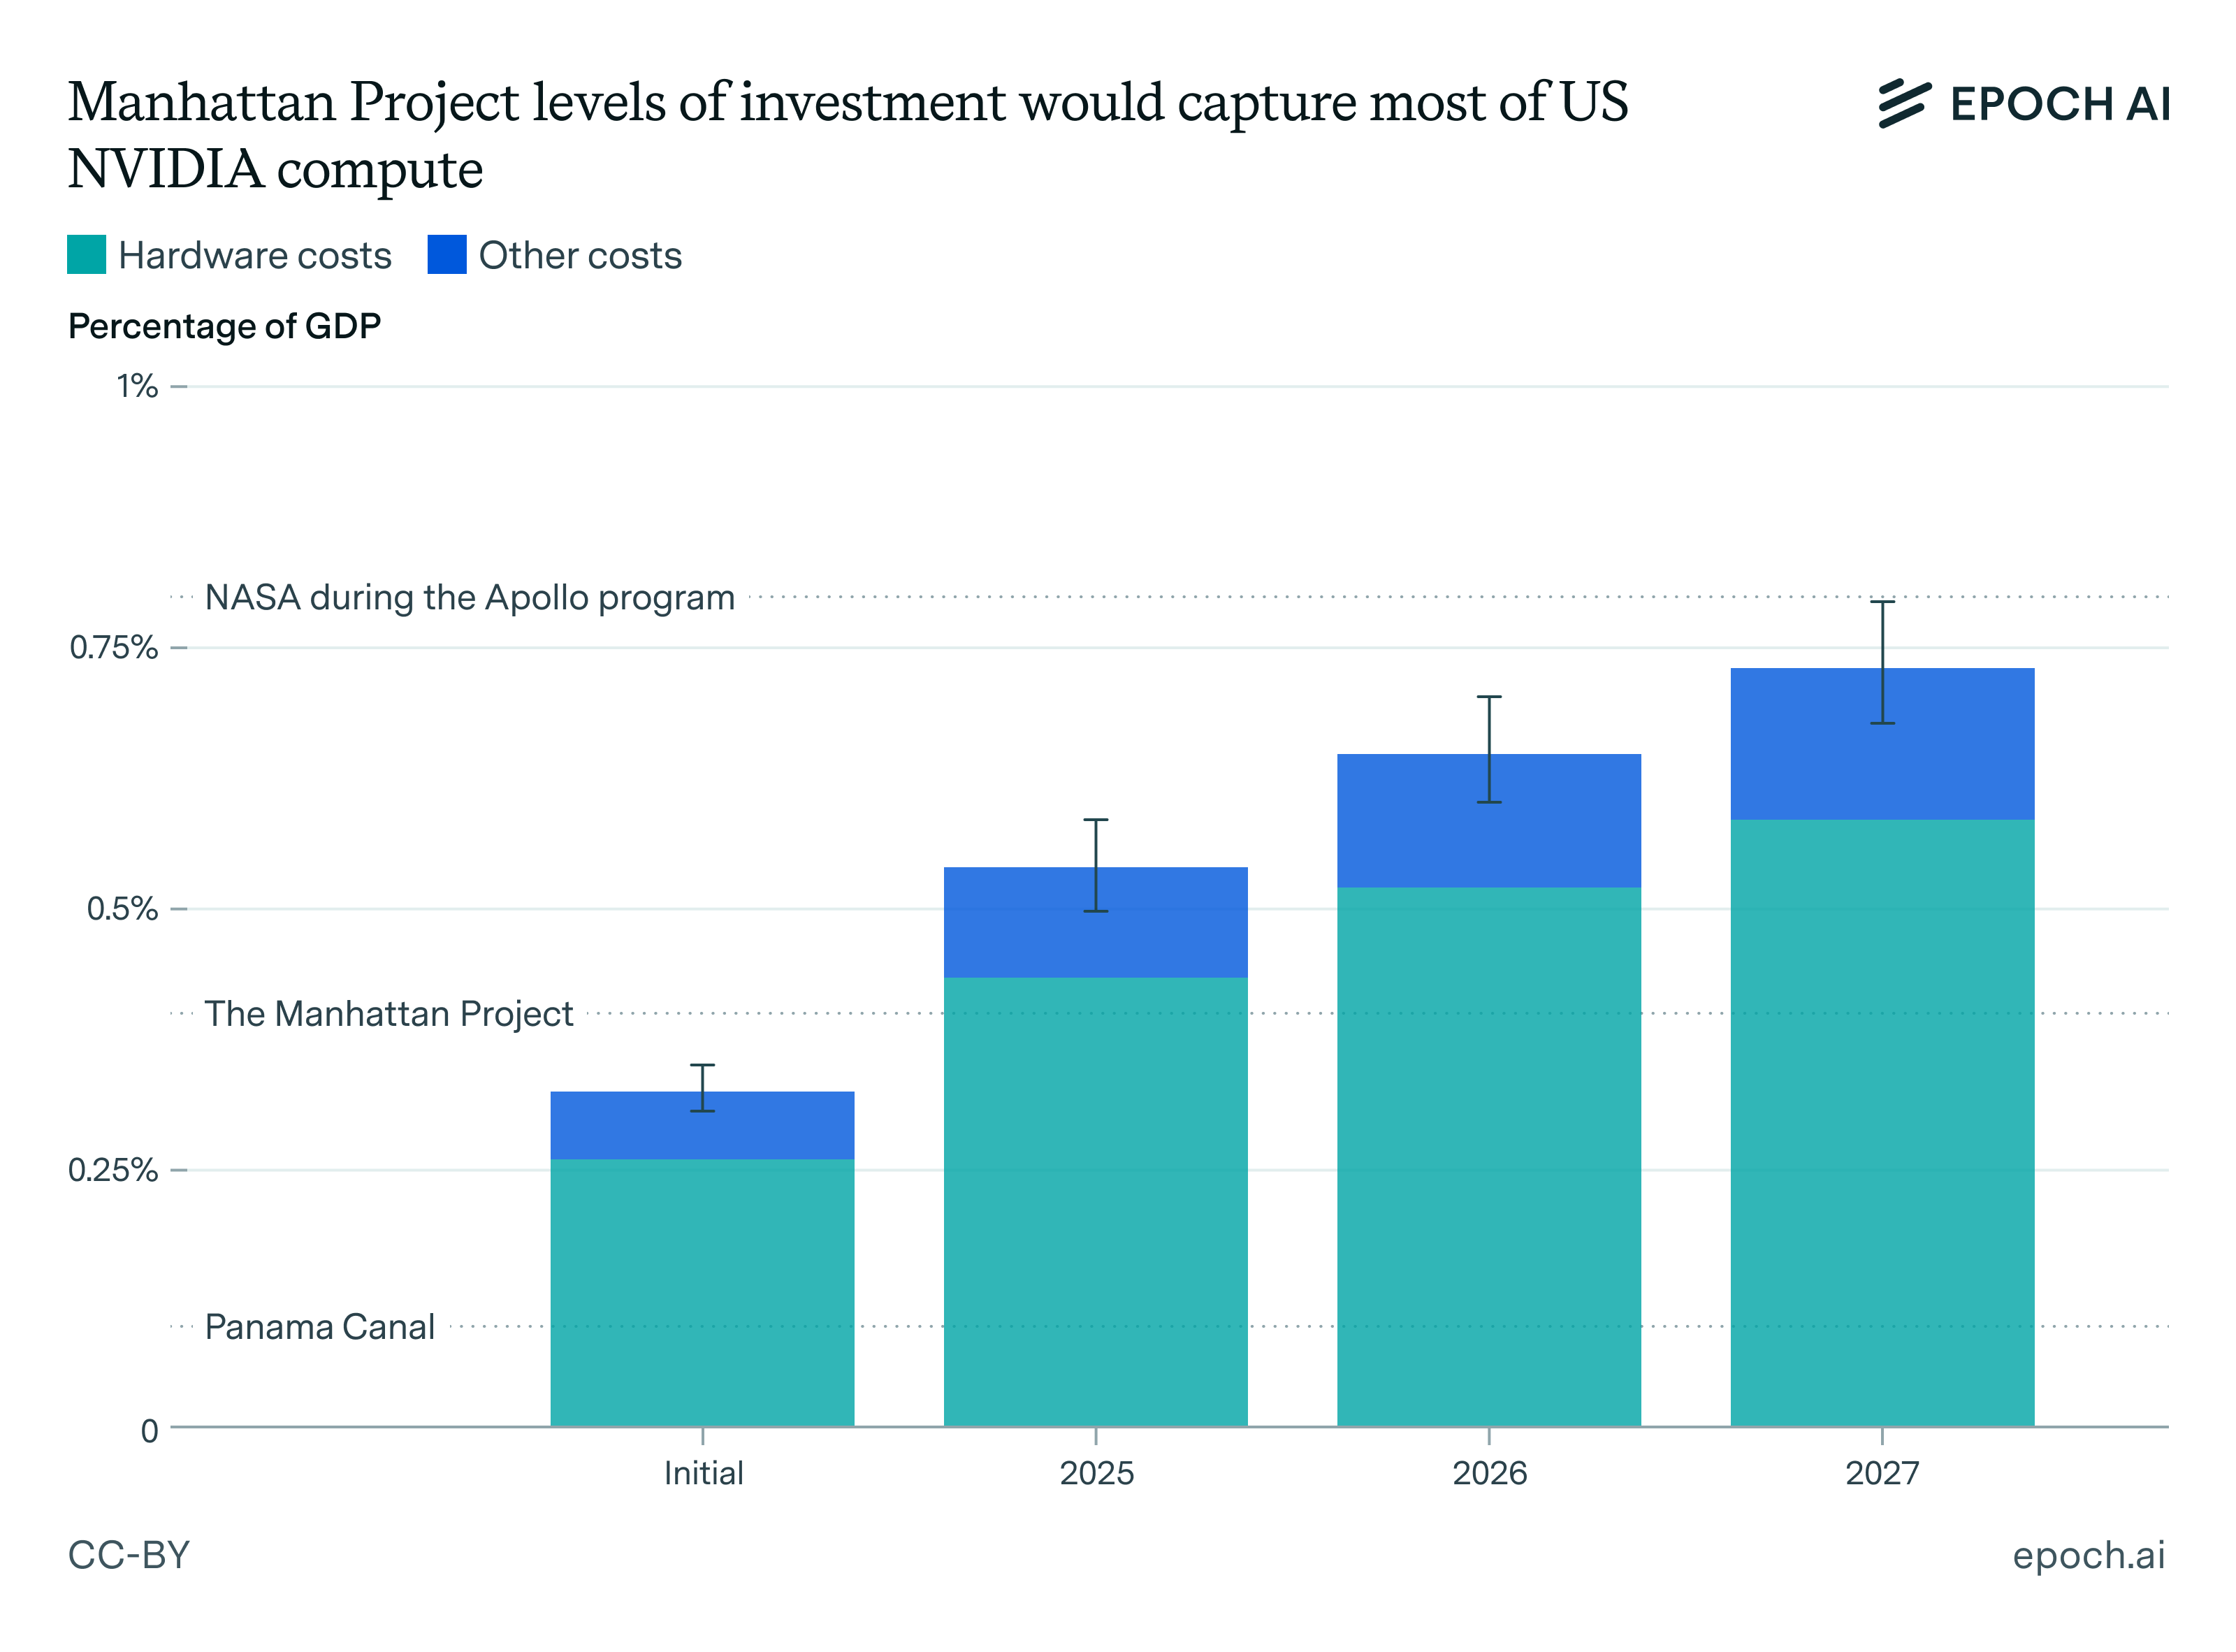
実は、この投資額は、NVIDIA が米国企業にAIハードウェアを販売して得る売上高のトレンドを単純に外挿した値と一致している。したがって、米国で購入できる計算資源の総量も、既存の計算資源のトレンドから導けるはずである。
NVIDIA の計算資源の総量とハードウェア費用の既存のトレンドを外挿し、その計算資源の大部分が一つの国家AIプロジェクトに統合された場合に何が起きるかを考えると、このことが分かる。まず、現在米国にあるAIの学習に関係するハードウェアの費用は約990億ドルである。これは、各年の NVIDIA の売上高に、世界のAI計算資源に占める米国のシェアを掛け、減価償却を考慮して求めたものである。3
将来のハードウェアの費用も同様に求めると、平均で年約2,300億ドルとなる。これは、将来の売上高の予測に、世界のAI計算資源に占める米国のシェアを組み合わせたもので、このシェアがおおむね現在と同じままであり、ハードウェアの費用が総所有コストの80%程度になると仮定している。

合計すると、H100換算でおよそ2,700万基のGPUになる。これを100日間使えば約 3e29 FLOP となり、先ほどの 1.2e29 FLOP という推定とおおむね同じ水準である。
それを支える電力は足りるか?
前節の計算を見ると、国家プロジェクトは大量の計算資源を手に入れられるかもしれないが、それは話の一部にすぎない。特に、プロジェクトがこの計算資源をすべて使えるだけの電力はあるのだろうか。ここでは、学習を一か所に集中させる場合だけを考える。既存の計算資源のトレンドが示すよりはるかに大きな学習実行の実現可能性にとって、これが最悪のシナリオだからである。4
まず、そのようなプロジェクトに実際どれだけの電力が必要かを求める必要がある。ハードウェアの効率のトレンドを外挿すると、2,700万基の H100e には 7.4 GW が必要になる。5これはニューヨーク市に電力を供給するのに必要な平均の連続電力(5.7 GW)を上回り、世界最大の原子力発電所の出力(7.1 GW)とほぼ同じである。6
チップのクラスター建設の多くの側面は、意欲的な過去の例と比べてさえ大幅に加速できるが、電力インフラの整備についてはそうはいかない可能性が高い。7たとえば、以前の Epoch のレポートでは、過去の例から見て、3 GW を超える発電所の建設には約5年かかることが分かった。しかし、政府の後ろ盾があれば、状況は非常に大きく変わると予想している。
7.4 GW のクラスターは、すでに新たに計画されているガス火力発電設備だけで支えられる。2021年の時点では計画されていなかったが、2027年に設置される予定の 8.8 GW 分である。この新たな電力の大部分は、いずれにせよデータセンター向けである。ごく狭い地域に約10 GW の発電設備が集まった過去の例があることから、こうした新規の電源は一か所に集中させられる可能性が高い。8一般的な推定値を使えば、設置する発電設備の費用は約80億ドルとなり、国防生産法(DPA)を発動して発注を優先させ、スピードのために割増料金を払う余裕も十分に残る。9 10
あるいは、Abilene や Homer City のようにすでに進行中のプロジェクトを加速させ、同じく DPA によって近隣の発電所から徴用した周辺の電力で補うこともできる。11 12それぞれのすでに計画されている容量を 7.4 GW まで引き上げても、各州の現在の発電容量の約2%と約6%しか要しない。13方法はどうであれ、この規模、あるいはおそらくそれよりかなり大きい規模の集中型の学習実行を支えるエネルギーは、国家プロジェクトであれば、当面はチップと比べてボトルネックになるほどの困難なく供給できることは明らかだと思われる。
考察
では、このことは将来について実際に何を教えてくれるのだろうか。第一に、統一された国家プロジェクトがAIの進歩を非常に大きく加速しうることは、かなり明らかだと思われる。以前の Epoch のレポートでは、年4倍の計算資源の成長が2020年代の終わりまでに 3e29 FLOP に達するまで続くかどうかを分析したが、私たちは、これを2027年末まで前倒しできる可能性があると考える。しかも、これは米国のGDPに占める割合で見て、アポロ計画時のNASAより少ない年間費用で達成できる。ほかに大きな支援がなくても、計算資源を一つの組織のもとに統合するだけで、そうしなかった場合と比べてスケーリングはおそらく約1年前倒しされるだろう。14
私たちの推定は、Leopold Aschenbrenner が Situational Awareness で行った分析よりも新しいデータに基づいている。この更新されたデータを使うと、2028年ごろに見込まれている規模のデータセンターでは、同論考の推定より約1桁(OOM)大きいモデルを学習できる可能性がある。
もちろん、この分析を疑うべき理由はたくさんある。この分析が楽観的すぎるかもしれない点の一つは、国家プロジェクトが行われる状況には、たとえば台湾をめぐる戦争のシナリオが含まれうることである。その場合、たとえば NVIDIA が必要なハードウェアをすべて供給できる見込みは低くなる。ただし、こうした戦時のシナリオによって、国家プロジェクトを強力に推し進める動機が高まる可能性もある。
このようなプロジェクトを難しくするもう一つの要因は、逐次的な時間のボトルネックである。ここまでの分析は、2027年までに計算資源を大幅にスケールさせ、学習計算量を約3桁増やすという前提で組み立ててきた。しかし実際には、これほど大きくスケールアップするには、スケーリング実験や「リスク低減のための試験的な学習」など、実行に時間のかかる作業が伴いがちである。たとえば、GPT-4.5 の学習実行が予想より長い時間と、はるかに多くの人手を要した理由の一部は、こうした事情にあるのかもしれない。
そもそも国家プロジェクトが実現しない可能性もあるので、この分析が実際には当てはまらないこともありうる。また、国家プロジェクトに向けた本格的な試みがあったとしても、私たちは必要な計算資源をすべて確保するうえでの大きな困難、たとえば戦時のシナリオによる地政学的な問題や、計算資源の需要増加による大幅な価格上昇の影響などを、すべて省いている。
それでも、AIのスケーリングが歴史的に重要だったこと、大規模な国家プロジェクトやエネルギー拡大の前例があること、そしてAIマンハッタン計画への熱意が表明されていることを考えると、そのような可能性を切り捨てるのは賢明ではないだろう。そして、これまで見てきたことからすると、多額の投資と政治的な調整を伴う集中的な取り組みが、計算資源のスケーリングを大きく加速させる結果になることは、かなりありそうに思われる。
本稿のきっかけとなった会話をしてくれた Trevor Chow と、フィードバックをくれた Yafah Edelman、Josh You、Jaime Sevilla、JS Denain、Jannik Schilling、Duncan McClements、Jack Whitaker に感謝する。
注
-
これは次の計算による。0.8 * (1 + 1.3 + 1.3^2) * 2,440億ドル * 2.2e10 FLOP/s/ドル * 100日 * 24時間/日 * 3600秒/時間 * 利用率0.4 * 2 FP8/FP16 = 1.2e29 FLOP。1.3 という係数は FLOP/s/ドル の年間の改善率であり、0.8 という係数はハードウェア以外の費用を考慮したものである。 ↩
-
これは、2023年と2024年の NVIDIA のデータセンター部門の売上高に、各年の世界のAI計算資源に占める米国のシェアを掛け、4年間の定額法による減価償却を仮定して推定した。Google の TPU を考慮して調整することもできるが、2024年半ばの時点で TPU はAI計算能力の約25%しか占めていなかったので、結論が大きく変わる可能性は低いと思われる。特に、現在と比べて1,000倍を超える大幅な加速が可能だという点は依然として正しいと思われる。 ↩
-
特に、集中型の学習実行は、分散型の学習実行にはない形で電力供給の制約を受ける。大量の電力を同じ地理的な場所に送ることには困難が伴うからである。ここではほかのボトルネックは考慮しない。 ↩
-
これは、電力使用効率(PUE)1.1、利用率0.4、ハードウェアのエネルギー効率が毎年40%向上すること、各チップが出荷された年のトレンドどおりの性能であること、現在の8チップ構成の H100 サーバーが 10,200ワットを必要とすることを仮定している。 ↩
-
ニューヨーク市の年間の平均エネルギー消費量は 50,000 GWh であり、これを 24 * 365 = 8760 時間で割って必要な電力を求めた。ピーク時の消費電力はこの年間平均のおよそ2倍である。 ↩
-
たとえば、xAI の Colossus クラスターはわずか4か月あまりで建設されたが、同様のプロジェクトでは16か月でも通常は非常に見事だとみなされる。 ↩
-
非常に大規模なガス火力発電設備の建設を大幅に加速できることは、エジプトのメガプロジェクトによってすでに実証されている。 ↩
-
出力 2.2 GW のコマンチピーク原子力発電所から Abilene までの距離はわずか128マイル、出力 1.8 GW の Jewett の石炭火力発電所からはわずか251マイル、出力 1.8 GW の Forney Energy Center からはわずか213マイルである。Homer City から出力 1.8 GW のビーバーバレー原子力発電所までの距離はわずか86マイル、出力 1.9 GW のコネモー発電所まではわずか32マイルである。距離の推定値はすべて道路沿いのものである。現在計画されている容量は、Abilene が3段階合わせて 3.4 GW、Homer City が 4.5 GW と仮定するが、計画はやや不明確で変化している。現在の発電容量は 155 GW と 48 GW と仮定する。徴用された発電所の容量は、おそらく隣接地域からの容量で置き換えられ、時間をかけて再建されるだろう。ただ、元のマンハッタン計画は住民を強制的に立ち退かせることも平然と行っていたようなので、それも一つの可能性である。 ↩
-
Homer City の 4.5 GW と Abilene の 3.4 GW はすでに計画されている。徴用された発電容量はさらに別の発電所で置き換える、といった形で影響を広い地域に分散できるので、地元の住民が影響を感じることはほとんどないだろう。 ↩
-
たとえエネルギー供給を加速できず、プロジェクトが計算資源の総量と最大の学習実行の比率を一定に保つとしても、資源を統合すれば最大のプロジェクトが使える計算資源は4〜5倍になり、それはおそらくどこかの時点で表れるだろう。 ↩