
ニュースレター
GPT-5の学習計算量はなぜGPT-4.5より少なかったのか(そしてGPT-6はおそらくそうならない理由)
原題:Why GPT-5 used less training compute than GPT-4.5 (but GPT-6 probably won’t)
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
歴代のGPTモデルの中で、GPT-5は異色の存在である。それまでのどのGPTとも違い、GPT-5はおそらく直前のモデルであるGPT-4.5よりも少ない計算量で学習された。1
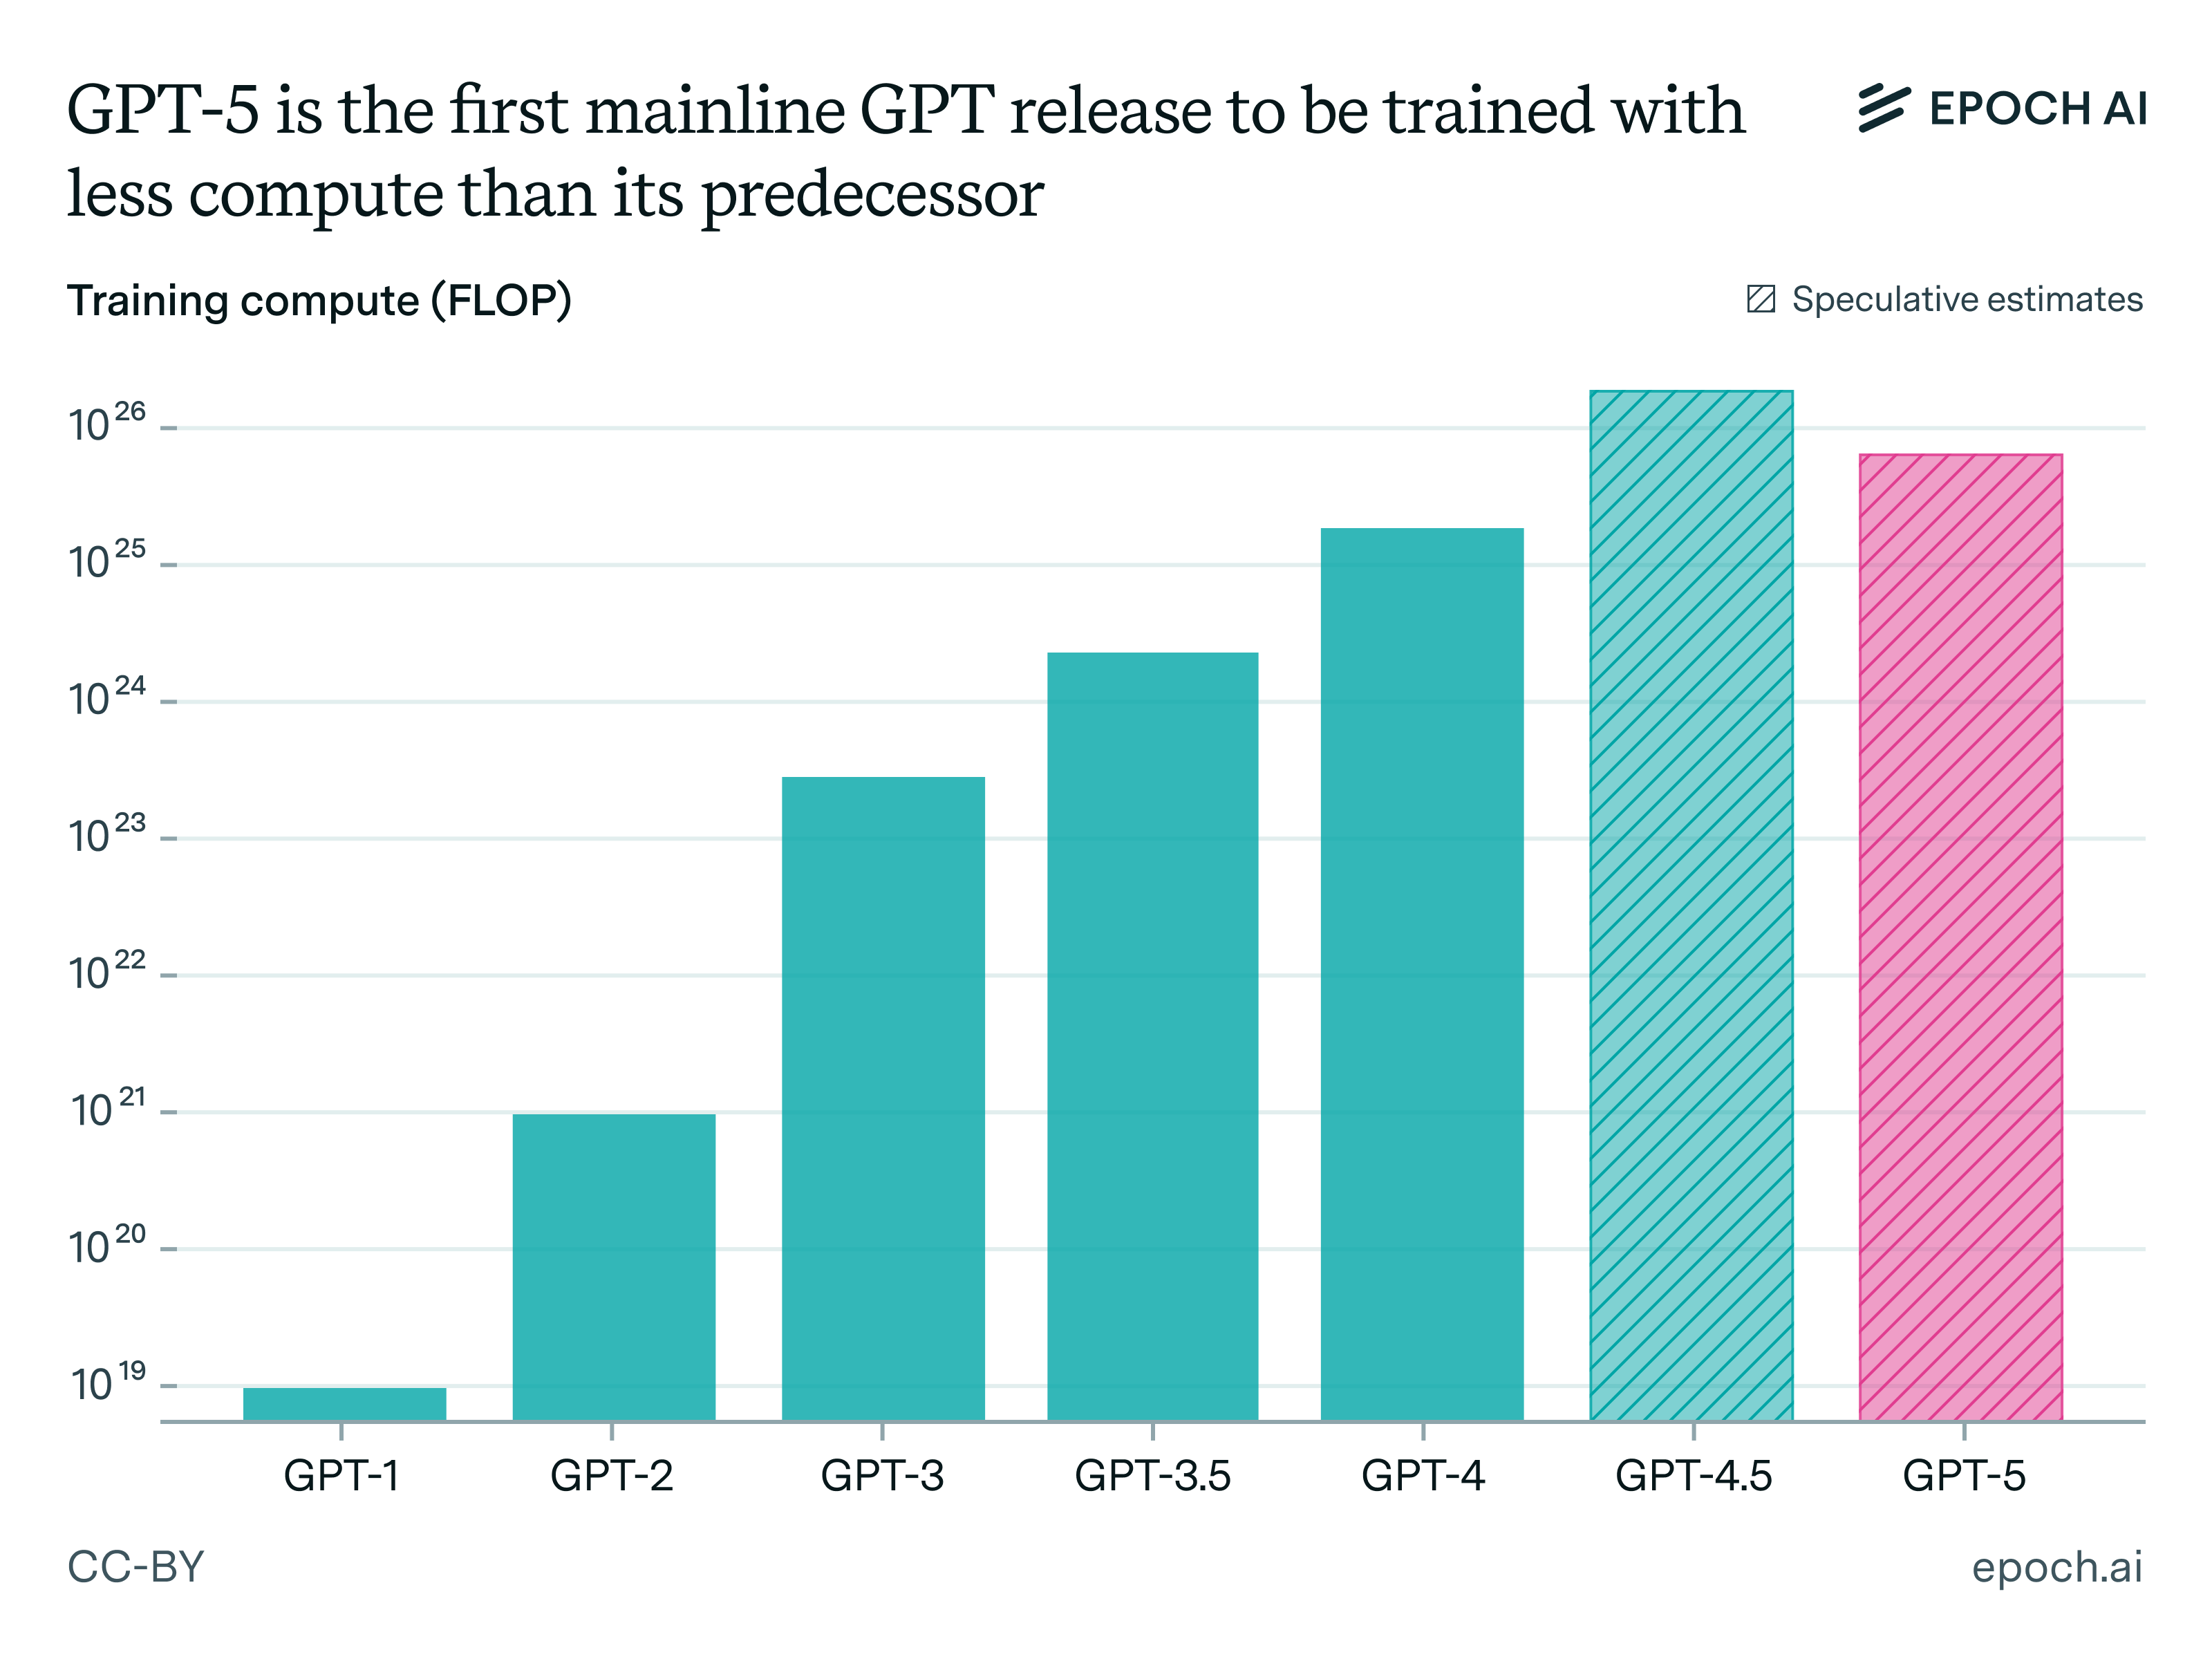
正確な数値は不確かだが、GPT-4.5がGPT-5より多くの学習計算量を使ったことはほぼ確実である。
しかし、ここで一つの謎が生じる。多くの計算量で学習したモデルほど性能が高い傾向があるのに、OpenAIはなぜGPT-5をGPT-4.5より少ない計算量で学習させたのか。そしてこのことは、OpenAIの今後のモデルにとって何を意味するのか。
本稿では、これらの問いへの答えは次のとおりだと論じる。
- GPT-5の学習計算量がGPT-4.5より少なかったのは、OpenAIが事後学習の規模拡大に注力したからである。新しい事後学習の手法を使えば、GPT-4.5より少ない学習計算量でGPT-4.5を上回れるようになった。だが、これらの手法はおそらく、GPT-4.5並みの計算規模に適用できるほどにはまだ成熟していなかった。適用するにはもっと時間(と計算資源)が必要だったはずで、強い市場の圧力のもと、OpenAIはおそらくそれを選ばなかった。
- OpenAIの次の主力モデル(「GPT-6」)は、おそらくGPT-4.5より多くの計算量で学習される。事後学習の規模を実りある形で拡大する方法をOpenAIが見つければ、より多くの学習計算量を使う方向へ戻る可能性が高い。
重要な点として、ここでいう「学習計算量」は、モデルの最終的な学習実行にかかる計算量を指す。実験の実行に使う計算量も含めれば、GPT-5の開発にかかった計算量の総量は、おそらくGPT-4.5より多かった。OpenAIの研究開発(R&D)向け計算資源への支出(予測値)は、2024年の約50億ドルから2025年の約90億ドルへ増えているからだ。2
では、それぞれの論点を順に見ていこう。
Epoch AI の最新情報を受け取る 購読する
GPT-5の学習計算量がGPT-4.5より少なかったのは、OpenAIが事後学習の規模拡大に注力したから
GPT-5の学習計算量はなぜGPT-4.5より少なかったのか。私たちは、二つの要因が組み合わさった結果だと考えている。第一に、OpenAIは、限界的な見返りの大きかった事後学習の規模拡大を優先すると決めた。第二に、当時は事後学習の計算量をGPT-4.5の水準まで簡単には拡大できなかった。仮にGPT-4.5と同じだけ事前学習したモデルで事後学習の規模を拡大しようとしていたら、時間と実験用計算資源の制約に突き当たっていただろう。
最近まで、ほとんどのLLMは事後学習の100倍の計算量を事前学習に使っていた。ところが2024年9月ごろ、研究者たちは「推論モデル」に使われる新しい手法を開発し、事後学習の計算量を効果的に拡大できるようにした。事後学習の計算量を3倍にすることが、事前学習の計算量を3倍にするのと少なくとも同じくらい役立つようになったのである。実際、こうした推論の手法を使えば、同じ性能を保ったまま事前学習の計算量を約10分の1に減らせる。3
つまり、GPT-4.5のように事前学習に約2億ドル、事後学習に200万ドルを費やす代わりに、4新しい事後学習の手法を使えば、同じ200万ドルの事後学習で、事前学習はわずか2,000万ドルのまま同等の総合性能を達成できるようになった。学習費用はおよそ10分の1になる計算だ。ただし、実験の実行に必要な計算量が増えるため、モデル開発の総費用が下がったことまでは意味しない。要するに、OpenAIはおそらくGPT-4.5より少ない計算量でモデルを学習させつつ、コーディングや検索のような多くの有用なタスクでGPT-4.5を上回ることができたのである。
しかし、これで分かるのは、OpenAIが少ない学習計算量でもGPT-4.5を上回り得たということまでで、実際になぜこの戦略を選んだのかは十分に説明できない。たとえば、なぜGPT-4.5をそのまま事後学習しなかったのか。また、なぜ小さなモデルを十分な量のデータで事後学習して、GPT-4.5並みの学習計算量に到達させなかったのか。
根本的な理由は、こうした形で事後学習の規模を拡大するのが難しいことにある。多くの試験と実験が必要で、時間と計算資源がかかる。新しく大きなモデルで行う場合はなおさらである。5また、質の高い事後学習データも大量に必要で、その設計と収集にも時間がかかる。
決定的なのは、OpenAIが市場の圧力のために大きな時間的制約を抱えていたことだ。それは競合するAI企業との激しい競争という形をとり、OpenAIの売上を脅かしていた。たとえば、コーディングではAnthropicのモデルがOpenAIのモデルを一貫して上回っていた。さらに、「GPT-5」という名のモデルが早ければ2023年11月にも公開されると多くの人が予想していたことも、圧力に拍車をかけた。6
こうした制約を踏まえると、OpenAIは小さなモデルで事後学習を可能な限り拡大したのだと私たちは考えている。それ以上拡大するには、計算資源や時間が足りないほどの実験か、手元にない事後学習データが必要だったはずだ。GPT-4.5規模のモデルを事後学習するだけでも時間か実験用計算資源がかかりすぎただろうし、ましてや数か月に及ぶより大規模な事前学習を始め、その上で事後学習を行うとなればなおさらだった。7
こうした事後学習の規模拡大の取り組みから生まれたのがGPT-5であり、OpenAIは8月までにこの最高水準の新モデルを公開できた。
GPT-6はおそらくGPT-4.5より多くの計算量で学習される
これは今後の学習計算量の傾向にとって何を意味するのか。私たちの最善の推測では、今後のGPTはより多くの計算量で学習される。
その理由を知るには、より大きな構図を見るとよい。GPT-5をGPT-4.5より少ない計算量で学習させたことは、より広い傾向の一部である。最高水準のモデルの学習計算量は、1年前に予想されていたよりもゆっくりとしか伸びていないのだ。8事後学習は学習計算量のごく一部にすぎず、その規模を拡大すると大きな見返りが得られたため、AI企業は限られた学習計算量を事前学習ではなく事後学習の拡大に振り向けた。9
実際、こうした推論のための事後学習の手法は、事前学習の計算量よりはるかに速いペースで規模を拡大してきた。10このペースが続けば、事後学習の計算量を3倍にすることは、まもなく計算予算全体を3倍にするのと変わらなくなる。そのため、現在の伸び率はおそらく1年余りしか維持できない。
ということは、このより広い傾向はおそらく終わり、学習計算量がもとの伸びの傾向に戻るかもしれない。この見立てが正しければ、GPT-6はGPT-5よりはるかに多くの学習計算量を必要とし、おそらくGPT-4.5よりも多くを必要とする。それに加えて、OpenAIは保有する計算資源を大幅に増やす計画で、年末までにさらに多くのGPUを稼働させる予定であり、11Stargate Abileneのような大規模クラスターも段階的に稼働していく。
一方で、学習計算量の拡大を阻むボトルネックが、私たちの予想より手ごわい可能性もある。たとえば、質の高い事前学習データの入手可能性や、事後学習用のRL環境の限界によるものだ。そもそも「学習計算量」をどう測るかを定めること自体も難しい。たとえば、大きなモデルを使って小さなモデル用の合成データを生成することは十分ありうる。その場合、小さなモデルの「学習計算量」の総量に、大きなモデルの学習にかかった計算量を含めるべきだろうか。
全体としては、学習計算量はおそらく再び伸びの傾向に戻ると私たちは考えている。ただし、それは長くは続かないかもしれない。12さらに、学習計算量の拡大は鈍っているものの、インフラの整備は続いている。つまり、学習実行の規模に比べて使える計算資源が増えていることになり、学習計算量の拡大は猛烈な勢いで戻ってくる可能性がある。
フィードバックをくれた Josh You、Lynette Bye、David Owen に感謝する。
注
-
OpenAIはこれまで、GPTの(整数の)世代が上がるたびに学習計算量を約100倍に拡大してきたが、GPT-5はこの傾向の例外である。 ↩
-
これらの数値については、いくつか注意すべき点がある。第一に、研究開発向けの計算資源には、実験の実行と最終的な学習実行の両方が含まれる。第二に、これらはThe InformationによるOpenAIの支出予測に基づく推定値であり、不確実性がかなり大きい。第三に、2024年の研究開発向け計算資源の費用は、「モデル学習用の計算資源」の30億ドルと、「研究用計算資源の償却」の10億ドルという二つの別々の数値で報じられている。これが何を意味するのかははっきりしないが、GPUは通常、数年かけて償却される。簡単のため2年間で償却すると仮定すると、研究開発向け計算資源の総額は20億ドル+30億ドル=50億ドルとなる。ただし、4年間で償却すると仮定しても、私たちの主張は変わらない。 ↩
-
ここでの正確な数値は、節約の大きさを示すための大まかな推定値として受け取ってほしい。限られたデータで推定したことと、効果の大きさが個々のベンチマークによって異なることがその理由である。 ↩
-
参考までに、Grok 4の学習費用は約5億ドルであり、GPT-4.5も同程度(ただしやや少ない)と私たちはみている。 ↩
-
大きなモデルほど難しくなる理由の一つは、事後学習の重要な部分である、事後学習用の環境でモデルを動かす作業に、より多くの時間と計算資源が必要になることだ。 ↩
-
GPT-4.5もおそらく、「GPT-5」と呼ばれるはずのモデルを開発しようとした試みだった。 ↩
-
OpenAIがGPT-5で事前学習の計算量を増やさずに事後学習の拡大に注力したとみられるもう一つの理由は、推論実行(インファレンス)の費用を抑えることである。ただし、これがどの程度の役割を果たしたかははっきりしない。たとえば、推論実行の速度や費用を懸念していたのなら、OpenAIは大きなモデルを小さなモデルに蒸留して、より速く安く動かせるようにすることもできたはずだ。 ↩
-
たとえば、GPT-4の公開から2.5年の間に登場した最高水準のモデルの多くは、Claude 3.7 Sonnetやo3のように、GPT-4の3倍未満の学習計算量しか使っていない。他の傾向と比べると、これは遅いように見える。最も計算集約的なモデルの学習計算量は、年5倍のペースで拡大してきたからだ。この食い違いの理由は、最も多くの計算量で学習したモデルが、性能で最高水準にあるとは限らないことにある。たとえば、Llama 4 Behemothのようなモデルはこの3倍という基準を超えたが、ベンチマークで競合企業の最良のモデルをはっきり上回ったわけではなかった。 ↩
-
この傾向には、すでに触れたような他の実務的な要因も寄与している。たとえば、新しい推論の手法は小さなモデルのほうが規模を拡大しやすい。そのため、各社は一時的に、事前学習をさらに拡大するよりも、比較的小さなモデルの公開に注力してきた。 ↩
-
ある推定によれば、この事後学習の計算量は4か月ごとに10倍に拡大できる。これ以上速くならないのは、おそらく、RLによる事後学習のためのRL環境をどれだけ速く構築できるかといった、規模拡大のボトルネックがあるからだ。 ↩
-
Sam Altmanは、OpenAIが年末までに「100万基をはるかに超えるGPUを稼働させる」と投稿したが、これがすべて最上位のGPUである可能性は低い。たとえば、A100、H100、BlackwellのGPUが混在していると考えるのが妥当だろう。 ↩
-
たとえば、事前学習のさらなる規模拡大や、RLによる事後学習の規模拡大によって、そうなる可能性がある。 ↩