
ニュースレター
ソフトウェアによる知能爆発をめぐる議論には実験が必要だ
原題:The software intelligence explosion debate needs experiments
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
人類最高のAI研究者をそれぞれ上回るAIが100万体いるとしよう。そのすべてがAIの進歩に取り組んだら、AIの進歩はどれだけ加速するだろうか。
SFのように聞こえるかもしれないが、これはAIの将来について最も重大な問いかもしれない。問題は、専門家のあいだでその答えが大きく割れていることだ。
一部の人々は、正のフィードバックループを予見している。これらのAIは、より賢いAIを作る新しいアルゴリズムを見つけられるほど賢く、そうして生まれたAIがさらに賢いAIを作り、それが繰り返される。ソフトウェアの進歩だけで、数年分のAIの進歩がたった1年に詰め込まれる事態が、ごく近いうちに見られるかもしれない。「ソフトウェアによる知能爆発」である。1
ほかの人々は、AIの進歩が速まることには同意するものの、何かが爆発的なフィードバックループを妨げると考えている。たとえば、新しいアルゴリズムを見つけるのがだんだん難しくなり、それがAIの自己改善のボトルネックになるかもしれない。あるいは、ソフトウェアの改善が、計算資源のような、そう簡単には増やせない物理的な資源に大きく依存しているかもしれない。
そして、どちらが正しいのかは本当に知っておく必要がある。ソフトウェアによる知能爆発が起こりそうなら、経済力や軍事力が少数の企業や国家にはるかに強く集中するかもしれない。そうした企業や国家は、経済に広く影響を及ぼすことよりも、AI研究の自動化に力を注ぐかもしれない。そうなれば、世界の大半が何が起きているのかに気づく前に、AIの進歩が急速に加速しかねない。
では、なぜ専門家の意見はこれほど割れるのか。そして、どちらが正しいのかをどうすれば見極められるのか。
Epoch AI の最新情報を受け取る 購読する
欠陥のあるデータ
意見が割れる根本的な理由は、強い証拠がないことだ。ソフトウェアによる知能爆発についてのこれまでの実証研究は、欠陥のあるデータとモデルを使ってきた。
先行研究では、研究開発(R&D)の投入が産出にどう結びつくかを表す「ジョーンズ・モデル」が使われてきた。たとえば、R&Dの投入はAI研究者の数、R&Dの産出は、AIのアルゴリズムが学習計算量をどれだけ効率よく使うか(「ソフトウェア効率」)で測ることができる。2
このモデルの中心となるパラメータは「R&Dの収穫」である。この例でいえば、研究者の数を2倍にしたときにソフトウェア効率がどう変わるかを表す。ソフトウェア効率も2倍になるなら、収穫はちょうど1である。4倍になるなら、収穫は2になる。一般に、投入を2倍にしたとき産出が 倍になるなら、収穫は である。
このパラメータが、ソフトウェアによる知能爆発の長期的な力学を左右する。3とくに重要なのは、収穫逓増(つまり )になるかどうかだ。この場合は投入した以上のものが得られ、より賢いAIがさらに賢いAIを再帰的に作る正のフィードバックループが生まれる。4 5
ここまではよい。だが、これを実際に当てはめると問題が出てくる。AIソフトウェアのいくつかの分野について、私たちが推定したこの収穫の値を見てみよう。6
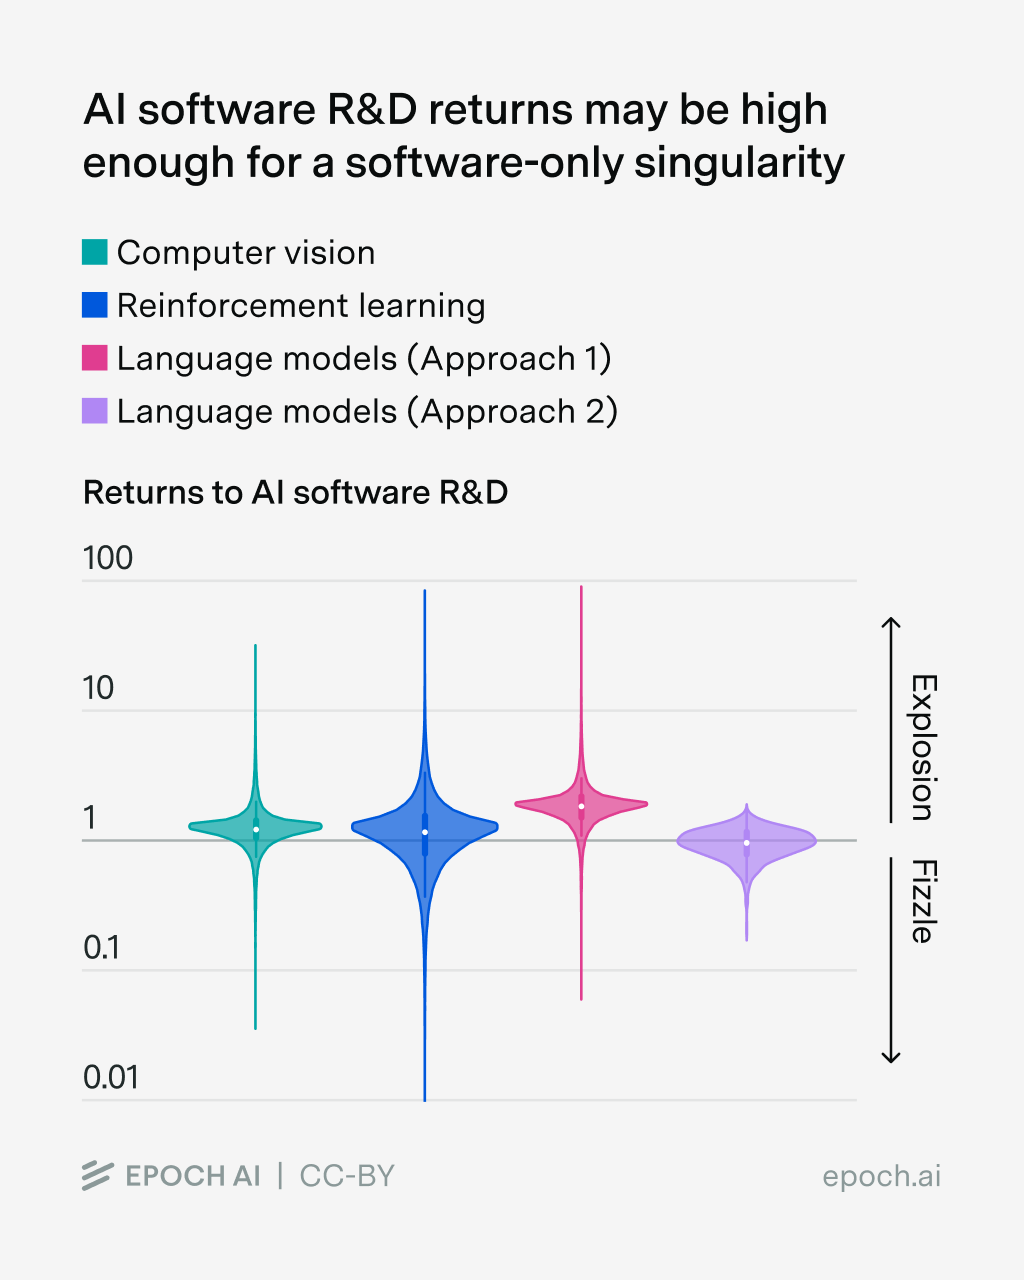
AIの三つの分野、(1) コンピュータビジョン、(2) 強化学習、(3) 言語モデルについて、ソフトウェアのR&Dの収穫を推定したもの。技術的な詳細は付録に示す。
推定では、収穫が複利的に増えていく側にかなりの確率が置かれている。だが不確実性はきわめて大きく、推定値の範囲は という重要な閾値をまたいでいる。そのため額面どおりに受け取れば、ソフトウェアによる知能爆発はかなりありうるように見える。少なくとも、否定するのは難しい。
しかし細部を掘り下げると、大きな問題がいくつも見えてくる。 を推定するには、R&Dの投入と産出についてデータを集める必要があるが、その測り方がきわめて不完全なのだ。
たとえば言語モデルの収穫を推定するために、私たちはまず自然言語処理の分野で発表された論文の数を調べた。これは研究者の数の代理指標であり、研究者によって生産性が異なる(そのため発表する論文の数も異なる)ことも反映している。
だがこれは、AIのほかの分野から波及してくるR&Dの労力をすべて無視している。たとえば Transformer のような言語モデルでは「残差接続」を使うのが一般的だが、この革新はコンピュータビジョンの研究に大きな着想を得たものだった。
そこで私たちは、R&Dの投入を測る第二の指標として、AIラボの人間の労働とAI計算資源の関数も検討した。残念ながら、これも同じような理由で欠陥がある。一部のAI企業の外にいる研究者から波及してくるR&Dの労力を無視しているのだ。7たとえば OpenAI の研究は、学術研究から着想を得ることが多い。
こうした「波及効果」のせいで、実際のR&Dの投入と、私たちが測定する投入とのあいだにずれが生じる。だが、これをどう補正するのが最善かははっきりしない。コンピュータビジョンなど、AIのほかの分野の論文も含めることはできるが、その多くは言語モデルの改善とは無関係だろう!学術界のR&Dの投入を考慮しようとすることもできるが、学術研究の計算資源が時代ごとにどれだけあったかは分からない。全般に、投入についてのよいデータはなく、代理指標か、限られたデータに基づく最善の推測に頼らざるをえない。
これはR&Dの収穫の推定値にとって何を意味するのか。もしかすると、「真の」収穫は観測された値より高いはずだということかもしれない。とくに、研究者の数と計算資源の供給は、どちらもおそらくAIラボより学術界のほうがゆっくり伸びている。8そのため、指標を広げて学術界も含めれば、R&Dの投入の伸びはより遅く測定される。つまり、産出が同じ回数だけ倍増するあいだに投入が倍増する回数は少なくなるので、推定されるR&Dの収穫は高くなる。
R&Dの産出にも同じような問題がある。理想的には、ソフトウェアの質を時期ごとに細かく測った指標がほしいが、残念ながら平均的な伸び率しか得られない。そのため推定値を得るには強い仮定を置かざるをえない。たとえば、ソフトウェアの進歩は一定の速さで進んできたと仮定する。これは既存の実証的な証拠と矛盾しないと言えそうだが、この点についての証拠はかなり弱いと私たちは考えている。実際、推論モデルの台頭は、アルゴリズムの進歩の加速を示すものだったのかもしれない。
全般に、この収穫を推定する際には、データにまつわる数多くの問題に向き合わなければならず、それらは推定値を上にも下にも偏らせうる。9
欠陥のあるモデル
データの問題がなくても、誤解を招く推定値が得られてしまうかもしれない。問題は、ジョーンズ・モデルを、実証的に観測されてきた範囲をはるかに超えて当てはめていることにある。
このモデルはもともと経済全体を対象に書かれたもので、そこでは主な投入である研究者も、主な産出である生産性も、年数%の速さで伸びている。だが私たちが当てはめようとしているのは、投入が数年で何桁も伸びる状況、つまり、AIの働き手がはるかに多くなり、しかもどんどん賢くなっていくソフトウェアによる知能爆発である。だから、ソフトウェアによる知能爆発を考えるのに、ジョーンズの運動法則がかなりひどく誤って定式化されていたとしても、それほど驚くには当たらない。
一つの問題は、ソフトウェアの改善を見つけるには、フロンティアの学習の実行に近い規模の実験を行う必要があるかもしれないことだ。これは結果を大きく変えうる。たとえば先行する実証研究では、こうした計算資源の必要性がソフトウェアによる知能爆発を妨げうるとされた。10だが、この力学を考慮していない先行研究もある。
もう一つの問題は、ジョーンズ・モデルには、ある時点で研究をどこまで並列化できるかについての厳しい上限が含まれていないことだ。11そのため、AI研究者の数を本当に速く増やせば、ソフトウェアの進歩は実質的に即座に無限大になる、とモデルは予測する。だがこれはありそうにない。Alec Radford が無限にいてAI研究をしたとしても、5分で無限のソフトウェアの進歩を得ることはできない。やはり実験を走らせて終わるのを待つ必要があるし、ソフトウェアの革新の中には順を追って起こらなければならないものもあるだろう。そのため、ジョーンズ・モデルを素朴に当てはめると、AIのR&Dが自動化されたときにソフトウェアがどれだけ進歩するかを大幅に過大評価してしまうかもしれない。
最後に、ほとんどの人は知能爆発と聞くと、AIがどんどん賢くなることを思い浮かべる。ところが知能爆発のモデルのほとんどは、AIの数がどんどん増えることを考えている。人々が実際に気にしているのがこちらだとは限らない。GPT-2 のコピーが無限にあっても、世界への影響はほとんどないと言えるだろう。「知能」の向上をモデル化するのが難しいのは、知能が実質的な研究の投入にどう換算されるのかがはっきりしないからだ。2倍賢いことは、研究者が2倍いることと同じくらいよいのだろうか。この点についてのデータはごくわずかで、これを補正したときの含意もはっきりしない。一方では、R&Dにおける知能の収穫はきわめて高く、実質的に を押し上げるかもしれない。他方では、R&Dの産出を知能に置き換えると、知能は実効計算量よりはるかにゆっくりしか伸びてこなかったと考えられ、 は下がる。
問題の一端は、アルゴリズムの進歩の性質がよく分かっておらず、どのモデルが正しいのかを判断できないことにある。そのため、R&Dへの投資の拡大といったことの影響を、過大評価したり過小評価したりしかねない。
前に進むには実験が必要だ
これまでのところ、ソフトウェアによる知能爆発を捉えようとする取り組みのほとんどは、理論的なモデル化か、概念的な議論か、雑然とした現実のデータの統計分析によるものだった。その一因は、ソフトウェアによる知能爆発を厳密に考えてきた人がほとんどいないことにある。また、考えてきた人々にとっては、こうした手法のほうが自分の技能に合っていたり、実施するのに安上がりだったりした。
しかし、既存のデータから得られる価値は、こうした手法ですでにほぼ搾り取られたと私たちは考えている。いま追加で取り組むなら、よりよい手法がある。実験である。実験を使えば、仮説をより直接に検証し、交絡要因を取り除いた、はるかに質の高いデータが得られる。また、主要な仮定が成り立つかどうかを検証できるので、たとえばどのモデルを使うかといった点で、ソフトウェアによる知能爆発についての考え方に役立つ。
とくに重要だと私たちが考える例をいくつか挙げよう。
ソフトウェアの進歩のうちどれだけがデータによるものかを調べる。ソフトウェアの改善の大半がデータの質の向上によるものだと分かれば、ソフトウェアによる知能爆発が起こる見込みについての私たちの確信度は下がるかもしれない。12しかし既存の手法は、実際の論文を大局的に統計分析するもので、どのアルゴリズムや学習データが使われるかを制御できない。そのため、どの革新が最も重要なのか、データがどれほど重要なのかを判断しにくい。対照的に、実験なら、はるかに高い度合いで条件を制御できる。
計算資源がソフトウェアの進歩のボトルネックにどれだけなっているかを理解する。ソフトウェアによる知能爆発では、計算資源をそれほど増やさなくても、ソフトウェアが大きく進歩しうる。そこで知りたいのは、実験にあまり計算資源を使わずに、最高水準を押し上げる新しいアルゴリズムを見つけるのがどれほど難しいかである。しかし、それがどれほど容易なのかを教えてくれる現実のデータはあまりない。そこで、それが可能かどうかを実験で確かめたい。たとえば、計算資源の予算を研究者に無作為に割り当て、それが研究者の実現できるソフトウェアの革新の量にどう影響するかを見る、といったことが考えられる。小規模な学習の実行でうまくいくアルゴリズムが、大規模な学習の実行にどれだけうまく通用するかを調べるスケーリング実験も行いたい。それが簡単に通用するなら、計算資源は私たちが考えるほど大きなボトルネックではないかもしれない。
大事なのは、実験さえすれば万事解決するわけではないということだ。欠陥のあるモデルを使い続けることになるかもしれない。実験が現実的でない場合もある。たとえば、ソフトウェアの革新がフロンティアの学習規模でどれだけうまく通用するかを検証したければ、フロンティアの学習の実行ができるだけの計算資源が必要になる!そうなると、この種の問いを研究できる主体は劇的に限られる。だから私たちは、実験によってソフトウェアによる知能爆発についての問いが「解決」するとは考えていない。
また、ほかの手法にもまだ役割はある。たとえば、ソフトウェアの進歩を最も強く制約している投入は何か、つまり知能なのか、計算資源なのか、エンジニアなのか、それとも別の何かなのかを知りたいとしよう。実験的な手法のほかに、ソフトウェアの進歩が主に計算資源の豊富な大手ラボから生まれているのか、それとも同じ顔ぶれの研究者から繰り返し生まれているのかを調べることもできる。
それでも、いま追加で取り組むなら、ソフトウェアのシンギュラリティについての理解を深めるのに最も有望な道は実験だと私たちは考えている。そして、ソフトウェアによる知能爆発が本当に起こるのなら、こうした問いについての証拠をできるだけ早く集めることがとりわけ重要になるかもしれない。
本稿にフィードバックをくださった Greg Burnham、JS Denain、Jaime Sevilla、Lynette Bye、Phil Trammell の各氏に感謝する。
技術的な付録
本文では、結果を幅広い読者に伝えるため、技術的な詳細の多くを省いた。だが、このニュースレターの読者のうち技術に関心の強い方は、私たちのモデル化やデータの選び方にも興味があるだろうから、ここで具体的に示す。
ジョーンズ・モデルを使ったR&Dの収穫の推定
をソフトウェアの質の何らかの尺度とし、これがジョーンズ型のアイデア生産関数によって改善されるとする。
は、アイデアが時間とともに見つけにくくなる可能性を表し、 は、実験用の計算資源 と認知的労働 が与えられたときの実質的な研究の投入を表す。研究が自動化され、 が、シミュレートされるAI研究者の実質的な人数に比例するようになったとしよう。この人数は、ある定数 を使って で表される。13
このモデルによれば、 ならソフトウェアの進歩は双曲線的に伸びる。本文の用語でいえば、 が「AI研究の収穫」である。したがって、AIソフトウェアの研究の収穫が十分に高ければ、ソフトウェアだけによる知能爆発が起こる。
次の節では、フロンティアの言語モデルについてAI研究の収穫をどう推定するかを説明する。これを測るうえで鍵となるのは、 を表す何らかの投入の指標を得ることである。
手法1:論文の数
一つの手法は、生み出される論文の数で を代理することである。14これは先行研究で使われたのと同じ手法である。
これを、ソフトウェアの進歩の速さについて推定値があるAIの分野、すなわちコンピュータビジョン、強化学習、言語モデリングについて行う。これらの推定値を使って「ソフトウェアの質」を定義し、15それを産出の指標として使う。16
各年の論文数のデータは OpenAlex から取得し、次の「コンセプト」コードで論文を特定する。
- コンピュータビジョン:Computer vision (C31972630) と Deep learning (C108583219)
- 強化学習:Reinforcement learning (C97541855)
- 言語モデル:Natural language processing (C204321447) と Deep learning (C108583219)
得られたパラメータの推定値を下の表に示す。
| コンピュータビジョン | 強化学習(Atari) | 自然言語処理 | |
|---|---|---|---|
| 1.302(0.269〜5.571) | 1.299(0.241〜5.581) | 1.586(0.322〜7.148) | |
| 1.038(0.245〜4.259) | 1.165(0.250〜4.362) | 0.835(0.187〜3.637) | |
| 1.262(0.727〜2.094) | 1.201(0.380〜2.708) | 1.892(1.069〜3.212) |
R&Dの投入を特定分野の論文数で代理した場合の、ジョーンズ・モデルの主要パラメータの推定値。中央値を示し、括弧内に90%信用区間を示す。この分析のコードはこの GitHub リポジトリにある。
そのうえで、ベイズ推論を使ってR&Dの収穫を推定する。17コンピュータビジョンや強化学習と同じく、言語モデルでも の中心推定値は1を超え、実は言語モデルのほうが中心推定値は高い。しかも90%信用区間も1を上回っており、ソフトウェアによる知能爆発を示唆している!一方で、これらの推定値はどれも不確実性がきわめて大きいので、分野ごとの信頼区間はかなり重なっている。
代理指標2:認知的労働と実験用の計算資源の何らかの関数
実際には、論文はR&Dの投入の代理指標としては不十分だと考えられるかもしれない。たとえばAIのR&Dでは多くの人がモデルを学習させているが、「発表された論文の数」はそうした人々をまったく直接には表していない。
そこで別の手法として、R&Dの投入を、2022〜2025年の OpenAI の学習計算量とAI研究者の労働の何らかの関数として扱うものを考える。
次の手法では、 を代理するのではなく、直接測ることを試みる。ソフトウェアの進歩が一定の速さで伸びていると仮定しよう。これはこれまでに得られている実証的な証拠と矛盾しない(こちらとこちらを参照)。このことは、ジョーンズの方程式が定常状態にあることを意味する。すなわち、
この式で、、、 はそれぞれ 、、 の伸び率を表す。 は に関する の弾力性を表す。つまり を1%増やすと、 は %増える。この式を整理すると次のようになる。
直観的には、この式は が研究の産出を研究の投入で割った比に等しいことを表している。ここで、ChatGPT が初めて公開された2022年11月以降のフロンティアAIラボを考えれば、右辺の各項を推定できる。なお、伸び率は底を として示す。
- :OpenAI の年間の計算資源への支出のデータから
- :OpenAI の従業員数の推移のデータから
- :市場が競争的なら、資本に関する産出の弾力性は計算資源の割合、すなわち研究資金のうち研究者ではなく計算資源に費やされる割合に等しくなるはずであることに基づく。計算資源の割合は0.59〜0.75程度だと推測している。18中心推定値としては、その平均の0.67をとる。19
:言語モデルにおける学習計算量の効率の向上についての推定値に基づく。
この手法のよいところは、「論文の数」という弱い代理指標に頼らないことだ。その代わりに、ソフトウェア効率が一定の速さで伸びてきたという追加の仮定を置く必要がある。
計算資源のボトルネック
Whitfill and Wu 2025 や Erdil and Barnett 2025 が指摘しているように、ジョーンズ・モデルの問題の一つは、計算資源のボトルネックがありうることだ。
厳密にいえば、 が、持続的な成長に両方の投入が欠かせない生産関数であるとする。このとき、シミュレートされるAIが増えて が増加していても、実験用の計算資源 が速く伸びていなければ、 はシミュレートされるAIの数ではなく、実験用の計算資源に比例するようになる。そうなれば、 がどんな値であっても、知能爆発の論拠は崩れる。
考えるべき基準ケースの一つは、コブ・ダグラス型の基準である。
この場合、 が足りなくても、 を増やせば常に産出を増やせるので、進歩が完全に止まるわけではない。ただし、 と の両方ではなく だけを増やすことには、いくらかの不利が伴う。この仮定のもとでは、知能爆発の鍵となるパラメータは になる。
という私たちの推定値を踏まえると、 の推定値はすべて3分の1にしなければならず、どれも1を下回る。
ジョーンズ・モデルにおける並列化の可能性
ジョーンズ・モデルの並列化の問題に対処するため、Phil Trammell は、R&Dの投入の効果が現在のソフトウェアの質の水準を介して決まる別のモデルを提案している。それを次の式に示す。 はソフトウェアの質、 は研究の投入である。
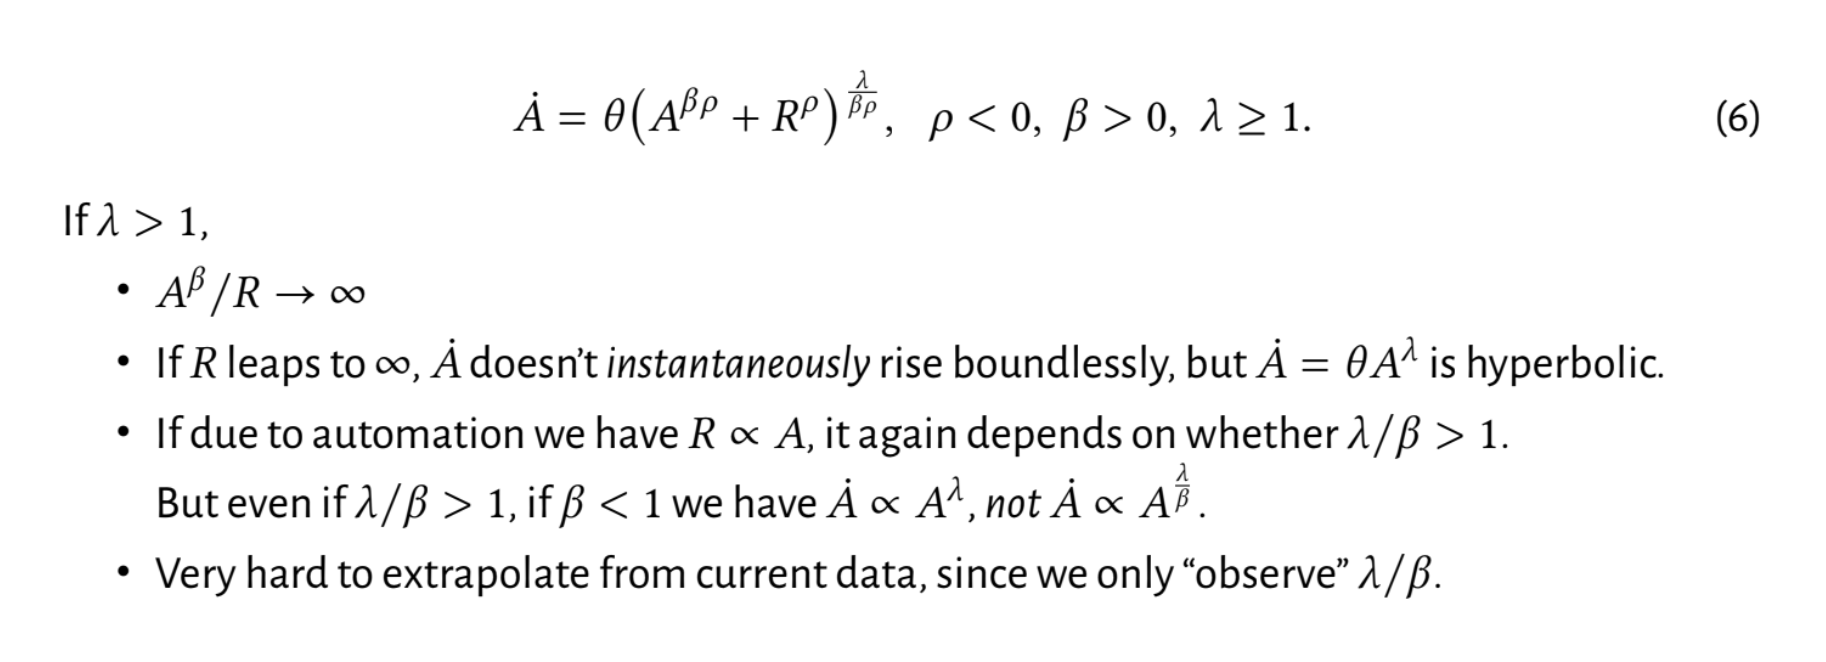
ここでは右辺の と のあいだの CES 関数のため、 である以上、 を大幅に増やすだけで をすぐに大幅に増やすことはできない。だが、これで並列化の問題には対処できるものの、残念ながら推定はより難しくなる!
注
-
これは「ソフトウェアだけによるシンギュラリティ」と呼ばれることもある。↩
-
モデルの全体は技術的な付録で説明する。↩
-
短期的には事情はもっと複雑かもしれない。このパラメータが主に決めるのは、AIのR&Dの短期的な力学ではなく、長期的な漸近的力学である。↩
-
なら、このフィードバックループは尻すぼみに終わる。 は、投入の伸びに比例して産出が伸びる特殊なケースだが、この場合も大規模な「知能爆発」は起こらない。↩
-
これは、ソフトウェアによる知能爆発が起きるときにだけAIがAIを改善する、という意味ではない。AIによるAIの改善はいずれにせよ起こる。問題は、その改善が「尻すぼみ」に終わるのではなく、「爆発」につながるほど速く起こるかどうかである。↩
-
データとモデルの技術的な詳細は、技術的な付録に示す。↩
-
これに対する反論の一つは、大手AI企業の外で提案されたアルゴリズムの革新は、フロンティアAIモデルの計算規模で通用するかどうかが分からないので、はるかに役に立たない傾向があるかもしれない、というものだ。↩
-
数字の感覚をつかむために挙げると、OpenAI はこの1年で計算資源のストックを2倍超に増やしており、AI企業は毎年従業員数をほぼ倍増させている。関連して、GPUクラスタに占める民間企業のシェアは高まっており、注目すべき機械学習モデルに占める学術界のシェアは時とともに低下してきたことも分かっている。そのため、OpenAI と学術界を合わせて見れば、労働と計算資源の両方、したがってR&Dの投入全体の伸びは、より遅く測定されるだろう。↩
-
さらに、投入と産出の指標そのものが、きわめて不確かなことも多い。たとえば既存のソフトウェアの進歩の推定値自体が、観察データに基づく推定である。R&Dの収穫についての先行研究の推定値にも非現実的なところがある。たとえば、ジョーンズの運動法則で研究の投入にかかる指数が1を超えているので、研究者を2倍にするとソフトウェア効率が2倍を超えて伸びうることになる!その一因は、データの制約のために個々の指数をうまく推定できないことだが、それでも全体の収穫ならそれなりにうまく推定できるだろう、というのが期待である。↩
-
具体的には、Whitfill and Wu 2025 は、計算資源と労働が補完財なのか代替財なのかを推定している。フロンティア規模が必要だという力学を考慮しなければ、計算資源と労働は代替財だという結果になる。だが、これを考慮すると、両者は非常に強い補完財だという結果になる!↩
-
さらに別の問題として、このモデルでは、計算資源と労働に基づいて研究の投入を代理する際に、データが明示的に入っていない。実際には、能力を高めるにはデータも欠かせない。↩
-
一方で、AIシステムは、検証やフィルタリング、より多様な問題の生成、質の高い強化学習環境の構築の手助けなどを通じて、データの質を高めうる。そのため、ソフトウェアの改善の大半が結局はデータの質に帰着するとしても、ソフトウェアによる知能爆発が起こることは考えられる。↩
-
が推論実行の計算効率なら、この式は厳密に成り立つ。 が学習計算量の効率なら、この式が成り立つのは、AI研究者の実質的な人数が(AIが賢くなっていくため)学習計算量に比例する場合に限られる。↩
-
このデータは OpenAlex から取得したもので、「Natural Language Processing」と「Deep learning」の両方に分類された論文に基づく。↩
-
ソフトウェアの質を定義するのは難しいが、過去の年のアルゴリズムを基準にして定義できる。たとえば2024年を起点に選び、その年のソフトウェアの質を1と定義する。2024年のモデルと比べて、2025年のモデルは同じ性能を出すのに必要な学習計算量が3分の1程度で済むかもしれない。そうであれば、2025年のアルゴリズムのソフトウェアの質は2024年のアルゴリズムの3倍だということになる。なお、これは、ある年のソフトウェア(アルゴリズムとデータ)がすべて同じ質だという疑わしい仮定を置いている。↩
-
厳密にいえば、これらの研究が示しているのはR&Dの産出の指標そのものではなく、その単一の伸び率である。コンピュータチェスのようなほかの分野では、チェスエンジンの ELO スコアを見ればよいので、R&Dの産出についてはるかに質の高いデータがある。それによって、単一の平均的な傾向ではなく時系列が得られる。↩
-
この手法の詳細は Erdil, Besiroglu and Ho 2024 にある。この論文に基づき、結果を偏らせないよう、比較的情報量の少ない事前分布を選んでいる。そこでは指数関数的な成長が典型的な結果となる。最尤推定のような手法ではなくこの手法を使う必要があるのは、実際の時系列ではなく、期間全体を通した一つの傾向しか得られないからだ。↩
-
この推定値は OpenAI の2024年の予算から取った。それによれば給与に7億、研究用の計算資源に10億が費やされており、単純に計算すると資本の割合は59%になる。研究スタッフへの支出だけを対象に補正し、株式報酬とより広い範囲のR&Dを含める、より精緻な分析をすると、約75%になる。↩
-
この項は時間がたっても一定とは限らないので、ある時点のスナップショットと考えてほしい。↩