
論文
AIベンチマークのロゼッタストーン
原題:A Rosetta Stone for AI benchmarks
はじめに
AIの能力を測るとき、私たちはベンチマークに頼っている。だが最良のベンチマークでさえ、AIにできることの狭い一端をのぞかせるにすぎない。
あるベンチマークを考えてみよう。モデルの性能がかなり低ければ、そのベンチマークのスコアは0%になる。だが、性能がきわめて低いモデルでも同じことが起きる。一方がもう一方よりずっと優れていても、ベンチマークからはこの二つのモデルを見分ける手がかりが得られない。
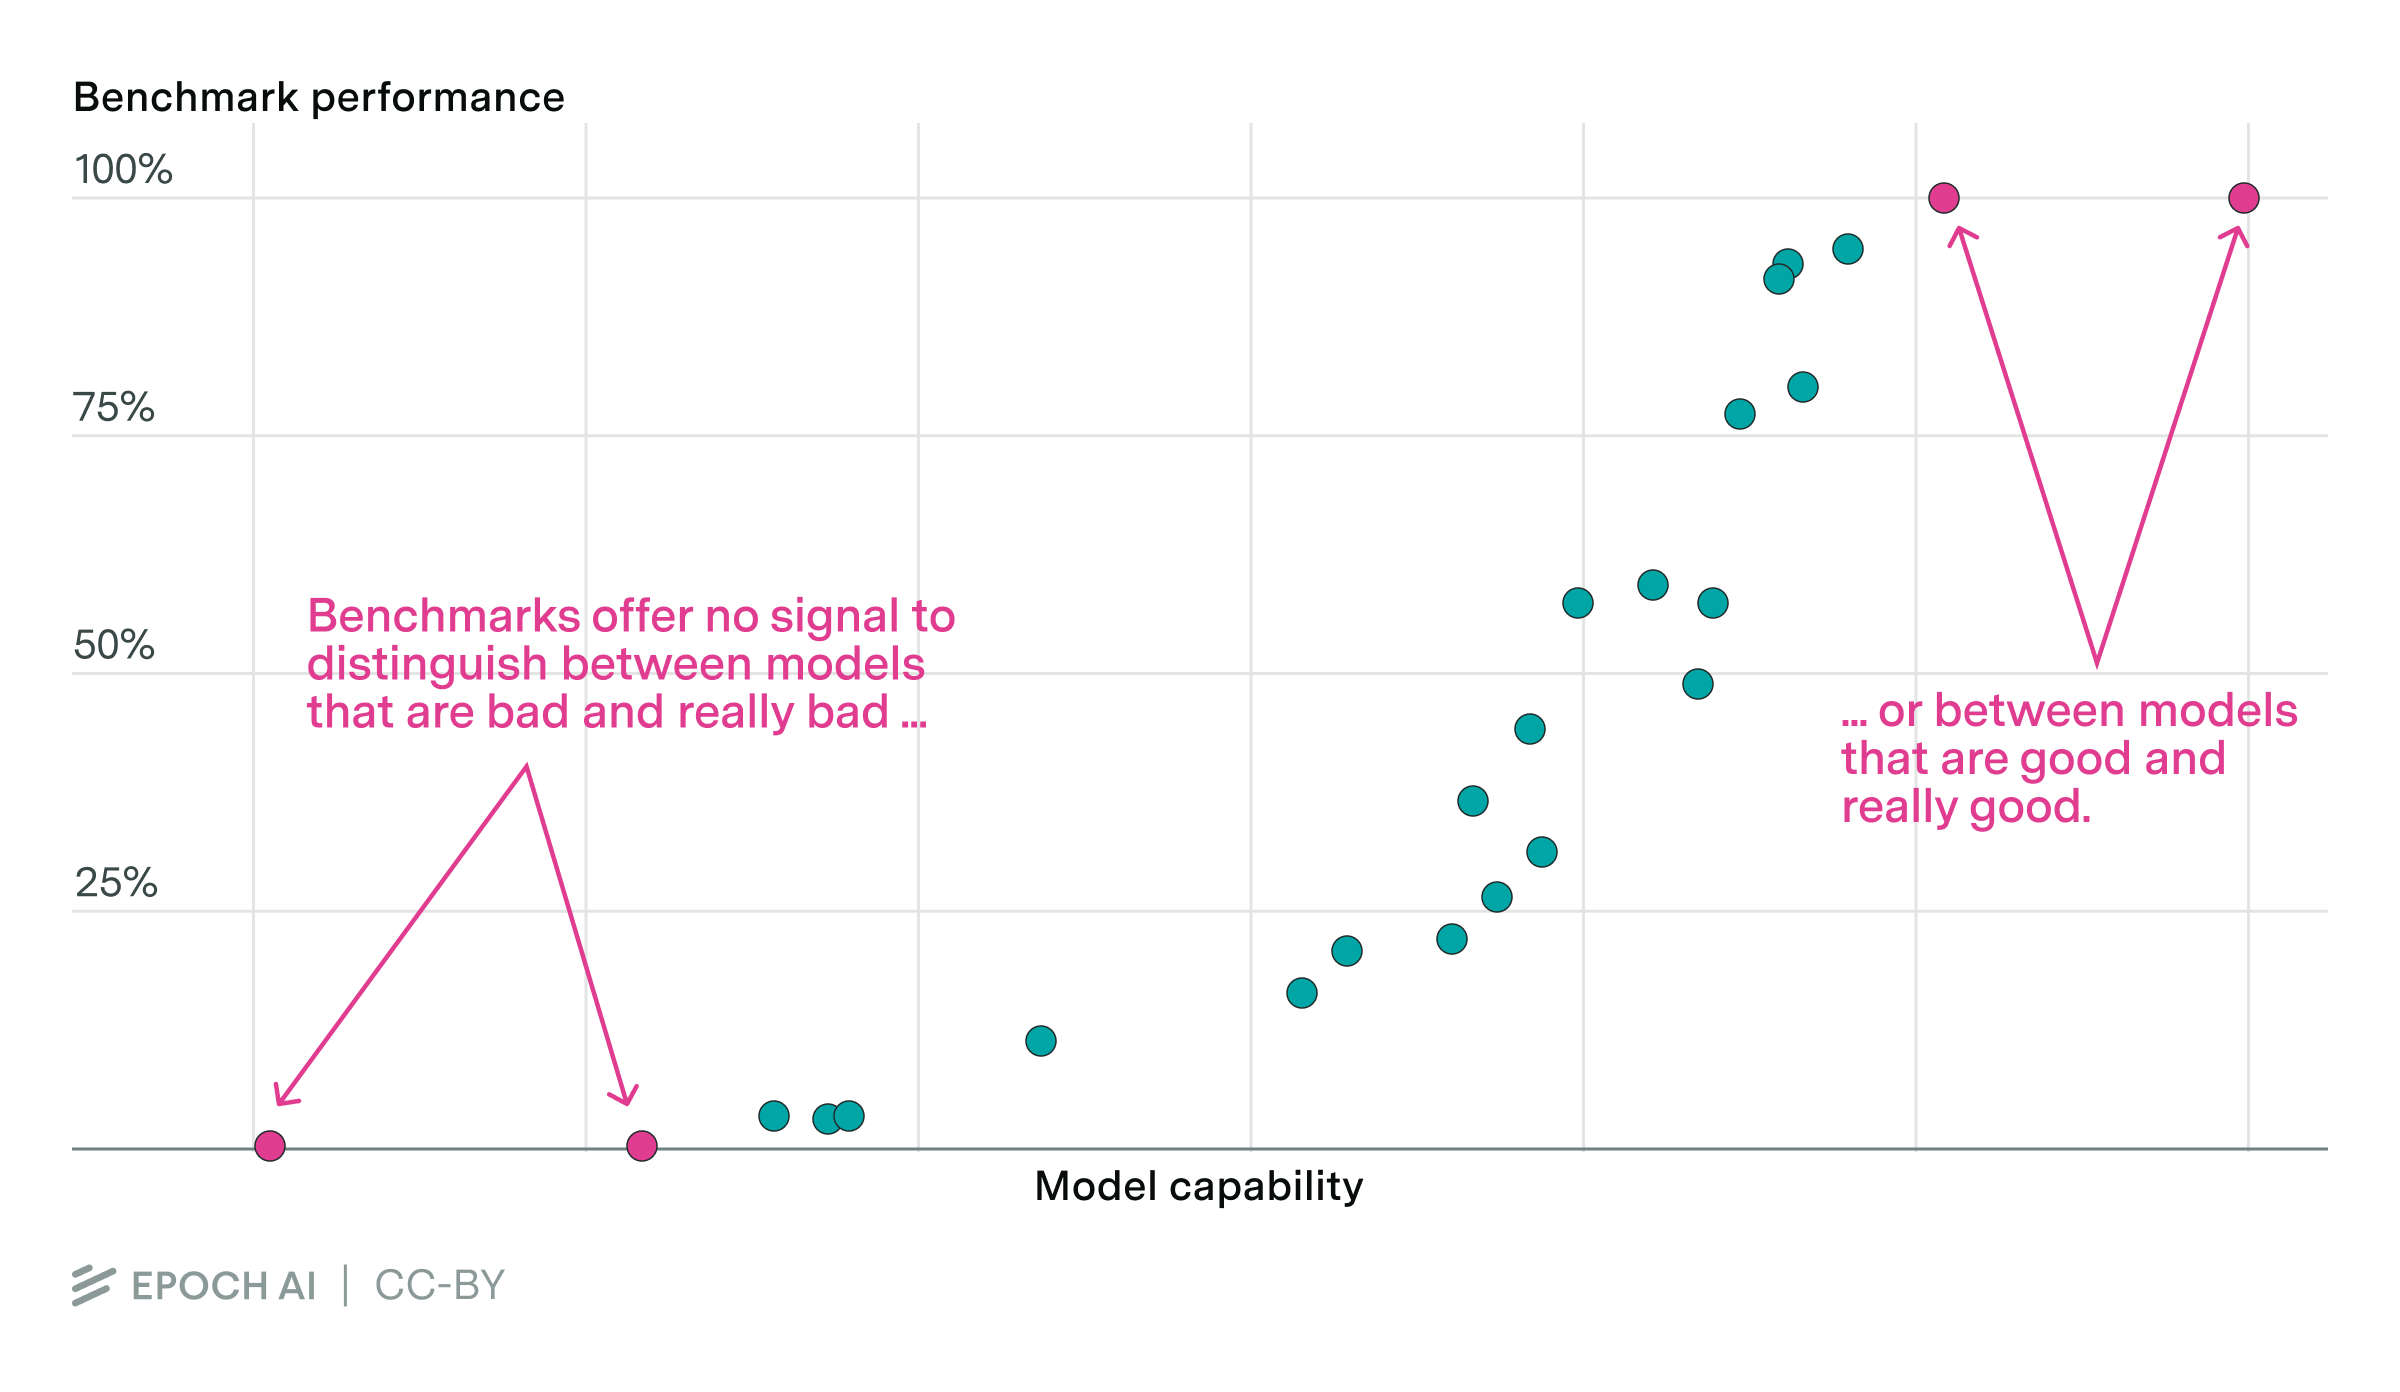
同じように、かなり優れたモデルのスコアは100%になるが、きわめて優れたモデルも100%になる。優れたモデルどうしも見分けられないのだ。
モデルを比べられるのは、モデルが中間にいるとき、つまり良すぎも悪すぎもしないときだけである。しかもモデルは急速に向上するので、中間にいる期間はごく短い。そのため、AIの進歩が加速しているのか、減速しているのか、壁に突き当たっているのかという長期的な動向が見えない。
新しい手法
では、どう解決すればよいのか。私たちは新しい手法を提案する。統計モデルを使い、難しさの異なる複数のベンチマークを一つの枠組みのもとで「つなぎ合わせる」のである。これはいわばAIベンチマークのロゼッタストーンで、幅広いベンチマークのあいだを翻訳し、同じベンチマークで評価されていないモデルどうしでも比べられるようにする。
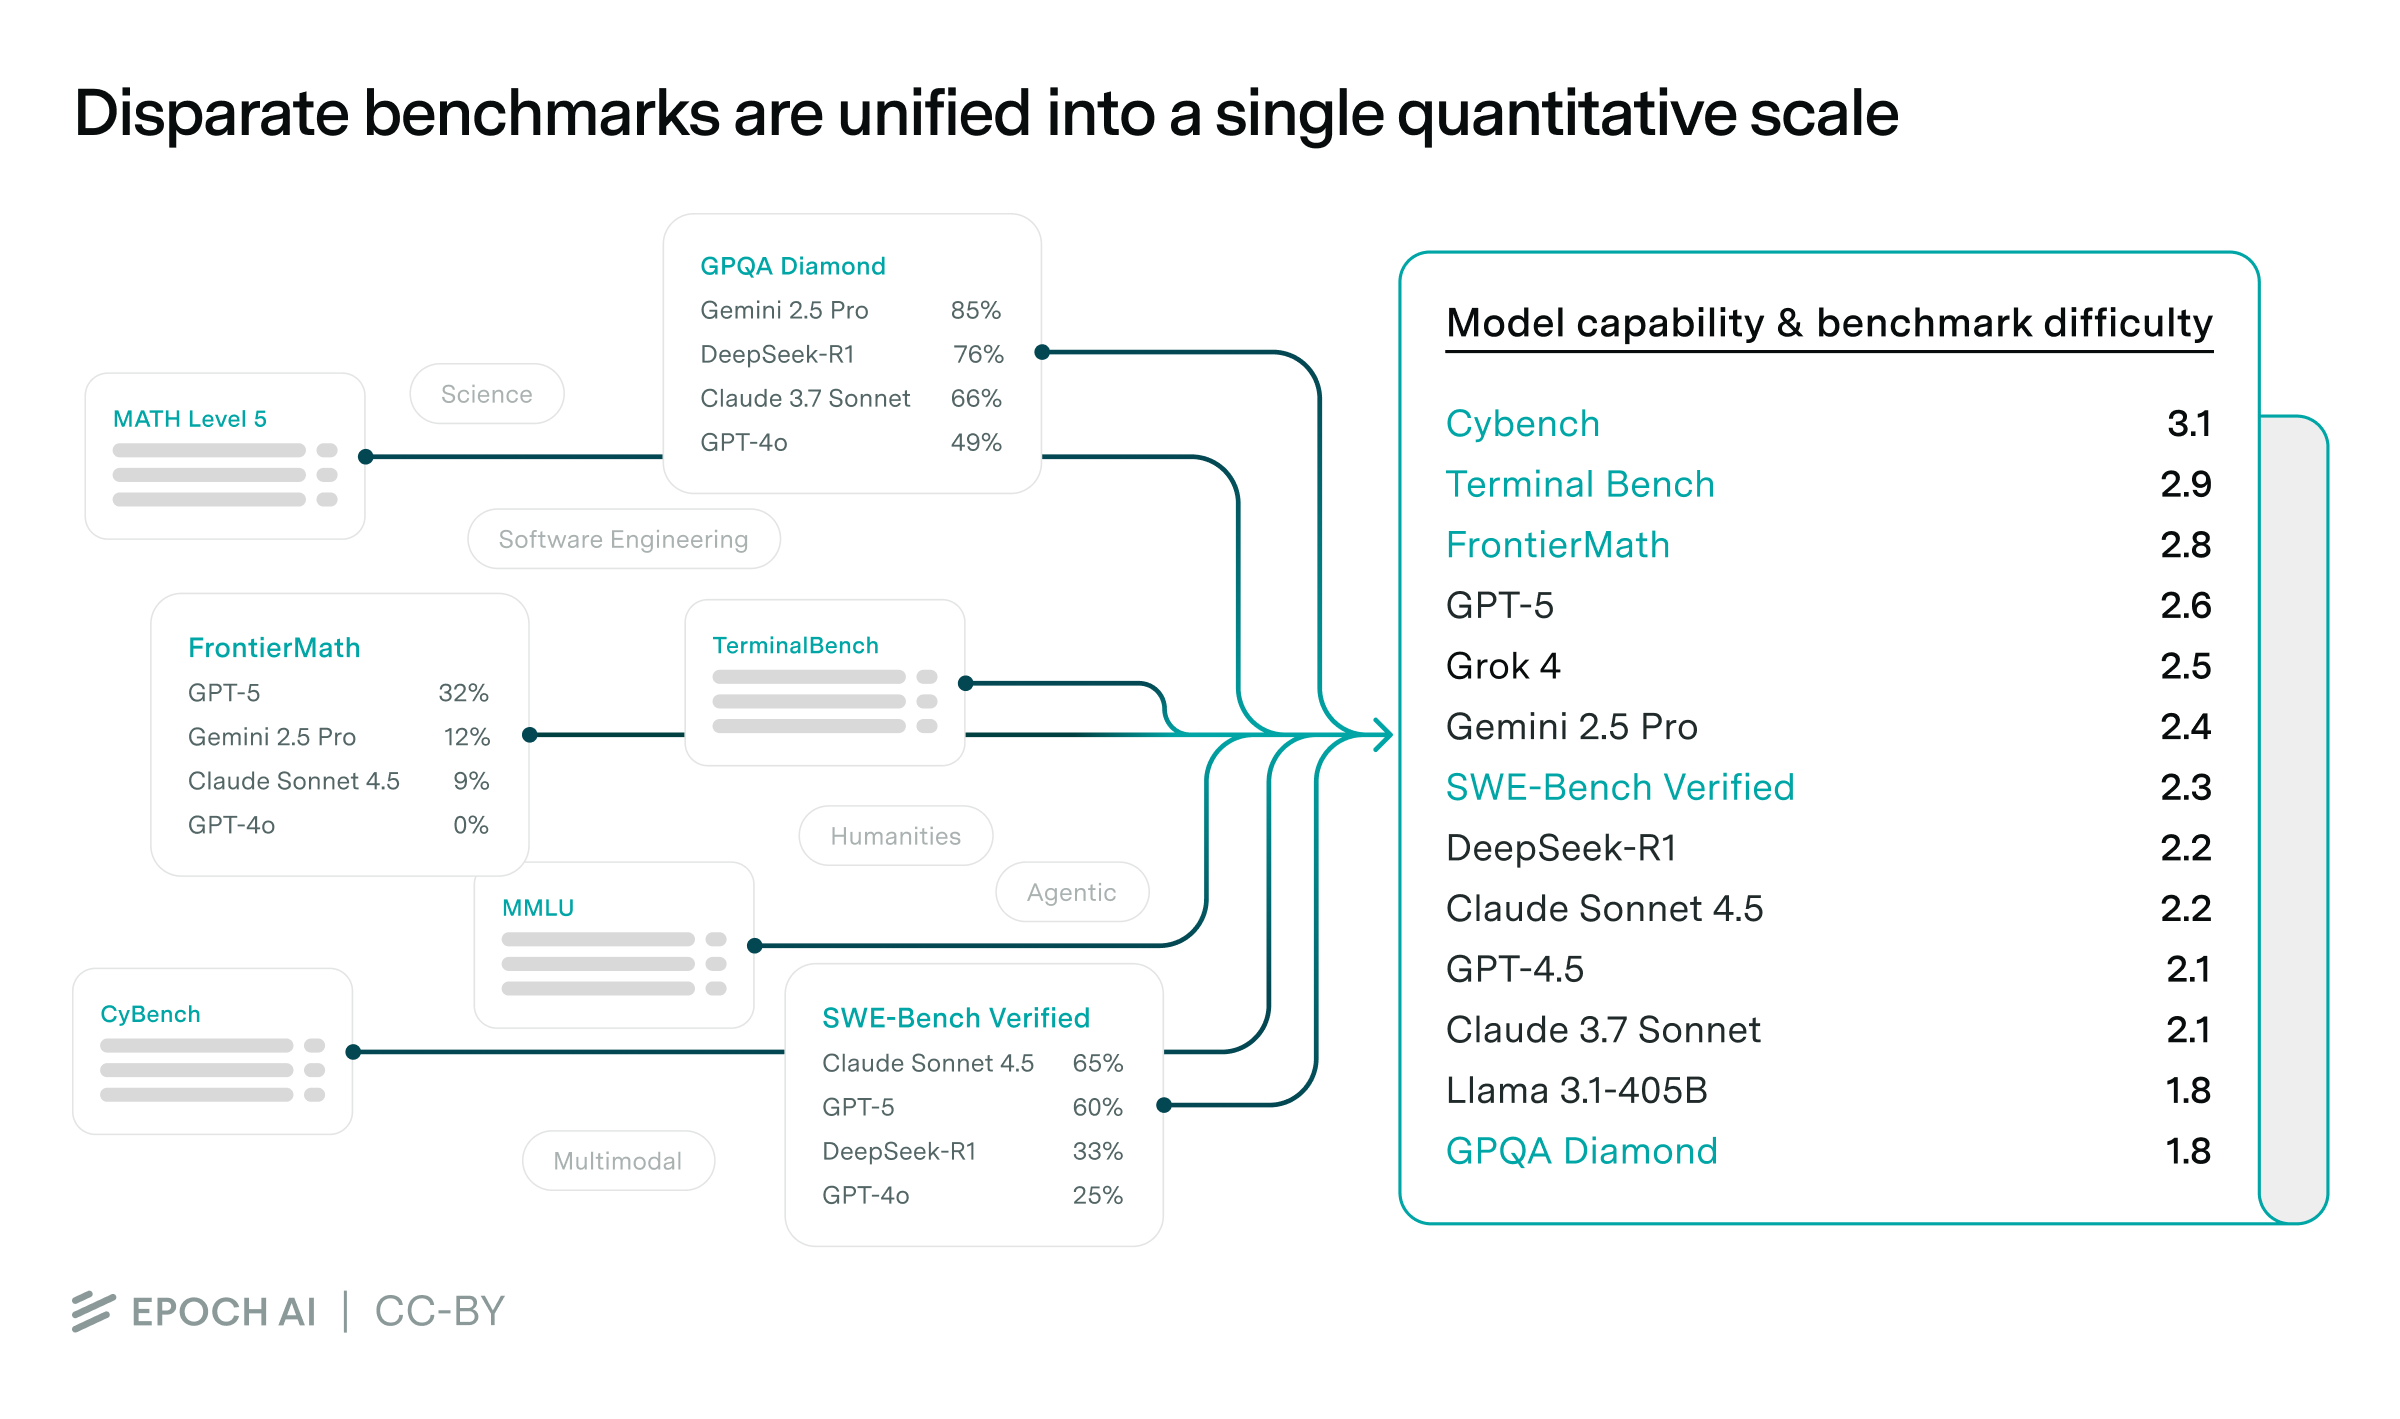
では、どういう仕組みなのか。中心となる考え方は、各モデルがその「能力」を表す一つの数値をもつと仮定することだ。チェスの棋士がイロレーティングをもつのに似ている。同様に、各ベンチマークは「難しさ」を表す一つの数値をもつ。チェスのパズルにもイロレーティングがあるのと似ている。最後に、各ベンチマークは、どれだけ早く飽和するかに対応する「傾き」をもつ。
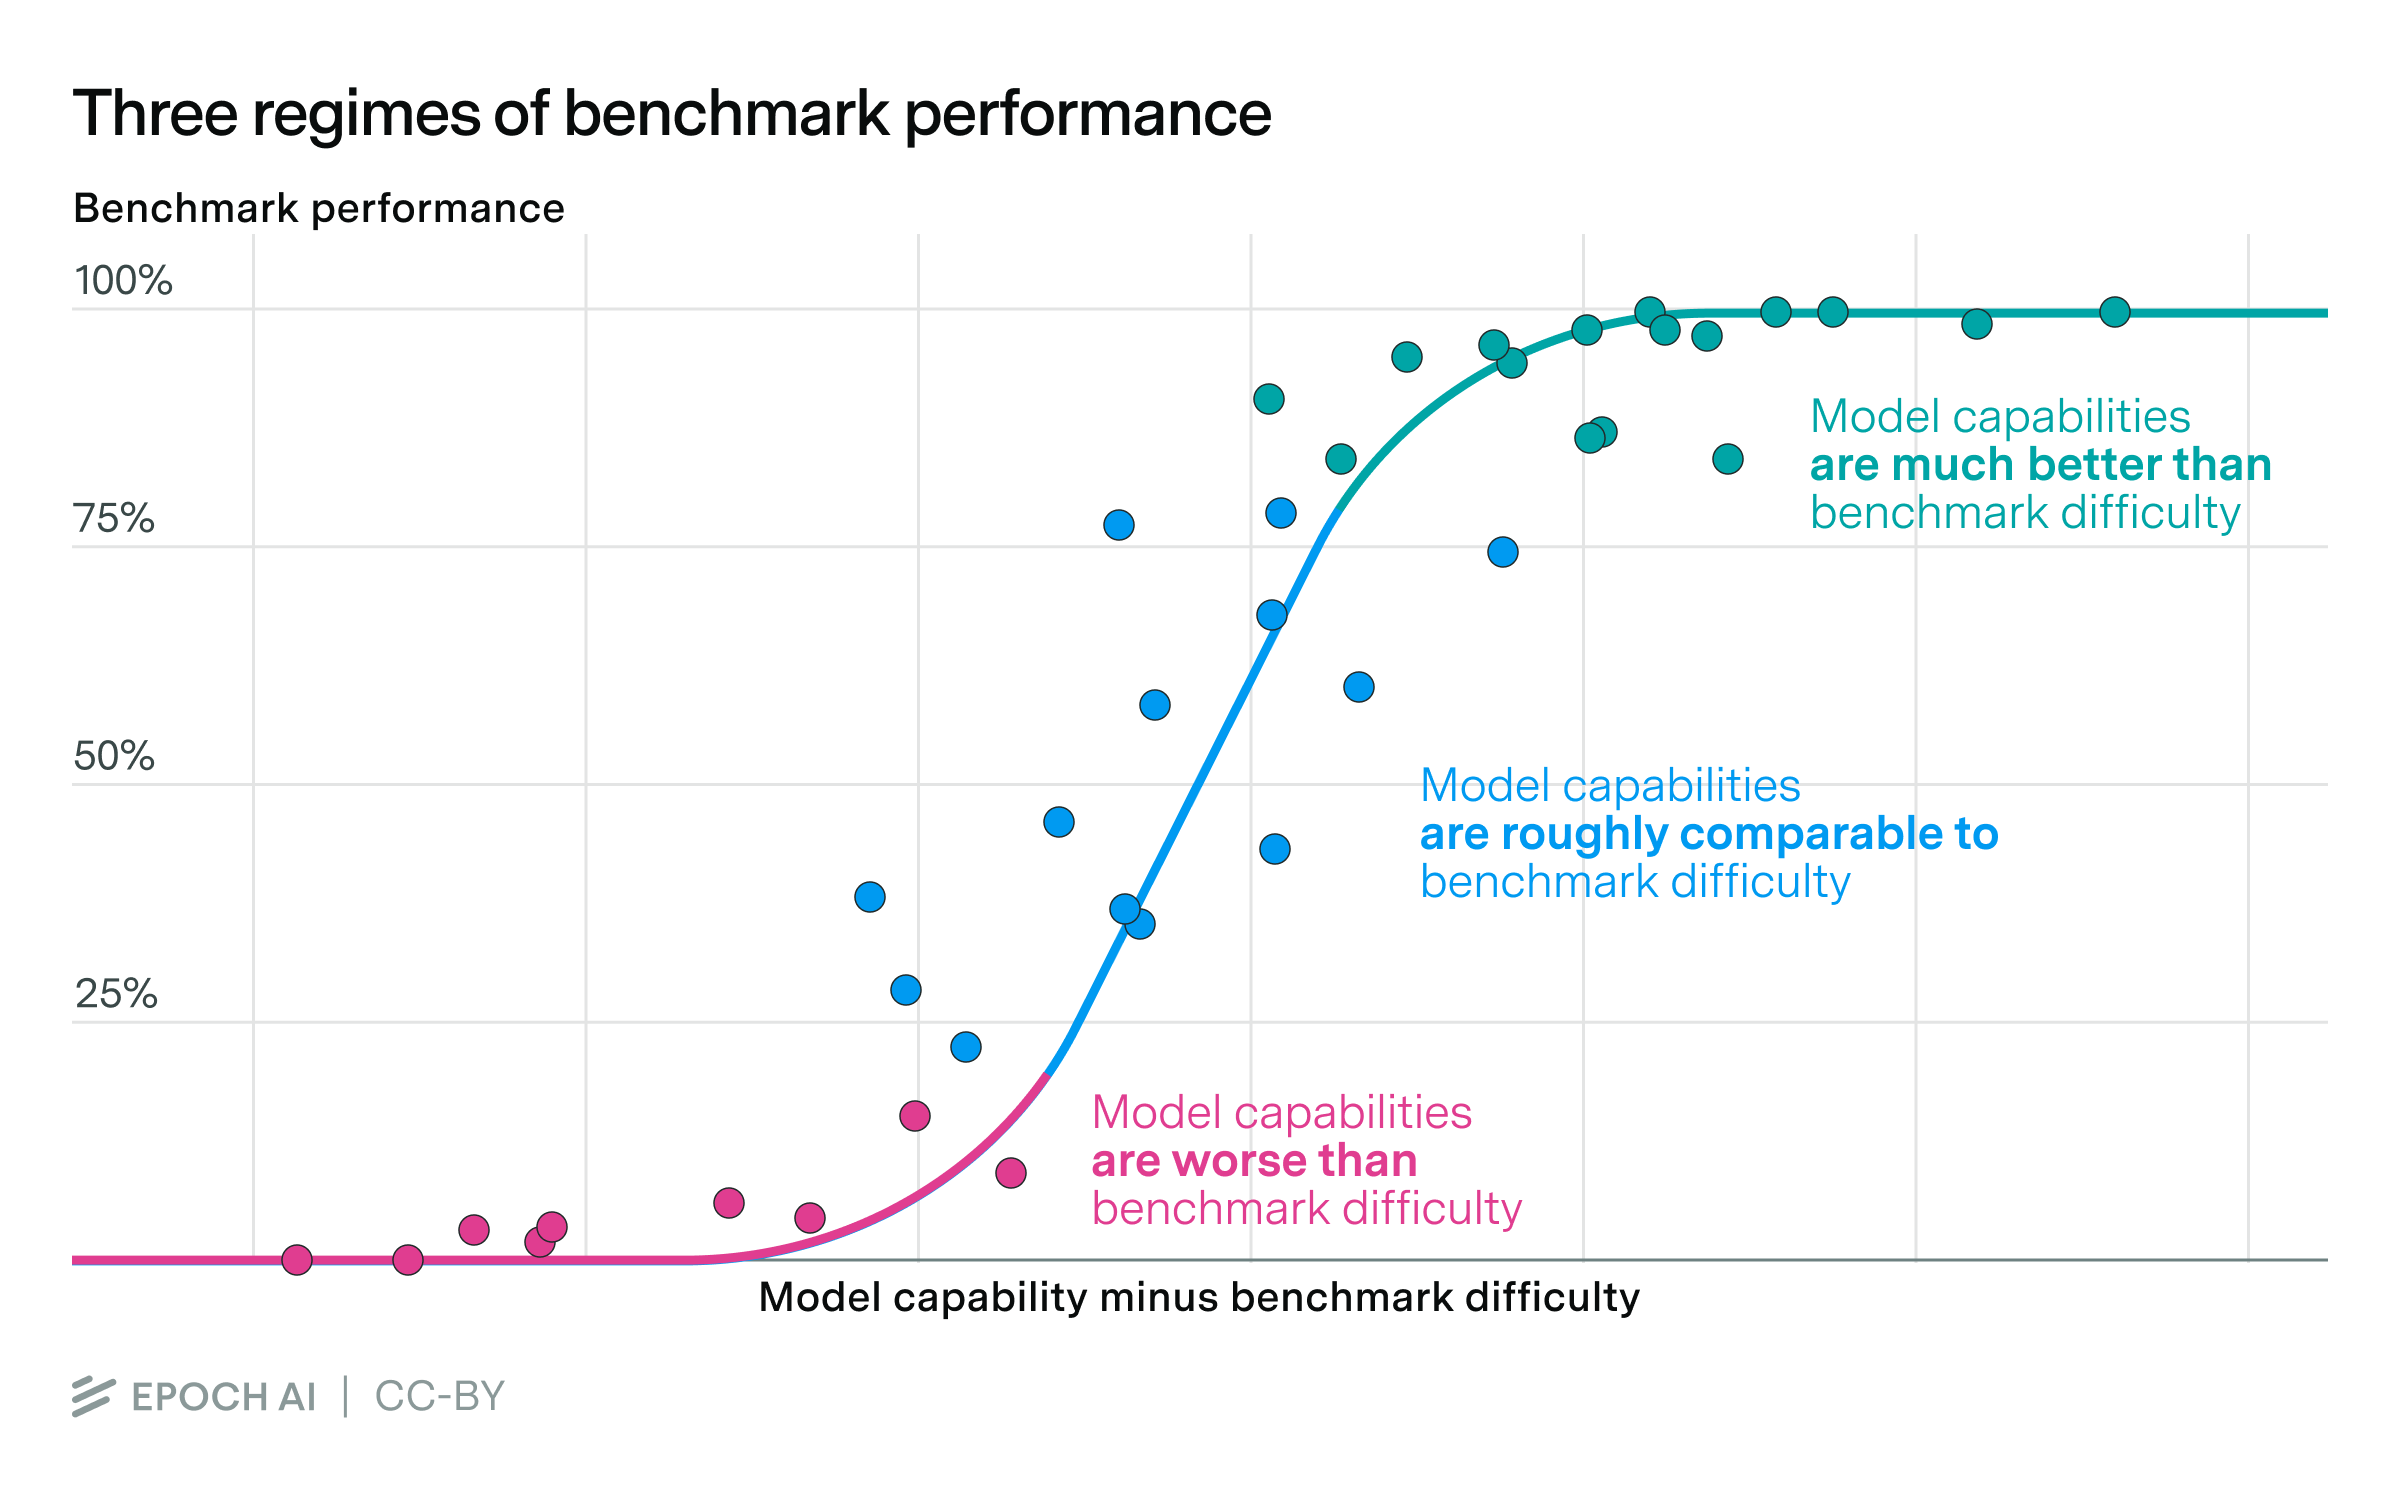
これらの潜在パラメータを推定するには、現実のベンチマークスコアをパラメータに対応づける統計的な枠組みが必要になる。最も単純な枠組みでは、モデルの能力はベンチマークの成績とともにどこまでも直線的に伸びる。だがベンチマークの成績は0%から100%の範囲に収まるので、対応関係はS字曲線のような形になり、三つの領域に分かれる。
- モデルの能力がベンチマークの難しさよりはるかに低い場合:ベンチマークに対してモデルの性能が非常に低いので、成績はランダムに答えた場合の基準値と変わらない。この基準値は多くの場合(常にではないが)0%である。1
- モデルの能力がベンチマークの難しさとほぼ等しい場合:S字曲線の中央部分にあたる。成績は能力に比例して伸び、その伸びの速さは傾きのパラメータで決まる。
- モデルの能力がベンチマークの難しさよりはるかに高い場合:モデルの能力がベンチマークに対して高すぎ、ベンチマークは100%(またはそれに近い値)で飽和している。
最後に、こうした能力・難しさ・傾きを推定するため、私たちのベンチマーク・ハブからデータを集める。全体で約40のベンチマークをつなぎ合わせ、約200のモデルの能力を推定する。
この枠組みから分かること
この枠組みは、モデルの能力を一つの数値で捉えられると仮定しており、これは単純化しすぎである。それでも、この枠組みで多くのことが分かる。
まず、この手法は驚くほど安上がりだ。一般的なモデルのリーダーボードと違って、利用者にモデルの出力を投票してもらう必要も、新たに評価を実行する必要もない。既存のデータを組み合わせるだけでよい。
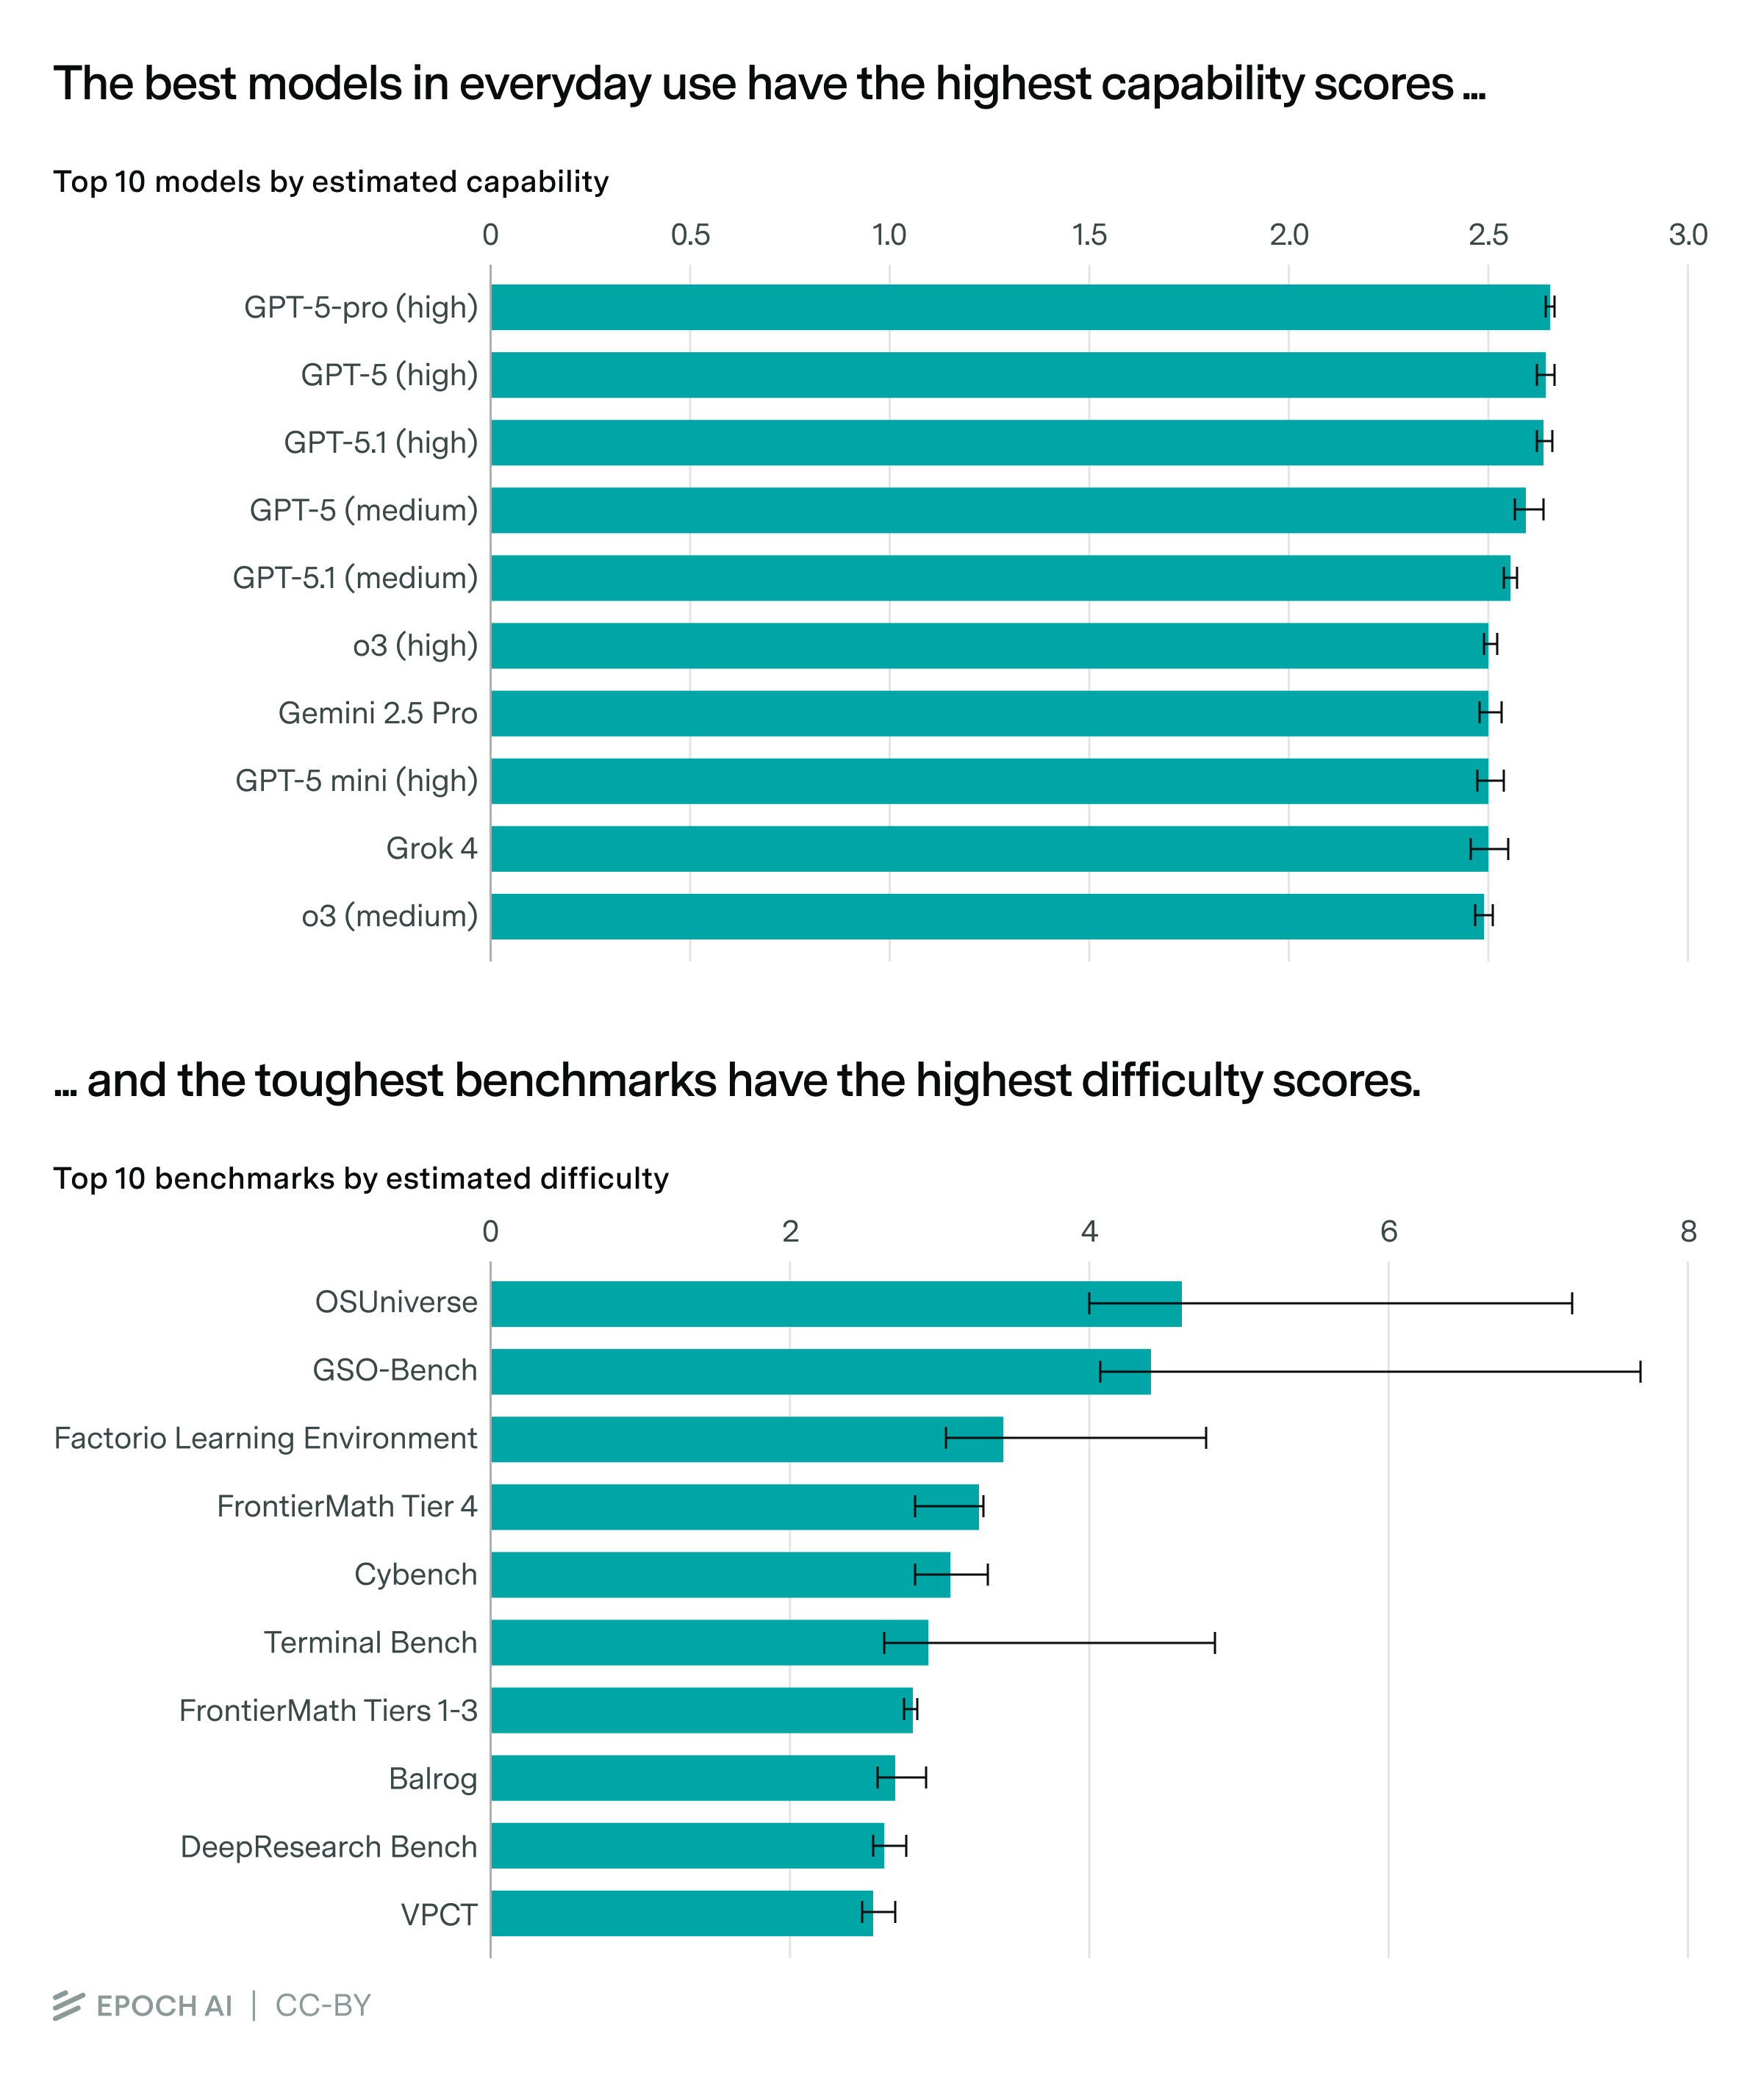
それでいて心強いことに、モデルの能力とベンチマークの難しさについてもっともらしい順位が得られ、GPT-5.1 や Gemini 2.5 Pro といったモデルが最高水準の近くに来る。2これは、評価の結果や、実際にこれらのモデルを使ってみた私たちの直感と一致する。
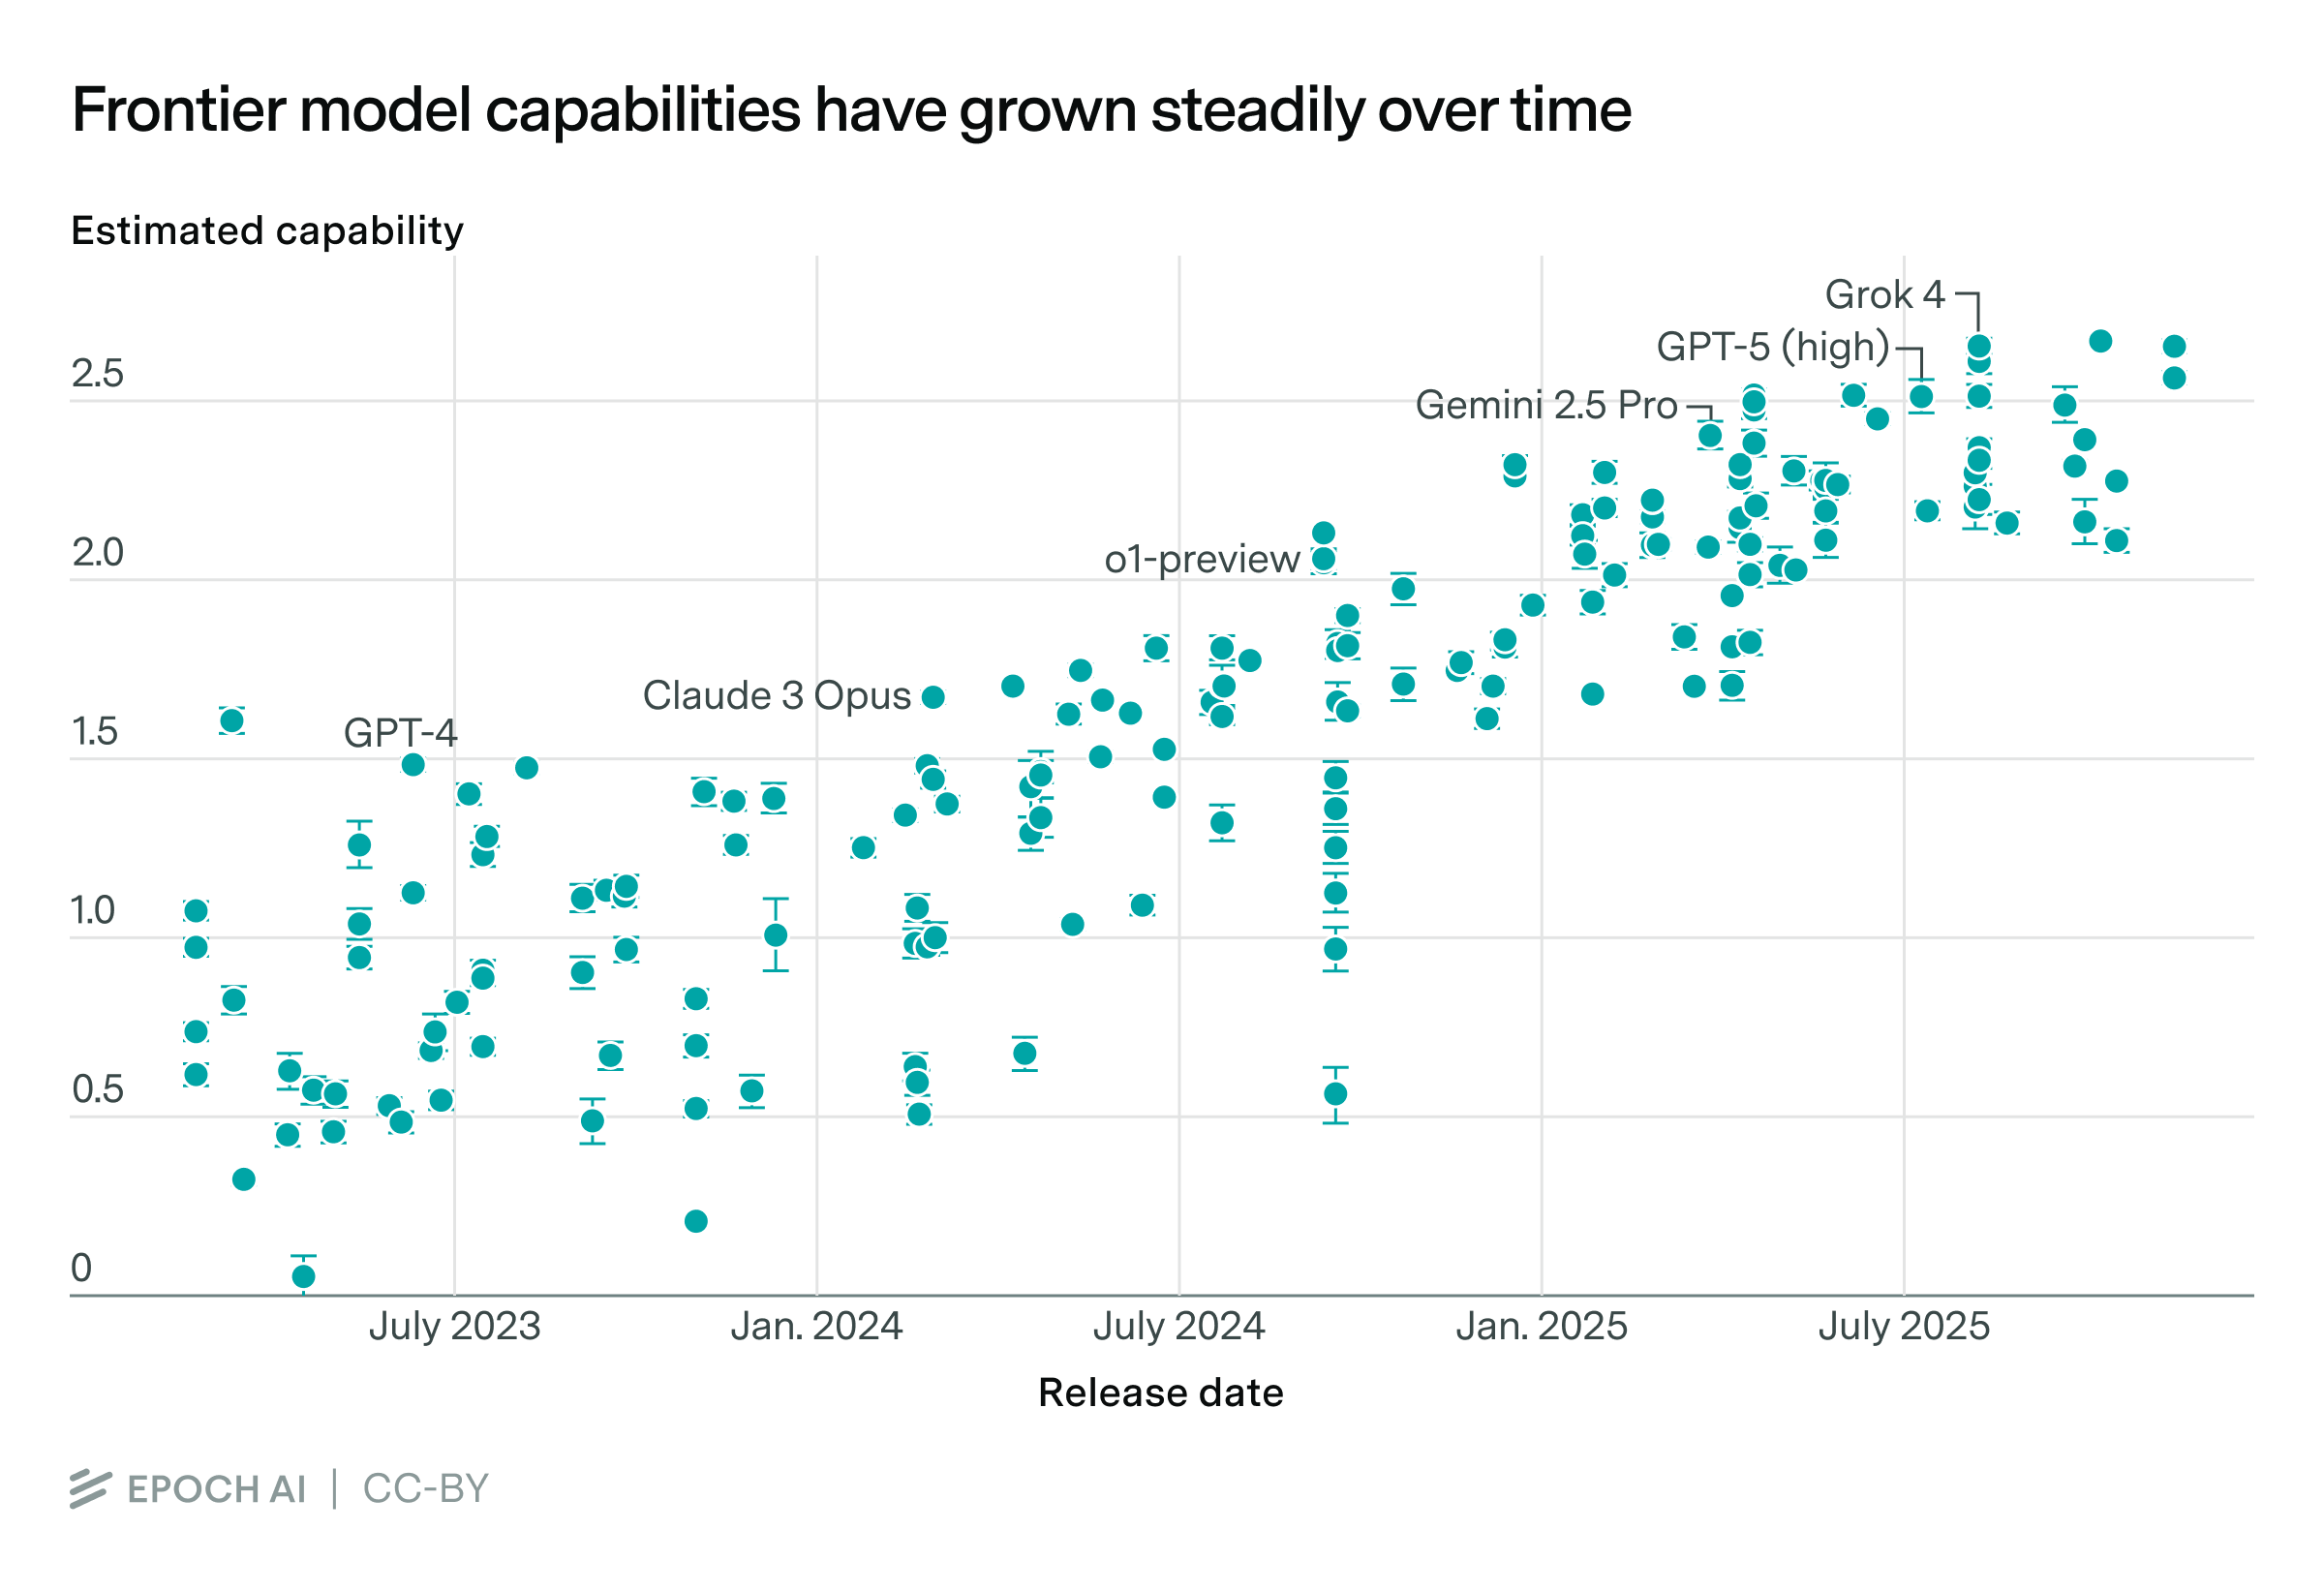
この枠組みを使えば、モデルの能力が時間とともにどう変わってきたかも分かる。能力の最高水準を押し上げたモデルについて平均すると、能力は年に約0.6単位向上している。これは GPT-4.5 から GPT-5 への能力の向上に匹敵する大きさだ。
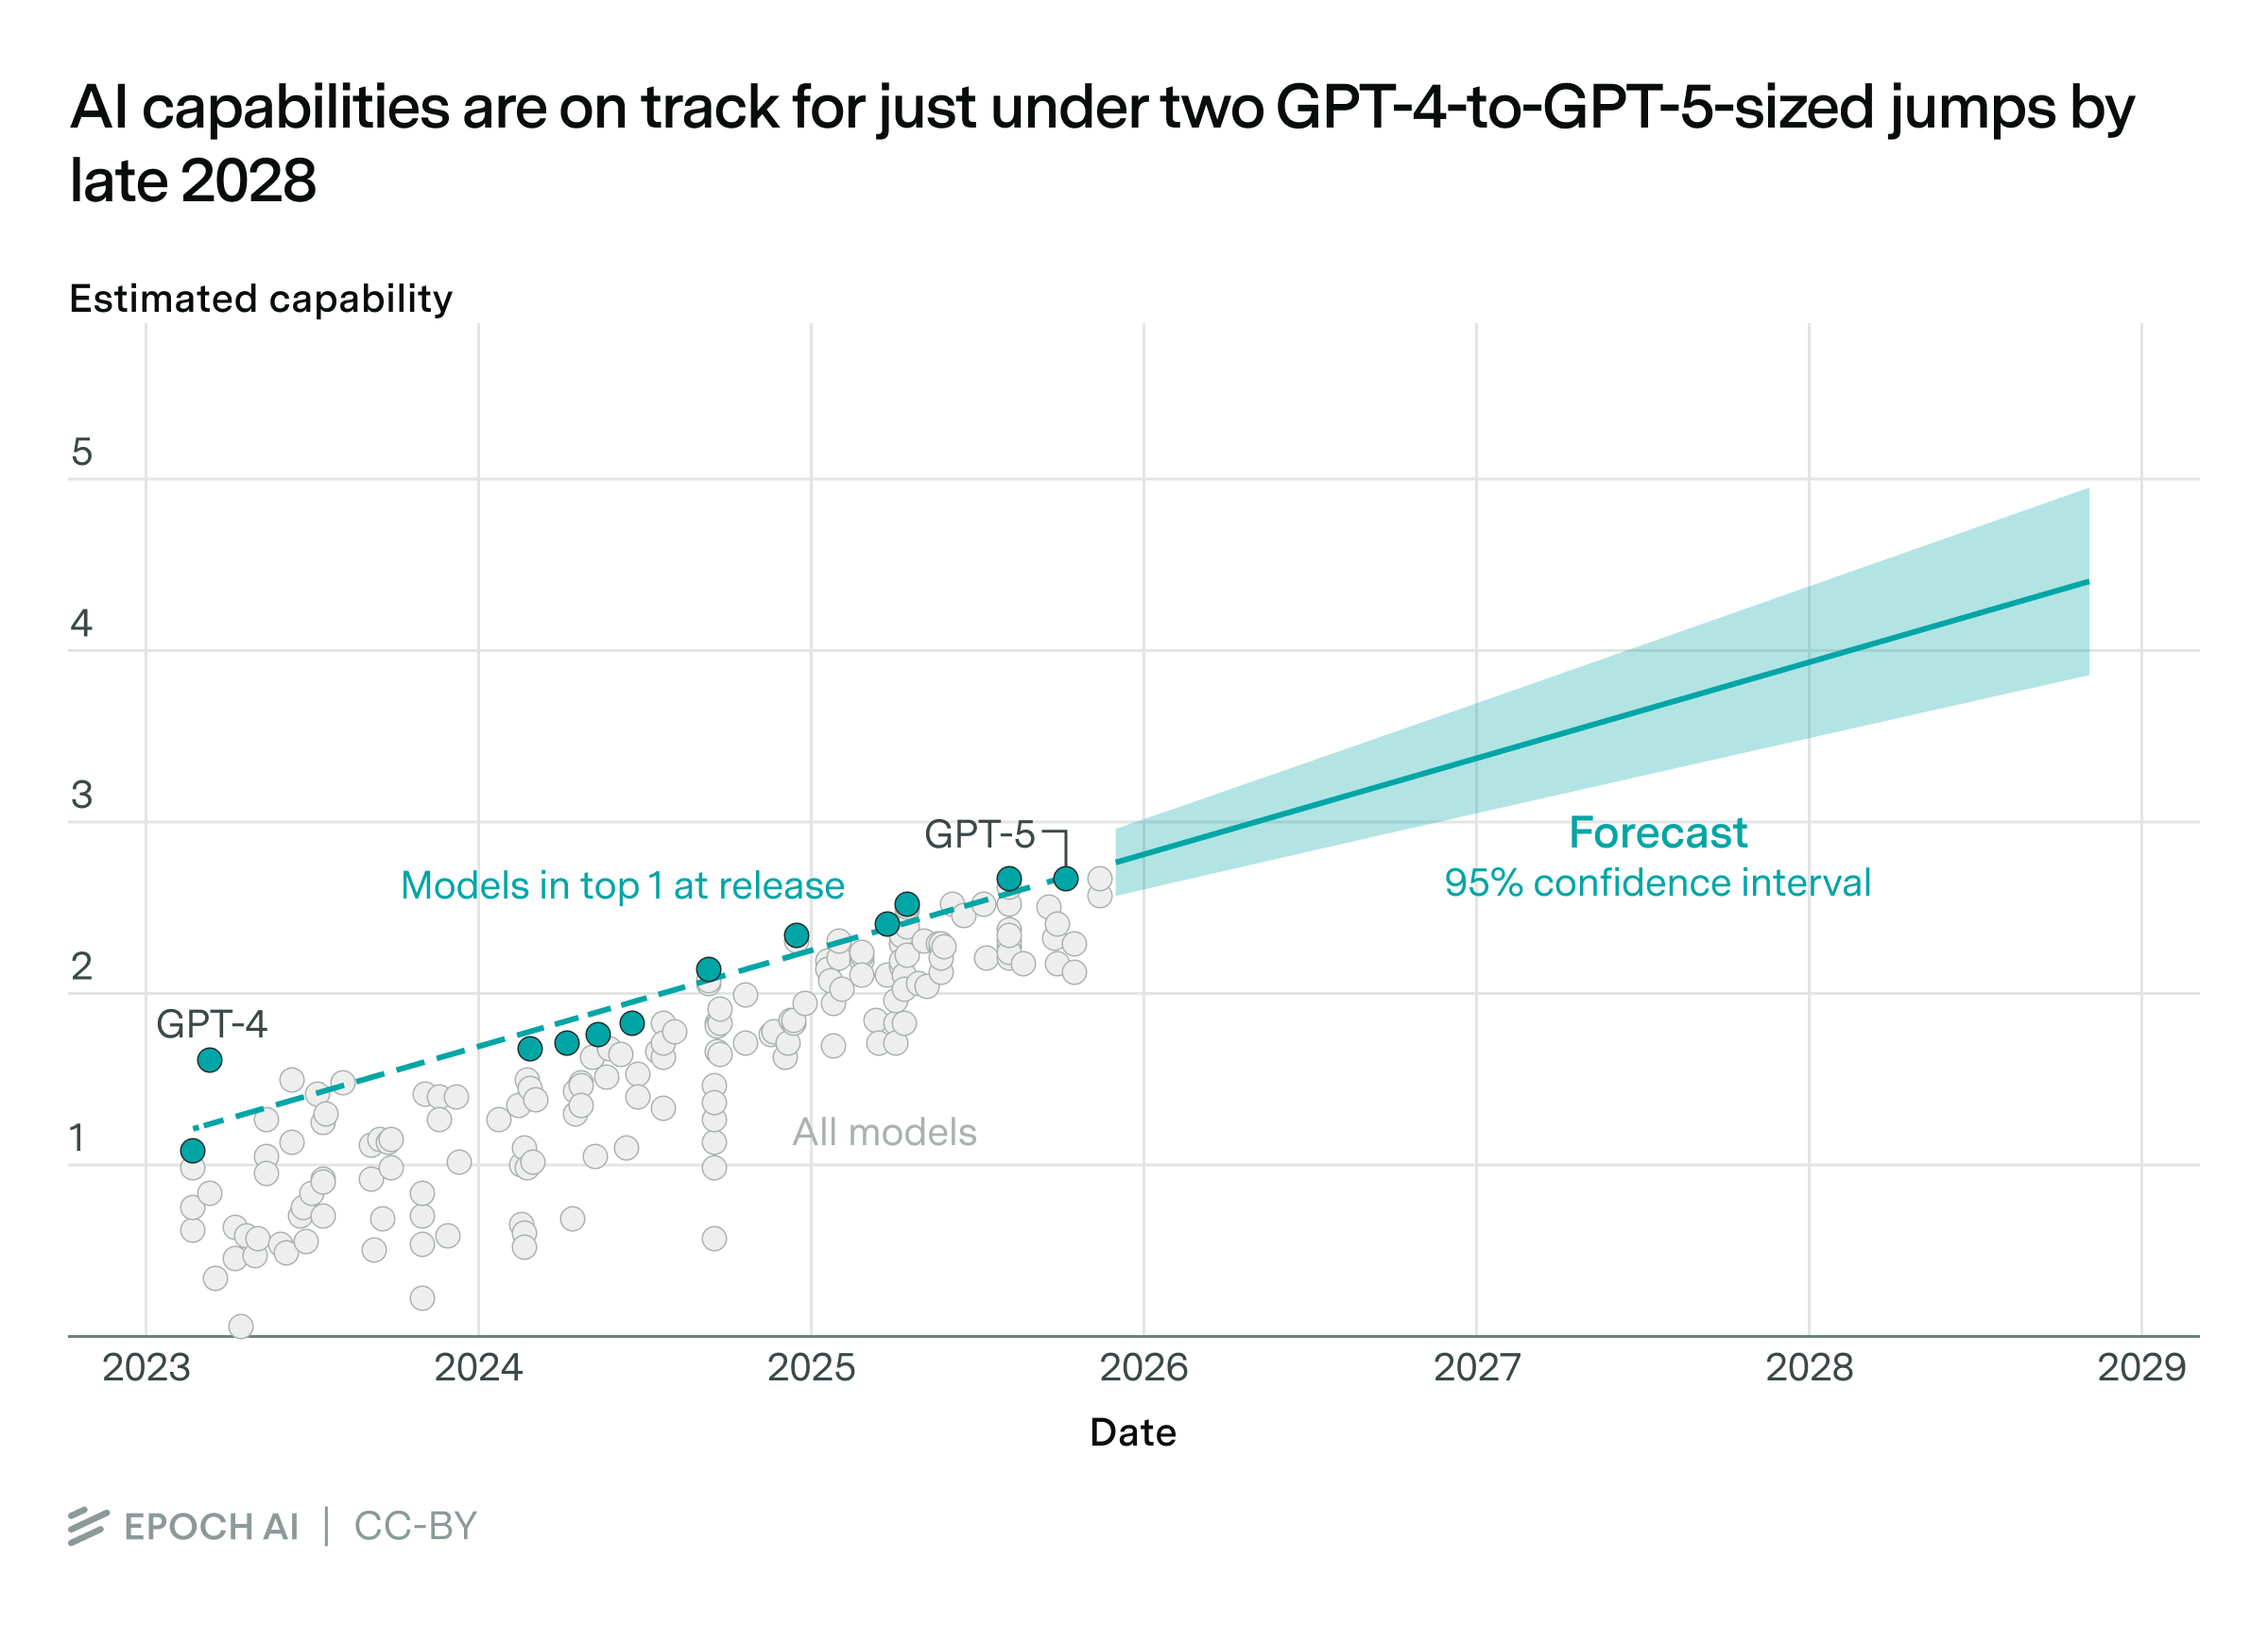
さらに、全体の傾向を先へ延ばせば、将来の能力の素朴な予測が得られる。
また、この傾向を使ってソフトウェアの改善を調べることもできる。ソフトウェアが改善すれば、同じ能力に達するのに必要な学習計算量が減る。つまり「ソフトウェア効率」が高まる。

この効果を定量化するため、この能力の傾向を、各モデルの学習にどれだけの計算資源が使われたかのデータと組み合わせる。そのうえでフロンティアモデルを統計的に分析すれば、能力の向上のうち、どれだけが学習計算量の増加によるもので、どれだけがソフトウェアの改善によるものかが分かる。結果は、同じ能力に達するのに必要な学習計算量が毎年約6分の1になる、というものだった!
これは驚くほど速い。だが、一部の人々は、進歩はさらにずっと速くなりうると主張している。AIがAI研究を完全に自動化できれば、AIは再帰的に自らを改善していく、という考え方だ。私たちの枠組みを使えば、これを検出できる。能力スコアが時間とともに加速していないかを見ればよい。合成データによるシミュレーションでは、2倍の加速を2〜3か月以内に確実に検出できた。
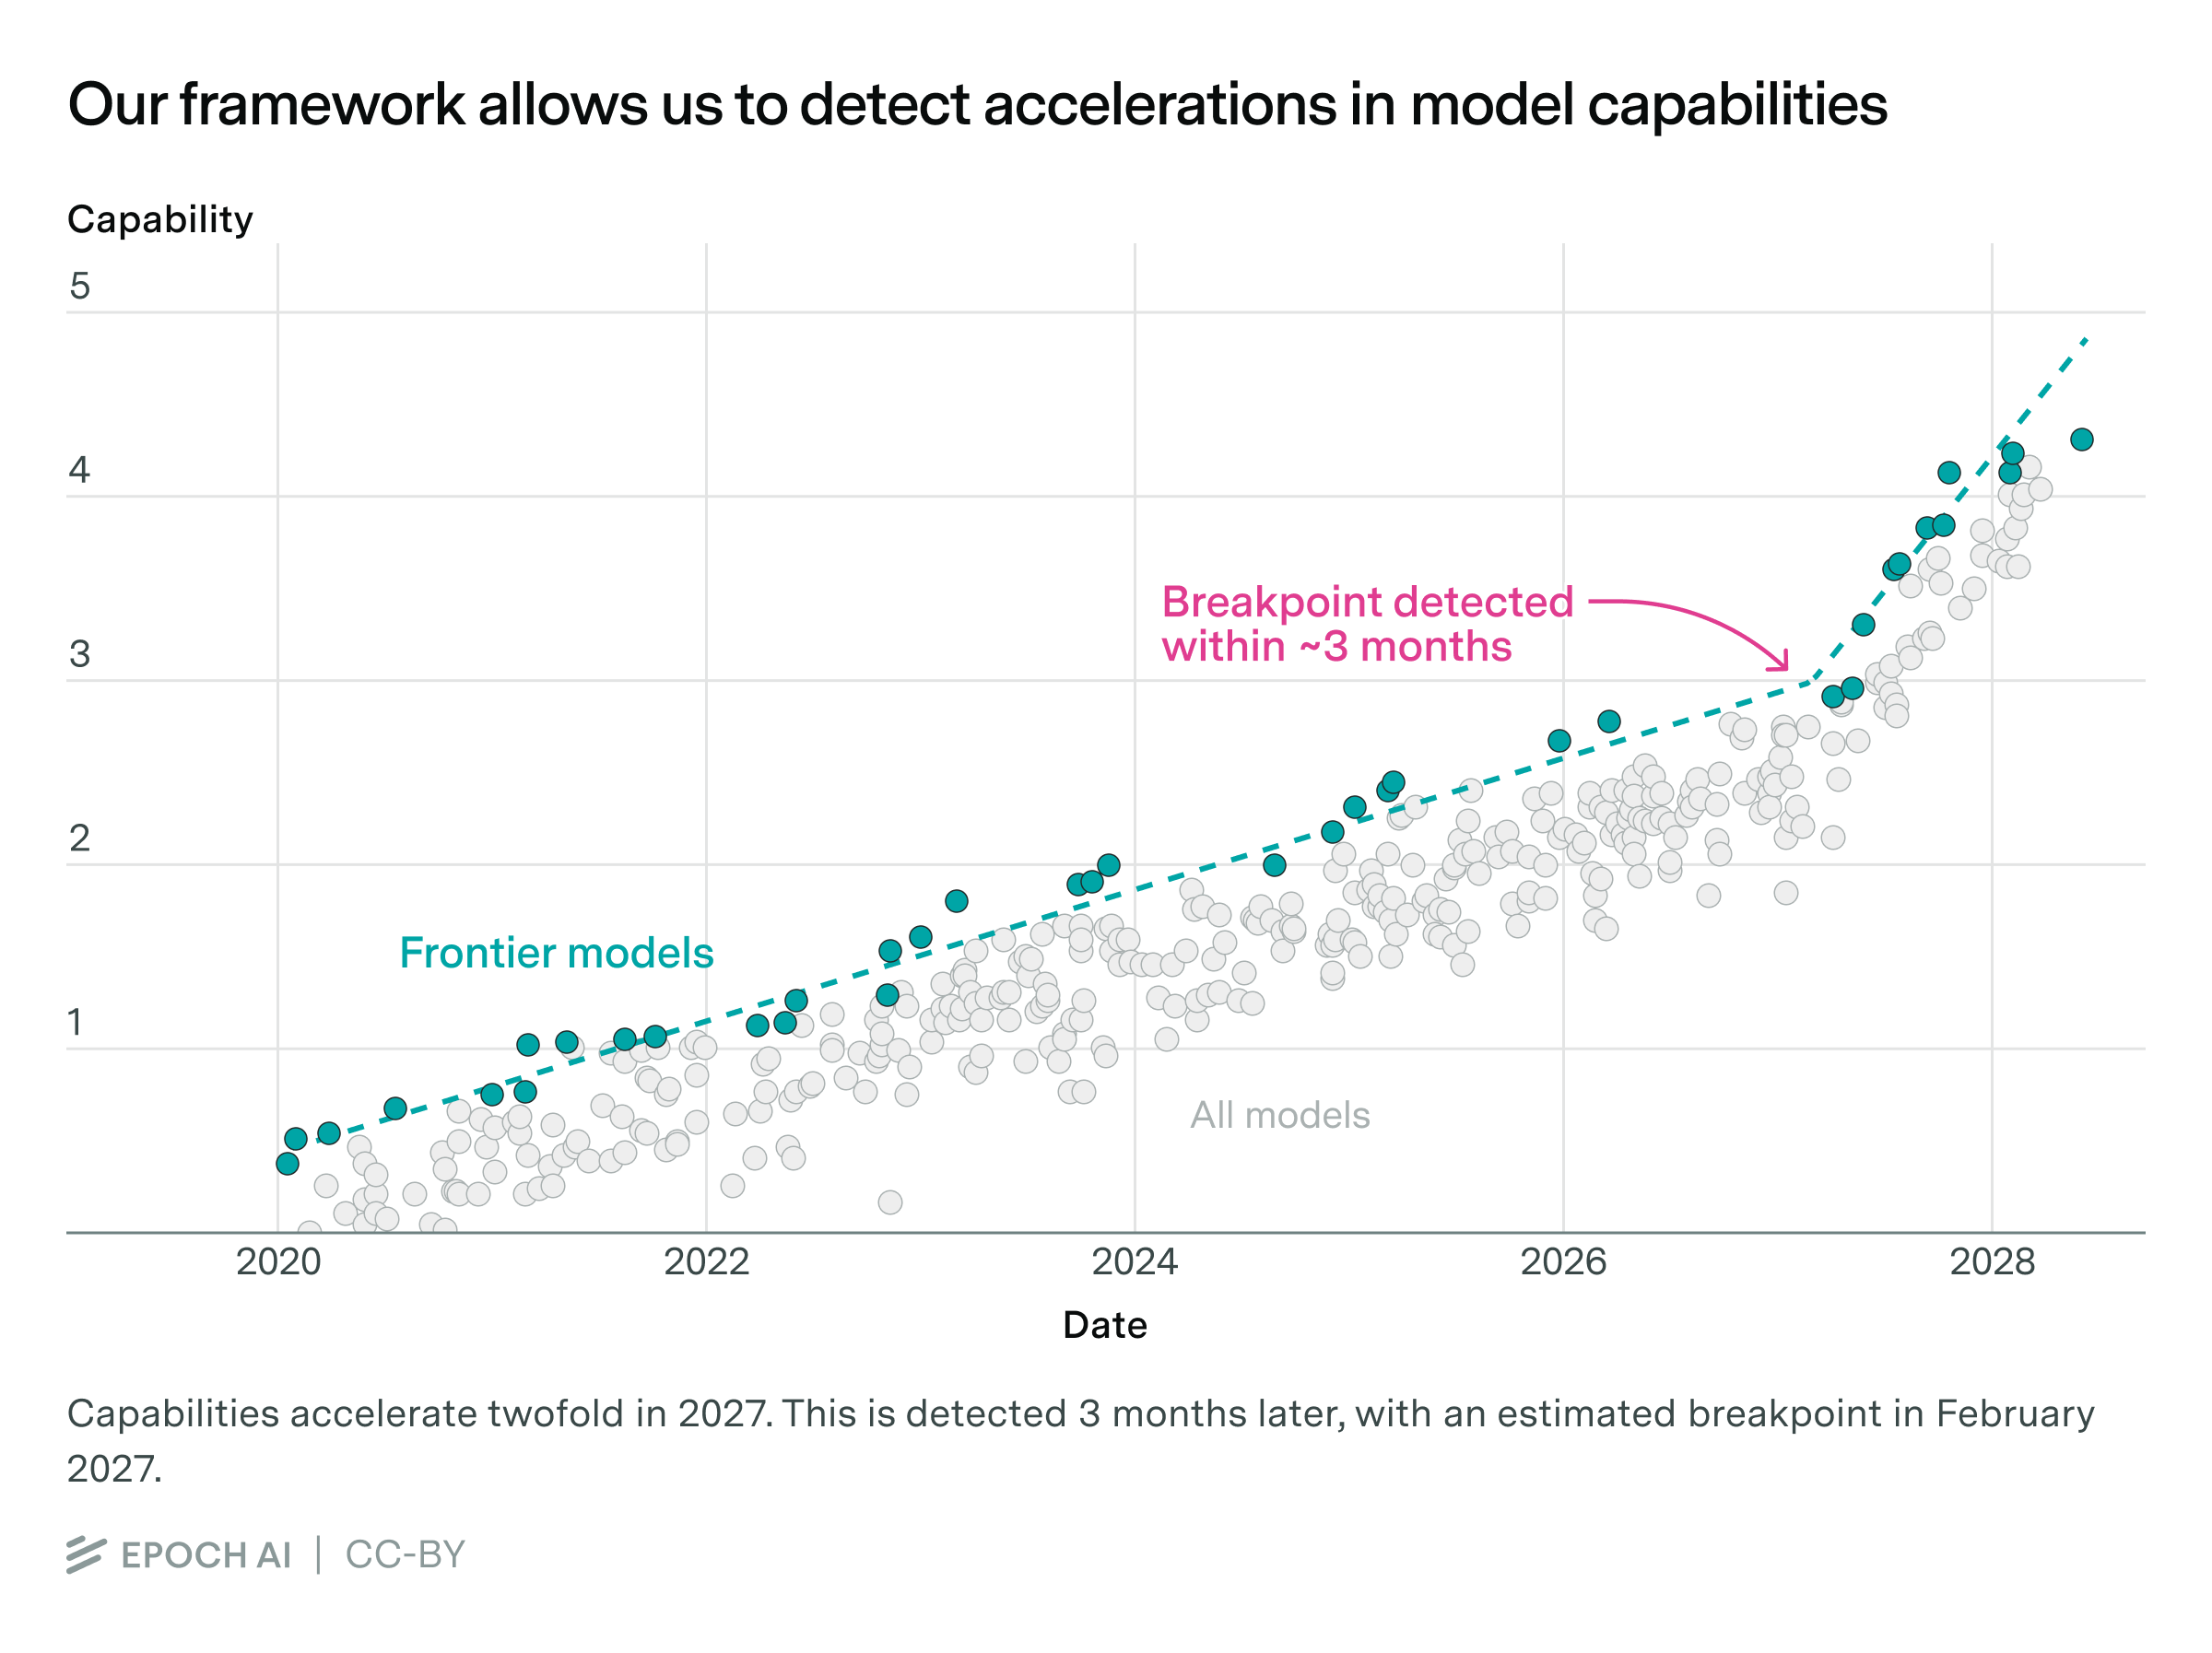
今後十分なベンチマークデータがあれば、これは能力の急激な加速を早期に知らせる警報となり、世界が対応する時間を稼げるかもしれない。
今後の課題
この手法にはいくつかの限界がある。なにしろ枠組みがベンチマークに依存しているので、ベンチマークの限界の大半をそのまま引き継ぐ。モデルは、全体的に性能を上げなくても、特定のベンチマークで非常によい成績を出すよう最適化されうる。ベンチマークが現実世界の複雑さを捉えようとすることはめったにない。さらに、モデルの能力の推定値は、モデルの評価のしかたによって変わりうる。
だが、こうした限界はさらなる研究の方向も示している。たとえば次のようなことができるだろう。
- より多くのベンチマークのデータを集め、モデルの能力とベンチマークの難しさについて、より長期の傾向を観察する。その際、現実世界のタスクの複雑さに重点を置いたベンチマークを優先する。
- モデルのベンチマークスコアを同じ条件で比べられるよう、評価の基盤を整える。
- 能力の急激な加速の検出方法を改善する。たとえば私たちの論文は、加速の始まりを示す変化点が一つだけある単純なシナリオを扱っている。だが現実の加速はもっと連続的かもしれず、それをより直接に扱う手法が必要になる。
結局のところ、私たちの研究は、AIベンチマークをつなぎ合わせる初期の試みにすぎない。既存のデータから新たな知見を引き出すのに役立ち、探るべき方向を数多く示している。まだ手の届きやすい成果もたくさん残っている。だからこそ、この手法を公開して継続的に運用しているEpoch能力指数(ECI)を多くの人に使ってみてほしい。私たちの枠組みを発展させる研究や、ベンチマークスコアから情報を引き出す別の方法を考える研究がさらに増え、AIの進歩への理解が深まることを期待している。
本研究は Google DeepMind の資金提供を受け、同社の研究者と共同で行った。本稿に有益なフィードバックをくださった Jay Tate 氏と Robert Sandler 氏に感謝する。