
ニュースレター
計算資源に基づくAI政策が直面する三つの課題
原題:Three challenges facing compute-based AI policies
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
今週の記事は、Google DeepMindのSubstack「AI Policy Perspectives」の執筆者とEpoch AIの共同執筆である。
EUのAI法が起草されたころ、事前学習の計算量は、モデルの能力を測る代理指標として妥当なものだった。当時、事前学習は学習計算量全体の90〜99%を占めており、両者の関係は比較的信頼できた。計算量が多いということは、より多くのデータで事前学習したより大きなモデルということであり、それは一貫してより高い能力につながっていた。
この単純な代理指標は、着実に通用しなくなってきている。事前学習の計算量は今も能力の主な原動力だが、現代のAI開発は、蒸留、合成データの生成、報酬モデル、推論のための事後学習に大きく頼っている。これらの手法は多くの計算資源を消費し、能力を高めうるのに、現行の規制の枠組みではしばしば計算に入っていない1。
計算量を測る標準的な方法は、今は廃止されたバイデン政権のAI大統領令でも使われていたもので、「事前学習」と「事後学習」の二つの段階の計算量を合計するというものである。合計があらかじめ定めた閾値を超えれば、そのモデルは追加の審査の対象となる2。しかし学習手法が進化し続けるなかで、この指標は、高度な能力を生み出す要因のうち、ますます狭い一部分しか測らなくなるおそれがある。
現在の方法には、主に三つの問題がある。
- 計算資源の使い道によって、モデルの能力への寄与は同じではない:たとえば、事後学習で行う近年の「推論の学習」の手法は、計算量あたりで見ると、他の事後学習の手法より大きな能力の向上をもたらすことが多い。
- AI研究所は、事前学習・事後学習以外の手法にも計算資源を使える:事前学習と事後学習のほかに、蒸留や報酬モデルの学習といった計算資源を多く使う手法も、モデルの能力に直接影響する。
- 実際に展開されたAIモデルが下流で発揮する能力は、学習に使った計算量だけでは決まらない:モデルが下流で発揮する能力は、コーディング環境やWeb検索へのアクセスなど、展開時に使えるツールやシステムに大きく左右される。
これらの課題があるため、現在の計算資源に基づくAI政策は、モデルの能力を表す代理指標としてますます当てにならないものの上に築かれていることになる。だからといって、そうした政策が必ずしも無意味になるわけではない。他の多くの方法にはない重要な利点が今もあるからである。しかし計算量の指標は、能力の主な原動力を捉えているかを定期的に評価し、十分に捉えていなければ更新する必要があるかもしれない。さらに、より良い指標を研究すること、計算量の指標をより幅広い評価の仕組みで補うこと、AIの用途や組織の統治に重点を置くことも役立つ可能性がある。
Epoch AI の最新情報を受け取る 購読する
1. 計算資源の使い道によって、モデルの能力への寄与は同じではない
フロンティアの大規模言語モデルの学習は、おおまかにいくつかの段階に分けられる。第一は「事前学習」で、大量のテキストのコーパスで次のトークンを予測するようにモデルを学習させ、自然言語の文を出力する能力を持たせる。第二は「事後学習」で、さまざまな追加の手法を使ってモデルを磨き上げる。これらの手法は、モデルの推論能力を高めたり、利用者の要求にモデルが悪意ある形で応じないようにしたりするのに役立つ。
重要な点として、計算量に対する能力の伸び方は、こうした学習手法によって異なる。その最も適切な例が推論の学習である。これは事後学習の一種で、言語モデルがより高度な問題解決能力と推論能力を身につけるのを助ける。通常は、教師ありファインチューニングや強化学習(RL)などの手法を組み合わせた多段階のパイプラインを伴い、モデルがより長く考えられるようにする(「推論実行時のスケーリング」)。
フロンティアAI研究所が公開している現在の言語モデルでは、推論の学習のほうが事前学習よりも能力の限界的な見返りが大きい可能性が高い。このことは、過去1年の主要なモデルの公開を見ると分かる3。言語モデルのGPT-4oと、それに追加の推論の学習と推論実行時のスケーリングを施したo1-highを考えてみよう。追加の計算量はわずかだったにもかかわらず4、性能はGPQA Diamondベンチマークで48%から77%に、MATH Level 5で50%から95%に跳ね上がった。推論の学習が効果を上げるには強力な事前学習済みのベースモデルが必要だが、その土台がいったんできれば、1 FLOPあたりの限界的な見返りは、事前学習をさらに続けるよりはるかに大きい。OpenAIが同じだけの追加の計算量を単に事前学習の継続に使っていたなら、性能はほとんど変わらなかっただろう。
o1-highは、少量の推論の学習を経て、GPQA DiamondとMATH Level 5でGPT-4oを大きく上回っている。o1の事後学習に使われたこの追加の計算量を、代わりにGPT-4oの事前学習の継続に費やしていたなら、能力の向上はごくわずかだっただろう。このことから、この規模では、推論の学習に使うFLOPのほうが事前学習よりはるかに大きな限界的見返りを生むと考えられる。
統治の取り組みで学習のFLOPを一つの数値に合算すると、この1 FLOPあたりの突出した影響を見落とし、モデルの本当の能力を過小評価するおそれがある。重要なことに、この影響は、推論の学習に充てる計算量の割合が増えるにつれて大きくなる可能性がある。上の例では、o1-highの推論の学習に割り当てられた計算量は、おそらくGPT-4oの事前学習の計算量の10%未満だった。しかし推論の学習の計算量は3〜5か月ごとにおよそ10倍に増えており、事前学習の計算量の年4〜5倍という伸びをはるかに上回っている。まもなくフロンティアモデルの学習計算量全体の大半を占めるようになるかもしれない。
そうなるにつれて、事前学習と事後学習の計算量の単純な合計は、モデルの能力を表す代理指標としてどんどん悪くなるおそれがある。より大きな計算規模でも事後学習が計算量に対して大きな能力の伸びをもたらし続けるなら、将来のモデルは、既存の閾値が定める計算量のごく一部で学習されながら、その閾値が捉えようとしていた水準をはるかに超える能力を達成するかもしれない。
2. AI研究所は、事前学習・事後学習以外の手法にも計算資源を使える
能力の向上にとって事前学習と事後学習の計算量がそれぞれどれほど重要かを適切に考慮したとしても、問題は残る。その一つは、モデルの性能にとって重要でありながら、既存の計算量の指標では見落とされている計算資源の使い道があることである。この節では、知識蒸留、合成データの生成、報酬モデルの三つの例を取り上げる。
知識蒸留
見落とされている第一の手法は知識蒸留である。この過程では、小さな「生徒」モデルが大きな「教師」モデルの中間出力(「ロジット」)をまねるように学習することで、教師から学ぶ。強力な教師がいれば、この手法は、同じ生徒モデルに標準的な事前学習を施すよりも、生徒の1 FLOPあたりで大きな能力の伸びをもたらしうる。
蒸留による効率の向上は劇的なこともある。この手法を初期に示したDistilBERTは、パラメータ数を40%減らし、計算予算も元のBERTモデルの学習に使われた分のわずか3%で済んだのに、教師モデルの能力の97%を保った。
この仕組みでは、三つの計算量の出どころを考慮する必要がある。生徒の学習、教師の学習、そして教師によるロジットの生成である。しかし現在の政策はふつう、生徒の学習の計算量しか数えず、生徒モデルが何を学べるかを大きく左右する、上流の教師の計算量を無視している。
フロンティアAI研究所のあいだでは、モデルの蒸留がますます標準的な慣行になっており、各研究所は教師モデルから蒸留した、より小さく効率的なモデルを提供している。たとえばMetaは、Llama 4の中型と小型のモデルを、大きな「Behemoth」モデルから蒸留して学習させた5。蒸留する理由は単純で、小さなモデルのほうがふつうは速く動き、必要な計算資源も少ないからである。そのため、この慣行がフロンティアでますます一般的になるにつれ、現行の規制で使われる計算量の指標はモデルの能力を過小評価するおそれがある。
合成データの生成
蒸留に関連して、フロンティアの言語モデルは、他の言語モデルが生成した出力テキストで学習することが増えている6。大量の合成データを生成すれば、それが学習計算量全体のかなりの割合を占めることもある。たとえば、phi-4モデルのための合成データの生成は、その事前学習の計算予算の約25%に相当し、学習用の素材を作るのに別のより強力なモデル(GPT-4o)を使っていた7。
EUのAI法は合成データの生成を学習計算量に含めているが、バイデン政権のAI大統領令は含めていなかった。いずれにせよ、合成データのパイプラインは、FLOPを数えるだけでは捉えきれない形で急速に進化している。たとえばKimi K2は、モデルを使って、ツールの仕様、課題、評価基準などを備えた事後学習の環境をまるごと生成した。この種の環境はモデルの学び方を形づくるが、その背後にある計算量は、現在のFLOPの数え方の規則ではきれいに捉えられない。モデルは、データの品質の評価、選別、拡張など、データの整備にも広く使える。たとえば、基本的な数学の問題を取り上げて、推論の各ステップを生成することがこれに当たる。これらの例は、「合成データ」が含むものの全体を、現在の計算量の指標が見落としうることを示している。
報酬モデル
報酬モデルも、規制の枠組みが見落としている計算資源の投資である。報酬モデルとは、RLのアルゴリズムにフィードバック信号を与えるように学習させた個別のモデルである。このフィードバック信号の質は、RLの効果と、モデルが最終的に獲得する能力を直接左右する。ところが、報酬モデルの構築に投じられた計算量はまったく計算に入っていない。この過程は計算資源を多く使う。研究所はプロンプトに対するモデルの応答を何百万も生成することがあり、それにはかなりの推論実行と学習の計算量が必要になる。
報酬モデルの重要性は、今年の国際数学オリンピックで見て取れた。OpenAI、Google DeepMind、HarmonicのAIシステムがいずれも金メダルを獲得したのである。注目すべきことに、OpenAIの研究者たちは、その成功を頑健な「汎用検証器」と報酬モデルのおかげだと述べている。しかし、これほど重要なのに、こうした報酬モデルの学習と実行に投じられた多大な計算資源は、現行の規制で使われる計算量の指標からは見えないままである。
学習手法の多様さが、標準化された計算量の指標を難しくしている
ここまで見た三つの例は、学習計算量にはさまざまな形態があるという複雑な現実を示している。これらの実装はいずれも、ありうる多くの変種のうちの一つの方法にすぎない。たとえば、蒸留だけでも段階的な蒸留、複数の教師を使う構成、自己蒸留などがあり、合成データの生成も、単純なデータ拡張から複雑なマルチエージェントのシミュレーションまでさまざまである。変種ごとに計算量に対する能力の伸び方が異なる可能性があり、標準化された計算量の指標を作ろうとする試みをいっそう難しくしている。
手法の幅広さに加えて、これらの学習手法が互いにどう影響し合うかも理解する必要がある。たとえば、推論の学習で計算量に対して能力がどれだけ伸びるかは、事前学習済みモデルと報酬モデルの強さに左右されうる。学習パイプラインが複雑になるにつれて、考慮すべきこうした相互作用はますます増えていく。
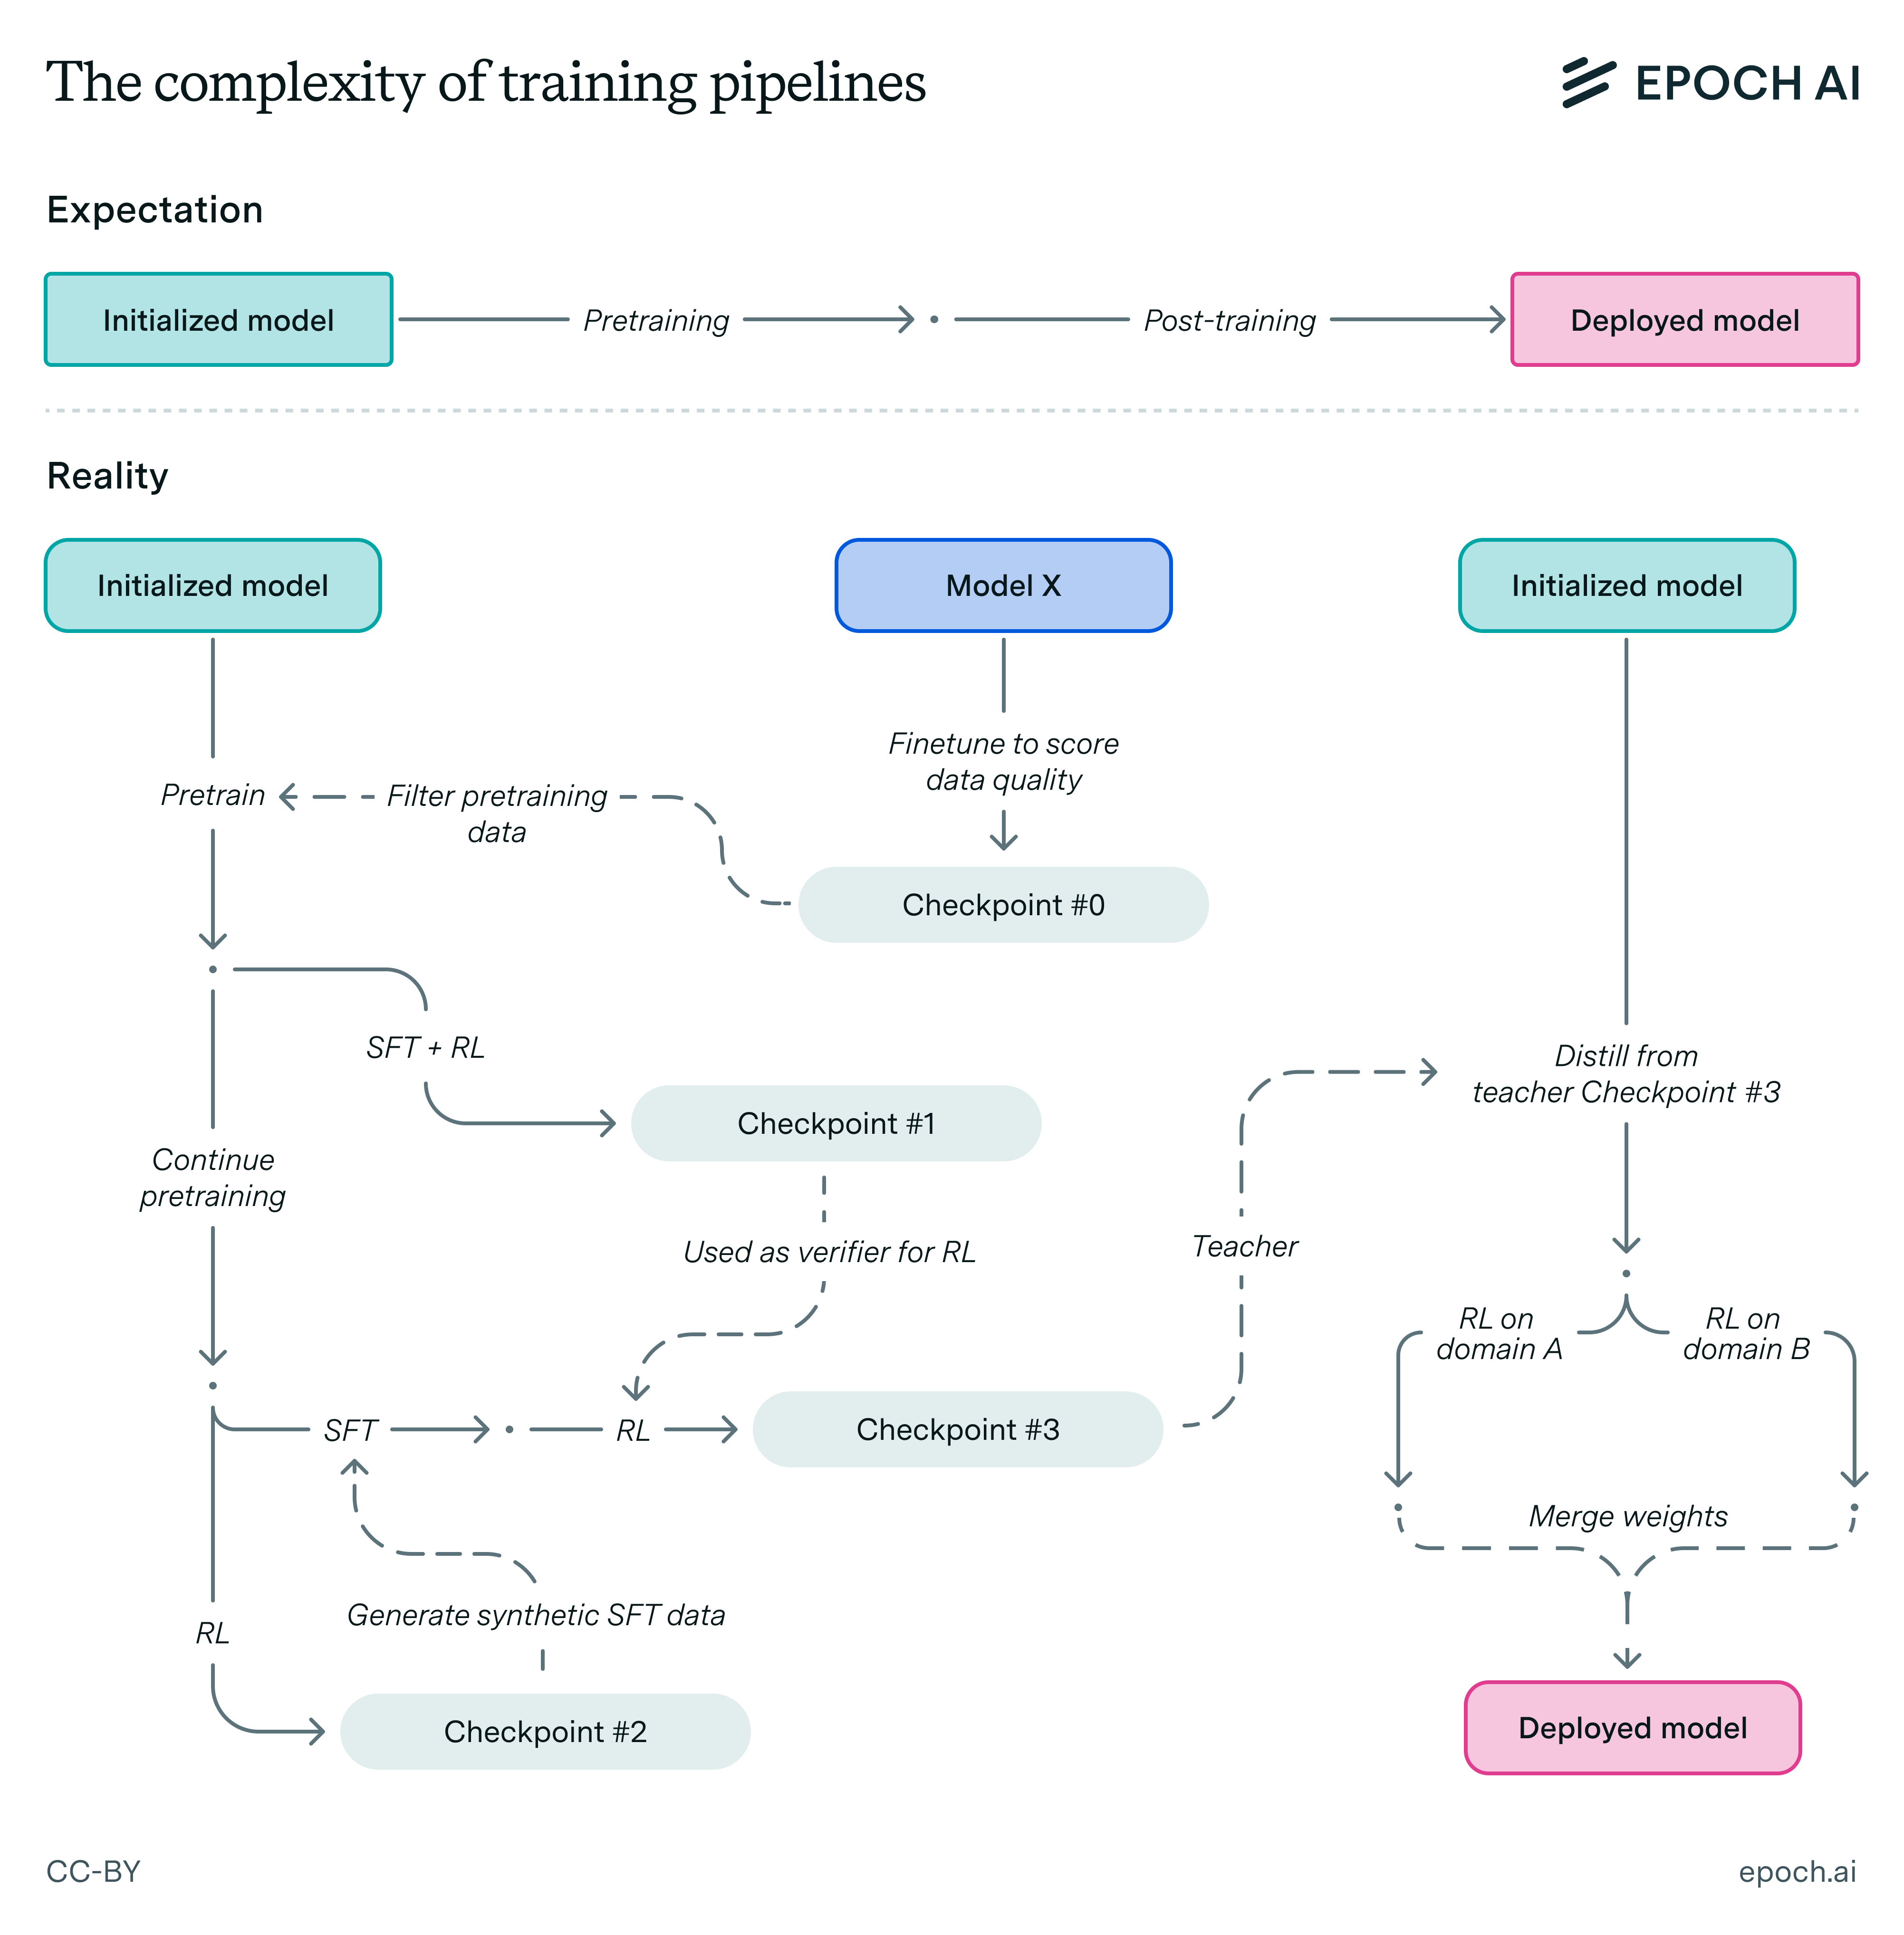
これまでの規制は主に事前学習と事後学習という単純な区別を中心に考えてきたが、実際には、学習計算量は無数の形態をとり、それらが複雑なパイプラインの中で絡み合っている。
こうした追加の学習計算量の出どころを考慮に入れたとしても、それぞれが能力にどう寄与するかについての理解はまだ乏しく、互いにどう作用し合うかとなればなおさらである。そのため、現在手元にある情報では、能力の代理指標として適切に機能する頑健な指標を作るのは難しい。
3. 実際に展開されたAIモデルが下流で発揮する能力は、学習に使った計算量だけでは決まらない
仮に上で述べた測定の課題に対処できたとしても、計算量はやはり不完全な指標である。ここから三つ目の、そして最後の論点に移る。現実世界に展開されたとき、モデルの能力は、学習に使った計算量だけでは決まらない。特に、利用者は個々のモデルを中心に構築された製品やアプリケーションを使うことが増えている。つまり、全体として観察される能力は、推論実行の予算や、コーディングやWebブラウジングのためのツールなど、モデルの周りの足場(スキャフォールド)にも左右される。
その顕著な例がAnthropicの製品Claude Codeである。この製品は、洗練された足場によって基本のClaudeモデルに外部のツールやデータベースへのアクセスを与え、はるかに有能なコーディングアシスタントに変える。こうした能力は、学習計算量を追加したからではなく、設計と統合の工夫によって高められた。
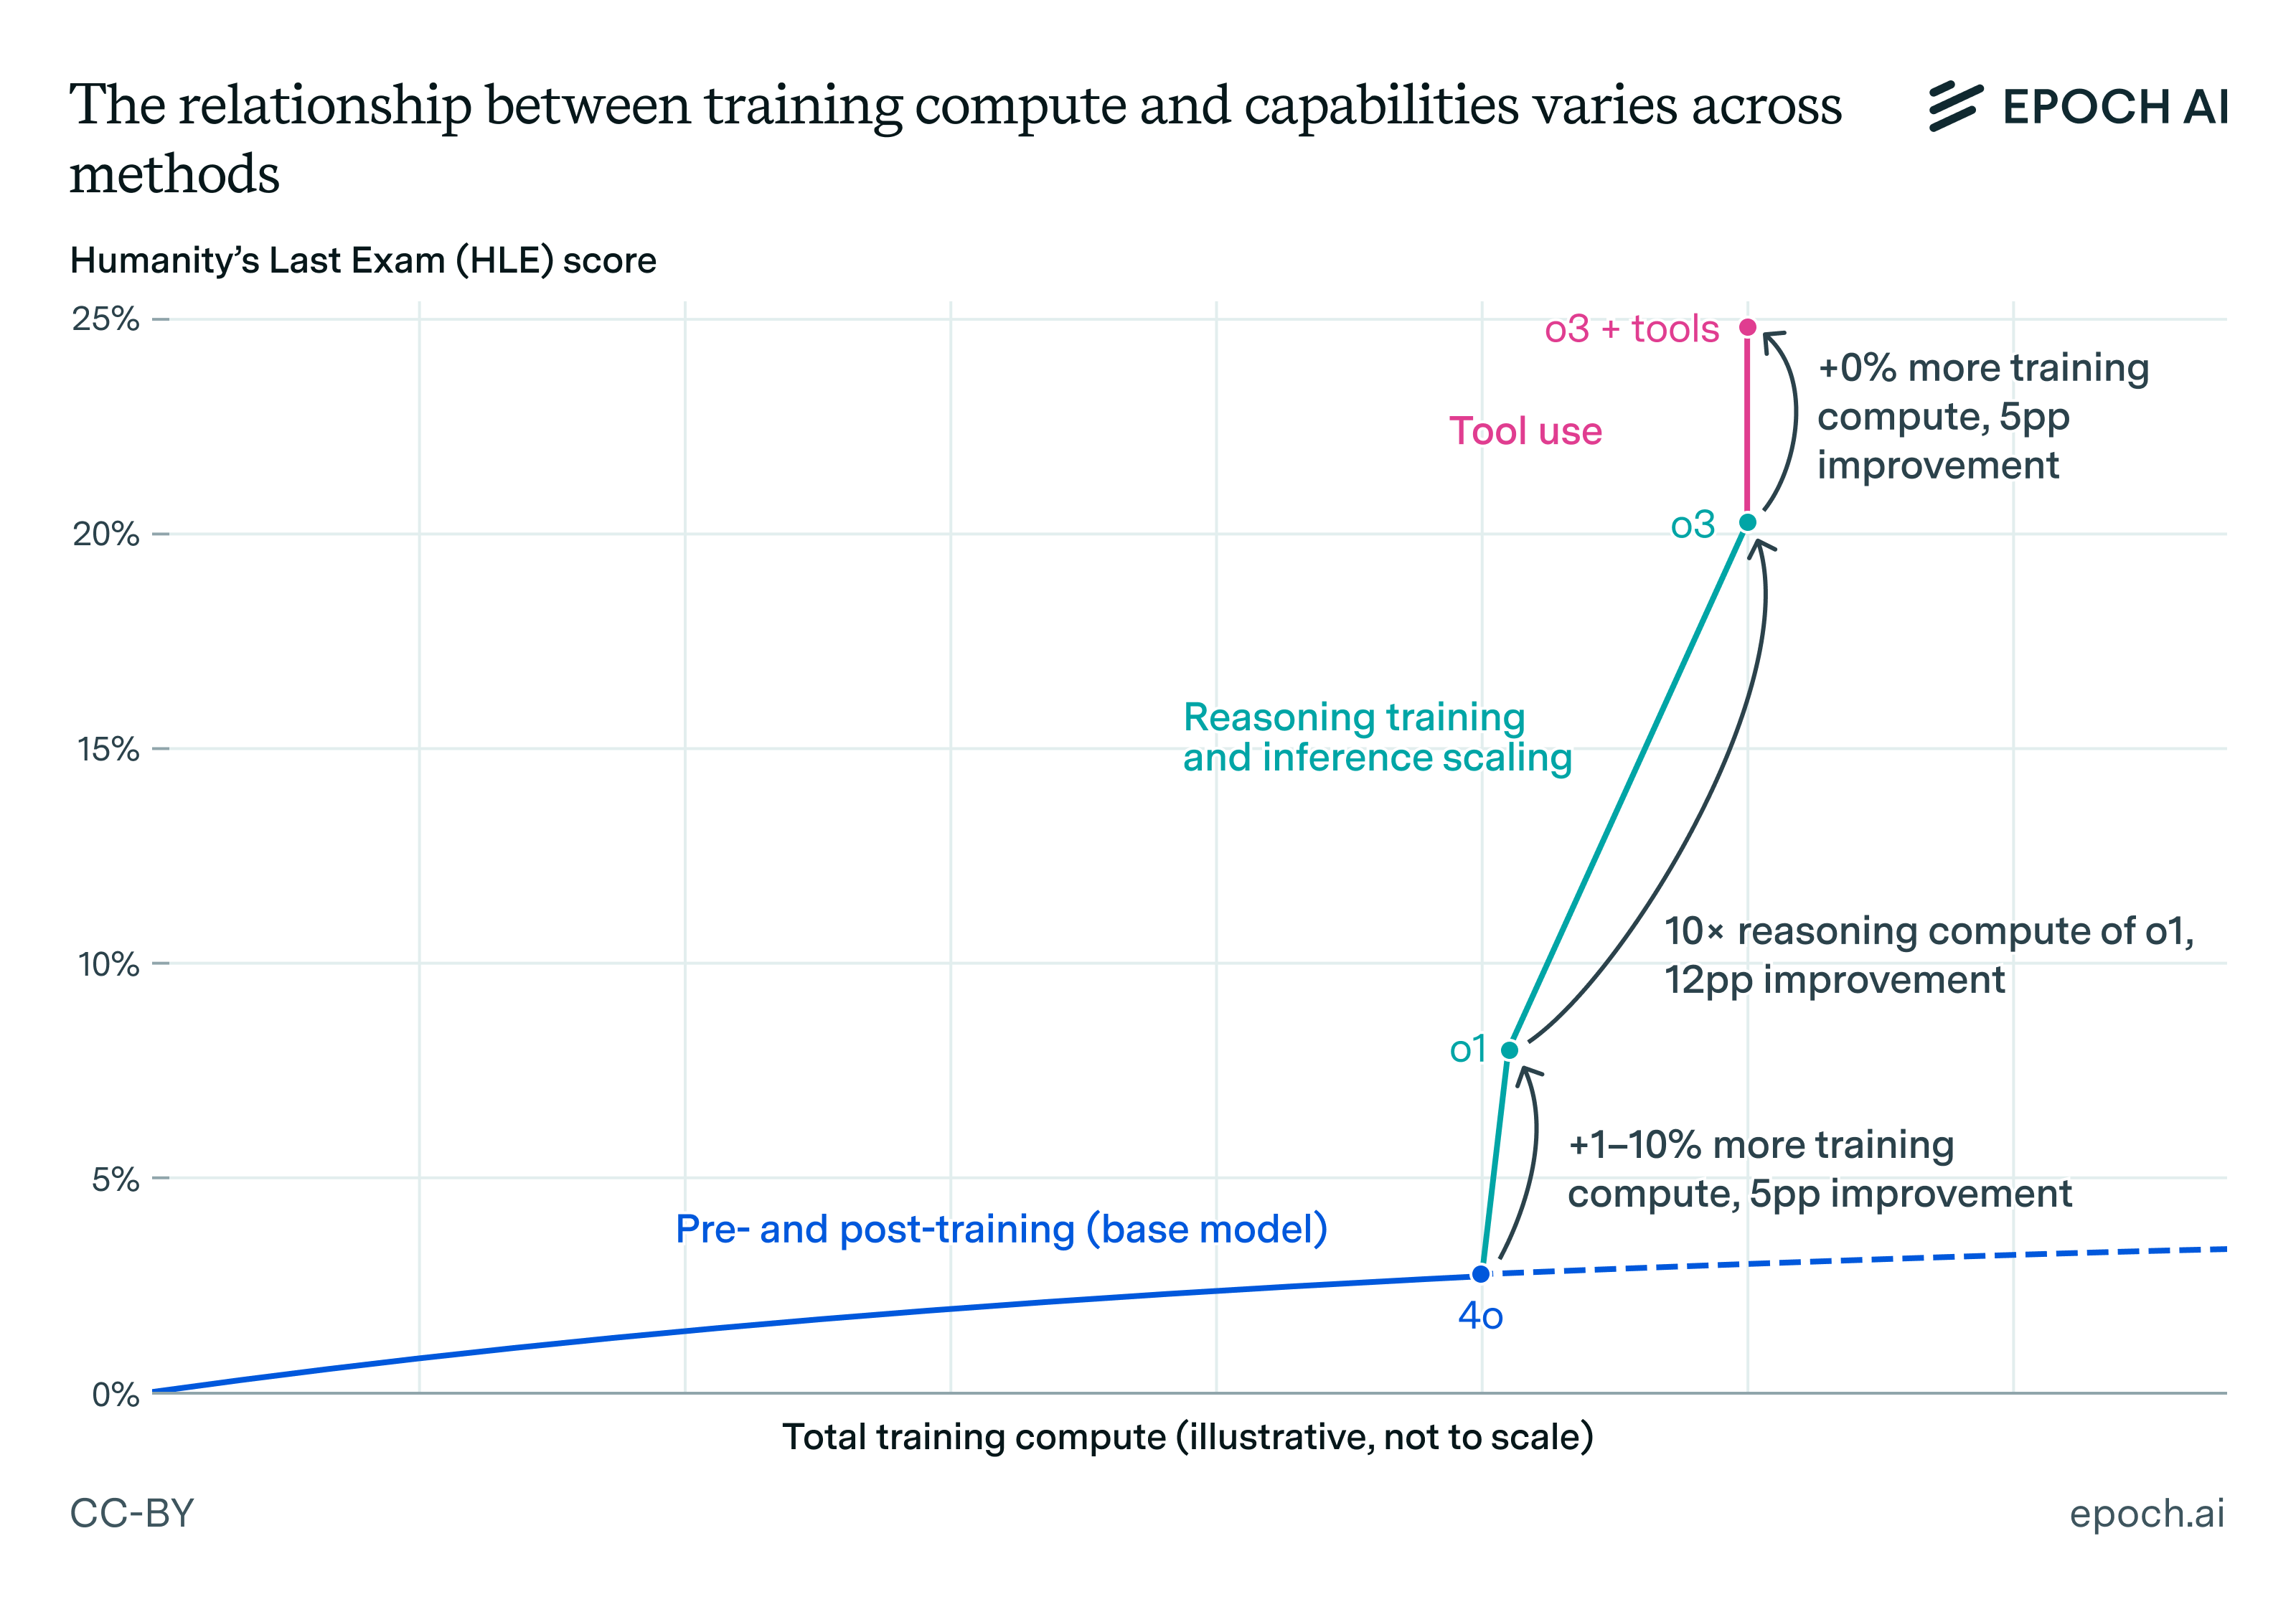
ツールの使用は、学習計算量を追加しなくてもモデルの性能を押し上げる。ここに示すとおり、o3+ツールはo3を大きく上回っており、計算量に基づく閾値では足場とツールの影響が見落とされることがよく分かる。なお、学習計算量の推定値は推測にもとづくものである。
現在の計算量の閾値は、この点を事実上見落としている。そうした閾値は、モデルの機能(つまり、ツールにアクセスできるときに全体としてモデルが何をできるか)よりも、モデルの構造(つまり、その学習計算量)に重きを置いているからである。懸念されるのは、システム設計そのものが時とともに改善し、素のモデルと、よく設計されたシステムに組み込まれた同じモデルとの能力の差がしだいに広がるにつれて、この死角が大きくなる一方だということである。
AIの公共政策にとって何を意味するのか?
計算量と能力の関係が急速に変わりつつあることを踏まえると、計算量の指標は無意味だということになるのだろうか。必ずしもそうではない。学習計算量には説得力のある利点がある。学習を始める前におおよそ割り当てられ、学習後に監査でき、組織間で比較できる。さらに、フロンティアの能力は、今後も計算資源への支出が最も大きいところで生まれる可能性が高い。統治の目的からすれば、計算量の指標の目標は、モデルの能力水準を正確に予測することではなく、どのモデルが審査に値するかを見分けることでありうる。
しかし学習パイプラインが進化するにつれて、事前学習と事後学習以外の要因が、現在の計算量の指標からは見えないまま、ますます能力を左右するようになるかもしれない。モデルの能力を実際に左右する要因のうち、私たちが数えている計算量の占める部分が縮小していけば、現在の計算量の指標は、どのモデルがフロンティアを押し広げているかを見分ける代理指標としてさえ、しだいに役に立たなくなるおそれがある。
政策立案者が、より幅広いAI統治の手段の一つとして計算量の指標を使い続けたいのであれば、上で述べた問題に対処するいくつかの方法を検討できる。
- より良い計算量の指標と閾値を研究する。現時点では、計算量と能力の関係についての私たちの理解には頑健な実証的基盤がなく、「計算資源」のさまざまな使い方が一般的になるにつれて、この状況が続く可能性もある。少なくとも、こうした規制の枠組みを更新するには、この関係をもっとよく理解する必要がある。もちろん目標は完璧な代理指標を作ることではないが、適切なデータの収集と分析によって、現在の指標をどの程度修正すべきか、廃止すべきか、あるいはフロンティアモデルだけに限って使うべきかを、よりよく理解できる。
- より頑健で表現力のある評価の仕組みを築く。下流の能力を判断する材料が学習計算量だけである必要はない。たとえば、自動化されたベンチマークや専門家によるチーミングなど、さまざまな評価と組み合わせることができる。これらは、モデルの能力、特に政策立案者が最も懸念する能力について、より信頼できる姿を描くのに役立つ。
- 用途や組織の単位での規制を重視する。これまでは個々のAIモデルを規制することに大きな重点が置かれてきたが、政策立案者は、最も重大なリスクが現実化しうる用途でAIシステムを規制することに力を入れることも検討できる。規制は組織の単位で行うこともでき、そうすれば特定の種類の計算量の厳密な定義をめぐる問題から離れられる。
これらの方法は、計算量の指標を直接改善するのに役立つかもしれないし、少なくとも政策判断で計算量の指標に頼る度合いを下げられるかもしれない。どの政策が最も理にかなっているかも時とともに変わっていく可能性が高いので、計算量と能力の関係の変化を引き続き注視することが欠かせない。そうすれば、新たな証拠に基づいて政策を見直していける。
フィードバックと支援をくださったJS Denain、Conor Griffin、Jaime Sevilla、Alexander Erben、Zhengdong Wangに感謝する。
注
-
変化が事前学習のアルゴリズムの進歩だけであれば、政策立案者は計算量の閾値を定期的に更新することで対処できる。しかし私たちが強調する核心の問題は、学習パイプラインそのものが進化しており、新しい要因がモデルの能力を押し上げていることである。これらの手法で計算量に対して能力がどれだけ伸びるのか、またそれらの相互作用が全体の能力にどう影響するのかは、はっきり分かっていない。そのため、閾値を単純に更新するだけではおそらく不十分である。↩
-
Epoch AIも、モデルの学習計算量を同じ方法で推定している。事前学習と事後学習の計算量を重み付けせずに合計し、合成データの生成のような付随的な計算資源の使い道は除いている。↩
-
推論の学習が大きな性能向上をもたらしうることを示すもう一つの例が、DeepSeek R1-Zeroである。RLによる学習の開始時点ではAIME 2024でわずか10%の得点だったが、8,000ステップのRLのあとには71%という見事な得点を達成した。RLの計算量はベースモデルの事前学習の計算量の5分の1にすぎなかったが、その比較的小さな計算資源の投資による能力の向上は劇的だった。↩
-
o1-highがGPT-4oをもとにしているかは確かではなく、o1-highがGPT-4oと比べてどれだけの計算量を必要としたかについての公開情報もない。ただし、これらは以前の記事で述べたとおり、私たちの最善の推測を反映している。↩
-
知識蒸留とは違い、これは中間出力の「ロジット」ではなく、実際に生成されたトークンを使う。↩
-
とはいえ、phi-4は相対的な費用の面ではかなり極端な例であり、特に大きな割合の合成データで学習したことでよく知られている。↩