
データの解説 AIチップの利用者
方法論
原文:AI chip users documentation – Methodology
「AIチップの利用者」エクスプローラーは、最大手のフロンティアAI開発企業であるOpenAI、Anthropic、Meta Superintelligence Labs、Google DeepMind、SpaceXAIに割り当てられ、利用されているAI計算能力の量についての分析をまとめたものである。この方法論の解説は2026年9月に執筆・公開したもので、参照用に作成・維持している。私たちのモデルの最新版はこちらのリポジトリを参照してほしい。
私たちは、各開発企業がAIの研究開発と推論実行に利用している1計算能力の量を推定する。これは、各開発企業が所有している計算能力と同じではない。開発企業の中には、主に他社から借りた2クラウドの計算能力を使う企業もあれば、大手テクノロジー企業の傘下にあるAI開発企業(Google DeepMind、Meta Superintelligence Labs、SpaceXAI)のように、通常は親会社から計算能力を割り当てられる企業もある。これらの推定からは、親会社が所有し、他社に貸し出している計算資源を除いている(たとえば、AnthropicはGoogleから計算能力の一部を借りているので、その計算資源はGoogle DeepMindには使えない)。
このエクスプローラーは、以前に私たちのニュースレターGradient Updatesに掲載した記事「フロンティアラボはAI計算資源の大半を(まだ)使っていない」と、それに付随する研究付録を土台にしている。この記事では、フロンティアの計算資源の傾向がAI業界の将来に何を意味するかを詳しく論じている。
定義については、大きな注意点が二つある。
第一に、Google DeepMindとMeta Superintelligence Labsについては、定義にある程度のあいまいさが残っており、私たちはそれを完全には解消していない。この二つのラボについては、フロンティアAI(研究開発と推論実行)または基礎的なAI研究に割り当てられた計算資源を推定し、広告推薦システムのような「中核事業」の活動に使われるAI計算資源は除こうとしている。しかし、この区別は必ずしもきれいに付くものではない。たとえば、DeepMindの計算資源と研究活動が、フロンティアAIやその他の基礎研究ではなく、フロンティアではない中核事業の活動をどの程度支えているのか、私たちには確かなことが分からない。一般に、AI計算資源の用途のうち何が「フロンティアAI」の用途で、何が動画や画像の生成モデルのような他の用途なのか、私たちは定義を持っていない。
第二に、OpenAIとAnthropicが利用できる、あるいは「利用している」計算資源を推定する際、両社のモデルに依存する第三者の製品を動かすのに使われる計算資源を含めるべきかどうかがあいまいである。両社のモデルは、クラウドパートナー(Amazon、Google、Microsoftなど)がホストするAPIでも利用できる。売上をモデル開発企業とクラウド事業者が分け合っている場合に、この計算能力を数えるべきかどうかは議論の余地がある。開発企業はこの計算資源からも売上を得るが、その取り分は自社製品の推論実行の計算資源から得る分よりも小さい。また、開発企業はこの計算資源を運用面で管理できないことがあり、その場合は研究に振り向けることができない。
OpenAIとAnthropicは、こうした取り決めを会計上異なる形で扱っている。Anthropicは第三者製品の売上をすべて自社の売上として計上し、計算能力の代金に加えて売上の一部の分配金も支払っている。一方、OpenAIは(2026年より前は)これらの製品の売上総額の20%だけを自社の売上として計上し、計算資源の代金は支払っていなかった。私たちはそれぞれの扱いにそのまま従う。この判断によって、両社の計算資源の推定は10〜25%程度変わりうる。MicrosoftがOpenAIのモデルを動かすのに使う第三者の計算資源が、それ自体で世界のAI計算資源の大口の消費者になった場合は、今後これを別の区分として推定することを検討する。
念のため述べておくと、OpenAIとAnthropicの計算能力は、ほぼすべてクラウドパートナーが所有している。問題は、両社が直接調達し管理している計算資源だけに範囲を厳密に絞るかどうかである。
AI計算能力は、既定ではNvidia H100 GPUに換算した数(略してH100e)で測る。各AIチップがカタログ上で実行できる8ビット演算の数を正規化し、Nvidia H100の仕様であるFP8で毎秒1979テラFLOPと比較する。
以下のラボごとの節では、モデルの仕様(サンプリングする入力、その分布、それを選んだ根拠)と、現在公開しているモデルの実行結果から推定がどう組み立てられるかの段階的な内訳を組にして示す。内訳では、各量の中央値と90%信用区間をモデルの計算順に示す。
OpenAI
OpenAIは他社から借りたクラウドの計算能力に頼っている。2026年時点では、主な貸し手はMicrosoft、Oracle、CoreWeaveだった。
2025年、OpenAIは自社の総計算能力の推移を電力容量で公表した。2023年末には0.2 GWの計算資源を使っており、2024年末には0.6 GW、2025年末には推定1.9 GWに増えた。3私たちは、これらのギガワットの数値は、OpenAIが使っているデータセンターのIT電力(つまりIT機器の最大消費電力)を指している可能性が最も高いと考えている。
これらの電力の数値に、MicrosoftがOpenAIのモデルを使う自社製品(Azure経由のAPIでの推論実行など)を動かすのに使う計算資源が含まれているかどうかは分からないが、おそらく含まれていないと考えている。高めに見積もると、MicrosoftがホストするOpenAIモデルの推論実行に使われる計算資源は、OpenAIの自社の計算資源群の規模の最大でおよそ25%に達する可能性がある。詳しくはこちらの研究付録を参照してほしい。
このMicrosoftの第三者向け計算資源を「OpenAIの計算資源」として数えるべきかどうかも議論の余地がある。OpenAIは売上と粗利益を得るために自社の計算資源の一部を推論実行に割り当てており、OpenAIに売上をもたらす第三者の計算資源もこの目的を果たしている。一方で、OpenAIがこのハイパースケーラーでの推論実行から得る粗利益は、自社での推論実行から得る粗利益よりおそらくずっと小さい。たとえば、OpenAIはこれまで、MicrosoftがホストするOpenAI製品の売上の20%しか分配されておらず、これは自社の粗利益率よりかなり低いとみられる。2026年4月の大幅な再交渉の後、OpenAIはMicrosoftがホストするOpenAIの推論実行から売上の分配を一切受け取らなくなった。データが入手できるかどうかによっては、今後これを計算資源の利用の別区分として追跡するかもしれない。
モデル化
詳細と可視化は、こちらのPythonノートブックと、主要なコードリポジトリを参照してほしい。
OpenAIは主にNvidiaのチップを使っているため、OpenAIの年ごとの電力の数値を、NvidiaのAIチップの仕様と販売構成の推移を用いて計算能力に換算する。4報道によれば、OpenAIは主に長期のクラウド計算資源の契約で計算資源を借りている。つまり、OpenAIが使うチップは、計算資源群が年々拡大するなかで何年も計算資源群にとどまる。5したがって、毎年追加される計算資源は、その年のNvidiaのチップ販売を反映していると考えられる(Nvidiaが売上を計上してから、そのチップがOpenAIに提供されるまでの導入の遅れを調整する)。6
OpenAIが追加したMW単位の容量をNvidiaのチップに対応づけるには、Nvidiaの年ごとのGPU構成を、データセンターに設置したときの各GPUのIT電力容量で重み付けする。これは、各Nvidiaチップの最も一般的なサーバー構成(DGX H100やGB200/GB300 NVL72など)でのGPUあたりのサーバー電力に、不確実なIT諸経費係数を掛けて求める。関係するパラメータはAIデータセンターから取っている。たとえば、ある年XにOpenAIが100 MWの計算資源を追加し、同じ年に(販売から導入までの数か月の遅れを調整したうえで)Nvidiaが、それぞれIT電力1500 WのH100を100万基と、IT電力1000 WのA100を100万基販売し、IT電力で見てH100とA100が60対40に分かれていたとする。この場合、OpenAIはその年にH100を60 MW分、A100を40 MW分追加したと推定する。
モデルには、次のパラメータで不確実性を組み込んでいる。
- OpenAIが報告したMWの数値は、丸めのために変動しうる(それぞれの方向に最大50 MW)
- OpenAIのMWの数値の正しい解釈は不確かである。私たちは、これらはIT電力を意味する可能性が最も高いと考えている(テクノロジー業界ではIT電力のほうがよく引用されるうえ、IT電力ではないと解釈すると、2025年末のH100eの数値が100万をわずかに超える程度という意外なほど低い値になる)。ただし、モデルには、OpenAIが示した数値が実は総電力であるという小さな可能性も組み込んでいる。その場合、実際のIT容量はPUE(1.1〜1.7の範囲)の分だけ割り引かれる。
- Nvidiaのチップの正確な構成は、チップが販売されてから稼働するまでの導入の遅れに左右される。この遅れは0.5〜2四半期と仮定している(関連する付録を参照)。NvidiaはBlackwell世代の販売を2024年末ごろに始めたが、導入の遅れが長いほど、OpenAIが2025年に追加した容量に占めるBlackwellチップの割合は小さくなる。
詳細は次の表のとおりである。
| パラメータ | 分布 | 根拠 |
|---|---|---|
| 電力の定義の係数 | 混合分布:90%は対数正規分布(0.95, 1.05)から、10%は1 / 対数正規分布(1.1, 1.7)から抽出 | OpenAIが公表した数値はIT電力か、総(施設全体の)電力か。90%の確率でIT電力(1.0の周りにわずかな不確実性が残る)、10%の確率で総電力とする。総電力の場合、真のIT電力はデータセンターのPUEである1.1〜1.7の係数の分だけ低くなる。 |
| 導入の遅れ | 対数正規分布 0.5〜2.0四半期(中央値は約1) | Nvidiaが売上を計上してから、チップが稼働するまでの遅れ。これは、OpenAIが2025年に計算資源群に追加した分のうち、HopperとBlackwellの割合に影響する。GPUの世代によって電力効率が違うため、ギガワットあたりの計算能力にも影響する。 |
| 丸めによるばらつき | 三角分布 ±50 MW(0で最大)、年ごとに独立 | 公表値は0.1 GW単位に丸められているとみられるため、実際の値は±50 MWずれうる。極端な値ほど起こりにくいため、一様分布ではなく三角分布とした。 |
| 電力の数値の正確さ | 対数正規分布(0.9, 1.2)(中央値は約1.04) | 丸めとIT電力か総電力かの問題を別にして、OpenAIの社内の総電力の数値そのものは正しいか。やや上振れに傾けている。 |
| NvidiaのIT諸経費係数 | 対数正規分布:中央値1.14、5パーセンタイル/95パーセンタイルは約1.00/1.35 | AIデータセンターの計算シートから取った分布。 |
| GPUあたりのサーバー電力 | A100 812.5 W、H100/H200 1275 W、GB200 1833 W、GB300 1944 W | 最も一般的なサーバー構成(A100とH100/H200はDGX、GB200/GB300はNVL72)のサーバー電力を、サーバーあたりのGPU数で割ったもの。 |
電力モデル(公表された各年末の時点で評価)
OpenAI 2025年12月31日:1.74M H100e(90%信用区間 1.25M–2.19M)IT電力 1 · 定数 公表された2025年末の電力1,900 MW(固定)2 · 入力 丸めの調整(±)=公表値は0.1 GW単位に丸められているため、真の値は上下どちらにも半単位以内にある0 MW-34 MW – 34 MW 0 1,500 2,500 MW 調整係数(シェア、比率)3 · 入力 電力の定義の係数(IT電力か総電力か)=二つの場合の混合:数値がすでにIT電力である(≈1)か、総電力をデータセンターのPUEで割ったものか0.99×0.73× – 1.05×4 · 入力 数値の正確さの係数1.04×0.90× – 1.20× 0 1.5 2.5 IT電力 5 · 導出 モデル化した2025年末のIT電力=(公表された2025年末の電力+丸めの調整)× 電力の定義の係数 × 数値の正確さの係数1,950 MW1,441 MW – 2,291 MW 0 1,500 2,500 MW 調整係数(シェア、比率)6 · 入力 Nvidiaの販売構成に対する導入の遅れ1.0q0.5q – 2.0q 7 · 入力 サーバー電力からIT電力への諸経費1.14×1.00× – 1.35× 0 1.5 2.5 H100換算 8 · 最終 OpenAIの計算資源(2025年末)=モデル化した2025年末のIT電力を、Nvidiaのチップ販売構成(導入の遅れの分だけずらしたもの)に配分し、チップの種類ごとに電力をサーバーのワット数 × サーバー電力からIT電力への諸経費でチップ数に換算し、H100換算で合計したもの1.74M1.25M – 2.19M 0 1.5M 2.5M H100e別の方法として、OpenAIの計算資源を、報道されたクラウドへの支出からモデル化することもできる。この代替モデルはこちらのノートブックで実装しており、報道されたOpenAIのクラウド計算資源への支出(2024年に68億ドル、2025年に163億ドル)をH100換算に変換する。具体的には、これらの支出額を補間して2024年末と2025年末の年換算の支出ペースを求め、当時のGPU時間あたりの価格に基づいてH100eに換算する。
2025年末については、二つのモデルはほぼ同じ結果になる。クラウド支出モデルの中央値は164万H100e(90%信用区間 114万〜241万)、電力モデルは174万(124万〜217万)である。一方、2024年末については、クラウド支出モデルのほうが高い推定になる。電力モデルの38.4万(27.6万〜48.5万)に対して、50.6万H100e(90%信用区間 29.7万〜77.3万)である。なお、クラウド支出モデルの誤差範囲はより広く、電力モデルの信用区間をほぼ包含しているため、両者はそれなりに整合している。採用するのは、より確度が高く頑健な電力モデルである。OpenAIは2024年末と2025年末の電力容量を直接公表しているのに対し、支出モデルでは年間の支出総額をある時点の年換算ペースに変換するために、より多くの仮定を置く必要があるからである。
これとは別に、NvidiaはForm 10-Kで「あるAI研究・展開企業が、2026会計年度[2026年1月終了]に当社の顧客からクラウドサービスを購入することで、当社の売上の相当な部分に寄与した」と述べている。これはOpenAIを指している可能性が非常に高い。OpenAIは自らを「AI研究・展開企業」と称しており、クラウドサービスを通じてNvidiaの計算資源を最も多く消費しているAI開発企業であることはほぼ確実だからである。企業は顧客の集中度の開示で売上の10%を基準にすることが多いが、Nvidiaのこの文言からは、この企業が売上の10%超を占めていたかどうかははっきりしない。私たちは、Nvidiaが2025年末までにH100換算で1,300万基を超えるGPUを販売したと推定している。
Anthropic
OpenAIと同じく、Anthropicも外部のクラウドパートナーのAI計算能力を使っている。2025年時点では主にAmazonとGoogleで、2026年にはSpaceX/xAIとCoreWeaveが加わった。
OpenAIと同じく、「Anthropicの計算資源」にも定義のあいまいさがある。Anthropicのモデルの推論実行のかなりの部分を、Amazon、Google、Microsoftの第三者APIが担っているからである。会計上、Anthropicとそのクラウドパートナーは、これを類似したMicrosoftとOpenAIの取り決めとは異なる形で扱っている。Anthropicはこれらの製品に使われる計算資源の代金を支払い、売上の全額をAnthropicの売上として計上し、ハイパースケーラーに分配する売上は費用として計上する。Anthropicはこの計算資源の代金をすべて支払い、売上もすべて計上しているので、私たちのモデルではこの第三者の計算資源を除こうとはしていない。Anthropicの計算資源への支出についての報道には、この第三者の計算資源がおそらく含まれているため、こうするとモデル化も簡単になる。
OpenAIと同じく、Anthropicに関係するハイパースケーラーの第三者向け計算資源は、おそらく相当な量だが、全体の中では少数派である。報道によれば、Anthropicは第三者経由の推論実行で得る粗利益のおよそ半分をクラウド事業者と分け合っている。全体の粗利益率が40%から80%の間なら、これらの製品の売上総額のうち20%から40%をクラウド事業者と分け合っていることになる。同じ報道によれば、クラウドパートナーへのこうした売上の分配は2025年に計3億6,000万ドルで、Anthropicの2025年の総売上45億ドルの8%にあたる。このことから、2025年のハイパースケーラー経由のClaudeの推論実行による売上総額はおよそ10億ドルで、Anthropic関連の推論実行の売上の約20〜25%だったと考えられる。2025年にはAnthropicの計算資源への支出の大半が研究と学習に向かったため、第三者APIでのClaudeの推論実行の計算資源は、Anthropicの計算資源全体のおよそ10%を占めていたことになる。7
モデル化
詳細と可視化は、こちらのPythonノートブックと、主要なコードリポジトリを参照してほしい。
2025年のAnthropicの計算資源は、主にギガワット単位のデータセンター容量の推定をもとに推定している。OpenAIは投資家向けのメモで、2025年末時点でAnthropicのデータセンター容量を1.4 GWと推定した。これはOpenAIが自社について主張する容量の約4分の3にあたる。これはOpenAIによる他社についての推定で、偏りがある可能性もあるため、OpenAIが自社の容量を公表した数値より不確かである。8そこで、それに応じて誤差の幅を大きくとってモデル化している。
さらに厄介なことに、OpenAIの計算資源群が主にNvidiaであるのに対し、Anthropicの計算資源群はNvidiaのGPU、AmazonのTrainium、GoogleのTPUに分かれている。したがって、OpenAIのときのようにNvidiaのチップ構成をそのまま使って電力を計算能力に換算することはできない。
実際には、Nvidiaの累計の計算資源群とTPUの累計の計算資源群は、電力効率がおそらく同程度である(詳しくはこちらのノートブックを参照)。そこで簡単のため、計算資源群のうちTrainiumの割合だけを考慮する(Anthropicが使うTrainiumチップはすべてTrainium2と仮定する)。Anthropicが使うAmazonの大規模なTrainium2拠点であるProject Rainierは、2025年後半にIT電力容量が600 MWを超えていたと私たちは推定している。その規模から見て、当時Anthropicの計算資源群全体の半分超をTrainium2が占めていたというのは妥当な見方である。
妥当性の確認として、Amazonは2026年初めまでにTrainium2チップを計140万基導入したと公表している。これらを導入すると、IT電力でおよそ1.2 GWを消費する。9Anthropicの1.4 GWの半分がTrainium2だったとすると、2025年末にはTrainium2の容量の約58%がAnthropicに割り当てられていたことになる。AnthropicはTrainiumチップの外部顧客として群を抜いて最大なので、これは妥当である。
Trainium2の電力効率はNvidiaのHopperと同程度だが、Nvidia Blackwellには劣る。そのため、Trainiumの割合が高いほど、AnthropicがNvidiaとTPUだけを使っていた場合に比べて、AnthropicのH100eはいくらか下がる。感度の確認として、Trainium2の割合のパラメータを20%から80%に上げると、H100eの推定の中央値は130万から111万へと15%下がる。したがって、全体の推定は、このパラメータのもっともらしい不確実性にはあまり左右されない。
Anthropicの計算資源群に関するその他の証拠
2025年のAnthropicの容量については、ほかにも二つの手がかりがある。第一に、報道によれば、Anthropicは2025年にクラウド計算資源に68億ドルを支出した。これはOpenAIの支出の約42%にあたる(詳しくは私たちのAI企業エクスプローラーを参照)。2025年のこの比率は、OpenAIのメモにある電力の数値と食い違う。メモでは、2025年末の電力容量で見て、AnthropicをOpenAIの計算資源の約75%という、はるかに高い割合に置いていた。この食い違いには、いくつかの説明がありうる。Anthropicの電力容量の伸びが年の後半に偏っていた可能性、Anthropicの計算資源のほうが安い可能性(計算資源群に安価な独自設計のTPU/Trainiumチップが多く含まれるため)、電力効率の違い(たとえば、Trainium2の多いAnthropicの計算資源群は、Blackwell/Hopperの混在するOpenAIの計算資源群より効率が低い)、あるいは、電力の数値を出す方法と報道されたクラウド計算資源の請求額を出す方法の間に、会計上の大きな違いがある可能性である。
第二に、Anthropicの計算資源の大きな部分は「Project Rainier」に集中している。これは、Amazonが独自設計のAIチップ「Trainium」を搭載したデータセンターをAnthropicに供給する、複数のデータセンターにまたがる取り組みである。10
2025年末時点で、インディアナ州のProject Rainier拠点には、約70万基のTrainium2チップからなる47万H100eが導入されていたと私たちは推定している。この拠点はAnthropicのために建設されたと広く報じられているので、Anthropicが唯一の、または主要な利用者だと考えてよい。Amazonはミシシッピ州にも約20万H100eの大規模なデータセンターを持っている。少なくとも一人の業界アナリストは、これをAnthropic/Project Rainierに割り当てられたTrainiumベースのデータセンターだと主張しているが、Anthropicがこの施設の唯一の利用者であるかどうかは、それほど明白ではない(ただし、その可能性は高い)。合わせると、Anthropicは2025年末までに、この二つの拠点から50万〜70万H100eのAmazon Trainiumを調達していたと考えられる。これは、AnthropicがAmazonとGoogleから借りている相当数のNvidiaとTPUのチップに上乗せされる分なので、Rainierに基づくこれらの数値は、2025年末のAnthropicを100万H100e超とするモデル全体の結果と整合する。
2024年の計算資源
詳細は推定のノートブックを参照してほしい。
2024年については、Anthropicのメガワット単位の計算能力について、公表値も第三者の推定もない。2024年の計算資源を推定する主な手がかりは、The Informationによる、Anthropicの2024暦年と2025暦年のクラウド計算資源への支出の報道で、それぞれ25億ドルと68億ドルである。これを使って、2024年末のAnthropicの計算資源への支出の年換算ペースを推定できる。2024年から2025年にかけての年2.7倍の伸びを単純に一つの指数関数的な成長率として補間すると、支出ペースは年40億ドルとなる。成長曲線の形を変えると、年25億ドルから50億ドルの範囲になる。
モデルの仕様(2024年)
| パラメータ | 分布(90%信用区間) | 根拠 |
|---|---|---|
| 2024年のクラウド計算資源への支出 | 対数正規分布 $2.08B – $3.0B | The Informationは25億ドルと報じた。報道や定義のあいまいさを考慮し、上下それぞれ20%の不確実性を置く。 |
| 2025年のクラウド計算資源への支出 | 対数正規分布 $5.67B – $8.16B | The Informationは68億ドルと報じた。報道や定義のあいまいさを考慮し、上下それぞれ20%の不確実性を置く。2024年の数値と0.5の相関をもたせてサンプリングする。 |
| 2025年内の成長の形 | 対数正規分布 0.9 – 1.5(中央値は約1.16) | 2024年→2025年の平均成長に対する倍率で表した、2025年内の成長。1は2024〜2025年の滑らかな指数関数的成長、1未満は支出の伸びが前に偏っている(2024年後半の支出が多い)こと、1超は後ろに偏っていることを意味する。詳しくはノートブックを参照。これにより2024年末の年換算ペースが決まる:年約35億ドル(年26億〜45億ドル)。 |
| 2024年のH100e時間あたりの実効価格 | 対数正規分布 $1.50 – $2.50(中央値は約$1.95) | H100の1年契約のレンタル価格は、1時間あたり約3ドル(2023年)から、2024年を通じて2ドル台前半まで下がった。Anthropicはおそらくそれより低い(複数年契約の割引、より安いTPU/Trainiumチップ)。「計算資源への支出」にはチップの使用時間以外の付随費用が含まれる可能性があり、その場合は実効価格が上がる。 |
モデルの仕様(2025年)
| パラメータ | 分布(90%信用区間) | 根拠 |
|---|---|---|
| IT電力の合計 | 対数正規分布 1.0 GW – 1.9 GW(中央値は約1.38 GW) | 流出したOpenAIの社内メモは、2025年末に稼働していたAnthropicの容量を約1.4 GWとしていた。OpenAI自身は1.9 GWである。下限の1.0 GWは、1.4 GWがIT電力ではなく施設の電力だったというリスクの大部分もカバーする。 |
| IT電力に占めるTrainium2の割合 | ほぼ正規分布 0.35 – 0.70(中央値は約0.52)、[0.1, 0.9]で打ち切り | Project Rainierの容量から判断した。詳しくは上の解説を参照。電力とは独立にサンプリングする。 |
| Nvidiaのチップの仕様と構成 | 固定:H100/H200はIT 1,453 W、1.00 H100e。GB200は2,090 W、2.53 H100e。Hopper:Blackwellは約1.48 : 1 | OpenAIのモデルから借用:GPUあたりのサーバー電力 × IT諸経費係数の中央値1.14、およびOpenAIの2025年末のHopper:Blackwell構成(A100は除外し、GB300はBlackwellに含めた)。混合した値:約945 H100e/MW。 |
| TPUの計算資源群の効率 | 固定:MWあたり約1,009 H100e(Nvidiaの構成の1.07倍) | Googleの実際のv5以降の計算資源群(Epochのチップ販売データ)を、台数 × IT電力(TDP × サーバー諸経費1.742。GB200 NVL72から導いた値)で重み付けしたもの。H100の1,979 TFLOP/sに対する、ネイティブの8ビットのピーク性能で評価した。 |
| Trainium以外の効率の区分 | MWあたり977 H100e × サンプリングした倍率、対数正規分布 0.8 – 1.25(幾何平均1.0) | NvidiaとTPUの効率は非常に近いので、Trainium以外の計算資源はすべて、両者の中間点の一つの区分にまとめる。得られる効率は不確かである。OpenAIのモデルでは、導入の遅れの不確実性によって0.83倍から1.16倍の不確実性が生じる。ここではTPUが混じっているため、これより広げている。 |
| Trainium2の仕様 | チップあたりIT約871 W(MWあたり754 H100e、Trainium以外の約0.77倍)× サンプリングした倍率、対数正規分布 0.85 – 1.2(幾何平均は約1.01) | チップあたりのH100eは、密な8ビット演算のスループットの比(1,299/1,979 TFLOP/s)である。チップあたりのIT電力871 WはフロンティアAIデータセンターから推定した。サーバー電力は推定値で、Amazonが公式の仕様を公表していないため、不確実性の幅をもたせている。 |
Google DeepMind
Google(ここではAlphabet全体の略称として使う)は大手ハイパースケーラーで、おそらく世界のどの企業よりも多くのAI計算資源を所有している。GoogleにはGoogle DeepMind(以下「DeepMind」)というAIラボ部門があり、フロンティアAIの取り組みのほか、多くのAI研究プロジェクトを抱えている。
ここでは、DeepMindが作ったモデルの推論実行を含め、DeepMindにどれだけの計算資源が割り当てられているかを推定する。これはGoogleの社内の計算資源の会計と一致するとは限らない。DeepMindの仕事が、たとえば広告推薦システムとどれほどはっきり区別されるかが明らかでないため、ここでの定義はあいまいになりうる。ただ、Googleの計算資源の配分についての私たちの不確実性は全般に大きく、この定義上の不確実性はその中に収まる程度のものである。
DeepMindの計算資源は次のように推定する。
- GoogleのTPUの容量と、NvidiaのGPU購入に占めるGoogleのシェアの推定(AIチップの保有者から)を出発点にGoogle全体の計算資源を推定し、販売された計算資源と稼働している計算資源の間の導入の遅れの分を割り引く。
- Googleの計算資源のうち、外部へのクラウド販売やその他の社内用途に割り当てられた分に対して、DeepMind関連の分がどれだけの割合だったかを推定する。2025年については、ML計算資源の半分をGoogle Cloudに割り当てたというGoogleの公表を使って、この割合を絞り込む手がかりにする。
詳しくはこちらのPythonノートブックを参照してほしい。
Googleの計算資源のうちDeepMindに回るのはどれだけか
全体として、DeepMindは2025年に、Googleの総AI計算能力のおよそ半分を学習と推論実行に使っていた可能性があると私たちは考えている。この結果には大きな不確実性があり、かなりの当て推量を含む。DeepMindの割合は3分の1から3分の2の間でもおかしくない。ただし、DeepMindがGoogle全体に占める割合が大きいが圧倒的ではないと推論できるだけの情報はあるので、まったく何も分からない状態で進めているわけではない。
GoogleのAI計算資源は、Google Cloudと社内利用に分かれる。AlphabetのCFOによれば、2025年のAlphabetの「ML計算資源」は、Google Cloudとその他の用途でおよそ半々に分かれており、2026年もこの比率は同程度になる。11ただし、Google CloudにはDeepMind関連の計算資源も含まれる。Cloudには、GPUとTPUの容量の販売に加えて、Gemini APIやGemini Enterpriseのサブスクリプションなど、企業向けのGeminiの推論実行の大半も含まれる。12
したがって、DeepMindの計算資源は次の式で表される。
Googleの総AI計算資源 ×(Cloudの割合 × Cloud計算資源に占めるDeepMindの割合 +(1 − Cloudの割合)× Cloud以外の計算資源に占めるDeepMindの割合)
言い換えると、Googleの計算資源はCloudとCloud以外でおよそ半々に分かれているので、DeepMindに全体の50%超が割り当てられているかどうかは、Cloud計算資源に占めるDeepMindの割合が、Googleの社内計算資源に占めるDeepMind以外の割合より大きいかどうかで決まる。
順に見ていこう。
Cloud計算資源に占めるDeepMindの割合。 前述のとおり、Google Cloudには企業向けのGeminiの推論実行の大半が含まれる。この計算資源の残りは、外部へのクラウドの貸し出しと、DeepMind以外のモデルのAPIの運用に回る。Google CloudはGoogleの計算資源のおよそ半分だったので、2025年末にはおよそ200万H100eを使っていた可能性がある(Googleが所有するAI計算資源の推定値を1四半期前にずらしたものの半分)。
上で示したOpenAIとAnthropicの推定からすると、2025年末に企業向けのGeminiの推論実行が100万H100eを超えていた可能性は低い。Menlo Venturesによる第三者の推定によれば、企業向けAIではAnthropicが市場をリードしており、OpenAI、Googleがそれに続く(私たちはこの順序には同意するが、そこで推定されたシェアを額面どおりには受け取っていない)。そして、Anthropicの推論実行の容量全体は、当時おそらく100万H100eを下回っていた。
社内計算資源(推論実行と研究開発)に占めるDeepMindの割合。
いくつかの証拠から、DeepMindはGoogleのCloud以外のAI計算資源の大きな割合(たとえば50%超)を占めている可能性がある。
第一に、Alphabetは2025年に「Alphabet-level activities」(全社レベルの活動)に160億ドルを支出したと公表しており、その主な使い道はDeepMindの研究開発だった。このことは、Googleが2025年にAIの研究開発にOpenAIと同程度の額を支出したことを弱く示唆する。OpenAIは2025年末に100万H100e近くを研究開発に割り当てていたとみられる。これはGoogleの総AI計算資源の約4分の1、Cloud以外の計算資源の約半分にあたる。この推定について詳しくは次節を参照してほしい。個人向け製品でのDeepMind関連の推論実行を含めれば、この合計はさらに増える。
第二に、SemiAnalysisは、Googleの全計算能力のおよそ40%がDeepMindの学習(おそらく学習と研究のすべてを意味する)に割り当てられていたと推定した。13
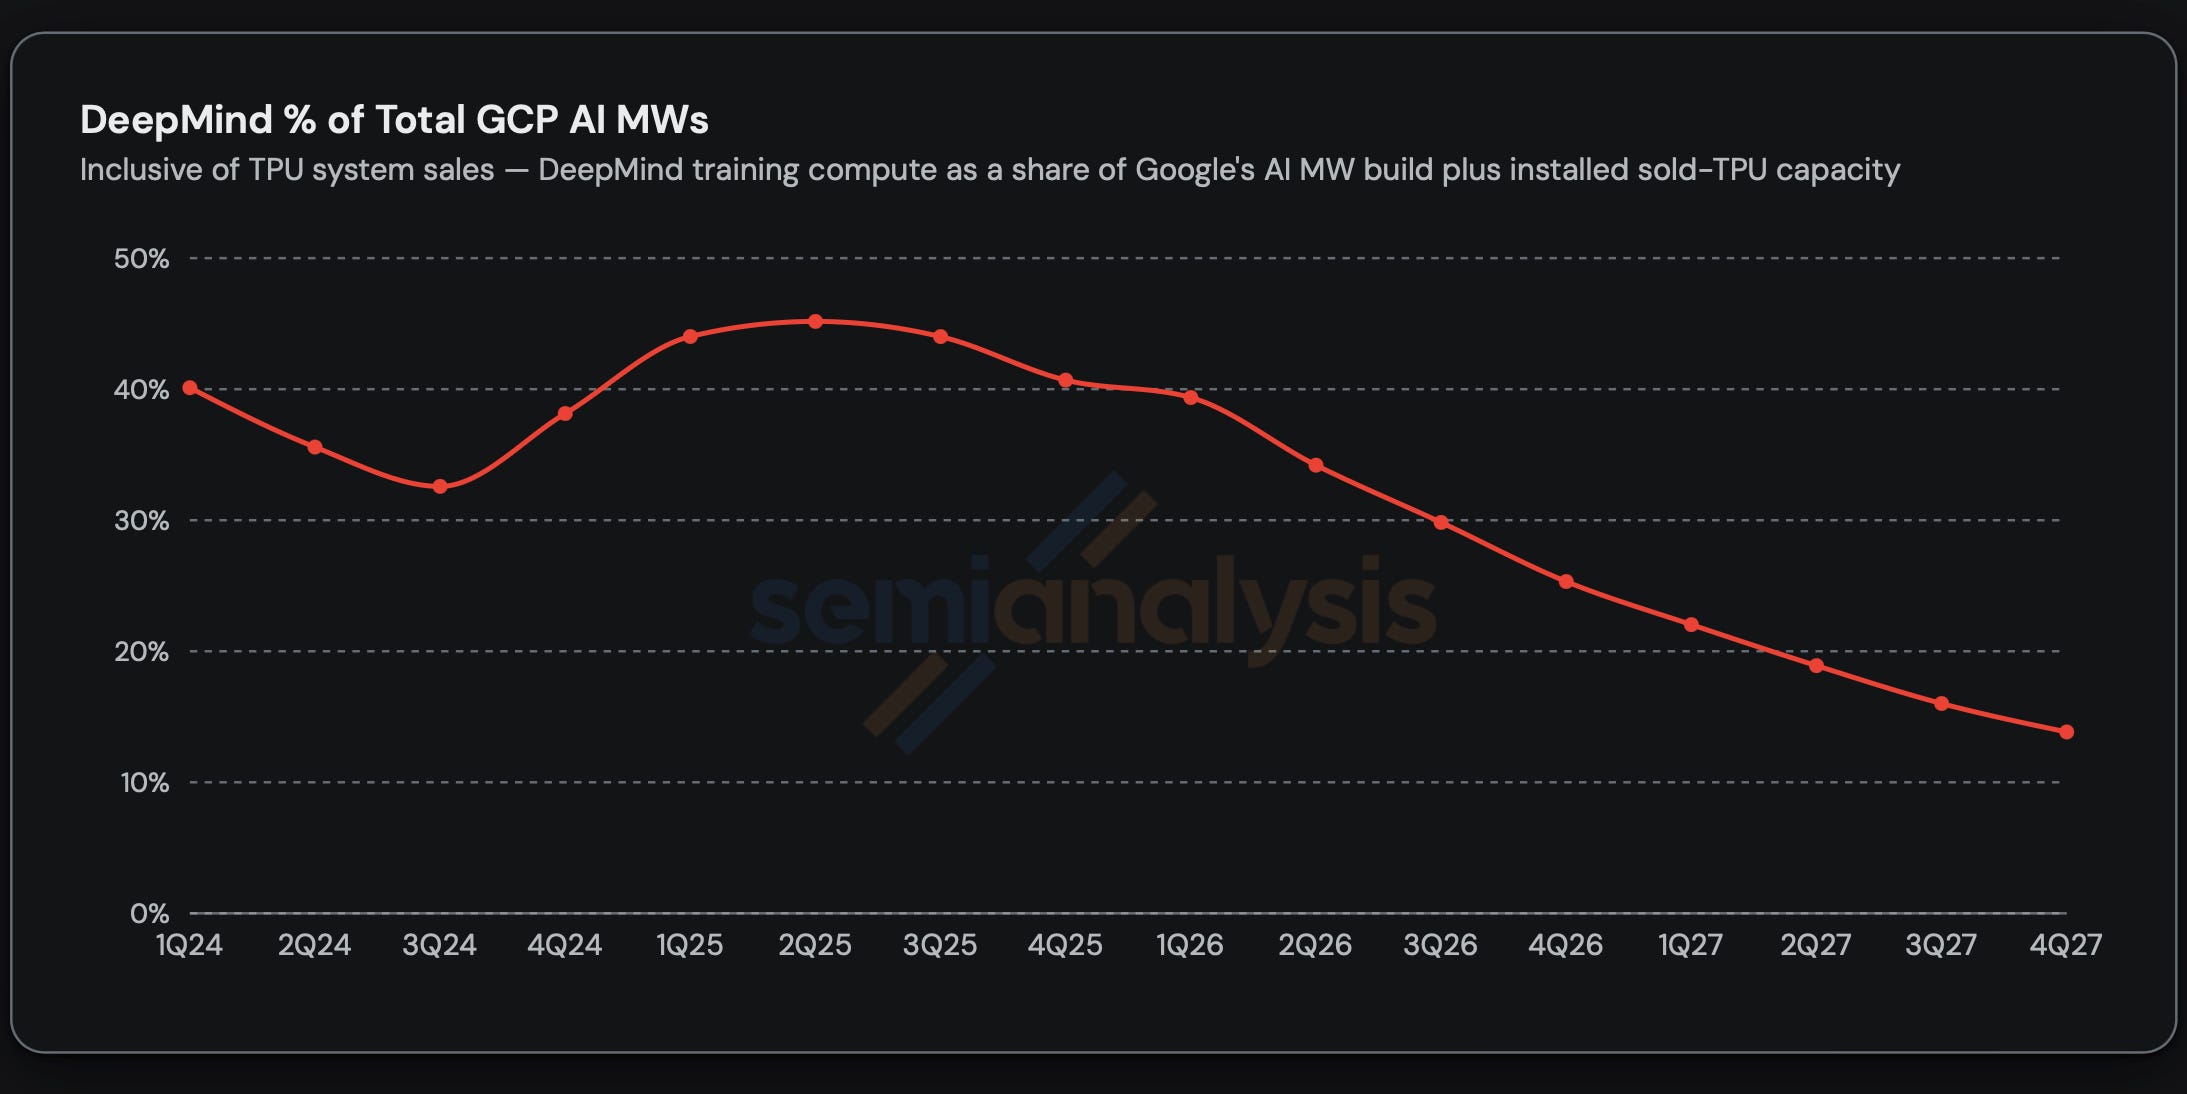
より大まかな外部の視点から見ると、DeepMindはGoogleの旗艦的なAI部門であり、フロンティアAIでの競争はこれまで高い優先事項だった。たとえば2023年には、Googleの経営陣は、ChatGPTのような競合他社のLLM製品の強さを、自社の検索事業にとって存亡に関わる脅威とみなしていた。Googleは、OpenAIと同等かそれ以上の量をDeepMindに割り当てられるだけの計算資源を所有している。AnthropicとOpenAIは年換算売上高と企業評価額を急速に伸ばしており、Googleにはこの市場で競争する大きな金銭的動機がある。ただしそれは、大量の計算資源を割り当てれば実際にDeepMindが競争力を保てるとGoogleが考えている場合である。2025年時点ではこれは妥当な判断に見えたが、一部の業界関係者は、2026年にはGoogleのDeepMindへの信頼が揺らいでいると主張している。
DeepMindの割合が高いという見方への反論は、Googleには計算資源の別の用途が多数あるという単純な事実である。Metaの節で論じるように、広告やコンテンツの推薦システムはおそらくMetaのAI計算資源の大きな割合を吸収しており、Googleの広告事業は売上がMetaと同程度である。GoogleとAlphabetには、AIや機械学習の処理を必要とする製品・サービスが無数にある(翻訳、検索、地図、自動運転など)。
2024年の配分
2025年と違い、Googleは2024年にAI計算資源をCloudと社内利用でどう分けたかを明らかにしていない。そこで、DeepMindの割合をCloudとCloud以外に分解せず、DeepMindの全体に占める割合を一つの変数で表す。2025年のモデルからは、Googleの計算資源全体に占めるDeepMindの割合は約32%〜67%となる。これを2024年に遡って外挿し、より広い25%〜75%の区間をとる(対数正規分布、中央値は約43%)。言うまでもなく、これはかなり原理に乏しい推測である。
Alphabet-level activities
Alphabetは「Alphabet-level activities」(以下「ALA」)という営業費用の項目を報告しており、これを「主に当社の共有のAI研究開発に関連する費用を反映[する]」ものと説明している。14GoogleはALAに2025年に167.6億ドル、2026年第1四半期に54億ドル(年換算220億ドル)を支出しているので、2025年末の年換算の支出ペースは年170億〜220億ドルだったと考えられる。このすべてがAI関連というわけではない。Googleによれば慈善活動、人事、法務の費用も含まれるが、その文言からは大部分がAIの研究開発向けであることがうかがえ、2025年末のAIの研究開発の年換算ペースはおそらく年150億〜200億ドルだったことになる。ALAは2024年に105億ドル、2023年に91.86億ドルで、ALAに占めるAIの割合は時とともに高まってきたとみられる。
ALAの支出は、DeepMindの計算資源の割り当てについて、わずかながら証拠になる。DeepMind関連の研究開発の計算資源はALAの区分に入ると考えられるが、製品開発と十分に結びついている分は除かれているかもしれない。
ALAの支出額を計算資源に換算するのは簡単ではない。この支出の多くは、人件費やデータなど、計算資源以外の費用に回るからである。こちらのコードのノートブックで大まかなモデルを示しているが、DeepMindの計算資源の全体モデルでは直接使っていない。
DeepMindのH100eあたりのコストは、OpenAIのような企業がクラウドでNvidiaのチップに支払う額よりおそらくずっと安い。DeepMindは主に独自設計のTPUを使っており、外部のクラウド企業に利益分を支払わないからである。たとえばSemiAnalysisは、TPUv7のチップ時間あたりの総所有コスト(TCO)はGB200より44%低い(FLOP/sの仕様は同程度)と推定している。これには、クラウドの層を介さないことによる割引は含まれていない。ここから、クラウドでNvidiaを借りる場合より50%を超えて割安で、H100e時間あたり1ドル未満(年8,700ドル未満)の価格だと考えられる。たとえばALAの半分が計算資源に支出されたとすると、DeepMindの研究開発だけで(推論実行の計算資源を除いて)100万H100eを超える割り当てがあったことになり、これはおそらく高すぎる。
より広く見ると、年約150億〜200億ドルのAI研究開発費は巨額である。比較すると、OpenAIの2025年の研究開発費は190億ドルだった(うち約80億ドルが研究開発の計算資源に割り当てられ、計算資源への支出総額の半分を占めた)。つまり、2025年のALAはOpenAIの研究開発費の約90%に相当したとみられ、ALAの大半をDeepMindの研究開発が占めていた。
2025年には、OpenAIの計算資源への支出の半分、つまり約90万H100eが研究開発に割り当てられた。DeepMindは計算資源のコストが低いので、2025年にDeepMindがOpenAIより多くの研究開発の計算能力を持っていたことは十分ありうる。ただし、コストが低いことは、研究開発費のうち計算資源に割り当てられる割合が低かったことを意味する可能性もある。
全体として、ALAからは、弱い根拠ながら、2025年末にDeepMindが研究開発に100万H100eのオーダーの計算資源を使っていたことがうかがえる。個人向けの推論実行を加えれば、DeepMindに割り当てられたCloud以外のAI計算資源は優に100万H100eを超え、GoogleのCloud以外のAI計算資源の合計の半分を超えうる。
モデルの仕様(2025年)
| パラメータ | 分布(90%信用区間) | 根拠 |
|---|---|---|
| Alphabetが所有するNvidiaの計算資源 | 対数正規分布 955k – 1.59M H100e(中央値は約1.24M) | AIチップの保有者のダッシュボードの信頼区間からサンプリングした。Alphabetの計算資源の合計の分布を得るため、TPUとは独立に抽出する。これは単純化であり、不確実性には相関がある(Googleの合計に共通する誤差)、あるいは負の相関がある(GPUとTPUの購入はトレードオフの関係にある)と主張することもできる。 |
| Alphabetが所有するTPUの計算資源 | 対数正規分布 3.08M – 4.54M H100e(中央値は約3.74M) | 出典と注意点は上と同じ。 |
| 導入の遅れの比率 | 対数正規分布 0.55 – 0.87(中央値は約0.69) | 0.5〜2四半期の設置の遅れから導かれる、稼働している計算資源と所有している計算資源の比率。 |
| GoogleのML計算資源に占めるCloudの割合 | 対数正規分布 0.45 – 0.55(中央値は約0.50) | GoogleのCFOによれば、2025年にはML計算資源の「およそ半分」がクラウドに使われ、2026年には「半分をわずかに超える」見通し。この発言を中心に狭い幅をとった。 |
| Google Cloudの計算資源に占めるDeepMindの割合 | 対数正規分布 0.2 – 0.6(中央値は約0.35)(社内計算資源に占めるDMの割合と50%の相関をもたせてサンプリング) | クラウドの半分(約160万〜200万H100e)には、外部へのGPU/TPUの貸し出し(Anthropic向けなど)と、企業向けのGeminiの推論実行が含まれる。企業向けのGeminiは、OpenAIやAnthropicの推論実行を下回る規模、つまり2025年末に約100万H100e未満で動いているとみられるので、この割合はおそらく0.5未満である。 |
| Googleの社内AI計算資源に占めるDeepMindの割合 | 対数正規分布 0.4 – 0.8(中央値は約0.57)(Cloud計算資源に占めるDMの割合と50%の相関をもたせてサンプリング) | 企業向け以外のGeminiの推論実行(個人向けチャットボット、Google検索のAI Overviews)と、DeepMindの研究開発の両方を含む。クラウドに占めるDeepMindの割合と並んで、おそらく最も不確かなパラメータで、かなりの当て推量を要する。詳しくは上の要約を参照。 |
2024年末の遡及推定
Google DeepMind 2024年12月31日:420k H100e(90%信用区間 214k–775k)2024年末の遡及推定 H100換算 1 · 入力 Googleが所有するNvidiaの計算資源群433k322k – 577k 2 · 入力 GoogleのTPUの計算資源群916k678k – 1.25M 3 · 導出 所有する計算資源群の合計=Googleが所有するNvidiaの計算資源群+GoogleのTPUの計算資源群1.36M1.09M – 1.71M 0 1M 2M H100e 調整係数(シェア、比率)4 · 入力 導入の遅れ=チップを所有してから稼働させるまでの遅れ1.0q0.5q – 2.0q 5 · 導出 稼働している割合=導入の遅れ1回分だけ前の所有ストック ÷ 2024年末のストック0.71×0.51× – 0.85× 0 1.5 2.5 H100換算 6 · 導出 稼働している計算資源群=所有する計算資源群の合計 × 稼働している割合960k650k – 1.29M 0 1M 2M H100e 調整係数(シェア、比率)7 · 入力 GoogleのML計算資源に占めるDeepMindの割合44%25% – 76% 0 1.5 2.5 H100換算 8 · 最終 DeepMindの計算資源(2024年末)=稼働している計算資源群 × GoogleのML計算資源に占めるDeepMindの割合420k214k – 775k 0 1M 2M H100eMeta Superintelligence Labs
Metaは世界最大級のハイパースケーラーの一つで、2025年末には世界のAI計算資源全体のおよそ10%を保有していた(独自設計のMTIAチップは含まない。MTIAは2025年には比較的少量だった)。
Metaには、基礎的なAI研究とあわせてフロンティアAIの研究開発に取り組む、Meta Superintelligence Labs(MSL)という大きなAI部門がある。15MSLは2025年より前は「Meta AI」、さらにその前は「FAIR」と呼ばれていた。ここで推定するのは、MSLが利用できる計算資源の量である。
ただし、Metaの計算資源の多くは、MSLにもフロンティアAIにも使われていない。Metaは、コンテンツや広告を推薦することで中核のソーシャルメディア事業を強化する推薦システムの学習と運用にも、AI計算資源を使っている。Metaの推薦システムは、「数千」基のGPUで学習した大規模なTransformerベースのモデルで動いている。Metaの計算資源のうち、MSLに割り当てられる分と、推薦システムなどの他の用途に割り当てられる分の割合が、2024年と2025年のどちらについても、私たちのモデルの不確実性の中心的な要因である。
MSLのAI計算資源の利用の推移は、次のようにモデル化する。
- AIチップの保有者にあるMetaの計算資源の購入量を出発点に、販売された計算資源と稼働している計算資源の間の導入の遅れの分を割り引いて、Metaが導入したAI計算資源の推移を推定する。
- 2025年については、Metaが借りた外部のクラウドの容量も推定する。これはわずか、あるいは無視できる程度だったかもしれない。
- 2024年と2025年のそれぞれについて、Metaの計算資源がMSLと中核事業の間でどう配分されたかを推定する。
MSLと中核事業の配分に関する証拠
Metaは推薦システム(RecSys)が自社の事業にとって重要であることを強く訴えている。2025年に見られた利用と売上の力強い伸びを、AIによる1日数兆件の推薦のおかげだとしており、これらのシステムが年2,000億ドル超のMetaの広告事業の収益を大きく押し上げていることがうかがえる。これは大量の計算資源の割り当てを十分に正当化するだろうが、RecSysの学習と推論実行の規模に対する収穫にも左右される。業界調査会社SemiAnalysisは、推薦システムをスケールさせる限界収益は魅力的だと考えており、MetaもTransformerによる推薦システムの大規模学習の利点について書いている。
Metaは2025年第1四半期(MSLのための採用攻勢に乗り出す前)に、2025年の設備投資の大半は生成AIではなく、推薦システム用の計算資源を含む「中核事業」に向かうと述べた。言い換えると、Metaの設備投資は、生成AI+中核事業向けAI(推薦システムなど)+AI以外の設備投資に分かれ、Metaは後の二つを合わせると設備投資全体の50%を超えると予測していた。設備投資に占めるAIの割合のより正確な内訳がない限り、これだけでは、MetaのAI計算資源のうち生成AIに向かう割合をはっきりと絞り込むことはできない。16しかし少なくとも、フロンティアAIが、推薦システムやその他の用途に向けたMetaのデータセンター投資をすべて押しのけたわけではないことは分かる。
同時に、LLMとフロンティアAIは、少なくとも2023年以降、Metaにとって明らかに大きな優先事項だった。2024年、Metaはフロンティア規模のモデルLlama 3 405Bを公開した。このモデルは16,000基のH100 GPUで学習され、学習FLOPはGPT-4のおよそ2倍で、当時知られていた中で最大級の学習実行の一つだった。Metaはまた、H100を24,000基ずつ搭載した学習クラスター2基を発表し、2024年後半には、フロンティアモデルの学習に使うとする10万基のH100 GPUのクラスターを構築した。17このクラスターだけで、当時のMetaのAI計算資源全体のかなりの割合、およそ15%を占めていた。18
2025年、MetaはフロンティアAIへと大きく舵を切り、トップクラスのAI人材を採用・引き抜く大規模な採用攻勢に乗り出した。データ企業のスタートアップScale AIのCEOを人材獲得目的で迎え入れるために150億ドルを投じたこともその一つである。MetaのCEOであるMark Zuckerbergも、Meta Superintelligence Labsに「業界トップ水準の計算資源と、研究者一人あたりで群を抜いて最大の計算資源」を用意する計画だと発表した。19
全体として、一部の業界アナリストや評論家は2025年半ばに(ポッドキャストでの何気ない発言として)、MetaのGPUの50〜60%が推薦システムに使われていると推定した。一方、SemiAnalysisの公式モデルは、2025年のMetaの計算資源の追加分のおよそ半分をMSLに割り当てている。20
2025年については、Metaの計算資源に占めるMSLの割合を、90%不確実性区間が33%〜80%、中央値が50%をわずかに超える対数正規変数としてモデル化している。残念ながらこれはかなり大まかで「感覚的」なものであり、MetaがMSLと推薦システムの両方を明らかに優先しているものの、計算資源の配分について確かな数字を公表していないという事情を反映している。
2024年については、Metaの経営陣や第三者のアナリストによる論評が少ないので、不確実性はより大きくとるべきだとも言える。しかし前述のとおり、Metaは2024年末までにLlama 4のために10万基のH100のクラスターを使っていたと公表しており、これは役に立つ。合計約50万〜80万H100eのうち、フロンティアAIの取り組みを10万H100e超に固定できるからである(以前に公表された2基の2.4万H100のクラスターが拡張されたのか、この10万基のクラスターに統合されたのかは明らかでない)。したがって、20%を超える割合である可能性は非常に高い。しかし、2025年後半にMetaがMSLへと舵を切ったことからすると、2024年のMeta AIのAI計算資源に占める割合は、広告に比べて2025年より低かった可能性がある。そこで、90%不確実性区間を25%〜80%とする対数正規分布を選んだ。これにより中央値は51%から45%へといくらか下がる。
2025年のクラウド計算資源の購入
Metaは、自ら所有する計算資源に加えて、2025年後半からGoogle、Oracle、CoreWeave、Nebiusからクラウド計算資源を購入する大型契約をいくつか結んでいる。これらの契約は、少なくとも大規模には、2025年末までにはおそらく稼働していなかったが、その時点でMetaが年換算で数十億ドル規模(1桁台)のクラウド計算資源を購入していた可能性はある(逆に、Metaは2026年から自社の計算能力の一部をクラウドで販売し始めるかもしれない)。
2025年に公に報じられた契約は、CoreWeave(2031年末までで142億ドル、年換算ペースは年23億ドル)、Google(6年間で100億ドル、年換算ペースは年16億ドル)、Oracle(報道によれば期間不明の200億ドルの契約で、公式には確認されていない)、Nebius(5年間で30億ドル、つまり年6億ドル)である。Oracleの契約も6年間だとすると、合計で年約70億〜80億ドルになる。ただし、これらの公の報道が網羅的であるとは限らない。21
CoreWeaveのCEOは、142億ドルの契約が「2026年に」稼働すると述べており、2026年第1四半期の10-Qからは、この容量が第1四半期中もまだ立ち上げ途中だったことがうかがえる。同四半期の売上20億ドルのうち、上位2社の顧客がそれぞれ45%と20%を占め、それ以外に10%を超える顧客はいなかった。上位2社はそれぞれMicrosoftとOpenAIであることがほぼ確実なので、222026年初めのMetaの支出は年換算で最大8億ドル(年換算80億ドルの売上ペースの10%)、つまりこのクラウド契約の満額の年換算ペースの最大でおよそ3分の1だったことになる。
CoreWeaveの例から外挿して、2025年末にMetaが購入したクラウド計算資源の容量がまったく稼働していなかった確率をそれなりに(25%)見込んでモデル化している。一部の容量が稼働していた場合でも、Metaの支出ペースはおそらく35億ドル未満、つまり報じられたこれらの契約の最終的な年換算ペースの半分未満だった。支出ペースの分布は、2025年の典型的なクラウド契約価格を使ってH100eに換算する(下記参照)。簡単のため、この計算資源の区分はすべてMSLに帰属させる。
モデルについて詳しくは、こちらのPythonノートブックを参照してほしい。
モデルの仕様(2025年)
| パラメータ | 分布(90%信用区間) | 根拠 |
|---|---|---|
| 所有するNvidia | 対数正規分布 1.43M – 2.38M H100e(中央値は約1.84M) | AIチップの保有者のダッシュボード。2025年末の販売ベース。単純化の仮定として、AMDの抽出とは独立とする。 |
| 所有するAMD Instinct | 対数正規分布 345k – 612k H100e(中央値は約460k) | 出典は同じ。AMDはMetaの合計の約20%。 |
| 導入の遅れの比率 | 対数正規分布 0.62 – 0.90(中央値は約0.75) | AIチップの保有者の推移に0.5〜2四半期の導入の遅れを当てはめて導いた。 |
| 稼働している計算資源に占めるMSLの割合 | 対数正規分布 0.33 – 0.80、[0.1, 0.9]で打ち切り(中央値は約0.51) | 上の要約を参照。 |
| 2025年末のMeta AIのクラウド計算資源への支出ペース | 25%の確率で0ドル。それ以外は対数正規分布 年$0.5B – $3.5B、年$5Bで打ち切り | 上の要約を参照。 |
| Meta AIのクラウド計算資源のH100e時間あたりの価格 | 対数正規分布、H100e時間あたり約$1.20〜$1.50 | SemiAnalysisの2025年8月のGPU時間価格の調査から導いた。この調査ではH100時間あたり1.30ドル、H200時間あたり1.60ドル、GB200時間あたり3.30ドル、GB300時間あたり3.96ドルで、H100e時間あたり1.30〜1.60ドルの範囲となる。Metaが支払う価格は、契約期間が長いため、これらの数字をやや下回る可能性がある(執筆時点では、InferenceXでy軸の指標に「3 year rental」を選ぶとこの値を確認できる。ただし、Metaの6年契約については価格を過大評価している可能性がある)。 |
2024年末の遡及推定
Meta Superintelligence Labs 2024年12月31日:248k H100e(90%信用区間 124k–480k)2024年末の遡及推定 · Meta AI / GenAIの範囲 H100換算 1 · 入力 Metaが所有するNvidiaの計算資源群603k448k – 804k 2 · 入力 AMD Instinctの計算資源群(全所有者)544k441k – 674k 0 400k 800k 1.2M H100e 調整係数(シェア、比率)3 · 入力 AMDの計算資源群に占めるMetaの割合40%30% – 56% 0 1.5 2.5 H100換算 4 · 導出 Metaが所有するAMD Instinctの計算資源群=AMD Instinctの計算資源群(全所有者)× AMDの計算資源群に占めるMetaの割合220k152k – 320k 5 · 導出 所有する計算資源群の合計=Metaが所有するNvidiaの計算資源群+Metaが所有するAMD Instinctの計算資源群829k658k – 1.05M 0 400k 800k 1.2M H100e 調整係数(シェア、比率)6 · 入力 導入の遅れ=チップを所有してから稼働させるまでの遅れ1.0q0.5q – 2.0q 7 · 導出 稼働している割合=導入の遅れ1回分だけ前の所有ストック ÷ 2024年末のストック0.68×0.47× – 0.84× 0 1.5 2.5 H100換算 8 · 導出 稼働している計算資源群=所有する計算資源群の合計 × 稼働している割合562k368k – 778k 0 400k 800k 1.2M H100e 調整係数(シェア、比率)9 · 入力 Meta AI(MSL以前)のフロンティアの割合45%25% – 81% 0 1.5 2.5 H100換算 10 · 最終 Meta AIのフロンティアの計算資源(2024年末)=稼働している計算資源群 × Meta AI(MSL以前)のフロンティアの割合248k124k – 480k 0 400k 800k 1.2M H100eSpaceXAI
SpaceXAIは、SpaceXに買収される前はxAIとして知られていた、大手のフロンティアAI開発企業である。
SpaceXAIは二つの供給源からAI計算資源を得ている。
- 計算資源の大部分はSpaceXが所有しており、主にテネシー州メンフィス近郊のColossus 1とColossus 2の拠点にある。
- xAIはこれまでクラウドの計算能力も一部使っており(おそらく現在も使っている)、2024年時点ではOracleがパートナーとして確認されている。
2026年に入り、SpaceXはColossusの一部をAnthropic、Google、Reflectionなどの他社に貸し出し始めた。SpaceXは2026年にCursorも買収し、CursorとSpaceXAIのチームが共同でモデルを開発している。今後は、この二つのチームの計算資源をまとめて扱い、SpaceXが所有して他社に貸し出している計算資源を差し引くことになるだろう。
Colossusの容量
Colossus 1とColossus 2の稼働中の計算能力の推移の推定は、AIデータセンターのエクスプローラーから取っている。2026年5月にSpaceXとAnthropicの計算資源の提携が始まるまでは、その100%をSpaceXAI/xAIが使っていたと仮定する。Colossus 1と2が、SpaceXAIの所有するAI計算能力の大部分を占めていることはほぼ確実である。たとえば、SpaceXの第2四半期の決算資料は、2026年3月31日時点の定格の計算能力を1.0 GWと開示しており、5月に提出されたS-1(76ページ)は、Colossus 1と2が「合わせて約1.0ギガワットの計算能力を提供している」と述べている。
AIデータセンターから取った計算資源の推定には不確かなものもあるが、Colossusの推定は比較的確度が高い。その多くが、現在は上場企業であるSpaceXの具体的な発言に基づいているからである。ただし、Colossus 1と2の各フェーズがいつ稼働したかについては、まだいくらか不確実性がある。
- 2024年に稼働していたのはColossus 1だけだった。Colossus 1の第1フェーズである10万基のHopper GPUは9月に完成・稼働し、さらに10万基のHopperからなる第2フェーズは2025年2月までに稼働したと私たちは推定している。2024年末については、この第2フェーズの一部が稼働していたとして補間する。この割合は40%から95%の間である可能性が高いとモデル化している(これらの日付の間を単純に線形補間すると、第2フェーズは約70%完成していたことになるため)。
- 2025年までにColossus 1は完成し、20万基のHopper GPUと3万基のBlackwell GPUで、約27.6万H100eが稼働していた。これらのチップ数は企業の発言によって十分に裏付けられている。一方、Colossus 2の第1フェーズである11万基のNvidia GB200は2025年10月までに稼働し、さらに11万基のBlackwell GPUからなる第2フェーズは2026年4月までに稼働したと推定している。衛星画像に基づく私たちのモデルでは、2026年1月時点でColossus 2の容量はまだ当初の11万基のGPUのままだったと推定している。23そこでここでは、2025年末のColossus 2はまだ第1フェーズだけだった可能性が高く、第2フェーズが部分的に完成していた可能性もいくらかある、とモデル化している。
外部のクラウドの容量
xAIは2024年にOracleと提携し、2万基のH100でGrok 2を学習した。xAIが2026年までこのクラスターを使い続けていた可能性は十分にある。xAIの設立は2023年にすぎず、大型のAIクラウド契約では複数年契約が一般的だからである。
SpaceXのS-1には、AIクラウド計算資源への支出の大まかな上限・下限を定めるのに使える情報もある。112ページで、次のことを開示している。
- GPUの減価償却費は、2024年に比べて2025年に16.73億ドル増えた。
- 「インフラとクラウドコンピューティングの研究開発費」は14.4億ドル増えた。
- 「インフラとクラウドコンピューティングの売上原価」は4億1,200万ドル増えた。
後の二つの区分を合わせると、「インフラ」と「クラウドコンピューティング」への支出は約18億ドルになる。ただし、この18億ドルはクラウド計算資源への支出と「インフラ」をひとまとめにしている。「インフラ」はおそらく、ネットワークや施設といったGPU以外のAIインフラの運用費と減価償却費を意味する(GPUの減価償却費は別の区分なので)。さらに、これは2025年の増加分にすぎず、2024年の基準値は確認されていない。
2024年の基準値
SpaceXは2024年の「インフラとクラウドコンピューティング」への支出を開示していないが、2024年のAI研究開発費が11.76億ドルだったことは確認している(117ページ)。なお、SpaceXの「AI」セグメントには、実際にはxAIのラボとX(以前はTwitterとして知られていたソーシャルメディア)の両方が含まれる。2024年のAIの売上原価は約17億ドルだったが、2024年のxAIの推論実行の計算資源の費用はおそらく研究開発の計算資源の費用より小さかったので、これは主にXのトラフィックを処理する費用だと考えてよい。
そしてこの11.76億ドルは、xAIの研究開発のクラウド計算資源への支出の上限である。そこには、Xの研究開発費、人件費やデータといった計算資源以外のAI研究開発費、Colossus 1の減価償却によるクラウド以外の計算資源の研究開発費も含まれるからである。Colossusは2024年に60億ドルの設備投資だったので、減価償却が9月初めに始まり、6年の償却期間(年10億ドル)だとすると、xAIは2024年にColossus 1の研究開発費としておよそ3億ドルを計上した可能性がある。
これらを除外すると、2024年のAI研究開発費11.76億ドルには推論実行のクラウド計算資源が含まれていないとはいえ、それでもその年のxAIのクラウド計算資源の請求総額よりおそらく大きい。これはGrok 2のクラスターの規模とも整合する。2万基のH100を1時間2ドルで借りると年3億5,000万ドルかかるので、2024年末のxAIのクラウド支出の年換算ペースは、おそらく3億ドルから10億ドルの範囲だった。
2025年
SpaceXAIは2025年に「インフラとクラウドコンピューティング」の費用を約18億ドル増やした。GPUの減価償却費の増加は16.73億ドルと報告されており、GPU以外の機器はAIデータセンター建設の資本コストの少なからぬ部分を占めることから、この18億ドルの大部分はおそらく「インフラ」の側(つまりGPU以外の機器の減価償却)だった(S-1は91ページで、AI関連のクラウドコンピューティングへの支出が2025年に「増加した」ことを、数字は示さずに確認している)。2024年の大まかな基準値が3億ドルから10億ドルであることを考えると、2025年の支出ペースは年10億ドルから20億ドルが妥当で、かなり厳しい上限は約30億ドルとなる。1時間2ドルとすると、これらはそれぞれおよそ5.7万H100eと11.4万H100eに相当する。
クラウド計算資源はxAIの計算資源全体のごく一部にすぎない可能性が高いことを示したので、クラウドへの支出を、年間支出とH100時間あたりの価格の厳密な推定に分解する必要はない。簡単のため、xAIのColossus以外のクラウド計算能力について、2024年は2万〜6万H100e、2025年は3万〜12万H100eという単一のH100eの分布をモデル化している。
2025年末のモデル
SpaceXAI 2025年12月31日:635k H100e(90%信用区間 587k–787k)H100換算 1 · 定数 Colossus 1の完成分+Colossus 2のクラスター1(S-1に基づく下限)554k(固定)2 · 定数 Colossus 2のクラスター2(GB300 110k基、S-1)278k(固定)0 500k 1M H100e 調整係数(シェア、比率)3 · 定数 12月31日にクラスター2の一部でも稼働していた確率33%(固定)4 · 入力 12月31日に稼働していたクラスター2の割合0.0%0.0% – 58% 0 50% 100% H100換算 5 · 導出 Colossusの稼働中の容量=Colossusの下限+Colossus 2のクラスター2 × 12月31日に稼働していたクラスター2の割合554k554k – 714k 6 · 入力 その他の拠点+クラウドの購入61k30k – 122k 7 · 最終 SpaceXAIの計算資源(2025年末)=Colossusの稼働中の容量+その他の拠点+クラウドの購入635k587k – 787k 0 500k 1M H100e2024年末のモデル
SpaceXAI 2024年12月31日:203k H100e(90%信用区間 171k–237k)H100換算 1 · 定数 Colossus 1のフェーズ1(H100 100k基、2024年9月稼働)100k(固定)2 · 定数 Colossus 1のフェーズ2(2回目のHopper 100k基)100k(固定)0 150k 250k H100e 調整係数(シェア、比率)3 · 入力 12月31日に稼働していたフェーズ2の割合67%39% – 95% 0 50% 100% H100換算 4 · 導出 Colossusの稼働中の容量=Colossus 1のフェーズ1+Colossus 1のフェーズ2 × 12月31日に稼働していたフェーズ2の割合167k139k – 195k 5 · 入力 その他の拠点+クラウドの購入34k20k – 60k 6 · 最終 SpaceXAIの計算資源(2024年末)=Colossusの稼働中の容量+その他の拠点+クラウドの購入203k171k – 237k 0 150k 250k H100e付録:2026年のフロンティア開発企業の計算資源
2026年末時点のAnthropicとOpenAIの計算資源について正式な予測はないが、いくつかの証拠は、両社の計算資源群が引き続き急速に伸びることを示している。
OpenAIのプレジデントであるGreg Brockmanは、同社が2026年に計算資源に500億ドルを支出し、これは2025年の支出のおよそ3倍になると証言した。これは2024年から2025年にかけてのOpenAIの計算資源への支出の伸びよりいくらか速い。また、チップの効率が時とともに向上するために追加の計算資源への支出の費用対効果が高まるなら、OpenAIの計算能力は2026年に3倍を超えて増えることになる。
Anthropicも2026年に計算資源を積極的に増やしている。特に、2026年5月、AnthropicはSpaceXと合意し、Colossus 1データセンター全体(22万基を超えるNvidia GPU、つまり約28万H100e)とColossus 2の一部を借りることになった。この容量に月12.5億ドル(年換算150億ドル)を支払う。さらに、インディアナ州のProject Rainier拠点は、2026年上半期に計算能力を約20万H100e増やしたと推定している。全体として、報道によれば、Anthropicは2026年第2四半期だけで計算資源に約60億ドル、つまり2025年通年の支出に近い額を支出する計画であり、計算資源への支出が非常に急速に拡大していることを示している。
SpaceXも計算資源群を急速に拡大している。Colossus 1と2にあるSpaceXの計算資源群の合計は、現在H100換算で約140万基である。前述のとおり、Colossus 1と、場合によってはColossus 2の一部は現在Anthropicが使っているので、2026年半ば時点でSpaceXの社内AIラボであるSpaceXAIが利用できる容量は、外部のクラウドの容量を除いて約110万H100eとなる。
SpaceXはまた、2026年10月から11万基のGPU(おそらくBlackwell GPUで、約28万H100e)を月9億2,000万ドルでGoogleに貸し出す契約を結んだほか、AIモデルのスタートアップReflection AIとも月1億5,000万ドルの小規模な契約を結んだ。これにより、SpaceXAIが社内で利用できる容量はさらに減るが、私たちはColossus 2が2027年初めまでに約180万H100eに拡大すると予測している。
付録:チップの販売とデータセンターへの導入の間の遅れ
チップが販売された時点(NvidiaやBroadcomなどのチップベンダーが売上を計上した時点)から、データセンターに導入されて利用可能になるまでの導入の遅れは、上記の計算資源のモデルの2か所に関わる。
- GoogleとMetaの所有する計算資源のストックの推定(両社によるNvidia、AMD、Broadcomのチップの購入の推定から得る)を、導入済みの計算能力に補正するのに使う。
- それほど重要ではないが、OpenAIのチップの計算資源群で、Nvidia GPUの世代構成がどう推移したかを推定するのにも使う。
AIチップの販売の推定は、主にNvidia、Broadcom、AMDなどの主要なチップベンダーが計上した売上に基づいている。24これらの企業はハードウェアの納入後に売上を計上するが、AIチップやサーバーが顧客(クラウド企業ではなく、サーバーのODM/OEMのような中間顧客の場合もある)に納入された後でも、その一部は保管中や輸送中、あるいはデータセンターへの設置中である可能性がある。
こうした導入の遅れについての詳しい実証的な証拠は乏しい。大まかに言えば、遅れの主な原因はサーバーの組み立てとデータセンターへの設置の二つである。
データセンターへの設置については、CoreWeaveが参考になる。同社は、ハードウェアが納入から収益化までに「約3か月の設置期間」を経ると開示している。2025年後半までに、同社はこの導入期間を「数週間以内」に短縮していた。
なお、典型的な導入の遅れは、いくつかの点で誤解を招くおそれがある。第一に、新しいチップ世代の技術的な問題や、電力供給の遅れのようなインフラのボトルネックなど、AIチップの設置を遅らせる業界全体の系統的な要因がありうる。たとえば、報道によれば、2025年初めにはラックの発熱の問題のため、クラウド企業がサーバーを受け取った後でも、NvidiaのGB200の導入の多くが数か月遅れた。このため、2025年上半期には、販売された計算資源に対する導入済みの計算資源の比率が異例に低かった。ただし、現時点でGB300やその他の現代のAIチップに同様の問題があるとは承知していない。
業界全体の導入のボトルネックが続けば、いずれ上流のチップ販売に影響が出る。したがって、Nvidiaのようなチップ企業が販売の堅調な伸びを報告していれば、業界は直近の過去に深刻な導入のボトルネックを経験しなかったと、さかのぼって判断できる。顧客が将来の供給を確保するために、設置できないチップの購入を一時的に増やすことはありうるが、それはいずれ不合理になるか、財務的に続けられなくなる。
さらに、過去のAIチップの販売に典型的な(中央値の)導入の遅れを当てはめて導入済みのストックを推定すると、導入の遅れのばらつきが無視される。チップによって導入に時間がかかるものもある。極端な例として、AIチップの3分の2が丸1年保管されたままで、残りはほぼすぐに設置される場合を考えよう。チップの販売が急速に伸びているなら、一律に1年の遅れを当てはめると、導入済みのチップの計算資源群を過小評価することになる。すぐに設置される3分の1のチップが、どの時点でも導入済みの計算資源群の中で不釣り合いに大きな割合を占めるからである。
注
-
運用上利用できるという意味での「利用」である。たとえば、開発企業がクラウド企業から一定数のAIチップを借りていても、その容量の一部がときどき遊休になることがある。実際の稼働率はモデル化していない。 ↩
-
クラウド計算資源を「借りる」という言い方はくだけた表現で、業界ではあまり使われない。業界ではクラウドの計算能力やサービスを「購入する」「販売する」と言うことのほうが多い。「借りる」と言うことで、購入者が関係するチップやデータセンターをまったく所有していないことがはっきりする。 ↩
-
これらは丸めた数値なので、0.2 GWと0.6 GWはあまり正確ではない。公表されたグラフをデジタル化して確かめたところ、棒の高さは付記された数値と実質的に等しかったので、棒の大きさはおそらく丸めた数値から作られている。 ↩
-
OpenAIは、AMDのGPUの採用(2025年後半に締結)のほか、Trainiumチップや、Broadcomによる今後の独自設計チップについても契約を結んでいるが、2025年にはいずれも大きな規模には達していないと仮定している。 ↩
-
H800やH20のような中国市場向けのチップは除く。 ↩
-
OpenAIはまた、AnthropicがOpenAIの会計基準を使っていれば、2026年初めのAnthropicの年換算売上高はおよそ4分の1、つまり総額300億ドルのうち80億ドル減っていたと推定した。OpenAIはMicrosoftでの推論実行の代金を支払っていないので、Anthropicはハイパースケーラーでの推論実行から得る粗利益だけを売上として数えるべきだ(つまり、ハイパースケーラーへの売上の分配と、クラウド計算資源のコストの支払いの両方を差し引くべきだ)という意味だったのかもしれない。そうだとすると、OpenAIは、Anthropicが計上した売上のうちハイパースケーラーのプラットフォーム経由の割合が、当時25%をいくらか上回っていたと考えていたことになる。 ↩
-
ただし、当時OpenAIがAnthropicよりかなり多くの計算資源を持っていたという点では、OpenAIの言うことがほぼ確実に正しい。たとえば、2025年のOpenAIの累計資金調達額は約50%多かった。 ↩
-
私たちのデータセンターのモデル化による、チップあたり871 Wに基づく。 ↩
-
2025年のOpenAIの計算資源は、これに相当する「Stargate」の取り組みへの集中度が比較的低かったため、OpenAIのデータセンターから推論しても、OpenAIの計算資源全体についてはあまり分からない。唯一稼働しているStargateの拠点であるOracleのStargate Abileneは、現在、インディアナ州のRainierより電力容量が小さい。 ↩
-
ある記事は、「2025年、Googleは計算能力のおよそ半分をCloudに割り当てる見込みだと、[GoogleのCFOであるAnat]Ashkenaziがこの春のMorgan Stanleyのカンファレンスで述べた」と報じている。2026年2月の決算説明会によれば、Googleは2026年も同様の比率を維持する。「そして2026年には、ML計算資源の半分をわずかに超える分がCloud事業に向かう見込みです」。この配分が、電力容量、金額、生の計算能力(FLOP/sなど)、あるいはその他の指標のどれで測られているのかは明らかでない。 ↩
-
「企業向け」とは、個人ではなく企業や法人顧客にサービスを提供することを意味する。 ↩
-
これは、GoogleのいうCloudとCloud以外の50対50の分解と食い違う。DeepMindの学習の計算資源はGoogle Cloudに含まれないはずで、個人向けの推論実行の計算資源を含めれば、DeepMindの合計は優にGoogleの全計算資源の50%を超えうるので、DeepMind以外の社内のAI計算資源の用途が入る余地がなくなるからである。 ↩
-
この区分は、DeepMindがGoogle Brainと統合された2023年にさかのぼる。2023年、Alphabetは「[Alphabet-level activities]には主に、当社の汎用AIモデルの開発費を含むAI中心の共有の研究開発活動、慈善活動などの全社的な取り組み、一部の罰金や和解金を含む一部の財務・人事・法務の費用などの全社共有の費用が含まれる」と書いた。2024年もこの文言は実質的に同じだったが、2025年には、この費用区分の完全な説明は変わらないものの、「Alphabet-level activitiesは主に、当社の共有のAI研究開発に関連する費用を反映している」とする、より短い要約が加えられた。これは、2025年までにAIの研究開発がこの区分の大部分を占めるまでに増えたことを意味する。 ↩
-
MSLには、Alexandr Wangが率いる、フロンティアLLMに注力する「TBD」という中核チームがあるが、この推定はMSL全体を対象としている。 ↩
-
Metaの設備投資がすべてAIの計算資源やデータセンターに向かい、中核事業が設備投資の大半を占めるなら、AIへの設備投資の半分超が推薦システムのような中核事業の用途に向かうことになる。しかし、最近の急速な伸びを考えると、Metaの設備投資の大半はおそらくAI関連だが、AIの割合は、設備投資に占める生成AIの割合を絞り込めるほど高いとは限らない。たとえば、Metaの設備投資の70%がAIに向かったとすると、AIの推薦システムが使うのはMetaの設備投資全体のわずか21%(中核事業の割合を51%とした場合)で、MetaのAIへの設備投資の21/70 = 30%にすぎない可能性がある。設備投資全体のうちAI向けが60%だけなら、AIの推薦システムは設備投資全体の11%にすぎない可能性もある。一方で、Metaは設備投資の大半が中核事業に向かうと述べただけなので、この割合は51%よりずっと大きい可能性もある。 ↩
-
Metaは実際には、10万基のクラスター全体を一つの学習実行に使わなかったのかもしれない。2025年にMetaが公表した最大の学習実行であるLlama 4 Behemoth(このモデルは結局公開されなかったが)は、32,000基のH100で学習された。このような大規模な学習クラスターは、推薦システムに取り組むチームとはおそらく共有されないだろうと推測するが、確かなことは分からない。 ↩
-
私たちは、Metaが2024年末にAIチップを70万H100e超所有しており、そのうち60万H100eがNvidiaのGPUだったと推定している(これは、Meta自身による2024年末のAI計算資源のストックの予測とも等しい)。 ↩
-
研究者一人あたりの計算資源についてのこの主張は、MSLの計算資源の合計を推定できるほど具体的ではない。本格的な規模の学習実行や推論実行の計算資源とは別の「研究者用の計算資源」に範囲が限られている可能性があり、またこの文脈でMetaが何人を「研究者」と数えているのかも分からない。 ↩
-
SemiAnalysisは2024年のMSLには意外なほどわずかな分しか割り当てていないが、2024年には「MSL」が正式には存在しなかったため、この割り当ての意味ははっきりしない。 ↩
-
Metaは2025年10月に、計400億ドルのクラウド計算資源の契約を結んだと開示した。これが公に報じられた契約とどれだけ重なるかは不明である。400億ドルは、公になった三つの契約の報道された総額とほぼ等しいが、Googleとの契約は2025年8月に結ばれたと報じられている(一方、CoreWeaveとOracleとの契約の報道は9月下旬で、10月の合計に含まれている可能性が高い)。全体として、2025年末にMetaは、クラウド計算資源などの約束を含む「解約不能な契約上の約束」を、2026年に300億ドル、2029〜2030年には年約200億ドルまで減っていくと報告した。これは、Google/CoreWeave/Oracleについての報道に基づく年約70億ドルの年換算ペースより大きな上限となるが、これらの約束には他の費用も含まれる。Metaは2026年4月にもCoreWeaveと別の契約を結んだ。 ↩
-
2026年第1四半期の売上の45%を占めた顧客Aは、2025年のCoreWeaveの売上の72%も占めており、MicrosoftはこれまでCoreWeaveの圧倒的な最大顧客であったことが知られている。2026年第2四半期の提出書類で、CoreWeaveは、Metaとともに、2025年に220億ドル相当の契約を結んだOpenAIを、もう一つの重要な顧客として挙げている。 ↩
-
SpaceXの開示からは、Colossus 2の各フェーズの正確な時期は特定できない。たとえば、2026年3月31日時点の容量は1.0 GWと報告しているが、2025年末の数値は報告していない。 ↩
-
Amazon TrainiumとHuaweiについては、計上された売上ではなく、それぞれ企業の開示と第三者の推定に頼っており、これらが販売されたチップ数と導入されたチップ数のどちらをよりよく表しているかは明らかでない。詳しくはAIチップの販売の方法論を参照してほしい。 ↩