
データの解説 AIチップの販売
方法論
原文:AI chip sales documentation – Methodology
概要
このデータセットは現在、Amazon(Trainium/Inferentia)、AMD、Cambricon、Huawei、Nvidia、Google(TPU)が設計・販売する主力AIチップについて、販売総数または出荷総数の推定値を追跡している。
ほとんどのチップの種類と期間について、正確な販売数は当該企業から開示されていない。ただしNvidiaは、HopperとBlackwellの販売総数について、最も情報量の多い直接の開示を行っている。私たちの数値はすべて、データと調査に基づく推定値であり、多くの場合、大きな不確実性を伴う。
以下では、チップの設計企業ごとに具体的な方法論と仮定を説明する。要点は次のとおりである。
- AMDとNvidiaについては、決算の開示情報とそこでのコメントから得た売上高のデータを出発点とする、売上高ベースのモデルを使う。この売上高を決算説明のコメントに基づいて製品ごとに割り振り、報道とアナリストの推定から平均販売価格を推定する。Nvidiaの分析コードはこちら、AMDのコードはこちらにある。
- GoogleのTPUについては、Broadcomの決算説明でのコメントと報道からGoogleのTPU支出を推定し、部品表(BOM)に基づく製造原価モデルと、BroadcomのTPUの利益率の推定を組み合わせて、チップ1基あたりの平均支払価格を推定する。TPUのコードノートブックはこちらにある。
- Amazonについては、主にAmazon自身によるTrainium2の数量の直接の開示に依拠し、大規模なTrainiumデータセンターに関する情報とアナリストの推定で補う。
- Huaweiについては、第三者のアナリストによる数量の推定を直接まとめる。
- Cambriconについては、Cambriconの2025年の年次報告書での開示(全製品ラインの生産総数と販売総数を明記している)を基準とする売上高ベースのモデルを使い、第三者のアナリストの推定と報道で裏付ける。
Nvidia
NvidiaはAIチップの最大の販売企業であり、同社はそのチップを「GPU」と呼んでいる。ここでは、2022年以降のNvidiaのAI向けGPUの出荷総数をどう推定したかを説明する。対象はNvidiaの主力AI向けGPUであり、ゲーム用GPU(一部のAIの実務者が使っている)や自動運転車向けのチップは含めない。
NvidiaのAI向けGPUの販売数は、NvidiaのAI計算資源による売上高、GPUの報道価格・推定価格の推移、そしてどの種類のチップがいつ出荷されたかについての発表とNvidiaの発言をもとに推定する。
次に、このモデルの結果を、2025年10月までにHopper GPUを400万基、Blackwell GPUを300万基出荷したというNvidiaの公開情報と比較する。
売上高ベースのモデル
このモデルのコードはこちらにある。
売上高ベースのモデルは次の手順をとる。
- NvidiaのAI計算資源(AI向けGPU・サーバー)による売上高の推移を調べる。Nvidiaはこれを四半期ごとに報告している。このデータは直近の四半期である2025年10月までをカバーしている。
- 四半期ごとに、Nvidiaのコンピュート売上高がGPUのモデル(A100、H100など)ごとにどう内訳されるかを、主にNvidiaの決算説明でのコメントに基づいて記録または推定する。
- そのうえで、GPUやその他の機器の価格に関する報道と推定を使い、出荷されたGPUの台数を推定する。
データの対象は2022年以降に限る。チップの典型的な寿命はおそらく3〜6年であり1、販売も急速に伸びてきたことを踏まえると、これで既存のNvidiaチップのストックのごく大部分を捉えられるはずである。
NvidiaのAI向けGPUの売上高
Nvidiaは、データセンター向けの製品を販売する「データセンター(Data Center)」部門の売上高を個別に開示している。データセンター部門は2024年以降、Nvidiaの総売上高の80%超を占めており、Nvidiaの主要なAIチップはすべてここに含まれる。ただしゲーム用GPUと自動運転車向けのチップ(いずれも私たちの集計の対象外)は含まれない。
Nvidiaは「データセンター」をさらにコンピュート(Compute)とネットワーキング(Networking)に分けており、近年はコンピュートがデータセンターの80〜85%を占めている。2ネットワーキングとは、チップどうしを接続するためのケーブル、スイッチ、その他の部品のことである。これはチップのクラスターを構築するうえで極めて重要だが、チップの数を推定する目的では、ネットワーキングの売上高はおおむね無視する。
細かい点として、「コンピュート」は物理的な計算機器の販売だけではない。Nvidiaは、コンピュートの売上にはハードウェア(GPU、CPU、インターコネクト)、クラウドの計算資源の売上(DGX Cloud)、AI関連のソフトウェア製品が含まれると説明している(5ページ)。3ソフトウェアとクラウドの割合はおそらくごく小さい。たとえば2024年のこれらの売上高は20億ドルで、コンピュートの売上高の総額約1,000億ドルに比べればわずかである。私たちは、コンピュートの売上高の約95〜99%がハードウェアの販売によるものと仮定する。加えて、Nvidiaのクラウド部門が使っている計算資源の大半は、Nvidiaが販売したうえで借り戻したものである。4
この売上高のデータを以下にまとめる。Nvidiaの会計年度は1月に終わり、暦年より約11か月先行している(たとえばFY25は2025年1月26日に終わった)。Nvidiaの四半期は暦の四半期と一致しないので、可視化では補間を使ってGPUの数を暦の四半期に割り振っている。
| 期間 | データセンターの売上高 | コンピュートの売上高 |
|---|---|---|
| 2023会計年度(およそ2022年2月〜2023年1月) | 150億ドル | 113億ドル |
| 2024会計年度(2023年2月〜2024年1月) | 475億ドル | 389億ドル |
| 2025会計年度(2024年2月〜2025年1月) | 1,153億ドル | 1,023億ドル |
| 2026会計年度、最初の3四半期(2025年2月〜2025年10月) | 1,314億ドル | 1,110億ドル |
Nvidiaの売上構成の推移
総売上高とチップの価格の推移が分かったら、次は四半期ごとの売上高をチップの種類に割り振る。Nvidiaはチップごとの販売の内訳を一貫して開示してはいないが、決算説明のコメントでかなり詳しい情報を示している。
NvidiaのHopper世代(H100)は2022年後半に投入され、2023年に生産が大きく拡大し、その間にA100は縮小した。次の主要な世代であるBlackwellは、2025年の前半から半ばにかけて拡大した。また、Nvidiaの中国向け仕様のチップは、輸出が合法だった期間(2022年後半〜2023年10月と、2024年2月ごろ〜2025年4月。H200も2026年に中国で販売される予定)に販売の約15%を占めた。
注記付きの簡略な年表を以下に示す。より詳しい推定と注記はこのシートにある。
注意点として、私たちはこの一覧にないデータセンター向けGPUの販売を、ゼロに切り捨てている。これが当てはまる主なGPUは、2023年初めに発売された下位グレードのL40である。L40の販売についてはほとんど情報がないが、2023〜2024年の販売の一部を占めていた可能性はある。また、H200をH100と、B100をB200と、のように一部のGPUをまとめて扱っている。
| GPU | 初出荷 | おおよその売上シェア | 注記 |
|---|---|---|---|
| A100 | 2020年6月 | 2022年後半まで主流 | Hopper以前の主力製品。2023年9月には、A100の売上高は「前四半期比で減少」しており、このアーキテクチャの「終盤」にあった。 |
| H100とH200(「Hopper」) (内訳が開示されておらず仕様も近いため、2024年のH200とまとめて扱う) | 2022年後半 | 2023〜2024年は約80%、2025年前半は約15〜20% | ChatGPT以後の時代の主力AIチップ。2022年10月までに出荷が始まり、2023年1月にはH100の売上高は「A100よりはるかに多く」なっていた。Hopperは2025年後半まで販売が続いた。4月時点でBlackwellへの移行は「ほぼ完了」し、Blackwellが約70%を占めていたが、翌四半期にはH100/H200の販売がむしろ増加した。 |
| A800 | 2022年10月 | A800とH800で2023年後半まで約20% | 中国の規制に適合させたA100の派生品。2023年10月に禁止された。 |
| H800 | 2022年後半 | 中国の規制に適合させたH100の派生品。2023年10月に禁止された。該当期間に中国はデータセンター売上の19%を占めた。 | |
| H20 | 2024年2月 | 2024年2月〜2025年4月に約13% | 中国向けに大幅に性能を落としたHopperの派生品。最終的に2025年4月に禁止された。中国は2024年の売上高の約13%を占め、H20の販売は2025年春に46億ドル、つまりコンピュート売上の約13%だった。 |
| 「Blackwell」B200 (B100とまとめて扱う) | 2024年後半 | 2025年半ばまでに過半 | Hopperの次の世代。内訳が開示されておらず、B100のシェアも小さいと見られるため、B200を性能の低いB100とまとめて扱う。B200の大半はGB200システムとして販売されている(後述のB200/B300の注記を参照)。2025年1月までの四半期のBlackwellの売上高は110億ドルで、データセンターの約33%を占めた。翌四半期には、Blackwellはデータセンターのコンピュートの「70%近く」に達した。 |
| B300(別名Blackwell Ultra) | 2025年半ば | 2025年後半までにB200に代わって過半 | B200の中間世代の改良版で、2025年7月までに販売額が「数百億ドル」に達し、おそらくBlackwellのおよそ半分を占めた。翌四半期にはBlackwellの3分の2に達した。 |
チップの価格
サーバーとチップの違いについて
Nvidiaが出荷したGPUの数を推定するには、次にコンピュートの売上高をチップ1基あたりの平均価格で割る。平均価格は、報道とアナリストによる報告・推定から集める。
前述のとおり、コンピュートの売上高には少額のソフトウェアとクラウドの売上が含まれる。もう一つ、影響が大きいかもしれない点として、NvidiaはGPUの一部を完成品のサーバーに組み込んで販売している。つまりNvidiaのコンピュートの売上高には、チップでもネットワーキングでもないサーバー部品の売上も含まれる。5このため、NvidiaがAIチップ1基あたりで得る実質的なコンピュートの売上高は大きくなる。
前提として、NvidiaのAIチップの大半は、単体のカードとしてではなくサーバーに組み込まれて導入される。学習や商用規模の推論実行にはサーバーが必要だからである。サーバーのコストの大半はGPUそのものだが、サーバーの部品がコストを上乗せする。8基のGPUを搭載したH100サーバーの部品表に基づくある推定では、ネットワーキング部品も含めたサーバー全体の販売価格は、GPU 8基分より約38%高い。後述するように、Blackwell NVL72システムも個々のBlackwell GPUに対しておおむね同程度の上乗せがある。GB200 NVL72ではGPU 1基あたりのサーバー価格がおよそ4万〜5万ドルであるのに対し、単体のB200は3万〜4万ドルである。
ただし、Nvidia全体での「サーバーの上乗せ分」は、おそらく約30%よりずっと低い。
- Nvidiaのサーバーの大半は、完全に組み立てられた状態でNvidiaから購入されてはいないようだ。2023年のある記事は、Nvidiaがパッケージ化したH100サーバーがNvidiaのデータセンター売上高の20%を占めたと推定している。つまり、GPU以外のサーバー部品はNvidiaのデータセンター売上高の10%未満だったことになる。6残りはDellやSupermicroなどの他社が組み立てたり販売したりしているのだろう。
- 第二に、こうしたサーバー部品の一部は、コンピュートではなくネットワーキングの売上高に計上されるはずである。
全体として、Nvidiaのサーバー市場の詳しい分析はここでは扱わない。サーバーの上乗せ分に関するこの不確実性を織り込めるよう、チップの価格の不確実性区間を十分に広くとっている。
A100
CNBCによれば、単体のA100は2023年に約1万ドルだった。SemiAnalysisは「1万ドル超」としている。DGX A100サーバーの発売時の希望小売価格は2020年に19万9,000ドル、つまりGPU 1基あたり2万5,000ドルだった(希望小売価格が設定されたNvidiaの主力AI製品としてはおそらく最後のもの)。ただしこれにはサーバーの上乗せ分が含まれており、大量購入の割引前の価格でもある。
A800については、Financial Timesが2023年の価格を1基あたり約1万ドルと報じている。これはおそらく単体のチップの価格である。
全体として、2022〜2023年のA100には1万〜1万5,000ドルの不確実性区間を使う。報道の下限はおおむね1万ドルであり、サーバーの上乗せ分がありうることを踏まえたものである。
H100
Hopper世代は、CEOのJensen Huang自身による開示のおかげで、平均価格について最も良い直接の証拠があると言えるかもしれない。Nvidiaは2025年10月までに(中国を除いて)Hopper GPUを400万基販売し、合計1,000億ドルの売上高を得た。これを平均するとGPU 1基あたり2万5,000ドルになる。ただし、どちらの数字もきりのよい値に見えるので、ある程度丸められていると考えられる。
その他の報道は次のとおりである。
- CNBCは2024年3月、アナリストはH100の価格を2万5,000〜4万ドルとおおむね推定していると報じた(GPUとサーバーの区別や、これが業界平均の価格かどうかは示していない)。
- Financial Timesは2024年9月、NvidiaがH100を最近値下げし、2万〜2万3,000ドルで販売しているとするSemiAnalysisの見解を引用した。
- 2023年5月、SemiAnalysisは、Nvidiaが販売するHGX H100サーバーに搭載された8基のGPUの価格を19万5,000ドル、つまりGPU 1基あたり2万4,000ドルと推定し、サーバー全体ではGPU 1基あたり約3万4,000ドルとした。2023年半ばにH100が2万4,000ドルで販売されていたことを裏付ける報道は見つからなかったので、HGXのセットを買わない顧客が実際にこの価格で入手できたのかは不明である。
- 私たちが公開の価格表示を集めた小さなデータセットでは、H100サーバーはおおむねGPU 1基あたり約3万5,000ドルで、時間とともに明確な傾向は見られなかった。
全体として、2024年と2025年のH100の価格は2万ドル台前半から半ばとする報道で、比較的意見が一致している。2023年の平均価格についてはより不確実である。この年にはH100が広く不足していたと報じられている。
H200とH100の比較
2024年、NvidiaはH100の中間世代の改良版であるH200の販売を始めた。主な違いはメモリの増強で、H100の80 GBに対して141 GBである。広帯域メモリ(HBM)のコストはおおむね1 GBあたり10〜20ドルなので、H200の製造コストはH100より約1,000ドル高い。Nvidiaが全体のGPUの粗利益率である約75%をこの追加コストに適用したとすれば、価格は約4,000ドル上がることになる。
NvidiaはH200とH100の販売の内訳を開示しなかったが、少なくとも1人のアナリストは、2024年後半からHopperの販売の過半がH200になると予測していた。したがって、H200の投入によってHopperの平均価格が(すべてH100だった場合に比べて)有意に上がった可能性がある。7
Jensen Huangの数量の開示との突き合わせ
2025年後半、Jensen Huangは、Nvidiaが中国向けの販売を除いて合計400万基のHopper GPUを総額1,000億ドルで販売したと述べた(つまりH100とH200が400万基で、H20とH800は含まない)。丸めの可能性を無視すれば、この世代の平均販売価格は約2万5,000ドルということになる。
Hopperの売上高を詳しく見ると、話はもっと複雑になる。コンピュートの売上高に、NvidiaのGPU販売に占めるHopperのシェアの推定値を掛けてHopperの売上高の総額を推定すると、ネットワーキングを除いて約1,260億ドルになる。これは丸めを考えれば「1,000億ドル」と整合する可能性はある。しかしこの値からすると、平均売上高は2万5,000ドル(総販売数は500万基になり、400万基に切り捨てられる可能性は低い)よりも約3万ドル(総販売数は約420万基)に近いと考えられる。
私たちが推定したHopperの売上高が、報告された1,000億ドルと食い違う理由は、丸め以外にもいくつか考えられる。
- 前述のとおり、NvidiaはH100サーバーやサーバー機器の販売からも売上を得ている(ただし、これはJensenの言うHopperの売上高の総額に含まれるべきだという見方もできる)。
- L40の販売:L40はH100とほぼ同時期に投入された下位グレードのデータセンター向けGPUである。私たちは単純化のためにL40のシェアをゼロに切り捨てているので、その販売分は暗黙のうちにH100の合計に含まれている。NvidiaがL40を200億ドル近く販売したとは考えにくいが、あるアナリストは2023年のL40の販売が20億〜30億ドルに達すると予測していた。
- A100とBlackwellへの割り振りが少なすぎる可能性がある。ただし、この配分についての決算説明でのコメント(こちらにまとめた)はかなり具体的である。
- ソフトウェアやその他の周辺によるコンピュートの売上高が、私たちの想定より多い可能性がある(私たちは1〜4%としてモデル化している)。
Hopper(H100/H200)の平均価格についての私たちの全体的な信用区間を以下に示す。
H100とH200は3年以上にわたって販売されたので、推定を年ごとに分ける。
| 年 | 価格の下限 | 価格の上限 | 幾何平均 | 注記 |
|---|---|---|---|---|
| 2022 | 2万7,000ドル | 3万5,000ドル | 約2万9,600ドル | いずれにせよ2022年の数量は少ない |
| 2023 | 2万7,000ドル | 3万5,000ドル | 約3万700ドル | |
| 2024 | 2万5,000ドル | 3万2,000ドル | 約2万8,200ドル | 2024年後半にはH100は2万〜2万5,000ドルだったと報じられている。H200によって押し上げられている可能性がある。サーバーの売上の可能性とCEOによる数量の開示を踏まえて上方に調整した。 |
| 2025 | 2万2,000ドル | 3万ドル | 約2万5,600ドル | 2025年にはH100サーバー全体の価格が(GPU 1基あたり)2万ドル台前半だったと報じられているが、H200はより高価である。サーバーの売上の可能性とCEOによる数量の開示を踏まえて上方に調整した。 |
H800
Reutersは、GPUを8基搭載したH800サーバーが200万元、つまり約28万ドルで販売されたと報じた。これはHGX H100サーバーを27万ドルとしたSemiAnalysisの2023年の報告と近く、GPUの価格も同程度だったと考えられる。ある記事はH800の「市中」価格を3万5,000ドルから6万9,000ドルまでの幅で伝えているが、上限のほうはほぼ確実に代表的な価格ではない。
全体として、H100に使うのと同じ2万5,000〜3万5,000ドルの範囲を使う。
H20
複数の情報源によると、1基あたりの価格はおおむね1万ドル台前半だった。Reutersは2024年2月に「カード1枚あたり」1万2,000〜1万5,000ドルで販売されたと報じ、TechPowerUpは2024年7月に1万2,000ドルと報じた。Reutersはさらに2025年2月、「アナリストの推定では、Nvidiaは2024年にH20を約100万基出荷し、同社に120億ドルを超える売上高をもたらした」と報じた。
これらの報道を踏まえ、次の価格の仮定を使う。
| 年 | 価格の下限 | 価格の上限 | 幾何平均 | 注記 |
|---|---|---|---|---|
| 2024 | 1万ドル | 1万5,000ドル | 約1万2,200ドル | 2024年の報道の大半は1万2,000〜1万5,000ドルに収まっている |
| 2025 | 1万ドル | 1万3,000ドル | 約1万1,400ドル |
Blackwell(B200とB300)
Nvidiaの次世代のBlackwellチップは2024年後半に発売され、B100、B200、B300(別名Blackwell Ultra)の3種類がある。
B200とB300はBlackwellの主力GPUで、B300は中間世代の改良版である。これらは主にGB200およびGB300システムの形で導入される。このシステムはBlackwell GPU 2基ごとにNvidia Grace CPUを1基搭載しており、最も一般的な構成は、Blackwell GPUを72基搭載したNVL72サーバーラックである。8GB200/GB300システムは、単体のB200/B300に比べてGPU 1基あたりの定格FLOP/sが10%高い。
全体として、NVL72はBlackwellの形態として圧倒的に普及しているようだ。9NVL72が主流であることを考えると、B100はおそらく少量の製品なので、B200とまとめて扱う。
B200とB300の価格はいくらか。まずB200から始め、B300がどう違うかを論じる。
(G)B200の価格を推定するには、二つの方法がありうる。(1)単体のB200 GPUの価格を調べる。(2)NVL72システムのGPU 1基あたりの価格を推定し、ネットワーキングなどGPU以外のコストの分だけ下方に調整する。
単体のB200については次のとおりである。
- Jensen Huangは2024年3月、単体のB200の価格は1基あたり3万〜4万ドルになるとも述べた。10
- 私たちは部品表の内訳に基づき、B200の製造コストを約6,400ドル[5,700〜7,300ドル]と推定した。粗利益率を75〜80%とすると、価格は2万5,000〜3万2,000ドル、製造コストの信頼区間の両端を掛け合わせれば2万2,800〜3万6,500ドルになる。11これは財務報告を使う方法より信頼性が低いと言える。B200 GPUに限った利益率が分からない場合は特にそうである。
一方、GB200 NVL72の価格はかなりよく記録されている。
- SemiAnalysisは、GB200 NVL72サーバーの価格をハイパースケーラーとネオクラウドとで異なり320万〜350万ドル、つまりGPU 1基あたり4万4,000〜4万9,000ドルと推定しており、業界平均はその間のどこかにあることになる。
- 別の情報源(HSBC)はやや低い推定を示しており、GB200のNVL72を260万ドル(GPU 1基あたり3万6,000ドル)としている。他のアナリストの推定(GB200が広く出回る前の2024年半ばのもの)は1システムあたり300万ドル、つまりGPU 1基あたり約4万1,700ドルだった。
- HSBCのアナリストは、GB200スーパーチップ(GPU 2基)の価格を6万〜7万ドル、つまりGPU 1基あたり3万〜3万5,000ドルとも推定した。
ただし、GB200の実質的な価格(出荷したGPU 1基あたりのNvidiaのコンピュート売上高)はこれより低くなる。
- NVL72にはかなりの量のネットワーキング機器が含まれるので、価格の一部はNvidiaのネットワーキング部門に計上される。Nvidiaは、ネットワーキングの売上高が急増しており、その要因の一つは「GB200およびGB300システム向けのNVLinkによるコンピュート・ファブリックの成長」だと述べている。その四半期、ネットワーキングはNvidiaのデータセンター売上高全体の18%を占めた。これが、NVL72のコストのうちNvidiaのネットワーキングに計上される割合のおおよその上限になる(Nvidiaはサーバーラックの外で使うクラスター規模のネットワーキング機器も販売している)。
- H100サーバーと同様に、GB200サーバーの一部はサーバーOEMが販売するか、ハイパースケーラーが組み立てる。その場合、Nvidia独自でない部品のコストはNvidiaに入らない。
全体として、これらのNVL72の数字はGPU 1基あたり3万5,000〜4万ドルの範囲を示している。GB200には3万3,000〜4万2,000ドルの価格範囲を使う(3万5,000〜4万ドルを、あまり原理的な根拠なく広げたものである。3万5,000〜4万ドルは狭い範囲だが、中央50%の区間としてなら妥当な選択だろう)。
GB300とGB200の比較
GB300の価格はGB200とどう違うだろうか。
- HSBCは、GB300 NVL72の販売価格を300万ドルと推定している。これはHSBC自身がGB200 NVL72について示した260万ドルより約15%高い(この比率をあまり文字どおりに受け取るべきではない。同じ機関とはいえ、手法や時期が異なる可能性があり、丸めもありうる)。
- Apple(AI計算資源をハイパースケーラー規模で購入する企業ではない)は、GB300ラック1台あたり370万〜400万ドル、つまりGPU 1基あたり5万1,000〜5万5,000ドルを支払ったと報じられている。これは、SemiAnalysisが報告したGB200 NVL72の「ネオクラウド」向け価格より10〜20%高い。
- B300はロジックダイやその他の部品の点でもB200と異なるが、コストを最も押し上げるのはおそらく、GPU 1基あたりメモリが約100GB増えたことである。HBMが1 GBあたり15ドルで、75%の利益率で価格設定されるとすれば(前述のH200の議論を参照)、GPUの価格はB200より約6,000ドル上がる。つまり、約20%の値上がりになると考えられる。
GB200の区間に10〜20%の上乗せを適用し、GB300の上乗せ率とGB200の価格の間に相関を置かない単純なモデルでは、GB300の価格範囲は3万8,000〜4万9,000ドルになる。上限は、Appleが購入したGB300 NVL72システムについての高めの報道と整合する。
Nvidiaの直接の発言との突き合わせ
NvidiaのCEOであるJensen Huangは、2025年10月までにNvidiaが合計400万基のHopper(H100とH200)と300万基のBlackwell GPUを出荷したと明かした。いずれも中国市場を除いた数字である。(中国での販売を除く):Hopper GPUが400万基、Blackwell GPUが300万基(厳密には彼はBlackwell GPUを600万基と言っているが、これは各GPUパッケージ内の2つのダイを個別に数えたものである)12
これを私たちの推定と比べるとどうだろうか。私たちのモデルでは、2025年10月までのNvidiaのGPU出荷数の全体は次のようになる。
- H100が430万基(A800とH800を除く)
- 2025年10月までにBlackwell GPUが254万基(B200が160万基、B300が94万基)
これらは完全には整合しておらず、特にBlackwellの合計は300万基より約15%少ない。Blackwellの300万基という数字は実際には600万基のBlackwellダイを2で割ったものなので、この差は丸めでは説明できない。Blackwell GPUが約250万基なら、ダイは500万基になるからである。13
Blackwellの差について、ほかに考えられる説明は次のとおりである。
- 私たちのHopperの数はやや多く、Blackwellの数は少ないので、世代間で売上高を誤って割り振っているのかもしれない。ただし、2025年のHopper/Blackwellの配分についての決算説明でのコメント(こちらにまとめた)はかなり具体的である
- 私たちはGB200とGB300の価格と仕様を使っている。しかしB200とB300のチップはやや安く、性能がやや低いB100はさらに安い。したがって、これらの派生品がBlackwellのかなりの割合を占めるなら、GPUの数は増える(同時にGPU 1基あたりの計算能力は下がる)。GB200とGB300の配分がずれている可能性もある。GB300のほうが高価だからである。
- 私たちのBlackwellの価格の推定が、全般にやや高すぎる可能性がある
結論に大きな差はないので、この差を完全に解消することは試みない。私たちは2025年10月以降も、HopperとBlackwellに限らずNvidiaのチップ出荷のモデル化を続けるつもりであり、重点はNvidiaの販売について最良の包括的なモデルを構築することにある。
概要
Googleは、テンソル処理ユニット(TPU)と呼ばれる独自のAIアクセラレータを設計している。TPUは、Google DeepMindが学習と推論実行に使うほか、Google全体のAI・機械学習の作業や、Anthropicなどの外部のクラウド顧客にも使われている。14
Googleは、大手チップ設計企業のBroadcomと提携してTPUを生産している。GoogleがTPUの高レベルのアーキテクチャを設計し、Broadcomが物理設計と供給の実務(TSMCへの製造の発注を含む)を担う。要するに、GoogleはTPUをBroadcomから購入しており、その生産はBroadcomが管理している。
GoogleはTPUの数量を開示していないが、その数量の推定に使える証拠はかなりある。私たちは次の方法論を使う。
- BroadcomのAIチップとAIハードウェアの売上高についての同社の発言と、その売上高に占めるGoogleのシェアについての報道・推定を使って、GoogleがTPUにいくら支出しているかを推定する。
- 次に、TPUの平均価格を割り出す。まず、ボトムアップのモデルでTPUの製造コスト(つまりBroadcomにとってのコスト)を推定する。次に、BroadcomのTPUの粗利益率についての報道・発言を使ってこれを調整し、GoogleがTPU 1基あたりにいくら支払っているかを推定する。
TPUへの支出総額についての情報が多いので、現時点では2024〜2025年の販売を対象にする。
多くの入力が不確実なので、モンテカルロ・シミュレーションを使い、結果を信頼区間付きで報告する。モデルの全体はこちらにある。
TPUへの支出
Broadcomは四半期ごとにAI半導体の売上高を報告しているが、これには独自設計のAIアクセラレータ(いわゆるXPU。TPUを含む)とネットワーキング製品の両方が含まれる。ただしBroadcomの経営陣は決算説明会で、XPUがAI半導体の売上高のおよそ65〜70%を占めると述べており、これによってXPUの売上高を切り分けられる。たとえば、Broadcomの2024会計年度のAI半導体の売上高は122億ドルで、XPUの売上高は80億〜85億ドルということになる。
Broadcomの会計四半期は暦より約2か月先行していることに注意してほしい。たとえば同社の2025年第4四半期は11月2日に終わった。結果を四半期ごとに可視化する際は、補間を使ってTPUの数を暦の四半期に割り振っている。
次のステップは、そのXPUの売上高に占めるGoogleのシェアの推定である。
2024年、BroadcomのXPUの主な顧客はGoogleとMetaの2社だった。Metaは2024年にBroadcomに約9億8,700万ドルを支出したと報告している。15XPUの売上高の総額から開示された顧客の支出を差し引くと、2024年のGoogleのBroadcomへのTPU関連の支出はおよそ70億〜75億ドルだったことになる。
2025年、BroadcomのAI半導体の売上高はほぼちょうど200億ドルだった。同社は2025年第3四半期にXPUがAI半導体の65%を占めたと述べており、これは2024年と同程度なので、通年のシェアもおそらく同程度で、XPUの売上高は約130億ドルになる。
GoogleのTPU/XPUへの支出は、いくつかの方法で推定できる。
- Googleの設備投資は2024年の520億ドルから2025年には910億〜930億ドルに増え、およそ75%増加した。Googleの設備投資とその増加は主にAIへの支出によるものだが、AI向けの設備投資を一貫して切り分けて開示してはいない。GoogleのBroadcomへの支出が2024年の約70億〜75億ドルから同じ割合で増えたとすれば、TPU関連の支出は120億〜130億ドルになる。16
- 2025年にGoogleがBroadcomのXPUの売上高の約90%を占めたとする推定を当てはめると、支出はおよそ120億ドルになる。HSBCは、2026年にはGoogleがBroadcomのASICの売上高の78%を占めると推定した。Broadcomは2026年に他の設計企業とのXPUの案件を拡大する予定なので、2025年にはBroadcomのASICの売上高に占めるTPUのシェアが85%以上だった可能性がある。
- 他のアナリストの推定と照らし合わせる。これらは、GoogleによるBroadcomのXPUの売上高を110億〜130億ドルとモデル化している。
TPUの価格のモデル化
前のステップで、GoogleがBroadcomを通じてTPUにいくら支出したかの推定が得られた。この支出をTPUの生産数量に換算するために、推定した売上高をチップ1基あたりの価格で割る。これには二つのステップがある。
- 部品表モデルを使って、TPUの世代ごとにBroadcomにとっての製造コストを推定する
- Broadcomの利益率についての報道を踏まえ、Googleが支払う価格を推定する
部品表に基づくコストモデル
TPUの製造コストは四つの要素に分けられる。
- ロジックダイのコストは、各プロセスノードについて公開で報じられたウェハー価格と、業界アナリストによるダイサイズの推定から求め、ダイサイズとプロセスノードによって変わる歩留まりの仮定で調整する。
- HBMのコストは、世代ごとのメモリ価格に関する報道とメモリ容量に基づく。
- 先端パッケージングのコストはTSMCのCoWoSプロセスの費用で、同社の先端パッケージングの売上高の開示と、生産能力の割り当てに関する報道から推定する。
- 補助部品のコストには、電力供給のハードウェア、プリント基板(PCB)、モジュール単位の組み立てと検査が含まれる。
私たちの推定は、ウェハー価格、世代ごとのメモリコスト、TSMCの生産能力と売上高の開示から導いたパッケージングのコストなど、公開されている情報に基づいている。新しいチップほど先進的なプロセス、大きなダイ、多くのメモリを使うので、推定値はTPUの世代によって異なる。
Broadcomの利益率
BroadcomのTPUの粗利益率はおそらく60%前後で、ありうる範囲は50〜65%である。
- 2024年第1四半期、CEOのHock Tanは、カスタムチップ事業は「当社全体の粗利益率と同程度の利益率を確保できる」と述べた。当時の全体の粗利益率は約75%だった。
- 2023会計年度については、Google-Broadcomの提携の初期には利益率が高かったことを反映して、利益率を55〜70%と推定する。
- 2025年の決算説明会で、Broadcomは一貫して、XPUの利益率は事業全体(70%台半ばから後半)より低いと述べ、半導体部門全体(60%台半ばから後半)よりも低いことも示唆した。17
- アナリストの一社であるUBSは、XPUの利益率を55%と推定した。
- 2026年第1四半期の決算説明会で、Hock Tanは、AI向けXPUの利益率が45〜50%で推移しているという見方にはっきりと反論し、歩留まりとコストが改善した結果、「AIでのモデルは、半導体事業のほかの部分のモデルとかなり一致するようになる」と述べた。ここから、粗利益率は60〜65%前後と考えられる(その四半期のBroadcomの半導体全体の利益率は68%だった)。
利益率が60%なら、Broadcomにとって製造コストが1,000ドルのチップは、1,000ドル / (1 - 60%) = 2,500ドルで販売されることになる。
結果のまとめ
| TPUのバージョン18 | 製造コスト | Googleへの価格 | Googleへの価格の中央値 |
|---|---|---|---|
| v4i | 700〜1,100ドル | 1,700〜3,200ドル | 2,300ドル |
| v4 | 1,100〜1,500ドル | 2,700〜4,500ドル | 3,400ドル |
| v5e | 950〜1,400ドル | 2,000〜3,500ドル | 2,700ドル |
| v5p | 2,300〜2,900ドル | 5,000〜7,600ドル | 6,000ドル |
| v6e | 1,600〜1,900ドル | 3,400〜5,000ドル | 4,100ドル |
| v7 | 4,600〜5,500ドル | 9,800〜1万4,700ドル | 1万2,000ドル |
私たちのコストの推定はTPUのモジュールだけを対象とし、ネットワーキングを除いている。ネットワーキングはシステム全体で見ると無視できないコストだが、BroadcomはこれをXPUの売上高とは別に計上している。そこで、売上高のデータとコストモデルの整合性を保つために、ネットワーキングを除いている。
私たちの推定は、外部の報道とおおむね一致している。ある半導体調査会社は、v5eを3,000ドル、v5pを6,000ドル、v6eを4,000ドルと推定しており、いずれも私たちの中央値の推定とよく一致する。ただし同じ情報源はv7(旧称v6p)を8,000ドルと推定しており、私たちの中央値1万2,000ドルを大きく下回る。v7をより高く見積もる報道もある。あるアナリストは1万3,000ドルと推定し、The Informationは1万2,000ドルと報じた。後者の推定は私たちの推定とよく一致する。
生産構成
TPUの売上高の総額を世代別のチップ数に換算するために、TPUのバージョンごとの四半期の生産構成の推移を推定する。TPUの世代によってコストが大きく異なるので、生産構成は重要である。推論実行に最適化したチップは、メモリを多く積んだ学習向けのチップより安く、新しい世代は先進的なプロセスノードとパッケージングのために古い世代より高価である。四半期ごとの生産構成は、TPUのバージョンにわたる確率分布としてモデル化し、シェアの合計が100%になるよう正規化する。
生産構成の推定は、専門家との議論と業界の報道に基づいている。モデル化の方法には、いくつかの重要な知見が反映されている。
第一に、私たちの理解では、TPUの生産の立ち上がりは、たとえばNvidiaやAMDのGPUの立ち上がりよりずっと短い。GPUの生産は通常、世代間の重なりが大きい、複数の四半期にわたる段階的な移行を伴う。これに対してTPUの生産は「一度に一つのチップ」というパターンをとる傾向がある。生産はある世代から次の世代へ比較的すばやく切り替わり、重なりはごくわずかである。たとえば2024年第4四半期にv5eの生産が終わってv6eが始まったとき、両者を並行して生産する期間が長く続くことはなかった。生産ラインが一方のチップから他方へ切り替わったのである。
上の点について補足すると、推論実行に最適化したチップ(v4i、v4、v5e、v6e)と学習向けのチップ(v5p、v7)は並行して生産される傾向がある。二つの分類それぞれの中では、複数の世代を並行して生産するのではなく、ある世代から次の世代へと生産が移る。
次に、TPUのモデルは、Googleが「プレビュー」を発表する前後に生産が立ち上がり、Googleが「一般提供(GA)」を発表する時点ではすでに本格生産に入っている。SemiAnalysisは、「Googleは、次の世代が導入されてからではなく、生産が立ち上がる時点でTPUを発表するようになった」と指摘した。つまり、生産はしばしば公開プレビューの発表の前後に始まり、一般提供に向けてすばやく拡大する。たとえばTPUv5eでは、2023年8月のGCPでのプレビュー発表の数か月前から、まとまった量の生産が始まっていた。
各TPUが一般提供に至った時期をまとめた表と図を以下に示す。パラメータの全体は私たちのモデルにある。
| TPUのモデル | プレビュー提供日19 | 説明 | 生産構成についての注記 |
|---|---|---|---|
| v4i | 2020年第1四半期 | 推論実行専用のチップ | v4に移行する前の2022年第4四半期の生産に、小さなシェアで含まれる。 |
| v4 | 2022年5月 | 効率的で拡張性の高いチップ。 | FY23の第1〜第2四半期に主に生産され、v5eの立ち上がりに伴いFY23の第3四半期に急減する。FY23の第3四半期までに生産が終わる。 |
| v5e | 2023年8月 | 小型でコストを最適化した推論実行用のチップ。 | Google Cloudでのv5eのプレビュー日より早く生産が始まり、FY23の第2四半期からまとまった量が生産される。生産ラインがv4からv5eへすばやく切り替わるため、FY23の第3〜第4四半期には主流になる。FY24の第4四半期にv6eが立ち上がるのに伴い生産が終わる |
| v5p | 2023年12月 | 学習向けのチップ。 | FY24の第1四半期からv5eと並行して立ち上がる。v5pは高性能な学習向けのチップで、v6eよりメモリがかなり多いので、v6eが本格生産に達した後も、一部のワークロードにはv5pのほうが適している可能性がある。v5pの生産はFY25を通じて比較的一定の水準で続き、その後v7に移行すると仮定する。 |
| v6e | 2024年10月 | コストを最適化した次世代チップ | 2024年後半に試験的な量で現れる。v6eは2024年第4四半期から本格的な量で生産され、2025年も生産が続くとモデル化する。生産ラインが一方から他方へ切り替わるので、v5eの生産との重なりはごくわずかである。 |
| v7 | 2025年11月 | 高性能な次世代チップ | 2025年後半に生産に入る。2025年第3四半期には少数ながら無視できないシェアを占め、大規模な立ち上がりは2026年にずれ込む。 |
数量の推定
チップの数量は、四半期ごとのTPUの売上高を、チップ1基あたりの加重平均価格で割って算出する。この計算はモンテカルロ・シミュレーションで行い、売上高の推定、生産構成のシェア、製造コスト、利益率など、すべての入力パラメータの不確実性を結果に伝播させる。結果は中央値と90%信頼区間で報告する。
限界
この分析は代理指標からの間接的な推定に頼っているため、いくつかの点で不確実性が生じる。
- 顧客間の配分:BroadcomのXPUの売上高は複数の顧客に分かれており、顧客間の正確な配分は開示されていない。私たちの推定は限られたデータ点に頼っており、競争の状況を十分に表していない可能性がある。
- 契約ごとの価格:部品の価格は個別に交渉され、数量や顧客との関係によって大きく異なることがある。Googleが支払う価格は、私たちがコストモデルに使っている二次情報源の報じる価格と異なる可能性がある。
- 生産と導入の違い:私たちの推定はBroadcomが製造したチップを反映しており、Googleのデータセンターに導入されて稼働しているチップではない。生産から導入までには、私たちのモデルでは捉えられない時間差があるかもしれない。
- TPUのバージョン構成の不確実性:TPUのバージョンごとの生産構成について、Googleや報道からの情報はほとんどない。TPUのバージョン間の生産の配分の推定は、TPUの専門家やアナリストとの会話に大きく依存している。実際の構成は大きく異なる可能性があり、世代によって価格が大きく違うので、数量の推定に影響する。推定の方向性には自信があるが、個々の推定値の不確実性は大きい。
まとめ
このモデルは、Broadcomが公開しているAI半導体の売上高と、TPUの世代ごとのボトムアップのコスト推定を組み合わせて、GoogleのTPUの生産数量を推定する。Broadcomの報告する総額から独自設計のアクセラレータの売上高を切り分け、Googleのシェアを推定し、チップ1基あたりの製造コストをモデル化し、製品の年表と業界の報道から四半期ごとの生産構成を推測する。推定した支出を加重平均価格で割ると、チップの生産数量が得られる。
不確実性の源はいくつかあり、Broadcomの売上高の顧客間の配分、契約ごとの価格、TPUの世代間の生産構成などが含まれる。結果は、モンテカルロ・シミュレーションによる中央値と、これらの不確実性を反映した信頼区間で報告する。
Amazon
Amazonは近年、独自のAIチップであるTrainiumとInferentiaの導入を拡大してきた。Trainium2は2024年後半に投入され、最新のTrainium3は2025年12月に一般提供が始まった。この拡大は主に、同社の最大の計算資源の顧客であるAnthropicのためのものである。証拠が限られており、2024年より前の数量は少ないと考えられるので、2024〜2025年の数量だけをモデル化している。
要点は次のとおりである。
- Trainium2の累計ストックについての主な証拠は、2025年末から2026年初めまでに140万基のTrainium2が導入されたというAmazonによる直接の開示である。これは、Amazon/AnthropicのProject Rainierのデータセンターから得られる証拠とはやや食い違う。こちらはアナリストの分析に基づく仮定を使うと、約130万〜270万基の範囲を示す。
- Amazonの古いAIチップと新しいAIチップについては、不確実性がずっと大きい。Trainium3は、発売後の短い期間にかなりの数量に達した可能性がある。Trainium1とInferentiaは、Trainiumの計算能力のストック全体のうち、おそらく小さな割合しか占めない。
- Trainiumの売上高の四半期ごとの内訳がないので、アナリストのコメントに基づいて累計を時期ごとに割り振っており、ある程度の不確実性がある。
Trainium2の累計ストック
Amazonの開示
Amazonは2026年2月5日の2025年第4四半期の決算で、「Trainium2はすべて契約済みで、140万基のチップが配備されている(landed)」と述べた。これは非常に情報量の多い開示だが、ある程度の解釈を要する。
- 「140万基」は下限である。決算説明会では「140万基超」と述べている。ただし1.4という数字はかなり具体的なので、合計が150万基以上ということはないと考えられる。
- 「配備されている(landed)」は「稼働している」とも単に「納入された」とも取れる。NvidiaやAMD、Broadcomからの推定との一貫性を保つため、私たちは原則として納入されたチップを数えるようにしている。Trainium2がすべて契約済み(顧客に使われている)と強調していることからすると、「稼働している」の意味だと考えられる。
- 時点:この開示は四半期の財務情報の節の外に記載されていたので、2025年12月31日の四半期末時点ではなく、2月5日時点の最新の情報を反映しているようだ。
時間のずれの問題が二つあり、向きが逆である。導入済みのチップと納入済みのチップの違いと、決算発表が年末から約35日後だったことである。これを踏まえても、140万基は依然として2025年末時点のTrainium2のストックの最良の中心推定値と思われるが、(たとえば)10%の誤差幅を加えることになるかもしれない。
Project Rainierからの証拠
以下では、Trainiumのデータセンターからの証拠に基づく方法論の概略を示す。現在はTrainiumの数量について主にAmazonの開示に従っているが、2026年1月初めに最初に公開したTrainiumの推定には、以下の証拠を使っていた(透明性のために記すと、当初の点推定ではTrainium2の合計は250万基で、Amazonが確認した140万基のおよそ1.8倍だった)。
私たちのフロンティアAIデータセンターのデータセットは、AmazonとAnthropicの大規模なデータセンター2か所を追跡している。どちらも両社の大きな「Project Rainier」の一部で、インディアナ州New Carlisle20と、ミシシッピ州Madisonにある。どちらのデータセンターも、おそらく主に、あるいはもっぱらTrainium2を使っているが、公式に確認されているのはNew Carlisleだけである。衛星データの分析とAmazonの発言を組み合わせると、2025年末には2か所のProject Rainierの拠点で約100万基のTrainium2が稼働しており、2025年半ばの約75万基から増えたと推定される。
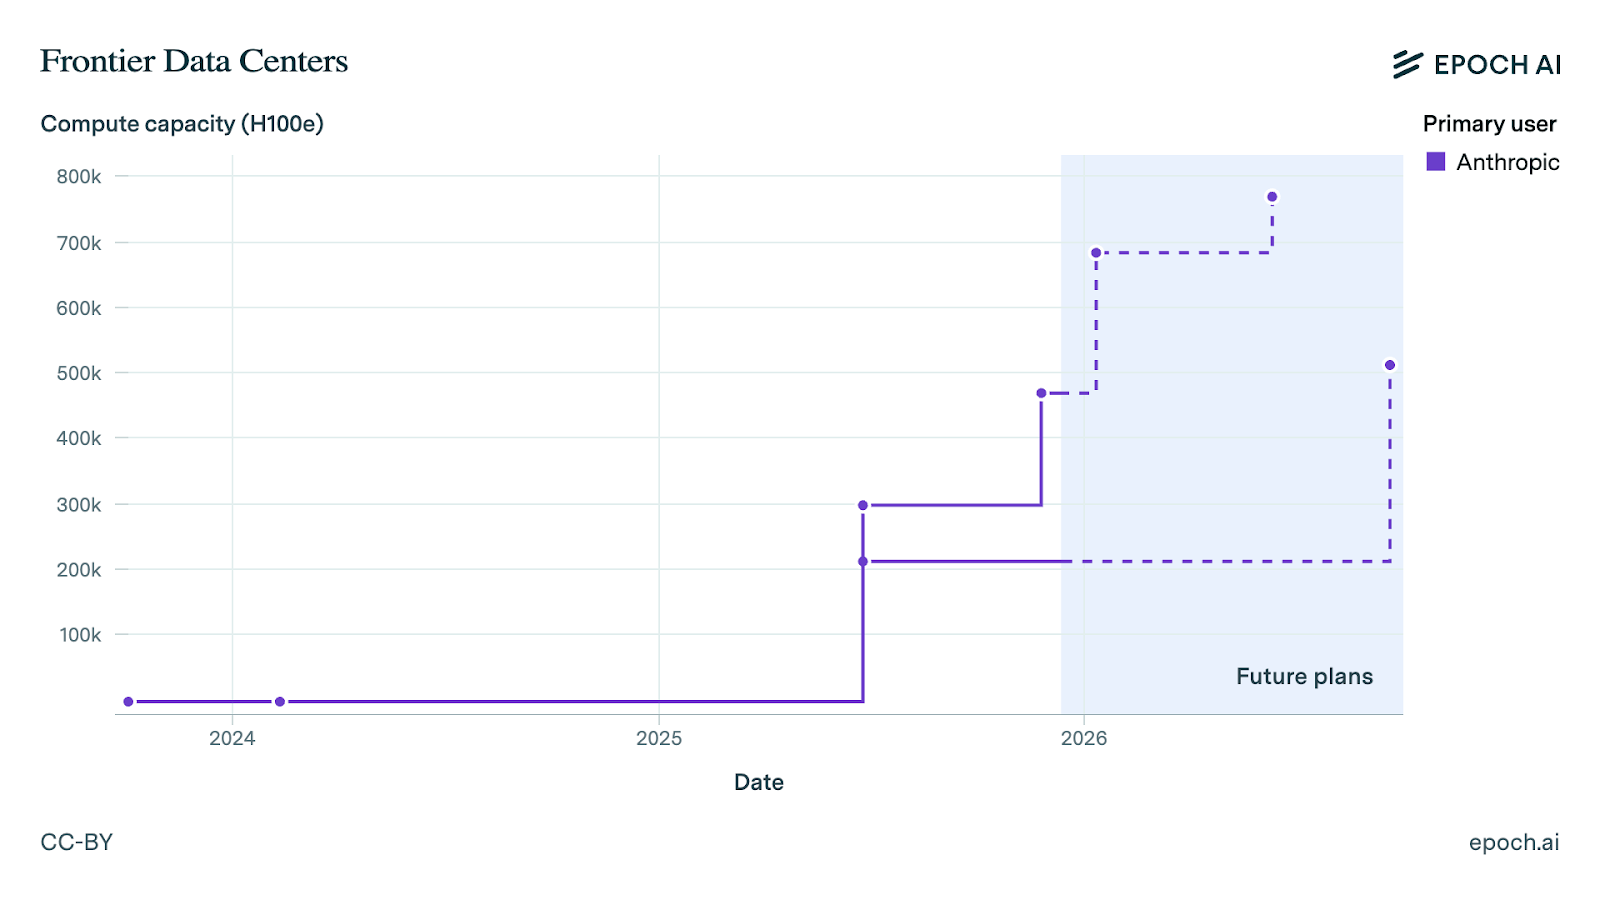
(Trainium2の総数量の開示とは独立した)いくつかの証拠が、RainierがTrainium2全体の大きな部分を占めることを裏付けている。
- Amazonは、2025年第3四半期にTrainium2の売上高(Trainium2の貸し出しによるクラウドの売上高)が「前四半期比で150%増加した」と示した。これはRainierが年半ばに稼働を始めた時期と重なっており、Rainierがクラウドの保有台数の大半を占めると考えられる。
- SemiAnalysisは、AnthropicがTrainium2の唯一の大口の外部利用者であり、BedrockやAlexaなどのサービスのための「Amazon社内の需要よりかなり大きい」と報じている。
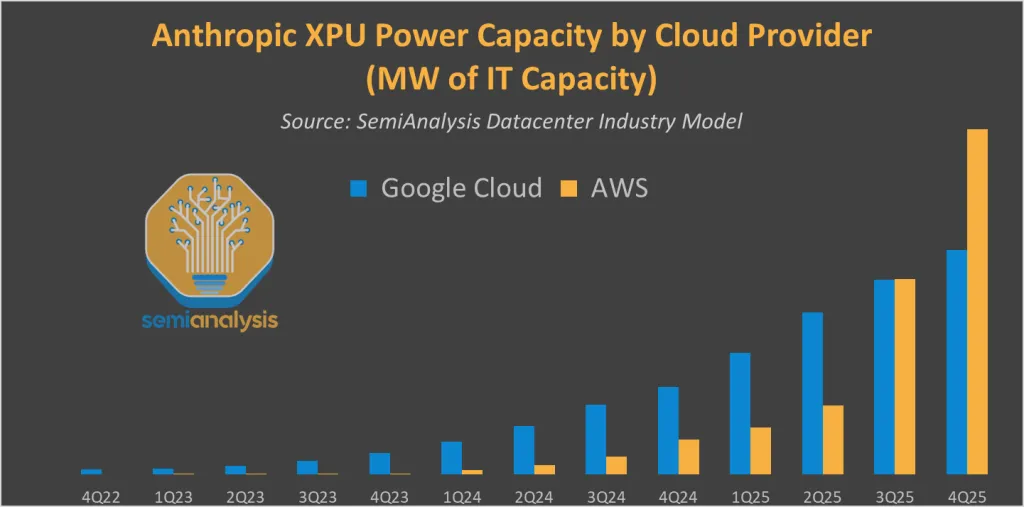
Trainium2に占めるRainierのシェアの上限はどうか。SemiAnalysisの推定では、この2か所のキャンパスの大半ができる前の第1四半期のAnthropicのTrainiumの能力は、2025年第4四半期の能力のおよそ15%だった。これはTrainium1とTrainium2が混在していた可能性もあるが、AnthropicがTrainium2より古いAmazonのチップを使っているという報道は、私たちの知る限りない。
推定の参考にするため、Project RainierとTrainiumのウェハー割り当てからの証拠に基づくパラメータを持つ、二つの定量的なモデルを作成した。どちらのモデルも、Amazonが開示したTrainiumの数量の情報を十分に取り込んでいないので、あらゆる点を考慮した私たちの見解を表すものではないが、上に挙げたほかの証拠が何を意味するかを示している。
| パラメータ | 2025年末の中心推定値 | 90%不確実性区間 | 注記 |
|---|---|---|---|
| New CarlisleのTrainium2 | Trainium2が約71.4万基 | 50万〜100万基 | 12月下旬のTrn2を71.4万基と推定している。Amazonは10月までに「50万基近く」を確認し、年末までに100万基を計画していた。 |
| MadisonのTrainium2 | Trainium2が約32万基 | 約19万〜約54万基 | 私たちのデータセンターの推定は、一般に上下それぞれ1.5倍の80%信頼区間、つまり[約21.3万〜48万基]をとる。これをzスコアを使って90%信頼区間に換算した。(New Carlisleの区間は、Amazonの発言があるためこれより狭い。) |
| AnthropicのTrainium2に占めるRainierのシェア | – | 70〜85% | SemiAnalysisによれば、AnthropicのTrainium2のストックの15%はRainierより前からある |
| Trainium2全体に占めるAnthropicのシェア | – | 60〜90% | 大まかな推測:Rainierはクラウドに導入されたTrainiumの過半(おそらく60%超)を占め、AnthropicはおそらくTrainium全体の主要な利用者である |
| モデルが出力したTrainium2のストック総数 | Trainium2が190万基 | Trainium2が130万〜270万基 | Rainierの規模と、Rainier/Anthropicのシェアの推定に基づくTrainium2の合計。Guesstimateで実装した |
Trainium3
Trainium3は2025年12月に一般提供が始まり、Amazonは2月初めに、Trainium3は「すでに本番のワークロードを処理しており、強い需要がある」と述べたが、数量は明らかにしなかった。
情報は限られているが、最も役に立つ公開の手がかりは、TSMCが2025年に約18万基のTrainium3チップを生産するとしたMorgan Stanleyの予測かもしれない(Trainium2は110万基とされ、これは累計140万基とかなり整合する)。ただしこの推定は2025年2月のものなので、かなり不確実である。加えて、これらの数字はTSMCのCoWoS(チップ生産の最終段階の一つ)向けのウェハー割り当てに基づいており、CoWoSはチップの出荷・納入より前に行われる。
2026年2月の執筆時点では、Trainium3の数量のモデルは省いている。そのため、Trainiumのストック総数を過小に推定するおそれがある。
Amazonの古いAIチップ(Trainium1とInferentia)
Trainium2より前のAmazonのAIチップについても、証拠は比較的限られている。
SemiAnalysisのグラフは、2024年のTrainium1とInferentiaの生産をまとめて示しており、その合計は2024〜2025年のTrainium2の合計のおよそ14%である(オレンジの棒の累計と青の棒の累計の比較)。2026年2月時点で導入済みのTrainium2が140万基だったとすれば(これは2月までのTrainium2の生産数を過小に見積もっており、程度は小さいがおそらく2025年までの生産数も過小に見積もっている)、2024年に生産されたチップは合計で約20万基ということになる。
加えて、Omdiaは、Amazonが2024年にTrainiumとInferentiaのチップを合計130万基導入したと推定した。2024年のTrainium2の数量はおそらく数十万基の低いほうだったので(SemiAnalysisの報道と、総数量が140万基で2025年に立ち上がったと考えられることから)、2024年のTrainium1とInferentiaはおよそ100万基ということになる。ただし、Omdiaがこれをどう内訳したかは分からない。ほかの報道が示唆するよりずっと多いTrainium2の数量を推定していた可能性もある。
Trainium1とInferentia2の性能は、カタログ上はTrainium2の約30%にすぎない。100万基という多めの数を採っても、2024〜2025年に140万基のTrainium2が導入されたことを踏まえると、これらの古いチップはAmazonの独自AIチップの計算能力換算の合計の約20%を占めるにとどまる。したがって、この不確実性の影響はあまり大きくない。
Amazonのチップの時期ごとの割り振り
Trainiumの累計ストックの推定が得られたとして、それらはどのような時期に出荷されたのだろうか。
私たちのデータセンターのモデルにいくつか手がかりがある。Project Rainierは2025年半ばまでに大規模に立ち上がりつつあった。New CarlisleとCantonは2025年半ばの時点ですでに合わせて75万基のTrainium2に達していたと推定される。これは、Amazonが開示した2024〜2025年の累計140万基の半分強であり、データセンターに基づくモデルの中央値の推定の3分の1超である。これらの推定は不確実だが、Trainium2の出荷が2025年後半に偏りすぎてはいなかったことを示唆している。
SemiAnalysisは、Trainiumのパッケージ生産の相対的な伸びの推移も推定しており、参考になる。それによれば、2025年のTrainium2の総生産は2024年の約4倍で、2024年のTrn2の生産は2025年の約25%、累計の約20%ということになる。ただし、パッケージの生産からサーバーの出荷までには時間差があるとSemiAnalysisは注記している。21


同じグラフは、2024年と2025年の各四半期について、Trainium1とTrainium2の生産の相対的な伸びも示している。Trainium1は2024年半ばにピークを迎えて縮小し、Trainium2は2024年に立ち上がり、2025年にはより緩やかに伸びた(前半が2025年の合計の40〜45%を占めた)。
これらの四半期ごとの推定を文字どおりに受け取りすぎないように、またパッケージの数量のばらつきは実際の納入では均される可能性があるので、これを四半期あたり11〜22%の一定の成長率としてモデル化することもできる(2025年の数量に占める前半のシェア40〜45%に対応する)
全体として、AmazonのAIチップの納入の(大まかな)推移は次のようになる
- 2024年:
- Trainium1/Inferentiaが20万〜100万基
- Trainium2が約30万基(それまでの合計の約20%)
- 2025年前半:Trainium2が約45万基
- 2025年後半:Trainium2が約65万基
チップ1基あたりのコスト
Trainiumのコストについての報道やアナリストの分析は限られているが、SemiAnalysisはAmazonにとってのTrainium2の単価をチップ1基あたり約4,000ドルと推定している。
これは、Nvidia H100(1基2万ドル超)のような競合製品よりずっと安い。Trainium2はH100の約66%のFLOP/sの仕様を持ち、メモリ量も同程度であるにもかかわらずである。それでも、この数字は妥当と考えられる。Amazonはチップ設計企業のAnnapurna Labsを買収しており、独自チップの取り組みが強く垂直統合されているからである。Trainium2より複雑で、メモリも2倍多いNvidia B200でさえ、製造コストはおそらく約6,000ドルにすぎない。
Amazonは今も外部のチップ設計企業であるMarvellやAlchipと提携しているが、これらの設計パートナーにとってこの提携は、たとえばGoogleのTPUがBroadcomにもたらす利益よりずっと少ないと報じられている。22
Huawei
HuaweiのAscend 910シリーズのチップは、中国国内で設計された中国の主要なAIアクセラレータであり、近年は910Bと910Cが主なモデルである。HuaweiのAscendの数量は他のアナリストがかなり詳しく扱っているので、私たちは主にこうした外部の研究を要約し、まとめている。それ以前の年についての分析は少なく、またHuaweiのAscendの大部分はおそらく製造から2年未満なので、2024年と2025年を対象にする。
2024年の生産
Ascend 910Bについては、アナリストの見方は40万〜45万基でおおむね一致している。36krは約40万基の出荷を報じ、SemiAnalysisとBernsteinはどちらも45万基とした。Financial Timesはわずか20万基とし、際立った外れ値だった。新しい910Cについては、推定を示したのはSemiAnalysisだけで、限られた初期生産で約5万基としている。
2024年の合計:910Bが約40万基、910Cが約5万基
2025年の生産
2025年については、特に910Bと910Cの構成について推定がより大きく分かれる。SemiAnalysisは910Bを15万2,000基、910Cを65万3,000基と予測しており、新しいチップへの大きな移行を見込んでいる。Bernsteinは、それぞれ35万基とより均等な配分を見込んでいる。Bloombergは、2025年の910Cを約30万基とし、2026年にはそれを倍増させる計画があると報じた。
米商務省ははるかに低い数字を示しており、Ascendの合計をわずか20万基としている。この数字は他の推定と食い違っており、中国国内のサプライチェーンだけで生産されたチップに範囲を限ったものかもしれない。関連する輸出規制が最近強化されるまで、HuaweiはAscendのロジックダイをTSMCからの輸入で調達しており、HBMも輸入していた。
910Cの推定については、SemiAnalysisの約60万基という高めの数字のほうをより信頼している。SemiAnalysisの推定ははるかに詳しく(他のアナリストの推定は報道で数字が伝えられているだけである)、SemiAnalysisは半導体について比較的高い専門性を持つからである。
2025年の合計(最良の推定):910Bが約20万基、910Cが約60万基
HuaweiのAscendの計算能力換算の合計の推定
これらのAscendの数量の推定を踏まえると、Ascendのストックの計算能力の合計はどれくらいか。難しいのは、910Bと910Cのどちらにも、公表された仕様が複数あることである。910Bは16ビットで320 TFLOP/sとよく言われるが、派生モデルの仕様は280〜400 TFLOP/sにわたる。同様に、910Cは800 TFLOP/s(丸めた値の可能性がある)とされることが最も多いが、SemiAnalysisは780 TFLOP/sとしている。
この不確実性を扱うため、モンテカルロ・モデルを使い、910Bには280〜400 TFLOP/s、910Cには780〜800 TFLOP/sの範囲を使う。加えて、このデータセットの目的上、8ビット(またはそれ以上)の数値形式での最大のOP/sの定格値を使う。910BのINT8の仕様は2倍高く、560〜800 TOP/sである。910CのINT8の仕様は公表されていないが、910CのINT8の最大性能はFP-16の定格値の約2倍の約1500〜1600 TOP/sと仮定する。
上記の調査に基づき、台数にも不確実性区間を適用する。
このモデルでは、2024年はH100換算で18万基(90%信用区間:13万〜24万基)で、そのうち14万基が910B、4万基が910Cによる。2025年はH100換算で53万基(45万〜62万基)で、910Bが7万基、910Cが46万基である。
Cambricon
Cambricon Technologiesは北京を拠点とするAIチップ設計企業で、中国国内に上場している数少ないAIアクセラレータ企業の一つである。2016年に中国科学院からのスピンアウトとして設立され、2020年に上海の市場に上場した。同社の製品は主に中国国内市場でHuawei Ascendと競合しているが、Cambriconのその市場でのシェアはずっと小さい。Cambriconはチップを設計するが製造はしない。生産は中国の主要な国内ファウンドリであるSMICが担っている。
Cambriconは2024〜2025年に爆発的な成長を遂げた。その要因は、先端チップの入手を制限する米国の輸出規制と、国産の代替品や追加の計算資源を求める中国の大手AI企業の需要の急増が重なったことである。
ここではCambriconのSiyuan 590を取り上げる。2024年以降、CambriconのAIチップの売上高のほぼすべてをこのチップが占めており、次世代チップのSiyuan 690は2026年後半まで大規模な量産に入らないと見込まれているからである。Cambriconのそれ以前のチップ(Siyuan 290や370など)は現時点では追跡していない。590の数量が急速に伸びたことを踏まえると、既存の導入済みのストックに占めるそれらの割合は無視できるほど小さい。
方法論
出荷数量の推定には、主にCambriconの2025年の年次報告書、第三者のアナリストの推定、報道を使う。私たちの方法は二つの手法を組み合わせている。
- 売上高ベースのモデル:2025年について、Cambriconの年次報告書は全製品ラインの生産総数(127,673基)と販売総数(117,436基)を開示している。これらの数字を、Cambriconが開示したセグメント別の売上高の内訳と組み合わせて、Siyuan 590の数量を切り分け、そこから平均販売価格(ASP)を導く。
- アナリストによる数量の推定:第三者のアナリストと報道による出荷数量の推定(主にGoldman Sachs、JPMorgan、IDC、SemiAnalysis)をまとめ、裏付けとして使う。外部のアナリストは推定の基になるモデルを公表していないので、これらは信頼区間のない点推定として扱う。
数量の推定
AIアクセラレータの販売の代理指標としての総売上高
売上高ベースの三角測量の前提は、Cambriconの報告する売上高がAIアクセラレータの出荷とよく連動し、他の売上源は無視しても差し支えないほど小さいことである。これは同社の公開情報によって裏付けられている。
2024会計年度、Cambriconのクラウド向けチップのセグメント(クラウド向けAIチップと、同社のチップを中心に構築したサーバーであるインテリジェント完成機からなる)は11億6,600万元の売上高を生み、総売上高の99.7%を占めた。残りの二つのセグメントであるエッジコンピューティングとIPライセンスは、それぞれ654万元(0.5%)と41万2,000元(0.03%)にとどまり、今後も小幅な成長しか見込まれていない。2025年前半も状況はほぼ同じだった。TrendForceは、Cambriconの売上高の99.6%がクラウド向けAIチップによるものだったと報じている。SemiAnalysisは別途、2024年の売上高はすべてSiyuan 590の販売によるものだったと推定している。
そこで、Cambriconの総売上高を、AIアクセラレータによる売上高の代理指標として扱う。Siyuan 590の年間の台数の推定を四半期ごとの推定に換算するには、年間の台数を、Cambriconが報告した四半期ごとの売上高に比例して割り振る。この方法は、Siyuan 590の平均販売価格が各年の中ではほぼ一定であると仮定している。主な限界は、年内にASPが上がった場合、この方法では後半の四半期の数量を過大に、前半の四半期の数量を過小に見積もることである。
2024年の出荷
年次報告書は、2025年に生産数量が409.84%増加したと開示している。2025年の生産数127,673基から逆算すると、127,673 ÷ (1 + 4.0984) = 約25,042基が2024年に生産されたことになる。これは、2024年に出荷されたSiyuan 590を25,000〜26,000基とする独立した推定や、2024年の売上高はすべて590によるものだったとするSemiAnalysisの推定とよく一致する。2024年に販売されたSiyuan 590の数は約25,042基を基準とする。
年次報告書はまた、2025年に販売数量が201.57%増加したと開示している。2025年の販売総数117,436基から逆算すると、117,436 ÷ (1 + 2.0157) = 約38,943基が2024年の販売総数になる。この数字は全製品ラインを含む。
ここに差が生じる。約2.5万基がSiyuan 590だったとすれば、残りの約13,901基は他の製品ラインによるものでなければならない。
クラウドのセグメント(Siyuan 590はここに含まれる)以外で唯一のハードウェアの分類は、エッジコンピューティング向けのチップである。重要なのは、2024年の売上高の約99.7%がクラウドのセグメントによるもので、エッジはわずか0.5%だったことである。ここから、エッジ向けのチップはそれなりの数量が出荷されているもののASPが非常に低いと考えられる。データセンター向けのアクセラレータではなく小型の組み込みチップであることとも整合する。
これに基づき、残りの数量をエッジに割り当てる。
- Siyuan 590が2.5万〜2.6万基
- エッジ向けチップが1.3万〜1.4万基
照合:Cambriconは、最大の顧客(ByteDanceだと広く推測されている)が2024年の売上高の79.1%を占めたと開示した。独立した報道は、ByteDanceが2024年に約20,000基のSiyuan 590を購入したと推定しており、これは合計約25,042基のおよそ80%にあたる。これはByteDanceの開示された売上シェアとよく一致しており、数量の基準値への信頼を高める。
2025年の出荷
2025年の年次報告書は、2025年に全製品ラインで合計117,436基を販売したと開示している。Siyuan 590の数を切り分けるため、セグメント別の売上高のデータを使ってエッジ向けチップの数を差し引く。
エッジの売上高は2025年に339万元に減少した。これを台数に換算するため、2024年のデータからエッジ向けチップのASPを導く。6,540,000元 ÷ 13,901基 = 約471元/基である。これは低い数字で、Cambriconのエッジ向け製品がデータセンター向けのアクセラレータではなく小型の組み込み型の推論実行用チップであることと整合する。2024年から2025年までエッジのASPが一定だったと仮定すると、3,393,000 ÷ 471 = 約7,204基のエッジ向けチップが2025年に販売されたことになる。
販売総数からエッジ向けの数を差し引くと、117,436 − 7,204 = 2025年に販売されたSiyuan 590は約110,232基になる。
2026年の見通し
Bloombergは、Cambriconが2026年に50万基を目標としており、そのうち最大30万基がより先進的なSiyuan 590と次期製品のSiyuan 690であると報じている。
| 年 | 数量の推定 | チップの種類 | 出典 |
|---|---|---|---|
| 2024 | 約25,042基 | Siyuan 590 | 年次報告書(から導出)、IDCが裏付け |
| 2025 | 約110,232基 | Siyuan 590 | 年次報告書の実績値、エッジ分を調整 |
| 2026 | 約500,000基(目標) | Siyuan 590/690 | Bloomberg |
Siyuan 590の導出ASP
上記のエッジ分を調整した台数を使い、クラウドのセグメントの売上高をSiyuan 590の販売数で割って、Siyuan 590のASPを導く。
| 年 | クラウドの売上高 | 590の販売数 | 導出ASP(人民元) | 導出ASP(米ドル) |
|---|---|---|---|---|
| 2024 | 11.7億元 | 約25,042 | 約46,560元 | 約6,380ドル(1ドル=7.3元で換算) |
| 2025 | 64.8億元 | 約110,232 | 約58,760元 | 約8,510ドル(1ドル=6.9元で換算) |
この分析からは、Siyuan 590のASPが2024年から2025年に26%上昇したと考えられる。一つの説明は、Cambriconが2024年にはByteDanceにSiyuan 590を大幅な割引価格で販売していたというものである。その年、ByteDanceは売上高の約79%を占める、Cambriconの実質的に唯一の大口の買い手であり、実績のないチップをいち早く採用する立場として、単価の引き下げを交渉する強い力を持っていた。
2025年、米国政府はNVIDIAのH20の中国への輸出を禁止し、中国のAI企業が入手できる高性能な選択肢として最後に残っていたものの一つがなくなった。これがSiyuan 590のような国産の代替品への需要を加速させた可能性が高い。Cambriconの財務はこれを裏付けている。売上高は5倍超に伸び、新たに4社の大口の買い手が上位5社に入り、売上高は2024年よりはるかに均等に顧客に分散していた。ASPが46,560元から58,760元に上がったことは、Cambriconが単一の顧客への割引の関係から、競合する多数の買い手に市場価格に近い水準で販売する形へ移ったという変化と整合する。
相互検証:2025年9月の報道は、Siyuan 590の市場価格を60,000〜80,000元と伝えた。2025年の導出ASPである約58,760元はこの範囲の下端にあるが、最大の顧客が数量割引を受け、他の顧客は表示価格に近い額を支払っているとすれば、なお整合しうる。
計算性能の仕様とH100換算の推定
Siyuan 590は、SMICのN+2プロセスノード(おおむねTSMCの7nmに相当)で製造され、80GBのHBMを搭載している。Siyuan 590について公開されている計算性能の仕様は限られており、ばらつきもあるので、Cambriconの計算能力換算の推定は、仕様がよく記録されているチップより大きな不確実性を伴うものとして扱う。
H100換算には、この記事で報じられたINT8性能の512 TOPSという数字を使う。これにより、Siyuan 590の点推定は0.26 H100eになる。根拠となる公開の証拠が不確実であることを認識したうえで、これを中心推定値として使う。
この推定は、Siyuan 590がNVIDIA A100の性能のおよそ80%を発揮するとする他の公開の報道とおおむね整合する。A100のINT8性能は624 TOPSで、512 TOPSはその約82%にあたる。他の報道はFP16で345 TFLOP/sとしており、その中には、Cambriconの共同創業者による基調講演の発表資料を写したとされる、中国の報道機関が掲載した写真も含まれる。私たちはH100eへの換算にFP16の数字は使わないが、このチップの報じられた性能についてのもう一つの公開の参照点にはなる。
| 指標 | 値 | 出典と引用 | 確度 |
|---|---|---|---|
| TPP | 4,493 | Yahoo FinanceがBernsteinのレポートを引用:「7月のBernsteinのレポートによれば、Huaweiの910Bは総処理性能(TPP)5,120を発揮し、H20の2,368を上回る。CambriconのSiyuan 590もTPPが4,493で、H20を上回る。」 | 中 |
| 指定なし | A100の80% | TrendForceがBusiness Todayを引用:「一方、Business Todayは、2023年に発売されたSiyuan 590はNVIDIAのA100のおよそ80%の性能を発揮し、中国国内の7nmプロセスで製造されていると指摘している。」 | 中 |
| FP16 | 345 TFLOPs | AOL:「Cambriconが本領を発揮したのは2023年のMLU 590だった。590は7nmで製造され、FP16で345 Tflopsのピーク性能を発揮し、場面によってはNvidiaのH20を上回る可能性さえあるとする報道もあった。」中国の報道機関の投稿には、Cambriconの共同創業者による基調講演のものとされる写真が含まれ、そこにはSiyuan 590の仕様としてFP16で345 TFLOPsと記されている(Google翻訳で翻訳したもの。下に示す)。 | 可能性が高い |

AMD
AMDは、Instinct GPUと呼ばれるAIチップを販売している。特定の企業や用途向けに独自設計されたもの(Google/BroadcomのTPUやAmazonのTrainiumなど)ではないAIチップの販売では、AMDはNvidiaの最大の競合企業と言えるだろう。23
AMDのAIチップの販売24を推定するには、まず次のことを行う。
- Instinct GPUの販売によるAMDの売上高の総額を推定する。
- 報道とアナリストの分析に基づき、GPUのモデルごとの平均販売価格を推定する。
- 製品の発売日、判明している顧客への導入、会社のコメントに基づき、四半期ごとのGPUの世代間の生産構成をモデル化する。
四半期ごとのInstinctの売上高、GPUの価格、生産構成の推定がそろえば、売上高を加重平均価格で割って台数を算出できる。この計算はモンテカルロ・シミュレーションで行い、すべての入力パラメータの不確実性をモデル化して、結果を中央値と信頼区間で報告する。モデルの全体はこちらにある。
AMDはAI向けGPUからどれだけの売上高を得ているか
AMDは四半期ごとに「データセンター」の売上高(つまり、データセンター向けの製品を販売する部門の売上高)を報告しているが、そのうちInstinct AI GPUによる売上高と、EPYC CPUなど他の製品による売上高の内訳は開示していない。Instinctの売上高を推定するため、会社の開示に頼り、いくつかの基準点から逆算する。
最も重要な基準点は、Instinctの売上高が2024年に50億ドルを超えたというAMDの開示である。補助的な基準点が、この50億ドルを2024年の各四半期に割り振るのに役立つ。AMDの2024年第2四半期の決算説明会で、CEOのLisa Suは、Instinct MI300の売上高が初めて10億ドルを超えたと述べた。これは、2024年の50億ドル超を四半期ごとにどう割り振るかのモデル化の根拠になる。
2025年については、Instinct GPUの売上高はより不確実である。
AMDのデータセンター部門は2025年に全体として成長したが、2025年第1四半期と第2四半期には二つの要因による逆風を受けた。第一に、2025年4月の新たな米国の輸出規制で、中国市場向けに設計されたAMDのMI308チップが制限され、第2四半期に8億ドルの損失計上が生じた。第二に、AMDの新しいMI325X GPUの需要が予想外に弱かった。データセンターの売上高に占めるInstinctのシェアは、2024年第4四半期の約50%から2025年第1四半期には約40%、2025年第2四半期には約30%に下がったと推定する。
この低下は2025年第3四半期に反転した。AMDが新しいGPU世代であるMI350シリーズを投入し、これが「非常に順調に立ち上がり」、第3四半期の成長を牽引したからである。2025年第3四半期のデータセンターの売上高43.4億ドルのうち、Instinctは35〜50%、つまり売上高で約15億〜23億ドルを占めたと推定する。
AMDはEPYCとInstinctの内訳を定期的には開示していないので、不確実性は無視できない。実際の売上高の分布は、特に直接の情報が限られている四半期では、異なる可能性がある。
| 四半期 | DCの売上高 | Instinctのシェア | Instinctの売上高 | 注記 |
|---|---|---|---|---|
| 2024年第1四半期 | 23.4億ドル | 約30% | 約7億ドル | 立ち上がりの軌道に基づく仮定 |
| 2024年第2四半期 | 28.3億ドル | 約36% | 10億ドル超 | 会社の開示 |
| 2024年第3四半期 | 35.5億ドル | 約42% | 約15億ドル | 補間 |
| 2024年第4四半期 | 38.6億ドル | 約47% | 約18億ドル | 補間 |
| 2024年の合計 | 126億ドル | 44% | 約50億ドル | AMDの2024会計年度 |
| 2025年第1四半期 | 36.7億ドル | 35〜45% | 13億〜17億ドル | MI308の輸出規制、MI325Xの需要の弱さ |
| 2025年第2四半期 | 32.4億ドル | 25〜40% | 8億〜13億ドル | MI308の8億ドルの損失計上、引き続き軟調 |
| 2025年第3四半期 | 43.4億ドル | 40〜53% | 17億〜24億ドル | MI350の立ち上がり |
平均販売価格
Instinctの売上高を台数に換算するには、AMDが各Instinct GPUをいくらで販売しているかを推定する必要がある。推定は主に業界アナリストのレポートに基づく。
各ASPは、報道とアナリストの推定に基づく範囲内の一様分布としてモデル化する。
| GPUのモデル | 価格の範囲 | 出典 |
|---|---|---|
| MI250X | 8,000〜1万2,000ドル | Massed Compute |
| MI300A | 6,000〜7,500ドル | El Capitanのコスト ÷ 台数から導出 |
| MI300X | 1万〜1万5,000ドル | Tom’s Hardware、Citi(SeekingAlpha経由)(Microsoftの支払額は約1万ドル) |
| MI325X | 1万〜2万ドル | 下限は需要の弱さの中でのハイパースケーラー向けの割引を反映 |
| MI350X | 2万2,000〜2万5,000ドル | Seeking Alpha(2万5,000ドルの価格設定の報道) |
| MI355X | 2万5,000〜3万ドル | Seeking Alpha |
GPUの売上構成の推移
GPUによってコスト効率が異なるので、AMDのチップの計算能力の総量を測るには、GPUのモデル間の四半期ごとの配分を推定する必要がある。
売上構成は、製品の発売の年表、判明している顧客への導入、生産の立ち上がりについての会社のコメントを使ってモデル化する。2024年の販売の大半はMI300シリーズによるもので、旧製品のMI250X、MI300A、MI300Xが小さなシェアを占めたと推定した。2025年第3四半期には次世代のMI350シリーズが予定より早く発売され、すぐにInstinctの売上高の過半を占めたと推定する。より詳しい年表を以下に示す。パラメータの全体は私たちのモデルにある。
AMDは製品ごとの正確なシェアを開示していないので、売上構成には大きな不確実性がある。実際の構成は、特に複数の世代が重なる製品の移行期には、大きく異なる可能性がある。
| GPU | 発売日 | 説明 | 売上シェアについての注記 |
|---|---|---|---|
| MI250X | 2021年11月 | 前世代の主力GPU | 2024年初めに小さなシェアを占めた旧製品 |
| MI300A | 2023年1月 | 300シリーズの最初の製品で、AIよりHPC向けに設計 | El Capitan向けのMI300A 4.45万基の大半は、2024年第2四半期と第3四半期に納入された。その後は縮小 |
| MI300X | 2023年12月 | Nvidia H100と競合する主力AI向けGPU | 2024年を通じて拡大し、2025年にMI325Xに置き換えられて段階的に縮小 |
| MI308X | 2023年12月 | 輸出規制に対応した中国向け仕様の300X | 大量の出荷が実際に行われたかは不明で、2025年4月に輸出が完全に阻止された |
| MI325X | 2024年10月 | メモリを増やした300Xの改良版で、Nvidia H200に相当 | 2025年第2四半期に出荷され、2025年第1四半期に5〜20%のシェア、需要の弱さにもかかわらず2025年第2四半期までに15〜40%に拡大。B200に対して投入時期が不利だった |
| MI350 | 2025年6月 | Nvidia Blackwellと競合する次世代GPU | 量産が予定より早く進み、2025年第3四半期の成長の主な牽引役となった |
数量の計算
四半期ごとのInstinctの売上高の推定、各モデルのASPの分布、生産構成のシェアがそろったら、GPUの総売上高に各モデルの生産シェアを掛けてモデルごとの売上高を求め、それをそのモデルのASPで割って台数を算出する。
点推定を使うのではなく、すべての確率分布から同時にサンプリングし、モンテカルロ・シミュレーションで得られる台数を計算する。
限界
私たちの分析には不確実性の源がいくつかあり、そのために次のような限界がある。
売上高の配分:AMDは大半の四半期でEPYCとInstinctの内訳を報告していない。開示されたデータ点を基準にしているが、EPYCが私たちの想定より速く、あるいは遅く成長したなどの理由で、AMDの実際のEPYC/Instinctの構成が推定と異なれば、GPUの売上高の推定には偏りが生じる。
生産構成:GPUのモデルごとのシェアは製品の年表と導入の報道から推定しているが、AMDは実際の配分を開示していない。実際の配分は、特に製品の移行期には、推定と大きく異なる可能性がある。モデルによって価格が異なり、1万5,000ドルのGPUと2万5,000ドルのGPUの構成を見誤れば、台数に直接影響するので、これは重要である。
価格:GPUの価格は顧客、契約の構造、時期によって異なり、私たちのASPの範囲では十分に捉えられない。大量一括購入や顧客の需要は、GPU 1基あたりの平均価格に無視できない影響を与えうる。ASPは報道された範囲内の一様分布としてモデル化しているが、実際の契約価格はおそらくもっと複雑な分布をしている。
2025年第2四半期とそれ以降の四半期に対するMI308の輸出規制の影響は、依然として不確実である。AMDは第2四半期の8億ドルの損失計上と、年間15億〜18億ドルの影響を開示したが、製品構成、価格、顧客への配分への影響の全体を正確にモデル化するのは難しい。
導入の遅れ:私たちの推定はAMDが生産・販売したチップを反映しており、必ずしも顧客のデータセンターに導入されて稼働しているチップではない。AMDが売上を計上してからチップが稼働するまでには、導入の遅れがあるかもしれない。四半期ごとの分析では、こうした時期のずれによって数量が期間の間で移る可能性がある。
まとめ
AMDのInstinct GPUはNvidiaのデータセンター向けアクセラレータと競合しているが、AI計算資源の市場に占めるシェアはずっと小さい。AIチップ市場でのAMDの位置を把握するため、2024年と2025年のInstinct GPUの数量を推定する。
AMDは、Instinct GPUの売上高をEPYCサーバー向けCPUの売上高とともに単一のデータセンター部門にまとめている。このため、Instinct GPU製品ラインによるAMDの売上高を追跡するのは難しくなる。私たちはGPUの売上高を推測し、それをチップの平均価格で割って台数を推定する。売上高の主な基準点は、2024年のInstinctの売上高が50億ドルを超えたというAMDの発言である。また、2024年第2四半期にMI300の売上高がその四半期で10億ドルを超えたという開示も使う。この二つの点から、製品の発売、採用状況についての報道、AMDが決算説明会で話した生産スケジュールを考慮して、GPUの売上高がほかの四半期にどう分布していたかを推定する。
GPUのモデルごとの価格は、アナリストのレポートと顧客との契約についての報道から推定する。Microsoftのようなハイパースケーラーは大量購入でMI300X 1基あたり約1万ドルを支払っており、MI350Xのような新しいモデルは2万2,000〜2万5,000ドルで販売されている。GPUの世代間の生産構成は、製品の年表、判明している導入、製造についての会社の発言から求める。点推定を使うのではなく、モンテカルロ・シミュレーションを実行して不確実性を伝播させる。
その他のAIチップ
私たちのAIチップの販売ハブは現在、Nvidia、AMD、GoogleのTPU、AmazonのTrainium、Huawei、CambriconのAIチップを対象としており、他の設計企業によるAIチップの製品群は含めていない。これらは全体として、私たちが対象とする製品群に比べれば小さく、世界のAI計算能力のストックのおそらく10%未満だと考えている。この結論は、個別の企業についての調査(ほとんどの場合、比較的限られた浅いものではあるが)、広帯域メモリやCoWoSといったAIチップの投入物についての業界の推定とサプライチェーンの分析、そして暗黙知(私たちの一覧にないAIチップ企業がAMDやTrainiumほどの規模に達していたら、もっと話題になっているはずだ)を組み合わせて得たものである。
以下に簡単な概要を示す。参考までに、私たちが対象とするチップ設計企業は、2025年にH100換算で1,000万基を超えるAIチップを販売し(累計約2,000万基)、その金額は数千億ドルにのぼると推定している。
Metaは、Broadcomと提携してMTIAと呼ばれる独自のAIチップの取り組みを進めている。2026年3月、MetaはMTIAチップを「数十万基」導入したと明らかにした。MTIA 300チップは最近投入されたばかりなので、この数十万基の大半は、古いMTIA 100と200のチップである可能性が高い。どちらも計算能力はH100のごく一部にすぎない。
MicrosoftもMaiaと呼ばれる独自のAIチップの取り組みを進めており、ある程度導入しているが、公開されている情報は限られている。
Intelは一連のAIチップ(「Gaudi」)を販売している。2024年、IntelはGaudiの販売目標であるわずか5億ドルを達成できなかった。2024年後半には、2025年についてより意欲的な販売目標として、Gaudi3チップ20万〜25万基(カタログ上はそれぞれH100およそ1基分に相当)、金額にして約30億ドルを示した。しかしIntelはそれ以降Gaudiの売上高を切り分けて開示していないようで、2025年半ばにはGaudi関連の在庫の評価損3億6,100万ドルを開示したので、この比較的控えめな見通しさえ達成できたかは疑わしい。
Cerebras、Groq、SambaNovaなど、比較的確立したAIチップのスタートアップがいくつかある。Groqは高性能で低遅延のAIチップを販売しており、投資家には2025年の売上高を5億ドルと見込んでいると伝えていた。その後Nvidiaに事実上買収されたので、Groqの製品群は今後Nvidiaに吸収されるかもしれない。Cerebrasも低遅延のチップに取り組んでおり、OpenAIと大型の契約を結んだが、これまでの売上高やチップの出荷についての情報は限られている。SambaNovaの販売については具体的な公開情報を把握していないが、私たちも詳しくは調べていない。
これはAIチップ企業を網羅した一覧ではないが、この一覧にない企業はおそらく確立の度合いがより低く、チップを開発・販売したことすらない可能性もある。
AI向けでない・データセンター向けでないチップ
消費者向けのGPUや、商用・データセンター向けのAIチップとして売り出されていないその他のチップも追跡していない。これらの一部は、小規模なAIの作業に役立つかもしれない。ここで最も重要な分類はおそらく、Nvidiaのデータセンター向けでないチップだろう。これには、ゲーム用GPU、プロ向けのGPU、「車載」(自動運転・ロボティクス)向けのチップが含まれる。近年、Nvidiaの売上高の90%近くはデータセンター向けの販売によるものなので、これらの部門は、主要なAIのワークロードへの適性が低いことを別にしても、Nvidiaの主力のデータセンター向け製品よりずっと小さい。
消費者向けの機器全般は、AIで使われる並列演算(行列の乗算など)の能力がGPUよりずっと低いCPUで動いている場合でも、小さなAIモデルのエッジでの推論実行をある程度こなせる。しかし全体として見ても、それほど大きいとは思われない。AIチップはすでにコンピューターのチップ全体のかなりの割合を占めており(2025年の世界の半導体売上高約8,000億ドルに対し、Nvidiaのデータセンターだけで約2,000億ドル)、AI向けの作業には、専用のAIチップのほうが消費者向けのCPUよりはるかに適していることを考えてほしい。
注
-
チップの寿命の推定は、こちらの「分析」を参照のこと。2022年ごろのチップの一部はすでに退役している可能性があるが、単純化のため、退役や故障は明示的にモデル化していない。 ↩
-
2022年については、ネットワーキングの明示的な内訳が得られなかったので、コンピュートを75%として推定・補間した(ネットワーキングのシェアは2020年以降おおむね低下してきた)。 ↩
-
ごく細かい点だが、Nvidiaは実際には2種類の内訳を報告している。Nvidiaには「Compute & Networking」と「Graphics」の二つの「報告セグメント」がある。これとは別に、データセンター(Data Center)を含むいくつかの「市場プラットフォーム」ごとの内訳も報告している。データセンター(私たちが使っているもの)の中で、売上高はさらに「コンピュート」と「ネットワーキング」に分けられる。理由は分からないが、データセンターの売上高(「コンピュート」と「ネットワーキング」の合計)は、報告セグメントの「Compute & Networking」より約1%小さい。 ↩
-
Nvidiaのクラウドは、主にOracleやネオクラウドから借りた能力で運営されていると報じられている。Nvidiaはまた、社内の研究とモデルの学習に使う計算資源の少なくとも一部に、外部のクラウドの計算資源を使っている。ここから、Nvidiaは自社のハードウェアをほとんど所有していないと考えられる(未納入の在庫は別だが、これは私たちの集計に含めていない)。 ↩
-
サーバー内のネットワーキング機器は、ネットワーキングの売上高に計上されるはずである。 ↩
-
「もしそれより高かったら、OEMやODMが悲鳴を上げているはずだと私たちは考えている」。これは、Nvidiaのサーバーを販売したり、サービスとして組み立てたりする第三者を指している。 ↩
-
2025年後半にNvidiaが中国へのH200の販売については輸出許可を得たのに、H100については得なかったことは、その時点でH100が生産終了しているか、もはや重要でなかったことを示すものかもしれない。 ↩
-
あるいは、GPUを8基搭載したB200サーバーに組み込んだり、単体で導入したりすることもできる。 ↩
-
Nvidiaによれば、2025年4月までにハイパースケーラーは毎週1000台近くのNVL72ラックを導入していた。1台あたり200万〜300万ドルの売上高とすれば、13 * 1000 * 200万〜300万 = 260億〜390億ドルの売上高になる。これに対し、翌四半期のデータセンターの売上高の総額は410億ドルだった。 ↩
-
発言の全文(B200のダイの実物を掲げながら):「これは、まあ、3万、4万ドルくらいになるだろう」 ↩
-
グラフにはBlackwell GPUが600万基とあるが、スライドの小さな文字「Blackwell and Rubin are 2 GPUs per chip(BlackwellとRubinはチップ1個あたりGPU 2基)」から、これはジェンスン流の計算(Jensen math)の一例だと分かる。各パッケージ内の2つのGPUダイを、それぞれ別のGPUとして数えているのである。したがって600万基は、従来の意味でのBlackwell GPU 300万基を意味する(つまりこの数え方では、単体のB200はGPUを2基含み、NVL72システムは144基を含む)。これは、GB200/GB300スーパーチップがそれぞれGPUを2基(または4基)含むことを指しているのではない。 ↩
-
それに、上場企業のCEOが販売の数字について話すなら、切り上げではなく切り捨てる可能性が高い。 ↩
-
最近、Google/BroadcomはTPUを直接販売することも決め、たとえばAnthropicや他のクラウド企業に販売する。これらの納入はおそらく2026年に始まるので、私たちが推定しているTPUの数量は、おそらくすべてGoogleが所有している。 ↩
-
これが開示されたのは、BroadcomのCEOであるHock TanがMetaの取締役を務めているからである。Metaからのこの売上高がすべてXPUに向けられたとは限らず、その場合、XPUに占めるGoogleのシェアはさらに高くなる。 ↩
-
BroadcomへのTPUの支出が設備投資全体に比例して増えるという仮定は、支出がデータセンター、ネットワーキング、その他の分野へ移る場合には、厳密には成り立たないかもしれない。 ↩
-
たとえばBroadcomは第2四半期に、全体の粗利益率が「主にAI売上高に占めるXPUの割合が高まることによって」低下すると予測した。これは、XPUの利益率がAI事業全体より低いことを意味する。Hock Tanはまた、「カスタム[チップ]はおそらく半導体の中で(利益率を)押し下げている」と述べた質問者にも反論しなかった。 ↩
-
パラメータの範囲と分布の仮定が同一でも、独立したモンテカルロの抽出による小さな確率的ばらつきや、分布の表現・サンプリング方法の実装上の細かな違いのため、Squiggleでのモデル化の値は表の値とごくわずかに異なることがある。上に示した値は、最終的な推定を導いているPythonのノートブックによるものである。 ↩
-
TPUのバージョンにプレビュー期間がなく、直接一般提供(GA)に移った場合は、GAの日付を記載している。 ↩
-
Amazonは「Project Rainier」という名前を、特にNew Carlisleを指して使うことが多い。 ↩
-
「AmazonとAnnapurnaはコストを非常に重視しており、サプライヤーに厳しい要求をする。BroadcomのASICの案件と比べると、Trainiumのプロジェクトでは、チップ設計パートナーのAlchipとMarvellが得られる利益の総額がずっと少ない。」 ↩
-
ただし全体ではGoogle/Broadcomに大きく後れをとっている。 ↩
-
AI・機械学習に使えるが、そのために設計されてはいないAMDのゲーム用GPUは含まない。 ↩