トピック
数学におけるAI
原文:AI in math
AIの推論能力を数学ほどはっきり試せる分野はほとんどない。数学では答えを自動で検証でき、最も難しい問題は人類の知識の最前線にまで及ぶ。Epochは、数学の課題でのAIの成績の推移を追跡している。その手段の一つが私たち独自のベンチマークFrontierMathで、今日の最良のシステムにできることの限界を試すよう設計した、専門家レベルの問題からなる。
- FrontierMathFrontierMath: Open Problems
- ポッドキャストAIの数学の能力は、長いあいだ凸凹なままかもしれない――Daniel Litt
- FrontierMathFrontierMath: Tiers 1-4
- データインサイト8月には数学プレプリントの25%がAIの使用を明記しており、4月の4%から増加した
arXivの数学プレプリントでAIの使用を明記したものは、2026年4月の4%から8月には25%に増え、6%はAIが研究に大きく貢献したと認めていた。
- データインサイトGPT-6 Astraは数学のベンチマークでは首位だが、ソフトウェアエンジニアリングではそうではない
OpenAIのGPT-6 Astraは、Epoch能力指数(ECI)で166のスコアを記録して首位に立ち、Claude Fable 5.1の164、GPT-5.6 Solの162を上回った。Math-ECIの170は新記録だが、ソフトウェアエンジニアリングのベンチマークでは、SWE-ECIの164がFable 5.1の167になお及ばない。
- お知らせFrontierMath Erdős を発表する
2026年8月時点で未解決の、重要なエルデシュ問題68問からなるベンチマーク。Thomas Bloomが選定し、Leanで形式化した。AIシステムは、決められた予算の範囲内で各問題を証明または反証しなければならない。
- データインサイトClaudeはソフトウェアエンジニアリングで実力以上の成績を示し、数学では下回る
AnthropicのClaudeのモデルは、全体のEpoch能力指数(ECI)の値と比べて、ソフトウェアエンジニアリングのベンチマーク(SWE-ECIで集計)では上回り、数学(Math-ECI)では下回る。ソフトウェアエンジニアリングでの上振れはほとんどの世代で一貫しており、最近のモデルでも続いている。数学での差は縮まりつつあるのかもしれない。Opus 4.6と4.7はどちらも、Math-ECIが全体のECIとの差1ポイント以内に収まっており、以前のモデルの大きな差とは対照的である。
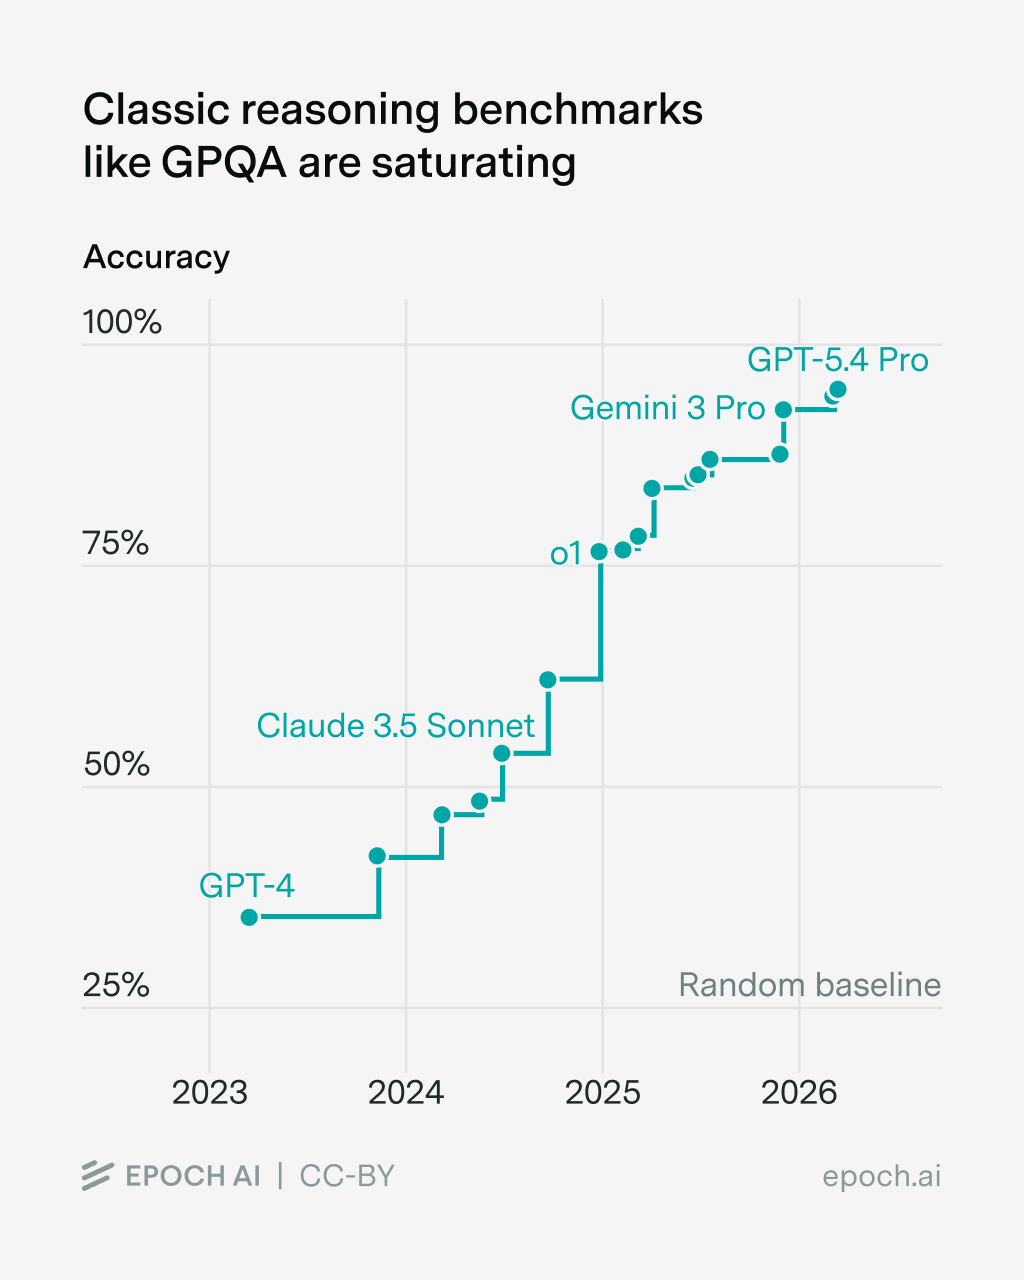
- ポッドキャストAIベンチマークに未来はないのか?
この回では、Greg BurnhamとTom AdamczewskiがAnson Hoとともに、ベンチマークへの悲観論に反論し、次世代のAIベンチマークがどのようなものになりうるかを掘り下げる。