
ニュースレター
今日のモデルの手が届くのは FrontierMath の70%未満である
原題:Less than 70% of FrontierMath is within reach for today’s models
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
私たちが観測したかぎり、FrontierMath の1回の実行でモデルが出した最高の成績は29%である。1 FrontierMath のような問題をモデルに解かせたいなら、考慮すべきはこの数字である。
しかし、最高水準の成績を測る別の方法もある。どれかのモデルが、どれかの実行で、一度でも解いた FrontierMath の問題はいくつあるか、である。こちらは、今日のモデルの「手が届く」範囲についてより多くを教えてくれる。また、より先を見据えた指標でもある。今日のモデルが問題を解くための正しいアイデアを多少なりとも生み出せるなら、明日のモデルがその問題を確実に解けるようになる可能性は高まる。2 言い換えれば、正答率の傾向を単に外挿するよりも、少し具体的な将来の見通しが得られる。
話をさらに面白くするのは、LLMにベンチマークを N 回解かせたとき、少なくとも一度正しく解けた問題の割合(pass@N と呼ばれる)が log(N) に比例して増えるという実証的な証拠がいくらかあることだ。これが一般に成り立つなら、log(N) には上限がないので、モデルに試行回数を多く与えれば pass@N は100%に近づくと予想されることになる。FrontierMath の飽和は、すでにそれほどはっきりと視界に入っているのだろうか。
これを調べるため、私は GPT-5(medium)を32回実行した。3,4 結論を言えば、FrontierMath はまだ終わっていない。これらの実行での pass@N の伸びは対数以下で、50%未満で頭打ちになるようだ。
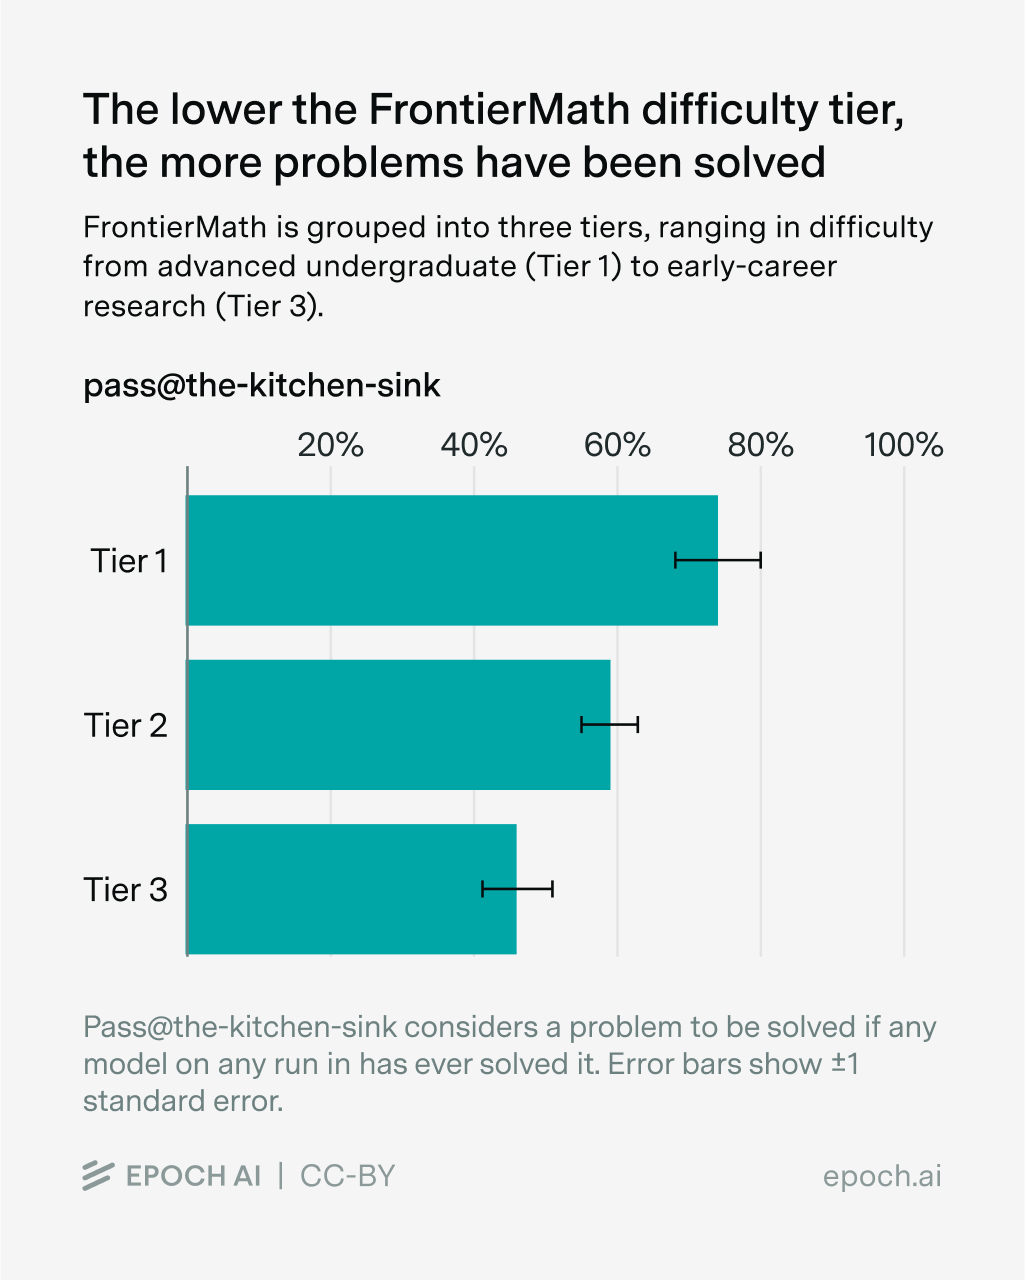
ただし、これは1つのモデルにすぎない。手元には他のモデルの実行結果も多数あり、近いうちに何が確実に解けるようになりそうかを理解するうえで、それらも同じくらい参考になりそうである。それらをすべてまとめると、pass@手当たり次第(pass@the-kitchen-sink)は57%になる。つまり、どれかのモデルがどれかの実行で解いた問題の割合である。ここからは推測の領域になるが、これらのモデルをすべて繰り返し実行しても、70%未満で頭打ちになると私たちは見積もっている。
今後、FrontierMath の正答率の向上のうち、この57%の問題を確実に解けるようにすることによるものと、モデルがこれまで解けなかった問題を解くことによるものが、それぞれどれだけになるかが興味深い。
Epoch AI の最新情報を受け取る 購読する
GPT-5 の pass@N は50%未満で頭打ちになる
下のグラフは、私たちの足場(scaffold)で GPT-5 を32回実行したときの pass@N を示している。対数関数で当てはめた直線と比べて、pass@N の曲線が上に凸になっていることに注目してほしい。
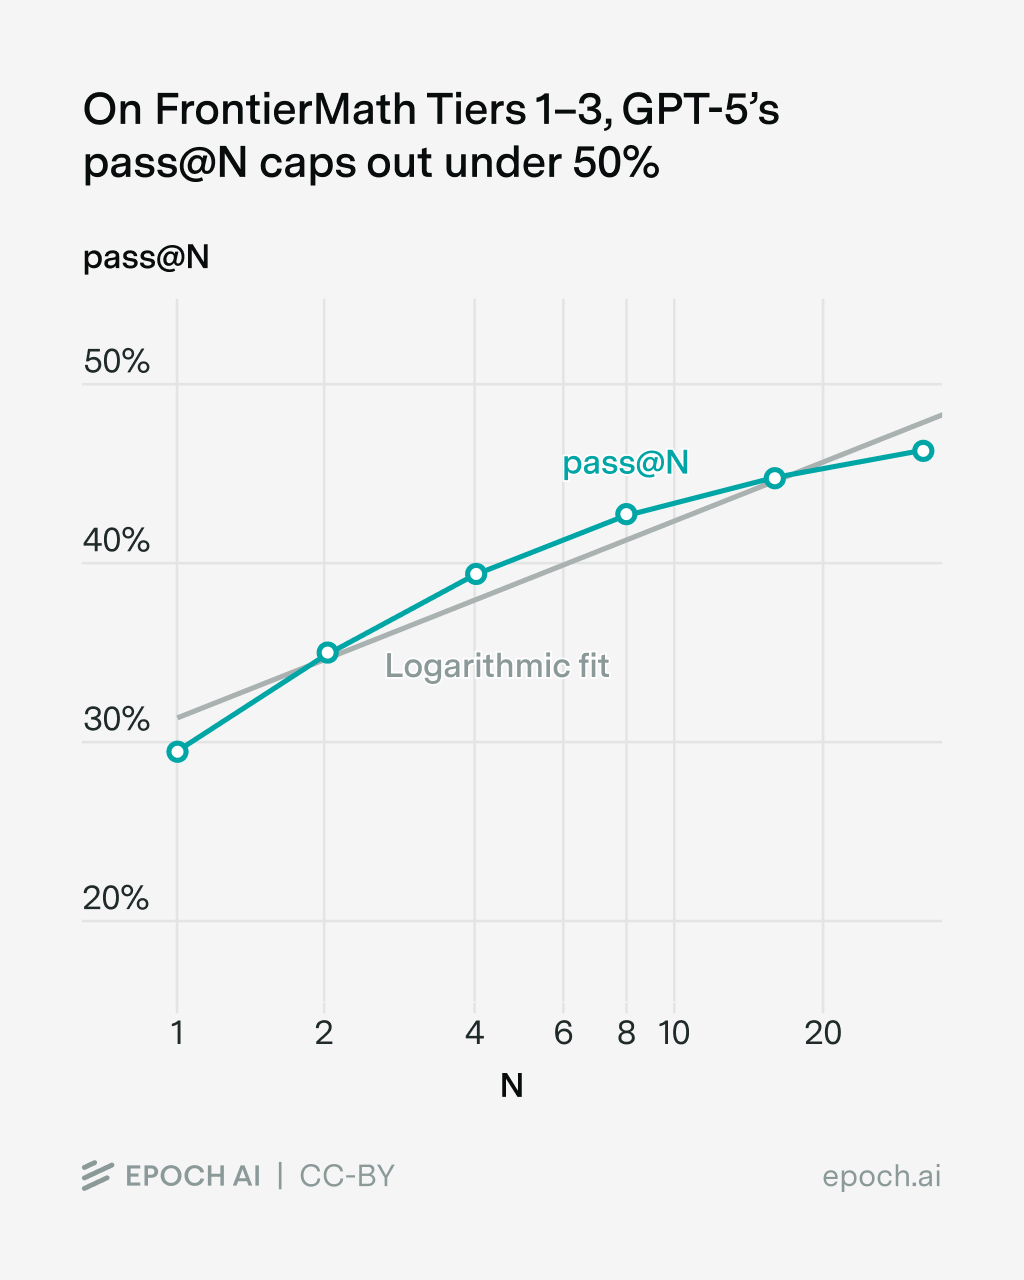
以下は同じデータを表にしたものである。N を2倍にするたびに pass@N は増えるが、増え幅は直前の倍増のときより小さい。両端を比べると、N を1から2に倍増すると pass@N は5.4%増えるが、16から32に倍増しても1.5%しか増えない。
FrontierMath ティア1〜3での GPT-5 の pass@N
| N | Pass@N | 2倍による増加 | 増加の差 | 解けた問題数 |
|---|---|---|---|---|
| 1 | 29% | – | – | 85 |
| 2 | 35% | 5.4% | – | 101 |
| 4 | 39% | 4.5% | -0.9% | 114 |
| 8 | 43% | 3.3% | -1.2% | 123 |
| 16 | 45% | 2.1% | -1.1% | 130 |
| 32 | 46% | 1.5% | -0.6% | 134 |
さらに倍増を重ねたら、pass@N はあとどれだけ増えるだろうか。平均すると、倍増による増え幅は倍増のたびに約1%ずつ小さくなった。これを外挿すると、N を32から64にしたときに0.5%増え、それで終わりになる。もう少し裾が長いかもしれないが、大まかな切りのよい数字で推測するなら、ここでの pass@N は50%未満で頭打ちになる可能性が高いと思われる。5
これを検証するため、これらの実行のどれでも解けなかった問題から10問を無作為に選び、それぞれをさらに100回、計132回サンプリングした。つまり、倍増をおよそ2回追加したことになる。これらの問題は一度も解けなかった。これは観測データと矛盾しない。あと2回の倍増で手が届くかもしれない問題はわずかしかないので、10問を選んでそれに当たるとは考えにくいからである。しかし少なくとも、あと100回機会を与えさえすれば GPT-5 が正解できる問題が大量に眠っている、という可能性は排除できる。6,7
pass@手当たり次第はおそらく70%未満で頭打ちになる
GPT-5 以外のモデルや、Epoch 以外の足場ではどうだろうか。少し雑多になるが、少なくとも Epoch がこれまでに蓄積してきたさまざまな FrontierMath の実行を見ることはできる。私たちはこれを pass@手当たり次第と呼んでいる。現時点で、この「手当たり次第」の中身は次の6つの区分から集めたものである。
- 上で説明した GPT-5 の32回の実行
- Epoch のベンチマークハブにある、さまざまな開発元のさまざまなモデルの52回の実行
- OpenAI が実施し Epoch が採点した ChatGPT Agent の16回の実行
- 手作業で評価した Gemini 2.5 Deep Think の1回の実行
- 数か月前に自由な探索の一環として行った o4-mini の20回の実行
- o4-mini、Gemini 2.5 Pro、Grok 4 で実験していたときに行った、その他6回の実行
これらをすべて合わせると、pass@手当たり次第は57%、つまり290問中165問が解けたことになる。
これらの問題のうち140問は、少なくとも2つの区分で解かれている。ここから、開発元が異なるモデルどうしでも、得意・不得意の傾向はそれほど違わないと考えられる。あるモデルが解ける問題は、おそらく別のモデルも解ける。下の表は、各区分の中でだけ解かれた問題の数と、その区分全体の pass@N を示している。特に、GPT-5 の32回の実行で解けた問題のうち、それまで他のどの実行でも解かれていなかったものは1問しかなかったことに注目してほしい。
| 区分 | この区分でのみ解けた問題数 | Pass@N |
|---|---|---|
| ChatGPT Agent (N=16) | 14 | 49% |
| GPT-5 (N=32) | 1 | 46% |
| Epoch ハブの実行 (N=52) | 7 | 37% |
| o4-mini (N=20) | 1 | 33% |
| その他の実験 (N=6) | 0 | 33% |
| Gemini 2.5 Deep Think (N=1) | 2 | 29% |
この傾向から目立って外れているのは ChatGPT Agent で、他のどのモデルも解けなかった問題を14問(5%)解いた。これには明白な説明がある。ここで唯一、ウェブ検索ツールを使えるモデルだということである。FrontierMath には純粋な「調べれば済む」問題は含まれていないが、あまり知られていない知識を適切に応用して解くことを想定した問題はいくつかあるので、ウェブ検索は役に立つと考えられる。8
ChatGPT Agent は16回実行しているので、上と同じように pass@N の伸び方を見ることができる。そうすると、同様に対数以下のパターンが見られる。N を倍増したときの見返りは、倍増のたびに(絶対値で)約1%ずつ小さくなる。単純に外挿すると、さらに倍増を重ねればあと6%伸びる余地があるかもしれない。
FrontierMath ティア1〜3での ChatGPT Agent の pass@N
| N | Pass@N | 2倍による増加 | 増加の差 | 解けた問題数 |
|---|---|---|---|---|
| 1 | 27% | – | – | 80 |
| 2 | 34% | 6.9% | – | 99 |
| 4 | 40% | 5.9% | -0.9% | 117 |
| 8 | 45% | 4.8% | -1.2% | 130 |
| 16 | 49% | 4.0% | -0.8% | 142 |
pass@手当たり次第はどこで頭打ちになるだろうか。
GPT-5 と ChatGPT Agent については、すっきりした推定値がある。これらを追加で実行して得られる増加分が互いに重ならないと保守的に仮定すると、極限で7%が加わり、累計で64%になる。
その他のすべてのモデルを繰り返し再実行した場合に何が加わるかを予測する、同じくらいよい方法はない。少なくとも言えるのは、これらのモデルはこれまでのすべての実行を合わせて問題の46%を解いているが、GPT-5 も ChatGPT Agent も解けなかった問題は13問(5%)しか解いていない、ということである。つまり、これらのモデルが新たに加える多様性はかなり小さいと考えられる。ただし、これらのモデルのどれかを繰り返し再実行すれば新しい領域に踏み込む可能性も排除できない。
最終的な数字を出すために、この集団には ChatGPT Agent と同じだけ、つまり先の2つの推定のうち大きいほうと同じだけ、まだ伸びる余地が残っていると仮定する。ここでも増加分が重ならないと保守的に仮定すると、全体の上限は70%になる。
FrontierMath の最初の公開時、私たちは問題の7%に誤りがあると推定した。問題文の致命的な曖昧さや、解答集や検証スクリプトの不具合によるものである。私たちは誤りを見つけしだい集め、ベンチマークを定期的に更新しているので、この数字は時とともに下がっていく。現時点で把握している未修正の誤りは、問題の2%にすぎない。保守的に誤り率を10%とみなすと、FrontierMath の問題のうち20%が、現在のモデルの手の届かないところにある可能性が高いことになる。
解かれた57%の問題に戻ると、FrontierMath の難易度のティアごとに予想どおりのパターンが見られる。低いティアほど解かれる割合が高い。
FrontierMath でモデルが向上していくときの注目点が得られた
Epoch は最近、2030年のAIがどうなると予想するかについてのレポートを公開した。そこには FrontierMath の成績について次のような予測が含まれていた。
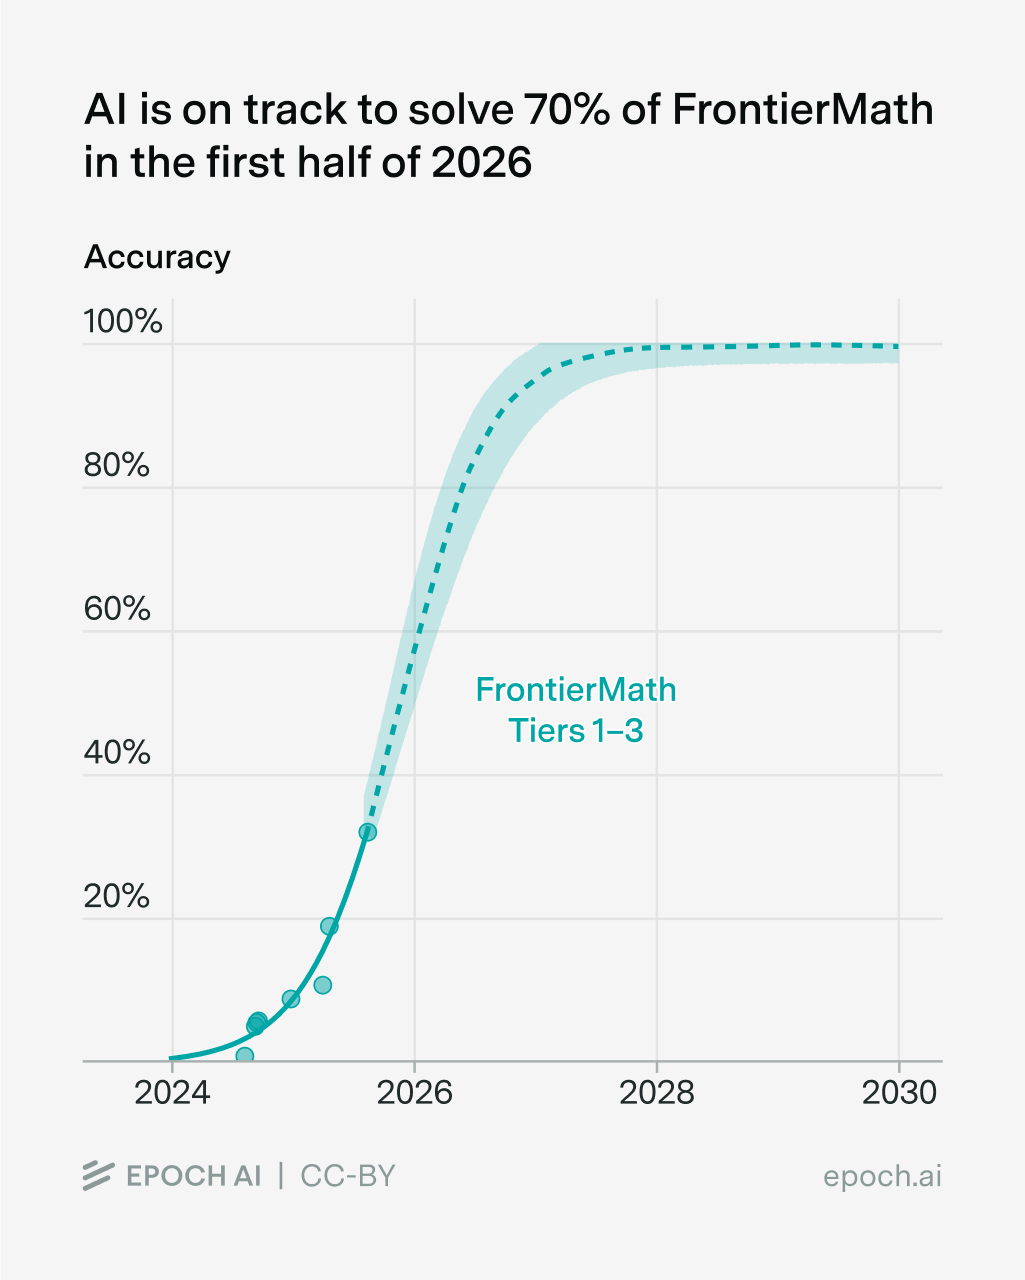
70%という成績は今日のSOTAと比べると高く見えるが、私たちの予測ではそれが来年前半に達成される。本稿の調査からすると、これはもっともらしい。何らかのモデルがほぼそれだけの数の問題を解くのを、すでに観測しているからである。追加の学習で、pass@手当たり次第で観測された成績を確実なものにできさえすれば、それだけで道のりの大半を進んだことになる。
同じ理由で、もしモデルが実際にこの成績の水準に達したときには、より精密に見るべきものが得られる。特に、増加分のうち、少なくとも一度解かれたのをすでに観測している問題によるものと、それまで一度も解かれていなかった問題によるものが、それぞれどれだけあるかを確かめられる。
両極端では、進歩の解釈は大きく異なる。増加分がすべて以前に解かれた問題によるものなら、それは純粋に信頼性の向上を表している。一方、増加分の多くがどのモデルも以前に解けなかった問題によるものなら、能力の意味のある進歩と解釈できる。
GPT-5 の実験に使った API クレジットを提供してくれた OpenAI に感謝する。本稿にフィードバックをくれた Daniel Litt に感謝する。
注
-
本稿で FrontierMath と言うときは、つねにティア1〜3の非公開問題を指す。 ↩
-
この推論は、当てずっぽうで答えたときの得点がほぼ0%になるベンチマークでしか成り立たないが、FrontierMath はそういうベンチマークである。答えはたいてい大きな整数か複雑な記号表現の実数なので、モデルがまぐれで正解することを心配せずに繰り返しサンプリングできる。 ↩
-
これらの実行は、通常の足場の10倍のトークン予算で行った。現在ベンチマークハブに表示している実行では、GPT-5 は25%を記録したが、問題の3%で足場の10万トークンの予算を超えていた。10倍のトークン予算を与えてみたところ、29%を記録し、予算を超えることは一度もなかった。今回の実験では、標準の足場を標準の10倍のトークン予算で使った。今後、足場の全般的なトークン予算を引き上げる予定である。 ↩
-
これらの実行は GPT-5(high)で行うつもりだったが、評価基盤の不具合により、実際には GPT-5(medium)で行われていた。標準の足場での FrontierMath ティア1〜3の得点は、修正後の GPT-5(high)が27%、GPT-5(medium)が25%である。GPT-5(high)を使っていたとしても、本稿の全体的な結論は変わらないと私は考えている。特に、(後で論じるように)GPT-5(medium)の32回の実行すべてで、他のどのモデルの実行でも解けなかった問題を1問しか解けなかったことから、GPT-5 にはそれほど伸びる余地が残っていないと考えられる。それでも、GPT-5(high)の漸近値が GPT-5(medium)より数ポイント高い可能性は十分にある。 ↩
-
とはいえ、これが非常にゆっくり増えるものの上限のない関数、たとえば小さな c に対する c*log(N) や log(log(N)) である可能性は排除できない。 ↩
-
もちろん、こうした実験は一般に、p(solve)=0 と p(solve)=小さな値 を区別するだけの検出力を持たない。問題を解くのに k ステップが必要で、GPT-5 が各ステップを正しく行う確率を p と大まかにモデル化すると、p(solve)=p^k となる。k=10、p=½ の問題では、GPT が709回のサンプルでそれを解く確率は約50%である。私はこの問題も「手の届く」ものに数えたい。 ↩
-
これらの問題は、他のどのモデルの実行でも解けなかった問題の中から選んだ。これらの実行については本稿の後半で詳しく論じる。 ↩
-
これを追加する実験を予定している。 ↩