
ニュースレター
古典的な推論ベンチマークよ、安らかに眠れ。次は何か?
原題:RIP Classic Reasoning Benchmarks. What's Next?
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
推論ベンチマークにはおなじみの作り方がある。タスクはテキストのみ、出力は採点しやすく、人間の専門家なら数時間でこなせる、というものだ。残念ながら、この作り方はもう時代遅れになった。象徴的な例として GPQA を考えよう。大学院レベルの科学の問題からなるベンチマークである。驚くほど長く使われてきたが、今では明らかに飽和している。
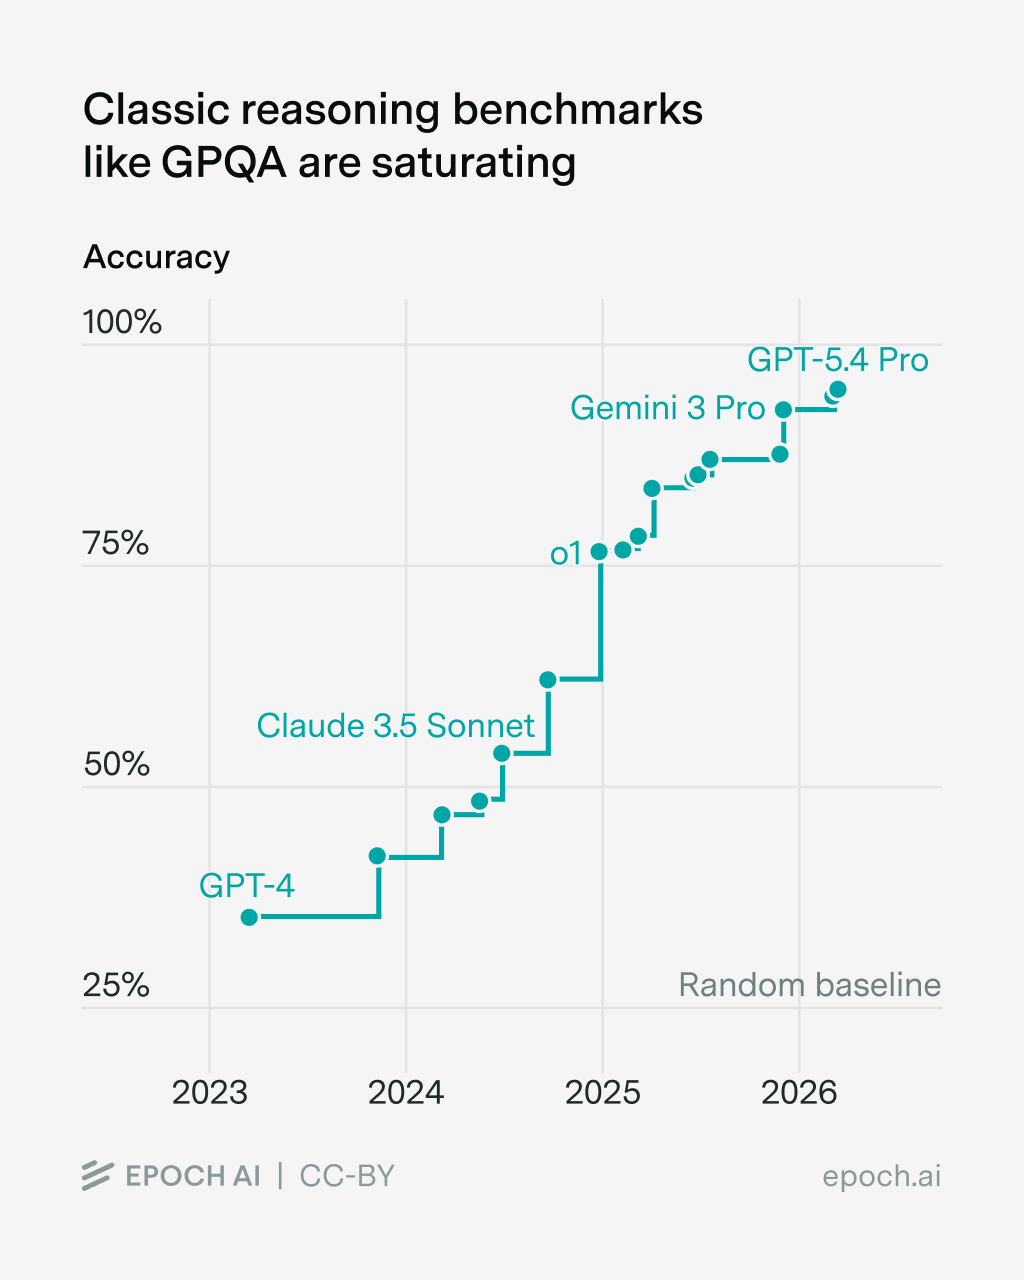
科学でも数学でもコーディングでも、古典的な推論ベンチマークの多くについて同じことが言える。次は何か。古い作り方が新しい作り方を指し示していると私は思う。テキストのみ、採点しやすい、短いタイムホライズン、人間の専門家のほうが上、という要素のどれか一つを緩めればよいのだ。どの方向も追求する価値がきわめて大きく、飽和にはほど遠いと思う。代償は、そうしたベンチマークを作るのに時間とお金が余計にかかることだけである。
Epoch AI の最新情報を受け取る 購読する
古典的な形式のまま、マルチモーダルにする
正確に言うのは難しいが、私の目には、AIの視覚的・空間的な推論はテキストのみの推論に後れをとっているように見える。今も急速に伸びてはいるが、出発点が低い。いずれにせよ、意味のあるマルチモーダルな推論ベンチマークを作るのは、今でも比較的易しいようだ。
一例を挙げよう。最近の Epoch のチーム合宿で、私たちはIKEAの家具を一つ注文し、部品をすべて並べてラベルを付け、AIシステムに組立説明書を渡して、各部品が説明書のどの手順で初めて使われるかを答えさせた。トップクラスのモデルの正答率は40%前後だった。1
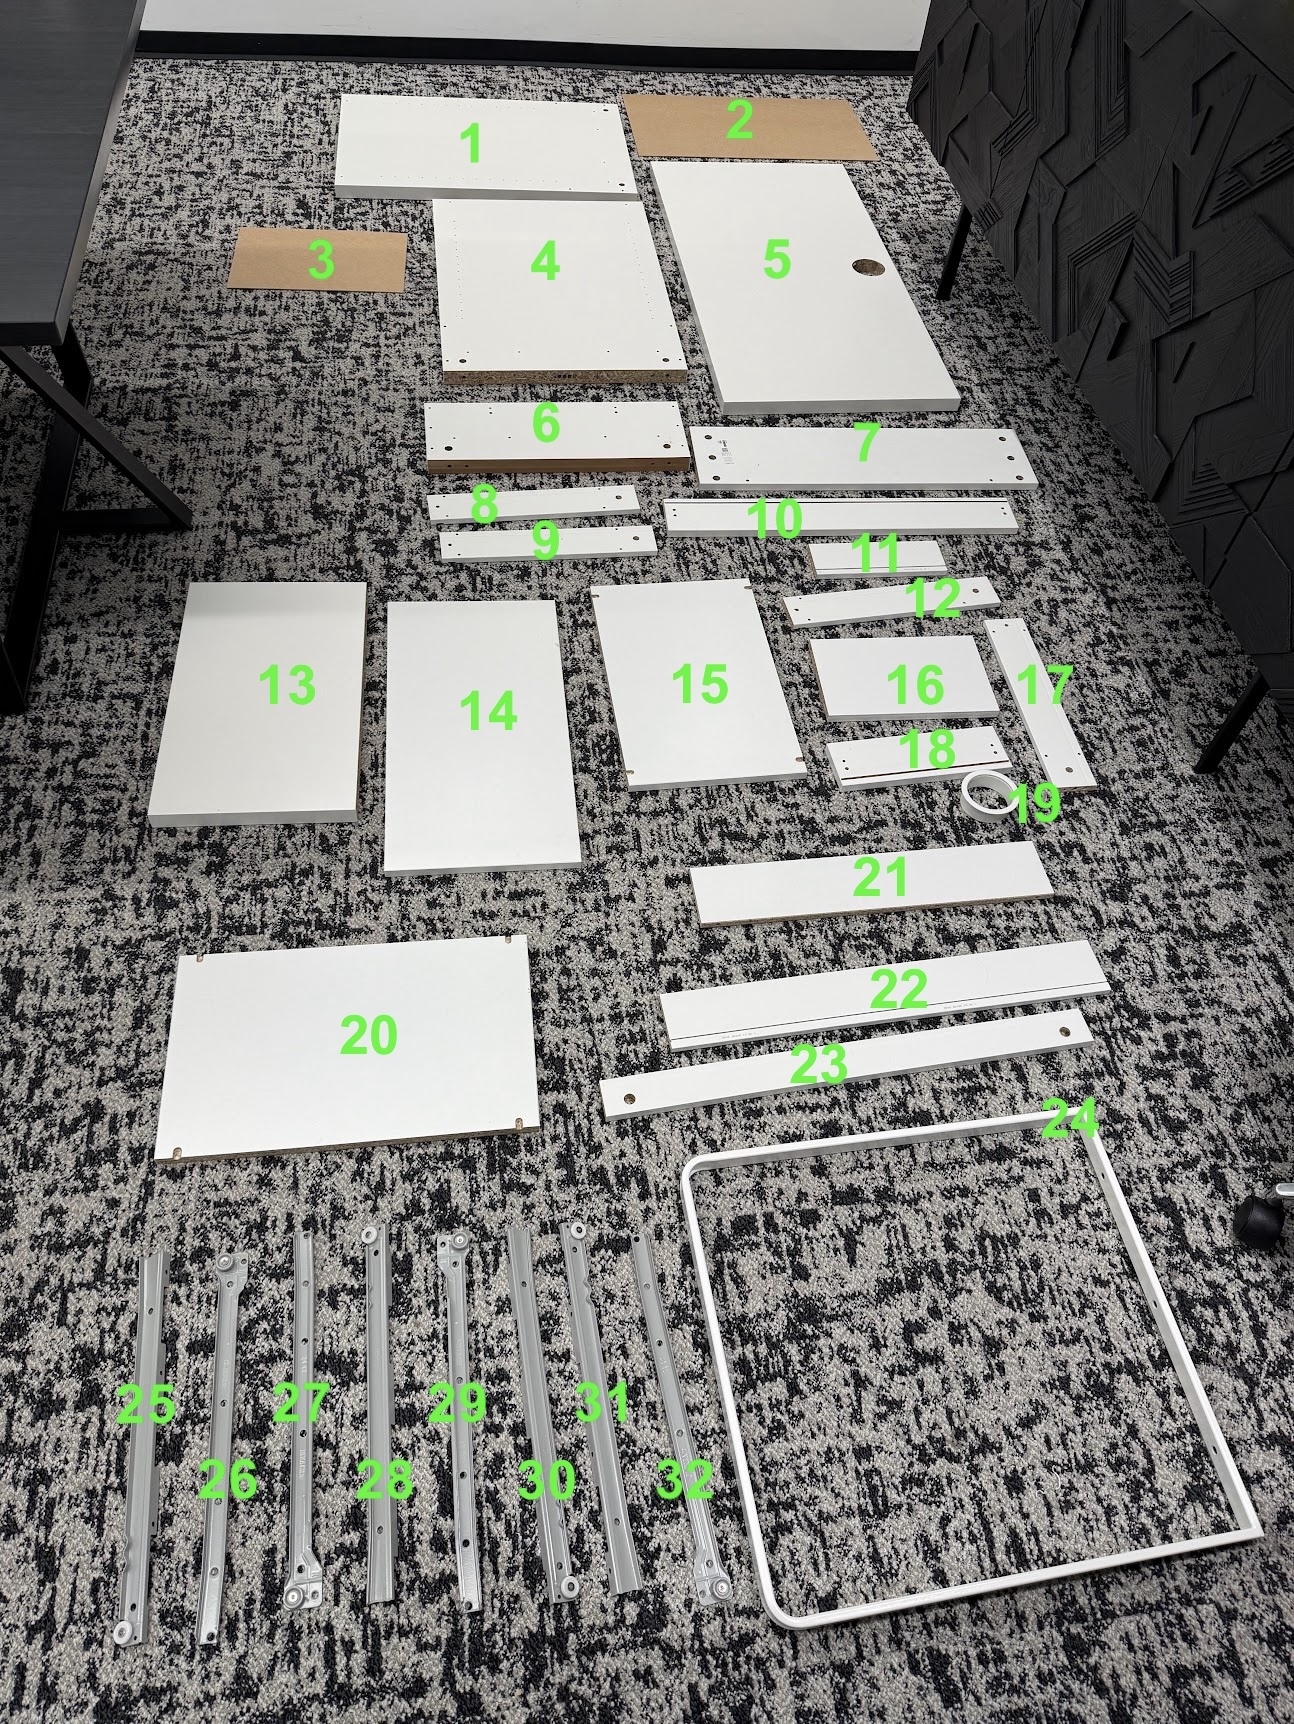
6番のラベルを付けた部品が初めて使われるのはどの手順か。AIシステムには答えられない。
採点しやすく、比較的短いタイムホライズンで人間がAIに勝つという点では、これはまだ「古典的」なベンチマークである。また、より広く重要なタスクに関係する能力を試しているとも言えそうだと考えている。少なくともマルチモーダルなタスクについては、一人が1週間楽しんで取り組むだけで、今でも面白いベンチマークを作れる。ほかの例としては SpatialBench や IRGB がある。ARC-AGI やほかのビデオゲームのベンチマークもこれに当てはまると言えるだろう。
古典的な形式のまま、タイムホライズンを延ばす
第一世代の「長文脈」ベンチマークは、モデルのコンテキストウィンドウをデータで埋め(多くは少なくとも一部を合成で生成したもの)、多くの場合ツールなしでそのデータを処理させるものだった。これは、多くの話の筋を同時に追うモデルの「素の」能力を測っていた。こうしたベンチマークのなかには、まだいくらか伸びしろが残っているものもある。だが、Anthropic がスコアを報告したこの種のベンチマークの一つでは、それまでのスコアが40%未満だったところ、Claude Mythos は80%に跳ね上がった。2この種の長文脈ベンチマークは、役目を終えつつあるのかもしれない。
それでも、長い時間を要する推論中心のベンチマークには、まだ伸びる余地があると思う。私が特に関心をもっている方向の一つはゲームである。多くのゲームにはマルチモーダルな側面がかなりあるが、なかには、Magic: the Gathering のようなカードゲームを中心に、その側面が比較的少ないのに、戦略面でも戦術面でも高度な推論を求めるものがあると思う。1回のゲームは必ずしも長くないが、より適切な単位は、連続して何回も行うゲームかもしれない。結局のところ、人間はそうやって何回も遊ぶなかでゲームに上達する。AIにも同じことができるのだろうか。これについての既存の証拠は否定的だと思うが、意外なほど断片的だ。ベンチマークを作れば、この点の見通しがよくなるだろう。
非常に長い期間にわたるソフトウェア工学のプロジェクトも、まだ掘り尽くされていないかもしれない。同僚たちが最近書いたように、人間なら数週間かかりうるソフトウェア工学のタスクの一部は、AIシステムの手の届く範囲にあるようだ。これらは仕様がきわめて正確に定められているので、実行時に少しずつ改善を重ねていくやり方に特に向いたタスクである。それでも、この難しさの尺度の難しいほうの端は、飽和しないまま残るのではないかと思う。AIシステムは、広く使われている人間の実装と同じくらいよく動き、同じくらい効率的なCコンパイラを実装できるだろうか。できるかもしれないが、試してみる価値はある。
採点しにくい出力を受け入れる
ベンチマークの世界で、これは決して不人気な意見ではない。現実に意味のあるタスクには、短い形で正誤を判定できる答えがないことが多いのは当然だ。これは、推論の比重が大きいタスクでも変わらない。たとえば同僚の Anson は最近、AIに自分の仕事をさせてみた経験について書いた。彼が選んだタスクのうち二つは、複雑な経済モデルのインタラクティブなWebインターフェースを再現することと、与えられたデータセットを分析して結果について出版に値する記事を書くことだった。
誰もがこれを知っているのにこの分野がその方向へなかなか動かないのなら、必要なのは、こうした評価をもっと定期的かつ厳密に行う慣行にするための、少しの協調だけなのかもしれない。だから私は、CRUX の結成を心強く思った。「成功をきれいに定めることも自動で採点することもできない、現実世界の環境」で評価を行う研究者の共同体である。彼らは、Anson のような過去の単発の実験もうまくまとめている。
この領域は、見かけほど新しくはない。まさにこの種の評価の初期の例が、2025年の国際数学オリンピック(IMO)で行われた。AIの解答は、人間の解答と同じ基準を使って公式の審査員が採点した。つまりこのAIのベンチマークは、数十年かけて作り上げられ磨かれてきた、IMOの解答を採点するという人間の既存の慣行に便乗したのだ。これがあまりに順調に進んだので、ベンチマークとしていかに異例だったかについての論評は比較的少なかった。
これは、ますます高度になるAIの出力を評価する良い方法を示していると思う。人間がすでに互いの仕事を審査している既存の慣行に接続するのだ。AIシステムは、機械学習の学会で最優秀論文賞を取れるだろうか。ロー・レビューに論文を載せられるだろうか。短編小説のコンテストで優勝できるだろうか。科学、法律、報道、エンターテインメントなど、書かれたものを審査することが中心にある職業と協力すれば、今あるものより雑然としているが多くの点でより多くを教えてくれるベンチマークがたくさん生まれうる。
人間の専門家の能力をはるかに上回る水準を狙う
科学・技術分野のベンチマークは、人間のトップクラスの専門家の成績を目標にすることが多い。AIシステムはまだそうしたベンチマークのすべてを飽和させたわけではないが、進歩は急速である。ついにそうなったとき、私たちはどこへ向かえばよいのか。いくつかの場合には、人間がやり方を知らないタスクを出せばよい。採点のしやすさを手放す必要さえない。
これはまさに、私たちが FrontierMath: Open Problems で行ったことだ。人間が解こうとして解けなかったが、解答をプログラムで評価できる、未解決の数学の問題を見つけるのである。こうした問題を考え出すのは決して簡単ではないが、いったん考え出せば大規模に実行できる。単純な正答率の指標にはなじまないかもしれないが、良い面としては、ベンチマークの各タスクがそれ自体で価値のある事例研究になる。
幅広い種類の最適化問題もこれに当てはまる。人間のベースラインがあるかもしれないが、そのベースラインに達したからといってベンチマークが飽和したとみなす必要はない。この方向のすでに優れた研究としては、AIシステムが機械学習モデルをどれだけ効果的に事後学習できるかを問う PostTrainBench、AIシステムが制約充足のエンジンをどれだけうまくプログラムできるかを問う ALE-bench、AIシステムが汎用の数値計算プログラムをどれだけ高速化できるかを問う AlgoTune がある。
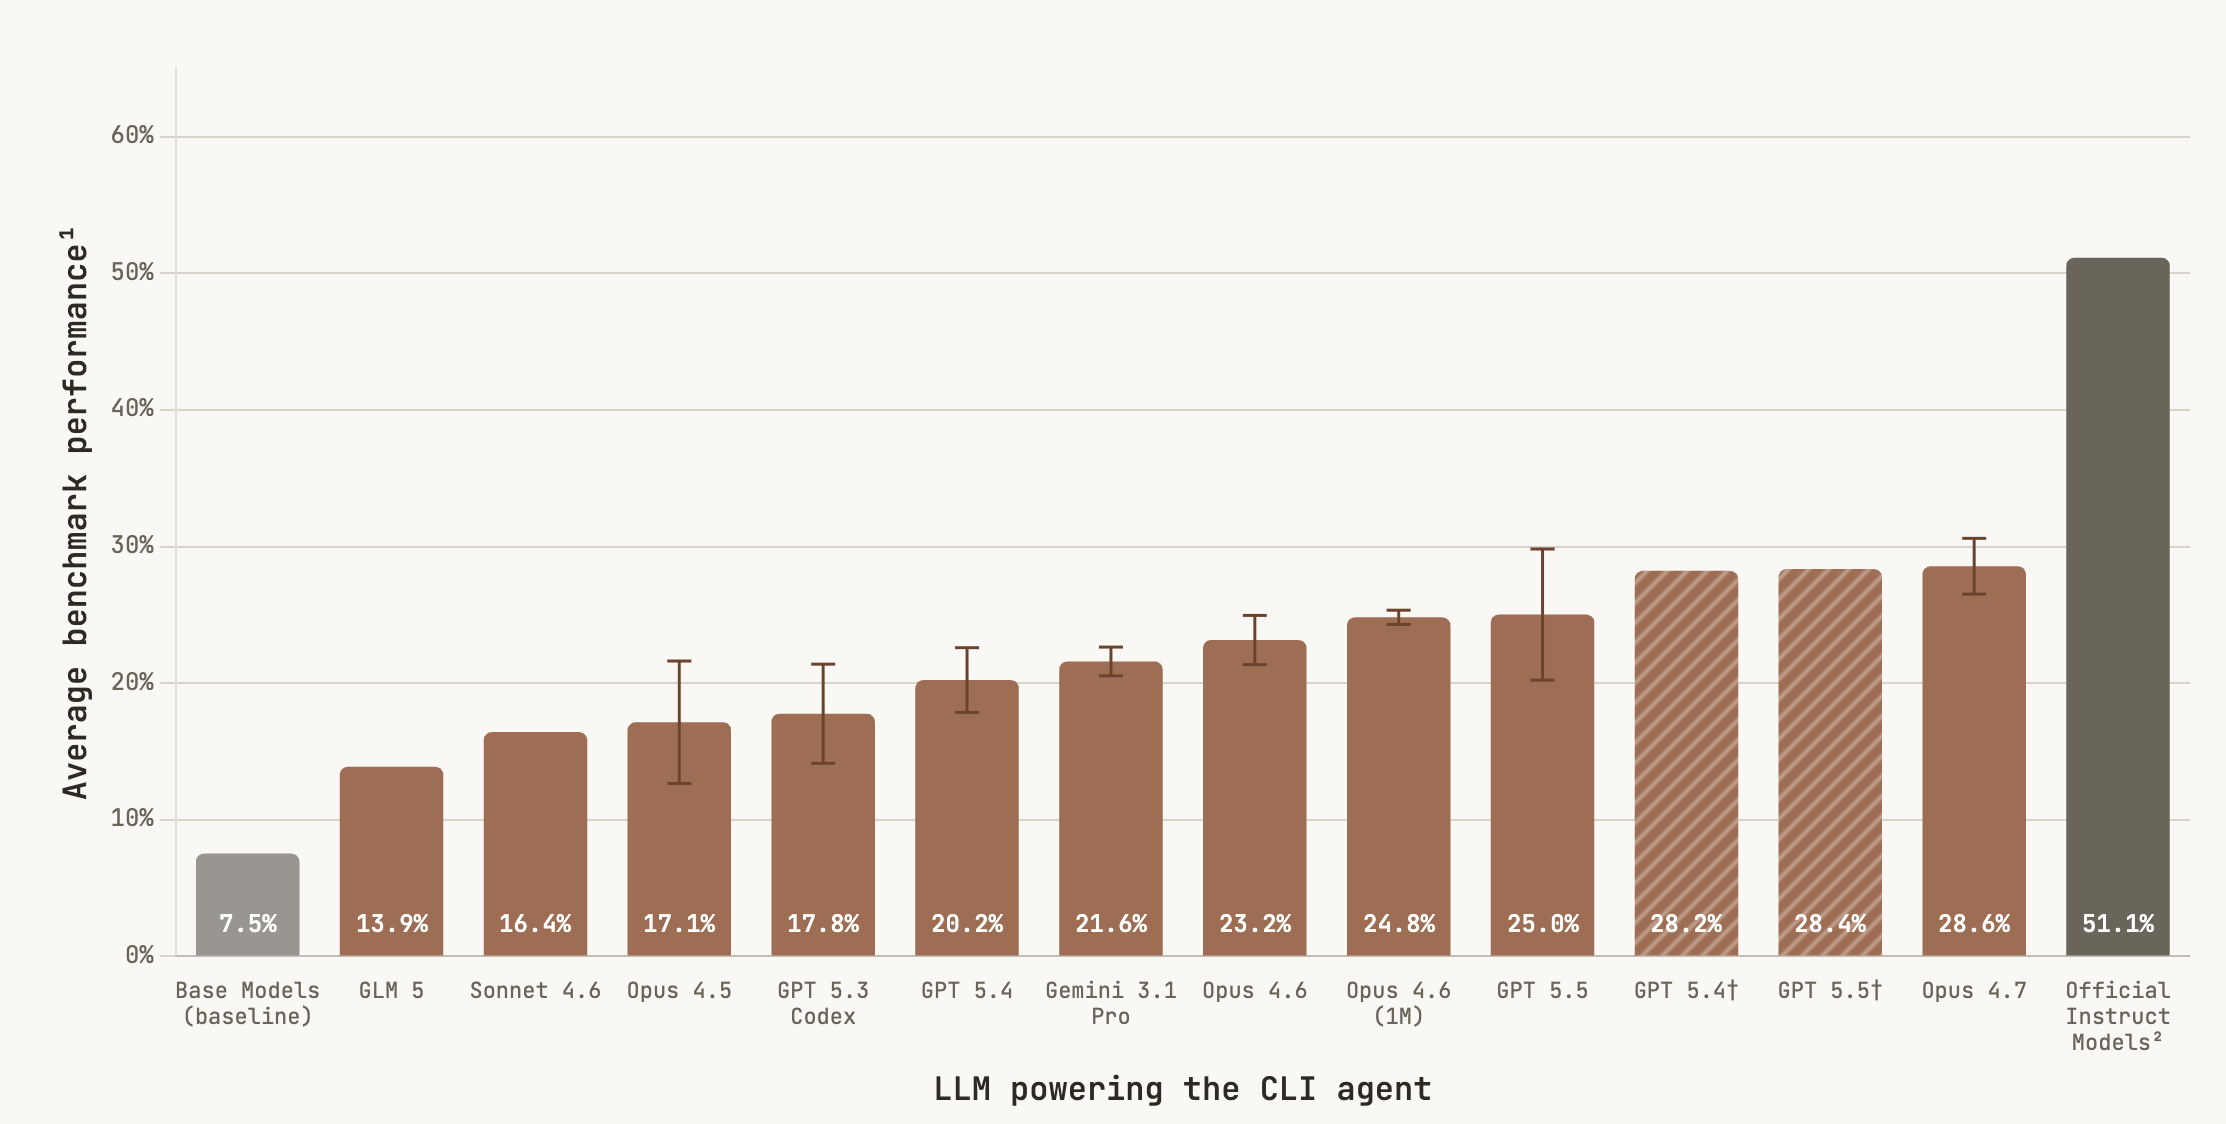
PostTrainBench の結果。51.1%で止まる理由はない!
ある意味で、こうしたベンチマークは常に意味をもち続ける。仕事をするのがすべてAIだとしても、資源の最適化の問題は常にあるからだ。
常識はどうか?
高度な推論がこれだけ話題になっているのに、GPT-5.5 Pro は今でも、私のお気に入りの GSM8K の問題をしょっちゅう間違える。
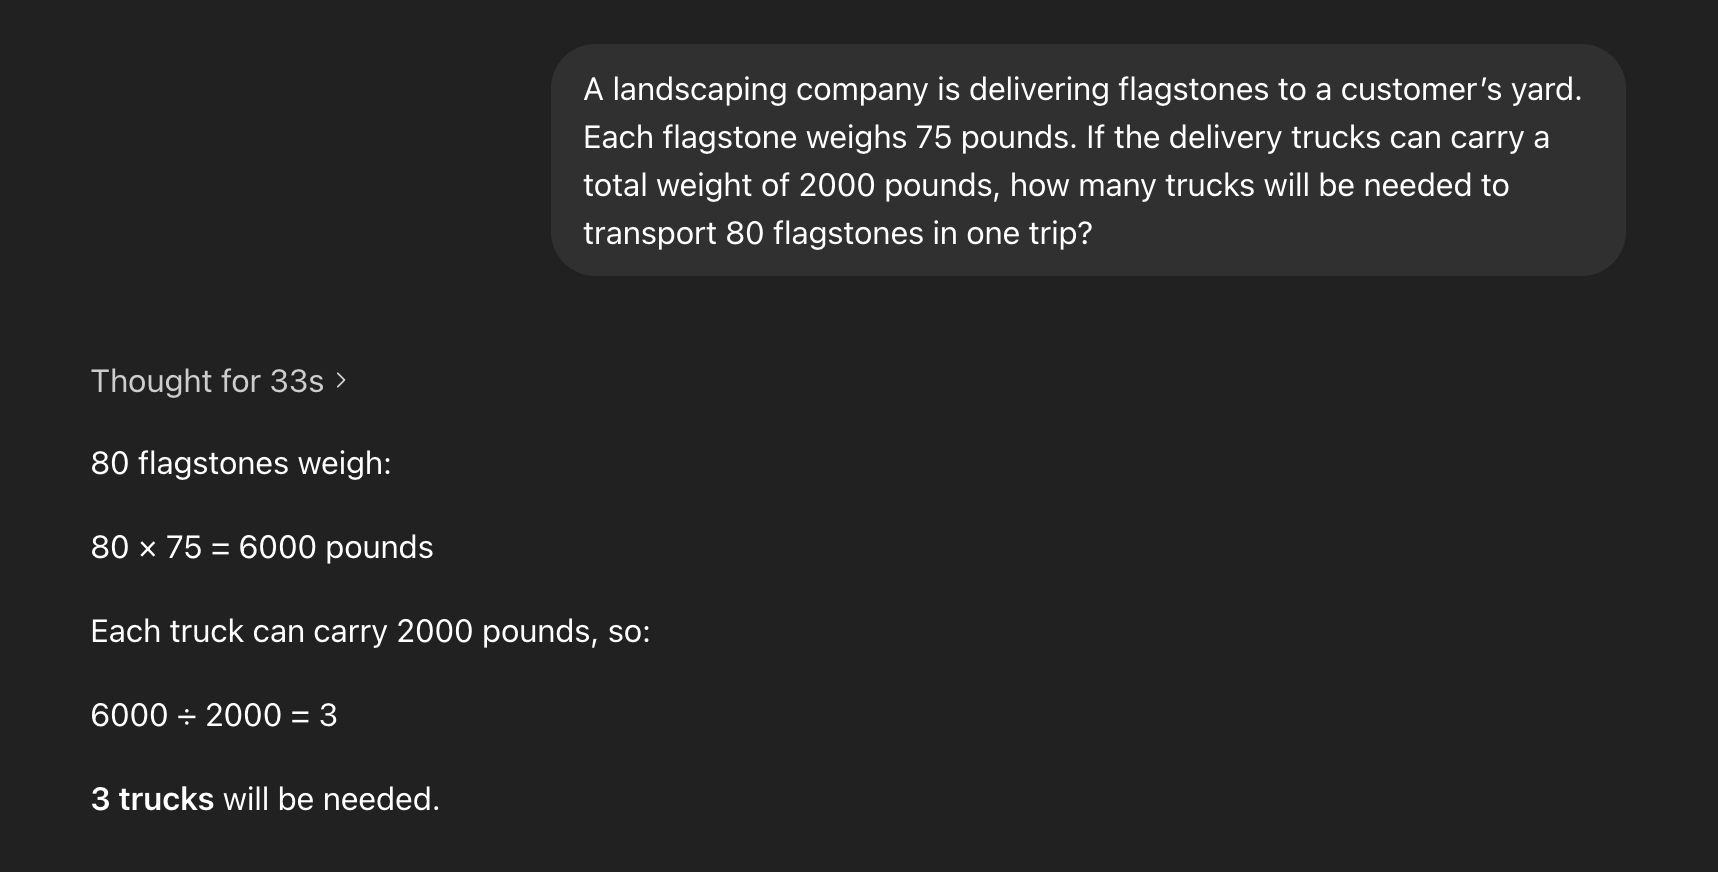
これはいわば引っかけ問題だが、そう意図されたものではなかったのではないかと思う。人間も間違える。完全に孤立した例というわけでもない。たとえば一部のモデルは、車を洗ってもらうのに近くの洗車場まで(車ではなく)歩いて行くよう勧める。これをどう考えればよいのか。
こうした例は、人間の認知バイアスにいくぶん似ている。たいていは、あまりよく考えなかったせいで問題を間違える、という形をとる。私の個人的な感覚では、こうした例は見つけにくくなってきている。この種のものを体系的に測ろうとする試みの一つである SimpleBench では、この1年半のあいだにモデルの成績が人間の平均的なベースライン近くまで上がってきた。
こうしたベンチマークが完全には飽和しないなら、AIは決して間違えないといった最も強い主張に水を差すことになるだろう。とはいえ、実用上の意味は限られていると思う。より大きな現実世界のタスクをこなすなかでこうした「引っかけ」が生じたとしても、AIシステムは、最初の一回でなくとも、自分の誤りに気づくのがうまくなっていくと思う。
推論ベンチマークはまだ死んでいない
AIシステムが有能になるにつれて、現実世界で実際の結果をもたらすエンドツーエンドのタスクだけでベンチマークしたいという誘惑が強まっている。そうすることには価値があると思う。また、AIシステムがそうしたあらゆる場面で「ただうまく動く」わけではないことも明らかだと思う。すると、AIシステムはいったいなぜ失敗するのか、という問いが残る。考えられる失敗の仕方の一つは、途中で出くわす問題を推論で解き進められないことだ。そう考えると、推論ベンチマークにはまだ果たすべき役割があると思う。
ただし、私たちが作るベンチマークは、モデルがまだ苦戦する場面を見つけるという課題に応えなければならない。私の作り方はすでに示した。テキストのみ、短いタイムホライズン、採点しやすい、人間の専門家のほうが上、のうち少なくとも一つを手放すことだ。これによってベンチマーク作りはより難しくなるが、かつてなく面白くもなる。
注
-
しっかりした人間のベースラインはないが、私たちの簡単な試験からは、人間なら30分よりずっと短い時間でこなせることがうかがえる。 ↩
-
このベンチマークは GraphWalks である。Mythos のスコアはシステムカードの表6.3.Aを参照。 ↩