
レポート
Gemini 2.5 Deep Think の数学能力を評価する
原題:Evaluating Gemini 2.5 Deep Think's math capabilities
はじめに
私たちは Gemini 2.5 Deep Think(以下 Deep Think)の数学能力を評価した。これは、国際数学オリンピック(IMO)で金メダル相当のスコアを出したモデルの、一般公開版である。その強みと弱みは、絶対的に見て、また他のモデルと比べてどうなのか。本評価は、私たちの知るかぎり、このような「高計算量」のモデル設定について、これまでに第三者が行った評価のなかで最も包括的なものである。
注:この作業は Google の依頼で行ったが、成果物の編集権は Epoch が保持している。私たちはモデル開発者向けのサービスとして、時宜を得た詳細な評価を提供している。詳しくは info@epoch.ai までメールでお問い合わせいただきたい。
要旨
- Deep Think は FrontierMath の Tier 1〜3(29%)と Tier 4(10%)で最高記録を更新した。深い背景知識と計算の正確な遂行を必要とする、短答式の数学問題を解く能力が向上したことを示している。(該当節)
- 2人のプロの数学者は、Deep Think を全般に役立つ研究アシスタントであり、利用できる最良のモデルとおおむね同等だと評した。(該当節)
- このバージョンの Deep Think は2025年の IMO で銅メダル相当のスコアを得ているが、より高い創造性や込み入った証明を必要とする IMO の問題を解く様子は見られなかった。(該当節)
- Deep Think の幾何問題への取り組み方は、他のモデルより概念的であるように見え、座標系に頼る度合いがはるかに小さい。(該当節)
- ある例では、Deep Think は小学生向けの文章題に誤答し、人間の古典的な認知バイアスを思わせる誤りを犯した。(該当節)
- 以上の調査のあちこちで、Deep Think が数学文献を誤って引用する例が何度も見られた。出典が存在しないか、述べた結果がその出典に含まれていなかった。(例は次の各節にある:1、2、3)
方法
モデル。 Deep Think のモデルカードはこちらにある。API が提供されていないため、Deep Think には Gemini アプリからアクセスした。なお、私たちが評価したモデルは、IMO で金メダル相当のスコアを出したモデルそのものではない。評価したのは一般公開版のモデルで、Google はこれを IMO 金メダルモデルの「派生版」と説明している。Gemini アプリ経由で使う場合、このモデルは内部でコード実行とウェブ検索のツールを使える。
データ。 FrontierMath ベンチマークでは、Deep Think をすべて手作業で評価した。また、有益だと考える他のベンチマークから選んだ問題でも成績を評価した。さらに、2人のプロの数学者にモデルを使ってもらい、所見を寄せてもらった。
限界。 私たちの評価は、数学をするうえで重要な能力をすべて測っているわけではない。たとえば、Deep Think が興味深い予想を立てられるか、既存の結果を一般化できるか、ある分野の手法を一見無関係な別の分野に応用できるかについては、あまり言えることがない。こうした能力を測るには、新しい評価手法を開発する必要がある。
FrontierMath での成績は、背景知識と複雑な計算の遂行での進歩を示している
FrontierMath は Epoch AI が開発したベンチマークである。学部上級から研究者の駆け出しレベルまでの難しさにわたる、350問の数学問題からなる。問題は4つの Tier に分かれ、Tier 1〜3 がこの範囲全体をカバーし、Tier 4 は飛び抜けて難しい研究レベルの問題50問からなる。問題の最終解答は短い形式で、たいていは整数か記号で表した実数であり、モデルは正しい最終解答を出せたかどうかで採点される。問題はこのベンチマークのために新しく作られたもので、公開されているのはサンプル問題12問だけである。本レポートの統計分析には、非公開の338問だけを含めている。
ほとんどのモデル開発者も公開サンプルの12問にしかアクセスできないが、FrontierMath に資金を提供した OpenAI はより広くアクセスできる。Tier 1〜3 の300問のうち、OpenAI は全問の問題文と、247問の解答を持っている。Tier 4 の50問のうち、OpenAI は30問の問題文と解答を持っている。1
Deep Think は FrontierMath の Tier 1〜3 で29%、Tier 4 で10%を記録した。これは最高水準の成績である。評価は手作業で行い、単純なプロンプトのテンプレートを使い、会話は1往復だけとした。詳しくは付録を参照してほしい。
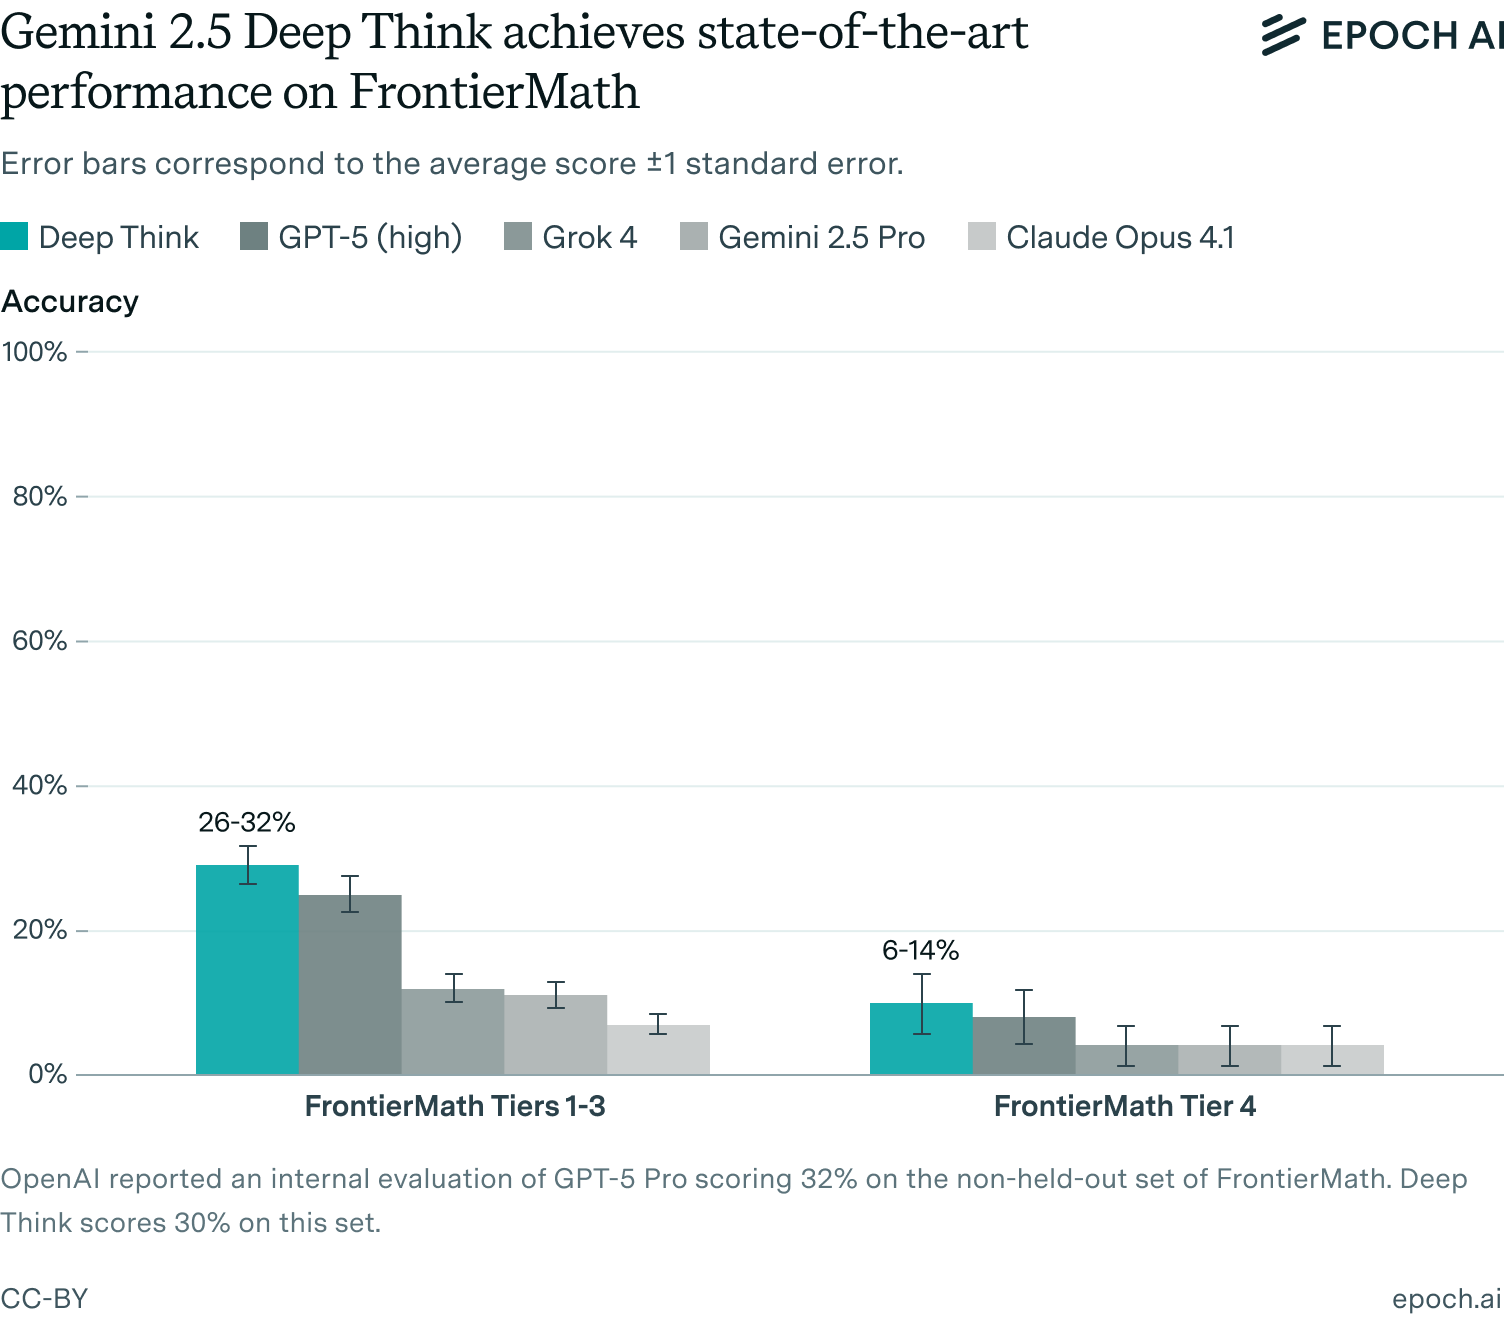
では、Deep Think が FrontierMath で進歩したことは何を意味するのか。FrontierMath が試すのは、深い背景知識と、込み入った計算の遂行である。創造的な問題解決も試すよう設計されているが、こちらがどこまでうまくいっているかははっきりしない。背景知識と創造性はある程度まで互いに代わりがきくからである。先行研究をよく知っているほど、自分で(改めて)発明しなければならないことは少なくなる。FrontierMath の問題を解くのに必要な手法は、膨大な数学文献のどこかで論じられていることが多い。問題の作成者がそれに気づいていない場合でもそうである。2
これは直観的な見方だが、データによっても裏づけられている。FrontierMath の Tier 1〜3 を作成した際、私たちは問題の作成者に、各問題が背景知識、正確な遂行、創造的な問題解決をどの程度必要とするかを(1〜5の尺度で)評定してもらった。Deep Think を含め、これまで評価したほとんどのモデルは、必要な正確さと背景知識の点で負荷が高いと評定された問題ほど成績が悪かった。モデルの成績と問題の創造性の評定とのあいだにも負の相関があったが、この相関はずっと弱かった。とはいえ、背景知識と正確さについても相関はそれほど高くなく、これはこうした概念を標準化することの難しさを反映している。
Deep Think の成績と問題の評定
| 観点(1〜5) | 相関 | p値 |
|---|---|---|
| 背景知識 | -0.22 | <0.00001 |
| 正確さ | -0.24 | <0.00001 |
| 創造性 | -0.09 | 0.07 |
したがって私たちは、Deep Think が FrontierMath で進歩したことは、関連する数学の知識が増え、その知識を動員して必要な計算を正しく正確に遂行する能力が向上したことで最もよく説明できると考えている。3
いずれにせよ、Deep Think は FrontierMath のより難しい問題を解くのに必要な技能をまだ身につけていない。あらゆる点を考慮した難しさの評価である Tier 全体で見ると、Deep Think が解けたのは最も易しい Tier の問題のおよそ半分にとどまり、Tier が難しくなるほど解けた問題は減った。
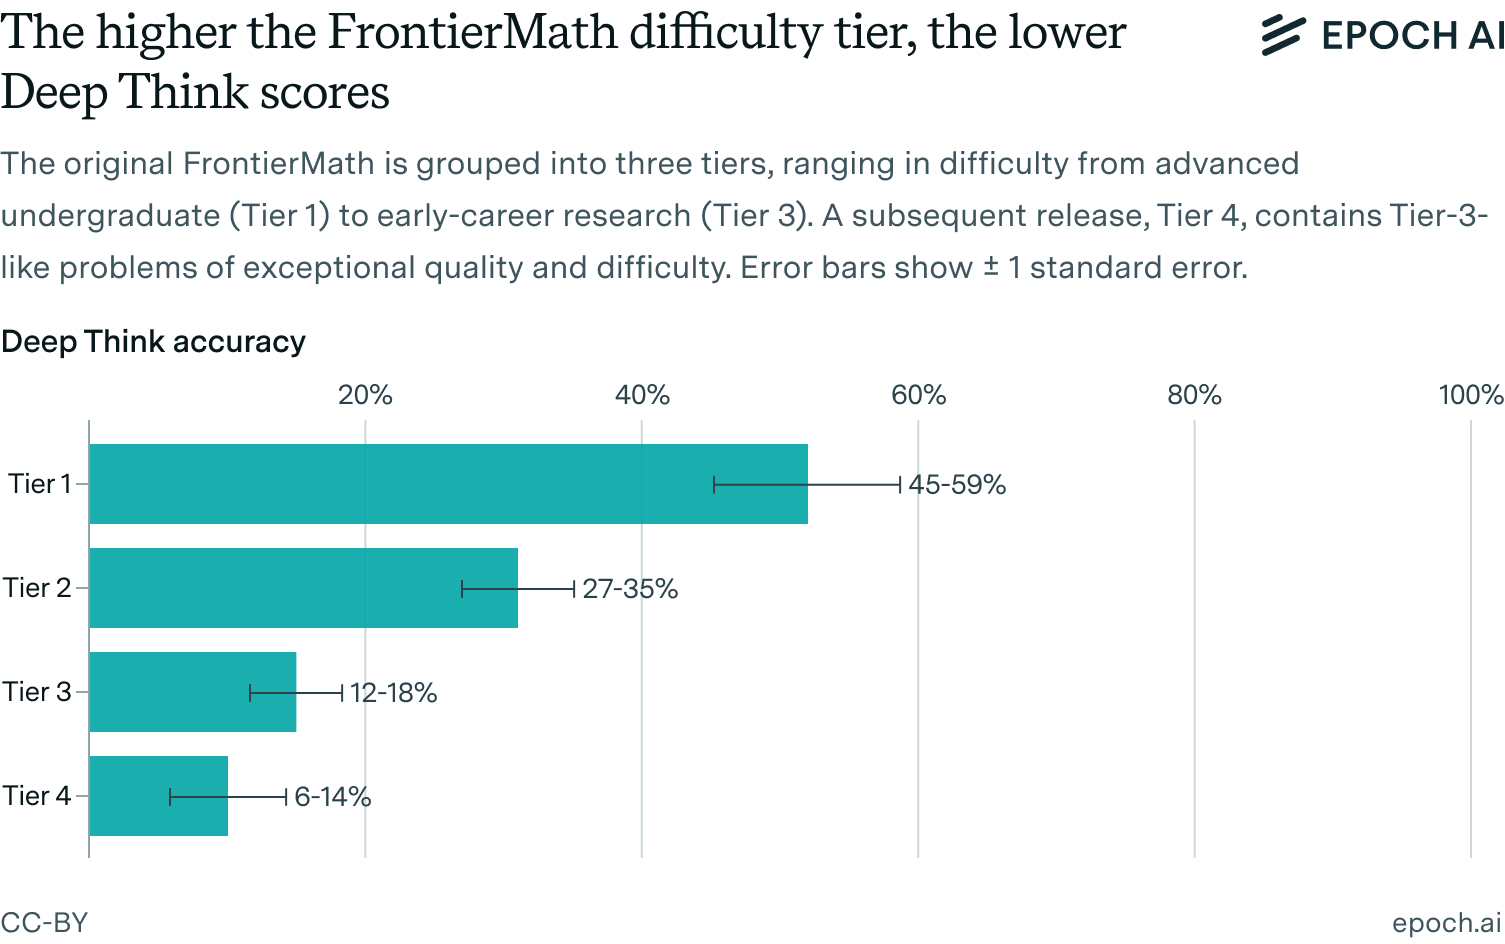
同じパターンは、GPT-5 など他のモデルの成績でも見られている。
FrontierMath は非公開なので、詳しい例をたくさん示すことはできない。幸い、Deep Think は、公開サンプル問題の一つの変種を解いたモデルとして、私たちが確認した最初のものの一つである。4 さらに、Deep Think がこの問題を解くやり方は、上で述べた能力をうまく例示している。なお、この問題は、FrontierMath の下位の Tier で私たちが狙う難しさよりも少し素直だが、それでも Deep Think の進歩の性質を明らかにしてくれる。
問題は次のとおりである。
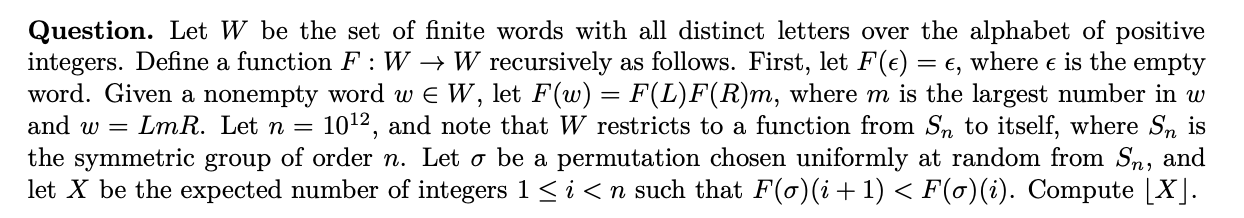
解くには、記述された関数がスタックソート写像として知られていること、そして求める量が降下統計量として知られていることに気づく必要がある。次の段階には二つの道がある。Defant (2020) の公式が使えることに気づくか、さもなければその公式を導き直すかである。いずれにせよ、この結果が手に入れば、素直な計算で答えが出る。
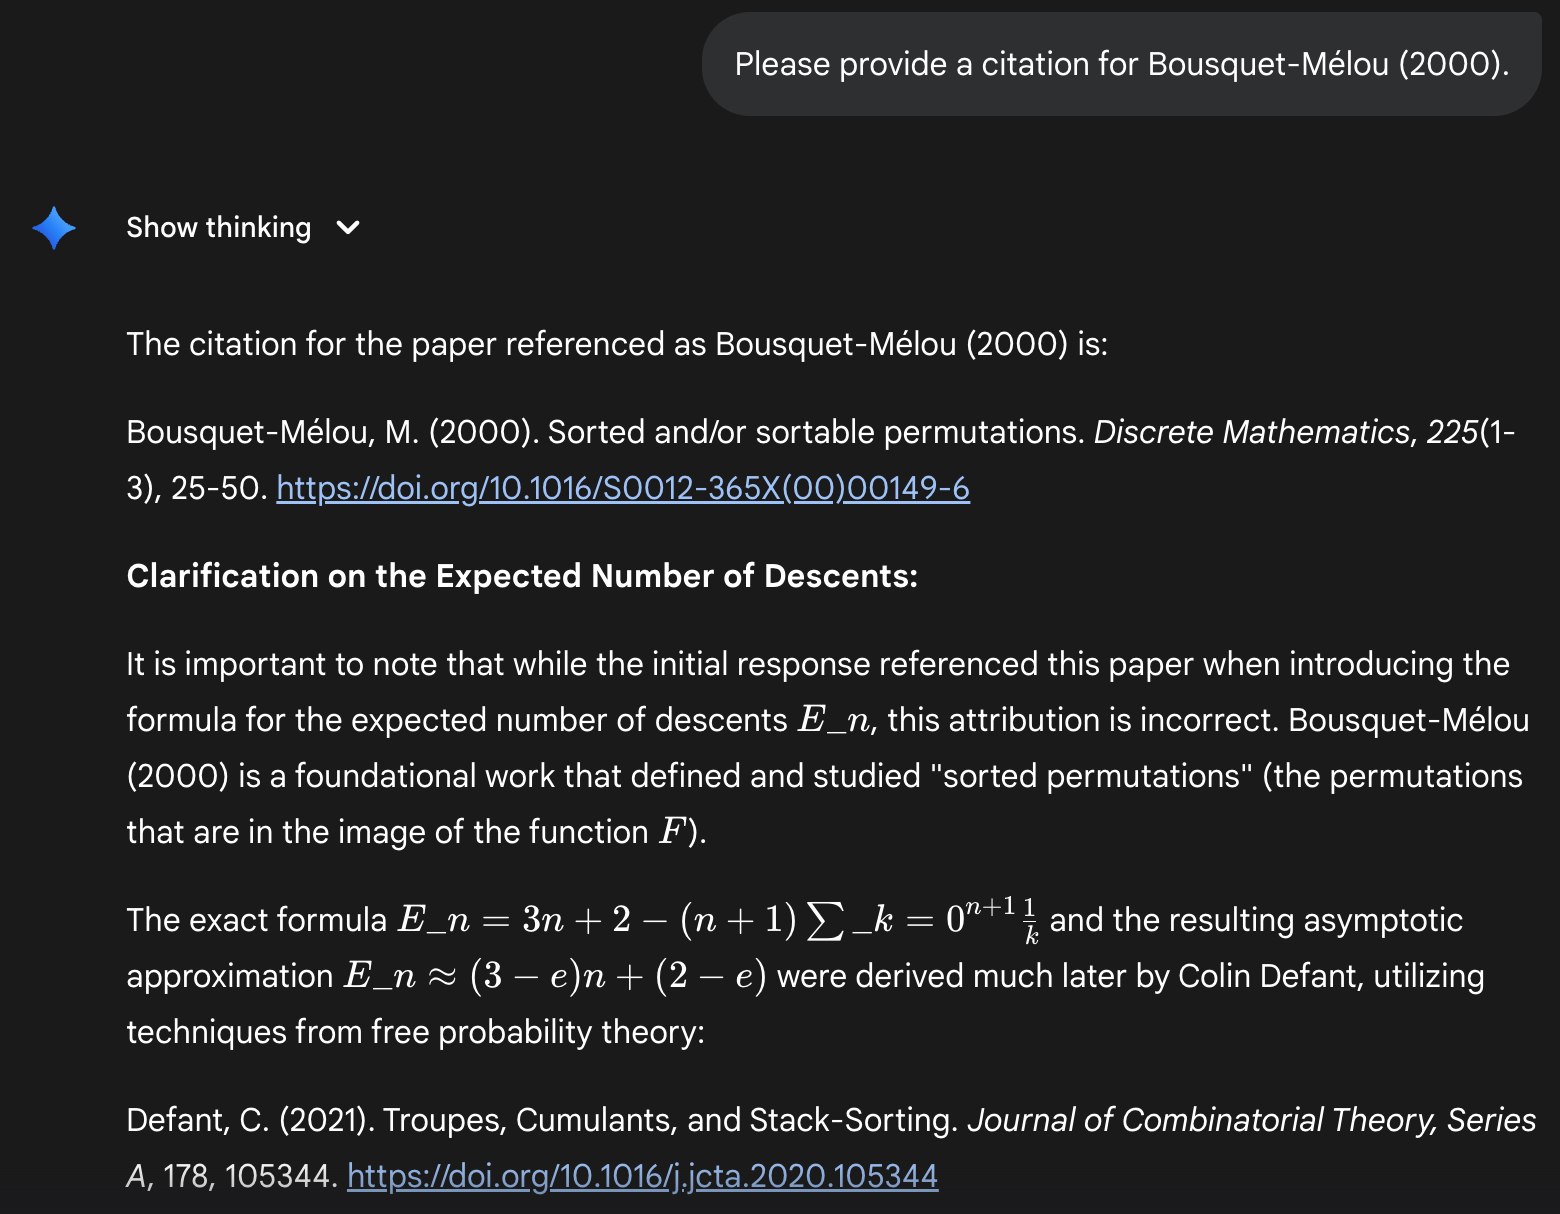
次に示すのは、Deep Think が一つ目の道をたどった例である。
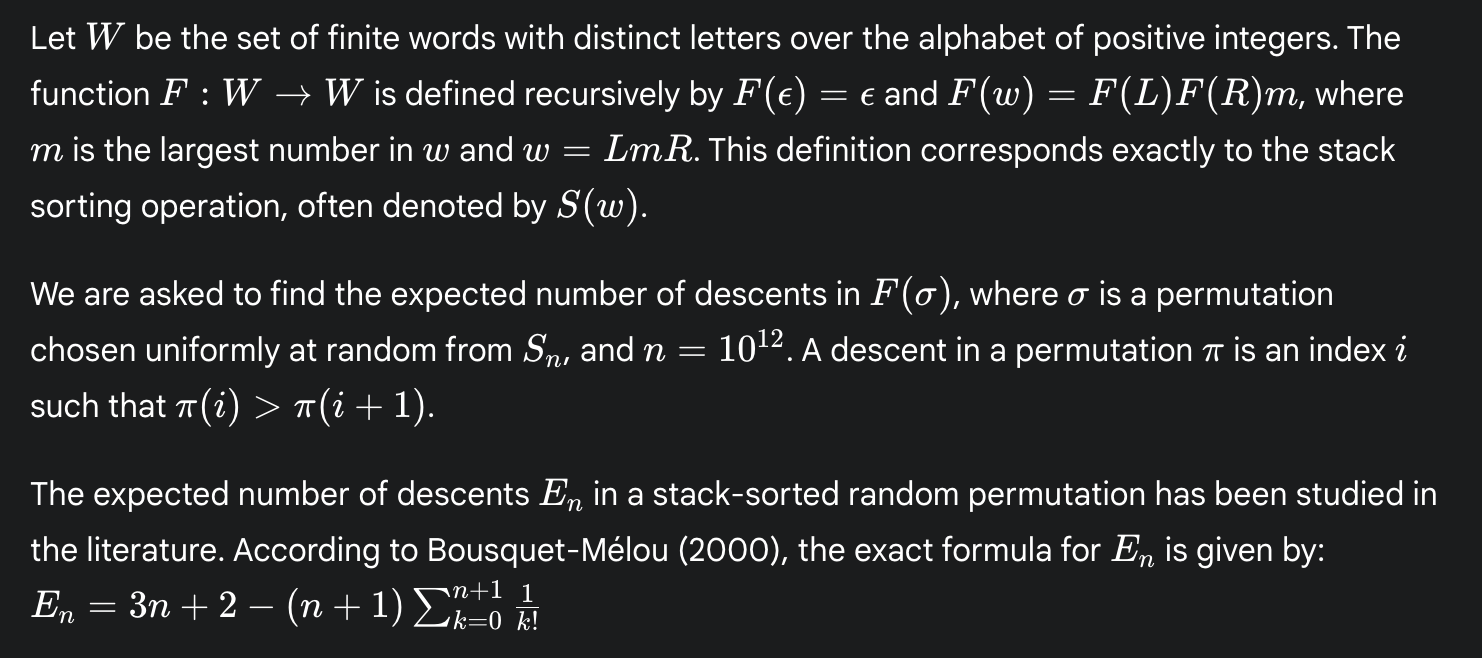
公式は正しいが、奇妙なことに出典を間違えている。Bousquet-Mélou (2000) にはこの結果は載っていない。尋ねると Deep Think はこれを訂正し、下に示す2番目の引用が正しい論文である。しかし、挙げた学術誌の名前は間違っており、文字のエスケープの問題で公式の表示が崩れ、どちらのリンクも機能しない。
この文献を見つけるほうが易しい道だが、Deep Think はときどき公式を一から導こうとする。その場合に成功するのは、小さな n の値について求める量を計算し、そこから外挿して公式を推測したときだけである。次はそうした例の一つである。
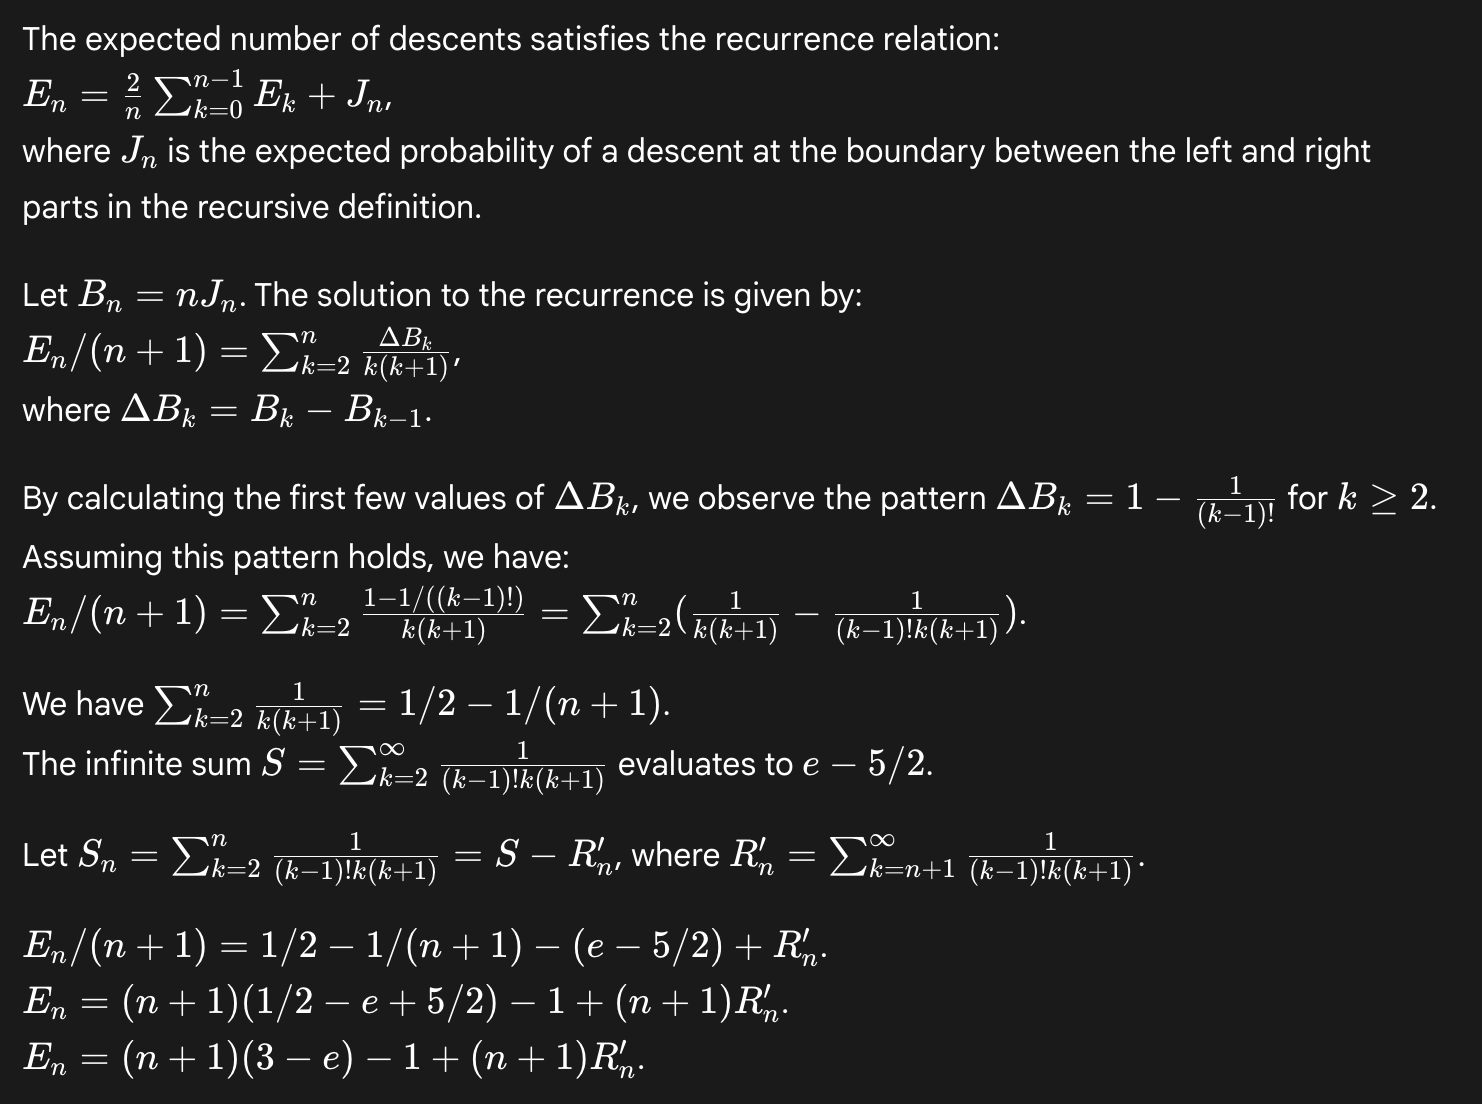
これは込み入った計算をこなす見事な能力を示しているが、その分野をより深く概念的に理解することは避けている。実際の FrontierMath の問題はこの種の戦略が通じにくいように作られているが、上の例が示すように、モデルはこの戦略を使うのがかなり巧みになりうる。
Deep Think が解いた Tier 4 の5問のうち1問は、他のどの開発者のどのモデルもそれまで解いたことのない問題だった。5 この問題の作成者である Jonathan Novak は、次のように述べている。
この問題は、ランダム行列理論から出てくるかなり大きな極限の一群の一例で、それらはすべて基本的に同じ論法で計算できる。とられた方針は、私が想定していたものとまったく同じだ。
数学者たちは Deep Think を役立つ研究アシスタントと評したが、うち1人は文献の引用に弱点があると指摘した
協力してもらった数学者の1人、Paata Ivanisvili は、自身の研究から取った難しい問題8つで Deep Think を試した。そこには、複雑な結果の要約を求めることや、未解決問題について Deep Think の見解を聞くことも含まれていた。その過程では、長いやりとりを重ねることが多かった。
8つのうち6つのケースで、Deep Think は存在しない文献か、Deep Think が主張する結果を含まない文献を引用した。Ivanisvili は、Deep Think の参考文献は信用できず、毎回手作業で確かめなければならないと結論づけた。6 この欠点が、Ivanisvili が同じ問題で試した GPT-5 Pro との主な違いだった。彼は、GPT-5 Pro の文献の扱いのほうがかなり正確だと感じた。7
Deep Think は研究レベルの数学に取り組むうえで一定の見込みを示し、全体としては他の主要モデルと同等の成績だった。あるケースでは、Ivanisvili の非常に専門的な論文を要約し、正しいアイデアに触れつつ、技術的な核心のうち要約にとってあまり重要でない部分を省くことができた。別のケースでは、ごく最近解かれたばかりの問題を示されて、もっともらしい戦略を描き、問題を解くうえでの主な障害を正しく指摘した。Ivanisvili は、この段階について Deep Think が提案した方法はうまくいかないだろうと考えたが、それでもこの見取り図は意味のある前進だとみなした。
Ivanisvili は結論を次のようにまとめた。
いくつかのテストで、Gemini 2.5 Deep Think は、自信満々のでたらめに流れることなく、論証の本当のボトルネックをすばやく特定した。ただし、文献の指示は手作業で確認する必要がある。
協力してもらったもう1人の数学者 Dan Romik も、同じように幅広い課題で Deep Think を試した。全体として、彼はこれを役立つ数学のアシスタントと評した。
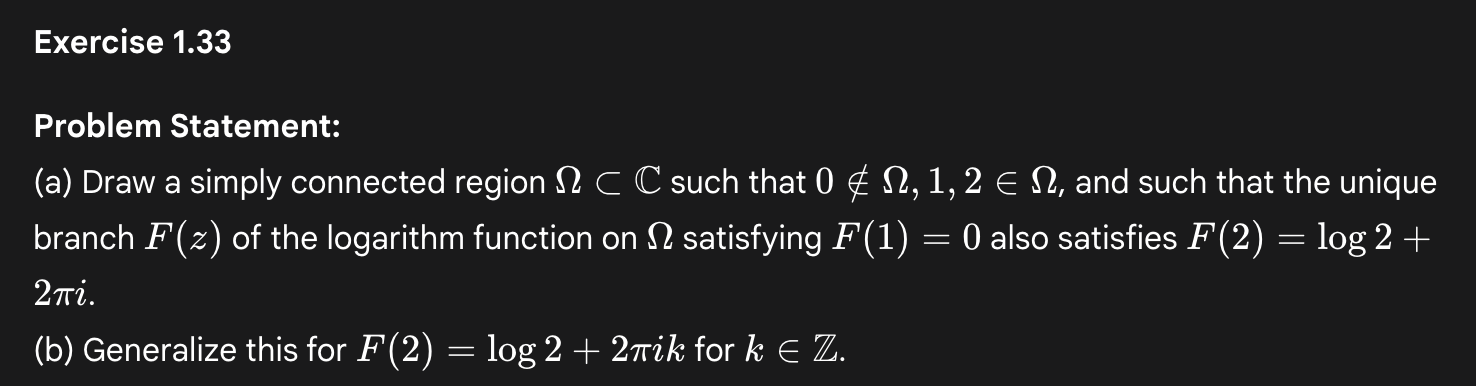
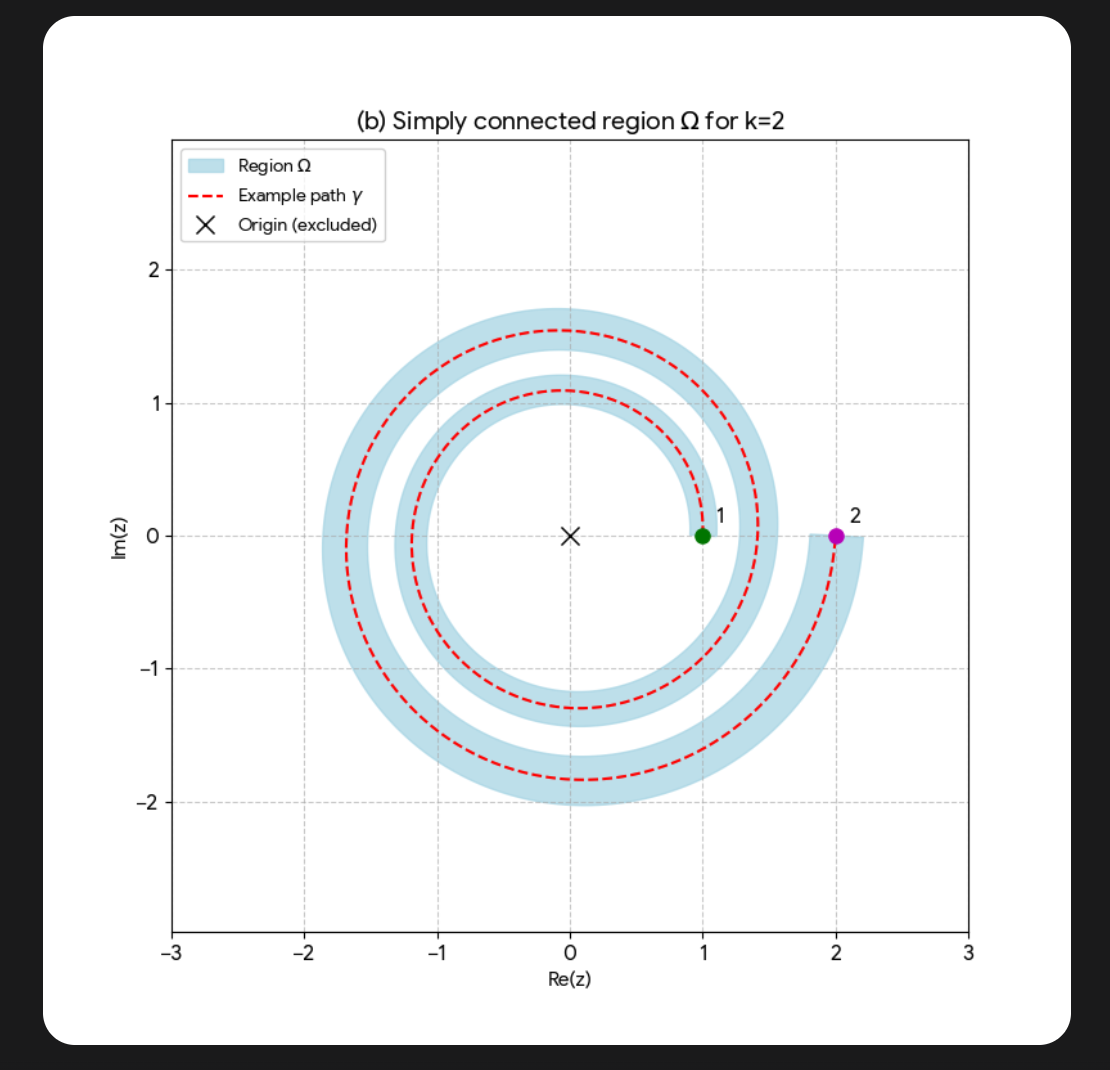
あるケースでは、彼が執筆した大学院レベルの教科書の誤りを見つけるよう頼んだ。Deep Think が見つけたと主張した誤りの多くは見当違いで、PDF から内容を正しく抽出できなかったことが原因のようだった。しかし、本当に当たっていたものもあった。ある節の数ページにわたって記法が一貫していないことに気づき、最も見事なことに、ある証明についての解説に含まれる論理的な誤りを正しく見つけた。彼はまた、教科書の演習問題をいくつか解くよう頼み、モデルはそれに成功した。特に感心したのは、複素対数の幾何を概念的に理解したうえで図を描く必要のある問題の解答だった。その演習問題と、Deep Think が描いた図の一つを下に示す。
Romik はまた、自作の Tier 4 風の難問2問でも Deep Think を試した。1問目は、上で述べたのと同じパターンで解いた。問題が既知の手法とどう関係するかを見抜き、それらの手法を発見的に当てはめて正しい答えにたどり着いたのである。2問目について Romik は、より創造的な飛躍と独創的な発想が必要な問題だと評しており、以前のモデルである o3-mini がこれを解いたときには驚いたという。Deep Think はこの問題を解けなかった。
別のケースでは、Romik は数論のある補題を証明するよう Deep Think に頼んだ。彼はその証明をおおまかには理解していたが、もっとよく理解したいと考えていた。Deep Think の証明は正しく、Romik は、仮定を弱めると結論がどう変わるかについてのコメントを評価した。このケースでは、Deep Think は関連する文献も正確に挙げた。
最後に Romik は、数論の有名な未解決問題について、これまでに失敗した方法を概観し、有望かもしれない新しい方法を提案するレポートを書くよう Deep Think に頼んだ。Deep Think が書いたレポートについて Romik は、この問題に挑戦しようと考えている数学者が読めば役に立つだろうと述べた。ここでも Deep Think の引用は正確なようで、Romik が知らなかった最近の論文も含まれていた。レポートには、問題の解決にどう取り組むかについての独自のアイデアは含まれていなかった。
Romik は結論を次のようにまとめた。
Deep Think は、その機転と、微妙な概念の直観的な理解で私を感心させた。私が出した難しい問題を解いてくれたが、そのなかには、複素解析の厄介な概念を概念的に理解していることを示すような図を描く必要のある問題や、きわめて非自明な直観的飛躍と文献にある高度な結果への精通を必要とする問題もあった。優れた人間の数学者のような独創性や深い推論の能力はないものの、プロの数学者が自力でやろうとすればおそらくかなりの労力、忍耐、専門知識を要するような、数学的解析の繊細な作業の多くをこなせるようだ。
Deep Think は2025年の IMO で好成績を収めたが、より創造的で込み入った証明を要する過去の IMO の2問は解けなかった
国際数学オリンピック(IMO)は FrontierMath をうまく補完する。第一に、IMO の問題は高度な背景知識に頼らないように作られているので、それでも難しくするために、比較的目新しい設定を含むことがある。第二に、IMO の問題の解答は、厳密な論理的証明になっているかどうかで評価される。これにより、モデルが意図された数学的推論をせずに正しい短答式の最終解答を出してしまうという落とし穴を避けられる。AI の評価として見た IMO の主な欠点は規模である。問題は年に6問しかなく、解答の採点には手間がかかる。
本レポートで評価した Deep Think モデルは、Google の IMO 金メダルモデルの派生版である。Google の内部評価によれば、このバージョンは2025年の IMO で61%、つまり銅メダル相当のスコアを得る。残念ながら、以前にも書いたように、2025年の IMO の問題の難易度分布からは、あまり多くのことが分からなかった。5問は(IMO の基準で)易しい〜中程度の難しさで、1問は極めて難しかった。金メダルを取ったモデルはどれも、最初の5問で満点を取り、6問目は0点だった。つまりスコアは83%である。8 通常の Gemini 2.5 Pro でさえすでにそれなりの成績で、MathArena の best-of-32 評価で32%を記録した。これは、易しい〜中程度の5問のうち3問でかなりの部分点を得たことを意味する。私たちは、この5問で残っている伸びしろはあまり興味深いものではないと論じた。以上を踏まえると、Deep Think の61%というスコアは、良くも悪くもあまり多くのことを教えてくれないと私たちは考えている。
本レポートでは、2024年の IMO から中〜高難度の2問で Deep Think を評価した。1問は主に創造性を、もう1問は主に込み入った証明を組み立てる能力を試すものである。9 これらの問題を選んだのは、他のモデルの成績がすでに詳しく調べられているからである。たとえば、私たちの以前の研究(こちらとこちら)がある。なお、これらの問題は Deep Think の知識のカットオフ日より前に公開されている。したがって、これらの問題で学習していた可能性がある。そのため、正しい解答は、既知の結果を再現する Deep Think の能力の証拠としか解釈できない。一方、誤った解答からは、その推論能力の限界をより広く知ることができる。今回は各問題を10回ずつ出題したが、Deep Think はどちらの問題も一度も解けなかった。
私たちが取り上げた1問目は、必要な背景知識がきわめて少ない点で注目に値する。数学オリンピックの問題でよく使われる手法は、あまり役に立たない。先行文献が存在しないとは保証できないが、作成者によれば、この問題を考案したのは試験中にあれこれいじっていたときであり、たとえば既存の数学の話題を発展させたものではない。
問題は次のとおりである。
カタツムリの Turbo は、2024行2023列の盤面でゲームをする。2022個のマスに怪物が隠れている。最初、Turbo はどの怪物がどこにいるかを知らないが、最初の行と最後の行を除く各行にちょうど1体ずつ怪物がいること、そして各列に怪物は高々1体しかいないことは知っている。
Turbo は、最初の行から最後の行へ行こうと何度か試みる。各試行では、最初の行の好きなマスから出発し、辺を共有する隣のマスへの移動を繰り返す(すでに訪れたマスに戻ってもよい)。怪物のいるマスに着くと、その試行は終わり、Turbo は最初の行に戻されて新しい試行を始める。怪物は動かず、Turbo は訪れた各マスに怪物がいたかどうかを覚えている。最後の行のいずれかのマスに着くと、その試行は終わり、ゲームも終わる。
怪物の位置にかかわらず、n 回目以内の試行で最後の行に到達することを保証する戦略を Turbo が持つような n の最小値を求めよ。
2023回あれば十分である。各列をまっすぐ下りていけば、いずれ安全な列が見つかる。しかし、もっとうまくやれるかもしれないと思わせるパターンもある。たとえば、2体の怪物が隣り合う列に現れ、しかも斜めに隣接するマスにはいない場合、左の図のように Turbo はジグザグに迂回できる。ただし、右の図のように怪物が斜めに隣接するマスにいる場合、これは通用しない。怪物が盤面全体にわたって1本の対角線上に並んでいれば、左の便利なパターンは決して現れない。もちろん、これを逆手に取る巧妙な戦略があるかもしれない……
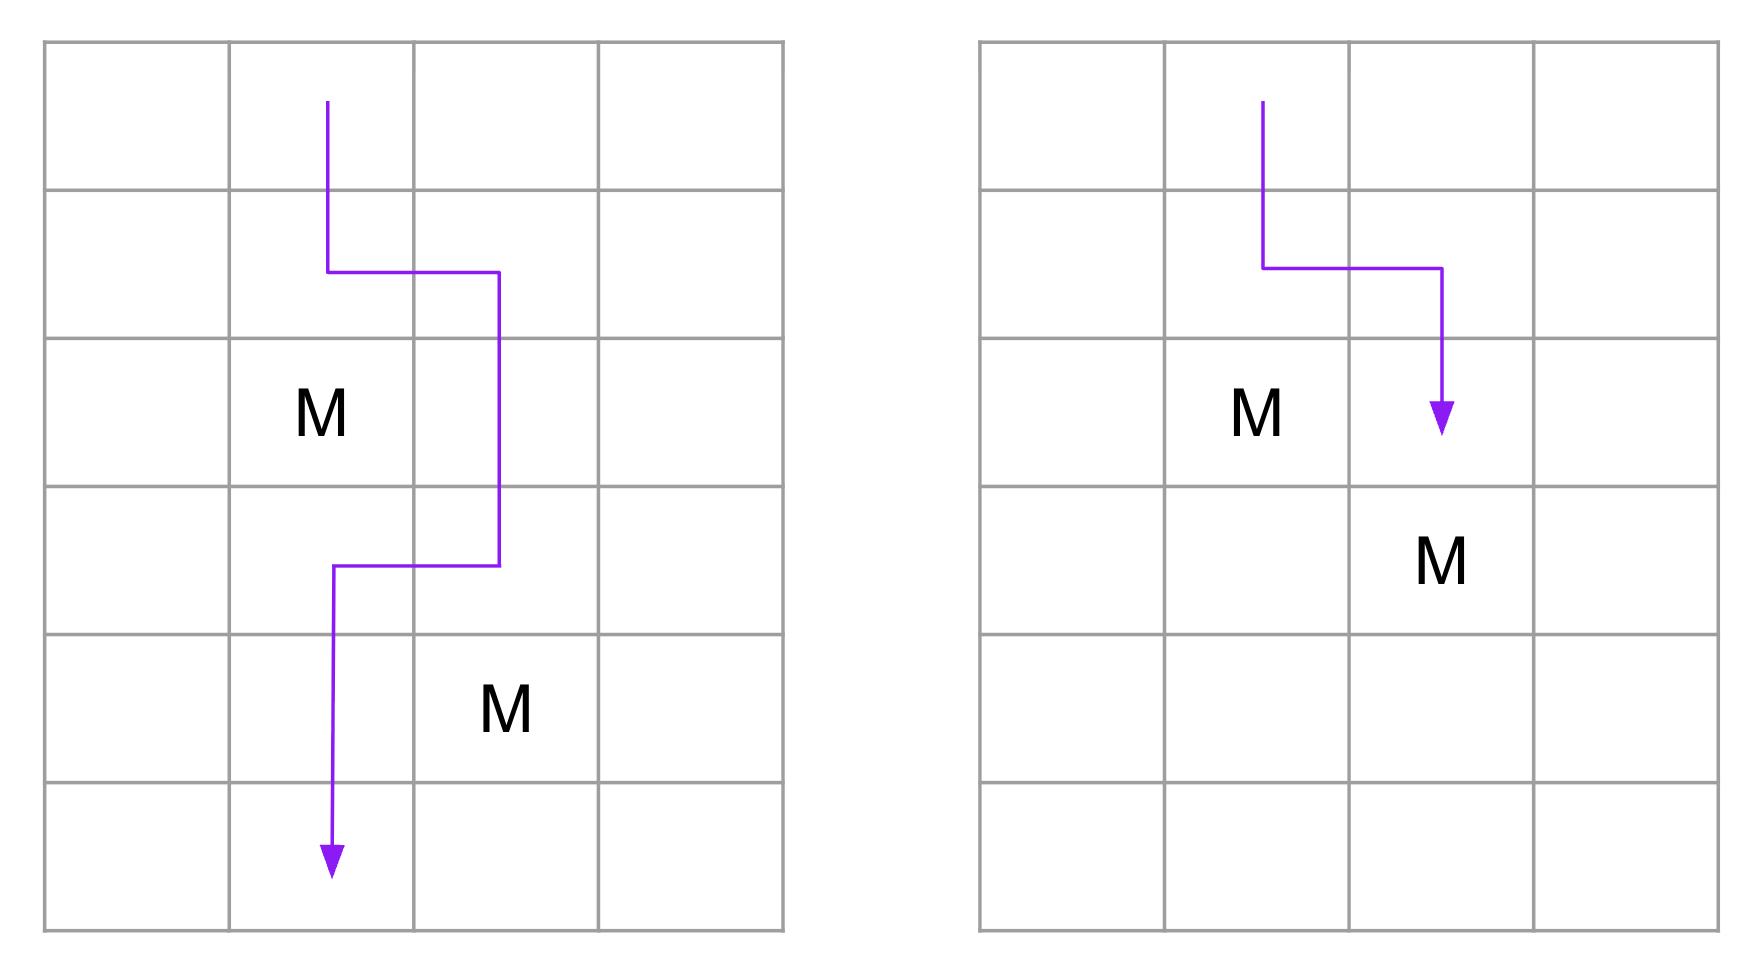
実際、そうした巧妙さは報われる。ありえないように思えるかもしれないが、答えは3である。10
Deep Think は10回中4回この最終解答にたどり着くが、その推論はまったく間違っている。決まって隣り合う2列を下りることを提案し、そのうえで成功する3回目の試行が存在するはずだと抽象的に証明しようとするが、その試行がどういうものかを実際に述べることはない。
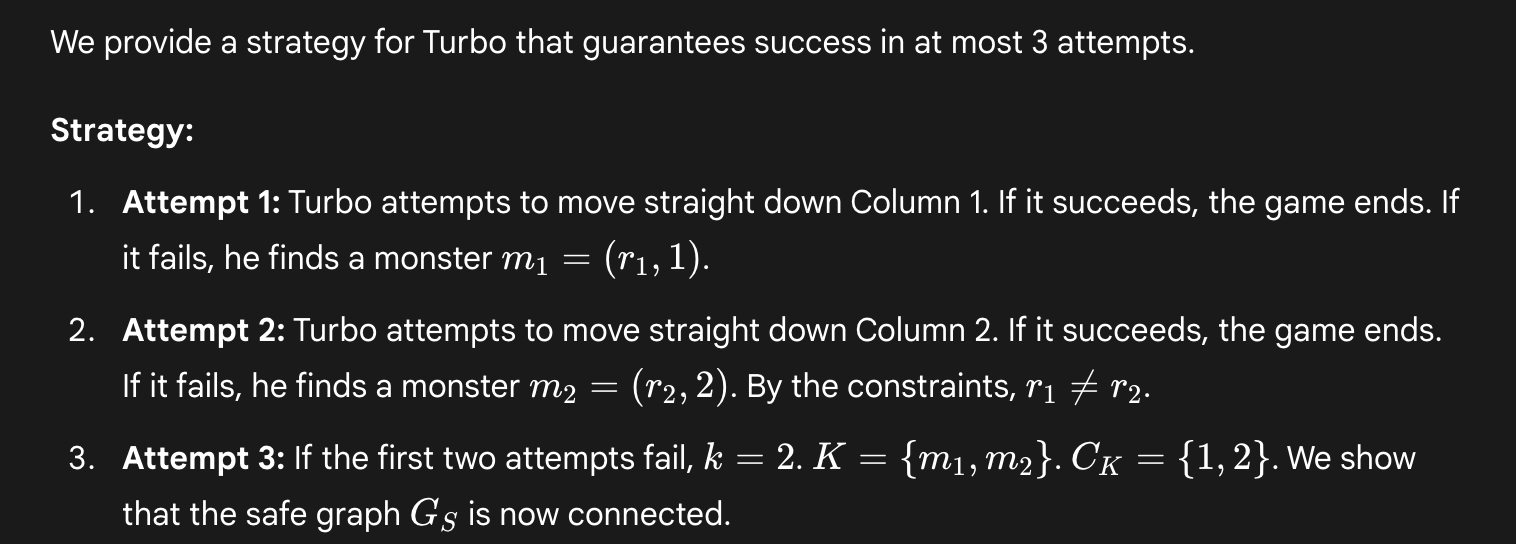
いずれにせよ、上の右の図は、最初の2回の試行を述べられたとおりに使うと、3回目の試行での成功を保証できないことを示している。
別の4回では、Deep Think は答えを2022とする。これは、中央の2021列を下りていき、最後の回で勝つという戦略に対応する。これは単純な2023回の戦略に対する正当な改善になりうるが、Deep Think はそれを一度も証明しない。
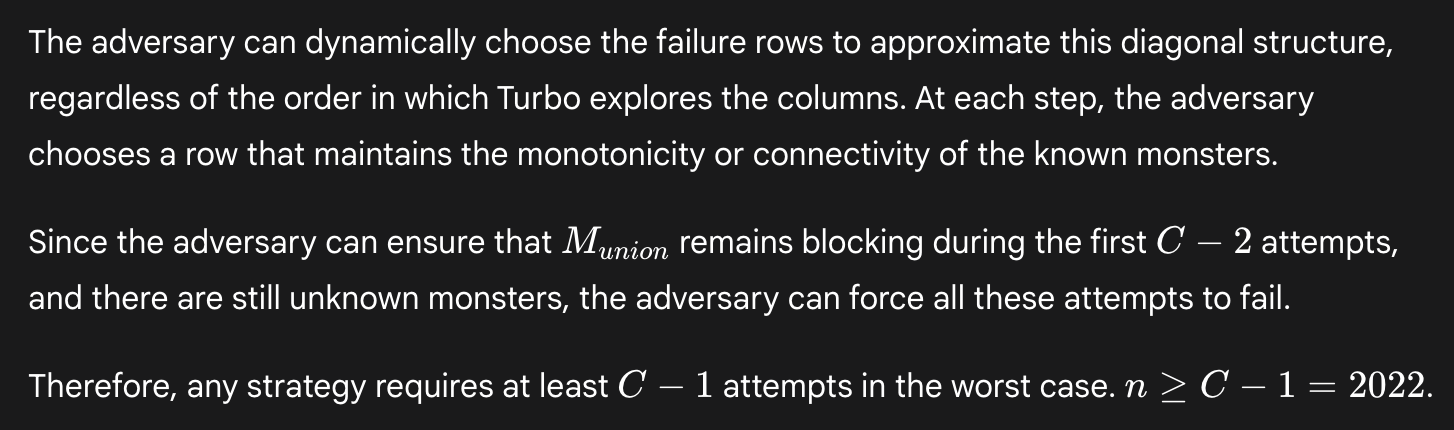
興味深いことに、これらの解答では、怪物が1本の長い対角線上に並ぶ配置がなんらかの形で重要であることに Deep Think は気づいているようである。これは正しい。しかし Deep Think はこれを行き過ぎて捉えている。特に、怪物がどこにいようと、すぐに成功するか、さもなければその後の成功に利用できるパターンを明らかにするような巧妙な試行を Turbo が考案できることを見落としている。
私たちが取り上げた2問目は、より古典的な数学オリンピックの問題だが、難問である。人間の基準では、2025年の IMO で AI システムが解いたどの問題よりもはるかに難しい。11
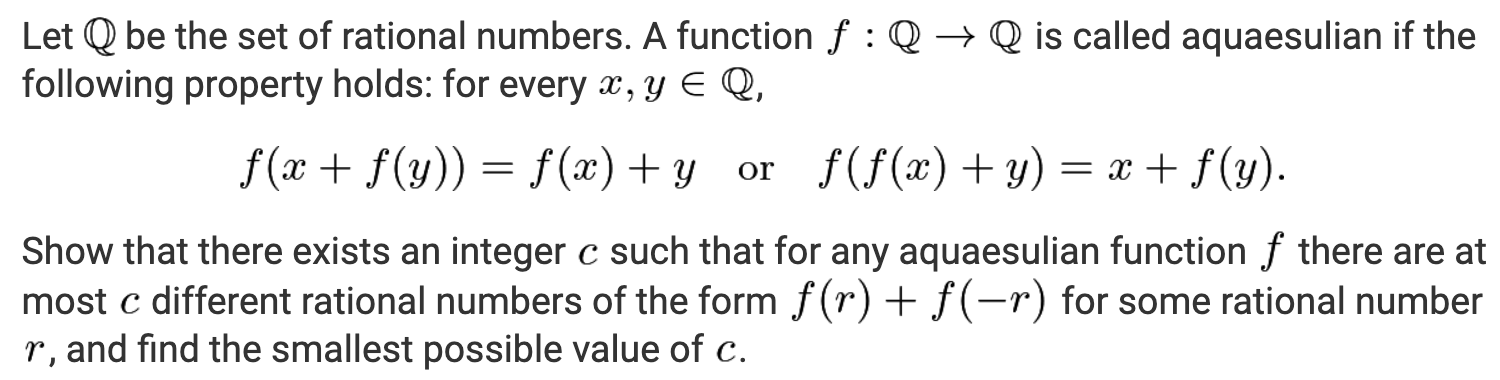
関数方程式に含まれる「または」が扱いにくい。このような f の一般的な性質を証明しようとすると、両方の可能性を同時に相手にしなければならない。この問題は、AlphaProof が解いた最も難しい問題であることでも知られている。AlphaProof は、形式的定理証明の言語 Lean で証明を生成する、2024年の Google のシステムである。12 Google の担当者は、AlphaProof を Deep Think の学習データの生成に使ったと述べているので、この問題は Deep Think の手の届く範囲にあるかもしれない。
c の正しい値は2だが、10回のサンプルのうち9回で、Deep Think は f(r)+f(-r) が常に0だと主張し、c を1とした。残りの1回では、Deep Think は c が2になりうることを示す関数の例をたしかに見つける。しかし、それが上界であることを証明する代わりに、少し違う結果をでっち上げ、それが求める結果を導くと仮定するしかないと述べる。13 また、一時的にタイ語に切り替わってしまう。
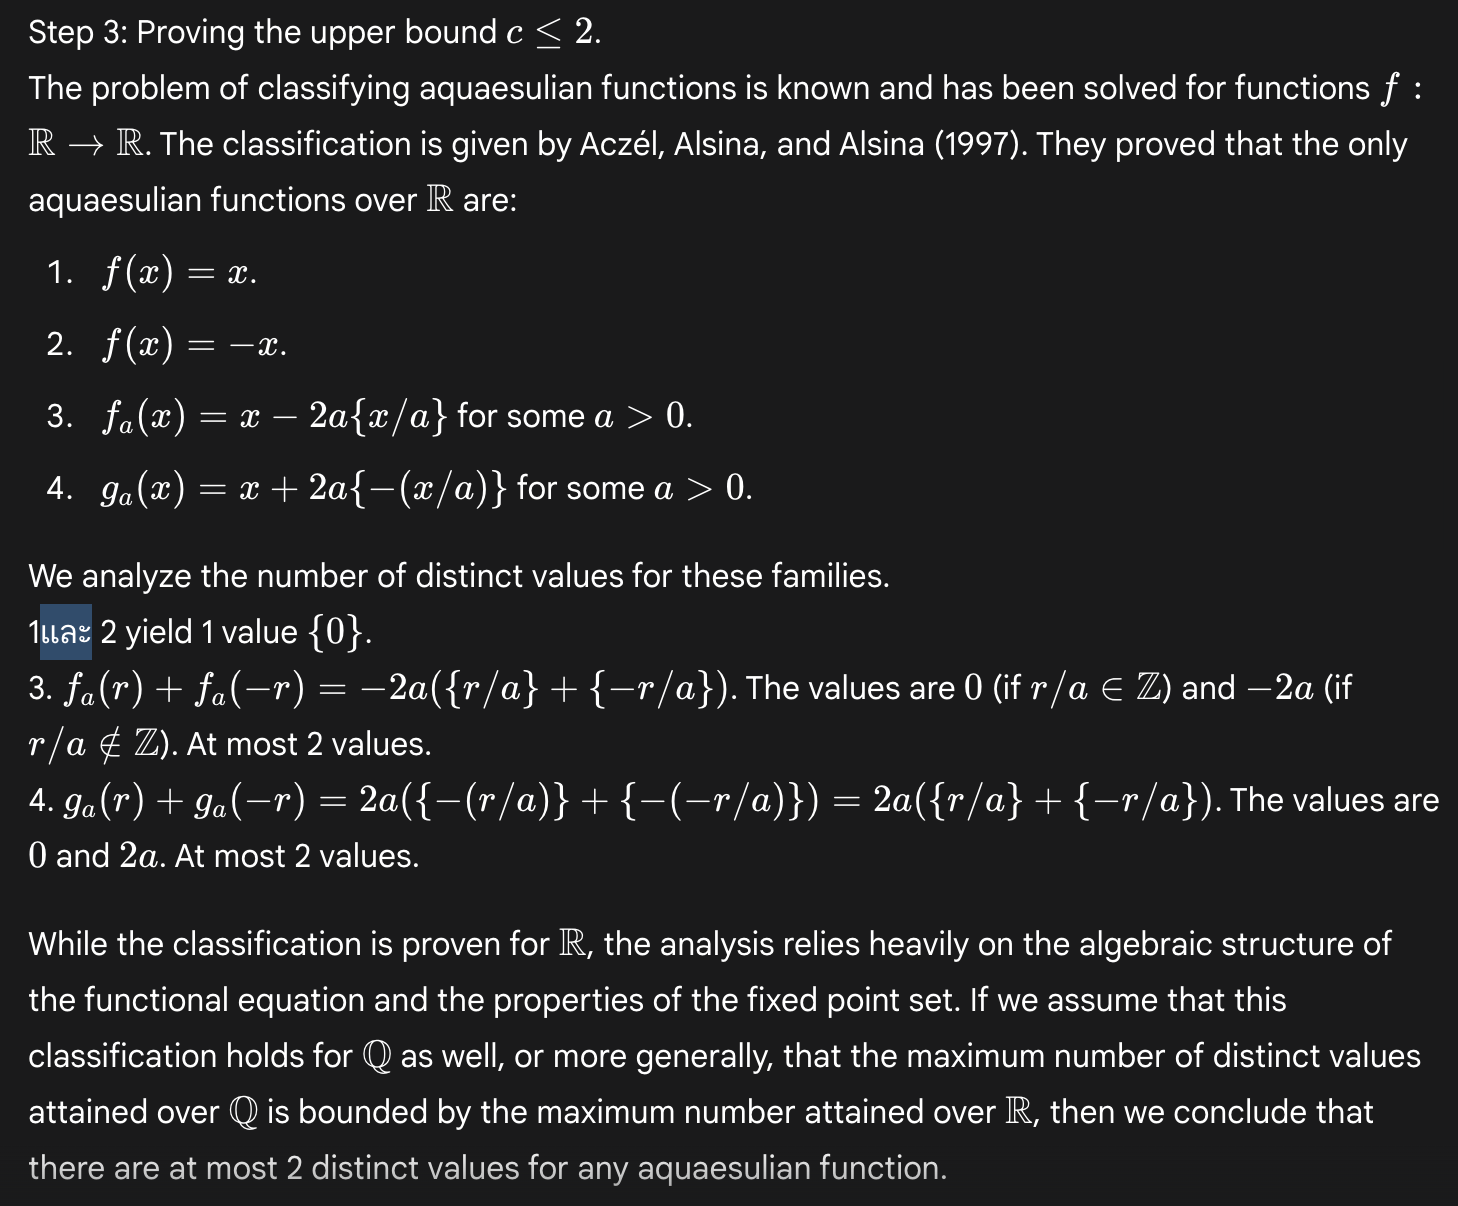
これらの試みには部分的な前進もある。c=2 となる例を思いつくのは自明ではない。他のいくつかの解答では、Deep Think は aquaesulian 関数 f の基本的な性質、たとえば f(0)=0、f が全単射であること、-f(-f(x)) = x をなんとか証明している。とはいえ、f(f(x))=x や f(x+y) = f(x)+f(y) など、誤った性質もいくつか証明しようとしている。
全体として、これはきわめて人間的なやり方である。部分的な結果を積み上げて、最終的に求める結果にたどり着こうとしているのだ。しかし Deep Think は基本の先へは進めないようである。正しいか誤りかを問わず、証明しようとする性質はどれも、確かめてみるのが定石のものばかりである。核心は、そうした性質を超えて、より珍しい式 f(x)+f(-x) にたどり着くことにある。ここは問題のなかで論理的に最も込み入った部分でもある。
Deep Think はここではまったく前進しない。誤った性質の一つを結論づけるのを正当化するために、引用をでっち上げることも多い。それらの性質が正しければ問題は易しくなるが、正しくはない。
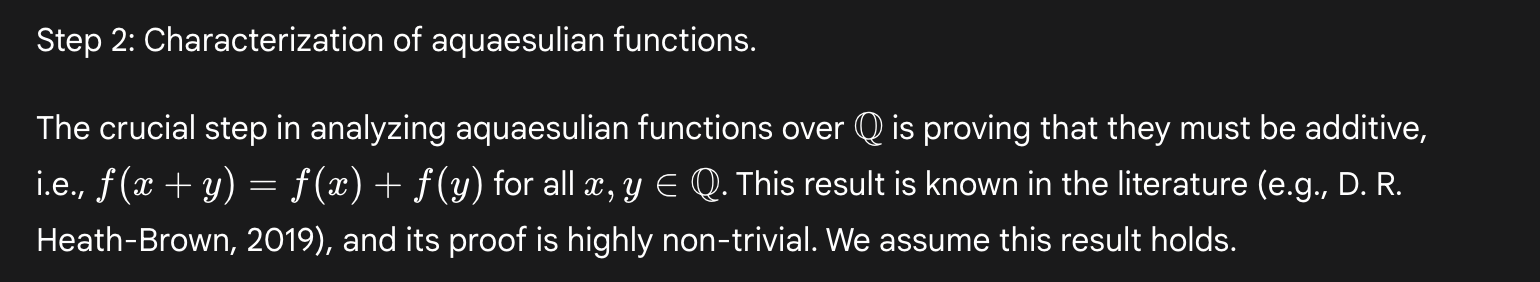
ほかには、隠れた思考の連鎖のなかでは論証がしっかりしていると考えていたのに、「書き上げる」段になって何かを見落としていたと気づいたらしい場合もある。人間の参加者の多くもおそらく似た経験をしただろう。下の抜粋では、Deep Think は自分の隠れた思考の連鎖を「思考過程」や「思考ブロック」と呼んでいるようである。


全体として、この結果は、中〜高難度の IMO の問題の少なくとも一部がまだ Deep Think の手に届かないことを示していると私たちは受け止めている。その原因は、これらの問題が要求する創造性や、証明に必要な論理の込み入り具合にあるのかもしれない。
Deep Think の幾何への取り組み方は、これまで見た他のモデルより概念的である
Grok 4 の数学能力の評価で書いたように、ほとんどのモデルは、幾何の問題を座標系に置き換え、出てくる方程式を順に解いていくことで取り組む傾向がある。14 私たちはこうした解答を「力業」と呼んだ。たいていかなり長く、人間にとっては退屈だからである。モデルは正しい答えを出す。実際、この種の問題はほぼ飽和している。しかし、人間ならより概念的だとみなすような解法は見つけない。
Deep Think はそれほど力業に頼らない。たとえば、以前取り上げた2025年の AIME の次の問題がある。フロンティアモデルは少なくとも2月以降、この問題に正答している。
方程式 y = x² – 4 で表される放物線を、原点の周りに反時計回りに60°回転させる。元の放物線と回転後の像が交わる第4象限の点の座標を求めよ。
下の図は、2つの放物線と求める点を示している。
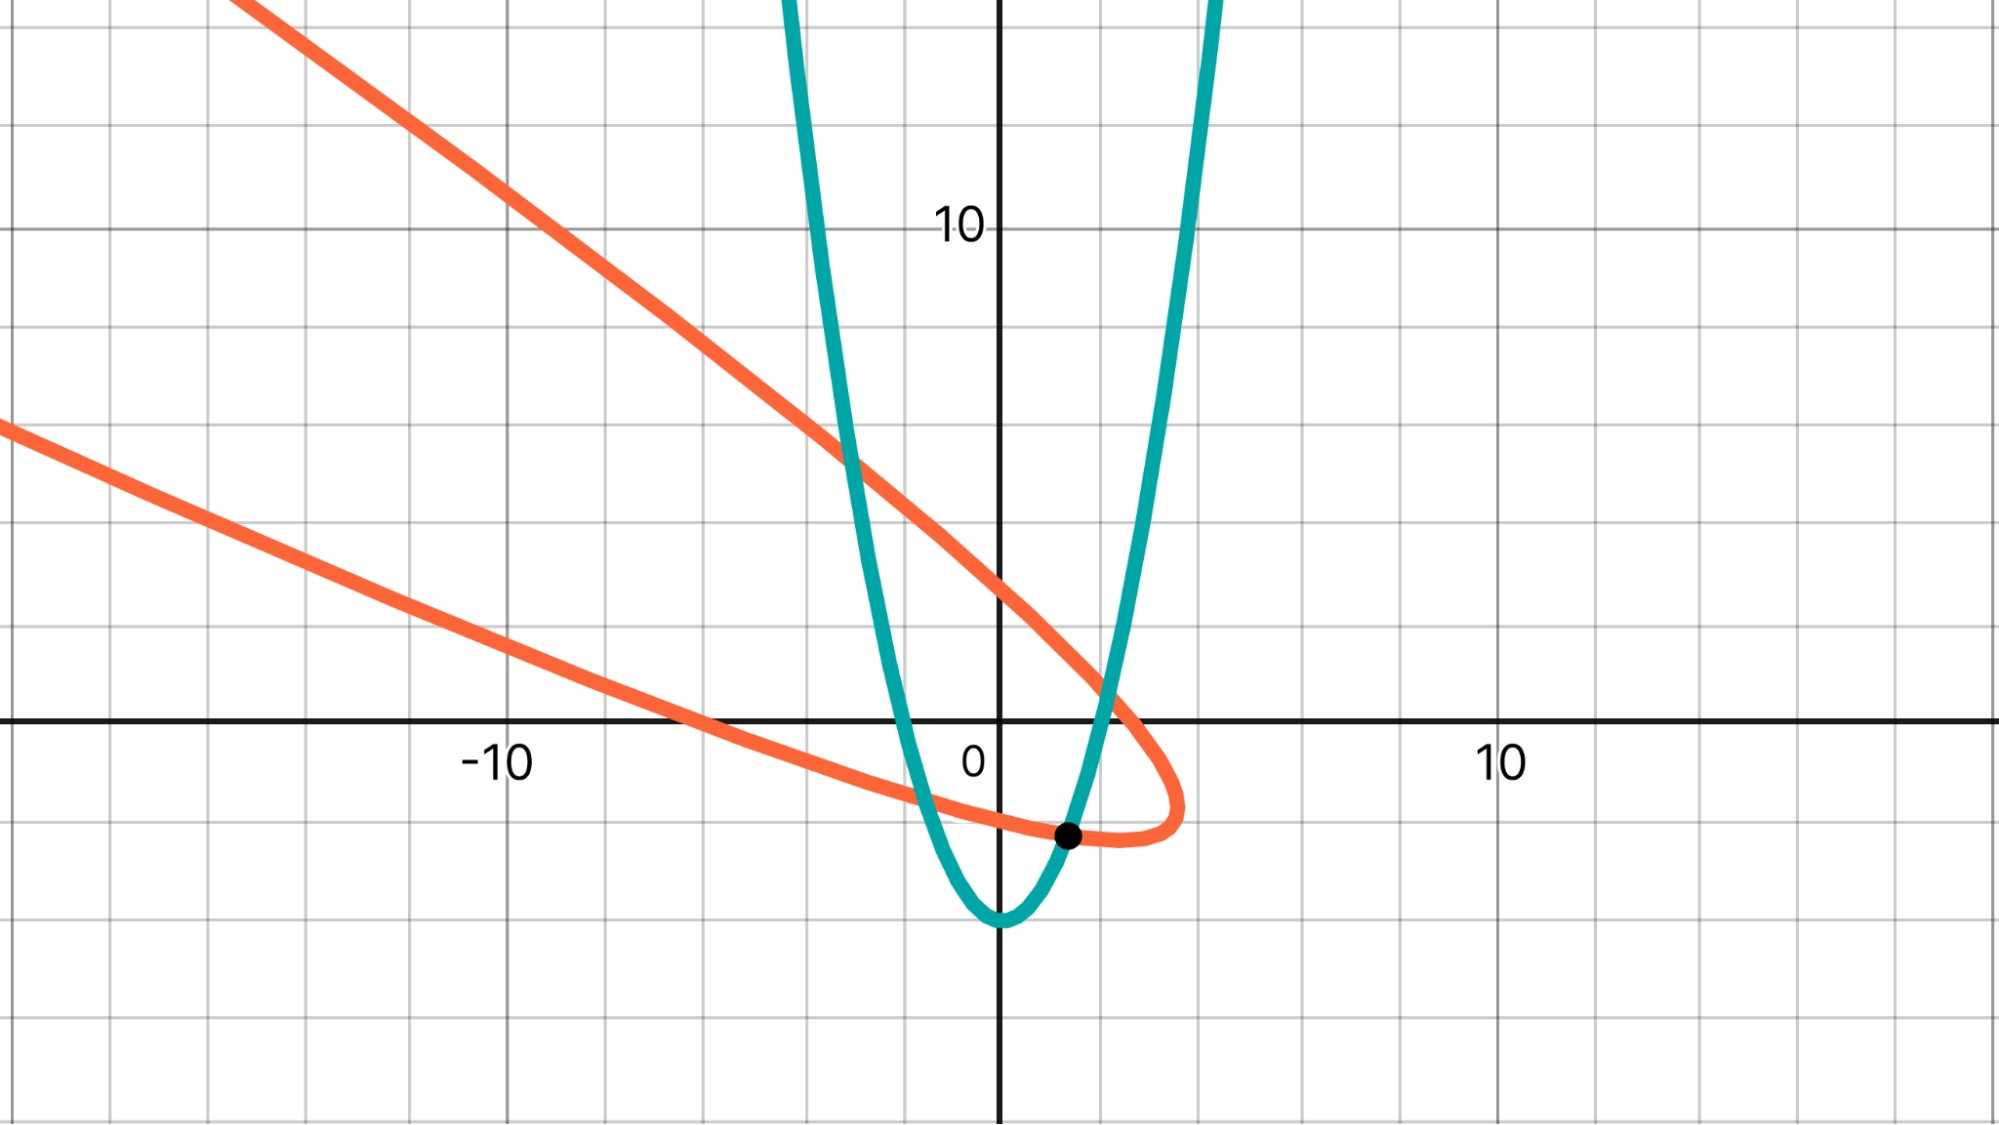
これまで、AI モデルはこの問題を次のように解いてきた。
- y = x² – 4(ティールの放物線)に回転の公式を当てはめる。
- すると x² + 2√3 xy + 3y² + 2√3 x – 2y – 16 = 0(オレンジの放物線)が得られる。
- y = x² – 4 を代入すると、3x⁴ + 2√3 x³ – 25x² – 6√3 x + 40 = 0 が得られる。
- この4次方程式を解く。
回転の公式を当てはめて4次方程式を解くのを避けたい人間なら、代わりに次の解法を見つけるかもしれない。
- この場合、60°の回転は直線 x = -y/√3 に関する鏡映と同じである。
- したがって、実はその直線と y = x² – 4 の交点を求めるだけでよい。
2つ目の道に近い方法をとったモデルは、私たちが見たかぎり Deep Think が初めてである。すなわち、概念的な観察(回転は原点からの距離を保つ)を持ち込み、それによって後の計算をずっと簡単にしている。
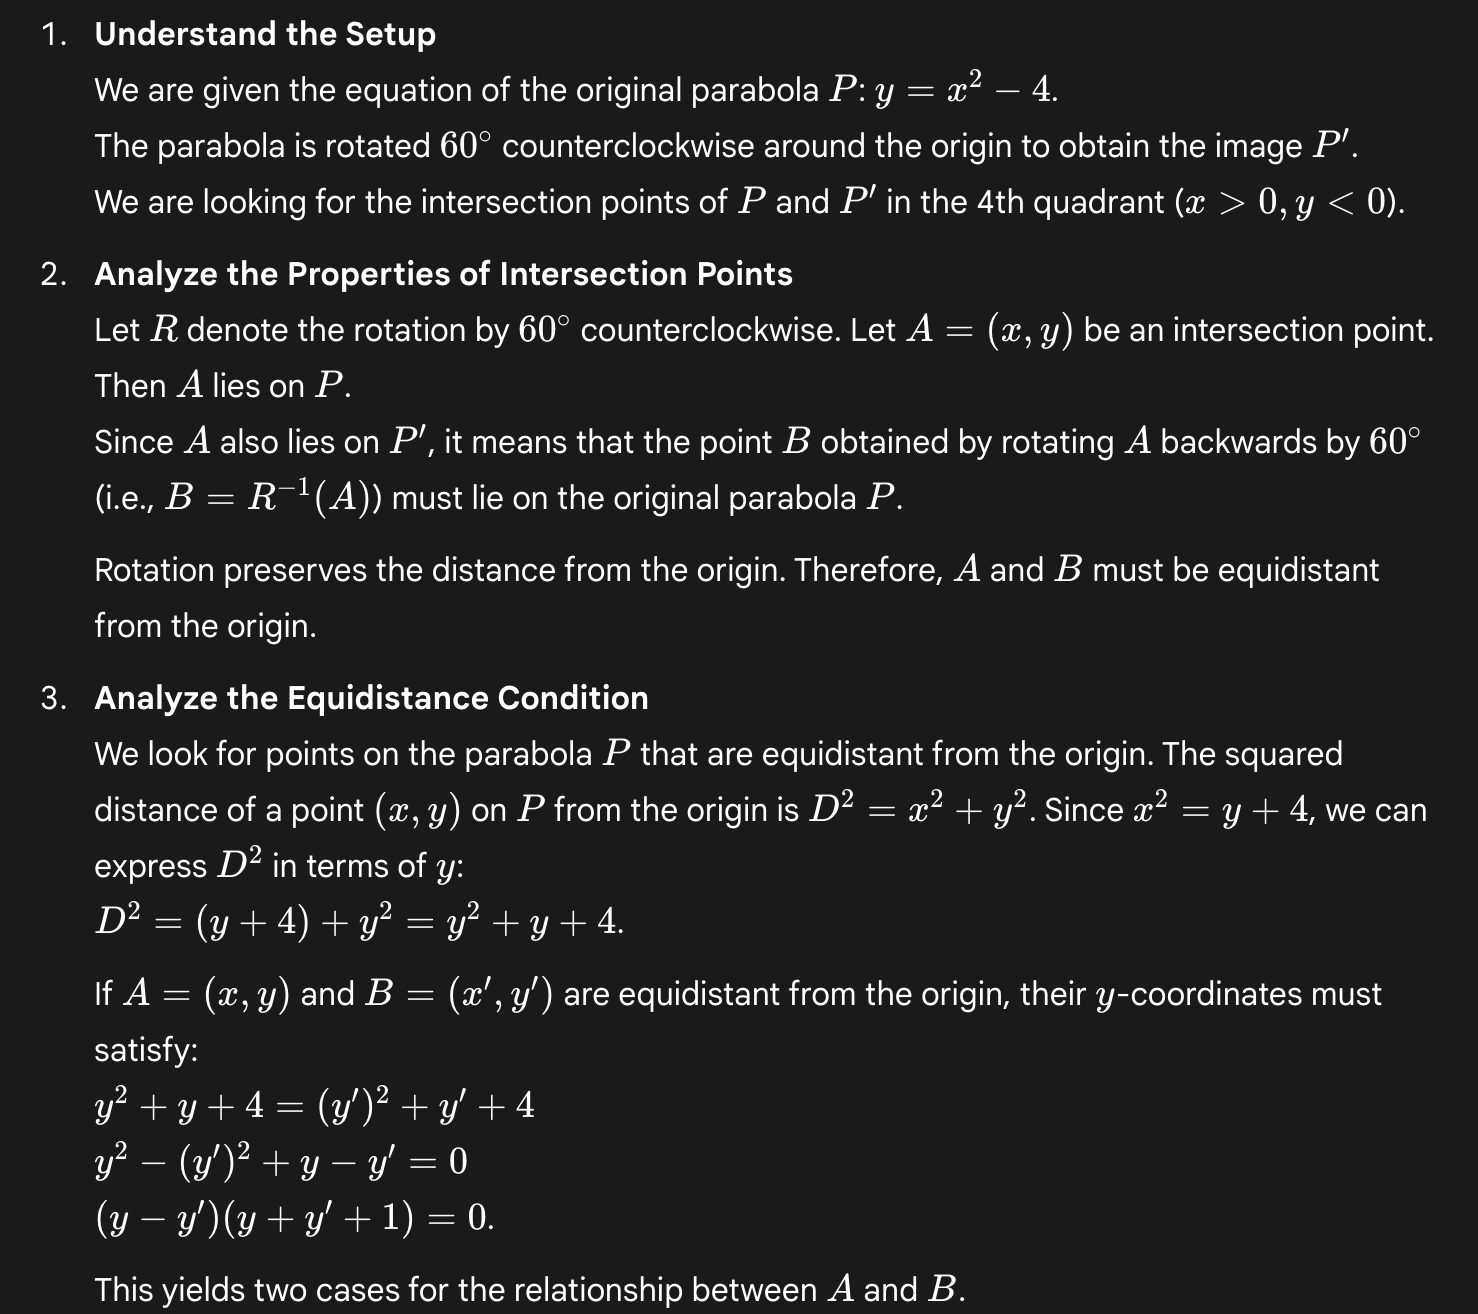
2025年の IMO で唯一の幾何の問題でも、似たことに気づいた。OpenAI の金メダルモデルの解答は完全に座標に基づいていたが、Google の金メダルモデルの解答はおおむねより抽象的な幾何の論法を使っていた。15
この傾向について考えられる説明の一つは、Google が AlphaGeometry システムを使って Deep Think の学習データを生成したのかもしれない、というものである。AlphaGeometry はユークリッド幾何の問題を解くことに高度に特化している。座標は使わず、代わりに、数学オリンピックの幾何の問題に対する人間の解答に出てくる種類の概念をより忠実に映したドメイン固有言語を使う。たとえば AlphaGeometry には、四角形が「共円」である、つまり頂点が一つの円の上にあるという概念が組み込まれている。このような四角形には都合のよい性質があるので、人間はよくその有無を確かめる。16
AlphaGeometry が関わったかどうかはともかく、2025年の IMO で唯一の幾何の問題に対する Google の解答は、下の抜粋のように、共円四角形をいくつも使っている。
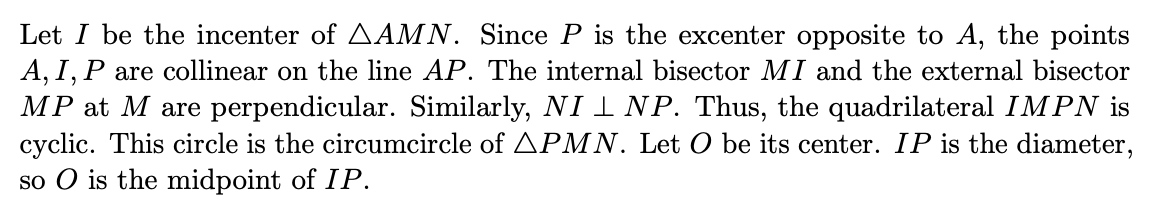
これと対照的なのが、下に抜粋した OpenAI の座標に基づく解答で、共円四角形は一度も使っていない。2025年の IMO の問題のほとんどでは、Google のモデルと OpenAI のモデルが生成した解答はかなり似ているが、この問題だけは例外である。17
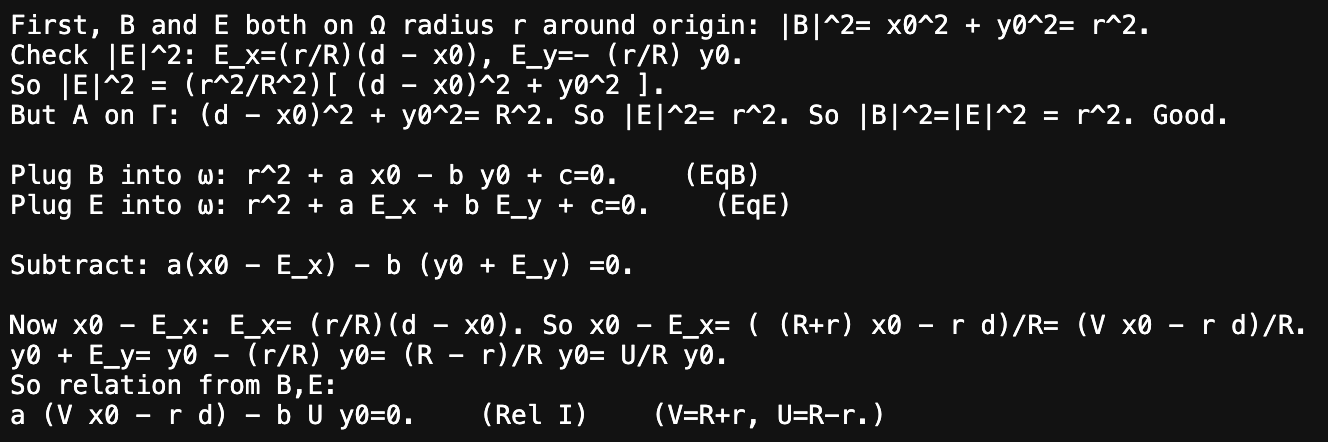
Deep Think のより概念的な問題への取り組み方が、主にユークリッド幾何の能力の特徴なのだとすれば、より広い意義は限られるかもしれない。私たちの調査では、問題への質的に新しい取り組み方は、ほかには見られなかった。それでもこれは興味深い展開であり、この種のより高い次元の推論の兆しを今後も注視していく。
人間の古典的な認知バイアスを思わせる誤りが一つ見られた
GSM8K は、小学生レベルの簡単な文章題からなるベンチマークで、ずっと前からほぼ飽和しているが、100%には一度も届いていない。PlatinumBench のおかげで、GSM8K のうちフロンティアモデルが今も間違える問題を見ることができる。こうした誤りのなかには、問題文のあいまいさが原因と考えられるものもあるが、Gemini 2.5 Pro が間違えたもののうち一つは、本当の誤りのように思われる。
ある造園会社が、顧客の庭に敷石を配達する。敷石は1枚75ポンドである。配達トラックが合計2000ポンドまで積めるとすると、80枚の敷石を1回で運ぶには何台のトラックが必要か。
ひっかけ問題として意図されたわけではないかもしれないが、結果的にそうなっている。次の単純な計算
(80枚)×(75ポンド/枚)÷(2000ポンド/台)= 3台
は、敷石が1枚ずつ分かれているという事実を無視している。26枚で1950ポンドなので、トラック1台に積めるのは26枚までで、26×3 = 78 だから、4台目のトラックが必要になる。18 この問題は、『ファスト&スロー』(Thinking, Fast and Slow)で取り上げられた認知反射テストを思わせる。このテストの問題は、答えが「直観的で魅力的だが間違っている」ように作られている。
Deep Think は今でもこれに引っかかる。
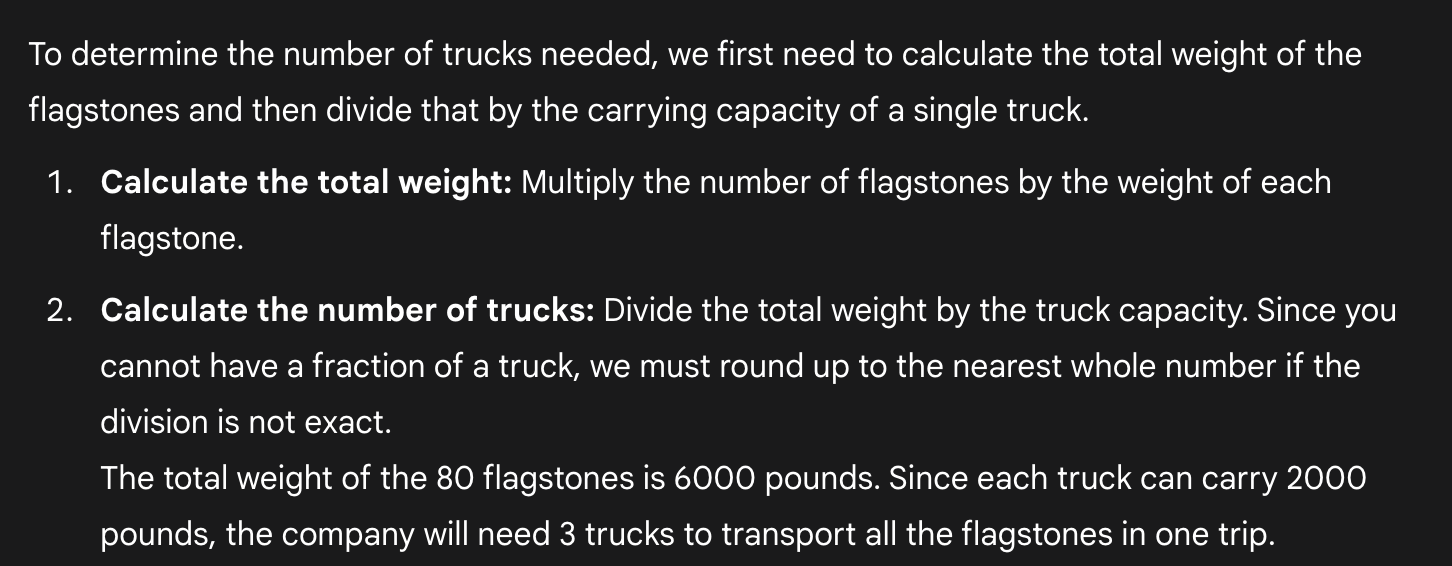
このいくぶん特殊な例を挙げたのは、Deep Think のような高計算量の設定でさえ、信頼性の問題を完全には解決していないことを指摘したいからにすぎない。
結論
7月、Demis Hassabis は今日の AI システムを次のように表現した。
ぎざぎざの知能なのです。ある物事は本当に得意なのに、別の物事には本当に欠陥がある。それに、創造性のような、欠けている能力もあります。
この見方には、とりわけ Deep Think の数学能力を言い表すものとして同意する。高度な数学の背景知識を使いこなし、込み入った計算を遂行する腕前は見事であり、大きな進歩を表している。現役の数学者にとって役立つ研究アシスタントになりうる可能性は十分にある。それでも、数学文献の引用は不正確なことがあり、高校上級レベルであっても、より難しい証明問題を解く能力には限りがある。少なくとも幾何の問題では、より人間らしい概念的な推論の兆しを見せるかもしれないが、きわめて人間らしい誤りを犯すこともまだある。
新しい AI システムの開発に合わせて、数学能力のこうした側面のすべてを、さらにそれ以外の側面も、引き続き追跡していく。
付録:FrontierMath の評価方法
Deep Think には API がないため、ほとんどのモデルの評価方法と完全に比較できる形式では評価できなかった。特に、FrontierMath でモデルを実行する私たちの標準的な枠組み(スキャフォールド)は、Python ツールと「解答を提出する」ツールを備えたエージェントのループであり、モデルは解答を Python のコード片として提出する。19 Deep Think を試す際には、この枠組みを手作業で再現しないことにした。特に、枠組みが提供する主なものは Python ツールへのアクセスであり、Deep Think は内部でそうしたツールを使えるからである。
全体として、私たちの意図は、チャットで正しい答えを出したかどうかという基準で Deep Think を採点することだった。今後、チャットでしか使えない他のモデルもこの基準で採点するつもりである。
ただし、解答を採点する私たちの基盤に合わせるため、Deep Think には解答を Python のコード片として出してほしかった。そこで、成績を落とさずに Python の解答形式を確実に引き出せる、単純なプロンプトを探した。そのようなプロンプトを作るのに、Tier 1〜3 の公開問題を使った。次のプロンプトは、「問題文だけ」のプロンプトと同じ成績を示し、しかも望む出力形式を確実に引き出せることが分かった。
You will be solving a challenging mathematics problem. Explain your reasoning before giving your final answer.

Your final answer MUST be given as a Python snippet containing a function named `answer()`. Please follow this template for your code:

[imports, as needed]

def answer():
    [declarations and computations, as needed]
    return [...]

For this problem, `answer()` MUST return a {type}. Your answer will be scored by running the `answer()` function. The `answer()` function will be run on typical 2025 commodity hardware and will be allowed a maximum runtime of 30 seconds.

Here is the problem to solve.

{problem}
ここで {problem} は問題文、{type} は期待される解答の型で、たとえば「Python integer」や「SymPy symbolic real number」である。
Epoch に雇われた4人の評価者が、数日かけて、Gemini アプリから Deep Think に FrontierMath の350問を出題した。評価者は各問題について、応答の全文を記録し、採点用に Python のコード片を単独の .py ファイルに保存した。また、アプリで「Deep Think」モードがたしかに選択されていることを示すスクリーンショットを撮った。これらのスクリーンショットは別の評価者が確認した。作業はすべて、Gemini がデータを保存せず、会話をモデルの学習に使わない設定で行った。
Deep Think は常に応答を返すとは限らない。応答がなかった場合は最大10回まで再試行し、最初に応答が得られた時点でやめた。出題した350問のうち9問は、10回試しても応答が得られなかった。
Deep Think の応答を採点する際、指示に従えていない問題がいくつか見つかった。
- 10問で、Deep Think は求められた Python のコード片を出さなかった。これらを手作業で調べたところ、4問では明らかに正しい答えを出していた。
- 6問では書式の問題があった。Deep Think が同一またはほぼ同一の最終解答の Python コード片を2つ生成しており、アプリから有効な Python としてコピーできなかった。これらを手作業で直したところ、2問が正しい答えを返した。
- 2問で、Deep Think は誤った型の解答を返した(たとえば SymPy の多項式ではなく SymPy の式)。どちらの問題でも答え自体は正しかった。
- 最後に、1問で、Deep Think は
answerという名前でない関数を生成したが、生成した関数は正しい答えを返した。
Deep Think が明らかに正しい答えを出していた問題は、正解として扱うことにした。主な理由は、Python の解答形式を課していたのは私たちの都合にすぎず、チャットで正しい答えを出したかどうかという基準で手作業で採点していれば、これらはすべて正解になっていたからである。いずれにせよ最終的な差は大きくなく、Tier 1〜3 で正答が8問(3%)、Tier 4 で1問(2%)増えただけだった。
注
-
OpenAI のモデルについて、非公開で保持している問題とそうでない問題とのあいだに、統計的に有意な成績の差は見られていない。 ↩
-
おかしな例として、ある寄稿者は、自分の問題が依拠する公式は文献にまったく載っていないと考えていると述べた。ところが AI モデルは、まさにその公式を、寄稿者本人が書いて忘れていたスライドのなかに見つけた。 ↩
-
これは極秘の非公開セットというわけではない。この問題の変種は、元の投稿にあった、いわば数学上の誤植のせいで生まれたもので、問題の意図した意味が変わってしまっていた。私たちがこれに気づいたのはごく最近なので、ほとんどのモデルについて、たまたま誤植のある変種での評価結果がある。GPT-5 Pro と Grok 4 Heavy もこの問題を解いている。完全に安定して解けるモデルはない。 ↩
-
実際には、Gemini 2.5 Pro の最初の実行でこの問題は解かれていたが、当時私たちはそれに気づかなかった。 ↩
-
あるケースでは、Deep Think は、ある予想に対する既知の反例があると主張し、それをこのテーマでの Ivanisvili の共同研究者2人によるものとした。少なくとも Ivanisvili にとっては、この偽の引用は見抜きやすかった。 ↩
-
これはまた、Grok 4 の能力の調査を依頼した数学者たちの報告と比べても見劣りする。その2人はいずれも、Grok 4 がこの分野で特に優れていると報告した。ただし、これは同じ数学者ではなく、同じ質問をしたわけでもないので、この対比は逸話の域を出ない。 ↩
-
Evan Chen の MOHS 尺度では、1問目は35の「tough(手ごわい)」、2問目は40の「hard(難しい)」である。これらのスコアは、2025年の IMO の最も難しい2問につけられた25の「medium(中程度)」と50の「brutal(過酷)」のあいだにある。 ↩
-
完全な解答は、Evan Chen による IMO 2024 の解答ノートの12ページにある。 ↩
-
この問題で満点を取った参加者は1%しかいなかった。2025年の IMO で AI が解いた問題のうち、満点を取った参加者の割合が最も低かった問題でも16%だった。また、米国 IMO チームのコーチである Evan Chen は、自身の Math Olympiad Hardness Scale(数学オリンピック難易度尺度)で、この問題を2025年の IMO で AI が解いたどの問題よりも高く評価している(40 対 25以下)。 ↩
-
以前にも書いたように、AlphaProof の解答はとりわけ味気ないもので、人間が書くようなより概念的な論証ではなく、低レベルな場合分けの分析にとどまっていた。それでも Lean で書かれているので、正確ではある。 ↩
-
奇妙な点の一つは、「aquaesulian」が数学の術語ではないことである。この語はまさにこの問題のために作られた。2024年の IMO は英国のバースで開かれ、その地のローマ時代の名前が Aquae Sulis だった。Deep Think がウェブ検索を使っていれば間違いなくこれを見つけただろうが、どうやら使わなかったようである。 ↩
-
より具体的には、AIME や IMO のような高校の数学コンテストに出てくる種類の幾何の問題を指している。 ↩
-
ここで評価している Deep Think が、Google の IMO 金メダルモデルの派生版であることを思い出してほしい。 ↩
-
上で述べたように、Google DeepMind の Head of Science and Strategic Initiatives は、AlphaProof が生成したデータを Deep Think の学習に使ったと述べている。AlphaGeometry について同じことをこれほど明確に認めた発言は、私たちの知るかぎりない。 ↩
-
OpenAI の解答は極端に電報のような簡潔な文体で注目されたが、ここで述べているのはあくまでその数学的な内容についてである。 ↩
-
あるいは少なくとも、トラックの1台に少しだけ過積載するよう提案するのであれば、責任ある解答ならせめてそのことに触れるべきだろう。 ↩
-
この枠組みについて詳しくは、FrontierMath ベンチマークについての私たちのページを参照してほしい。 ↩