
レポート
AIのスケーリングは2030年まで続けられるか?
原題:Can AI scaling continue through 2030?
はじめに
近年、AIモデルの能力は大きく向上した。私たちの研究からは、計算資源のこうした増大でAIの性能向上のかなりの部分を説明できると考えられる。1スケーリングによる改善が一貫して予測どおりに得られてきたことから、AIラボは学習の規模を積極的に拡大しており、学習計算量(training compute)はおよそ年4倍のペースで増えている。
AIの学習計算量の年4倍という伸びは、近年の歴史で最も急速だった技術の拡大のいくつかと比べても速い。携帯電話の普及の最盛期の伸び率(年2倍、1980〜1987年)、太陽光発電の設備容量の導入(年1.5倍、2001〜2010年)、ヒトゲノムの解読(年3.3倍、2008〜2015年)よりも速い。
本稿では、AI学習のスケーリングの現在の急速なペース(およそ年4倍)を2030年まで続けることが技術的に可能かどうかを検討する。スケーリングを制約しうる4つの主要な要因として、電力の確保、チップの製造能力、データの不足、そして「レイテンシの壁」を調べる。レイテンシの壁とは、AI学習の計算で避けられない遅延が課す、根本的な速度の上限である。
この分析では、生産能力の拡大、投資、技術の進歩を織り込んでいる。具体的には、先端チップのパッケージング施設の拡張計画、発電所の追加建設、複数の電力網を活用するためのデータセンターの地理的な分散などを検討する。こうした変化を反映するため、さまざまな公開情報にもとづく予測を取り入れた。半導体ファウンドリの拡張計画、電力会社の供給能力の増加予測、その他の関連する業界データ、そして私たち自身の研究である。
分析の結果、2e29 FLOPの学習は、この10年の終わりまでにおそらく実現可能になる。言い換えれば、2030年までに、GPT-4がGPT-2を規模で上回るのと同じ程度にGPT-4を規模で上回るモデルを学習することが、非常に高い確率で可能になる。2それが実際に追求されれば、この10年の終わりまでに、2019年のGPT-2の初歩的な文章生成と2023年のGPT-4の高度な問題解決能力との差に匹敵するほどの、劇的なAIの進歩が見られるかもしれない。
AI開発者がこの規模のスケーリングを実際に追求するかどうかは、今後数年でAIの拡大に数千億ドルを投じる意思があるかどうかにかかっている。AI投資の経済性については後で簡単に論じるが、投資判断の詳しい分析は本稿の範囲を超える。
それぞれのボトルネックについて、関連する供給量と、それが可能にする最大の学習の規模を控えめに見積もった。3分析全体を通じて、学習の期間は2〜9か月と仮定する。これは学習期間が長くなる傾向を反映したものである。また、分散学習のためにAIデータセンターの電力とチップを割り当てる際、企業が確保できるのは既存の供給量の10〜40%程度にとどまると仮定する。4
電力の制約。2030年までに1〜5 GWのデータセンター・キャンパスを建設する計画が、すでに議論されている。これは1e28〜3e29 FLOPの学習を支えられる規模である(参考までに、GPT-4はおそらく2e25 FLOP前後だった)。地理的に分散した学習なら、複数の地域のエネルギーインフラを利用して、さらに規模を拡大できる。米国のデータセンター拡張についての現在の予測を踏まえると、米国内の分散ネットワークはおそらく2〜45 GWをまかなえる。データセンター間の帯域幅が十分だと仮定すれば、これで2e28〜2e30 FLOPの学習を支えられる。さらに、新しい発電所の費用を負担する意思のある主体なら、3〜5年前から計画を立てることで、はるかに多くの電力を利用できるだろう。
チップの製造能力。AIチップは、大規模なAIモデルの学習に必要な計算資源を提供する。現在、その増産は先端パッケージングと広帯域メモリ(HBM)の生産能力に制約されている。しかし、メーカーが計画している増強とハードウェアの効率改善を考えると、生産能力は十分に伸びる可能性が高い。GPUが複数のAIラボに分けられ、一部はモデルの提供に使われることを考慮しても、H100換算で1億基のGPUを学習に充て、9e29 FLOPの学習をまかなえるだろう。ただし、この予測の不確実性は大きい。私たちの推定はH100換算で2,000万〜4億基の幅があり、これは1e29〜5e30 FLOP(GPT-4の5,000〜30万倍)に相当する。
データの不足。大規模なAIモデルを学習するには、それに見合った大規模なデータセットが必要である。インデックスされたウェブには約500兆語の重複のないテキストがあり、2030年までに50%増えると予測されている。画像・動画・音声データからのマルチモーダル学習も、スケーリングにある程度貢献する可能性が高く、学習に使えるデータを3倍に増やすこともありうる。データの質、利用可能性、複数エポックの学習、マルチモーダルのトークナイザーの効率をめぐる不確実性を考慮すると、2030年までに学習に使えるデータはトークン換算で400兆〜2京と推定され、6e28〜2e32 FLOPの学習が可能になる。推測にすぎないが、AIモデルによる合成データの生成によって、この量は大幅に増える可能性がある。
レイテンシの壁。レイテンシの壁は、順伝播と逆伝播に最低限かかる時間から生じる、一種の「速度制限」である。モデルが大きくなるほど、学習に必要な逐次的な演算は増える。並列に処理する学習トークンの数(「バッチサイズ」)を増やせばこの遅延を分散して吸収できるが、この方法には限界がある。「臨界バッチサイズ」を超えると、バッチサイズをさらに増やしても学習効率の向上は頭打ちになり、より大きなモデルを学習するにはより多くのバッチを逐次的に処理しなければならない。このため、一定の期間内に実行できる学習計算量には上限がある。私たちの推定では、現代のGPU構成で累積する遅延によって、学習の規模は3e30〜1e32 FLOPで頭打ちになる。この規模を超えるには、別のネットワーク・トポロジー、通信遅延の短縮、あるいは現在可能な範囲よりも積極的なバッチサイズの拡大が必要になる。
結論。技術的に実現可能な学習の正確な規模には大きな不確実性があるものの、私たちの分析からは、2030年までに2e29 FLOP前後の学習がおそらく可能になると考えられる。これは現在のモデルからの大幅な規模の拡大であり、GPT-2とGPT-4の規模の差に近い。最初に制約となる可能性が高いのは電力で、次が十分な数のチップを製造する能力である。それ以上の規模に拡大するには、エネルギーインフラの大幅な拡張と新しい発電所の建設、地理的に分散したデータセンターを結ぶ高帯域のネットワーク、そしてチップの生産能力の大幅な拡大が必要になる。
以下では、この10年のAIのスケーリングを制約しうるボトルネックを詳しく分析する。そのうえで、どの制約が最も厳しくなりそうか、またAIの学習をここまで拡大することが経済的・財務的に実現可能かを検討する。
電力の制約
この分析では、AI学習のスケーリングの現在の軌道を維持するのに必要な電力を予測する。そのうえで、この電力需要を満たすための戦略として、敷地内での発電、地域の電力網からの供給、地理的に分散した学習ネットワークを検討する。対象は米国内で行われるAIの学習に絞り、それぞれの方法の実現可能性と制約を調べる。5
1〜5ギガワット(GW)のデータセンター・キャンパスは、2030年までにおそらく実現可能である。この幅は、ペンシルベニア州でAmazonが結んだ960 MWの原子力発電の契約から、OpenAIとMicrosoftやSam Altmanが目指していると報じられている5 GWのキャンパスまでにわたる。機械学習用GPUのエネルギー効率の向上が見込まれることを踏まえると、こうしたキャンパスは1e28〜3e29 FLOPのAI学習を支えられる。
単一キャンパスのデータセンターを超えて規模を拡大するには、地理的に分散した学習が必要になり、複数の地域にまたがるエネルギーインフラを利用できる。現在の予測を踏まえると、分散学習のネットワークは2〜45 GWの需要をまかなうことができ、2e28〜2e30 FLOPの学習が可能になる。こうしたネットワークで実行できる最大の学習は、帯域幅によっても制約されうる。具体的には、既存のデータセンターの傾向に沿った毎秒4〜20ペタビット(Pbps)のデータセンター間帯域幅があれば、3e29〜2e31 FLOPの学習を支えられる。これはおそらく十分に大きく、帯域幅は電力の確保に比べれば大きな障害にはならないだろう。6
これより大きな学習もありうる。2030年までに、学習中のGPUに電力を供給するのに必要なインフラの費用は、GPUそのものの費用の40%程度になると予想される。また、天然ガスや太陽光による電力供給の急速な拡大は、拡大を決めてから3〜5年以内に手配できるだろう。ただし、インフラ全体のレベルのボトルネックによって制約される可能性はある。
AIの電力需要の現在の傾向
AIモデルの学習が消費する電力は、データセンターの総電力使用量のうち、現在はまだ小さいが急速に増えている部分である。ここでは、現在の需要についての既存の推定を概観し、将来の傾向を外挿して、その予測をデータセンター全体の電力容量や国全体の電力容量と比べる。
大規模なAI学習は主にハードウェアのアクセラレータ、具体的にはGPUに依存している。現在の最先端のGPUはNvidiaのH100で、7熱設計電力(TDP)は700Wである。クラスタのインターコネクトやCPUといった補助的なハードウェアと、冷却や配電などデータセンター全体のオーバーヘッドを加えると、ピーク時の電力需要はGPU1基あたり1,700Wに達する。8
GPU1基あたりの電力需要を使えば、フロンティアモデルの設備電力需要を推定できる。最近のLlama 3.1 405Bモデルは、4e25 FLOPの学習に16,000基のH100 GPUのクラスタを使った。この構成には合計27MWの設備容量が必要だった(16,000基 × GPU1基あたり1,700W)。これは米国の23,000世帯の年間平均消費量に相当する大きな量だが、9数百メガワットを必要とすることもある大規模なデータセンターと比べれば、まだ小さい。この10年の終わりまでに、この需要はどれだけ増えるだろうか。2030年までのフロンティアの学習は、Llama 3.1 405Bの5,000倍の2e29 FLOPに達すると予測される。10しかし、電力需要がそれほど増えるとは考えていない。これにはいくつかの理由がある。
第一に、ハードウェアの電力効率は時間とともに向上すると予想される。機械学習の学習に使われるGPUの、W(ワット)あたりのピークFLOP/sは、2010年から2024年にかけて年1.28倍前後で伸びてきた。11これが続けば、この10年の終わりまでに学習の効率は4倍になる。
第二に、将来のAI学習ではハードウェアがより効率的に使われると予想される。Llama 3.1 405BはFP16形式(16ビット精度)を使ったが、Inflection-2に見られるように、FP8での学習の採用が広がっている。Anthropicの共同創業者の一人は、FP8がフロンティアラボの標準的なやり方になると示唆している。2030年までに学習は8ビットに移行し、電力効率はおよそ2倍になると予想される(たとえばH100は、16ビット精度で1e15 FLOP/s前後なのに対し、8ビット精度では2e15 FLOP/s前後の性能を出す)。12
第三に、学習期間は長くなると予想される。2010年以降、注目すべきモデルの学習期間は年20%のペースで延びてきた。この傾向が続けば、2030年までに学習期間は3倍になる。学習期間が長くなれば、必要なエネルギーが時間的に分散される。参考までに、Llama 3.1 405Bの学習期間は72日だった。GPT-4など同時期の他のモデルは、約100日かけて学習されたと推測されている。ただし、学習期間が1年を超える可能性は低いと考えている。より優れたアルゴリズムや学習手法は一定の期間で大きな性能向上をもたらすので、ラボはそれと同程度の間隔で新しい手法を取り入れたいと考えるからである。
以上をすべて踏まえると、2030年の学習は、Llama 3.1 405Bの学習に比べて4倍(ハードウェアの効率)× 2倍(FP8)× 3倍(期間の延長)= 24倍、電力効率が高くなると予想される。したがって、傾向どおりの2030年の2e29 FLOPの学習には、Llama 3.1 405Bの学習に使われた電力の5,000倍(規模の拡大)÷ 24倍 ≈ 200倍の電力が必要になり、電力需要は6 GWとなる。
この数字は、米国の総設備容量である約1,200 GWや、2023年に米国が平均して発電した477 GWと比べれば、まだ比較的小さい。13しかし、現在の米国の全データセンターの消費電力である約20 GWと比べると大きい。14しかもその大部分は現在AIとは関係がない。さらに、数ギガワットの電力を消費する施設は前例のない巨大さである。アルミニウム精錬所のような現在のエネルギー多消費型の施設でも、需要は最大で1ギガワット程度のオーダーであり、それを大きく超えることはない。15,16以下の節では、このようなエネルギー多消費型の施設が実現可能かどうかを調べる。
地理的に集中した学習での電力の制約
地理的に集中した学習では、単一のデータセンターで行う場合でも、単一キャンパス内の複数のデータセンターで行う場合でも、電力の供給方法は2つある。敷地内で発電するか、地域の電力網を通じて(場合によっては複数の)発電所から電力を引くかである。
企業はすでに敷地内発電を進めている。Metaはミズーリ州の350MWの太陽光発電所とアリゾナ州の300MWの太陽光発電所の出力に対する権利を購入した。17Amazonはペンシルベニア州にデータセンター・キャンパスを所有し、隣接する2.5 GWの原子力発電所から最大960メガワットの供給を受ける契約を結んでいる。こうした取引の主な動機は、電力網への接続費用を節約し、信頼できるエネルギー供給を確保することである。今後数年で、こうしたデータセンターによって前例のない規模の学習が可能になるかもしれない。960 MWは、今日のフロンティアの学習に必要な27 MWの35倍を超える電力である。
敷地内発電でさらに多くの電力を得ることはできるだろうか。現在、米国には設備容量が2.5 GWを超える発電所が少なくとも27か所あり、18最大のものはワシントン州のグランドクーリー水力発電所(6.8GW)である。しかし、既存の発電所の発電容量のかなりの部分は、すでに長期契約で割り当てられている可能性が高い。19余剰容量がこれほど限られていることから、既存の米国の発電所が大規模な敷地内発電の取引に応じるのは難しいかもしれない。余剰のエネルギー容量が乏しいことは、紛争も生んでいる。たとえば、960 MWの敷地内原子力発電を得ようとするAmazonの計画には、2つの電力会社が異議を唱えており、Amazonの購入量を現在の300 MWに抑えるよう求めている。両社は、この取り決めが電力網の共有費用の負担を逃れるものだと主張している。こうした紛争は、ほかの敷地内発電の取引も妨げるかもしれない。
今後数年でさらに大規模な発電所が建設されるかもしれないが、最近建設された例は少なく、直近の3 GW超の発電所は建設に5年ほどかかった。20すでに計画されている米国の発電所のなかに、2030年までに3 GW超の規模の敷地内データセンターに対応できるものがあるとは考えにくい。21それより大きな規模に移るには、むしろ電力網から電力を引く必要があるだろう。
その目安として、地理的に限られた地域でのデータセンターの消費傾向を見ることができる。たとえば北バージニアは米国最大のデータセンター集積地で、ピーク容量で5 GWの電力に接続された300近いデータセンターがある。22北バージニア最大の電力会社であるDominionは、今後15年でデータセンターの負荷が4倍になると見込んでいる。これは年10%の伸びを意味する。Dominionやこの地域の他の電力会社が同様の拡張計画を守れば、2030年までに北バージニアのデータセンターの電力容量は10 GW前後に増えると予想できるかもしれない。23
ギガワット級のデータセンターを検討している企業もあり、この規模は2030年までに実現可能に見える。この評価は業界の指導者たちの発言に支えられ、最近の報道でも裏づけられている。米国最大の電力会社NextEraのCEOは、5ギガワットのAIデータセンターの用地を見つけるのは難しいが、1ギガワットの施設を支えられる場所は国内に存在すると最近述べた。また、MicrosoftとOpenAIが、「数ギガワットの電力」を必要とするStargateと呼ばれるAIデータセンター・キャンパスを2028年に向けて暫定的に計画しており、2030年までに最大5 GWへ拡張するという報道とも整合する。24
まとめると、現在の軌道からは、2〜5 GWの電力需要に対応できるAI学習施設が2030年までに実現可能だと考えられる。この評価は3つの主な要因にもとづいている。北バージニアで5 GWから10 GWへの増加が見込まれていることに代表される、データセンターの電力容量の予測される伸び。うわさされているStargateキャンパスのような、ギガワット級のデータセンターに関する業界の野心的な計画。そして、米国内の一部の場所では1〜5ギガワットの施設が実現可能だとする電力会社の評価である。参考までに、うわさされているStargateキャンパスのような5 GWの電力供給があれば、予想されるエネルギー効率の向上と、学習期間の300日超への延長を考慮すると、2030年までに2e29 FLOPの学習が可能になる。25併設の発電所や地域の電力網から電力を得る学習ネットワークが10 GWを超える可能性は低い。それは北バージニアの全データセンターで予測される総電力需要に近い規模になるからである。
地理的に分散した学習での電力の制約
AIの学習を単一のデータセンターの外へ分散させれば、地域の電力の制約を回避しやすくなる。データセンター間の分散学習では、作業負荷を複数のデータセンターに分散させる。それらのデータセンターは近接している場合もあれば、そうでない場合もある。この方法はGemini Ultraのような大規模モデルでおそらく使われており、それによってより多くのハードウェア資源を利用できた。26地理的に分散した学習はこの考え方をより広い地域に広げたもので、別々の電力網を利用できる可能性がある。大手テック企業はすでに複数の地域にデータセンターを展開しており、この方法をとるのに有利な立場にある。たとえば、Googleは米国の15の州でデータセンターを運営している。27この方法なら、より広い範囲の電力資源を利用して、より大規模な学習を行える可能性がある。
分散したデータセンターのネットワークは、どれだけの電力を利用できるだろうか。地域内のデータセンター・ネットワークの場合と同様に、データセンターの電力の伸びについての過去の傾向、供給者の予測、第三者の予測にもとづいて議論する。後の節では、米国全体の電力供給の大幅な拡大の実現可能性に影響する要因を論じる。それが実現すれば、データセンターはさらに多くの電力を利用できるようになる。
米国のデータセンターが利用できる電力の潜在量は大きく、しかも増えている。この容量を正確に評価するには、2つの重要な指標を区別することが欠かせない。停止時間や変動を織り込んだ実際のエネルギー消費の平均値と、データセンターの定格であるピーク容量の合計である。私たちの推定では、米国のデータセンター全体の平均消費電力は現在20 GWを超えている。28Dominionは、同社が電力を供給するデータセンターの需要は平均で容量の60%だと述べており、私たちが話を聞いた専門家の推定では、データセンターは平均して定格容量の40〜50%程度を消費している。ここから、全体の容量は33〜50 GW、中心推定で約40 GWとなる。29さらに、SemiAnalysisのデータセンター業界モデルによれば、北米(その大部分は米国)のデータセンターのIT容量の合計は2023年末に約36 GWで、2024年末には約48 GWになる見込みであり、この推定と整合する。30
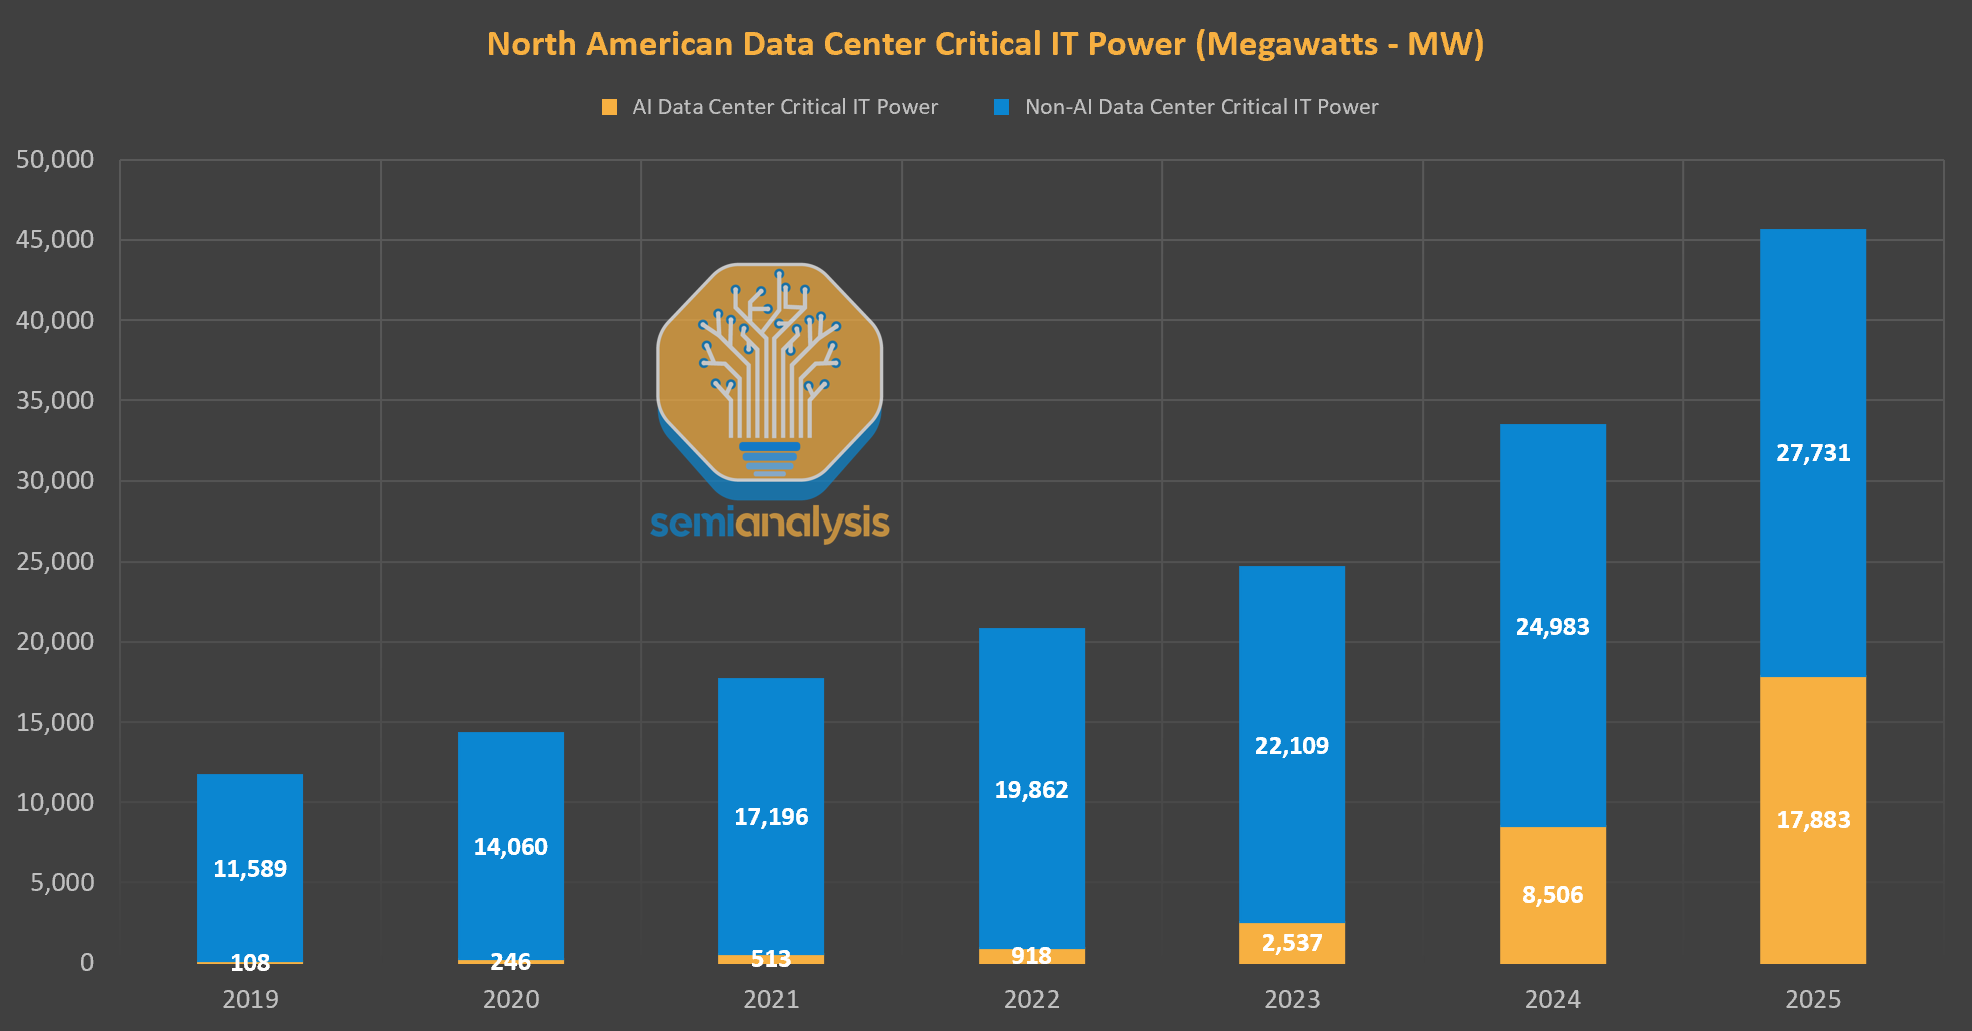
図2:SemiAnalysisのデータセンター業界モデルによる、北米のデータセンターのIT設備容量の合計(実績と計画)。重要な注記:総容量を求めるには、これらの数値にPUEを掛ける必要がある。PUEはAIデータセンターで1.2倍、その他のデータセンターで1.5倍である。
複数の情報源と予測が示すように、データセンターの電力容量が急速に拡大する可能性は大きい。SemiAnalysisの過去のデータによれば、同社が追跡しているデータセンターの容量は2019年から2023年にかけて年約20%で伸びた(図2を参照)。2024年と2025年に計画されている拡張はこれを加速させるもので、予定どおり完了すれば年32%の伸びになる。
電力会社の成長予測からも、データセンター業界全体で実現可能な伸び率を推定できる。北バージニアでは、Dominionが今後数年のデータセンターの電力について年10〜15%の伸びを計画している。31これは、2017年から2023年にかけての年24%の需要の伸びに続くものである。バージニア州の別の電力会社NOVECは、今後数年で年17%の伸びを見込んでいる。
最後に、ほかの独立した推定も年15%前後の伸び率と整合する。Goldman Sachsは、データセンターの消費電力が年15%で伸び、2030年に400 TWh(平均需要で約46 GW)に達すると予測している。米国電力研究所(EPRI)は、AIの用途が急速に拡大した場合の伸び率として15%を想定している。
全体として、年10〜30%の伸びは達成可能に見える。中心推定の15%で伸びれば、米国のデータセンターの容量は2030年までに40 GWから最大90 GWへ、つまり50 GW増える可能性がある。繰り返しになるが、ここでは実際の伸びの予測の幅を、実現可能な伸びの推定の根拠として使っているので、この数字は控えめだと言える。
データセンター全体の電力容量がわかったとして、そのうちAIに使える電力はどれだけだろうか。現在、米国のデータセンターの大半は、インターネットサービスやクラウドコンピューティングなど、AI以外の用途に充てられている。たとえばSemiAnalysisは、2023年末時点で北米のAIデータセンター全体で3 GWの設備容量を追跡している。これはデータセンターの総容量の約8%にあたる。32しかし、AIデータセンターが電力需要に占める割合は上昇しており、今後数年でAI向けの電力容量の割合はさらに大きくなると予想される。
AI以外のデータセンターの電力需要の年間伸び率について、既存の予測は8〜11%あたりに集中している。33伸び率が8%なら、AI以外の用途の需要は現在の約37 GWから2030年までに約60 GWに増え、AIデータセンターには90 GW − 60 GW ≈ 30 GWの容量が残る。これはAIの設備容量がおよそ30 GW ÷ 3 GW ≈ 10倍に拡大すること、つまりAIの設備電力容量が年47%前後で伸びることを意味する。34この予測は、AI以外の用途への成長の配分が固定されていると仮定している。しかし、AIの用途の方が収益性や戦略的重要性が高いとわかれば、クラウド事業者は資源を配分し直すかもしれず、そうなればAI以外の拡張を犠牲にして、AIの設備電力容量はさらに大きく伸びるだろう。
最後に、この容量のうちどれだけを1回の学習に充てられるかを推定する。この追加の電力容量は、Microsoft、Google、Amazonなど複数の主体で分け合うことになる可能性が高い点を考慮しなければならない。私たちの最善の推測では、最大の割合を得る企業がAIデータセンターの電力容量の33%程度を得るかもしれない。企業は学習用の容量を前倒しで確保できるので、大規模な学習を始める時点では、容量の大半、おそらく最大80%程度を学習に充てられる。合計すると、AIデータセンターの容量の33% × 80% = 26%が1回の学習に使われる可能性がある。35
これらの推定を踏まえると、米国で最も資源に恵まれたAI企業は、2030年までに30 GW × 26% ≈ 8 GWの分散学習を組織できる可能性が高い。関連する伸び率と現在の容量の不確実性を考慮すると、開発者が分散学習のために確保できる最大の供給量について、2〜45 GWという控えめな推定が得られる。これにより2e28〜2e30 FLOPの学習が可能になる(後の節の図3を参照)。参考までに、先の分析では、単一キャンパスの施設は2030年までに2〜5 GWの容量に達する可能性があるとした。分散学習の推定の上限(45 GW)はこの単一キャンパスの予測を大きく上回っており、分散学習によって電力のボトルネックを乗り越えられる可能性を示している。
地理的に分散した学習の実現可能性
地理的に分散した学習では、作業負荷を複数のデータセンターに分散させて電力の制約を緩和する。この方法は、私たちの分析で予測した規模でも技術的に実現可能である可能性が高い。この方法は、AIモデルの学習の既存の慣行の上に成り立つ。学習の計算は、すでに多数のGPUで大規模に並列化されている。AIの学習の基本的な構造は、地理的な分散に向いている。データセットはバッチに分割され、モデルの重みの更新はバッチごとに1回しか行われない。分散構成では、こうしたバッチを複数の拠点に分けることができ、データセンター同士が同期して勾配の更新を共有するのは各バッチの終わりだけで済む。
この方法が実行可能であることは、現在の慣行からも裏づけられる。たとえば、GoogleのGemini Ultraモデルは複数のデータセンターにまたがって学習されたと報じられており、地理的に分散した学習の実用性を示している。36Gemini Ultraに使われたデータセンターが地理的にどれほど離れていたかは明らかでないが、その学習は大規模な分散運用の具体例となっている。
広く分散したデータセンターで分散学習を行えるかどうかは、レイテンシによって制約される。米国の主要なデータセンターが11,000 kmの光ファイバーのループ(高めの見積もり)で結ばれているシナリオでは、通信のレイテンシは約55msになる。37同期にはネットワークを2往復する必要があり、110msかかる。これは光速の3分の2という伝送速度を使った計算なので、光ファイバー通信を使う限り、このレイテンシは短縮できない。したがって、学習を300日以内に完了させるなら、勾配の更新は最大で300日 ÷ 110ms = 2億4,000万回となる。
学習の有効性を損なわずにバッチをどこまで大きくできるかは、はっきりしない。ここでは6,000万トークンと仮定する。これは、GPT-4が学習中に達成した最大のバッチサイズに一致すると推測されている値である。そうすると、学習中に約1e16トークン(2億4,000万バッチ × 6,000万トークン/バッチ)を処理でき、Chinchilla最適なスケーリングのもとでは約6e31 FLOPの学習が可能になる。38言い換えれば、非常に遠く離れたデータセンターを含むネットワークという悲観的な仮定を置いても、レイテンシが最も厳しい制約になる可能性は低い。
レイテンシのほかに、帯域幅も大規模な分散学習の実現可能性に影響する。Marvell Teralynx 10に代表される現在のデータセンター用スイッチの技術から、達成可能な帯域幅の見当がつく。このデータセンター用スイッチは400 Gpsのポートを128個備え、合計の帯域幅は51.2 Tbpsである。39すると、16Tパラメータのモデルの勾配の更新を、標準的な2段階のリング型all-reduce演算を使って8ビット精度で送信するには、1回あたり2 × 16T × 8ビット ÷ 51.2 Tbps = 4.9秒かかる。先と同様にall-reduceごとに110msのレイテンシを加えると、all-reduce 1回あたりの合計時間は5秒となる。Chinchillaのスケーリングを前提にすると、このモデルサイズは300日未満の学習で実行できる学習の規模を最大にし、3e28 FLOPの学習となる。40
しかし、達成可能な帯域幅は、Teralynx 10のイーサネットスイッチ1台で扱える量よりはるかに大きい可能性が高い。第一に、データセンターの組の間のリンクは複数のスイッチと対応する光ファイバーで扱うことができ、はるかに大きな帯域幅を実現できる。たとえば、GoogleのStargateネットワークの各ノードは、外部トラフィックを扱う32台のスイッチを備えていた。リング型all-reduceの構成では、32台のスイッチを持つデータセンターは、隣接する2つのデータセンターそれぞれとの接続に16台ずつスイッチを割り当てられる。GoogleのB4ネットワークの前例を踏まえると、データセンターの組ごとに8〜32台のスイッチという構成は実現可能だと考えられる。41
第二に、将来はより優れたスイッチやトランシーバーが登場し、達成可能な帯域幅が増える可能性が高い。ASICスイッチのより広い傾向からは、帯域幅が年1.4〜1.6倍で伸びると考えられ、42この10年の終わりまでに380〜850 Tbpsのイーサネットスイッチが登場することになる。43
2030年までに達成可能なデータセンター間の帯域幅についての最終的な推定は4〜20 Pbpsであり、3e29〜2e31 FLOPの学習が可能になる。これを踏まえると、分散学習にとって帯域幅が大きな制約になる可能性は、そもそも必要な電力供給を確保することに比べれば低い。
分散学習ネットワークの帯域幅の拡大は、データセンター間に光ファイバーのペアを追加で敷設することで実現でき、工学的な課題としては比較的単純である。AIの学習に数千億ドルかかる可能性がある状況では、こうした帯域幅の拡大に必要な投資は相対的に小さく見える。44
エネルギーのボトルネックのモデル化
結論として、2030年に地域の電力供給で支えられる学習は、おそらく1〜5 GWを使い、2030年までに1e28〜3e29 FLOPに達しうる。一方、地理的に分散した学習は2〜45 GWの供給を集め、データセンターの組の間で4〜20 Pbpsの接続を実現でき、2e28〜2e30 FLOPの学習が可能になる。45総合すると、2030年までに2e28〜2e30 FLOPの学習が可能になる可能性が高いと見られる。46これらの推定の背後にある仮定は、下の図3にまとめてある。
チップの製造能力
GPUなどのAIチップは、AIモデルの学習に必要な計算資源を提供し、AIのスケーリングにとって重要な投入物である。ここ数年、計算量の伸びを主に牽引してきたのはGPUクラスタの拡大であり、性能が高く、レイテンシが低く、メモリ帯域幅の大きいGPUによって、ますます大きな学習が可能になっている。したがって、AIのスケーリングは、チップメーカーが生産できる最先端GPUの数に制約される可能性がある。
私たちは、パッケージング能力の予測される伸び、ウェハー生産の伸び、製造工場(ファブ)への設備投資など、半導体業界のデータを分析して、将来のGPU生産とその制約をモデル化した。私たちの予測では、2030年までのGPU生産は年30〜100%で拡大すると見込まれ、これはCoWoSパッケージングとHBM生産の伸び率と一致する。
中央値の予測では、AIの学習用にH100換算で1億基のGPUを生産できるだけの製造能力が見込まれ、9e29 FLOPの学習をまかなうのに十分である。この推定は、GPUが複数のAIラボに分配され、一部がモデルの提供に使われることを考慮している。ただし、この予測には大きな不確実性がある。主な原因は、先端パッケージングと広帯域メモリの能力拡張がどうなるかわからないことである。私たちの推定はH100換算で2,000万〜4億基の幅があり、1e29〜5e30 FLOP(GPT-4の5,000〜25万倍)の学習を可能にしうる。
現在の生産量と予測
近年、データセンター用GPUの販売は急速に伸びている。AI用GPUで圧倒的な市場シェアを持つNvidiaは、2023年に376万基のデータセンター用GPUを出荷したと報じられている。2022年の264万基からの増加である。582023年末までに、65万基のNvidia H100 GPUが大手テック企業に出荷された。2024年の予測では出荷が3倍になる可能性があり、H100の出荷は150万〜200万基と見込まれている。この量があれば、6e27 FLOPの学習をまかなうのに十分である。59
しかし、学習計算量の現在の年4倍の傾向を2030年まで外挿すると、2e29 FLOP前後の学習が見込まれる。この規模の学習には、H100換算で2,000万基近いGPUが必要になる。601つのAIラボが確保できるのは総生産量の最大20%程度だとすると、世界の製造能力は2030年までにH100換算で1億基に近い水準に達する必要がある。これは現在の生産水準をはるかに超えており、GPU生産の大幅な拡大が必要になる。61
Nvidiaの主なチップ製造を担うTSMCは、増産にあたっていくつかの課題に直面している。短期的な主要ボトルネックの一つはチップのパッケージング能力であり、とくにTSMCのChip-on-Wafer-on-Substrate(CoWoS)プロセスの能力である。これはNvidiaが最新のGPUで使っている主なパッケージング方式である。このパッケージング工程では、ロジック部分と広帯域メモリ(HBM)のスタックを組み合わせ、そのまま使えるAIチップにする。新しい施設には多くのベンダーの複雑な装置が必要なため、パッケージングは急速に拡大するのが難しい。こうした施設の建設には、人員の専門的な訓練も必要である。こうした制約のため、Nvidiaなどの顧客からの需要は強いのに、TSMCのAIチップの生産量は限られてきた。
TSMCはこの制約の解消に大きな力を注いでいる。同社はCoWoSパッケージングの能力を急速に増強しており、2023年12月の月14,000〜15,000枚のウェハーから、2024年末までに月33,000〜35,000枚に増やす見込みである。62この能力をさらに拡大するため、TSMCは2023年に新しいファブ、Advanced Backend Fab 6を開設した。フル稼働すればこのファブは月最大83,000枚のウェハーを処理でき、TSMCの先端パッケージングの量を2倍以上に増やすことになる。63TSMCはまた、2026年までパッケージング能力を年60%増やす計画を発表している。最近のCoWoS能力の増強は、年30%から100%の幅にある。この傾向が続けば、一定サイズのダイの生産可能数もおそらく同程度のペースで増えるだろう。64,65
HBMチップそのものの生産も、GPU製造に対するもう一つの大きな制約である。HBMチップは2026年までほぼ売り切れている。HBMの量は2023年から2024年にかけて2〜3倍に増えると見込まれているが、この伸びの多くは、より低価格帯のメモリチップであるDRAMからの能力の振り替えによるものである。現在のHBMの首位でNvidiaの主な供給元であるSK Hynixは、中長期的にHBMの需要が年60%伸びると予測しており(おそらく売上高を指している)、ある調査会社は2023年から2028年にかけて生産量が年45%伸びると推定している。
GPU製造の2つの主要な制約であるHBMの生産とTSMCのCoWoSパッケージング能力は、今後数年で同程度のペースで拡大すると予測されている。TSMCが発表した計画と、年30〜100%の幅にある最近のCoWoS能力の伸びの傾向にもとづき、GPUの生産も短期的には同程度のペースで伸びると推定する。
GPUの生産は大幅に伸びているが、ウェハーの生産そのものが主な制約要因になる可能性は低い。現在、データセンター用GPUはTSMCのウェハー総生産量のごく一部にすぎない。2024年初め時点のTSMCの5nmと3nmのプロセスノードの生産能力について、私たちの中心推定は年220万枚である。662024年に予測される200万基のH100 GPUが消費するのは、5nmノードの能力の約5%にすぎない。67予測される伸び率を踏まえても、GPU製造がTSMCの最先端の生産能力の大半を占めるようになる可能性は、当面は低い。GPU生産の拡大に対する主な制約は、むしろチップのパッケージングとHBMの生産にあるように見える。
とはいえ、GPU製造がいずれTSMCの最先端ノードの大半を占めるようになることは十分にありうる。そうしたシナリオには前例がある。2023年には、TSMCの3nmの生産の約90%をAppleが吸収した。AIチップの利益率の高さを考えれば、NvidiaはTSMCの先端ウェハーの生産能力をめぐって、AppleやQualcommなどの競合より高い値を付けられる可能性がある。これは十分ありうると考えているが、このシナリオは私たちの主な分析には含めていない。
GPU生産と利用可能な計算資源のモデル化
TSMCは、AIサーバーの需要が今後5年間で年50%伸びると予測した。TSMCの営業利益率はこれまで年5ポイントずつ上昇しており、投資家は値上げによってこれが続くと見ている。これを踏まえ、GPUの実際の数量の伸びは年35%前後と推定する。68これは他の予測と比べて控えめである。AMDは2027年までデータセンター用チップが年70%伸びると見込んでおり、同程度の値上げを仮定すれば、GPUの数量は年60%程度伸びることになる。69こうしたより積極的な推定は、先に論じたCoWoSパッケージングとHBM生産の短期的な増強の予測とよく一致しており、その信頼性を裏づけている。私たちはこうした推定の幅を考慮に入れ、GPUダイの生産は年30〜100%のどこかで拡大すると予測する。
この拡大を支えるだけのウェハー生産能力はあると予想される。TSMCの過去の傾向では、2014年から2023年にかけて設備投資は年15%、ウェハー生産能力は年8%で拡大した。70TSMCは、GPU生産の拡大に充てる設備投資を増やし、GPU向けに割り当てたウェハー、パッケージング、その他の生産工程を大幅に拡大するかもしれない。TSMCが、自社の予想するAIサーバー市場の年50%の伸びに合わせて設備投資の伸びを加速させれば、投入と産出の伸びの過去の関係から、ウェハーの総生産能力は年27%拡大する可能性がある。71全体として、最先端ウェハーの生産の伸び率は年5〜20%と見られる。
現在の最先端ウェハーの生産量にはかなりの不確実性があり、月10万〜33万枚のどこかだと仮定する。年5〜20%の伸びで、2030年までに生産される最先端ウェハーの累計は1,000万〜3,700万枚と予測される。TSMCなどの予測にもとづき、これらのウェハーの約20%がデータセンター用GPUの生産に充てられると予想する。
これらの予測からは、世界全体で合計2e30〜4e31 FLOP/年に相当するH100換算のストックが生産されることになる。もちろん、1回の学習に充てられるのはその一部にすぎない。個々のラボが受け取るのは出荷量のごく一部にすぎず、ラボはGPUを推論実行やその他の実験にも割り当てるうえ、学習の期間はおそらく1年未満だからである。ハードウェアとアルゴリズムの現在の改善ペースと、AIの予算の増加を踏まえると、ハードウェアやソフトウェアの進歩が鈍化しない限り、学習の期間はおそらく6か月を超えない。私たちは、学習の期間を2〜9か月程度と仮定する。ハードウェアとソフトウェアの進歩が停滞すれば上限寄りに、現在より加速すれば下限寄りになる。
AIチップは競合する多くのラボに分配され、どこかのラボが世界の計算資源ストックのうち無視できない割合を保有する可能性が高い。たとえば、Metaは2023年の大手企業向けH100出荷の4分の1を購入したと報じられている。私たちの推定では、最近は、ある時点で単一のラボが保有するデータセンター用GPUの割合は10〜40%のどこかである。
この割り当てのうち一部は、おそらくモデルの提供に使われ、学習には使えない。その割合がどれほどかを知るのは難しい。しかし、単純な経験則による議論を使うことができる。簡単な分析によれば、AIラボは両方の作業に同程度の資源を割り当てるべきである。これが成り立ち、学習用の計算量が年4倍で伸び続けるなら、利用可能な計算資源全体の約80%が新しいモデルの学習に使われると予想される。72
以上をまとめると、次のような見通しになる。中央値の軌道では、原理的にはH100換算で約1億基を学習に充て、9e29 FLOPの学習をまかなうことができる。ただし、この予測の不確実性は大きい。私たちの推定はH100換算で2,000万〜4億基の幅があり、これは1e29〜5e30 FLOPに相当する。上限を定めるため、TSMCの5nm以下の生産能力が現在から2030年まですべてGPU生産に充てられるという仮想的なシナリオを検討した。この場合、利用可能な計算量は1桁増え、1e30〜2e31 FLOPに達しうる。現在のウェハー生産の予測にもとづくこの上限は、パッケージング、HBM生産、ウェハー割り当ての既存の制約がすべて解消された場合に、AIの学習能力に及びうる最大の影響を示している。下の図4はこれらの推定を示し、その背後にある仮定を一覧にしている。
データの不足
AIの学習を拡大するには、ますます大きなデータセットが必要になる。これまでAIラボは、学習の燃料としてウェブのテキストデータに頼ってきた。毎年生成されるウェブデータの量は、学習に使われるデータの量よりもゆっくりとしか増えないため、これだけでは際限のない成長を支えられない。この節では、データの不足についての私たちの以前の研究を要約し、さらにマルチモーダルデータと合成データによって可能になりうる規模の拡大を推定して、その研究を発展させる。
学習に使われたことが知られている最大の学習用データセットは、公開されているテキストとコードのデータで15兆トークンのオーダーである。73私たちの推定では、インデックスされたウェブには重複除去後で約500兆トークンが含まれ、これは既知の最大の学習用データセットの30倍のデータ量である。CommonCrawlのような既存のコーパスだけを見れば100兆まで下がり、非公開のデータも含めれば3,000兆まで上がる可能性がある。74
Chinchillaのスケーリング則は、データセットのサイズとモデルのサイズを比例して拡大すべきだと示している。したがって、インデックスされたウェブ全体を使って学習データを30倍に増やせば、AIラボは30倍のデータと30倍のパラメータでモデルを学習でき、計算量は900倍になる。つまり、Chinchilla最適になるように学習すれば、最大で8e28 FLOPになる。75,76,77
最近の年4倍の計算量のスケーリングの傾向が続けば、テキストデータについてのこの「データの壁」には約5年で突き当たる。しかし、他のモダリティのデータや合成データの生成が、この制約を緩和するのに役立つかもしれない。以下で論じるように、マルチモーダルデータによって実効的なデータのストックは450兆〜2京3,000兆トークンになり、6e28〜2e32 FLOPの学習が可能になる。さらに、AIラボが計算資源の予算のかなりの割合をデータの生成に充てれば、合成データによってこれをはるかに超えるスケーリングが可能になるかもしれない。78
マルチモーダル
AIラボは、画像や動画など他のモダリティのデータを活用できる。79現在のマルチモーダルの基盤モデルは、10〜40%が画像データであるデータセットで学習されている。80このデータは、モデルが画像を理解し生成できるようにするために使われる。マルチモーダルな理解の有用性を考えると、将来のデータセットには、純粋にこの目的のために、テキスト以外のデータがかなりの割合で含まれるようになると予想される。とはいえ、データのストックを大幅に拡大するには、マルチモーダルデータの割合がテキストデータよりもはるかに大きくならなければならない。
音声・画像・動画のモデリングはそれ自体で十分な価値を持つので、AIラボは音声と映像だけの学習を拡大するだろう。強力な視覚能力があれば、モデルは作業の流れに組み込まれたアシスタントとして、情報を整理したり、ウェブブラウザを操作したりできるようになる。流暢で高速な多言語の音声能力を持つモデルは、テキストだけの場合に比べて、個人向け音声アシスタント技術、リアルタイム翻訳、顧客サービスを大きく改善し、より滑らかなやり取りを可能にするだろう。現在の画像モデルが使う計算量は言語モデルよりはるかに少ないが、81テキストデータがボトルネックになる一方で画像データは豊富にあるというシナリオでは、AIラボは画像モデルにより多くの資源を充て始めるかもしれない。
タンパク質の配列や医療データのような他のモダリティにも価値がある。しかし、そうしたデータのストックが、利用可能な学習データのストックを大幅に拡大するほど大きくなる可能性は低い。82
マルチモーダルデータは、さまざまな形で言語理解をさらに助けうる。音声・画像・動画データからテキストを書き起こせば、テキスト関連のデータのストックをさらに広げられる。83より推測的な話になるが、テキスト以外のデータが、転移学習やモダリティ間の相乗効果によって言語能力を向上させる可能性もある。たとえば、音声データとテキストデータを組み合わせると、単一モダリティのモデルに比べて性能が向上しうることが示されており、こうした相乗効果は規模とともに大きくなると示唆されている。しかし、モダリティ間の転移学習についての研究は乏しく、マルチモーダルデータからの転移学習が役に立つと確実に結論づけることはできない。
これらのシナリオのいずれかが実現した場合、学習にどれだけの視覚データが使えるだろうか。インターネットには約10兆秒の動画があり、画像の数も10兆に近いかもしれない。84これらのモダリティとテキストデータとの換算率を定めるのは難しい。Chameleon-34Bのような現在のマルチモーダルモデルは画像を1,024トークンに符号化するが、マルチモーダルのトークナイザーとモデルが効率的になるにつれて、この数は時間とともに減っていくと予想される。画像をわずか32トークンで効率的に符号化した例もあり、典型的なテキストの辞書サイズで調整すると、画像1枚あたり22トークンになる。85私たちは画像1枚および動画1秒あたり22トークンを中心的な推測として採用する。これは、画像と動画のマルチモーダルによって、学習に使える実効的なデータのストックがおよそ400兆トークン増えることを意味する。86つまり、画像と動画のコンテンツは、それぞれテキストと同じくらいスケーリングに貢献する可能性がある。そうなれば、テキストデータだけで学習する場合の10倍の規模の学習が可能になる。
さらに、インターネット上には公開された音声がおそらく5,000億〜1兆秒のオーダーで存在する。87ニューラル符号化器は音声を1.5 kbps未満で保存でき、それでいてはるかに高いビットレートの標準的なコーデックに引けをとらない。これは音声1秒あたり言語換算で100トークン未満に相当する。したがって、保存されている音声の総量は50兆〜100兆トークンのオーダーである可能性が高く、テキストや画像の推定から大きくは離れていない。88そのため、音声によってデータのストックが何倍にも増えることはおそらくない。
すべてのモダリティの推定を足し合わせ、データの総ストック、データの質、エポック数、トークナイザーの効率の不確実性を考慮すると、学習に使える実効トークンは400兆〜2京と推定される。これにより、2030年までに6e28〜2e32 FLOPの学習が可能になる(図5を参照)。
この区間は非常に広いので、範囲の上限がどのようにして可能になりうるかを順に見ておくと役に立つだろう。ただし、以下の数字は説明のための例にすぎない。実際の信頼区間は、これらのパラメータの値の範囲にもとづくモンテカルロ・シミュレーションから得ている。
インデックスされたウェブ上のテキストデータの量の高めの推定は、2,000兆トークンである(Villalobos et al, 2024)。一方、インターネット上の画像の数と動画の秒数の高めの推定は40兆である。画像1枚または動画1秒あたり100トークンという高めの推定も使うと、視覚トークンは4,000兆、テキストと視覚を合わせると6,000兆トークンになる。さらに、このデータのストックが2030年までに2倍になり、品質フィルタリングで80%が取り除かれ(FineWebはトークンの約85%を捨てた)、モデルがこのデータで10エポック学習されると仮定すれば、実効的なデータセットのサイズは約2京トークンになる。これらのパラメータの一覧と、選んだ値の範囲の根拠については図5を参照のこと。
合成データ
ここまでの予測では、人間が生成したデータだけを考えてきた。合成データの生成によって、データの供給を大幅に拡大できるだろうか。機械学習のいくつかの重要な節目は、人間のデータに頼らずに達成されてきた。AlphaZeroとAlphaProofは、それぞれゲームをプレイすること、幾何の問題を解くことを学び、自ら生成したデータだけで学習して、人間の専門家に匹敵するか、それを上回った。合成データでファインチューニングした言語モデルは、コーディングや推論を要する問題への回答の能力を向上させられる。注意深く選別した合成データで学習した小さなLLMは、ウェブから収集したテキストで学習した大きなモデルに比べて、はるかに少ないパラメータと学習データで同等以上の性能を達成できる。Llama 3.1のような大規模なフロンティア言語モデルは、長いコンテキストを扱う能力、多言語での性能、ツール使用の能力など、人間が注釈を付けた高品質なデータの収集が難しいか費用がかかる分野で、能力を補強するために合成データを使っている。
計算資源を使って高品質な合成データを生成できるはずだと考える主な理由の一つは、出力を生成するよりも、その品質を検証するほうが簡単なことが多いことである。この原則が最もはっきり当てはまるのは、正しさや品質を示す明示的なシグナルを作れる分野である。たとえばコーディングの課題では、生成したコードが単体テストに合格するか、サンプル入力に対して正しい出力を返すかを確認できる。数学では、論理や計算の誤りを検出して修正できる。
この方法によって、開発者は計算資源を使って多数の解の候補を生成できる。そのうえで、生成した解のそれぞれの正しさや品質を体系的に検証し、高品質な例だけを残して、水準に満たないものを捨てることができる。この方法なら、高品質な合成例で満たされたデータセットを計算によって作り出せる。こうした課題では、推論実行により多くの計算量を費やして、より高品質な出力を生成できる。
検証は生成より簡単だという原則は、コーディング以外のさまざまな分野にも当てはまるかもしれない。たとえば、研究論文の品質と新規性を査読するほうが、独自の論文を書くよりも簡単なことが多い。同様に、物語の一貫性やもっともらしさを評価するのは、魅力的な物語をゼロから書くよりも一般に難しくない。こうした場合、従来の記号的なシステムでは検証が難しいかもしれないが、現代のAIシステム、とくに大規模言語モデルは、人間の検証者に匹敵する評価能力を示している。つまり、AIに検証させれば、こうした複雑な分野でも高品質な合成データを作れるかもしれない。
高品質な合成データを生成するのに使える仕組みは、ほかにもある。たとえば、モデルが高品質な出力を直接は生成できなくても、いくつかの小さなステップを組み合わせれば生成できる、ということはよくある。これが思考の連鎖(chain-of-thought)プロンプティングの核となる考え方であり、より単純な例から段階的に積み上げることで、モデルにますます複雑な算術を教えることに使える。
合成データの利用にはいくつかの障害がある。第一はモデル崩壊の可能性である。合成データに頼りすぎると、能力が劣化したり停滞したりするおそれがある。有望な兆しはあるものの、ここまで紹介した自己修正の仕組みでこの結果を避けられるかどうかははっきりしない。
データの生成に割り当てる計算量を増やせば、2種類の方法で合成学習データの品質を高められる。多数の候補を生成してから品質でふるい分ける方法と、思考の連鎖による推論のような計算量の多い手法を使って、より優れた出力を直接生成する方法である。しかし、この戦略は計算資源への投資が増えるにつれて収穫逓減に直面するかもしれない。検証や品質推定の工程が不完全な場合、計算量を追加で割り当ててもデータの質の改善は頭打ちになるかもしれない。90
合成データはすでに、数学やコーディングのように検証が簡単な分野や、ツール使用や長いコンテキストのデータ、選好データのように、人間が注釈を付けた高品質なデータの収集が難しいか費用がかかる少数の分野で役立っている。この成功と、ここまで論じた直観を踏まえると、これまでに実証された範囲を超えて、幅広い分野で高品質な合成データを生成できることは十分ありうると考える。ただし、まだ不確実である。そうであれば、十分な計算量を費やせば必要に応じてデータを追加で生成できるので、データの量はスケーリングの制約にならないかもしれない。
合成データは、データのボトルネックを克服するのにおそらく役立つと予想される。しかし、このテーマの研究は始まったばかりで、既存の証拠も一様ではない。そのため本稿では、控えめにマルチモーダルデータからの推定に頼り、あらゆる種類の合成データを除外する。
レイテンシの壁
AIのスケーリングに対するもう一つの潜在的な制約がレイテンシである。モデルが1つのデータ点を処理するには最低限の時間がかかり、このレイテンシはモデルのサイズとともに増える。学習データはバッチに分割され、1つのバッチ内のデータは並列に処理できるが、バッチの大きさには限界がある。したがって、学習の期間は少なくとも、1つのバッチの処理時間に学習のバッチ数(学習データセットのサイズをバッチサイズで割ったもの)を掛けた長さになる。学習の期間が有限である以上、この関係によって、モデルのサイズと学習に使えるデータの量が制限され、ひいては学習の全体の規模が制限される。91
典型的なレイテンシはごく小さいため、この制約は今日の学習ではあまり問題にならない。しかし、層をまたぐ演算は逐次的に行われるので、最小レイテンシはモデルのサイズとともに増え、より大きな学習ではこの制約がはるかに重要になる可能性がある。
学習では、バッチサイズを増やしてより多くのデータを並列に処理することで、このレイテンシの問題にある程度対処できる。具体的には、バッチサイズを増やすと、より多くの計算資源と引き換えに確率的勾配降下法の収束が改善する。これにより、バッチあたりの計算量は増えるものの、学習全体に必要な計算量を大きく増やすことなく、学習を速められる。しかし、「臨界バッチサイズ」を超えると、バッチをさらに大きくしても、バッチあたりの効果は急激に小さくなる。したがって、バッチを際限なく大きくするのは効率的ではなく、ますます大きなデータセットでモデルを学習するには、逐次的に処理しなければならないバッチの数を増やす必要がある。
このボトルネックの大きさを定量的に把握するため、大規模なTransformerモデルを学習するときのレイテンシの主な発生源を調べる。バッチサイズを6,000万トークン(GPT-4のバッチサイズと推測されている値)とすると、2e30〜2e32 FLOPの学習が可能となり、層ごとに少なくとも270〜400マイクロ秒(µs)のNVLINKとInfinibandの通信レイテンシが生じる。
ただし、臨界バッチサイズはおそらくモデルのサイズとともに大きくなると予想されるので、これは過小評価かもしれない。バッチサイズをモデルサイズのおよそ立方根に比例して大きくできるという推測的な仮定のもとでは、3e30〜1e32 FLOP前後の学習が実現可能と推定され、現代のハードウェアでは少なくとも290〜440 µsのレイテンシが生じる。92
ノード内のレイテンシによるレイテンシの壁
まず、ノード内のレイテンシ、つまり複数のGPUを搭載した単一のノード(サーバー)に関わるレイテンシに分析を絞る。この場合、最も関係するレイテンシは2種類ある。1回の行列乗算(matmul)にかかる時間を表すカーネルレイテンシと、GPU間で結果を伝えるのにかかる時間を表す通信レイテンシである。
この2つのレイテンシの推定は、広く使われている機械学習用ハードウェアを基準にする。Erdil and Schneider-Joseph(2024)の実験によれば、A100 GPUのカーネルレイテンシは4.5 µsのオーダーである。一方、8基のGPUからなるNVLINKポッドでのall-reduceの通信レイテンシは9.2 µsのオーダーである。93したがって、NVLINKポッドでの行列乗算1回あたりの基本レイテンシの合計は13.7 µsのオーダーになる。
Transformerの各層のレイテンシは、ここから素直に導ける。具体的には、標準的なデコーダのみのTransformerモデルの各層では4回の行列乗算が連続して行われ、94各層を2回(順伝播と逆伝播で)通過しなければならない。したがって、層とバッチあたりの最小レイテンシは行列乗算1回の8倍、つまり となる。
レイテンシの壁のもとで可能な最大の学習の推定を仕上げるには、層の数と学習データの量のスケーリングについて何らかの仮定を置く必要がある。経験則として、モデルの層の数はパラメータ数のおよそ立方根であり、95学習データセットのサイズはChinchillaの規則に従ってパラメータ数に比例して大きくなると仮定しよう。具体的には、層あたりの最小レイテンシを120 µs、バッチサイズを6,000万トークンと仮定すると、9か月で学習できる最大のモデルは700兆パラメータとなり、最大6e31 FLOPのChinchilla最適なモデルが可能になる。ただし、NVIDIA Collective Communications Library(NCCL)のall-reduceあたりのレイテンシが、中程度のサイズのメッセージについて報告されている値より遅いとわかれば、この推定は楽観的すぎることになるかもしれない。96,97,98
ノード間のレイテンシによるレイテンシの壁
ここまではノード内(within-node)のレイテンシだけを考慮してきた。これはある程度理にかなっている。テンソル並列は、逐次的な行列乗算のたびにノード間で通信するのを避けるために、8基のGPUからなるNVLINKポッドの中だけで行われることが多いからである。しかし、スケーリングを続けるにはノード間の通信が必要になり、レイテンシが増える。
具体的には、標準的なInfiniBandのツリー型トポロジーを使うと、ノード間のレイテンシは、通信するノードの数の対数に比例して増える。NVIDIA Collective Communications Library(NCCL)を使うと、all-reduce演算には少なくとも の時間がかかる。ここで は参加するポッド内のGPUの数、 は参加するポッドの数である(この式には通信レイテンシとカーネルレイテンシの両方が含まれる)。99
2次元テンソル並列を使う学習では、ポッドの数は、2次元テンソル並列の計算で協調するGPUの数に対応する。具体的には、TP方向の2次元テンソル並列で学習するクラスタでは、TP基のGPUの同期が必要になる。その場合、8基のGPUからなる各ポッド内で平均2.75基のGPUが通信し、ポッドの総数は となる。
たとえば、2,000方向の2次元テンソル並列を使う3億基のH100クラスタでは、all-reduceあたり 個のポッドが関わり、7.4 µs + 2 x (2.75 x 0.6 µs + log2(16) x 5 µs) = 50 µsのレイテンシが生じる。これは先と同様に、層とバッチあたり8 x 50 µs = 400 µsのレイテンシに相当する。これが、バッチサイズ6,000万で9か月未満に可能な限り大きなモデルを学習できるクラスタのサイズであり、ハードウェアの効率の予測を踏まえると7e30 FLOPに達する。100
これらのレイテンシはどうすれば減らせるか
クラスタのトポロジーを改善すれば、通信レイテンシを大幅に減らせるかもしれない。たとえばメッシュ型トポロジーなら、ノード間レイテンシが対数的に増えるのを回避できる。ただし、すべてのノード間を直接接続する必要があるため、データセンター内のネットワーク構成はより複雑になる。
別の解決策として、ポッドあたりのGPUを増やした大きなサーバーを使ってノード間レイテンシを減らすことや、より効率的な通信プロトコルを使うことが考えられる。たとえばMetaは、Llama 3.1の学習のために、NVIDIA Collective Communications Library(NCCL)から派生させたNCCLXを作った。これはレイテンシの大きい構成向けに最適化されたもので、Metaによれば通信中のレイテンシを数十マイクロ秒削れるという。
あるいは、バッチサイズを大きくしたり、層の数を減らしたりする方法を探ることもできる。OpenAIによる以前の研究は、臨界バッチサイズ(それを超えると学習の効果が大きく逓減する点)を、学習データに対して勾配がどれだけばらつくかに関連づけている。これにもとづき、Erdil and Schneider-Joseph(2024)は、バッチサイズはモデルの削減可能な損失の逆数に比例して大きくできるのではないかと推測している。Chinchillaによれば、この逆数はモデルのパラメータ数のおよそ立方根に比例する。101これが成り立てば、レイテンシの壁はスケーリングにして1桁先へ押し戻される。下の図7を参照のこと。
層の数をどうスケーリングすべきか、また減らせるかどうかについての研究はほとんどない。一部の実験的な研究は、すでに学習済みのTransformerの中間層の最大半分を刈り込んでも、性能の低下はわずかであることを示している。ここから、学習前に一部の層を取り除けるかもしれないと考えられるが、はっきりしているとはとても言えない。当面、この可能性は考えないことにする。
不確実性を考慮した結論として、1e32 FLOPを超えてスケーリングするには、ネットワーク・トポロジーの変更か、理論的な議論が示唆するよりもバッチサイズを速く、あるいは層の数を遅く増やすような別の解決策が必要になる。
最も厳しい制約はどれか
ここまで、AIのスケーリングに対する4つの主なボトルネックを個別に検討してきた。これらを合わせて考えると、この10年の終わりまでに最大2e29 FLOPの学習が実現可能になる。これは現在のモデルに比べておよそ1万倍の規模の拡大であり、スケーリングの過去の傾向が2030年まで途切れずに続きうることを意味する(図7を参照)。102
濃い色の箱は四分位範囲を、薄い色の領域は80%信頼区間を表す。
最も厳しい制約は電力とチップの確保である(図7を参照)。この2つのうち、電力のほうが融通がきくかもしれない。エネルギー産業は集中度が低く、電力供給を100 GW拡大した前例もあり、供給者は3〜5年前から計画すればそれを実行できるはずである。チップ製造の拡大には複数の課題がある。先端パッケージングのような主要な工程はすでにほとんどがデータセンター用GPUに割り当てられており、新しいファブの建設には巨額の設備投資と高度に専門的な人材が必要である。
データは最も不確実なボトルネックとして際立っており、その不確実性の幅は4桁に及ぶ。推論能力を高めるうえでのマルチモーダルデータの有用性は限られているかもしれない。また、そうしたデータの利用可能なストック、その質、現在のトークン化手法の効率についての私たちの推定は、いずれもテキストデータについての推定ほど確かではない。最終的には、合成データによって際限なくスケーリングできるようになるかもしれないが、それには大きな計算コストがかかる。
最後に、レイテンシの壁は遠い先の制約だが、いずれ乗り越えなければならない障害として行く手に控えている。より大きなポッドやポッド間のより多くの接続を伴う、より複雑なネットワーク・トポロジーを採用すれば、この壁を先へ押し戻せるかもしれない。
ラボはこの新たな高みまでスケーリングしようとするか
AIの主要なボトルネックをめぐる現在の傾向を外挿すると、この10年の終わりまでに最大2e29 FLOPの学習が可能になることがわかった。この規模の達成は傾向どおりである。これまでの最大の学習は5e25 FLOPのオーダーであり、年4倍という過去の傾向があと6年続けば、およそ2e29 FLOPで学習されたモデルが生まれる。このような学習に必要なクラスタの価格は、数千億ドルのオーダーになる。103AI業界は実際にこの規模のモデルを学習しようとするだろうか。
これまで、AIモデルの規模の拡大は一貫して能力の向上につながってきた。これによってスケーリングを重視するAI開発の見方が根づき、学習への支出は年2.5倍前後で増えてきた。初期の兆候からは、これが続く可能性が高いと見られる。注目すべきことに、MicrosoftとOpenAIが「Stargate」と呼ばれるデータセンター・プロジェクトの計画に取り組んでいると報じられている。費用は最大1,000億ドルにのぼる可能性があり、2028年に始動する予定だという。このことから、大手テック企業は、私たちが検討しているような巨大な規模の達成に向けて実際に準備を進めていると考えられる。
AIシステムが十分に大きな経済的リターンを生む可能性を示すさらなる証拠は、GPT-4を超えてGPT-6相当のモデルまでスケーリングし、それにアルゴリズムの大幅な改善と事後学習による改善を組み合わせることから生まれるかもしれない。その証拠は、たとえばGPT-5のような新しいモデルがリリース後1年以内に200億ドルを超える売上を生むといった形で現れるかもしれない。あるいは、AIの機能が大きく進歩し、モデルが既存の作業の流れに違和感なく組み込まれ、ブラウザのウィンドウや仮想マシンを操作し、バックグラウンドで自律的に動作するようになるといった形かもしれない。こうした進展があれば、AIラボとその出資者は、これらのシステムが持つ巨大な潜在的価値を確信するだろうと予想される。
経済的な作業のかなりの部分を自動化できるAIがもたらしうる見返りは莫大である。経済全体が、データセンター、半導体製造工場、露光装置など、計算資源に関わる資本のストックの積み上げに数兆ドルを投資することは十分ありうる。この潜在的な投資の規模を理解するために、世界の労働報酬が年約60兆ドルであることを考えてみよう。AIによる自動化で経済成長が加速する効果を考えに入れなくても、人間の労働を効果的に代替できるAIの開発が実現可能になれば、この60兆ドルの流れのほんの一部でも獲得するために数兆ドルを投資することは、経済的に正当化されるだろう。
標準的な経済モデルの予測によれば、AIによる自動化が人間の労働の大半またはすべてを置き換える段階に達すれば、経済成長は10倍以上に加速しうる。わずか数十年で、この加速した成長によって経済の産出は数桁増える可能性がある。この可能性を考えると、完全またはほぼ完全な自動化をより早く達成することには、世界の産出のかなりの部分に相当する価値がありうる。この巨大な価値を認識した投資家は、資本のかなりの部分を従来の部門から、AI開発とそれに不可欠なインフラ(エネルギーの生産と配送、半導体製造工場、データセンター)へと振り向けるかもしれない。前例のない経済成長が見込まれることで、AI開発に数兆ドル規模の投資が向かう可能性がある。104
企業や政府が大規模な学習に数百億ドル以上を投資する用意があるかどうかという問いに決着をつけることは、結局のところ本稿の範囲を超える。しかし、少なくとも十分にありうることだと私たちは考えており、だからこそこの分析に取り組んだのである。
結論
本稿では、学習の拡大に必要な主要な要因について、その利用可能性と潜在的な制約を分析し、2030年までに実現可能なAI学習の最大規模を推定した。4つの種類のボトルネック(電力の制約、チップの製造能力、データの不足、レイテンシの壁)を検討し、どの時点でそれらがより大きな学習を実現不可能にしうるかを調べた。主な結果は次のとおりである。現在の傾向にもとづけば、この10年の終わりまでに最大2e29 FLOPの学習が実現可能になる。言い換えれば、この10年の終わりまでに、AIラボが、GPT-4が学習計算量でGPT-2をしのぐのと同じ程度にGPT-4を規模で上回るモデルを学習することは、おそらく実現可能である。
この規模を超える学習が実現不可能になりうる最も有力な理由の一つは、電力網が供給できる電力の量である。電力網全体のレベルの制約、炭素排出削減の公約、政治的な要因のために、2030年までにデータセンターへの電力供給を大幅に拡大するのは難しいかもしれない。
2つ目の主要な制約は、H100換算で年に数千万基のチップを製造する能力が限られていることである。今後10年間に設備投資が大幅に加速しなければ、関連する製造能力の大部分がGPUやその他のAIアクセラレータの生産に充てられたとしても、能力は限られるかもしれない。
全体として、これらの制約があっても、AIラボはこの10年の間、年4倍のペースでスケーリングを続けられる。しかし、これらは進歩を続けるために対処しなければならない大きな課題である。
この規模のAI学習が実際に行われれば、その意義は計り知れない。AIは数千億ドルを超える投資を集め、人類史上最大の技術プロジェクトになるかもしれない。規模そのものがより高い性能と汎用性につながるので、この10年の終わりまでに、この10年の初めから私たちが経験してきたのと同じくらい大きなAIの進歩が見られるかもしれない。
最後に、この研究では、AI技術の軌道を予測する際に直面する不確実性と格闘してきた。電力の制約とチップ製造は重要なのに、とりわけ不確実である。今後の研究で、これらをより深く調べていく。
Anson Ho、David Owen、Konstantin Pilz、Benjamin Todd、Romeo Dean、Michael Dickens、Max Negele、David Schneider-Joseph、Andy Lubershane、Natalia Martemianova、Ying Yi、Luke Emberson、Peter Wildeford、Jean-Stanislas Denain、Trevor Gaunt、David Mathers、Dylan Patel、Carl Shulman、Ajeya Cotra、Alexander Erben、Ryan Greenblatt、Tim Fistの各氏に感謝する。
付録
付録A:外挿モデルの概要
ボトルネックについての私たちの単純な外挿モデルは4つの要素からなり、本文で論じた主なボトルネックをそれぞれモデル化している。モデルのコードはこちらにある。出典付きのデフォルトのモデルパラメータは
こちら
にある。第一に、電力の制約をモデル化するため、米国全体のデータセンターの設備電力容量を考える。これを地域の電力会社によるデータセンター需要の予測に従って拡大し、米国の総電力容量の伸びの予測によって制限する。また、AI以外のデータセンターの伸びの傾向を別にモデル化し、その伸びはデータセンター全体の容量の伸びを超えないように制約する。AIデータセンターの予測容量は、予測されるデータセンターの総容量と、予測されるAI以外のデータセンターの容量との差としてモデル化する。その一部(付録Bに従ってモデル化)が、1回の学習に利用できる容量の最終的な推定である。この推定を、指数関数的に改善するエネルギー効率(FLOP/s/W)の傾向と学習期間の推定と組み合わせて、可能な最大の学習を計算する。分散学習の実現可能性の節で述べたように、これと、達成可能と考えられる帯域幅のもとで可能な学習の規模の分布との小さいほうをとる。さらに、この結果と、2030年までに見込まれる地域の電力供給の分布で定まる、地域内での最大の学習との大きいほうをとる。
第二に、チップの製造能力の制約をモデル化するため、CoWoSパッケージングと広帯域メモリ(HBM)生産という現在のボトルネックを考える。GPUの生産は年30〜100%で伸びると予測する。これは最近の増強や、CoWoSとHBMの予想される伸びと一致する。モデルは、このGPU生産の傾向を、TSMCの7nm未満のノードのウェハー総生産量の予測によって制限する。ただし、私たちが選んだパラメータでは、2030年までにこの制限が大きな影響を及ぼすことはない。計算資源のストックは時間とともに蓄積し、新しいチップのFLOP/sは年44%向上すると仮定する。電力のモデルと同様に、これを利用可能なストックの割合、学習期間、利用率の推定と組み合わせて、可能な最大の学習を推定する。
第三に、データにもとづくモデルでは、テキスト、動画、画像の既存のストックを考える。これらを、転移の効率に関するいくつかの推定に従って組み合わせる。最後に、これらがインターネットのコンテンツの過去の伸び率に見合ったペースで指数関数的に増えるとモデル化する。実効的なデータのストックを最大の学習の規模に換算するには、パラメータあたり20トークンというChinchillaのスケーリングと、学習計算量の合計はパラメータ数と学習データセットのサイズの積の6倍に等しいという関係を使う。
第四に、そして最後に、レイテンシの壁による上限を計算するため、付録Eで詳しく述べる連立方程式を解く。ここでは、テンソル並列を行うために同期が必要なGPUの数に応じて通信レイテンシがどう増えるかを考え、バッチサイズのスケーリング、層の深さのスケーリング、ハードウェア性能の向上も考慮する。
モデルのパラメータはすべて、私たちが見つけられた証拠と、私たち自身の推測や直観にもとづいて選んだ。モデルの入力は、分布の10%、50%、90%の分位点についての私たちの推測に当てはめたメタログ分布に従うと仮定する。さらに、割合のパラメータは0%から100%の範囲に、伸び率は1より大きくなるように制約する。また、ガウス・コピュラによってパラメータ間に相関を持たせる。持たせた相関は下の表1で説明する。
表1:モデルのパラメータ間に持たせた相関。| パラメータ | パラメータ | スピアマンの順位相関係数(ρ) | 理由 |
|---|---|---|---|
| 米国のデータセンターの電力容量の伸び | GPU生産の伸び | 0.5 | GPUに大規模な投資がなされるなら、電力供給にも投資がなされる。 |
| 米国のデータセンターの電力容量の伸び | 最大のデータセンター・キャンパスの電力容量 | 0.5 | 大規模なデータセンターが開設されているなら、おそらく総電力需要もより速く伸びている。 |
| データセンター間の帯域幅 | 米国のデータセンターの電力容量の伸び | 0.3 | 電力の拡大に大きな努力が払われているなら、帯域幅についてもおそらく同様である。 |
| 学習期間 | 米国のデータセンターの電力容量の伸び | 0.5 | 電力が大きな制約なら、それを回避するためにより長く学習しようとする。 |
| 学習期間 | GPU生産の伸び | 0.5 | GPU製造が大きな制約なら、それを回避するためにより長く学習しようとする。 |
| 学習期間 | GPUの効率の伸び | -0.7 | GPUの性能向上が遅ければ、学習期間は延びうる(The Longest Training Runを参照) |
| インターネット上のテキストデータのストック | インターネット上の画像データのストック | 0.7 | あるモダリティに大きなデータのストックがあるなら、ほかのモダリティでも利用できる可能性が高い。 |
| インターネット上の画像データのストック | インターネット上の動画データのストック | 0.7 | 同上。 |
| インターネット上の動画データのストック | インターネット上のテキストデータのストック | 0.7 | 同上。 |
付録B:最大の学習に割り当てられる資源の割合
電力とチップの製造能力をモデル化する際には、AIラボ間の競争によって、1つのラボが最大の学習のために確保できる資源の割合がどう影響されるかを考えなければならない。この割合を推定するため、2024年初めの時点で最も資源に恵まれた各企業が利用できるAIチップのストックを考える。次に、各企業のストックを、利用可能なAIチップの総ストックで割る。最後に、一部のチップが推論実行に割り当てられることを考慮して、この割合を下方修正する。便宜上、AIチップのストックはH100換算で測る。つまり、16ビット精度でストック全体のFLOP/sに匹敵するNvidia H100 GPUの数である。計算の全容はこちらで見られる。
Meta:調査会社Omdiaによれば、Metaは2023年末までに15万基のH100 GPUを取得した。Metaは2024年末までにH100換算で合計60万基のGPUを保有する計画である。したがって、2024年初めのMetaのH100換算のストックは、15万〜60万基だった可能性が高い。
Microsoft:Omdiaの推定では、Microsoftも2023年末までに15万基のH100 GPUを取得した。報道によれば、Microsoftは12月までにAIチップのストックを3倍の180万基にする計画である。これがどのような種類のチップになるかは不明だが、この計画からは当初のストックが60万基だったことになり、時期から見て新しいチップの多くはH100だと考えられる。ハードウェアの効率向上のペースにもとづくと、当初のストックの60万基はH100換算で約30万基に相当する。105ただし、Microsoftの拡張計画がいつ始まったのかは正確にはわからない。Microsoftは2024年初めまでにすでにさらに多くのH100 GPUを取得していたかもしれない。私たちの推定では、最大14万基である。106これらをすべて考慮すると、2024年初めのMicrosoftのH100換算のストックは、15万〜60万基だった可能性が高いと考える。
Google:TPUと呼ばれるGoogle独自のAIチップの生産については、公にはほとんど知られていない。しかし、調査会社TechInsightsのあるレポートは、毎年のTPUの総出荷数を推定している。107各世代のTPUのリリース時期から見て、2023年の推定200万基と2022年の推定150万基の大半はTPUv5だった可能性が高い。ただし、TPUv5には、効率の高いTPUv5eと、性能の高いTPUv5pの2つの版がある。それぞれの割合は不明なので、TPUv5の総出荷数は100万〜350万基、そのうちTPUv5pが占める割合は10〜90%と推定する。
2021年にリリースされたTPUv4については、生産のピークはおそらく2020年から2022年の間にあったと考え、TechInsightsが報告した年間生産量にもとづいて、合計25万〜150万基が生産されたと推定する。2021年より前の生産量の推定ははるかに少なく、古い世代は性能も低いので、それより古い世代のTPUは無視する。GoogleはNvidiaのGPUも保有しているが、Googleのラボが主力モデルの学習にTPUだけを使ってきた実績を考えると、それらのGPUを最大の学習に割り当てる可能性は低いと考える。したがって、TPUv4とTPUv5の数を合わせると、Googleが利用できるH100換算の総数は40万〜140万基と推定される。
Amazon:Omdiaのレポートによれば、Amazonは2023年末までに5万基のH100 GPUを取得した。これはMicrosoftやMetaの3分の1である。Amazonには独自のTrainiumチップもあり、ある報道によれば、Amazon Web Services(AWS)は近く、ピークで65e18 FLOP/sの計算能力を持つ、最大10万基のTrainium2チップのクラスタを提供する。これはFP16精度を仮定するとH100換算で約66,000基、FP8精度を仮定すると33,000基に相当する。Amazonがすでにこうしたクラスタを複数保有しているなら、合計でH100換算で数十万基を保有している可能性がある。しかし、これらのクラスタは稼働し始めたばかりなので、AmazonのAIチップのストックが、Googleの推定ストックであるH100換算40万〜140万基を超える可能性は低いと見られる。
総ストック:2024年初めまでに学習に利用できるAIチップの総ストックを推定するため、実際に出荷されたH100、その他のGPU、GoogleのTPUを合計する。実際に出荷されたH100は、50万〜160万基だった可能性が高い。Omdiaは、大手企業への出荷を合計65万基と推定した。Nvidiaのデータセンター部門の年換算売上高が475億ドルで、価格が3万ドルであることを考えると、販売できたH100は多くても約160万基である。
その他のGPUは、H100換算で20万〜100万基を占める可能性が高い。前世代のA100のピークは2021年と2022年で、Nvidiaはこの2年でデータセンター部門の売上を合計250億ドル得た。1基15,000ドルとすると、販売数は最大170万基で、H100換算で約50万基に相当する。より控えめな推定では、150億ドル ÷ 2万ドル ≈ 75万基のA100、つまりH100換算でおよそ25万基となる。A100以外のGPUは、性能が低いか市場シェアがはるかに小さいため、寄与はより小さいだろう。先に、Microsoftの15万基のH100 GPUから、H100換算の総数はそのおよそ2倍になると推定した。同様の議論をここに当てはめると、H100以外のGPUからは最大で500,000 * 2 = 100万基のH100換算となる。
学習への割り当て:利用可能な計算資源は、新しいモデルの学習と既存のモデルの推論実行とに分けられる。簡単な分析によれば、AIラボは両方の作業に同程度の資源を割り当てるべきである。この均衡を仮定すれば、将来の資源配分を推定できる。2029年に学習と推論実行の計算量が等しく、学習計算量が年4倍で伸び続けるなら、総計算量の4分の1(2029年の学習計算量に等しい)は2029年のモデルの推論実行に使われ、4分の3は2030年のモデルの学習に使われる。つまり、2030年の計算量の80%は新しいモデルの学習に、20%は以前のモデルの推論実行に使われることになる。
結果:実際のH100、その他のGPU、TPUのストックを合計すると、2024年初めまでにH100換算で合計150万〜350万基と推定される。ストックの推定が最も大きいのはGoogleのH100換算40万〜140万基なので、このストックを使って総資源の配分を推定する。企業の計算資源の80%が学習に使われることを考慮して調整すると、最終的な結果として、最大の学習には利用可能なチップの総ストックの26%(16〜40%のどこか)を割り当てられる。
付録C:帯域幅の制約
個のデータセンターからなるリング型all-reduceの構成を考える。データセンターの各組の間の光ファイバーの帯域幅は bps、ネットワークを1往復するレイテンシは 秒とする。
標準的なリング型all-reduceは、 段の並列のreduceと、それに続く 段のbroadcastからなる。各段では、各ピアが隣のピアにサイズ のテンソルを送る。ここで はモデルのサイズであり、パラメータあたり8ビットと仮定すると、送信には 秒かかる。合計では 秒かかる。
これに、ネットワークの2往復に相当するレイテンシを加える必要があり、all-reduce 1回あたりの合計時間は次のようになる。
レイテンシについて論じた分散学習の実現可能性の節で説明したのと同様の論理に従うと、勾配の更新は最大で 回となり、データセットのサイズは まで可能になる。ここで は達成可能な最大のバッチサイズである。
モデルのサイズとパラメータ数の間には通常のChinchillaの関係()を仮定し、scipyのfsolve機能を使って、学習できる最大のモデルを数値的に求める。
付録D:マルチモーダルデータとテキストデータの換算
ここでは、画像1枚または動画1秒が、テキストの1トークンに対して何トークンに符号化されるかを推定する。
異なるモダリティのデータの換算率を定めるのは複雑である。極限的には、マルチモーダルのトークナイザーは、メディアに含まれる情報量にほぼ比例したトークン数でそのメディアを符号化すると予想される。そこで、画像データと動画データがテキストに比べてどれだけの情報を持つかを推定する。
Henighan et al(2020)は、32x32の画像1枚が説明文に比べてもたらす情報の増分は、2〜3語(つまりテキストの2〜4トークン)に相当すると推定しており、私たちはこれを画像の情報量の下限とする。Chameleon-34Bは、512x512の画像を、テキスト換算で1,024トークン、つまり770語で符号化する。2024年6月時点で、OpenAIはGPT-4oで512x512の画像を処理するのに、テキストトークン255個分の料金を課している。Yu et al(2023)は、典型的なテキストのトークナイザーの4倍の大きさである218トークンの辞書を使い、256トークンで画像を良好な性能で符号化している。私たちはこれを テキストトークンに相当するとみなす(典型的なテキストのトークナイザーは216項目のコードブックを使うので、このように調整する)。Yu et al(2024)は、211項目のコードブックから32トークンを使って256x256の画像を符号化しており、これは テキストトークンに相当する。Chameleonの論文が最も素直な応用例ではあるが、ほかの証拠がより低い次元を示していることを踏まえ、画像1枚あたり2〜290トークンの範囲を考える。
動画については、典型的な話す速さにもとづき、動画の1秒は2〜10語、つまりテキストの2〜13トークンに相当すると推測する。動画の情報は画像に比べて冗長性が高い。たとえば、典型的な高解像度の画像は2MBの容量をとるのに対し、720p/1080pの動画は1時間あたり1GBの容量、つまり1秒あたり0.2MBであり、動画1秒あたりの情報は画像10枚分より少ないことになる。そこで、話し言葉の1秒あたり2トークンを下限とし、画像に割り当てたのと同じ1秒あたり290トークンを、動画に含まれる画像の内容についての寛大な上限とする。
こうして、画像1枚または動画1秒あたり2〜290トークンという換算率が得られる。これは非常に大まかな推測であり、異論の余地が大いにあることを認めておく。
付録E:通信レイテンシの制約が変化する場合に可能な最大の学習の計算
この付録では、ツリー型トポロジーの構成を使って、レイテンシの制約にぶつからずに学習できる最大のモデルをどう推定するかを説明する。
層とバッチあたりのレイテンシ は、基本の通信レイテンシ と、ノード内の可変の通信レイテンシ およびノード間の可変の通信レイテンシ を組み合わせたものである。ここでは、8基のGPUからなるNVLINKノード(そのうち各層の後に協調するのは最大 基)とツリー構造を仮定し、NCCLのリポジトリにあるall-reduceのレイテンシの式を使う。各層にはアテンションとMLPのブロックがあり、学習中はバッチごとにそれぞれを順方向と逆方向に通過する必要があるので、これを4倍する。
各層の後に2次元テンソル並列の同期に関わるランクの数()は、テンソル並列全体に関わるランクの数の平方根である。これは、データ並列とパイプライン並列で実現できるGPU間の最大の分割数に反比例するとして上限を定める。その際、テンソル並列で効率よく処理できるバッチ内の最小サンプル数 を考慮する()。
そもそも を推定するには、GPUがその帯域幅のもとで達成できる利用率を調べる必要がある。この利用率は、メモリアクセスに費やす時間が計算に費やす時間とほぼ等しいときに最適になる。言語のTransformerでは、次元が のテンソルの乗算を行う。これにはおよそ 回の積和演算と、 回の読み書きが必要である。ここでdffとdmodelは、それぞれフィードフォワード層の次元とモデルの次元である。ハードウェアのピーク性能をH FLOP/s、帯域幅をW バイト/秒、パラメータの精度をpバイトとすると、メモリアクセスと計算が釣り合うのは次の場合である。
モデルが十分に大きければ、この式の右辺は に単純化され、次が得られる。
FP8精度のH100では、GPUあたりの最小バッチサイズは となる。理論的には、帯域幅とハードウェア性能の向上の速さが異なるので、この最小バッチサイズは時間とともに大きくなる。分析を簡単にするため、ほぼ一定にとどまると仮定する。
GPUの数は、モデルの計算量 を学習期間 と利用率で調整したハードウェア性能 で割ったもので近似する(利用率は規模とともに悪化するので、これは過小評価である)。
モデルの計算量 、データセットのサイズ 、モデルのサイズ は通常の関係に従う。
また、データセットのサイズ は、Chinchillaの規則に従ってモデルのサイズ に比例して大きくなると仮定する。
バッチサイズ と層の深さ は、モデルのサイズに対して指数関数的に増えると仮定する(バッチサイズがスケーリングしないと仮定する場合は、 を所与とすればよい)。
このとき、最小の学習時間 は、層とバッチあたりの時間 に、層の数 と勾配の更新回数()を掛けたもので下から抑えられる。規模が最大になる点では、この制約はちょうど等号で成り立つ。
この連立方程式を、scipyのfsolve機能を使って数値的に解く。
付録F:前例のない経済成長が巨額のAI投資を促しうる
「ラボはこの新たな高みまでスケーリングしようとするか」の節で、AIによる自動化がもたらす前例のない経済成長が、巨額のAI投資を促しうると論じた。これはまったく保証されたものではないが、この付録では、この力学を示すための大まかな計算を示す。
出発点として、生涯価値関数 を考える。そのフロー効用は、消費 について等弾力的とする。AIによる大規模な自動化の経済的な影響を捉えるため、消費は で一定のままある年 まで続き、その後は無限大になると仮定する。すると次が得られる。
ここで、和は年 についてとり、割引因子を 、異時点間の代替の弾力性を とする。
次に、これをAI投資に関連づける。具体的には、こうした経済的な影響が訪れる時期を早めるために、代表的な主体がどれだけのフロー消費を差し出す意思があるかを考える。代表的な主体にとって、消費 (年 )と消費 (年 )が無差別、つまり だとしよう。すると次が成り立つ。
この式に、説明のためにもっともらしい数値を入れてみる。大規模な自動化の時点を 年後から 年後に早めたいとし、割引率を2%(つまり )、 とする(Havránek et al. 2015)。すると となり、毎年のフロー消費の26%を差し出す価値があることになる!
米国では、GDPの約70〜80%が消費に充てられており(World Bank, 2022)、その額は毎年約18.75兆ドルにのぼる。上の計算を信じるなら、大規模な自動化の到来を早めるために、毎年約4.7兆ドル相当の消費を手放すことになる。もちろん、この計算は強気な仮定にもとづいているが、少なくとも、AIインフラへの巨額の先行投資がなぜ理にかなう場合があるのかを示している。
注
-
LLMについては、計算量のスケーリングがおそらく事前学習による性能向上の大半を説明する。事後学習の手法は、具体的な手法や分野によって、大きいがばらつきの大きい改善をもたらしうる。両方を考えると、計算量のスケーリングの相対的な重要性ははっきりしなくなる。 ↩
-
GPT-2の学習は約2e21 FLOP、GPT-4の学習は約2e25 FLOPで、1万倍の増加である。 ↩
-
レイテンシの制約のもとでの最大の学習の推定は楽観的すぎるかもしれない点に注意されたい。中程度のサイズの行列の乗算における通信レイテンシは、私たちの推定より効率が悪いのではないかと考えているからである。 ↩
-
この要約と本稿全体を通じて、範囲を示す場合は80%信頼区間と理解されたい。 ↩
-
ただし、開発者が最終的に他の国を選ぶ可能性もある点に注意されたい。たとえば、中国の事業者は過去10年間に1テラワットを超える発電設備を導入しており、UAEには電力の確保に有利な規制手続きがある。 ↩
-
学習の期間は2〜9か月とし、分散学習では、1つの企業が活用できるのはAIデータセンター向けの利用可能な電力供給の16〜40%にとどまると仮定している。 ↩
-
つまり、現在広く使われているGPUのなかでの最先端である。Nvidiaはすでに次世代のBlackwellチップを発表している。将来のGPUの世代については、2030年までの効率の向上を予測することで考慮している。なお、Google DeepMindは学習に主にGoogleのTPUを使っているが、私たちはNvidiaを基準にしている。NVIDIAの製品のほうがTPUより入手できる情報が多く、AI業界全体で圧倒的に広く使われているからである。 ↩
-
H100 DGX SuperPODサーバーの予想平均電力(EAP)と個々のGPUのTDPとの平均的な比率にもとづくと、オーバーヘッドの係数は1.4MW ÷ 1016基 ÷ GPU1基あたり700W = 1.96倍となる(こちらの表4を参照)。さらに、冷却や配電などデータセンター全体のオーバーヘッドを表す電力使用効率(PUE)は、たとえばPatterson et al(2021)では1.2倍の追加係数と報告されている。その結果、GPU1基あたり700 * 1.96 * 1.2 = 約1700Wとなる。ここでは私たちの以前の研究に従っている(論文の付録A.4を参照)。 ↩
-
平均的な米国の世帯は年に10,000 kWhの電力を消費しており、1年の8,760時間で割ると平均で約1,200 Wとなる。 ↩
-
これは、機械学習用ハードウェアの電力効率の傾向に関する私たちの以前の研究を発展させた分析から導いた。 ↩
-
4ビットでの学習は特定の研究の文脈で議論され、実証もされているが、実際に役立つかどうかははっきりしない。私たちは控えめに、役立たないと仮定する。 ↩
-
太陽光、風力、水力などの電源は断続的に発電するので、実際には1200 GWの容量をすべて使うことはできない。また、電力需要も時間とともに自然に変動する。米国は2023年に4,178テラワット時超を発電した。4178 TWh ÷ 1年の8760時間 = 平均477 GWの発電である。 ↩
-
この数値についての詳しい議論は「地理的に分散した学習における電力の制約」の節を参照のこと。 ↩
-
興味深い事例の一つは揚水発電所である。バージニア州バース郡には米国最大の揚水発電所があり、潜在的な出力容量は3GWである。入力容量もおそらく同程度である。「発電時の水の流量は最大で毎分1,350万米ガロン(51,000 m³)(毎秒850 m³)に達する。蓄電時の流量は最大で毎分1,270万米ガロン(48,000 m³)(毎秒800 m³)に達する」。もう一つの比較対象はCERNの大型ハドロン衝突型加速器で、消費電力のピークは200 MWである。 ↩
-
太陽光発電所の出力は時間帯によって変わるので、平均の容量は公称容量のおよそ4分の1である点に注意されたい。 ↩
-
注目すべきことに、そのすべてが水力、原子力、または化石燃料による発電所である。 ↩
-
大口の電力消費者は長期契約で電力を確保しているので、大規模な発電所の電力は少なくとも一部が契約で押さえられている。さらに、私たちが相談したある専門家は、米国の多くの地域が電力不足の「高いリスク」にさらされているため、既存の供給を考えると米国には余剰の電力容量がほとんどないと述べた。 ↩
-
2000年以降に建設された3GW超の米国の発電所は、2つしか見つけられなかった。フロリダ州のManatee石油火力発電所とWest County Energy Centerである。3GW超のその他の発電所の大半は1970年代に建設された。West County Energy Centerは2006年3月に建設許可が下り、2011年7月までに3基目の発電設備の建設を終えた。これは、3GW超の発電所を5年で建設できることを示唆している。 ↩
-
これはすでに存在するか計画されている発電所に当てはまることを強調しておく。強い意志を持つ主体なら、3 GWを超える大規模な発電所を自ら建設できるかもしれない。 ↩
-
北バージニア最大の電力会社(Dominion)は、2019年以降に4 GWを超えるデータセンターを接続しており、データセンターとの契約は5.8 GWにのぼる。北バージニアの別の電力会社NOVECも多くのデータセンターに電力を供給しているが、顧客数はDominionの270万に対して17万5,000と、全体としてははるかに小さい電力会社である。 ↩
-
Dominionは年10%の伸びを予測しており、これは6年間で約1.8倍の増加になる。伸びの予測についての詳細は次の節を参照のこと。なお、こうした大規模なデータセンターへの需要がはっきりするにつれて、電力会社は拡張計画を見直す可能性が高く、予想外の需要に直面して積極的に拡張した前例もある。たとえば2022年、Georgia Powerは「州内の新しいデータセンターと製造業のために、わずか18か月前の予測の17倍の電力、つまり新しい原子炉4基分に相当する電力が必要になる」と述べた。 ↩
-
「[MicrosoftとOpenAIの]幹部は、早ければ2028年にStargateを始動させ、2030年にかけて拡張することを議論しており、最終的には5ギガワットもの電力が必要になる可能性がある」。Stargateは提案されているプロジェクトのコードネームである。 ↩
-
H100に比べてW(ワット)あたりのFLOP/sが4倍になり、FP8の性能を使うと仮定している。今日の学習と同程度の100日では、約7e28 FLOPになる。 ↩
-
Geminiの技術報告書:「Gemini Ultraの学習には、複数のデータセンターにまたがる、Googleが所有する大規模なTPUv4アクセラレータ群を使った」。いくつのデータセンターに分割されたのか、またそれらが近接していたのかは明らかでない。 ↩
-
所在地については同社のISO 27001適合報告書を参照のこと。 ↩
-
現在、米国のデータセンターはおそらく平均で20 GWを超える電力を消費している。IEAは、米国のデータセンターが「2022年に約200 TWh(米国の電力需要の約4%)」を消費したと推定しており、これは年間平均で約23 GWになる。一方、McKinseyは2022年の米国のデータセンターの平均消費を17 GWと推定し、Goldman Sachsは2023年に146 TWh、つまり平均約17 GWと推定している。こうした推定の幅と近年の急速な伸びを考えると、現在の値はおそらく20 GWを上回っている。 ↩
-
20 / 0.6 = 33.3、20 / 0.4 = 50。 ↩
-
SemiAnalysisは、電力使用効率(PUE)を考慮せずにクリティカルIT容量(図2を参照)を報告している。PUEとは、データセンターの総電力を、冷却などのオーバーヘッド機能ではなく計算に直接使われる電力で割ったものである。私たちのGPU1基あたりの消費電力の推定にはこのオーバーヘッドも含まれているので、IT容量ではなく総容量を使う必要がある。SemiAnalysisの推定にもとづき、AI以外のデータセンターのPUEを1.5倍、AIデータセンターのPUEを1.2倍と仮定して、36 GWと48 GWという推定を得た。 ↩
-
これは、2つの異なる予測から伸び率を逆算したものである。第一に、Dominionはデータセンターの容量が2023年から2028年にかけて2倍になると予測している。5年で2倍は年約15%の伸びである。系統運用者による別の予測では、Dominionのデータセンターの負荷は15年で4倍になり、4^(1/15) = 約1.1、つまり年10%の伸びとなる。ここでは2030年までの伸びを論じているので、より短期の予測のほうがおそらく適切である。 ↩
-
上の図からは、AI以外のデータセンターとAIデータセンターのIT設備容量として、それぞれ22,109 MWと2,537 MWが読み取れる。前者のPUEを1.5倍、後者を1.2倍と仮定すると、AIデータセンターの設備容量は となり、これは総設備容量の にあたる。 ↩
-
Goldman Sachsは、AI以外のデータセンターのエネルギー使用量が2024年の165 TWhから2030年に304 TWhへ増えると予測しており、これは10.7%の伸び率になる。SemiAnalysisは、2023年末から2028年末にかけてのAI以外のクリティカルIT容量の伸び率を8%と推定している。SemiAnalysisのデータによれば、北米のAI以外のIT容量の最近の年間の伸びは11〜13%だった。 ↩
-
比較のために言えば、Goldman SachsとSemiAnalysisはいずれも、2024年を通じてAIの電力需要が計画上2倍超に拡大すると見込んでいる。これは小さな基数からの拡大なので、どれだけ長く維持できるかははっきりしない。 ↩
-
これは、Nvidia H100 GPU換算の単位で測った、利用可能なAIチップの総ストックに占める各企業の現在の割合にもとづいている。電力容量の割合をチップの割合にもとづいて推定したのは、関連するデータがより多く得られたからであり、また電力容量とチップの数には強い相関があるからである。私たちの最善の推測では、現在最大の割合を持つのはGoogleで、33%(20〜50%)である。詳細は付録Bを参照のこと。企業によっては、資源のかなりの割合を推論実行のために確保しておくことを選ぶかもしれない。ここでは暗黙のうちに、企業は資源の大半を学習用クラスタに充て、そのクラスタを後で推論実行に再利用するかもしれないと仮定している。 ↩
-
Geminiの技術報告書:「Gemini Ultraの学習には、複数のデータセンターにまたがる、Googleが所有する大規模なTPUv4アクセラレータ群を使った」。 ↩
-
これは、米国の主要なデータセンター集積地をすべて結ぶ11,000kmのリング型ネットワークに相当する。信号は秒速200,000 kmで伝わると仮定する。これは悲観的な仮定であり、分散したデータセンターがここまで離れている必要はない。パケットを送るスイッチのレイテンシも考慮している。MarvellのTeralynx 10のような現代のイーサネットスイッチのレイテンシはパケット転送1回あたり500 nsのオーダーで、はるかに大きい伝送のレイテンシに比べれば無視できる。 ↩
-
Chinchilla最適なスケーリングのもとでは、モデルはパラメータあたり20トークンで学習すべきである。また、モデルの学習にはトークンとパラメータの組あたり6 FLOPが必要である。したがって、FLOPは6 x 1.4e16 x 1.4e16 / 20 = 5.88e31となる。 ↩
-
InfineraのGXシリーズのような他の光ファイバーのソリューションは、ファイバーと波長あたり1.2 Tbpsをうたっており、より高い性能を達成できるかもしれない。 ↩
-
帯域幅が増えればより大きなモデルを学習できるが、モデルが大きいほど勾配の更新に時間がかかるので、計算はやや複雑である。計算方法は付録Cで説明する。 ↩
-
データセンター同士の協調は、スイッチとルーターによる方式で行われるとは限らない点に注意されたい。たとえば、近接する複数のデータセンターは、RDMA over Converged Ethernet(RoCE)のようなプロトコルで接続し、ルーターを介さずに大規模な学習を協調して行える。それでも、B4ネットワークは、ハイパースケーラーが大規模なデータセンター間で達成できる帯域幅を示す例になると考える。 ↩
-
この区間は、2001年から2023年の間に発表された33個のASICスイッチ・コントローラーを対象としたブートストラップによる指数回帰から導いた。 ↩
-
ファイバーの容量を増やすには、ポートの数かファイバーあたりの帯域幅を増やす必要がある。ファイバーあたり最大700Tbpsの長距離接続が実証されているが、私たちが相談した専門家は、商用の環境ではファイバーあたり最大3 Tbpsの帯域幅を見込むべきだと考えている。研究の場でこれを超えるために使われる手法は、空間分割多重のような技術に依存しており、商用ではファイバーの本数を増やすより劣ると考えられているからである。過去の傾向からは、この10年の終わりまでに600 Tbps ÷ 128ポート = 5 Tbpsとなり、専門家の評価とおおむね一致する。つまり、この傾向は実際にこの水準まで続きうることが示唆される。 ↩
-
帯域幅の拡大に関連する費用の例を2つ挙げる。200 Tbps、6,000kmの大西洋横断ケーブルMAREAの費用は1億6,500万ドルだった。一方、商用の200Gのラストワンマイルの地下光ファイバーの敷設費用は1フィートあたり11.30〜24.13ドルである。これらの費用は、陸上のデータセンター間接続をあまりよく代表していないかもしれない。 ↩
-
この推定は、分散した電力と帯域幅のそれぞれのもとで可能な学習の分布の最小値に対応する。 ↩
-
この最後の推定は、直前の推定と、単一のデータセンター・キャンパスで実現可能な学習との分布の最大値に対応する。 ↩
-
当然生じる疑問の一つは、供給の伸びとは無関係に、AI開発者が既存の利用者より高い値を付けるだけで、より多くの電力を獲得できるのではないかというものである。米国では電力会社は厳しく規制されており、価格決定を精査する委員会の監督を受けている。このため、データセンターが電力をめぐって他の利用者より高い値を付けられる範囲は限られるかもしれない。 ↩
-
計画、許認可、建設を含む開発期間全体は、これより長くなる。太陽光発電所は、許認可を除き計画期間を含めて2年未満で済む。 ↩
-
世界的には、原子力発電所の建設期間は平均6〜8年だが、米国で最も新しい原子力発電所であるVogtleは約14年かかった。バース郡やグランドクーリーのような主要な水力発電所は、およそ10年を要したようである。風力発電の建設期間はかなりばらつきがあるようで、その分布ははっきりしない。 ↩
-
ただし、最近閉鎖されたいくつかの原子力発電所は、より短い期間で再開されるかもしれない。また、Sam Altmanが支援する2つの企業を含め、さまざまな種類の次世代原子力発電所に取り組んでいる企業もあるが、これらが2030年までに大規模に導入される可能性は低いと見られる。 ↩
-
太陽光発電は全体としてはガスより安いとも言えるが、運用費が非常に低い代わりに、初期の資本費用が高い。EIAは、蓄電池付きの太陽光発電の資本費用を1kWあたり2,000ドル超と推定しており、太陽光の発電が断続的であることを考慮すると1kWあたり8,000ドルを上回る。電力を非常に積極的に拡大しようとする企業は割引率が高く、そのためにガスを好むかもしれない。 ↩
-
ある2020年の論文は、炭素回収によってガスの費用が1kWhあたり3.87セント上がると推定している。別の推定では、ガスの炭素回収の費用はCO2排出量1トンあたり79〜88ドルである。天然ガスは1kWhあたり約1ポンド、つまり約2000分の1トンのCO2を排出するので、こちらもやはり1kWhあたり約4セントとなる。 ↩
-
1700 Wで270日間は約11,000 kWhであり、1kWhあたり17セントで約1800ドルになる。 ↩
-
ただし、系統接続の待ち行列にあるプロジェクトの総容量は1480 GWと膨大なので、この制約がどれほど厳しいかははっきりしない。系統接続を申請したプロジェクトの大半は最終的に取り下げられるので、今後数年で1480 GWの容量が稼働するという意味ではない。 ↩
-
AIの成長を支える電力源としてクリーンエネルギーと化石燃料のどちらが適しているかについては、合意がない。NextEraのCEOは、風力と太陽光のほうがガスより有望だと述べた。一方、元米国エネルギー長官のErnest Monizは、データセンターは化石燃料に大きく頼らざるをえないと考えている。いずれにせよ、使えるエネルギー源を限定すれば、拡大はおそらくより難しくなる。 ↩
-
この節全体を通じて、圧倒的な市場シェアを持つNvidiaに焦点を当てている。ただし、GoogleのTPUを含む他社のAIチップも、生産の拡大にあたって同様の制約に直面すると予想される。AIチップのサプライチェーンはTSMC、SK Hynix、Samsungのようなファウンドリに高度に集中しているので、チップメーカーが違っても同様の制約に直面する。 ↩
-
1つのラボが200万基のH100の約4分の1を学習用に集め(付録Bを参照)、FP8精度で2e15 FLOP/s、FLOP/sの利用率40%、学習期間6か月と仮定した場合である。 ↩
-
1,600万基のGPUがそれぞれ2e15 FLOP/sの性能を利用率40%で6か月間発揮すれば、2e29 FLOPを実行できる。 ↩
-
これは、性能の向上が年40%前後という過去のペースで続くと仮定したうえでのことである。そのペースなら性能は8倍になるが、FLOPの合計を20倍にするには足りない。 ↩
-
ウェハーは大きなシリコンの板で、そこから多数のダイが作られ、ダイはパッケージングされてチップになる。ウェハー1枚からH100 28基分のダイを作れる。 ↩
-
いつフル稼働に達するかは明らかでない。 ↩
-
これは、チップの数そのものがこのペースで増えるという意味ではない。とくに、Nvidia B200のように複数のダイを1つのチップにパッケージングする場合はそうである。 ↩
-
AIチップの性能の傾向を維持するには、将来、CoWoS以外の新しいパッケージングの方式が必要になるかもしれず、それには新しい生産ラインへの移行が必要になるかもしれない。これは不確実性を多少増やすが、私たちのモデルでは、将来の伸びはCoWoSの最近の伸びと計画されている伸びと同程度だと仮定している。 ↩
-
対応する売上の報告と推定されるウェハー価格にもとづき、2023年第4四半期の平均は3nmウェハーが月約5万枚、5nmウェハーが月約13万枚と推定した。同様に、China Timesは、2023年末までに3nmで月6万〜7万枚が見込まれると報じた。5nmと3nmの数字を合わせると、2024年初めの5nmと3nmのプロセスノードの月間総生産量は約18万枚だった可能性が高い。これは、これらの先端プロセス技術を使ったウェハーの年換算の生産量で220万枚にあたる。なお、NVIDIA H100 GPUはTSMCの特別な4Nノードで製造されているが、このノードはTSMCの売上報告では5nmに含まれている。 ↩
-
欠陥を考慮したうえでウェハー1枚あたりH100のダイ28個と仮定すると、200万基のH100 GPUには約71,429枚のウェハーが必要になる。2024年初めの5nmウェハーを月13万枚とする推定を使うと、これはTSMCの5nmウェハーの年換算の生産能力のおよそ5%にあたる(71,429 / (130,000 * 12) ≈ 4.6%)。 ↩
-
これは で近似できる。ここで は加算されるパーセントポイントの数である。 ↩
-
これでさえ、過去5年間のNvidiaのデータセンター部門の売上の伸びに比べれば控えめである。 ↩
-
2014年の12インチ換算で年818万枚から、2023年のおよそ1,650万枚への増加である。TSMCの2025年の設備投資の伸びの計画は、こうした過去のペースと一致している。 ↩
-
生産量が設備投資の何乗かに比例するとモデル化すれば、設備投資の伸びを比例して拡大すると、生産量の伸びも比例して拡大するはずである。したがって、8% / 15% * (30%〜70%) ≈ 16%〜37%となる。 ↩
-
2029年に学習と推論実行の計算量が等しく、学習計算量が年4倍で伸び続けるなら、総計算量の4分の1(2029年の学習計算量に等しい)は2029年のモデルの推論実行に使われ、4分の3は2030年のモデルの学習に使われる。つまり、2030年の計算量の80%は新しいモデルの学習に、20%は前年のモデルの推論実行に使われることになる。 ↩
-
GPT-4oやClaude Opus 3.5のような大規模な独自モデルは、より大きなデータで学習されているかもしれない。 ↩
-
データのボトルネックに関する私たちの以前の研究と同様の論理に従い、データセットのサイズを5エポック分と、品質による5分の1のペナルティ係数で調整している。中央値の推定では、この2つの係数は相殺される。 ↩
-
これを推定するにあたり、モデルの学習に使われる計算量は学習トークン数とモデルサイズの積のおよそ6倍だと考える。パラメータあたり20トークンというChinchillaの処方に従えば25兆パラメータが推奨され、6 * 25T * 500T = 7.5e28となる。 ↩
-
専門家混合(mixture-of-experts)アーキテクチャのような疎なモデルを学習する場合はどうだろうか。疎性によって、順伝播1回あたりに関わるパラメータの数を大幅に減らせる。学習に使うトークン数がおおむねChinchillaのスケーリングに従うなら、データのストックは、より小さな計算量の規模で使い尽くされると予想される。典型的な疎性の水準を考えると、少なくとも10倍は小さい規模である。しかし、疎なモデルのスケーリング則はよくわかっておらず、効率的に学習されたモデルはより少ないデータで学習されるかもしれない。当面、この点は考慮しない。 ↩
-
AIラボは、学習データのボトルネックに突き当たっても、効率は落ちるものの、データセットのサイズを増やさずにより大きなモデルを学習して性能を高めることができる。これは学習不足(undertraining)と呼ばれる。たとえば、損失がChinchillaのパラメトリックな当てはめに従うなら、Chinchillaのスケーリングに比べて損失の勾配が10分の1になるだけで、モデルを最大3000倍まで学習不足にできるかもしれない。同様に、AIラボは推論実行時の効率を高めるために、モデルを過剰学習(overtrain)させることを選ぶかもしれない(これにより、より小さなモデルで同程度の性能に達することができる)。過剰学習によって、AIラボはより早くデータのボトルネックに突き当たるかもしれない。簡単のため、学習不足と過剰学習についての考慮は脇に置く。 ↩
-
もう一つ考慮すべき点として、人口が増え、インターネットの普及率が高まるにつれて、人間が生成したテキストデータのストックは時間とともに増える。私たちは以前、これによって公開されているテキストデータのストックが年約7%増え、この10年の終わりまでにデータのストックが50%増えると推定した。最終的な推定ではこれを考慮しているが、影響が小さいため議論では省略する。 ↩
-
ここでは、私的な通信、ユーザーの端末の操作記録、科学や天文のデータなど、より特殊なデータ源は無視している。これらによって、さらに規模を拡大できるかもしれない。 ↩
-
Chameleonは画像データを37%含む混合データを使い、Qwen-VLは17%を使った。GPT-4は15%を使ったとされている。 ↩
-
私たちのデータベースで最も費用のかかった純粋な画像モデルはViT-22Bで、4e23 FLOPであり、フロンティアの言語モデルやマルチモーダルモデルより2桁少ない。 ↩
-
生物学的配列のデータベースには数十億のタンパク質配列とペタバイト規模の遺伝データが含まれているが、遺伝子配列の大半は冗長性が非常に高い。人間のゲノムのうち個人間で異なるのは最大でも0.4%にすぎない。したがって、重複を除いた総量はおそらく数十兆トークンであり、画像やテキストのデータよりかなり少ない。 ↩
-
たとえば、Whisperのような音声認識モデルを使って昨年収録された3,000万本のポッドキャストを書き起こせば、3,000万本 x 1本あたり10分 x 1秒あたり3トークン = 27億トークンのオーダーのテキストを生成できる。 ↩
-
McGrady et al(2024)は、YouTubeにアップロードされた動画を約140億本と推定しており(こちらで更新)、平均の長さは615.14秒である。YouTubeはすでにインターネットの全トラフィックの7%を占めているので、インターネット上の動画コンテンツの総量はこれよりそれほど大きくはないだろう(トラフィックとコンテンツは同じではないが、おそらく相関は強い)。Lee(2021)は、世界で撮影される画像は年約1兆枚のオーダーだと報告しており、ストックは合計で約10兆枚に近いと考えられる。 ↩
-
リンク先の論文は符号化に32トークンを使っているが、使われているトークンの辞書は典型的なテキストのトークン辞書より70%小さい。 ↩
-
付録Dでは、モダリティ間の換算をより慎重に推定している。要するに、画像と動画のトークナイザーに関する既存の研究と、画像と動画の圧縮率にもとづいて、根拠のある推測を行った。その結果、画像1枚または動画1秒あたり2〜290トークンという推定に至った。 ↩
-
先に述べたように、インターネットには10兆秒のオーダーの動画があり、その大半には対応する音声がある。しかし、動画とそれに対応する音声の間にはおそらくかなりの冗長性がある。オーディオブックのように、話し言葉の録音の多くは書き起こされてもいる。主に書き起こされていない音声の大きな供給源はポッドキャストである。Podcast Indexは1億4,300万本のポッドキャストのエピソードをインデックスしており、エピソードあたりの平均の長さを約40分とすると、約3,500億秒の音声になる。音楽はおそらく最も冗長性の低い種類の音声データで、Spotifyには1億曲があり、これは約240億秒の音楽に相当する。全体として、公開されていて冗長でない音声は数千億秒のオーダーで存在する可能性が高いと見られる。 ↩
-
テキストと同様に、非公開のデータセットはおそらく公開の情報源より多くのデータを含んでいる。WhatsAppだけでも年に70億件のボイスメッセージが送られており、これは1,000億〜1兆秒の話し言葉に相当し、10年間では合計1兆〜10兆秒になる。 ↩
-
10倍の計算量で学習する対象モデルはパラメータが 倍になるので、学習中に1つのデータ点を処理するのに FLOPかかる。そのデータ点の生成に必要なのは FLOPである。これは、 パラメータの初期モデルを使い、 の学習の差にわたって推論実行と学習のトレードオフを利用した場合である。したがって、各データ点について、生成に使う計算量と学習に使う計算量の比は となる。 ↩
-
ほとんどの場合、推論実行の計算量を増やして出力の質を高められる範囲には限界がある。この頭打ちは通常、推論実行の計算量を1〜2桁増やしたあたりで起こるが、試行回数に制限のないコード生成のような特定の課題では、効果がさらに続くこともある。 ↩
-
この節全体を通じて、Erdil and Schneider-Joseph(2024)の結果に従う。 ↩
-
ここでは論じていない関連するボトルネックとして、計算とメモリアクセスの不均衡による利用率の低下があり、メモリの壁とも呼ばれる。これは小さな行列で起こり、実際、現在のハードウェアではレイテンシのボトルネックよりもこちらのほうが厳しい制約になると予想している。メモリ帯域幅とハードウェア性能のバランスが今後どう変わっていくかははっきりしない。 ↩
-
NCCLのリポジトリによれば、基本レイテンシは6.8 µsで、NVLINKのリングの可変レイテンシはランクと通信ラウンドあたり0.6 µsである。典型的なNVLINKの構成ではGPUは8基で、2次元テンソル並列のために行列乗算ごとにそのうち2〜3基が通信する。all-reduceには2ラウンドの通信が必要なので、all-reduceあたりの通信のレイテンシは となる。 ↩
-
QKVの射影、アテンションの計算、2つの連続する線形層である。 ↩
-
モデルをスケーリングする自然な方法の一つは、モデルの幅、フィードフォワード層の次元、層の数をそれぞれほぼ比例して大きくすることである。これは実際に一部の開発者によって裏づけられている。たとえばErdil and Schneider-Joseph(2024)は、Hoffmann et al(2022)がモデルを でスケーリングしていると計算している。ここで は層の数、 はパラメータ数である。なお、「形状」についてのスケーリング則の研究はほとんどないので、この関係が将来も成り立つかどうかについては大きな不確実性がある。 ↩
-
計算を順に追うと次のようになる。学習時間 は9か月未満でなければならず、少なくとも生じるレイテンシ 以上である。ここで は層とバッチあたりの最小レイテンシ、Lは層の数、 は処理するバッチの数(データセットのサイズ をバッチサイズ で割ったもの)である。不等式 を、スケーリングの仮定 と のもとで解くと、 が得られる( はモデルのパラメータ数)。その結果、最大のモデルサイズは700兆パラメータとなり、Chinchillaのスケーリングに従えば FLOPの学習が可能になる。 ↩
-
レイテンシの制約のもとで、学習不足によって損失をさらに最適化することも検討した。その結果、Chinchillaのスケーリングに比べて損失の減少はわずかだったので、この可能性は無視する。 ↩
-
モデルが疎性を使う場合、層の数、ひいてはレイテンシが一定のままでも、モデルのパラメータあたりに費やす計算量は大幅に少なくなるかもしれない。しかし、データの量とモデルの層の数の最適な関係も変わるかもしれない。疎なモデルのスケーリング則はよくわかっていないので、当面この可能性は無視する。 ↩
-
個のポッドとポッドあたり 基のGPUが関わるall-reduceのレイテンシは、 とモデル化できる。NCCLのリポジトリに記載されている低レイテンシ(LL)のツリー構成での基本、ノード内(NVLINK)、ノード間(InfiniBand)のレイテンシの値として を使い、これにErdil and Schneider-Joseph(2024)と同様に のカーネルレイテンシを加える。 ↩
-
この数値の計算方法は付録Eで説明する。要するに、レイテンシがクラスタのサイズに依存し、逆にクラスタのサイズもレイテンシに依存するような、非線形の連立方程式を立てている。 ↩
-
Chinchillaのスケーリングでは、損失はモデルサイズの約0.35乗に比例して減少する。 ↩
-
ここまでの議論では関心のある時点として2030年に焦点を当ててきたが、私たちが構築した外挿モデルは、それまでの年にもそれ以降の年にも適用できる。モデルの説明は付録Aを参照のこと。 ↩
-
2e29 FLOPの学習には、H100換算で3,000万基を利用率40%で3か月間稼働させる必要がある。性能が年44%向上し、最先端の機械学習用GPUの価格が10%上がるとすると、ハードウェアの取得費用は約2,000億ドルになる(学習期間を2倍にすれば、そのおよそ半分になる)。 ↩
-
Nvidiaのデータセンター用GPUの世代はおよそ2年おきなので、前の世代の性能は次の世代の 分の1、つまり約0.48倍である。Microsoftが過去4世代のGPUをそれぞれ15万基購入したとすると、合計はおよそ となる。 ↩
-
Bloombergの推定(Yahoo Finance経由)によれば、2024年第1四半期のNvidiaの売上の19%をMicrosoftが占めた。Nvidiaの今年第1四半期のデータセンター部門の売上は226億ドルだったので、そのうち19%をMicrosoftが占め、H100の価格を1基3万ドルと仮定すると、2024年第1四半期時点でMicrosoftのH100は最大14万基となる。 ↩
-
CRNの報道によれば、TechInsightsはTPUに帰属する売上を「GoogleのTPUの設計を支援しているBroadcomが報告したカスタムチップ設計の売上と、GoogleがTPUを社内およびクラウド顧客向けにどう展開しているかを見て」推定した。「そのうえで、GoogleのTPUに公正な市場価格を当てはめた」。 ↩