
レポート
AIに関する大統領令から見た生物配列モデル
原題:Biological sequence models in the context of the AI directives
要旨
ホワイトハウスが最近出したAIに関する大統領令は、生物学に応用されたAIのリスクを取り上げている。この大統領令は、主に生物配列データを用いて1e23回を超える演算で機械学習モデルを学習する開発者に対し、モデルの開発中に行ったサイバーセキュリティ、レッドチーミング、その他のリスク管理の取り組みを連邦政府に報告するよう義務づけている。
本レポートでは、生物配列モデルを対象に新たに整備したデータセットの概要を示す。このデータセットには、100件近い生物配列モデルについて、学習に使われた具体的なデータセット、想定されるタスク、モデルの重みの入手可能性などの包括的な情報が含まれている。さらに本分析では、合わせて数十億件のタンパク質配列を含む30の生物配列データセットも扱っている。本分析で注目する点は次のとおりである。
生物配列モデルの学習計算量の傾向
- パラメータ数1,000億のタンパク質言語モデルである xTrimoPGLM-100B(Chen et al., 2023)は、大統領令の報告義務の閾値である1e23回の演算を6倍上回っている。十数件以上のモデルが、大統領令の報告閾値まで10倍以内のところにある。
- 生物配列モデルの学習に使われる計算量は、過去6年間で平均して年8〜10倍のペースで増えてきた。この学習計算量の急速な伸びは、コンピュータビジョンや強化学習のシステムの伸び率を上回り、言語モデルの伸び率に匹敵する。1
生物配列データ
- 数十億件のタンパク質配列と構造データを提供する大規模な公開データベースがある。主なタンパク質配列データベースには、UniRef(3億6,500万配列)、UniProtKB(2億5,200万)、MGnify(30億)、BFD(25億)、MetaClust(16億)がある。
- 主要なデータベース全体でのタンパク質配列データの総量は約70億件と推定される。これは、今日の最高水準の生物配列モデルの学習にこれまで使われてきた量より1桁大きい。
- タンパク質とDNAの配列データの総量は急速に増えている。2022年から2023年にかけて、主要なデータベースはDNA配列で31%、メタゲノム由来のタンパク質配列で20%、タンパク質構造で6.5%の割合で伸びた。
- タンパク質配列の大半は、既知のDNA/RNA配列を翻訳して得られたものである。加えて、PDB の実験的に検証されたタンパク質構造や、AlphaFoldDB と ESMAtlas のAIで予測された構造が、モデルの学習を補う資源として急速に拡大している。
本分析は、使われた計算資源や学習データを含め、生物配列モデルを包括的に概観する。これにより将来の計算量の伸びの傾向を外挿でき、さらに規模を拡大したときにどのモデルが規制上の精査を必要としそうかについて、有益な知見が得られる。本研究はさらに、規制監督のための学習計算量の閾値の現行の定め方に、規制上の抜け穴がありうることを明らかにする。具体的には、大統領令の下では、生物データを相当量含むが過半ではないAIモデルは、学習中に1e23回を超える演算を使っていても、厳格な監督を免れるかもしれない。そうなると、強化された報告義務を課されることなく、大量の生物配列でモデルを学習できてしまう可能性がある。
AIに関する大統領令
ホワイトハウスが2023年10月に出した大統領令は、人工知能(AI)システムの開発と展開がもたらしうる国家安全保障上のリスクに対処するため、包括的な一連の措置を打ち出している。この大統領令は、「デュアルユース基盤モデル」を開発する企業に、政府への定期的な報告の提出を義務づける。報告には、モデル開発の計画とリスク管理の戦略を詳しく記す必要がある。そこには、モデルの重みを保護する取り組みや、危険な能力を特定するためにモデルにレッドチームテストを行う取り組みが含まれる。
大統領令によれば、報告義務の対象となる「デュアルユース基盤モデル」の定義は商務長官が決定し、更新する。ただし、長官が正式な定義を示すまでの暫定期間に報告の対象となるモデルとして、二つの具体的な区分を挙げている。
10^26回を超える整数演算または浮動小数点演算の計算能力を用いて学習された[あらゆる]モデル、あるいは、主に生物配列データを用い、かつ10^23回を超える整数演算または浮動小数点演算の計算能力を用いて学習されたモデル。
「主に生物配列データ」を用いて1e23回を超える演算で学習されたAIモデルを開発する主体は、新たな報告とコンプライアンスの要件に直面する。生物データで学習されたモデルに加えて、この大統領令は、生物配列だけを扱うわけではなくても悪用されうる大規模な基盤モデルにも監督を広げている。こうしたデュアルユースのモデルは通常数百億のパラメータをもち、精査に値する。その規模と汎用性ゆえに、高リスクの分野に誤って応用されれば、悪用されやすいからだ。
大統領令は大まかな指示を与えているが、求められる報告の基準、レッドチームテストの正確な内容、研究所が実施すべきサイバーセキュリティ対策は定めていない。こうした空白を埋める作業は米国国立標準技術研究所(NIST)に委ねられている。NIST はエネルギー長官および国土安全保障長官と連携して、今年後半にリスク評価と規制の枠組みを策定することになっている。これらの枠組みは、生物配列データを扱うAIモデルの学習、展開、普及、応用の指針となり、その安全で責任ある利用を確保するものになる。
Epoch AI はこれまでに、多くの大規模機械学習モデルの情報を公開してきた(Epoch AI, 2024)。しかし、この大統領令は、生物配列モデルに限って1e23回の演算というより低い報告閾値を設けている。本分析では1e23回の閾値の影響を受けるモデルを取り上げ、生物学に応用されたAIへの統治を強化するこの大統領令の下で、規制上の開示が必要になりそうなモデルを明らかにする。
生物配列データで学習されたモデル
2020年のタンパク質構造予測精密評価(Critical Assessment of Structure Prediction、CASP)第14回大会で AlphaFold 2 が変革的な性能を示して以来、生物学の問題に機械学習の手法を応用することへの関心が急速に高まっている(Read et al., 2023)。生物配列モデルの大半は、タンパク質(アミノ酸)、DNA、RNAの配列で学習されている。生物配列モデルはさまざまなタスクをこなすように学習される。主なタスクは次のとおりである。
- タンパク質構造予測:AlphaFold 2(Jumper et al., 2021)、RoseTTAFold(Krishna, 2023)、ESMFold(Lin et al., 2022)がこの群の代表例である。これらのモデルは、アミノ酸配列からタンパク質の三次元構造を直接予測する。
- タンパク質設計:Fold2Seq(Cao et al., 2021)、ProGen(Madani et al. 2023)、ProteinGAN(Repecka et al., 2021)がこの群に属する。これらのモデルは、特定の構造上または機能上の制約を満たす新しいタンパク質配列を生成するように設計されている。合成生物学の分野で、望ましい特性をもつタンパク質の設計に使われている。ZymCTRL(Munsamy et al., 2022)のように、酵素など特定の種類のタンパク質の生成に特化したモデルもある。
- 接触・距離予測:DMPfold(Greener, 2019)や DeepConPred2(Ding, 2018)などのモデルがこの群の例である。これらのモデルは、タンパク質内のアミノ酸残基間の距離と接触の予測に特化している。こうした予測は、タンパク質の折りたたみの仕組みを理解するうえでも、構造予測モデルの精度を高めるうえでも欠かせない。
- タンパク質-リガンド相互作用予測:この区分には、特定の分子とタンパク質の結合のふるまいを予測するのに重要なモデルが含まれる。例として、タンパク質-リガンド結合親和性を予測する LEP-AD(Daga et al. 2023)や、RNA配列とRNA結合タンパク質の相互作用を予測する BERT-RBP(Yamada and Hamada, 2022)がある。
- 遺伝子制御領域予測:HyenaDNA(Nguyen et al. 2023)や DNABert(Ji et al. 2021)など、遺伝子配列で学習されたモデルは、DNA配列内のプロモーター、エンハンサー、スプライス部位といった制御領域を予測するように学習されている。
- 汎用の生物配列モデル:汎用の生物配列モデルとは、特定のタスクに依存しない形で生物配列の表現を学習するモデルである。ラベルのないタンパク質、DNA、RNAの配列からなる大規模なデータセットで学習され、多様な生体分子に共通する構造上・機能上の特性を捉える。例として、Ankh(Elnaggar et al., 2023)や xTrimoPGLM-100B(Chen et al., 2023)がある。ファインチューニングを行えば、汎用モデルを活用して、配列の変異が機能に及ぼす影響、タンパク質の細胞内局在、タンパク質の構造、タンパク質間の相互作用など、タンパク質の機能のさまざまな側面を予測できる。
これらの区別は厳密な境界ではない。あるタスクのために開発されたモデルが、ほかのタスクに転用できることも多いからだ。たとえば AlphaFold 2 はもともとタンパク質構造予測のために設計されたが、ほかの多くの用途にもうまく応用されてきた。ヒトのプロテオームにおける単一アミノ酸の変化がタンパク質の機能を損なうかどうかの予測(AlphaMissense、Cheng et al. 2023)や、複数の鎖からなるタンパク質複合体の予測(AlphaFold-Multimer、Evans et al. 2021)などである。2
生物配列モデルには、LSTMや、特にTransformerなど、自然言語処理で一般的なアーキテクチャがよく使われる(Hu et al., 2022)。たとえば、OpenAI の GPT や Google DeepMind の Gemini といった主要な言語モデルで使われているTransformerアーキテクチャ(Vaswani et al., 2017)は、Nucleotide Transformer(Dalla-Torre et al., 2023)や xTrimoPGLM-100B(Chen et al., 2023)などの生物配列モデルにも採用されている。
自然言語処理のアーキテクチャを生物配列に適用してできたモデルは、タンパク質配列の場合はタンパク質言語モデル(pLM)、DNAやRNAの配列の場合はヌクレオチド言語モデル(nLM)と呼ばれることが多い。ほかの基盤モデル(Bommasani et al., 2021)と同じく、pLMとnLMは大量の計算資源とラベルのないデータで学習され、さまざまな下流タスクに適応させることができる。最高水準のタンパク質構造予測モデルの多く(ESMFold、OmegaFold など)は、タンパク質言語モデルを適応させたものである(構造予測のためのpLMの調査については Hu et al., 2022 を参照)。pLMはモデルの規模と計算量の拡大から大きな恩恵を受けており(Chen et al., 2023、Lin et al., 2022)、そのため大統領令の文脈ではより重要である。
生物配列データについての詳しい情報は付録Aに、データ収集の方法は付録Bに記載している。
学習計算量
過去6年間で、生物配列モデルの学習に使われる計算量は急速に増えてきた。これらのモデルの学習に使われる計算資源の予算は、平均して年8〜10倍のペースで増えていることが分かった(付録Cを参照)。この計算資源の使用量の伸びは、同じ期間のコンピュータビジョンのモデルや強化学習のシステムで見られた伸びより速い。ただし、2018年から2024年の言語モデルの計算量の伸び率とは同程度である(Epoch AI, 2024)。今日の最先端の生物配列モデル、たとえば ESM2-15B(Lin et al., 2022)、ProtBERT、ProtT5-XXL(Elnaggar et al. 2021)、Nucleotide Transformer(Dalla-Torre, 2023)は、さまざまな大学や企業の研究所によって1e22 FLOP以上で学習されている。
特筆すべきは xTrimoPGLM-100B(Chen et al., 2023)である。これは、清華大学と中国のバイオテクノロジー企業 BioMap Research の研究者が、1兆トークンのタンパク質で学習したパラメータ数1,000億のタンパク質言語モデルだ。2023年1月18日から6月30日にかけて768基の NVIDIA A100 で学習され、学習には約6e23回の演算を要した。これは大統領令が定める1e23回の閾値を大きく上回る。3 xTrimoPGLM-100B は、ほとんどのベンチマークタスクで Meta の ESM2-15B などのより小さなモデルを上回り、妥当な三次元構造をもつ新しいタンパク質配列を生成する高い潜在能力を示している(同上)。
xTrimoPGLM-100B の学習に使われた計算量は ESM2-15B や ProtBERT などのモデルの数倍だが、言語モデルの基準からすると比較的小さい。たとえば xTrimoPGLM-100B は、暦の上で3年早く公開された GPT-3(Brown et al., 2020)とおおむね同じ規模である。Meta や Google DeepMind など、タンパク質配列モデルで先頭を走る大手企業の研究所は、ほかの目的のために、その10倍や100倍の資源でモデルを日常的に学習している。主要な大規模言語モデルは独自仕様でクローズドソースであることが多いのに対し、本データセットの生物配列モデルの大多数は、コードと重みを自由にダウンロードできるように公開している。
生物データで学習された大規模言語モデル
本データセットのモデルのほとんどは、生物配列データだけで学習されている。しかし一部は、主にテキストのコーパスで学習され、生物データでは部分的に学習またはファインチューニングされただけの大規模言語モデルである。その中で目を引くのが言語モデル Galactica-120B(Taylor et al., 2022)で、1e23回を超える演算で学習された。その学習データには UniProt や RefSeq といった生物データセットが含まれている。しかし、生物データは学習データの過半を占めていなかったため、Galactica-120B はおそらく大統領令の追加の報告義務の対象にはならない。Llama-molinst-protein-7b(Fang et al., 2023)も、生物データで部分的に学習された言語モデルの例である。これは LLaMA-7b をファインチューニングしたモデルで、Mol-Instructions データセットで学習されている。このデータセットには、テキストによる指示にもとづくタンパク質設計を容易にすることを目的として、タンパク質の構造・機能・活性を予測するためのタンパク質向けの指示が含まれている。Llama-molinst-protein-7b は生物配列をモデル化する能力をもつが、Galactica と同じく、主に生物配列データで学習されたわけではない。
大統領令の解釈によっては、これが最近の大統領令の報告義務の抜け穴になりうる。1e26 FLOP未満で学習されたモデルは、既知のタンパク質配列をすべて取り込みながら、主に生物データで学習されたわけではないという理由で監督を免れる可能性がある。たとえば、1e25 FLOPで学習される基盤モデルは、通常およそ10兆トークンで学習される(Hoffmann et al., 2022)。こうしたモデルは、既知のタンパク質配列のコーパス全体、つまり約70億配列をデータセットに含めることができ、それでも生物配列データが学習データの少数派であるために追加の報告義務の対象にならない可能性がある。4 それでも、こうしたモデルは、追加の統治要件の基準に該当する、より小さな生物データ専用のモデルの能力に匹敵するか、それを上回るかもしれない。
生物配列データ
大統領令は、生物データセット、特に病原体やオミクス研究に関するデータセットが国家安全保障にもたらす影響を強調している。5 大統領令は各省庁に対し、保有するデータ資産について詳細なセキュリティ審査を行うよう指示している。6 この節では、生物配列データの入手可能性、生成、利用について検討する。
生物配列モデルの学習に使われる生物配列データは、政府・学術・民間の機関が編纂した膨大な数の公開データベースから提供されている。主な情報源を三つの主要な区分に分ける。
-
DNA配列データベース。分析したデータベースの中で伸び率が最も高い。GenBank では、2022年から2023年にかけて格納された配列の数が31%増えた。DNAデータの伸びを牽引してきたのは全ゲノムショットガンシーケンシング7による研究である。GenBank のそれ以外のすべての区分(従来型エントリーと呼ばれる)のエントリー数の伸びは、これに比べてはるかに小さい。
-
タンパク質配列データベース。タンパク質配列データベースの情報の詳しさはさまざまである。UniProtKB のように注釈が豊富なデータベースは、伸び率がずっと低い(6.7%)。これに対し、MGnify のようなメタゲノムデータベース(20%)は、タンパク質配列を提供するものの、タンパク質の構造、機能、由来についての詳しい情報を欠いている。
-
タンパク質構造データベース。タンパク質構造の実験データを集めるのは時間がかかり、骨の折れる作業である。そのため、Protein Data Bank は年6.5%しか伸びていない。これに対し、AIモデルで予測したタンパク質構造を公開するデータベースは、大量の合成データを素早く生成できる。AlphaFoldDB や ESMAtlas のような合成データのデータベースは、利用できるデータの供給を劇的に増やしてきた。ただし、合成データを作る余地が尽きるにつれて、その伸びは鈍るかもしれない。
国際塩基配列データベース共同研究(INSDC)、MGnify、UniProtKB、PDB などの大規模な生物データベースのエントリーの大半は、細胞性生物(ヒト、動物、植物、菌類、酵母、細菌)に関するものである。たとえば UniProtKB のエントリーは、97%が細胞性生物、2%がウイルスのタンパク質配列で、後者の一部は既知の病原体である。
| データの種類 | 主なデータセット | エントリー数 | 提供者/主な資金提供者 | 伸び率 2022-2023 | データの生成方法 | この種のデータで学習された主なモデル |
|---|---|---|---|---|---|---|
| DNA配列 | INSDC(GenBank、ENA、DDBJ) | 34億 | NCBI(米国)、ENA(欧州)、DBBJ(日本) | 31.3%[GenBank] | DNAシーケンシング(次世代シーケンシングとサンガー法) | CaLM, Nucleotide Transformer, HyenaDNA |
| タンパク質配列 | MGnify タンパク質データベース | 30億 | EMBL-EBI(欧州) | 20.0%[MGnify] 15.21%[UniRef50] 6.7%[UniProtKB] 0.39%[UniProtKB/ Swiss-Prot] 6.75%[UniProtKB/ TrEMBL] | タンパク質配列の大半は既知のDNA/RNA配列から推定 | ESM2, ESM1b, ESM1v, ProtT5, ProtBert, ProGen, RITA, Ankh, gLM, xTrimoPGLM, AlphaFold, AlphaFold 2 |
| BFD | 25億 | Steinegger M. and Söding J.(研究者) | ||||
| MetaClust | 16億 | Steinegger M. and Söding J.(研究者) | ||||
| UniParc | 5億9,600万 | PIR(米国)、 SIB(スイス)、EMBL-EBI(欧州) | ||||
| UniRef | 3億6,500万 | PIR(米国)、 SIB(スイス)、EMBL-EBI(欧州) | ||||
| UniProtKB | 2億5,200万 | PIR(米国)、 SIB(スイス)、EMBL-EBI(欧州) | ||||
| RNA配列・タンパク質配列と結びついたDNA配列 | RefSeq | 4億1,100万 | NCBI(米国) | 13.2%[RefSeq] | ||
| タンパク質構造 | ESMAtlas | 7億7,200万 | Meta | 6.5%[PDB] | AIによる予測 | AlphaFold, AlphaFold 2 |
| AlphaFoldDB | 2億1,400万 | Google DeepMind | ||||
| PDB | 21万3,000 | Worldwide PDB(国際) | 実験による決定(X線、NMR、クライオ電顕) | |||
| SCOPe | 10万7,000 | CPE and LMB(英国) |
表1.生物配列モデルの主なデータ源の概要。エントリー数は、データベースによって、DNA配列、タンパク質配列、タンパク質配列のクラスター、タンパク質構造、タンパク質構造のクラスターのいずれかの数を指す。NMRは核磁気共鳴(NMR)分光法、クライオ電顕はクライオ電子顕微鏡法を指し、どちらもタンパク質構造を調べる手法である。
タンパク質配列データは豊富にあるが、機能についての詳しい知見があるのは、UniProtKB-Swiss-Prot に含まれるものなど、より小さな一部に限られる。これらには、リガンド結合部位、細胞内局在、三次元構造、既知の機能が、手作業で(UniProtKB-Swiss-Prot)または自動で(UniProtKB-TrEMBL)注釈づけされている。UniRef のデータセットはすべて UniProtKB と UniParc に格納された配列から作られており、本レポートで分析したモデルの学習データセットとして最もよく使われている(補足図3)。
遺伝子データの重要な情報源の一つが、メタゲノムシーケンシングである。メタゲノムシーケンシングとは、複数の生物のゲノムデータ(DNA/RNA)を配列決定することをいう。具体的には、多様な環境(土壌、海洋、マイクロバイオームなど)から採ったサンプルに含まれる細菌などの生物が対象になる。メタゲノムデータベースには、MGnify、MetaClust、BFD(AlphaFold の学習用に MetaClust と UniProtKB を組み合わせて整備したもの)がある。これらのメタゲノムデータベースのタンパク質配列は、DNAの配列決定されたコード領域から推定されたものである。メタゲノム研究で配列決定される遺伝子の多くは途中で切れているため、エントリーの大半は配列のN末端かC末端のどちらかを欠いている。さらに、メタゲノムデータベース由来のタンパク質配列は、機能についての詳しい注釈を欠いていることが多い。
メタゲノムデータは、データセットを多様にするため、事前学習の段階に含められることが多い。たとえば、質の高い UniProtKB ベースのデータセットに大量のメタゲノムデータを加えたことで、CASP14 における AlphaFold の性能が向上した(Jumper et al. 2021)。同様に、xTrimoPGLM-100b の学習手順には、UniRef90 に加えてメタゲノムデータベース(BFD、MGnify、MetaClust)の11億配列を使った事前学習が含まれ、その後、より質の高い UniRef90 のデータを重視して冗長性を取り除いた部分集合で学習している(Chen et al. 2023)。このように、メタゲノムシーケンシングのデータは、詳しい注釈を欠いてはいるものの、生物配列モデルにとって重要なデータ源である。
生物配列データの傾向
生物配列データは過去40年にわたって着実に蓄積されてきた。DNA、タンパク質配列、タンパク質構造のデータベースを含む主要な公開生物配列データベース全体で、エントリー数は急速に、ただし指数関数よりは緩やかに増えている。世紀の変わり目ごろには、UniProtKB、UniRef、UniParc といった複数の UniProt データベースや、MGnify、Metaclust が登場し、生物配列データベースの数が大きく増えた。その後、AIによる予測にもとづくデータベース、特に AlphaFoldDB と ESM Metagenomic Atlas が登場し、急速な成長をたどった。これは、タンパク質構造データの生成に機械学習の手法が与えた影響の大きさを物語っている。
生物配列モデルは、大量の生物配列データで学習することで、下流タスクの性能が向上する。だが、異なるデータベースには同じエントリーが重複して含まれていることが多い。そのためAIの開発者は通常、複数のデータセットを集約したうえで、重複を取り除いてデータを精製する。学習に現在利用できるタンパク質配列データの桁をおおまかに把握し、それによって生物配列モデルの規模拡大の余地を直感的につかむため、主要な公開タンパク質配列データベースに含まれる重複のないエントリー数を推定した。データベース同士の重複は大きいので、エントリー数を単純に合計することはできない。そこで、互いに重複しないデータセットの構成要素を合計して、おおまかな推定値を出した。具体的には、UniParc(5億9,600万)、MGnify(30億)、BFD 内の土壌参照カタログ(20億)、BFD 内の海洋参照カタログ(2億9,200万)、MetaClust(15億9,000万)を合計すると、約75億配列になる。8 代わりに、より小さな UniProtKB(2億5,200万、UniParc の部分集合)を含めた場合、合計は重複のない配列で約71億になる。
この集計は不正確ではあるが、蓄積されたタンパク質配列データの規模の感覚をつかむことはできる。これらの主要なリポジトリ全体で70億件を超える。さらに実際には、データセット内で互いに類似度の高い配列の数を減らすため、学習前にさまざまな配列類似度の閾値でデータセットをクラスタリングすることが多い。それでも、この推定からは、現在のデータの蓄積量が、これまでの最大の学習で使われた量のおそらく10倍近いと考えられる。
生物配列データの情報源
主なデータ生成方法は三つある。DNAシーケンシング、既知のDNA/RNA配列からの推定、そして実験によるタンパク質構造の決定である。DNAシーケンシングは、GenBank、ENA、DDBJ からなる INSDC のデータベースのような、DNA配列データベースの作成に使われる。使われている主なシーケンシング技術には、次世代シーケンシング(NGS、2005年から商用化)と、従来のサンガー法(1986年から商用化)がある。
Illumina、Oxford Nanopore、Pacific Biosciences が商用で提供している次世代シーケンシング技術による大規模並列のNGSは、INSDC のDNA配列データベースに34億件のエントリーを集めるのに大きく貢献してきた(Hershberg, 2022)。同じ傾向は、INSDC の共同事業の一部で、NGS技術が生み出した生のシーケンスリードだけを収めた Sequence Read Archive(SRA)にも表れている。SRA の配列の多くは、GenBank/ENA/DDBJ のエントリーや、NGS技術に頼ってきた1000ゲノムプロジェクトのようなヒトゲノムの大規模シーケンシングプロジェクトと結びついている。SRA のデータに必要な記憶容量は過去10年で指数関数的に増えており、2013年から2019年の間におよそ40%増えた(NCBI Insights, 2020)。
MGnify、MetaClust、UniProtKB のようなタンパク質配列データベースの配列の大半は、既知のコードDNA/RNA配列を翻訳して得られたものである。この手法によって数十億件のタンパク質配列が集められてきた。UniProtKB の2億5,200万配列の95%超は INSDC のDNA配列から得られたものであり、MGnify だけでも30億配列を収めている。
最後に、構造データの生成には実験的手法が広く使われている。PDB などのデータベースのタンパク質構造は、X線結晶構造解析、NMR分光法、クライオ電子顕微鏡法といった実験的手法で得られている。加えて、ESMAtlas の7億7,200万エントリーや AlphaFoldDB の2億1,400万エントリーに見られるように、AIによる予測手法も構造データベースの成長に寄与している。
考察
最近出されたホワイトハウスの大統領令は、デュアルユースのリスクをもたらしうる、生物配列データで学習されたAIモデルについて、包括的な報告と監督の要件を新たに定めている。1e23回の演算(すべてのモデルについては1e26回)を超える生物配列モデルは、モデルの詳細、悪用の可能性を探るレッドチーム評価、サイバーセキュリティの保護策、モデルの重みへのアクセス管理について、開示を義務づけられる。しかし、規制のさらなる明確化が必要かもしれない。生物データを混ぜ込みつつ1e26回の演算の閾値を下回るモデルは、より小さな純粋な生物配列モデルの能力に匹敵するか上回りながら、統治の措置を免れることが十分ありうるからだ。
本分析により、xTrimoPGLM-100B が1e23回の演算の閾値を少なくとも6倍上回っていることが明らかになった。学習計算量は、より広い機械学習の分野の基準から見ても急速に増えており、生物モデルの予算は年8〜10倍のペースで伸びている。この計算量の伸びは、計算能力の向上とデータの入手しやすさが急速な進歩を推し進めている、機械学習全般のより広い傾向と整合している。
大統領令は、モデルの学習に使われる生物配列データセット、特に病原体の情報を含むものに関するセキュリティ上の懸念に対処する必要性を強調している。本調査により、シーケンシング技術とAIによる予測手法の進歩に支えられて、DNA、タンパク質、構造のデータベースにわたる生物データが膨大かつ急速に拡大していることが確認された。
政策・規制の観点から見ると、本研究の結果から、生物データを扱うAIモデルを統治する現行の規制の枠組みに抜け穴がありうることがはっきりする。大統領令が「主に生物配列データ」で学習されたモデルに重点を置いているために、生物データを相当量含むが過半ではないモデルが、学習中に1e23回を超える演算を使っていても厳格な監督を免れてしまうことが、意図せず許されるかもしれない。その結果、大量の生物配列を含むモデルが、高リスクの生物配列モデルのために意図された強化された統治の対象にならない可能性がある。政策立案者と規制当局は、大規模なマルチドメイン・マルチモーダルの学習のような、AIの学習の新しい手法に歩調を合わせるために、現行の枠組みをどう適応させる必要があるかを検討しなければならない。
謝辞
有益なコメントをいただいた Oliver Crook、Simon Grimm、Adam Marblestone、Ben Cottier、David Owen、Matthijs Maas、Juan Cambeiro、Jaime Sevilla、Misha Yagudin、Martin Stoffel、そしてウェブサイトへの掲載と体裁の調整を手伝ってくれた Edu Roldán に感謝する。
付録A:生物配列の背景情報
セントラルドグマは、DNAからRNA、そしてタンパク質へという遺伝情報の流れを示すものである。この枠組みは、遺伝子がRNAに転写され、それがアミノ酸配列に翻訳されて、折りたたまれて機能をもつタンパク質になる過程を説明する。この付録では、転写、翻訳、タンパク質の折りたたみという主要な過程が、遺伝子を機能をもつタンパク質に変える仕組みを簡単に概観する。
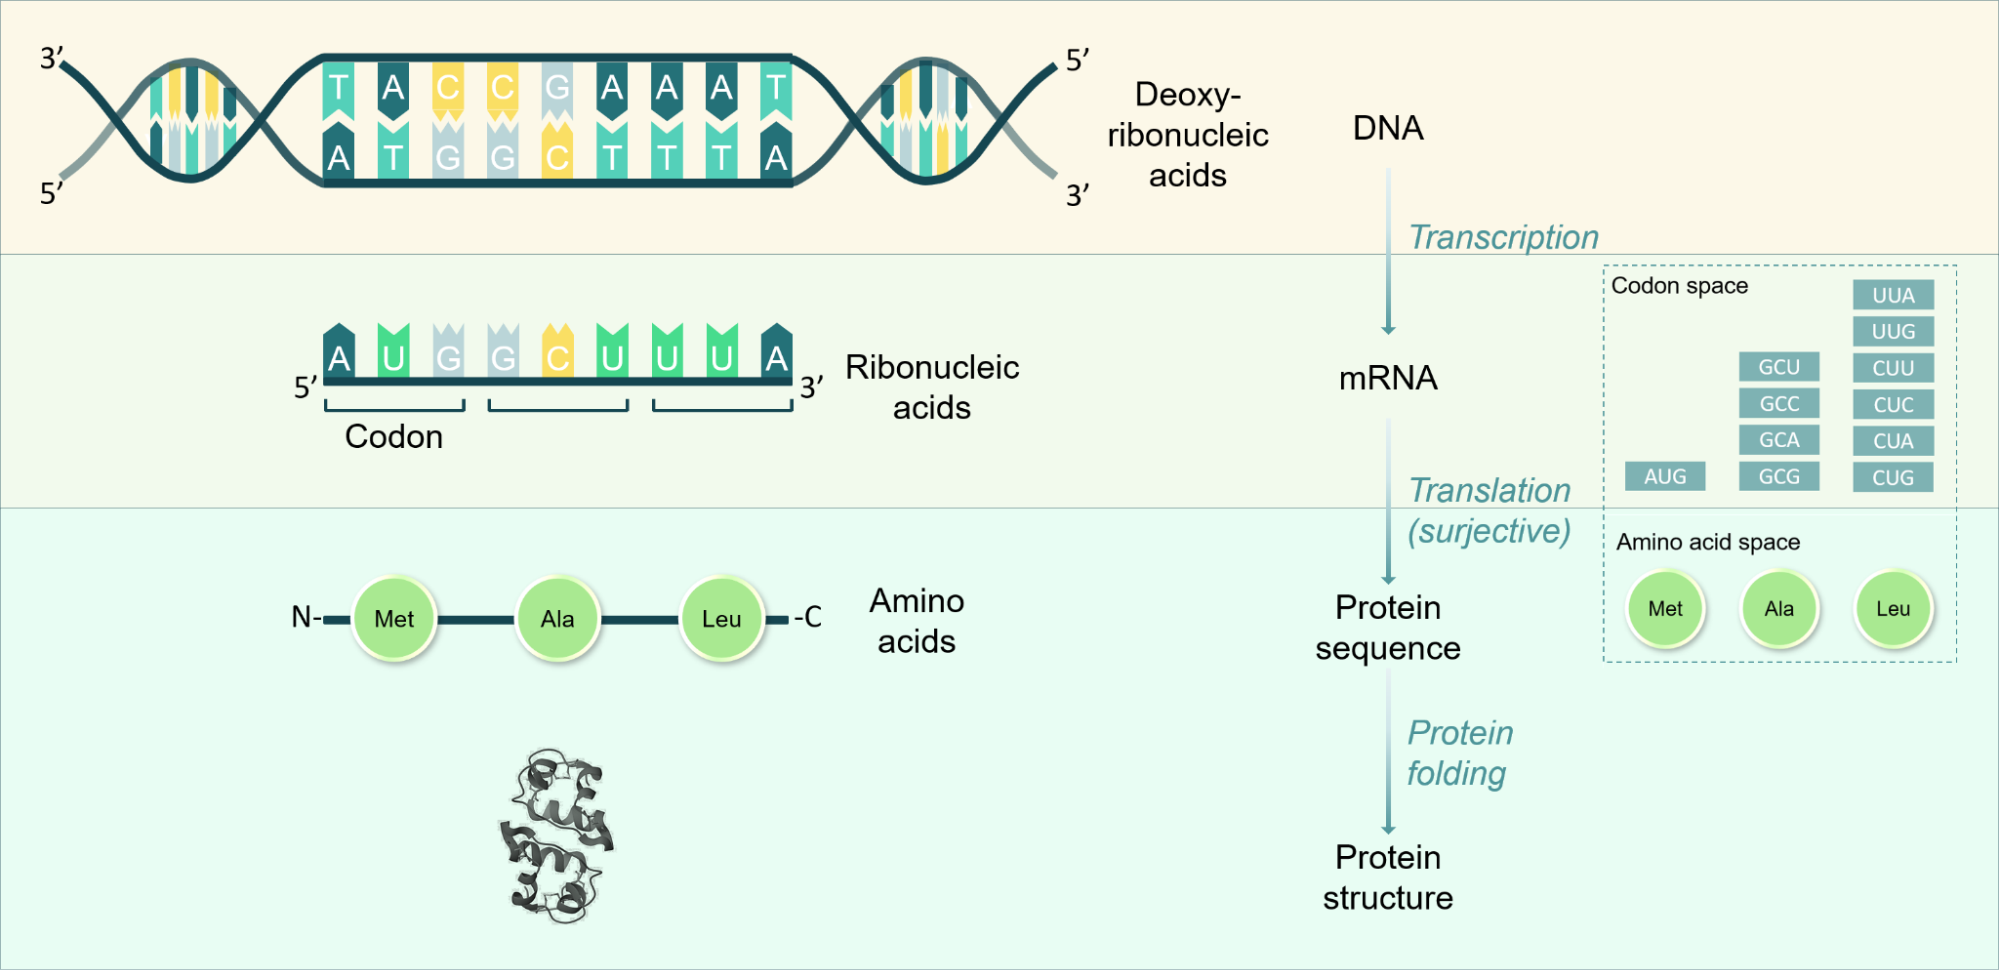
補足図1.生物学のセントラルドグマの概要。本レポートで扱う異なる種類の生物配列データの関係を示している。例として示した構造は、PDB のヒトインスリン前駆体の二量体である。
転写:DNA分子は二本鎖の配列で、相補的なデオキシリボ核酸の塩基対からなる。DNAのコード領域には、一般に遺伝子と呼ばれる塩基対の配列が含まれ、翻訳されてタンパク質の合成に使われる。これに対し非コード領域には、どのような状況でコード領域が転写されるかを制御する配列が含まれる。転写とは、DNAが一本鎖のリボ核酸の配列に写し取られる過程を指す。このとき、アデノシン(A)の相補塩基として、チミジン(T)の代わりにウリジン(U)が組み込まれる。DNAによく見られるヌクレオチドは4種類(アデニン(A)、チミン(T)、シトシン(C)、グアニン(G))、RNAによく見られるものも4種類(アデニン(A)、ウラシル(U)、シトシン(C)、グアニン(G))である。
翻訳:一本鎖のメッセンジャーRNA(mRNA)の配列は翻訳の過程の土台となる。翻訳では、リボソームがコドンと呼ばれるRNA塩基の三つ組を認識し、それに対応する特定のアミノ酸を、伸びていくアミノ酸配列の鎖に付け加える。翻訳は全射的な過程である。つまり、あるコドンは一つのアミノ酸を指定するが、複数のコドンが同じアミノ酸を指定することがある。そのため、DNAやRNAの配列からアミノ酸配列を推定することはできるが、アミノ酸配列から一意のRNA/DNA配列を推定することはできない。タンパク質の大多数の構成要素となる一般的なアミノ酸は20種類ある。
タンパク質の折りたたみ:タンパク質の配列は自発的に三次元構造へと折りたたまれ、それによって機能を果たせるようになる。この自発的な過程はふつうミリ秒の時間スケールで起こり、予測は容易ではない。タンパク質がとりうる理論上の立体配座は多く、折りたたまれた後には配列上で離れたアミノ酸同士の相互作用も多いからだ。実験的には、X線結晶構造解析が構造を検証する重要な手法である。タンパク質を結晶格子に組み込んだうえでX線を照射し、回折パターンを求める。同様に、より新しい手法としてクライオ電子顕微鏡法(クライオ電顕)がある。タンパク質を水溶液に入れ、非結晶の氷ができるほど短い時間で凍らせて、電子顕微鏡で撮像し、高解像度のタンパク質構造を求める。
生物配列と自然言語の比較:生物配列の語彙は自然言語よりはるかに小さい。少数の核酸(と、ありうる64通りの核酸の三つ組)と20種類のアミノ酸が、生物配列の基本的な文字となる。しかし生物配列は、自然言語の文に比べて数百文字と長く、離れた位置同士の依存関係を含む傾向がある。英語の場合、文の長さは平均15〜20語である。
付録B:データ収集の方法
本データセットは、生物配列モデルの文献、モデルの評価に使われる一般的なベンチマークのリーダーボード、頻繁にダウンロードされているオープンソースのタンパク質言語モデルを調査して構築した。主な情報源は次のとおりである。
| 情報源 | 説明 |
|---|---|
| Hugging Face | 人気のある公開オープンソースのタンパク質言語モデルを収録 |
| ProteinGym(Notin et al. 2023) | ProteinGym ベンチマークの論文で報告されたモデルを収録。この論文は、タンパク質の変異がタンパク質の適応度などの指標に及ぼす影響を予測するモデルの能力を比べる一連のベンチマークで、モデルを評価している。 |
| PEER Integrated Leaderboard | タンパク質配列の理解のための包括的なマルチタスクベンチマークである PEER ベンチマークのリーダーボードから、一部のモデルを収録 |
| 機能予測ベンチマーク(Unsal et al. 2022) | 表1に掲載された、深層学習の手法を用いたモデルを収録 |
| タンパク質言語モデルの調査(例:Hu et al., 2022) | 事前学習済みタンパク質言語モデルを幅広く調査した Hu et al. 2022 の表1のモデルを収録 |
| CASP12 と CASP13 に提出されたモデル | CASP14 での AlphaFold 2 の画期的な成功以前にタンパク質構造の予測に使われていたモデルについて、より広い歴史的文脈を示すため、CASP12〜CASP13 に参加した注目すべきモデルを収録 |
補足表1.生物配列モデルのデータセット構築に使った主な情報源
データベースの成長データは、データベースについて公開された統計(ある場合)から収集するか、データベースの各リリースとともに公開されるリリースノートから抽出した。詳細は補足表2に示す。
| データベース | データの出所 | リリースノートから抽出するためのコード |
|---|---|---|
| GenBank-traditional | リリースノート から抽出 | ノートブック1 |
| GenBank-all | ||
| ENA | リリースノートの付録A「Database growth table」にもとづく | |
| DDBJ | 最新のリリースノートの表「10. Release History」にもとづく | ノートブック2 |
| RefSeq | リリースノートの3.9節「Growth of RefSeq」にもとづく | |
| MGnify | リリースノートから抽出 | ノートブック3 |
| UniParc | 2014〜2023年のデータはリリースノートから抽出。2004〜2014年のデータは UniProt 2015 論文の補足資料で公開されたもの | ノートブック4 |
| UniRef100 | ||
| UniRef90 | ||
| UniProtKB | ||
| UniProtKB/Swiss-Prot | ||
| UniProtKB/TrEMBL | ||
| PDB | PDB の統計 からダウンロードしたCSV | |
| AlphaFoldDB | Varadi et al. 2024 の図1で追跡された、2021年7月〜2022年7月の4回のリリース | |
| ESMAtlas | ESMAtlas のウェブサイトにもとづくデータ点 |
補足表2:データベースの成長統計のデータ源
学習中に使われた計算量の推定には、Sevilla et al., 2022 が説明する方法を用いた。
付録C:学習計算量の伸び
本データセットには、少ない計算量で学習されたモデルと、はるかに大きな計算資源の予算で学習されたモデルの両方が含まれている。そのため分散が大きく、単一の指数関数的な傾向ではデータにうまく当てはまらない。そこで、計算資源の予算が最も少ない学習を除外し、単純な指数関数を推定する。除外の基準を決める原理的な方法はないので、さまざまなフィルター(連続する365日の各期間内で、下位20、30、40パーセンタイルのモデルを除外する)を適用し、除外後のデータを使って伸び率を推定した。
伸び率は年8.7倍から10.4倍(年0.94〜1.02桁)となった(補足図2を参照)。これは、画像や言語モデルなど、AIのほかの分野の伸びより明らかに速い(Epoch AI, 2023)。
付録D:生物配列データセットの利用状況
この付録では、本データベースのモデルの学習にさまざまな生物配列データセットがどう使われているかを詳しく示す。補足図3は、各データセットで学習されたモデルの数を示しており、複数のモデルで使われたデータセットだけを表示するように絞り込んでいる。
最もよく使われているデータセットは UniRef50 で、23のモデルの学習に使われている。次いで UniRef90 が11のモデルの学習に使われている。最もよく使われている構造データベースは PDB で、6つのモデルの学習に用いられている。
注
-
同じ期間のフロンティアモデルの規模拡大はおよそ年5倍(Epoch AI, 2024)、画像モデルではおよそ年4倍(Epoch AI, 2024)だった。一方、言語モデルでは使われる計算量がもっと速く、およそ年10倍のペースで伸びている(Epoch AI, 2024)。 ↩
-
Google DeepMind(当時は DeepMind)は2021年、AlphaFold 2 のブレークスルーを創薬の分野に生かすため Isomorphic Labs を分社化した。また、AlphaFold の新しい版では、タンパク質、核酸、低分子、イオン、修飾残基を含む複合体の結合構造の予測が大幅に改善されると発表している。こうした生体分子間の相互作用の予測は、タンパク質の機能を理解するうえで特に重要になると考えられる。 ↩
-
実際には、このモデルはこれより長く学習されているかもしれない。最新のプレプリント(2023年7月6日時点)には、「現時点で、xTrimoPGLM-100B は、モデル化能力をさらに高めることを目指して、統一的な方法で事前学習を続けている」とある。 ↩
-
生物配列データの節で詳しく述べたように、既知の生物配列データの現在のコーパスは約70億のタンパク質配列からなる。1配列あたりの平均の長さを200アミノ酸とし、1アミノ酸を1トークンとしてトークン化すると、表現できる生物配列データセットの総量はおよそ1.4兆トークンになる。GPT-4 や Gemini など今日の最高水準のLLMは、通常10兆トークンのオーダーで学習されている。したがって、生物配列データを組み込んだとしても、学習データ全体に占める割合は少数派にとどまる。 ↩
-
大統領令は、「米国政府が保有・生成し、作成に資金を提供し、またはその他の形で所有するデータおよびデータセット、特に病原体やオミクス研究に関連するものを、生成AIモデルの学習に用いることが国家安全保障に及ぼす影響を検討し、これらのデータおよびデータセットの利用に関わるリスクを軽減する方法について勧告を行う」としている(第4.4節 (ii) (B))。 ↩
-
大統領令は次のように命じている。「本節の4.7(a)で求める初期の指針の策定から180日以内に、各省庁は、合衆国法典第44編第3511条(a)(1)および(2)(B)が求める包括的なデータ目録にあるすべてのデータ資産についてセキュリティ審査を行い、適宜、適用法と整合する形で、そのデータの公開がCBRN兵器に関して引き起こしうる最優先の潜在的セキュリティリスク(そのデータがAIシステムの学習に使われうる方法など)に対処する措置を講じなければならない」(第4.7節 (b))。 ↩
-
DNA鎖をランダムに断片化し、互いに重なり合う多数のDNA断片を並列に配列決定する手法。配列決定した後、重なり合う断片をイン・シリコで整列・アセンブルして、全ゲノム配列を得る。 ↩
-
BFD には UniProtKB と MetaClust が含まれているため、二重計上を避けるために BFD 内の土壌参照カタログと海洋参照カタログだけを合計した。 ↩