
レポート
最長の学習実行
要点:大規模な機械学習システムの学習実行は、おそらく14〜15か月未満で終わる。長い学習は、後から始まる学習、つまりより優れたハードウェアとアルゴリズムを使える学習に競り負けるからである。
計算資源の予算の拡大と、計算資源を効果的に使う方法についての理解の深まり(たとえばスケーリング則の活用による)は、近年の機械学習の進歩を推し進める二つの大きな原動力である。
実質的な計算資源の予算を増やす方法は数多い。ハードウェアの改良、AI研究開発への投資の増加、そしてアルゴリズム効率の向上である。本稿では、見過ごされがちだが重要でありうる要因を一つ取り上げる。それは、モデルを実時間でどれだけ長く学習させる気があるかである。
ここでは、学習実行の最適な期間を見積もるための簡単な数学的枠組みを検討する。ある研究者が、ある期限までにモデルを学習させる任務を負い、学習をいつ始めるかを決めなければならないとする。研究者は重要な問題に直面する。学習の開始を遅らせれば、より優れたハードウェアを使える。だが早く始めれば、モデルをより長く学習させられる。
関連するパラメータの推定値を使って、最適な学習期間を計算する。そのうえで、さらに六つの考慮事項を検討する。1)計算資源に充てる金額の予算が時間とともにどう増えるか、2)アルゴリズム効率が向上する速さ、3)開発者が時間とともにソフトウェアを更新できるかどうか、4)確率的な成長を伴うより現実的な枠組みでは何が起こるか、5)各研究所が最適な学習実行を明示的に目指しているわけではないことが、この枠組みにとって問題になるか、6)ハードウェアを購入せずに借りる場合には何が起こるか、である。
結論は、研究者が学習中にハードウェア構成を更新できるかどうかによって変わる。ハードウェアを更新できない場合、最適な学習実行はおそらく3か月未満になる。学習中にハードウェア構成を更新できる場合、最適な学習実行は1.2年未満になる。
これらの数字はおそらく過大評価である。1)ソフトウェアの進歩について控えめな推定値を使っていること、2)現実世界の不確実性が開発者をより短い学習へと向かわせること、3)ハードウェアを借りる場合には、長く待ってから期限間際に学習を並列化する動機が生じること、がその理由である。
| シナリオ | 最長の学習実行 |
| ハードウェアの改良 または ハードウェアの改良+投資の増加+ハードウェアの入れ替え | 3.6年 |
| ハードウェアの改良+ソフトウェアの改良 | 1.2年 |
| ハードウェアの改良+投資の増加+ハードウェアの入れ替えなし | 9.1か月 |
| ハードウェアの改良+ソフトウェアの改良+投資の増加+ハードウェアの入れ替え | 10.2か月 |
| ハードウェアの改良+投資の増加+ソフトウェアの改良 | 6.5か月 |
学習実行の長さを考える簡単な枠組み
ある期限 までにモデルを学習させたい研究者を考える。この研究者は、1ドルあたりの計算量を最大にするために、学習をいつ始めるかを決めようとしている。
研究者は重要なトレードオフに直面する。一方では、改良されたハードウェア(および/または、より大きな金額の予算や優れたアルゴリズムなど)を使うために、学習の開始を遅らせたい。他方で、開始を遅らせれば、モデルを学習させる実時間が短くなる。
ハードウェアの価格性能比が次のように向上しているとする。
ここで は初期のFLOP/ドル/時間、 は年あたりの向上率である1。時点 で学習を始めると、時点 における累計のFLOP/ドルは次のようになる。
ここで は学習を始める時点で手に入るハードウェアの価格性能比(FLOP/ドル/時間)、 は学習を始めてからの経過時間である。金額の予算が固定されているとき、期限 までに得られるFLOP/ドルを最大にするには、いつハードウェアを買って学習を始めるべきだろうか。
それを知るには、時点 までに終わる学習を始める最も効率的な時点 を求める必要がある。それには、 を で微分し、結果をゼロと置けばよい。
最適な学習実行の長さは となる。私たちは以前の研究で、GPUの費用対効果の向上率を と推定した(Hobbhahn and Besiroglu, 2022) 2。ここから、最適な学習実行の長さは 年となる。
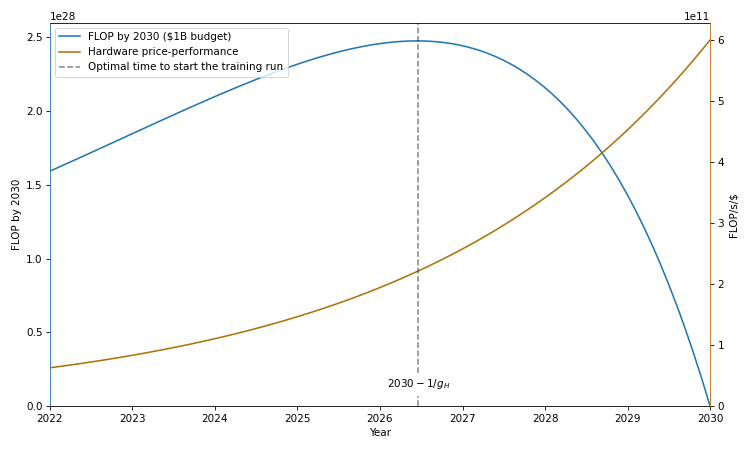
青は、期限を \(T = 2030\)、投資額を10億ドルとしたときに、各年に始めた学習が消費する計算量の総量。茶色はハードウェアの価格性能比で、2022年の初期価格性能比を \(H_0 \approx ~6.3 \times 10^{10} \; \text{FLOP/s/\$}\)、向上率を \(g_H \approx 0.281\) と仮定している(Hobbhahn and Besiroglu, 2022 を参照)。
直感的には次のとおりである。期限 までにモデルを学習させたいなら、一方では、価格性能比の高いハードウェアを使えるようになるまでできるだけ長く待ちたい。他方で、待てば学習に使える時間の合計は減る。最適な学習期間とは、この二つのトレードオフの釣り合いがちょうど取れる期間である。
この計算はいくつかの仮定に基づいている。
- 機械学習への投資意欲が時間とともに高まることを無視している。そのため研究者は、待てばより大きな予算を確保できるかもしれない
- ソフトウェアの改良やスケーリング則の理解の深まりによって、研究者が将来、計算資源をより効果的に使えるようになるかもしれないことを無視している
- 実務者は学習の途中でハードウェアを更新しないと仮定している
- 関係する量が予測可能な一定の率で決定論的に向上すると仮定している
- 開発者が固定された期限に合わせて最適化すると仮定している
- 開発者が自前のハードウェアを購入すると仮定している
これらの仮定を一つずつ緩めて、どこに行き着くかを見ていこう。
増え続ける金額の予算を考慮する
実際には、機械学習の学習実行に投じられる計算資源の総量は、GPUの価格性能比よりも速く伸びてきた。企業は機械学習モデルの学習に充てる金額の予算を増やし続けてきた。そのため研究者は、より大きな予算を使うために、機械学習モデルの学習を遅らせたいと考えるかもしれない。
私たちの以前の研究では、学習実行に投じられる計算資源の伸び率を と求めた3。この伸び率は と分解できる。つまり、ハードウェア効率の伸び と、投資の伸び の和である4。
上と同じ論法で、最適な学習実行の長さは 年、すなわち か月と計算できる。
これは、先ほどの約 年という学習期間よりはるかに短い。研究者は、より優れたハードウェアと、より大きな金額の予算の両方を待ちたい。金額の予算はハードウェアの価格性能比の向上よりもおよそ1桁速く伸びてきたので、予算の伸びを考慮に入れる研究者は、モデルを学習させる実時間がおよそ1桁短くなる。
アルゴリズム効率の向上を考慮する
2020年、ニューラルモデルのスケーリング則に関するKaplan et alの論文は、計算資源を効果的に活かしてモデルを学習させる手順を実務者に示した。その2年後、Hoffmann et alがスケーリング則を見直した研究を発表して状況を一変させ、計算資源をさらに効率よく使えるようにした。
モデルを効果的に学習させる方法についての理解は、急速に進んでいるようである。そのため今日の実務者は、分野の進歩によって努力が無駄になりかねないことを恐れて、何年にもわたる学習の計画を思いとどまるかもしれない。
この現象を調べる方法の一つは、10年前と同じ結果を得るのに今日どれだけ少ない計算資源で済むかを把握することである。新しい展開に照らすと一部は古くなっているものの、Hernandez and Brownによるアルゴリズム効率の測定は、今もこの分野で最良の研究である。
彼らは、7年間でアルゴリズム効率が44倍向上したことを見いだした。これは伸び率 に相当する。
これをハードウェアの向上率と合わせると、合計の伸び率は になる。これは、最適な学習実行の長さ 年に相当する。
これに投資の伸び率も合わせることができる。その場合、実効計算量の伸び率の合計は となる。ここから、最適な学習実行の長さは 年、すなわち か月となる。
ハードウェアの入れ替えを考慮する
ここまでの分析では、機械学習の実務者が固定したハードウェア基盤を使い続けると仮定してきた。しかし理論上は、実行中の学習を止め、重みとオプティマイザの現在の状態を保存し、新しいハードウェア構成で学習を再開することもできる。
仮定の話としては、研究者は時間の経過に合わせてハードウェアを更新することもできる。だが実際には、予算が固定されていれば、これを考えても意味がない。期限までに1ドルあたり最も多くの計算資源を買える時点でお金を使いたいからである。それより前や後にお金を使えば、全体として1ドルあたりの見返りは小さくなる。
ただし、予算が固定されている必要はない。投資が増えるにつれて、入ってきたお金で新しい、より優れたハードウェアを買い、手持ちのハードウェアを増やしていける。
各時点で使えるお金が の率で増えるとしよう。お金はいつでも使って最新鋭のハードウェアを買える。そのハードウェアの費用効率は、ずっと のペースで向上してきた。
時間をかけて予算を使う方法は数多くありうる。しかし最適な解は、ハードウェアの費用効率と残り時間の積が最大になる時点で、使える予算をすべて使い、その後に入ってくるお金はできるだけ早く使ってより大きな見返りを得ることである。
形式的には、時点 で始めた学習が時点 までにかき集められるFLOPの累計は次のとおりである。
先ほどと同じく で微分すると、最適な学習実行の長さが得られる。
答えは、予算が固定され、投資の増加がなく、ハードウェアの入れ替えも許されない場合と同じである。つまり、予算の増加の影響は消える。最適な学習実行の長さは、今度はハードウェアの向上率だけで決まる。
これは単に、より大きな金額の予算を待つ動機がもはやないからである。研究者は、何もしなくてもハードウェア予算の伸びの恩恵を受けられる。したがって、学習実行の最適な期間は、ハードウェアの価格性能比の向上だけを考えたときと同じになる。
ソフトウェア効率の向上も考慮すると、学習実行を短くする強い動機が生じる。ハードウェアは時間とともに更新できても、学習に使うアルゴリズムの手順は学習の開始時点でおおむね固定されてしまうかもしれないからである。
この状況で最大化しようとしている量は、質で調整したFLOPであり、次のように表される。
これを微分してゼロと置くと、最適な学習の長さ は次の式を満たすときに得られる。
この解は代数的には表せないが、数値的に解くのは簡単である。本稿を通じて使ってきた伸び率の値を使うと、最適な学習の長さはおよそ10.2か月となる。
確率的な変動を考慮する
ここまでの枠組みでは、ハードウェア効率、投資、アルゴリズム効率が滑らかに予測どおり伸びる、単純な決定論的な設定を仮定してきた。
現実の進歩はもっと確率的である。新しいハードウェアは期待を上回る(あるいは下回る)かもしれない。市場の変動や自分の研究分野への関心の度合いによって、ある時点で学習のためにかき集められる金額の予算は左右されうる。
確率的な変動を組み込んだ枠組みを作ることは、本稿の範囲を超える。ただ、ポートフォリオ理論の考え方を参考にするのは有益かもしれない。将来何が起こるか確信が持てないときは、資本を長期のプロジェクトに縛りつけたくない。この考え方は学習実行を短くする方向に働く。つまり、本稿で推定している数字はおそらく高めに出ている。
固定された期限
この枠組みに対しては、開発者が固定された期限に間に合わせようとしていると仮定している、という反論がありうる。実際には、研究者は結果が出るまで長く待つことをいとわない場合も多い。
それでも、これは良い枠組みだと考えている。私たちはAI研究を、多くの研究所がそれぞれ異なる時点で学習を始めるものとしてとらえている。
どの四半期をとっても、最も計算量の多いモデルを発表するのは、最適な長さに最も近い学習を始めた研究所になる。
各研究所が明示的な期限に合わせて最適化したり、学習の長さを計画したりしていなくても、その中で最も計算効率の高い研究所は、やはりおおむねこの法則に従う。最適より短く、あるいは長く学習させる研究所は、太刀打ちできなくなる。
最も計算量の多いモデルが最も目覚ましいモデルでもあると仮定すれば、このモデルは、目覚ましいモデルの学習の長さについて良い上限を与える。
ハードウェアを借りる場合
ここまでの議論では、各研究所が学習用のハードウェアを借りずに購入すると仮定してきた。最大級のモデルをふだん学習させているGoogleやMetaのような一部のトップ研究所には、これが当てはまる。しかし他の多くの研究所は、Amazon AWS、Lambda Labs、Google Cloudといったクラウドコンピューティング基盤からハードウェアを借りている。
ハードウェアを借り、学習に必要なのが利用可能な容量のごく一部にすぎない場合、このモデルは当てはまらないと私たちは考える。ハードウェアの価格は時間とともに下がり、学習はかなりの部分を並列化できる。そのため、ハードウェアを借りる研究所には、できるだけ長く待ち、期限間際に(ハードウェアを購入する場合に最適な数と比べて)はるかに多くのGPUを使ってごく短期間でモデルを学習させる強い動機がある。
これは検討すべき重要な場合だと私たちは考えている(機械学習では、購入したハードウェアを使うよりも借りるほうがおそらくはるかに一般的である)。しかし私たちの主な関心は、各時点で最大級のモデルを学習させることに伴う意思決定の問題を理解することにあるので、ハードウェアを借りる場合はあまり深く調べていない。
結論
本稿では、継続的に向上するハードウェア、拡大する予算、高まるアルゴリズム効率が、学習実行を長くすることの有用性をどのように制限するかを分析した。
研究者は、ある時点 に終わる学習をいつ始めるかを決めるとき、トレードオフに直面する。一方では、改良されたハードウェアや、より大きな金額の予算や優れたアルゴリズムといった他の要素を手に入れるために、学習の開始を遅らせたい。他方で、開始を遅らせれば、ハードウェアを使える時間は減る。これらの要素が時間とともに変化する速さはおおよそ分かっているので、機械学習の学習実行の最適な期間を推定できる。
これらのトレードオフの釣り合いを最適に取ると、学習実行は2.5か月から3.6年のあいだに収まるはずだという結果になった。
ハードウェアの入れ替えを許すと、予算の増加の効果は消える(学習を止めずに、入ってくるお金を使えるからである)。これにより、最適な学習実行の長さは1.2年から3.6年に延びる。
これらの数字は過大評価だと私たちは考えている。改良は確率的に起こり、不確実性があるために開発者は一つの学習に過剰に投資することを避けるようになり、ハードウェアを借りる場合には学習を始めるまで長く待つ動機が生じるからである。
さらに、大規模な学習は技術的に実施が難しいことがある。ハードウェアは故障し、交換が必要になる。エラーやバグのせいで、途中まで進んだ学習を破棄せざるをえないこともある。こうした要因はすべて、最適な学習実行を短くする5。
このモデルの最大の不確実性は、アルゴリズム効率が向上する速さである。結果の導出には(Hernandez and Brown, 2020)の推定値を使った。この論文はスケーリング則をめぐる議論より前のもので、言語モデルではなくコンピュータビジョンのデータを使っている。私たちの感触では、(ある種の)アルゴリズムの改良はこの論文の推定より速く進んできた。そうであれば、最適な学習実行はさらに短くなりうる。
いずれにせよ、現在のハードウェアの向上率のもとでは、少なくとも研究者が1ドルあたりの計算量を最適化している限り、注目すべき機械学習モデルで4年を超える学習実行はおそらく見られないと結論できる。
| シナリオ | 最長の学習実行 |
| ハードウェアの改良 または ハードウェアの改良+投資の増加+ハードウェアの入れ替え | 3.6年 |
| ハードウェアの改良+ソフトウェアの改良 | 1.2年 |
| ハードウェアの改良+投資の増加+ハードウェアの入れ替えなし | 9.1か月 |
| ハードウェアの改良+ソフトウェアの改良+投資の増加+ハードウェアの入れ替え | 10.2か月 |
| ハードウェアの改良+投資の増加+ソフトウェアの改良 | 6.5か月 |
謝辞
議論に加わってくれたSam Ringer、Tom Davidson、Ben Cottier、Ege Erdil、Lennart Heimに感謝する。
本稿のグラフを作成してくれたEdu Roldanに感謝する。
2026年5月18日、ハードウェアの入れ替えとソフトウェア効率の両方がある場合の分析を追加した。この場合の分析を展開してくれたSebastian DeLorenzoに感謝する。
2023年6月28日、「ハードウェアの改良+投資の増加+ソフトウェアの改良」の計算の誤りを修正した。誤りに気づいてくれたNick Gabrieliに感謝する。
2022年9月22日、「ハードウェアの改良+投資の増加」の計算の誤りを修正した。
注
-
ハードウェアの価格性能比は、新しいGPU設計やリソグラフィ技術の登場に応じて不連続に跳ね上がるのではなく、時間とともに滑らかに向上すると仮定している。より現実的な階段関数状の過程でも、この枠組みの主な結論はおおむね成り立つと考えている(ハードウェアの離散的な世代に合わせて、最適な学習期間がときおり数か月ずれることを除けば)。↩
-
彼らは、ハードウェア効率の倍増期間を2.46年と求めている。これは年あたりの伸び率 に相当する。↩
-
私たちは、大規模な学習実行に投じられる計算資源の倍増期間を6.3か月と求めた。これは年あたりの伸び率 である。↩
-
理論上は、学習の長さが伸びていることも考慮すべきである。実際には、いくつかのデータ点を見たところ学習の長さは時間とともに直線的に伸びているようだったので、その影響はかなり小さいと考えている。↩
-
MetaのOPTの作業記録がこれをよく示している。128ノードのクラスタで、人手での検出と対処を要する障害が多発したため、モデルを1〜2日より長く続けて学習させられなかったと報告している。↩