
レポート
学習と推論実行のあいだでの計算資源のトレードオフ
原題:Trading off compute in training and inference
要点
現在の機械学習システムでは、システムの性能は学習の過程で費やす計算資源(compute)の量と密接に関係している。しかし、推論実行(インファレンス)時の計算資源の使用量を増やす代わりに学習済みモデルの能力を高めることや、性能が下がる代わりに推論実行時の計算資源の使用量を減らすことも可能である。たとえば、モデルを枝刈りして推論実行のコストを下げることもできるし、思考の連鎖(chain of thought)で推論するよう指示して、推論実行のコストを上げることもできる。
5つの具体的な手法(モデルのスケーリング、モンテカルロ木探索、枝刈り、再サンプリング、思考の連鎖)から得た証拠にもとづき、現在の大半のモデル(たとえばGPT-4)と比べて、次のことが可能だと私たちは考えている。
- 推論実行1回あたりの計算量を1〜2桁(OOM)増やす代わりに、性能を保ったまま学習計算量を約1桁節約する。特定の事実知識やごく具体的な技能(たとえば韻を踏む言葉の選び方を知っていること)を必要としない、大半の言語タスクでこれが当てはまると考える。
- 推論実行1回あたりの計算量を2〜3桁増やす代わりに、性能を保ったまま学習計算量を約2桁節約する。逐次的な推論の要素を含むタスクや、より易しい下位タスクに分解できるタスクで、これが可能だと考える。
- 推論実行1回あたりの計算量を5〜6桁増やす代わりに、学習計算量を3〜4桁節約する。これが起こるのは、解を安く検証でき、多数の試行を低コストで並列に行えるタスクに限られると考える。これまでに確認できたのは、コーディング問題を解く場合と、形式数学で命題を証明する場合だけである。
- 逆方向に、学習計算量を1〜2桁増やす代わりに、性能を保ったまま推論実行1回あたりの計算量を少なくとも約1桁減らすことも可能である。これは大半のタスクで当てはまると考える。1
本研究の重要な含意として、モデルの能力と展開の規模のあいだにトレードオフがあることがはっきりする。大規模に展開されるモデルでは推論実行がコストの大半を占めるので、2AI企業は、一般に提供するモデルの推論実行コストを最小にするため、こうした計算資源を節約する手法のいくつかを使うだろう。3
一方でこれらの企業は、社内利用や少数の外部顧客向けであれば、追加の推論実行計算量を活用して、小さな規模でより高い能力を実現できるかもしれない。危険なAI能力の進展や拡散を抑えようとする政策提案は、この可能性を考慮に入れるべきである。
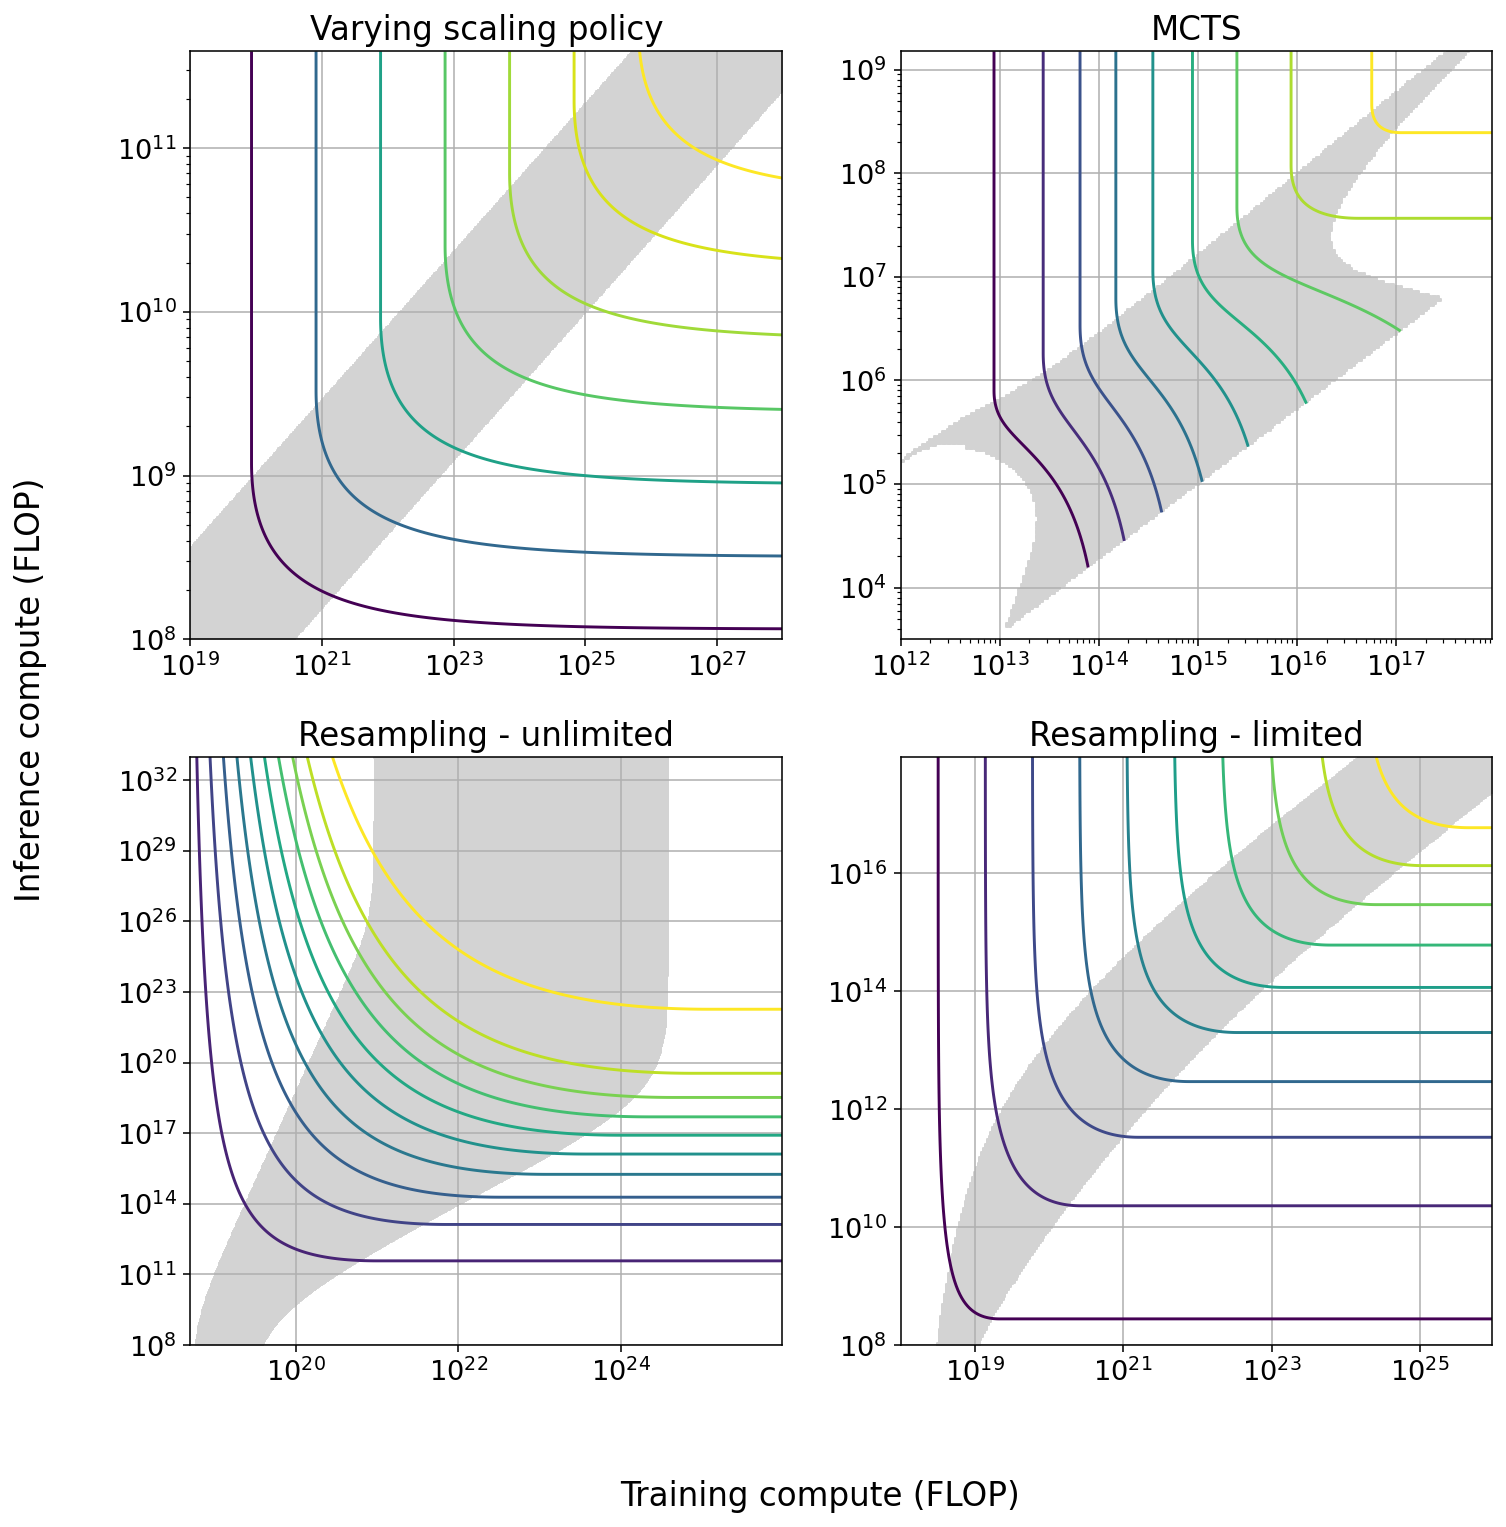
概要図:最も詳しく調べた4つの手法のトレードオフ図。実線の曲線は性能が一定の線を表す。網掛けの領域は効率的な交換の幅、すなわち2種類の計算資源を6対1より良い限界交換比率でトレードオフできる領域である。規模が大きくなるにつれてこの幅が広がる場合もあれば、狭まる場合もある。
| 手法 | 学習側のトレードオフの最大幅 | 推論実行側のトレードオフの最大幅 | 規模を大きくした場合の影響 | 現在のモデルの使われ方 |
| スケーリング方針の変更 | 1.2 OOM | 0.7 OOM | なし | 学習計算量が最小 |
| MCTS | 1.6 OOM | 1.6 OOM | モデルが完璧な性能に近づくと、幅が急に0に近づく | 混在 |
| 枝刈り | ~1 OOM | ~1 OOM | 幅がわずかに広がり、学習への収穫が逓増する4 | 学習計算量が最小 |
反復サンプリング:検証が安価な場合5 | 3 OOM | 6 OOM | 幅が広がる6 | 推論実行計算量が最小 |
| 反復サンプリング:検証が高価な場合 | 1 OOM | 1.45 OOM | なし | 推論実行計算量が最小 |
| 思考の連鎖 | 該当なし7 | 該当なし | 不明 | 推論実行計算量が最小 |
概要表:調べた5つの手法それぞれについて、学習計算量と推論実行計算量の両方におけるトレードオフの最大の大きさ、モデルを大きくしたときのトレードオフのふるまい、現在のモデルがたいていトレードオフのどの領域に位置しているかを示す。「学習計算量が最小」とは、現在のモデルが、その性能を得るのに必要な最小限の学習計算量で学習されていることを示す。
概要
はじめに
機械学習システムにおける学習計算量と能力の関係はよく知られており、スケーリング則という観点から広く研究されてきた。8この関係のために、現在、高度なAI能力は膨大な計算資源を利用できる企業に集中している。この関係はAI能力の予測にも使われ、フロンティアAI能力の進展と拡散を抑えるために提案されている政策の一部の技術的な基盤にもなっている。9
推論実行計算量が能力に及ぼす影響には、これまであまり注意が払われてこなかった。この影響は限られているものの、検討に値するほど大きいと私たちは考える。推論実行時により多くの計算資源を費やす代わりに能力を高められる手法は複数ある。この可能性によって、学習により多くの資源を費やすか、推論実行により多くの資源を費やすか、というトレードオフが生じる。
学習計算量と推論実行計算量の関係は複雑である。推論実行1回のコストはモデルの技術的な特性であるのに対し、モデルの耐用期間全体での推論実行の総コストは、実行される推論実行の回数にも左右される。この2つを区別しなければならない。
推論実行1回のコストは、学習のコストよりはるかに小さい。おおまかな目安として、推論実行1回のコストは学習コストの平方根に近い(図Aを参照)。ただし、ばらつきはかなり大きい。10一方、モデルの耐用期間全体での推論実行の総コストは、学習コストを大きく上回ることが多い。同じモデルが非常に多くの推論実行に使われるからである。11
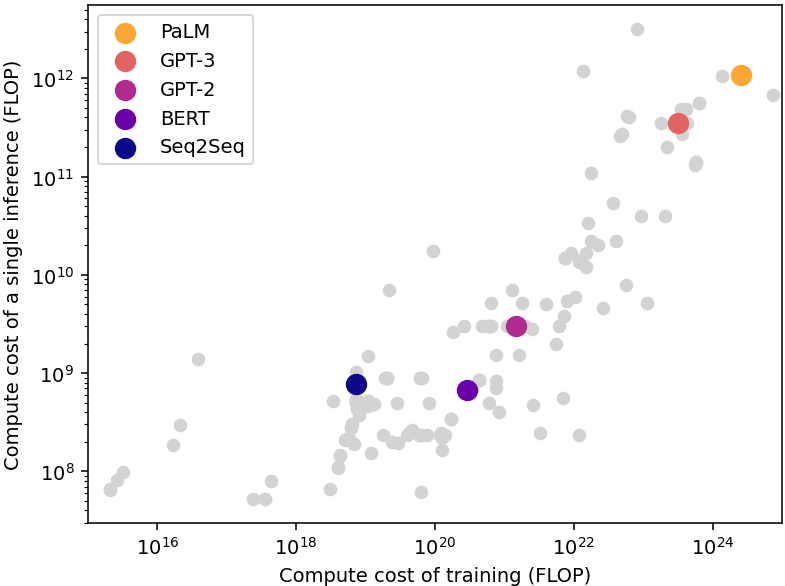
図A:2012年以降に発表された複数の言語モデルについての、学習と推論実行1回に必要な計算量。推論実行1回の計算量は、通常、学習計算量の平方根に近い。データはEpoch AI (2022)による。
トレードオフ
個々の手法
推論実行計算量を増やして能力を高める手法や、同じ性能を保ったまま推論実行計算量を節約する手法をいくつか分析した。トレードオフできる計算量は、手法と分野によって異なる。
たとえば過剰学習(overtraining)を使えば、学習計算量を2桁余分に費やして推論実行計算量を1桁節約しつつ、Chinchillaと同じ性能を実現できる。一方、再サンプリングを使えば、推論実行計算量を1.5桁余分に費やして学習計算量を1桁節約しつつ、AlphaCodeと同じ性能を実現できる。この2つの可能性を、それぞれの手法が生むトレードオフとして図Bに示す。
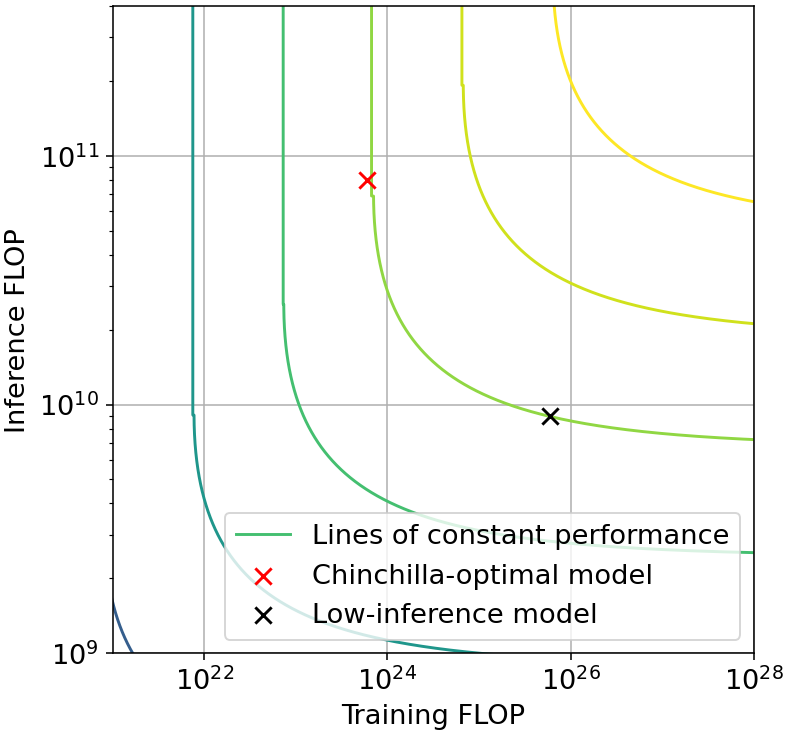
図B:トレードオフの例。左:言語モデリングにおける過剰学習によるトレードオフ。推論実行の少ないモデル(黒)は、Chinchillaの意味で最適なモデルと比べて、学習に2桁余分に費やすことで推論実行を1桁(OOM)節約している。右:n@kでのコード生成における再サンプリングによるトレードオフ。推論実行の多いモデル(赤丸)は、増強していないモデル(赤の×)と比べて、推論実行計算量を1.5桁余分に費やすことで学習計算量を1桁節約している。増強は学習後に行えるので、小さなモデル(赤丸)でも、推論実行計算量を3桁追加して増強すれば、1桁大きいモデルの能力を再現できることになる。
手法と分野によるばらつきが大きいので、一般にどれだけの計算量をトレードオフできるかについて正確な数字は示せない。ただし、おおまかな目安として、どの手法でも、学習と推論実行のどちらか一方で約1桁の計算量を節約する代わりに、もう一方を1桁よりいくらか多く増やすことになると考える。
加えて、推論実行計算量をかなり効率よく活用できる種類のタスクがある。AIが生成した解を安く検証でき、失敗のコストが小さいタスク(たとえば、自動テストに通るプログラムを書く、数学の命題の形式的な証明を生成する)では、有効な解が見つかるまで多数の解を生成できる。
こうしたタスクでは、推論実行時に6桁分の追加の計算量を有効に費やし、学習計算量を3桁減らすことができる。経済的に重要なタスクの多くがこうした性質をもつとは考えていないが、重要な例が少数ある可能性はある。12
手法の組み合わせ
これらの手法は組み合わせることができる。少なくとも一部の場合には、2つの手法を組み合わせた効果が、個々の効果を合わせたものと同じくらい大きいことを確かめた。つまり、それぞれの手法で1桁節約できるなら、両方を組み合わせると2桁節約できる。
しかし、これは特殊な場合であり、一般には2つの手法を組み合わせても、得られる利益は個々の手法の合計より小さいと考える。これらの手法は、同じ作用の仕組みを使っていると互いに干渉しうるからである。13したがって、効果的に組み合わせられるのは、作用の仕組みが大きく異なる手法どうしだけだと考える。
これを踏まえると、手法を組み合わせれば最大で約2〜3桁の節約が可能だと考える。3つ以上の手法を組み合わせても、たいていは効果がないからである。14これらの手法の一部(特に思考の連鎖とMCTS)は、逐次的な推論のような合成的な構造をもつタスクで主に利益を生むようである。ほかのタスクでは、それほど大きな節約は見込めないかもしれない。
含意
こうしたトレードオフの帰結を評価するには、現在のモデルがトレードオフのどこに位置しているかが決定的に重要である。現在のモデルがどの手法でも推論実行計算量の最大値に近いところにあるなら、推論実行計算量は大きく節約できるが、学習計算量はまったく節約できない。逆の場合も同様である。
前の世代のLLM(GPT-3、PaLM、Chinchilla)は、手法を組み合わせたトレードオフでは中間点に近いところに位置づけられるだろう。個々の手法ではトレードオフの両端のどちらかにいることが多いが、手法によってどちらの端にいるかが異なるからである。枝刈りも過剰学習も使っていないので、それらの手法については推論実行計算量が多い側の端にいる。しかし、思考の連鎖も探索も使っていないので、それらの手法については推論実行計算量が少ない側の端にいる。
最新世代のモデル(GPT-4、PaLM 2)についてはあまり分かっておらず、将来のモデルについては何も分からないが、次の理由から、それらは組み合わせたトレードオフの推論実行が少ない側の端により近いところにある可能性が高いと考える。
学習と推論実行のどちらに計算資源を費やすかの最適な配分は、そのモデルが行うと見込まれる推論実行の回数によって決まる。推論実行が大量に必要と見込まれる用途(たとえばシステムの商用展開)では、推論実行コストを最小にする経済的な動機がある。逆に、推論実行が少数しか必要ないと見込まれる用途(たとえばモデルの能力の評価)では、学習がコストの大半を占めるので、そうした動機はない。15
その結果、大規模に展開されるモデルは、推論実行計算量が少ない側の端により近くなる可能性が高いと思われる。一方で、そうしたモデルには、推論実行計算量をより多く使い、そのため大規模には提供されない、はるかに能力の高い版が存在することになる。
結論
推論実行時に追加の計算資源を費やすと、性能に大きな影響が出ることがある。これは特に、AI企業やオープンソースの集団が大規模に展開するモデルに当てはまる。そうした主体には、推論実行を安く行えるよう最適化したモデルを作る動機があるからである。
場合によっては、推論実行時に追加の計算資源を費やすことで、2桁多い計算量で学習したモデルと同じ性能を実現できるかもしれない。これは、アルゴリズムの進歩を考慮しなければ、GPTモデルの世代間(たとえばGPT-3とGPT-4)の差におおよそ相当する。したがって、少なくとも一部のタスクでは、GPT-4のような現在のフロンティアモデルを使って、現存するどのモデルよりも大きなモデルの能力を再現できるはずである。自動検証が可能なタスクでは、さらに大きな改善も可能かもしれない。
このことはAIガバナンスにいくつかの帰結をもたらす。こうして増強したモデルは大規模には提供されないが、一部の主体はそれを効果的に活用できるかもしれない。たとえば次のようなことである。
- モデル評価や安全性研究は、これらの手法を使って、将来大規模に利用できるようになる能力を先取りして調べることができる。
- 一部の用途では、推論実行コストが高いために規模は限られるものの、AIの進歩が予想より速くなるかもしれない。たとえばAI企業は、増強したモデルを使って自社のAI研究を加速できるかもしれない。
報告書の全文
背景
ある機械学習モデルと学習の設定が与えられると、学習に費やす計算量と推論実行1回に費やす計算量の比は、たいてい一定である。この比は、アーキテクチャ、最適化手法、学習データの量などによって決まる。
しかし、ある種のモデルとタスクでは、この計算資源の支出を変えて、学習と推論実行に費やす計算量を独立に変えられる。また、推論実行のたびにモデルを複数回実行するだけで効果がある場合もある。こうして、性能に影響を与えずに、学習に費やす計算量を減らして推論実行に費やす計算量を増やすこと、またその逆を行うことができる。
このことは、AIによる自動化に必要な計算資源の予測に影響する。たとえば、推論実行のコストを高くする代わりに、学習時の計算量をはるかに少なくして人間レベルのAIを実現できるかもしれない。
本報告の貢献
予備報告では、このトレードオフを可能にする手法をいくつか特定し、それぞれの手法について予備的な分析を行い、トレードオフのモデル化にCES関数を使うことを検討した。予備報告は、CES関数ではトレードオフの動きを十分に捉えられないかもしれないと結論した。
本報告では、それらの手法のうち、学習計算量と推論実行計算量の両方についてスケーリングの分析を行えるだけのデータがあるものを選んだ。そのうえで、各手法に特有のスケーリングのふるまいを踏まえてさまざまな関数形をデータに当てはめ、当てはめたモデルにもとづいてトレードオフを分析した。
選んだ4つの手法は、モデルとデータのスケーリング、モンテカルロ木探索(MCTS)、枝刈り、複数サンプリングである。どの手法にも、モデルを計算量の多い側に寄せるか推論実行の多い側に寄せるかを決める制御変数がある。これらの変数の一部には上限や下限がある。たとえば、推論実行1回あたりに生成するサンプルを1個未満にはできない。こうした制約は、トレードオフの制約につながる。
| 手法 | ||||
| 手法名 | スケーリング方針の変更 | 枝刈り | MCTS | サンプリング+選択 |
| 制御変数 | データ量とパラメータ数の比 | 枝刈り後のモデルの密度 | MCTSのノード数 | サンプル数 |
| 仕組み | パラメータ数 | パラメータ数 | フォワードパスの回数 | フォワードパスの回数 |
| 調べた分野 | 言語 | 画像 | ゲーム | 言語 |
表1:調べた手法とその特徴。「仕組み」は、各手法が推論実行計算量に影響を及ぼす際に何を介するかを表す。「調べた分野」は、各手法を調べるのに使ったモデルの分野である(ただし、どの手法も複数の分野に適用できる)。
手法
スケーリング方針の変更
モデルのパラメータ数と学習データセットの大きさを変えるだけで、一定の制約の範囲内で、望みの学習計算量と推論実行計算量をもつモデルを得られる。学習計算量TCと推論実行計算量ICは、パラメータ数Nとデータ量Dと、おおよそ次の関係にある。TC = 6ND、IC = 2N。
これらの関係を使うと、NとDで表したスケーリング則からトレードオフの式を導ける。たとえば、Hoffmann et al. (2022)で見いだされたスケーリング則は次のとおりである。
経験的に求められたパラメータの値を代入すると、学習に約1.2 OOM(桁)多く費やす代わりに、推論実行計算量を約0.7 OOM減らせることが分かる。モデルが多数の推論実行に使われるなら、比較的小さな規模ではこれが割に合うことがある(図2)。16ただし、現在のモデルはすでに最小限の計算量で学習されているので、このトレードオフを学習計算量の節約に使うことはできない。
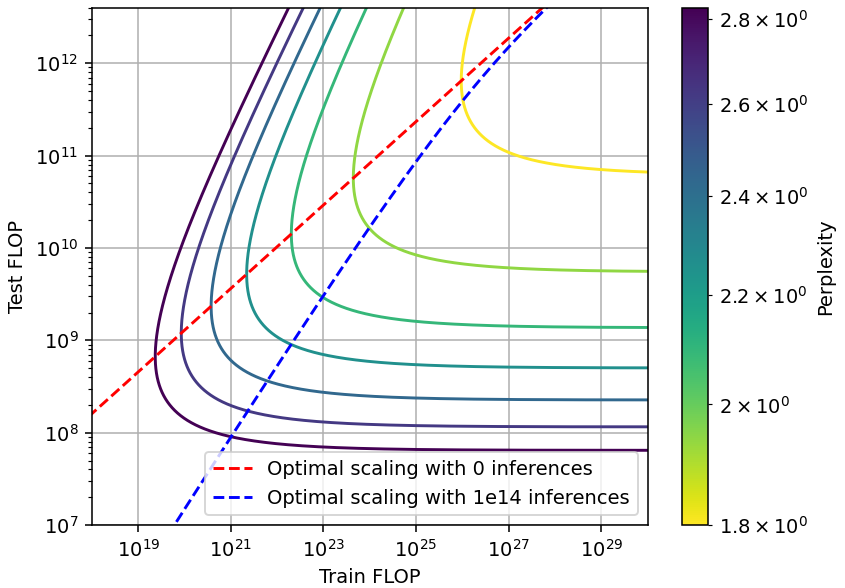
図2:Hoffmann et al. (2022)のスケーリング則が生むトレードオフの形。赤の破線はChinchillaのスケーリング、青の破線は1e14回の推論実行のコストを考慮した計算最適なスケーリングに対応する。
この種のトレードオフの興味深い特徴は、推論実行計算量が多い側の端で、等高線が垂直ではなく斜めになることである。学習計算量を一定にしたまま推論実行計算量を増やすには、より少ないデータで学習する必要があり、それが性能を損なうからである。したがって、性能を保つには、推論実行計算量とともに学習計算量も増やさなければならない。
一方、学習計算量は、より多くのデータで学習するだけで増やせ、推論実行計算量にはまったく影響しない。そのため、学習計算量が多い側の端では、等高線は水平のままである。
モンテカルロ木探索
ゲームをプレイするエージェントの一部、特にAlphaZeroは、フォワードパスの中でモンテカルロ木探索(MCTS)を用いる(Silver et al., 2017)。この探索のノード数は学習時と推論実行時で変えることができ、フォワードパス1回あたりの総計算量はこの数に比例する。17
MCTSを使うエージェントのスケーリングを調べるため、Jones (2021)の結果を再現し、拡張した。ターン制のボードゲームであるHexで学習した、大きさとMCTSノード数の異なるAlphaZeroエージェントを評価した。18
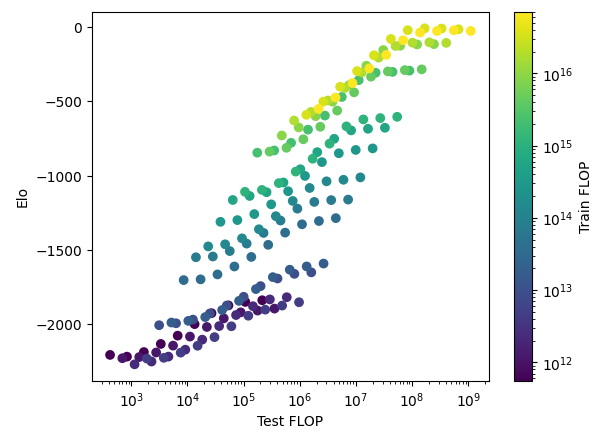
図3:HexにおけるAlphaZeroエージェントのスケーリングは、テスト時のFLOPと学習時のFLOPのどちらについてもS字曲線になる(学習時のFLOPが多い側と少ない側の両端に点が集中していることに注意)。
エージェントの性能は、学習計算量についても、MCTSのノード数についてもS字曲線を描く(図3)。この関係から、スケーリング則を導ける。
ここでσはデータに当てはまるS字曲線の任意のパラメータ表示、Cは学習計算量、MはMCTSのノード数である。ここでは、S字曲線のパラメータ表示に、滑らかに折れ曲がるべき乗則(Caballero et al., 2022)を用いた。
これらの曲線のパラメータはモデルのスケーリング方針に左右されるので、特定のスケーリング方針で学習したモデルからなるデータの一部だけにモデルを当てはめた。こうすることで、スケーリング方針を変えた効果とは切り分けて、MCTSのノード数だけを変えた効果を取り出せる。
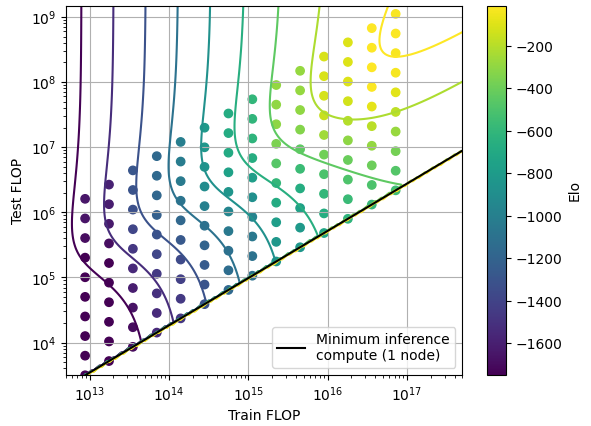
図4:HexにおけるMCTSのトレードオフについての、モデルの等高線と実データ。Eloは、完璧なプレイが0点になり、Eloが低いほど性能が低くなるように正規化している。
このスケーリング則を使って、トレードオフの形を描ける(図4)。MCTSの探索ノードが1個未満のモデルは実行できないので、学習計算量ごとに推論実行計算量の最小値がある。
この場合、トレードオフの傾きと幅は小さな規模では一定だが、規模が大きくなり、モデルが完璧なプレイに近づくと変化する。この形の変化は、モデルの大きさを拡大するだけでは完璧な性能に届かないことによる。-500 Eloを超えて性能を上げるには、MCTSのノード数を増やすことが必要になり、その結果、トレードオフの幅は狭まる。
性能が低いところでは、学習の1 OOMに対して推論実行の1.6 OOM強をトレードオフする。一方、性能が高いところではこれがほぼ逆転し、学習の1.6 OOMを推論実行のわずか1.1 OOMとトレードオフできる(図5)。最後に、完璧な性能に達すると、トレードオフは消え、学習計算量と推論実行計算量の両方を最小にする点が1つだけになる。
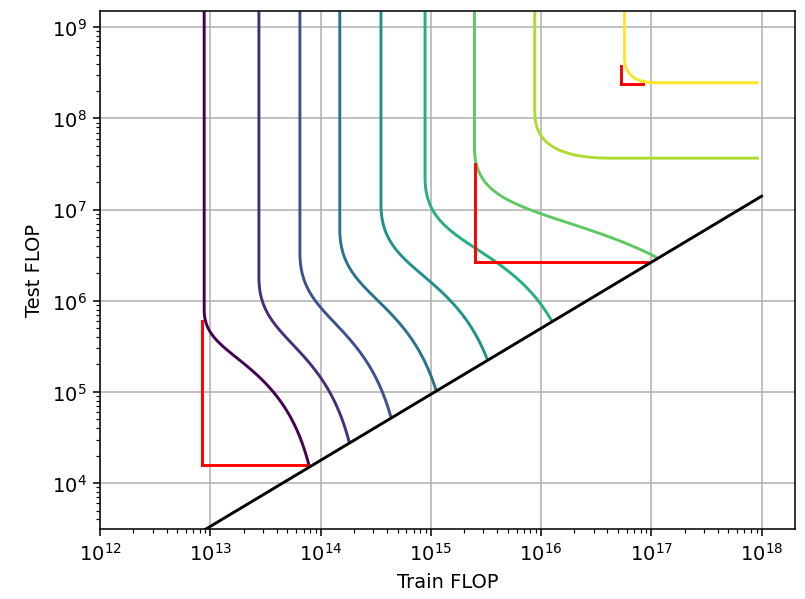
図5:MCTSのトレードオフの幅は規模によって変化する
さらに、学習計算量が多い側の端では等高線が水平にならない(少なくとも性能が高いところでは)一方、推論実行計算量が多い側の端では垂直になることが分かる。これはChinchillaのスケーリングで見たのと逆である。この場合は、学習計算量を減らさずに推論実行計算量を自由に増やせる(MCTSのノードを加えればよい)が、その逆はできないからである。
枝刈り
枝刈りとは、学習後に重要でない重みを取り除いてモデルを小さくする一連の手法を指す(Blalock et al., 2020)。この手法は、学習の計算量の節約には使えないが、推論実行の計算量の節約には使える。ここでは、スケーリングの分析が見つかった具体的な枝刈り手法である、反復的大きさ枝刈り(Iterative Magnitude Pruning、IMP)(Frankle et al., 2018)だけを分析した。
この手法は次のように働く。まずモデルを通常どおり学習し、絶対値が最も小さい重みの一部をゼロにする。次に、残った重みを初期値に戻し、モデルを再び学習する。この手順を何回か繰り返す。よくある設定では、反復ごとに重みの20%を枝刈りし、最大で約20回反復する(Frankle et al., 2018)。
枝刈り後のモデルの密度とは、枝刈り後の大きさと枝刈り前の大きさの比、すなわち枝刈り後に残る重みの割合である。推論実行計算量はモデルの大きさに比例するので、密度を下げると、推論実行計算量も同じ割合で減る。
しかし、枝刈りは学習のコストを増やす。枝刈りを1回反復するたびに、モデルを学習し直さなければならないからである。各反復で重みの割合xを枝刈りし、それをn回繰り返すと、学習計算量は(1-(1-x)^n)/x倍になる。たとえば、重みの20%ずつを枝刈りして密度10%を実現するには、各回あたり約4.5倍の学習計算量が必要になる。
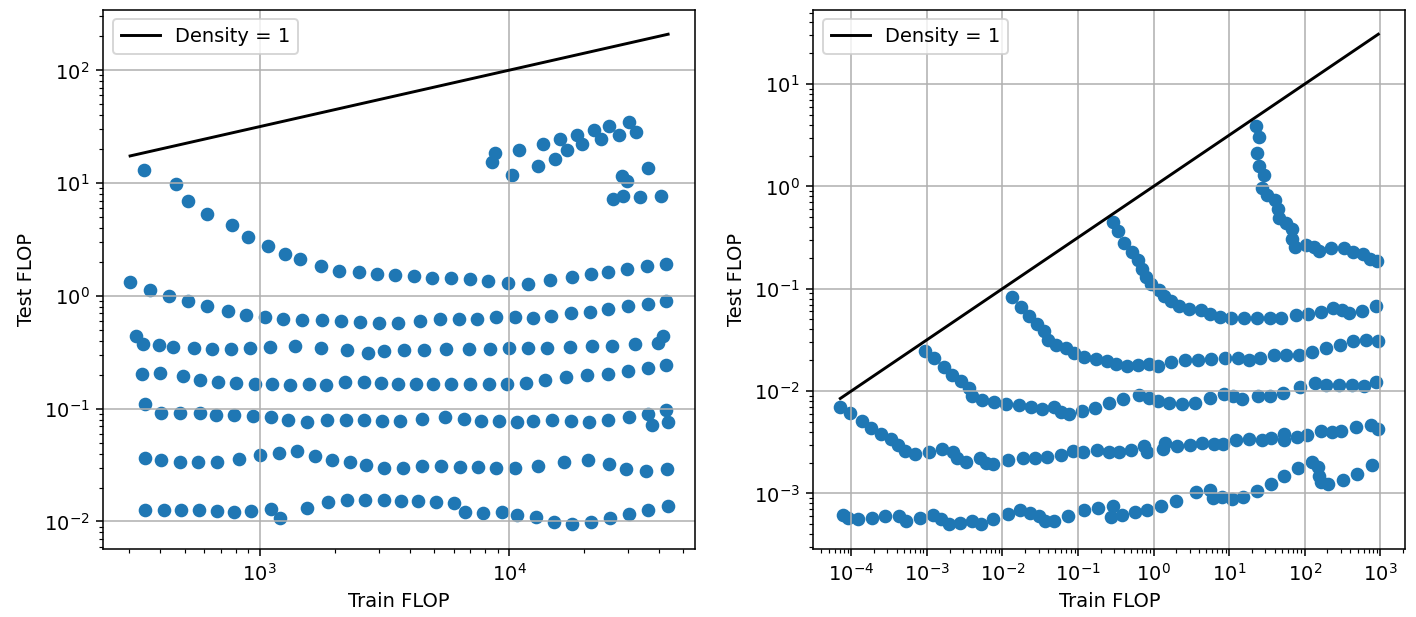
図6:枝刈りのトレードオフ。データはRosenfeld et al. (2020)による。左:ネットワークの深さ(層の数)のスケーリング。右:ネットワークの幅(層の大きさ)のスケーリング。枝刈りのコストは学習計算量に含めている。
トレードオフの特徴は規模によって変わることが分かる(図6右)。大きなモデルほど深く枝刈りでき、より少ない学習計算量と引き換えに、より多くの推論実行計算量を節約できる。試した最大の規模では、枝刈りによって、性能を保ちつつ、学習計算量の約0.7 OOMの増加だけで推論実行計算量を約1 OOM減らせる。これは、モデルを密度約10%まで枝刈りすることに相当する。このように規模に左右されるのは、最大の規模ではモデルが過学習しており、枝刈りの恩恵をより大きく受けるためかもしれない。
反復サンプリングとふるい分け
生成モデルでは、モデルから複数回サンプリングし、生成された出力のうち最良のものだけを残すことができる。コーディング問題を解く場合には、これによって正答を出す確率が大幅に上がる(Li et al., 2022)。
コードと数学の生成についてデータを集めた。これらの分野では解の正しさを自動で評価できるので、大規模なサンプリングが現実的になる。こうした問題の評価指標には2種類ある。
- pass@kは、k個のサンプルを生成したとき、そのいずれかが正しい確率である
- n@kは、k個のサンプルを生成してそのうちn個を選んだとき、そのn個のいずれかが正しい確率である。
n@kは、解の正しさの確認にコストがかかり、そのため少数の解の候補しか評価できない、ほかの分野の条件を模擬するのに使われる。この設定では、生成したサンプルを何らかの品質基準でふるいにかけ、n個だけが残るようにする。
pass@kでは、サンプルを増やせば必ず役に立つ。そのどれかが正しい可能性が常にあるからである。しかし、n@kではそうはならない。ふるい分けが常に最良のサンプルを選ぶとは限らず、nの値が十分小さければ、サンプル数を増やしても最終的には頭打ちになる(図7)。
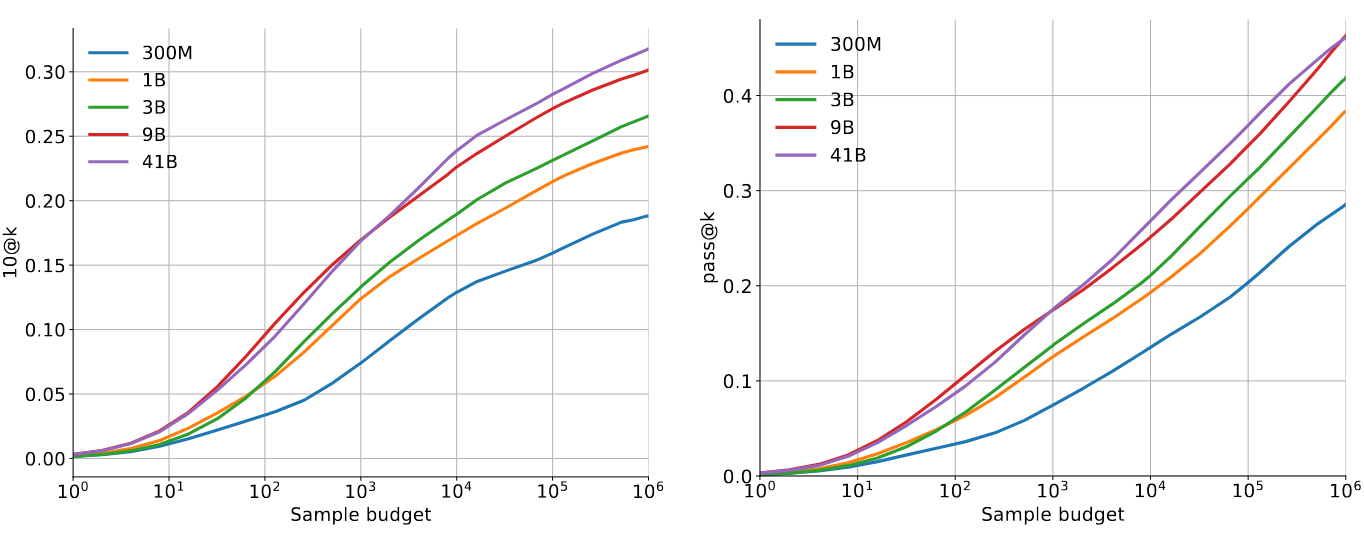
図7:AlphaCodeにおける10@kとpass@kの比較。モデルの大きさとk(サンプル数の予算)の値を変えている。出典:Li et al. (2022)。
試行回数に制限がない場合
pass@kの状況は次のようにモデル化できる。正答率は、何らかの「探索」の尺度のべき関数である。サンプル数を増やすと探索される解の量が増え、大きなモデルほどうまく探索する。この後半の部分は単純な対数関数で表せる。サンプル1個の探索の価値を とする。ここでTCは学習計算量、A、aは当てはめるパラメータである。すると、性能は傾きbのS字曲線で与えられる。これを、曲線が常に正答率100%で飽和するよう少し修正した、滑らかに折れ曲がるべき乗則でパラメータ表示する。
このモデルをAlphaCodeの結果で検証した。仮定は単純だが、データにかなりよく当てはまる(図8)。
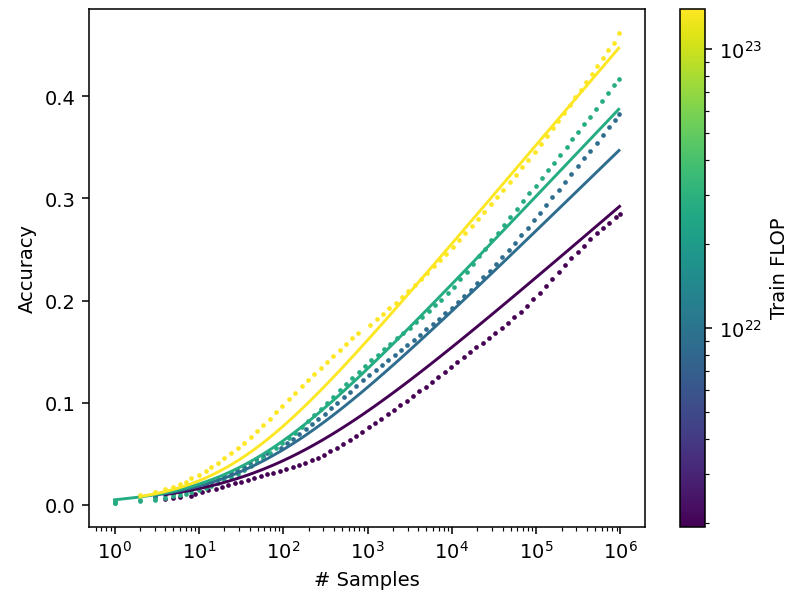
図8:pass@kを用いたコード生成のスケーリングモデル。点は実データ、実線はモデルの当てはめである。データはLi et al. (2022)による。
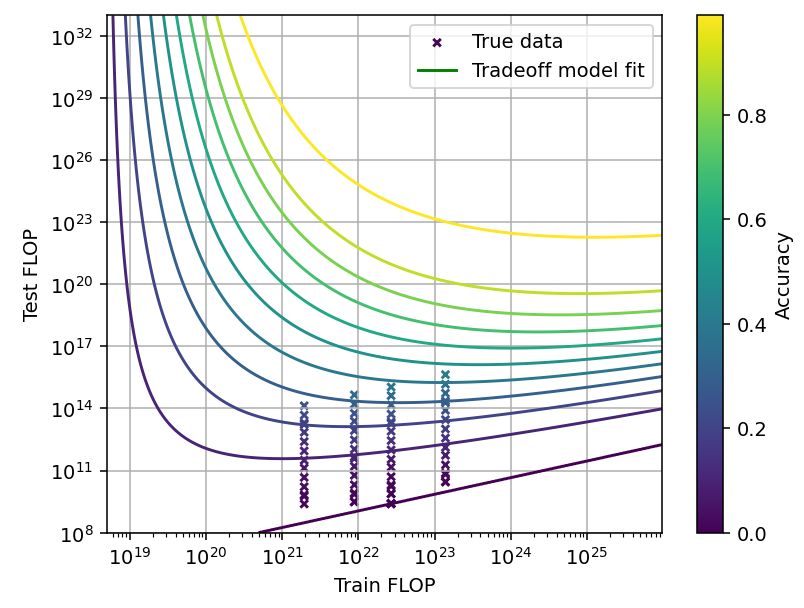
図9:pass@kを用いたコード生成のトレードオフ。データはLi et al. (2022)による。
このモデルを使って、pass@kについてトレードオフの形を描ける。残念ながら、データがかなり限られているので、このモデルをあまり真に受けるべきではない。とはいえ、トレードオフの形は規模に左右されるようである。小さな規模では、学習の最大2 OOMを推論実行の約3〜4 OOMとトレードオフできる。一方、正答率が完璧に近いところでは、学習の4 OOMを推論実行のわずか6 OOMとトレードオフできる(図9)。トレードオフの全体の形はMCTSの場合と似ており、学習計算量が多い極限で等高線が右上がりになる。
AlphaCodeのデータに加えて、Minervaの数学の生成のデータでもモデルを検証した(図10)。この場合、pass@kの性能はn@kの場合とよく似たふるまいをし、正答率はある程度のサンプル数で頭打ちになる。サンプルが十分にあれば、AlphaCodeでも同じふるまいが見られる可能性は十分ある。そうだとすれば、上で概略を示したモデルは成り立たず、以下で試行回数に制限がある場合について作るのと同じモデルを使わなければならない。
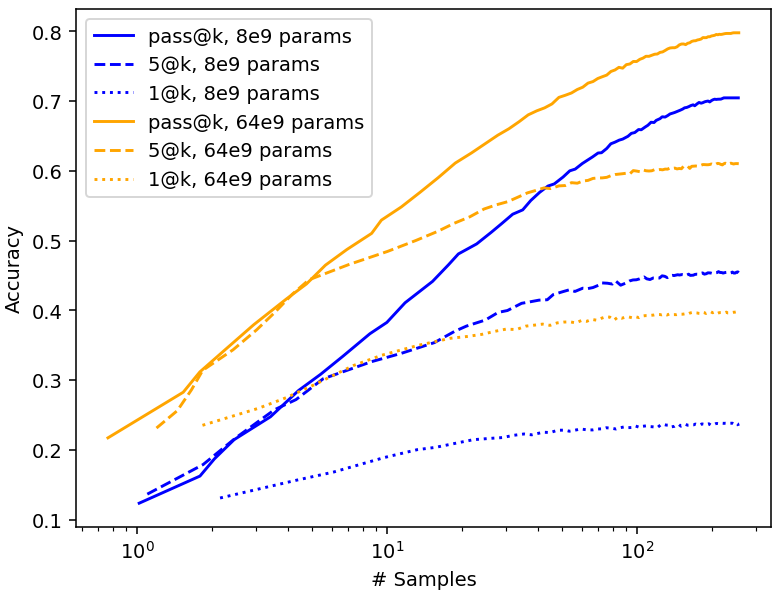
図10:Minervaのpass@kとn@kの性能。データはLewkowycz et al. (2022)による。
試行回数に制限がある場合
n@kの場合、サンプルを増やしても、いずれ性能は向上しなくなる。前の場合とよく似たモデルを用いる。唯一の違いは、S字曲線が1より小さく、傾きbで決まる値で飽和することである。
この違いの結果、トレードオフできるのは学習の約1 OOMと推論実行の1.45 OOMだけになる(図11)。また、この幅は規模によらないようである。ただし、データが何桁にもわたっていないので、この結論にはあまり確信がない。
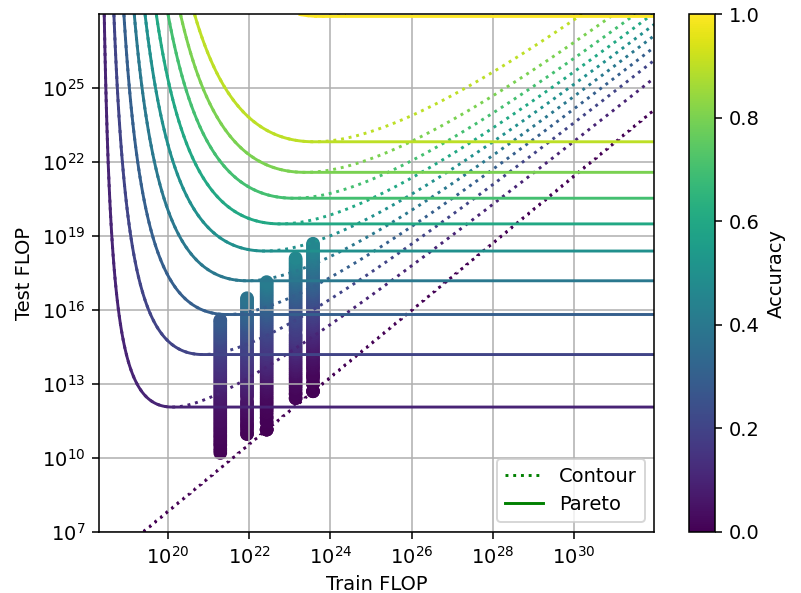
図11:10@kを用いたコード生成のトレードオフ。データはLi et al. (2022)による。
思考の連鎖とモデルカスケード
「言語モデルカスケード」(Dohan et al., 2022)という用語は、言語モデルの複数の推論実行を構造的に組み合わせることを指し、スクラッチパッド、タスクの分解と委任、リフレクション(reflexion)などの手法を含む。
これらの手法は、推論実行計算量を多く使うことで一部のタスクの性能を大きく高めるが、私たちは定量的には分析しなかった。一因は、推論実行計算量を増やしたときにこれらの手法がどうスケールするかについて、データがあまり見つからなかったことである。加えて、これらの手法の多くは、使う強さを連続的に変えることができず、使わないか使うかの離散的な切り替えしかできない。そのため、トレードオフ曲線を当てはめるという私たちのやり方は、これらの手法のモデル化には向いていない。
この種のデータで最も参考になったのは、Tree-of-Thoughts(Yao et al., 2023)のデータである。19この手法は思考の連鎖による推論の経路を探索するもので、MCTSを思わせる。実際、規模に対するふるまいはMCTSとサンプリング+選択の両方に似ているようで、正答率はノード数に対して対数線形に上がる。
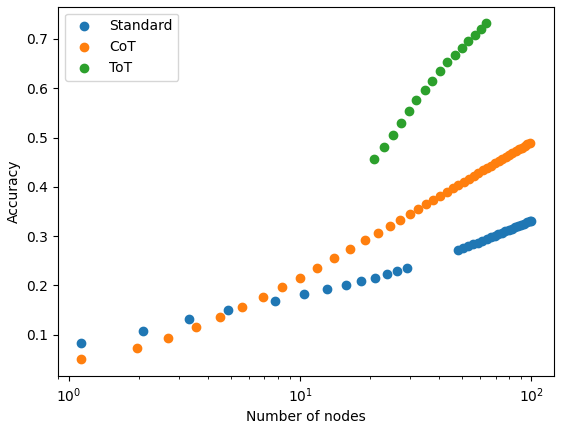
図12:探索ノード数に対するTree-of-Thoughtsのスケーリングを、Chain-of-Thoughtと標準的なプロンプトと比べたもの(後2者では、ノード数は単に生成したサンプル数である)。データはYao et al. (2023)による。
トレードオフの組み合わせ
これらの手法の一部は組み合わせて使うことができ、そうすればより大きなトレードオフになるだろう。たとえばHexについては、Chinchilla型のトレードオフとMCTSのトレードオフの両方のデータがあり、それぞれ単独の場合と組み合わせた場合の大きさを比べられる(図13)。組み合わせたトレードオフの幅は、2つの独立した幅の和に近い。
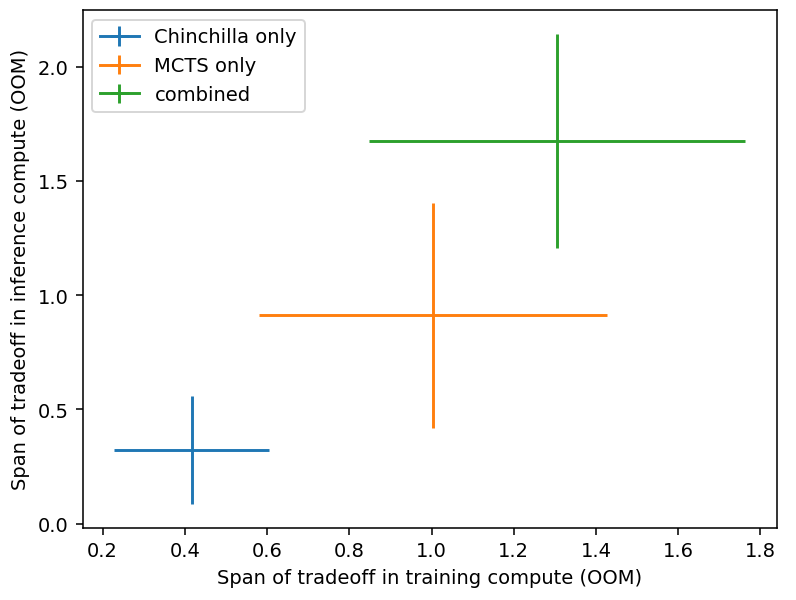
図13:Hexにおけるトレードオフの組み合わせ。十字の位置と大きさは、さまざまな性能水準にわたってとった平均と標準偏差を示す。データはJones (2021)による。
おそらく、調べた手法のすべてを効果的に組み合わせられるわけではない。つまり、一部の手法は組み合わせてもトレードオフが大きくならない。Chinchilla型の手法と枝刈りは、どちらもモデルの大きさを独立のパラメータとして使うので、効果的には組み合わせられないと推測する。同様に、MCTSと再サンプリングも、どちらもモデルへの問い合わせを繰り返すものなので、おそらく組み合わせられない。
トレードオフのモデル化
各手法が生むトレードオフを調べるなかで、一般に、学習計算量と推論実行計算量の両方を増やしたのに性能が下がる、ということが起こりうると分かった。つまり、これまで描いてきた等高線はパレートフロンティアではない。こうした非効率な学習設定にも注意を払ったのは、モデルをデータに当てはめるのに役立つからである。
しかし、実際の研究者は、学習と推論実行の計算量の予算のもとで利用できる最適な学習設定を使うはずである。そこでトレードオフのモデルでは、損失の実際の等高線ではなく、パレートフロンティアだけに注目する(図14)。
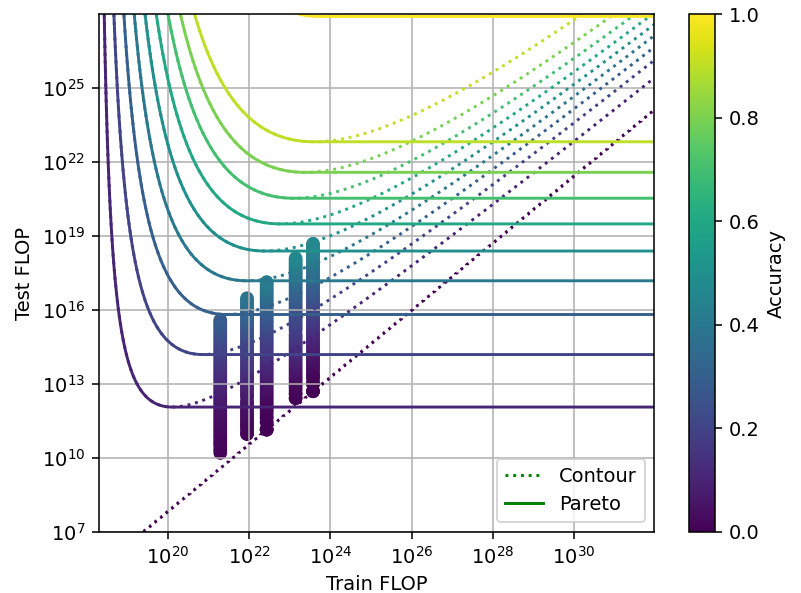
図14:パレートフロンティアと損失の等高線の比較
さまざまな手法が生むトレードオフを調べた結果、質的に異なる3種類のトレードオフを特定した(図15)。それらの主な違いは、1) 一方を一定に保ったとき、性能が学習計算量または推論実行計算量に対して飽和するかどうか、2) トレードオフの幅が規模に対して一定か、狭まるか、の2点である。
HexやMATHで見られるように、対象のタスクで完璧な性能に近づいているときには、規模とともに幅が狭まる可能性が高い。一方、頭打ちにならずにモデルを何桁もスケールし続けられるときには、幅は一定になる傾向がある。
- 飽和する。幅は規模によらず一定。例:Chinchillaのスケーリング。モデルがまだ完璧な性能から遠いときに、この種のトレードオフが見られる可能性が高い。この種のトレードオフはCES関数でモデル化できる。
- 飽和する。幅は規模とともに狭まる。例:MCTS、試行回数に制限があるコード生成。モデルが完璧な性能に近づいているときに、この種のトレードオフが見られる可能性が高い。対数CES関数でうまくモデル化できるかもしれない。
- 飽和しない。幅は規模とともに広がる。例:試行回数に制限がないコード生成。これはまったく異なる種類のトレードオフで、一方の要因を一定に保ったとき、学習計算量または推論実行計算量の関数としての性能が頭打ちにならない場合に生じる。つまり、計算量を増やせば必ず役に立つ。双曲線関数でモデル化できる。
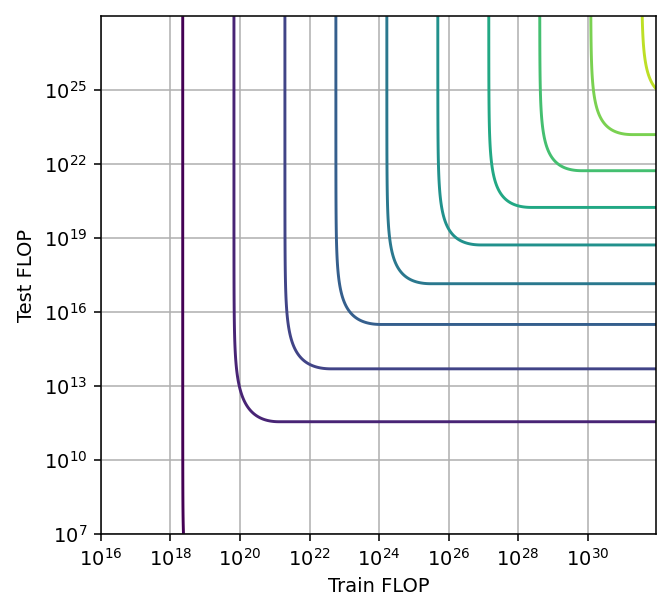
図15:種類a、b、c(左から右)のトレードオフのパレートフロンティア。
種類c)のトレードオフにあたりそうな例は、再試行の回数に制限がないコード生成だけである。この場合、推論実行計算量に対する収穫は、6桁増やしてもゼロにならないようである。しかし、より易しい数学の生成のベンチマークでは、追加の推論実行計算量に対する収穫が最終的にゼロになることが確かに見られる。このことから、まだその地点には達していないとしても、推論実行計算量が十分にあれば、コード生成の性能もいずれ飽和すると考えられる。
枝刈りも、規模とともに幅が広がる手法のようである。しかし、これは過学習による見かけ上の現象だと考えており、より難しいタスクや生成モデルでは、枝刈りのトレードオフが同じようにふるまうとは考えていない。
効率と最適なスケーリング
トレードオフの効率とは、学習計算量と推論実行計算量のあいだの「交換レート」を指す。トレードオフの全幅にわたって、効率はたいてい1をいくらか下回る。そのため、学習と推論実行のどちらかで1 OOMを節約するには、もう一方を1 OOMより多く増やす必要がある。ただし、一般に効率はトレードオフの幅全体で均一ではなく、最適な点は学習計算量と推論実行計算量の相対的なコストによって変わる。
結論
4つの異なる手法を調べた結果、学習計算量と推論実行計算量のトレードオフについて、質的・量的な性質をいくつか特定した。大半の場合、規模を大きくしてもこのトレードオフの幅は一定か狭まり、その幅は両方の要因で1〜2桁程度だと考える。
例外となりうるのは、試行回数に制限がない再サンプリングの場合である。この場合、追加の推論実行計算量に対する収穫は常に大きく、規模とともに広がる、はるかに大きな幅(6桁以上)を実現できるようである。ただし、この結論は、スケーリング則を当てはめた範囲の2倍にわたって外挿してはじめて得られるものである。さらに、より易しい数学の生成のベンチマークの結果では、このように幅が広がる様子は見られない。そのため現時点では、試行回数に制限がない再サンプリングが本稿で示したほど有望だという点には、あまり確信がない。
上記の手法の一部を組み合わせると、2〜3桁のトレードオフの幅が得られる。既存の手法と組み合わせられる新しい手法が見つかるかもしれないが、それらが既知の手法と似たトレードオフを生む限り、3〜4桁を超える幅のトレードオフが見られるとは考えていない。
謝辞
この草稿の以前の版にコメントをくださったEge Erdil、David Owen、Anson Ho、Tom Davidson、Tamay Besiroglu、Jean-Stanislas Denain、Jaime Sevilla、Markus Anderljung、Lisa Soderの各氏に感謝する。
参考文献
Blalock, D., Ortiz, J. J. G., Frankle, J., & Guttag, J. (2020). What is the State of Neural Network Pruning? ArXiv:2003.03033 [Cs, Stat]. https://arxiv.org/abs/2003.03033
Caballero, E., Gupta, K., Rish, I., & Krueger, D. (2023, July 23). Broken Neural Scaling Laws. ArXiv.org. https://doi.org/10.48550/arXiv.2210.14891
Dey, N., Gosal, G., Chen, Z., Khachane, H., Marshall, W., Pathria, R., Tom, M., Hestness, J. (2023). Cerebras-GPT: Open Compute-Optimal Language Models Trained on the Cerebras Wafer-Scale Cluster. ArXiv:2304.03208 [Cs]. https://arxiv.org/abs/2304.03208
Dohan, D., Xu, W., Lewkowycz, A., Austin, J., Bieber, D., Lopes, R. G., Wu, Y., Michalewski, H., Saurous, R. A., Sohl-dickstein, J., Murphy, K., & Sutton, C. (2022, July 28). Language Model Cascades. ArXiv.org. https://doi.org/10.48550/arXiv.2207.10342
Epoch AI. (2022). Parameter, Compute and Data Trends in Machine Learning. /data/ai-models?view=table#explore-the-data
Frankle, J., & Carbin, M. (2019). The Lottery Ticket Hypothesis: Finding Sparse, Trainable Neural Networks. ArXiv:1803.03635 [Cs]. https://arxiv.org/abs/1803.03635
Jones, A. L. (2021, April 15). Scaling Scaling Laws with Board Games. ArXiv.org. https://doi.org/10.48550/arXiv.2104.03113
Lewkowycz, A., Andreassen, A., Dohan, D., Dyer, E., Michalewski, H., Ramasesh, V., Slone, A., Anil, C., Schlag, I., Gutman-Solo, T., Wu, Y., Neyshabur, B., Gur-Ari, G., & Misra, V. (2022). Solving Quantitative Reasoning Problems with Language Models. ArXiv:2206.14858 [Cs]. https://arxiv.org/abs/2206.14858
Li, Y., Choi, D., Chung, J., Kushman, N., Schrittwieser, J., Leblond, R., Eccles, T., Keeling, J., Gimeno, F., Dal Lago, A., Hubert, T., Choy, P., de Masson d’Autume, C., Babuschkin, I., Chen, X., Huang, P.-S., Welbl, J., Gowal, S., Cherepanov, A., & Molloy, J. (2022). Competition-level code generation with AlphaCode. Science, 378(6624), 1092–1097. https://doi.org/10.1126/science.abq1158
Olausson, T. X., Inala, J. P., Wang, C., Gao, J., & Solar-Lezama, A. (2023, June 22). Demystifying GPT Self-Repair for Code Generation. ArXiv.org. https://doi.org/10.48550/arXiv.2306.09896
Owen, D. (2023). Extrapolating performance in language modeling benchmarks. https://epoch.ai/files/llm-benchmark-extrapolation.pdf
Patterson, D., Gonzalez, J., Urs Hölzle, Le, Q. V., Liang, C., Lluís-Miquel Munguía, Rothchild, D., So, D. R., Texier, M., & Dean, J. (2022). The Carbon Footprint of Machine Learning Training Will Plateau, Then Shrink. ArXiv (Cornell University). https://doi.org/10.48550/arxiv.2204.05149
Rosenfeld, J. S., Frankle, J., Carbin, M., & Shavit, N. (2021, July 3). On the Predictability of Pruning Across Scales. ArXiv.org. https://doi.org/10.48550/arXiv.2006.10621
Silver, D., Hubert, T., Schrittwieser, J., Antonoglou, I., Lai, M., Guez, A., Lanctot, M., Sifre, L., Kumaran, D., Graepel, T., Lillicrap, T., Simonyan, K., & Hassabis, D. (2017). Mastering Chess and Shogi by Self-Play with a General Reinforcement Learning Algorithm. ArXiv.org. https://arxiv.org/abs/1712.01815
Yao, S., Yu, D., Zhao, J., Shafran, I., Griffiths, T. L., Cao, Y., & Narasimhan, K. (2023, May 17). Tree of Thoughts: Deliberate Problem Solving with Large Language Models. ArXiv.org. https://doi.org/10.48550/arXiv.2305.10601
Zelikman, E., Huang, Q., Poesia, G., Goodman, N. D., & Haber, N. (2023, May 28). Parsel: Algorithmic Reasoning with Language Models by Composing Decompositions. ArXiv.org. https://doi.org/10.48550/arXiv.2212.10561
注
-
これを可能にする手法として調べた過剰学習と枝刈りは、きわめて汎用的だからである。量子化のようなほかの手法も、非常に汎用的であるように思われる。↩
-
Patterson et al. (2022)は、2019年、2020年、2021年のそれぞれ3週間について、Googleのデータセンターにおける推論実行の総コストが機械学習の計算資源の支出全体の60%を占めることを示している。加えて、2023年7月時点で、GPT-4がChatGPTでは有料の顧客に対しても利用回数の上限付きでしか提供されていないことから、推論実行が現在AI企業にとってボトルネックになっていると考えられる。↩
-
これはすでに起きている。オープンソースのモデルでは量子化が広く使われており、推測ではあるが、クローズドソースのモデルでも使われている。↩
-
学習計算量が1 OOM増えるごとに、推論実行計算量の幅はおよそ0.08 OOM広がる。トレードオフの効率(推論実行計算量の減少と学習計算量の増加の比)は、学習計算量が1 OOM増えるごとに0.5上がる。↩
-
ここでは何桁にもわたって外挿しているので、この結果は疑ってかかるべきである。↩
-
学習計算量が1 OOM増えるごとに、学習計算量と推論実行計算量の両方の幅が0.75 OOM広がる。↩
-
思考の連鎖型の手法については、この量を決められなかった。こうした手法はたいてい二者択一で、使うか使わないかのどちらかしかなく、使う強さを連続的に変えることができないからである。↩
-
たとえばOwen (2023)を参照。↩
-
たとえば、一定の規模を超える学習の実行を一時停止する提案や、大規模なモデルの学習に許可を必要とする提案がある。↩
-
たとえばGPT-3では、学習のコストが3e23 FLOPであるのに対し、推論実行1回のコストは3e11である。したがって、学習のコストは推論実行1e12回分に相当する。↩
-
Patterson et al. (2022)は、2019年、2020年、2021年のそれぞれ3週間について、Googleのデータセンターにおける推論実行の総コストが機械学習の計算資源の支出全体の60%を占めることを示している。↩
-
安価な検証ができるのは、形式的な体系の中で具体的な目標を達成するタスクだけだと考える。一例はビデオゲームのプレイだが、これは経済的な影響が大きくない。ハッキングやチップ設計は、より重要な候補である。↩
-
たとえば、過剰学習と枝刈りはどちらもモデルのパラメータ数を減らすことに頼っているので、おそらく効果的には組み合わせられない。一方、過剰学習とMCTSは効果的に組み合わせられる。↩
-
対象のタスクで安価な検証ができないと仮定した場合である。安価な検証ができるなら、組み合わせたトレードオフの幅は6 OOM以上になるかもしれない。↩
-
たとえば、3億人のユーザーが1年間、平均して1日1回モデルに問い合わせ、1回の問い合わせで1000トークンを消費すると仮定すると、1年間のフォワードパスの回数は300e6 * 365 * 1000 = 110兆回になる。一方、GPT-3の大きさのモデルを計算最適に学習するには3.5兆回のバックワードパスが必要で、その1回あたりのコストはフォワードパスの3倍である。したがって、学習のコストは1年間の推論実行のコストの10分の1にすぎない。そのため、総コストを最小にするには、より小さなモデルを過剰学習させるのが理にかなうかもしれない。↩
-
これはDey et al (2023)が調べている。同論文の第4節では、Cerebras-GPTとPythiaのモデルファミリーを比べている。実行する推論実行が2000億回未満ならCerebras-GPTファミリーのほうが計算効率が高いが、それを超えるとPythiaのほうが効率が高くなる。↩
-
MCTSのノードごとに、基盤となるニューラルネットワークに問い合わせる。↩
-
Hexを選んだのは、Jones (2021)のデータとコードがすぐに使えたからである。↩
-
自己修復(self-repair)(Olausson et al., 2023)やParsel(Zelikman et al., 2023)など、ほかの手法のデータも見つけたが、それらの分析は反復サンプリングによる利益のほうに重点を置いている。↩