
ニュースレター
リードタイムが延びるため、計算資源のスケーリングは減速する
原題:Compute scaling will slow down due to increasing lead times
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
2020年以降のAIの進歩を支えてきた計算資源の大規模なスケーリングは、まもなく減速する可能性が高い。経済的な不確実性が高まり、開発のサイクルが長くなるからである。
投資家は理屈のうえでは計算資源を数桁拡大できるが、必要な額は数千億ドルにのぼり、しかもリターンは不確かである。そのため投資家は、段階的なスケーリングへと向かうだろう。つまり、投資し、製品を展開してリターンを見極め、そのうえで追加の投資を判断し直すというやり方である。さらに、必要な計算資源が大きくなるほど、プロジェクトの開始から製品の展開までにかかる時間(いわゆる「リードタイム」)が大幅に延びる。これがフィードバックループを生み、計算資源のスケーリングのペースはおのずと落ちていく。
具体的には、計算資源の規模が10倍増えるごとに、リードタイムはおよそ1年延びるというのが現時点での私たちの最善の見立てである。たとえばOpenAIは現在、おそらく150億ドルを超える計算資源をもっており、この計算資源のストックは年におよそ2.2倍のペースで増えてきた。1 このペースが続くなら、今のトレンドからは2030年ごろに1兆ドル規模のクラスターが登場すると予測される。だがリードタイムが延びれば、それは2035年ごろまでずれ込むだろう。
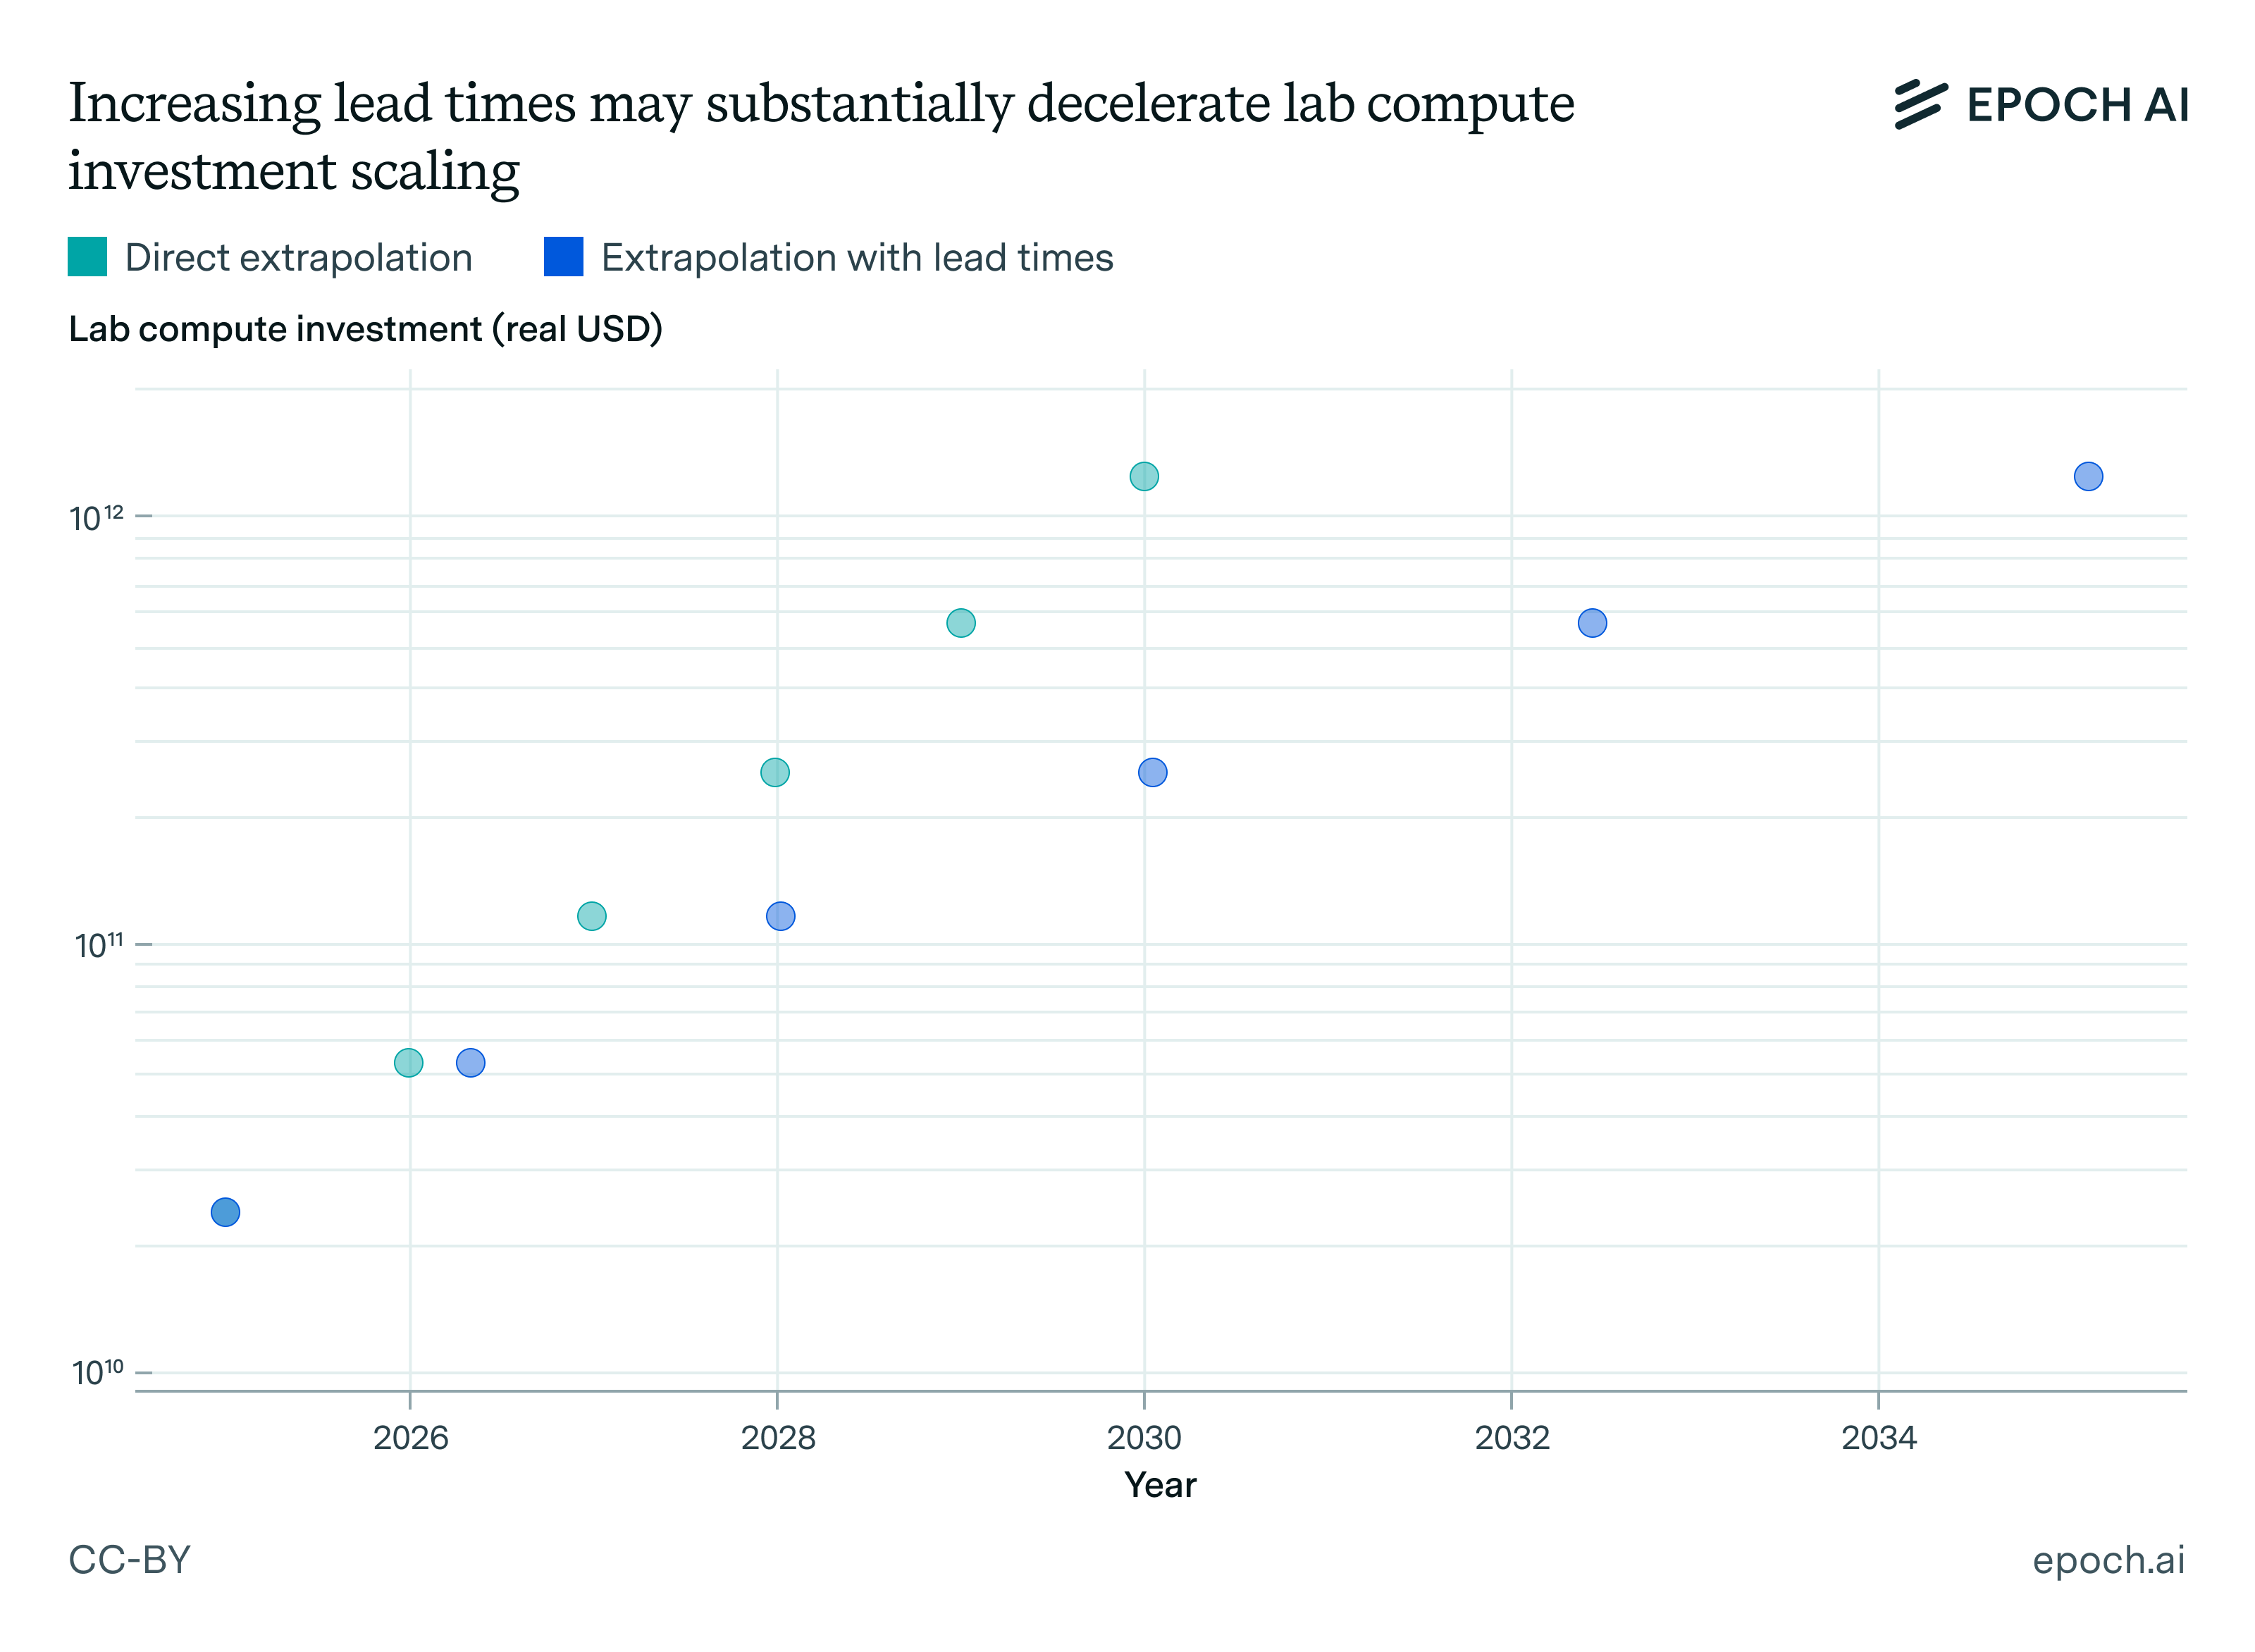
「リードタイムを考慮した外挿」は、単純な外挿を出発点とし、計算資源のストックが10倍増えるごとにリードタイムが1年延びるように調整して求めた。この遅れは積み重なるため、計算資源の規模が大きいほど遅れの合計も大きくなる。
ここで押さえておきたいのは、この力学が最も直接に当てはまるのは研究所が保有する計算資源のストック全体であって、学習実行の規模ではないことだ。リードタイムによって計算資源への投資のスケーリングが鈍っても、最先端のAI研究所は、計算資源のうち学習に回す割合を増やすことで、あと1〜2年は学習計算量を年5倍のペースで拡大し続けられるかもしれない。
その影響はきわめて大きいかもしれない。実験を行って新しいアルゴリズムの改善を見つけようにも、必要な計算資源を確保しにくくなるおそれがあり、いずれは学習計算量のスケーリングも減速せざるをえなくなる。計算資源はモデルの能力と強く相関しているので、私たちはこの力学がAIの進歩を鈍らせると予想している。
Epoch AI の最新情報を受け取る 購読する
投資リターンの不確実性が「一か八かの拡大」を妨げる
投資家が「苦い教訓(Bitter Lesson)」を信じているなら、利用できる計算資源の拡大にすべてをつぎ込むはずだと思うかもしれない。たとえばGATEモデルのような経済モデルにはこの種の力学が見られ、このモデルは(疑わしいことに)今日AIに25兆ドルを投資するのが最適だと予測している。
しかし実際には、そこまで巨額の投資が行われる可能性はきわめて低い。その理由の一つは、スケーリングのリターンがきわめて不確かな一方で、コストは莫大だからである。たとえばxAIのColossusクラスターの第2期だけでも、すでに100億ドル近いハードウェア取得費がかかった。計算資源を1,000倍に拡大すれば、おそらくコストは少なくとも1,000倍になり、2 リターンを少しでも過大に見積もれば、きわめて高くつく。ハードウェアの取得費が数千億ドル、さらには数兆ドルに近づき、世界総生産の数パーセントに迫るにつれて、この懸念はますます重みを増す。
これは単なる仮定の話ではない。わかりやすい例が、2024年初めにSam AltmanがAIインフラのために7兆ドルを調達しようとした件で、これは投資家やチップメーカーから不信の目を向けられた。歴史的に見ても、これほど前例のない規模の投資は、少なくとも投資家やアナリストの懐疑に迎えられてきた。3
投資家は、巨額の投資に踏み切るより、中間的なやり方を好む可能性が高い。拡大をいくつかの小さな段階に分け、そのたびにリターンを観察するのである。1,000倍の拡大を一気に行うのではなく、計算資源への投資を10倍ずつ増やし、各段階を続けるかどうかの判断の節目にすることもできる。1,000倍に拡大してから、すべてが無駄だったと判明するよりは、はるかに安上がりだ!4
リードタイムが延び、投資(ひいては計算資源のスケーリング)が減速する
ただし、段階的な拡大はスケーリングが減速しうる理由の一部にすぎない。もう一つの要因がリードタイム、つまり新しいAIモデルを作るプロジェクトが計画されてから、そのモデルが実際に展開されるまでの時間である。5
かつては、最先端のAIモデルを開発するのに、少量の計算資源を借りるだけで済んだ。しかし2020年代に入ると、AI企業は数万基のGPUを購入する必要に迫られた。これには長い交渉と納期がともなう。さらに拡大するには、新たな大規模データセンターを建設し、チップの製造能力を増強しなければならない。いずれも実行に数年かかるプロジェクトである。
リードタイムの長期化がどれほど事態を遅らせうるかを見極めるには、具体的な制約と、それぞれにともなうリードタイムを見る必要がある。下の表にそれをまとめ、以下で制約を一つずつ分析する。
| 主な制約 | 研究所の計算資源への投資額(実質米ドル) | 推定リードタイム(年) |
|---|---|---|
| GPUを借りる | 3,000万ドル未満 | ~0 |
| GPUを購入する | 3,000万〜10億ドル | ~0.5 |
| データセンターを建設する | 30億ドル | 1-2 |
| 超大規模データセンター/発電所を建設する | 100億〜300億ドル | 2-3 |
| ファブを大幅に増強する | 300億ドル | 2 |
| 最先端のファブを一から新設する | 3,000億ドル | 4-5 |
表1:計算資源への投資の水準が上がると、新たな大きな制約が生じ、それぞれにリードタイムがともなう(ファブを一から新設する場合など)。
GPUを借りる:約0年。2010年以降、リードタイムはおおむね無視できるほど短く、たいていは1年を大きく下回ってきた。その理由の一つは、実験を行ったり最先端に近いモデルを学習させたりするには、おおむねクラウドの計算資源で足りていたことである。クラウドの計算資源の事業者は、利用者に数百から千数百基のGPUを数週間から数か月にわたって使わせることが多く、6 その費用は最大で数千万ドルにのぼり、1024 FLOP程度の学習が可能になる。これはDeepSeek-V3の学習と同じ桁である。7 しかも、こうした計算資源はたいていすぐに利用できる。たとえばGoogle Cloudでは、遅くとも6時間〜3日前に予約できる。別の例として、SFComputeは計算資源を利用するためのスポット市場を構築している。
GPUを購入する:約0.5年。GPUが数万基の規模になると、大手のAI研究所は計算資源を自前で購入してしまうことが多くなり、その投資額は3,000万〜10億ドルに及ぶことが多い。たとえばxAIは、Grok 3の学習でOracle Cloudとの協業を試みたものの、モデルの学習と展開を早めるため、最終的には計算資源を自社で取得する道を選んだ。8 こうした購入にはふつう数十週間、ごく大まかに言えば半年ほどかかる。たとえばMetaのAI Research SuperClusterでは、A100 GPUを1万基増設するのに6か月のリードタイムを要した。またアナリストは、NVIDIA H100のリードタイムが数十週間程度だと報告している。
データセンターを建設する:1〜2年。GPUを数十万基の規模に拡大するには(これは現在の最大級のAIスーパーコンピュータのいくつかに相当する規模である)、多くの場合、新たなデータセンターと数十億ドルが必要になる。たとえばGrok 3の学習には、まず10万基を超えるH100を備えたxAIのColossusクラスターを構築する必要があった。Colossusは122日という驚異的な短期間で完成したが、より一般的なリードタイムは1〜2年程度である。
超大規模データセンターを建設する:1〜3年。私たちの知るかぎり、Colossusはこれまでで最大のAIスーパーコンピュータであり、稼働には約300 MWの電力を要する。これをさらに10倍に拡大すると、超大規模データセンターの規模に達する。100万基を超えるGPUを擁し、稼働に1 GW超を要する可能性がある規模である。こうした施設の建設は、ふつう数年がかりの事業になる。たとえばMetaの1.5 GW超のHyperionクラスターは2029年後半か2030年の完成が見込まれており、リードタイムは4〜5年になる。Crusoeは、アビリーンのキャンパスを、建設開始から2年後の2026年までに1.2 GWへ拡張することを目指している。本当に大きなデータセンターは複数の建物を段階的に建てるので、一部を並行して進めればリードタイムを短縮できる可能性がある。そのため、私たちの推定は下限寄りにしている。9
ファブを大幅に増強する:約2年。この規模の計算資源への投資を支えるには、大量のチップを製造する必要もある。その方法の一つは、既存の製造工場(「ファブ」)に最新の半導体製造装置を入れ、生産能力を大幅に増強することである。10 この装置は主にASML製で、納入までのリードタイムは12〜18か月程度である。設置と、高い歩留まりに達するまでの立ち上げの期間を加えると、リードタイムは合計で約2年になると私たちは見ている。
超大規模な発電所を建設する:2〜3年。この規模(数百億ドル)の計算資源への投資では、考慮すべき制約がほかにも加わる。たとえば、データセンターを支える大規模な発電所を建設しなければならない。歴史的に見ると、米国の最大級の発電所(100〜1000 MW級)は建設に2〜6年かかってきた。ここでも推定を下限寄りにしているのは、AIの大きな需要が、これまで発電所の建設を遅らせてきたボトルネックの一部を乗り越えるかもしれないからである。
最先端のファブを新設する:4〜5年。計算資源の需要が3,000億ドル規模の投資を要するほどに高まれば(数千万から数億基のGPUが必要になるかもしれない)、既存のファブの転用ではもはや足りず、新しいファブが必要になるだろう。11 比較のために言えば、TSMCが2024年に製造したH100は100万〜200万基で、こうした需要を1〜2桁下回る。しかし新しいファブの建設には、ふつうかなりのリードタイムがかかる。たとえばTSMCのアリゾナ工場の建設リードタイムは約3年と見込まれ、2010〜2020年の米国のファブ全般でも建設リードタイムは約2.5年だった。ただしこれには、許認可や着工前の準備にかかるリードタイムが含まれておらず、これらが数年上乗せされる可能性もある。12 たとえば、2010〜2018年のNEPA(国家環境政策法)の審査手続きには、平均で約4.5年かかった。もっとも、現在の政治情勢を考えると、これはさほど大きなボトルネックにはならないと私たちは見ている。全体として、建設とその他の要因の両方を含め、リードタイムは合計4〜5年と推定する。
以上をまとめると、計算資源が10倍増えるごとに、リードタイムはおよそ1年ずつ延びる。その結果、投資家が経済的リターンについて意味のあるシグナルを得るまでの時間が延び、計算資源のスケーリングのペースが落ちる。
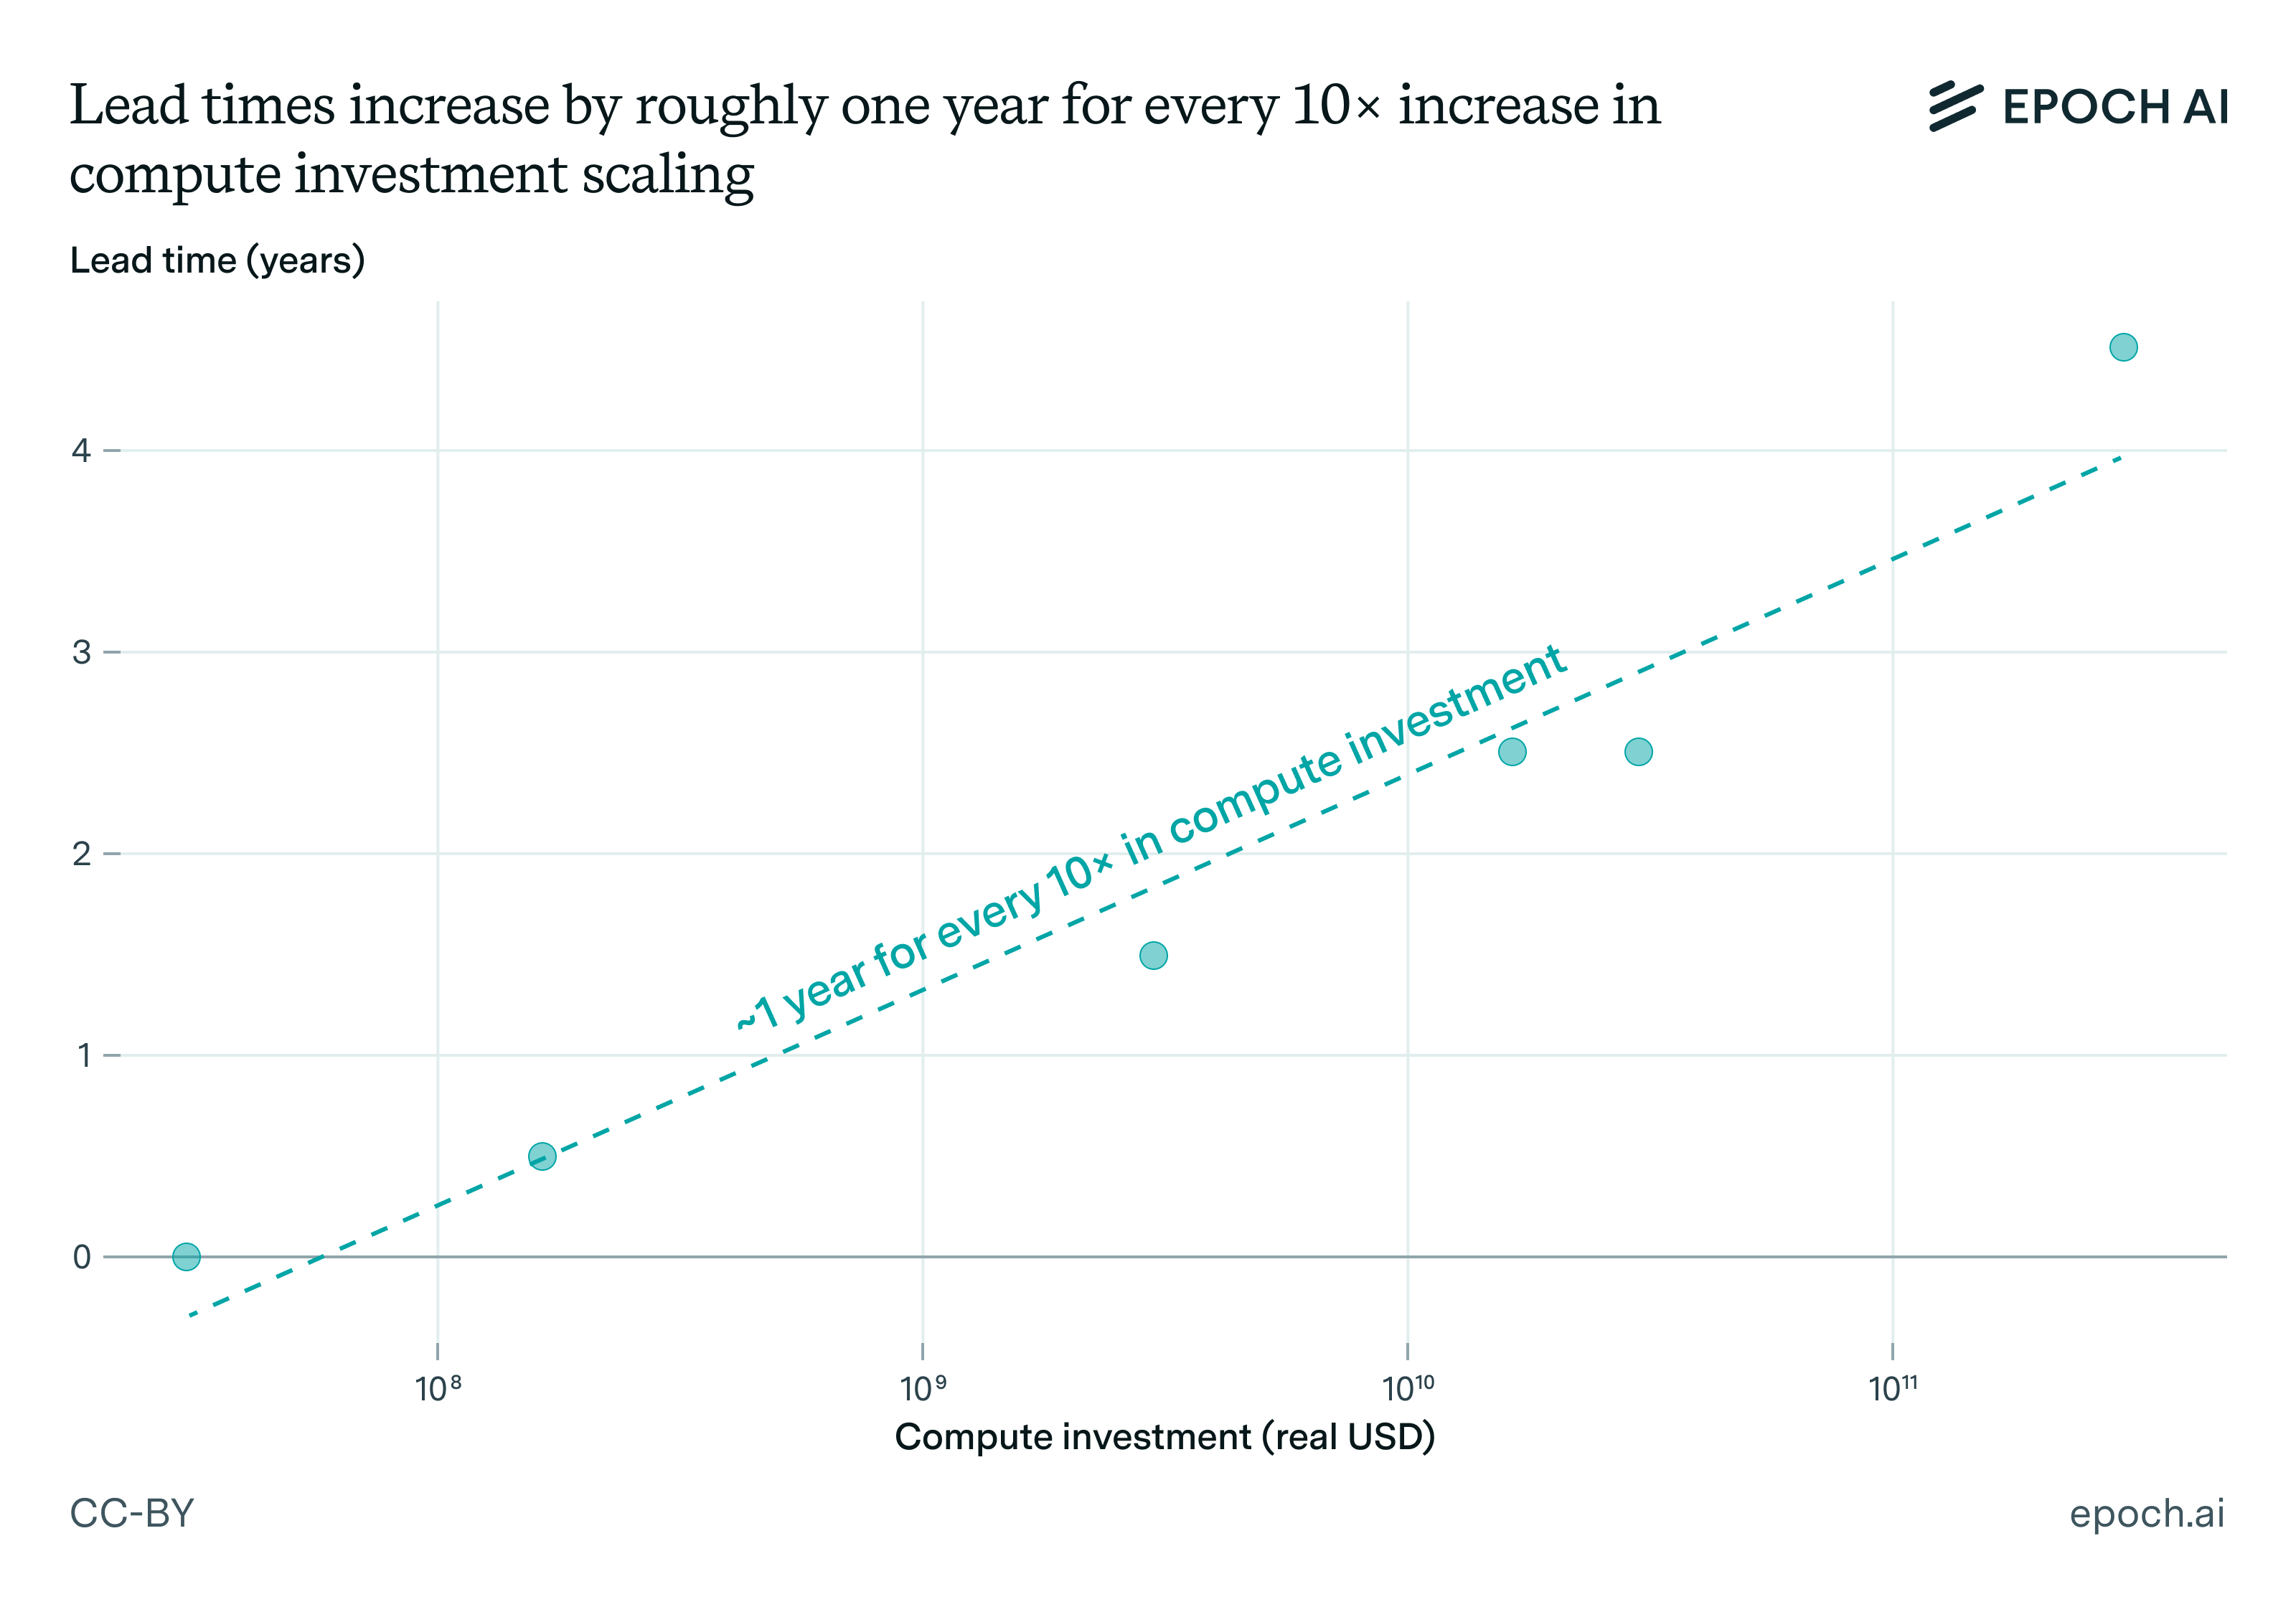
計算資源への投資の水準ごとに推定したリードタイムのグラフ。データは表1に示した。ある主な制約について投資額に幅がある場合は、その幾何平均をとった。
今後数年のAIの進歩にとって何を意味するか
計算資源のスケーリングがAIの進歩にとってどれほど重要だったかを考えれば、その減速はおそらく大きな出来事になる。実験の数が減る(あるいは小規模な実験しかできなくなる)ため、新しいアルゴリズムの革新を見つけにくくなる。また、ここ数年のAIの能力向上の中心にあった学習計算量のスケーリングのトレンドからも外れることになる。13 しかも、私たちが特定のボトルネックを見落としていれば、減速は予測よりさらに大きくなるかもしれない。14
一方で、この力学が予測ほどには効いてこない理由もある。私たちの議論は、投資家が経済的リターンを見極めるには展開を待たなければならないと仮定しているが、これには反論の余地がある。将来のベンチマークが現実世界での経済的影響をよりよく反映するようになったり、経済的な生産性に関するスケーリング則がより整備されたりするかもしれない。
懐疑的になりうるもう一つの理由は、リードタイムを短縮できることである。たとえばColossusデータセンターは、わずか122日で建設された。この規模のプロジェクトでふつう2年かかることを思えば、はるかに速い。十分な政治的意思があれば、「AIマンハッタン計画」のような形で巨額の資金を先行して投じ、期間をさらに縮められるかもしれない。投資のリードタイムの一部を回避できる可能性もある。たとえば許認可の手続きは、資金調達の前に始めておける。こうした方法がどれほど効くかは、リードタイムと投資額のトレードオフに大きく左右されるが、これについての証拠は今のところほとんどない。
自動化が大きく進んだ世界では、リードタイムはさらに縮むかもしれない。ロボット工学の普及が建設を加速させたり、AIシステムがプロジェクトの設計を最適化したりする可能性がある。とはいえ、こうした力学はどうしてもきわめて推測的なものになる。
全体として私たちは、減速を防げるほどにはリードタイムを縮められないと予想している。効果の大きさは、ここで述べたより小さいかもしれない。たとえば、計算資源が10倍になるごとにリードタイムが延びるのは8か月ではなく4か月にすぎない、ということも十分ありうる。それでも、方向性としては、ここで説明した力学がひどく過小評価されていると私たちは確信している。そして今後数年でリードタイムはますます長くなり、計算資源のスケーリングに大きな影響を及ぼす、というのが私たちの最善の見立てである。
Yafah Edelmanは、Epoch AIに加わる前にこのテーマの予備的な研究を支援してくれたLong-Term Future Fundに感謝する。
注
-
たとえば、OpenAIの計算資源への支出は、2024年半ばの約60億ドルに対し、2025年半ばにはおよそ130億ドルだった。ここから、増加率は約2.2倍となる。 ↩
-
ハードウェアの調整コストのような要因によって、取得費の総額は、コストを単純に1,000倍した素朴な予想よりもさらに高くなる可能性がある。 ↩
-
たとえば、Brett Simpsonが「TSMCからあのようなロードマップが出てきたのは見たことがない」と述べた場面のやりとりを参照。 ↩
-
1,000倍への拡大をすぐに行わない理由は、ほかにも考えられる。たとえば、段階的なスケーリングは、アルゴリズムの観点(計算効率など)からもかなり重要かもしれない。はるかに大きな学習実行に乗り出したり、そのアルゴリズムのためにはるかに大きな計算インフラを構築したりする前に、計算資源を増やしたときにそのアルゴリズムがどれほどうまくスケールするかを知っておくのは有益である。 ↩
-
「リードタイム」をもっと厳密に定義するのは難しい。たとえばファブの歩留まりまでの期間については、ファブの建設に投資することを投資家が信頼できる形で示せた時点から数え始める。だが、これはかなりあいまいである。数え終わりは、文字どおりチップの生産が始まった時点(歩留まりはひどいかもしれない)からフル稼働での生産に至る時点までのどこかであり、これもあいまいさを増す。とはいえ、「歩留まりまでの期間」をどう操作的に定義しても、計算資源への投資が大きくなるほど期間が大幅に長くなることに変わりはないので、私たちの中心的な主張は揺らがない。 ↩
-
これはCrusoe、Amazon Web Services、Google Cloudといった一般的なクラウド計算資源の事業者に当てはまる。たとえばAmazon Web Servicesでは、最初に512基のGPUを最長2週間予約でき(後から延長も可能)、Google Cloudでは最大1024基のTPUを予約できる。 ↩
-
例を挙げると、H100を100基(1015 FLOP/s)使い、利用率30%で2か月間学習させると、およそ1023 FLOPになる。代わりにH100を1,000基使えば、およそ1024 FLOPに達する。 ↩
-
別の例として、Llama 3はMetaが所有する約2万基のGPUで学習された。ただし、もっともらしい反例もある。たとえばGPT-4は、A100を2万5,000基備えたMicrosoft Azureのクラスターで学習された。 ↩
-
とはいえ、それほど並行化できない理由もある。たとえば、後の建物のリスクを減らすために先に建てる建物を建設することがあり、その場合は逐次的なボトルネックが生じる。 ↩
-
これは、スリーマイル島原発をAIデータセンターへの電力供給のために再稼働させるように、すでに停止した、あるいは本来なら停止するはずだった発電所を使うことにいくらか似ている。 ↩
-
さらに、TSMCが製造するチップは複数のAI研究所で分け合う必要があるかもしれず、TSMCの製造への負担はいっそう増す。 ↩
-
もう一つ重要な力学として、ファブの歩留まりはふつう時間とともに向上する。 ↩
-
加えて、GATEのようなモデルが予測する経済的影響も控えめになる。こうしたモデルは、この記事で詳しく述べたような逐次的な時間のボトルネックを、あまり明示的にはモデル化していないからである。 ↩
-
たとえば、大規模なAIチップの増産を支えるのに十分な数の労働者を育成することにともなうリードタイムは考慮していない。 ↩