
論文
アルゴリズムの進歩を再検討する
原題:Revisiting algorithmic progress
概要
機械学習の進歩のうち、どれだけがアルゴリズムの進歩、計算量の拡大、関連するデータセットの拡大によるものなのかは、あまりよくわかっていない。私たちの論文では、コンピュータビジョンの試験台としておそらく最もよく知られているImageNetでの画像分類について、アルゴリズムの進歩を調べることで、この問いを前進させた。
100個のコンピュータビジョンのモデルからなるデータセットを用いて、ニューラルネットワークのスケーリング則に基づくモデルを推定し、アルゴリズムの進歩の速さと性質を分析できるようにした。シャープレイ値を使って、コンピュータビジョンの進歩のさまざまな原動力を分解し、アルゴリズム、計算量、データの相対的な重要性を推定した。
主な結果は次のとおりである。
- より優れたアルゴリズムの導入は、9か月ごとに計算予算を倍増させるのに相当する寄与をしている。これはムーアの法則による向上よりはるかに速い。ただし、不確実性はある(95%信頼区間は4〜25か月)。
- おおまかに言えば、画像分類の進歩のうち約45%は計算量の拡大、約45%はより優れたアルゴリズム、約10%はデータの拡大によるものである。
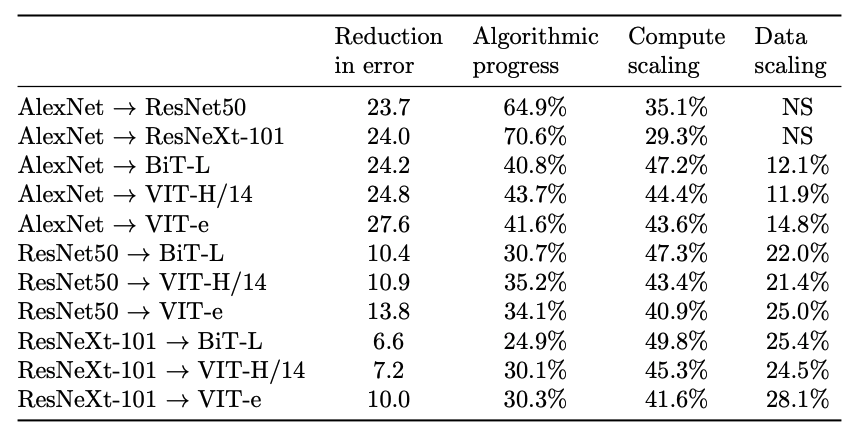
シャープレイ値による分解に基づいて、モデルの組の間の進歩を、アルゴリズムの進歩、計算量の拡大、データの拡大に割り振ったもの。「NS」は、それらのモデルの間で該当する投入物が拡大されなかったことを示す。四捨五入のため、合計が100にならない場合がある。
- アルゴリズムの進歩の大部分(75%超)は計算量を補う(つまり研究者が計算資源をより効果的に使えるようにする)ものであり、データを補うものは少数である。
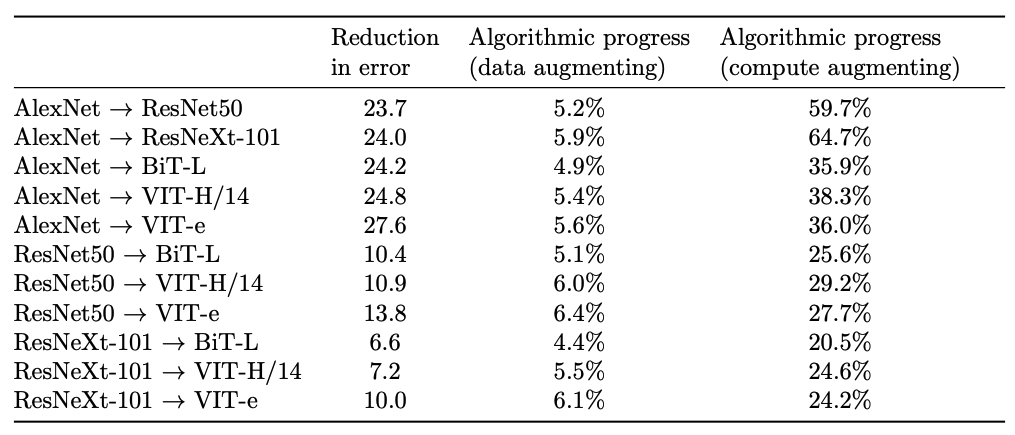
アルゴリズムの進歩のうち、計算量を補うものとデータを補うものの割合。
本研究では、以前にHernandez and Brown (2020)が調べ、LessWrongでGwernやRohin Shahが論じた問いを再検討する。Hernandez and Brown (2020)は、人気のあるオープンソースのモデル15個を実装し直し、AlexNetと同じ性能に達するのに必要な計算量が44分の1に減ったことを見いだした。これは、アルゴリズムの進歩が、ハードウェア効率の向上についての元来のムーアの法則のペースを上回り、実効計算量を16か月ごとに倍増させていることを示している。
この手法の問題は、どのベンチマークとしきい値の組を選ぶかに結果が大きく左右されることである。達成しやすいしきい値を選ぶと、アルゴリズムの改善はそれほど重要でないように見える。計算量を拡大すれば、初期のモデルでも簡単にそのしきい値に届くからである。逆に、達成しにくいしきい値を選ぶと、性能向上のほぼすべてをアルゴリズムの改善で説明することになる。初期のモデルが今日の最高水準のモデルの性能に達するには、際限なく多くの計算量が必要になりうるからである。私たちは、この手法によるアルゴリズムの進歩の速さの推定値が、易しいしきい値と難しいしきい値のどちらを選ぶかによって10倍ほど変わりうることを示す。1
本研究は、アルゴリズムによる効率化がどのように起きるのかについて新たな知見を与える。すなわち、効率化は主にデータのボトルネックではなく計算量のボトルネックを緩めることで働く。さらに、(実験データではなく)観察データを使って機械学習のアルゴリズムの進歩への理解を深める方法についても、手がかりを与える。
注
-
とはいえ、95%信頼区間は4〜25か月にわたるため、私たちの推定値は、アルゴリズムの進歩が実効計算量を16か月ごとに倍増させるというHernandez and Brown (2020)の推定値と矛盾しない。 ↩