
ニュースレター
予測者たちは2025年のAIの進歩をどれだけうまく予測したか?
原題:How well did forecasters predict 2025 AI progress?
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
この記事は、AI Futures Project、AI Digest、Epoch AIの共同で執筆した。AI Digestの2025年の調査の結果を分析したものである。2026年のAI予測調査にはこちらから参加できる。
私が読むAIの論文は、二本に一本くらいの割合で「AIの進歩は速い」という趣旨の一文から始まっている気がする。確かに、それは明らかに正しい。1年前にはGPT-5もDeepSeek-R1もなく、Claude 3.7 Sonnetすらなかったのだ! だが、進歩が正確にはどれほど速かったのか、そして人々がそれを予見していたのかを言う人は、あまりいないようだ。だから、AI Digestが過去1年のAIの進歩を予測してもらう調査を公開したとき、私はわくわくした。
この調査は、「AI 2027的な世界観」とでも呼べるものを追跡するのに役立つ。AIの研究開発(R&D)の自動化がAIの能力の急伸をもたらし、ひいては人類にさまざまなリスク、特にAIシステムに権力を明け渡すことによるリスクをもたらす、という世界観である。これは設問のテーマに表れている。調査の約半分は、AIの研究開発に関連するベンチマークでの性能の予測である。残りの半分は現実世界への影響を扱う。AIを使ったサイバー攻撃、人間によるAIの制御の喪失、そして収益や世論といったもっと「地味な」事柄である。この世界観が部分的にでも正しいなら(そして私は、その水準は満たしていると思う)、これらの設問は、AIの未来についての最も重大なテーマのいくつかを捉えている。
では、予測者たちはこれらの設問でどれだけうまくやったのだろうか?
Epoch AI の最新情報を受け取る 購読する
回答者の属性:若手、やや短いタイムライン、AIによる破局のリスクを高く見積もる
この問いに答えるには、まず予測者たちがどんな人々だったのかを知る必要がある。回答者は主に、AI DigestのXでの呼びかけと月刊ニュースレターで集まった。総勢421人で、中には本格的な予測の実績を持つ人もいた。たとえば、常に上位に入る予測者のPeter Wildeford(今回は14位)や、AI予測の研究者のAjeya Cotra(今回は3位)がいる。
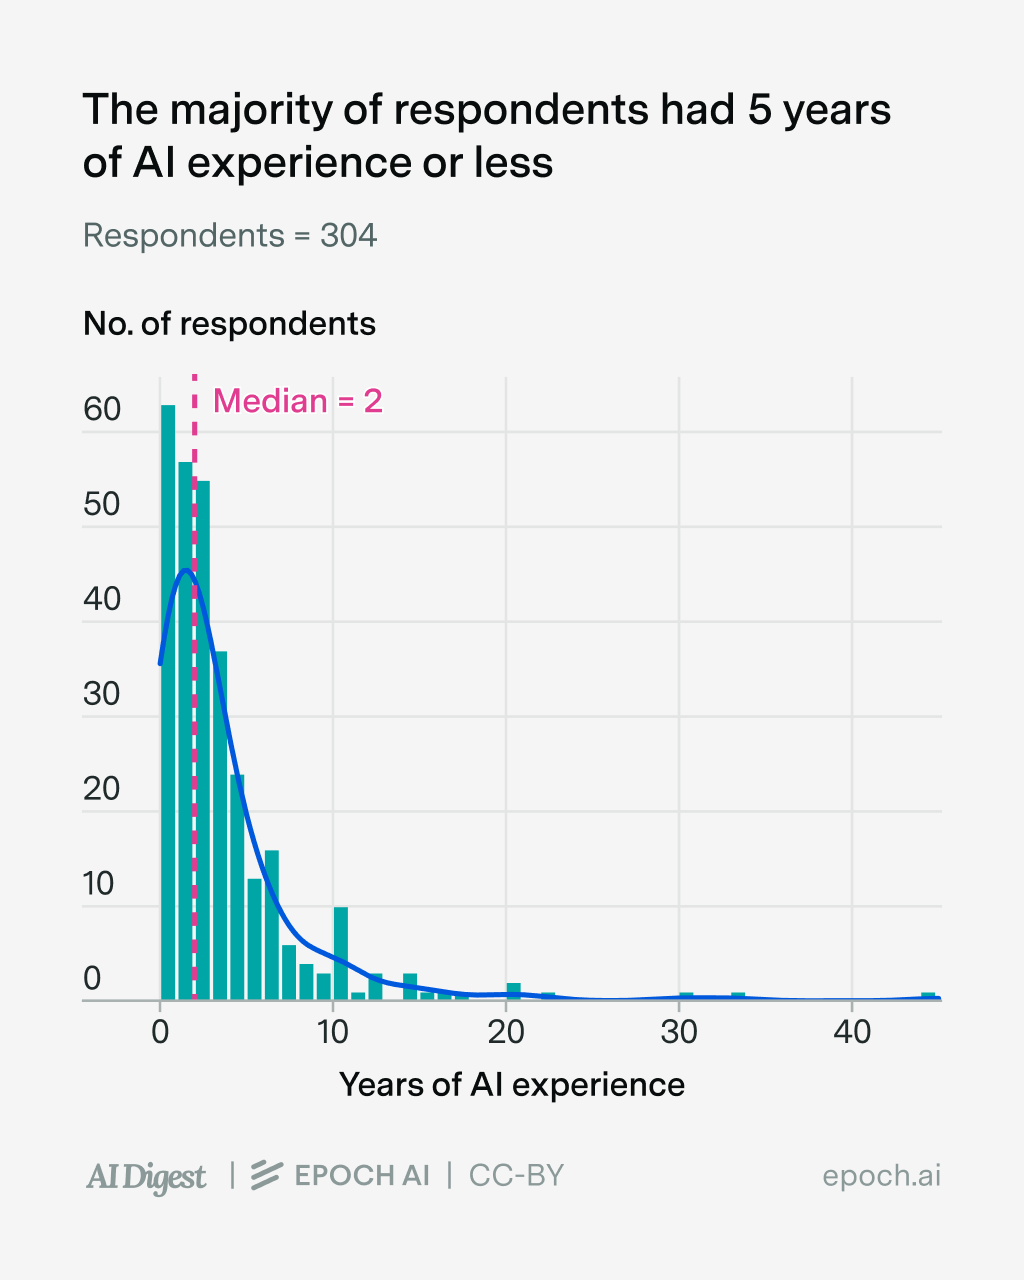
予測者についてまず押さえておきたいのは、かなり若手が多かったことだ。73%がAIについて何らかの職業上または学術上の経験があると答え、そのうち80%は経験が5年以下だと答えた。
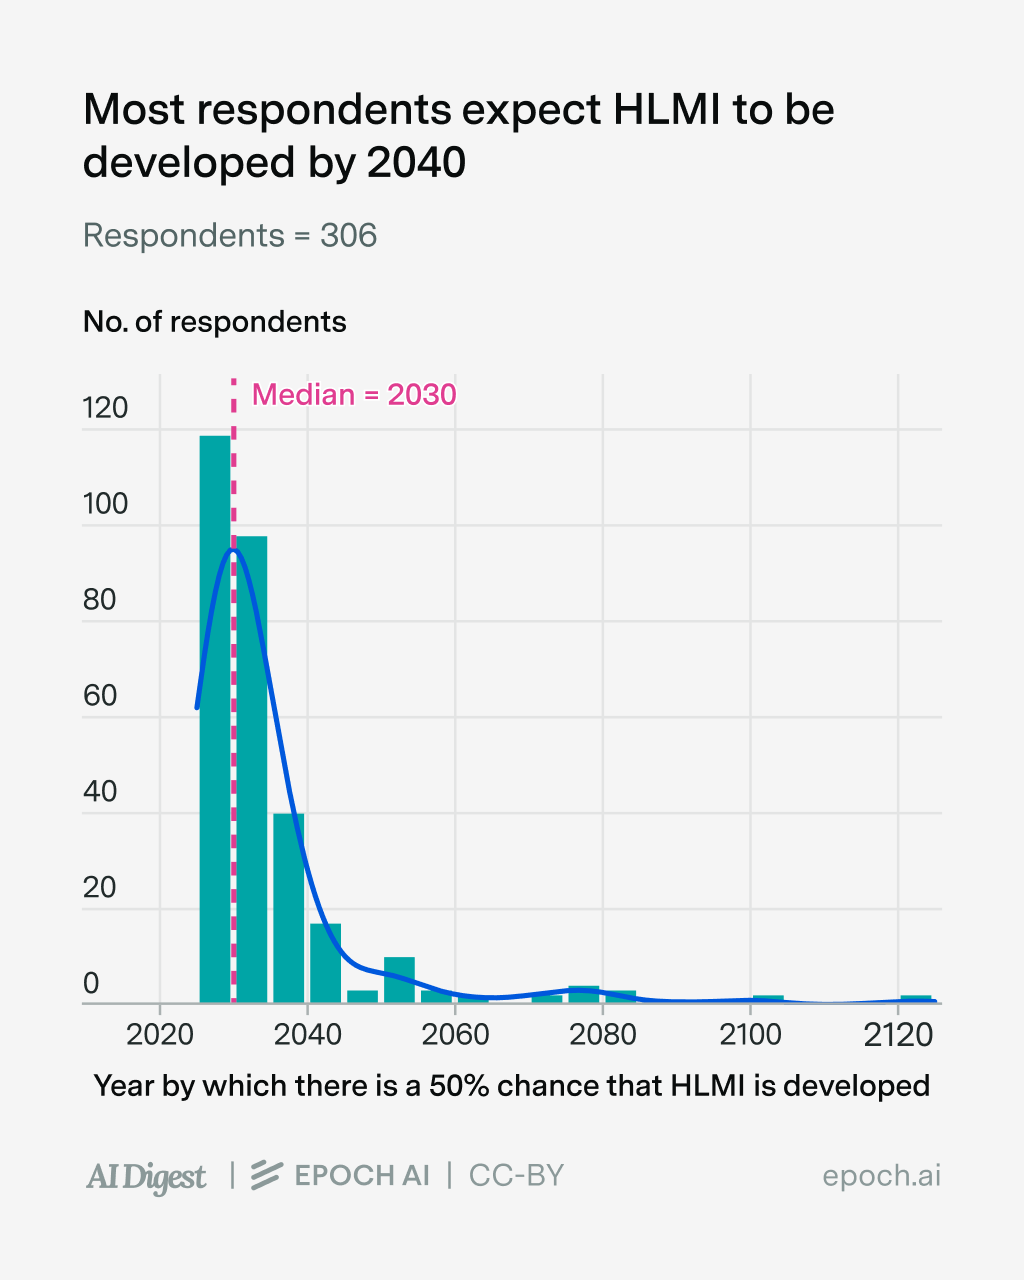
次に、彼らは「高水準機械知能(HLMI)」の到来時期の予想(タイムライン)をかなり早く見ていた。HLMIとは「人間の助けなしに、あらゆるタスクを人間の労働者よりもうまく安く実行できる機械」のことで、ロボット工学も含むようである。半数はHLMIが2030年までに開発されると予想し、90%は2040年までと予想していた。
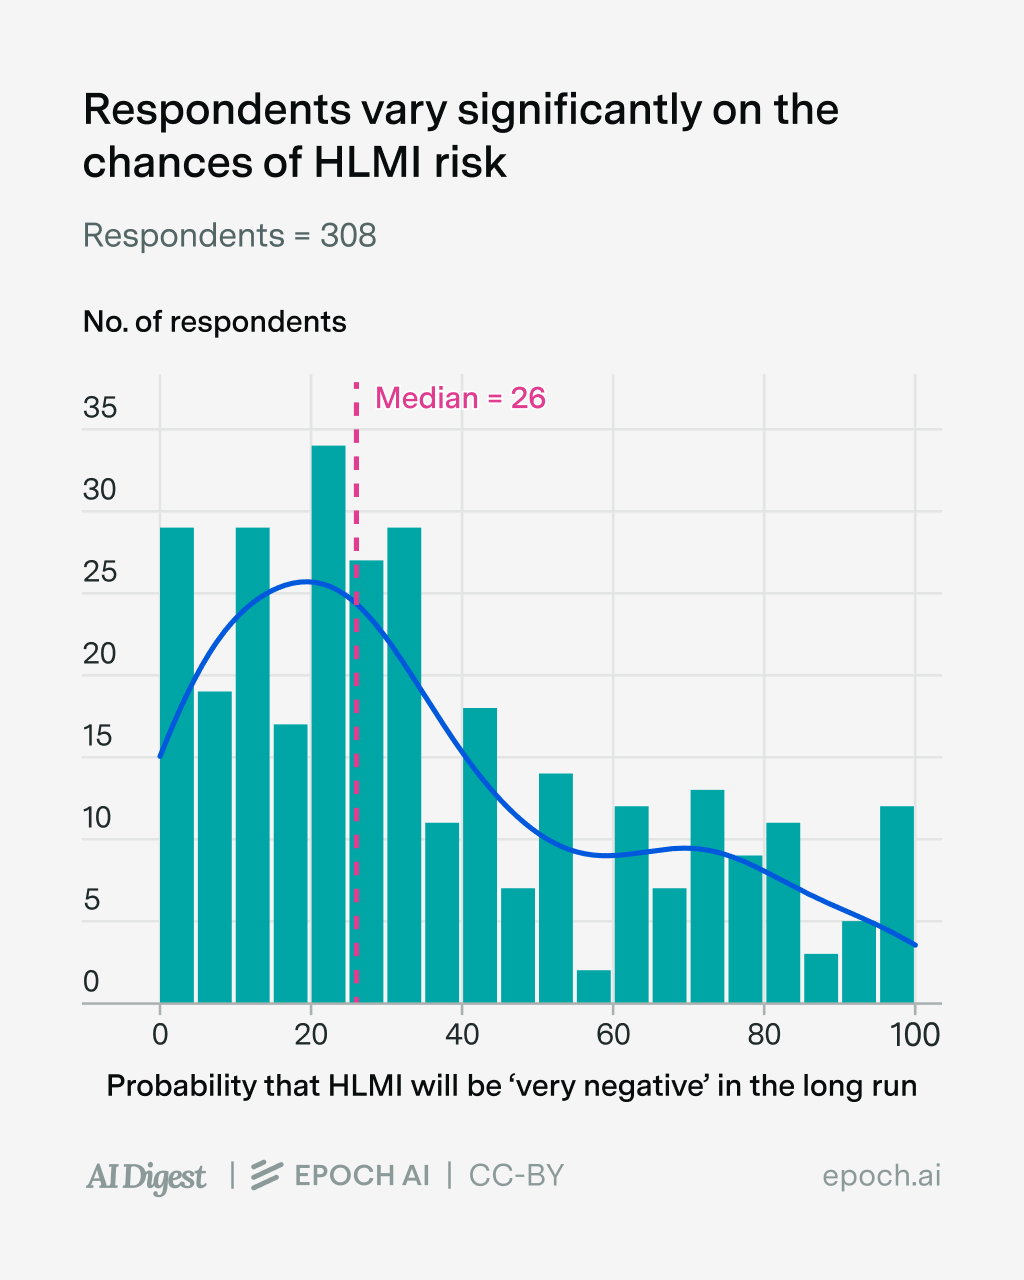
三つ目に、回答者はかなり「悲観的」だった。4分の3が、HLMIが人類の絶滅のような「きわめて悪い」結果につながる確率を10%超と答えた。
ごく単純化すれば、これらの予測者は「2040年までにHLMIが来ると予想し、それが恐ろしい結果を招くかもしれないと考える、若手のAI専門家」とみなせる。AI安全性のコミュニティではかなりよくある人物像だ。そしてこれが何を意味するかは考えてみる価値がある。今後15年ほどのAIの進歩とその影響について彼らが正しければ、産業革命ですら歴史書の脚注のように見えるかもしれない。
そこで肝心の問いだ。彼らは過去1年のAIの進歩について正しかったのだろうか?
AIの研究開発に関連するベンチマーク:予測の中央値は(ほぼ)的中した
調査の前半では、参加者に五つのベンチマークでの性能を予測してもらった。どれもAIの研究開発に関連するものである。結果は次のとおりだ。
| テーマ | 予測時点のスコア | 予測の中央値 | 結果 |
|---|---|---|---|
| RE-Bench 自由形式の機械学習の課題 | 0.60(o3公開後は0.61) | 1.1 | 1.13 |
| SWE-Bench Verified Pythonの実際のGitHub issueの解決 | 55.0%(o3公開後は71.7%) | 88% | 80.9% |
| Cybench プロ向けのサイバーセキュリティ競技の課題 | 35% | 62% | 82% |
| OSWorld 簡単なコンピュータ操作のタスク | 24.5% | 60% | 72.6% |
| FrontierMath 答えを自動で検証できる、きわめて難しい数学の問題 | 2.0%(o3公開後は24%) | 40% | 40.7% |
注:結果の判定理由は、元の調査のリンクで見られる。[追記:この記事の執筆後、OSWorldの性能は66.3%から72.6%に更新された。]
おおむね、予測の中央値はかなり良く見える。RE-BenchとFrontierMathでは基本的に正しく、OSWorldとSWE-Bench Verifiedでもかなり近かった。唯一の例外はCybenchのようで、予測の中央値は進歩を20ポイント過小評価した。
では、Cybenchでは何がまずかったのか? 予測の根拠を書いてくれた数十人の回答者を見ると、主な理由は二つあると私は推測する。一つ目は、既存のベンチマークの傾向を外挿せず、このベンチマークはかなり難しいだろうという見込みを漠然と示すにとどまったことだ(ただ、それがどう定量的な予測に結びつくのかは、私にはあまりはっきりしない)。二つ目は、ラボがCybenchでの改善を報告するのをどれだけためらうかを過大評価したことだ。多くの回答者は、サイバーセキュリティのベンチマークで高いスコアを出せば強力なサイバー攻撃能力があることを示し、ラボがより厳しい監視を受けることになるので、ラボには報告しない動機がある、と考えていた。
予測者の外れ方はそれほど大きくなかったものの、もう一つ興味深い例がSWE-Bench Verifiedである。Cybenchとは違って、予測者は進歩をいくらか過大評価した。予測の中央値は88%だったが、最終的な結果は81%だった。では、なぜ予測者は行き過ぎたのか? SWE-Benchのコーディング課題は推論モデルに特に向いている、と論じた人もいた。多くのラボがこのベンチマークで好成績を出すことに特化してモデルを最適化しているので進歩は速いだろう、と論じた人もいた。Anthropicは新しいモデルの発表で、しばしばこれを最初に挙げるベンチマークにしているし、これでスコアを上げ続けることを仕事にしている人までいる。最後に、当初の最高水準が72%だったことを指摘し、スコアが「S字曲線の急な部分」を上り始めると、ベンチマークは通常すぐに飽和することを根拠にした人もいた。こうして、このベンチマークの飽和点である90%前後に近い予測が出た。
大まかに言って、これらの議論はどれも正しいと私は思う。だから、SWE-Bench Verifiedのスコアが結局90%近くまで行かなかった理由は、私にはちょっとした謎である。欠陥のある設問がスコアを80%で頭打ちにしたとは思えない。別の分析では、誤りの率はおそらく5〜10%だと示唆されているからだ。さらに、Epochではこのベンチマークでさまざまなモデルを走らせてきたが、どれか一つでもモデルが解いたことのある問題の割合を見ると87%になる。だから、モデルがまだ一部の問題で力不足なだけかもしれないし、単なる偶然でさえあるかもしれない。いずれにせよ、予測者全体としては、行き過ぎたことから見方を大きく修正する必要はないと思う。
これは、個々の予測者が見方を修正すべきでないという意味ではない。結局のところ、予測者全員が同じ信念を持っているわけではないのだから! たとえば、HLMIが2030年より前に開発されると予想した人々は、2030年より後と予想した人々よりも、ベンチマークについて強気の予測をする傾向があった。FrontierMathでのその例を示す。
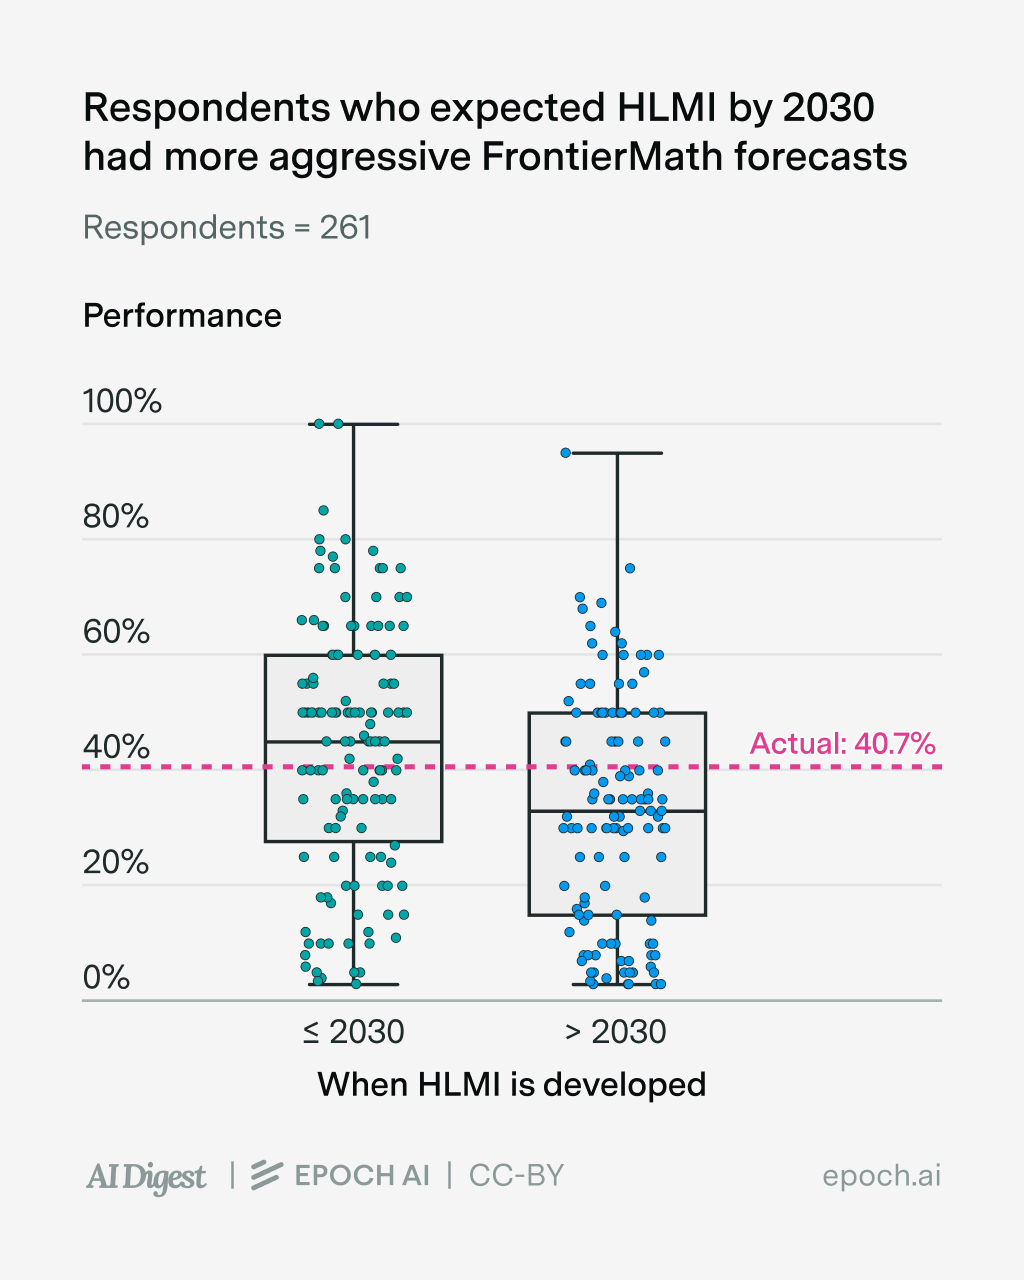
「タイムラインが長い人がベンチマークの改善を遅く見込むのは当然だろう、常識ではないか?」と思うかもしれない。実は私はそうは思わない。ベンチマークの改善が遅いと予想するからではなく、ベンチマークはHLMIへの進歩の代理指標としてあまり意味がないと考えるから、タイムラインが長いということもありうる。たとえば、これは(AI 2027の共著者である)Eli Liflandと、Mechanizeの共同創業者Ege Erdilのタイムラインの決定的な違いである。ErdilはAIのタイムラインは数十年単位だと公に論じてきた。
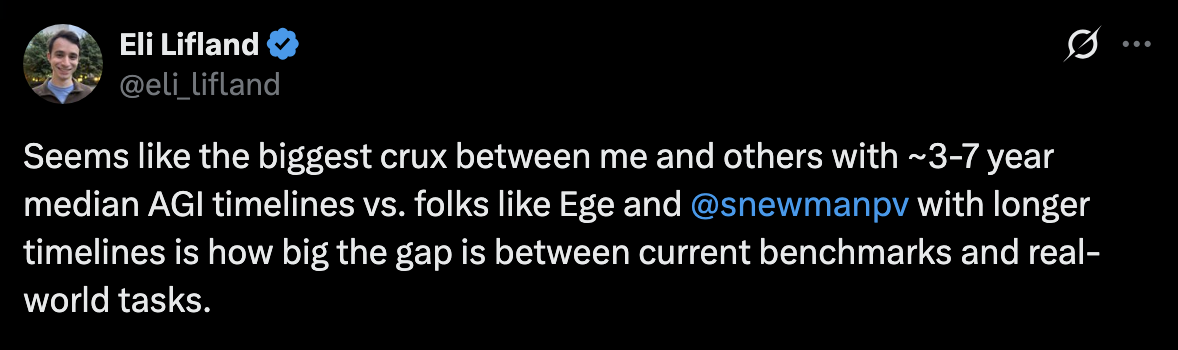
(出典)このツイートを書いた時点で、EliのAGIタイムラインの中央値は2031年前後だった点に注意。回答者の「2030年までにHLMI」グループには入らないものの、これでもタイムラインは短いほうに数えられる。
実際、この調査の場合、タイムラインが2030年以前の人々の成績は、2030年より後の人々とかなり似ていた(タイムラインが長い人々のほうがほんの少し良かったが、統計的に有意ではない)。1
OpenAIの準備態勢スコア:リスクについては当たり外れがあった
調査の後半は、AIの研究開発以外の、より広い社会的影響へと次第に向かう。先ほどほのめかしたように、そうした影響は、ベンチマークの大幅な改善から生じるかもしれないし、生じないかもしれない。その最初の部分では、AIによって生じうるリスクを扱った。結果は次のとおりである。
| OpenAIの準備態勢スコア:リスク領域 | 予測時点のリスク水準 | 予測の中央値(「はい」と判定される確率) | 結果 |
|---|---|---|---|
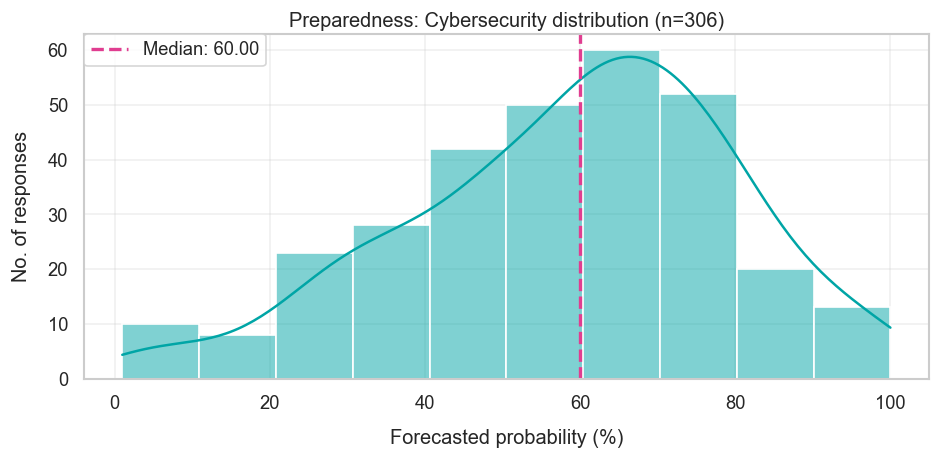
| サイバーセキュリティ リスク水準は「低」から「中」に上がるか? | 低 | 60% | はい |
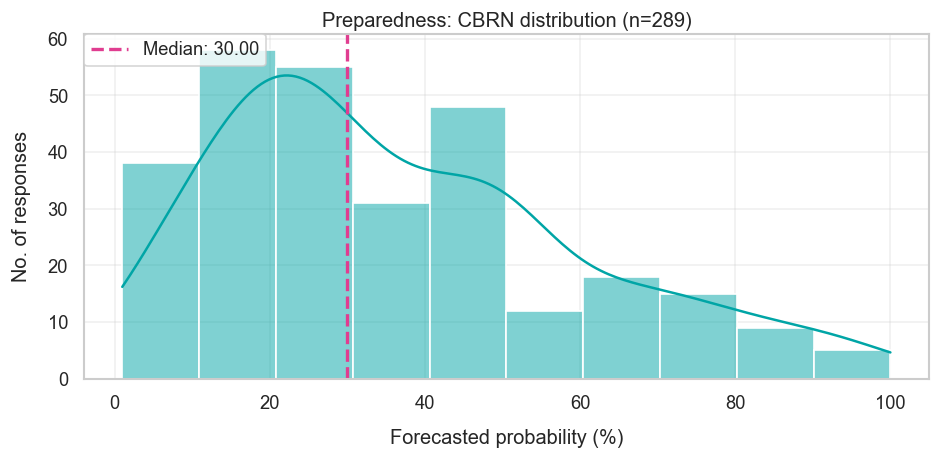
| 化学・生物・放射性物質・核のリスク リスク水準は「中」から「高」に上がるか? | 中 | 30% | はい |
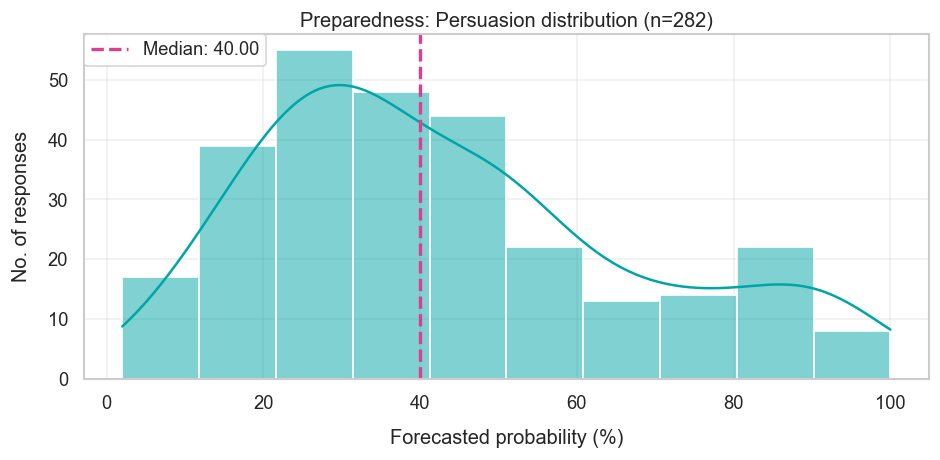
| 説得 リスク水準は「中」から「高」に上がるか? | 中 | 40% | 該当なし(区分が削除された) |
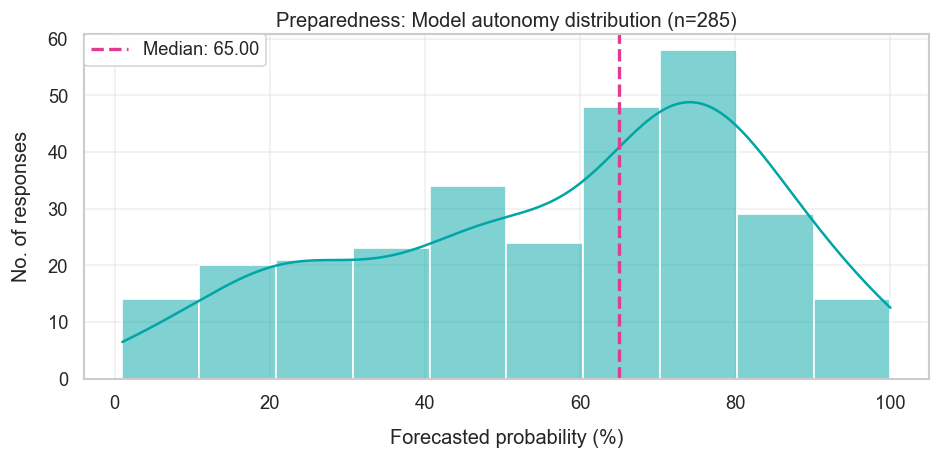
| モデルの自律性 リスク水準は「低」から「中」に上がるか? | 低 | 65% | はい |
注:結果の判定理由は、元の調査のリンクで見られる。
この調査は、OpenAIの2023年の準備態勢フレームワーク(Preparedness Framework)を使って、生じうるリスクを捉えた。このフレームワークは、同社が「ますます強力になるモデルがもたらす破局的なリスクを、どのように追跡、評価、予測し、それから身を守るか」を述べたものである。リスクは四つの領域に分かれる。化学・生物・放射性物質・核(CBRN)のリスクのほか、サイバーセキュリティ、人間の説得、モデルの自律性(モデルが人間の運用者に停止させられるのを回避したり、自己改良したりできるようになること)である。各リスク領域には「低」「中」「高」「重大」の四つのリスク水準があり、調査では四つのリスク領域それぞれでリスク水準が上がる可能性がどれだけあるかを尋ねた。
上の表を見ると、予測の中央値は、サイバーセキュリティとモデルの自律性でリスク水準が「低」から「中」に上がることを正しく見抜いていたようだ。これはそれほど意外ではないかもしれない。これらはコーディングやコンピュータ操作と深く関わっており、(前の節で見たように)予測者はAIがそうした分野で大きく向上すると予想していたからだ。
しかし、予測者は「中」から「高」に上がったCBRNのリスクを過小評価した。では何がまずかったのか? 小さな要因の一つは、Cybenchの場合と同じく、回答者が、こうしたリスクの上昇を控えめに報告するOpenAIの動機を過大評価したことかもしれない。だが、それだけでは説明しきれない。同じ議論は他のすべてのリスク領域にも当てはまるはずだからだ。より大きな理由は、LLMが生物学的な能力をどれだけ底上げ(アップリフト)しうるかを、彼らが特に過小評価したことのようだ。CBRNのリスクが「中」から「高」に上がるのに必要な条件を見てみよう。
「モデルが、専門家が新たな脅威の経路を開発するのを可能にする。または、モデルが意味のある形で向上した支援を提供し、関連分野で基礎的な訓練(たとえば学部の入門レベルの生物学の講義)を受けた人なら誰でもCBRNの脅威を作り出せるようにする。」
多くの予測者は、モデルが「真に新しい脅威の経路」を開発するのは難しいだろうと論じた。私の知るかぎり、これは正しい。だが彼らは、モデルが非専門家にCBRNの脅威を作り出すための意味のある「底上げ」を提供できるようになるとも予想していなかった。こちらは外れた。GPT-5.2はこの基準を満たしたようである。興味深いことに、これは今年初めの研究と一致しているように見える。その研究では、スーパーフォーキャスターと生物学の専門家が底上げの大きさを大幅に過小評価していた。
これらの結果を合わせると、OpenAIのリスク水準の予測は当たり外れがあったと言える(残る「説得」のリスク領域は、4月にOpenAIのリスクのフレームワークから削除されたので、この設問の判定は決着がつかなかった)。
AIの存在感:収益は過小評価、世論は過大評価
ここで調査の最後の部分に移る。AIの現実世界への影響、具体的には年換算売上高と、AIに対する世間の懸念を扱う部分である。
| 設問 | 予測時点の値 | 予測の中央値 | 結果 |
|---|---|---|---|
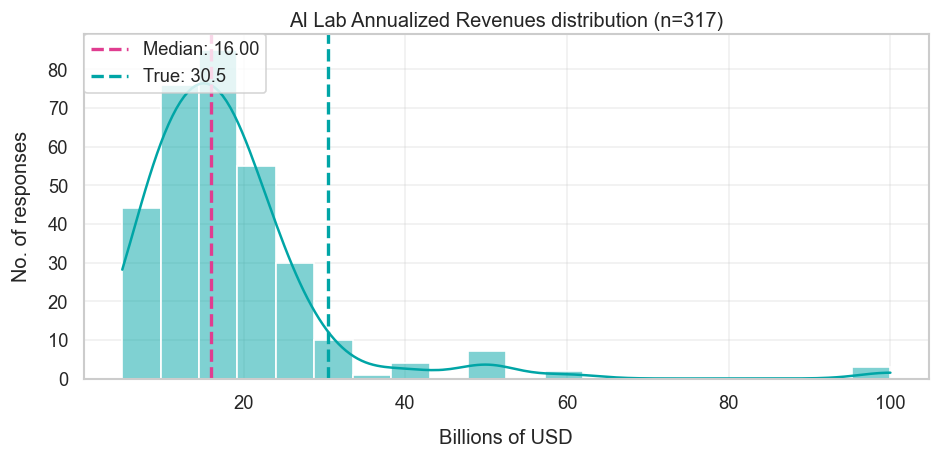
| OpenAI、Anthropic、xAIの収益の合計 | 47億ドル 注:2024年12月ではなく8月の値。後述の議論を参照 | 160億ドル | 304億ドル |
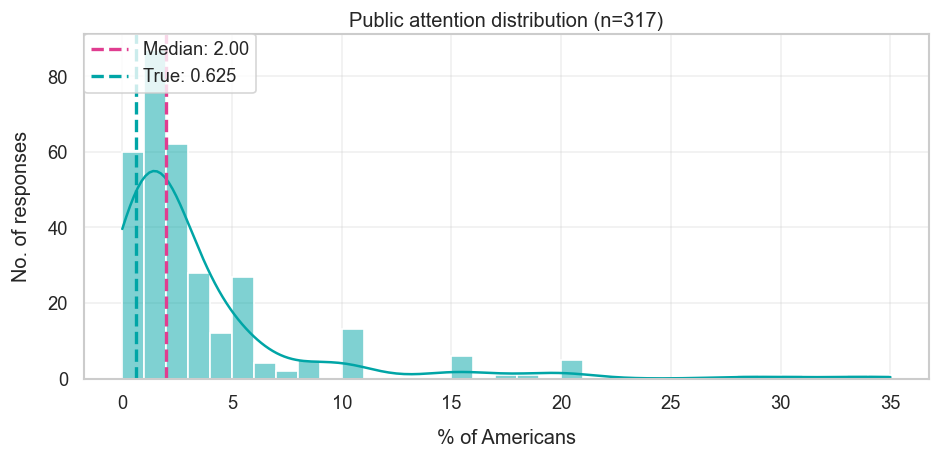
| 2025年12月31日までに、コンピュータ/技術の進歩を米国の最も重要な問題に挙げる米国人は何%になるか? | 0.38%(2024年9〜12月) 0.45%(2024年3〜12月) | 2% | 0.625% |
注:結果の判定理由は、元の調査のリンクで見られる。
準備態勢フレームワークの設問と同じく、ここでも当たり外れがあった。予測者は収益を大幅に(半分ほどに)過小評価し、AIに対する世間の懸念を過大評価した。
フロンティアのラボの収益
私にとって、調査全体で最も印象的だった結果は、人々がAIラボの収益を大幅に過小評価していたことだ。予測の中央値では、OpenAI、Anthropic、xAIの年換算売上高は昨年末までに160億ドルになるとされていたが、実際にはその約2倍、正確には304億ドルだった。わずか1年先の予測だったのに、なぜこれほど大きな差が生じたのだろうか?
一つの問題は、設問の読み違いかもしれない。重要なことに、調査が尋ねたのは2025年の年間総収益ではなく年換算売上高だったので、予測者が設問を誤解していれば、ずっと低すぎる推計を出したかもしれない。
だが、これで本当に差が説明できるとは思えない。Eli Liflandはその理由の一つを挙げている。調査自体が年換算売上高の数字を示していたのだ。そのため、示された数字から「収益はN倍に伸びるだろう」と推論した人は、用語の混同とは関係なく同じ予測に行き着くはずである。
もう一つの理由は、これらの設問での予測者の根拠を見るとわかる。書かれた33件の根拠のうち、9件は年換算売上高に明示的に言及していたのに対し、明らかに通年の収益についてのものは2件だけだった。残りの22件はかなりあいまいで、たとえば「過去の傾向を外挿する」と言いながら、その傾向が正確に何なのかは書いていなかった。だから完全に確かではないが、これは大半の回答者が正しく年換算売上高を見ていたことを弱く示唆していると思う。
最後の可能性は、調査で示された年換算売上高の基準値、つまり47億ドルについての混乱である。この数字は、2024年12月ではなく8月のOpenAIの収益の数字に基づいていたので、予測者はすでに古くなった出発点に引きずられたのかもしれない。もっと新しい基準値を見られていれば、彼らの予測はそれほど外れなかっただろう。
だが、これも全体の説明にはならないと思う。予測者が更新された数字を持っていたとしよう。後知恵を使えば、その数字はわかる。2024年末時点で、OpenAIの年換算売上高は約55億ドル、Anthropicは約9億ドルだった。合計で年換算売上高は64億ドルになる。では、彼らの予測はどうなっていただろうか? 予測者の根拠を読むと、多くの回答者は「年2〜3倍」の成長率を外挿していたようで、高めに見積もっても予測は192億ドルになっていたはずだ。304億ドルという結果にはかなり近づくが、それでも届かなかっただろう。
私が正しければ、これらの予測者が外れた理由は、むしろOpenAIとAnthropicの収益が狂ったように伸びたことにある。そして本当に狂ったようになのだ。年換算売上高は約64億ドルから304億ドルに増えた。1年で約4.8倍である!
AIに対する世間の関心
調査の最後の設問は、AIに対する世間の懸念についてのもので、具体的には「2025年12月31日までに、コンピュータ/技術の進歩を米国の最も重要な問題に挙げる米国人は何%になるか?」というものだった。
予測の中央値は、結果としていくらか過大評価だった。どの期間で平均するかにもよるが、答えは約0.625%で、昨年末時点では約0.4%または0.45%だった。対照的に、予測の中央値は約2%だった。つまり、ここでは世間の懸念がある程度過大評価されている。
この過大評価は、たとえば5%を超えるような、かなり高い予測を出した一握りの人々でいっそう甚だしいようだ。こうした回答者の中には、雇用市場への影響やAIの安全性への懸念の高まりによって、世間の関心が本当に急上昇すると考えた人もいたが、実際にはそうはならなかった。
ここから読み取りすぎるのは私の誤りかもしれない。人々は正確な数字をそれほど深く考えず、世間の関心は高まるが小さいままだろうと考えて、1%や2%のようなきりのいい数字を選んだだけではないかと思う。それでも全体として、これは、経済学者がよく私に向ける批判に少し似ていると言えそうだ。つまり、自分たちの技術の重要性を過大評価する「技術屋」だという批判である。
調査から得られる教訓
結果を一文でまとめなければならないとしたら、予測者はベンチマークのスコアについてはおおむね正しかったが、OpenAIの準備態勢フレームワークのリスクと現実世界への影響については当たり外れがあった、と言うだろう。最も目立ったのは、収益とCBRNのリスクを過小評価し、AIに対する世間の懸念を過大評価したことである。次の画像でそれがわかる。
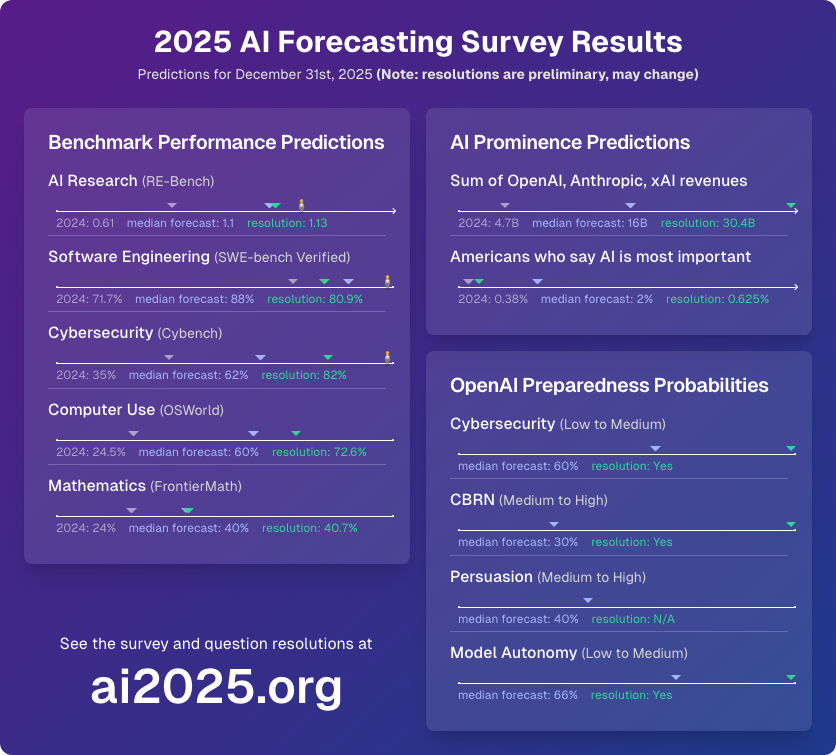
最新版は、元の予測調査の「Summary」タブを参照。
私にとって、これらの結果は、ある重要な問いを改めて議論の中心に引き戻すものだ。「ベンチマークは、より広い社会的影響をどれだけ反映しているのか?」という問いである。調査の回答者は、AIの研究開発のベンチマークでの改善をかなりうまく予測した。だが、こうしたベンチマークが実際に何を教えてくれるのかについては、常にはっきりさせておくべきだ。たとえば、RE-BenchはAIの研究開発を追跡するために設計されているが、そのタスクは非常に「きれい」な傾向がある。フィードバックのループが整っていて、並行して進むタスクも少なく、何百万行ものコードを抱える現実のAI研究とはかなり違う。有用なベンチマークではあるが、そこで好成績を出したからといって、たとえばAIの研究開発が自動化できるということにはならない。
また今は、研究者や予測者が、現実世界への影響の予測をどう改善できるかを考えるのによい時期でもある。比較的わかりやすい答えの一つは、こうした影響についてもっと多くのデータを集めることだ。この調査の予測者が現実世界への影響でうまくいかなかったのは、外挿に使える質の高いデータが少なかったことも一因だろう。したがって、今後の予測を改善したいなら、特にAIの影響がシリコンバレーの外へと広がり続けるにつれて、さまざまな現実世界の指標についてデータを集めるべきだろう。
では、これらすべてはAIの進歩とその社会的影響にとって何を意味するのか? Dwarkeshは「モデルは、タイムラインが短い人々の予測する速さで印象的になり続けているが、役に立つようになる速さは、タイムラインが長い人々の予測するとおりだ」と書いている。この調査の結果はおおむねこれを支持していると思うが、収益についての結果は反例になるかもしれない。年換算売上高の数字は、モデルが役に立つようになる速さが、タイムラインが短い人々と長い人々のどちらの予測よりも速いことを示唆しているように見えるのだ!
別の見方をすればこうなる。この調査の回答者は、おそらく世界のほぼ誰よりも、近い将来のAIの急速な進歩に強気だった。それなのに、AIの収益を大幅に過小評価したのだ! だから、あれほど騒がれているにもかかわらず、AIは私たちが思っていた以上に大きな出来事なのかもしれない。
この記事についてフィードバックと支援をいただいたEli Lifland、Adam Binksmith、JS Denain、Lynette Bye、Josh You、Tao Lin、Greg Burnhamに感謝したい。
付録
本文では、一般の読者に向けて、予測調査から得られる大局的な主な教訓を中心に取り上げた。これに対しこの付録は、回答の分布やデータの解釈の仕方といった細かい詳細にも関心がある読者のためのものである。
AIの研究開発に関連するベンチマーク
調査で取り上げたのは、次の五つのベンチマークである。
- RE-Bench:「GPT-2をファインチューニングする」のような、自由形式の機械学習の課題7問。
- SWE-Bench Verified:Pythonの小規模な実際のGitHub issueを解決する。
- Cybench:Webアプリの脆弱性を突くといった、プロ向けのサイバーセキュリティ競技の課題。
- OSWorld:PowerPointのスライドを複製するといった、簡単なコンピュータ操作のタスク。
- FrontierMath:答えを自動で検証できる、きわめて難しい数学の問題。
このうち最初の三つは、コーディングの多いタスクを含み、AIの研究開発とかなり明確に関連しているように見える。OSWorldとFrontierMathはもっと議論の余地があるが、AIの研究開発におそらくかなり重要なスキル、つまりコンピュータ操作と深い技術的推論を捉えている。FrontierMathとOSWorldでの性能は、全体として最初の三つのベンチマークともかなり相関している。さまざまなモデルにわたって、同じ潜在的な「能力」因子を捉えているからかもしれない。
RE-Bench
Research Engineering Bench(RE-Bench)は、AIの研究開発の自動化を測るためにMETRが作ったベンチマークである。「GPUカーネルを最適化する」「GPT-2をファインチューニングする」といった、難しい自由形式の機械学習の課題7問からなる。各タスクには一定の基準性能を達成する出発点のコードがあり、目標はその性能をできるだけ高めることである。
厄介なのは、性能を測る最も自然な指標が課題ごとにかなり異なることだ。同じ土俵で比べられるようにするため、METRの研究者はこれらの異なる指標を正規化する必要があった。参照コードの出発点の性能を0とし、人間の専門家が設定した人間の基準を1とする。そのうえでタスク全体で平均をとる。
2024年末時点で、AIの最高スコアはClaude 3.5 Sonnetの0.61だった。予測の中央値は1.1で、最終的な結果の1.13に非常に近い。とはいえ、この最終結果はGemini 3 Proのスコアに基づいている。Claude Opus 4.5やGPT-5.2が評価されていればもっと良い成績を出していた可能性もあり、そうなら予測は過小評価だったことになる。なお、このGeminiでの評価は、RE-Benchの7タスクのうち5タスクだけを対象にしている。
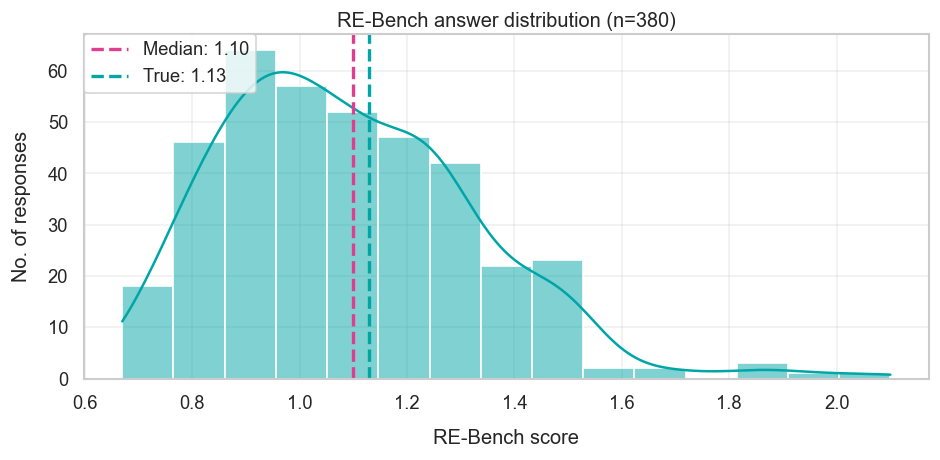
得られた根拠を見ると、興味深い点がいくつかわかる。一つは、理論上ありうる値を超えているらしい推計があることだ。理論上の最高スコアは、元の調査の「more info」欄に基づいて推計できる。各タスクにはそれぞれ最大値があり、1.36、2.53、1.25、1.81、2.51、1.8、1.48である。これを平均すると1.82になるが、これより高く予測した人もいた。最大値の上限に同意していないからかもしれないが、根拠を読んだかぎりでは、そもそもこの上限をまったく考慮していなかったからではないかと思う。
予測がどれだけ強気か慎重かに影響した要因も見ることができる。強気の予測(たとえばスコア1.2以上)をした人々は、RE-Benchのようなタスクに向けた最適化が盛んに行われるだろう、推論モデルによる改善が効きやすい、フィードバックのループが速い、と考える傾向があった。0.9未満と予測した人々は、あまり中身のある根拠を書いていないようだった(たとえば「素朴な当て推量だ」といったもの)。そして、この二つの範囲の間の予測をした人々は、それまでの改善の速さに少し多く頼る傾向があった。ただし、その速さを決めるのにどんなデータを使ったのかは、必ずしもはっきりしない。外挿の仕方によって予測が違ってくるようだったからである。
SWE-Bench Verified
SWE-bench Verifiedベンチマークは、実際のGitHub issueから取ったソフトウェアエンジニアリングの問題500問からなる。問題はPythonに特化しており、誤りを除くために人間のアノテーターが検証している。
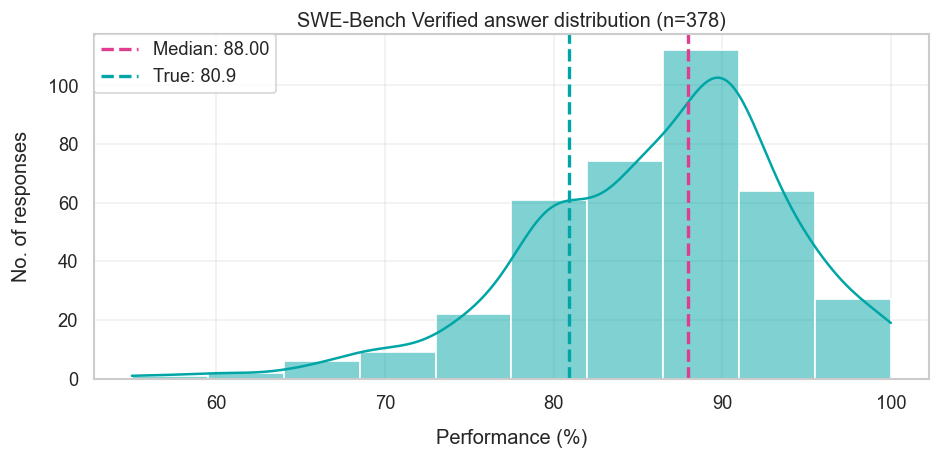
これは本文で詳しく論じたので、ここではあまり詳しくは述べない。ただ一つ付け加えると、遅めの予測の根拠の中には、o3の71%より低い基準値から推論しているらしいものがあった(代わりに、Amazon Q Developer Agentによる55%の基準値を使っていた)。これはおそらく、調査で示された参考値が、最初の公開から数週間後に更新されたためだろう。これは観察される予測を引き下げる方向に働くはずだが、それでも全体の予測が最終的に観察された約80%の性能を上回るのを防ぐには足りなかったようだ。
Cybench
Cybenchは、サイバーセキュリティのタスクからなるベンチマークである。タスクは、参加者がコンピュータプログラムの特定の脆弱性を突き止めようとする、プロレベルの「Capture the Flag(旗取り)」競技から取られている。
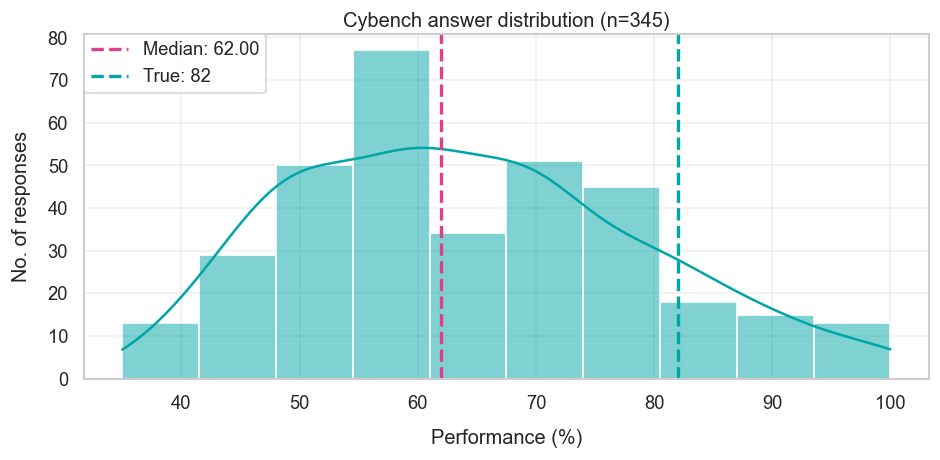
スコアは「ガイドなし」の評価設定で決められる。この設定では、中間チェックポイントとしてどのサブタスクをこなせばよいかの手引きがなく、AIモデルはタスク全体を最初から最後まで遂行しなければならない。
OSWorld
OSWorldは、361件のコンピュータ操作のタスクからなる、よく知られたベンチマークである。タスクは、文書にページ番号を付けるといった、Linuxベースの環境での簡単で現実的なものが中心である。
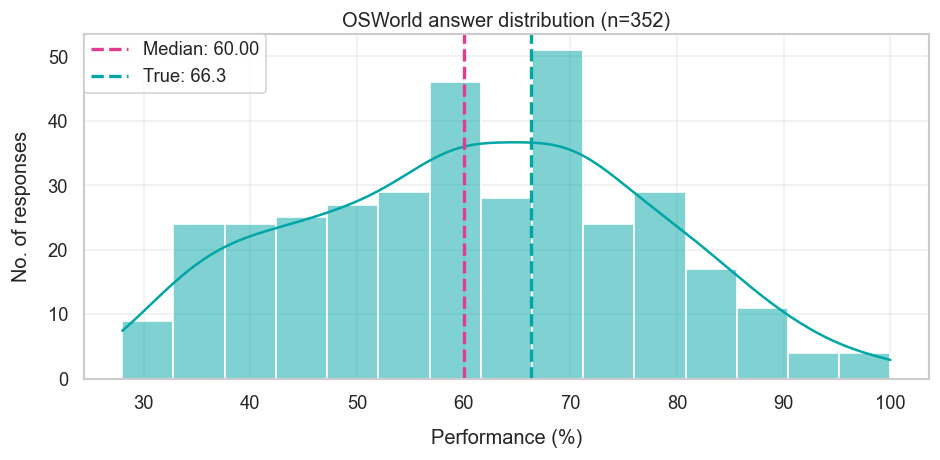
予測時点での最高水準の性能は24.5%で、予測の中央値は60%だった。これは実際の性能の66.3%にかなり近いが、予測者はどこまでの性能が達成されるかについてかなり不確かだったようだ。
その大部分は、OSWorldのタスクがどれだけ難しいかについての直観の違いに行き着くと思う。強気の予測をした人々は、このベンチマークのタスクを「工学的な問題」のようなものとみなし、性能向上のボトルネックは、研究者がより多くの時間と労力をかければおそらく解消されると考える傾向があった。慎重な予測をした人々は、OSWorldにはマルチモーダルなスキルが必要で、言語モデルはそれが苦手な傾向がある、と考えがちだった。後者の議論は誇張されていると思う。OSWorldの多くはグラフィカルユーザーインターフェースなしでこなせる。もっとも、予測が行われていた時点では、このことはおそらく広く知られていなかった。
最後の問題は、これらの性能の数字が、最初に見えるよりも解釈しにくいことだ。Greg Burnhamは、そうした問題の一つを簡潔に述べている。「標準的なやり方に反して、OSWorldは継続的に更新されている。7月の大型アップデートでタスクの大半が変わり、それ以降もタスクの指示の10%が更新された。さらに、タスクの10%はWebのライブデータに依存している。そのため、時期をまたいで結果を比べるのが難しい。」
FrontierMath
FrontierMathは、きわめて難しい数学の問題数百問からなるベンチマークである。各問題には、数値、行列、SymPyのオブジェクトといった、自動で検証できる答えがある。
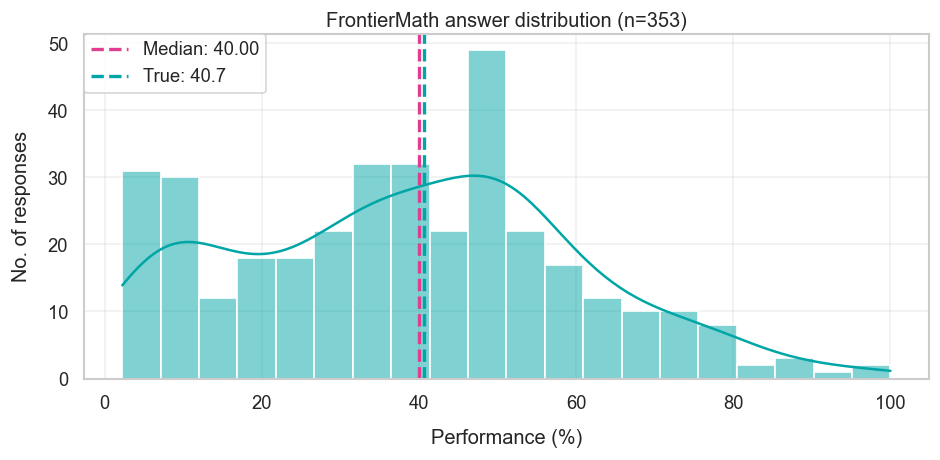
ここでは予測の中央値は非常に良かったようだ。中央値は40%で、実際の答えは40.7%だった。私にとってもっと興味深いのは、なぜこの数字が大幅に高くならなかったのかである。
たとえば5月に私は、FrontierMathの性能が年末までに50%をはっきり超えると予想していると書いた。実際、75%といった予測も不合理ではなかったと思う。このベンチマークの問題は、おおよそ25%が「学部レベル」、50%が「大学院レベル」、残りの25%が「研究レベル」になっている。だから、モデルが「大学院レベル」の問題の大半を解けると予想するなら、75%近いスコアを予想してもおかしくない。ほかにも理由はある。たとえば、予測時点で得られた限られたデータをもとに、ベンチマークの進歩のシミュレーションを走らせることだ。唯一の問題は、この予想が外れたことである。
振り返ると、私は二つの誤りを犯したのかもしれない。一つ目は、これらの難易度の区分が、AIシステムが解ける問題と解けない問題をそれほどきれいに分けてはいないことだ。特に、このベンチマークの問題は、非形式的な議論で答えを当て推量する、いわば「ズル」で解けてしまうことがあるからである。
二つ目の誤りは、o3の公開を受けて見方を修正しすぎたことだ。o3は、FrontierMathの公開から1か月以内に、最高水準の性能を2%から約25%へと一気に引き上げた。実際、(わずかな)修正のしすぎはよくある問題だったようだ。o3公開前の中央値は結果の値を約30%下回り、o3公開後の中央値は約10%高すぎた。
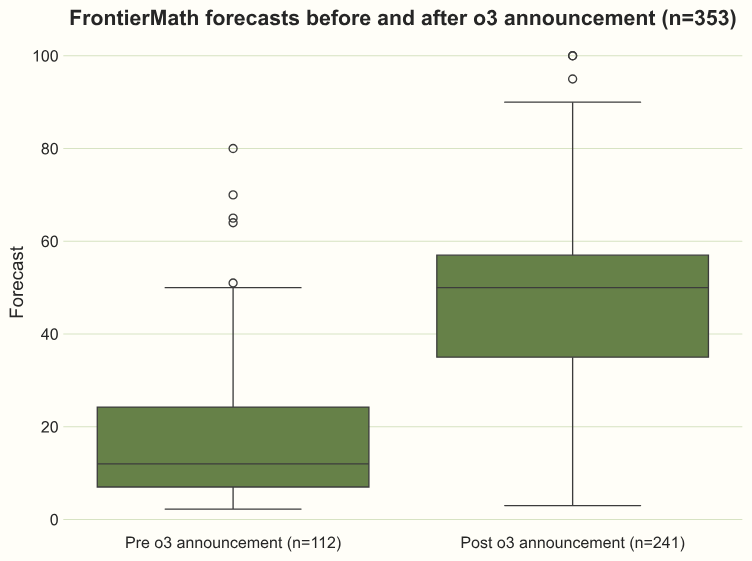
これを厄介にしているもう一つの小さな点は、予測の開始時に示された約25%という数字がOpenAIの社内評価に基づいているのに対し、最終的な結果はEpoch AIの評価に基づいていたことだ。後者は多くの場合いくらか低い。たとえばo3の場合、Epochの数字での最高スコアは18.7%に近い。
OpenAIの準備態勢スコア、フロンティアのラボの収益、AIに対する世間の関心
これらは本文でかなり詳しく論じたので、主なグラフを示す以外にはあまり詳細を付け加えない。
OpenAIの準備態勢スコア
フロンティアのラボの収益
AIに対する世間の関心
信用区間のデータ
調査に回答する際、参加者は任意で自分の予測に80%信用区間を付け加えることができた。そのデータの一部を下の表に示す。
| 設問 | 80%信用区間が真の値を含んでいた割合 |
|---|---|
| RE-Bench 回答者380人 | 86.6% 有効な区間149件中 |
| SWE-Bench Verified 回答者378人 | 87.0% 有効な区間146件中 |
| Cybench 回答者345人 | 70.0% 有効な区間130件中 |
| OSWorld 回答者352人 | 85.8% 有効な区間127件中 |
| FrontierMath 回答者353人 | 76.5% 有効な区間132件中 |
| AIラボの年換算売上高 回答者317人 | 57.7% 有効な区間111件中 |
| 世間の関心 回答者317人 | 73.0% 有効な区間111件中 |