
ニュースレター
AIは FrontierMath ですでに人間を超えているのか?
原題:Is AI already superhuman on FrontierMath?
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
人間は FrontierMath でどれくらいの成績を上げるのだろうか。
FrontierMath は、AIの数学能力の限界を試すために私たちが昨年公開したベンチマークである。学部上級レベルから、フィールズ賞受賞者でさえ難しいと感じるものまで、さまざまな難易度の300問を収録している。
人間の基準値を求めるため、私たちは MIT で競技会を開いた。約40人の優秀な数学専攻の学部生と各分野の専門家が参加した。参加者は4〜5人ずつ8チームに分かれ、インターネットを使える状態で4.5時間かけて23問を解いた。1 そのうえで、FrontierMath で現在最高水準のAIシステム、すなわち o4-mini-medium と対決させた。2
結果はどうだったか。o4-mini-medium は人間のチームの平均を上回ったが、全チームを合わせたスコア、つまり少なくとも1チームが解いた問題の割合には及ばなかった。つまり、AIは FrontierMath でまだ明確に人間を超えているわけではない。しかし、まもなくそうなると私は考えている。
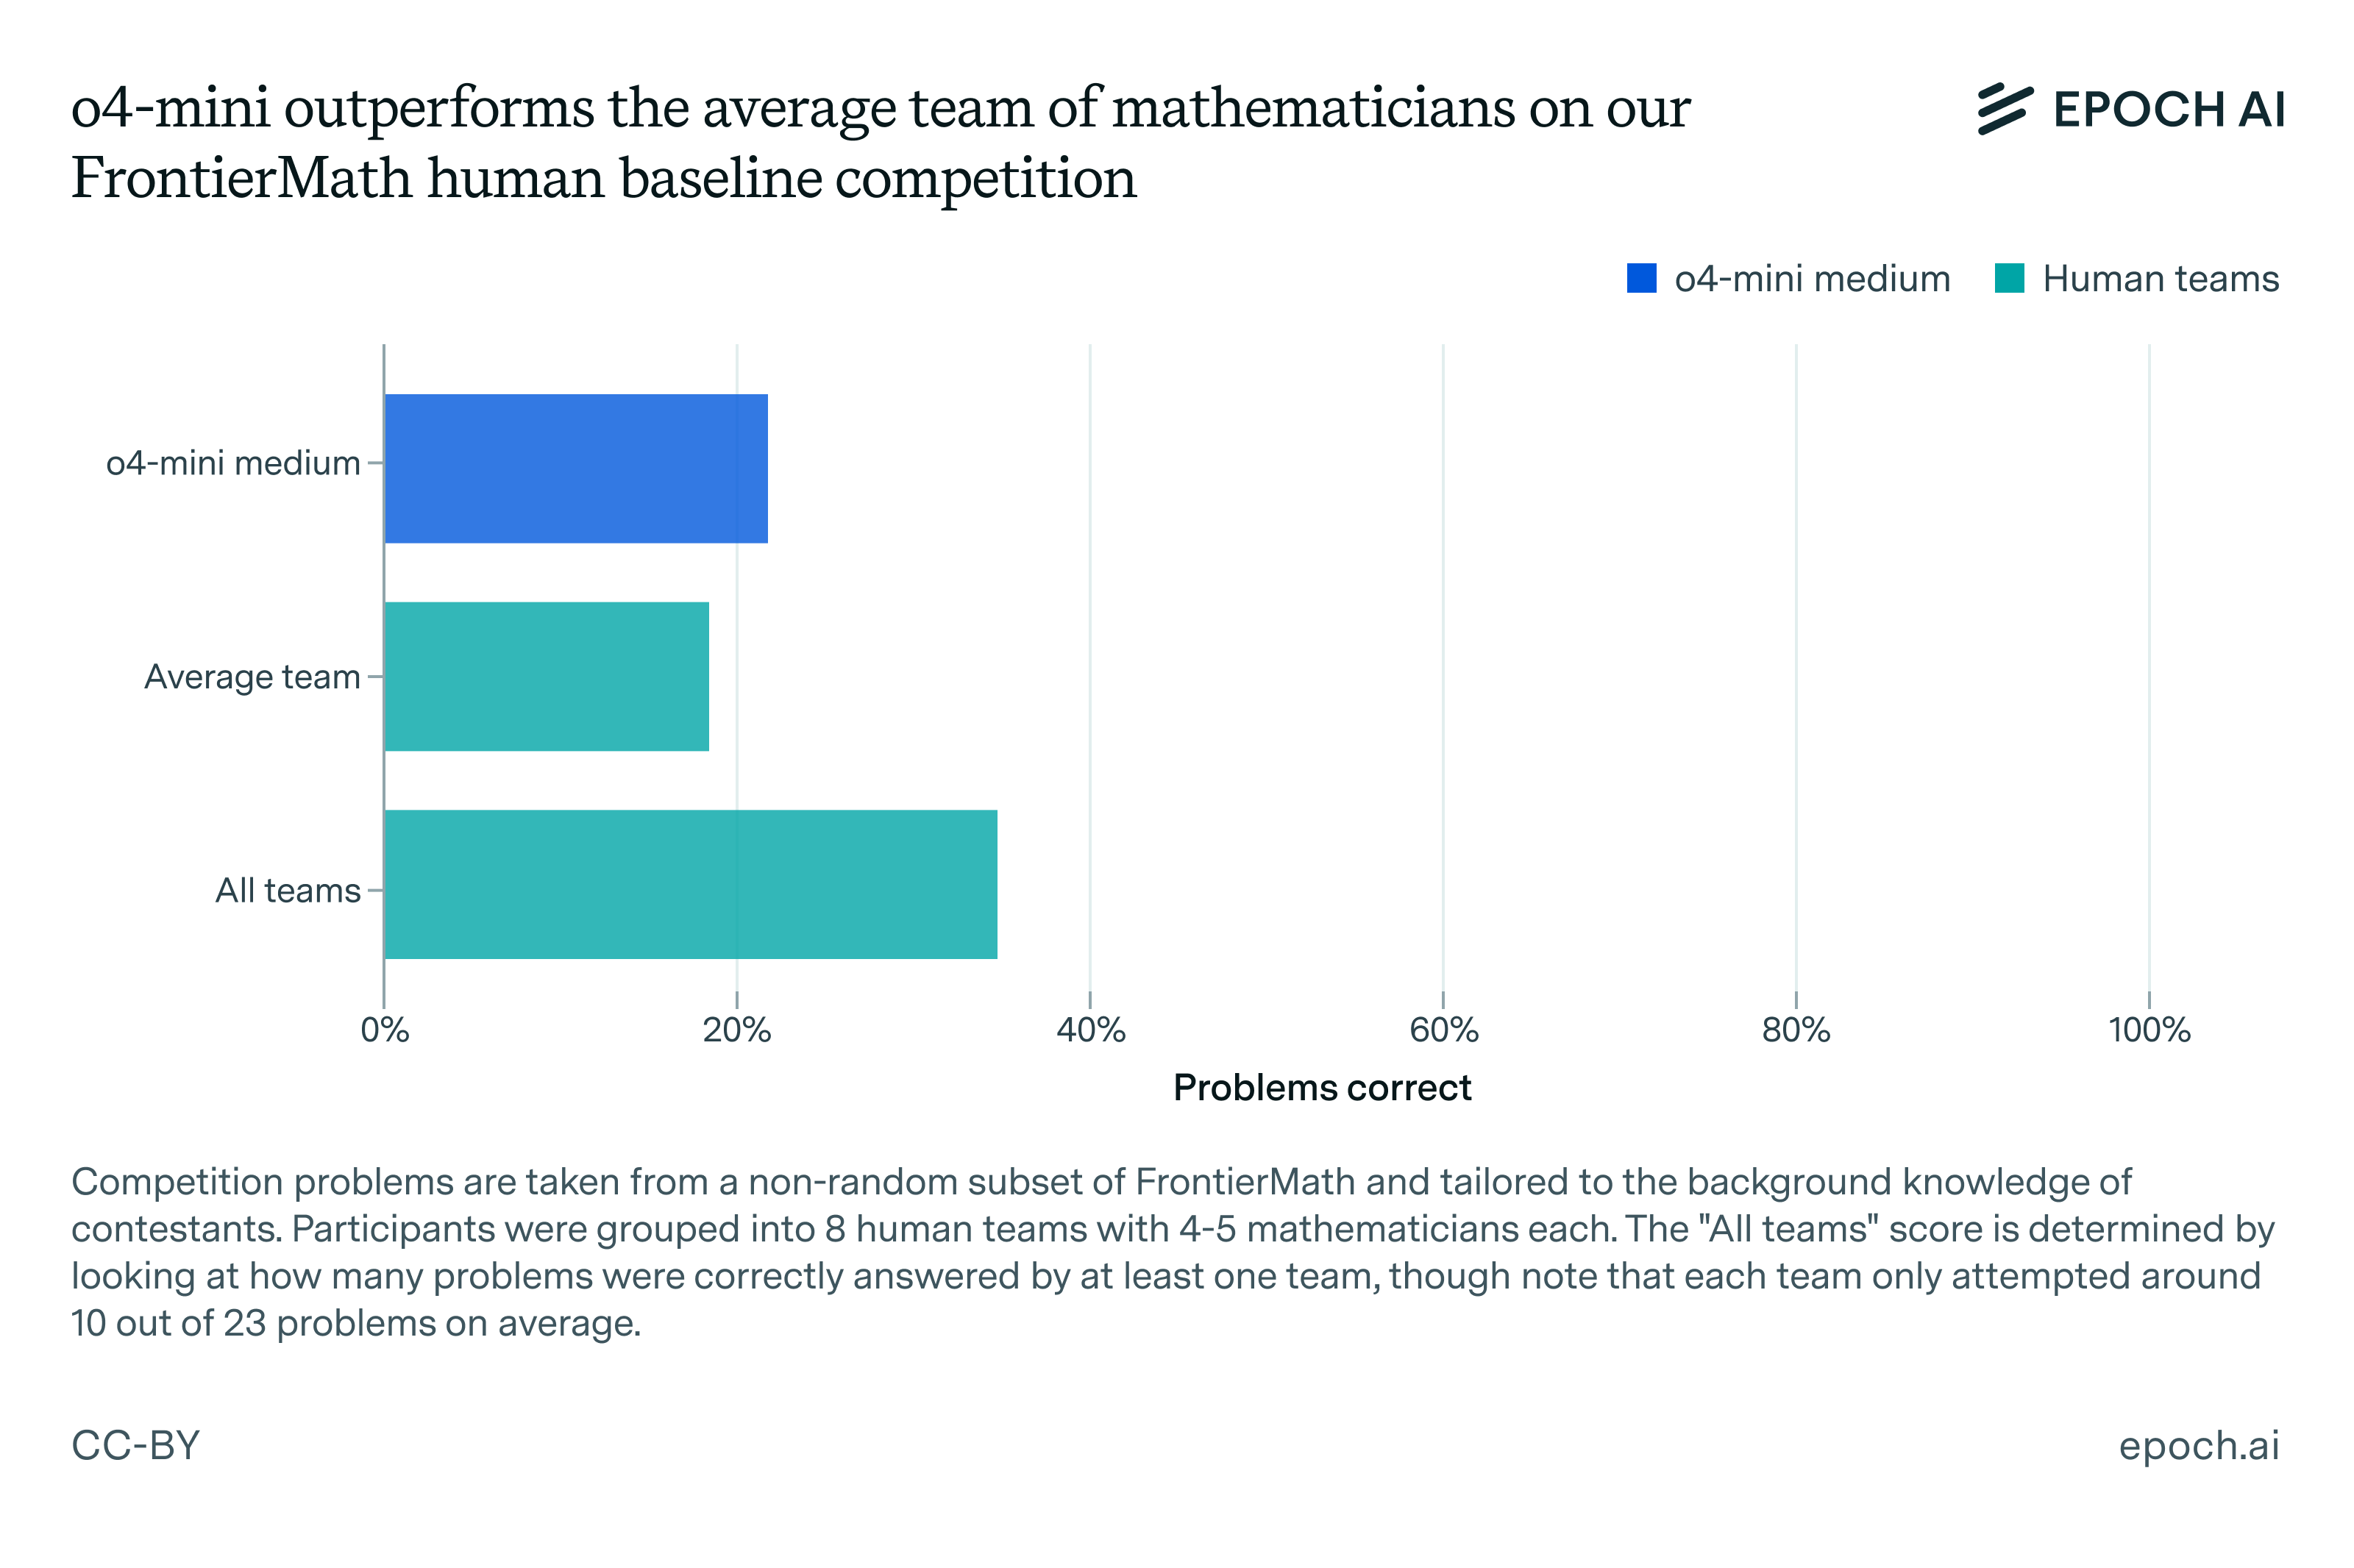
図1:o4-mini-medium は FrontierMath の人間の基準値を測る競技会で22%を記録し、チームの平均(19%)を上回ったが、全チームを合わせたスコア(35%)には届かなかった。o4-mini-medium が解けたのは、少なくとも1つの人間のチームが解いた問題だけだったことに注意。競技会の結果はこのスプレッドシートにある。
ただし、このデータは FrontierMath の、代表性のない小さな部分集合に基づくものにすぎない。では、全体としての人間の基準値にとってこれは何を意味するのだろうか。FrontierMath で最も参考になる「人間の基準値」は30〜50%のどこかだと私は考えているが、残念ながら、これは表面上見えるよりもかなり曖昧なものであることがわかる。
そこで本稿では、この人間の基準値の結果について知っておくべき4つのこと、つまりそれがどこから来ていて、何を意味するのかを簡単に説明したい。
Epoch AI の最新情報を受け取る 購読する
1. 分野の専門知識を持つ人が少なかった
質の高い結果を得るため、参加資格として卓越した数学の能力を示すことを求めた。たとえば、博士号を持つ人や、競技会で非常に優れた実績を持つ学部生などである。
参加者を4〜5人ずつ8つのグループに分け、各チームに特定の分野の専門家が少なくとも1人いるようにした。ここで言う分野の専門家とは、たとえばその分野の大学院の学位を持つか博士課程に在籍しており、その分野を得意分野として挙げた人である。
専門家だけのチームを作り、さまざまな分野の専門家をそろえられれば理想的だったが、実際にはほとんどのチームで学部生と専門家がほぼ半々だった。また、参加者の大半はボストンの数学コミュニティの地元の人たちで、このコミュニティでは解析学の専門家が少ないことがよく知られている。
2. 競技会は、幅広い知識よりも推論能力を反映するように設計した
ある意味では、AIシステムはすでに人間を超えている。たとえば、最も博識な人間の数学者と比べても、はるかに多くの知識を持っている。これはAIにとって大きな強みである。FrontierMath の問題は数論から微分幾何学まで幅広い分野にわたっており、これらの分野すべての最先端に通じている人間は一人もいないからである。
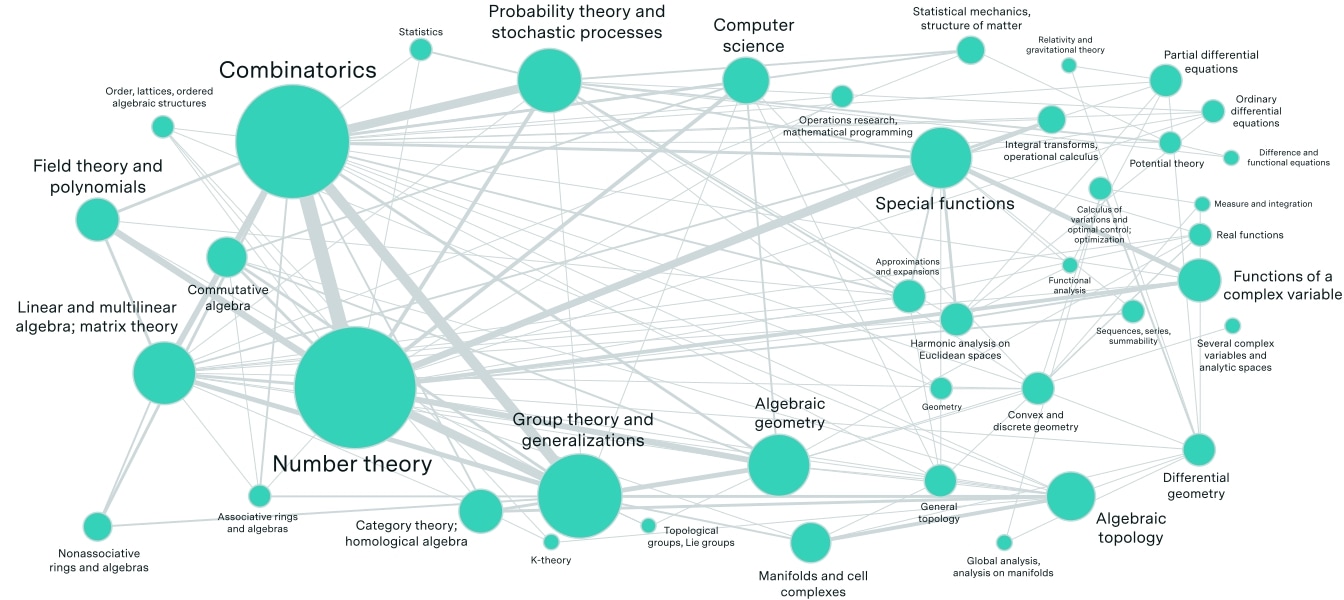
図2:FrontierMath ベンチマーク全体の分野を図示したもの。幅広い分野にわたっている。
この知識面での強みはそれ自体意味のあるものだが、FrontierMath が何より測れるように作り込まれているもの、つまりAIシステムが数学的推論を行えるかどうかは捉えていない。
そこで、より意味のある人間の基準値を得るため、必要な予備知識が少ない問題か、参加者の予備知識に合わせた問題を選んだ。3 具体的には、優秀な学部生なら取り組める「一般」問題7問と、参加する専門家に合わせた「上級」問題16問を選んだ。4 上級問題は、(1) 位相幾何学、(2) 代数幾何学、(3) 組合せ論、(4) 数論の4つの下位区分に分かれる。
とはいえ、回答がすべて一般問題に偏らないよう、ある程度幅広い分野で回答を得たいとも考えていた。競技会の採点方式でそれを促そうとした。「上級」問題は1問正解するごとに2点、「一般」問題は1点とした。また、全5分野(「一般」区分と4つの「上級」下位区分)のそれぞれについて、少なくとも1問正解した分野ごとに1点を加えた。
最後に、高い成績を促すため、上位チームには賞金を出した。1位は1000ドル、2位は800ドル、3位は400ドルである。参加を促すため、その他の参加者には150ドルの謝礼を支払った。
3. 「人間の基準値」の定義はやや曖昧である
各チームはおおむね問題の13%から26%を解き、平均は19%だった。o4-mini-medium は競技会の問題の約22%を解いた。扱っているサンプルサイズを考えると、これはほぼ互角だと私は考えている。
しかし、人間の基準値をこのように報告しても、あまり参考にならないかもしれない。理想的には、各チームが4つの上級分野すべての専門家をそろえていればよかったが、8チームのどれもそうではなかった。そのため、平均した人間の基準値のスコアは、必要な知識をすべて備えたチームと比べるとやや過小評価になっている可能性が高い。
これを考慮する一つの方法は、8つの人間のチームのどれかが正解した問題を正解とみなすことである。そうすると成績は約35%に上がるが、これはやや楽観的すぎるとも思う。ある意味でこれは、人間に「ゴールを何度も狙える」ことを許している(すべてのチームが関連分野の専門知識を持つ問題については、人間のチームにとって「pass@8」のようなものになる)。一方、o4-mini-medium は pass@1 の設定で評価された。これを考えると、この競技会での人間の成績はおそらくこの2つの境界の間のどこか、約20〜30%だったのだろう。5
しかし、ベンチマーク全体での人間の基準値を求めたいなら、2つ目の問題に対処する必要がある。具体的には、下の表に示すように、競技会の問題は FrontierMath のデータセット全体とは難易度の分布が異なる。
| 難易度のティア | FrontierMath 競技会 | FrontierMath ベンチマーク全体 |
|---|---|---|
| ティア1(学部レベル程度) | 17% | 20% |
| ティア2(大学院レベル程度) | 13% | 40% |
| ティア3(研究レベル程度) | 70% | 40% |
FrontierMath 競技会とベンチマーク全体における問題の難易度の分布。競技会の「一般」問題はティア1かティア2の問題で、「上級」問題はすべてティア3である。6
そこで、結果を難易度のティアごとに分け、ベンチマーク全体の難易度の分布に基づいて全体のスコアに重みを付けた。そうすると、人間の基準値はチームごとの平均に基づくと約30%、「ゴールを何度も狙える」方式に基づくと52%に上がる。
残念ながら、この調整方法が本当に妥当かは確信が持てない。同じ重み付けを適用すると、o4-mini-medium のベンチマークでのスコアは約37%になるはずだが、ベンチマーク全体での評価では19%だからである。これは、競技会のティア1/ティア2の問題が、ベンチマーク全体の同じティアの平均的な問題より比較的易しかったためかもしれないが、それを事後に調整するのは難しい。
4. AIは FrontierMath でまだ人間を超えていないが、おそらくまもなく超える
では、これらは結局何を意味するのだろうか。
第一に、o4-mini-medium が(少なくとも競技会の制約のもとでは)人間のチームと同じくらいのスコアを達成することはわかったが、モデルがどのようにそれを達成しているのかはわからない。AIシステムは FrontierMath の問題の答えを単に当て推量しているのだろうか。人間の解き方と比べるとどうなのだろうか。これについては近日中に詳しく報告する。
第二に、関連する人間の基準値が本当に30〜50%程度なら、AIは年末までにこのしきい値を明確に超える可能性が高いと私は考えている。
注意点として、競技会の形式のために人間の成績がやや低く出ているかもしれない。たとえば、時間がもっとあれば人間の成績が大きく上がる可能性は十分にある。o4-mini-medium が1問を解くのにかかる時間は約5〜20分だが、人間はたいていそれよりかなり長くかかる。たとえば、競技会後のアンケートに回答した参加者は、いちばん気に入った問題に平均約40分を費やしていた。機械学習のタスクについての関連研究も、長い時間をかけたときの伸び方は人間のほうが優れていることを示唆している。AIの成績はある程度の時間が経つと頭打ちになるが、人間の成績は上がり続けるのである。また、FrontierMath の問題は実際の数学研究をそのまま表しているわけではないことにも留意すべきである。
それでも全体としては、これは FrontierMath の評価結果を位置づける助けになる有用な人間の基準値だと思う。AIがいつこのしきい値を超えるのか、注目している。
FrontierMath の人間の基準値を測る競技会に資金を提供してくれた Open Philanthropy に感謝する。
注
-
参加者には、いくつかのルール(チーム外の人に連絡しない、生成AIツールを使わない、など)のもとで、ノートパソコンでインターネットにアクセスし、問題を解く助けとして任意の言語でコードを書くことを認めた。 ↩
-
私たちの予備的な評価では、FrontierMath の競技会用の部分集合で Gemini 2.5 Pro は o4-mini-medium と同じスコアを記録し、23問中まったく同じ5問を解いた。 ↩
-
もちろん、これは参加する人間にいくらか有利に働くが、それが問題になるかどうかは何を測りたいかによる。推論能力の比較に特に関心があるのでなければ、AIは FrontierMath ベンチマーク全体ではすでに人間を超えている可能性が非常に高いと私は考えている。 ↩
-
もともと「一般」問題は8問あったが、競技会の参加者の1人がそのうちの1問の作者だったため、その問題を除外しなければならなかった。 ↩
-
もちろん、人間の基準値を具体的に定める方法はほかにもある。たとえば、FrontierMath の問題には「予備知識の評価」が付いているので、予備知識の評価が「学部レベル以下」に相当する問題の部分集合を考えることもできる。しかしそうすると、サンプルサイズが23問から8問に減り、設けた採点方式の目的もある程度損なわれる。しかも、得られる結果は大まかには同じである。残った8問では o4-mini-medium は約50%となる(チームの平均と同程度)。代わりに、人間のチームのどれかが正解した問題を正解とみなすと、成績は75%になる。 ↩
-
これは、以前発表した、ティア1、2、3がそれぞれ25%、50%、25%という難易度の分布とは異なる。以前の発表は FrontierMath の2024年11月26日時点のチェックポイントに基づいていたが、上の表の数字は2025年2月28日時点のチェックポイントのものだからである。 ↩