
レポート
SWE-bench Verifiedはどんなスキルを評価しているのか?
原題:What skills does SWE-bench Verified evaluate?
SWE-benchは、GitHubから集めた現実のソフトウェアの課題(issue)で大規模言語モデルを評価するベンチマークである。言語モデルは、コードベースと課題を与えられ、記述された問題を解決するパッチを生成する。
- 規模:課題の記述が付いた、Pythonのみのコーディング問題500問
- データの収集:GitHubの課題を収集し、人手で選別
- 採点方法:単体テスト
- 汚染のリスク:高い
要点
-
SWE-bench Verifiedは、AIの現実的なエージェント型コーディングのスキル、つまりCursorやClaude Codeのようなコーディングツールに必要なスキルを試す(リンク)。
-
問題のほとんどは比較的単純で、人間のエンジニアなら1時間足らずで修正できる(リンク)。
-
このベンチマークには汚染のリスクが高く(リンク)、テストが現実のクローズドソースのコードベースにうまく一般化しない可能性がある(リンク)。
-
モデルの周りに構築する足場(スキャフォールド)が、モデルそのものの能力と同じくらいベンチマークの性能を左右する(リンク)。
-
このベンチマークが飽和すれば、モデルがPythonのリポジトリで小〜中規模の課題を自律的に修正できることの強い証拠になる(リンク)。
はじめに
大規模言語モデル(LLM)はすでにプログラミングで広く使われており、近い将来に大きく進歩すると見込まれている。OpenAIのCPOであるKevin Weilをはじめ、多くのAIリーダーが今年中にコーディングの大部分が自動化されると予測している。
LiveCodeBenchやAider Polyglotなど、コーディングにおけるLLMの進歩を測ろうとするベンチマークは数多い。しかしこれらのベンチマークは、孤立した設定でコードを試し、LeetCode風の問題をゼロから解かせる。これは、エンジニアが直面する現実のコーディング作業をほとんど反映していない。現実の作業は大きなリポジトリの中で行われ、バグの修正、新機能の実装、既存コードのリファクタリングといった能力を必要とする。
SWE-bench Verifiedは、SWE-bench (Jimenez et al., 2023)の部分集合で、大規模で人気のあるPythonリポジトリの実際のバグを理解し、コードの中を探り、修正する能力でモデルを評価する。これによって、この隔たりを埋めている。SWE-bench Verifiedは従来のコーディングのベンチマークよりはるかに現実的だが、主に試しているのは、少数のよく知られたリポジトリで単純なバグを修正する能力である。さらに、汚染のリスクがありうることから、このベンチマークが現実のクローズドソースのコードベースに一般化するのかという疑問も生じる。
ベンチマークの問題の構成
SWE-bench Verifiedは、人気のある12のPythonリポジトリでの実際のバグ修正500件に基づいている。各問題は、マージされたプルリクエストと、それに対応するGitHubの課題を収集して作られた。この集まりを選別し、実際にマージされ、かつプロジェクトのテストスイートへの変更を含むプルリクエスト(PR)だけを残した。
ベンチマークを実行するモデルに与えられる問題には、次のものだけが含まれる。
- PRがマージされる前の状態のリポジトリ
- PRに関連する課題のタイトルと本文を含む課題の記述
評価のため、また正解を定めるために、ベンチマークの各問題には次のものも含まれる。
- 人間が書いた元のコード(正解パッチ)
- 正解パッチに伴って追加・変更されたテストを含むテストパッチ
- リポジトリのテストスイートから選んだテスト。以前から通っていて修正後も通り続けるべきテスト(Pass-to-Pass)と、バグのせいで失敗していて課題の解決後に通るべきテスト(Fail-to-Pass)である。
モデルの評価方法
モデルには、リポジトリの保守担当者が目にするのと同じもの、つまり修正前のコードベースと課題の記述が与えられる。モデルの課題は、その問題に対するコードのパッチを書くことである。パッチは適用されたうえで、問題に含まれる二つのテスト群(Pass-to-PassとFail-to-Pass)を実行して検査される。
このベンチマークの設定は現実的で、モデルのエージェント型コーディングのスキルを試す。このスキルは、Cursor、Claude Code、Codexのように普及が進むツールやエージェントにとって重要である。
SWE-bench Verifiedの誤り率は比較的低い
ベンチマークで最も重要な点の一つは誤り率、つまり、誤っている、あいまいである、あるいは解けない課題の割合である。SWE-bench Verifiedのうち、欠陥や不備のある問題の割合は5%から10%と比較的低いと確信している。
そう評価する主な理由は二つある。第一に、リポジトリの保守担当者がマージした課題だけが収録されている。したがって、どの問題も保守担当者の審査を経ている。第二に、そしてより重要なことに、SWE-bench Verifiedは、元の1600問からなるSWE-benchデータセット(Jimenez et al.によるSWE-bench)を検証して作った部分集合である。各問題について、3人の独立したアノテーターが詳細な評価基準に従い、課題の記述の明確さ、テストスイートの適切さと頑健さ、全体として解けるかどうかを評価した。これによって元の問題の3分の2以上が除かれ、最終的に質の高い500問が残った。
しかし、アノテーションは決して完璧ではなく、データセットを注意深く調べたところ、問題のある例がまだいくつか残っていることが分かった。SWE-benchのリーダーボードの上位5件の提出結果の出力を分析したところ、どのモデルと足場の組み合わせも解けなかった課題が85件(17%)あった。こうした特に難しい課題のうち40件を人手で評価し、課題の記述が不明確でないか、テストが厳しすぎないかを調べた1。分析の結果、無効な問題が14件見つかった2。この割合を、どのモデルにも解かれなかった80問に当てはめると、誤り率は6%となる。同じ誤りの分布を、5件の提出のうち1件か2件しか解けなかった問題にも広げると、誤り率は合計で10%になる。ここから、無効な問題の割合は全体としておよそ5%から10%と考えられる。評価基準をもっと緩くしたり、リポジトリ固有の慣習に通じた専門家の判断にもっと頼ったりすれば、誤り率は5%に近づく可能性がある。
問題そのものの欠陥に加えて、モデルが、与えられたテストは通るものの、既存のテストスイートでは捕捉されない新しいバグを意図せず持ち込むコードを生成することもありうる3。つまり、SWE-bench Verifiedで報告されるスコアは過大になっているかもしれない。
ここには重要な点がある。SWE-bench Verifiedの問題の選定はモデルを評価するのに必要だが、そのせいで、このベンチマークが試すのは現実のコーディングのやや偏った部分集合にもなる。課題が明確に書かれ、解があいまいさなく定まっている場面である。これは、ほとんどのエンジニアが日々の仕事で直面する雑然とした現実とは違う。
課題のほとんどは単純なバグ修正である
SWE-bench Verifiedの誤り率は比較的低いが、GitHubの課題全般を解決するモデルの能力を測っているわけではない。課題の約90%は、経験豊富なエンジニアなら1時間足らずで済ませられる修正である。したがって、このベンチマークが実際に試しているのは、AIがコードベースに単純な編集を加えられるかどうかである。
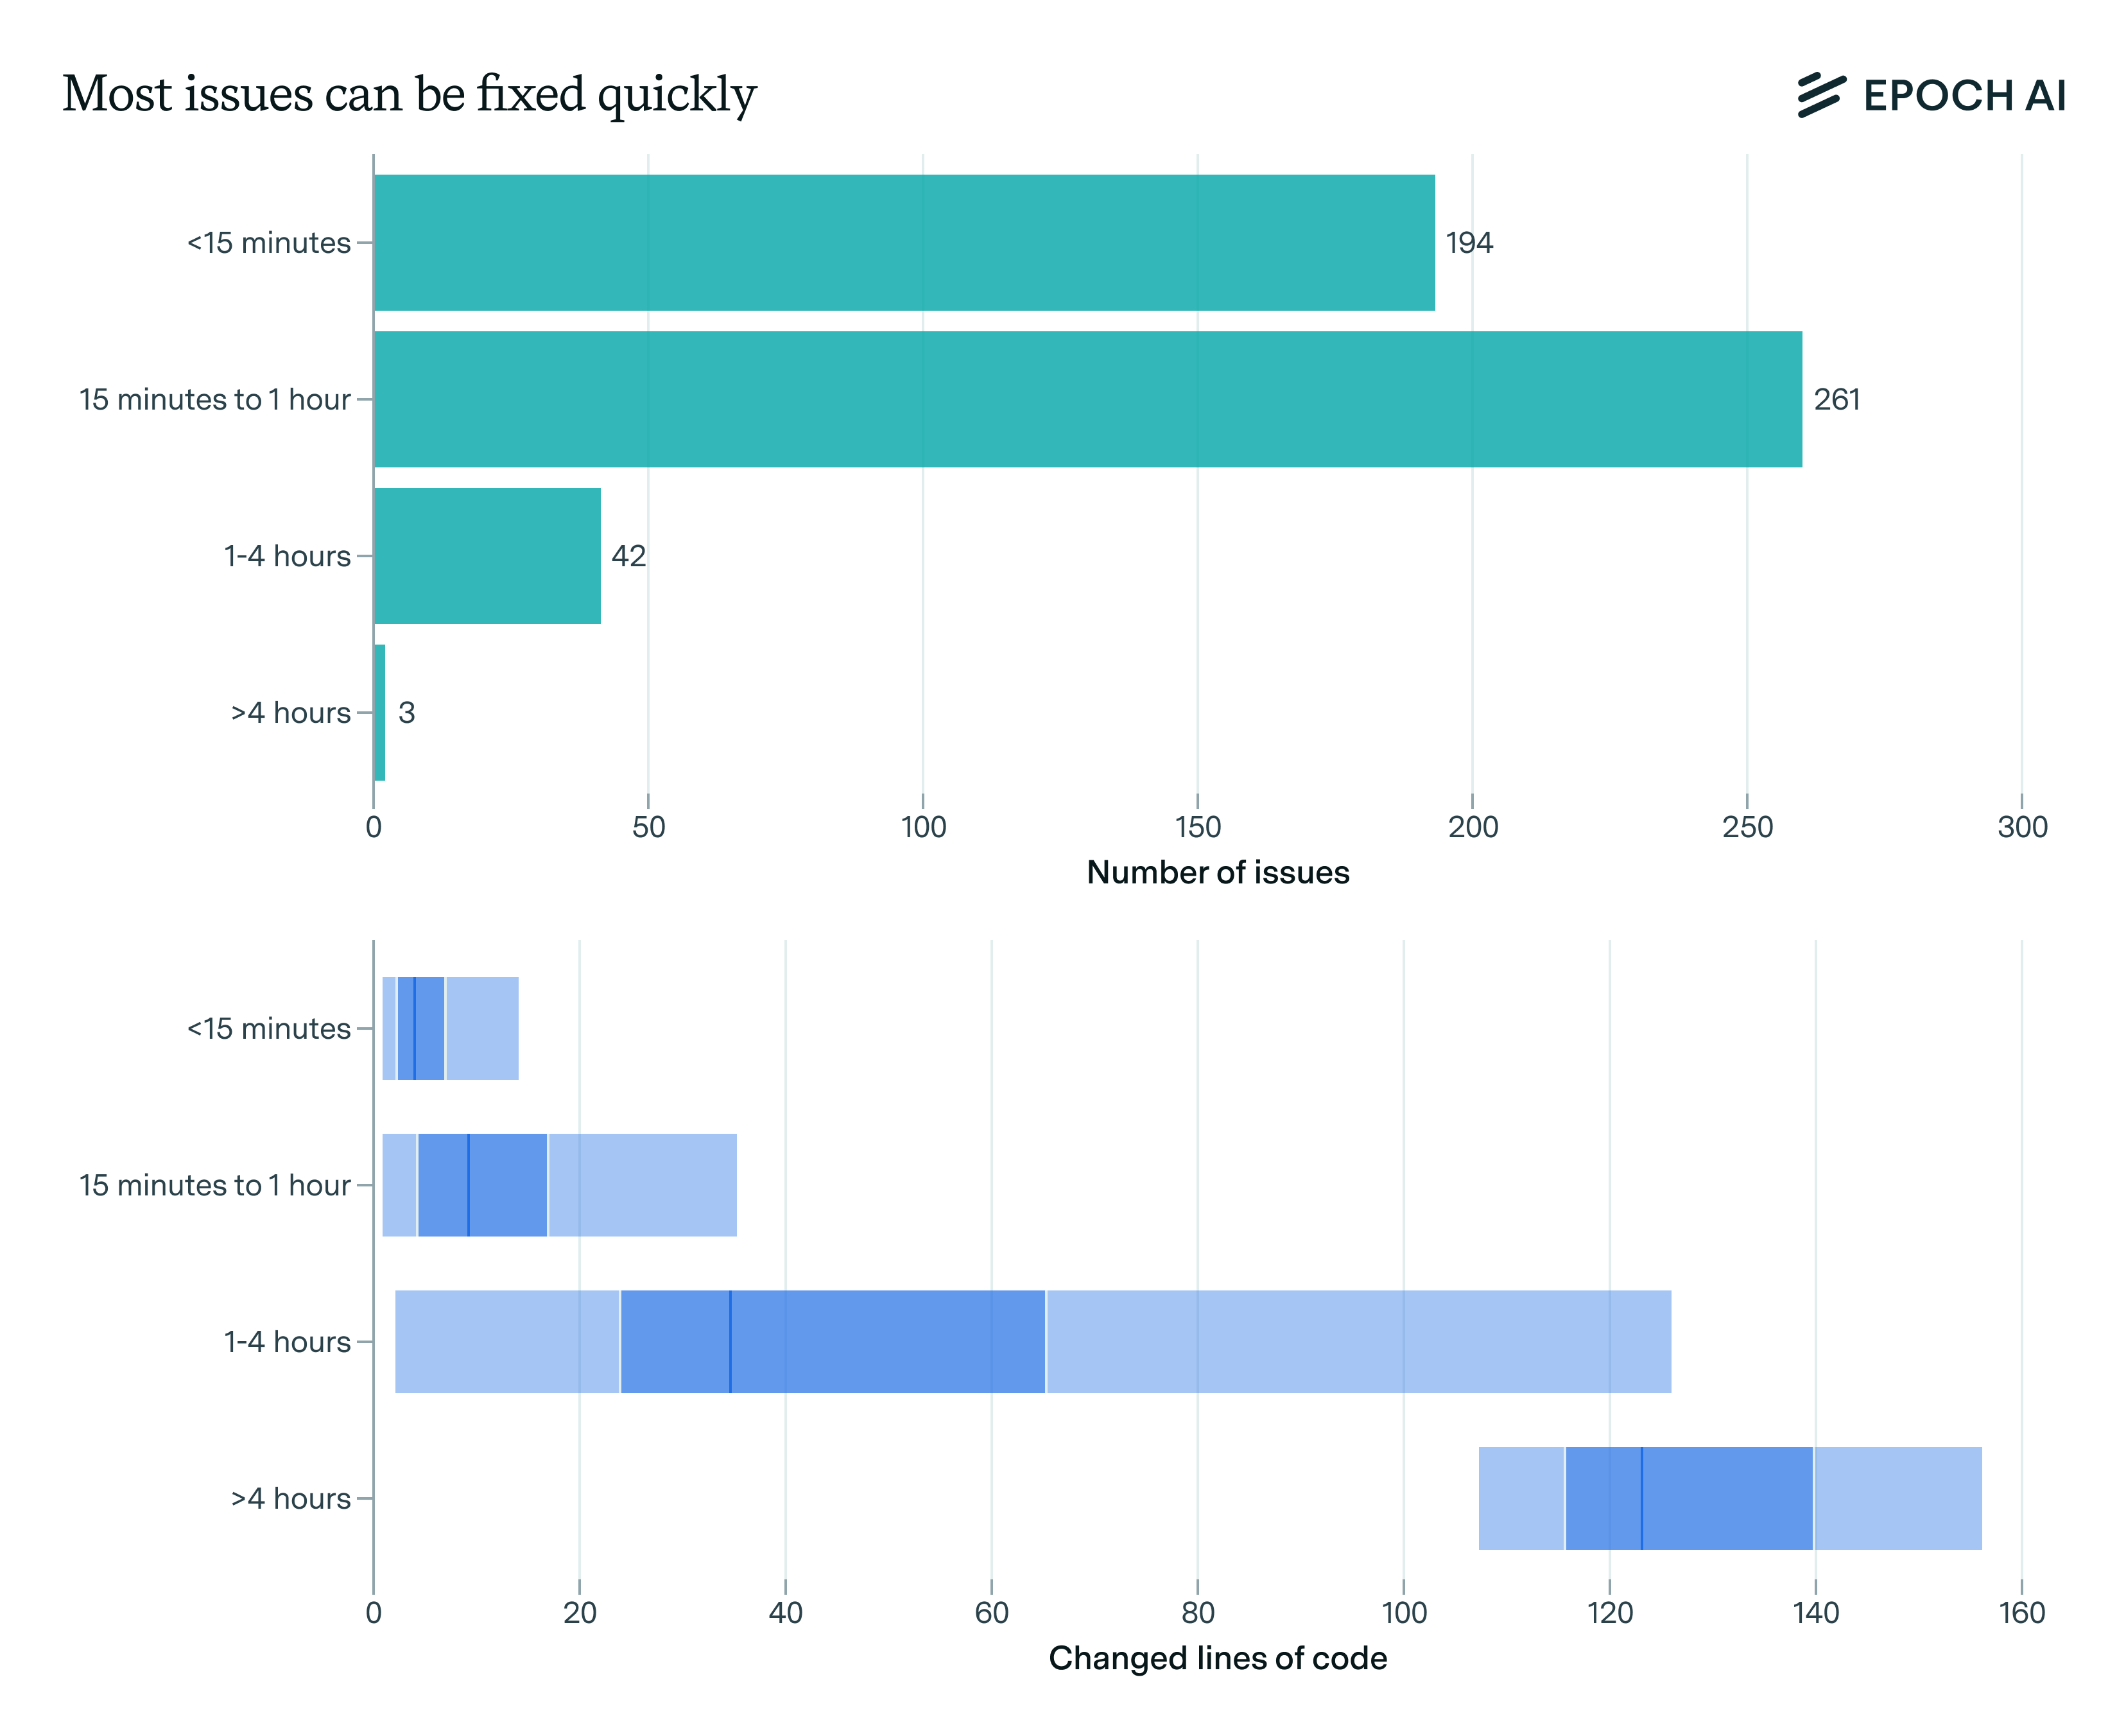
SWE-bench Verifiedのアノテーターは、そのコードベースに通じた経験豊富なソフトウェアエンジニアが各課題の修正にかかる時間を見積もった。課題の39%は15分未満で済む「些細な変更」、52%は15分から1時間かかる「小さな変更」と評価された。4時間を超えると見積もられたのは、わずか3件だった。
METRの調査では、これらの時間の見積もりは楽観的すぎることが分かった4。一方で、時間の見積もりは正解パッチで変更されたコードの量とよく相関している。すぐ済む修正(15分未満)では変更されたコード行数(LOC)は平均でわずか5行で、「15分〜1時間」の区分の課題では平均14行である。ベンチマークのわずか8%を占める「1〜4時間」の区分では平均50行が変更されており、最も大きい区分(「4時間超」)には課題が全部で3件しかない。
AmazonによるSWE-bench Verifiedの分析も、この結果を裏づけている。それによれば、変更の78%は関数だけに手を加え、クラスには(あるいはクラスと関数の両方には)手を加えておらず、変更が必要な関数は平均1.87個である。さらに、SWE-bench Verifiedの課題の大多数はバグ修正(87%)に分類され、残りは機能要望(9%)とリファクタリング(4%)である。
小さな課題が大半を占めるのは、ベンチマークの選定過程で説明できる。マージされ、かつテストスイートも変更するPRに絞り込むと、小さく独立したバグが大きく優遇される。人手によるアノテーションは欠かせないものの、範囲がはっきりしない課題も除いてしまう。そうした課題も、もっと文脈があれば解けたかもしれない。しかし、人間のソフトウェアエンジニアが直面する課題はもっと多様で、新機能の設計と実装や、コードのリファクタリングもしなければならない。記述や要件はもっとあいまいなこともあり、変更を依頼する側は、それを実装するエンジニアの直感と経験に頼っている。
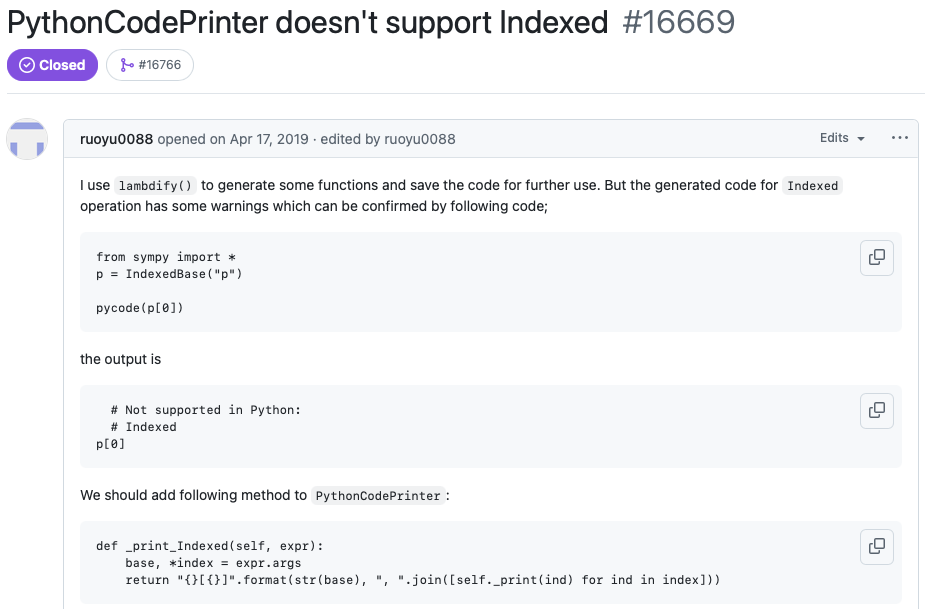
ベンチマークの多くの課題がいかに単純かを示す具体例を見てみよう。sympyリポジトリのこの課題は、sympyのコードベースにそれほど詳しくない人でも理解しやすい、素直な問題を記述している。人間のアノテーターはこの課題を「15分未満の修正」に分類しており、実際、対応するPRで変更されたのはわずか5行だった。
この例では、課題の本文が解決策の案まで示している。ただし、リポジトリに最終的にマージされたパッチは、その案とは少し違っていた。修正案が示されるのは珍しいことではない。Aleithan et al.もSWE-Benchを分析し、これを「解の漏洩」と呼んで、こうしたヒントのせいでベンチマークが非現実的で簡単すぎるものになっていると示唆している。私たちはこの見方に同意しない。再現可能な例や修正案まで付いた、仕様のはっきりしたバグ報告は、オープンソースのプロジェクトではよくあるもので、課題のテンプレートで修正案を求めているリポジトリも多い。したがって、こうした「漏洩した解」は現実のバグ報告の特徴であって、ベンチマークの設計上の欠陥ではない。それでも、結果を解釈するときにはこの点を考慮に入れる価値がある。
コードベースの多様性の低さが外的妥当性を制限している
SWE-bench Verifiedは、非常に人気のあるPythonプロジェクトから課題を集めている。多様性を目指してはいるものの、使っているリポジトリは12個だけであり、より幅広いソフトウェアエンジニアリングの仕事をどこまで代表できるかは限られる。
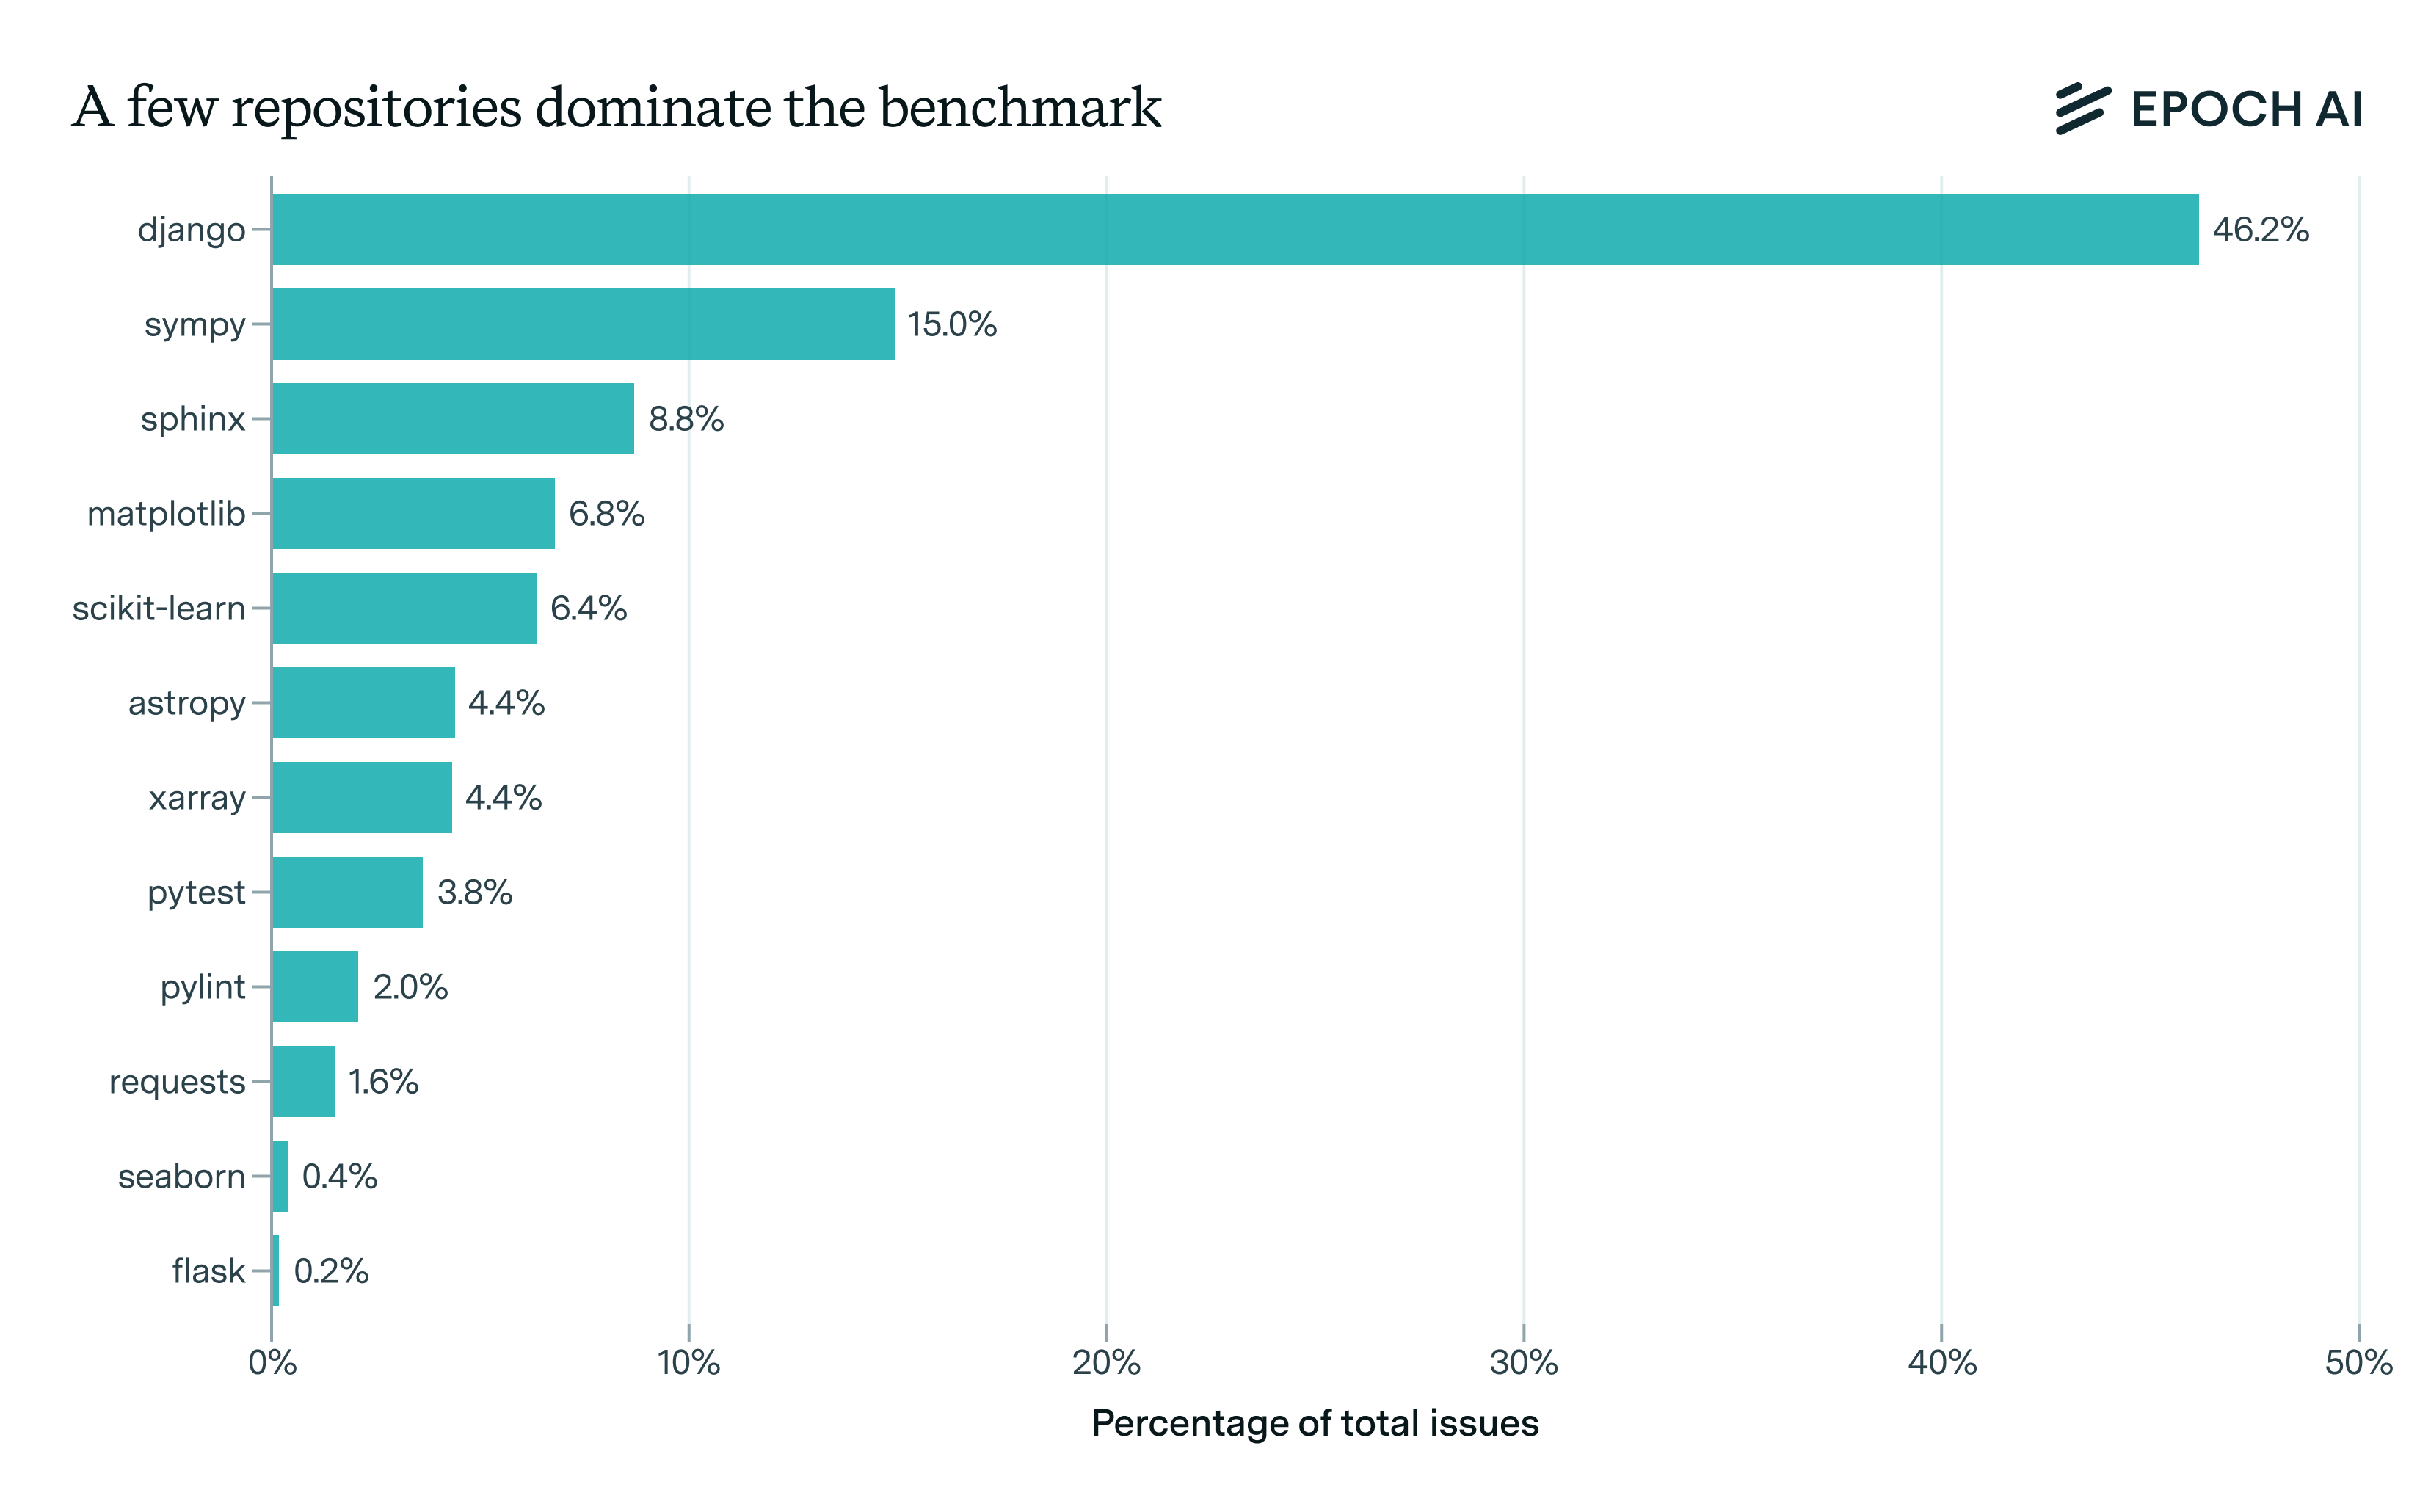
多様性が低いことに加えて、リポジトリの分布は大きく偏っている。WebフレームワークのDjangoという一つのリポジトリが、全課題の半分近くを占める。上位5つのリポジトリ(django、sympy、sphinx、matplotlib、scikit-learn)でベンチマークの80%以上を占め、下位5つのリポジトリは全体の約8%にすぎない。
これほど集中しているということは、LLMは学習中にこれらのリポジトリに出会っている可能性が高いということであり、モデルはその構造、スタイルの慣習、さらには個々の課題にまでなじんでいることになる5。その結果、このベンチマークは、同じくらいの複雑さを持つ本当に新しいクローズドソースのリポジトリに比べて、解きやすいかもしれない。
ベンチマークの半分は2020年以前の課題を試している
SWE-bench Verifiedは静的なベンチマークなので、問題が古いと、現在のソフトウェア開発の実務との関連性が懸念され、データ汚染のリスクも高まる。
Verifiedの元になったSWE-benchデータセットは、2023年10月に作られた。LiveCodeBenchのようなベンチマークとは違い、課題の集合は時間とともに更新されない。したがって、現在および将来のモデルはすべて、関連するコードベース、その経時的な変更、さらには課題そのものでも学習している可能性が高いと考えてよい。これらの公開リポジトリは学習データの重要な供給源だからである。実際、Huggingfaceでは、The StackやSWE-Fixerなど、GitHubの課題やPRを収めた公開データセットが見つかる。
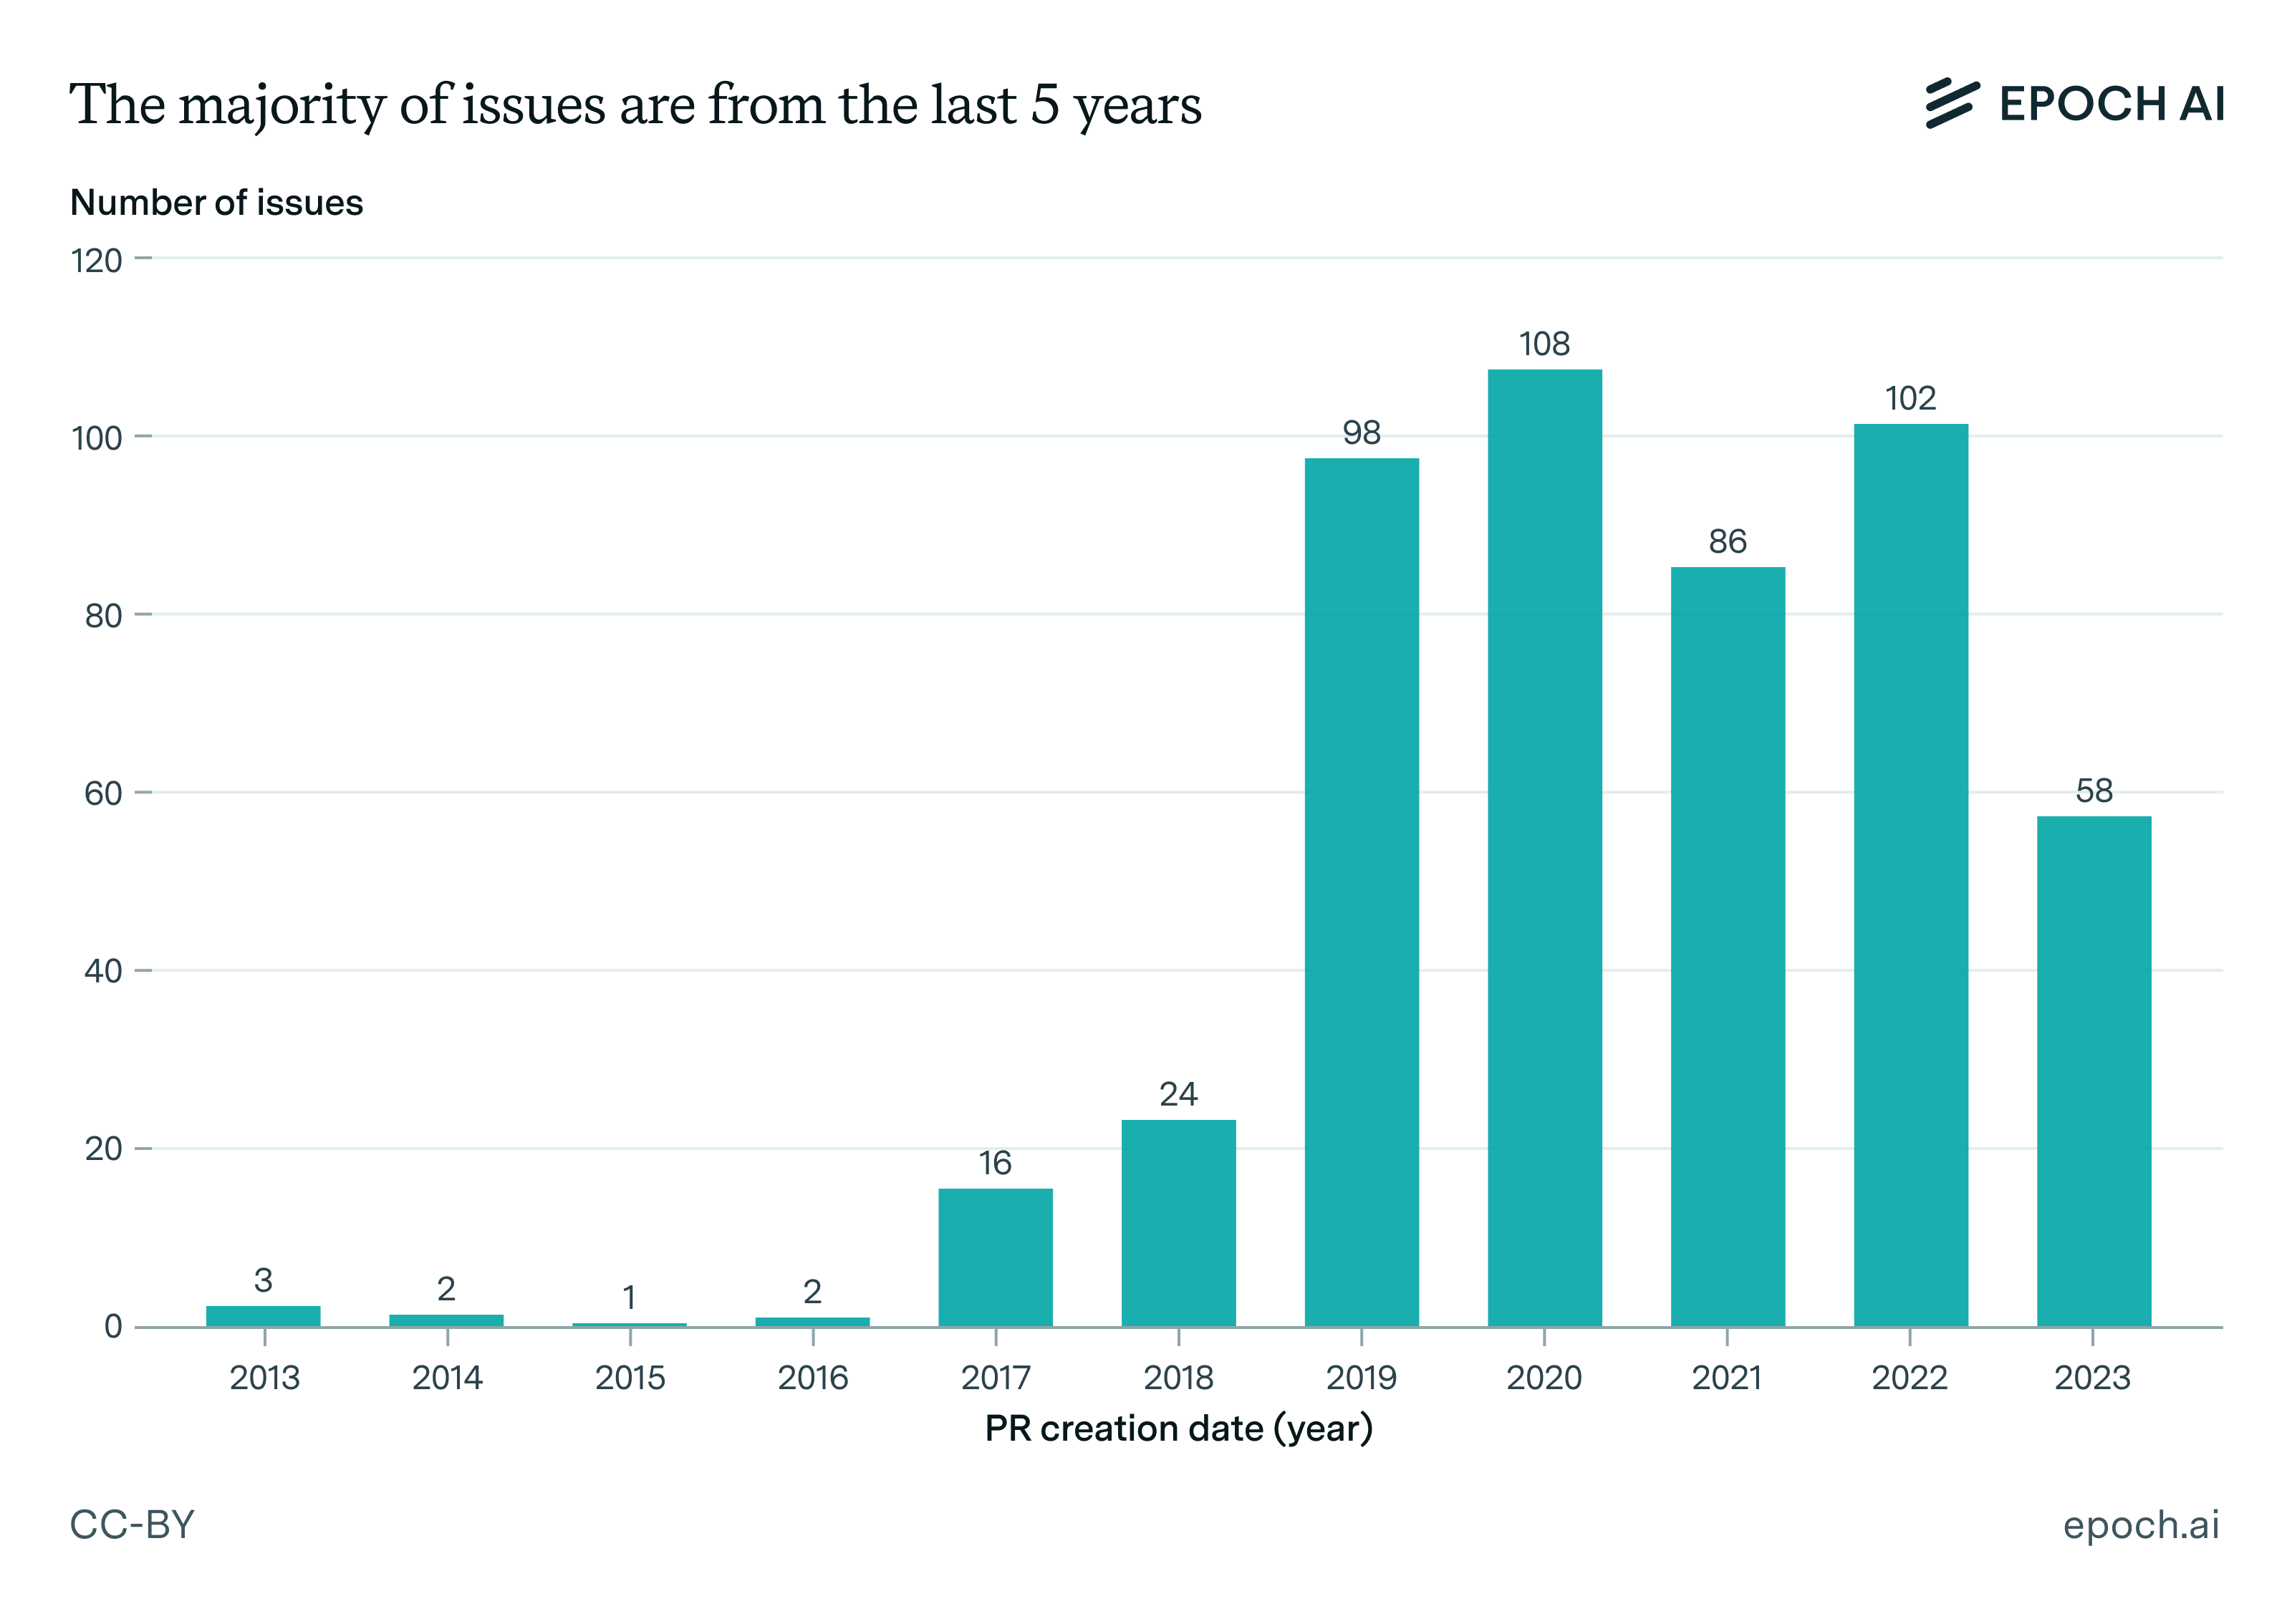
SWE-bench Verifiedの課題の半分は2020年以前のもので、中には12年前にまでさかのぼるものもある。比較のために言えば、2020年に公開されたPython 3.9は、2025年10月にサポート終了(EOL)を迎える。その結果、このベンチマークはしばしば、まもなく廃止されるPythonの機能を使ったコードベースでの作業をモデルに求めることになる。
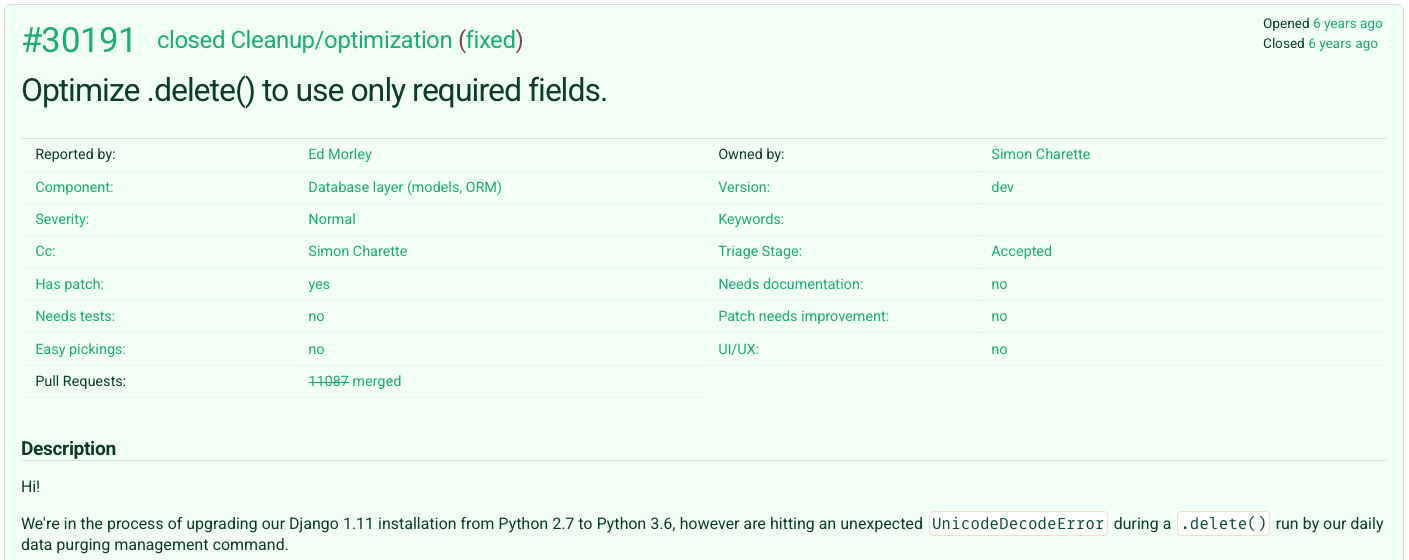
スクリーンショットの課題(こちらで見られる)は、Python 2から3への切り替えにあたってDjangoプロジェクトをバージョン間で移行するという内容で、EOLの数か月前の2019年に作られた。同様の課題をいくつか見つけたが、それらのバグを修正したコードは、今でも動くPythonの機能を使っていた。古いコードベースを扱うことは確かに現実のソフトウェアエンジニアリングの一部であり、企業はソフトウェアの更新が遅く、EOLを過ぎても使い続ける。しかしPythonの利用者は全体として、新しいPythonのバージョンをすぐに取り入れる傾向があり、型ヒントのような機能はますます普及している。課題の日付とリポジトリの選び方は、こうした「現代的な」機能を捉えていない。
足場はモデルと同じくらい重要である
SWE-bench Verifiedのリポジトリでは、モデルはコードを生成するだけでなく、コードベースを能動的に操作しなければならない。そのためにモデルは、足場(スキャフォールド)の中で動く。足場とは、専用のツール、構造化されたプロンプト、管理された環境を提供し、モデルがファイルを編集したりディレクトリを移動したりできるようにする枠組みである。足場の中には、複数の解の生成、実行時エラーの確認、コンテキストウィンドウの管理といった高度な推論実行の手法を備えるものもある。
たとえば、SWE-Agentの足場は、GPT-4oやClaude Sonnetなどさまざまなモデルで動く。一度に100行だけを表示する専用のファイルビューア、リンターを組み込んだ編集ツール、ディレクトリ内の文字列を検索する独自のツールを備えている。これらのツールを使うと、標準のシェルコマンドだけを使うより高い性能が出る。
優れた足場は性能を最大20%高めうる6。つまり、SWE-bench Verifiedでの性能は、基盤となるモデルの能力と同じくらい、足場の洗練度を反映している。私たちの実行では、InspectフレームワークとSWE-Agent 1.0.1のツールを使っているが、提供されたツールを呼び出せないことが多いモデルがあり、その場合はその問題の実行が失敗に終わった。開発元はモデルを一部の足場に重点を置いて最適化しているので、別のツールで評価すると性能が引き継がれないことになる。
この足場への依存には、三つの大きな意味合いがある。第一に、ある足場での結果は別の足場に引き継がれないことが多いため、ベンチマークのスコアの解釈が難しくなる。第二に、SWE-bench Verified専用に最適化された足場は、現実のコーディング作業に一般化しないかもしれない。第三に、足場の選択が評価費用の大きな要因になる。ある足場は、複数の解答の試みを生成してから最良のものを選び、より高い費用でより高い性能を達成する。注目したい重要な指標の一つは、単一の試行でのpass@1スコアである。こちらのほうが、Claude Codeのようなツールでの実際の利用体験に近いからである。
結論
SWE-bench Verifiedが主に試しているのは、モデル(とそれに付随する足場)がPythonのコードベースの中を探り、明確な記述のある、範囲のはっきりした小さな課題を修正する能力である。孤立したLeetCode風の問題でモデルを評価するベンチマークに比べれば、エージェント型コーディングのはるかに現実的なテストである。モデルは、現実の問題に直面した実際の利用者が提出した課題を修正しなければならず、複雑なコードベースのどこを変更すべきかを見つけるためにツールをうまく使わなければならない。大規模で徹底した人手のアノテーションが行われ、すべての課題がコードベースの保守担当者にマージされたものなので、問題の質の高さは保証されている。
しかし、SWE-bench Verifiedで使われているコードベースとその課題は、すべて公開されている。つまり、モデルはこれらのコードベースになじんでいる可能性が高く、汚染のリスクが高い。そのため、これらの結果をソフトウェアエンジニアリング全体に一般化するのは難しい。ほとんどのエンジニアは、モデルがなじんでいないクローズドソースのコードベースで仕事をしているからである。コードベースの多様性の低さ(5つのリポジトリがベンチマークの問題の80%超を占める)と、一部の課題の古さも、注意しておくべき点である。
全体として、SWE-bench Verifiedはソフトウェアエンジニアリングの仕事の全体像を捉えておらず、なじみのあるオープンソースのPythonリポジトリでのバグ修正という狭い一部分だけを扱っている。それでも、SWE-bench Verifiedで高いスコアに達するということは、人間のエンジニアが、システム設計、新機能の開発、創造的な問題解決など、このベンチマークが捉えていない作業に専念できるということを意味する。
注
-
たとえば、この課題はFutureWarningを使うよう提案しているが、PRでは使われていない。別の例として、Djangoリポジトリのこのチケットは、モデルが参照できないテストパッチに言及している。↩
-
上限を見積もるため、意図的に非常に厳しく評価した。厳しい評価の例を挙げると、この課題は負の時間数で失敗することに明示的に言及しているが、テストスイートはもっと一般的で、負の分数についてもテストしている。私たちはこの課題を誤った課題とした。↩
-
Wang et al.は、モデルが生成したパッチの一部が、テストスイート全体を実行するとリグレッションを引き起こすことを見いだした(SWE-bench Verifiedは、テストパッチに含まれるファイルのテストしか使わない)。さらに彼らは、リポジトリのテストスイートがありうるバグをすべて捕捉できるとは限らず、そのためにテストは通るが新しいバグを持ち込むパッチをモデルが生成しうると評価している。ただし、正解パッチでしか通らない新しいテストを導入すると、すべてのテストを通るパッチをモデルが生成するのは、不可能とまではいかなくても難しくなる。↩
-
METRは、エンジニアにSWE-bench Verifiedの課題を6件修正させた。そのうち4件は「15分未満の修正」の区分のもので、エンジニアが修正にかかった時間は8分、26分、67分、84分だった。残りの2件は「1時間〜4時間」の区分のものだった。ただし、標本の大きさ(ベンチマークの1%)は、強い結論を引き出すには小さすぎる。さらに、エンジニアがそれぞれのリポジトリにどれだけ通じていたかは明らかにされていない。↩
-
SWE-bench Multimodalの著者らは、モデルが学習データのカットオフ日以降の課題のほうで良い性能を示したことを見いだした。ただし、標本が小さすぎるうえ、それらの課題はベンチマークの他の課題より易しい可能性がある。↩
-
Claude 3.7の性能は独自の足場を使うと62.3%から70.2%に上がり、4oの性能は「SWE-Agent」の足場での23%から「Agentless」の足場での33.2%に上がる。DeepSeek R1-0528は私たちのツールでは33%の性能だが、DeepSeekはAgentlessの足場で57.6%と報告している。↩