
レポート
OSWorldは、AIのコンピュータ操作能力について何を教えてくれるのか?
原題:What does OSWorld tell us about AI’s ability to use computers?
OSWorldは、大規模言語モデルをコンピュータ操作のタスクで評価するベンチマークである。モデルにはタスクの指示とUbuntuの仮想マシンが与えられ、タスクを遂行するための操作を実行しなければならない。
- 規模:コンピュータ操作のタスク361件
- データの出所:人間、フォーラム、チュートリアルなど
- 採点方法:評価関数
- 汚染のリスク:中
AIシステムがデジタルな同僚になるには、コンピュータを使えなければならない。本稿では、この節目に向けた進歩を測るために設計された人気のベンチマーク、OSWorldを検証する。このベンチマークには何が含まれているのか。進歩をどう解釈すべきか。そして、AIシステムがほぼ満点を取る、つまりこのベンチマークを飽和させたとき、それは何を意味するのか。
主なポイント
- OSWorldの飽和とは、モデルが、よく使われるオープンソースのアプリケーションを使って、Linuxベースの環境で簡単で現実的なタスクを実行できることを意味する。たとえば、文書にページ番号を付ける、スプレッドシートからCSVファイルを書き出す、といったタスクである。
- このベンチマークは時期によって内容が変わるので、時期をまたいで結果を比べるのは難しい。
- 7月の大型アップデートは、タスクの指示の大半に影響した。それ以降も、タスクの指示の約10%が更新されている。
- タスクの約10%はインターネットのライブデータに依存している。つまり、Webサイトが変わるにつれて、これらのタスクの難易度や実行可能性が時間とともに変わりうる。
- OSWorldの多くは、グラフィカルユーザーインターフェース(GUI)をほとんど、あるいはまったく使わずにこなせる。つまり、スコアからわかるAIのGUI操作能力は限られている。
- タスクの約15%は端末(ターミナル)しか必要としない。
- さらに30%のタスクは、想定されたGUI操作の多くを、端末の操作やPythonスクリプトで置き換えてこなせる。
- 多くのタスクには、ややあいまいな指示がある。そのため、スコアは純粋なコンピュータ操作能力だけでなく、指示を正しく解釈する能力も部分的に測っている。
- タスクの約10%には、タスクを無効にしてしまう深刻な誤りがある。この割合は多くのベンチマークと同程度である。
これらの事実を踏まえると、OSWorldで報告されたスコアの差を解釈するのは難しい。差は、GUIベースのコンピュータ操作能力によって生じているのかもしれないが、ベンチマークのデータの変更、端末やPythonを使う能力、あいまいな指示を解釈する能力によって生じている可能性もある。
この検証を書き終えての感想をまとめると、現実的で、かつ厳密なコンピュータ操作のベンチマークを作るのは難しい、ということになる。OSWorldのチームの取り組みには大きな敬意を抱いている。
OSWorldの設定と評価
ベンチマークのタスクは、次のような形でモデルに提示される。
- 実行すべきタスクを説明する指示。
- Ubuntuの仮想マシン。空のデスクトップから始まることもあれば、特定のアプリケーションが開かれた状態から始まることもある。マシンはインターネットに接続されている。
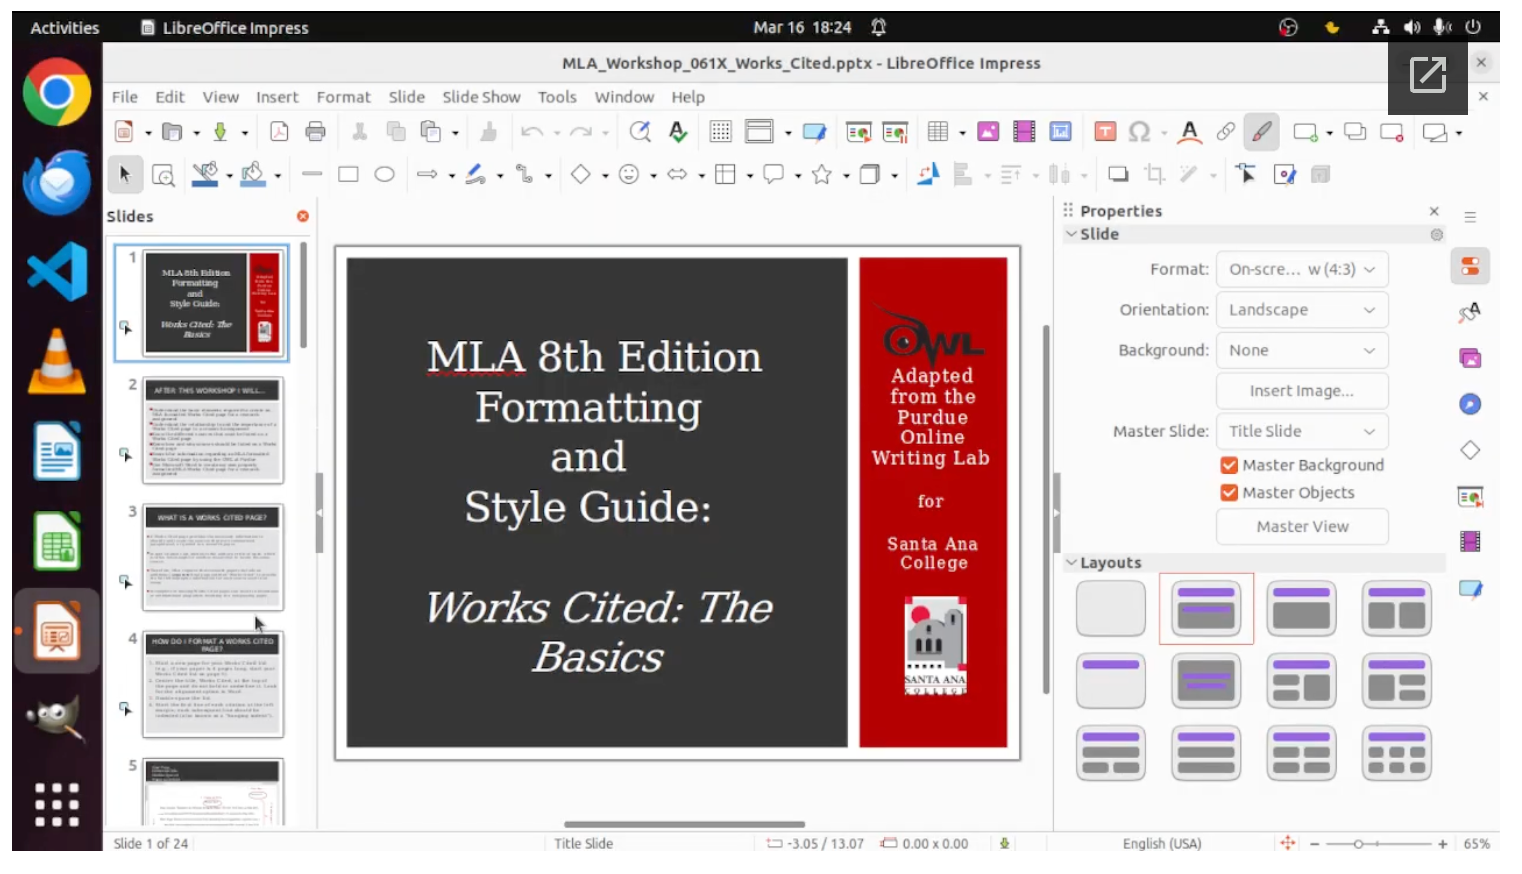
タスクの開始状態の例。LibreOffice Impressのファイルが開かれている。
タスクの指示は「最後の2枚のスライドを複製してください。」である。
タスクは、ベンチマークの作成者自身が用意したもののほか、フォーラムやチュートリアルなどの資料から取られている。
評価用のスキャフォールドは、設定を説明する汎用のプロンプトを与え、マシンの状態をモデルに見せる。1モデルは、マウスとキーボードをプログラムで制御するためのパッケージであるpyautoguiを使ってPythonコードを書くことで、マシンを操作する。
モデルがタスクを終えると、マシンの状態が、指定された目標の状態に達しているかどうかで評価される。途中の手順は評価されない。予想外の、あるいは意図されていない一連の操作で目標の状態に達しても、モデルが減点されることはない。2
OSWorldは361件のタスクからなる。3タスクの約8%は、遂行が不可能になるように作られている。典型的には、アプリケーションがサポートしていないことを指示が求めているためである。そうした場合、モデルはそのタスクが実行不可能だと述べることになっている。
OSWorldのタスクの指示は継続的に更新されており、時期をまたいだ比較の価値ははっきりしない
OSWorldの開発チームは、タスクの指示の改善を続けている。2025年7月の大型リリースでは、タスクの指示と評価関数の大半が更新された。それ以降も、さらに10%のタスクの指示が変更されている。修正前の誤りのせいでタスクが不必要に難しく、あるいは不可能になっていたのなら、その分だけ、モデルの能力が時間とともに向上したかのように見えてしまう。誤りを修正する努力は称賛に値するが、ライブではないベンチマークとしてはきわめて異例のやり方であり、時期をまたいだ比較の意味を弱めてしまう。
OSWorldの飽和とは、モデルが、よく使われるオープンソースのアプリケーションを使って、Linuxベースの環境で簡単で現実的なタスクをこなせることを意味する
全体として、タスクは実用的な現実の作業の流れ、つまり人々がコンピュータで日常的に行っている種類の作業をよく代表していると私たちは判断した。ほとんどのタスクは人間の基準では比較的簡単で、典型的には、より大きな作業の一部分である。すべてのタスクがLinuxのUbuntuディストリビューションを使い、それに標準で同梱されているオープンソースのアプリケーションを中心としている。4
ほとんどのタスクは簡単である
OSWorldのタスクの複雑さを把握するため、Abhyankar et al.は、各タスクの完了に必要な最小限の基本操作(クリック、テキスト入力、キーボードコマンド)の数を分析した。その分析によれば、ほとんどのタスクは10ステップ未満で完了できる。数十、あるいは数百ステップを要するタスクも少しはあるが、大半のタスクは、人間ならほんの数分で終わる作業にあたる。5
タスクの長さは使うプログラムによっていくらか異なり、LibreOffice Calc(オープンソースの表計算ソフト)のタスクや、複数のアプリケーションにまたがるタスクでは、比較的多くのステップが必要になる。
ステップ数が中央値(6)のタスクの例は、画像の編集である。開始時点で、画像はすでにGIMPで開かれている。
Could you fill the background layer with green color, leaving the object layer as is?〔訳:オブジェクトのレイヤーはそのままにして、背景のレイヤーを緑色で塗りつぶしてもらえますか?〕
ずっとまれな、より手の込んだタスク(104ステップ)は、多肢選択式のテストを採点し、そのデータをスプレッドシートに入力するものである。
I am grading students' English exam papers, but the test consists only of multiple-choice questions. It's too exhausting to check each question one by one and record the detailed scores. Can you help me compare the remaining students' answers with the answer key and record the detailed scoring in the opened spreadsheet?〔訳:生徒の英語の試験答案を採点しているが、試験は多肢選択式の問題だけでできている。1問ずつ確認して詳しい点数を記録するのは疲れすぎる。残りの生徒の解答を解答キーと照らし合わせ、開いているスプレッドシートに詳しい採点を記録するのを手伝ってもらえるか?〕
20ステップを超えるタスクは約12%で、50ステップを超えるものはわずか5%である。こうした長めのタスクは比較的まれなので、タスクの長さがモデル間の性能差の大きな要因になるとは考えていない。
タスクではさまざまなアプリケーションが使われる
OSWorldには、Webブラウザ、コードエディタ、スプレッドシート、画像エディタなど、よく使われるアプリケーションにまたがる多様なタスクがそろっている。
タスクの約3分の1は、複数のアプリケーションにまたがる操作を必要とする。たとえば、ファイルをダウンロードして、別のアプリケーションで処理するといったものである。タスクはアプリケーションの区分にわたってかなり均等に分布している。タスクは全般に、現実の作業の流れに即したものだと私たちは判断した。
名前にあるOSはLinuxで、アプリケーションはオープンソースだが、これはおそらく大きな問題ではない
OSWorldのタスクの設定はすべて、Ubuntuと、LibreOffice、Chrome、GIMPのようなオープンソースやフリーウェアのアプリケーションを使う。当然ながら、WindowsとMicrosoft Officeのほうがはるかに広く使われており、そうした環境で同様のタスクを行う正確な手順は異なるだろう。つまり、このベンチマークは、最もよくあるコンピュータ操作の場面を直接代表してはいない。
この種のずれがあると、一般には、ベンチマークでの性能が現実の有用性に結びつかないのではないかと心配になる。だが、OSWorldの場合はむしろ懸念が逆向きである。モデルの開発者がもっと普及しているOSやアプリケーションに力を注げば、OSWorldのスコアは実際に関係する能力より遅れて伸びるかもしれない。全体として、これは大きな問題ではないだろうと私たちは考えている。領域をまたいだ転移を示す証拠がいくらかあり、主要な開発者は利用できるあらゆるOSのデータで学習させるだろうと考えられるからだ。6
端末の操作とPythonスクリプトでかなりのことができる
「コンピュータ操作」という言葉から思い浮かぶのは、GUIをあちこちクリックする姿である。そのため、OSWorldのタスクのほぼ半分がGUIの操作をほとんど、あるいはまったく必要としないと知って、私たちは興味を引かれた。
タスクの約15%は端末だけでこなせる
端末を使うことは、広い意味でのコンピュータ操作の一部であり、OSWorldのタスクの一部もこれを反映している。たとえば、次は端末からプログラムを強制終了するタスクである。
Hey, my LibreOffice Writer seems to have frozen and I can't get it to close normally. Can you help me force quit the application from the command line? I'm on Ubuntu and I don't want to restart my computer or lose any other work I have open.〔訳:LibreOffice Writerがフリーズしたみたいで、普通に閉じられない。コマンドラインからアプリケーションを強制終了するのを手伝ってもらえる? Ubuntuを使っていて、コンピュータを再起動したり、開いている他の作業を失ったりはしたくない。〕
他のタスクでは、GUIでポイントしてクリックするのではなく端末を使うのが想定された作業の流れなのかどうかが、それほどはっきりしない。たとえば、このタスクはVS Codeの拡張機能をインストールするものである。これは端末のコマンド(code --install-extension /home/user/test.vsix)でも、GUIでも行える。
Please help me install an extension in VS Code from a local VSIX file "/home/user/test.vsix".〔訳:ローカルのVSIXファイル「/home/user/test.vsix」から、VS Codeに拡張機能をインストールするのを手伝ってください。〕
幅広いコンピュータ操作をカバーするように設計されたベンチマークとしては、こうしたタスクは適切に思える。ただし、結果を解釈するときには、こうしたタスクがあることを踏まえなければならない。あるモデルがこのベンチマークで向上したとしても、主に向上したのは端末の操作かもしれず、「コンピュータ操作」のベンチマークと聞いてすぐに思い浮かぶGUI操作が向上したとは限らない。
タスクの約30%では、GUI操作の多くを端末の操作やPythonスクリプトで置き換えられる
関連して、想定された作業の流れではGUIを使うものの、端末とPythonスクリプトを使うことで必要なGUI操作を大幅に減らせるタスク群もある。これは特にスプレッドシートのタスクに当てはまる。スプレッドシートをプログラムで編集するためのPythonパッケージがあるからだ。
たとえば、スプレッドシートの編集についての次のタスクを考えてみよう。
Fill all the blank cells in B1:E30 with the value in the cell above it.〔訳:B1:E30の空白のセルをすべて、その上のセルの値で埋めよ。〕
モデルは、タスクがどのスプレッドシートを指しているのかを判断するために環境とやり取りする必要がある(このタスクの設定では、LibreOffice Calcがこのスプレッドシートを開いた状態で始まる)。だがそれ以外は、Pythonスクリプトを使ってスプレッドシートの変更を実現できる。もちろん、人間はこのタスクをこうはやらない。しかし、コードのほうが「得意」なモデルはこのやり方をとるかもしれず、OSWorldの評価はそれを減点しない。
公式のリーダーボードを見ると、コード実行ツールを使えるモデルは、GUIだけのエージェントよりかなり高いスコアを出している。こうしたモデルが、GUI操作を避けるのに役立ちそうなソフトウェアパッケージ、たとえばスプレッドシートを操作するためのopenpyxlを使う例が数多く見られる。実は、スキャフォールドにコード実行ツールが含まれていないモデルが、それでもこうしたパッケージをダウンロードする例もいくつか見られる。下のスクリーンショットは、一連の文書から連絡先情報を抜き出してExcelの表に整理するよう求めるタスクで、Claude Sonnet 4がopenpyxlとpandasをインストールしているところである。
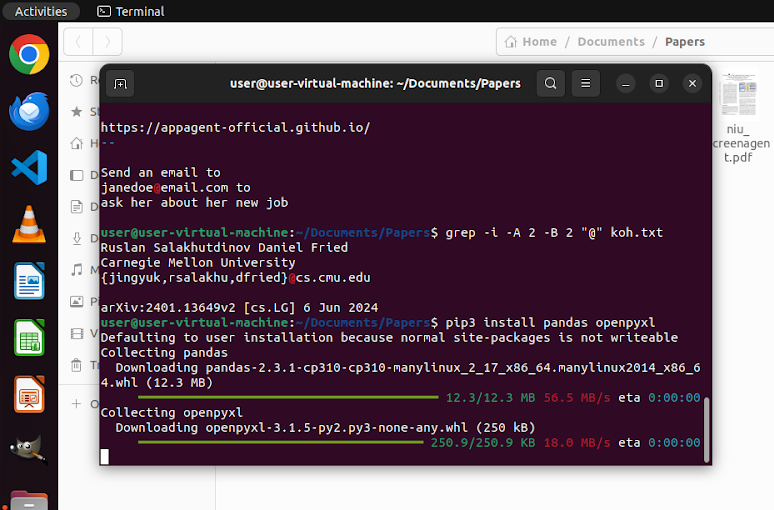
このふるまいがどれほど広く見られるかは定量化していないが、確かに起きている。
多くの指示はあいまいすれすれで、指示の意図を見抜くことが成功の大きな部分を占める
一見してあいまいなタスクが多いことに私たちは気づいた。よく調べると、妥当な推測ができることが多く、その推測はしばしば正解の結果と一致した。ある意味では、これはきわめて現実的である。人間はAIアシスタントにややあいまいなタスクを与えることがあり、アシスタントが妥当な推測をできるのは確かに望ましい。7
しかし、これがタスクの中で群を抜いて難しい部分になっているように見える場合があまりに多いことに、私たちは驚いた。たとえば、プレゼンテーションの編集についての次のタスクを考えてみよう。
Align the first textbox on slide 3 to the right, on slide 4 to the center, and on slide 5 to the left. Ensure that the alignment is applied correctly to each respective slide.〔訳:スライド3の最初のテキストボックスを右に、スライド4では中央に、スライド5では左に揃えよ。それぞれのスライドに揃えが正しく適用されるようにせよ。〕
このタスクの一つ目のあいまいさは、「揃える(align)」がテキストボックスの中のテキストを指すのか、テキストボックスそのものを指すのかである。つまり、モデルはテキストボックスの位置はそのままにして中のテキストの揃え方を変えるべきなのか、それともテキストはそのままにしてテキストボックスを動かすべきなのか?
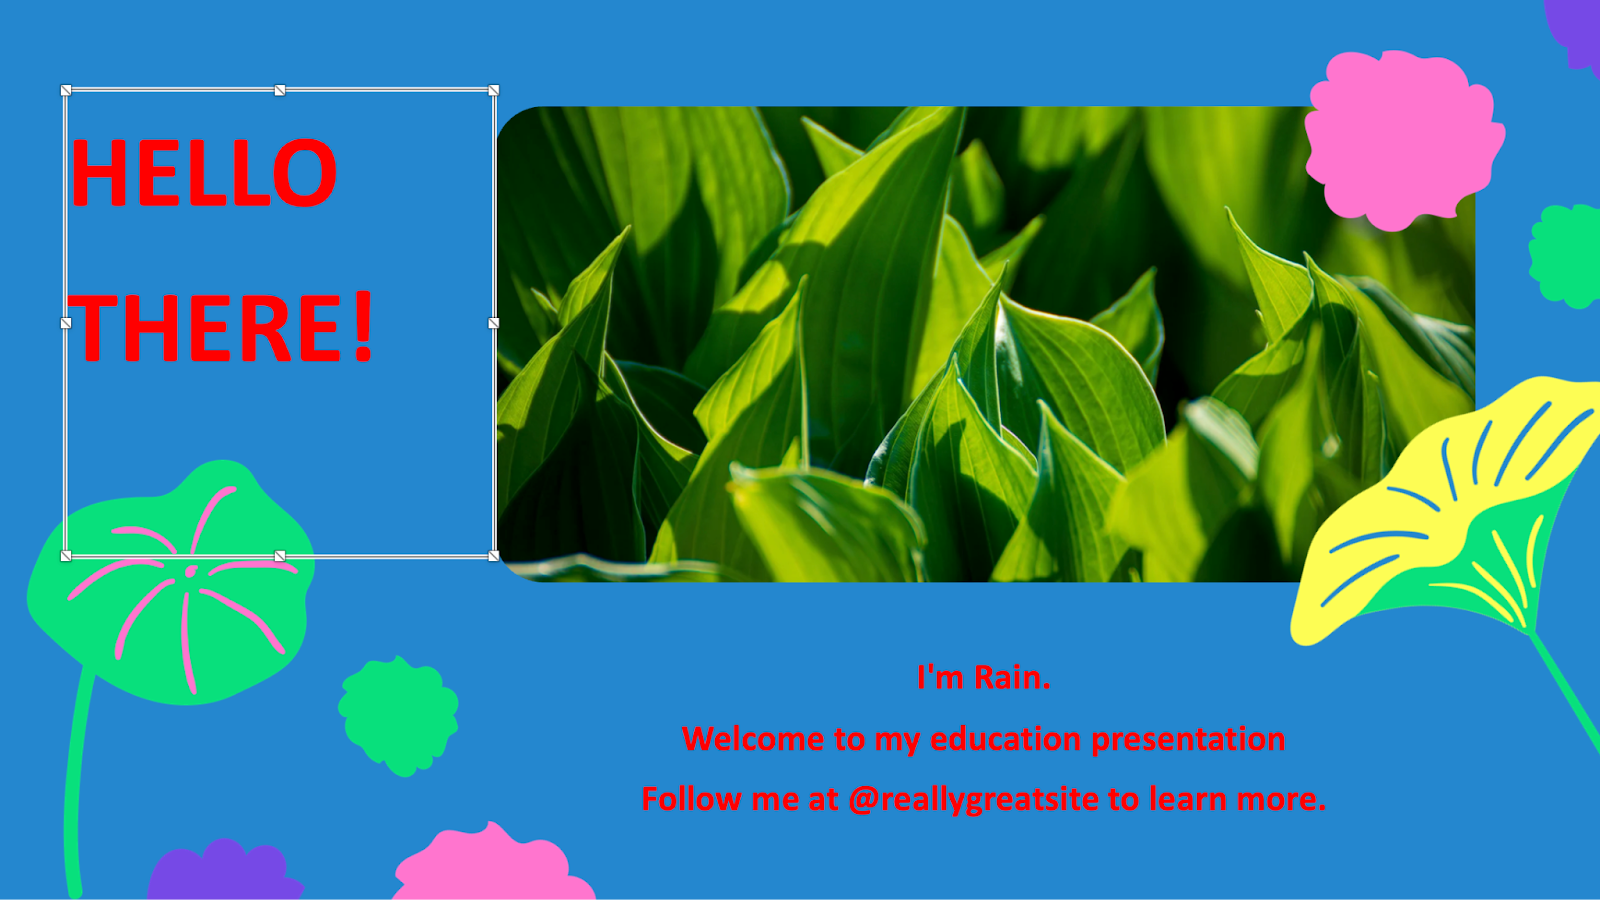
対象ファイルのスライド3。該当するテキストボックスが選択されている。
筆者の一人はこれをあいまいだと感じたが、もう一人は「揃える」という言葉はテキストそのものと結びつく意味のほうがはっきりしていると感じた。
しかし、あいまいさはさらに深まる。該当するスライドのうち2枚では、複数のテキストボックスが一つのオブジェクトに「グループ化」されている。指示が「最初のテキストボックス」と言うとき、それはグループ内のすべてのボックスを指すのか、それとも一番上のボックスだけなのか? あるいは、グループ化されたオブジェクトを動かして、テキストそのものはそのままにすべきではないか、と考え直すべきなのか?
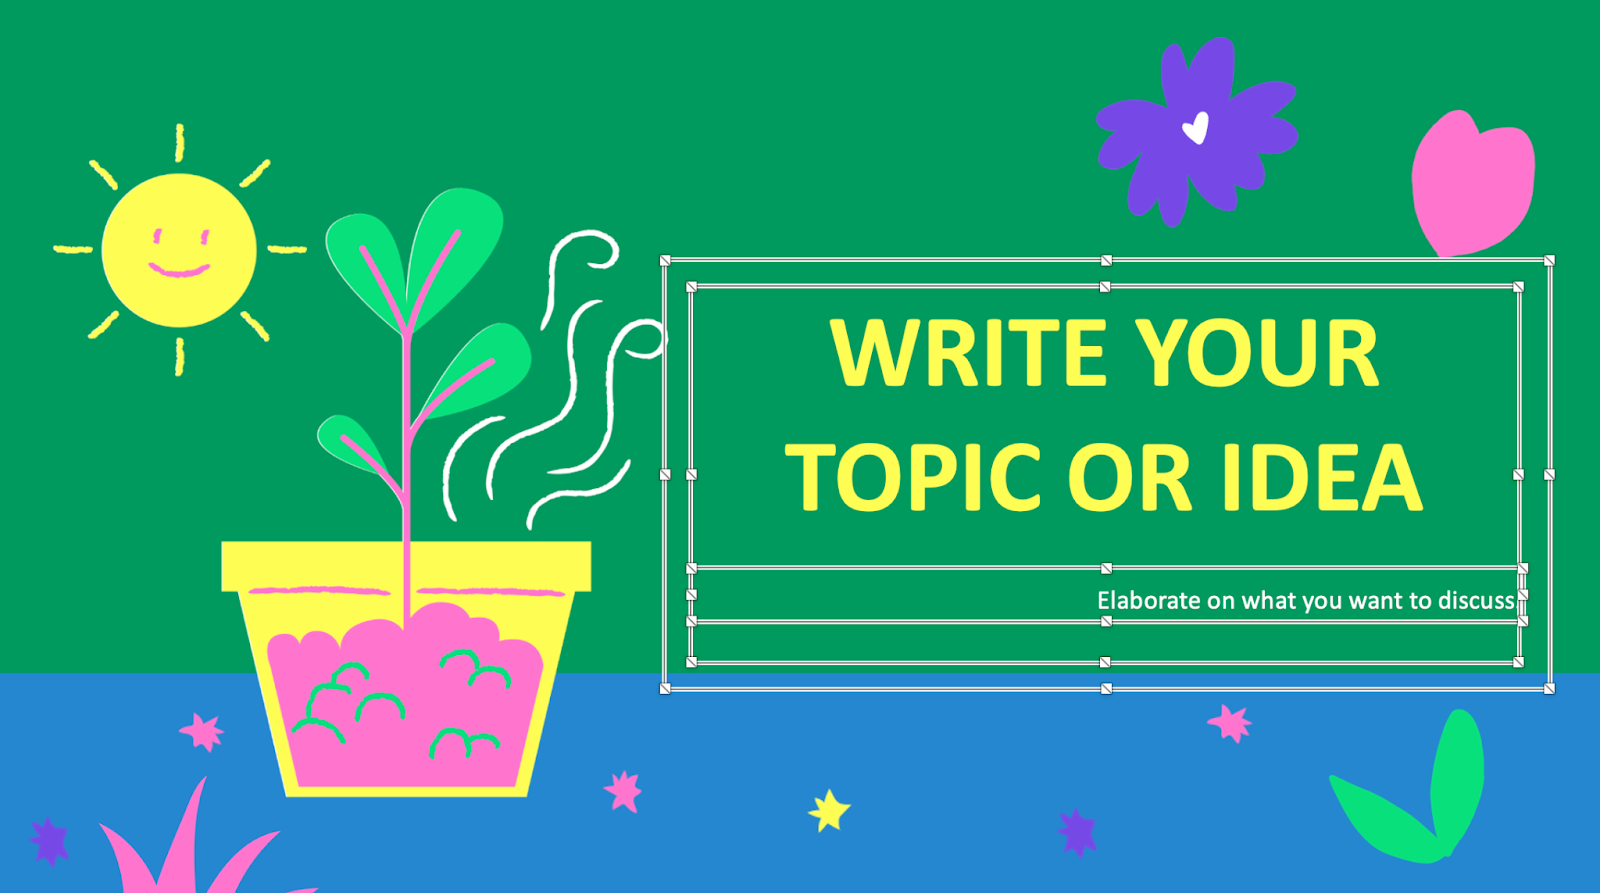
対象ファイルのスライド4。該当するグループオブジェクトが選択されており、それを構成する2つのテキストボックスが表示されている。
ここでも、筆者の一人はこれを致命的にあいまいだと感じたが、もう一人は、各グループ内の最初の(一番上の)ボックスの中のテキストだけを揃えるのが最善の推測だと感じた。そして実際、これがこのタスクの意図された解だった。
どのタスクのあいまいさが許容できる程度で、どのタスクが許容できないかについて、すべての読者が同意するとは考えていない。私たちの間では、タスクに関係する成果物(スライド、画像、コード)を作るときの一般的な慣習によく通じている人ほど、そのタスクの指示を致命的にあいまいだと感じにくいことがわかった。
いずれにせよ、このあいまいさを切り抜けることは、コンピュータのプログラムを使える能力とは別のスキルである。モデルは、OSWorldのタスクを完了するのに必要なコンピュータ操作のスキルをすべて備えていても、指示の意図された意味について妥当だが誤った推測をすれば失敗しうる。
この問題は主観的な性質のものなので、タスクの何%がこの部類に入るかを推計するのは難しい。とはいえ、元のOSWorldの論文での人間の基準は72%だったことは指摘できる。ここから、あいまいさが影響しているタスクは28%以下だと考えられる。8
OSWorldのタスクの約10%には深刻な誤りがある
これはAIのベンチマークとして珍しい誤りの率ではない。以下では、タスクの中に見つかったよくある誤りの種類をいくつか挙げる。
単純な形で壊れているタスクもある。たとえば、評価関数は計算によって出力される最終的な数値を確認するが、正解とされる数値が間違っている、といったものである。9
また、厳しすぎる評価関数や甘すぎる評価関数も見られた。厳しい評価関数の例として、次のタスクを考えてみよう。
On the current website, show me the cars available for pickup at Boston Logan Intl Airport from the 10th to the 11th of next month, sorted by the number of seats to find the largest capacity.〔訳:今開いているWebサイトで、来月10日から11日にボストン・ローガン国際空港で受け取れる車を、最も定員の多いものがわかるよう座席数順に並べて表示して。〕
指示は単に「10日から11日」と求めているだけなのに、評価関数は両日とも時刻が正午(12PM)に設定されているかを確認する。甘い評価関数の例として、次のタスクを考えてみよう。
The cells are so big that I can not click on the cell I want, zoom out a little bit.〔訳:セルが大きすぎて目当てのセルをクリックできない。少し縮小して。〕
このタスクで開かれるスプレッドシートは260%に拡大されている。ところが、評価関数は、モデルが拡大率を下げたかどうかしか確認しない。ズームバーの特定の場所をクリックすると好きなだけ縮小できることがわかったので、モデルがたとえば実用的でない10%まで縮小しても、成功と判定されてしまう。
また、実際には操作を行うことを求めていないタスクもいくつか見られた。スキャフォールドの一部としてモデルに与えられる汎用のプロンプトは、モデルに操作を行うよう促すものと思われる。だが場合によっては、指示の言い回しのせいで、モデルが単に情報を提供するのではなく操作を行えば、指示の素直な意味を無視することになってしまう。たとえば次のようなものである。
On my surface pro whenever I launch Chrome it always opens "funbrain.com." I don't want this. I cleared my cache but it still happens. What should I do?〔訳:私のSurface Proでは、Chromeを起動するといつも「funbrain.com」が開く。これはやめてほしい。キャッシュを消去したが、まだそうなる。どうすればいい?〕
最後に、どうにも直しようのないあいまいさもあった。たとえば、このタスクで言及されている「IMDB Top 30 list」が何を指しているのか、はっきりした対象は見つけられなかった。
I'm a huge movie fan and have kept a record of all the movies I've watched. I'm curious to find out if there are any films released before 2024 from the IMDB Top 30 list that I haven't seen yet. Help me create another sheet 'unseen_movies' in the opened Excel. This sheet should share the same headers and sort the results according to IMDB rankings from high to low.〔訳:私は大の映画好きで、見た映画をすべて記録している。IMDB Top 30 listのうち、2024年より前に公開されたもので、まだ見ていない映画があるかを知りたい。開いているExcelに「unseen_movies」という別のシートを作るのを手伝って。このシートは同じ見出しを使い、結果をIMDBの順位の高い順に並べること。〕
OSWorldのタスクの約10%はインターネットのライブデータに依存しており、そのため難易度が時間とともに変わりうる
Webブラウザを使い、稼働中のWebサイトからデータを取り出すことに依存するタスクもある。こうしたタスクは、Webサイトや元になる情報が変わるにつれて、難易度が変わったり、実行不可能になったりしうる。
特に壊れやすい例として、TripAdvisorでホテルを探すようモデルに求める次のタスクを考えてみよう。
Find a Hotel in New York City with lowest price possible for 2 adults next weekend.〔訳:来週末、大人2人でニューヨーク市のホテルをできるだけ安い価格で探して。〕
このタスクの評価スクリプトは、モデルが移動した先のWebサイトに特定のHTML要素があるかを確認するのに、厳密な絶対XPathに頼っている。TripAdvisorのサイトの構造が更新されれば、このタスクは解けなくなる。Webを使う他のタスクはそれほど壊れやすくはないが、その多くは特定のURLが存在し続けることに依存している。
結論
OSWorldは、AIシステムが、よく使われるオープンソースのアプリケーションを使ってLinuxベースの環境で簡単で現実的なタスクをどれだけうまく実行できるかを知る手がかりになる。最高水準のモデルは、このベンチマークで10%未満から70%近くへと大きく前進した。その多くがコンピュータ操作能力の向上を反映していると言ってよい。
しかし、進歩は慎重に解釈しなければならない。タスクの難易度は時間とともに予測できない形で変わり、多くのタスクはGUI操作をあまり、あるいはまったく使わずにこなせ、指示を解釈するスキルがコンピュータを使うスキルと同じくらい重要な場合もあるからだ。
本稿にフィードバックをいただいたHUDのParth Patelに感謝する。
付録
OSWorldのバージョンと派生版
OSWorldはもともと香港大学のXLANG Labの研究者が開発し、2024年4月に公開した。同じチームは2025年7月、OSWorld-Verifiedと名付けた大型アップデートを行い、多くのベンチマークのタスクを修正した。しかし、一部のベンチマークとは違って、「Verified」という修飾語は定着しなかったようで、最近の言及でもこのベンチマークは単に「OSWorld」と呼ばれている。上で述べたように、XLANGのチームはタスクの指示の更新を続けており、Verifiedの公開以降、10%を超えるタスクが影響を受けている。本稿では、ベンチマークのメインリポジトリにある最近のバージョンを扱い、これを単にOSWorldと呼んでいる。
OSWorldをもとに、さらに派生版のベンチマークが作られている。たとえば次のものがある。
- OSWorld-Human:人間がタスクをどう解くかの注釈を加えたもの。
- OSWorld-Grounding(別名OSWorld-G):OSWorldのタスクと、それらのタスクでのエージェントの行動の軌跡を使って、より細かい単一ステップのタスクを作ったもの。
- OSWorld-MCP:MCPのツールを追加してOSWorldを拡張したもの。
方法
本稿のために、筆者の一人がベンチマークのすべてのタスクを調べ、上で述べたさまざまな観点で分類した。端末だけでこなせるか、想定されたGUI操作を端末の操作とPythonスクリプトで最小限にできるか、深刻な誤りがあるか、という観点である。もう一人の筆者が、これらのタスクの分類から無作為に抽出したものを見直し、セカンドオピニオンを出した。特に断りのない限り、本稿で示した割合は、両筆者があるタスクの分類で一致した割合に基づいている。
注
-
状態は、GUIそのものか、アクセシビリティツリーで示される。↩
-
極端な場合、モデルはオープンソースのOSWorld-Verifiedのデータセットをオンラインで見つけ、目標の状態のうち該当する部分(多くの場合、ファイル一つだけ)をダウンロードすることもできる。このような不正の事例は把握していない。↩
-
これはGoogle Driveを伴う8件のサンプルを除いた数である。Googleアカウントの使用に技術的な難しさがあるため、ほとんどの評価ではこれらを除外している。↩
-
オープンソースではないアプリケーションであるChromeとVS Codeも使われている。↩
-
元の論文は、人間がタスクを完了するまでの時間の中央値を2分と記録している。分布の裾は長く、15分かかったものも「かなりの数」含まれている。人間のテスターは大学生だった。人間が完了に長い時間をかけたタスクのかなりの部分は、GIMPなどの不慣れなアプリケーションの使い方を覚えていたためだろうと私たちは考えている。↩
-
Wang et al.は、OS AとOS Bのデータで学習させると、OS Aのデータだけで学習させるよりも、OS Aでの性能が良くなることを示した。予想どおり、OS Aのデータだけで学習させた場合のOS Bでの性能は、OS Bのデータで直接学習させた場合よりもやはり劣る。↩
-
筆者の一人は、駆け出しのころの職場を思い出して嫌な気分になった。上司はプレゼン資料の書式について(彼にとっては)あいまいな指示を出し、資料が自分の意図と合わないと腹を立てたのである。↩
-
論文は人間の誤りの原因を分析していない。原因は、あいまいな指示、タスクの難しさに対して人間の意欲が足りなかったこと、そして無効なタスク(公開以降に修正されたものもあるが、すべてではない)が混ざったものだと考えている。↩
-
その一例:「表をCSVファイルに書き出し、それから価格の中央値(medium price)を求めるコードを書くのを手伝って(空の値は平均で埋めること)。結果は「result.txt」に保存すること。」私たちが表計算で確かめた答え(25.27)は、results.txtの正解の内容(24.93)と異なる。↩