
ニュースレター
ベンチマークのスコアを超えて:o3-mini の数学的推論を分析する
原題:Beyond benchmark scores: Analyzing o3-mini’s mathematical reasoning
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
これを読んでいる方なら、最高水準の言語モデルが数学の問題を解くことで目覚ましい進歩を遂げてきたことを、きっと耳にしているだろう。たとえば最近、人間の成績を基準として測るために私たちが開いたコンテストで、o4-mini が数学者チームの平均を上回ったことが分かった。
しかし、こうした数字だけでは、これらのモデルが具体的に何をでき、何をできないのか、そしてそれはなぜなのかは、あまり分からない。推論モデルは複雑な数学の問題をどのように解いているのか。人間の数学者と同じように推論しているのか。そして、どこで力が及ばないのか。
こうした問いに答えるため、私たちは14人の数学者に、OpenAI から共有を受けた、FrontierMath の問題に対する o3-mini-high の要約されていない生の推論過程29件を分析してもらった。1本稿の目的は、この調査から得られた主な知見を共有し、それがAIと数学の交差する領域での今後の発展にとって何を意味するのかを論じることである。
Epoch AI の最新情報を受け取る 購読する
o3-mini-high は FrontierMath の問題をどう解いているのか?
並外れた博識——しかも単なる暗記ではない
29件の推論過程のうち13件は正しい答えに至っていた。では、o3-mini-high はこれらの問題をどのように解いているのだろうか。
重要な要因の一つは、その並外れた博識である。これほど大量のデータで学習していることを考えれば、驚くには当たらない。このモデルは幅広い分野にわたる FrontierMath の問題に取り組むことができ、数学者たちは全員一致で、非常に知識が豊富だと認めた。ある数学者は「[o3-mini-high は]問題の数学的背景を正しく展開しており、非常に高度な概念も扱っている[…]。一般的な知識や問題の理解は、ここではボトルネックになっていない」と述べた。
しかも、純粋な暗記というわけでもない。問題を解くのに必要な手法を作問者が意図的に分かりにくくしていた場合でも、数学者たちは総じて、o3-mini-high には正しい定理を持ち出して前進するまずまずの能力があると評価した。具体的には、推論過程の約66%で、数学者たちは関連する数学的結果を持ち出す能力について、モデルに5点満点中3点以上を付けた。
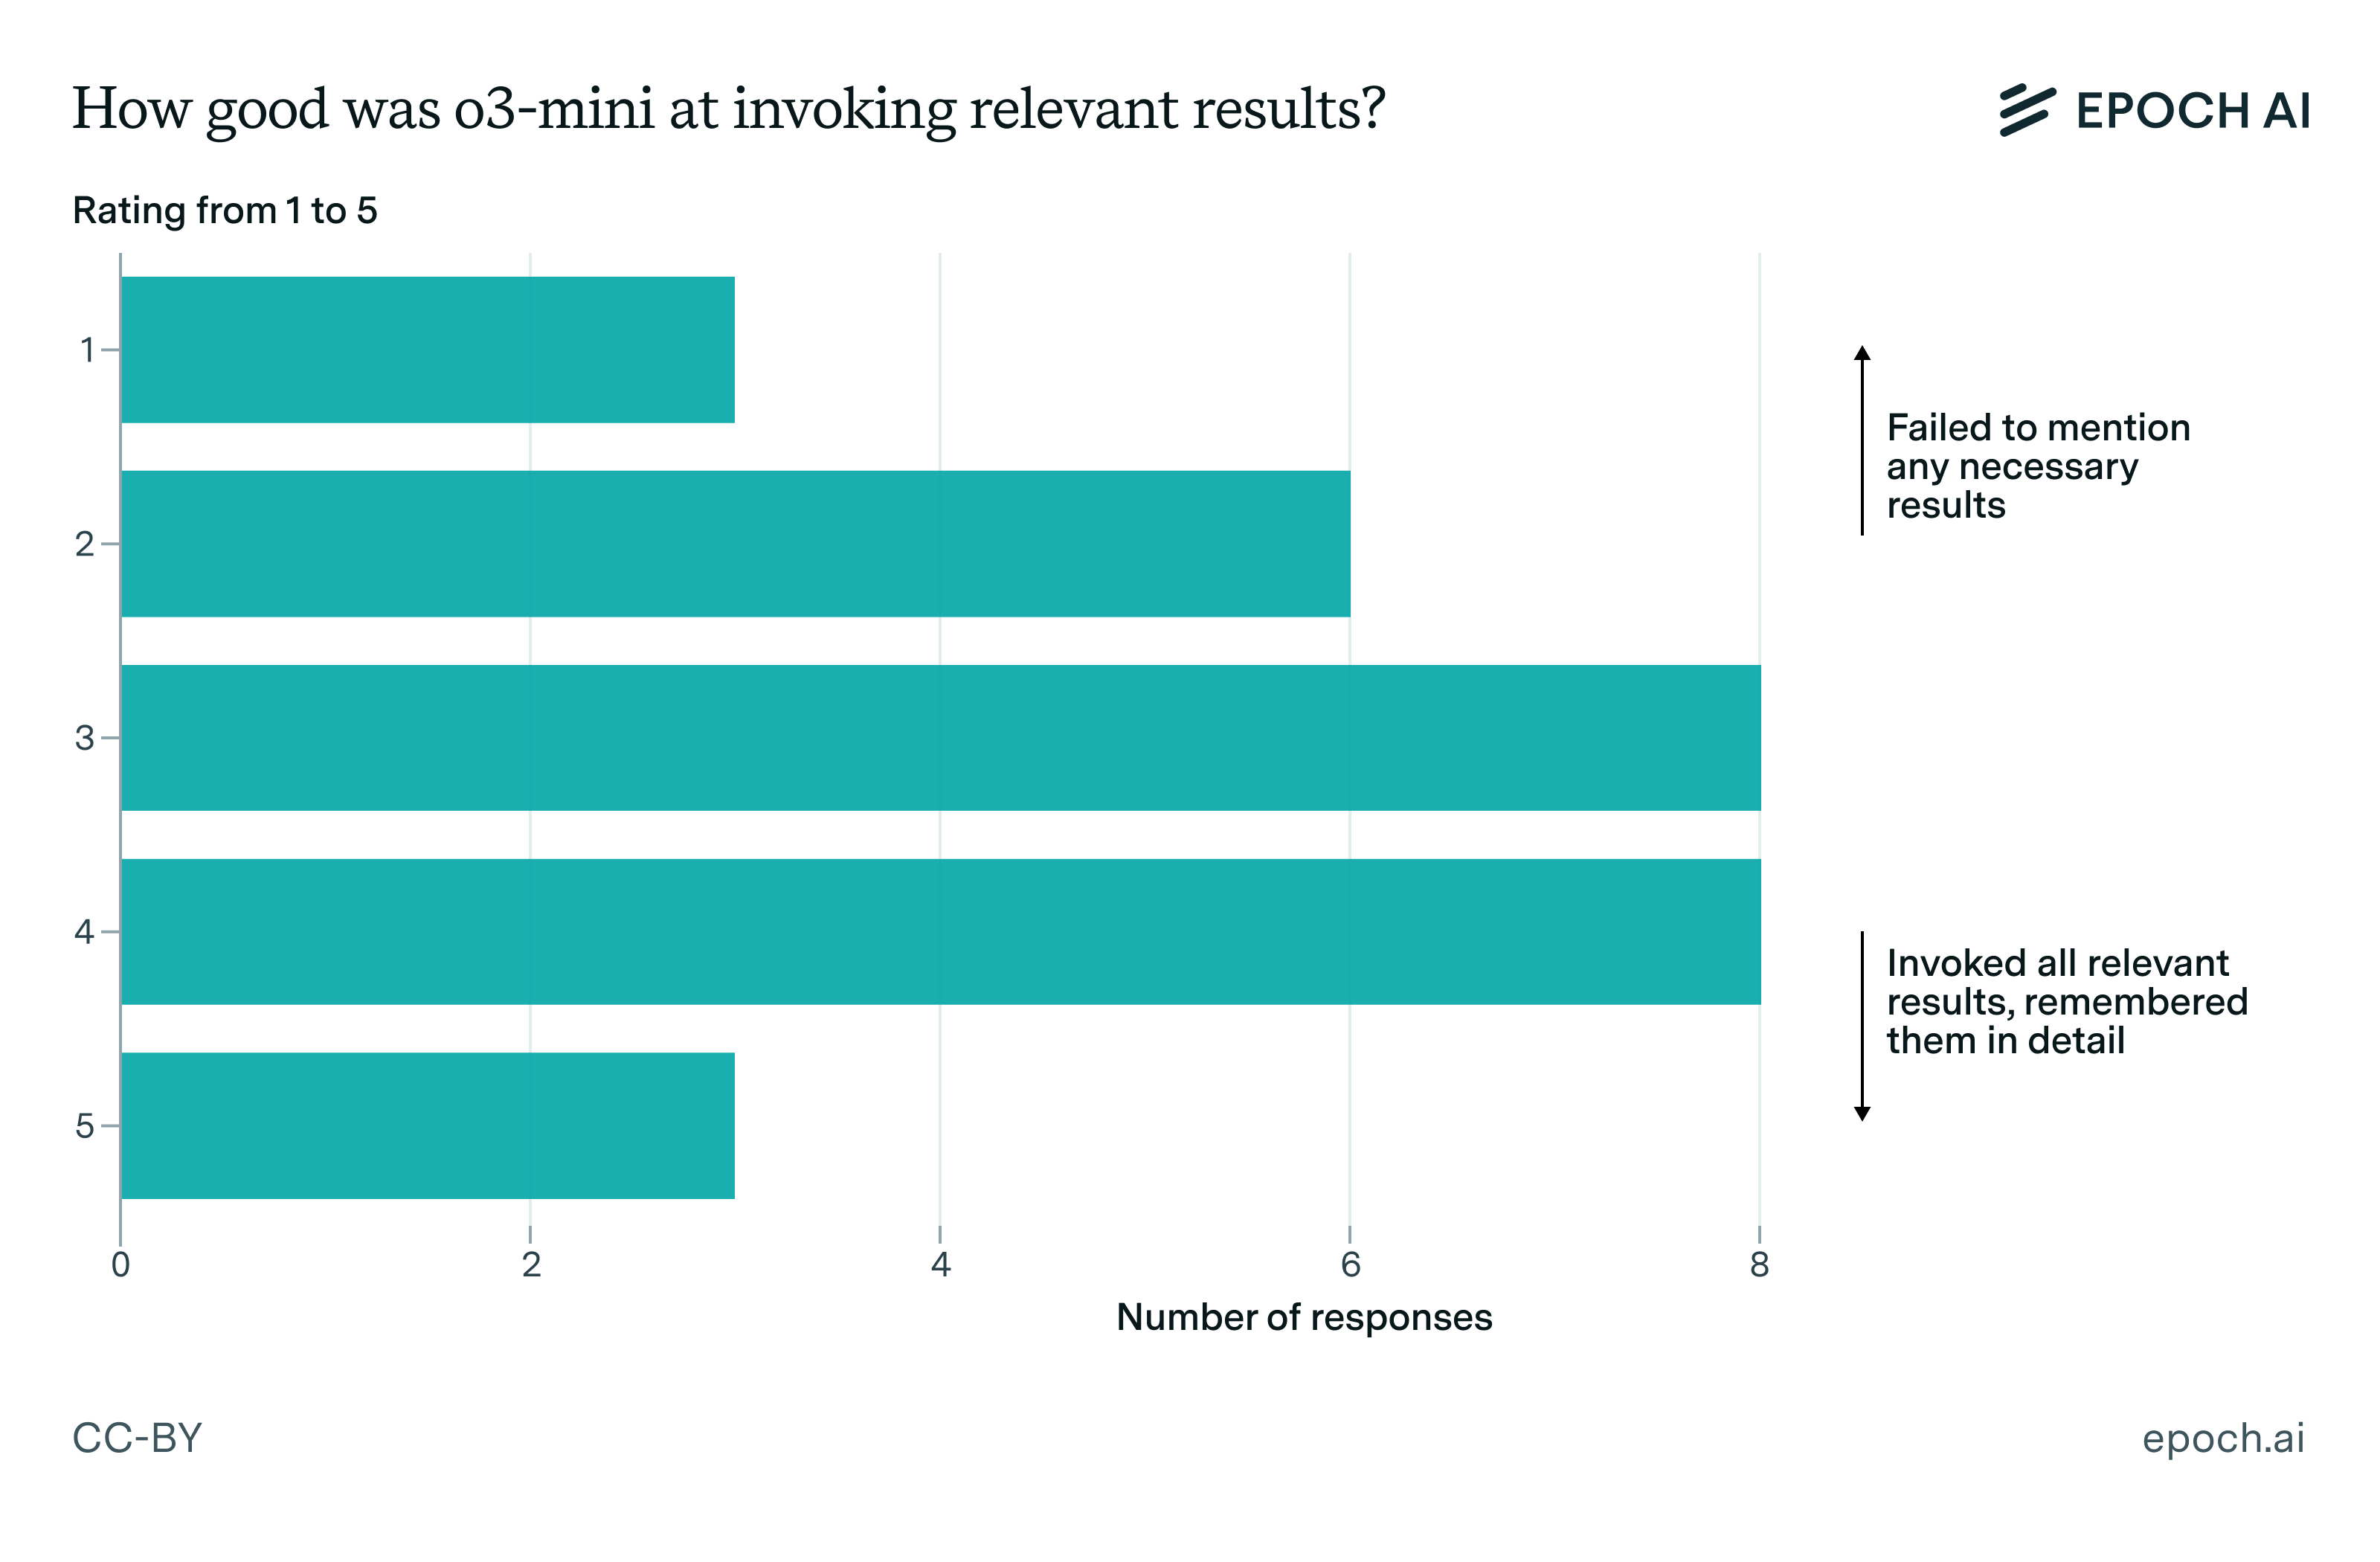
図1:レビューした数学者たちは総じて、o3-mini-high が数学の文献から関連する結果を持ち出すのはまずまずうまいと評価し、約3分の2の問題で5点満点中3点以上を付けた。
「感覚頼みの帰納的推論者」
数学者の多くは、o3-mini-high がかなりくだけた推論スタイルをとる傾向があることも指摘した。ある数学者はこのモデルを「感覚頼みの帰納的推論者」と表現し、問題の手がかりをつかむのに役立つ手軽な実験を見つけ出す「数学者のような好奇心」を備えていると評した。別の数学者は「このモデルは、少しくだけた、厳密でないやり方で考えているようだ。考えの最初の定式化は大ざっぱなことが多く、言葉づかいは厳密でなく、数学の論文に書いたら通用しないような例外的なケースもある」と指摘した。
なぜこのモデルは、推論をもっと形式化しないのだろうか。私たちにもはっきりとは分からないが、少なくとも「モデルが怠けている」というより複雑な説明が必要だろうと考えている。たとえば、ある数学者は「このモデルは、必要なときには計算したりコードを書いたりすることを恐れない」と述べている。計算やコードは手間のかかる作業だが、そのおかげでモデルは、全体としてはかなり「感覚頼み」でありながらも地に足がつき、抽象的になりすぎずにすんでいる。また、数学者が「形式的な推論」と呼ぶものが実は事前学習データに十分含まれておらず、事後学習でも不完全にしか引き出されていない可能性もある。
o3-mini-high がつまずくところ
精密さの欠如
前節で触れた形式的な精密さの欠如は、o3-mini-high が力の及ばない主な領域の一つでもある。たとえば、ある数学者は「[o3-mini-high が]人間の数学者に大きく劣るのは、発見したことを証明しようとして追究しない点だ」と述べている。ある事例では、モデルがくだけた推論によって正しい予想を立てるものの、「その予想を証明しようとすらしない。代わりに、その予想をそのまま使って問題を解き、正しい答えを得ている」ことが分かった。
私たちはこうした状況を「ずる解き(cheesing)」と呼んでいる。モデルが、想定された推論(この例では関連する予想の証明が含まれていたはずである)をすべてたどることなく、実質的に答えを当て推量してしまうことである。2正しい答えに至った推論過程のうち、ずる解きは少数派ながら無視できない割合を占めた。
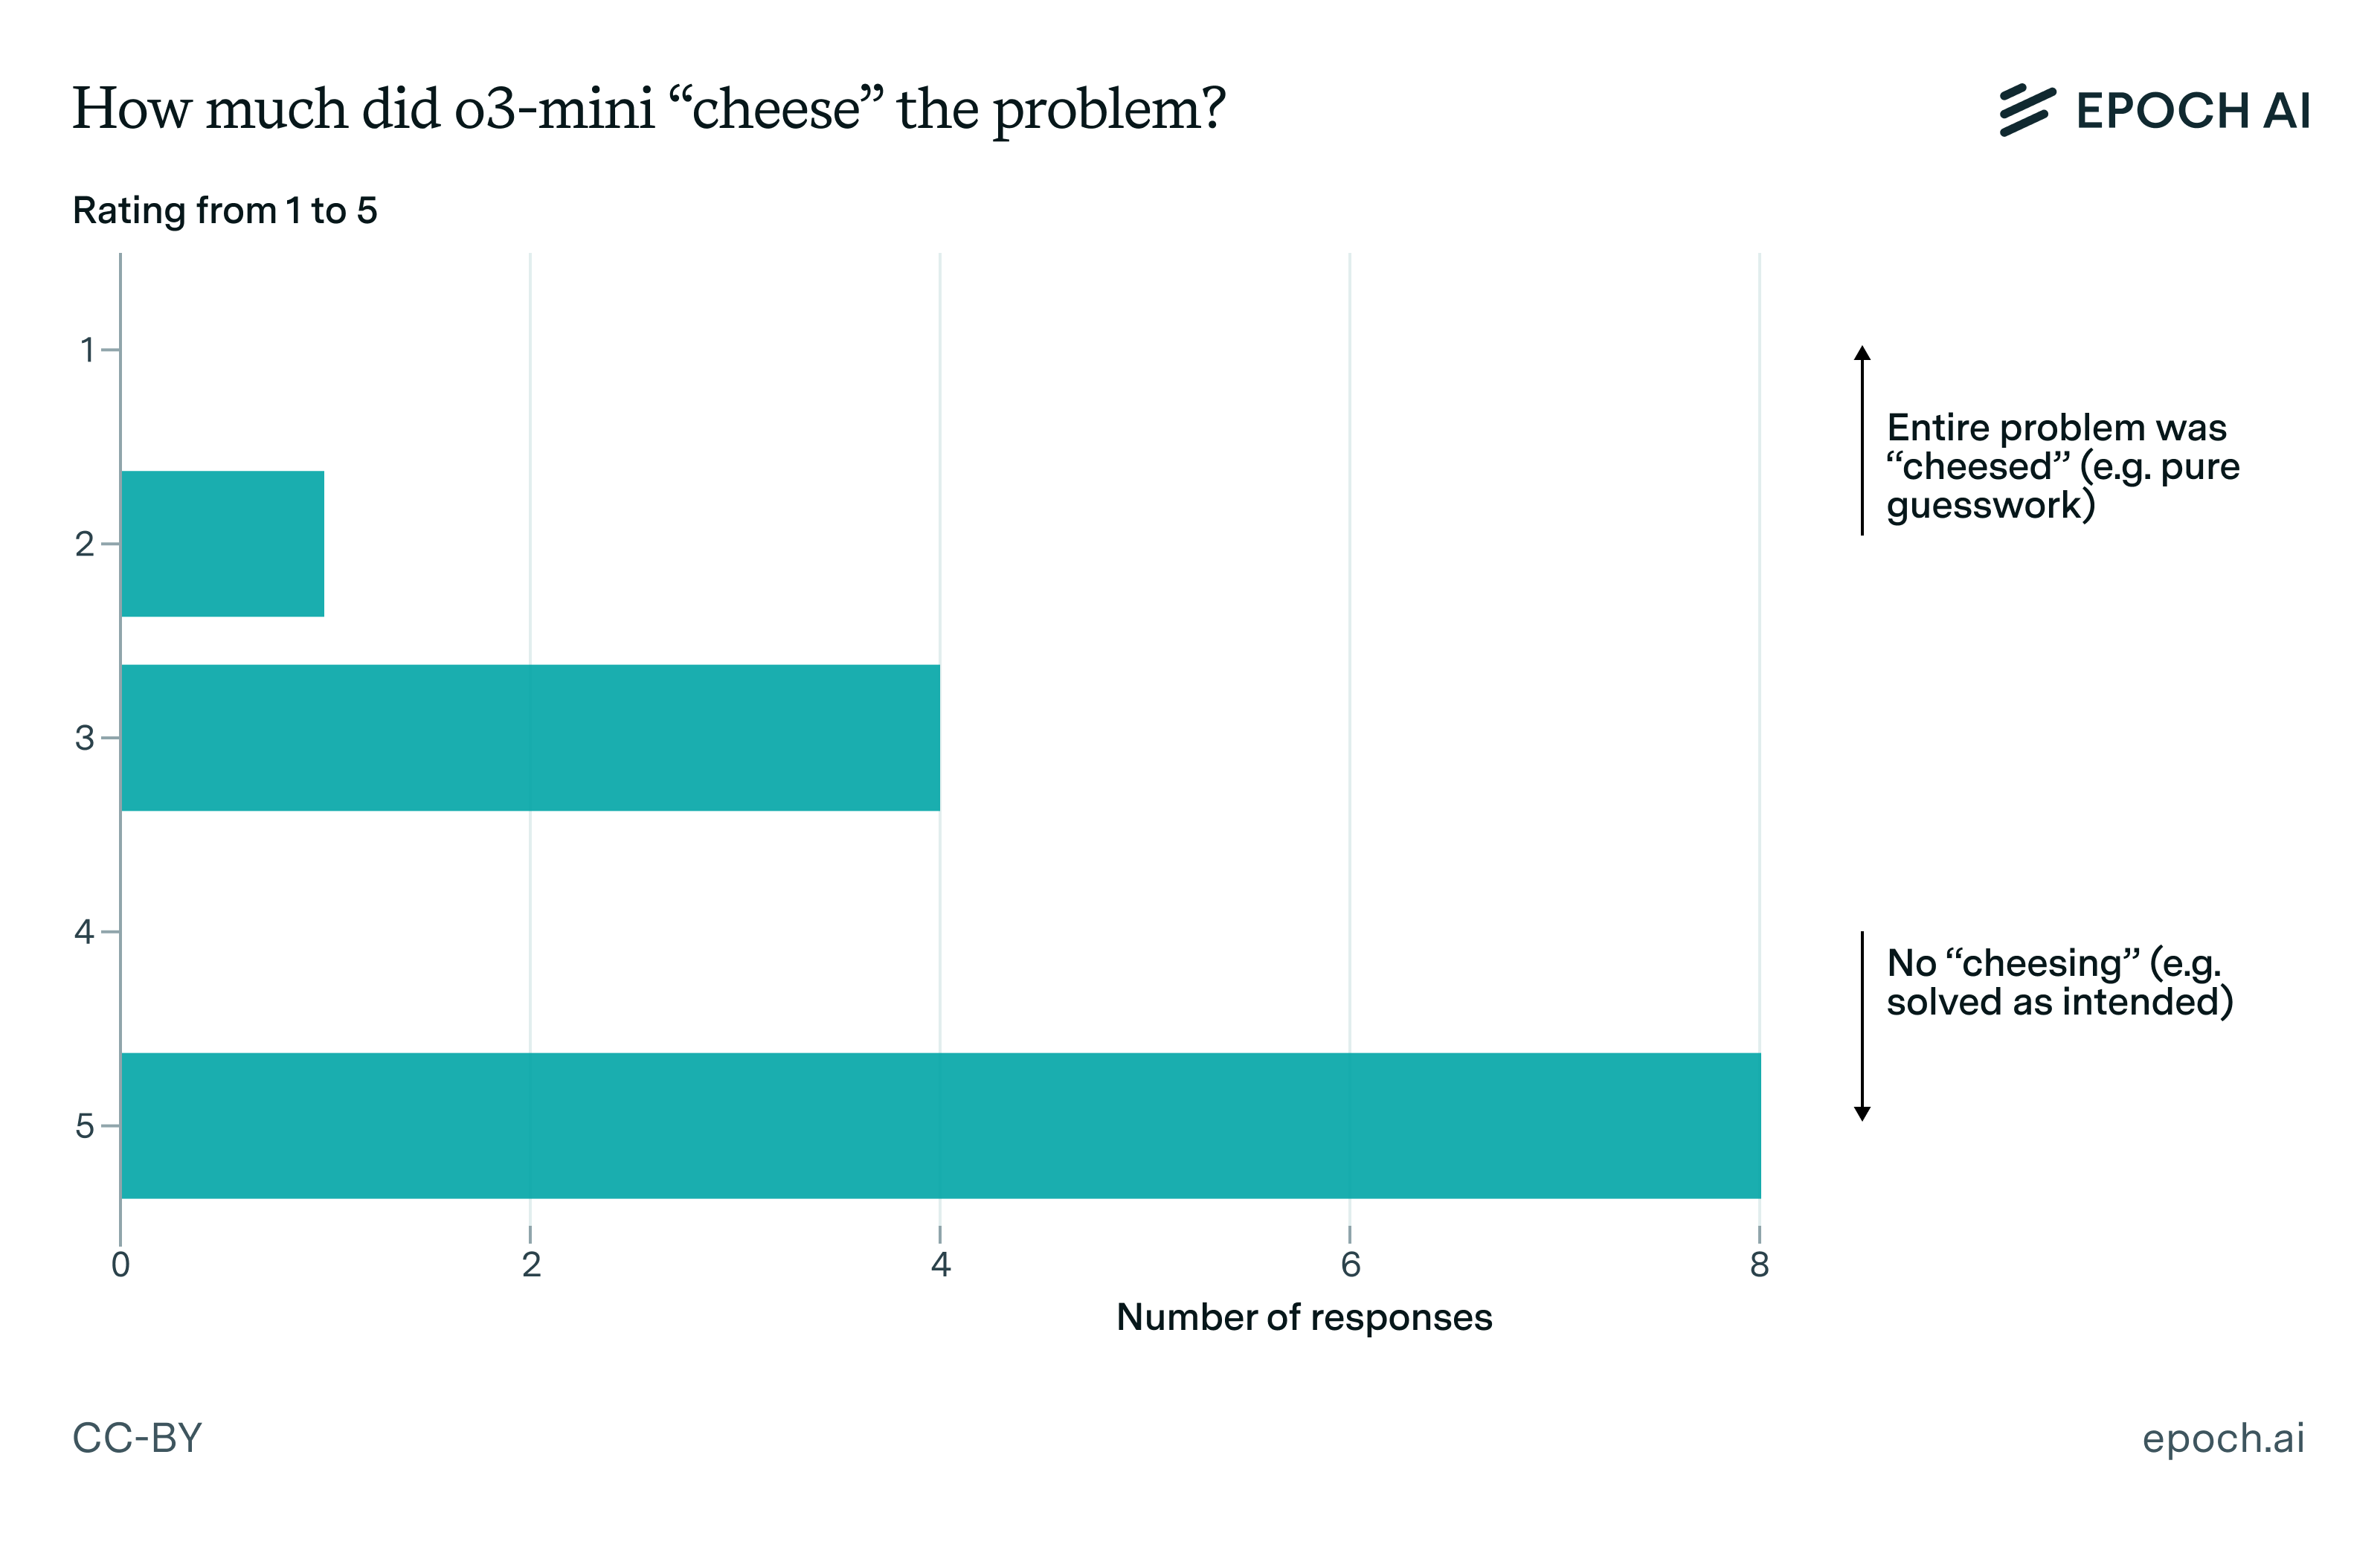
図2:問題の「ずる解き」(想定どおりに問題を解かないこと)はかなりよく見られたが、多くの場合、o3-mini-high はずる解きをまったくせずに問題を正しく解いていた(つまりスコア5)。このグラフは、o3-mini-high が該当の問題に正しく答えた推論過程だけを対象としている点に注意。
o3-mini-high が大筋では正しい方向に進んでいながら、最後の決定的なつながりを見落としただけで正解に至らなかったこともあった。たとえば、ある分割理論の問題では、あと一歩で正解というところまで来ており、作問者は「n=0 から [伏せ字] までの出力を足し合わせさえすれば、答えは正しかった。これには本当に感心した」と述べている。
次のグラフが示すように、o3-mini-high がここまで解決に近づけなかったことのほうが多かった。
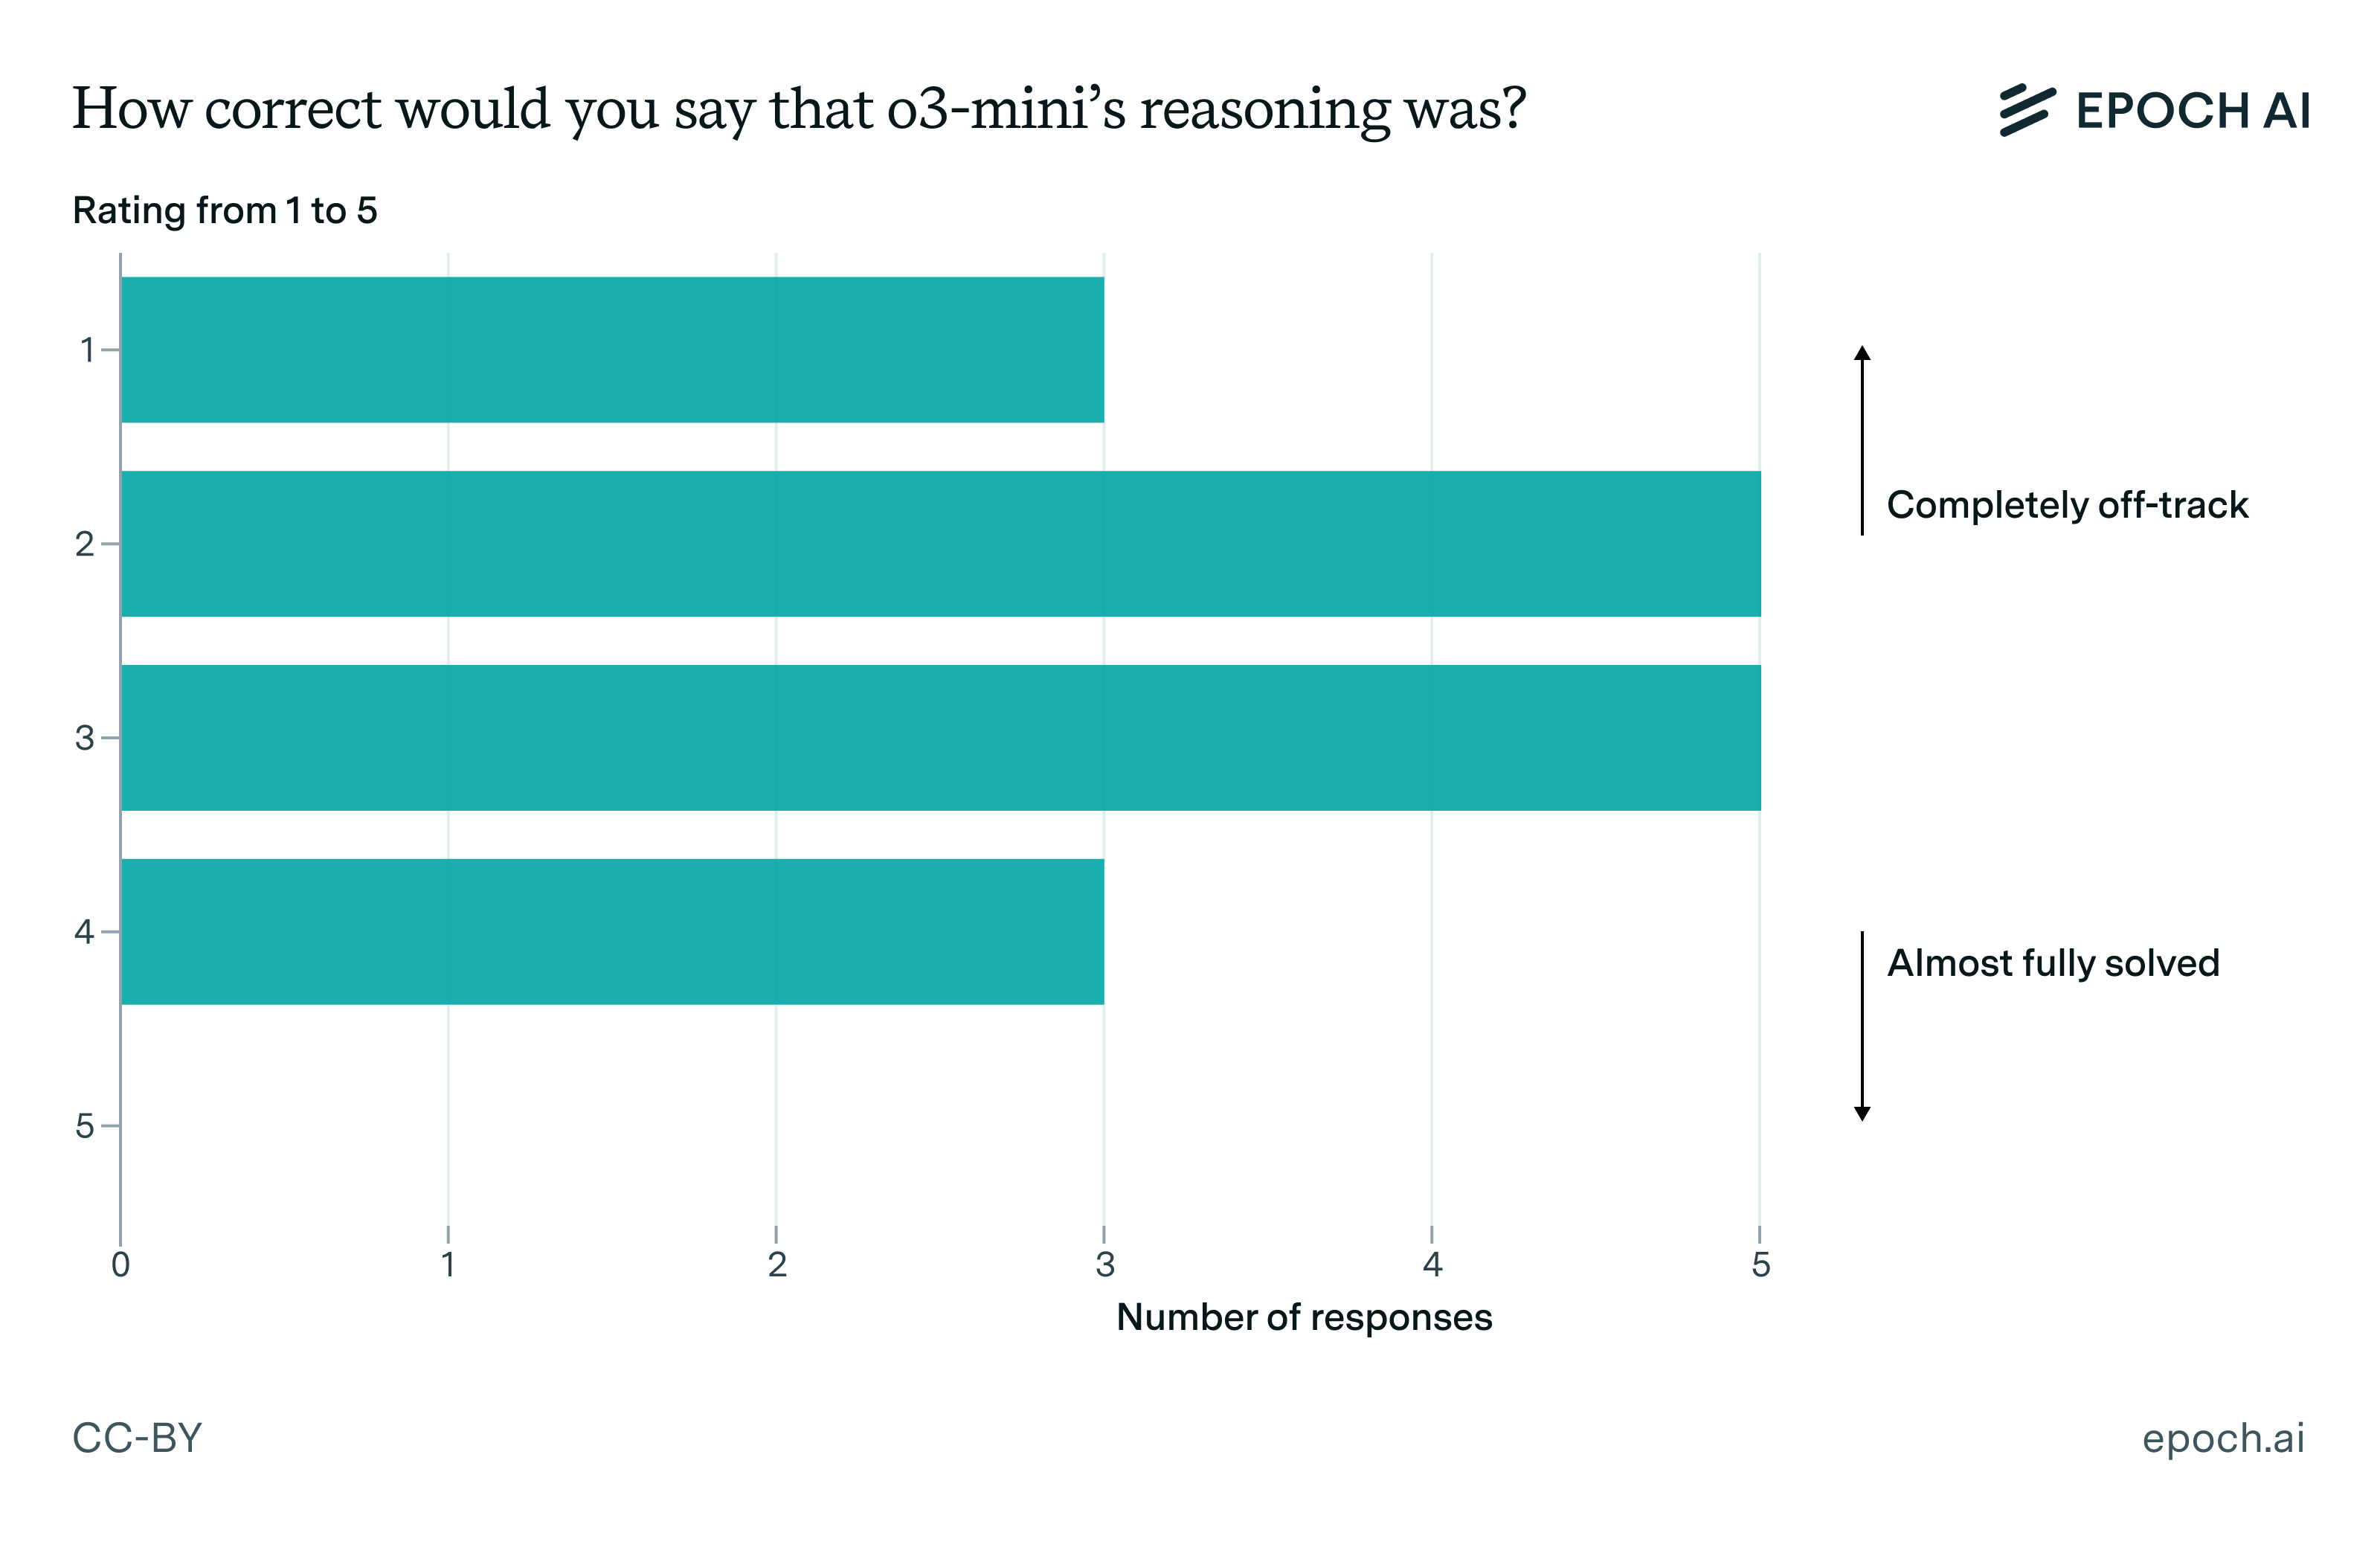
図3:o3-mini-high が誤った解に至った事例のうち、正解に非常に近かったのは約18%にすぎない。全体として、推論がどの程度正しかったかにはかなりのばらつきがあった。
創造性と理解の深さの欠如
数学者たちが指摘した o3-mini-high の最大の限界は、おそらく、創造性と理解の深さの欠如だろう。同じくらい知識のある人間と比べると、特にそうである。ある数学者は、この状況を次のようにまとめた。
「このモデルはしばしば、幅広く本を読み、多くの結果や著者の名前を挙げられる熱心な大学院生に似ている。最初は感心させられるかもしれないが、専門家にはすぐに、その学生が内容を深く身につけておらず、読んだことをほとんど受け売りしているだけだと分かる。このモデルも似た振る舞いを見せる。関連する文献を見つけるのはうまいが、それを新しいやり方で発展させたり応用したりはできない。」
別の数学者は次のように述べた。
「このモデルには気に入ったアイデアがいくつかあって、それを当てはめようとしていた。[…]そのいくつかのアイデアが尽きると、実質的な進展はなかった。本当に残念に思う。プロの組合せ論の研究者なら、問題に取り組んだり問題を別の形で捉え直したりする、もう少し創造的な試みを期待するだろう(たとえその試みが失敗するとしても)。」
ある数学者は、「AIにとっては、大きな有限体上のある超楕円曲線の点の数を数えることよりも、新しいアイデアが必要な中学2年生向けの数学オリンピックの問題を解くことのほうが難しいといえるかもしれない」とまで言った。これが文字どおり正しいかどうかはともかく、ほとんどの数学者が観察したのと同じ大まかな現象を言い表している。3
ハルシネーション
このモデルには、ほかにも多くの失敗のパターンが見られた。目立った問題の一つは、推論過程の約75%にハルシネーション(もっともらしい誤り)が含まれていたことで、数学用語や公式を誤って覚えていることが多かった。たとえば、ある数学者は次のように指摘した。
「関連する公式の名前はよく思い出すが、それを正確に再現できず、細部を思い出せないところには「(…)」のような穴埋めの記号を入れることが多い。」
o3-mini-high は、ライブラリやインターネット検索などのツールの使い方にも問題があるようだった。たとえば、このモデルは「ハルシネーションで作り出した、存在しない多くのURLから情報を取ってこようと」していたと評された。これは、たとえばごくマイナーな数学的結果を正確に述べるといった場面で問題になる。実際、ある回答者は「Google や arXiv を閲覧して関連しそうな結果を探すといったことができるエージェント型のシステムがあれば、実際の問題での性能は大きく向上するだろう」と考えていた。4
o3-mini-high は人間の数学者のように推論するのか?
ここまで見てきたことを踏まえると、o3-mini-high の推論は人間の数学者の推論とどれほど似ているのだろうか。全体として、この問いへの答えには、数学者によって、また個々の推論過程によって、ある程度のばらつきがあったようだ。
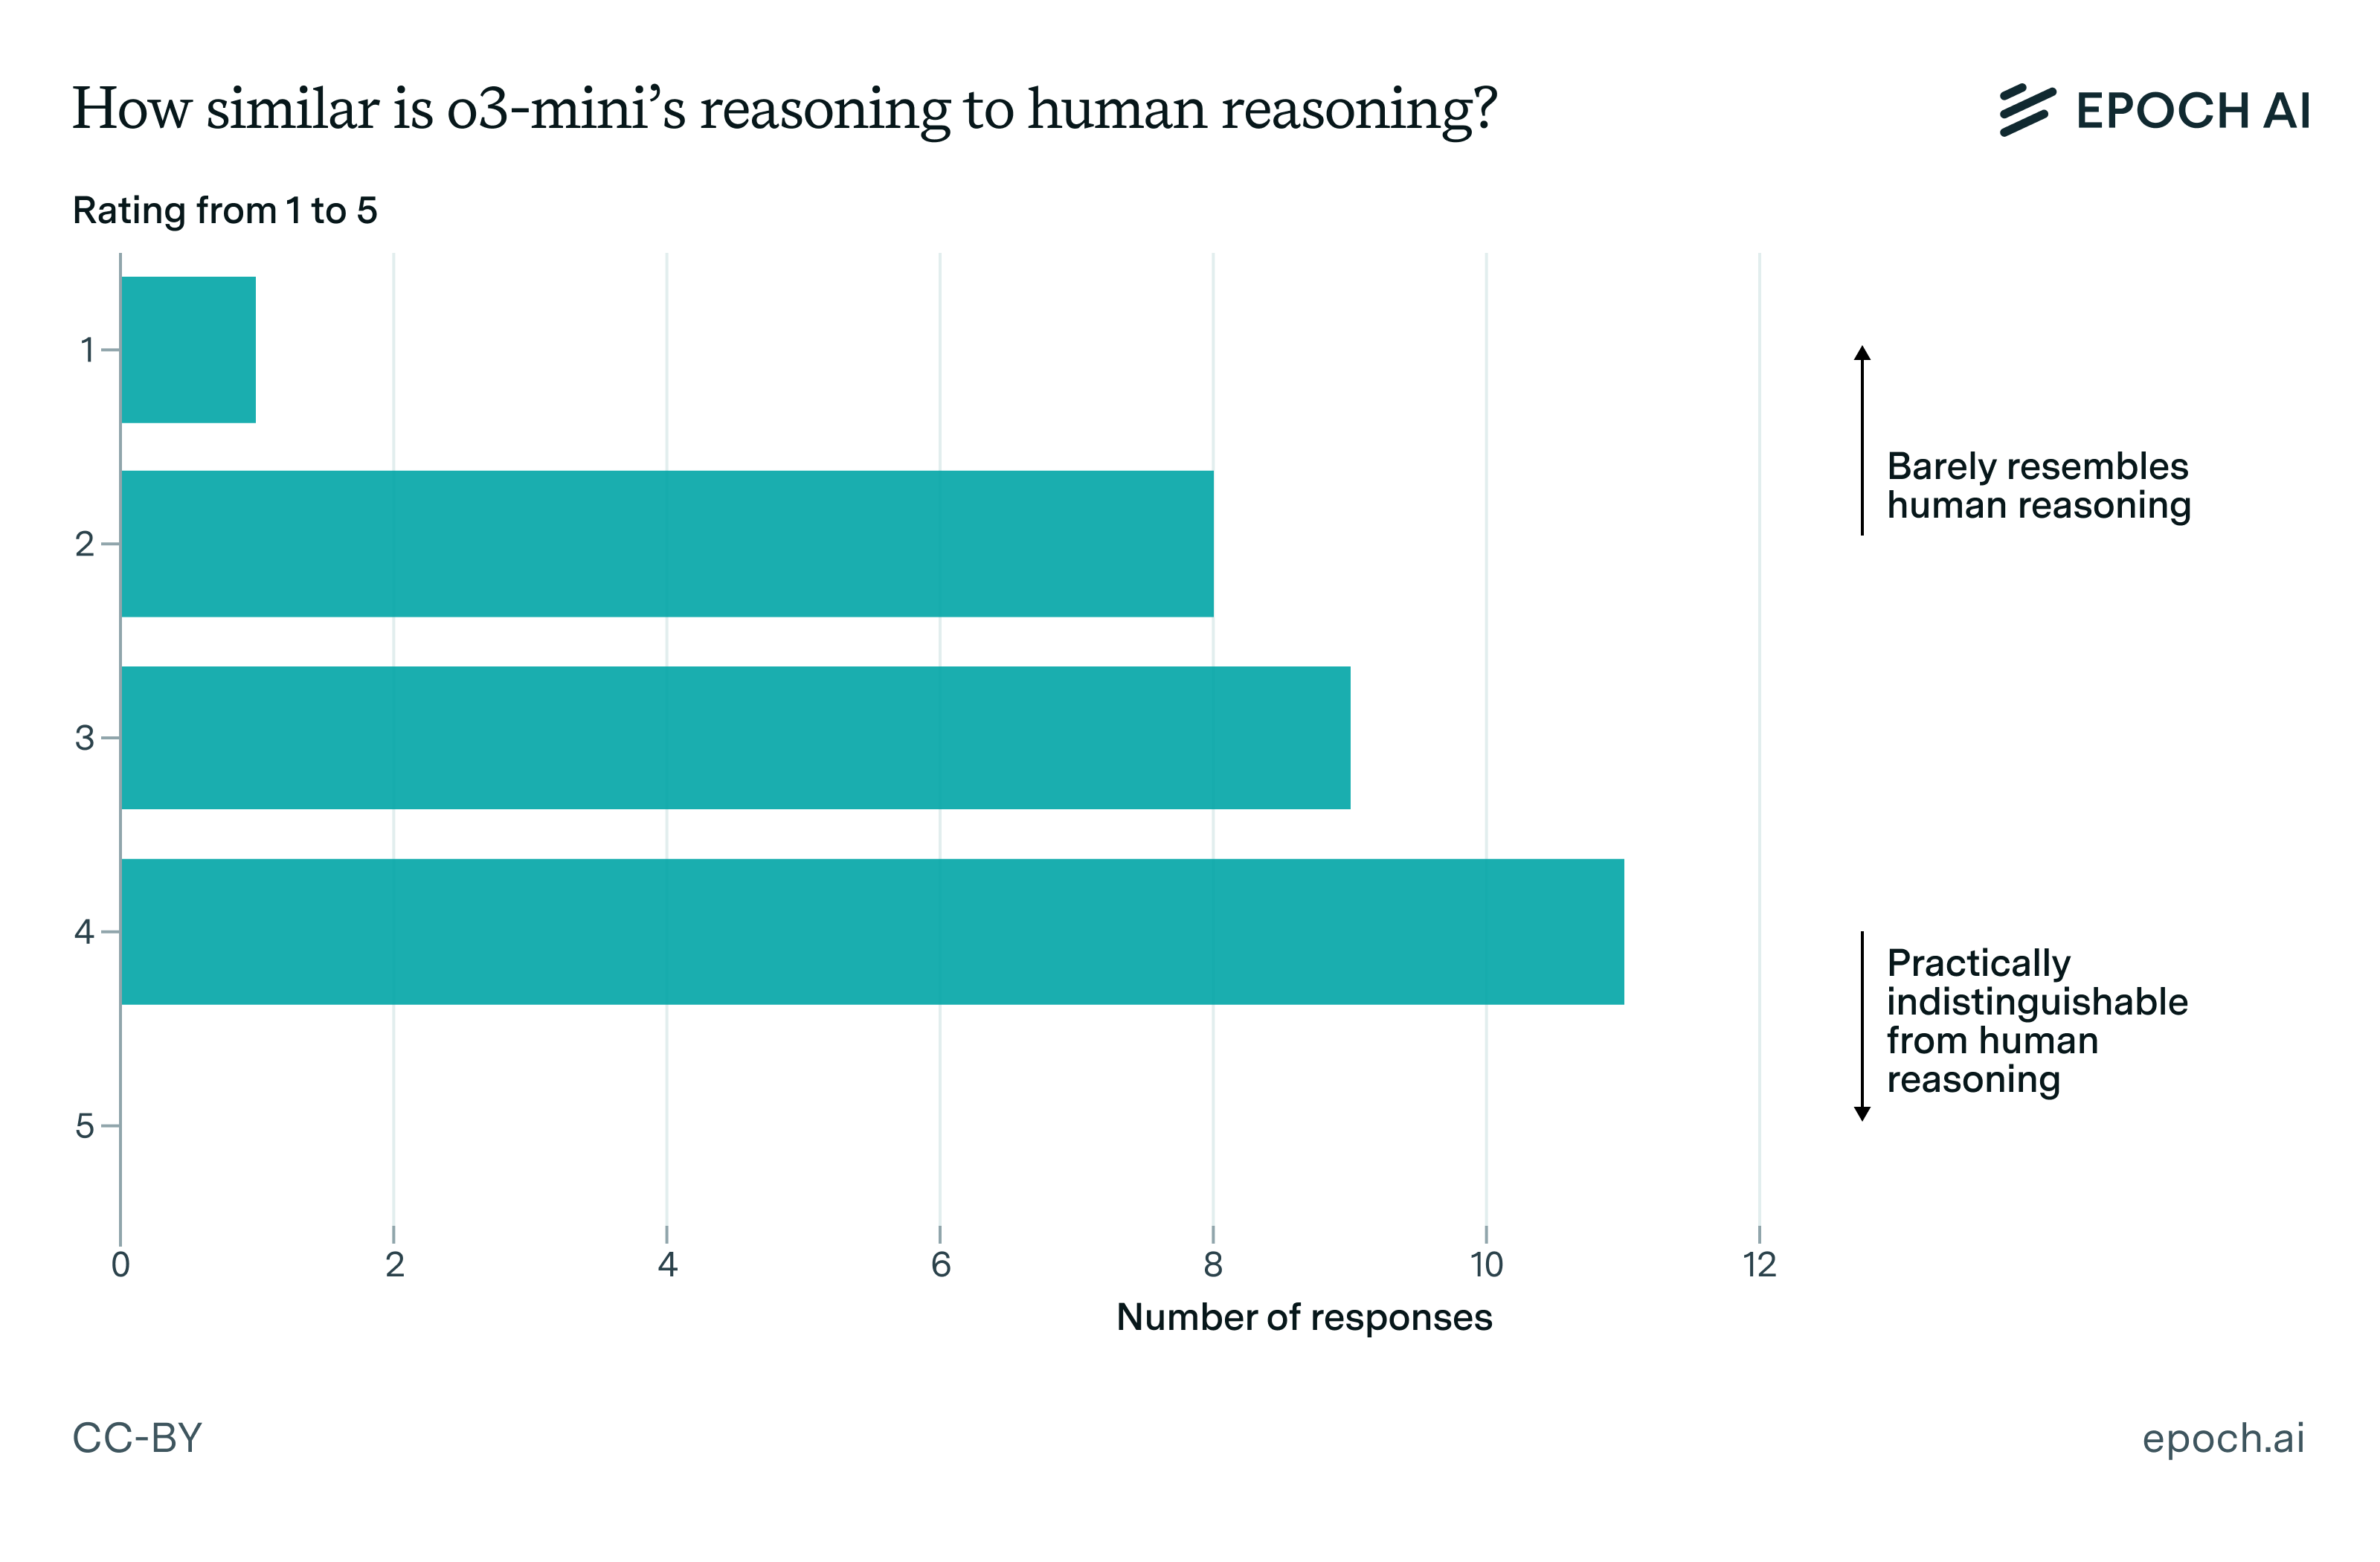
図4:o3-mini-high の推論がどれほど人間らしいかについての数学者の評価。スコア1はまったく人間らしくない推論、スコア5は人間の数学者と見分けがつかない推論にあたる。
意見がばらついたのは、主に o3-mini-high の能力の組み合わせが、少なくとも人間としてはかなり雑多だからだと考えている。一方では、人間のように問題について推論する能力が非常に高いようで、好奇心の兆しを見せ、問題に対するさまざまな攻め方を探っている。
他方で、知識がありすぎるくらいなのに、創造性と形式性に欠け、奇妙な癖もいくつかあるようだ。一つには、o3-mini-high は推論過程が非常に冗長になる傾向がある。ある数学者はこれを「口頭試験でやたらと饒舌な学生のようなものだ。悪い戦略ではない」と表現した。
しかし、この冗長さのすべてが明らかに役立っているわけではない。ある回答者は「このモデルは、最終的な答えを提出することに妙に神経質だ」と指摘した。その一例として、o3-mini-high は「もう終わった、今度こそ最終的な答えは上のとおりだ、という文を言い換えては繰り返すループに陥り、ときおり自信をなくしては、最終的な式に入る算術をもう一度一歩ずつ計算し直す」。少なくともこのような場合、モデルの推論過程は、冷静な人間の数学者のものとは明らかに違って見えることがある。5
考察
以上を踏まえると、o3-mini-high は簡潔に言って「博識な感覚頼みの推論者で、プロの数学者のような創造性と形式性に欠け、妙に冗長だったり同じことを繰り返したりしがち」とまとめられる。これは、私たちがオンラインで目にした数学者たちの意見とおおむね一致しているようだ。6
この分析からは、自然に2つの重要な問いが浮かぶと考えている。
第一に、そもそもなぜ o3-mini-high のような推論モデルはこうした性質を持つのか。その一部は自明である。数学の公開文献の多くを含む大量のデータで学習しているのだから、博識なのは当然である。しかし、なぜこれらのモデルがこの知識をもっと活用できないのか、つまり数学の異なる分野の間にもっとつながりを見出したり、新しいアイデアを創造的に思いついたりできないのかは、私たちにとってもっと謎である。
第二に、推論モデルは、創造性や形式的な推論といった現在の弱点をどれだけ克服していくのか。そして、それによって将来の推論過程はどれほど変わるのか。たとえば、o3-mini-high の推論のアプローチと、AlphaProof のようなシステムのアプローチを対比できる。後者は(完全にではないにせよ)大部分を合成データで学習しており、まったく異なるデータ分布を見てきている。数学が合成データとどれほど相性が良いかを考えると、将来の推論モデルは人間の数学者にあまり似ていないものになると予想するのが妥当だと考えている。
もちろん、ここで行ったことは、これらの推論モデルの仕組みを理解するために可能な分析のほんの表面をなぞったにすぎず、今後さらにこうした分析を進めたいと考えている。
この分析を可能にした推論過程を送ってくれた OpenAI に感謝する。
注
-
本稿の結果は、OpenAI が独自のスキャフォールド(モデルを動かすための周辺の仕組み)を使って FrontierMath の一部で o3-mini-high を実行した評価に基づいている。その後、こうした未加工・未選別の推論過程(通常は私たちが見られないもの)を送ってもらった。私たちはすべての推論過程を見られるわけではなく、これらの評価の実行に使われたコードやツールも手元にない。そのため、モデルの全体的な性能は、私たちのベンチマークハブで独自の評価として報告しているものとは異なる可能性が高い点に注意してほしい。 ↩
-
FrontierMath でこれが可能なのは、問題の答えが数値か Sympy のオブジェクトとして表せるからである。問題は当て推量では解けないように設計されているが、そのためにAIシステムが問題を「ずる解き」できるという潜在的な弱点が生じている。 ↩
-
これはモデルが向かっている方向でもある。たとえば、o3、o4-mini、Gemini 2.5 Pro はツールの使用に対応している。 ↩
-
もっとも、公平を期すなら、人間は通常、思考の連鎖をすべて声に出して読み上げられるわけではなく、内心では(あるいは表に出しても!)かなり神経質なのかもしれない。とはいえ、一部の数学者が遭遇したような、ひたすら繰り返すループとまったく同じように見えるとは思えないので、この指摘は依然として成り立つ。 ↩
-
とはいえ、モデルの推論が忠実でないという問題が潜んでいる可能性もあり、この調査ではそれを調べることを優先しなかった。 ↩