
レポート
機械学習システムの学習にかかるドル建てコストの推移
原題:Trends in the dollar training cost of machine learning systems
本レポートの結果に関する重要な注意点
- コストの推定値の不確実性の幅は大きく、実際のコストは数倍大きいことも小さいこともありうる。コストの推定値は、それ自体が他の推定値(学習計算量の推定値、GPUの価格性能比の推定値など)の上に組み立てられている。それぞれの推定値の不確実性については、手法の節と付録Jを参照のこと。
- 推定したコストの増加率は個々のコスト推定値よりは頑健だが、この増加率も慎重に解釈すべきである。将来へ外挿する場合は特にそうである。
- コストの推定値が対象とするのは、機械学習システムの最終的な学習の実行(final training run)に使われた計算資源だけであり、それ以外は含まない。
- コストの推定対象は、Sevilla et al. (2022, p.16) で論じられた基準に照らして注目に値する、公に知られた機械学習システムである。性能の向上は時期によって不規則である。つまり、計算予算が2倍になっても、能力が常に同じだけ向上したわけではない。この挙動は分野によって大きく異なる。
- テック企業が「社内で」支払う額と、同じ量の計算資源に消費者が支払うであろう額とは大きく異なる。たとえば Google は、自社のTPUについて1時間あたりの支払いは少なくて済むかもしれないが、当初は何世代ものハードウェアを開発するコストを負担していた。
有益なフィードバックとコメントをくださった Michael Aird 氏、Markus Anderljung 氏、Epoch AI チームに感謝する。
要約
-
2009年から2022年までに発表された機械学習(ML)システム124件のデータセットを用いて、1機械学習システムの最終的な学習の実行にかかる計算資源のコスト(米ドル建て)は、年0.49桁(OOM)のペースで増えてきたと推定した(90%信頼区間:0.37〜0.56)。2より詳しい結果は表1の「全システム」の行を参照のこと。3
-
これに対し、2015年9月以降の「大規模」システム(比較的多くの計算資源を使ったシステム)の学習に使われた計算資源のコストは、サンプル全体よりもゆるやかに、年0.2桁のペースで増えてきたと推定した(90%信頼区間:年0.1〜0.4桁)。より詳しい結果は表1の「大規模」の行を参照のこと。(詳細)
推定方法 | データ | 期間 | 規模(期首〜期末)4 | 最終的な学習の実行のドル建てコストの増加率 |
|---|---|---|---|---|
(1) GPU全体の価格性能比のトレンドを使う | 全システム(n=124) | 2009年6月〜 2022年7月 | 0.02ドル〜8万ドル | 年0.51桁 90%信頼区間:0.45〜0.57 |
| 大規模(n=25) | 2015年10月〜 2022年6月 | 3万ドル〜100万ドル | 年0.2桁5 90%信頼区間:0.1〜0.4 | |
| (2) 機械学習システムの学習に実際に使われたNVIDIA GPUのピーク時の価格性能比を使う(結果へ) | 全システム(n=48) | 2009年6月〜 2022年7月 | 0.10ドル〜8万ドル | 年0.44桁6 90%信頼区間:0.34〜0.52 |
| 大規模(n=6)7 | 2016年9月〜 2022年5月 | 200ドル〜7万ドル | 年0.2桁 90%信頼区間:0.1〜0.4 | |
| 増加率の加重混合8 | 全システム | 2009年6月〜 2022年7月 | 該当なし9 | 年0.49桁 90%信頼区間:0.37〜0.56 |
表1:機械学習システムの学習に使われる計算資源のドル建てコストについて、対数線形回帰にもとづいて推定した経時的な増加率。OOM=桁(10倍)。拡張版の結果表は回帰結果のまとめの節を参照のこと。
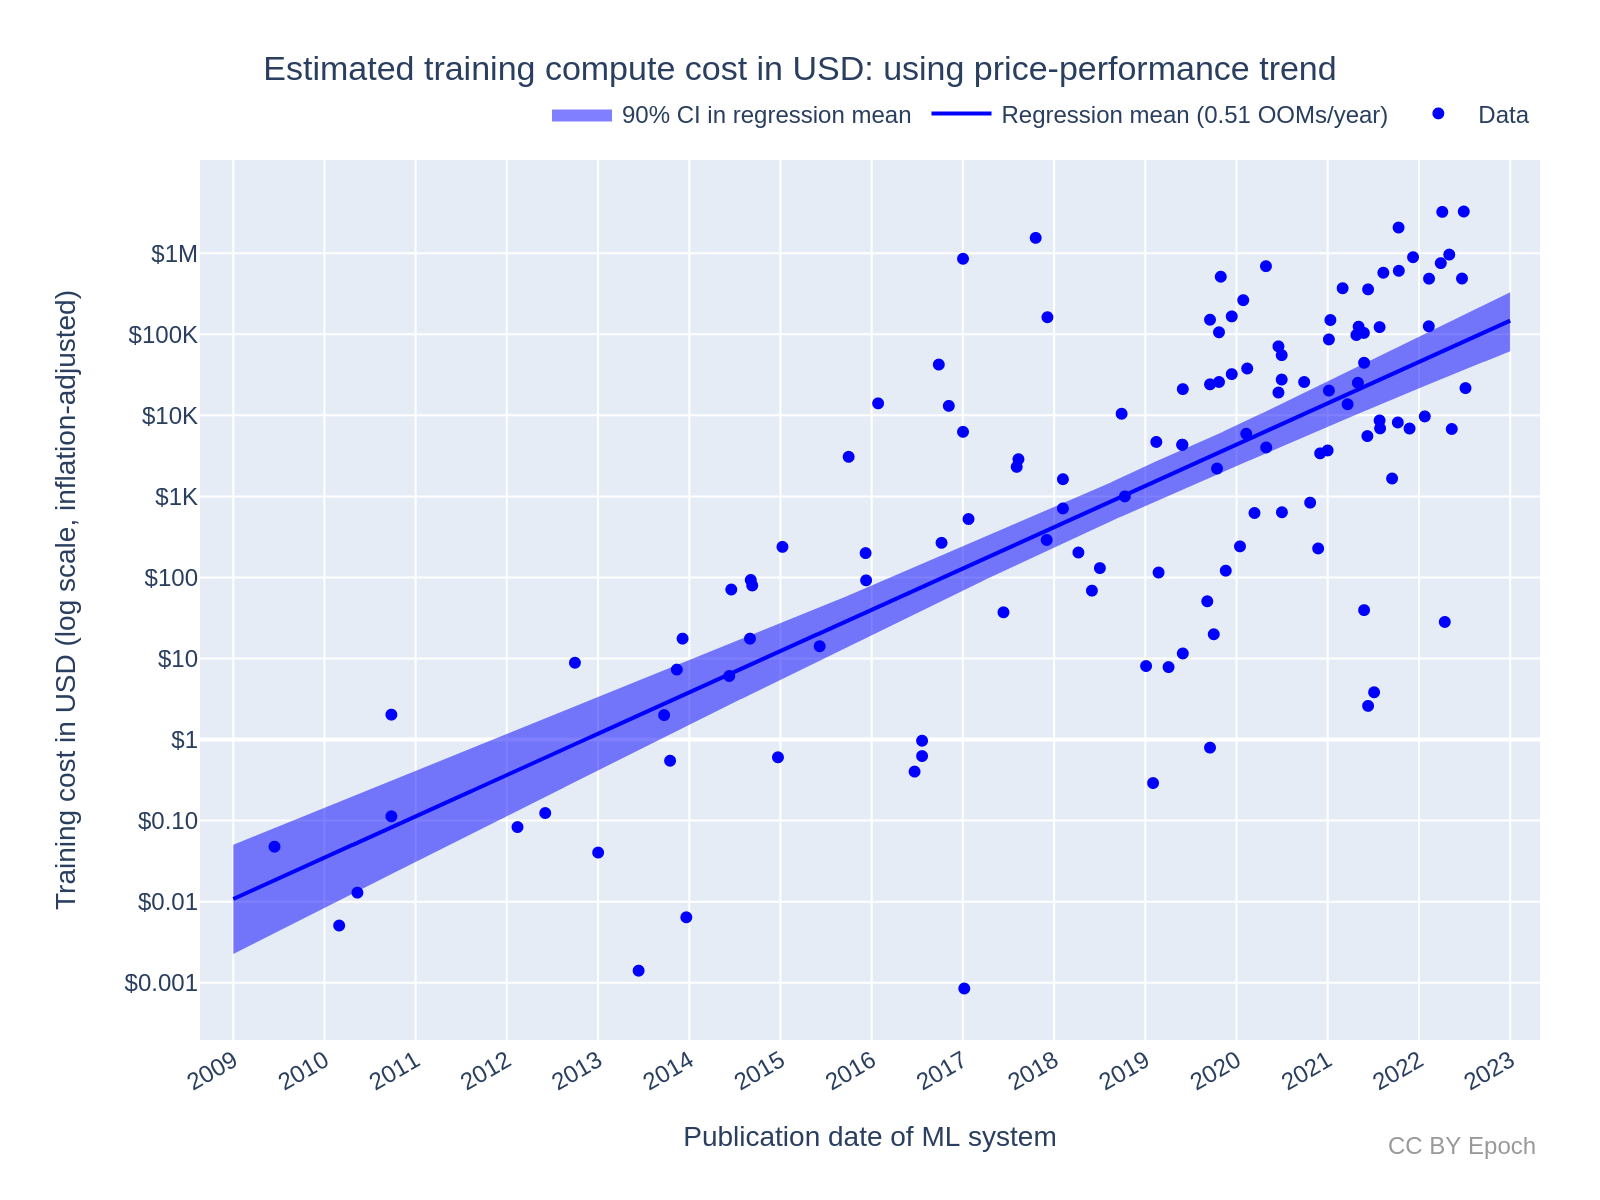
図1:機械学習システムの最終的な学習の実行にかかった計算資源のコストの推定値(米ドル)。ここでのコストは、Hobbhahn & Besiroglu (2022) の全GPUの価格性能比のトレンドにもとづいて推定している(本レポートでいう「手法1」)。
過去の結果を用いて、最も高額な学習の実行にかかる計算資源のコストが、2021年の米国GDPの約1%にあたる2,330億ドルを超えるのはいつかを予測した(ただし不確実性は大きい)。Cotra (2020) にならい、このコストを、AIへの世界的な投資の規模にとって重要な閾値とみなす。10(詳細)
- 現時点で最も高額なコスト推定値(Minerva の327万ドル)から、「全システム」の増加率である年0.49桁(90%信頼区間:0.37〜0.56)を使って単純に外挿すると、最も高額な学習の実行にかかる計算資源のコストは、2032年(90%信頼区間:2031〜2036年)に実質値で2,330億ドルを超える。
- これに対し、私の最善の推測による予測では、コストの増加が今後鈍化することを示す証拠と、コスト推定値に含まれる偏りの要因を考慮して補正した。11これらの補正は一部を私の直観的な判断に頼っているため、結果は慎重に解釈すべきである。2025年の初期コストを3億8,000万ドル(90%信頼区間:5,500万〜15億ドル)とし、年0.2桁(90%信頼区間:年0.1〜0.3桁)の増加率で外挿した。その結果、最も高額な学習の実行にかかる計算資源のコストが実質値で2,330億ドルを超えるのは2040年(90%信頼区間:2033〜2062年)となった。
今後の研究として、次のことを勧める。
なぜ学習のドル建てコストを調べるのか
機械学習の学習の実行にかかる計算コスト(FLOP単位)は、機械学習の能力が時間とともにどう発展するかを理解するのに役立つ。たとえば計算コストの推定値を性能指標と組み合わせれば、機械学習システムの効率の推移を測ることができる。しかし、ムーアの法則(より具体的にはハードウェアの価格性能比のトレンド)によって、計算のコストは(ドル建てで)指数関数的に安くなってきた。過去10年間、機械学習への計算資源の支出は、ムーアの法則よりはるかに速いペースで増えてきた。12
計算量とは対照的に、機械学習の学習の実行にかかるドル建てのコストは、その学習の実行が(実際の経済的な観点で)どれほど高価か、そしてある主体がその学習の実行にどれだけ支出する意思があるかを、よりよく示している。 そしてドル建てのコストと支出の意思を理解すれば、次のことを予測しやすくなる。
- AIの進歩の速さ(AI開発は、研究の進歩に固有の難しさだけでなく、経済的な要因にも左右されるため)。
- どの主体が変革的AI(Transformative AI、TAI)を開発する資金的な余裕を持つか。これは、どの主体が最初にTAIを開発するかを考える手がかりにもなる。
本研究の主な目的は、学習コストに関する次の問いに答えることである。
- 学習のドル建てコストは、時間とともにどれくらいのペースで増えているか。
- 学習コストのトレンドは安定しているのか、鈍化しているのか、加速しているのか。
- これまでで最も高額な機械学習の学習の実行はどれか。
もう1つの目的は、ドル建てコストを推定するさまざまな手法を検討し、手法の違いが結果に与える影響を分析することである。機械学習の学習の実行のドル建てコストについては、計算コストよりもさらに公開情報が少ない傾向があるため、不確実性を減らす手段として別の推定手法を検討することは特に重要だと考えている。
手法
学習用計算資源のドル建てコストを推定する手法の背景
本研究では、ある機械学習システムを生み出した最終的な学習の実行について、計算資源の実際のコストを推定する。13最終的な学習の実行にかかる計算資源のコストは、次の2つに分解する。
- ハードウェアコスト:ハードウェアの初期費用のうち、その学習の実行に費やされた分。
- エネルギーコスト:学習の実行中にハードウェアを動かす電気代。
ハードウェアコストを推定するモデルとして、私の知る限り最も単純なのは次のものである。14
ここで training_time はハードウェア1台あたりの学習に使ったGPU時間、hardware_replacement_time はそのハードウェアが新しいハードウェアに置き換えられるまでに使われる総GPU時間である。
このモデルでは、開発者が n_hardware 台のハードウェアを単価 hardware_unit_price で購入し、各台を合計 hardware_replacement_time の期間使うと考える。したがってハードウェアの初期費用は hardware_replacement_time にわたって償却され、ハードウェアの使用料が $/s 単位で得られる。開発者はその $/s のレートで、ある機械学習システムの学習に training_time を費やす。なお、このモデルはハードウェアの販売価格以外のハードウェア関連コスト(スイッチや相互接続ケーブルなど)を無視している点に注意してほしい。
エネルギーコストを推定するモデルとして、私の知る限り最も単純なのは次のものである。15
ここで hardware_power_consumption の単位は kW、energy_rate の単位は $/kWh である。最大消費電力は通常、ハードウェアのデータシートに記載されている。たとえば NVIDIA V100 の PCIe モデルの最大消費電力は 0.25kW と公表されている。
クラウドコンピューティングの価格を使えば、ハードウェア、エネルギー、保守のコストを個別に推定せずに考慮できる。クラウドコンピューティングの価格は通常、使用時間1時間・ハードウェア1台(たとえばGPU 1基)あたりのドルで表される。16したがって、最終的な学習の実行をクラウドコンピューティングで計算した場合のコストは、次の式で求められる。
ただし、クラウドコンピューティング事業者は利益を上げる必要があるため、その価格には事業者のコストに上乗せされた利ざやも含まれる。そのため、クラウドコンピューティングの価格(特に割引価格ではなくオンデマンド価格)は、実際の学習コストの上限として役立つ。本研究では、クラウドコンピューティングの価格ではなく、ハードウェアの価格だけを使ってコストを推定する。
学習計算量とGPUの価格性能比から学習コストを推定する
前節で示した推定モデルは、コストと最も直接的に相関する変数(購入したハードウェアの台数など)を追う、最も単純なモデルだと私は考えている。そのため、これらのモデルは不確実性の要因を最小限に抑えられる。しかし、ある機械学習システムの学習時間や、学習に使われたハードウェアの台数についての情報は、手に入らないことが多い。一方、機械学習システムの学習計算量を推定するのに十分な情報は、比較的手に入りやすい。Compute Trends Across Three Eras of Machine Learning(Sevilla et al., 2022)とそれに付随するデータベース17は、機械学習システムの学習計算量の推定値を、現時点で最も包括的にまとめたものである。18データが入手しやすいことから、前節で示したモデルではなく、FLOP単位の学習計算量を使う推定モデルを選んだ。
学習計算量からハードウェアコストを推定するには、ハードウェアの価格性能比(1ドルあたりのFLOP/s)も知る必要がある。本研究では、Trends in GPU price-performance で全GPU(n=470)について見いだされた価格性能比のトレンドを使う。また、同研究のGPUデータセットにある個々のGPUの価格性能比の推定値も一部使う(詳しくはこちらの付録を参照)。推定するのはハードウェアコストだけで、エネルギーコストは推定しない。その理由は、(a) エネルギーコストはそれほど大きくないとみられること(根拠はこちらの付録を参照)、(b) 私にとっては、エネルギー消費のデータよりも、ハードウェアのスループットと計算量に関するデータのほうが入手しやすかったことである。
ある機械学習システムの学習のハードウェアコスト(ドル)を推定するのに実際に使ったモデルは、次のとおりである。
\textit{hardware_cost} = \textit{training_compute} / \textit{realised_training_compute_per_\$}ここで realised_training_compute_per_$ の単位は FLOP/$ であり、次の式で表される。
\textit{realised_training_compute_per_\$} = \textit{hardware_price_performance} \cdot \textit{hardware_utilization_rate} \cdot \textit{hardware_replacement_time}ここで hardware_utilization_rate は、理論上のピークFLOP/sスループットのうち学習で実際に達成された割合である。hardware_price_performance の単位は1ドルあたりのFLOP/sで、次の式で表される。
このモデルを実際に使うには、いくつかの課題がある。
-
学習計算量はそれ自体が複数の変数にもとづく推定値であり、大きな不確実性を伴う傾向がある。19
-
ハードウェアの交換時期は、開発者の資源とニーズによって異なる。たとえば開発者は、以前のハードウェアのコストを研究成果で「回収」していなくても、大規模な実験を行えるだけの資金を得たために、早めにハードウェアを更新することがある。
-
ある機械学習システムで達成されたハードウェア利用率についての情報は、信頼できないことが多い。
-
ハードウェアの単価は時期によって変動する。近年(2019年以降)は、1.5倍程度の変動がよくあるようだ。20
上記の問題を無視して、次の単純化の仮定を置いた。
- 学習計算量の推定値を真の値とする。
- ハードウェアの交換時期は一定で2年とする。21
- 学習中は一定の利用率35%が達成されたとする。22
- 各ハードウェアモデルについて、信頼できそうな情報源が報じた単価のうち、そのハードウェアの発売日に最も近い時期に報じられたものを使った。(データの出典についての詳細はこちらの付録にある。)
本研究の結果は上記の仮定に依存しているが、こちらの付録ではこれらの仮定の影響を定量化し、機械学習システムの最終的な学習の実行にかかる計算資源のコストについて、私の実際の最善の推測と本当の不確実性を推定しようと試みた。
手法1:GPU全体の価格性能比のトレンドを使う
hardware_price_performance 変数を推定する方法の1つは、価格性能比の全体的な経時トレンドを使うことである。こうすれば、各機械学習システムに実際に使われたハードウェアを知る必要がなくなる。Trends in GPU price-performance では、GPUハードウェアの価格性能比(1ドルあたりのFLOP/s)は平均しておよそ2.5年ごとに倍増してきたと推定された。価格性能比を推定する1つ目の手法として、このトレンドを使った。具体的には、機械学習システムが発表された時点でのトレンド線の値を、その価格性能比とした。
手法2:機械学習システムの学習に実際に使われたハードウェアの価格性能比を使う
手法1は、次の点で現実的でない。
- ハードウェアの購入は実際には、システムの発表日より前、おそらく学習の実行が始まる数か月から数年前に行われる。
- 実際に達成できる価格性能比は離散的である。
- 第一に、価格性能比は、その時点でどのGPUが入手できるかに左右される。Trends in GPU price-performance のグラフに見られるように、新しいGPUが入手可能になる時期は離散的で、やや不規則である。
- 第二に、価格性能比は、実際にどのハードウェアを選んだかに左右される。実際の価格性能比はハードウェアの機種によって異なり、実際に使われたハードウェアは、市場で入手できる最新のハードウェアより古い場合もある。
こうした限界に対処するため、2つ目の推定手法では、ある機械学習システムの学習に実際に使われたハードウェアの価格性能比にもとづいて推定する。たとえば GPT-3 は NVIDIA V100 GPU を使ったと報じられている。そこで GPT-3 の学習コストを推定する際には、V100 の実際のFLOP/sの仕様値と推定単価を使って、価格性能比(1ドルあたりのFLOP/s)を計算した。そしてその価格性能比の値を、前述のハードウェアコストの式に当てはめた。
データセット
データセットは Training cost trends in machine learning で公開している。データの収集と処理の方法の詳細はこちらの付録にある。
コード
すべての結果は、付属の Colab ノートブックを使って作成した。
大規模システム
Compute Trends Across Three Eras of Machine Learning で示された主な結果では、2015年後半以降、1つの計算量のトレンドを同時並行する2つのトレンドに分けていた。そのうちの1つが「大規模」システムのトレンドである。大規模システムとは、全システムの平均的な計算量のトレンドから上に外れたシステム(つまり、異常に多くの学習計算量を使ったシステム)を指す。学習計算量とAIの能力の関係を考えると、23こうした大規模システムのトレンドは、将来のAIの能力の最先端がどうなるかを知る手がかりとして、より有用である。
大規模システムの学習コストのデータセットを作るにあたり、まず Compute Trends Across Three Eras of Machine Learning と同じシステム群から始めた。次に、こちらの結果の節に示したグラフを目視で確認し、より最近公開された次のシステムを加えた。24「Chinchilla」「PaLM (540B)」「OPT-175B」「Parti」「Minerva (540B)」である。
結果
手法1:全機械学習システムについてGPU全体の価格性能比のトレンドを使う(n=124)
全機械学習システムの学習コストの増加率:年0.51桁
図2は、選んだ機械学習システム(n=124)の学習コストをシステムの発表日に対してプロットし、線形のトレンド線を引いたものである(y軸が対数目盛りであることに注意)。対数線形回帰を当てはめると、最終的な学習の実行にかかる計算資源のドル建てコストの増加率は年0.51桁(90%信頼区間:年0.45〜0.57桁)となった。注目すべきことに、この増加は、Sevilla et al. (2022, Table 3) が示した「全システム」(n=98)の2010〜2022年の計算量(FLOP単位)のトレンド、年0.7桁(90%信頼区間:年0.6〜0.7桁)よりもゆるやかである。
この増加率の推定値は、計算量と価格性能比の対数線形トレンドを組み合わせた結果にすぎない点に注意してほしい。先行研究で報告された計算量の増加率(年0.7桁)から、GPUの価格性能比の増加率(年0.12桁)を差し引くだけでも、同程度の増加率が推定できる。25
当てはめたトレンドにもとづくと、2030年初めまでに予測される、画期的な機械学習システムの平均的な学習コストの増加は次のとおりである。
- 2022年末と比べて+3.6桁(90%信頼区間:+3.2〜+4.0桁)
- 5億ドル(90%信頼区間:9,000万〜30億ドル)
ここでも、また以降の同様の結果すべてでも、正確なコストの予測よりも、桁単位での追加の増加の予測のほうに確信を持っている。前者は、不正確かもしれない定数因子(ハードウェアの交換時期やハードウェア利用率など)の影響を受けないからである。
図2:連続的なGPUの価格性能比のトレンドを使って推定した、画期的な機械学習システムの学習用計算資源のコスト。機械学習システム名のラベルが付いたインタラクティブ版のグラフは、こちらの Colab ノートブックのセルを参照のこと。
大規模機械学習システムの学習コストの増加率:年0.2桁
「大規模」システム群に対数線形回帰を当てはめると、図3のグラフが得られた。傾きはおよそ年0.2桁(90%信頼区間:年0.1〜0.4桁)だった。この結果はより小さなサンプル(n=124に対してn=25)にもとづくものだが、最も高額な学習の実行のコストは、画期的な機械学習システム全体よりも大幅にゆるやかに増えていると結論づけるには十分な証拠があると考える。これは、AI and Compute(CSET)や、Cotra の「Forecasting TAI with biological anchors」26の予測と方向性が一致している。すなわち、主要なAI開発者が現在学習に支出する意思の程度を踏まえ、また近年の全体的な増加率は持続不可能に見えることも踏まえると、近年の支出の増加は2020年代のうちに大きく鈍化する可能性が高い、という予測である。
当然ながら、大規模システムの増加率が、全システムの増加率よりもこれほど低い状態が長く続くことはありえない。もしそうなら、全システムの増加がすぐに現在の大規模システムに追いついてしまうからである。大規模システムの増加がはるかにゆるやかである主な理由は、「大規模」システムの選び方が、計算量の多い外れ値に大きな重みを置くことにあるようだ。このデータセットで早い時期に現れた AlphaGo Master や AlphaGo Zero などの外れ値は特に高く、そのため後の外れ値がそれほど極端に見えなくなる。とはいえ、これによって大規模システムへの支出の増加がよりゆるやかだという結論が損なわれるとは考えていない。むしろ、大規模システムの将来のコストについての不確実性が増すということである。
当てはめたトレンドにもとづくと、2030年初めまでに予測される、大規模機械学習システムの学習コストの増加は次のとおりである。
-
2022年末と比べて+1.8桁(90%信頼区間:+1.0〜+2.4桁)。27
-
8,000万ドル(90%信頼区間:600万〜7億ドル)
つまり、大規模システムのトレンドは全システムの平均的なトレンドより高い水準から始まるものの(前節を参照)、増加がゆるやかなため、予測値は5億ドル(90%信頼区間:1億〜30億ドル)より低くなる。
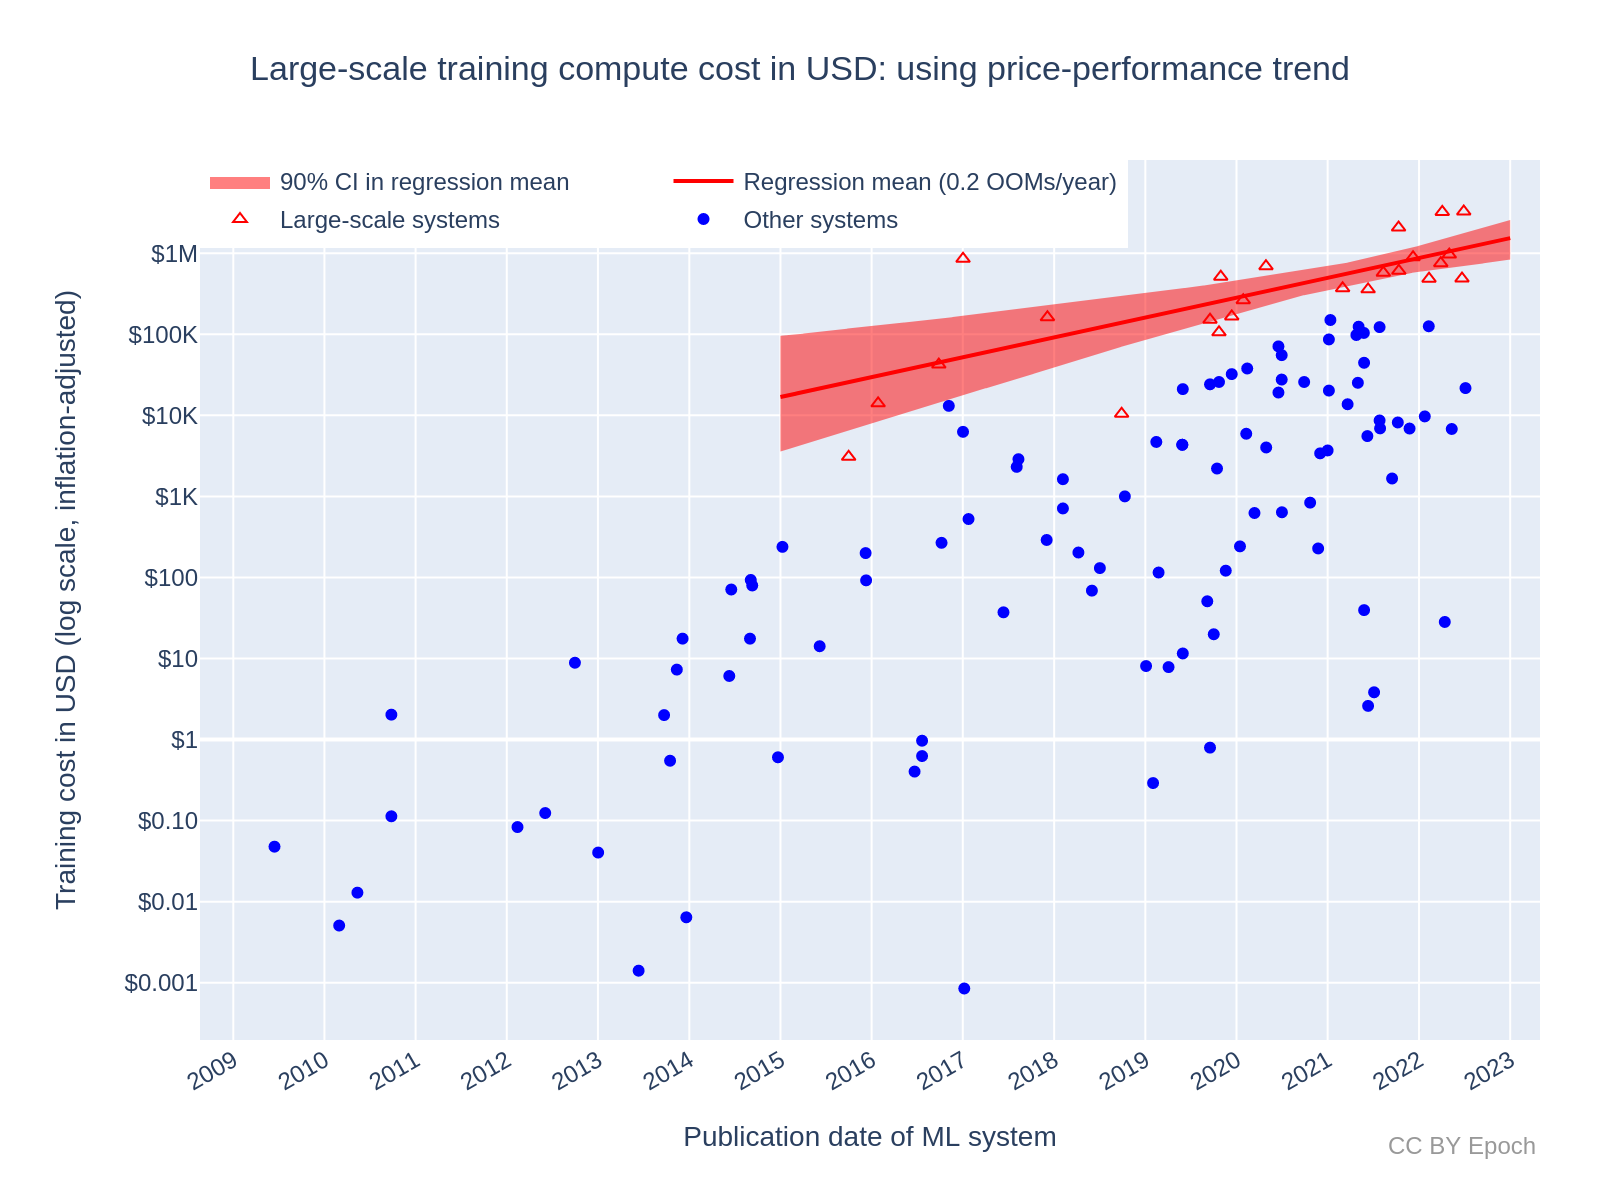
図3:手法1を使って推定した、大規模機械学習システムの学習用計算資源のコスト。機械学習システム名のラベルが付いたインタラクティブ版のグラフは、こちらの Colab ノートブックのセルを参照のこと。
手法2:機械学習システムの学習に使われたNVIDIA GPUの価格性能比を使う(n=48)
全機械学習システムの学習コストの増加率:年0.44桁
図4は、NVIDIA GPUで学習した機械学習システム(n=48)の学習コストの桁を、システムの発表日に対してプロットし、線形のトレンド線を引いたものである。トレンドは年0.44桁(90%信頼区間:0.34〜0.52)となった。つまりこのモデルは、GPU全体の価格性能比のトレンドにもとづくモデルの年0.51桁(90%信頼区間:0.44〜0.59)よりもゆるやかな増加を予測する。この増加率(年あたりの桁数)の違いは、単にデータセットが小さいことによるものだと分かった。ただし絶対的なコスト(ドル)の推定値は、平均して手法1のおよそ2倍である。28
当てはめたトレンドにもとづくと、2030年初めまでに予測される、画期的な機械学習システムの平均的な学習コストの増加は次のとおりである。
- 2022年末と比べて+3.1桁(90%信頼区間:+2.4〜+3.6桁)
- 2億ドル(90%信頼区間:800万〜20億ドル)
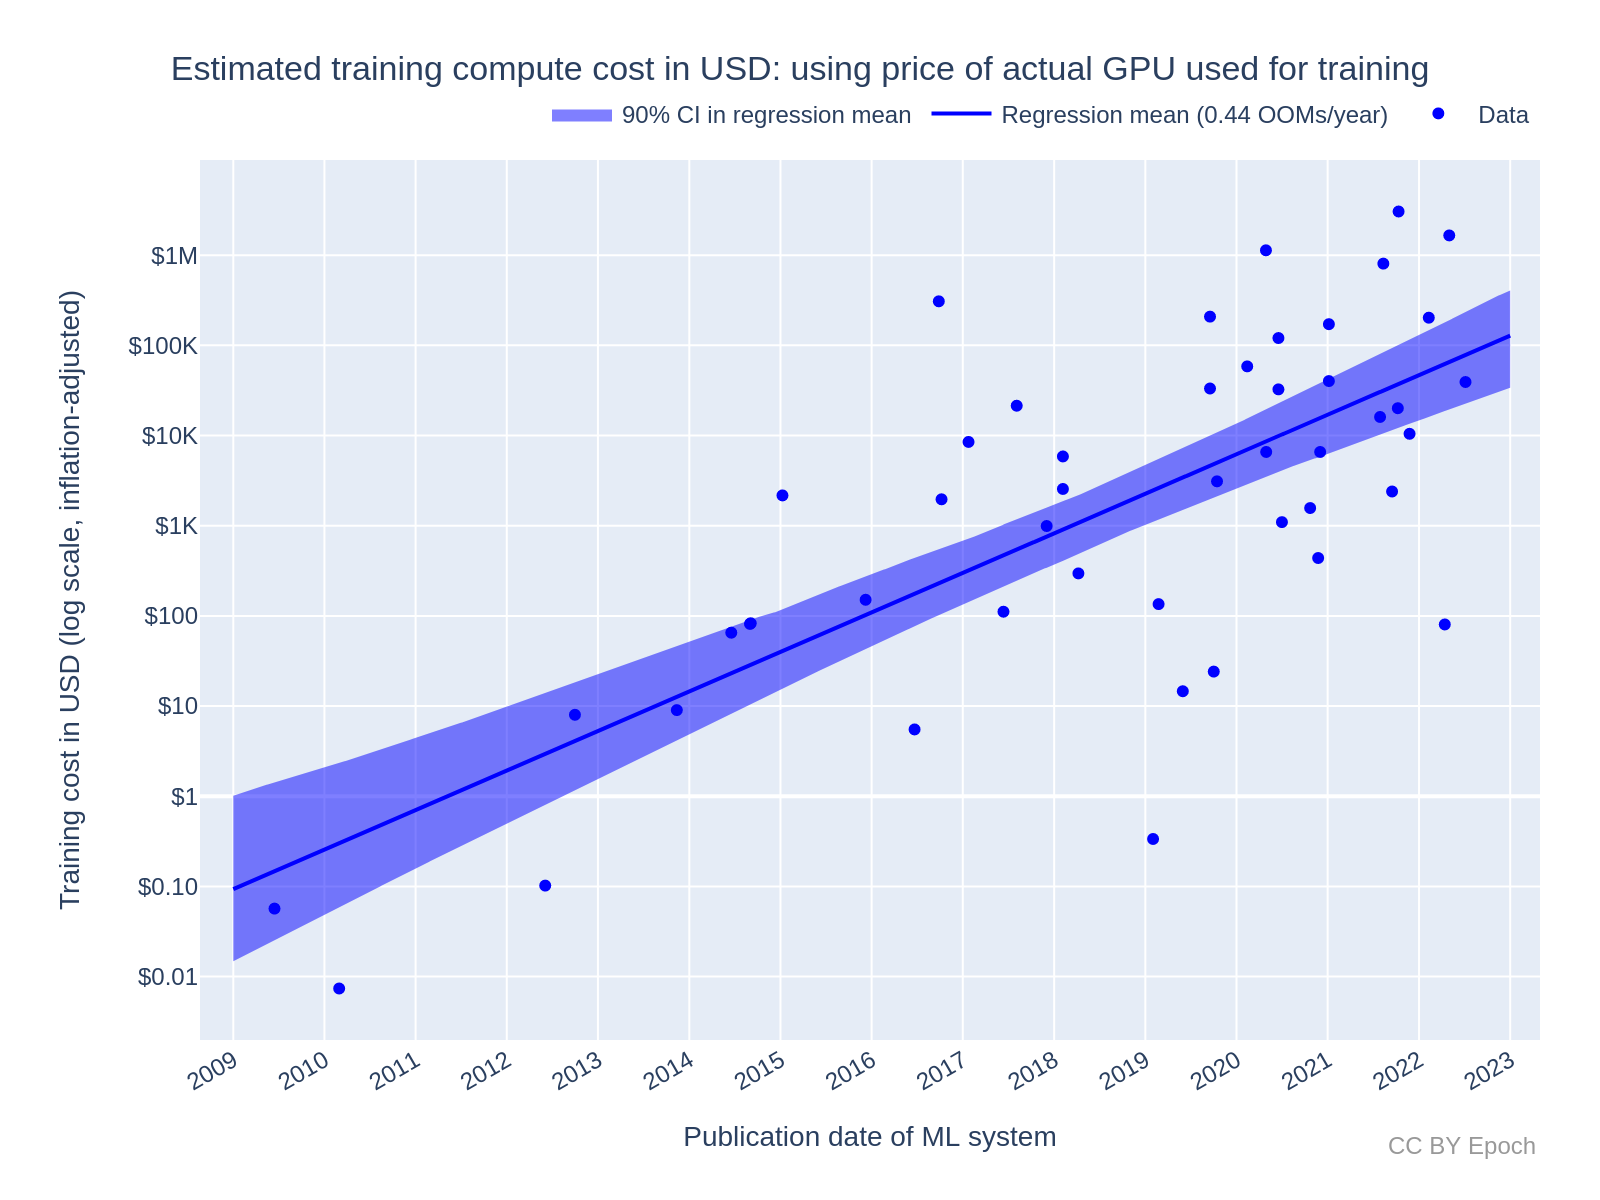
図4:学習に実際に使われたNVIDIA GPUのピーク時の価格性能比を使って推定した、画期的な機械学習システムの学習用計算資源のコスト。機械学習システム名のラベルが付いたインタラクティブ版のグラフは、こちらの Colab ノートブックのセルを参照のこと。
大規模機械学習システムの学習コストの増加率:年0.2桁
大規模システムのトレンドについては、手法1と同じ方法で大規模システムを選び出したが、手法2のより小さなサンプル(n=48)に含まれるシステムだけを対象にした。その結果、残ったのはわずか6件だった。このシステム群に対数線形回帰を当てはめると、図5のグラフが得られた。傾きはおよそ年0.2桁(90%信頼区間:年0.1〜0.4桁)だった。サンプルサイズが非常に小さく、不確実性も非常に大きいため、この結果は他の結果よりもずっと軽く扱うべきである。この回帰による2030年の予測は無視し、手法1を採るべきだと考える。とはいえ少なくとも、最も高額な学習の実行のコストが画期的な機械学習システム全体よりも大幅にゆるやかに増えてきたことがうかがえる点では、この結果は手法1と一致している。
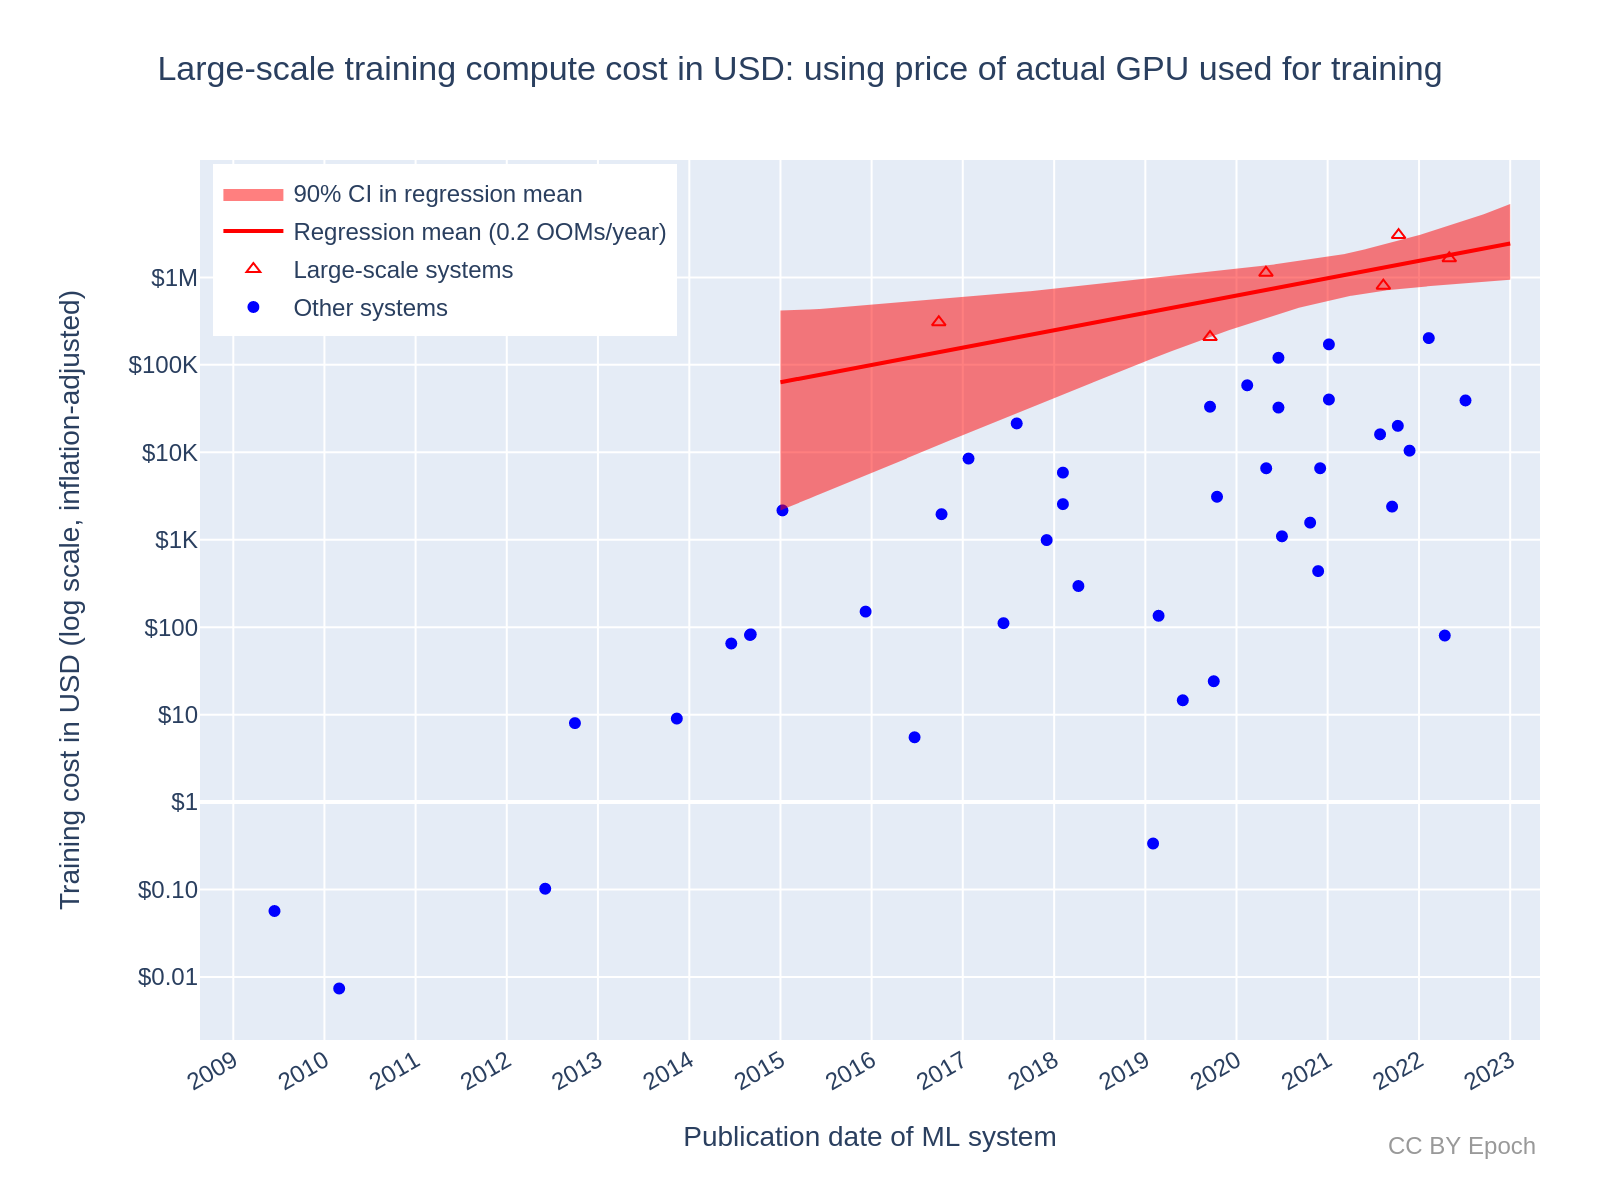
図5:手法2を使って推定した、大規模機械学習システムの学習用計算資源のコスト。機械学習システム名のラベルが付いたインタラクティブ版のグラフは、こちらの Colab ノートブックのセルを参照のこと。
全回帰結果のまとめと比較
表2と表3は、それぞれ「全システム」と「大規模」システムについて、すべての回帰結果をまとめたものである。「全システム」の回帰結果が期間の取り方に対してどれほど頑健かを分析したところ、手法1が予測する平均増加率は期間を変えてもかなり頑健であるのに対し、手法2はその点ではるかに頑健性が低かった(詳しくはこちらの付録を参照)。ただし、個々のコストの推定値は手法2のほうが正確だと考えている。手法2は、各機械学習システムの学習に使われた特定のハードウェアの価格データを使うからである。全体としては、現在のデータセットでは手法1で得た増加率のほうが頑健だと考える。ただし、手法2について同程度の数のデータ点が得られれば、この結論が変わる可能性はそれなりにありそうだ。そのデータの収集は、今後の研究として取り組む価値があるだろう。
| 推定方法 | 期間 | データ | 増加率(年あたりの桁数) | 2030年までの予測平均コスト |
|---|---|---|---|---|
| 手法1(ハードウェア価格の平均的なトレンドを使用) | 2009– 2022 | 全システム(n=124) | 0.51 90%信頼区間:0.45〜0.57 | 5億ドル (90%信頼区間:9,000万〜30億ドル) |
| 手法2(実際のハードウェア価格を使用) | 2009– 2022 | 全システム(n=48) | 年0.44桁 90%信頼区間:0.34〜0.52 | 2億ドル (90%信頼区間:800万〜20億ドル) |
| 結果の加重混合29 | 2009– 2022 | 全システム | 年0.49桁 90%信頼区間:0.37〜0.56 | 3億5,000万ドル (90%信頼区間:4,000万〜40億ドル)30 |
| 計算量のトレンド(参考)31 | 2010– 2022 | 全システム(n=98) | 年0.7桁 95%信頼区間:0.6〜0.7 | 該当なし |
| GPUの価格性能比のトレンド(参考)32 | 2006– 2021 | 全GPU(n=470) | 年0.12桁 95%信頼区間:0.11〜0.13 | 該当なし |
表2:画期的な機械学習システムの最終的な学習の実行に使われる計算資源のドル建てコストについて、対数線形回帰にもとづいて推定した経時的な増加率。参考として、下の2行には、先行研究で見いだされた学習計算量(FLOP単位)とGPUの価格性能比(1ドルあたりのFLOP/s)のトレンドを示す。
| 推定方法 | 期間 | データ | 増加率(年あたりの桁数) | 2030年までの予測平均コスト |
|---|---|---|---|---|
| 手法1(ハードウェア価格の平均的なトレンドを使用) | 2015–2022 | 大規模(n=25) | 年0.2桁 90%信頼区間:0.1〜0.4 | 8,000万ドル (90%信頼区間:600万〜7億ドル) |
| 手法2(実際のハードウェア価格を使用) | 2015–2022 | 大規模(n=6) | 年0.2桁 90%信頼区間:0.1〜0.4 | 6,000万ドル (90%信頼区間:200万〜90億ドル) |
| 計算量のトレンド(参考)33 | 2015–2022 | 大規模(n=16) | 年0.4桁 95%信頼区間:0.2〜0.5 | 該当なし |
表3:大規模機械学習システムの最終的な学習の実行に使われる計算資源のドル建てコストについて、対数線形回帰にもとづいて推定した経時的な増加率。参考として、最下行には先行研究で見いだされた学習計算量(FLOP単位)のトレンドを示す。
支出の上限に達する時期の予測
過去のトレンドを使えば、最も高額な学習の実行への計算資源の支出が、経済的な制約にもとづくなんらかの上限にいつ達するかを(不確実性は大きいものの)予測できる。支出の本当の上限がどこにあるかについては、非常に不確かである。しかし Cotra (2020) にならい、コストの上限として2,330億ドル(2021年の米国GDPの1%)を選んだ。少なくとも、AIへの世界的な投資の規模にとって重要な閾値だと思われるからである。34
想定した上限に達する時期を予測するにあたり、次の事実と推定値を使った。
- 米国GDP:2021年に23兆3,200億ドル35
- 選んだ支出の閾値:GDPの1%=0.01 × 23兆3,200億ドル=2,332億ドル
- この数値はおよそ 10^11.37 に等しい
- 過去の起点となるコストの推定値:327万ドル(Minerva) 2. この数値はおよそ 10^6.51 に等しい 3. Minerva の時点はおよそ2022.5年(2022年6月29日)
- 2025年初めの推定コスト:6,000万ドル36 4. これはおよそ 10^7.78 である
- コストが支出の上限に達する年を推定する式:[起点の年]+([上限]−[起点]の桁数)/[将来の増加率(年あたりの桁数)] 5. 上記の数値を使った例:2022.5 +(11.37 − 6.51 桁)/(年0.49桁)≒ 2032
得られた予測は次のとおりである。まず単純な外挿による予測、次に私の最善の推測にもとづく予測を示す。
- 現時点で最も高額なコスト推定値(Minerva、327万ドル)から、過去の増加率を使って単純に外挿した場合:
- 「全システム」のトレンドである年0.49桁(90%信頼区間:0.37〜0.56)を使うと、2032年(90%信頼区間:2031〜2036年)に2,332億ドルのコストに達する。この外挿を図6に示す。
- 「大規模」のトレンドである年0.2桁(90%信頼区間:0.1〜0.4)を使うと、2047年(90%信頼区間:2035〜2071年)に2,332億ドルのコストに達する。
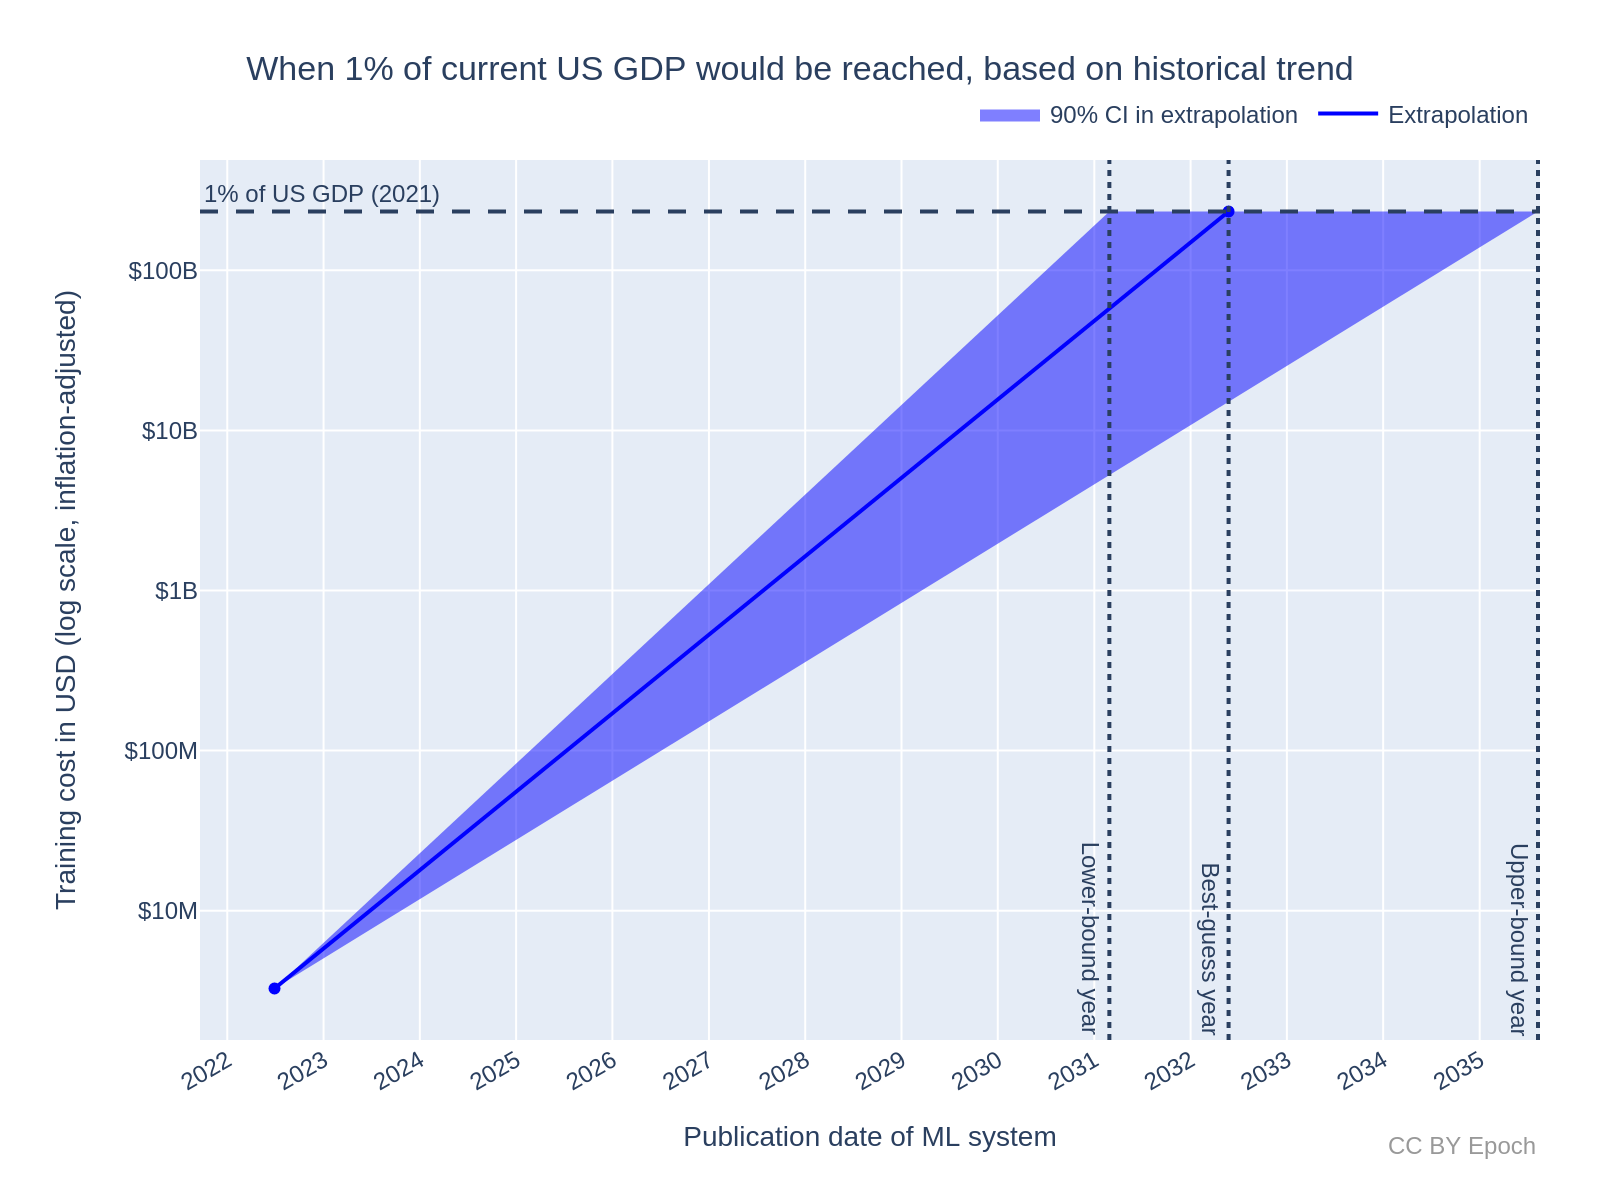
図6:現時点で最も高額なコスト推定値(Minerva、327万ドル)と、「全システム」について見いだされた過去の増加率だけにもとづいて、学習コストを現在の米国GDPの1%まで外挿したもの。
私の最善の推測では、コストの増加が今後鈍化することを示す証拠と、コスト推定値に含まれる偏りの要因を考慮して補正している。37これらの補正は一部を私の直観的な判断に頼っているため、結果は慎重に解釈すべきである。結果は次のとおりである38。
独立した印象39:2025年の初期コストを2億ドル(90%信頼区間:2,900万〜8億ドル)とし、年0.3桁(90%信頼区間:年0.1〜0.4桁)の増加率で外挿すると、2036年(90%信頼区間:2032〜2065年)に2,332億ドルのコストに達する。
すべてを考慮した見解:2025年の初期コストを3億8,000万ドル(90%信頼区間:5,500万〜15億ドル)とし、年0.2桁(90%信頼区間:年0.1〜0.3桁)の増加率で外挿すると、2040年(90%信頼区間:2033〜2062年)に2,332億ドルのコストに達する。この外挿を図7に示す。
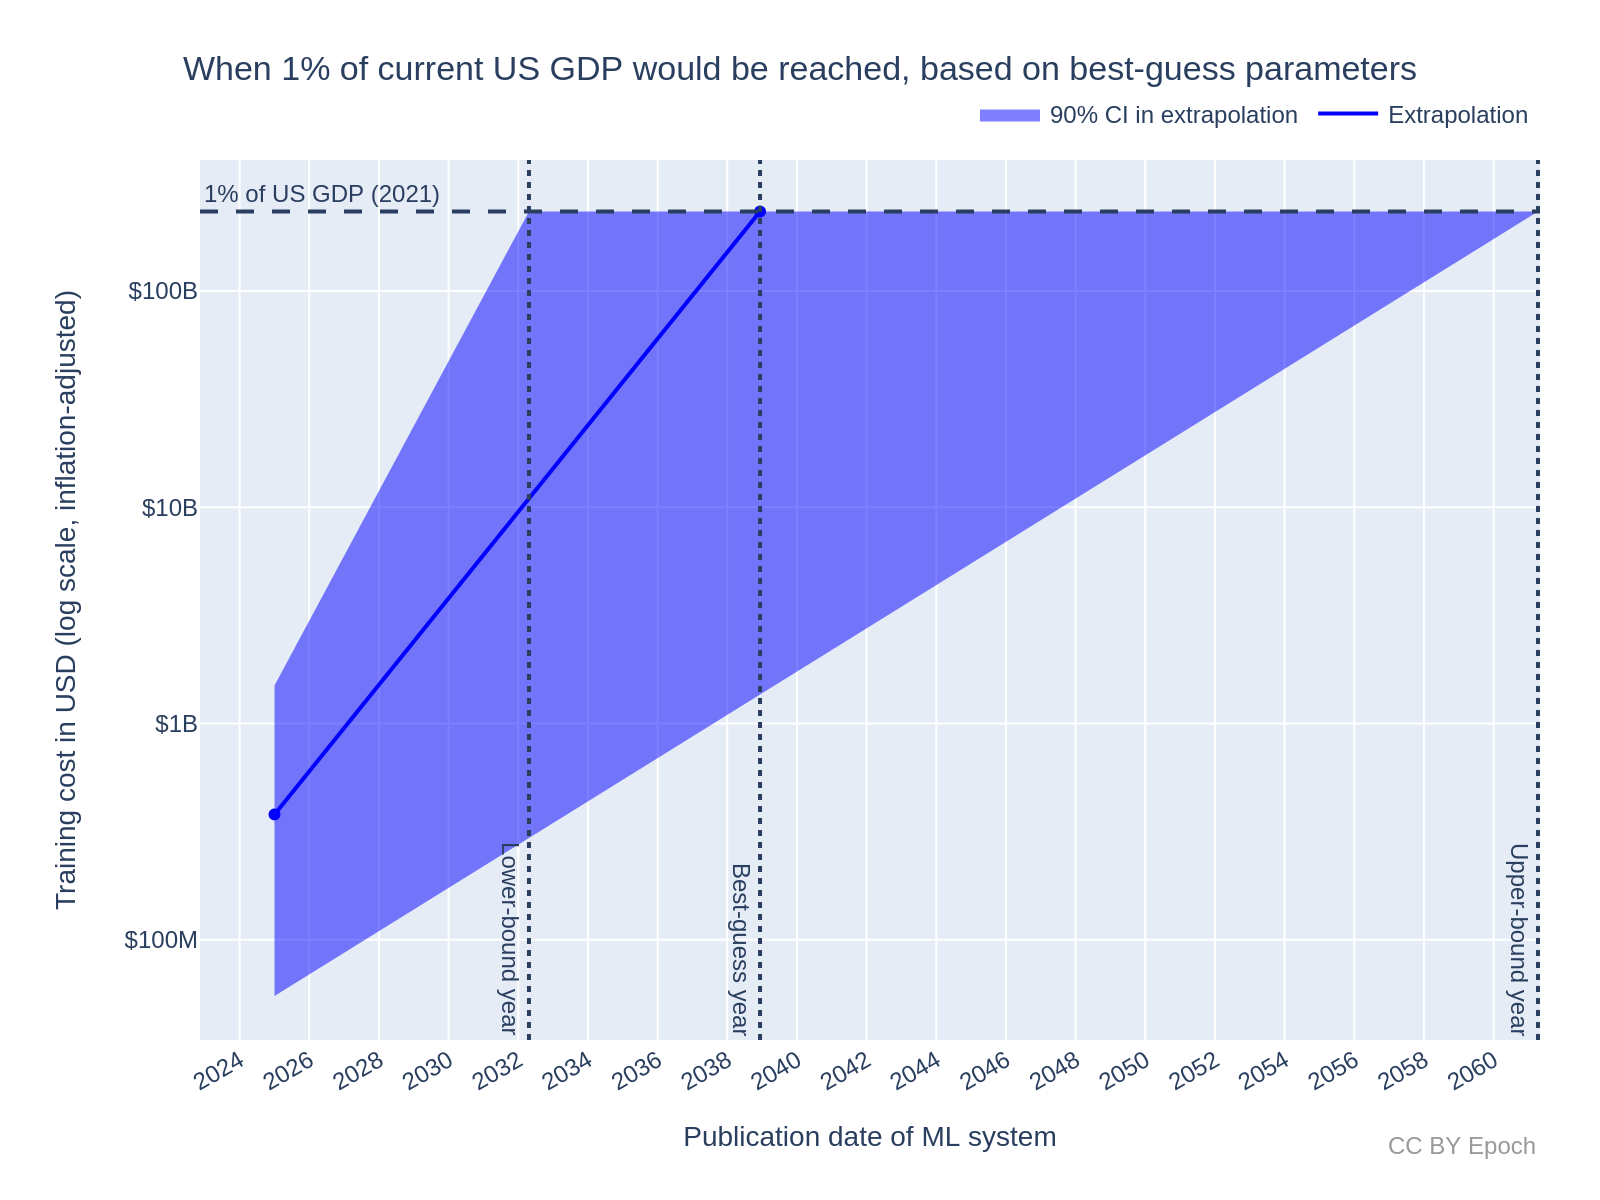
図7:2025年時点で最も高額なコストと増加率について、私の最善の推測によるパラメータにもとづいて、学習コストを現在の米国GDPの1%まで外挿したもの。本文で報告した年は、このグラフで使った決定論的な計算よりも1年ほど遅い点に注意してほしい。これは Guesstimate で使われているモンテカルロ法による推定のためだと思われる。
今後の研究への提言
手法2にGoogle TPUで学習したシステムを含める
手法1のサンプルが124件だったのに対し、手法2に使ったデータセットのサンプルは48件しかなかった。さらにこのデータセットには、NVIDIA GPUで学習したと私が確認できた機械学習システムしか含まれていない。今後の研究では、他のハードウェア、特に Google のTPUを含めるとよいだろう。私のデータセットのシステムのうち、少なくとも25件がTPUで学習されていたことが分かっている(データが欠けているシステムもあるので、25件より多い可能性もある)。
クラウドコンピューティングの価格と利益率を使って、コストのより信頼できる範囲を推定する
今後の研究として、次の手法を発展させることで、FLOP/$(ひいては学習の実行のハードウェアコスト)について、より信頼できる上限・下限を推定することを勧める。40
- FLOP/$ の推定手法1:GPUのピーク性能(FLOP/s)を価格(ドル)で割って価格性能比を求める。それに一定のハードウェア交換時期(秒)を掛けて、FLOP/$ 単位の値を得る。
- 発展1:そのGPUについての NVIDIA の利益率を推定する。公表価格や小売価格をその利益率の分だけ割り引いて、ハードウェアコストの下限(つまり、おおむね製造コスト)を得る。次に、公表価格や小売価格の代わりにそのコストを使って、1ドルあたりのFLOP/sの上限値を求め、手法1で使う。
- ハードウェアが可能な限り安いことになるので、これによって学習用計算資源のコストの下限が得られる。
- 発展2:公表価格や小売価格(または発展1のように推定した製造コスト)(ドル)を、クラウドコンピューティングのレンタル価格(ドル/時間)で割って、ハードウェアの交換時期を推定する。そしてその値を手法1で使う。
- 製造コストが価格の下限であり、オンデマンドのクラウドコンピューティングのレンタル価格が1時間あたりの価格の上限であるなら、これによってハードウェア交換時期の下限が得られる。
- 代わりに小売価格と、最大限に割り引かれたレンタル価格(たとえば3年間のレンタル契約に対する割引)を使えば、この推定値はハードウェア交換時期の上限に近くなる。
- 発展1:そのGPUについての NVIDIA の利益率を推定する。公表価格や小売価格をその利益率の分だけ割り引いて、ハードウェアコストの下限(つまり、おおむね製造コスト)を得る。次に、公表価格や小売価格の代わりにそのコストを使って、1ドルあたりのFLOP/sの上限値を求め、手法1で使う。
- FLOP/$ の推定手法2:GPUのピーク性能(FLOP/s)を、現在のクラウドコンピューティングのレンタルコスト(ドル/時間)で割って、FLOP/$ 単位の値を得る。
- 発展1:GPU全体の価格性能比の増加率を使って、この現在の FLOP/$ の値から過去の時点 t(機械学習システムの発表日)へ外挿する。ここでは、FLOP/$ と1ドルあたりのFLOP/sは定数倍しか違わず、したがって増加率は FLOP/$ と1ドルあたりのFLOP/sで同じだと仮定する。
- こうして得た FLOP/$ の値を使えば、学習用計算資源のコストの上限が得られる。オンデマンドの時間単位のクラウドコンピューティングの価格には比較的大きな利ざやが含まれているうえ、私のデータセットのうちクラウドコンピューティングで学習した機械学習システムは、クラウドコンピューティングサービスが提供する割引を利用していた可能性が非常に高いと考えられるからである。41
- 発展1:GPU全体の価格性能比の増加率を使って、この現在の FLOP/$ の値から過去の時点 t(機械学習システムの発表日)へ外挿する。ここでは、FLOP/$ と1ドルあたりのFLOP/sは定数倍しか違わず、したがって増加率は FLOP/$ と1ドルあたりのFLOP/sで同じだと仮定する。
投資、支出の配分、収益を調べる
さらなる調査に値する重要で幅広いテーマとして、AIへの投資、AIへの支出の配分、AIシステムが生み出す収益について、それぞれのトレンドと相互の関係を理解することが挙げられる。これが分かれば、将来AIにどれだけ支出する意思があるか、また大規模な学習用計算資源のコストの増加率が今後も下がり続けるのか、横ばいになるのか、上がるのかを推定する手がかりになる。それはさらに、TAIがいつ到来するか、そしてそれまでの間にAIがどのような影響を及ぼすかの予測にもつながる。
付録
付録A:最終的な学習の実行のエネルギーコストは、ハードウェアコストの約20%とみられる
エネルギーコストの例として、GPT-3 は学習中に 1,287 MWh のエネルギーを消費したと推定されている。42この推定は、メモリ、ネットワークインターフェース、冷却ファン、ホストCPUを含めた、GPUチップ1基あたりのシステム平均電力の実測値にもとづいている。また、「データセンター内の計算機器を直接動かす電力を超えるエネルギーのオーバーヘッド」も考慮している。43米国エネルギー情報局のこの記事の最初のグラフから判断すると、2020年の米国の平均電力価格は1kWhあたり約0.13ドルだった。これらの数値を掛け合わせると、1,287,000 kWh × 0.13ドル/kWh=167,310ドルとなる。
比較のため、私が推定した GPT-3 のハードウェアコストは次のとおりである。
- GPUの価格性能比の全体的な線形トレンドを使った場合、70万ドル
- 実際のハードウェアの価格性能比を使った場合、110万ドル
したがってエネルギーコストは、ハードウェアコストの約24%または15%になる(平均するとおよそ20%で、これが表題の数字である)。エネルギーコストは、学習のエネルギーコストとハードウェアコストの合計に対しては、それぞれ約20%または13%を占めることになる(平均するとおよそ17%)。
これは1つの機械学習モデルを使った1つの例にすぎないが、ハードウェアコストに対するエネルギーコストのおおよその目安として参考になると考える。この1つの例にもとづき、ハードウェアコストは一般にエネルギーコストの数倍大きく、したがって機械学習システムを生み出す総コストを推定する際には、ハードウェアコストに注目するほうが重要だと仮定する。
付録B:データの収集と処理
機械学習システムの名前、発表日、FLOP単位の学習計算量は、Parameter, Compute and Data Trends in Machine Learning(2022年8月20日時点)から取得した。44このデータベースに収録されたシステムは、「画期的な」機械学習システムとみなされている。45システムの一覧を、FLOP単位の計算量の推定値がすでにあり、かつ2006年より後に発表されたもの(GPUの価格性能比のデータがおおよそこの時期から始まるため)に絞り込んだ。その結果、124件のシステムが残った。最も古いシステムは、2009年に発表された「Large-scale Deep Unsupervised Learning using Graphics Processors」の「GPU DBNs」で、これはたまたま2010年にディープラーニングの時代が始まる直前にあたる。46
手法1では、Trends in GPU price-performance で報告された全GPUのトレンド(倍増期間2.45年、つまり10倍になるまで8.17年)を使った。同研究のデータは2020年までで、インフレ調整がされているため、47学習のドル建てコストには2020年の米ドルを単位として使った。また、GPUの価格性能比のデータは2021年までしかないのに対し、2021年と2022年の機械学習システムも含めたため、そのトレンドを少しだけ外挿していることになる。
各機械学習システムの学習に使われたハードウェアのデータは、私のデータセットの「ML SYSTEMS」列の「Hardware model」列にある。124件の機械学習システムのうち、論文に具体的なハードウェアの情報が記載されていたのは78件だった。48この78件のうち、48件が NVIDIA GPU を使っていた。「実際のハードウェア」による推定手法(手法2)では、サンプルを NVIDIA GPU を使った48件のシステムだけにした。今後の研究では、Google のTPUなど他のハードウェアを含めるとよいだろう。私のデータセットのシステムのうち少なくとも25件が、TPUで学習されていたことが分かっている。49
個々のハードウェアモデルの価格性能比を推定するため、「HARDWARE」というスプレッドシートを作成した。これは上記のリンク先のデータセットにある。当初は Parameter, Compute and Data Trends in Machine Learning データベースの「HARDWARE_DATA」シートのコピーだったが、いくつか変更を加えた。
-
NVIDIA A100 を含め、GPUの種類やGPUに関するデータを追加した
-
価格情報の出典を追加し、それらの出典を組み合わせて1つの価格の推定値を得た50
-
「Peak FP performance (FLOP/s)」列を追加した
「Peak FP performance (FLOP/s)」列は、そのハードウェアが提供する理論上の最大性能を表す。NVIDIA のアクセラレータGPUでは、浮動小数点数でのピーク性能は「Tensor」または「Tensor Core」モードで動作させたときに達成される。このモードは、数値表現に混合精度(たとえばFP32で累算するFP16)を使う。具体的なピーク性能が手に入らない場合、この列には既定で、他の列にある浮動小数点性能の値のうち最大のものを入れた。そのうえで、ピーク性能を推定単価で割って1ドルあたりのFLOP/sの値を求め、実際のハードウェアモデルの価格性能比を推定した。51
コストの推定値が、機械学習の開発者が達成しえた最良の性能をよりよく反映するように、一定の種類の性能(たとえば32ビットの数値表現)ではなく、各GPUについて公表されている最大(ピーク)性能を使った。ただし、このピーク値にハードウェア利用率35%を掛けて、ピーク性能を割り引いている点に注意してほしい。ピーク性能を使うと、そうしない場合よりもコストの推定値は低くなる。
付録C:回帰の手法
報告した回帰結果はすべて、1000サンプルのブートストラップで得たものである。コストの増加率(年あたりの桁数)の平均推定値は、ブートストラップの各サンプルにおける回帰の傾きの平均である。増加率の90%信頼区間は、ブートストラップの各サンプルで得た回帰の傾きの5パーセンタイルと95パーセンタイルである。回帰による予測(たとえば表2の「2030年までの予測平均コスト」列)は、各ブートストラップサンプルの中で予測値を計算し、それらのサンプルの平均・5パーセンタイル・95パーセンタイルをとって求めた。正確な実装はこちらの Colab ノートブックのセルを参照のこと。
また、Sevilla et al. (2022, Appendix A) と同じ手順で、推定した学習計算量(FLOP単位)の不確実性も考慮した。各ブートストラップサンプルでは、各機械学習システムの計算量に、0.5から2までの対数一様分布から無作為かつ独立に抽出した係数を掛けた。ただし、こうした無作為な乗数を入れても、増加率の推定値には大きな影響はなかった。52
Sevilla et al. (2022) との違い
Compute Trends Across Three Eras of Machine Learning(Sevilla et al., 2022)は、画期的な機械学習システムの学習に使われた計算量(FLOP単位)の経時的なトレンドを調べた。学習計算量は、ドル建ての学習コストを推定する私のモデルの主要な変数の1つなので、私の分析の多くは Sevilla et al. (2022) と似ている。ただし、私はアプローチの中でいくつか独自の判断をしており、次の違いは注目に値する。
-
ドル建てコストのトレンドを分析する際、計算量のデータセットに含まれる計算量の少ない外れ値を含めた。これらのシステムを除外する理由に十分な確信が持てなかったからである。53
-
最も高額なシステムのデータセットに、AlphaGo の各システムを含めた(ただし、Sevilla et al. が行ったような、このデータセットに対する回帰は行っていない)。54AlphaGo の各システムは統計的な外れ値かもしれないが、最初の変革的AIシステムは、これまでに学習されたなかで最も高額なシステム(かそれに近いもの)になる可能性が高いと考えており、AlphaGo の各システムはその前例となる。
-
私のデータセットには、Sevilla et al. (2022) の発表後に Parameter, Compute and Data Trends in Machine Learning データベースへ追加されたシステム(Minerva など)が多く含まれている。
-
「ディープラーニング以前の時代」のデータは、「GPU DBNs」というシステムを除いて検討の対象から外している。この唯一の例外は、データの選び方によるものである(データの出典に関する付録を参照)。
-
学習コストを推定する手法2では、学習用ハードウェアについてのデータが手に入るかどうかの関係で、Sevilla et al. (2022) に含まれていたシステムの大半を除外している。
付録D:NVIDIA GPUの価格性能比を、機械学習システムの発表日の関数として調べる
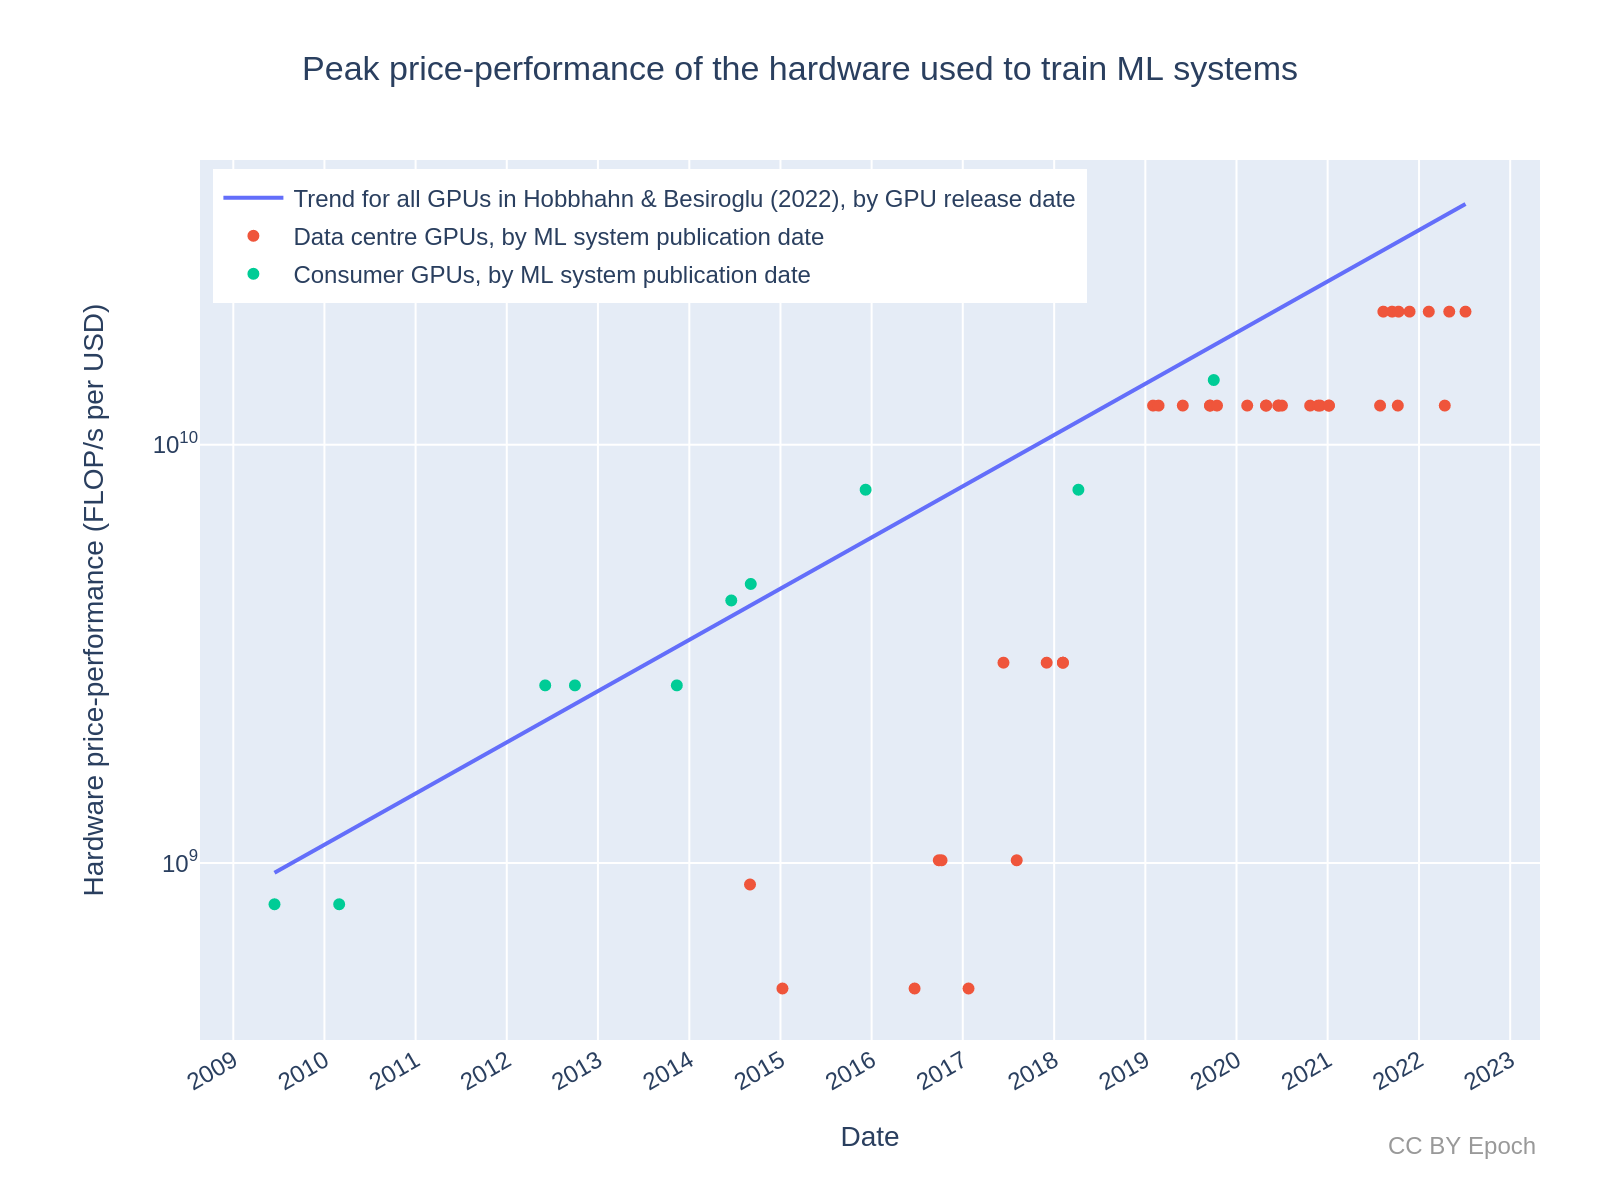
図7:機械学習システムの学習に使われたNVIDIA GPUのピーク時の価格性能比。データセンター向けGPU(NVIDIA A100 など)と一般消費者向けGPU(NVIDIA GeForce GTX TITAN など)に分けて示す。機械学習システム名とハードウェア名のラベルが付いたインタラクティブ版のグラフは、こちらの Colab ノートブックのセルを参照のこと。
図7を目視で確認すると、NVIDIA の一般消費者向けGPU(つまり NVIDIA GeForce GTX シリーズ)で学習した機械学習システムの時期は、GPUの価格性能比のトレンド(青い線)に遅れずについていっている。ハードウェアの発売日と機械学習システムの発表日のずれは、これに大きな影響を与えていないようだ。一方、NVIDIA のデータセンター向けGPU(K・P・Vの各モデル)で学習した機械学習システムの時期は、トレンドからずっと大きく遅れている。これらのGPUの価格性能比は、平均してトレンド線の約2.5分の1である。55ただし、最新のデータセンター向けGPU(V100 と A100)は、以前のデータセンター向けGPUよりもトレンド線にずっと近いところから始まっている。全体として、このデータは、手法2が手法1よりも高いコストを推定しがちな理由を説明している(別の付録で論じたとおり)。
GPU全体のトレンド線とデータセンター向けGPUの価格性能比との食い違いは、NVIDIA がデータセンター向けGPUに大きな割増価格を付けていることで説明できる可能性が高い。NVIDIA 自身はデータセンター向けGPUの希望小売価格を公表しておらず、顧客が NVIDIA にハードウェアの代金として最終的に支払う価格は秘密保持契約の対象で、したがって入手できないと私は考えている。56NVIDIA のデータセンター向けGPUについて私が持っている価格情報は、プレスリリースやニュース記事での報道、専門家の推定によるものである。価格が開示されていないことを踏まえると、NVIDIA の最大手の顧客は交渉によって提示価格を引き下げていると予想される(通常の一般消費者向けGPUでは、このようなことは起きない)。そのため、これらのGPUに割増価格が付いている理由の1つとしてありそうなのは、交渉の前に価格を高めに設定しておくためだと考える。
食い違いのもう1つの理由として考えられるのは、データセンター向けGPUが、GPU間の通信帯域幅(ビット毎秒)に向けて部分的に最適化されていることである。私の価格性能比の指標はビット毎秒ではなく毎秒のFLOPだけを使っているので、この点は反映されていない。データやネットワークの一部が複数のGPUに分割されている場合、GPU間の通信速度はニューラルネットワークの学習のボトルネックになる。57
付録E:記録を更新したコスト
手法1のデータセット:AlphaGo Zero が突出し、Minerva が最高
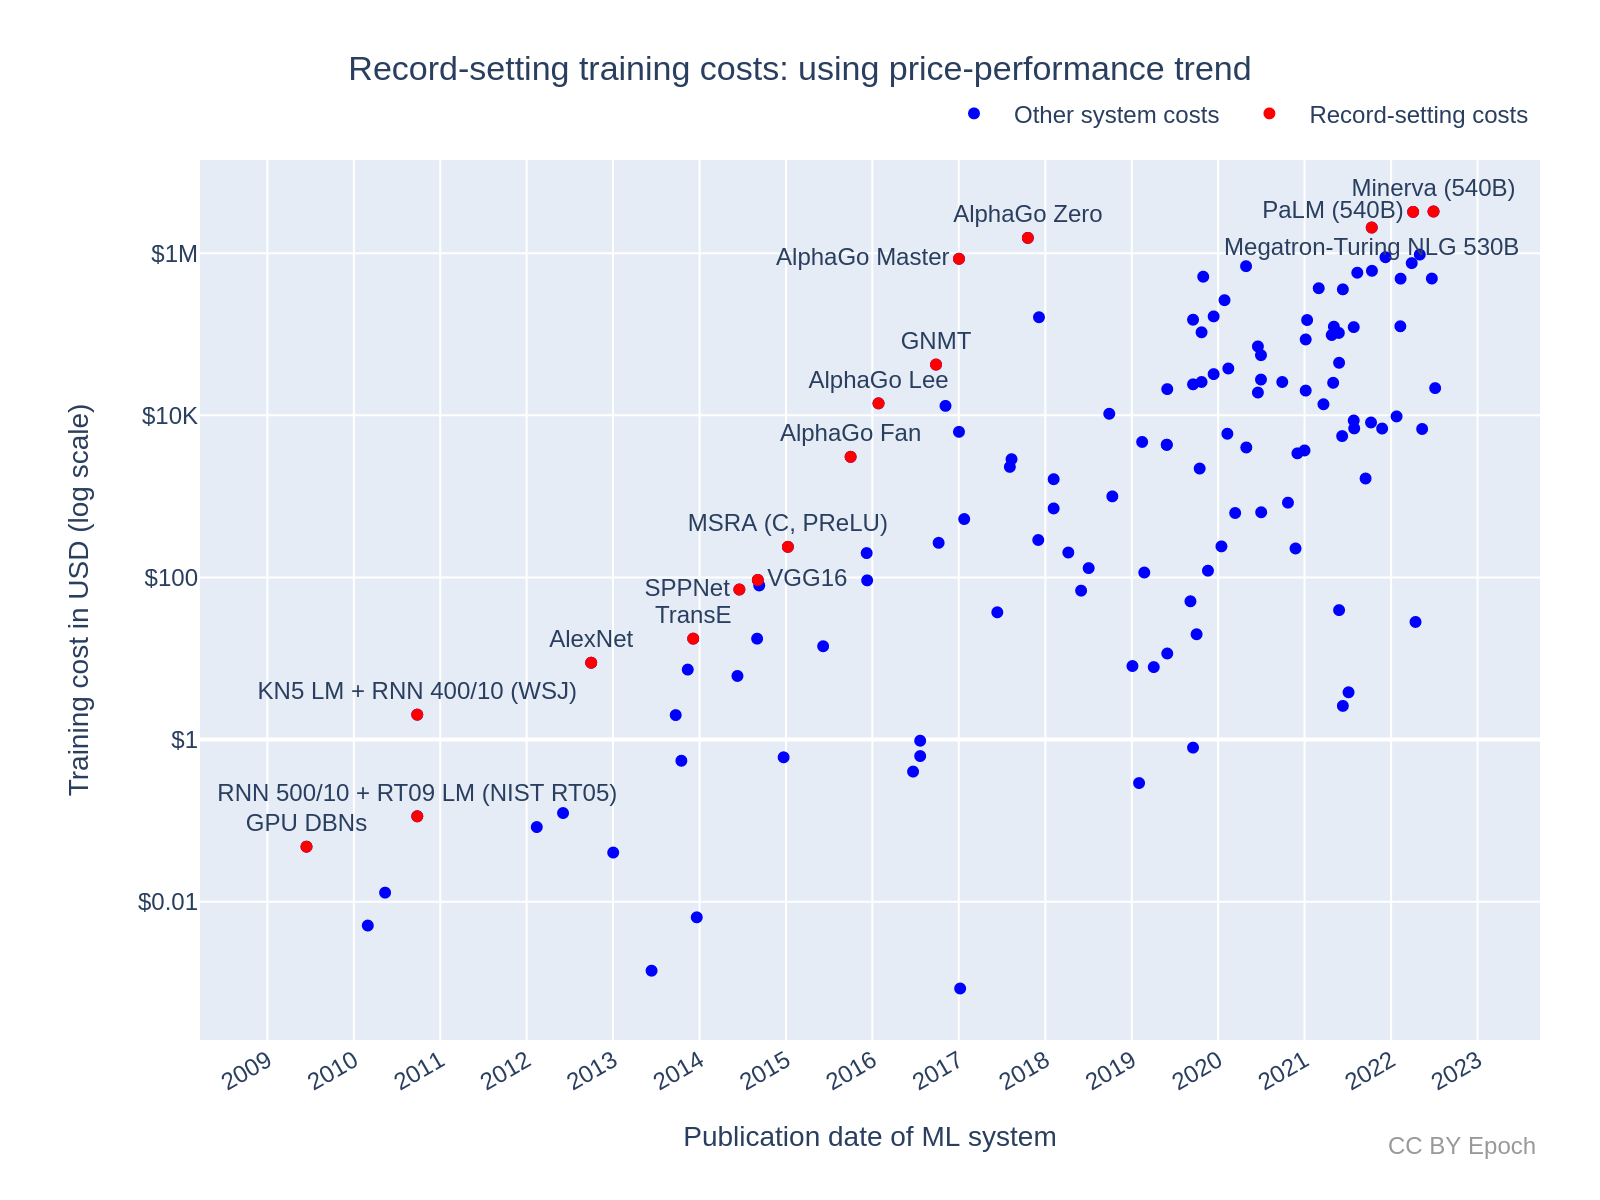
図9:手法1を使って推定した学習コスト。記録を更新したコストを赤で示す。
最も高額な学習の実行の推移(図9の赤い点)を見ると、コストの記録を更新したシステムは、学習計算量の記録を更新したシステムと似ている。58注目すべきことに、この推定手法では、AlphaGo の全システム(Fan、Lee、Master、Zero)が記録を更新していた。AlphaGo Master と AlphaGo Zero は特に突出した外れ値で、AlphaGo Zero はトレンド線の平均より3.7桁上にある。AlphaGo Zero のこのコスト記録(ここでの推定は150万ドル)は、約4年後に言語モデルの Megatron-Turing NLG(210万ドル)と PaLM(320万ドル)が現れるまで破られなかった。これは、AlphaGo Zero 以前のどの期間(いずれも約2年以下)よりも、はるかに長い記録の間隔である。また、AlphaGo Zero は、金銭的な投資の面で Megatron-Turing NLG や PaLM よりも異例だった。比較すると PaLM は平均より1.7桁上にすぎず、2019年から2022年にかけては、コストが10万ドルから400万ドルのシステムがはるかに多く登場した。学習に最も費用がかかったシステムは2022年の Minerva で、推定320万ドルだった。
手法2のデータセット:GNMT が突出し、Megatron-Turing NLG が最高
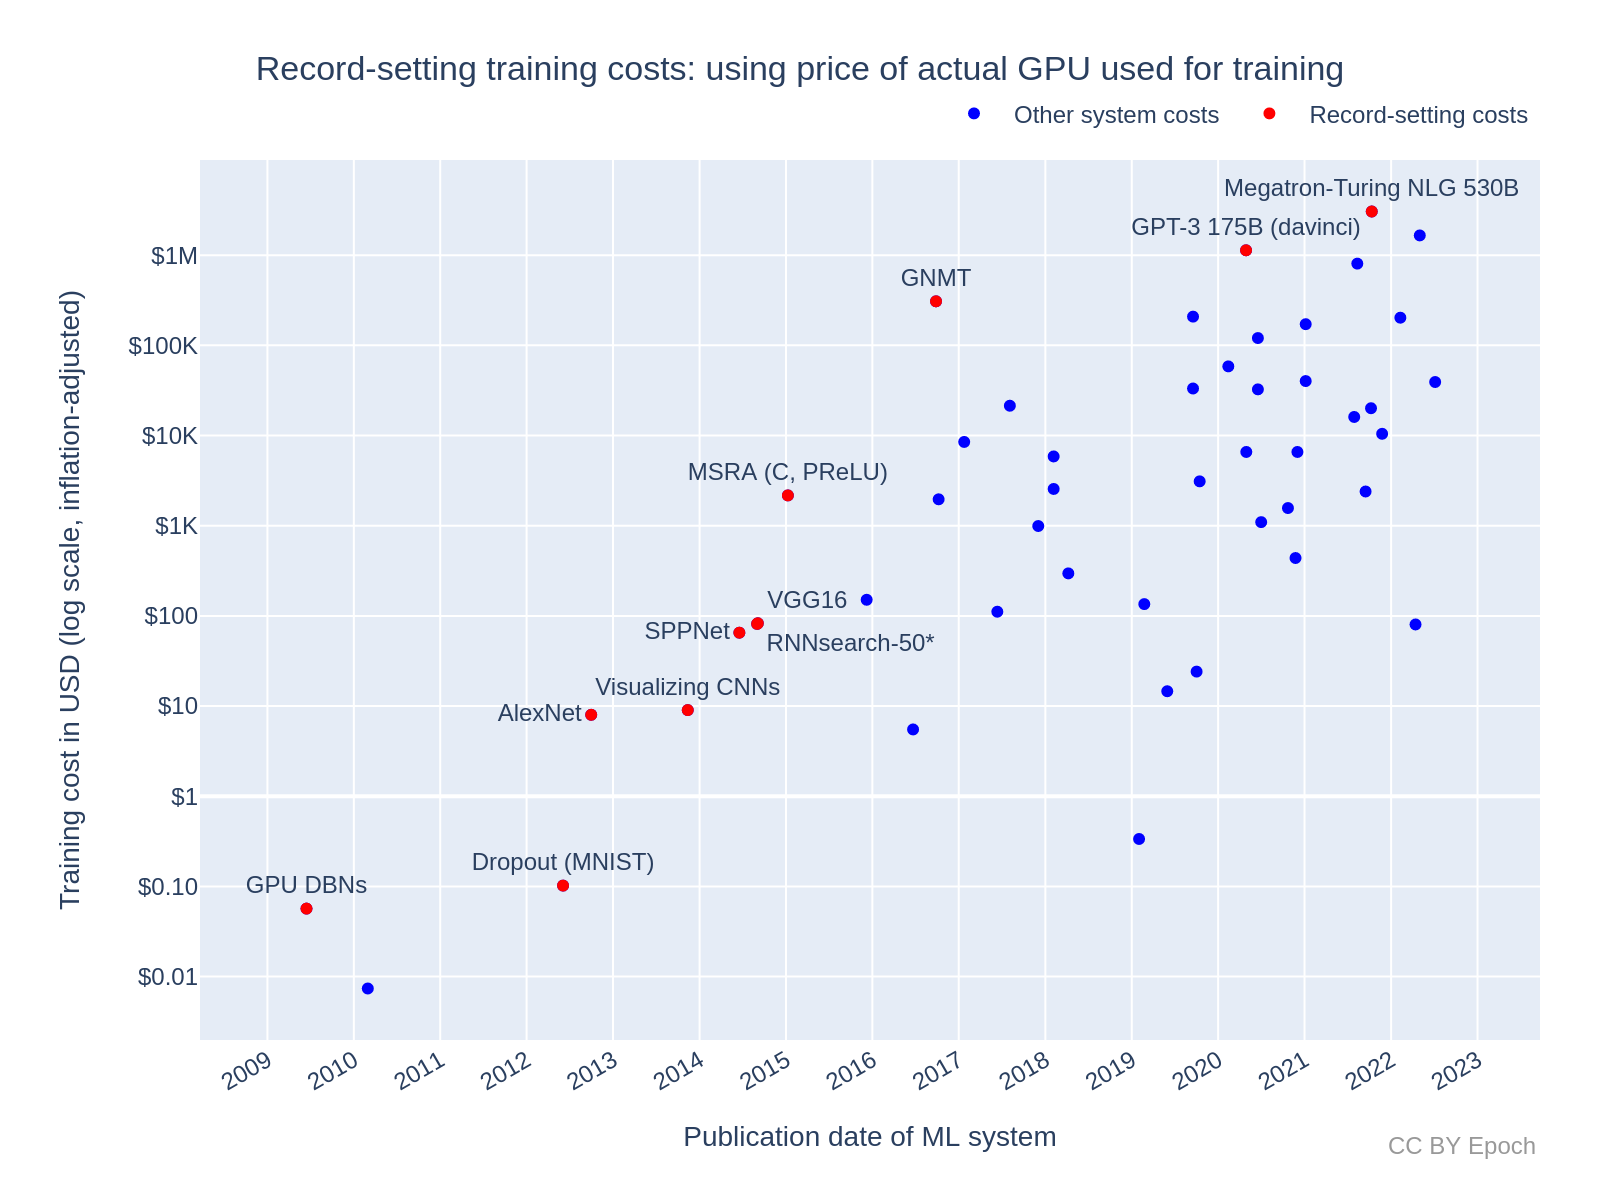
図10:手法2を使って推定した学習コスト。記録を更新したコストを赤で示す。
手法2のデータセットで最も高額な学習の実行を検討する際の重要な注意点は、データセット全体(n=124)にあるシステムの多くが欠けていることである。特に、近年の Google と DeepMind の画期的なシステムの多くは含まれていない。NVIDIA GPU ではなく Google のTPUで学習されたからである。こうしたシステムには AlphaGo や PaLM がある。
そのうえで言えば、手法2のデータセット(図10)で記録を更新した学習コストの特徴は、手法1のデータセットと似ている。このデータセットで最も突出したコスト記録は、2016年9月に発表された GNMT である。GNMT のコストは推定30万ドルで、トレンド線より3.1桁上にある。次の記録は2020年5月の GPT-3 で、110万ドル、トレンドより2.1桁上である。この2つの記録の間隔は約3.5年で、このデータセットでは記録の間隔として最長である。このサンプルで最も高額なシステムは2021年後半の Megatron-Turing NLG で、300万ドル、トレンドより1.9桁上である。これは手法1を使った推定値の210万ドルより高い。
付録F:期間の取り方に対する回帰結果の頑健性
要点:
- 手法1が予測する平均増加率(およそ年0.5桁)は、期間を変えてもかなり頑健なようだ。4つの期間のうち、平均の最小値は0.44、最大値は0.58である。これらの増加率の信頼区間はおおむね重なっている。
- 手法2は、この点ではるかに頑健性が低い。3つの期間のうち、平均の最小値は0.35、最大値は0.84で、この2つの結果の90%信頼区間は重ならない。
- 手法2についてより大きなデータサンプルが得られれば、この頑健性の差はほぼ解消されると予想する。
機械学習システムの最終的な学習の実行にかかる計算コストについて、回帰結果がどれほど頑健かを確かめるため、期間を変えて回帰をやり直した。結果を表4に示す。特に意味があると思われる期間を選んだが(理由は後述)、無作為な期間を使うのも妥当だろう。
- 手法1と手法2の両方で、次の期間を使った。
-
2015年9月〜2022年:この期間は、すべての「大規模」システムが登場する「大規模の時代」と一致させるために選んだ。この時代は分散が大きいのが特徴で、「ディープラーニング」のトレンドとは別に「大規模」のトレンドが生じているとも言えるからである。59
-
2009年〜2015年8月:同様に、この期間は「大規模の時代」の直前の期間として選んだ。
-
- 加えて、手法1についてだけ、2017年10月20日〜2022年の期間も使った。この期間は、AlphaGo の全システムを除外するために選んだ(ただし、2015〜2017年に登場した他のシステムも除外される)。AlphaGo の全システムがコストの記録を更新しており(こちらの節の図9を参照)、AlphaGo Master と AlphaGo Zero は特に大きな外れ値なので、AlphaGo の各システムのコストの値は回帰結果に大きな影響を与えると予想した。
- なお、手法2のデータセットには、たまたま AlphaGo のシステムが1つも含まれていない。これらは Google のTPUで学習されており、私は NVIDIA GPU で学習したシステムのデータしか集めていないからである。
| 推定方法 | 期間 | データ | 増加率(年あたりの桁数) |
|---|---|---|---|
| 手法1(ハードウェア価格の平均的なトレンドを使用) | 2009– 2022(最長の期間) | 全システム(n=124) | 0.51 90%信頼区間:0.45〜0.57 |
| 2009年〜 2015年8月 | 全システム(n=23) | 0.55 90%信頼区間:0.34〜0.75 | |
| 2015年9月〜 2022年 | 全システム(n=101) | 0.44 90%信頼区間:0.27〜0.61 | |
| 2017年10月20日〜 2022年 | 全システム(n=83) | 0.58 90%信頼区間:0.35〜0.80 | |
| 手法2(実際のハードウェア価格を使用) | 2009– 2022(最長の期間) | 全システム(n=48) | 0.44 90%信頼区間:0.34〜0.52 |
| 2009年〜 2015年8月 | 全システム(n=9) | 0.84 90%信頼区間:0.61〜1.14 | |
| 2015年9月〜 2022年 | 全システム (n=39) | 0.35 90%信頼区間:0.14〜0.55 |
表4:機械学習システムの最終的な学習の実行にかかる計算コストの増加率。期間を変えたコストデータに対する対数線形回帰による。
要点以外の観察:
- 2015年9月から2017年10月までの期間のデータは、推定される増加率を、そのデータがない場合よりも遅くしている。2015年9月〜2022年の期間を使うと増加率は0.44になるが、開始時点を(AlphaGo の全システムが発表された後の)2017年10月に移すと、増加率は0.58に変わる。
- 期間を2015年9月〜2022年に限定すると、サンプルサイズの減少は比較的小さいのに、信頼区間の幅は大きく広がる(手法1では0.12から0.34へ、手法2では0.18から0.41へ)。これは、2009年〜2015年8月の期間と比べてこの期間のコストの分散が大きいためだと考える。その様子は図2と図4で目視でも確認できる。
- 2009年〜2015年8月の期間での手法2の増加率は他の結果と根本的に異なるが、サンプルサイズが非常に小さいため、他の結果よりもずっと軽く扱っている。2015年9月〜2022年の期間では、全期間の結果にずっと近い値になる(0.44に対して0.35)。
付録G:手法2の増加率は機械学習システムのサンプルが小さいことによるが、その推定値は平均して手法1の約2倍である
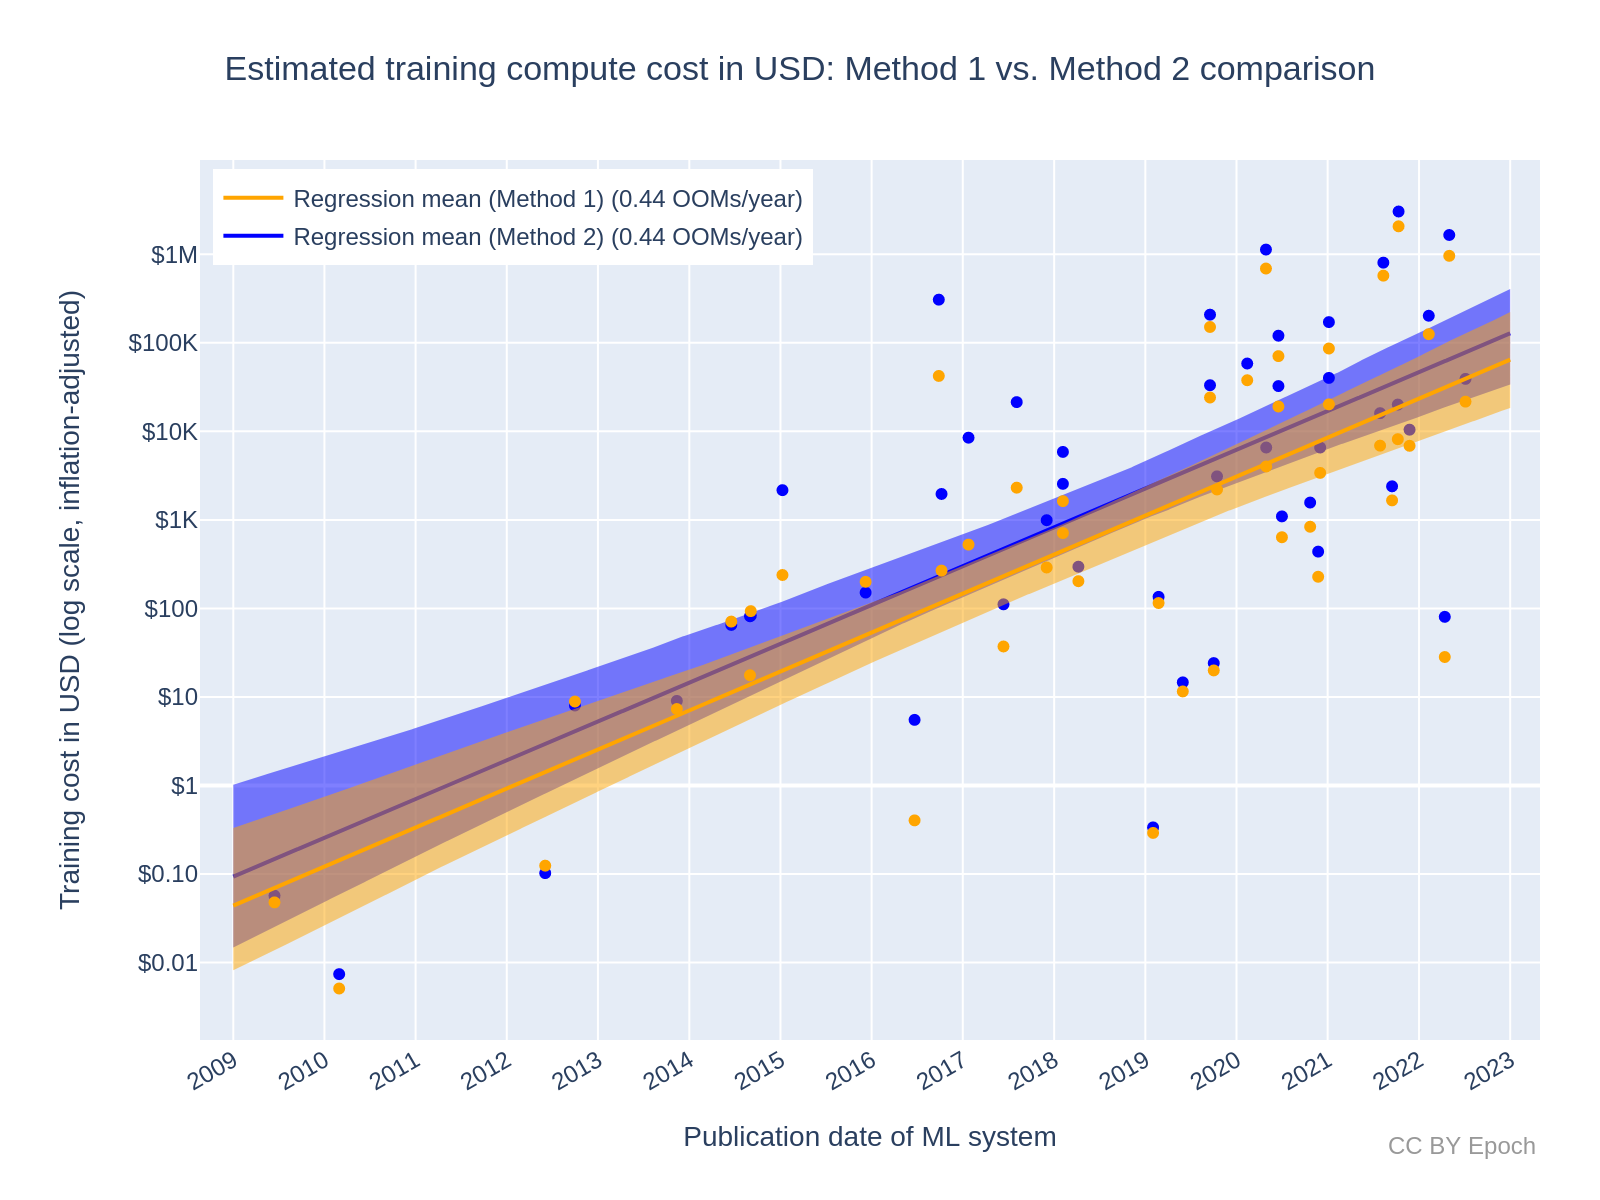
図11:学習用ハードウェアのデータが得られた機械学習システムのデータセットを使った、学習コストの推定値の比較。(a) 青:その機械学習システムの学習に実際に使われたGPUの価格性能比を使ったコストの推定値と、当てはめたトレンド。(b) オレンジ:GPUの価格性能比のトレンド線が予測する価格性能比の値を使ったコストの推定値と、当てはめたトレンド。機械学習システム名のラベルが付いたインタラクティブ版のグラフは、こちらの Colab ノートブックのセルを参照のこと。
図11が示すように、手法2で得た増加率(年0.44桁)は、離散的なGPUの価格性能比のデータを使ったことよりも、機械学習システムのデータセットが小さいことに主に左右されている。というのも、この小さなデータセットに手法1を使っても、トレンドの増加率は同じになるからである。増加率が似ていることから、手法2はより優れたGPUが発売されてから機械学習の学習の実行に使われるまでの遅れを考慮しているものの、データセットの中でその遅れは平均するとほぼ一定であると考えられる。トレンドの傾きは同じだが、予測は約7か月ずれている。60言い換えれば、手法2の平均予測は一貫して手法1のトレンド線の約2倍である。61
付録H:コスト推定値の比較対象
PaLM と AlphaGo Zero についての他のコスト推定値は高すぎるようだが、私の推定値もおそらく低すぎる
以下は他の情報源による3つのコスト推定値で、私が使ったものよりもシステム固有の推定手法にもとづいている。
- PaLM:1,700万ドル、2,310万ドル、920万ドル。手法1による推定値の320万ドルと比べてほしい。62
- 1,700万ドル:推定モデルは、基本的にこちらの節の最後に示した式である。つまり、コア時間で表した学習時間、ハードウェアのコア数、そのハードウェアのクラウドコンピューティング価格を掛け合わせる。
- 2,310万ドル:学習計算量とハードウェアの価格性能比を使う私の推定モデルと似ている。ただしここでは、私が使った(hardware_unit_price / hardware_replacement_time)の式の代わりに、クラウドコンピューティングの価格を使っている。この $/s の値によって、FLOP/s が FLOP/$ に換算される。
- 920万ドル:(a) の手法と似ているが、LambdaLabs のクラウドコンピューティング価格を使い、TPU V4 の代わりに NVIDIA A100 GPU を当てはめている。
- AlphaGo Zero:3,500万ドル。手法1による推定値の150万ドルと比べてほしい。 4. 3,500万ドルという推定値の推定モデルは、基本的にこちらの節の最後に示した式である。つまり、学習時間、ハードウェアの台数、そのハードウェアのクラウドコンピューティング価格を掛け合わせる。
- GPT-3:460万ドル。手法2による推定値の110万ドルと比べてほしい。 5. ここでの推定方法は、NVIDIA V100 GPU 1基で学習した場合の仮想的な学習時間を計算し、その学習時間に当時の Lambda での V100 のオンデマンドのクラウドコンピューティング価格(1時間あたり)を掛けるというものである。私の推定値との違いは、想定したハードウェア利用率(私は35%、この推定は25%)63と、1時間あたりのハードウェアコスト(私は0.52ドル、この推定は1.50ドル)にある。64
上記の参考推定値はいずれも、システム開発者にとっての実際のコストの少なくとも2倍の大きさだと考える強い理由がある。 なぜなら、どの推定値も、エンドユーザーがクラウド事業者にハードウェアを1時間単位でオンデマンドで借りる場合の価格にもとづいているからである。2022年8月26日時点で、Google Cloud は TPU V4 の価格について、1年間のレンタル契約で37%、3年間のレンタル契約でオンデマンド価格から55%の割引を提供している。おそらく Google Cloud は、55%の割引を適用しても利益を上げているのだろう。したがって、自社の計算クラスタを使う Google Research のようなAI開発者にとっては、65最終的な学習の実行のコストは少なくとも55%低く、おそらくはさらに低いはずである。上記の PaLM の推定値のうち私の手法に最も近いもの(2,310万ドル)から55%割り引くと1,040万ドルとなり、私の推定値の320万ドルにずっと近づくが、それでもまだ大きく離れている。
AlphaGo Zero については、学習に使われた自己対局データの生成は TPU V1 チップで行われた。このチップは、当時の Google Cloud のGPU 1基と比べて約20倍高価だった。66参考推定値によれば、TPUの計算コストはGPUの計算コストをはるかに上回っていた。DeepMind や Google が、これらのTPUを購入するのに相応の高い割増価格を支払った可能性はある。しかし、2017年の Wired の記事には「Zero の開発中、システムは同社にとって最大3,500万ドルもするハードウェアで学習されたと[DeepMind の CEO である Demis Hassabis]は言う」とある。67これは上記の AlphaGo Zero の学習用計算資源のコストの推定値(2020年に出されたもの)と同じだが、おそらくある程度は偶然の一致だろう。私はこの記事を、TPUの購入コストが3,500万ドルだったという意味に解釈している。そのコストを正当化するには、TPUはおそらく、(少なくとも合計で)AlphaGo Zero 自体と同程度の計算量を使う、AlphaGo Zero 以外の目的にも使われたと考えられる。したがって、この証拠はやはり、AlphaGo Zero の学習の実際のコストが少なくとも3,500万ドルの半分(つまり約1,700万ドル)であることを示していると考える。とはいえ、それでもこのシステムについては、私の推定値が低すぎる可能性が高いことになる。
別の参考値として、Cotra と Davidson は AlphaGo Zero のコストを280万ドルと推定しており、私の推定値は150万ドルである。ただし、私は彼らと同じFLOP単位の学習計算量の推定値を使ったので、この推定値は私のものと強く相関している。Cotra と Davidson は計算に約 1e17 の FLOP/$ の推定値を使ったが、68私は約 2e17 を使った。69
別の付録では、私のデータセットにある各機械学習システムの最終的な学習の実行にかかった本当の計算コストは、手法2の推定値の2倍(90%信頼区間:0.4倍〜10倍)だという、私の総合的な最善の推測について説明する。
Forecasting TAI with biological anchors
変革的AI(TAI)の到来を予測する Cotra の生物学的アンカーモデル(以下「Bioanchors」)の構成要素の1つに、「支出の意思」がある。これは、ある時点で主体がAIの学習の実行に支出してもよいと考える最大の金額である。簡単に言えば、Cotra は支出の意思を時間の指数関数としてモデル化した。当初の増加率は計算用ハードウェアの長期的な過去のトレンドにもとづき、その後、最も豊かな国のGDPによって決まる増加率へと平坦化していく。70
Bioanchors モデルの主要なパラメータの1つは、予測期間の開始時点(2025年)での、最も高額な学習の実行の計算コスト(2020年の米ドル建て)である。これについての Cotra の最善の推測は10億ドル(つまり $10^9)だった。私のデータと推定値によれば、2022年の計算資源の最大支出は Minerva (540B) で、$10^6.5、つまり約350万ドルだった。全システムの増加率についての私の総合的な推定値であるおよそ年0.5桁を使うと、2025年初めまでに、(2022年6月に発表された)Minerva と比べて約1.25桁の増加が予測される。つまり、私のモデルは2025年までに最大支出が 10^(6.5 + 1.25) = $10^7.75(約6,000万ドル)になると予測する。これは Cotra の最善の推測よりおよそ1桁低い。
「大規模」のトレンドの値を使うと、2025年までの推定値はさらに低い 10^(6.5 + [2.5年 × 年0.24桁]) = 10^7.1(約1,000万ドル)になる。71別の付録の分析にもとづくと、Minerva についての私の起点のコスト推定値は過小評価である可能性が最も高いと考える。一方で、全システムを含むトレンドよりも、ゆるやかな「大規模」のトレンドのほうが、学習コストの長期的な上限をよりよく予測すると考える。そこで、私の起点のコスト推定値が1桁大きく、$10^7.5 だったと仮定してみよう(実際の最高額のコストはそれより低かった可能性が60%を超えると考えている72)。その場合、私の最善の推測は $10^8.1(約1億3,000万ドル)となり、それでも Cotra の最善の推測よりおよそ1桁低い。
Cotra の支出の意思のモデルのもう1つの主要なパラメータは、予測期間の開始時点(2025年)での、最も高額な学習の実行への計算資源の支出の増加率(年単位)である。Cotra の最善の推測によれば、この増加率は2035年ごろまで支配的で、その後はGDP成長の限界が支配的になる。このパラメータについての Cotra の最善の推測は、倍増期間2年である。73これは Trends in GPU price-performance で見いだされたGPUの価格性能比の増加率(倍増期間2.5年)に近く、log10(2)/2 ≒ 年0.15桁に相当する。
ここでも、私の結果が予測する増加率は年約0.5桁(倍増期間にして約0.63年)で、Cotra の最善の推測である年0.15桁よりはるかに速い。Cotra も推論の中で過去の急速な増加を考慮しており、この種の増加は2020年から2025年まで続くが、その後はハードウェアの価格性能比に近い、より長期的な過去の増加率に戻ると考えていた。742016年以降の「大規模」システムの増加率がすでに年0.2桁とゆるやかになっているという知見は、75支出の増加の鈍化が、Cotra が2020年に予想したよりも早く起きている可能性を示唆している。
Cotra の支出の意思のモデルの残り2つのパラメータ、つまり主体が計算に支出してもよいと考えるGDPの最大割合と、GDPの成長率については、私の知見に大きな含意はないと考える。
AI and Compute(CSET)
CSET の「AI and Compute」(Lohn & Musser, 2022)は、ここで使ったものと似た手法で、学習計算量(FLOP単位)の増加率とハードウェアの価格性能比(FLOP/$ 単位)の増加率を組み合わせ、学習用計算資源のドル建てコストを予測している。Lohn と Musser の分析は計算量の増加率に最も敏感である。彼らが使った増加率(倍増期間3.4か月、年1.1桁に相当)76が、FLOP/$ の増加率(彼らの中央推定値では倍増期間4年、年0.08桁に相当)よりもはるかに遅いからである。77したがって、彼らが推定する学習コストの増加率は 1.1 − 0.08 ≒ 年1.0桁となる。78これは、2009〜2022年の過去の増加率についての私の総合的な推定値である年0.49桁のおよそ2倍である。つまり、彼らの手法では2027年までにコストが+5桁増える(その年までの米国GDPの予測値にほぼ相当する)と予測されるのに対し、私の手法ではその倍の期間、つまり2032年までにその分の増加が予測される。大規模システムについて見いだした、より控えめな年0.2桁の増加率を使うと、+5桁に達するのは21年後(2043年)になる。79近年の支出の増加は今後数十年にわたって持続不可能に見える、という基本的な論点は変わらない。しかし、計算資源への支出が2027年に頭打ちになるのか2043年に頭打ちになるのかでは、AIの到来時期やAIガバナンスにとっての含意がかなり異なると考える。
本研究と CSET の「AI and Compute」のもう1つの食い違いは、2022年の最も高額な学習の実行についての推定値である。同報告書の p.10 に書かれているように、Lohn と Musser は、2018〜2019年の推定倍増期間3.4か月を2021年まで延長して、4億5,000万ドルというコストを得ているようだ。80この推定値は実際のコストとしては高すぎると考える。81同報告書が2022年に発表されたことを考えると、2021年に4億5,000万ドルのコストを想定するのは強気すぎると思う。既知の公開された機械学習システムのうち、最終的な学習の実行にそれだけのコストがかかったものは、ほぼ確実に存在しなかったからである。私の推定値と他の研究の推定値(こちらの節を参照)にもとづき、2021年に行われた最も高額な機械学習の学習の実行の計算コストは、少なくとも1桁低かった(つまり4,500万ドル未満だった)と、70%の確信度で考えている。
付録I:学習コストの増加率についての総合的な最善の推測
別の付録では、機械学習システムの学習にかかる計算コストを評価・予測した先行研究を、私の結果と比較しながら検討した。この付録では、その検討をもとに、次の問いに対する私の総合的な最善の推測とその理由を述べる。どのような一定の増加率を置けば、変革的な機械学習システムの最終的な学習の実行のコストを最も正確に予測できるか。ここでは Cotra (2020) のように、この増加率が、世界総生産の成長による上限に達するまで維持されるモデルを想定している。この増加率についての私の独立した印象は年0.3桁(90%信頼区間:年0.1〜0.4桁)であり、すべてを考慮した見解は年0.2桁(90%信頼区間:年0.1〜0.3桁)である。理由は次のとおりである。
-
本レポートの結果を出発点として、「大規模」システムの増加率(手法2のサンプルサイズは小さすぎると判断したため、手法1で得たもの)と、「全システム」の総合的な増加率の混合モデルを作った。82これらの増加率は、それぞれ表3と表2に示している。その結果、総合的な増加率は年0.39桁(90%信頼区間:年0.13〜0.55桁)となった。
-
この初期の結果が妥当かどうかを確かめるため、最終的な学習の実行への支出の上限がどこにありうるか、そして現在の増加率にもとづくとその上限にいつ達するかを検討した。
-
支出の上限については、Cotra (2020) に従い、最も豊かな国のGDPの1%とした。83ただし私の方法は Cotra の方法よりもさらに単純で、米国の現在のおおよそのGDPの1%を一定の上限としているだけである。
-
私のデータでは Minerva がこれまでで最も高額なシステムであることが示唆されているので、Minerva について予測したコスト(log10 単位で6.5)を起点として使う。
-
したがって、その支出の上限に達する年は 2023 +(11.3 − 6.5 桁)/(年0.39桁)≒ 2023 + 12 = 2035 となる。
- 判断の材料は、現在の民間テック企業の売上高(たとえば Alphabet の2021年の売上高は2,576億ドルと報じられている)と、AIの能力が向上してより多くの収益を生むようになったときに1回の学習の実行に支出してもおかしくない額についての、私のごく大まかな直観である。それにもとづくと、1つの機械学習システムの学習のための計算資源への支出が2035年までに2,000億ドルに達する可能性は10%を超えると考える。
- しかし、2035年までにそうなる可能性が50%を超えるとは考えない。
- したがって、増加率についての私の最善の推測は年0.4桁未満でなければならない。
-
支出の増加は2025年以降、倍増期間2年(年約0.15桁)へと鈍化するという Cotra の推論にも説得され、より低い増加率を選ぶことにした。
-
Lohn & Musser (2022) は、近年の計算資源への支出の増加が続けば2030年より前に米国GDPに匹敵する額に達するが、それはありえないと論じた。85支出が米国GDPに匹敵する規模になるのはありえないというこの主張は、先に述べた見解の相違とはほぼ独立したものとして扱う。したがって、この主張にも説得され、より低い増加率を選ぶことにした。
-
以上の証拠をどう重み付けるかについての直観的な判断にもとづき、初期の増加率である年0.39桁(90%信頼区間:年0.13〜0.55桁)を25%引き下げて、年0.29桁(90%信頼区間:年0.10〜0.41桁)とした。私の方法は精度に欠けるので、これを丸めて年0.3桁(90%信頼区間:年0.1〜0.4桁)とした。この推定値が私の独立した印象である。
-
私のすべてを考慮した見解は(独立した印象とは異なり)、Cotra (2020) により強く従い、初期の増加率の推定値を50%引き下げて年0.2桁(90%信頼区間:年0.1〜0.3桁)としている。繰り返しになるが、この引き下げの程度は、原理的な計算ではなく、どれだけ補正すべきかについての私の直観だけにもとづいている。
-
なお、現在からTAIまでの期間全体とは対照的に、より短い時間スケール(たとえば2〜5年)で測れば、大規模システムの学習コストの増加率は、現在からTAIが開発されるまでのどこかの時点で年0.3桁を上回る可能性が最も高いと予想している。AIが経済に大きな影響を与えうることが目に見えて示された時点で、AIへの投資の増加率が高まると予想しているからである。86ただし、AIへの投資、AIへの支出の配分、AIシステムが生み出す収益のトレンドと相互の関係については、現時点では不確実性が大きいと考える。そのため、これらの分野を調べることは今後の研究の重要なテーマである。
付録J:学習コストについての総合的な最善の推測
本研究で使った2つのコスト推定手法は、どちらも、機械学習システムの最終的な学習の実行にかかる計算資源の本当のコストについての、私のすべてを考慮した最善の推定値を直接表すものではない。これらの手法による推定値は参考になるが、強い単純化の仮定を置いており、真の値に対して偏りと分散を加えると予想される。この付録では、学習コストについての総合的な最善の推測を得るために、これらの限界をごく大まかにどう考慮したかを説明する。
手法2は各機械学習システムの学習に使われた特定のハードウェアの価格を使うので、手法2のコスト推定値は手法1よりも正確だと考えている。そこで、最善の推測の基準点には手法1ではなく手法2を使う。ただし、手法2の過大評価と過小評価の要因を考慮すると、両者はおおむね相殺し合うことが分かった。そのため、手法2の推定値はたまたま私の最善の推測と近くなっている。一方、手法1の推定値はこの最善の推測のおよそ2分の1である。
私の独立した印象では、手法2の推定値は平均すれば正確である。ただしこれは、手法2を直接最善の推測として選んだからではなく、過大評価と過小評価の要因がおおむね相殺し合うからである。しかし、手法2の推定値は他の情報源による推定値よりずっと低いので(こちらの節を参照)、私のすべてを考慮した見解では、私のデータセットにある各機械学習システムの最終的な学習の実行にかかった本当の計算コストは、手法2の推定値の2倍87(90%信頼区間:0.4倍〜10倍)88である。
手法2
この手法がどう不正確かについての総合的な最善の推測
この手法での過大評価の要因(0.46倍)と過小評価の要因(2倍)を考慮すると、両者はおおむね相殺し合う。したがって、私の最善の推測としての独立した印象は、手法2の推定値は平均すればおおむね正確だというものである。ただし、その最善の推測に対する私の90%信頼区間は、手法2の推定値の0.2倍〜5倍である(こちらの節を参照)。念のため言えば、要因が相殺し合うように誤差の推定値を修正したわけではない。思いつく限りの誤差の要因をそれぞれ推定した結果としてこうなったのであり、要因がたまたまおおむね相殺し合ったことには私自身驚いている。
過大評価の要因
-
全体:以下に挙げる過大評価の要因だけを考慮すると、真の値は (1 − 0.39) × (1 − 0.25) ≒ 0.46、つまり当初の推定値より54%低くなる。
-
GPUの最大規模の購入(たとえばクラウドコンピューティング事業者や、自前のデータセンターを持つトップクラスのAIラボによる購入)で実際に支払われるハードウェアコストは、通常、公表されている価格より低いだろう。そうした買い手は、購入の際に交渉して価格を引き下げると予想されるからである。89また、明示的な交渉はないものの、ハードウェアの購入に適用される非公表の大量購入割引もありうる。これを考慮すると、GPUの最大規模の購入で実際に支払われる価格は、私が推定に使った価格の半分だというのが私の直観的な推測である。ただし、産業界が関わったシステムの数にもとづくと、この値引きが当てはまるのは私のデータセットの機械学習システムの77%だけだとも推測している。9077%のケースでコストが50%減れば、平均でコストは約39%減ることになる。(誤差+39%)
-
同じGPUモデルのハードウェア価格は、十分に長い時間スケール(2〜4年)では全体として下がる傾向がある。(誤差+16%)
- 価格は上下に変動する。しかしこの記事の最初のグラフによれば、2年の間隔で見ると、NVIDIA のデータセンター向けGPUの大半は価格が下がっている。そのグラフにあるすべてのGPUで、2022年の価格は当初の価格(さかのぼると2012年のものもある)より低い。
- この下落を平均で推定する
- 図7で NVIDIA V100 GPU を使った機械学習システムの実際の時期を見ると、その使用は過去4年にわたっている。これにもとづき、あるGPUモデルについて、そのモデルで学習した私のデータセットの機械学習システムは、平均してその期間のちょうど中ほど、つまりGPUモデルの発売から2年後に発表されたと仮定する。
- GPUの価格性能比のトレンドが、新しいGPUほど1ドルあたりのFLOP/秒が高いことだけでなく、古いGPUが同じペースで安くなることも意味すると仮定すれば、既存の各GPUは2.5年ごとに半額になるペースで安くなっていくことになる。
- これは、既存の各GPUが発売の1年後に 2^(-2/2.5) ≒ 57% の価格になる、つまり43%下がることを意味する。
- 別の方法として、発売後最初の2年間における NVIDIA GPU(PCI-Express 版)の実際の価格の変化を調べた(これもこの記事の最初のグラフにもとづく)。
-
A100:約15%下落
-
V100:約20%上昇
-
P100:変化約0%
-
K80:約20%下落
-
K40:約15%下落
-
K20:約10%下落
-
重み付けなしの平均:(-15 + 20 + 0 + -20 + -15 + -10) ≒ 7%の下落
-
つまり実際のデータは、価格性能比の倍増期間2.5年から導かれるものよりも小さな下落を示している(それぞれ7%と25%)。ただし、これは2020年ごろの半導体不足によってやや偏っている。半導体不足によって、2020年に V100 と A100 の価格が上がったからである。91
-
ここでも、あるGPUモデルで学習した私のデータセットの機械学習システムは、平均してそのGPUモデルの発売から2年後に発表されたと仮定し、この7%の下落を7%の過大評価と解釈する。
-
- 上記の43%と7%の推定値を平均すると、ハードウェア価格は25%下がることになる。これだけでも、私のコスト推定値は25%高すぎることが示唆される。
過小評価の要因
-
全体:以下に挙げる過小評価の要因だけを考慮すると、真の値は (1 + 0.4) × (1 + 0.2) × (1 + 0.2) ≒ 2.0、つまり当初の推定値より100%高くなる。
-
モデルによっては、クラウドコンピューティング事業者が提供する計算資源を使って学習されたかもしれない。その場合、クラウドコンピューティング事業者の利益率の分だけ、学習コストは高くなる。
- クラウドコンピューティングの利益率を67%とすると、92過小評価の倍率は 1/(1 − 0.67) ≒ 3倍になる。ただし、これが当てはまるのは機械学習システムの20%だけだと推測する。5件に1件のシステムのコストが私の推定の3倍なら、平均コストの増加倍率は(通常のシステム4件×1+クラウドコンピューティングのシステム1件×3)/(5件)= (4 + 3) / 5 = 1.4、つまり40%の増加となる。(誤差−40%)
-
ハードウェアを動かすエネルギーコストを無視している。(別の付録の GPT-3 の例にもとづき、誤差−20%。)
-
データセンターを構成する他のハードウェア(スイッチ、相互接続ケーブルなど)のコストを無視している。(誤差−20%。これはエネルギーコストの誤差を目安にした直観的な推測である。このコストの割合がこれよりずっと大きいとしたら驚く。現代のGPUには極めて高度な製造技術が必要であることを考えると、GPUは個々のハードウェア部品として、他のすべてを合わせたものより高価なはずだと思われる。)
全体として推定値に分散を加えるが、大きな偏りは加えないとみられる要因にもとづく信頼区間
以下では、手法2のコスト推定式に含まれる変数について、90%信頼区間を推定する。93そのうえでそれらの信頼区間を組み合わせ、私の学習コスト推定値の全体的な90%信頼区間として、中心推定値の0.2倍〜5.0倍を得る。これらは主観的な推定値である点に注意してほしい。数値の選び方は、最も精密な最善の推測を純粋に選んだというより、切りのよい数値にすることにある程度影響されているだろう。
- ハードウェア価格(ドル):中心推定値の0.5倍〜2.0倍
- 市場の力による経時的な変動
- 1.5倍程度の変動がよくあるようだ(観察については脚注12を参照)
- そうした限られた観察が示すよりも保守的にするため、0.5倍〜2倍の倍率を選んだ
- 市場の力による経時的な変動
- 計算量(FLOP単位):中心推定値の0.5倍〜2.0倍
- Sevilla et al. (2022, p.16) と同じ不確実性の倍率、0.5倍〜2倍を使った。
- ハードウェア利用率(%):10%〜60%(中心推定値の0.29倍〜1.71倍)
- この信頼区間は、記事 Estimating Training Compute of Deep Learning Models の「About GPU utilization rates」の囲みにもとづいて選んだ。この囲みは、利用率の具体的な推定値を11件挙げている。
- 下限
- その節で報告されている最も低い利用率は10%だが、この数値は元の著者によって「主観的な推定値」として報告されたものである。
- (Patterson et al, 2021) の図5で、著者らは GPT-3 について20%(25÷125)という低いGPU使用率を報告している。これは、その記事で挙げられたいくつかの例の中で2番目に低い数値である。
- 全体として、報告されていない20%未満の利用率がありうることを考慮し、5パーセンタイルとして10%を選ぶのは妥当だと思われる。
- 上限
- ハードウェア利用率についての私の不確実性は、対数正規分布より正規分布でモデル化するほうが適切だと考える。利用率は百分率であり、報告された値は20%から50%の間にかなり集中しているようだからである。
- そこで正規分布の対称性から、5パーセンタイルが平均の35%より25ポイント下なら、95パーセンタイルは25ポイント上の60%とすべきである。これは私の中心推定値35%のおよそ1.71倍である。
- この60%という選択の確認として、その記事に挙げられた実際の画期的な機械学習システムで達成された最も高い利用率は、Google の LaMDA モデルの56.5%である。したがって60%を選ぶのは妥当に思えるが、95パーセンタイルとしては低すぎるかもしれない。
- より高い数値も挙げられている(「単一のGPUでさまざまな畳み込みニューラルネットワークを使った実験」にもとづく75%や、「GSPMD は大規模で最大62%の利用率をもたらすと報告されている」)。しかし、画期的な機械学習システムの大半は複数のGPUで学習されてきたというのが(厳密に確認したわけではないが)私の印象なので、実際のほとんどの画期的な機械学習システムについて、これらの数値がそれほどありそうだとは思わない。
- 下限
- この信頼区間は、記事 Estimating Training Compute of Deep Learning Models の「About GPU utilization rates」の囲みにもとづいて選んだ。この囲みは、利用率の具体的な推定値を11件挙げている。
- ハードウェアの交換時期:1〜4年(中心推定値の0.5倍〜2.0倍)
- より優れたハードウェアが発売される周期や、交換作業にかかる間接コストを考えると、連続使用1年未満でハードウェアを交換するのは不合理に思われる。Morgan (2022) の最初のグラフによれば、NVIDIA はおよそ2年ごとに新しいデータセンター向けGPUを発売しているようだ。一方、より優れたデータセンター向けGPUが機械学習に採用される時期(図7を参照)を踏まえると、ハードウェアの交換を連続使用4年より長く待つのも不合理に思われる。そこで、これについての私の90%信頼区間は1〜4年とした。
- 推定に実際に使った数値は2年なので、不確実性の倍率は0.5倍〜2倍となる。
信頼区間を推定するため、学習コスト(私の中心推定値に対する比、たとえば0.5倍で表す)の10,000サンプルの5パーセンタイルと95パーセンタイルをとった。94各サンプルでは、上記の各変数について、上で示した範囲を持つ対数正規分布95から倍率を抽出した。そしてそれらの倍率をコストの式に従って掛け合わせたり割ったりして、そのサンプルの最終的なコスト比を得た。その結果、学習コストの全体的な90%信頼区間は中心推定値の0.2倍〜5.0倍となった。
手法1
別の付録での手法1と手法2の推定値の比較にもとづくと、手法1の推定値は平均して手法2の2分の1だというのが私の最善の推測である。つまり手法1は手法2と同じような点で不正確だが、それに加えて、平均してコストを2分の1に過小評価している。
注
-
これらは、データベース Parameter, Compute and Data Trends in Machine Learning から、Sevilla et al. (2022, p.16) に記された基準と同じ基準で選んだ「画期的な」システムである。「データセットのモデルはすべて、主に一連の必要条件(明示的な学習の要素を持つ、実験結果を示している、最高水準を前進させている)と、少なくとも1つの注目度の基準(被引用数が1000超、歴史的な重要性、最高水準の重要な前進、注目すべき場面での運用)を満たす論文から選んでいる。新しいモデル(2020年以降)についてはこれらの基準を評価するのが難しいので、主観的な選択に頼っている。選択基準を満たすモデルを、画期的なモデルと呼ぶ。」↩
-
この増加率は、同じ期間の同じシステム群について、浮動小数点演算回数(FLOP)で測った学習計算量の増加より、年約0.2桁低い。これは Sevilla et al. (2022, Table 3) における「全モデル」(n=98)の2010〜2022年のFLOP単位の計算量のトレンド、年0.7桁にもとづく。おおまかに言えば、私の増加率は、計算量の増加率から、Hobbhahn & Besiroglu (2022, Table 1) が年0.12桁と推定したGPUの価格性能比の増加率を差し引いたものになっている。↩
-
これらの結果は、今後の増加率についての、私のすべてを考慮した最善の推定値ではない。むしろ、学習計算量とGPUの価格性能比のデータを組み合わせて過去のコストを推定する2つの推定手法にもとづくものである。これらの手法は参考になるが、強い単純化の仮定を置いている。総合的な最善の推測はこの要約の第3項で説明するが、それはより主観的な推論にもとづいている。私はコストの推定値を公表されたハードウェア価格にもとづいて出している。元の開発者にとっての本当のコストを推定するうえでは、オンデマンドのクラウドコンピューティングの価格よりもハードウェア価格のほうが正確だと考えているからである。そのため、私のコスト推定値は Heim (2022) など他の情報源よりも1桁低いことが多い。↩
-
期間の始めと終わりにおける、線形回帰による予測平均コストである。↩
-
これらの大規模システムの結果については、「全システム」のサンプルに比べてサンプルサイズが小さく信頼区間が広いことを踏まえ、直観的な判断にもとづいて精度を有効数字1桁に落とした。↩
-
コストの推定値は大きく異なる(平均して手法1のおよそ2倍)ものの、手法1との増加率の違いは、単にデータセットが小さいことによるものだと分かった(詳しくはこちらの付録を参照)。↩
-
網羅性のためにこの結果を載せたが、サンプルサイズが非常に小さく、増加率の信頼区間も広いので、使うことは勧めない。↩
-
手法1と手法2で得た増加率は、この Guesstimate モデルで実装した正規分布の加重混合によって統合した。Guesstimate が出す結果は無作為性のため、モデルを開くたびにわずかに変わる点に注意してほしい。報告した値はその一例にすぎない。↩
-
混合の手法は、データセットに新たな回帰を当てはめるのではなく増加率を統合するものなので、この手法では平均予測を得ていない。↩
-
「Willingness to spend on computation forecast」と題された Cotra (2020) のこの節の「Long-run growth」の項目を参照のこと。↩
-
Sevilla et al. (2022) は、「2010年以前、学習計算量はムーアの法則に沿って増え、およそ20か月ごとに倍増していた。2010年代初めにディープラーニングが登場して以降、学習計算量の拡大は加速し、およそ6か月ごとに倍増している」ことを見いだした。↩
-
機械学習システムの開発と運用には、他にもいくつか大きなコストがかかるが、それらは推定していない。そうしたコストには次のものがある。
- 最終的な学習の実行以外の、実験や失敗した学習の実行に費やされた計算資源
- 学習データの収集と前処理に費やされた計算資源
- 研究を行い、実験を実装する人間の労働
- ハードウェアとソフトウェアのインフラの保守
- 人員の採用と管理を含む業務支援
- 特定の運用用途に向けたモデルのファインチューニングに費やされた計算資源と人間の労働
- モデルの推論実行に費やされた計算資源
-
今後の研究での発展として、ハードウェアの価格が、発売直後には寿命の終わりに近い時期よりも高いとする非線形モデルを使うこともできるだろう。そのようなモデルは、ハードウェア価格の経時的な実データにもとづいて作れるだろう。↩
-
この式は、ハードウェアの冷却に関わるエネルギーコストを無視している。こちらの付録の推論にもとづき、エネルギーコストの合計は一般にハードウェアコストに比べて小さいと考える。↩
-
たとえば Google Cloud のGPU料金を参照のこと:https://perma.cc/M5P3-MZF7 ↩
-
Parameter, Compute and Data Trends in Machine Learning. CC-BY Jaime Sevilla, Pablo Villalobos, Juan Felipe Cerón, Matthew Burtell, Lennart Heim, Amogh B. Nanjajjar, Anson Ho, Tamay Besiroglu, Marius Hobbhahn Jean-Stanislas Denain, and Owen Dudney. ↩
-
私は計算量にもとづいてコストを推定しているので、私の手法は Sevilla et al. (2022) と似ている。手法の違いの一覧はこちらの付録を参照のこと。↩
-
不確実性を示す1つの例として、2つの異なる推定手法の結果が最大1.7倍異なることが分かっている。Estimating Training Compute of Deep Learning Models の付録Bを参照のこと。↩
-
1.5倍という数値は Morgan (2022) にもとづく。「……品不足のため、実勢価格が、製品が最初に発表されて注文が入り始めた時点より高くなることがある点を忘れてはならない。たとえば[NVIDIA の]Ampere シリーズが出たとき、A100 の 40 GB SXM4 版は複数のOEMベンダーで1万ドルの実勢価格が付いていたが、旺盛な需要と製品不足のため、価格はすぐに1万5,000ドルに上がった。2020年後半に出たこのカードの 80 GB 版も同様で、OEMでは1万2,000ドル前後で売られていたが、すぐに1万7,500ドルに跳ね上がった。」15,000 / 10,000 = 1.5、17,500 / 12,000 ≒ 1.5 である。↩
-
この値と利用率の推定値は、Ajeya Cotra が「Forecasting TAI with biological anchors」で使ったものと同じである。要約は Grokking “Forecasting TAI with biological anchors” を参照のこと。特に、計算資源の価格トレンドを分析したこの Colab ノートブックの、「Convert from LINPACK FLOP/s to total FLOP in training run」と題されたセルを参照のこと。↩
-
Estimating Training Compute of Deep Learning Models が「大規模言語モデルには30%、その他のモデルには40%」を推奨していることにもとづく。私のデータセットには大規模言語モデルとその他のモデルの両方が含まれるので、0.3と0.4の平均を使った。データセットのシステムのうち大規模言語モデルは少数派のようなので、0.35という値は低すぎるかもしれない。↩
-
Scaling Laws for Neural Language Models は、言語の分野でこの関係の証拠を示している。経験的に、言語モデルの検証データセットに対する損失は、学習計算量の拡大に伴いべき乗則に従って改善する。↩
-
Compute Trends Across Three Eras of Machine Learning も、当初は目視で外れ値を判断していた。p.16 を参照のこと。「[私たちは]まず目視でどの論文を外れ値とするかを決め、それに合わせて[Zスコアの]閾値を選び、外れ値が自動的に選ばれるようにした。」↩
-
ここにはわずかな食い違いがあるが、丸めによるものかもしれない。Sevilla et al. (2022, Table 3) の倍増期間5.6か月から出発すると、これは log10(2) / (5.6/12) = 年0.65桁に相当し、増加率は 0.65 − 0.12 = 年0.53桁となる。この数値は、ここでの結果である年0.51桁と十分に近く、どのデータを含めたかの違いで説明できそうである。Sevilla et al. (2022) との違いについて詳しくはこちらの付録を参照のこと。↩
-
この要約の「Affordability of compute」の節を参照のこと。Cotra が予測した2025年以降の支出の増加は倍増期間2年で、年0.15桁に相当する。↩
-
これらの計算には、丸める前のより精度の高いトレンドの値を使った。年0.25桁(90%信頼区間:0.16〜0.34)↩
-
手法1と手法2で得た増加率は、この Guesstimate モデルで実装した正規分布の加重混合によって統合した。↩
-
この Guesstimate モデルを参照のこと。手法1と手法2の予測は、増加率と同じ方法で組み合わせた。↩
-
「Willingness to spend on computation forecast」と題された Cotra (2020) のこの節の「Long-run growth」の項目を参照のこと。↩
-
出典:https://data.worldbank.org/indicator/NY.GDP.MKTP.CD?locations=US ↩
-
計算はこの Guesstimate モデルを参照のこと。年の90%信頼区間を計算するにあたっては、単に増加率の下限と上限をモデルに代入し、得られた年の推定値の上限と下限を(それぞれ)とった。こうしたのは、増加率について計算した元の分布を使うと、意味をなさない結果(たとえば100年という予測)が出たからである。そのため、年の90%信頼区間は最適な幅より広いかもしれない。↩
-
これらのアイデアの一部を提案してくれた Lennart Heim 氏に感謝する。↩
-
利益率を示す1つの手がかりとして、Google Cloud はより長期のレンタル契約に対して(オンデマンド価格から)37%〜65%の割引を提供している。2022年の Google Cloud のGPU料金を参照のこと。↩
-
Patterson et al. (2021) の表4(p.6)を参照のこと ↩
-
Patterson et al. (2021) の表4の11行目と2.5節(p.5)の式、および2.3節(p.4)を参照のこと。↩
-
CC-BY Jaime Sevilla, Pablo Villalobos, Juan Felipe Cerón, Matthew Burtell, Lennart Heim, Amogh B. Nanjajjar, Anson Ho, Tamay Besiroglu, Marius Hobbhahn and Jean-Stanislas Denain. ↩
-
画期的なシステムは Compute Trends Across Three Eras of Machine Learning で定義されている。p.16 より:「データセットのモデルはすべて、主に一連の必要条件(明示的な学習の要素を持つ、実験結果を示している、最高水準を前進させている)と、少なくとも1つの注目度の基準(被引用数が1000超、歴史的な重要性、最高水準の重要な前進、注目すべき場面での運用)を満たす論文から選んでいる。新しいモデル(2020年以降)についてはこれらの基準を評価するのが難しいので、主観的な選択に頼っている。選択基準を満たすモデルを、画期的なモデルと呼ぶ。」↩
-
Compute Trends Across Three Eras of Machine Learning における、2010年に始まる「ディープラーニングのトレンド」にもとづく ↩
-
これは、論文の中を関連キーワードで2分ほど検索して確認できた範囲である。キーワードは「GPU」「TPU」「CPU」「NVIDIA」「processor」「Intel」「AMD」とした。特定のハードウェアが使われたと思われる論文については、「V100」(NVIDIA Tesla V100 を指す)などの語でも検索した。こうした語だけに言及し、他のキーワードには触れていない論文もあった。時間の制約のため、データセットの最後の30件のシステムについては論文を検索しなかった。その理由は、(a) Google のシステムだった(データを持っていないTPUを使っている可能性が高い)、(b) 中国圏のシステムだった(データを持っているハードウェアを使っている可能性が低い)、(c) それほど注目度の高くないシステムだった(たとえば、GPT-3 のような同時期の言語モデルよりはるかに性能の低い言語モデル GPT-Neo)のいずれかである。↩
-
データが欠けているシステムもあるので、システムの数は25件より多い可能性がある。↩
-
各ハードウェアの単価のデータは、複数の出典から得たものが多い。NVIDIA はデータセンター向けGPUの希望小売価格を公表していないので、NVIDIA のデータセンター向けGPUについて私が持っている価格情報は、プレスリリースやニュース記事での報道、専門家の推定(たとえば Morgan (2022))によるものである。出典どうしの値は通常近かったので、複数の出典の値を平均するのではなく、論理的なルールを当てはめて、どの出典を使うかをケースごとに選んだ。どの出典を使うかをどう選んだかは、データベースの「Real price (2020 USD) - merged」列の数式を確認してほしい。↩
-
正確に言えば、これらの係数を入れると、「全システム」の回帰の90%信頼区間の上下限は最大0.01変化したが、それは係数の存在によるものではなく、単にブートストラップサンプルの無作為な変動によるものだった可能性もある。↩
-
計算量の少ない外れ値をどのように除外したかについては、Sevilla et al. (2022) の p.16 を参照のこと。「本論文を通じて、計算量の少ない外れ値はデータセットから除外している。そのために、各モデルについて、発表日が1.5年以内の他のモデルに対する学習計算量の対数のZスコアを計算する。Zスコアが平均より標準偏差2つ分以上低いモデルを除外する。この基準により、1952年から2022年までの123モデルのうち5モデルが除外される。こうして除外されたモデルは、ポーカー、Hanabi、かくれんぼなど、比較的新しい分野のものであることが多い。」↩
-
Sevilla et al. (2022) の p.18 の図5を参照のこと。↩
-
計算はこちらの Colab ノートブックのセルを参照のこと。↩
-
価格情報は、たとえば NVIDIA A100 のデータシートには含まれていない。Morgan (2022) も参照のこと。「Nvidia はデータセンター向けGPUアクセラレータの希望小売価格を公表していない。これはどのIT供給業者にとっても悪い慣行である。品薄の製品について、それを超えると需要による割増価格が上乗せされる下限も示さず、再販業者やシステムインテグレーターがそこから値引きしても Nvidia が実際に部品代として請求する額に対してなんらかの利幅を確保できるような上限も示さないからである。」↩
-
これは、何人かの専門家と話し、これまでで最大のニューラルネットワークの学習に関する機械学習の論文(たとえば2022年の Google の PaLM システム)をいくつか読んだうえでの私の理解である。GPT-NeoX-20B 言語モデルの開発の中心的な貢献者だった Sid Black 氏は、会話の中で私に(要約すると)「大規模言語モデルの学習は相互接続がボトルネックになっている。ソフトウェアスタックをきちんと構成しないと、本当に遅くなる」と語った。PaLM の論文(p.8)には、「ポッドレベルの双方向データ並列化で興味深いのは、2つのポッドにまたがる合計1536台のホストに接続された6144個の TPU v4 チップという規模で、ポッド間の勾配転送について高い学習スループットを達成することの難しさである」とある。(この引用は専門用語だらけだが、私の理解では、「ポッド間の勾配転送」とは、ハードウェアのまとまりである異なる「ポッド」に属するハードウェアどうしでデータを転送することである。)↩
-
Sevilla et al. (2022) の p.18 の図5を参照のこと。手法1は学習計算量をGPUの価格性能比のトレンド線の値で割っているだけなので、これは驚くことではない。しかし仮に、学習計算量の増加が実際よりもゆるやかだったら、後のシステムは計算量の記録を更新してもコストの記録は更新しない、ということが起きたかもしれない。↩
-
「大規模」システムという別のカテゴリーが存在することは、Sevilla et al. (2022, p.22) で論じられている ↩
-
計算はこちらの Colab ノートブックのセルを参照のこと。↩
-
計算:(7か月 ÷ 1年あたり12か月)× 年0.44桁 ≒ 0.26桁 = 10^0.26 ≒ 2。↩
-
PaLM と AlphaGo Zero について手法1の推定値を挙げたのは、平均すれば手法2のほうが正確だと考えているものの、手法2で使える PaLM と AlphaGo Zero のデータがなかったからである。↩
-
この記事の脚注6には「V100 のFP32の理論値14 TFLOPSを2倍して、FP16の理論値28 TFLOPSとする」とある。この数値は、Patterson et al. (2021, Figure 5) が(GPT-3 の開発元である OpenAI に代わって)報告した実際の数値25 TFLOPSにかなり近い。NVIDIA が V100(PCIe 版)について公表している理論上のピーク性能は112 TFLOPSなので、28 TFLOPSは利用率25%に相当する。これに対し、私はすべてのシステムについて利用率35%を仮定した。↩
-
私は(NVIDIA V100 GPU 1基について、インフレ調整済みの)9,029.66ドルという価格を2年間で償却して使った。その結果、9029.66ドル ÷(2年 × 365日/年 × 24時間/日)≒ 1時間あたり0.52ドルとなる。LambdaLabs の記事の脚注1では、1時間あたり1.50ドルという価格が示されている。↩
-
PaLM の論文の p.66 を参照のこと。「PaLM 540B は Google のオクラホマのデータセンターで学習した……」↩
-
この記事の脚注にある表を参照のこと。TPUは1時間あたり6.50ドル、GPUは1時間あたり0.31ドルである。表ではGPUが「best」とされているが、これが入手できる最高性能のGPUという意味なのか、最も安いGPUという意味なのかは分からない。↩
-
この情報源は、情報の直接の出典を示していないので比較的信頼性が低いと思うが、それでもかなりの信頼を置いている。↩
-
このセルの注記には「Paul は、非常に効率よく使われた純粋な計算資源について、1ドルあたり1e17回の演算と推定した。ここでは、人件費、論文に含まれない失敗した実験、非効率などを考慮して1e16と仮定している」とある。しかしスプレッドシートの計算での数値は実際には1.2e17なので、これが誤記なのか、注記がもはや当てはまらないのかは分からない。1桁低いという仮定が正しいなら、これも私の推定値が異なる理由の1つになる。私は「学習用計算資源のコスト」の定義から、人件費と失敗した実験を除外しているからである。↩
-
図7のピーク時の価格性能比のトレンドは、2017年に1ドルあたり約1e10 FLOP/sである。1ドルあたり1e10 FLOP/s × 利用率35% ×(2 × 365 × 24 × 60 × 60 秒)= 2.2e17 FLOP/$。↩
-
報告書草稿の Willingness to spend on computation forecast の節を参照のこと ↩
-
この計算では、丸めた最終結果の年0.2桁ではなく、より精密な増加率である年0.24桁を使っている。↩
-
7.5桁(約3,200万ドル)を超える可能性が低いと考える理由を説明する。Minerva を生み出すための計算資源の大半は、まず PaLM の学習に使われた。Minerva は、PaLM のFLOP単位の計算量の8%を追加して学習された(Parameter, Compute and Data Trends in Machine Learning データセットの「Minerva (540B)」の「Training compute (FLOPs)」列を参照)。Lennart Heim 氏のこのブログ記事は、(Google ではない者が)クラウドコンピューティングを使った場合の PaLM の学習コストを900万〜2,300万ドルと推定した。これを8%増やすと、コストは約1,000万〜2,500万ドルになる。しかし Google は自社のハードウェアを使ったので(PaLM の論文の p.66 には「PaLM 540B は Google のオクラホマのデータセンターで学習した」とある)、他の事業者のクラウドコンピューティングの利ざやを払う必要がなく、コストはより低くなるだろう。こうした理由から、Minerva の学習にかかった計算資源の実際のコストが、ここで使う3,200万ドルという値を下回っていた可能性は90%を超えると考える。さらに、Minerva が実際に2022年で最も高額な学習の実行だった(まだ公表されていない学習の実行も含めて。Cotra もそれらを含めていたと想定している)可能性は70%を超えると考える。ここから、先に述べた全体の確率の目安 0.9 × 0.7 = 0.63 ≒ 60% が導かれる。↩
-
報告書草稿の Willingness to spend on computation forecast の節で、Cotra は「[増加は]倍増期間2年に鈍化し、2040年までに1,000億ドルに達すると仮定した」と書いている。Cotra の「最善の推測」の計算スプレッドシートのセルB7には現在、倍増期間2.5年と記載されているが、これは後の更新かもしれない。2020年時点の Cotra の最善の推測の推定値については、スプレッドシートではなく報告書を正とみなしている。↩
-
報告書草稿の Willingness to spend on computation forecast の節で、Cotra は「学習の実行が約10億ドルを超えると、非常に資源の豊富なラボにとってさえ、資金を集めてさらなる支出を正当化することは目に見えて難しくなると予想する。つまり、2025年以降は増加が鈍化するだろう」と書いている。↩
-
これは必ずしも新しい結果ではない点に注意してほしい。Compute Trends Across Three Eras of Machine Learning がすでに、大規模システムの学習計算量(FLOP単位)の増加がこのように鈍化していることを指摘している。FLOP/$ のトレンドは比較的信頼できるので、その学習計算量のドル建てコストも同様の特徴を持つ。↩
-
この増加率は OpenAI の「AI and Compute」から取られている。これがコストの推定と予測に使われた増加率であることを、著者らにメールで確認した。↩
-
同報告書の図2(p.13)を参照のこと。↩
-
この増加率の引き算は、対数空間でFLOPをFLOP/$で割ってドル建てのコストを得ることに相当する。↩
-
その精度まで値を信頼しているわけではないが、この計算ではより精密な推定値である年0.24桁を使った。5桁 ÷ 年0.24桁 = 21年。↩
-
p.10 より:「2021年末までに、トレンド線はさらに数回の倍増を予測しており、予想されるモデルは100万ペタFLOPS日をわずかに超える。そのようなモデルを Google Cloud の現在の価格で学習すると、4億5,000万ドルを超えるコストがかかる。」線がおよそ10^8と10^9の中間から始まっていることから、彼らがこのコストを論文の図2(p.13)の予測の起点として使っていることは明らかである。↩
-
著者らはメールで私に、この推定値は2021年の最高コストを正確に推定するためというより、むしろ近年の計算量の歴史的な増加が持続不可能であることを示すためのものだったと説明してくれた(その結論は初期コストの選び方にそれほど左右されないからである)。↩
-
混合モデルは正規分布の加重混合で、この Guesstimate モデルで実装した。↩
-
報告書草稿の Willingness to spend on computation forecast の節を参照のこと ↩
-
「united states gross domestic product」の Google 検索で返ってくる答えは、2021年について23兆3,200億米ドルである。↩
-
p.12〜13 より:「図2が示すように、1ドルあたりの計算量がおよそ4年ごとに(実線)、あるいは2年ごとにでも(網掛け部分の下限)倍増する可能性が高いと仮定すると、計算量のトレンド線は、この10年が終わる前に[すぐに]持続不可能になる。」図2は、外挿した学習用計算資源のコストが2027年ごろまでに米国GDPに等しくなることを示している。↩
-
「経済への大きな影響」をどう測るかは分からないが、例を挙げれば、現在人間が担っている財・サービスの仕事全体の1%が自動化されれば、学習の実行への支出の増加率を高めるのに十分だと考えられる。↩
-
2倍という倍率は次の推論にもとづく。こちらの節で私は「PaLM の推定値のうち私の手法に最も近いもの(2,310万ドル)から55%割り引くと1,040万ドルとなり、私の[手法1の]推定値の320万ドルにずっと近づくが、それでもまだ大きく離れている」と述べた。PaLM についての外部の推定値の背後にある推論にある程度従うなら、55%の割引を適用した後の値が、私がすぐに手に入れられる最も正確な値だと考える。しかし、前述のとおり手法1の推定値は2分の1に低すぎるとも考えている。そこでごく大まかな計算として、手法2に対する比は 1,040万 ÷(2 × 320万)= 1.625 となる。計算が不精密であることを踏まえ、これを切り上げて2とする。↩
-
90%信頼区間は、こちらの節で導いた90%信頼区間の上下限に2を掛けて得た。この区間は、すべての機械学習システムの平均コストについての私の不確実性ではなく、私のデータセットの個々の機械学習システムのコストがどれだけばらつくかを反映している点に注意してほしい。↩
-
私の推論についてはNVIDIA GPUの価格性能比に関する付録を参照のこと ↩
-
記事には「……Ampere シリーズが出たとき、A100 の 40 GB SXM4 版は複数のOEMベンダーで1万ドルの実勢価格が付いていたが、旺盛な需要と製品不足のため、価格はすぐに1万5,000ドルに上がった」とある。V100 の価格も同様の理由で2020年に上がったと想定している。↩
-
2022年8月26日時点で、Google Cloud は TPU V4 のオンデマンド価格について、3年間のレンタル契約で55%の割引を提供している。おそらく Google Cloud は、55%の割引を適用しても利益を上げているのだろう。そこで55%から67%に引き上げた。主な理由は利益率がそれより極端に大きいとは思わないからだが、切りのよい数値(およそ3分の2)を使うためでもある。↩
-
式は cost = compute / ((peak_hardware_throughput / hardware_price) * hardware_replacement_time * hardware_utilization_rate) である。↩
-
例外はハードウェア利用率で、これは正規分布から抽出した。↩