
レポート
「生物学的アンカーによるTAIの予測」を読み解く
原題:Grokking “Forecasting TAI with biological anchors”
注:
- Ajeya Cotra の報告書草稿Forecasting TAI with biological anchors (Cotra, 2020)を図で解説し、主要な仮定、直観、結論を要約する。
- 図はこちらで見られる。一部のボックスをクリックすると、報告書の該当箇所にリンクしている。1
提案とフィードバックをくれた Michael Aird、Ashwin Acharya、Epoch AI のチームに感謝する。詳細なフィードバックをくれた Jaime Sevilla と Ajeya Cotra には特に感謝したい。
要旨
Ajeya Cotra の生物学的アンカーの枠組みは、計算資源をAIの進歩の主要なボトルネックとみなすことで、変革的AI(Transformative AI、TAI)の開発時期を予測しようとするものである。これにより、「TAIはいつ開発されるのか」という問いの代わりの指標として、具体的な尺度(FLOPで測った計算資源)に注目できる。そうすると、この問いは主に二つの問いに分解できる。
- 2020年時点の学習計算量の要件:2020年の機械学習のアーキテクチャとアルゴリズムを使ってTAIを学習させるには、どれだけの計算資源が必要か。
- 計算資源の手の届きやすさ:ある年に、TAIの学習に必要な計算資源をまかなえる見込みはどれくらいか。
二つ目の問いには、主な三つの要因について既存のトレンドを見れば取り組める。(1)アルゴリズムの進歩(アルゴリズム効率の改善など)、(2)計算の価格の低下(ハードウェアの改良によるものなど)、(3)計算資源にお金をかける意欲の高まり、である。
一つ目の問いはずっと厄介である。Cotra は、脳を「概念実証」とみなすことでこれに答えようとする。脳の「学習」に使われた「計算量」で、汎用的な知能を学習させられることの証明だというのである。これにより、「TAIの学習にはどれだけの計算資源が必要か」という問いを、「人間の脳の『学習』にはどれだけの『計算』が使われたか」という問いに結びつけられる。ただし後者の問いには自明な解釈が一つあるわけではないので、Cotra はそれが何に当たるかについて六つの仮説を立て、「生物学的アンカー(biological anchors、bioanchors)」と名づけている。
- 進化アンカー:TAIの学習に必要な計算量 = 最初のニューロンの誕生以来、進化の過程で行われた計算量
- 生涯アンカー:TAIの学習に必要な計算量 = 人間の脳が成人になるまで(0〜32歳)に行う計算量
- 三つのニューラルネットワーク・アンカー:人間の脳の処理能力と、経験的なパラメータのスケーリング則に基づく。
- 厳密には三つあり、短・中・長の「実効ホライズン長」に対応する。実効ホライズン長とは、AIシステムに加えた変更が性能を改善するのか悪化させるのかを判定するのに必要なデータの量である。
- ゲノムアンカー:人間の脳の処理能力に基づき、パラメータ数を人間のゲノムのバイト数とし、上記と同じ経験的なスケーリング則を使い、長いホライズン長(一つの「データ点」=数年)を仮定して、必要な学習データの量を外挿する。
学習計算量の要件の分布を計算するにあたり、Cotra はこれらの生物学的アンカーの仮説全体に90%の重みを置き、残りの10%は、すべてのアンカーが必要な計算量を大幅に過小評価している可能性に充てている。
Cotra が「ある年までにTAIが開発される見込みはどれくらいか」という問いをどう分解しているかを、図で示すと次のようになる。
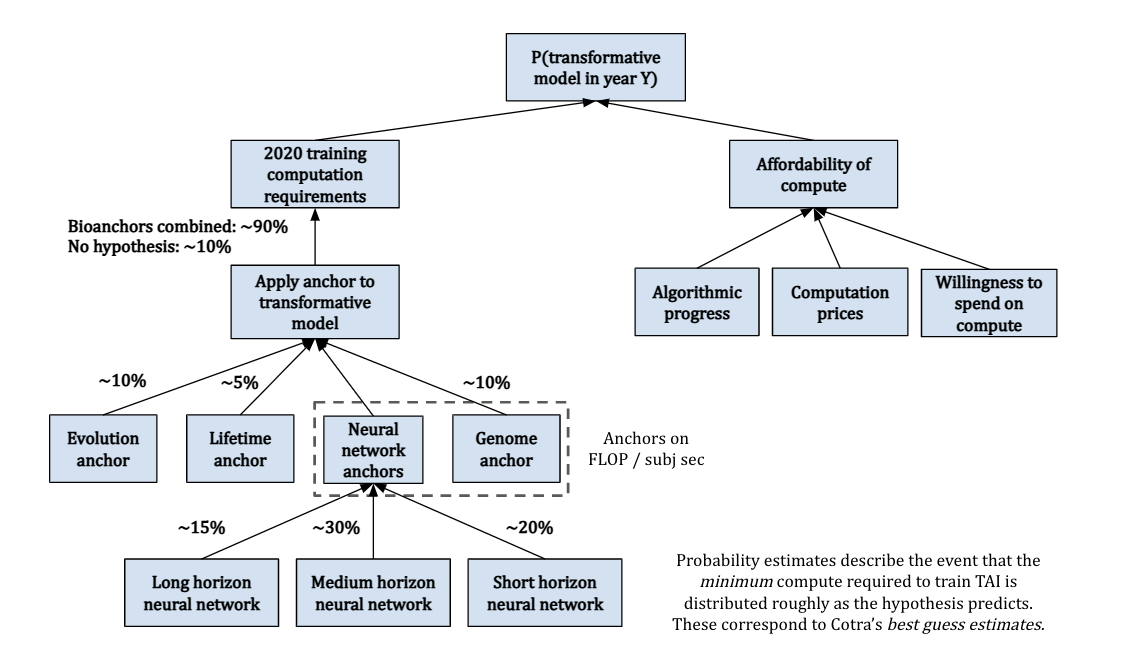
ここまでは、AIの到来時期(タイムライン)という問いを Cotra がどう分解したかの要約である。彼女の主な結論の要約はこちらを参照してほしい。
動機
AI安全性で最大の未解決の論争の一つが、AIの到来時期の問題、つまり変革的AI(TAI)はいつ開発されるのか、という問いである。2020年、Ajeya Cotra はこの問いに答えることを目指した報告書の草稿Forecasting TAI with biological anchors (Cotra, 2020)を公開した。付録を含めると200ページを超え、しかもまだ草稿なのである。
聞くところでは、この報告書の結果はすでにAIガバナンスの仕事の参考にされており、AI安全性の多くの研究者の見方に大きな影響を与えている可能性が高いと私は考えている。2とはいえ、文書が長いせいで、報告書を全部読んだ人、その仮定や限界を知っている人、手法を大づかみに理解している人はおそらく少ない。
この記事の狙いは、報告書の要約をもう一つ書いて、この状況を変えることである。モデルの背後にある直観を中心に扱い、枠組みを図で説明して、Cotra の報告書のさまざまな部分がどう組み合わさっているのかを示す。
なぜ計算資源に注目するのか
ご想像のとおり、将来の変革的な技術の行く末を予測するのは非常に難しい。過去に似た性質の技術があまりなかった場合はなおさらである。手がかりを得るには、どの変数が最も重要かについて、どうしても仮定を置かざるをえない。
報告書で Cotra が答えようとしているのは、次の問いである。
「変革的モデル」の学習に必要な計算量が、AI開発プロジェクトの手に届くようになるのは何年か。
ここで「変革的モデル」とは、(学習後に)そのモデルのコピーを多数動かせば、「少なくとも産業革命と同じくらい深い影響を世界の行く末に与える」ような単一のAIモデルを指す。3これは「変革的AI」がとりうる一つの具体的な形である。つまり Cotra の報告書は、ある経路(巨大なAIモデルの学習)でTAIを生み出すのに十分な、ある種の資源(計算資源)がいつ手に入るのかを問うている。彼女は、これが「変革的AIはいつ実現しうるのか」というより広い問い全体に光を当てることを期待している。
このように Cotra の問いはより限定的だが、TAIの到来時期というより広い問いにとっても参考になると考えてよさそうである。理由は次のとおりである。
- TAIに至る「大きなモデルを学習させる」という経路は技術的に可能に思われ、現在の最高水準のAIシステムの作り方に似ているので目立つ。(実際、これはAIへのアプローチとしては異例なほどの力ずくのやり方なので、「単一の大きなモデルを学習させることでTAIが得られるのはいつか」という問いは、「TAIが得られるのはいつか」という問いの「緩やかな上限」とみなせる。)
- 変革的モデルを学習させるうえで最大のボトルネックとなる資源は、計算資源である可能性が非常に高そうだ。たとえば(他の理由もあるが)次のような点がある。
- 深層学習の登場後に成功した多くのアルゴリズムやアーキテクチャは、数十年前にすでに提案されており、研究者がより多くの計算資源を使えるようになって初めて競争力のある性能に達した。
- 計算資源は大幅に増えている(2010年以降で100億倍)。これに比べて、アルゴリズム効率の伸びは小さい(2012年以降で44倍)。
- スケーリング仮説とスケーリング則を支持する証拠からは、計算資源の規模をますます大きくしてAIモデルを学習させると、規則的で予測可能な収穫が得られることがうかがえる。
また、標準化された単位をもたない「データ」や「アルゴリズム」のような漠然とした概念に比べて、計算資源が比較的測りやすいことも都合がよい。計算資源の尺度としてよく使われるのは、モデルが行う算術演算の総数で、FLOPで測る。モデルが1秒あたりに行う演算の回数(FLOP/sで測る)にも関心があるかもしれない。これは、モデルの学習に使うハードウェアの性能を示す。
枠組み
こうして Cotra は、TAI予測の枠組みで計算資源を中心に据える。「TAIはいつ開発されるのか」と問う代わりに、二つの別々の問いを立てるのである。
- 2020年時点の学習計算量の要件:2020年の機械学習のアーキテクチャとアルゴリズムを使って変革的モデルを学習させるには、どれだけの計算資源が必要か。
- 計算資源の手の届きやすさ:ある年に、変革的モデルの学習に必要な計算資源をまかなえる見込みはどれくらいか。
二つ目の問いには比較的素直に答えられる。分析してそのまま外挿できる明確なトレンドがいくつかあるからである。4しかし一つ目の問いは、厄介な問題を山ほど呼び込む。拠りどころにできる何らかの参照クラスを見つける必要があるのだ。
そこで Cotra は、人間の脳を拠りどころにすることにした。人間の脳を、汎用的な知能が実現可能であることの「概念実証」とみなし、この類推を真剣に受け止めるのである。人間の脳の「学習」に必要な計算量は、変革的モデルの学習に必要な計算量を知る手がかりになるはずだ、というのが前提である。
しかし、「人間の脳を学習させるための計算量」をそもそもどう定義すればよいのだろうか。定義には主に二つのあいまいさがありそうである。
- 人間の脳はどれだけの期間「学習」したのか。
- たとえば、脳が学習した期間は人間の一生と解釈すべきか、それともニューロンの進化の全過程と解釈すべきか。
- 学習の各時点でどれだけの計算資源が使われたのか。
- たとえば、人間の脳は何FLOP/sで動いているのか。
これらの問いへの答えが生物学的アンカーを決める。「人間の脳の学習にはどれだけの計算量が使われたか」という問いへの、ありうる四つ5の答えである。このうち二つは、計算資源のFLOPを直接の拠りどころにする。
- 進化アンカー:変革的モデルの学習に必要な計算量は、最初のニューロン以来、進化の歴史全体で行われた計算量の総計とおおむね同じである。この見方では、進化を非常に大きな探索アルゴリズムと解釈する。ありうるニューラル・アーキテクチャと環境の広大な空間を探索し、最終的に人間の脳に行き当たったというわけである。
- 生涯アンカー:変革的モデルの学習に必要な計算量は、子どもが誕生から32歳まで成長するあいだに行われる計算量とおおむね同じである。この仮説のもとでは、機械学習のアーキテクチャは人間の学習とおおむね同じくらい効率的だと予想することになる。
残りの二つの仮説は、総計算量ではなく、脳が行う1秒あたりの計算量(つまりFLOP/s)を拠りどころにする。これを使って、TAIが行う主観秒あたりのFLOP(FLOP / subj sec)を推定する。「主観秒」とは、人間が1秒で処理できるのと同じ量のデータをモデルが処理するのにかかる時間である。6これらの仮説は、TAIに必要なパラメータ数の予測が異なる。
- ニューラルネットワーク・アンカー7:TAIは人間の脳とおおむね同じだけのFLOP / subj secを行い、「パラメータ」と「FLOP / subj sec」の比率は今日のニューラルネットワークと同程度になるはずである。後で見るように、実際にはここに三つのアンカーがある。
- ゲノムアンカー:TAIは人間の脳とおおむね同じだけのFLOP / subj secを行い、人間のゲノムのバイト数とほぼ同じ数のパラメータをもつはずである。
これらのアンカーの主張は、次のように考えられる。TAIを作るには人間の脳に匹敵する処理能力が必要であり、パラメータも(1)その処理能力で動くニューラルネットワークに典型的な数、または(2)人間のゲノムと同じだけ必要になる。
Cotra の生物学的アンカーの枠組みの全体像を以下に示す。
左側では、生物学的アンカーを使って、TAIの学習に必要な計算量を決める。全体として Cotra は生物学的アンカーに90%の重みを割り当て、残りの10%は、すべての仮説が必要な計算量を大幅に過小評価している可能性のためにとっておく。右側では、計算の価格とお金をかける意欲に影響するトレンドに基づいて、この計算量をいつまかなえるようになるかを予測する。両者を組み合わせて、ある年までにTAIが実現する確率を推定する。
先に見たように、進化アンカーと生涯アンカーが予測するFLOPは直接推定できるが、ゲノムアンカーとニューラルネットワーク・アンカーではそうはいかない。そのためには、人間の脳が行うFLOP / subj secの値と、学習に必要な主観秒の数の両方を知る必要がある。
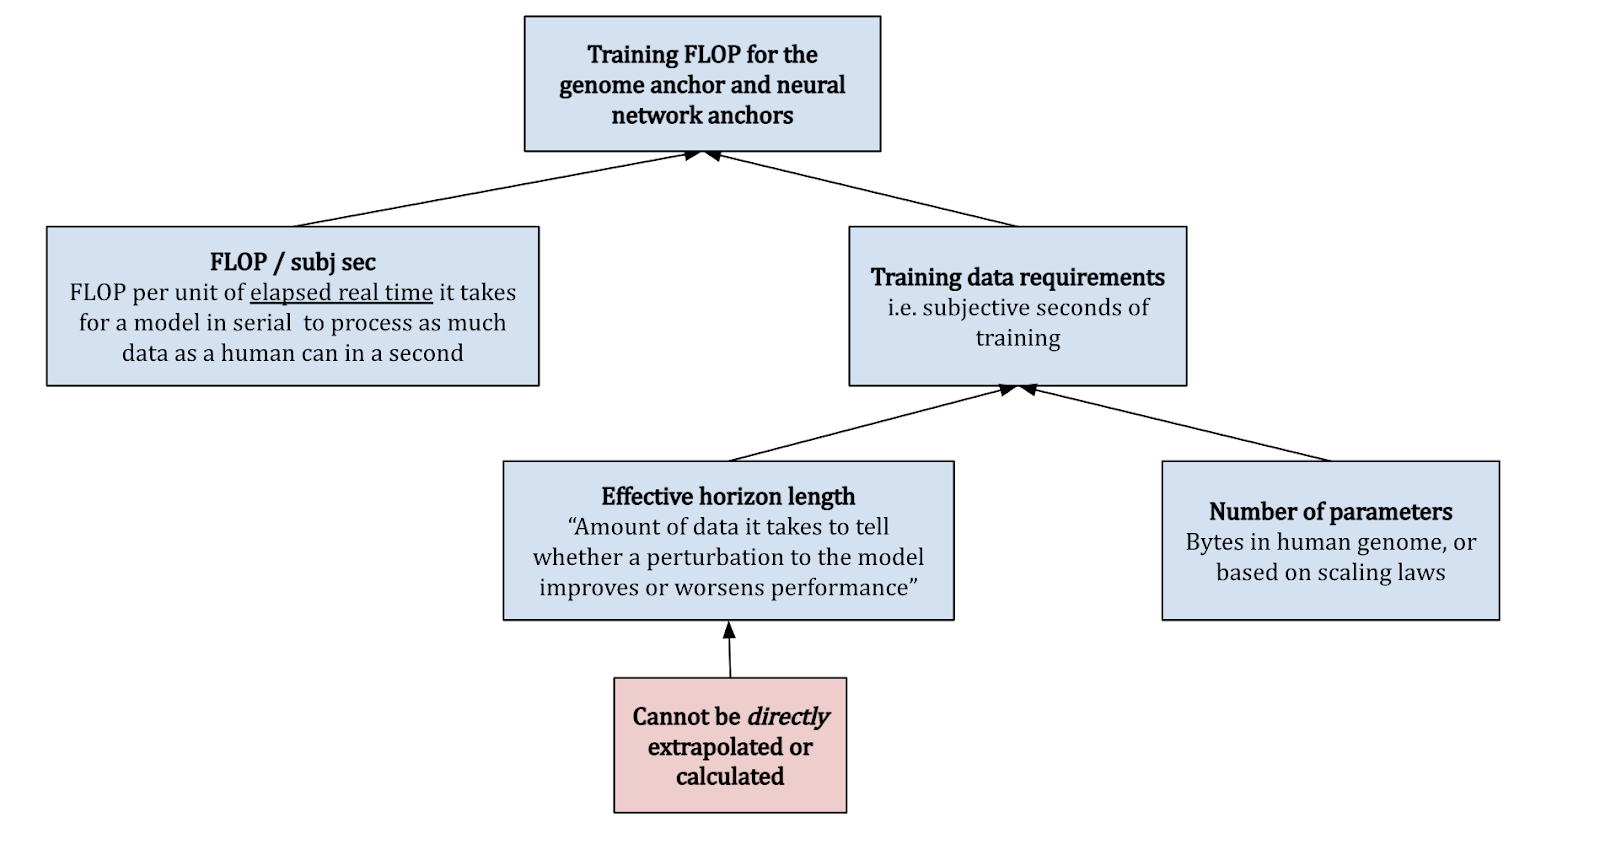
学習データの要件を求める作業は、二つの部分に分かれる。
- パラメータ数:該当する生物学的アンカーの仮説が定める。
- 実効ホライズン長:おおまかに言えば、モデルに加えた変更が性能を改善するのか悪化させるのかを見分けるのに必要なデータの量である。8これは直接外挿することも計算することもできないので決めるのが難しく、報告書で最大の不確実性の一つとなっている。
これらをすべて組み合わせると、該当する生物学的アンカーが予測する計算量のおおまかな推定が得られる。
これで、モデルの基本的な動機と仕組みの枠組みが分かったことになる。次の節では、複雑さの多くが潜んでいる部分、つまり生物学的アンカーそれぞれについて学習計算量の確率分布を求める作業に踏み込む。
生物学的アンカーを詳しく見る
各生物学的アンカーは、三つのステップを経るものと考えられる。
- 生物学的な証拠に基づいて、FLOPの事前分布を求める
- 現在の機械学習から得られる証拠と直観に基づいて調整する
- そのアンカーにどれだけの重みを置くかを決める
この節では、生物学的アンカーの各仮説を簡単に説明する9。それぞれについて依存関係の図も載せた。図のボックスは報告書の該当箇所にリンクしている。
進化アンカー
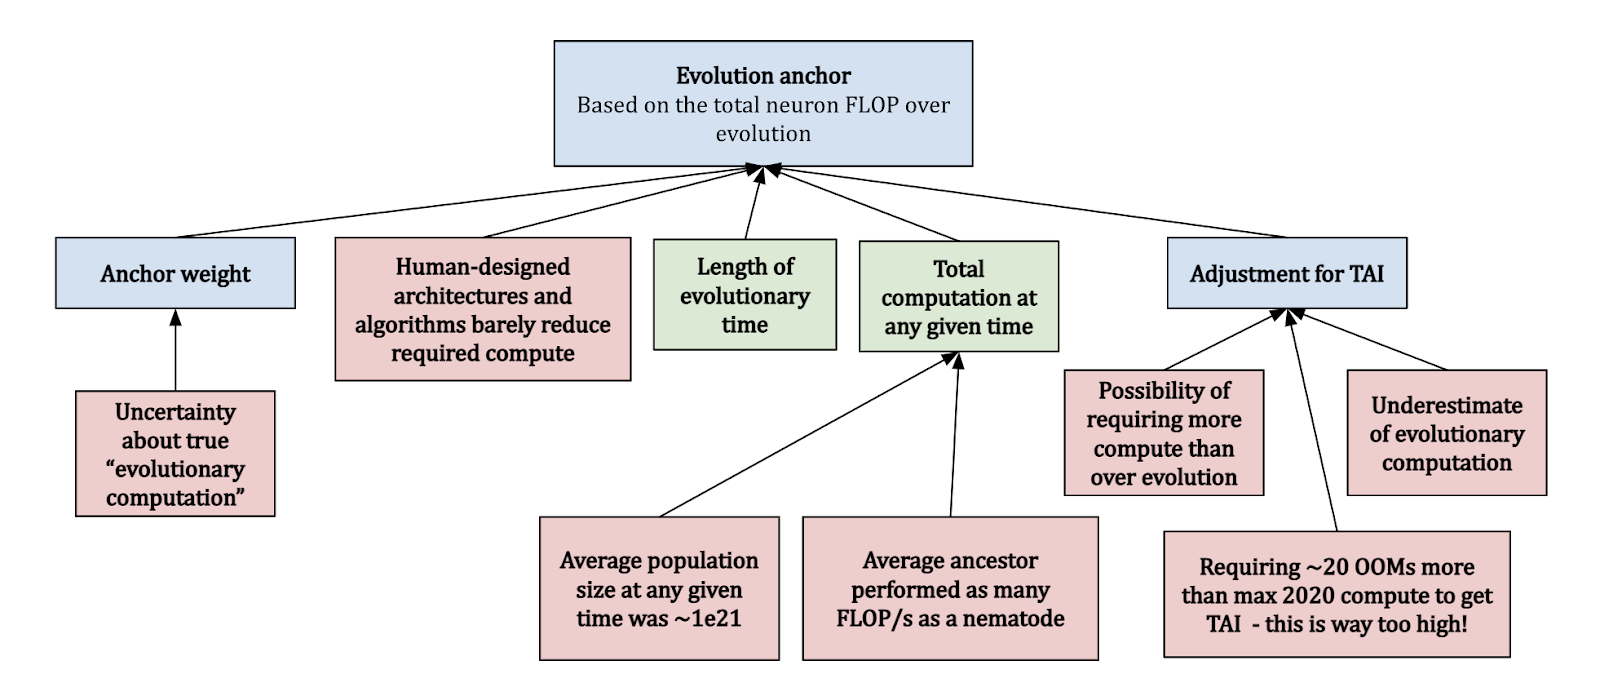
進化アンカーは、最初のニューロン以来、進化の過程全体で行われたFLOPの総計に注目する。この手法には明らかにいくつかの不確実性がある。
- 「進化の計算」をそもそもどう数えるのか。それはGPU上で行われるFLOPとどう比べられるのか。
- 任意の時点で、全生物種にわたって行われた「平均的な」計算量はどれくらいだったのか。
- 人間が設計したアーキテクチャの計算効率は、単なるランダム探索と比べてどうなのか。
Cotra はこうした点を考慮したうえで、「平均的な祖先」は線虫と同じだけのFLOP/sを行い、どの時点でも平均して約1e21の祖先がいたと仮定する。これにより中央値は約1e41 FLOPとなり、現代の機械学習と比べると桁外れに大きく思える。10彼女はこのアンカーに10%の重みを与えている。
生涯アンカー
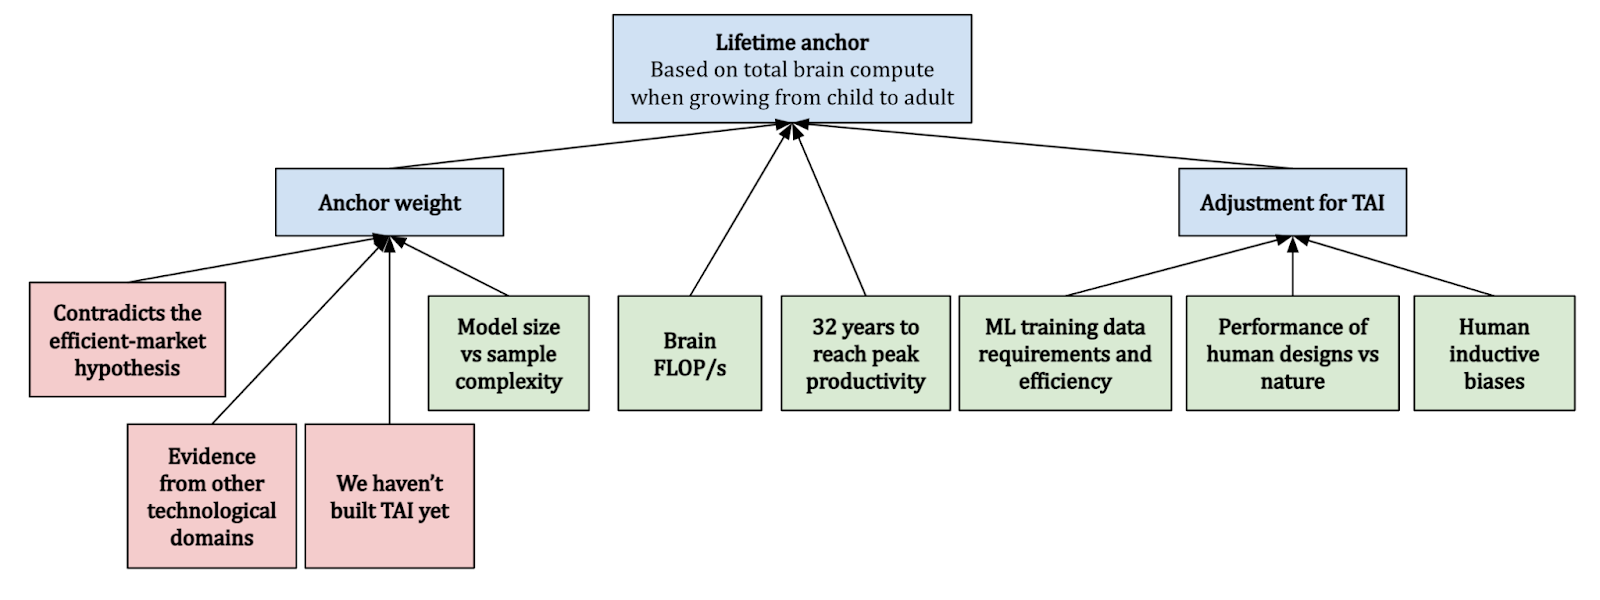
FLOPを直接数える二つ目の手法は、生涯アンカーに基づく。これは、子どもが成人(32歳)に成長するまでの脳の総計算量に注目する。脳のFLOP/sの数値を当てはめると、TAIに到達するには約1e27 FLOPが必要だということになりそうである。これはいくつかの理由から、あまりに少なすぎるように思える。
- 他の技術分野の例からは、私たちが作るものの効率は(関連する指標の上で)自然と比べて一般にあまりよくないことがうかがえる。
- また、効率的市場仮説とも矛盾し、AlphaStar並みの計算量でTAIになる確率がかなり高いと予測してしまう。実際にはそうなっていないようである。
全体として、Cotra は中央値を約1e28 FLOPとし、このアンカーに5%の重みを置いている。
進化アンカーと生涯アンカーは似た手法をとっているように見えるが、この二つの解釈が予測の点でどれほど大きく異なるかは、強調しておく価値が本当にあると思う。そこで、それを示す図を載せておく。
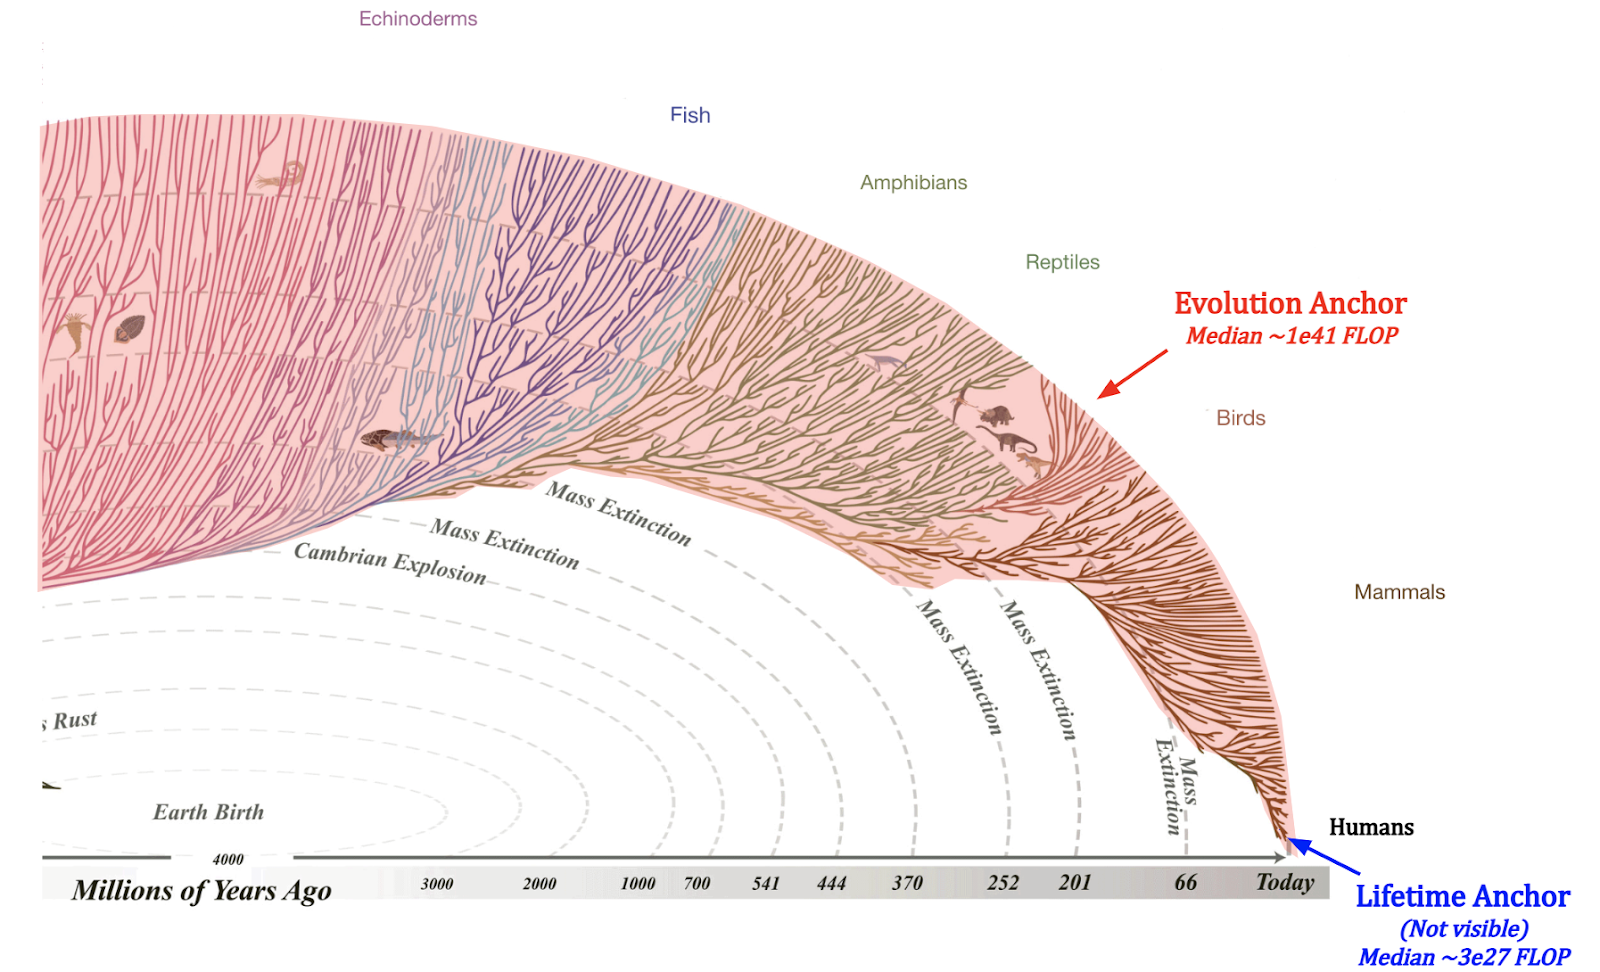
画像の出典:(系統樹)evogeneao Tree of Life Explorer
系統樹のうちニューロンをもつ部分を見ると、進化アンカーは、多くの異なる枝にまたがる赤い領域全体のニューロンの計算を含んでいる。一方、生涯アンカーでは、右下の小さな領域にぐっと近づき、哺乳類全体のうち人間だけを考え、これまでに生きた約1,000億人のうち一人の人間の生涯の32年間だけを考える必要がある。これは図ではとても見えるような大きさではない11。
ニューラルネットワーク・アンカー
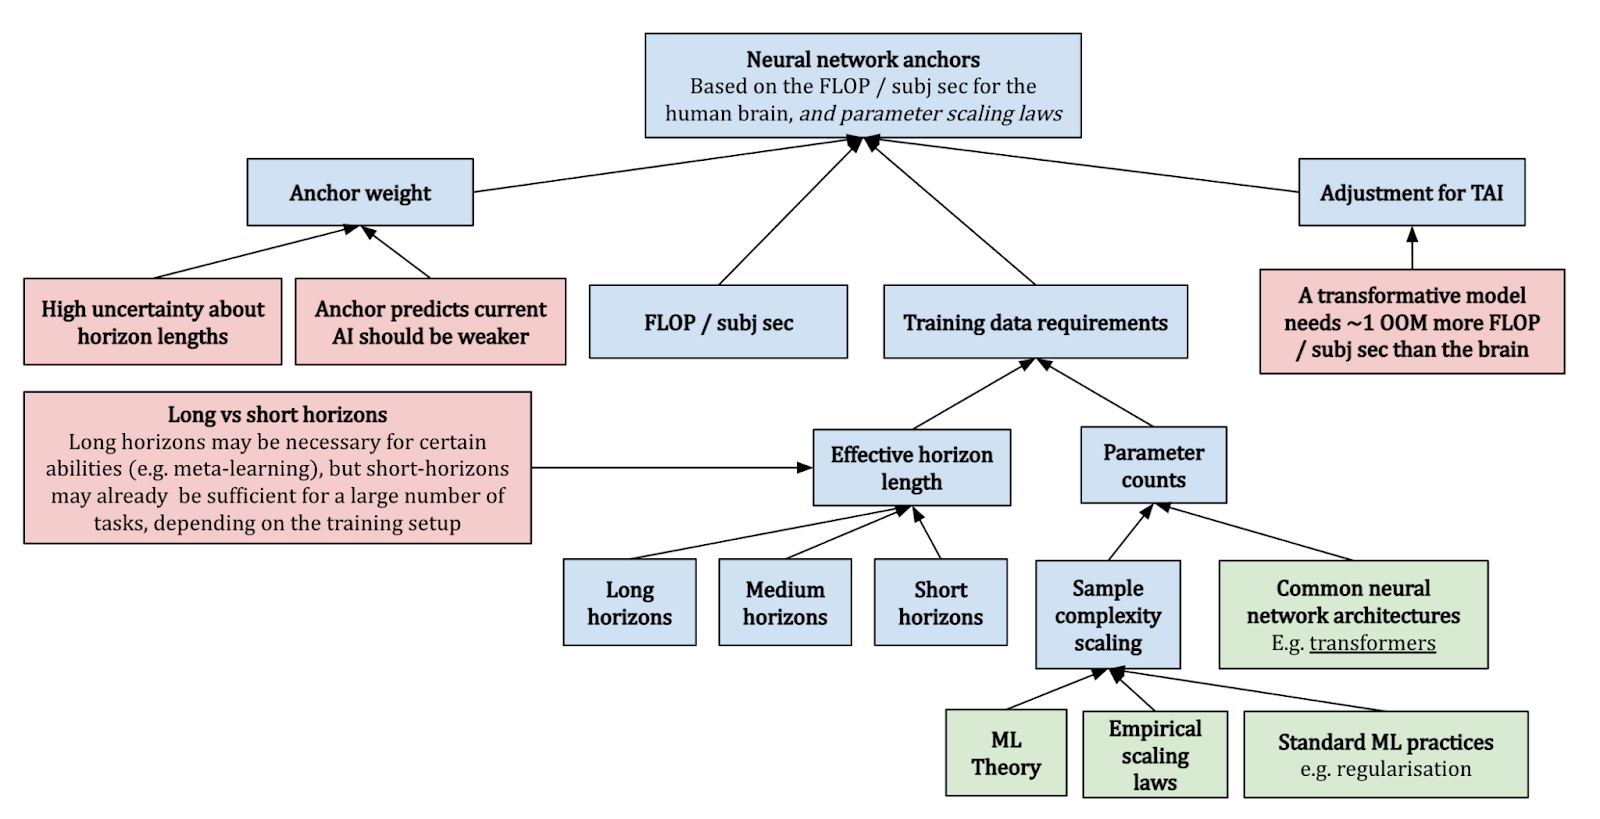
三つのニューラルネットワーク・アンカーは、脳が行うFLOP / subj secを拠りどころにし、パラメータのスケーリング則に基づいて、ネットワークの学習にどれだけの計算量が必要かを調べる。これらのアンカーは、変革的な影響を実現するのにどれだけのホライズン長が必要とみなすかによって異なり、それぞれに対応する対数一様分布をもつ。
- 短いホライズン:1主観秒〜1e3主観秒、中心は約1e32 FLOP
- 中程度のホライズン:1e3主観秒〜1e6主観秒、中心は約3e34 FLOP
- 長いホライズン:1e6主観秒〜1e9主観秒、中心は約1e37 FLOP
Cotra は、機械学習の理論と経験的な考察を組み合わせて、学習データの要件を定めている。短いホライズンに15%、中程度のホライズンに30%、長いホライズンに20%の重みを置き、三つのアンカーで合計65%となる。
ゲノムアンカー
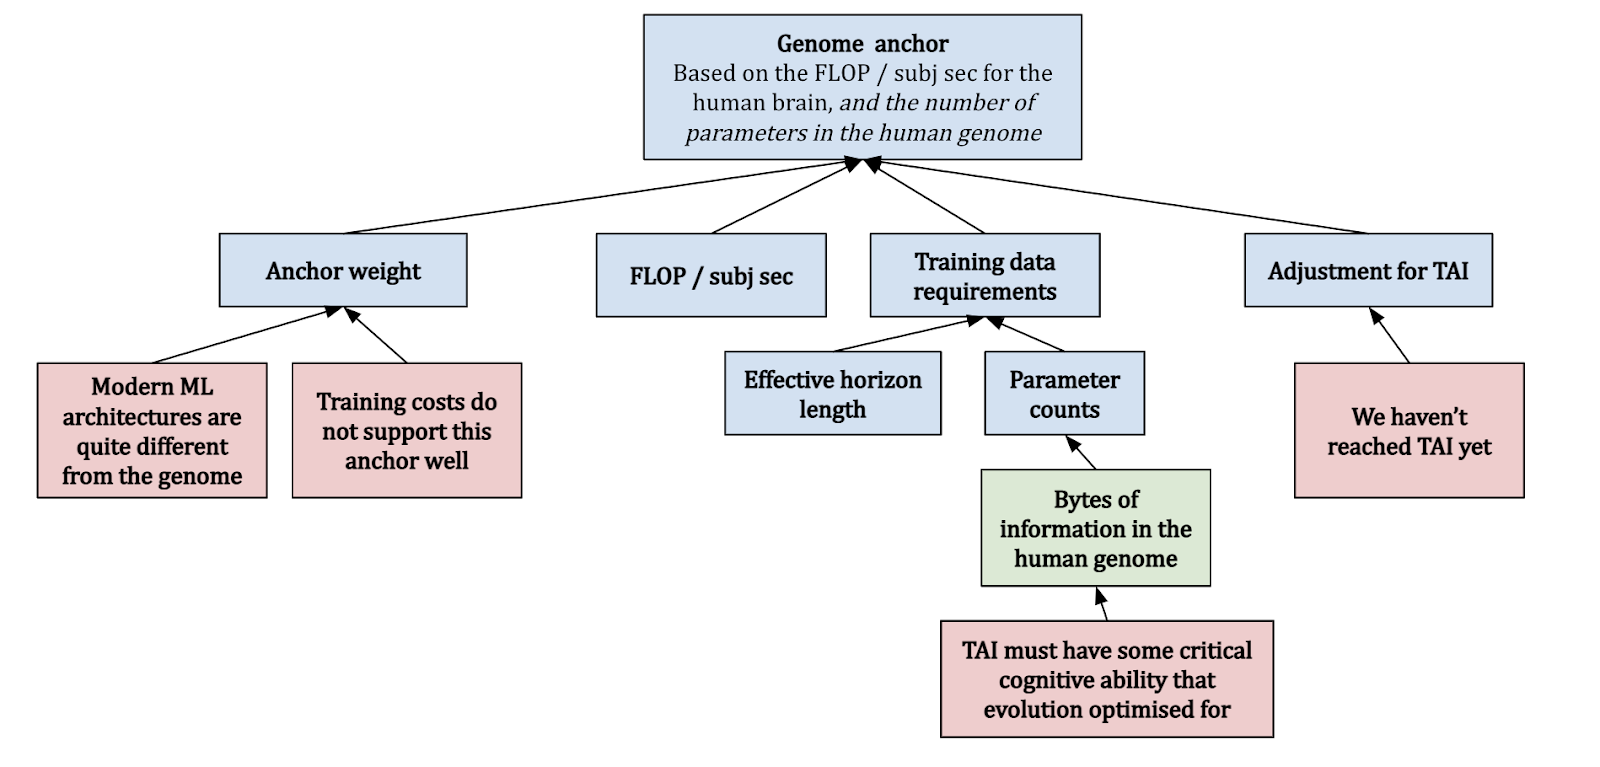
ゲノムアンカーは、人間の脳のFLOP / subj secに注目し、TAIには人間のゲノムのバイト数と同じだけのパラメータが必要になると見込む。この仮説は暗に、学習プロセスが構造的に進化に似ていること12と、進化が最適化してきた何らかの決定的な認知能力をTAIがもつことを仮定している。
少なくとも執筆時点(2022年5月)では、機械学習のアーキテクチャは人間のゲノムにあまり似ておらず、TAIもまだ開発されていない。そこで Cotra は、この仮説について、より多くのFLOPが必要だという方向に見積もりを修正している。全体として、彼女は中央値を約1e33 FLOPとし、このアンカーに10%の重みを置いている。
計算資源の手の届きやすさ
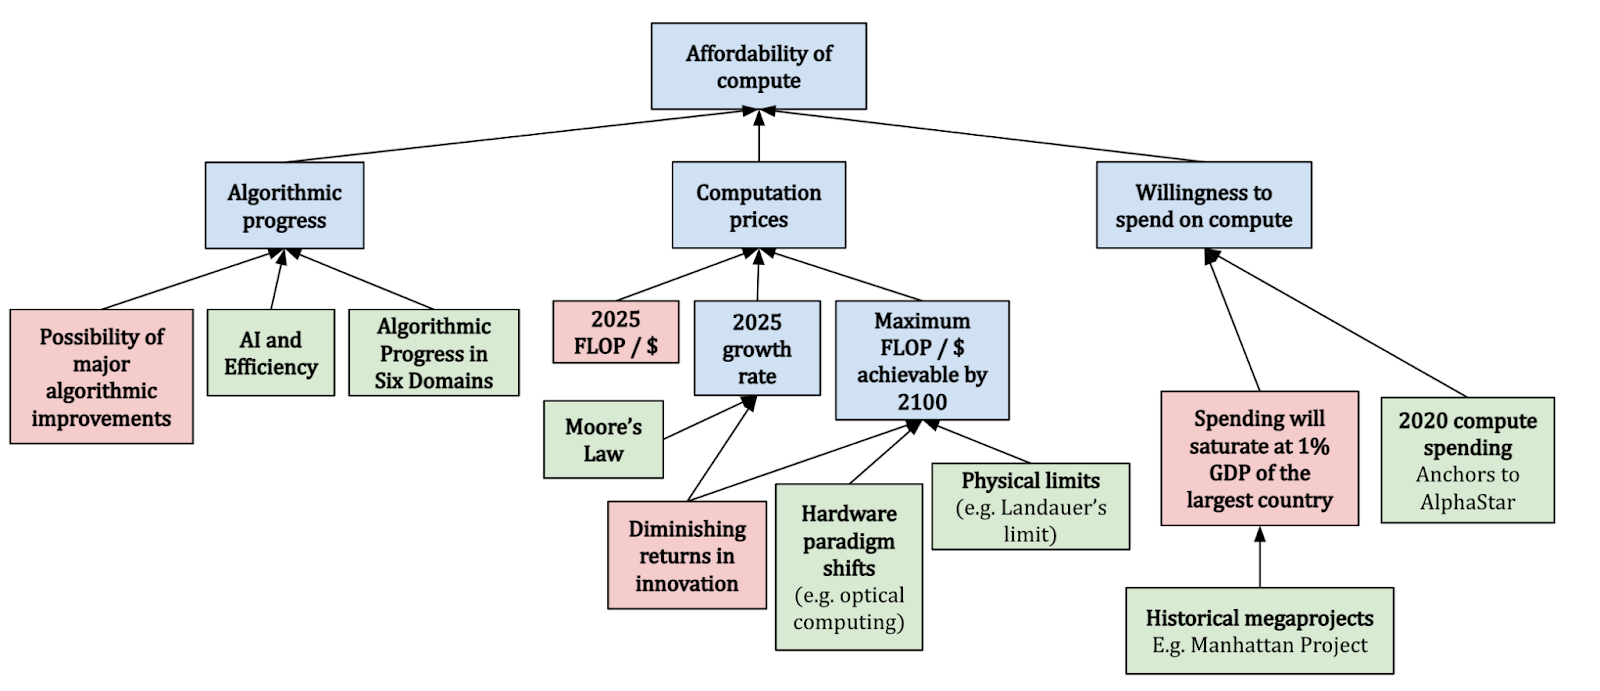
生物学的アンカーを使って、2020年のアルゴリズムとアーキテクチャでTAIを作るのに必要な計算量(FLOP)の分布を求めた後、Cotra は、その計算資源をまかなえるかどうかの確率分布を求める作業に移る。そのために、三つの異なる要因を検討する。
- アルゴリズムの進歩:これについては、AI and Efficiencyの研究に大きく依拠している。この研究によれば、2012年から2018年にかけて、コンピュータビジョンのアルゴリズム効率は44倍に伸びた。彼女は効率が約2〜3年ごとに倍増すると考えるが、進歩の上限は生物学的アンカーの仮説ごとに異なる。
- 計算の価格:時がたつにつれ、同じ価格でより多くの計算資源が手に入るようになると予想される。Cotra はおおむね現在の計算の価格のトレンドをもとに、価格は約2.5年ごとに半減し、さらに6桁下がったところで頭打ちになると見込んでいる。
- お金をかける意欲:Cotra は、巨大プロジェクト(マンハッタン計画など)の過去の事例研究を参照して、機械学習の学習実行にお金をかける意欲は最大の国のGDPの1%が上限であり、2025年以降は倍増期間2年で伸びると仮定している。
彼女がこれらの予測を2025年から2100年について立てているのは、2020年から2025年にかけて機械学習の学習実行に使う計算資源が急速に拡大し、その後は再び減速すると考えているからである。ここでの主な不確実性は、既存のトレンドが数年より先まで続くかどうかである。たとえば、私たち(Epoch AI)は最近、OpenAI のAI and Computeの調査が、計算資源の伸びについて強気すぎる結論を出していたことを見いだした。実のところ、公表の時点で、報告されたトレンドはすでに崩れつつあったという証拠がある。総じて、ここから言えるのは、これらの予測を慎重に解釈すべきだということだと思う。
すべてを組み合わせる:最終的な分布
すべてを組み合わせると、次の分布が得られる。
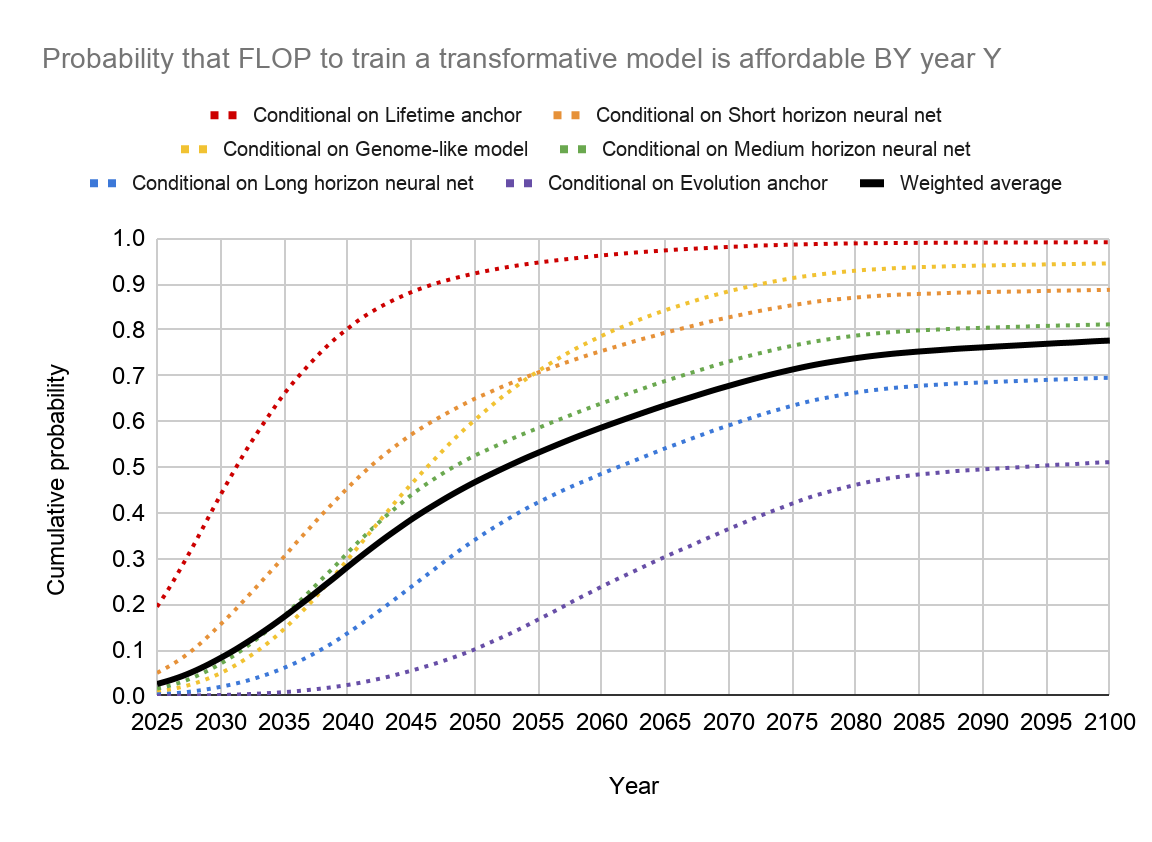
P(2030年より前にTAI) | P(2050年より前にTAI) | P(2100年より前にTAI) |
約8% | 約47% | 約78% |
10% | 50% | 90% |
2031 | 2052 | >2100 |
これらの結果に基づき、Cotra はTAIの実現時期の中央値の推定を2050年とする。推定に過度の精度があるように見せないための切りのよい数字である。これらの結果を見ると、今世紀中にTAIが開発される確率は非常に高い(上の表のとおり約78%)ようである。
もちろん、この研究の前提や手法には疑問を投げかけることもできる。たとえば次のような点である。
- 計算資源は本当にAIの発展を動かす最大の要因なのか。10年先でさえ、これを主なボトルネックと考えるのは本当に妥当なのか。
- 生物学的アンカーを使ってTAIの学習に必要な計算量を決めるという手法は、どれほど妥当なのか13。
- 報告書は、新しいパラダイム(光コンピューティングなど)の可能性や、開発を妨げうる外的な出来事を無視している。それでもこのモデルをどこまで信頼すべきなのか。
Cotra は、不確実性の源はほかにもあるとしつつ、最大の源は実効ホライズン長の適切な値だと述べている。ニューラルネットワーク・アンカーでは、これが1主観秒から1e9主観秒までの幅をとりうる。この点はさらに調べる必要があるという。また彼女は、このモデルが予期しないボトルネック(規制など)のために、到来時期が早い場合のTAIの確率を過大評価し、到来時期が遅い場合の確率を過小評価していると論じている。後者は、研究分野がおそらく、2020年のアルゴリズムとアーキテクチャのスケールアップに基づかない、TAIへの別の道を見つけているだろうからである。
結論
総じて、これはTAIを予測するための具体的な枠組みを作ろうとした最初の本格的な試みの一つであり、実に詳細である。それでも、答えの出ていない問いはまだ山ほど残っている。AI予測の分野が、それほど遠くないうちに答えを見つけてくれることを願っている。
また、これらの図と説明が、報告書が言わんとしていることと、今後どのような研究が興味深いかを大づかみに理解する助けになればと思う。報告書の全文とコードはこちらにあるので、ぜひ目を通してほしい。
図はこちらで操作できる(ボックスは報告書の対応する箇所にリンクしている)。図は Google スライドでかなり不格好に組み立てたものなので、こうした図を作るのに向いた、もっとよいソフトウェアをご存じなら、ぜひ教えてほしい。
注
-
緑のボックスは入力、赤のボックスは仮定または限界、青のボックスは「その他」に分類されるものを表す。 ↩
-
ここで「AI安全性」とは、高度なAIシステムによる地球規模の壊滅的リスクを減らすのに役立つ仕事全般を指しており、AIガバナンスと技術的なAI安全性の両方を含む。 ↩
-
一般には、こうした変革的な影響が単一のモデルによって引き起こされる必要は必ずしもない。ただ、この仮定を置くことは、複数のAIシステムから変革的な影響が生じうる時期の代わりの指標として、それでも適切だと言えるだろう。報告書は「影響」について、世界総生産(GWP)を用いたより厳密な定義も与えているが、私の印象では、仮定の面で重要な役割を果たしているのはTAIの厳密な定義ではなく、生物学的アンカーのほうである。つまり、TAIの定義がいくらか違っていても、同じ生物学的アンカーが使われていただろうと私は思う。 ↩
-
もちろん、物事はそれほど単純ではない。たとえば、ムーアの法則の終わりなどによってトレンドが続かない可能性も考える必要がある。 ↩
-
厳密には六つあるが、今はひとまずお付き合いいただきたい。 ↩
-
報告書で Cotra は次の例を挙げている。「一般的な人間は、技術的でない文章を1秒あたり3〜4語ほど読む。したがって言語モデルにとっての『1主観秒』は、そのモデルが約3〜4語分のデータを処理するのにかかる時間に相当する。人間の脳の1000倍のFLOP/sで動作するモデルが、1秒あたり3000〜4000語を処理するなら、主観秒あたりのFLOPは人間とほぼ同じになる」 ↩
-
ニューラルネットワーク・アンカーは、実際にはどの生物学的プロセスにも対応していないので、別の、おそらくより正確な言い方は、(「人間の脳の学習にはどれだけの計算量が必要だったか」ではなく)「人間の脳と同等のモデルを学習させるには、どれだけの計算量が必要になるか」となるだろう。 ↩
-
たとえば、文を与えられて真か偽かを答えるタスクでは、実効ホライズン長は入力文の長さになるかもしれない。 ↩
-
ここでの目的は、要点を簡潔に要約しつつ、もっと知りたい人のためにリンクを示すことなので、ここではあまり詳細に立ち入らない。 ↩
-
たとえば、Google のPaLMモデルの学習には約2.5e24 FLOPが使われた。それより17桁も小さいのである。 ↩
-
もちろん、この図は、ある種の生物が他の種よりはるかに多くの計算を行うことを考慮していない。それでも、人間の脳の「学習」にどれだけの計算量が必要だったのかについては非常に大きな不確実性がある、という直観はある程度伝わると思う。 ↩
-
これが進化アンカーと異なるのは、勾配を使えば、ありうるアーキテクチャやアルゴリズムを進化よりはるかに効率的に探索できると仮定している点である。この構造的な類似性があり、また特定のゲノム構成の適応度についてのフィードバック信号は一般にまばらなので、このアンカーは長いホライズン長でしか実際には意味をなさないと考えられる。ゲノムアンカーが三つに分かれていないのはこのためである。 ↩
-
私の見るところ、これは Eliezer Yudkowsky が記事Biology-Inspired AGI Timelines: The Trick That Never Worksでとっている観点である。Holden Karnofsky の応答も参照してほしい。 ↩