
レポート
GPUの価格性能比の傾向
原題:Trends in GPU price-performance
有益なフィードバックとコメントをいただいた Alyssa Vance、Ashwin Acharya、Jessica Taylor、および Epoch AI チームに感謝する。
要旨
2006年から2021年までに発売された470機種のGPU(グラフィックス処理装置)のデータセットを用いた結果、1ドルあたりの毎秒浮動小数点演算回数(以下、1ドルあたりFLOP/s)は約2.5年ごとに倍増していることがわかった。各時点の最上位GPUに限ると改善の速度はより遅く(1ドルあたりFLOP/sの倍増期間は2.95年)、一方でML研究によく使われるGPU機種では改善の速度はより速い(倍増期間は2.07年)。GPUの価格性能比の改善は、全体として、ムーアの法則に結びつけられる2年の倍増期間よりやや遅く、フアンの法則が示唆する速度よりはるかに遅いが、GPUの価格性能比の傾向に関する先行研究で概して得られていた値よりはかなり速い。本稿の目的は、より多くの、あるいはより質の高いデータにもとづいて、GPUの価格性能比の傾向をより正確に特徴づけることにある。その特徴づけは、分析に妥当な変更を加えても、従来の調査より揺らぎにくいものを目指す。1

図1. 本データセットのFLOP/sと1ドルあたりFLOP/s、および既存文献の関連する傾向
| 傾向 | 2倍になるまでの期間 | 10倍になるまでの期間 | 成長率 | 指標 |
|---|---|---|---|---|
本データセット | 2.46年 | 8.17年 | 年0.122桁 | 1ドルあたりFLOP/s |
ML用GPU | 2.07年 | 6.86年 | 年0.146桁 | 1ドルあたりFLOP/s |
| 最上位GPU | 2.95年 | 9.81年 | 年0.102桁 | 1ドルあたりFLOP/s |
| 本データのFP16(n=91) | 2.30年 | 7.64年 | 年0.131桁 | 1ドルあたりFLOP/s |
| ムーアの法則 | 2年 | 6.64年 | 年0.151桁 | FLOP/s |
| フアンの法則 | 1.08年 | 3.58年 | 年0.279桁 | FLOP/s |
CPUの歴史的傾向(AI Impacts, 2019) | 2.32年 | 7.7年 | 年0.130桁 | 1ドルあたりFLOP/s |
4.4年 | 14.7年 | 年0.068桁 | 1ドルあたりFLOP/s |
表1. GPUの価格性能比の傾向に関する本稿の結果と、既存文献の関連する傾向のまとめ。角括弧内は95%信頼区間。
はじめに
GPUは機械学習(ML)の処理を高速化するための主要な計算基盤であり、過去5年間の最大級のモデルは、すべてとは言わないまでもほとんどが、GPUか、TPU(テンソル処理装置)のような専用ハードウェアで学習されてきた。基盤となるハードウェアの価格性能比が改善したことで、MLの学習実行の規模は急速に拡大し(Sevilla et al., 2022)、それが近年のAIの進歩を中心となって支えてきた。
GPUの改善速度は、これまでにも分析されてきた。たとえば Su et al., 2017 は、2006年から2017年にかけてGPUのFLOP/sの倍増期間が2.4年であることを見いだした。Sun et al., 2019 は4,000を超えるGPU機種を分析し、1ワットあたりのFLOP/sがおよそ3〜4年ごとに倍増していることを見いだした。一方で、GPUの性能の改善は、CPUのような他のマイクロプロセッサに見られる指数関数的な改善(通常、倍増期間は2〜3年。AI Impacts, 2019 を参照)より速いと推測する人もいる。中でも注目されるのが、NVIDIA の CEO である Jensen Huang が提唱した、いわゆるフアンの法則である。Huang によれば、GPUは「5年ごとに25倍の改善」を遂げる(Mims, 2020)。これは性能の倍増期間に換算すると約1.1年に相当する。
CPUとGPUの価格性能比を具体的に分析した先行研究もある(表1にまとめた)。改善速度に関する従来の推定値は大きくばらついている(たとえば、価格性能比が10倍になるまでの期間は、計算精度によって約6年から約15年まで幅がある。表2を参照)。従来の手法は結果のばらつきが大きく、使うデータセットも小さかったため、私たちは既存の推定値に確信を持てない。2
| 文献 | プロセッサの種類 | 指標 | 2倍になるまでの期間 | 10倍になるまでの期間 | 成長率 |
|---|---|---|---|---|---|
| Bergal, 2019 | GPU | FP32、FP16、FP16融合積和演算での1ドルあたりFLOP/s | 4.4年(FP32) 3.0年(FP16) 1.8年(FP16融合) | 14.7年(FP32) 10.0年(FP16) 6.1年(FP16融合) | 年0.068桁(FP32) 年0.100桁(FP16) 年0.164桁(FP16融合) |
| Median Group, 2018 | GPU | FP32での1ドルあたりFLOP/s | 1.5年 | 5.0年 | 年0.200桁 |
| Muehlhauser and Rieber, 2014 | さまざま | MIPS/$ | 1.6年 | 5.2年 | 年0.192桁 |
| Sandberg and Bostrom, 2008 | CPUベース | MIPS/$ と1ドルあたりFLOP/s | 1.7年(MIPS) 2.3(FLOP/s) | 5.6年(MIPS) 7.7年(FLOP/s) | 年0.179桁(MIPS) 年0.130桁(FLOP/s) |
| Nordhaus, 2001 | CPUベース | MIPS/$ | 1.6年 | 5.3年 | 年0.189桁 |
表2. 先行研究で得られた価格性能比の改善。従来の推定値のより詳しい概観は AI Impacts 2015 も参照。
本稿は、主に次の3点で既存の研究を拡張することを目指す。
- 従来の調査で分析されたものより大きく、より新しいGPU機種も含むデータセットを用いて、GPUの価格性能比の改善速度について、現在あるものより正確な推定値を出す3
- 最高性能のGPUや、機械学習によく使われるGPUの価格性能比の傾向など、GPUの価格性能比の改善に関する主要な部分傾向をいくつか分析する
- 得られた傾向を、従来の推定値、ムーアの法則、フアンの法則、先行分析、GPUの性能に関する公の予測と比べ、その位置づけを示す
データセット
GPUの価格性能比に関する既存の2つのデータセットを組み合わせた。1つは Median Group によるもので、Nvidia と AMD のGPU 223機種のデータを含む(Median Group, 2018)。もう1つは Sun et al., 2019 によるもので、Nvidia、Intel、AMD が発売したGPU 413機種の価格性能比のデータを含む。
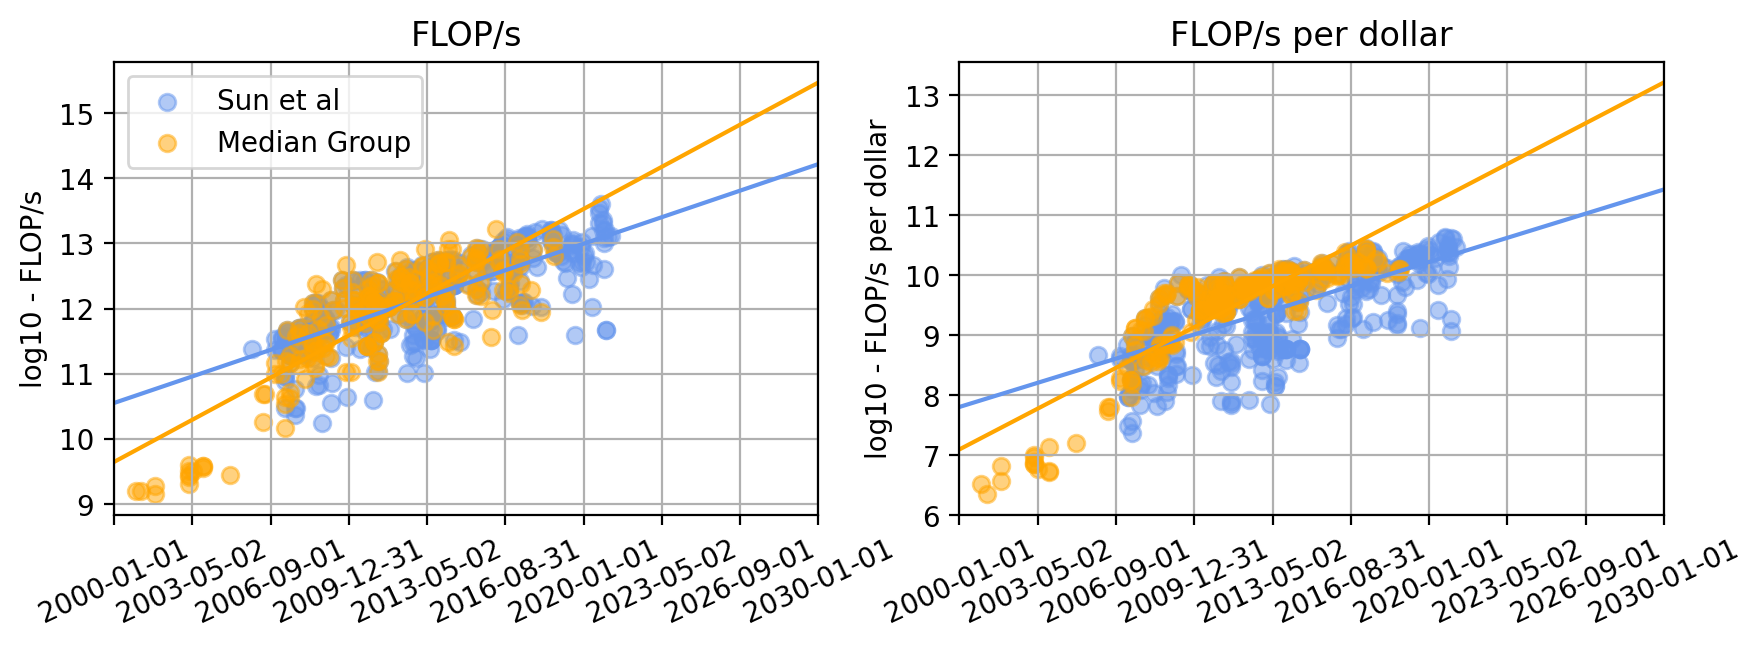
図2. Median Group と Sun et al., 2019 のデータセットにおけるFLOP/sと1ドルあたりFLOP/s
2つのデータセットを統合し、重複する観測値、つまり両方のデータセットに含まれていたGPU機種を取り除いた。さらに、同じ製品の別バージョンは、仕様が異なる場合を除いて取り除いた。4
また、2006年より前の観測値は、主に2つの理由から除外することにした。1) これらの機種はGPUでの汎用計算を可能にした技術革新より前のものであり、その性能水準を意味のある形で比較できるかどうかがはっきりしない。2) 各機種のデータシートで関連する性能の詳細を調べ、データの正確さを検証できなかった。より詳しい議論は付録Aを参照してほしい。
最後に、20機種のGPUからなる一群で、16ビットの性能が32ビット形式での性能の約60分の1しかないことに気づいた。他のすべてのGPUでは、16ビットの性能は少なくとも32ビットの性能と同等である。これらの16ビット性能の数値は誤りだった可能性があると考え、除外した。
こうして最終的なデータセットには、2006年から2021年までに発売された AMD、Intel、Nvidia のGPU 470機種が含まれる。以下、この統合したデータセットを「本データセット」と呼ぶ。本稿を通じて、FLOP/sは32ビット(単精度)でのものを指す。
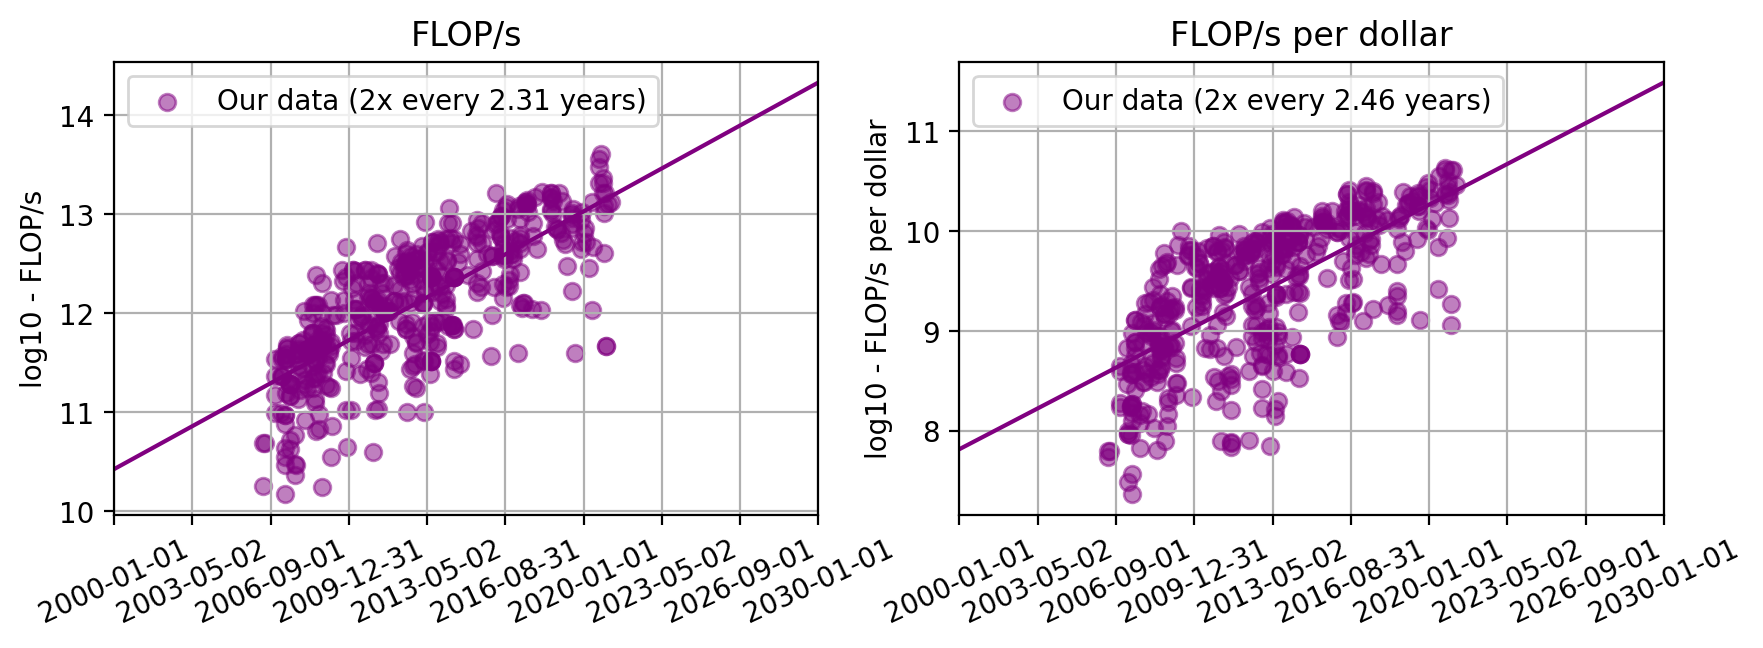
図3. 分析に用いたデータセットのFLOP/sと1ドルあたりFLOP/s
実証分析
以下では、本データセットのGPUについて、1ドルあたりFLOP/sで測った価格性能比と、FLOP/sで測った性能そのものの傾向を分析する。分析では、ML研究によく使われるGPUや最高性能のGPUなど、主要な部分集合も扱う。5
実証的な傾向と他の予測との比較
結果を位置づけるため、他所で提案されているGPUの(価格)性能の傾向と比較する。比較対象は次のとおりである。
- ムーアの法則。トランジスタ密度が2年ごとに倍増したというもの。比較のため、これをFLOP/sも2年ごとに倍増するという意味に解釈する
- フアンの法則。GPUの性能改善の速度を述べたもの。フアンの法則にはいくつかの解釈があるが、Huang 本人の元の言い回し、つまり「5年ごとに25倍の改善」を反映した解釈を選んだ
- CPUの価格性能比の歴史的傾向。1940年以降、7.7年ごとに10倍になってきたことがわかっている(AI Impacts, 2019)
- Cotra 2020 による予測。機械学習の学習実行に関わる計算資源の価格性能比の倍増期間を2.5年とするもの6
- Bergal, 2019 が得た、GPUの価格性能比の改善速度の従来の推定値
これらの傾向の中には、1ドルあたりFLOP/sとそのまま比較できるとは言いにくいものもあることは承知している(ムーアの法則は回路の密度に関するもので、フアンの法則は理論性能の改善に関するもの、Cotra 2020 の予測は1ドルあたりのFLOPに関するものである7)。これらと比較するのは、推定した傾向が関連する実証的な傾向や予測とどう関係するかを、大まかにつかむためにすぎない。
特に断らない限り、1ドルあたりFLOP/sの結果を示す。理由は、a) 先に論じたとおり、1ドルあたりFLOP/sのほうが重要な傾向だと考えるから、そして b) FLOP/sと1ドルあたりFLOP/sの傾向にはそれほど大きな違いがないからである。詳しい比較は付録Bを参照してほしい。
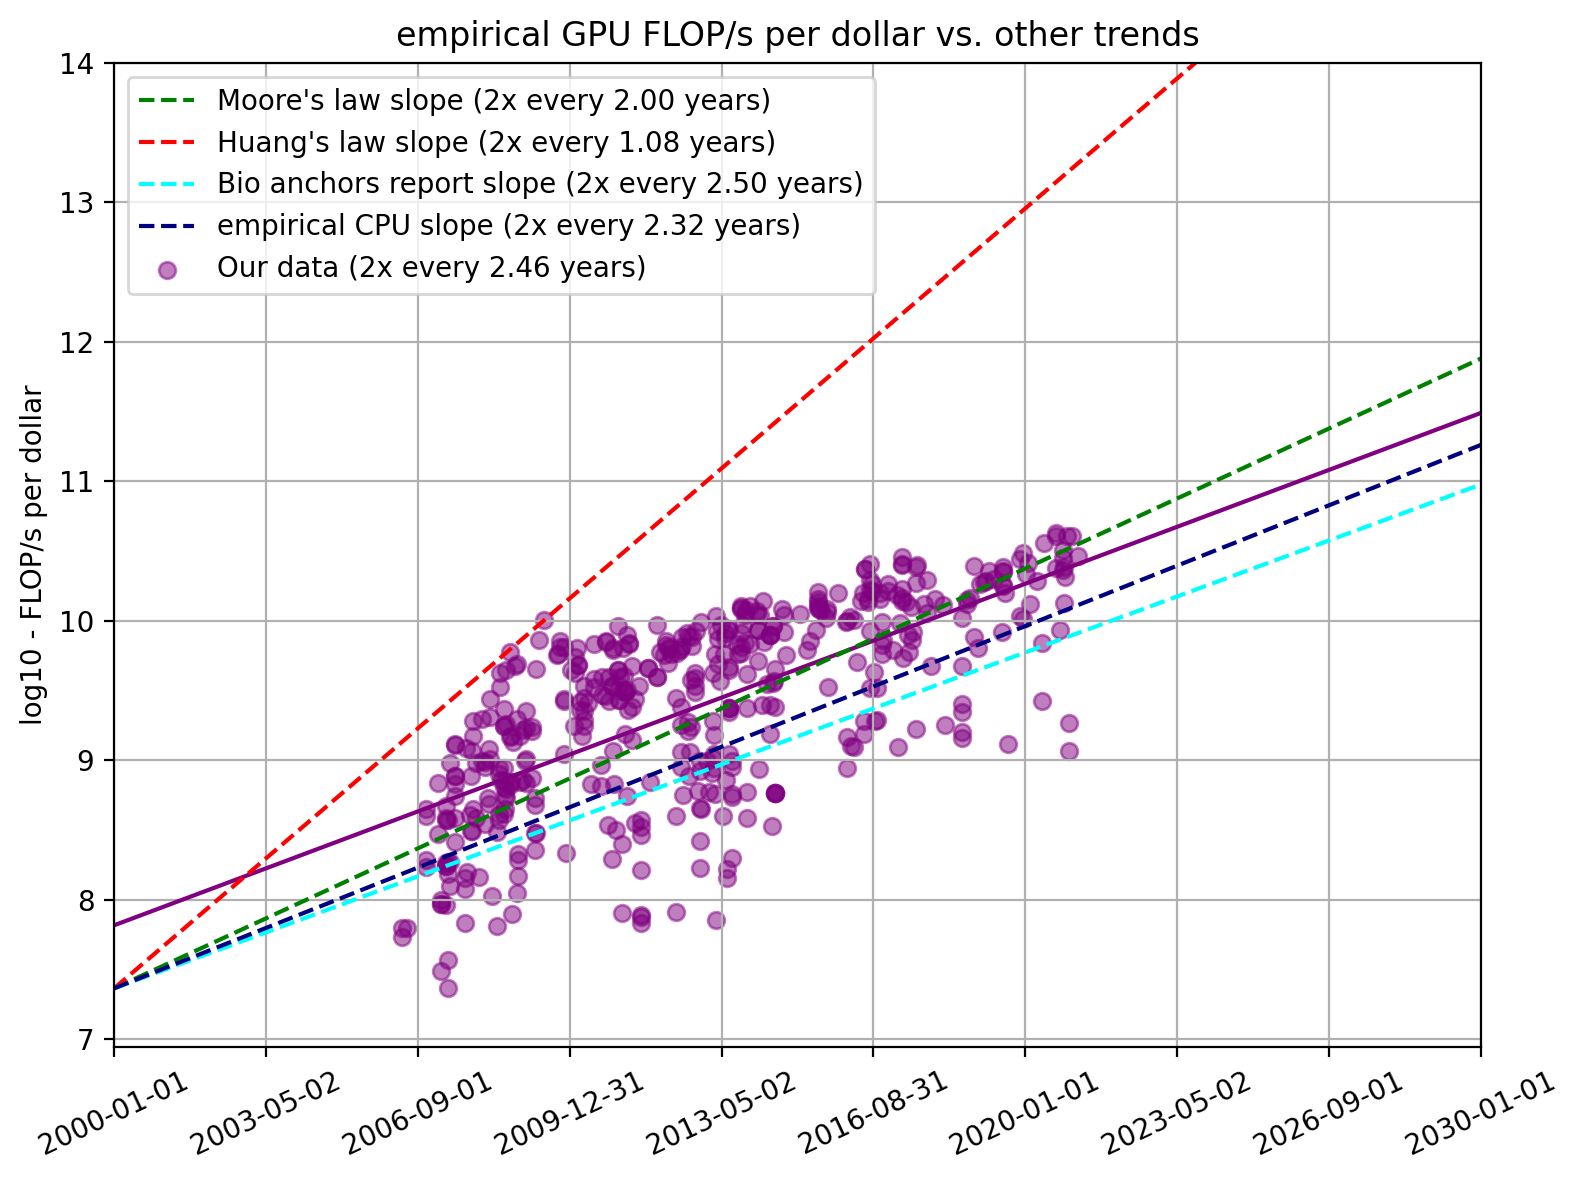
図4. 本データセットの1ドルあたりFLOP/sと、他所で得られた関連する傾向
全データに線形回帰を当てはめると、倍増期間は2.46年(95%信頼区間:2.24〜2.72年)となった。これは Cotra 2020 で使われた2.5という傾きとよく一致する。また、フアンの法則は傾向全体にはよく当てはまらず、大幅に過大であることもわかる。
浮動小数点形式の精度ごとの傾向
現在、深層学習では半精度計算(FP16)や混合精度計算(通常はFP16とFP32)がよく使われている。本データセットには、価格とFP16性能の両方の数値がわかるGPUが91機種あった。8
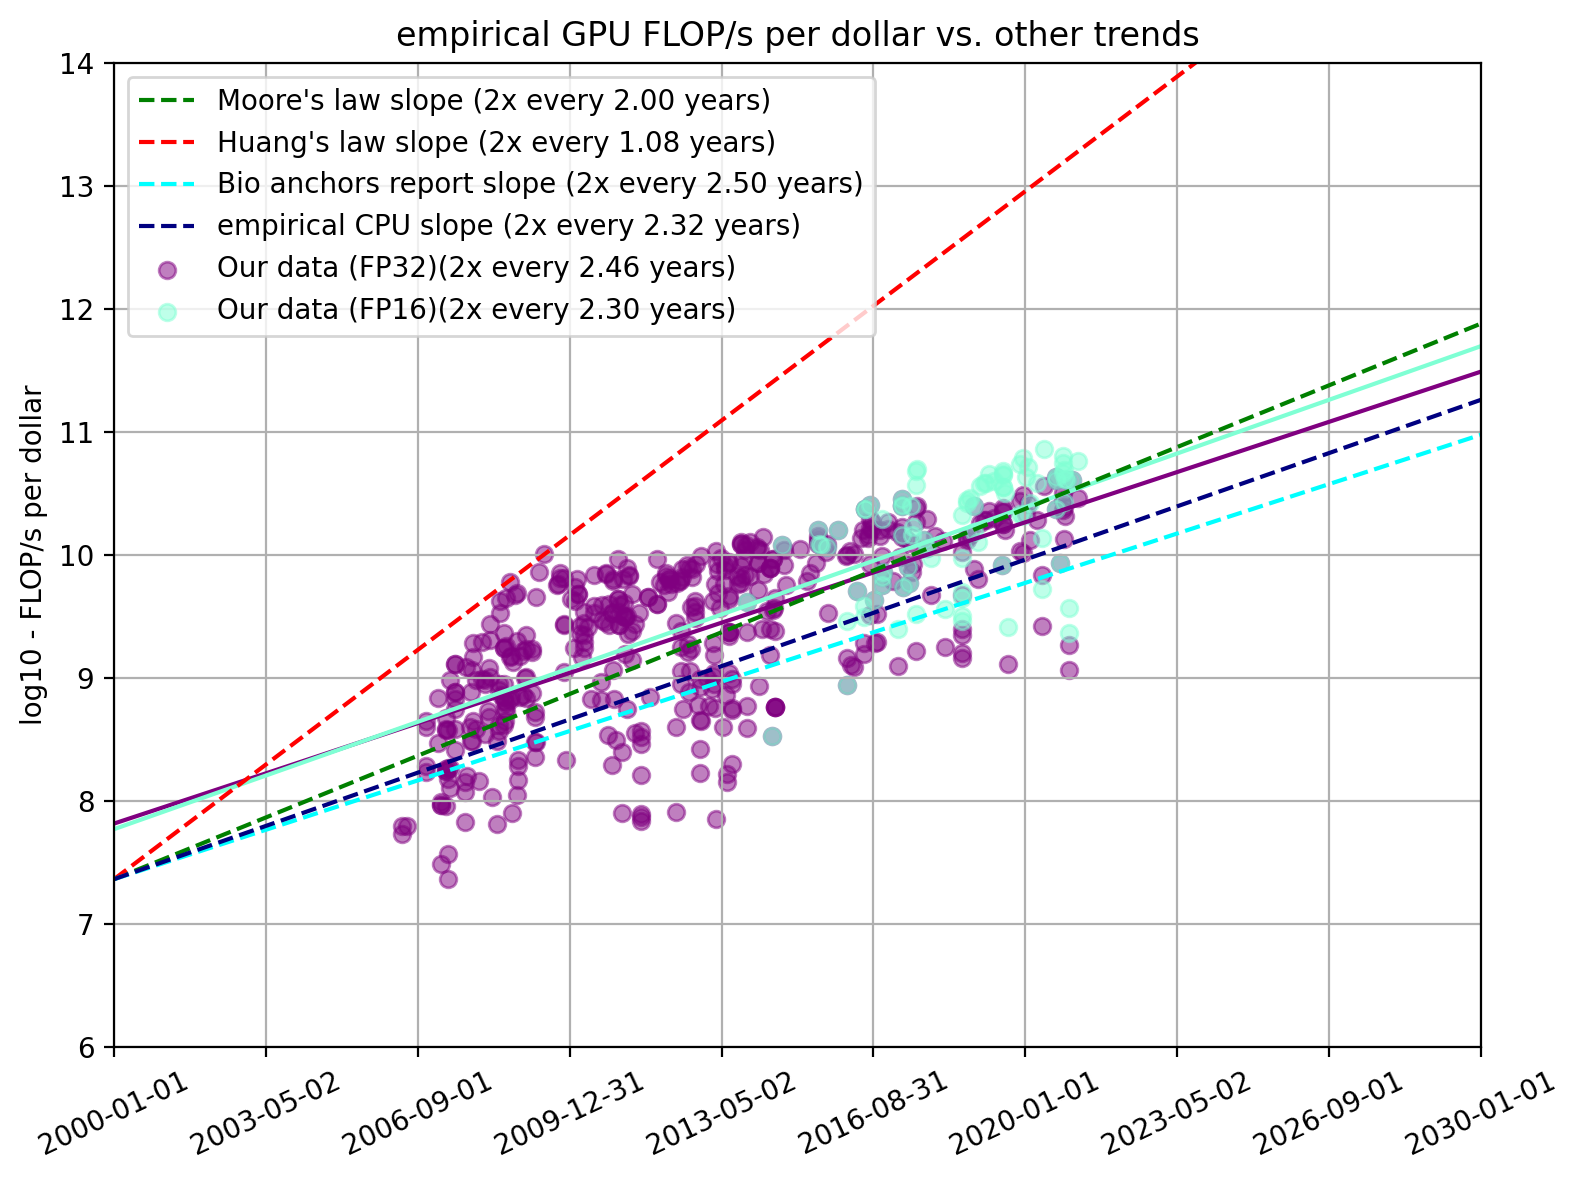
図5. FP32とFP16の性能での1ドルあたりFLOP/s
FP16での価格性能比の倍増期間は2.32年(95%信頼区間:1.69年、3.62年)だった。これはFP32での価格性能比の倍増期間の傾きと有意な差がないので、FP16とFP32の価格性能比の改善はおそらく同程度だと考えられる。これは、FP16の積和演算(FMA)で倍増期間を1.8年とした Bergal, 2019 の結果とは対照的である。9 2つの傾向に統計的に有意な差は見られないため、以下ではFP32での価格性能比を中心に扱い、データが最も多くそろっている機種を分析する。
MLに使われるGPUの傾向
MLの学習の大部分は、ごく少数のGPU機種で行われている。画期的なMLモデルを提示した75本の論文を調べた以前の論文から、MLシステムの学習によく使われる計42種のGPU機種を集めた。この42機種のうち、計26機種が本GPUデータセットに含まれていた。
MLに使われるGPUの価格性能比は、一般的なGPUより速く改善していることがわかった。ML用GPUの1ドルあたりFLOP/sは2.07年ごと(95%信頼区間:1.54〜3.13年)に倍増しており、全GPUの2.46年と比べて短い。ただし、これは全GPUの価格性能比の倍増期間の傾きと有意な差はない。

図6. 本データセット全体と、ML研究によく使われるGPU機種それぞれの1ドルあたりFLOP/sを、他所で得られた関連する傾向と比較したもの
さらに、最新のML用GPUは価格性能比の高いGPUの中に入る傾向があるのに対し、古いものはむしろ中位にある。
そのうえ、FLOP/sの観点から見ると、最新のML実験が最も強力なGPUを使っていることがさらにはっきりする。これは、現代のMLにとってGPUの重要性が増していることを示していると私たちは考える。ここでも、ML用GPUは全体の傾向より急な傾きを示す(倍増期間は2.00年で、全GPUの2.31年より短い)。
ML研究に使われるGPUで性能改善速度の点推定値が高いのは、関連する研究所が時間とともに、最上位のGPUの調達により多くの資源を費やすようになったことで説明できるかもしれない。もしそうなら、これは関連する研究所の投資判断が変わったことを反映しているにすぎず、ML処理に適したGPUで基盤となるハードウェアが通常より速く改善していることを意味するわけではない。このことと、GPU全体についての推定値と統計的に有意な差がないことから、基盤となるハードウェアの価格性能比の改善速度の推定値としては、約2.5年という倍増期間のほうが信頼できると私たちは考える。
最高性能のGPUの傾向
前節で見たように、最新のMLモデルは最先端のGPUで学習される傾向がある。したがって、最高性能のGPUの傾向を見ることは、将来のMLの能力を占うよい指標になるかもしれない。ただし、これはGPUの性能が線形に伸びると私たちが考えていることを意味しない。このデータにもとづく予測についての詳しい考えは、続編で公開する予定である。
ここでは、各月で1ドルあたりFLOP/sが最も高かったGPUを部分集合として選ぶ。この機種群では倍増期間は2.95年(95%信頼区間:2.54〜3.52年)となり、一般的な倍増期間より統計的に有意に長い。
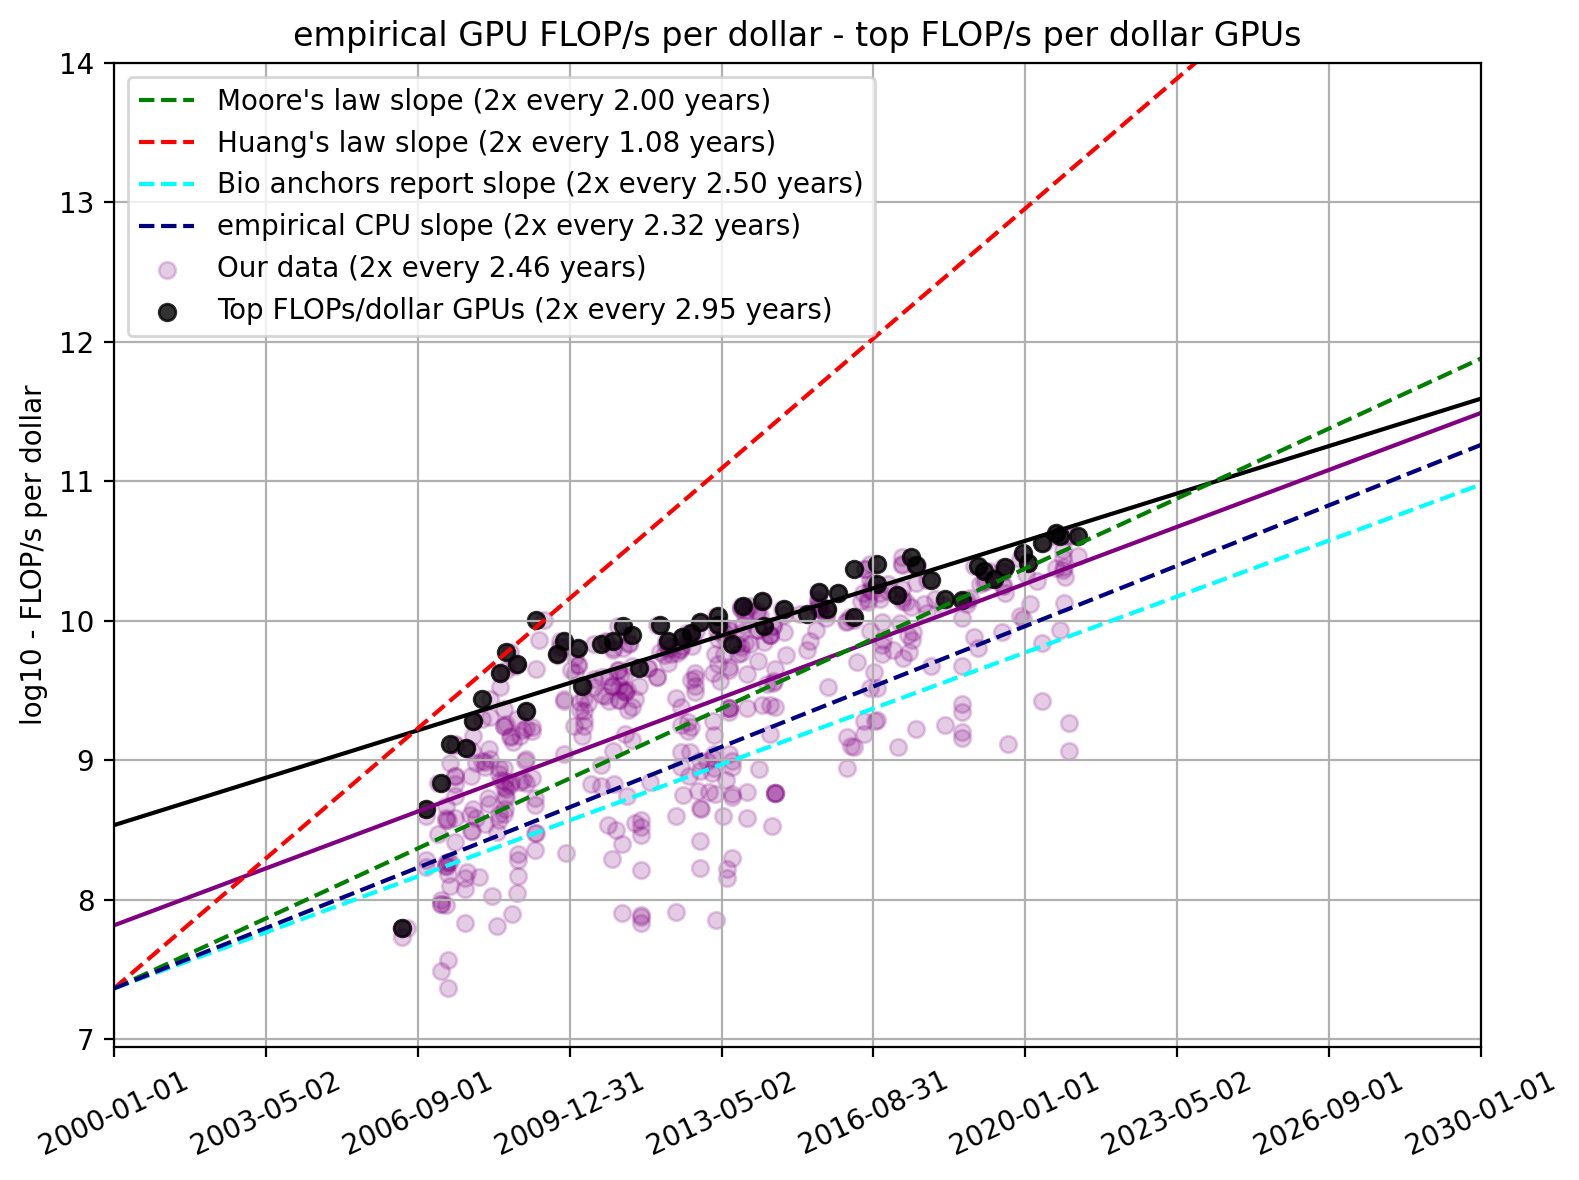
図7. 本データセット全体と、最高性能のGPUそれぞれの1ドルあたりFLOP/sを、他所で得られた関連する傾向と比較したもの
すべての傾向(表と図)
上で取り上げた傾向と付録に載せた傾向をすべて比較するため、それらを一覧にまとめ、それぞれについて2倍、10倍になるまでの期間を示す。
| 傾向 | 元の表現 | 2倍になるまでの期間 | 10倍になるまでの期間 | 成長率 | 指標 |
|---|---|---|---|---|---|
| ムーアの法則 | 2年ごとに2倍 | 2年 | 6.64年 | 年0.151桁 | FLOP/s |
| フアンの法則 | 5年ごとに25倍 | 1.08年 | 3.58年 | 年0.279桁 | FLOP/s |
| 生物学的アンカー報告書(Cotra, 2020) | 2.5年ごとに2倍 | 2.5年 | 8.30年 | 年0.120桁 | 1ドルあたりFLOP/s |
| CPUの歴史的傾向(AI Impacts, 2019) | 7.7年ごとに10倍 | 2.32年 | 7.7年 | 年0.130桁 | 1ドルあたりFLOP/s |
| Median Group, 2018 | 1.5年ごとに2倍 | 1.5年 | 5.0年 | 年0.200桁 | 1ドルあたりFLOP/s |
| 本データ(n=470) | - | 2.46年 [2.24, 2.72] | 8.17年 [7.45, 9.04] | 年0.122桁 [0.134, 0.111] | 1ドルあたりFLOP/s |
| 本データ(n=470) | - | 2.31年 [2.14, 2.51] | 7.68年 [7.12, 8.33] | 年0.130桁 [0.140, 0.120] | FLOP/s |
| 本データのFP16(n=91) | - | 2.30年 [1.69, 3.62] | 7.64年 [5.60, 12.03] | 年0.131桁 [0.179, 0.083] | 1ドルあたりFLOP/s |
| 本データのFP16(n=91) | - | 2.91年 [1.94, 5.83] | 9.68年 [6.45, 19.35] | 年0.103桁 [0.155, 0.052] | FLOP/s |
| ML用GPU(n=26) | - | 2.07年 [1.54, 3.13] | 6.86年 [5.12, 10.39] | 年0.146桁 [0.195, 0.096] | 1ドルあたりFLOP/s |
| ML用GPU(n=26) | - | 2.00年 [1.69, 2.43] | 6.63年 [5.63, 8.07] | 年0.151桁 [0.178, 0.124] | FLOP/s |
| 最上位GPU(n=57) | - | 2.95年 [2.54, 3.52] | 9.81年 [8.45, 11.71] | 年0.102桁 [0.118, 0.085] | 1ドルあたりFLOP/s |
| 最上位GPU(n=57) | - | 2.69年 [2.40, 3.30] | 8.92年 [7.99, 10.95] | 年0.112桁 [0.125, 0.091] | FLOP/s |
表3. GPUの価格性能比の傾向に関する本稿の結果と、既存文献の関連する傾向のまとめ。角括弧内は95%信頼区間。
図8. 本データセットとさまざまな部分集合の1ドルあたりFLOP/sを、他所で得られた関連する傾向と比較したもの
結論
全データの傾向では倍増期間は2.46年、ML用GPUの傾向では2.07年、各月の最上位GPUの傾向では2.95となった。データから見て、倍増期間が2年未満や3年超である可能性は低いと考える。さらに、ML用GPUの傾向の一部は、実際のハードウェアの進歩ではなく、MLがより優れたGPUを優先して使うことで説明できると考える。したがって、2年という倍増期間は強気すぎ、過去15年間のGPUの価格性能比の倍増期間は約2.5年とするのが正確だと私たちは考える。
付録A:2006年より前のデータの除外
総合的に見て、データを残す論拠は、除外する論拠より弱いと判断した。要するに、2006年より前のデータが比較可能な方法で測られているのかどうか、そもそも2006年より前のGPUを2006年以降のGPUと本当に比較できるのかどうかが、非常にはっきりしないのである。
2006年より前のデータを含める論拠:
- Median Group がデータを提供しており、何らかの方法でFLOP/sの推定値を入手している
2006年より前のデータを含めない論拠:
- グラフで見ると、データがどうも怪しい
- Alyssa Vance がコメントで指摘したように、汎用GPUは2005年まで開発されておらず、CUDAは2007年まで存在しなかった。つまり、今日話題にしているGPUとはほとんど関係のない、まったく別物のGPUを扱っていることになる。
2006年より前のGPUの大半では、「理論性能」の値が入手できない。したがって、このデータが最初にどのように集められたのかがはっきりしない。
2006年より前のGPUの一覧:
- GeForce 2 GTS Pro(FLOP/sの記載なし)
- GeForce 3(FLOP/sの記載なし)
- GeForce 3 Ti500(FLOP/sの記載なし)
- GeForce 3 Ti200(FLOP/sの記載なし)
- GeForce FX 5200(FLOP/sの記載なし)
- GeForce FX 5200 Ultra(FLOP/sの記載なし)
- GeForce FX 5600 Ultra(FLOP/sの記載なし)
- GeForce FX 5800(FLOP/sの記載なし)
- GeForce FX 5800 Ultra(FLOP/sの記載なし)
- GeForce FX 5900 / 5900 XT / 5900 ZT(FLOP/sの記載なし)
- GeForce FX 5700 Ultra(FLOP/sの記載なし)
- GeForce FX 5950 Ultra(FLOP/sの記載なし)
- GeForce FX 5900 Ultra(FLOP/sの記載なし)
- GeForce 6200 TurboCache 64-TC/256MB(FLOP/sの記載なし)
- ATI Xbox 360 GPU 90nm(FLOP/sの記載あり)
2006年以降は、GPU機種の仕様欄にFP32のFLOP/s性能が載っているようである。いくつか例を挙げる。
- GeForce 7900 GX2(2006年、FLOP/sの記載なし)
- GeForce 8800 GTX(2006年、FLOP/sの記載あり)
- GeForce 8800 GTS 640(2006年、FLOP/sの記載あり)
- GeForce 8600 GT(2007年、FLOP/sの記載あり)
- GeForce 8500 GT(2007年、FLOP/sの記載あり)
- Radeon HD 2900 XT(2007年、FLOP/sの記載あり)
- 以降も同様
付録B:FLOP/sによる頑健性の確認
本データセットでは、性能と価格に関心があるため、FLOP/sと価格の両方の情報があるGPUだけを扱っている。しかし、性能の情報があるGPUは、性能と価格の両方がわかるGPUよりはるかに多い。FLOP/sのデータがあるデータ点は1848件ある。選択効果がないことを確かめるため、「FLOP/sだけ」のデータからも傾向を分析した。
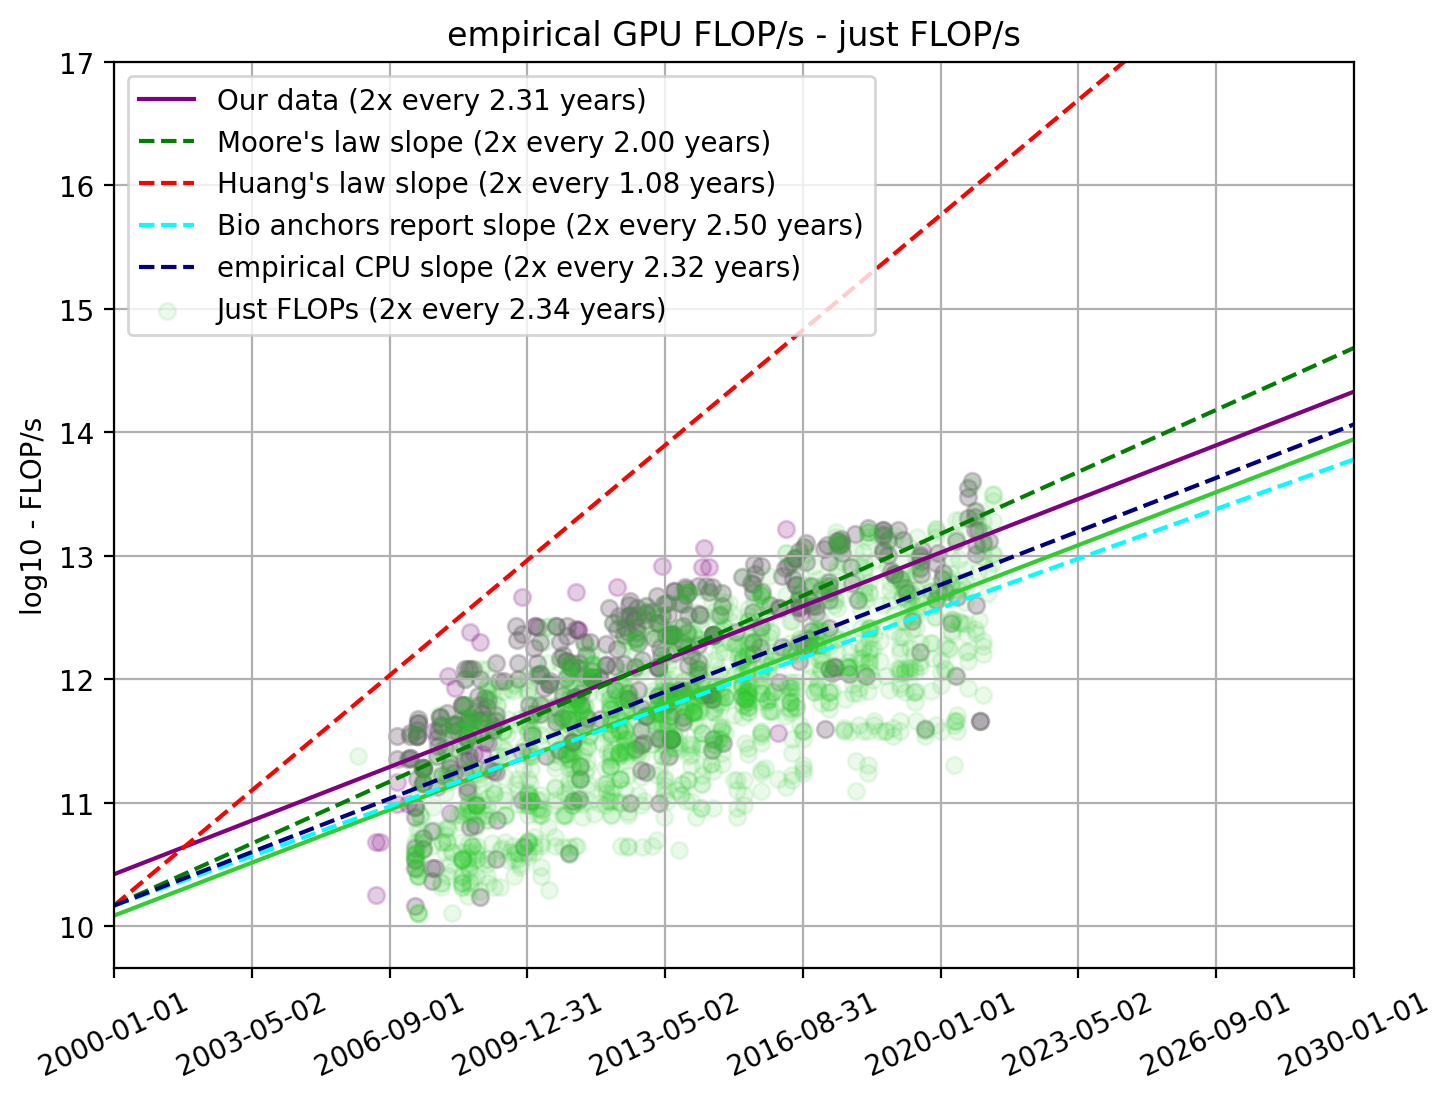
図9. FLOP/sの情報があるすべてのGPUを用いた実測のFLOP/s
その結果は、先の選択で見たものとほぼ完全に一致した。したがって、先の結果を捨てる理由はないと暫定的に結論する。さらに、価格データのあるGPUは、FLOP/sの値が高いものである傾向も見られた。より強力なGPUほどよく使われるので、価格情報も手に入りやすいのだろうと推測している。
FLOP/sのその他のグラフ
本稿で使ったすべてのグラフには、FLOP/sの情報だけを見たバージョンもある。ただし、これは前節の「FLOP/sだけ」のデータではない。本文で使ったのと同じデータセットを、価格で割らずに使ったものである。
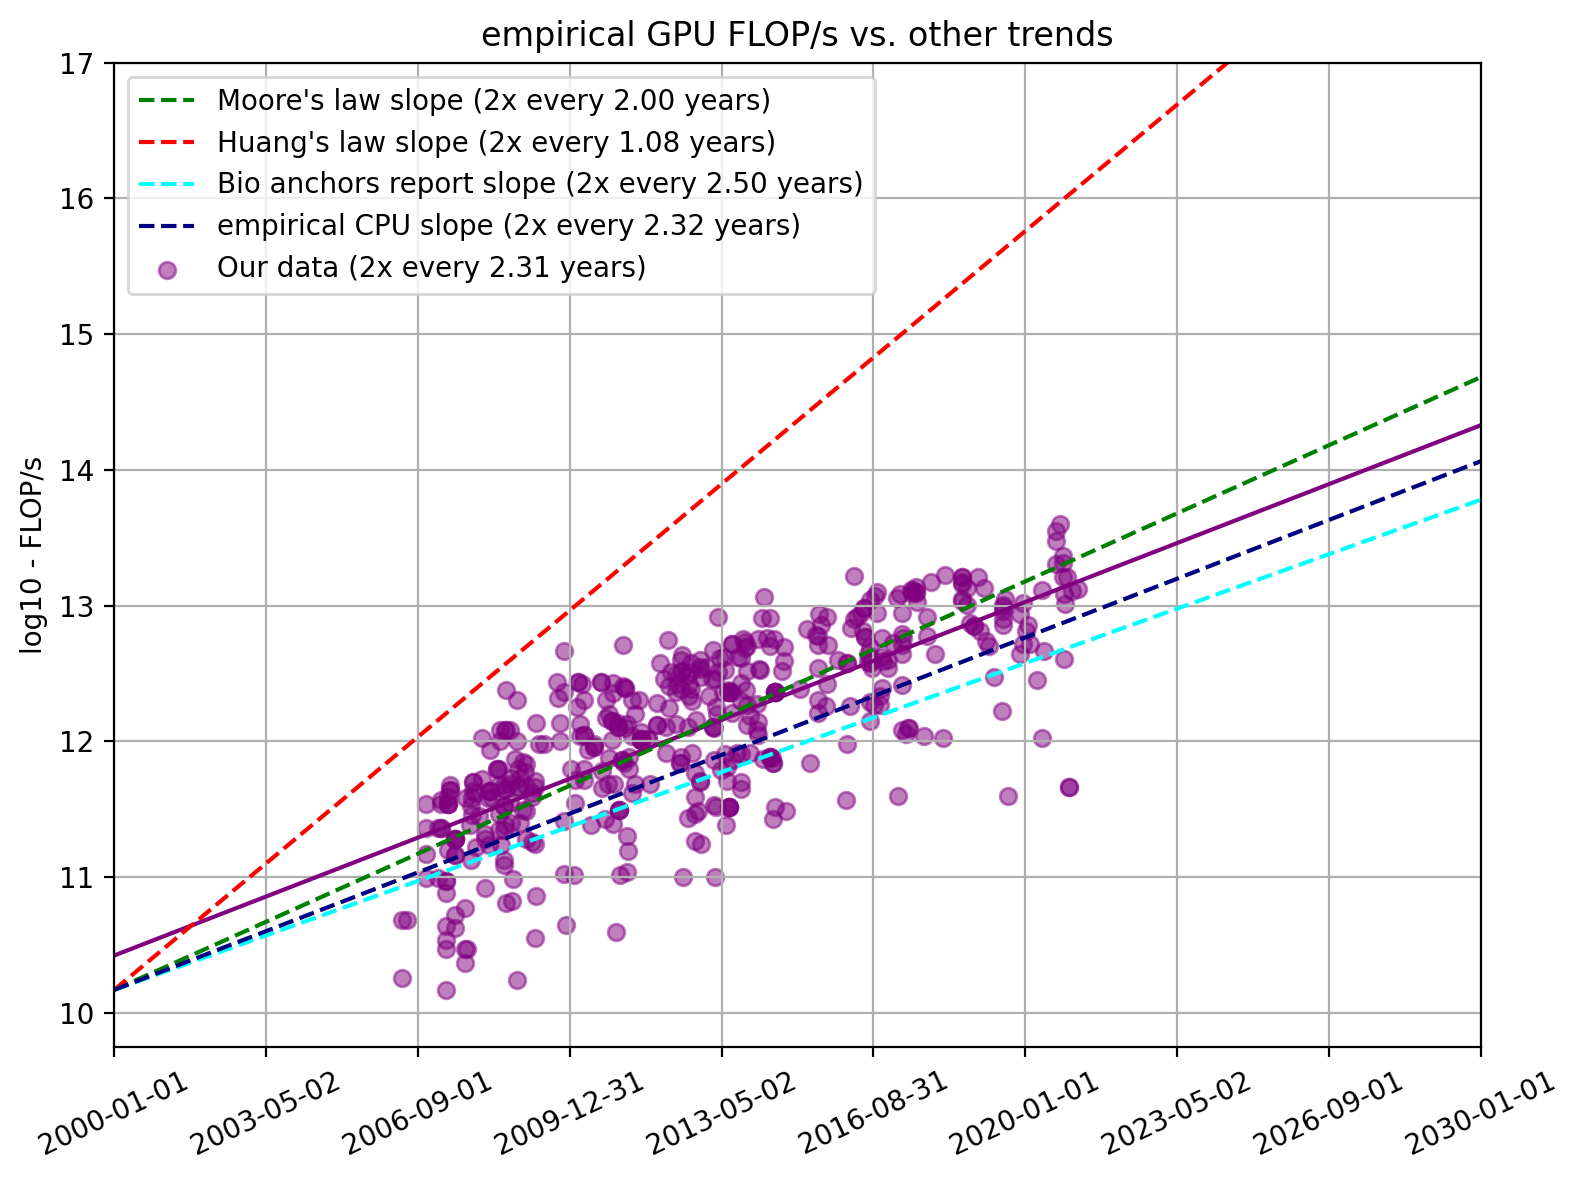
図10. 本データセットの実測FLOP/s
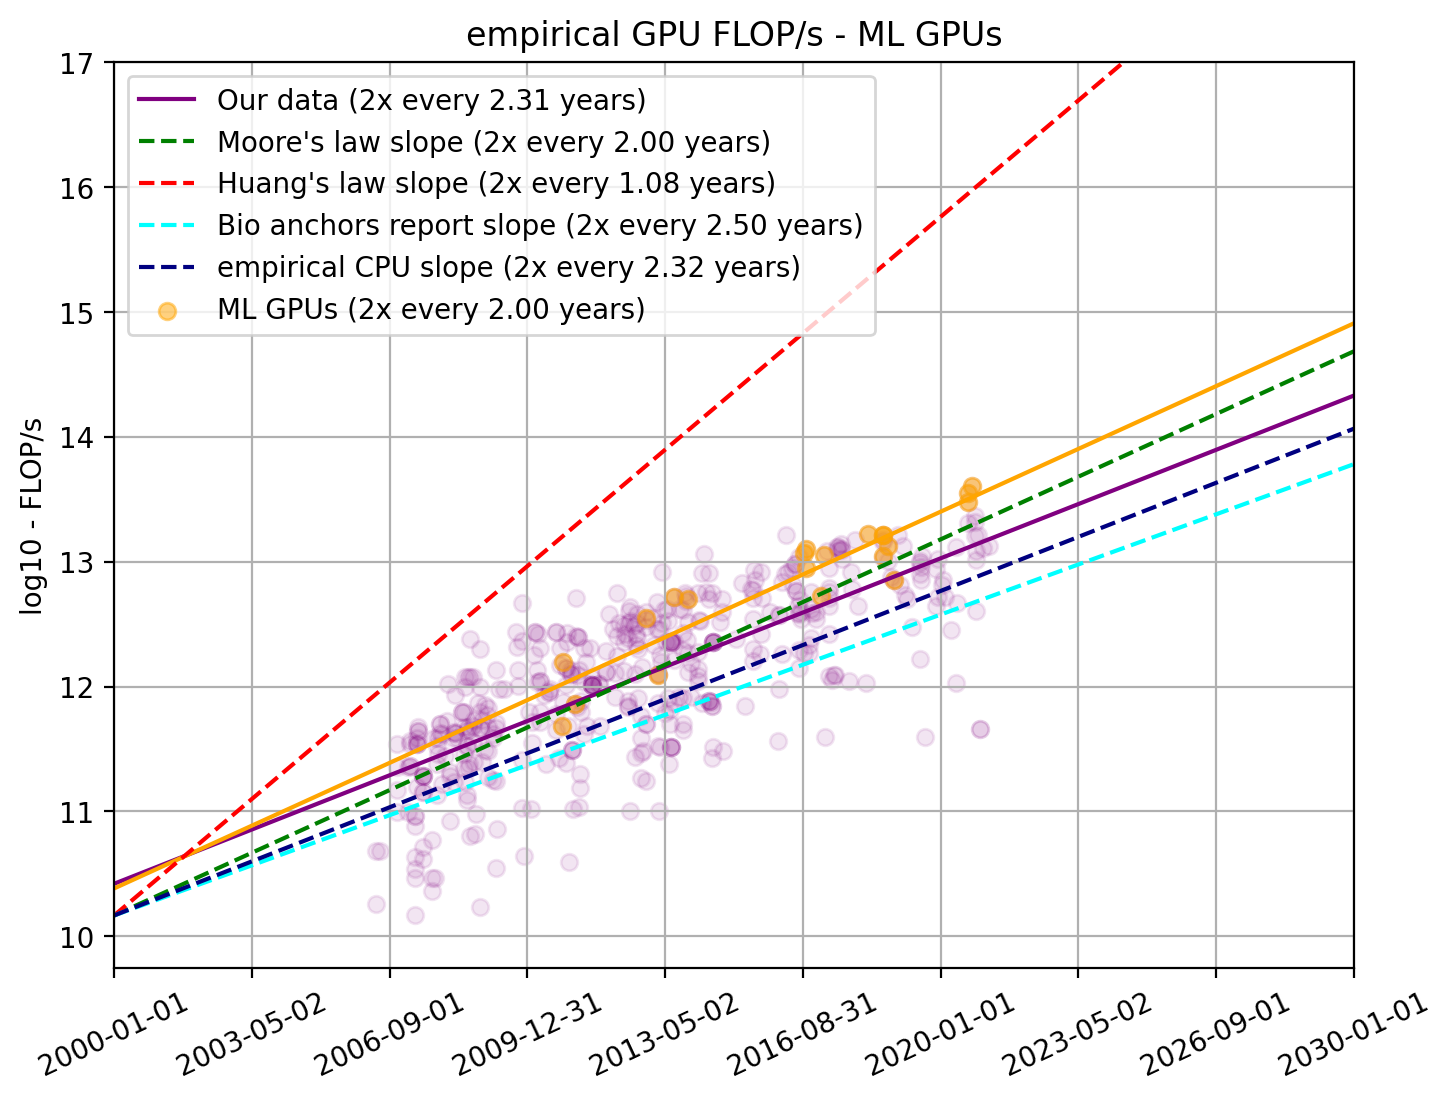
図11. 本データセットとML用GPUの部分集合の実測FLOP/s
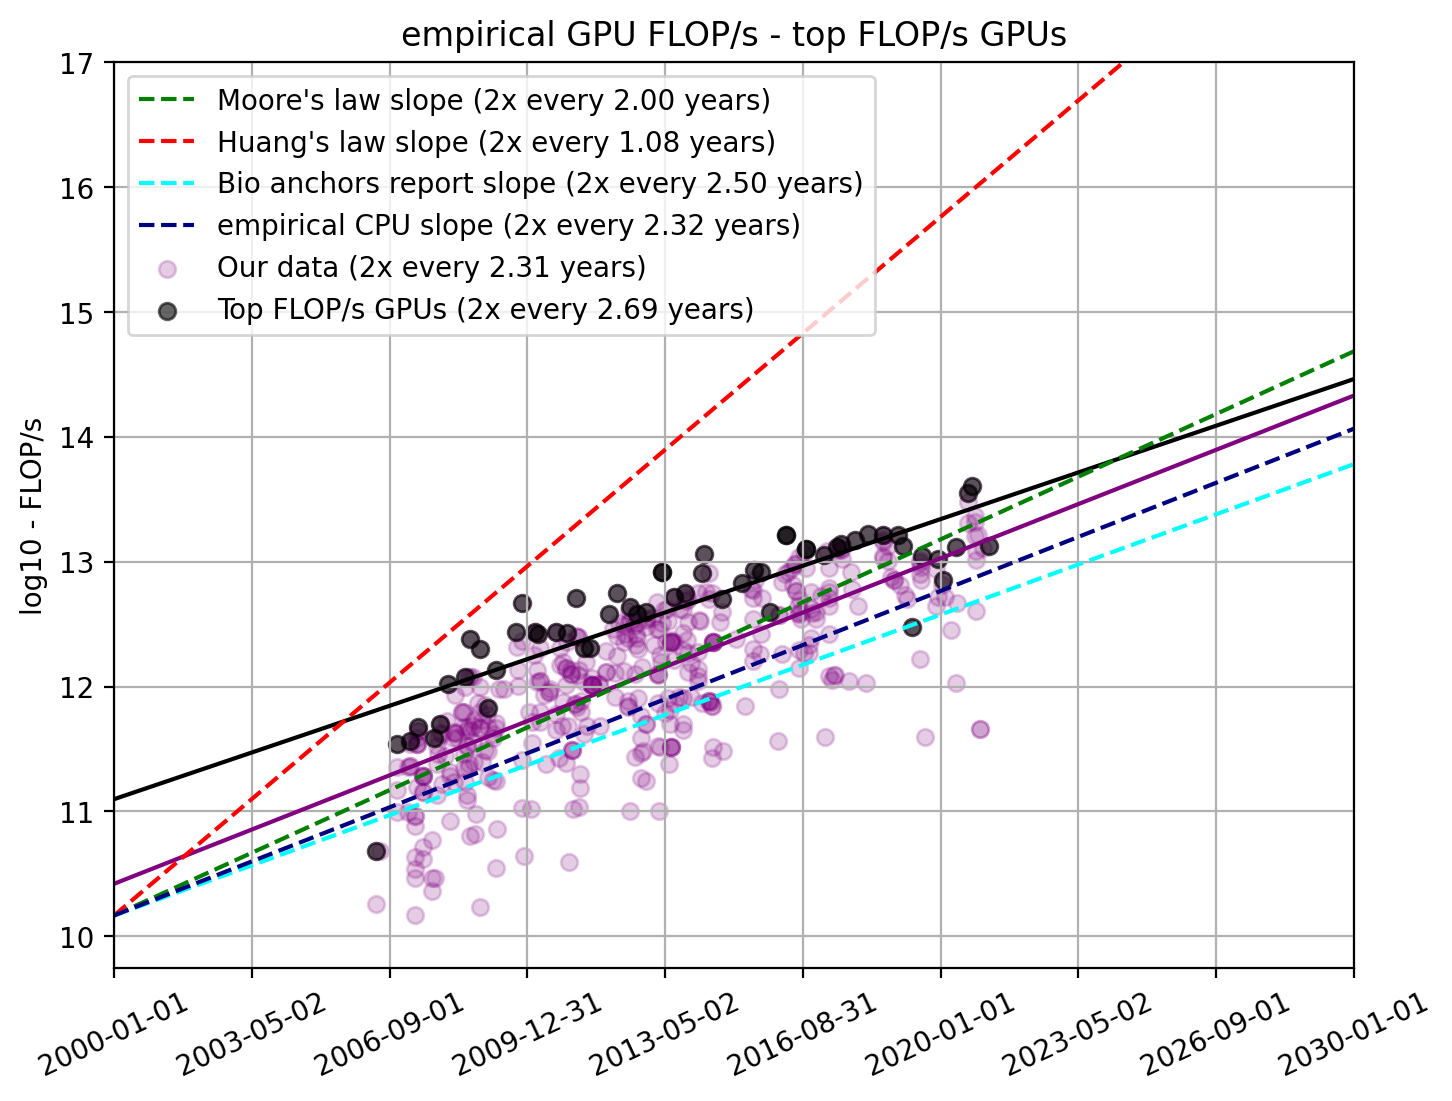
図12. 各月でFLOP/sの値が最も高かったGPUの実測FLOP/s
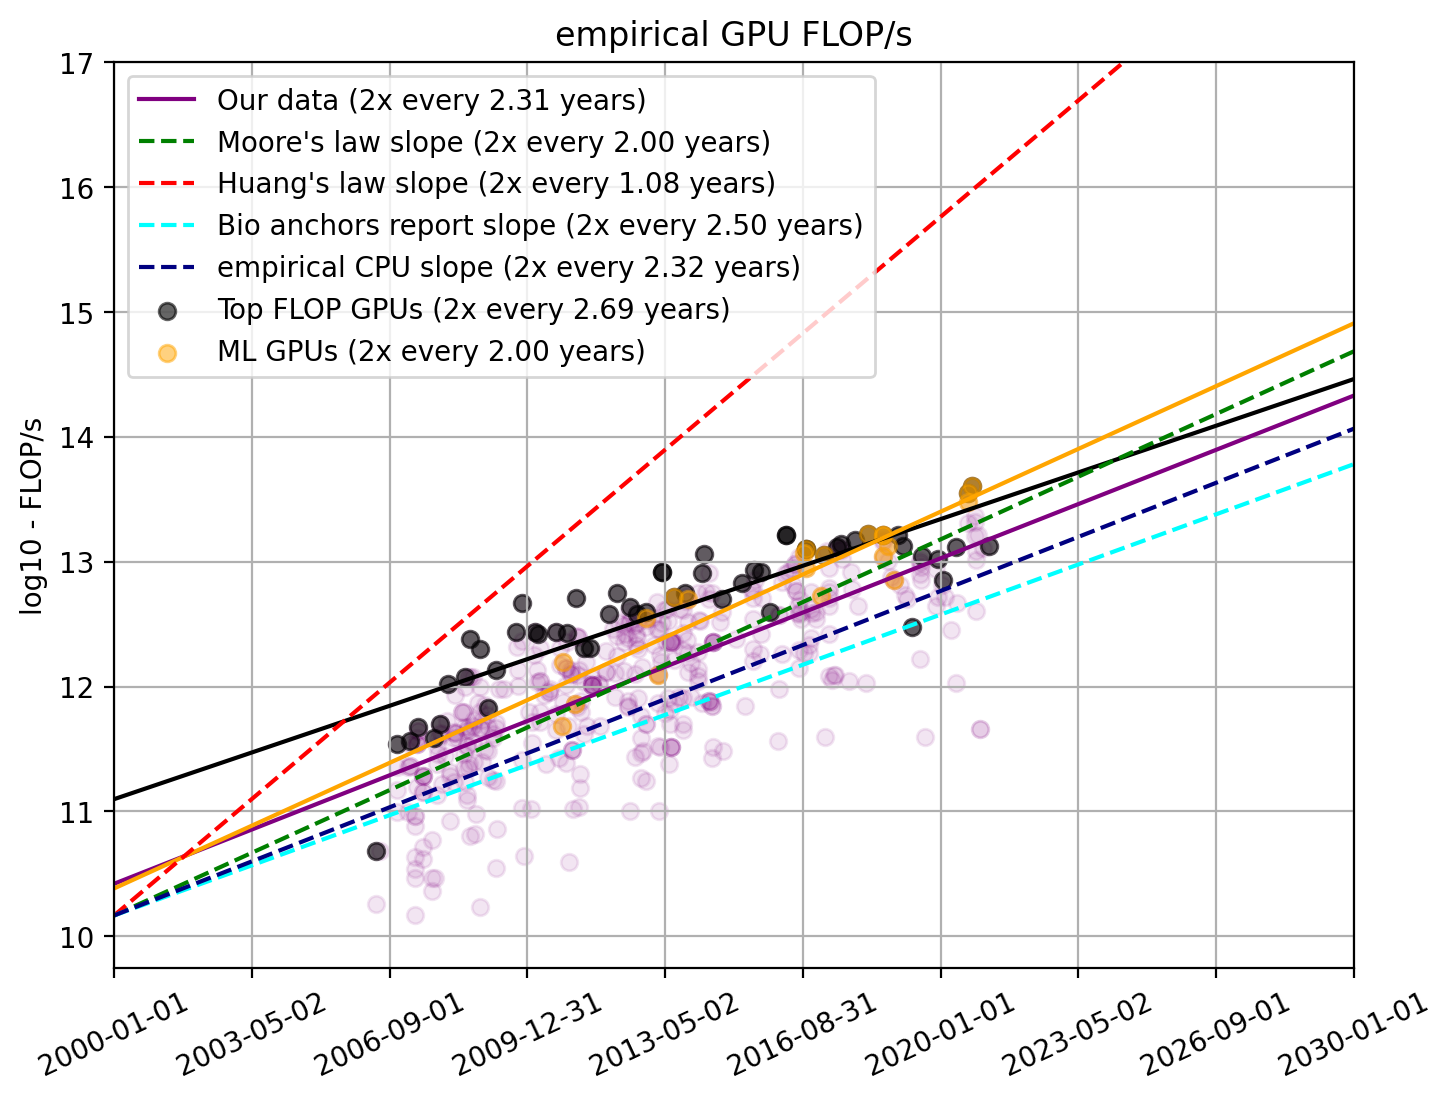
図13. FLOP/sが最上位のGPUとML用GPUを合わせた実測FLOP/s
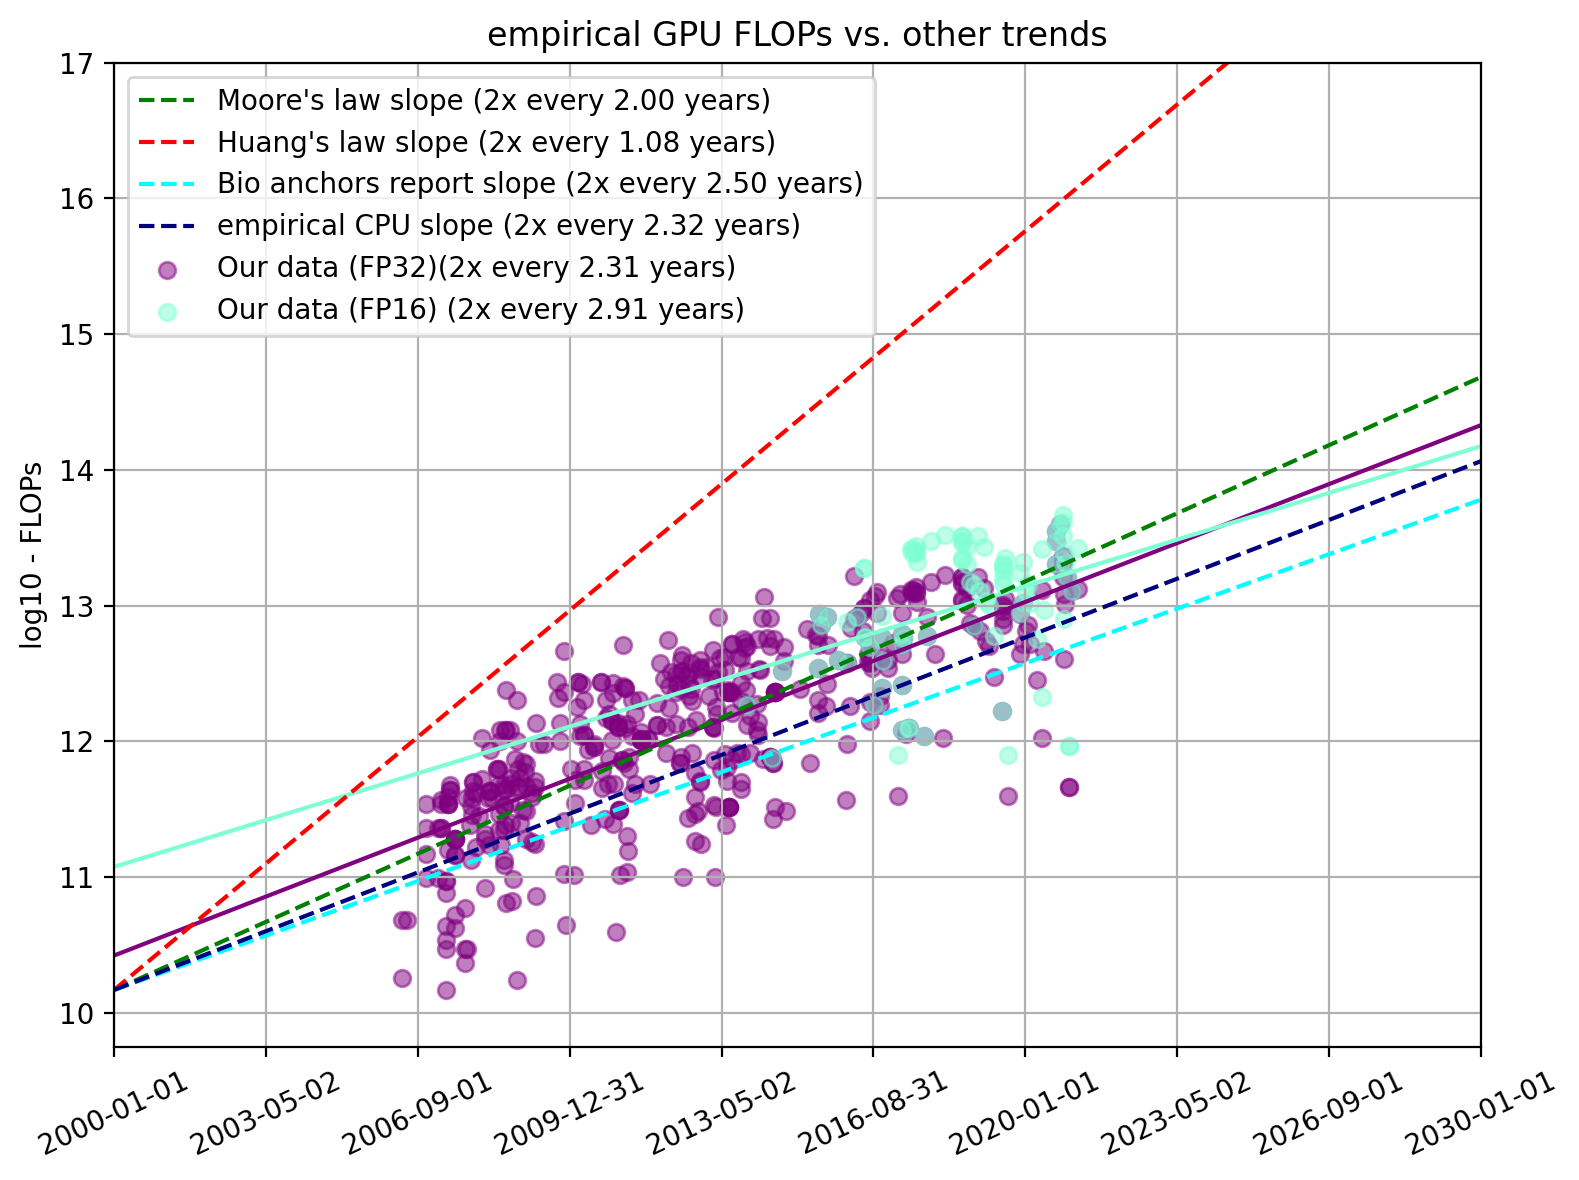
図14. FP16とFP32の実測FLOP/s
これらを本文に含めなかったのは、1ドルあたりFLOP/sとよく似た傾きを示しており、また1ドルあたりFLOP/sのほうが重要な指標だと考えるからである。
注
-
本稿は将来のGPUの価格性能比を予測しようとするものではなく、近年の歴史的傾向を把握するだけのものである。今後の研究では、GPUの価格性能比の傾向から、機械学習へのハードウェア支出のこれまでの伸びや、将来の大規模な機械学習の学習実行について何がわかるかを調べるつもりである。 ↩
-
さらに、Median Group(2018)による先行調査の推定値に問題があることを私たちは見つけていた。その後これを先方に伝え、先方はすでに修正している。 ↩
-
たとえば、NVIDIA Tesla K40c と NVIDIA Tesla K40d は仕様が実質的に同一なので、同じ機種とみなす。 ↩
-
主にこれらの指標を扱うのは、大規模なAI実験にどれだけの計算資源を投入しうるかという問いに主な関心があるからである。他にも関心の対象になりうる指標(エネルギー効率など)はあるが、本稿の動機となった問いとの関係がより間接的であり、また先行研究、特に Sun et al., 2019 で分析されているため、ここでは扱わない。 ↩
-
これは、Cotra の報告書草稿の第4節についての私たちの解釈である。そこで彼女は次のように書いている。「また、実効的な1ドルあたりFLOP/sは、2025年前後にはおよそ2.5年に1回倍増していると仮定する。これはムーアの法則(倍増期間を約1〜2年とし、2000年代半ばまでは成長をかなりよく説明していた)より遅いが、約2008年から2018年までの実効的な1ドルあたりFLOP/sの伸び(倍増期間は約3〜4年)よりは速い」 ↩
-
Cotra 2020 における1ドルあたりのFLOPは、1ドルで行える計算の総量を指す。 ↩
-
FP64の性能も最初に少し調べたが、新しいGPUではFP64の性能がFP32の性能よりはるかに低いようなので、その分析は含めないことにした。私たちはこれを、GPUメーカーがFP32とFP16を優先し、FP64を後回しにしているためと解釈している。 ↩
-
私たちの推測では、これは彼らの手法が移動する最適値を分析するものだからだろう。彼らの場合、分析するのは9個のデータ点になり、点推定値に確信を持つには不十分だと私たちは考える。 ↩