
ニュースレター
AIベンチマークが経済的影響を反映してこなかった本当の理由
原題:The real reason AI benchmarks haven’t reflected economic impacts
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
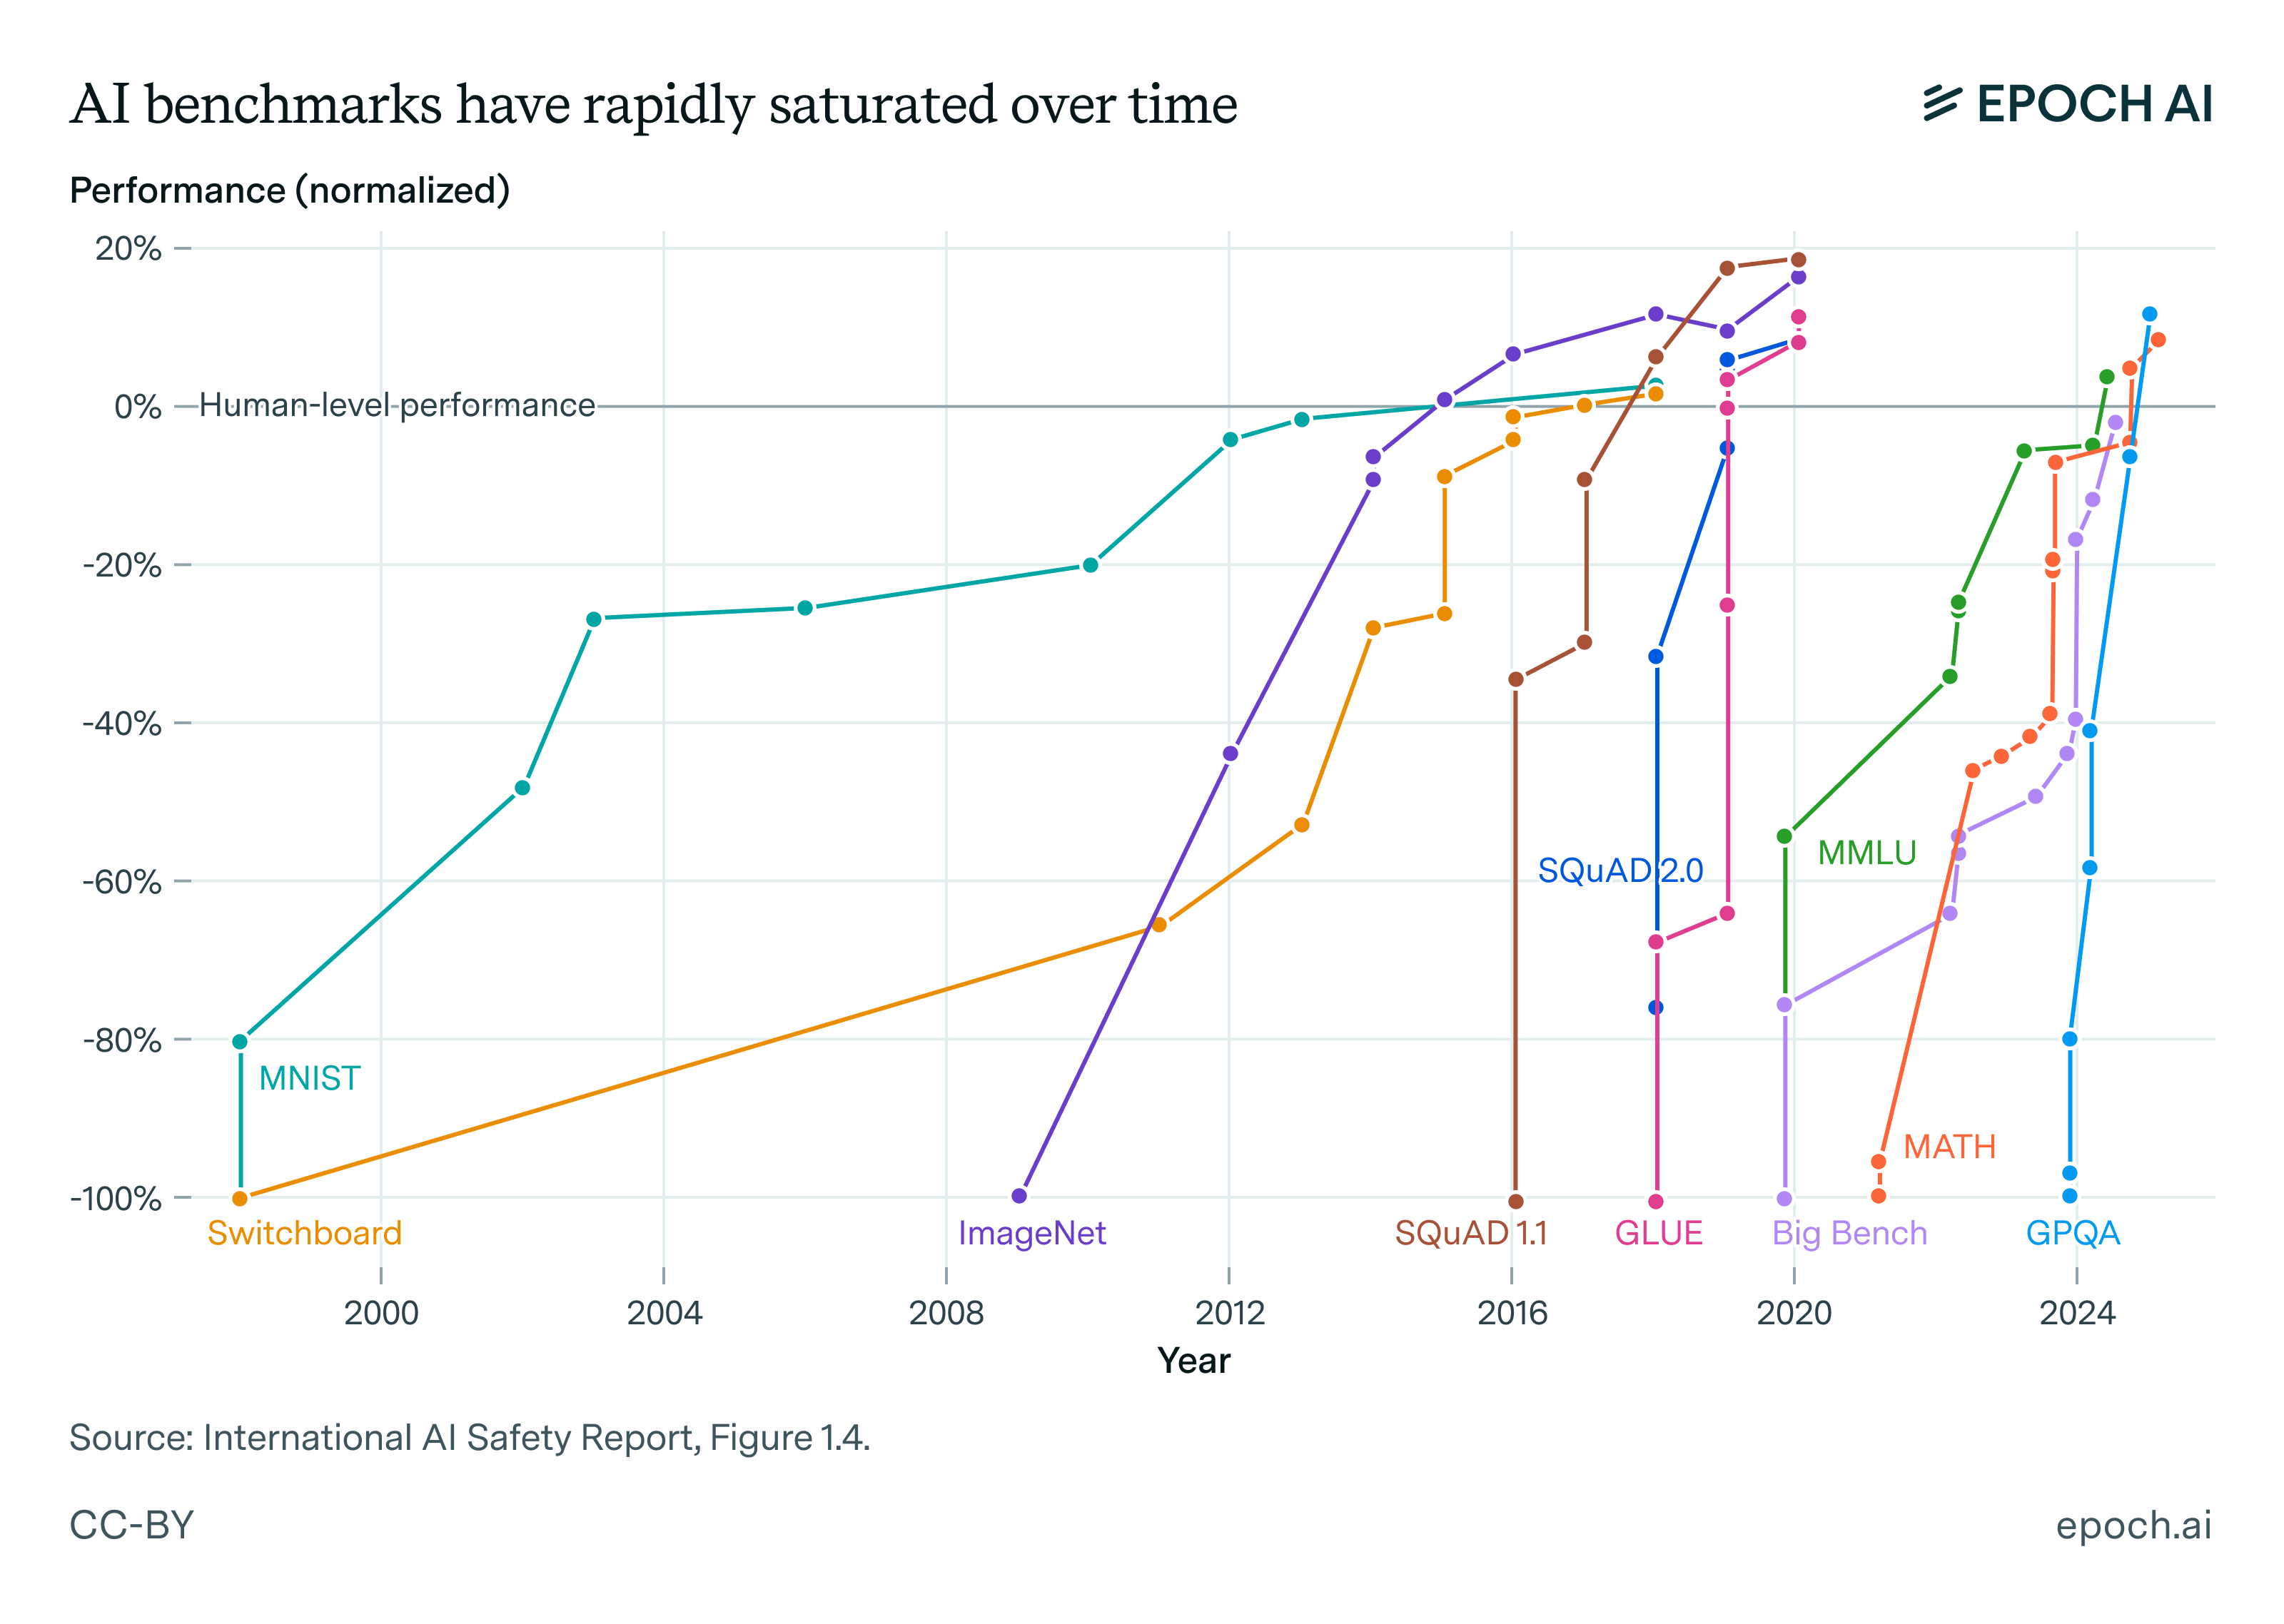
図1:主要なベンチマークで見るAIの急速な進歩。これらのベンチマークは、能力を押し上げるための指標として役立ってきた。しかし、この期間の大半は、ベンチマークの現実性が優先されていなかった。ベンチマークの高得点が、AIシステムの現実世界への影響についてあまり多くを教えてくれないことが多いのはこのためである。
2023年3月という太古の昔、OpenAIはGPT-4を公開した。そのベンチマーク結果は、法律専門職の将来について多くの疑問と憶測を呼んだ。
こうした懸念に応えて、Narayanan と Kapoor はブログ記事を書き、これはより一般的な問題、つまりAIベンチマークが現実世界の複雑さを反映できていないという問題の一例だと指摘した。そしてベンチマークがこの点でうまくいかなければ、AIシステムの現在と将来の影響について誤った結論を導きかねない。
これは間違いなく正しいが、部分的な答えにしかなっていないように思える。既存のベンチマークがなぜ現実世界の複雑さを捉えないのかを教えてくれないからだ。たとえば、AIベンチマークを設計する人たちは、現実世界のタスクが多肢選択問題を解くこととは違うことくらい、当然わかっているはずだ! それなのに、なぜわざわざ多肢選択問題のベンチマークを作るのだろうか。
その根本的な理由は、AIシステムの現実世界への影響を測ることを目標にした人がほとんどいなかったことにあると私たちは考えている。それを測るには、現実世界のタスクの複雑さを捉えるために相当な資源が必要になる。そうではなく、ベンチマークは主に別の目的、たとえば「ぎりぎり手が届く」タスクでモデルの相対的な能力を比べるといった目的のために最適化されてきた。
このことは、各時期に最もよく使われたベンチマークを眺めるだけでわかる。
- 2017年以前のベンチマークは、画像分類(例:ImageNet、CIFAR-100)や感情分析のような、単純で短いタスクが一般的だった。
- 2018年ごろから、ベンチマークは多肢選択式の質問応答や、単純な自由記述のテキスト生成タスクへと移り、コーディングや数学などさまざまな分野に広がった(例:CommonSenseQA、MMLU)。
- より現実的な場面でAIシステムを評価するよう設計されたベンチマーク(例:SWE-Bench、RE-Bench)が見られるようになったのは、ここ2年ほどのことにすぎない。しかしこうした最近のベンチマークでさえ、たいていは比較的短いタスクで構成されており、複雑な現実の経済活動を正確に表すタスクにはなっていない。
重要な点として、ベンチマーク設計のこうした変化は、AIシステム自体の能力の変化とぴったり重なってきた。ここから、人々は主に、その時点のAIの能力で「ぎりぎり手が届く」ベンチマークを作ることに集中してきたと考えられる。
では、なぜ研究者は「ぎりぎり手が届く」タスクに集中してきたのか。実際的な理由の一つは、ベンチマークが主に、AIモデルを改良するための有効な学習シグナルを与えるために作られてきたことだ。簡単すぎるタスクや難しすぎるタスクからは、役に立つフィードバックが得られない。また、あるモデルが別のモデルより優れているかどうかだけを気にするなら、現実的なタスクは要らない。スコアの差がより幅広い能力の差と相関するベンチマークさえあればよい。
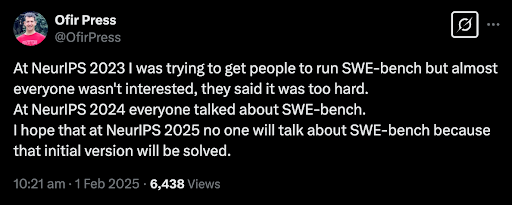
示唆に富む証拠が、2023年のベンチマーク SWE-Bench から得られる。SWE-Bench は実際の GitHub の issue を収録し、コーディング能力を評価する。公開された当初は、難しすぎると見る人もいた。しかし SWE-agent が公開されてこのベンチマークで10%を超えると、その後の性能向上は急速に続いた。
これに関連して、研究者がAIの進歩の速さを過小評価していたことも、話の一部なのかもしれない。たとえば2016年に自己回帰型の言語モデルに取り組んでいた研究者は、AIシステムを「経済的に有用なタスク」をこなすものとは考えない傾向にあった。そうするだけの能力がないと考えていたのである。そのため、ベンチマークは現実世界のタスクの比較的安価な代理指標として、しかも比較的単純なものとして、意図的に設計されていたのかもしれない。
研究者がAIの進歩の速さを過小評価していなかった場合や、学習シグナルの提供をはっきり重視していなかった場合でさえ、研究者は現実性以外のものを優先して最適化することが多かった。多くの評価は、囲碁を打つことや多肢選択式の科学の問題を解くことのように、人間にとって難しいタスクで構成されている。だからこそ、AIシステムがそれを解けるととりわけ印象的になる。しかし Narayanan と Kapoor が指摘するように、人間にとって難しいことがAIにとって難しいこととは相関しないかもしれない。そのため、ベンチマークのスコアと現実世界への影響との関係はさらに複雑になる。
なお、ベンチマークに現実性が欠けていた主な理由が、実際的な限界や根本的な限界だったとは私たちは考えていない。現実世界の複雑さを捉えるベンチマークを作るのは難しいこともあるが、これまでのベンチマークでそれが決定的な制約になっていたようには見えない。
たとえば、2021年によく使われたベンチマークの一つに HumanEval がある。これは数行のコードで解ける短く自己完結した問題で構成されており、現実のプログラミングを代表しているとはとても言えない。作成者が代わりに現実性を重視していたなら、SWE-Bench のようなものを作ることもできただろう。唯一の問題は、SWE-Bench のタスクが当時の最高のモデルには「手が届かない」ものだったであろうことだ。1現実性はボトルネックではなかった。単に優先されていなかっただけである。したがって、将来のベンチマークの現実性について、あまり悲観しすぎなくてよいと考えられる。
もちろん、現在や将来のベンチマークが現実世界への影響を簡単に捉えられるようになると言いたいわけではない。むしろ、現実的なベンチマークを作ろうとする最近の試みは、実際的な問題や根本的な問題に次々と突き当たっている。たとえば、RE-Bench に含まれる機械学習タスクの環境は、モデルの性能を簡単に検証できるよう、しばしば単純化しなければならなかった。そのため、これらのタスク環境からは、実際の機械学習研究が持つ複雑さの一部が失われている。実際の研究には、フィードバックの遅いループや不明確なタスクの指示がつきものなのかもしれない。
では、これはAIベンチマークの将来にとって何を意味するのか。私たちは、それが二つの力のせめぎ合いで決まると考えている。AIシステムの能力が高まり、経済のより多くの部門で使われるようになるにつれて、研究者にはこの種の現実世界の経済的影響を捉えるベンチマークを作る動機が強まる。その一方で、そうした現実的なベンチマークの設計は、実際的にも根本的にも、ますます大きな課題に直面する。
私たちの見るところ、この二つの力のどちらが勝つのかはまだわからない。この問いは今後の記事でさらに掘り下げる。この緊張関係をどう解消するかは、単なる学術的な問いではない。AIの進歩を理解し、AIが将来もたらす影響に備えるうえで、きわめて重要な意味を持つのである。