
ニュースレター
アルゴリズムはどれだけ速く能力を進歩させられるか?
原題:How fast can algorithms advance capabilities?
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
今週号は、シカゴ大学 XLab のリサーチマネージャーで、Google DeepMind のAIガバナンス・インターンでもある Henry Josephson による寄稿である。
AI 2027 のシナリオで著者たちは、AIシステムが再帰的に自己改良を重ね、わずか数年で超知能に至る急速な離陸(テイクオフ)を予測している。
本当にそんなことが起こりうるのか。それが可能かどうかは、ソフトウェアによる知能爆発、つまりAIの能力向上につながるアルゴリズムの急速な進歩の連鎖が起こるかどうかにかかっているかもしれない。
ソフトウェアによる知能爆発がありうるかをめぐる議論の重要な分かれ目は、主要なアルゴリズムの改善が小さなモデルから大きなモデルへとスケールするかどうかに帰着する。最も重要なアルゴリズムの進歩が、その有効性を示すのに大量の計算資源を必要とするなら、ソフトウェアだけによる知能爆発は起こりにくいと考えるべきである。そうであれば、急速な離陸は計算資源の制約によって妨げられうる。
最近のプレプリントで、シカゴ大学 XLab の私たちのチーム(Spencer Guo、Teddy Foley、Jack Sanderson、Anqi Qu、そして私)は、この分かれ目を調べるため、文献をレビューし、小規模な検証をいくつか行った。
その結果、歴史的に見て、最大級のアルゴリズムの進歩は、小さな版から単にスケールアップできるものではなかったことがわかった。開発と検証に大量の計算資源が必要であり、そのため、ソフトウェアによる知能爆発は見かけより実現が難しい。
Epoch AI の最新情報を受け取る 購読する
最良のアルゴリズムの改善は計算資源に依存するのか?
文献の調査では、アルゴリズムの進歩を次のどちらかに分類した。
- 計算資源に依存しないもの。進歩の利点が小さな規模で現れ、規模が大きくなっても続く、あるいは加速するもの
- 計算資源に依存するもの。進歩の利点が大量の計算資源があるときにだけ現れ、計算量が少ない水準ではそのアルゴリズムの進歩がほとんど利点をもたらさない(あるいは性能を損なうことさえある)もの
調査は、2017年ごろから始めて、できるだけ現在に近いところまで、言語モデルのアーキテクチャの変遷を調べることから始めた。注目したのは、実装の詳細が公開されていて文書化の充実したモデルファミリー、つまり初期の GPT、BERT の派生モデル、LLaMA、DeepSeek である。
学習データの違いをできるだけ制御するにはそれが最善だろうという仮説のもと、同じファミリー内の世代の移り変わりに注目するよう努めた。1 これにより、性能の向上がアルゴリズムの進歩によるものだと、とくに規模を制御できる場合には、より確信を持って言えるようになった。
このやり方から、いくつかのパターンが見えてきた。
- GPT では、スパースアテンションの台頭が見られた。
- BERT の派生モデルからは、レイヤー正規化が RMSNorm へと発展した過程がわかった。
- LLaMA の世代の移り変わりは、標準的なアテンションからグループ化クエリアテンションへの進展を示した。
- とくにハードウェアの制約を受けていた DeepSeek のリリースは、最先端の計算資源がなくても最先端の性能を出せるアルゴリズムを示した。
こうした観察が、実験の設計を組み立てる助けになった。複数のモデルファミリーで繰り返し登場するアルゴリズムを選んだ。残り続けたものほど、本物の改善である可能性が高いと考えたからだ。また、計算資源の制約があるため、実際に実装して検証できるアルゴリズムを選んだ。マルチヘッドアテンションは選ばれたが、完全な混合エキスパートのアーキテクチャは選ばれなかった。
アルゴリズムを「計算資源に依存する」か「計算資源に依存しない」かに分類する方法も、文献を参考にした。一部のアルゴリズムは最大級のモデルにしか登場せず、他のアルゴリズムは大きなモデルにも小さなモデルにも登場することがわかった。そこから、最終的に検証することになった「計算資源に依存する/依存しない」という区別が浮かび上がった。
たとえば、アテンションの仕組みに必要なメモリ量を減らすマルチクエリアテンション(MQA)を考えよう。論文で述べたとおり、
2019年に導入された当時、MQA は主に、メモリの制約が大きな懸念にならない小さなモデルで検証された。その結果、その利点はすぐには明らかにならなかった。しかし、モデルが大きくなるにつれてメモリ効率がますます重要になり、MQA は現代のLLM(Falcon、PaLM、StarCoder など)にとって欠かせない最適化となった。2
このように、小さな規模ではほとんど利点がなく、大きな規模でははるかに大きな利点をもたらす MQA は、より一般的な計算資源に依存するイノベーションの類型の格好の例である。
対照的に、レイヤー正規化のようなアルゴリズムは、モデルの大きさを問わず一貫して登場した。レビューの結果、レイヤー正規化は「2016年に使われていたはるかに小さなニューラルネットワークで高速化を示し、今日のモデルでもなおよく使われている」ことがわかった。3 したがって、レイヤー正規化は計算資源に依存しない。
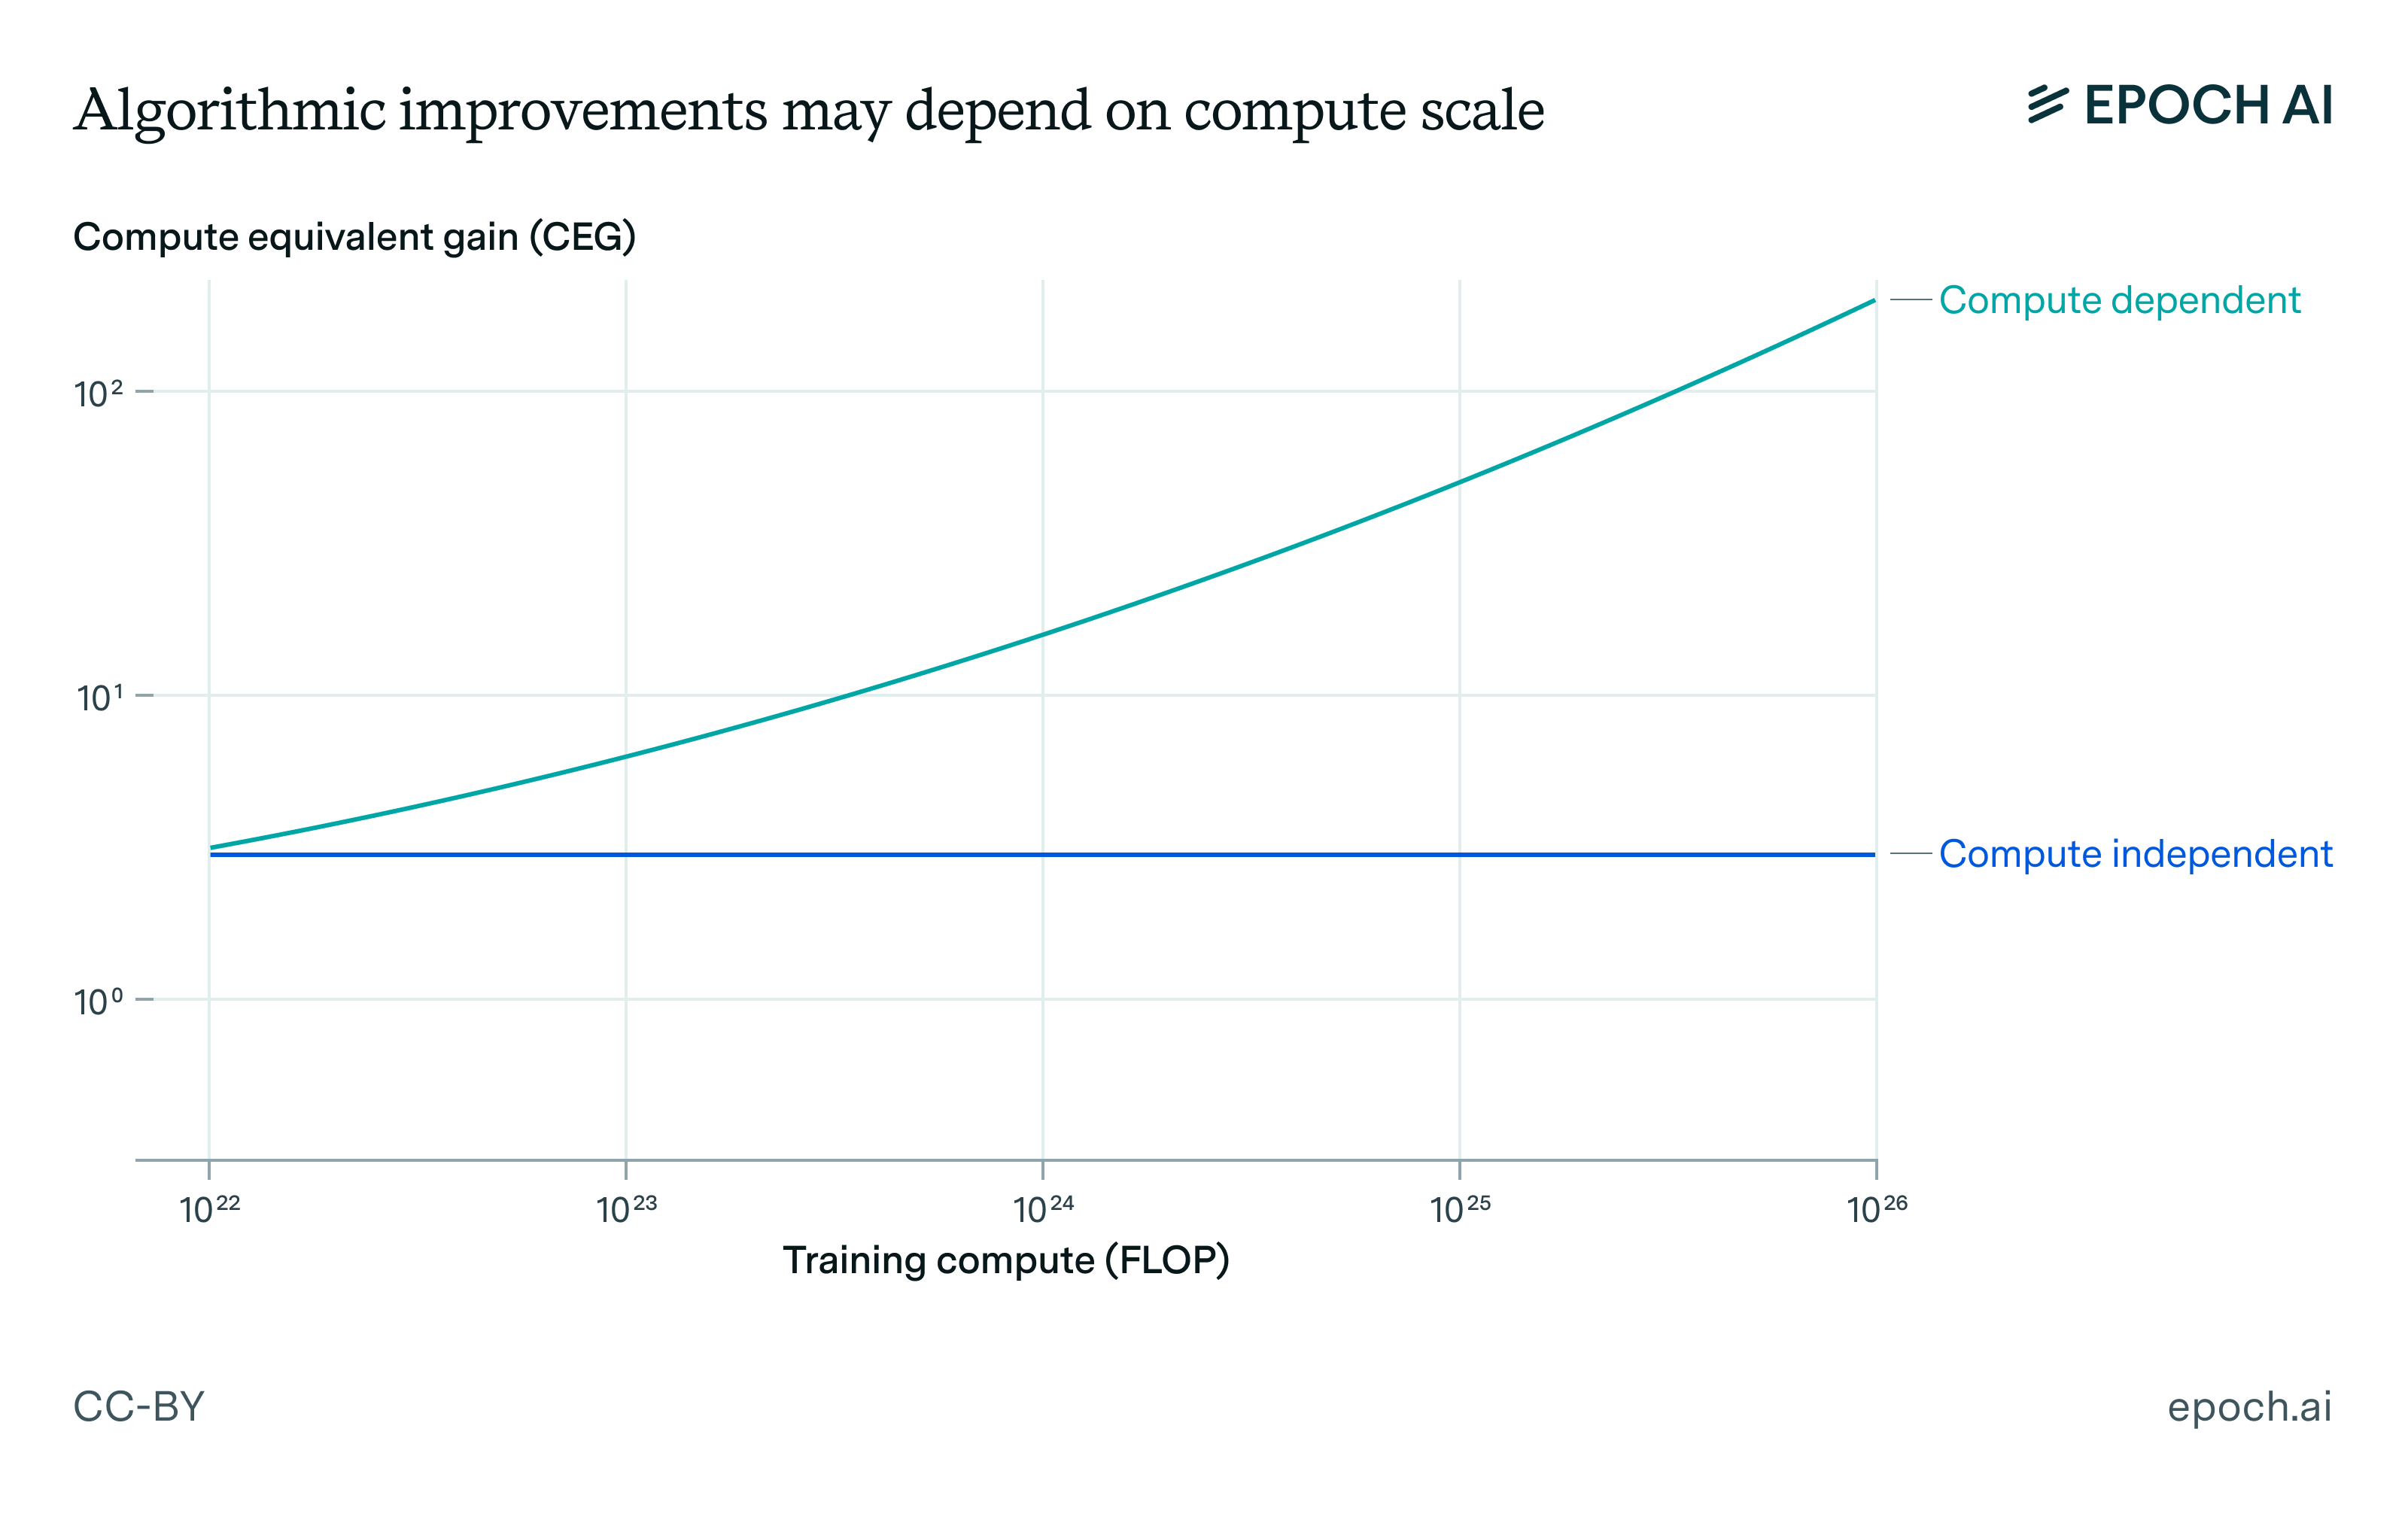
主要なアルゴリズムの進歩は計算資源に依存するという仮説を検証するため、上のアルゴリズムの改善を、GPT-2 を縮小した版(完全版の15億パラメータではなく約1億6,500万パラメータ)に実装した。計算量換算の利得(compute-equivalent gain、CEG)は、そのアルゴリズムの改善なしで OpenWebText で同じ交差エントロピー損失を達成するのに、どれだけ追加の計算量が必要かを比べて測る。たとえば CEG が2倍なら、そのアルゴリズムによって半分の計算量で同じ損失を達成できるということだ。
以下のアルゴリズムの進歩それぞれについて、計算量換算の利得を推定した結果を示す。
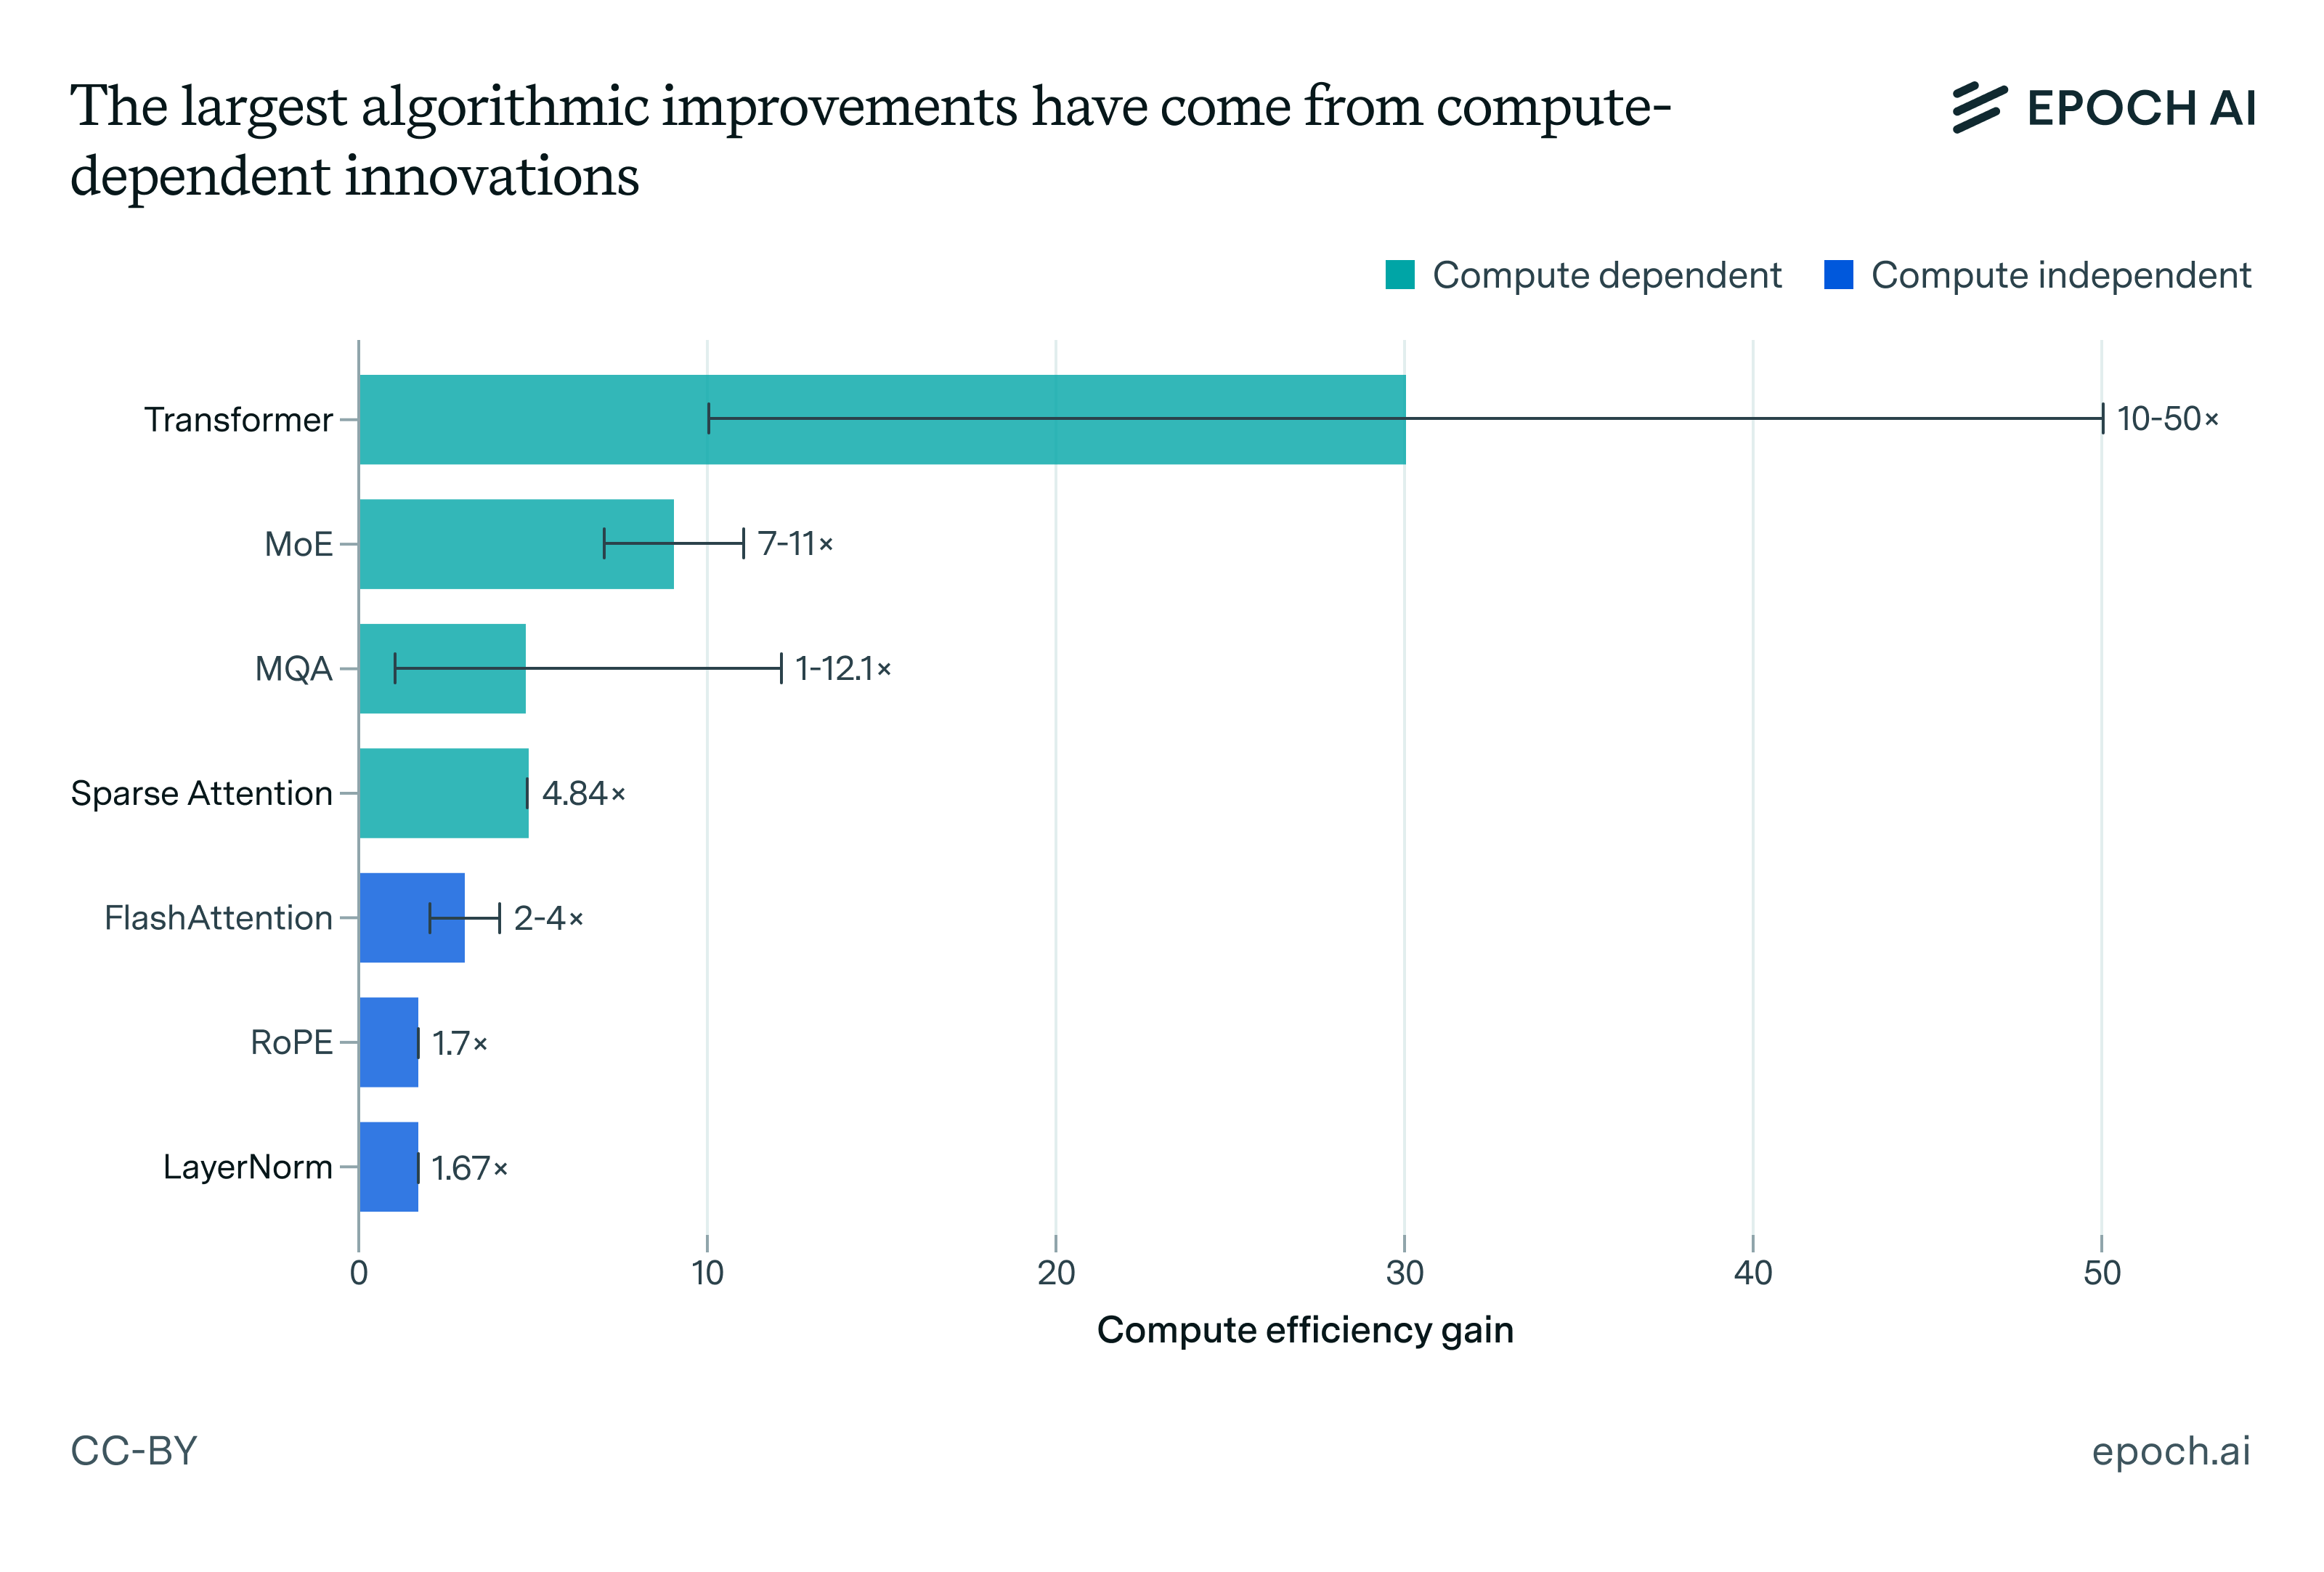
これらの数字を位置づけるために言えば、Dario Amodei は「どのフロンティアAI企業も、こうした計算量換算の倍率を日常的に数多く発見している。小さなもの(約1.2倍)は頻繁に、中程度のもの(約2倍)はときどき、非常に大きなもの(約10倍)はごくまれに」と述べている。4
計算資源に依存しない改善(LayerNorm+RoPE+FlashAttention)を組み合わせると、私たちの小規模なモデルでさえ、実験で約3.5倍の CEG が得られた。
この改善は、計算資源に依存する進歩について記録されている効果よりはるかに小さい。計算資源に依存する進歩は、はるかに大きな改善(10〜50倍以上)をもたらしうる。ただし、それを引き出せるだけの計算資源の予算がある者に限られる。
また、ここまでは計算資源に依存するか依存しないかというすっきりした二分法を使ってきたが、現実はもっと入り組んでいることにも注意が必要である。計算資源への依存の度合いはさまざまだ。
マルチクエリアテンションのささやかな効果(学習では1倍)と、Transformer アーキテクチャそのものが分野を一変させた影響(大きな規模で10〜50倍)を比べてみてほしい。計算資源に依存するイノベーションの中でも、規模に対してほぼ線形にスケールするものもあれば、強い超線形の改善を示すものもあり、計算資源に依存する改善はほとんど利点を示さないか、実際に性能を損なった。これは、一部のアルゴリズムの進歩はスケールアップして初めて真価を発揮するという仮説を支持している。
計算資源が凍結されても能力は進歩できるか? DeepSeek-V3 の場合
この力学を示す現実の例の一つが、中国の最近のフロンティアモデル DeepSeek-V3 である。高性能チップの入手を制限する輸出規制を受けていたにもかかわらず、6,710億パラメータの DeepSeek-v3 の最終的な学習実行にかかったのは、わずか278.8万H800 GPU時間だった。比較すると、LLaMA 3.1-405B-Instruct5 の最終的な学習実行には、より強力な H100 GPU で約3,084万時間が使われた。
DeepSeek は、計算資源にこれほど制約がありながら、どうやってこれほど高い性能を達成したのか。
答えはアルゴリズムの改善であり、マルチヘッド潜在アテンション、混合エキスパートのアーキテクチャ、混合精度学習などがそれにあたる。ここから、ハードウェアの制約があっても、アルゴリズムを改善すれば意味のある進歩を生み出せると考えられる。そして、DeepSeek が使ったイノベーションのうち最も効果の大きかったものが、計算資源に依存するもの、つまり大きな規模で最もよく機能するものだったことは示唆に富む。
AIの進歩にとっての意味
私たちの結果から見えるアルゴリズムの進歩の姿は、単純ではない。計算資源に依存しないイノベーションも依存するイノベーションも能力を前進させるが、両者の役割は異なり、その違いはAIの今後の軌道に大きく関わる。
私たちの文献レビューと分析は、Transformer アーキテクチャそのもののように最も大きな変革をもたらしたアルゴリズムの転換が、計算資源に依存するものだったことを裏づけている。こうしたイノベーションは、小さな規模ではほとんど、あるいはまったく利点がないことが多いが、十分な計算資源があれば桁違いの改善(10〜50倍以上の CEG)を引き出す。歴史的に見て、累積の CEG の効果の大部分、おそらく約99%がこうしたイノベーションによるものだ。ハードウェアとアルゴリズムは補完関係にある。最先端の計算資源があれば、より大きなモデルを作れるだけでなく、新しいアルゴリズムのパラダイムも開ける。
同時に、レイヤー正規化、RoPE、FlashAttention のようなアルゴリズムは、規模を問わず目に見える利点をもたらす。私たちの実験では、小さなモデルでさえ、これらを組み合わせて3.5倍の CEG が得られた。ハードウェアが固定されていても、意味のある進歩は起こりうる。こうした進歩は、ある能力水準を達成するためのハードルを下げ、より少ない計算資源で発見・検証できるので、資源の限られた環境での進歩を加速させる可能性がある。
しかし、計算資源に依存するアルゴリズムによる能力の向上と比べれば、それらは取るに足らないものにとどまる。計算資源に依存するアルゴリズムがこれほど大きな比重を占めることから、大規模な計算資源を使える組織は研究で大きく優位に立つと考えられる。大規模な計算資源があれば、最大の向上をもたらすまさにそのアルゴリズム、つまり小さな規模では有望に見えない、あるいは有害にさえ見えるかもしれないアルゴリズムを検証し、確かめられるからだ。
Tom Davidson はこれに異を唱え、6 研究者は小さな実験から外挿できるかもしれないと論じている。真にフロンティア規模の学習実行は世界全体でも少ないのに、アルゴリズムの進歩は鈍っていない、というのがその指摘だ。これはもっともな指摘だが、主要な研究所にとって「小さい」の定義がどれだけ変わったかを見落としているのではないかと思う。数十台から数百台の H100 を使う実験は、GPT-4 の本番の学習実行に比べれば「小さい」が、ほんの数年前と比べても、独立した研究者が利用できるものと比べても、膨大な計算資源である。こうした「中規模」の実験は、Davidson の言うように研究者のセンスと理論的な理解に導かれながら、常にフロンティア規模の学習実行を行わなくても有望な計算資源依存のイノベーションを見つけるのに十分なシグナルをおそらく与えてくれる。計算資源の豊富な研究所が優位を保っているのは、規模そのものによるだけでなく、計算資源に依存する効果が現れるほど大きな規模で、アルゴリズムの空間を効率よく探索できることにもよる。
したがって、再帰的な自己改良への道筋は、裾の重い分布の裾を構成する計算資源依存の進歩をAIシステムがどれだけ容易に発見できるかに、より大きく左右されそうである。私たちが見つけられた計算資源依存の進歩は、ほぼすべてが Transformer とその派生物の一部だったことに注意してほしい。7 計算資源依存の進歩は見つけるのが難しく、検証も容易ではないが、性能の面で最大の見返りをもたらす。したがって離陸のペースは、そうした進歩が相対的にどれだけ見つけにくく、どれだけまれにしか見つからないかにかかっている。
そこで、私たちの研究から一つだけ持ち帰るとすれば、次のことにしてほしい。到来時期(タイムライン)が早まるかどうかは、抽象的な意味でのアルゴリズムの進歩が見つけやすくなるかどうかだけでなく、計算資源に依存するアルゴリズムの進歩が見つけやすくなるかどうかにかかっている。
(輸出規制のような)ハードウェアの規制は、DeepSeek-V3 が頼ったような計算資源に依存する大きなブレークスルーの発見と検証を妨げることで、進歩を遅らせるだろう。ただし、計算資源に依存しない改善は積み重なり続けるので、進歩を完全に止めることはおそらくない。さらに、計算資源に依存しない道筋があるため、能力の大きな向上が想定された FLOP の水準を下回るところで起こるかもしれず、規制のための計算量の閾値を定めることはますます難しくなる。テスト時の進歩の台頭は、これをいっそう複雑にするだけである。
限界
締めくくる前に、限界を強調しておくべきだろう。私たちの実験は比較的小さなモデル(1億6,500万パラメータ)を使っており、分類は、複数の規模での実証的な検証ではなく、これらの結果を文献の分析と組み合わせることに頼っている。CEG は事前学習の損失で測っており、下流の能力では測っていない。
思考の連鎖(chain-of-thought)、k 回中の最良を選ぶサンプリング、検索拡張などの推論実行時の技法は分析していない。これらはおそらく独特のスケーリングの性質を持つ。Epoch の分析がこちらでいくつかの CEG の推定を示しているが、情報が古くなっている可能性がある。
また、事前学習を中心に扱ったため、ファインチューニング、RLHF、DPO などの事後学習・強化学習の技法も除外した。これらはより小さなモデルを使うが、実験の回数はかなり多いことが多く、計算資源の力学は事前学習とは大きく異なるだろう。
データは固定したものとして扱った。アルゴリズムの改善とデータセットの質・構成との相互作用はきわめて重要であり、「Scaling Data-Constrained Language Models」のような論文が、これを調べるためのデータを提供してくれるかもしれない。
今後の研究では、これらの領域を調べ、分類を他の分野(視覚、生物学)でも検証し、できればより大きな規模で結果を再現すべきである。
結論
アルゴリズムの進歩は、計算資源の規模と大きく相互作用する。計算資源に依存しない進歩があれば、ハードウェアの制約があっても前に進めるが、歴史的に最大の向上は、開発と検証にかなりの規模を必要とする計算資源依存のイノベーションからもたらされてきた。この区別を理解することは、効果的なガバナンスを設計し、AIの進歩を予測するうえで欠かせない。私たちの実験に基づけば、進歩の速さは、研究所が計算資源に依存するアルゴリズムの進歩をどれだけ容易に見つけ、検証できるかにかかっていると予想する。
注
-
つまり、たとえば LLaMA 3.2 は LLaMA 3.1 とほぼ同じデータ構成で事前学習されている、あるいは少なくとも、両者のデータの違いは、たとえば BERT の事前学習データと比べれば無視できる、と仮定している。 ↩
-
7ページ。 ↩
-
9ページ。 ↩
-
この点を指摘してくれた David Owen に感謝する。また、Amodei は次の文で Epoch の研究を引用している。「より知的なシステムを持つことの価値はきわめて高いので、こうした曲線の移動によって、企業はふつう、モデルの学習に費やす額を減らすのではなく増やすことになる。コスト効率の向上は、結局すべてより賢いモデルの学習に注ぎ込まれ、その限界は企業の資金力だけである」 ↩
-
念のため言えば、このモデルは埋め込みを除いて4,050億のパラメータを持つ。 ↩
-
これを教えてくれた Anson Ho に感謝する! ↩
-
実験に計算資源を使うこと、学習に使うこと、推論実行に使うことの間のトレードオフについてのさらなる議論は、Inference Magazine に掲載された Jack Wiseman と Duncan Clements の記事(こちら)を参照。 ↩