
ニュースレター
フロンティア言語モデルははるかに小さくなった
原題:Frontier language models have become much smaller
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
2017年に最初の Transformer が発表されてから GPT-4 が公開されるまでの間に、能力の最先端(フロンティア)にある言語モデルははるかに大きくなった。パラメータ数は、GPT-1 から GPT-3 までの2年間で1億1,700万から1,750億へと1,000倍に拡大し、続く2年9か月の GPT-3 から GPT-4 までの間に、1,750億から1.8兆へとさらに10倍に拡大した。
GPT-3 以降の傾向が続いていたなら、GPT-4 の公開が2023年3月だったことを考えると、今頃は10兆パラメータ近く、GPT-4 の約4倍の大きさのモデルが登場していてもおかしくなかった。ところが2023年に、フロンティア言語モデルが大きくなっていく傾向は逆転した。10兆パラメータに届くどころか、最初の GPT-4o や Claude 3.5 Sonnet のような現在のフロンティアモデルは、おそらく GPT-4 より1桁小さい。4o は約2,000億、3.5 Sonnet は約4,000億パラメータである。
この号では、まず、フロンティア研究所はアーキテクチャの詳細を公開していないのに、この変化が起きたとなぜ分かるのかを説明する。次に、傾向が逆転した原因はどんな要因にあると私が考えているのか、最後に、なぜこの逆転した傾向が続くとは予想していないのかを述べる。
Epoch AI の最新情報を受け取る 購読する
この変化が起きたとなぜ分かるのか
まず、オープンウェイトのモデルから得られる証拠がある。多数のベンチマークのスコアを考慮して算出される Artificial Analysis のモデル品質指数によると、現時点で最良のオープンウェイトモデルは Mistral Large 2 と Llama 3.3 70B で、パラメータ数はそれぞれ1,230億と700億である。これらのモデルは GPT-3 と似たアーキテクチャの密な Transformer だが、パラメータ数は GPT-3 よりさらに少ない。ベンチマークでの総合的な性能は、最初の GPT-4 や Claude 3 Opus といった前世代のモデルを上回り、しかもパラメータ数が少ないぶん、推論実行がはるかに安く速い。
クローズドウェイトのモデルについては正確なパラメータ数が分からないことが多いが、提供される速度と、研究所が課す料金から推測することはできる。短いコンテキストのリクエストに限ってみると、OpenAI は2024年11月版の GPT-4o を、ユーザー1人あたり毎秒100〜150出力トークンの速度で提供し、出力100万トークンあたり10ドルを課している。これに対し GPT-4 Turbo は最大でも毎秒約55出力トークンで提供され、出力100万トークンあたり30ドルかかる。GPT-4 Turbo は、現在出力100万トークンあたり60ドルの最初の GPT-4 より安く、GPT-4o は GPT-4 Turbo よりはるかに安く速い。したがって GPT-4o は GPT-4 よりはるかに小さなモデルである可能性が高い。
推論実行の経済性の理論モデルを使って、GPT-4 を H200 でどれだけ安く提供できるかを予測することもできる。H200 を推論実行に使う機会費用を1時間あたり3ドルと仮定し、GPT-4 と、それを仮想的に縮小した版を推論実行に提供した場合に、どの価格帯でどれだけの速さでトークンを生成できるかを下の図に示す。
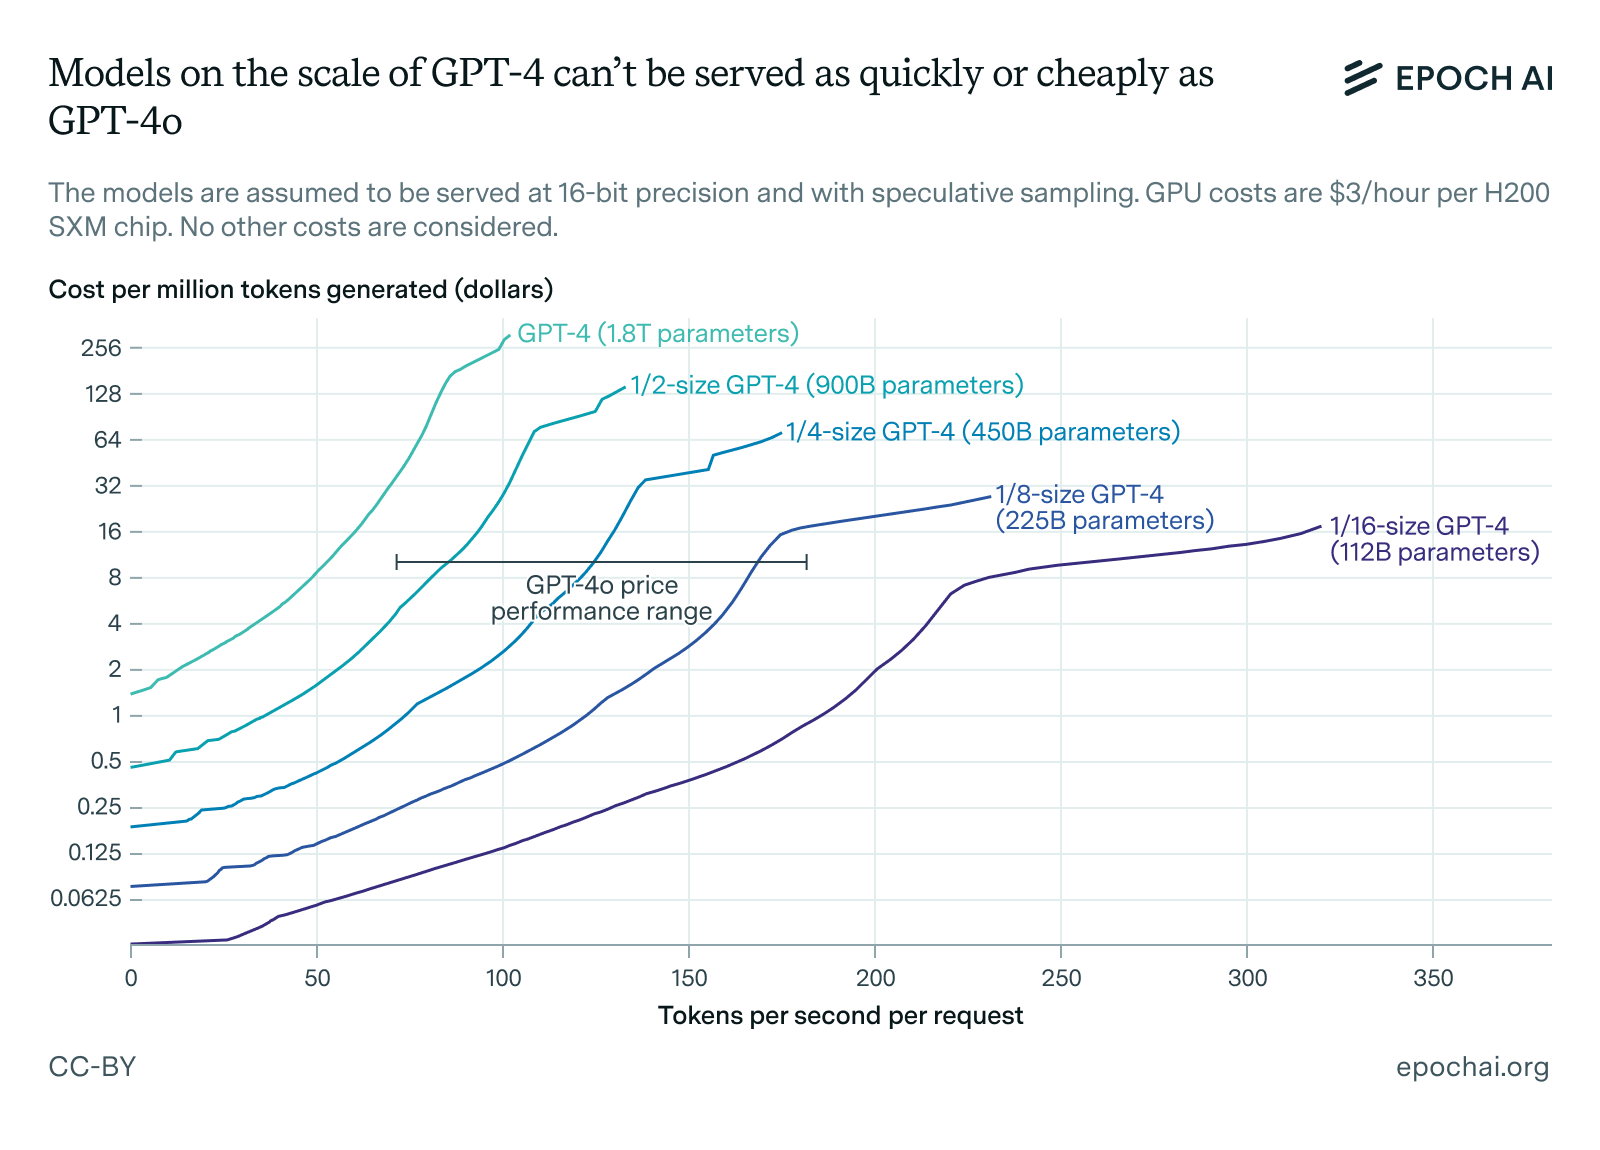
図1:GPT-4 を縮小した各版について、リクエストあたりのトークン生成速度と、生成100万トークンあたりのコストとの間のパレートフロンティア。結果は Epoch 内部のモデルに基づく。
全体として、ユーザー1人あたり毎秒100トークンを超える速度でモデルを提供し、しかもそれを余裕をもって行うには、モデルが GPT-4 よりはるかに小さくなければならない。上の図に基づくと、OpenAI がGPUのコストにどれだけ上乗せして課金していると仮定するかにもよるが、GPT-4o はおそらく GPT-4 の8分の1程度の大きさである。そうだとすれば総パラメータ数は約2,000億になるが、大まかな方法で導いた推定なので、2倍程度ずれていてもおかしくない。
Anthropic の最良のモデルである Claude 3.5 Sonnet は、GPT-4o より大きなモデルかもしれないことを示す証拠もある。実際、Sonnet は毎秒約60トークンでしか提供されておらず、出力100万トークンあたり15ドルかかる。非常に最適化された構成なら、この条件で最初の GPT-4 でさえ採算ぎりぎりで提供できるかもしれない。Anthropic はAPI料金にかなりの上乗せをしている可能性が高いと私たちは考えているので、Sonnet 3.5 の実際の大きさは、やはり GPT-4 よりかなり小さいはずだ。Anthropic の推論実行の速度が10万トークンのコンテキスト長でもあまり落ちないことも考え合わせると、約4,000億パラメータという推測は妥当に思える。
こうして見えてくるのは、最大のフロンティアモデル(たとえば Llama 3.1 405B や、推測ではあるが Claude 3.5 Sonnet)のパラメータ数が約4,000億で、多くはそれより少ない、という状況である。クローズドなモデルのパラメータ数の推定はかなり不確かだが、それでも GPT-4 や Claude 3 Opus から現在のフロンティアモデルへの縮小は、おそらく1桁近いと推測できる。
なぜこうなったのか
モデルがはるかに小さくなったことがなぜ分かるのかを示したので、次は2023年に傾向が逆転した理由を探っていこう。私の見るところ、その背景には四つの主な理由がある。
GPT-4 の公開後、AI製品への需要が急増した。2022年12月の「ChatGPT の衝撃」と2023年3月の GPT-4 の公開を経て、AI製品への関心は爆発的に高まった。その結果、提供企業は当初の予想をおそらくはるかに超える推論実行の需要に追われることになった。それまで、2020年から2023年3月にかけては、一定の能力水準に対して学習計算量を最小にするという基準でモデルが学習されていた。そしてそのためには、Kaplan のスケーリング則も Chinchilla のスケーリング則も、学習計算量が増えるにつれてモデルを大きくすることを推奨している。しかし、推論実行がモデルへの支出のかなりの部分、あるいは大部分を占めるようになると、これらの推奨よりもモデルを過剰に学習させる、つまり小さなモデルをより多くのトークンで学習させるほうがよい。その結果、Llama 2 70B から Llama 3 70B への移行で起きたように、モデルの大きさを変えずに学習計算量だけを増やすことになりうる。
過剰学習に加えて、研究所は蒸留と呼ばれる別の手法も使い、小さなモデルが大きさ以上の実力を発揮できるようにしてきた。蒸留とは、小さなモデルを、すでに学習済みの大きなモデルの性能に匹敵させようとすることである。大きなモデルを小さなモデルに蒸留する方法はたくさんある。単純なものとしては、大きなモデルを使って質の高い合成データセットを生成し、それで小さなモデルを学習させる方法がある。大きなモデルの内部(隠れ状態や対数確率など)にアクセスできることを前提とする、より複雑な方法もある。GPT-4o も Claude 3.5 Sonnet も、より大きなモデルから蒸留された可能性が高いと私は考えている。
Kaplan のスケーリング則から Chinchilla のスケーリング則への移行。一般に、Kaplan et al. (2020) による Kaplan のスケーリング則は、Hoffmann et al. (2022) による Chinchilla のスケーリング則よりも、学習トークン数に対するパラメータ数の比をはるかに高くすることを推奨している。学習計算量はおおよそアクティブパラメータ数と学習トークン数の積に比例するので、Kaplan から Chinchilla への移行によって、モデルは小さくなる一方、より多くのデータで学習されるようになった。その効果は過剰学習と似ていたが、根本の要因は、予想外の推論実行需要の増加ではなく、事前学習のスケーリングのやり方についての理解が変わったことにある。
テスト時計算のスケーリング。コンテキスト内で推論する手法が改善されるにつれて、推論実行時にトークンをより多く、より低いレイテンシで生成することの価値が高まってきた。かつてモデルが「十分に速い」かどうかの目安は人間の読む速さ程度だったが、ユーザーに示す出力トークン1つにつき推論トークンを10個生成するとなると、トークンをより効率的に生成できるモデルの価値はかなり高まる。このため、複雑な推論の性能を上げる方法としてテスト時計算のスケーリングを追求する研究所、たとえば OpenAI は、モデルをより積極的に小さくするようになった。
合成データの生成。研究所は、コストのかかる合成データでモデルを学習させることにますます関心を寄せており、これもモデルを小さくする理由の一つになっている。合成データは、モデルのパラメータ数と学習データセットの大きさを増やすという通常の手段を超えて(言い換えれば、事前学習の計算量のスケーリングを超えて)、学習計算量をスケールさせる新たな道を開く。学習に使うトークンをインターネットのスクレイピングから得る代わりに、後で学習に使うトークンを自ら生成できる。AlphaGo が自己対戦によって、学習に使う対局を学習と同時に生成していたのとよく似ている。こうすれば、Chinchilla のスケーリング則による計算最適なトークン数とパラメータ数の比を保ちながら、学習トークンを生成する際に各トークンにはるかに多くの計算を詰め込める。つまり、モデルを大きくせずに学習計算量を増やせる。
フロンティアモデルは小さくなり続けるのか
手短に答えれば、おそらくそうはならない。ただし、近いうちに GPT-4 よりはるかに大きくなると予想すべきかどうかは、もっと判断が難しい。
Kaplan から Chinchilla のスケーリング則への移行は一度限りの効果なので、これがモデルを小さくし続けると予想する理由はない。GPT-4 の公開後に見られた推論実行需要の急増も、おそらく、近い将来に予想される推論実行への支出の伸びより速かった。テスト時計算のスケーリングと合成データの生成は、まだすべての研究所に十分に取り入れられたわけではないが、質の高い学習データがあったとしても、非常に小さなモデルで達成できることにはおそらく限界がある。
これに加えて、合成データやテスト時のスケーリングを考慮に入れても、ハードウェアの進歩が続けば、最適なモデルの大きさはおそらく大きくなる。大きさの異なる二つのモデルに同じ推論実行の予算を与えた場合、予算を増やしていくと大きいほうのモデルが優位になると予想されるからだ。小さなモデルは、長いコンテキストにわたって一貫性を失ったり、より難しい問題を解くのに必要な複雑なパターン認識の能力を欠いたりしうる。そのため、推論実行の予算が非常に限られているときには小さなモデルのほうが性能が良くても、推論計算を増やしたときの性能の伸びは悪くなる。
GPT-5 や Claude 4(あるいは Claude 3.5 Opus)に当たる次世代のモデルは、おそらく最初の GPT-4 の大きさに戻るか、わずかに上回るだろう。その後、フロンティアモデルの大きさが再び頭打ちになる時期が来るかどうかは何とも言えない。原理的には、現在のハードウェアでさえ GPT-4 よりはるかに大きなモデルを提供できる。たとえば、GPT-4 を50倍に拡大した約100兆パラメータのモデルなら、出力100万トークンあたり3,000ドル、毎秒10〜20トークンの出力速度でおそらく提供できる。ただしこれが成り立つには、そうした巨大なモデルが、使う顧客にとって大きな経済的価値を生み出さなければならない。
私の推測では、たとえ巨大なモデルがそれだけの経済的価値を生み出すとしても、ほとんどの顧客の予算は十分に小さいので、1兆〜10兆パラメータの範囲のモデルがテスト時計算のスケーリングを使って、100兆パラメータのモデルに勝つだろう。主な理由は、テスト時計算のスケーリングを度外視しても、100兆パラメータのモデルの費用は、やらせたい作業のために人間を雇う費用に近づきつつあると考えるからだ。とはいえ、これは推測にすぎず、あまり重きを置くつもりはない。
議論をまとめると、私の結論は次のとおりである。
-
次世代のモデル(おそらく来年前半に登場する)の大半が GPT-4 より多くのパラメータを持つ確率は約80%である。
-
これらの次世代モデルが最初に公開されたあと、その後の3年間でフロンティアモデルの大きさの拡大が10倍未満にとどまる確率は約60%である。これは、GPT-3 から GPT-4 への飛躍に比べて伸びが緩やかになることを意味する。