
ニュースレター
DeepSeek-R1の学習には何が投じられたのか?
原題:What went into training DeepSeek-R1?
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
2025年1月20日、DeepSeek は最新のオープンウェイト推論モデル DeepSeek-R1 を公開した。ベンチマーク性能では OpenAI の o1 と肩を並べる。この公開は大きな論争を呼んだ。とりわけ注目されたのは、DeepSeek がモデルの学習コストを過少に報告したり、偽って伝えたりしているのではないかという疑いである。私はこの主張はありそうにないと考えており、その理由を今回の記事で検討する。
学習コストの点とは別に、このモデルのアーキテクチャ、学習過程、性能、価格設定について、実際に何がわかっているのかも整理しておきたい。
Epoch AI の最新情報を受け取る 購読する
アーキテクチャ
DeepSeek R1 のアーキテクチャは、同社が2024年12月に公開した先行モデル DeepSeek v3 と同一である。このモデルのアーキテクチャの要点は2週間前の Gradient Updates の記事で取り上げたので、ここでは大まかな概要を簡単に述べるだけにする。
全体として、このモデルは非常に疎な混合エキスパート(MoE)モデルで、総パラメータ数は6,710億だが、トークンごとに活性化するのは370億にすぎない。エキスパートは2種類に分かれる。すべてのトークンが常にルーティングされる1個の「共有エキスパート」と、256個の「ルーティング対象エキスパート」である。後者は、処理される各トークンについて8個が活性化し、学習ではルーティングが偏らないように工夫されている。パラメータの大部分はルーティング対象エキスパートのMoEパラメータであり、HuggingFace にあるモデルの設定ファイルをもとに、次のような簡単な検算でこれを確かめられる。
ルーティング対象のMoEパラメータ数 = (MoEブロック数) * (ルーティング対象エキスパート数) * (エキスパートあたりのテンソル数) * (MoE中間次元) * (モデルの隠れ次元) = 58 * 256 * 3 * 2048 * 7168 = 6,530億
DeepSeek v3 はまた、マルチヘッド潜在アテンション(MLA)という新しい仕組みを使って、KVキャッシュのサイズを削減している。グループ化クエリアテンション(GQA)やマルチクエリアテンション(MQA)など、ほかの一般的な手法に伴う性能低下は生じない。その代わりに、デコード時のアテンションの演算コストが増える。そのため DeepSeek v3 は、長いコンテキストでの推論実行時に、メモリ律速ではなく演算律速になるという点で、他の言語モデルの中では珍しい存在になっている。アテンションの演算コストは、過去のコンテキスト長が5000トークン前後になると、パラメータの積和演算と同程度になる。たとえば Llama 3 70B では、これが起きるのはコンテキスト長が50,000トークン前後になってからである。
この手法を導入した DeepSeek v2 の論文のアブレーション実験では、GQA や MQA の代わりに MLA を使うことで大幅な性能向上が得られている。この結果をどこまで信頼できるかははっきりしないが、推論実行コストが比較的低いわりにベースモデルの品質が高いことに、これが寄与したのかもしれない。
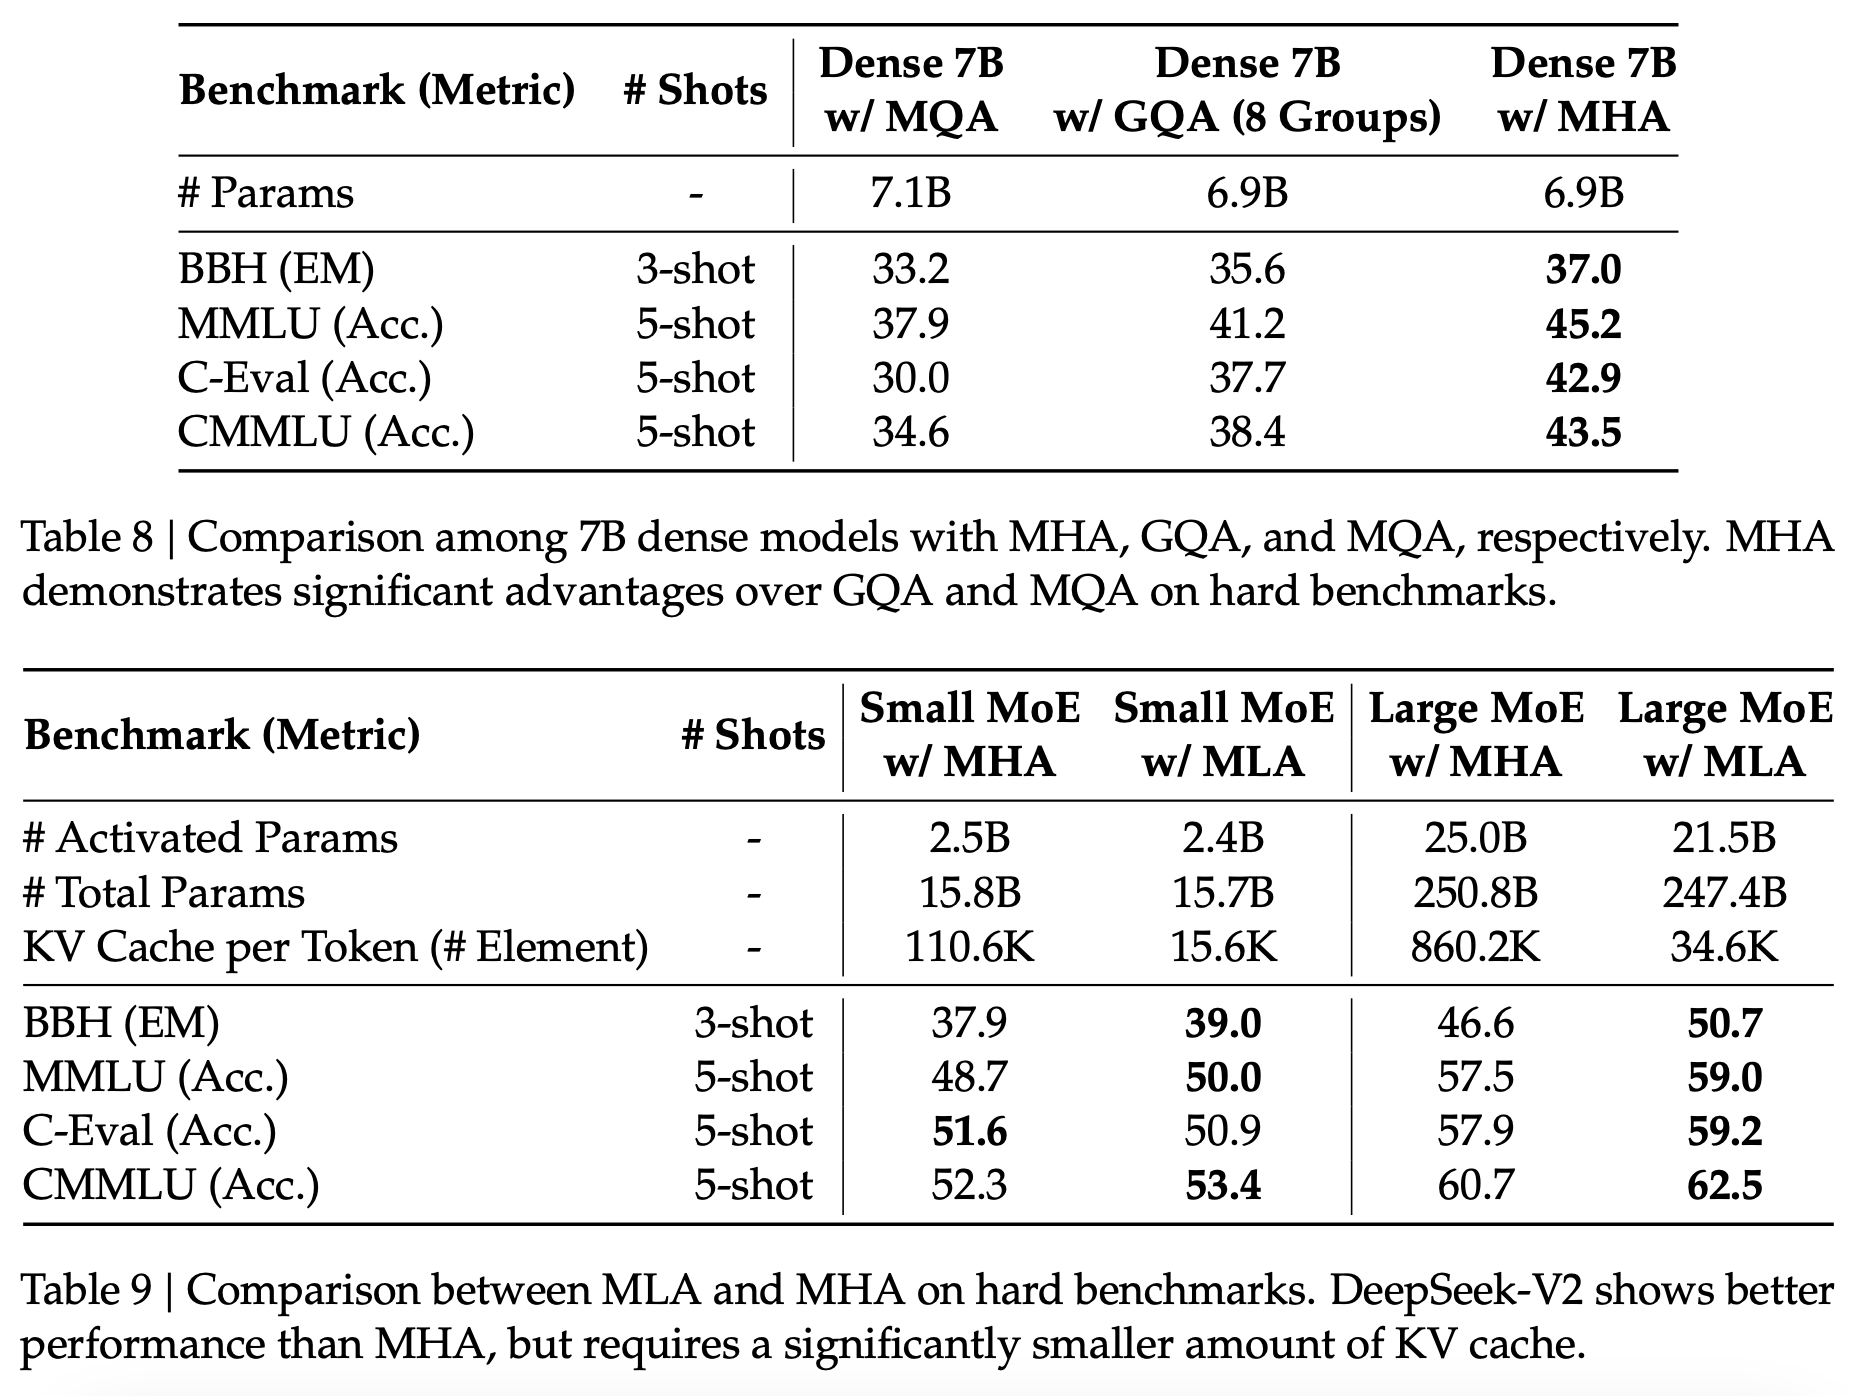
図1:DeepSeek v2 の論文にある、アテンション機構のアブレーション実験の結果。
こうした革新の多くはかなり前からあるものだ。たとえば MLA は、2024年6月に出た v2 の論文で導入された。V3 に対する R1 の本当の改良点は、強化学習を使って推論の性能を高めたことであり、これは次の節で取り上げる。とはいえ、ベースモデルのアーキテクチャは依然として重要である。強化学習は、もともと性能の高いベースモデルのほうがはるかにうまく機能するからだ。性能が高ければ、強化学習の初期の報酬シグナルがまばらになりにくい。したがって、DeepSeek が推論モデルの土台となる高性能なベースモデルをどうやって作れたのかを理解することは、やはり重要である。
学習
R1 をめぐる公の議論では、このモデルの学習における事前学習の段階と強化学習の段階がしばしば混同されている。そこでここでは、この二つの段階をはっきり区別しておきたい。
事前学習
DeepSeek r1 の事前学習にあたるのは DeepSeek v3 である。v3 の技術報告書は、モデルの学習方法について驚くほど詳しく書いている。2048基の H800 GPU からなるクラスタで FP8 混合精度の学習を行い、このクラスタで学習データ1兆トークンを処理するのに3.7日、つまり約18万 H800時間かかったという。また学習データセットの総量は14.8兆トークンだったとしており、ここから学習コストは約 14.8 * 180,000 = 266万 H800時間、H800の1時間あたりのコストを2ドルとすれば約530万ドルとなる。
これらの数字には驚くほど多くの懐疑の声が上がっているが、このアーキテクチャのモデルをこの方法で学習したと考えれば、むしろ高いくらいである。14.8兆トークンというデータセットの規模は妥当で、同程度の規模の他のモデルとも一致する。これが正しいとすると、このモデルの事前学習には 6 * (370億) * (14.8兆) = 3e24 FLOP が必要だったことになる。DeepSeek の学習クラスタが PCIe フォームファクタの H800 で構成されていると仮定すると、各GPUの性能は毎秒1.5e15 FP8演算であり、DeepSeek v3 の55日間の学習から導かれるモデルFLOP利用率(MFU)は約23%となる。
3e24 FLOP という数字が疑われてきた理由の一つは、同程度の資源で学習された他のモデルと比べて、このモデルの性能が際立っているように見えることだ。たとえば Llama 3 70B とその後継版は、学習に約2倍の計算量を要したが、ベンチマークでは DeepSeek v3 を大きく下回っている。性能の差の背後にあるのはアルゴリズムの進歩である。Llama 3 70B には、DeepSeek v3 の構築に使われた重要なアーキテクチャ上の革新の多くが欠けていることがわかっている。だから計算効率で劣るのは驚くことではない。データの品質の面で何が起きたかはあまりわかっていないが、その面でも DeepSeek が Llama シリーズを上回っていたとしても私は驚かない。
むしろ、モデルFLOP利用率がぱっとしないことを考えると、DeepSeek の学習をめぐる本当の謎は、なぜこれほど安かったのかではなく、なぜこれほど高くついたのかのほうである。わかりやすい答えは「MoEの学習は難しい」だが、これはかなり表面的で、実際の疑問には答えていない。そこで代わりに、この学習を高いMFUで取り回すのがなぜ難しいと予想されるのか、その理由を大まかな計算で示そう。
DeepSeek は学習に64ウェイのエキスパート並列を使った。この場合、ほとんどのエキスパートは互いに別々のGPUに配置される。そのため、連続する層のエキスパートの活性化に相関がないと仮定すると、ほぼすべてのトークンについて、MoEブロックに入るときと出るときにGPU間の通信が必要になる。この通信コストはどれくらいになるだろうか。
大まかに見積もると、各トークンは8個の活性エキスパートで処理されるので、7168次元の残差ストリームのベクトルを各活性エキスパートに送らなければならない。これがすべてのブロック、すべてのトークンで起き、活性化は16ビット精度なので、必要な活性化の読み出し量の合計は次のようになる。
16ビット * 8 * 7168 * 58 * 14.8兆 = 1e20 バイト
悲観的に、この通信はすべて InfiniBand 経由で行わなければならないとしよう。DeepSeek のクラスタでは、InfiniBand のGPUあたりの読み出し帯域幅はおそらく50 GB/sである。この場合、順伝播のMoEに入るときの通信だけで、必要な時間は次のようになる。
1e20 バイト / (2048 * 50 GB/s) = 11日7時間
これはかなりまずい。MoE後のオールリデュース(all-reduce)とオールトゥオール(all-to-all)の操作を考慮するとこれを数倍し、さらに順伝播だけでなく逆伝播も考慮するために2倍しなければならないからだ。こうした補正をすべて加えると、エキスパート並列の通信だけで55日を超える時間がかかってしまうことも十分ありうる。DeepSeek はこのことを認識しており、この問題に対処するためにいくつかの手を打っている。
-
エキスパート並列の通信と演算を効率よく重ね合わせ、通信時間の一部を隠している。
-
学習の設定を入念に調整し、各ルーティング対象エキスパートが活性化するのはトークンの約1/32だが、エキスパートどうしの活性化が互いに独立にならないようにしている。ネットワークトポロジー上で近くにあるエキスパートほど一緒に活性化しやすくなり、エキスパート並列の通信の多くが NVLink 上で行われるようになるので、上記の通信コストが大幅に削減される。
H800 の NVLink は H100 より遅い(オールリデュースの帯域幅が H100 の225 GB/sに対して約100 GB/s)。それでも InfiniBand より4倍速いはずなので、これがうまくいけば大きな成果になる。
ハードウェアの最適化にこれほど目覚ましい努力を払っても、MFUを23%までしか上げられなかったことは、実際にMoEモデルを学習するのがいかに厄介かを物語っている。MoEの推論実行を取り上げた以前の記事でも論じたように、MoEモデルは現実には、演算量だけに基づく机上の計算が示すよりもかなり効率が悪い。
R1-Zero の強化学習
次に、r1 の論文自体の貢献に移ろう。ベースモデルの v3 を推論モデルに変える強化学習である。この論文は v3 の技術報告書ほど詳しくはないが、それでも強化学習の段階にどれだけの計算量が必要だったはずかを推し量るのに十分な情報が載っている。
DeepSeek-R1 の中核となる、推論に基づく強化学習のループ(チェックポイント DeepSeek-R1-Zero を生み出すもの)は次のようなものだった。
- B個の質問からなるバッチをサンプリングする。それぞれについて、モデルはG通りの回答の続き(completion)を生成する。生成をいつ終えるかはモデルが決めるが、強化学習全体を通じた各回答の平均の長さをLとしておく。
- 各回答 i = 1, 2, …, G に報酬 r_i を割り当てる。これはルールに基づいて行う場合もあれば(コードならユニットテスト、数学の問題なら最終的な答えの正誤チェックなど)、別のLLMを使って回答を採点する場合もある。
- G個の報酬から平均を引き、標準偏差で割って正規化する。
- 次に、期待報酬の代理目的関数についてKステップの勾配上昇を行い、モデルが報酬の高い回答を出しやすく、報酬の低い回答を出しにくくなるようにする。G個のロールアウトは、現在のモデルから大きく離れた方策の振る舞いについてはあまり良い手がかりにならないので、目的関数では現在の方策から離れすぎることにペナルティを課す。
- 以上の過程をN回繰り返す。この強化学習アルゴリズム全体はグループ相対方策最適化(GRPO)と呼ばれ、より広く使われている PPO の安価な代替として、DeepSeek が以前の研究で導入したものである。
このように過程を分解すると、強化学習の第1段階のFLOPコストを大まかな式で表すのは簡単である。通常なら、順伝播と逆伝播を合わせてトークンあたり・パラメータあたり6 FLOPと仮定すればよいが、DeepSeek v3 のアテンション機構は演算量が際立って多いため、このコストが上がる。強化学習で使われた平均コンテキスト長 L = 4000 では、デコード時のアテンションのFLOPがパラメータのFLOPと同程度になる。そのため平均すると、活性パラメータあたり・生成トークンあたり2 FLOPではなく4 FLOPを費やすことになる。このコストを払う必要があるのは、各探索段階の後の最初の勾配ステップだけである。後続のステップでは、すでにサンプリングした軌跡を使うからだ。
誤差逆伝播のステップも影響を受けるが、この影響はそれほど問題なく無視できることがわかる。各ステップは長い系列長にわたって行うので、キーとバリューのベクトルを潜在表現から展開し、順伝播とは別の計算グラフを通して逆伝播する余裕がある。これによっていくらか追加のコストがかかるが、大きくはない。したがって、誤差逆伝播には通常どおり活性パラメータあたり・トークンあたり4 FLOPのコストがかかると近似的に仮定できる。
DeepSeek v3 の活性パラメータ数370億を考慮すると、最終的な見積もりは次のようになる。
推論の強化学習の計算コスト = N * B * G * (Lトークン) * (370億パラメータ) * (8 FLOP/パラメータ/トークン) +
N * (K-1) * B * G * (Lトークン) * (370億パラメータ) * (6 FLOP/パラメータ/トークン)
論文には、この計算に入る主要なパラメータについての情報がある。
-
N*K は強化学習全体での勾配ステップの総数で、論文のさまざまな図から約8000だとわかる。以前の研究で DeepSeek は K = 1 を使っており、その場合は N = 8000 となる。
-
論文の図3を見ると、これらのステップを通じたLの平均値は約4000だと推し量れる。
-
BとGはこの論文では明示されていないが、以前の研究で DeepSeek は B = 1024、G = 64 を使っていた。ここが私の計算で最大の不確実性の源である。たとえば、DeepSeek が R1 では B = 512 を使っていた可能性も十分にあり、その場合ここでのコストの見積もりはすべて2倍高すぎることになる。
ひとまず B = 1024 で進めるが、結果を解釈するときにはこの点を念頭に置いておくことが重要である。
以上をすべて組み合わせると、推論の強化学習の初期段階のコストは最終的に6.1e23 FLOPと見積もられる。強化学習の段階のMFUが事前学習と同程度だったとすれば、約100万ドルである。これは DeepSeek v3 自体の事前学習の演算コストを大きく下回る。GPU時間で測った強化学習のコストが事前学習のコストと同程度になるだけでも、強化学習中のMFUが事前学習の5分の1、つまり約5%でなければならない。
このような低いMFUがありうるかどうかを確かめるために、強化学習の段階にどれくらいの時間がかかったかを見積もることができる。逐次的に生成されたトークンの総数は約 N * L で、DeepSeekMath の論文に基づいて K = 1 とすれば3,200万になる。DeepSeek は R1 の推論実行をリクエストあたり毎秒約50トークンで提供しており、この速度なら3,200万の逐次トークンは7〜8日で生成できる。これは十分に短いので、DeepSeek の強化学習の設定では逐次処理の時間の制約が問題になるとは考えにくい。つまり毎秒50トークンで十分な速度である。興味深いことに、この速度は、2048基の H800 のクラスタが DeepSeek v3 の事前学習と同程度のMFUで動いていた場合に演算として必要になる量とも一致している。
この速度で、強化学習のうちトークン生成の部分にはどれくらいのコストがかかっただろうか。強化学習の段階全体で生成すべきトークンは合計 N*B*G*L = 2兆トークンである。DeepSeek の V3 の当初の割引前のAPI価格は出力100万トークンあたり1.1ドルだったので、コストは多くても (2兆トークン) * (100万トークンあたり1.1ドル) = 220万ドルのはずである。現在の割引価格である100万トークンあたり0.3ドルなら、この見積もりは60万ドルまで下がる。誤差逆伝播のコストも考慮すれば、先の100万ドルという見積もりとおおむね一致する。
以上のことから、強化学習のコストを事前学習のコストと同程度にするのに必要な極端に低いMFUは非現実的であり、生のFLOPコストから導ける結論はおおむね正確だと考えられる。
R1 のその後の学習
R1-Zero を生み出す強化学習のループは推論の学習の中核だが、最終的な R1 モデルが学習されるまでのステップはそれだけではない。DeepSeek はこのチェックポイントをもとに、コールドスタート用のデータセット(一部に整えた R1-Zero の出力を含む)を用意してベースモデルの v3 をファインチューニングする。その後、R1-Zero を生み出したのと同様の強化学習の段階をもう一度行う。このコールドスタートによって、強化学習の初期の不安定さが防がれ、モデルの出力と思考の連鎖(chain-of-thought)が人間に読めるものになる。この2回目の強化学習の段階について、論文の記述はあまり詳しくない。だが保守的に見るなら、1回目と同程度のコストがかかったと仮定し、それを考慮して当初のコスト見積もりを2倍にすればよい。
これが終わると、DeepSeek は最後のチェックポイントから得た約60万件の推論サンプルと、v3 自体の事後学習に使われた20万件のサンプルとで教師ありファインチューニング用のデータセットを作る。そして、このデータすべてで v3-base を2エポックにわたってファインチューニングする。サンプルあたりの平均の長さが約8Kだとすると(これは R1-Zero が学習の終わりに達する長さと一致する)、このSFTデータセットは合計 80万 * 8K = 64億トークンとなり、ファインチューニング自体のコストは無視できるほど小さい。このステップが興味深いのは、推論の過程を記録したトレースで限られた量のファインチューニングを行うだけで、ベースモデルを有能な推論モデルに変えられることを示している点だ。OpenAI のような研究所が推論のトレースを秘密にしておきたがるのも、これで説明がつく。
全体として、V3 から出発して R1 を学習するのに投じられたGPU時間のドル換算コストは、おおよそ100万ドル程度と見積もるのが妥当だと私は考えている。これに、V3 自体の事前学習に投じられた500万ドルが加わる。先の100万ドルという数字を単純に2倍にしないのは、B = 1024 という選択が正しいのか、2回目の強化学習の段階が本当に1回目と同じコストだったのかがわからないからだ。合計100万ドルという見積もりなら、上下どちらの方向に外れる可能性もほぼ同じくらいだと思うので、この数字を採るのが妥当だろう。
最後に付け加えると、これらの数字はすべて、実験の計算コスト、人件費、管理上の間接費などを無視している。あくまで、上で詳しく述べた意味で R1 の学習に投じられた学習実行のハードウェア時間のコストである。
性能と価格設定
DeepSeek-R1 は、両方のスコアがわかっているベンチマークでは、OpenAI の o1 と同程度の性能を持つようだ。DeepSeek が両モデルの結果を示している11のベンチマークのうち、o1 が R1 を上回っているのは6つで、これはほぼ互角と言ってよい結果である。研究所が自社モデルのベンチマークスコアを公表するときにはいつもの公表バイアスがあるので、総合的な性能ではやはり o1 のほうが R1 より上だと私は考えている。しかしその差は大きくなく、ほとんどの用途では両モデルは同程度のはずだ。
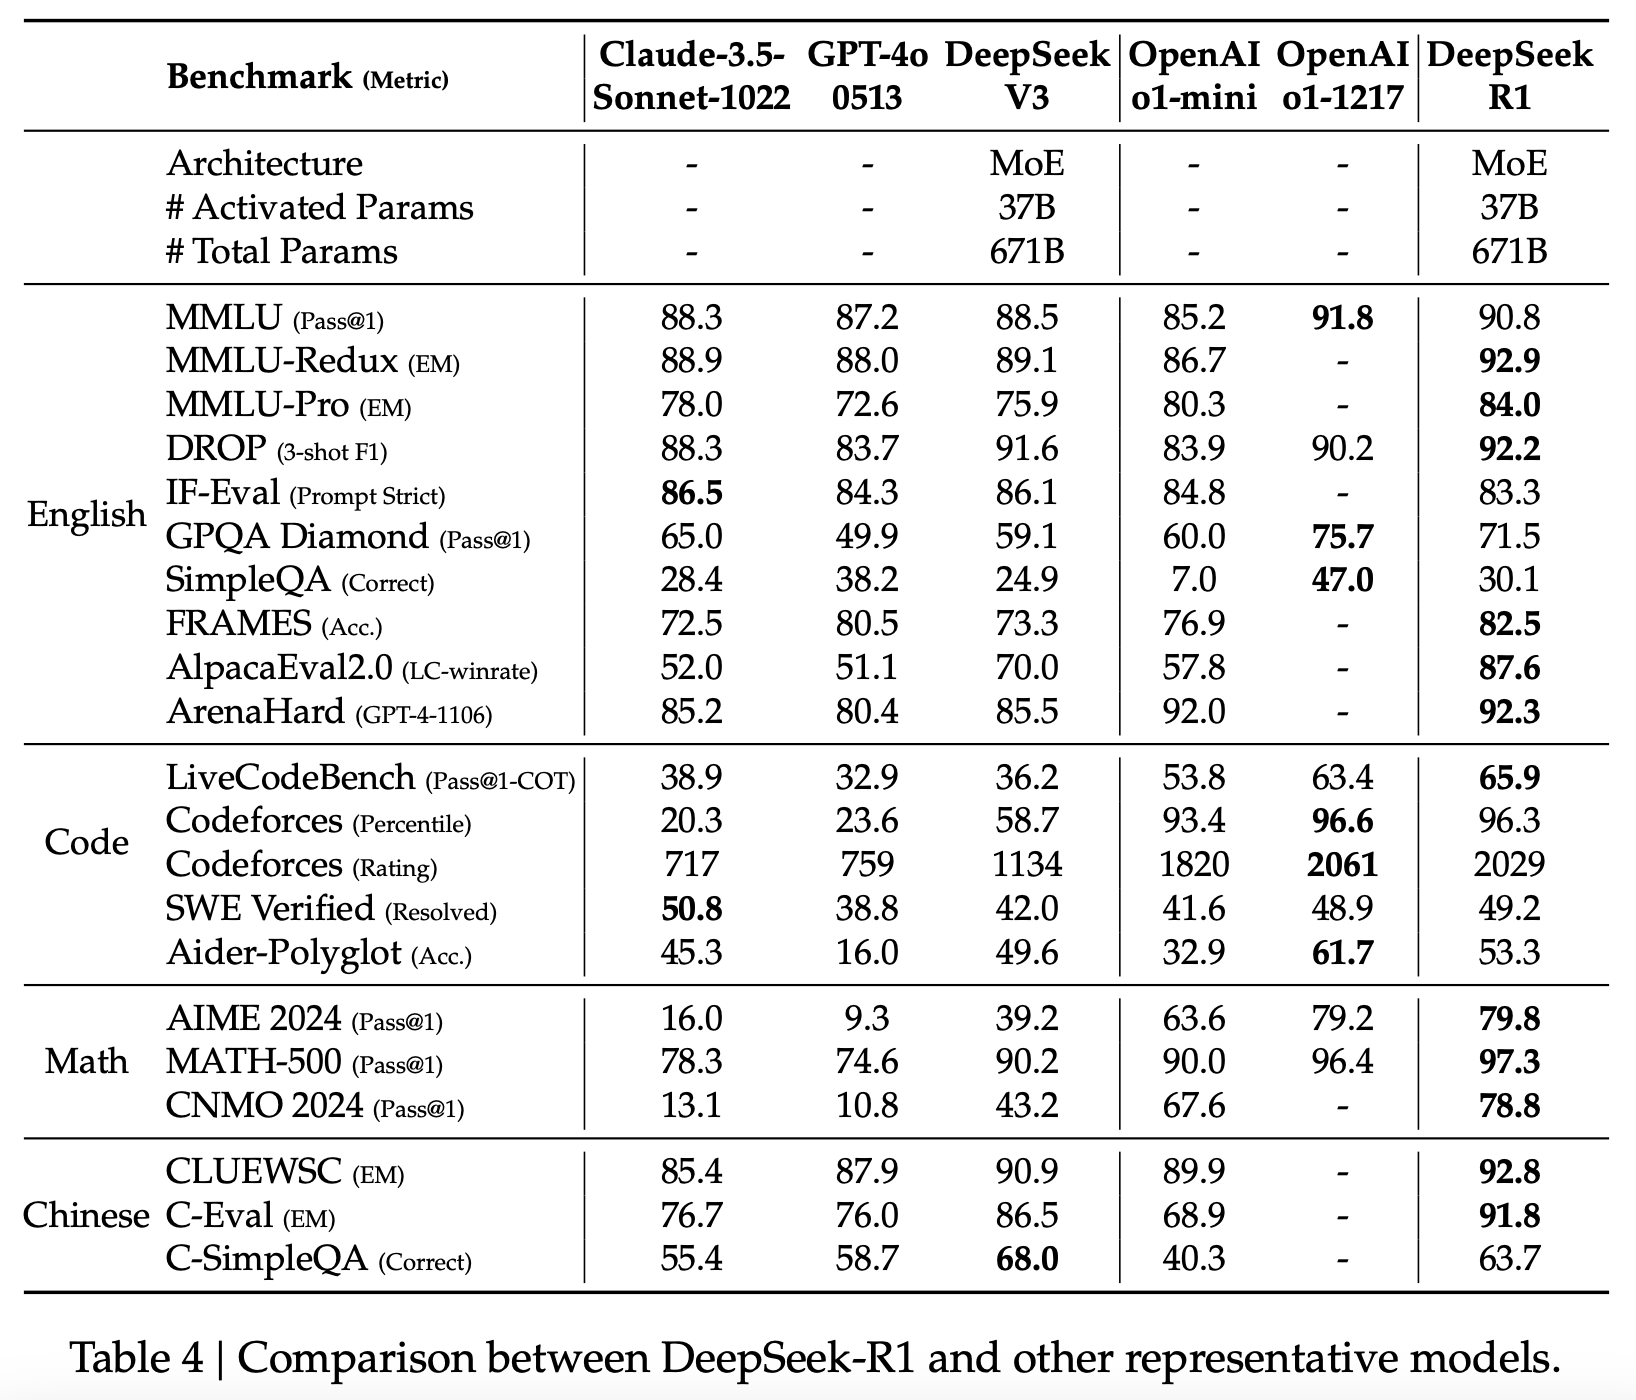
図2:DeepSeek-R1 と他の代表的なモデルを比較した表。DeepSeek R1 の技術報告書より。
しかし、両モデルの性能の差は小さくても、価格の差は決して小さくない。R1 の価格は出力100万トークンあたり2.2ドルで、o1 の出力100万トークンあたり60ドルと比べると格段に安い。しかも R1 は推論実行も遅くない。この大きな差を考えると、利用者にとっての価格で調整すれば、R1 は o1 よりもはっきり優れたモデルである。
この差は、R1 がモデルとして本質的に効率が良いから生じているのではないと思う。むしろ、OpenAI が大きな利ざやをとっているのに対して、DeepSeek はごくわずかな粗利益でモデルを提供しているからだろう。R1 のほうが推論のトレースが平均して短い可能性もあるが、こちらはそれほどはっきりしない。DeepSeek や他の中国の研究所とのコスト競争が、米国の研究所のAPIの利益率にどの程度影響するかはまだわからないが、米国の研究所にとって良い知らせではないと思う。
結論
今回の記事から読者に持ち帰ってほしい主な点は次のとおりである。
-
R1 の公開を機に DeepSeek のモデルへの世間の関心は爆発的に高まったが、技術的な観点から見れば、R1 の成功を支えた要素の大半は、DeepSeek が2024年に少しずつ開発してきたものである。この強化学習の設定を機能させるうえでの難しさの大半は、v3 のような高品質で安価で高速なベースモデルを用意することにある。
-
DeepSeek が報告した v3 のクラスタ規模と学習コストの見積もりは、v3 のアーキテクチャを持つモデルの事前学習として予想されるものと一致しており、コストを過少に報告している証拠はない。
-
DeepSeek は DeepSeek-R1 に投じた強化学習のコストについて明言していないが、論文で開示された情報に基づけば、約100万ドルと私は見積もる。
-
DeepSeek-R1 は、OpenAI が API で提供している最良版の o1 とほぼ同等でありながら、利用者にとっては約30分の1の安さである。この差はおそらく主に OpenAI の大きな上乗せ幅によるものだが、一部は R1 が単に効率の良いモデルであるためだという可能性も排除できない。
私の最善の推測では、ソフトウェアの効率の面で DeepSeek は依然として OpenAI や Anthropic のような米国のフロンティア研究所に後れをとっている。しかし、その差は大きくない。ベースモデルの DeepSeek v3 をフロンティア研究所のモデルと比べた限りでは、DeepSeek の遅れは約6か月だと私は見積もる。加えて、DeepSeek はモデルを限界費用に近い価格で提供する姿勢をとっているので、全体として利用者にとってはるかに魅力的な選択肢になっている。