
ニュースレター
長いコンテキストでの推論実行がもたらしうる大きな影響
原題:The huge potential implications of long-context inference
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
数字の上では、現代の大規模言語モデル(LLM)は本何冊分ものテキストを一度に読み込める。たとえば Gemini 2.5 Pro の「コンテキストウィンドウ」は100万トークンあり、『ハリー・ポッターと賢者の石』を10冊分詰め込める。1 では、はるかに長いコンテキストで推論実行(インファレンス)を大量に行えるとしたらどうだろう。LLMが100億トークンのコンテキストを受け取れ、しかもそれを実用に耐える形で使えるハードウェアとアルゴリズムがあったとしたら?
すぐ思いつく使い道は、ますます長い文書を読み込めるようになることだ。しかし私たちは、長いコンテキストでの推論実行がもたらす影響はそれよりずっと大きくなりうると考えている。
- モデルの展開後も新しい知識を学び続ける能力に、攻め口を与える。この能力の欠如は、現在のAIシステムが現実世界で役に立つうえでの最大のボトルネックの一つである。
- 強化学習(RL)の大幅なスケーリングを支える。より多くの推論を行うこと、モデルの出力を検証すること、質の高いRL環境を生成することに使える。
- ただしボトルネックもある。RLの実行が長くなるにつれて、研究の試行錯誤のサイクルは遅くなる。また、長いコンテキストでの推論実行が法外に遅く高価にならないよう、ハードウェアとアルゴリズムの大きな進歩も必要になる。
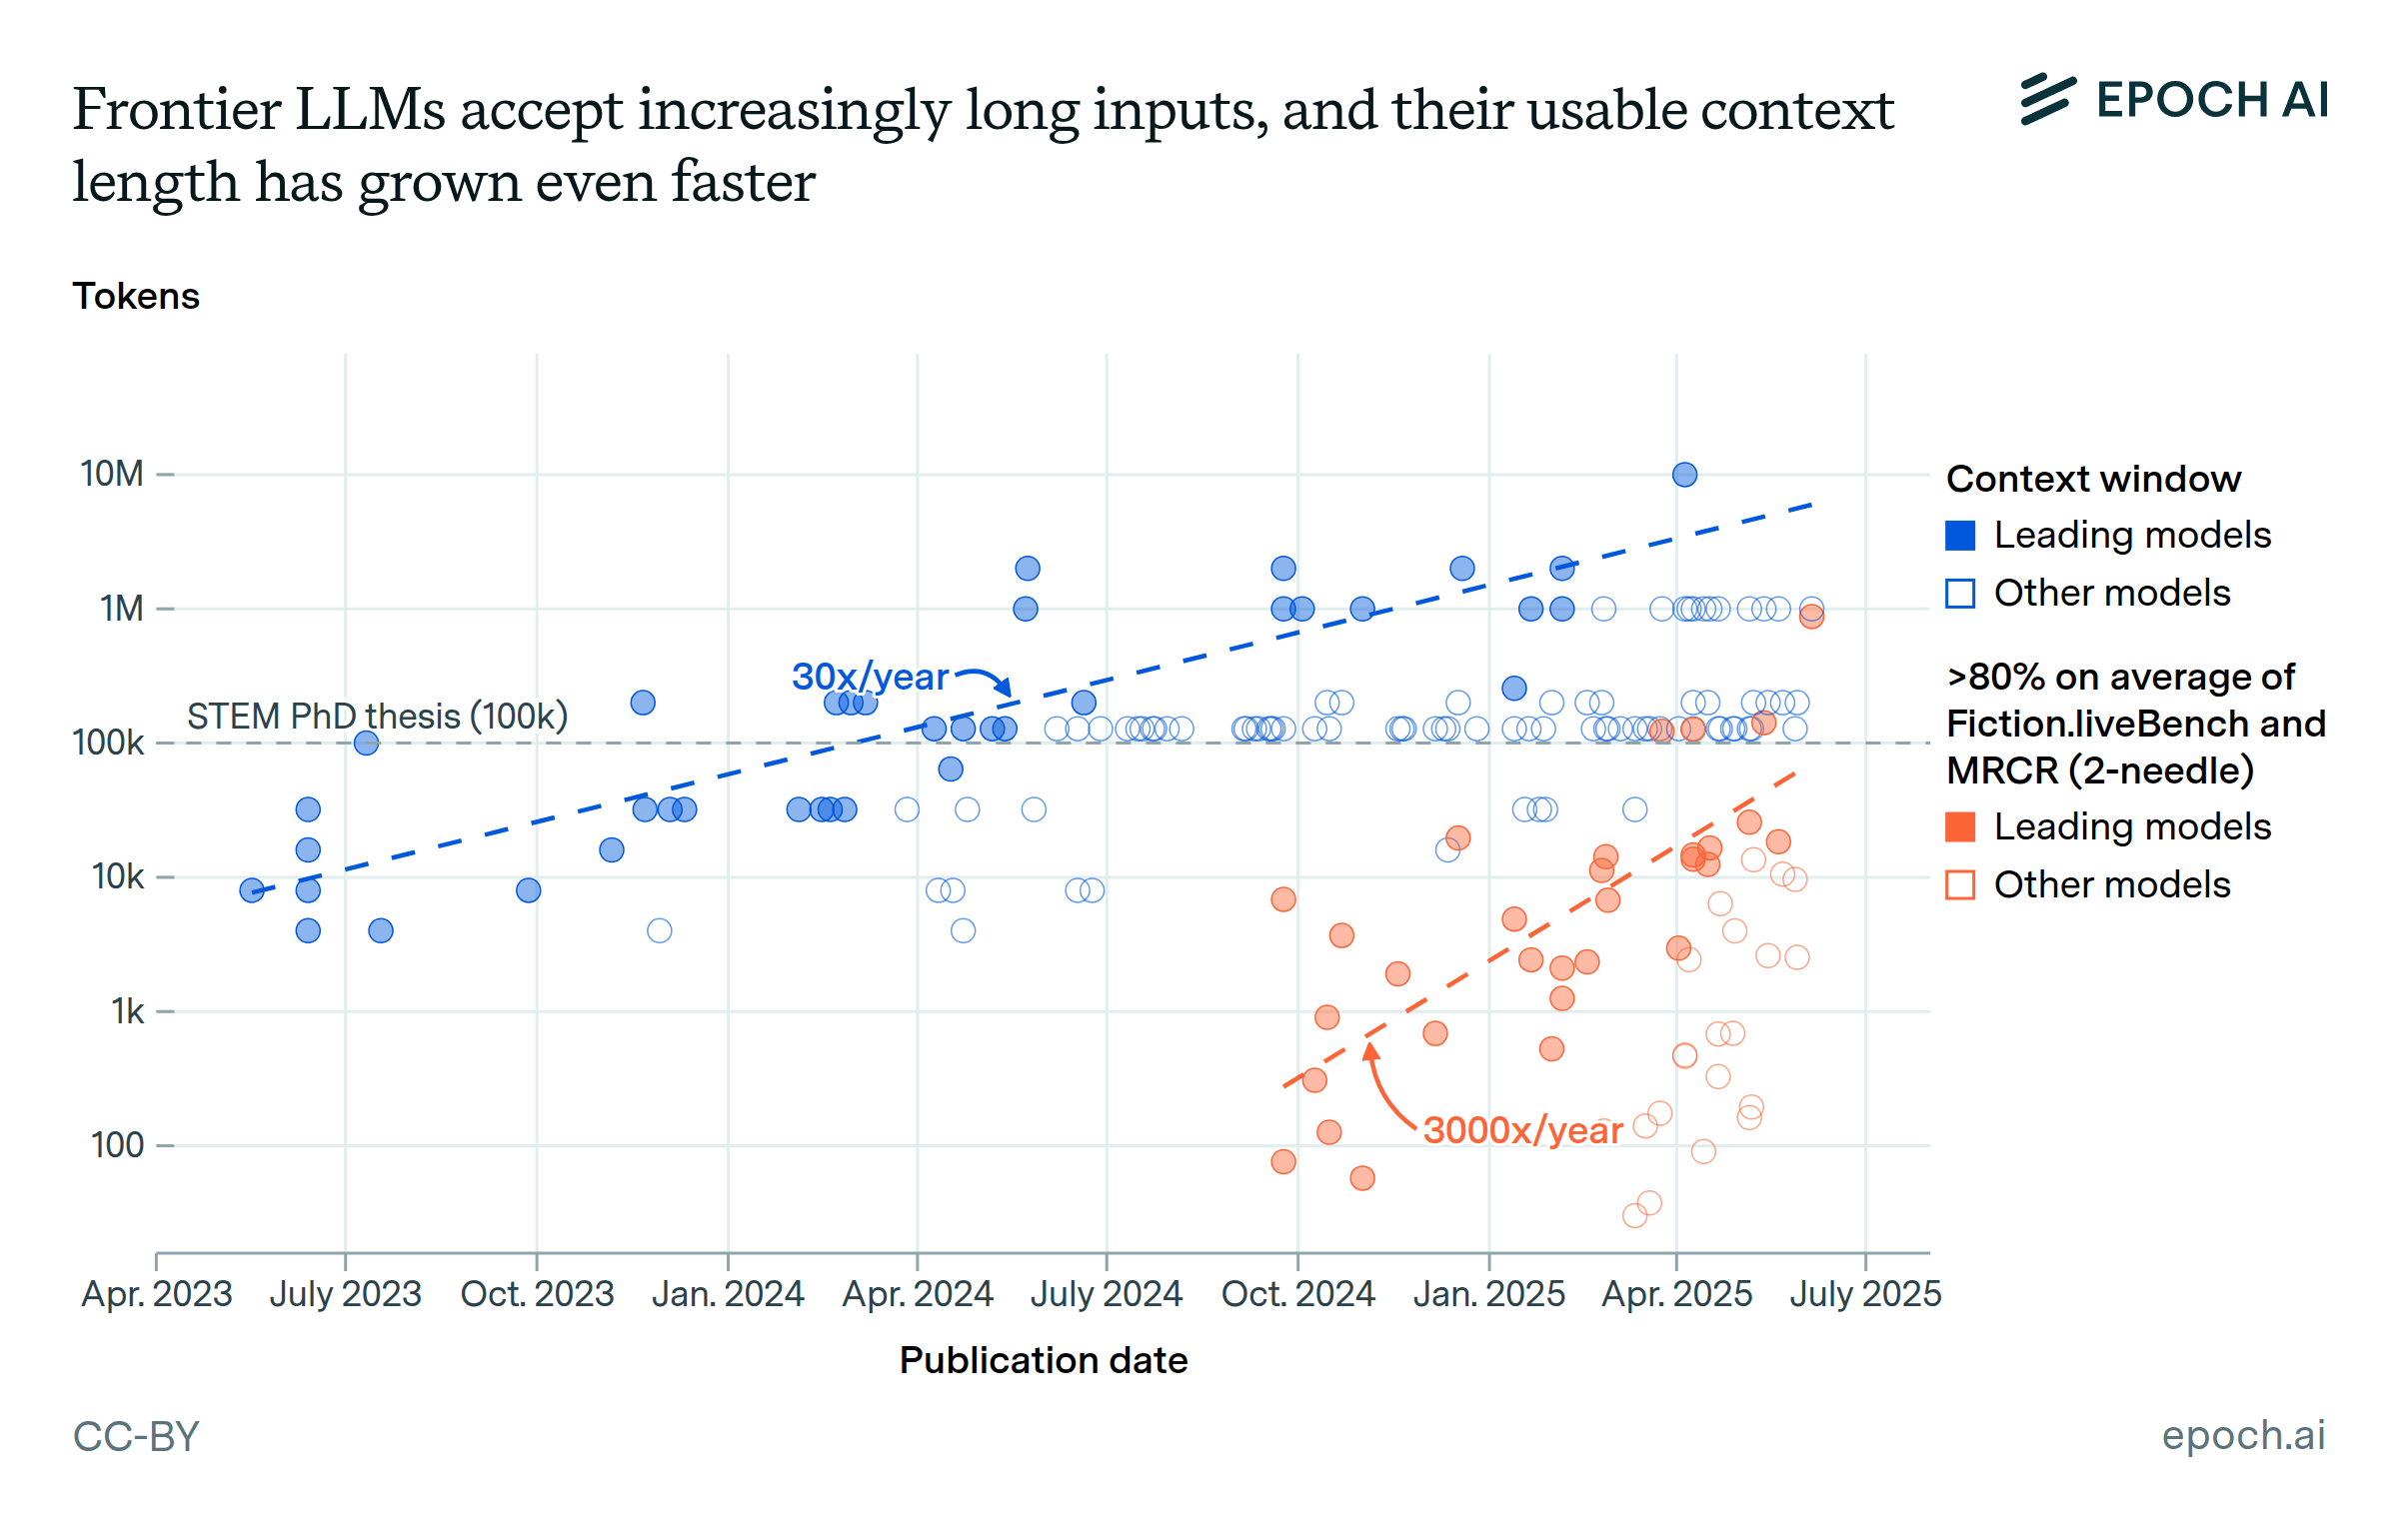
しかも、コンテキスト長は年30倍のペースで伸びており、フロンティアLLMはそのコンテキストを使いこなすのがずっと上手になっている。したがって、こうした傾向がこのペースのほんの一部ででも続けば、これらの大きな影響はごく近いうちに現実になりうる。
Epoch AI の最新情報を受け取る 購読する
極めて長いコンテキストでの推論実行は、継続学習への攻め口になる
本当の意味で経済的に役立つためには、LLMにはおそらく「継続学習」、すなわち時間をかけて知識を獲得し続ける能力が必要になる。2 たとえば、AIシステムが失敗から学んだり、研究の勘を養ったりするうえで、この能力は欠かせない。ところが現在のLLMには、長い対話の間や、ユーザーとの複数回のやりとりをまたいで保持できる「記憶」がほとんどない。
問題の一端は、LLMのコンテキストウィンドウが、継続学習を十分に支えられるほど長くないことにある。たとえば作業履歴をスクリーンショットで記録するなら、100万トークンのコンテキストでは、AIエージェントがコンピュータ上の作業を最大30分ほど行う分にしかならない。暗黙知を身につけるにはまるで足りない。3 しかしコンテキストが長くなれば、できることはずっと増える。1,000万トークンならコンピュータ操作およそ6時間分になり、100億トークンなら8か月分にもなる! もっと楽観的に、テキストと音声のトークンだけで作業経験を表せるとすれば、約4,000万トークンでも数か月分の「実務経験」を身につけるのに足りるかもしれない。4
そしてこうした長いコンテキストが使えるなら、モデルはコンテキストウィンドウ内の過去の事例から学べる。たとえば推論モデルは、思考の連鎖(chain of thought)の中で自分の誤りを正す能力をある程度示している。こうして学んだ修正をコンテキスト内に保持しておけば、将来モデルが問題を解く助けになりうる。
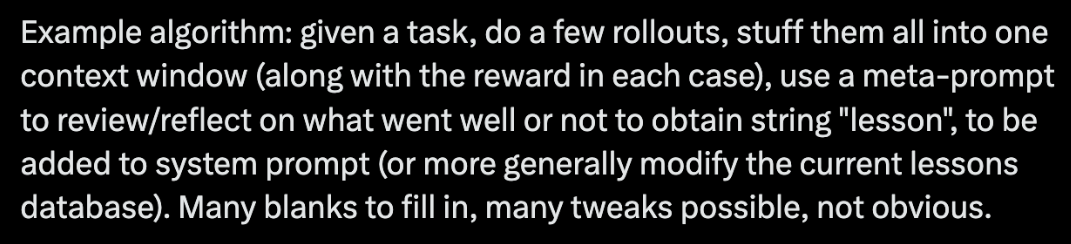
「巨大なコンテキストウィンドウとコンテキスト内学習による継続学習」というこの大まかなアプローチは、これまでに何度か提起されてきた。たとえば Aman Sanger は Cursor のチームとの議論でこれに触れているし、Andrej Karpathy も X でその仕組みの見取り図を示している。
とはいえ、このアプローチには異論もありうる。暗黙知は、過去のコンテキストをテキストで要約した形では保存しにくく、作業のやり方についての豊かな情報があまりにも多く失われてしまう、という反論だ。これには確かに一理あるが、だからといってこのアプローチが成り立たなくなるとは限らない。
一つには、現在のモデルより何桁も大きなコンテキストウィンドウがあれば、コンテキストを大いに最適化できる可能性がある。それで、過去の経験を非可逆に圧縮することに伴う課題を乗り越えられるかもしれない。たとえば、数か月分の作業コンテキストに相当する量を保存できるLLMがあるとしよう。これを「スリープタイム計算」と組み合わせることができる。モデルが(場合によっては予定された)空き時間を使い、最近の利用で得た新しい情報とのつながりを形成して学習するというものだ。こうして得られる学習済みのコンテキストは、大量の推論計算とRLで徹底的に最適化され、極めて効率的なものになりうる。大量のRLによって、現在のモデルのコンテキストの使い方はすでに大きく改善されており、次節で見るように、改善の余地はまだ大いにある。
情報をテキストの形で保存することが問題なのであれば、長いコンテキストを、いま活発に研究されている別のアプローチと組み合わせることもできる。一つには、トークンを複数の異なるモダリティに共通する表現として使える。あるいは、過去の知識を密に表現する学習済みのKVキャッシュの中に暗黙知を保存できるかもしれない。単純なテキスト要約よりずっと優れた表現になるだろう。
とはいえ、こうした手法が実際にうまくいくかどうかは、名目上のコンテキストウィンドウを大きくするだけでは決まらない。より関連性の高いコンテキスト(たとえば最近の作業上のやりとりすべて)をデジタル化してLLMと共有できるように、基盤を整える必要もある。
私たちはまた、実際にコンテキストをどれだけうまく使えるかも重視している。名目上は100万トークンのコンテキストウィンドウを持つモデルでも、それよりずっと短い入力で支離滅裂になり始めることがある。たとえば Vending Bench というベンチマークでは、モデルは自動販売機を運営して利益を上げるという単純な商売の作業をこなさなければならない。ところがモデルは、名目上のコンテキストウィンドウが埋まるよりずっと前に「脱線」して、大金を失うことがある。LLMを実際に使っていても同じことが見られる。長い会話の中でモデルが過去の誤りに引きずられすぎ、ユーザーは新しいチャットで一からやり直すしかないと感じてしまうのだ。
長いコンテキストでの推論実行を大量に行えれば、RLをさらにスケールできる
長いコンテキストウィンドウ全体にわたってモデルの一貫性を保つ方法の一つは、RLとテスト時計算のスケーリングという現在のパラダイムを続けることだ。たとえば、ある程度エンドツーエンドのRL学習を使うことが考えられる。この手法は OpenAI の Deep Research のような製品で、それなりの成功に貢献してきた。こうすると、ユーザーの問い合わせに長く応答する間、モデルが一貫性を保てるよう促す学習信号が得られる。
長いコンテキストでの推論実行を大量に行えることは、このRLスケーリングの継続も支える。理由の一つは、より長いロールアウトが可能になることだ。コンテキストウィンドウが大きければ、完了に時間のかかるタスクに対して、モデルにより長い推論の過程を出力させられる。
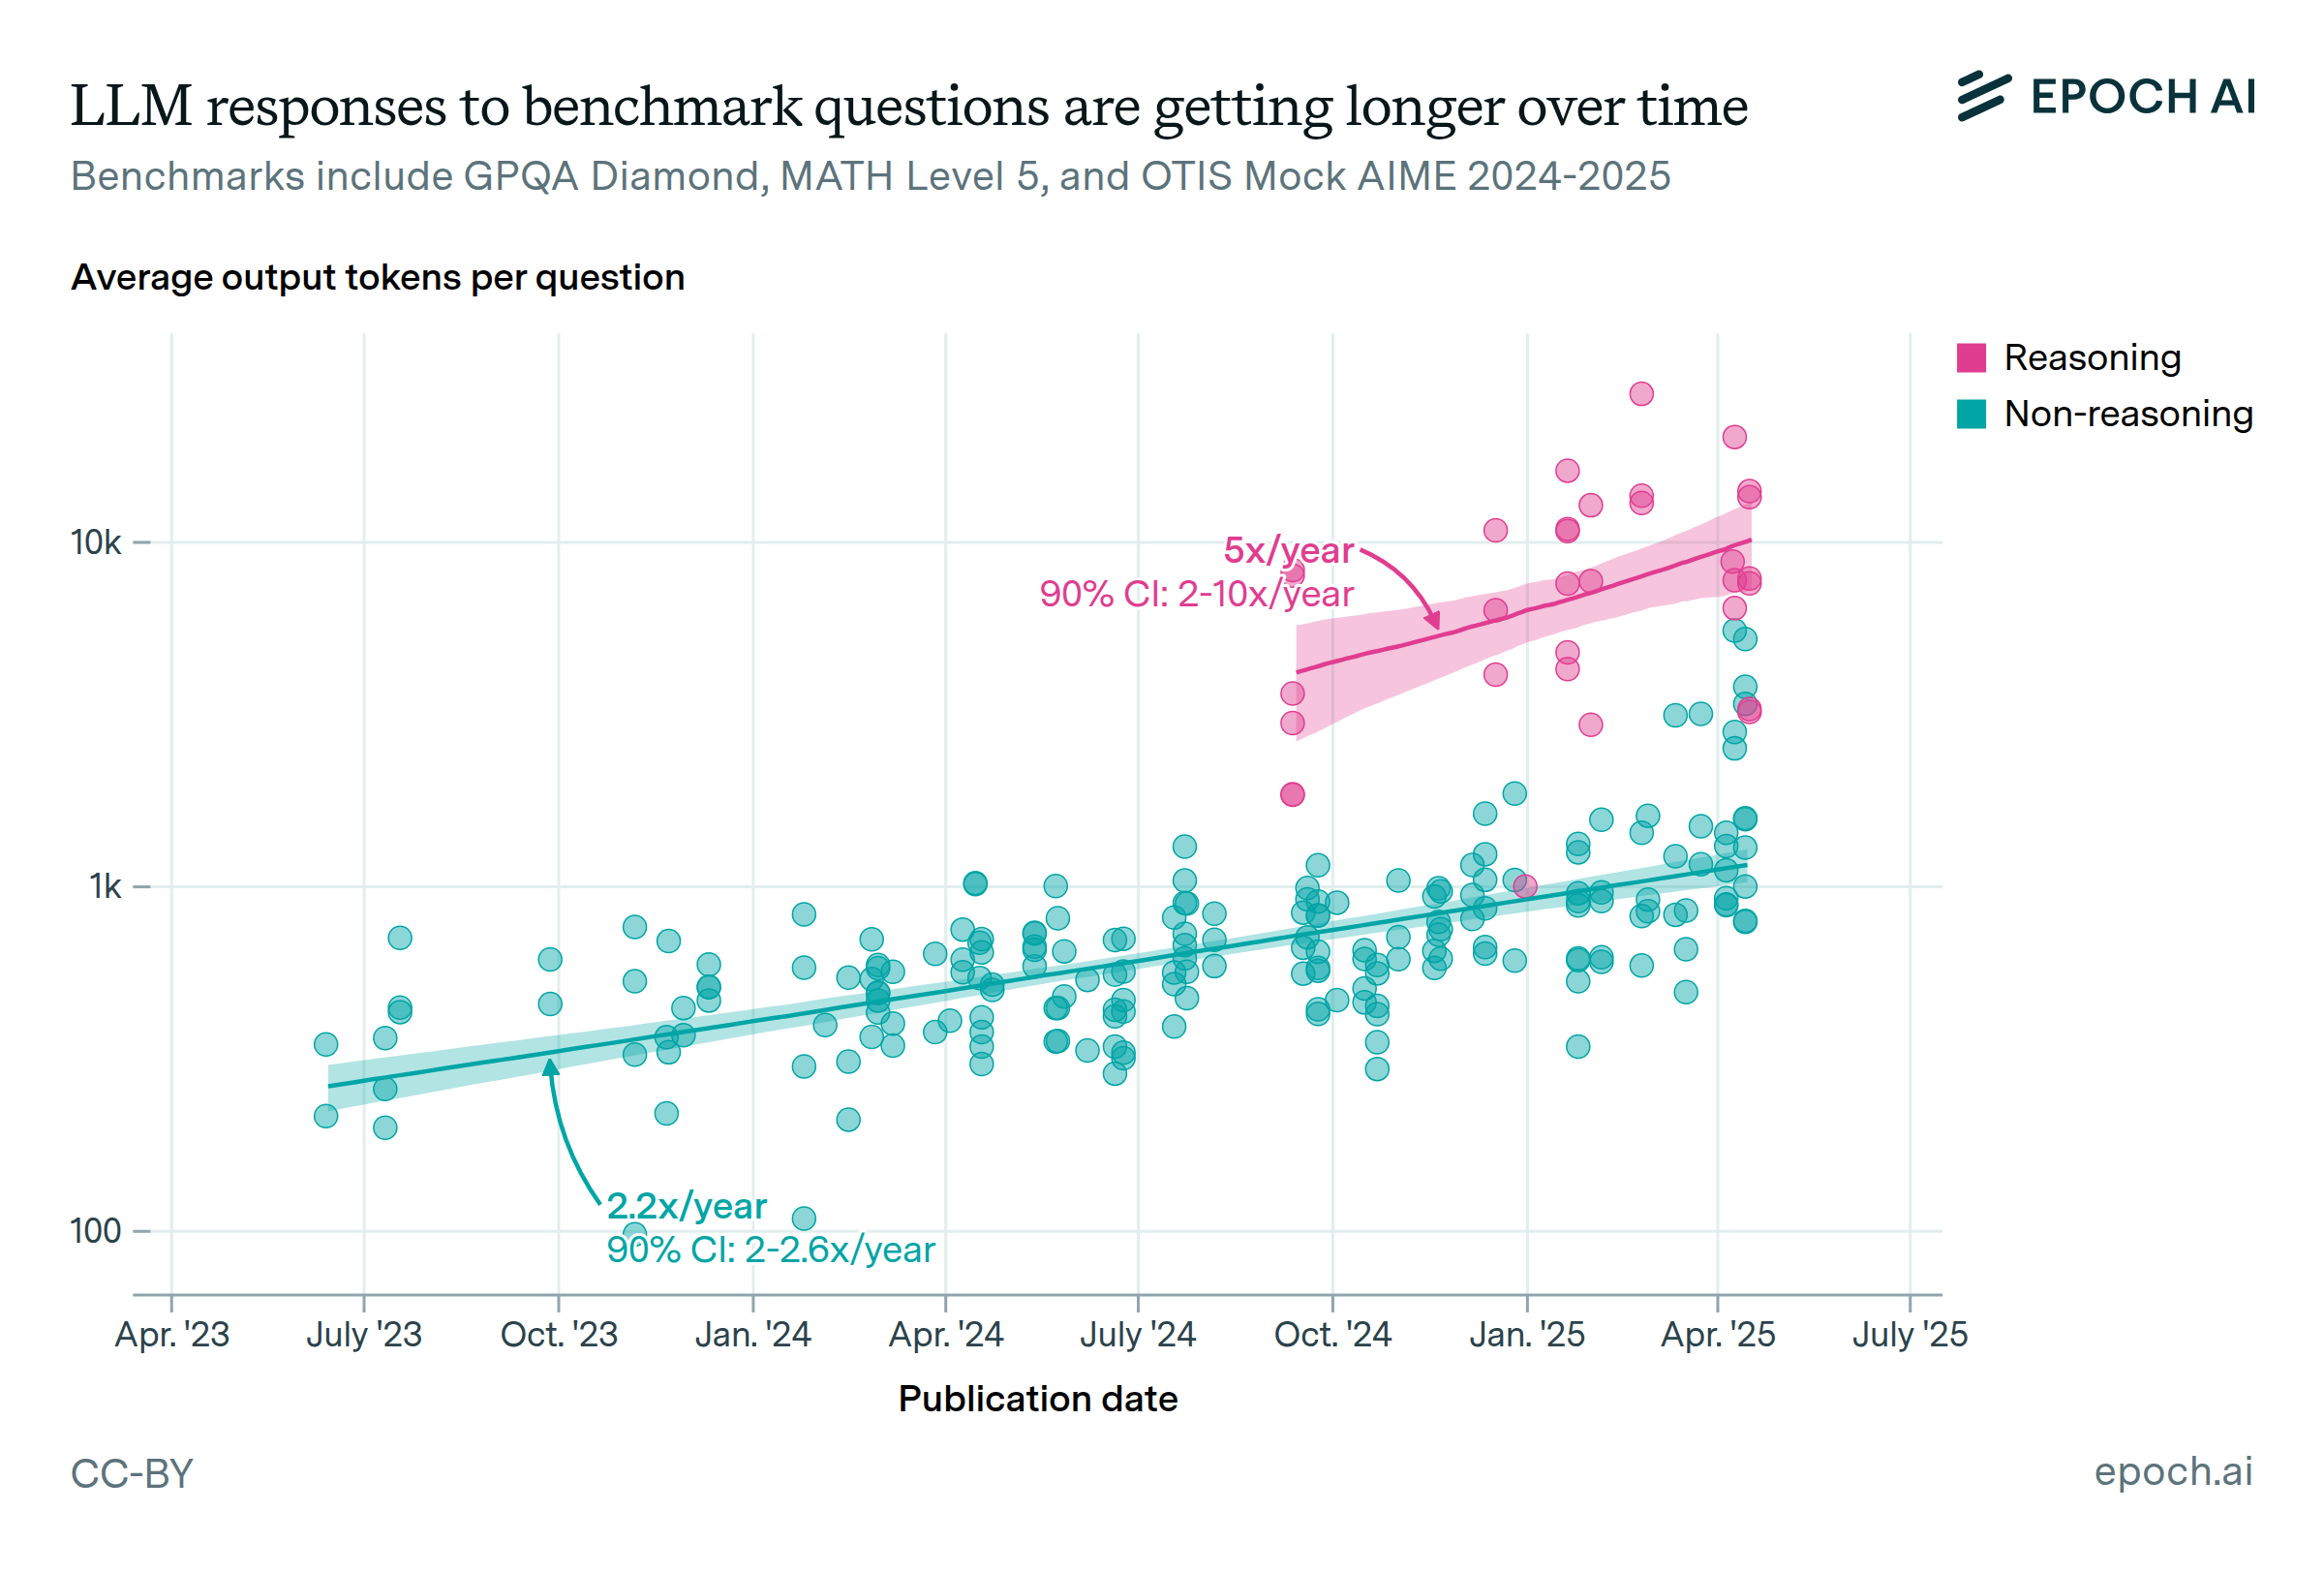
ベンチマークの問題に対するモデルの応答は時とともに長くなっており、通常RLで学習される推論モデルでは特にそうである。これにより、長いコンテキストでの推論実行の需要が高まる。
LLMがより長く複雑なタスクに適用されるにつれ、報酬が疎になる問題、つまりモデルが自分の出来について明確なフィードバック信号をまれにしか得られないという問題に、ますます直面するかもしれない。たとえば、AI研究開発で研究の方向性を選ぶ場面がこれに当たるだろう。そこでは、仮説を立て、実験を設計・実装するのに何か月もかかり、そのあとでようやく研究戦略の良し悪しについて何らかの信号が得られる。こうしたタスクでは、一回一回のロールアウトが長いだけでなく、ロールアウトをもっとたくさん行うことが特に役立つ。そうすれば、モデルが学習に使える「成功」を含むロールアウトが少なくとも一つは出てくる可能性が高まる。5
長いコンテキストでの推論実行は、推論モデルに質の高い報酬信号を与えるのにも役立つ。モデルの長い出力を検証するのに必要な、長い思考の連鎖を支えられるからだ。6 そして質の高い検証器は、すでにAIの進歩に欠かせないものとなっている。最も顕著なのは、GPT-5 の改善に使われた OpenAI の「Universal Verifier」である。
さらに、長いコンテキストでの推論実行は、RL環境(の一部)を合成的に生成するのにも役立つ。たとえば Kimi K2 の学習の一部では、MCP サーバーを組み合わせ、LLMを使って合成のツール、エージェント、タスク、記録を大量に自動生成し、良質な事後学習データの作成に役立てた。この工程は長いコンテキストでの推論実行のもう一つの需要源であり、将来はRLタスクの作成にも広げられる可能性が高いと私たちは考えている。7 現在、こうした環境の多くは手続き的に生成されているが、環境の質は時とともに上がっていくと私たちは予想している。より質の高い環境を構築するには、長い思考の連鎖やエージェントとのやりとりを使うことがますます重要になり、そのためには長いコンテキストを扱う能力が大いに役立つだろう。
より具体的に言えば、長いコンテキストでの推論実行は、推論モデルをスケールさせて数週間、さらには数か月という時間幅のタスクをこなせるようにするうえで、決定的な役割を果たしうると私たちは考えている。そしてこのRLスケーリングが、ここ1年の推論モデルで見てきたような改善に少しでも近いものをもたらすなら、その影響は非常に大きなものになりうる。
ボトルネック:研究の試行錯誤の遅れと、上昇しうるコスト
もちろん、こうしたRLスケーリングや継続学習はただでは実現しない。行く手にはボトルネックがある。
その一つは根本的なものだ。推論実行を数週間や数か月という時間幅にまでスケールさせれば、研究の試行錯誤をそれほど速く回せなくなる。新しいアルゴリズムで性能が上がるかどうかを確かめるのに数週間かかるのなら、新たなイノベーションが見つかる速さは大きく落ちかねない。Noam Brown は Latent Space のポッドキャストでこの点を指摘している。
「モデルに長く考えさせるようになると、実時間がボトルネックになる。モデルが即座に応答していた頃は、実験の試行錯誤はとても簡単だった。応答に3時間かかるとなると、実はずっと難しくなる。
[…]
実験はある程度並列化できるが、多くの場合、次にどんな実験をするかを決めるには、実験を走らせて終わらせ、結果を見なければならない。これこそが、到来時期を遅く見積もる立場の最も強い論拠だと思う」
もう一つのボトルネックはコストである。理論上は長いコンテキストでの推論実行を大量に行えるとしても、実際に使えるかどうかは手頃な費用で済むかにかかっている。大量のハードウェアと推論実行時のアルゴリズムの改善が必要で、そうでなければモデルの実行は法外に遅く高価になりかねない。そしてコストの懸念は実際にすでに表れている。Google DeepMind は、コストが高いことを理由に、Gemini 1.5 Pro の1,000万トークンのコンテキスト版をあえて公開しなかった。
それでも全体として、言語モデルに長いコンテキストでの推論実行の能力を持たせることは、極めて大きな意味を持ちうると私たちは考えている。現在の推論のパラダイムをはるかに先へ押し進める助けになりうるし、AIシステムが現実のタスクで本当に役立つために欠かせない能力をもたらすこともありうる。ある程度のコストは伴うものの、これらのボトルネックは乗り越えられないものではなさそうだ。そしてコンテキスト長と投資の現在の傾向を考えると、こうした影響はかなり早く訪れるかもしれない。
この記事の多くのアイデアのきっかけとなった議論をしてくれた Will Brown と、執筆について有益な意見をくれた Lynette Bye に感謝する。また、意見をくれた Josh You と Jaime Sevilla にも感謝する。
注
-
なお、継続学習の定義の中には、新しいデータでの学習、つまりモデルの重みが更新されることを明示的に含めるものもある。私たちはこの仕組みを特定しない、より広い定義を使う。主に関心があるのは、コンテキスト内で出会った新しい情報に基づいてモデルが行動し続けられる能力だからである。 ↩
-
これは画像1枚あたり約250トークン、毎秒2フレームを仮定している。コンテキストウィンドウが100万トークンなら、1,000,000 / (250 * 2) = 2000秒、つまり約30分に相当する。実際には、特に画面に表示される内容がテキスト中心の場合、もっと多くのトークンが必要になるかもしれない。しかしそれは時間幅を縮めるだけで、長いコンテキストでの推論実行ができることの重要性はかえって増す。 ↩
-
たとえば、ある人が1日に30,000トークン(論文約3本分に相当)のテキストを読むとしよう。話すのと同じ速さで考え、毎分125語の速さで話し、仕事中に1日6時間考えるとすれば、さらに45,000語(60,000トークン)になる。合計はおよそ10万トークン程度で、1年では 12 * 30 * 100,000 ≈ 3,500万トークンになる。実際には、人は話すより速く考えられることが多いので、さらに多いかもしれない。 ↩
-
ほかのアプローチも役立ちうる。たとえば研究過程での中間報酬は、モデルがより速く学ぶのにおそらく役立つ。 ↩
-
関連する例として Tongyi Lab の AgentScaler がある。エージェント型タスクの環境を構築するパイプラインを示したものだ。 ↩