
データの解説 AIデータセンター
方法論
原文:AI data centers documentation – Methodology
AIデータセンター・ハブは、信頼できる情報源の詳しい分析に基づいて作られており、その情報源の大半は一般に公開されている。各データセンターは、発見、調査、分析という一連の工程を経る。発見は、ニュース、衛星画像、私たちのこれまでの研究に基づく。次に、商用の衛星画像と、入手できる許認可の書類や企業の開示情報を分析し、データセンターの主要な詳細を調べる。最後に、十分に検証したモデルを適用して、IT電力容量、AI計算能力、資本コストといった主要な指標を推定する。この解説とハブの全体を通じて、「計算能力」はAI計算能力を意味する。つまり、データセンターやキャンパスのすべての計算処理ではなく、私たちが推定した、その用地にあるAI専用チップの能力を指す。以下の節では、この3つの段階をそれぞれ詳しく説明する。
発見
データセンターは、企業の発表、報道機関、第三者のデータベース、ソーシャルメディアへの投稿、そしてGPUクラスターに関するEpoch AIのこれまでの成果から見つけている。たとえば、AbileneにあるOpenAIのStargate施設はすでにGPUクラスターのデータベースに収録されていた。一方、GoodnightデータセンターはAterioが報告したもので、ミシシッピ州のAmazonのデータセンターについては、New York Timesで初めて知った。
ほかのデータセンターを調べている途中で、データセンターを発見することもある。たとえば、New Albany Business ParkにあるMetaのPrometheusデータセンターを調べていたとき、AWSとMicrosoftの新しい用地を発見した。
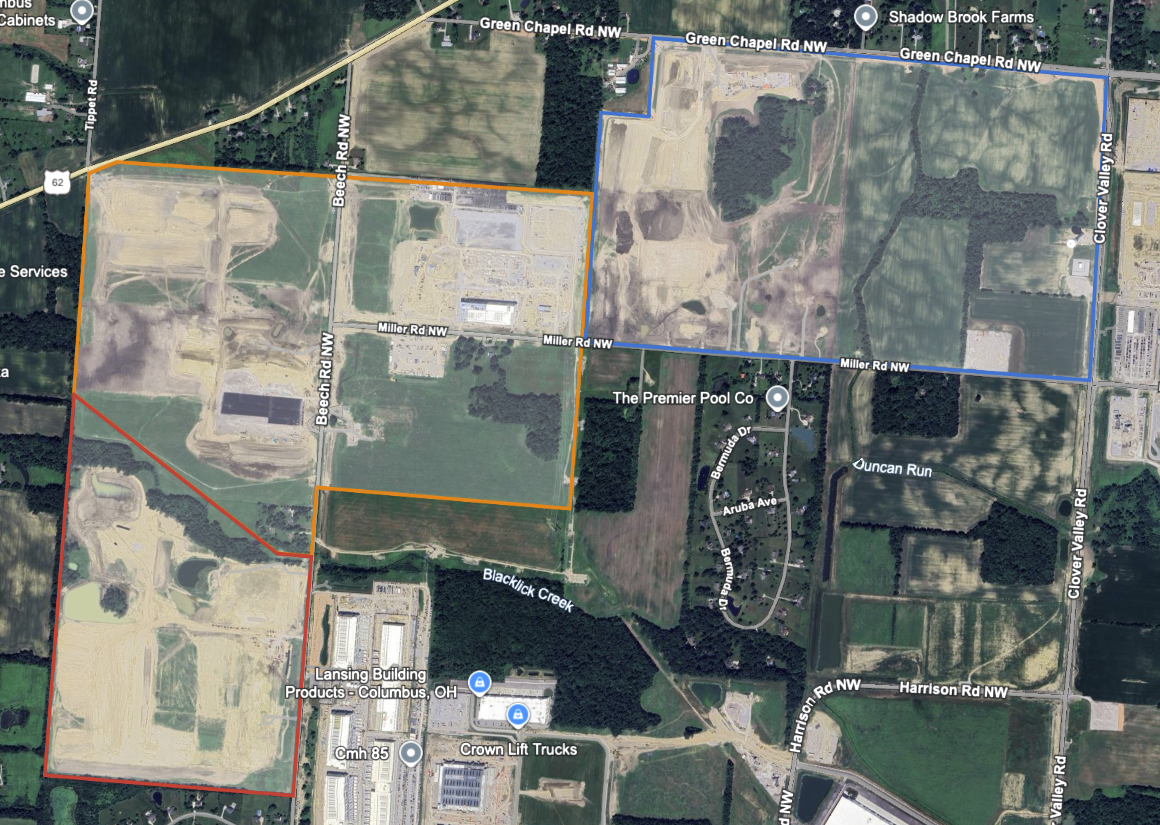
MetaのPrometheusデータセンターの用地の1つ(青枠)を探していたとき、AWS(オレンジ)とMicrosoft(赤)の用地を発見した。出典:Google Earth。
データベースの大半は米国のデータセンターだが、収録範囲は世界中に広がりつつある。チップ販売のデータベースに記録されたAI計算能力の総量に基づくと、このデータベースは、2026年9月30日時点で世界に設置されたAI計算能力の44%(90%信頼区間:23%〜81%)を収録していると推定される。この推定の詳細は、こちらのColabノートブックにある。
AIデータセンターは、主に計算能力の大きさで優先順位を付けている。ただし、世界全体でより釣り合いの取れた収録範囲にするため、米国外では米国より低い能力の基準を設けている。また、AI向けに最適化された施設を中心に扱うため、収録対象は原則として2024年以降に稼働を始めるデータセンターに限っている(いくつか例外はある)。計画中のデータセンターも含めるが、建設が始まっていて、私たちの分析に基づいて完成する見込みが相当程度ある場合に限る。実際には、これによって将来分の収録範囲の大半は、今から2〜3年先までに限られる。
調査
データセンターの存在を知ったら、いくつかのデータ源とツールを使ってさらに詳しく調べる。最もよく使い、最も役に立つのは、衛星画像、許認可の書類、企業の声明である。
衛星画像
データセンターは物理的な占有面積が大きいため、衛星画像や航空写真は、データセンターについて知るための優れた手がかりになる。主にSkyWatchを使い、VantorやAirbusなどの事業者から、既存の高解像度の衛星画像を購入したり、衛星に新たな撮影を依頼したりしている。また、Google Earthや、Sentinel-2衛星の公開画像(Copernicusで入手できる)も使っている。
データセンターのおおよその場所(市や郡など)しか分かっていない場合は、Google EarthやSentinel-2を使って、その地域を手作業で探すことがある。また、過去の事例から、ある企業のデータセンターがどのような外観をしているかという知識を使うこともある。たとえば、Amazonのデータセンターの一部がミシシッピ州Madison郡にあると読んだあと、その地域にあるAmazonの建物をすぐに見分けることができた。
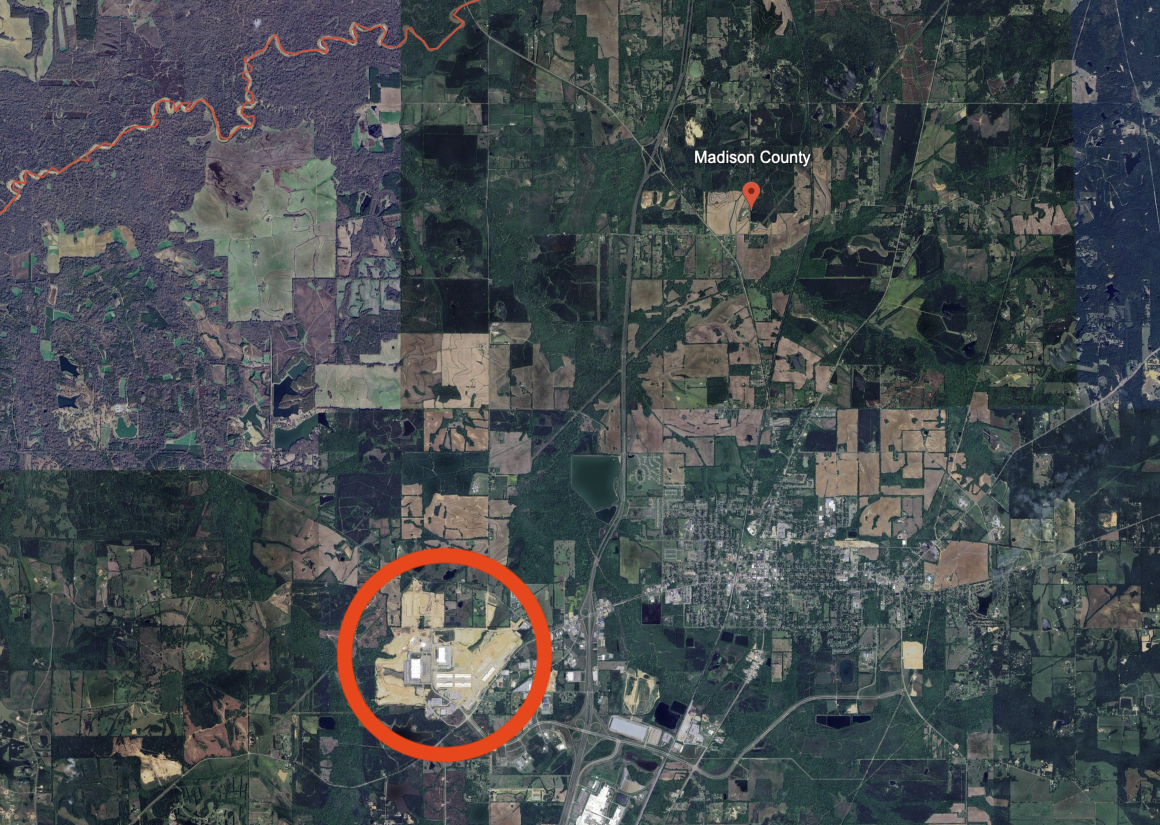
ミシシッピ州Madison郡の広い範囲を写した衛星画像を見ると、最近整地された広い土地(赤丸)が見つかる。出典:Google Earth。
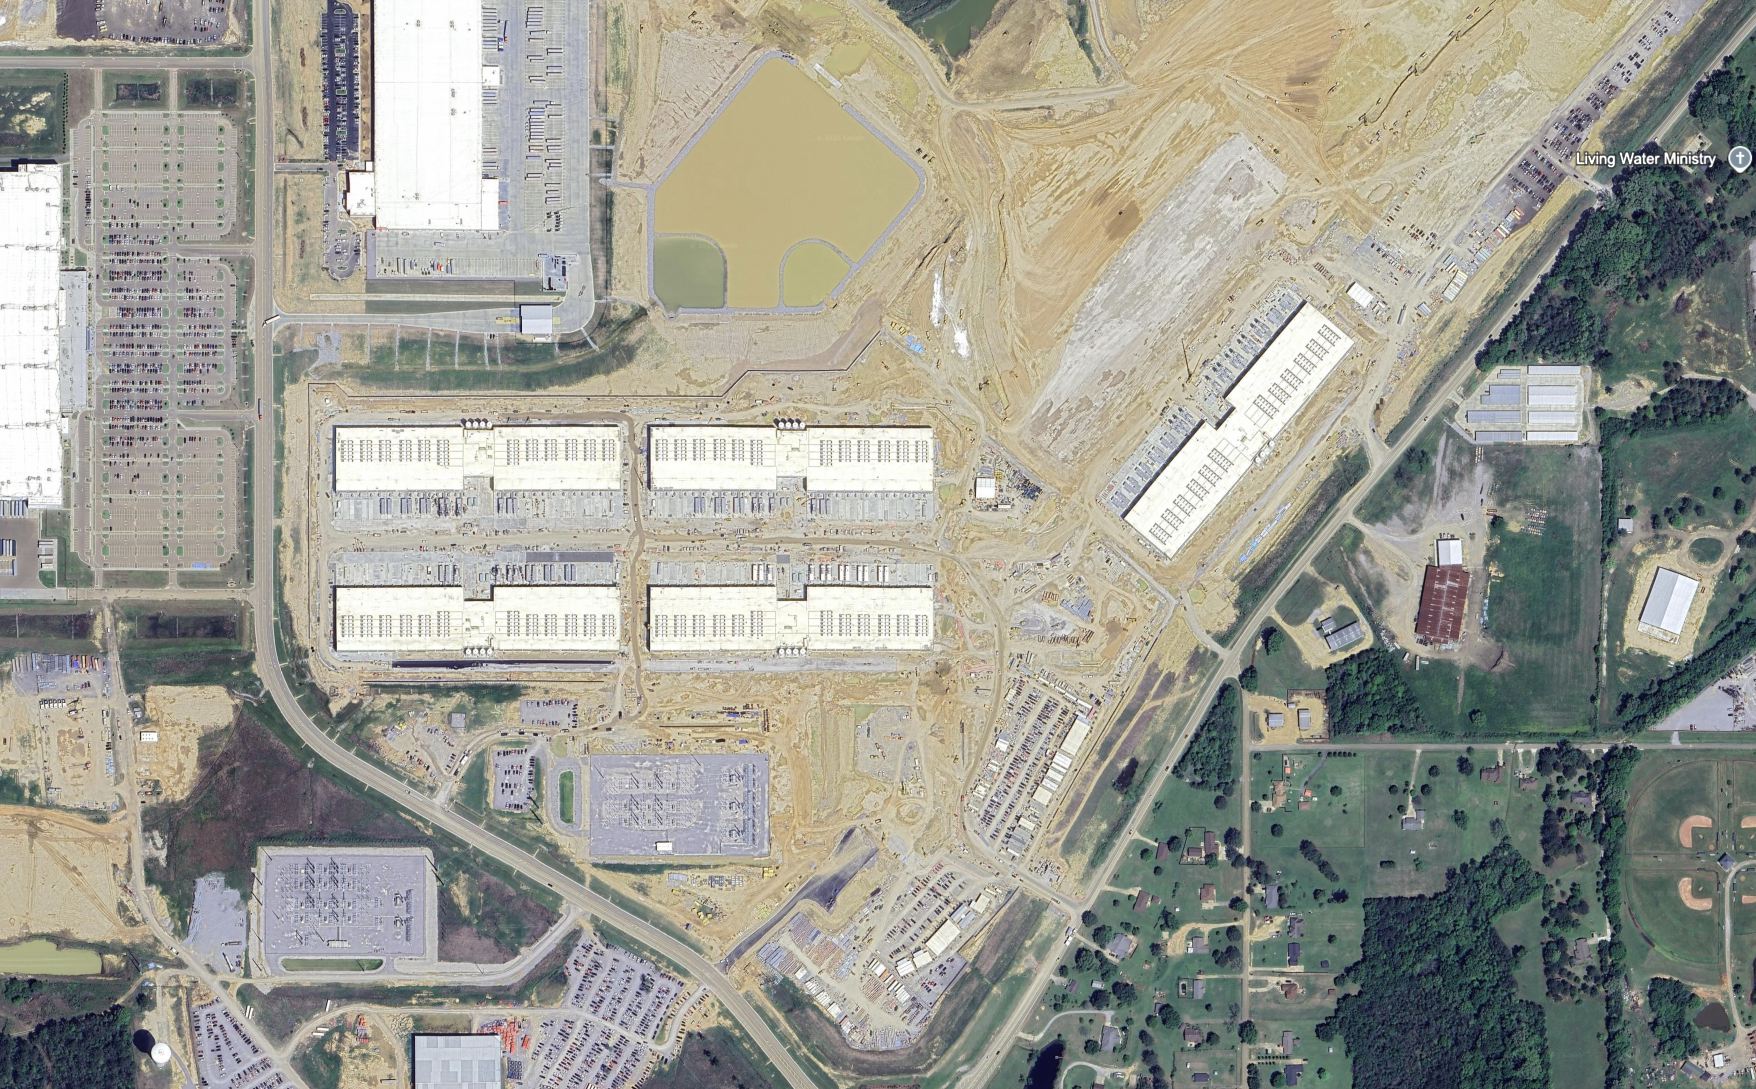
拡大すると、データセンターかもしれない建物が見つかる。出典:Google Earth。
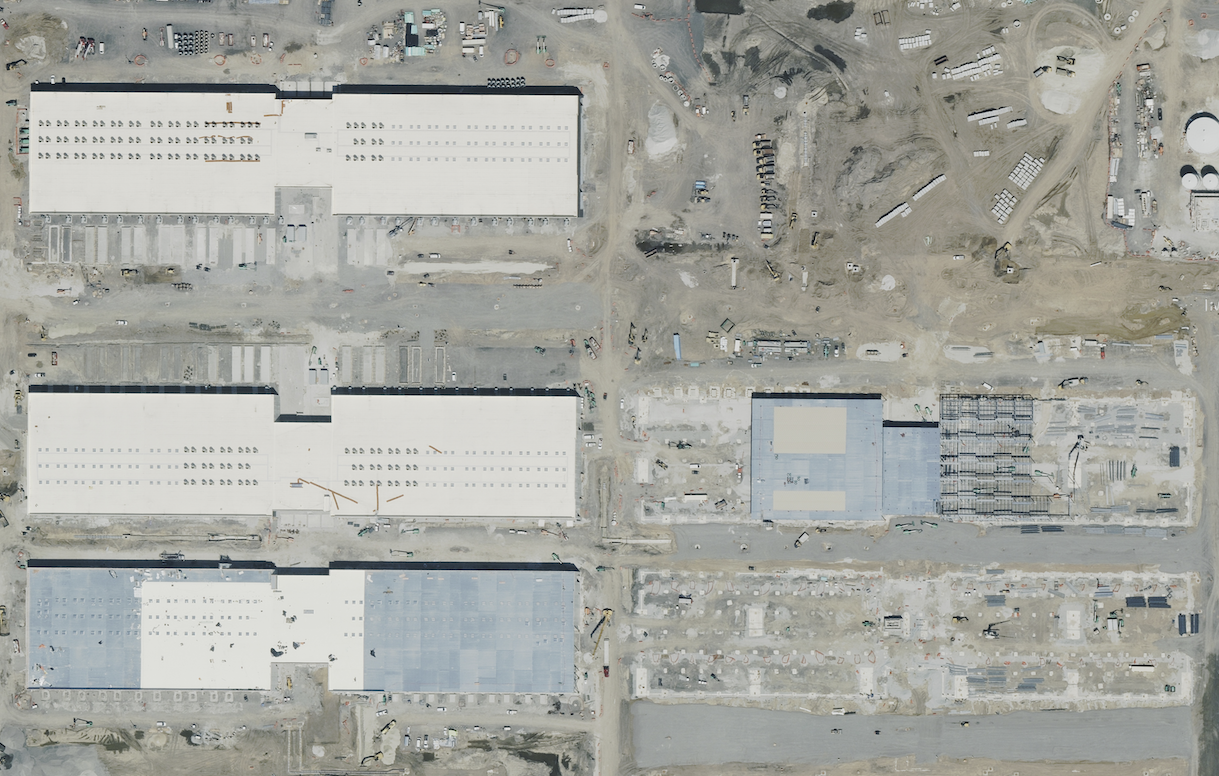
Madison郡の建物を、以前にインディアナ州で特定したAmazonのデータセンターと比べると、Amazonの新しいデータセンターを発見したことが確認できる。出典:Vexcel(SkyFi経由で提供)。
現代のAIデータセンターには主な特徴が3つあり、これらを組み合わせると、倉庫や工場のような似た建物と区別できる。
- 冷却設備。現代のAIデータセンターは発熱量が非常に大きいため、冷却設備が建物の外にまで広がっており、通常は建物の周囲や屋上に置かれている。冷却設備は通常、上面にファンの付いた長方形の装置として見分けられる(ファンが黒い穴のように見えることもある)。
- 非常用発電機。データセンターには、主電源(通常は電力網だが、電力網を介さない自家発電所の場合もある)が止まった場合に備えて、予備の電源が必要である。非常用発電機は通常ディーゼル式で、建物の脇に一列に並んだ長方形の装置として見分けられる。上に突き出た排気筒が見えることもある。
- 変電所。データセンターが稼働開始を早めるために電力網を介さない自家発電を使う場合でも、ほぼ必ず、いずれかの時点で電力網に接続される。つまり、施設の近くに変電所が必要になる。米国の変電所は通常、箱や電線が上に載った灰色の平板のように見える。中国などほかの国では、変電所は長方形の建物に覆われていることが多いが、それでも建物から電線が出ている。
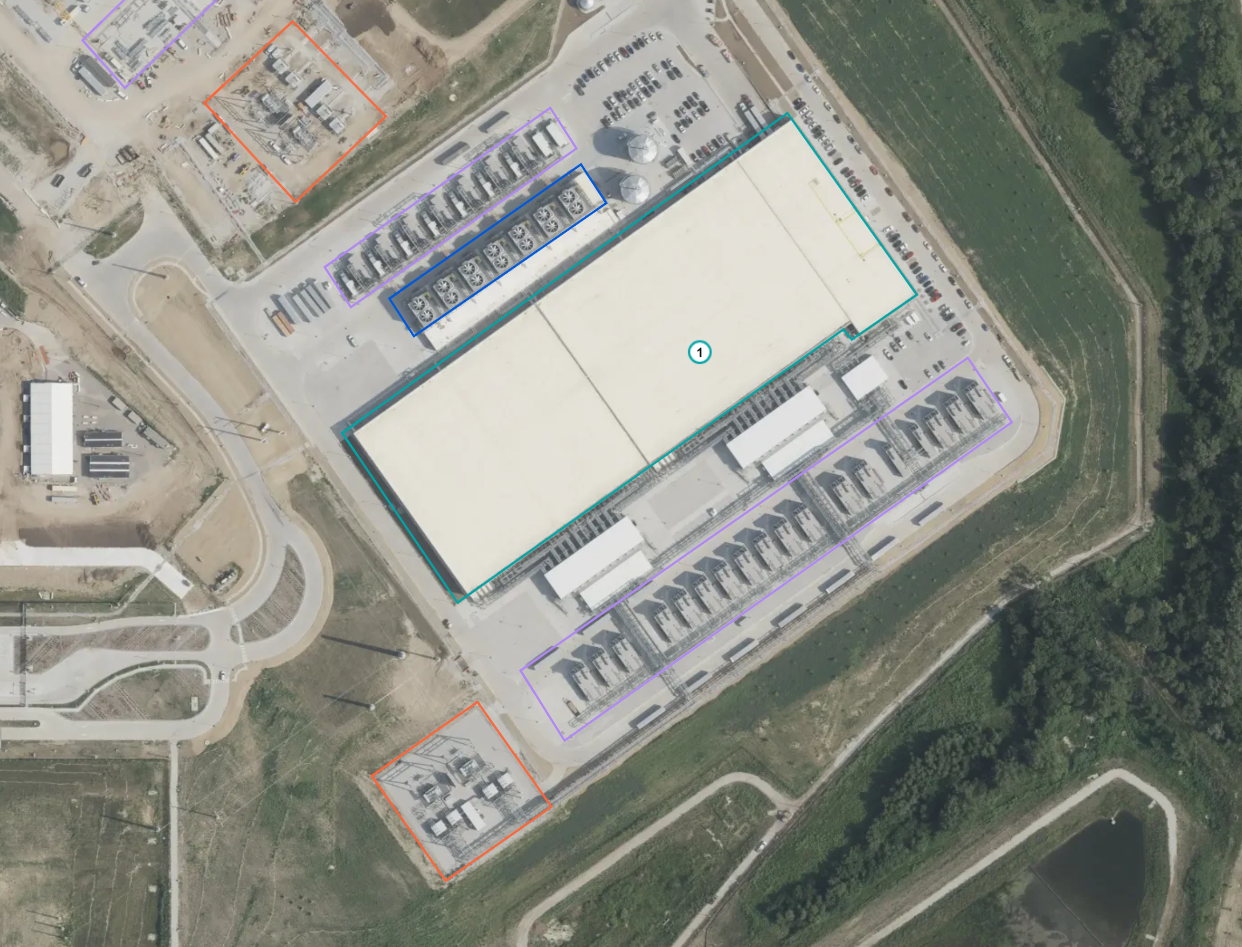
衛星画像でAIデータセンターを見分ける3つの特徴:冷却設備(青枠)、非常用発電機(紫)、変電所(オレンジ)。画像:Vexcel(SkyFi経由で提供)。
公開されている衛星画像からデータセンターを探してもうまくいかない場合は、AIツールを使って文字情報を検索する。これにより、より正確な住所が(たとえば許認可の書類から)見つかることが多い。
データセンターの位置を正確に突き止めたら、衛星画像を使っていくつかのことを調べる。
建設の経過:データセンターは数か月から数年かけて段階的に稼働するので、各データセンターを時間を追って見ていくことが役に立つ。衛星画像からは、整地がいつ始まり、建物にいつ屋根が載り、建設全体がいつ終わったかが分かる。Sentinel-2の画像は、整地や建物をとらえるのに役立つ。解像度は低いが、無料で、撮影頻度が高く、最新のものが手に入る。
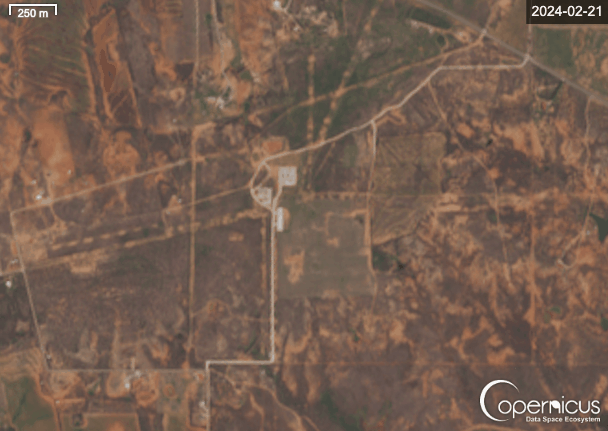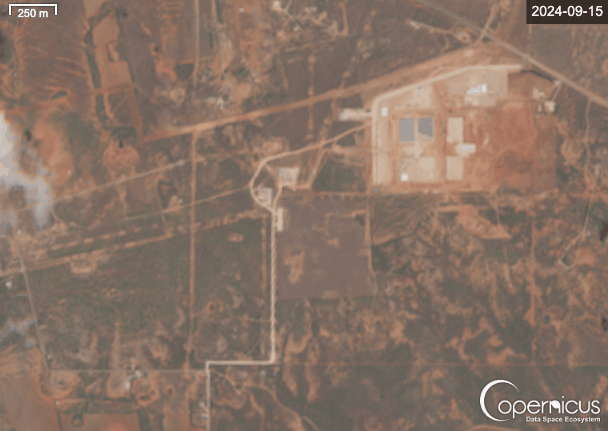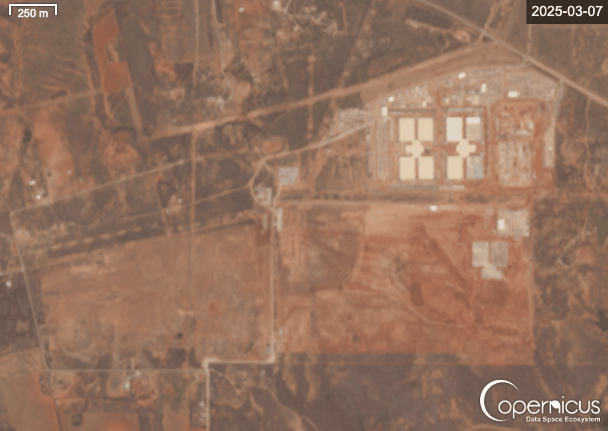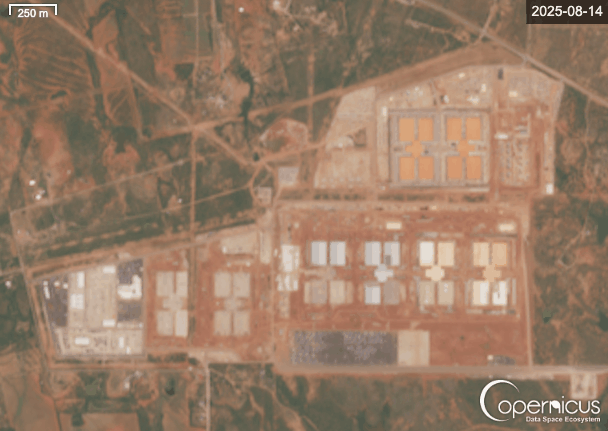
テキサス州AbileneにあるOpenAIとOracleのStargate施設のこのタイムラプスでは、整地が始まった時期、新しい建物や施設の建設が始まった時期、建物の屋根が完成した時期のおおよそを見て取れる。出典:Sentinel-2(Copernicus経由)。
冷却設備:衛星画像からは、冷却の方式、冷却装置の数、(該当する場合は)各装置のファンの数を特定できる。このデータを冷却モデルに入れてデータセンターのIT電力容量を推定する方法は、後で説明する。非常に解像度の高い画像(1ピクセルあたり30cm以下)は、冷却装置1台あたりのファンの数といった主要な詳細が写るので、冷却設備の特定に役立つ。
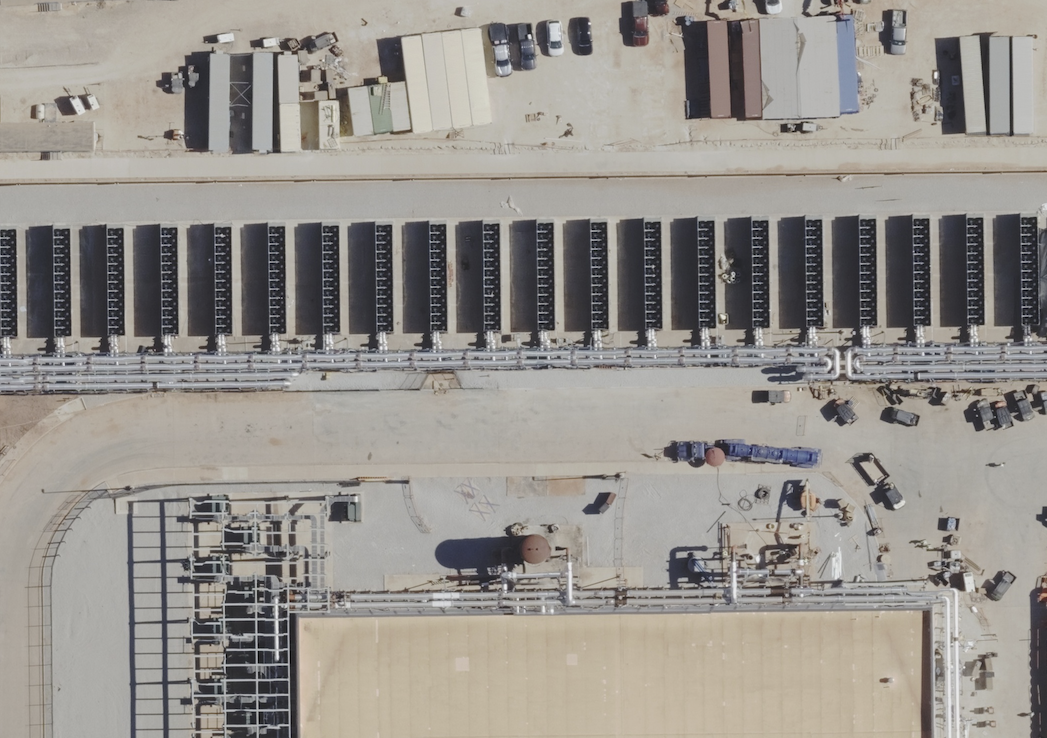
テキサス州AbileneにあるOpenAIとOracleのStargateデータセンターを拡大したこの画像では、それぞれ24個のファンを備えた長方形の装置が一列に並んでいる。冷却設備の外観についての事前の知識から、これらは空冷チラーだと判断した。出典:Vexcel(SkyFi経由で提供)。
衛星画像や航空写真からはデータセンターについて多くのことが分かるが、不確かなまま残ることも多い。冷却方式の中には、建物の外にはっきりした痕跡を残さないものもある(ただし、現代のAIデータセンターではまれである)。データセンターの所有者や利用者が分からないこともある。また、まだ整地されていない場合は、用地が最終的にいくつの建物にまで広がるのかがはっきりしないこともある。許認可の書類は、こうした未知の点を埋めるのに役立つ。
衛星画像に加えて、ドローンで撮影した動画や熱画像を使うこともある。これは、データセンターがいつ稼働したかを判断したり、使われている冷却設備や電源設備の正確な種類を特定したりするのに役立つ。
許認可とその他の法的文書
データセンターの建設は規制を受けており、企業はデータセンターを建てるために地元の当局へ許認可を申請しなければならない。典型的には、大気、水、建築に関する許可が必要になる。
地方自治体は通常、許認可のオンライン・データベースを持っており、多くの文書を一般に公開している。データセンターに関する許認可を探すため、私たちはAIツールを使ってこうしたデータベースを見つけ、検索することが多い。ただし、求めている情報を正確に得るには、手作業での検索や確認が必要になることもある。
データセンターには、稼働時に大気を汚染するディーゼル式の非常用発電機があるため、通常は大気に関する許可が必要になる。そのため、大気に関する許可の書類が入手できれば、少なくとも非常用発電機の数と、発電機1台あたりの電力容量が分かる。非常用発電機の総容量は、通常運転時のデータセンターのピーク電力容量をまかなえるよう設計されていることが多い。しかし、予備の容量がピーク電力容量よりずっと小さいこともあるので、ほかの証拠と照らし合わせることが重要である。最大級のAIデータセンターでは、ますますそうなっている。
天然ガスタービンを主電源や予備電源として使う場合にも、大気に関する許可が必要になる。許可の申請書類には、設計図、計画されている建物の数、住所、所有者など、ほかの情報も豊富に含まれていることが多い(例)。CrusoeのGoodnightデータセンターに関するこの税の減免協定のように、ほかの法的文書が役に立つこともある。
企業の文書と声明
組織がデータセンターのさまざまな側面について、自ら情報を明らかにすることもある。たとえば、Crusoeの2024年のインパクトレポートは、Stargate Abileneの電力容量とGPUの数についての情報を載せていた。Mortensenは、Richland ParishにあるMetaのHyperionデータセンターへの関与について説明した。送電系統運用者のMISOは、2024年に新たな電力負荷の発表を報告しており、その多くは大規模なデータセンターである。さらに、Elon MuskはxAIの2つのColossusデータセンターについて、Xに何度か投稿している。LLMを使ってウェブを検索すると、こうした公表物を見つけやすい。
分析
データセンターについての情報を集めたら、建物ごと・時点ごとに、IT電力容量、計算能力、資本コストといった主要な指標を分析する。そのために、入手できる情報に応じて、主に2つのモデルを使う。
1つ目は冷却設備のモデルである。設備の種類、数量、大きさから、データセンターが消費するIT電力の量を推定できる。2つ目は計算能力のモデルである。ハードウェアのデータベースにあるハードウェアの効率と、チップ所有者のデータベースにある誰がどのチップを所有しているかの情報に基づいて、IT電力容量から、使われているチップの種類とその総計算能力を推定する。チップの種類や数量がすでに分かっている場合もあり、その場合は計算能力をより確実に推定できる。これらのモデルの出力は、互いに比較したり、可能な場合は一次情報源と比較したりして検証している。
冷却モデル
データセンターのさまざまな冷却設備の冷却能力を推定するモデルを作った。このモデルは、冷却の方式と、ファンの数、ファンの直径、冷却装置全体が占める床面積といった物理的な特徴に基づく。1数百の冷却製品の仕様に基づいて、これらの特徴の間に強い経験的な関係があることを見いだした。
空冷チラーの冷却能力を、チラーのファンの数から推定するのに使った回帰モデル。冷却塔には別のモデルを使う。
このモデルで装置1台あたりの冷却能力を推定したあと、次の式でデータセンターのIT電力と施設全体の電力を推定する。
IT電力 = 冷却装置1台あたりの能力 × 冷却装置の数 ÷ 冷却のオーバーヘッド
施設全体の電力 = IT電力 × ピークPUE
熱を出すのはIT機器だけでなく、電源装置や照明もあるため、総冷却能力はピークのIT電力と施設全体の電力の間のどこかにある。そのため、冷却能力を「冷却のオーバーヘッド」で割ってIT電力を求め、その結果にピークの電力使用効率(PUE)を掛けて施設全体の電力を求める。ピークPUEとは、施設全体の電力容量をIT電力容量で割ったものを指す。これは通常のPUEとは異なる。通常のPUEは、ある期間における施設の平均エネルギー消費量をIT機器のエネルギー消費量で割ったものである。大きく異なる値を示唆する証拠がない限り、ピークPUEの既定値は、GoogleやAmazonのようなハイパースケーラーでは1.2、それ以外では1.4とする。2たとえば、空冷は空気の効率が低いため、蒸発冷却よりピークPUEが高くなりやすい。
冷却モデルには、なお大きな不確実性がある。仕様のデータからは、実際の冷却能力が、選んだ運転点によっては、モデルの予測より最大で2倍高い、あるいは2倍低い可能性があることがうかがえる。しかし、実際にはそれほど大きな誤差は見ていない。実際の冷却能力が得られた2件では、私たちの推定はほぼ完全に一致した。チップの数量に基づくIT電力の推定値のように、何らかの別の参照値がある場合は、モデルの予測は参照値の77%から118%の範囲に収まっている。3
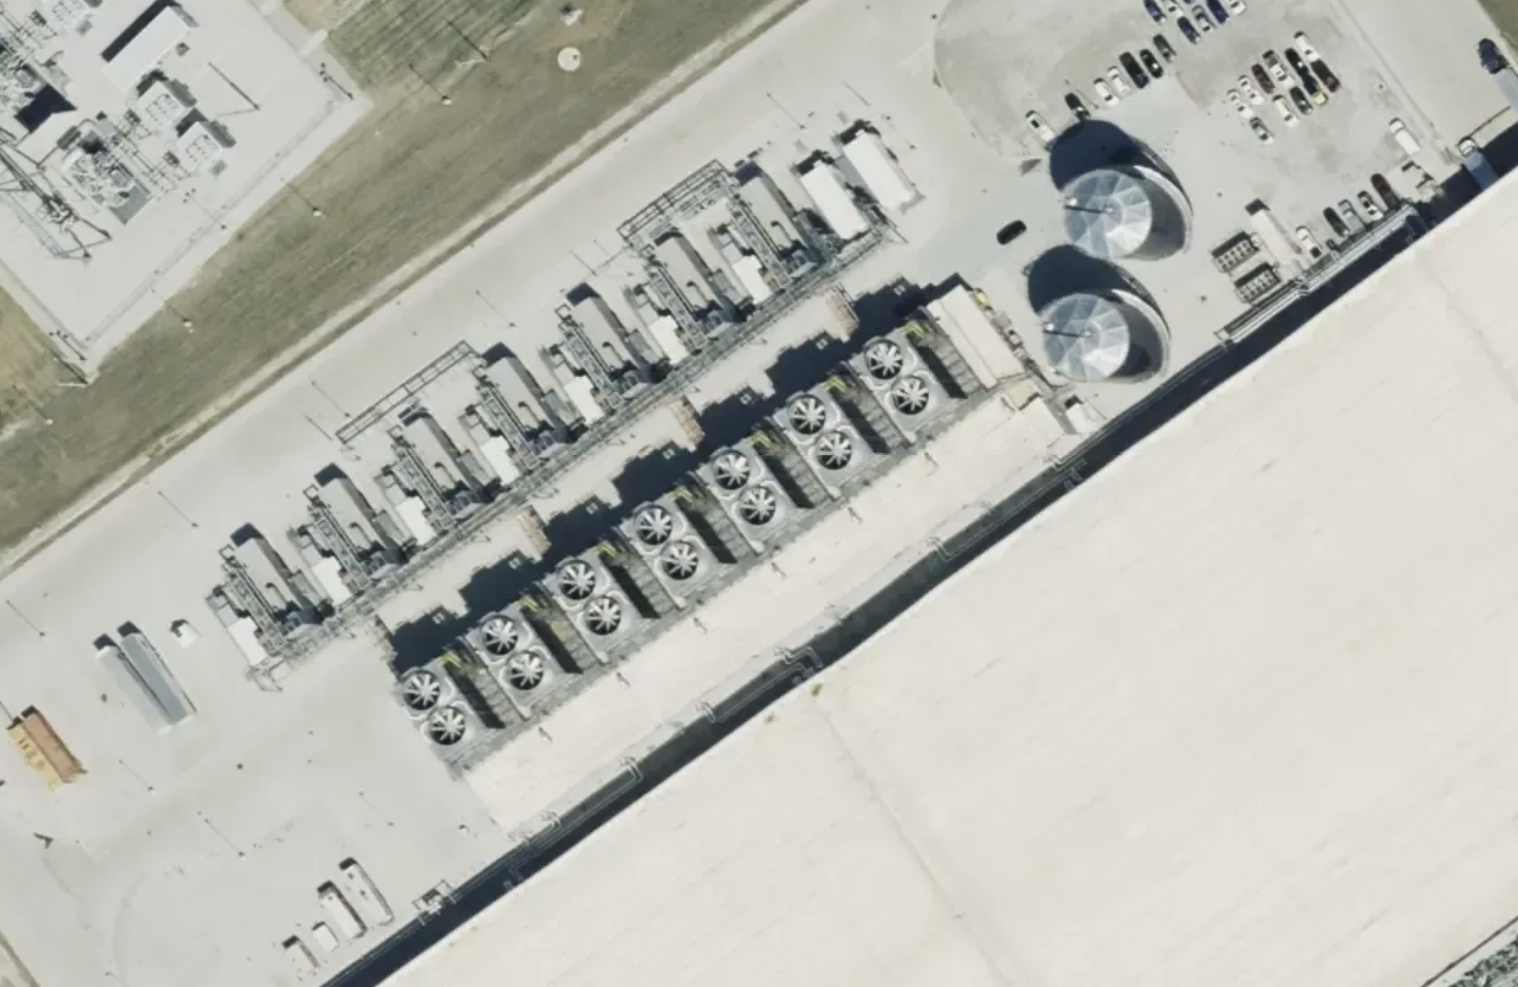
ネブラスカ州OmahaにあるGoogleのデータセンターの建物を拡大したこの画像では、直径5.5mのファンを2個ずつ備えた冷却塔が7基見える。これに基づくと、冷却モデルが出力する総冷却能力は210.5 MWになる。これは、業界標準の換算(3 gpm : 1冷却トン : 15,000 BTU/hr : 4396 W)を使うと、許可の書類に記載された毎分144,480ガロンという公称の能力とほぼ正確に一致する。出典:Vexcel(SkyFi経由で提供)
AIチップのモデル
データセンターで使われているチップの種類と数量が分かっていて、それを使ってデータセンターのIT電力容量を推定することもある。チップの数量から、データセンターのピークのIT電力を次の式で推定する。
IT電力 = チップの数量 × チップ1個あたりのサーバー電力 × ITのオーバーヘッド
ここで、ITのオーバーヘッドは、AIサーバーの電力の合計に対するIT電力の比である。専門家への相談と、NVIDIA GB200 NVL72サーバーのリファレンス設計に基づき、このオーバーヘッドはすべてのチップの種類について1.14とした。チップに基づくIT電力のモデルは、冷却に基づくモデルより信頼できるが、必要な情報を得るのが難しい。そのため、このモデルは冷却モデルやほかの結果の検証に役立つ。
チップの種類と数量が分かれば、AIデータセンターの最大計算性能も推定できる。これは、データセンターの能力を示す主要な尺度である。まず、性能を、8ビットの整数形式または浮動小数点形式での理論上のピークの毎秒演算回数として測る。これは、公開されているハードウェアのデータシートから、次の式で簡単に計算できる。4
性能 = チップの数量 × チップ1個あたりのFLOP/s
チップ1個あたりのFLOP/sには、データシートにある8ビット浮動小数点の最大の仕様値を使い、必要ならスパース性を考慮して仕様値を2で割る。こうすることで、性能の指標をAIモデルの学習に合わせている。私たちの知る限り、フロンティアAIの学習実行の大半は、スパース性を使わずに8ビットの浮動小数点数を用いている。推論実行では、INT4のような整数形式が使われる可能性が高い。
しかし、ほとんどの場合、データセンターについての具体的なハードウェアの詳細が分からず、上の方法は使えない。その場合は、チップの販売から設置までに1四半期の遅れがあると仮定し、チップの所有の推移の推定値を使ってチップの種類を推し量る。5たとえば、2026年第1四半期に稼働しているGoogleのデータセンターでは、Google TPUv6eとTPUv7の組み合わせを仮定し、2025年第2四半期までに稼働しているMicrosoftのデータセンターでは、Nvidia B200を仮定する。
このグラフは原文でご覧ください。
チップ所有者のハブを使うと、ある時点で企業のデータセンターにどの種類のチップがあるかを推定しやすい。
最も可能性の高いチップの種類を推し量ったら、次の式でチップの数量を推定できる。
チップの数量 = IT電力 ÷ (チップの電力 × サーバーのオーバーヘッド × ITのオーバーヘッド)
通常分かっているのはチップの電力(つまり、AIチップ単体の熱設計電力で、たいてい製品の仕様に記載されている)なので、「サーバーのオーバーヘッド」で割る必要がある。これは、AIチップ単体の電力の合計に対する、AIサーバーの電力の合計の比である(サーバーにはCPU、メモリ、ネットワークといったほかのハードウェアも含まれる)。NVIDIAのチップについては、このオーバーヘッドをデータシートから計算する。その他のサーバーについては、NVIDIA GB200 NVL72の仕様に基づき、サーバーのオーバーヘッドとITのオーバーヘッドを合わせた係数として1.74倍を使う。
チップの数量から計算性能を求めたら、それをH100換算(H100e)で表す。つまり、その性能に並ぶのに必要なNvidia H100 GPUの数である。これは、FP8 Tensorコアの仕様値を、スパース性を考慮して2で割ったものに基づく。
H100e = 性能 ÷ (3.958e15 ÷ 2) = 性能 ÷ 1.979e15
資本コストのモデル
最大級のAIデータセンターには数十億ドル規模の資本が必要である。データハブには全データセンターの総資本コストの推定値を載せているので、こうしたコストを簡単に比べられる。総資本コストには、IT機器、機械・電気設備、建物の躯体とホワイトスペース、建設労働、用地取得のコストが含まれる。これを推定するために、ワットあたりのコストのモデルを使う。このモデルが出すIT電力1ギガワットあたりの資本コストは380億ドルで、そのうち260億ドルが「計算資源」(サーバーとネットワーク設備)、120億ドルが「建設」(施設、用地、ユーティリティ工事)に充てられる。施設全体の電力1ギガワットあたりのコストはこれより低く、通常は300億ドルである。オーバーヘッドがあるぶん、支えられるサーバーの数が減るからである。
IT機器は資本コストのおよそ3分の2を占め、経験的に見て、AIチップのワットあたりのコストは時間とともにほとんど変わっていない。そのため、データセンターのハードウェアの種類や稼働日にかかわらず、同じワットあたりのコストの値を使う。実際には、データセンターのコストは、使われる正確なハードウェア、そのハードウェアの交渉価格、地元の労働市場、税の減免、その他多くの要因によって大きく変わる。さらに、私たちのコストの推定値は、データセンターが稼働を始める時点で必要となる資本を反映したものであり、その時点で所有者が実際に支出した資本を反映しているとは限らない。たとえば、借入金の返済は何年も後になることがある。
検証
多くのデータセンターについて、IT電力容量の推定を裏付ける複数の情報源を見つけている。それぞれの情報源には長所と短所がある。大気に関する許可は、どれだけの予備電力が計画されているかを知るのに良い情報源だが、計画は古くなることがある。新しい衛星画像に用地内に設置された冷却設備が写っていれば、現在実際にどれだけのIT電力が使われているかが分かるが、誤差の幅は大きい。独立した情報源が多いほど、最終的な推定は良くなる。
たとえば、Stargate Abileneの電力容量の合計については、6つの情報源がある。電力容量の直接の報告に基づくものもあれば、私たちの冷却モデルやAIチップのモデルに基づくものもある。これらの推定値は、建物1棟あたりの施設全体の電力で139〜190 MWという比較的狭い範囲に収まる。この6つの値を比べたうえで、最も信頼でき、ほかとも整合する推定値として147 MWを採用した。
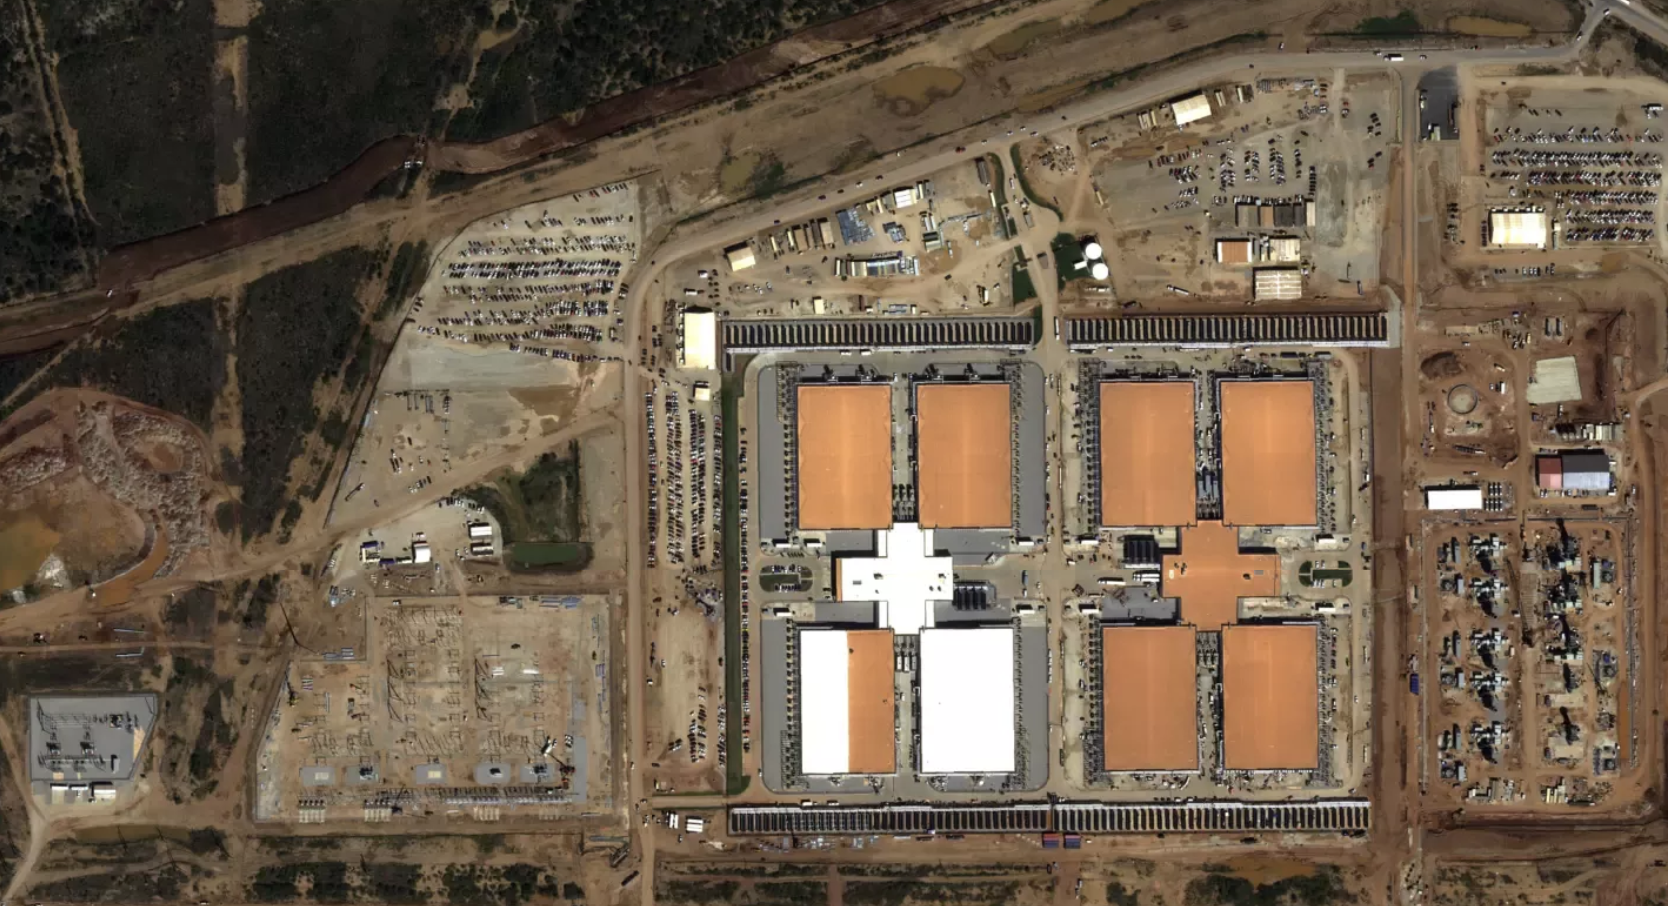
テキサス州AbileneにあるOpenAIのStargateデータセンターについては、左下の変電所(オレンジ枠)、建物の周囲の冷却設備(青)、右下の天然ガスタービン(マゼンタ)と、手元の情報から電力容量の推定値がいくつも得られる。画像出典:© Airbus DS 2026。
限界
AIデータセンターを見つけて分析する私たちの手法は完全ではない。発見の段階では、あまりに知られておらず、言及するニュース、噂、既存のデータベースが見つからないデータセンターもあるだろう。大規模なデータセンターは、その重要性と物理的な占有面積のために報じられやすいが、小規模なデータセンター(100 MW未満)も数多くあり、合計すれば相当な量のAI計算能力になりうる。上で述べたように、この限界に対処するため、衛星画像やほかの種類のデータの利用を広げている。
調査の段階では、許認可は将来の計画について最も信頼できる情報源の1つだが、計画は変わることがある。スケジュールが遅れることも早まることもあり、データセンターの規模が縮小することも拡大することもある。さらに悪いことに、データセンターによっては、オンラインで入手できる許認可の書類がまったくないこともある。許認可の公開のしかたは地方自治体によって異なり、規制も米国内で、そして世界ではなおさら大きく異なる。規制関連の文書がなければ、データセンターの先行きはそれほどはっきりとは見通せない。まだ建物が1棟も建設されていない場合は特にそうである。
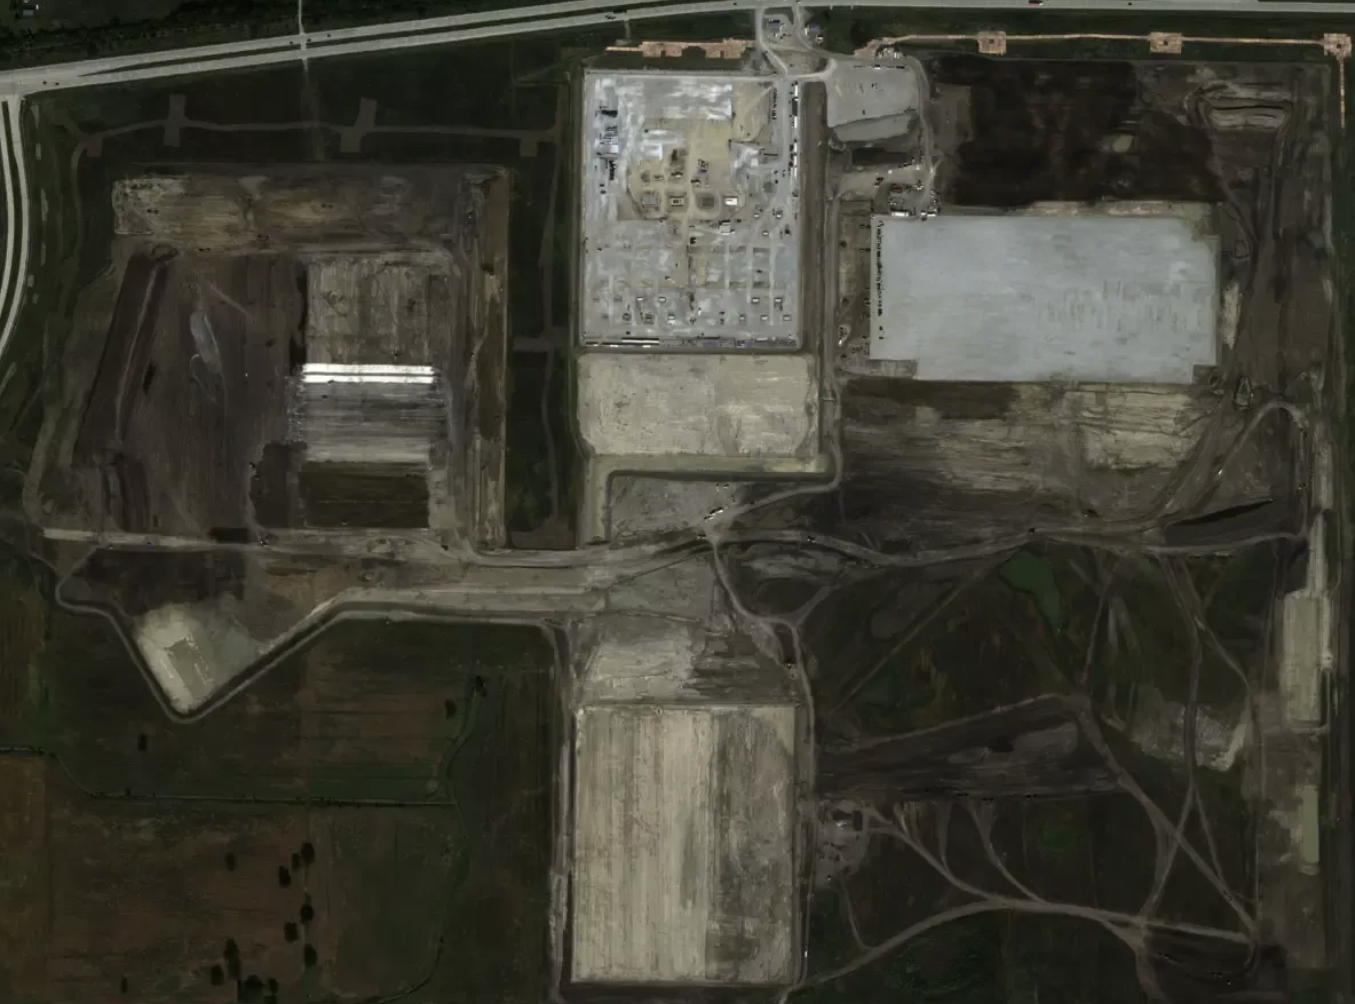
ウィスコンシン州にあるMicrosoft Fairwaterデータセンターの第2期は、2025年1月に建設が一時停止した。当初の計画より時間がかかることがうかがえる。出典:© Airbus DS 2025。
建物の一部が建設中であるか、すでに完成している場合は、衛星画像が大いに役立つが、これにも限界がある。AIデータセンターの電力密度は高まっているものの、外から見て分かる冷却設備なしで運営できているデータセンターもまだある。たとえば、AWSの標準的なデータセンターは、外に目立った冷却ファンがないにもかかわらず、数万個のTrainiumチップを収容できる。ただし、電力密度が上がり続けるにつれて、この設計はしだいに成り立たなくなると予想している。
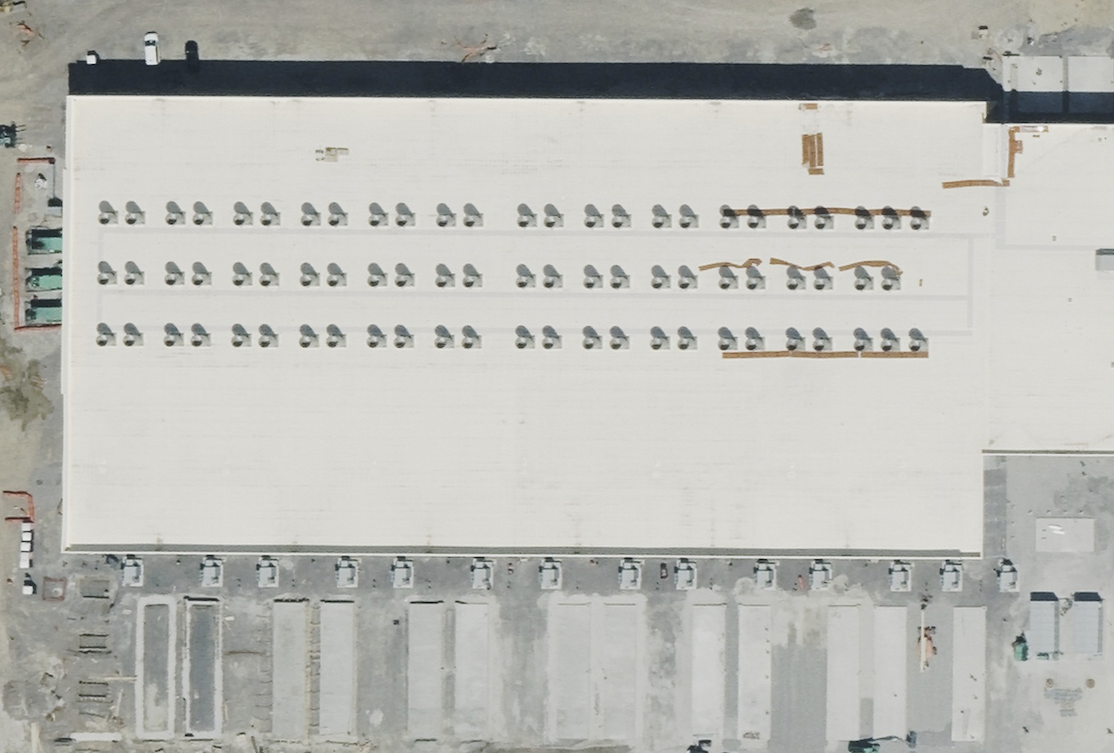
AWSの標準的な建物の冷却システムは、真上からの画像では分析しにくく、現在の冷却モデルの対象外である。出典:Vexcel(SkyFi経由で提供)。
データセンターを完璧に分析できたとしても、誰がそれを使っていて、どれだけの割合を使っているのかが分からないこともある。OpenAIやAnthropicのようなAI企業は、OracleやAmazonのようなハイパースケーラーと契約して計算資源を借りているが、個々のデータセンターについての取り決めは秘密にされていることが多い。
より多くのデータセンターを調べるにつれて、建設期間、IT電力、冷却、計算能力のモデルを改良してきた。たとえば、冷却設備の種類を正しく特定することが重要だと分かった。ウィスコンシン州のMicrosoft Fairwaterデータセンターを蒸発式冷却塔のモデルで分析したところ1.5 GWという値が出たが、これはその規模の建物としては現実的ではない。後になって、その設備は冷却塔ではなく空冷式の凝縮器だと分かった。こうした誤りから学び、AIデータセンターの分析を絶えず改善している。
注
-
データセンターではなく都市部の場所を対象にした、同様の研究がある:https://www.sciencedirect.com/science/article/abs/pii/S030626192300925X ↩
-
これらの値は、複数の情報源と要因に基づく。Uptime Instituteは、30 MW以上のデータセンターの平均PUEを1.44と報告している。SemiAnalysisの公開記事は、H100やGB200のGPUを収容する「典型的なコロケーション・データセンター」のPUEとして1.35を使っている(https://newsletter.semianalysis.com/p/h100-vs-gb200-nvl72-training-benchmarks)。暑い夏の日にはより多くの冷却が必要になるため、ピークPUEは平均PUEよりやや高くなると考えている。一方、ハイパースケーラーはPUEが低い傾向がある。たとえばGoogleは、2025年に自社のデータセンター全体で平均1.09だった。 ↩
-
誤差の計算は、こちらのスプレッドシートを参照してほしい。当初は最大誤差がもっと大きかったが、参照データと理論的な考察に基づいて冷却モデルを調整した。追加の分析によれば、個々のIT電力の推定値は、80%の確率で実際の値の1.4倍以内に収まる。 ↩
-
たとえば、NVIDIA GB200 NVL72のデータシート。ここで注意すべき点の1つは、ハードウェアのデータシートが性能をどのように報告しているかと、サーバーあたりのチップの数である。NVIDIAは通常、OP/sを「スパース性あり」で報告しており、これはほとんどの用途に当てはまる数値の2倍である。また、2個のB200 GPUからなるGB200のようなGrace-Blackwellの「スーパーチップ」と、GB200の36個分に相当し、72個のB200 GPUを含むGB200 NVL72サーバーとの関係も紛らわしい。私たちの経験では、業界の情報源が「50,000 GB200 NVL72 chips」のように報じる場合、たいていは50,000個のB200 GPUを意味している。それぞれの場合について、情報源を照合して最も可能性の高い意味を確かめている。 ↩
-
なお、AIデータセンターのデータセットとチップ所有者のデータセットの間には、ある程度の相互依存がある。たとえば、xAIのチップの所有はxAIのデータセンターについての私たちの分析に基づいており、Amazonのチップの所有も部分的にはAWSのデータセンターについての私たちの分析を参考にしている。循環的な依存を避けるため、チップ所有者のデータセットのうち独立した部分だけを使っている。 ↩