
レポート
「経済的価値」ベンチマークから何がわかるのか?
原題:What do “economic value” benchmarks tell us?
はじめに
本稿では、AIシステムが経済的価値のある現実世界のデジタルなタスク(コーディング以外)をこなせるかどうかを測ろうとする、最近開発された三つのベンチマークを検討する。Remote Labor Index(RLI)、GDPval、APEX-Agents である。
これらのベンチマークでの進歩は、実際の有用性と相関すると予想している。しかし、ベンチマークのタスクは明確に定義されており、比較的自己完結している。したがって、これらのベンチマークで高得点を取っても、デジタルな職業がエンドツーエンドで自動化されることを意味するわけではない。そうではなく、こうした仕事のやり方が、手作業での実行からAIへの仕事の委任へと移っていくことを意味するだろう。今日コーディングエージェントがソフトウェアエンジニアリングにもたらしている影響に似たものである。
これらのベンチマークには重要な違いもある。それぞれについて要点を短く述べる。
- RLI は、人間なら数日かかるマルチメディアのプロジェクトをAIがこなせるかどうかを測る。最初の評価ではおそらくモデルの能力を十分に引き出せていなかったが、最近改善された。それでも最高スコアはまだ非常に低い(5%未満)。
- APEX-Agents は、伝統的に高給とされるホワイトカラーの職種にまたがる、専門家なら2時間ほどかかるタスクをAIがこなせるかどうかを測る。タスクの指示は自己完結しているが、タスクの環境は他の二つのベンチマークより雑然としており、これはおそらく現実性を高めるのに役立っている。
- GDPval は、経済的価値のある非常に幅広いデジタルな仕事から着想を得たタスクを、AIがこなせるかどうかを測る。タスクは専門職の人が完了するのに約1日かかる。タスクが自己完結しているうえに、扱わなければならない雑然とした環境もないので、現実性は二重に限られている。また、三つのベンチマークの中で飽和に最も近い。
以下では、さらに詳しく見ていく。
| 項目 | RLI | APEX-Agents | GDPval |
|---|---|---|---|
| 開発者/評価者 | CAIS + Scale AI | Mercor | OpenAI |
| タスク数 | 240(うち公開10) | 480(すべて公開) | 1320(うち公開220) |
| 対象分野 | 視覚的な成果物を伴うタスク(ウェブデザイン、製品アート、動画編集など) | 投資銀行、経営コンサルティング、企業法務 | 44職種のタスク。大半は調査と文書作成 |
| タスクの出所 | 実際のフリーランスのプロジェクト | 専門家が考案し、モデルにとって難しくなるよう最適化 | 専門家が考案 |
| タスクで与えられる情報 | 必要な情報のみ | 必要よりはるかに多い情報 | 必要な情報のみ |
| 人間の所要時間(平均) | 29時間 | 2時間 | 7時間 |
| 評価時のウェブアクセス | あり | なし | あり |
| 評価方法 | 人間とAIの成果物を専門家が判定 | AIがルーブリックに照らして判定 | 人間とAIの成果物を専門家が判定 |
| 最高スコア(2026年2月時点) | 4% | 30% | 74% |
タスクの例
以下に、各ベンチマークから三つずつ、タスクの内容をごく簡単に要約して示す。これらの要約はタスクの仕様の細部や関連資料の複雑さを伝えきれていないが、参考として役に立つと思う。
RLI
- イヤホン一式の3Dモデルと、製品の特徴を示す五つのアニメーションを作成する。提供される資料は、さまざまな角度から撮ったイヤホンの画像である。
- 楽曲『雨に唄えば(Singing in the Rain)』を、指定された楽器の一覧で独自に編曲する。楽曲の音声が入った YouTube 動画へのリンクが提供される。
- あるアパートのインテリアデザインの案をいくつかレンダリングする。提供される資料には、間取り図と現在の内装の画像が複数含まれる。
APEX-Agents
- ある企業が REIT(不動産投資信託)に転換した場合の、株主への分配の正味現在価値をモデル化する。ファイルシステムには、その企業に関する関連文書と、計算用の Excel シートが含まれている。無関係な企業やプロジェクトに関するファイルも含まれている。
- あるデータ侵害で流出したデータが、GDPR上の個人データにあたるかどうかを判断する。ファイルシステムには、その侵害に関する情報と、GDPRに関する記事が含まれている。無関係な顧客や、EU以外のプライバシー法に関するファイルも含まれている。
- ある食品メーカーで、デジタル研修プログラムを受ける準備が最も整っている従業員は誰かを分析する。ファイルシステムには、その会社の従業員に関する情報のほか、会社に関する他の情報や無関係なプロジェクトも含まれている。
GDPval
- 医療機器メーカーのアカウントマネージャーとして、見込み客に見積もりを出す。見積もりの依頼に加えて、価格情報の入った Excel シートが提供される。見積もりは WHO の特定の基準に従わなければならず、その基準はウェブ検索で見つけることが想定されている。求められる成果物は Excel ファイルである。
- 私立探偵事務所の主任として、ある保険金請求に関する報告書をまとめる。現地調査員による二つの報告書と、AIが生成した画像が提供される。求められる成果物はPDFである。
- 政府機関の窓口担当者として、Thrift Savings Planに関する問い合わせに回答する。この制度に関する情報はウェブ検索で見つけることが想定されており、成果物はメールの本文である。
タスクの集め方も分野もそれぞれ異なる
各ベンチマークのタスクの集め方と構成を概観する。大きな違いの一つは、RLI のタスクが現実のプロジェクトから取られているのに対し、APEX-Agents と GDPval のタスクは専門家が考案したものだという点だ。このため、タスクの現実性では RLI が優位に立つ。RLI は成果物の形式でも大きく異なる。RLI のタスクはおもにマルチメディアの成果物を求めるのに対し、他の二つは調査中心のタスクで、成果物はたいていテキストか Microsoft Office のファイルである。
RLI のタスクは、フリーランサーがプラットフォーム Upwork で過去に完了した実際のプロジェクトである。1選定基準のうちおそらく最も重要なのは、プロジェクトの成果物を視覚的に評価できなければならないという点だ。2このベンチマークがマルチメディアの仕事に偏っているのはこのためである。
RLI のタスク一式は次のもので構成される。
- 元の依頼主のプロジェクト概要から作られたプロンプト
- 音声や画像などの入力ファイル
- 採点に使われる、フリーランサーの実際の成果物
成果物のファイルはウェブビューアでレンダリングされ、人間の評価者が確認する。
タスクはフリーランサーによってまとめられた。指示と資料に抜けがないか、適切に匿名化されているかを確かめるためのレビューも行われた。
APEX-Agents のタスクは一から作られたもので、投資銀行のアナリスト、経営コンサルタント、企業内弁護士という三つの職種の実際の専門職の人が作成した。
APEX-Agents のタスク一式は次のもので構成される。
- プロンプト
- 現実の業務環境を模した、ファイルとアプリケーションからなる環境。環境には通常、タスクの遂行には関係のないファイルやアプリケーションが数多く含まれている。
- 採点用のルーブリック
成果物は通常、テキストによる回答(タスクの約90%)か、ファイルの作成である。
タスクは専門職の人が作成し、タスクを難しくするためのLLMによる改良を含め、複数回のレビューを経た。これによって、実際の仕事と比べてタスクの分布がどの程度偏ったものになったかははっきりしない。
GDPval は、幅広い経済活動を網羅するようにタスクを集めることを目指した。米国のGDPへの寄与が大きい上位九つの産業から出発し、仕事のかなりの部分がデジタルに行われている44の職種を特定した。3各職種について、人間の専門家が30のタスクを作成した。
GDPval のタスク一式は次のもので構成される。
- プロンプト
- (必要に応じて)参照ファイル
成果物はさまざまなファイルで、たいていは Microsoft Office の標準形式である。
タスクは専門家のチームが作成し(タスクあたり平均5人が関わった)、人間とLLMによる複数回のレビューを経た。その中には、タスクの複雑さについての少なくとも基本的な絞り込みも含まれていた。たとえば、タスクが5分をかなり上回る作業を要すると思われるものであることなどである。
最後に、タスクの作成者への報酬について一言述べておく。RLI の場合、フリーランサーには過去の作業サンプルを提供する対価として平均41ドルが支払われた。APEX-Agents や GDPval のタスク作成者がどのように報酬を受けたのかはわからない。三つのベンチマークの公開サンプルはおおむね妥当に見えるが、現実的なタスクを作るための動機づけがタスク作成者に十分に与えられていなかったために、どんな細かな点が抜け落ちているかはわからない。
やり取りの欠如と環境の雑然さがタスクの現実性を左右する
三つのベンチマークはいずれも、一回きりのやり取りで構成されている。つまり、AIシステムは一つの固定されたプロンプトをもとに作業に取りかかり、採点対象となる成果物一式を一度だけ出す。当然ながら、これは人間の仕事の流れとは異なる。人間の仕事では、目標を聞き出し、要件を詰め、フィードバックを与えるために、長いやり取りが行われることが多い。
GDPval と RLI はどちらも、関連する情報をすべて、タスクの仕様を示すプロンプトと必要な入力ファイルという形で与える。これは典型的なオフィスワークの状況よりもかなりすっきりした設定である。オフィスワークでは、従業員はコンピュータで複数のアプリケーションやシステムを操作し、多くのファイルやタスクを同時に管理する。RLI のタスクも同様にすっきりしているが、プロジェクトにもともと文脈がずっと少ないフリーランスの仕事では、このほうが現実的だと思われる。
APEX-Agents は、意図的に雑然としたファイルシステムを持つ環境を用意することで、現実性のこの側面に対処しようとしている。そこには重複したファイルや、与えられたタスクと無関係な作りかけのプロジェクトが含まれる。この作られた雑然さがどれほど現実的かはわからないが、これによって RLI は、AIシステムが不慣れな文脈に「いきなり入り込む」能力をより良く測るものになっているのではないかと思う。
とはいえ、どのベンチマークのタスクも、より広いビジネスの文脈から切り離されて行われる。たとえば、働き手が気を配らなければならないかもしれない会社の全般的な方針、業務プロセス、戦略などである。またデータからは、機密情報や個人を特定できる情報が取り除かれており、これによってデータが単純化される傾向があるかもしれない。
人間が完了するまでの推定時間は大きく異なる
GDPval は、専門家にタスクを完了させることで、タスクの平均完了時間を推定した。APEX-Agents も同様だが、専門家が完了したのはタスクの一部のサンプルだけだった。この二つの平均完了時間は、それぞれ7時間と2時間だった。
RLI は、フリーランサーにタスクに費やした時間を報告してもらった。報告された平均時間は29時間だった。このような自己申告のデータには偏りがあるかもしれないが、完了時間のデータはフリーランサーがその仕事で受け取った報酬とよく相関しており、ある程度は現実的であることがうかがえる。
これほど完了時間が長いのはなぜだろうか。手がかりは公開された10のタスクしかないが、要するに、RLI のマルチメディアのタスクには細かく手間のかかる作業が多く、人間が完了するには実際に時間が必要だということのようだ。イヤホン一式の3Dモデルと製品の特徴を示す五つのアニメーションを作るタスクは最も長いものの一つで、60時間と報告されている。楽曲『雨に唄えば』の独自の編曲はほぼ平均的で、30時間かかっている。アパートのインテリアデザインのレンダリングを作るタスクは公開セットの中で最も高額でもあり、22時間と報告されている。
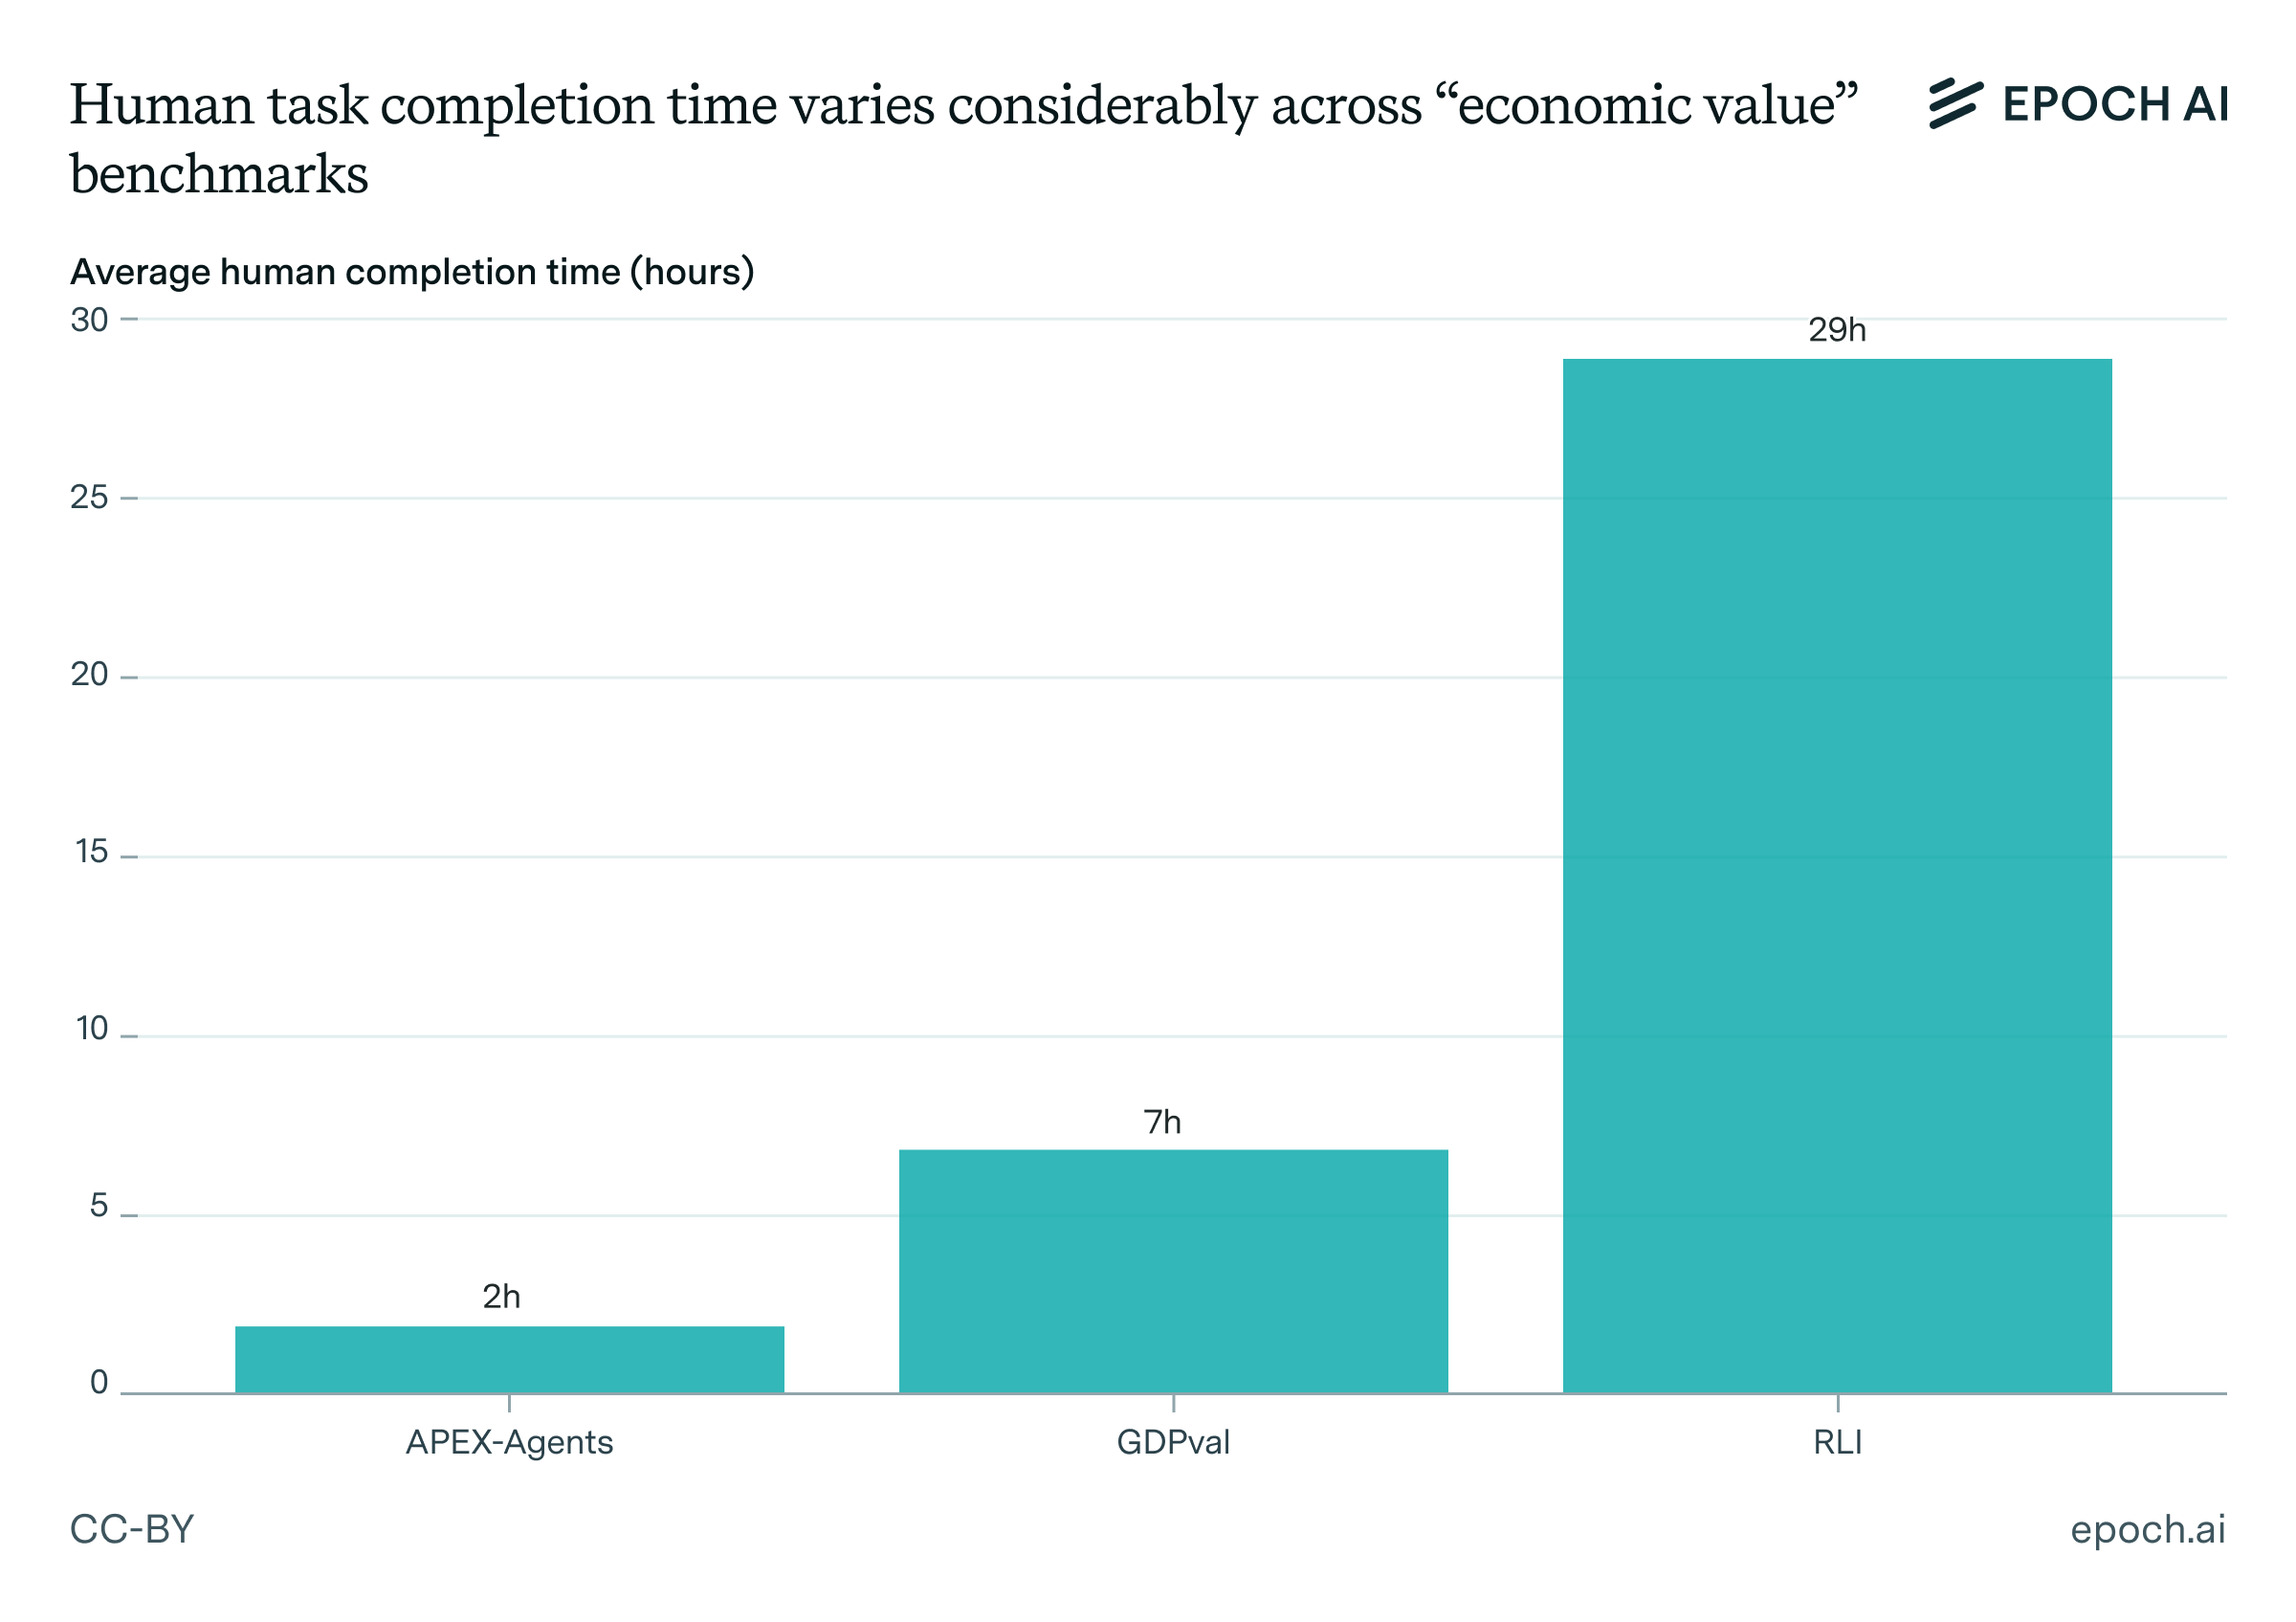
タスクの経済的価値は、所要時間ほどには違わない可能性も十分にある。RLI では、プロジェクトは元の依頼主に平均600ドルで請求されていた。たとえば APEX-Agents の場合、経験豊富な企業内弁護士の2時間分の報酬はこの額を上回りうる。
ウェブアクセスのせいで GDPval の評価の信頼性がやや下がる
APEX-Agents はウェブアクセスなしで実行されるが、RLI と GDPval はどちらもエージェントがウェブを閲覧することを認めている。RLI のタスクはもともと現実の仕事として行われたものなので、タスクの成果物の一部がオンラインで手に入ることがある。RLI はそうした場合に備えてブロックリストを管理している。4それ以外については、ベンチマークのサンプルは公開されておらず、大半はウェブ上のごく特定の情報に頼っているようには見えないので、解答がオンラインで手に入ることの全体的な影響は比較的小さいはずである。
しかし、GDPval のタスクの半分以上は調査に基づくもので、リアルタイムのウェブアクセスにより根本的に依存している。この設計には二つの問題が見られる。第一に、一部のタスクでは、ウェブサイトが時とともに変わるにつれてアクセスできなくなるかもしれないウェブ上の情報源を使う必要がある。これが現在影響しているのは二つのサンプルだけだが5、時間とともに増えると予想される。第二に、タスクの約5%は、今ではすでに過去になった時点の視点を前提としている。たとえばあるタスクは、先を見通す形で「2025年上半期(H1)の[…]エネルギー市場の包括的な分析」を求めている。関連する情報(その期間に実際に起きた出来事を含む)がはるかに手に入りやすい後知恵の立場からなら、モデルはこのタスクをより簡単にこなせるだろうと考えるのは十分にもっともである。
評価の方法は大きく異なる
GDPval では、人間の専門家が人間による参照用の成果物とAIの成果物を比べ、どちらが好ましいかを選ぶ。「引き分け」の選択肢もある。RLI も同様で、AIの成果物が参照用の成果物と「少なくとも同等か」を専門家に尋ねる。元の論文では、GDPval は少なくとも2人の人間の審査員を使い、RLI は3人を使っている。その後の評価で何人の審査員が使われているかは示されていない。
GDPval は「引き分け」率を「勝ち」率とは別に報告しているが、勝ち率の上限ははっきりしない。タスクによっては、人間による参照用の成果物を上回る余地があまりないかもしれないからだ。そのため私たちは、勝ち+引き分けの率が最も参考になると考えることが多い。これは RLI とも最も直接に比較できる。
AIシステムが人間と同等の成果物を出しているかどうかを評価するには、一対一の比較が直感的にわかりやすい。とはいえ、こうした比較がどのように行われているかについてはあまりわかっていない。特に、専門家が成果物を表面的な特徴だけで判断するのではなく、経済的な動機を持つ顧客の視点に立てるよう、どんな工夫がされているのかはわからない。6
APEX-Agents は、自己完結した事実からなるルーブリックを使い、その正しさをLLMが確認する。これは、事実に基づくベンチマークで成果物を評価するための一般的な手法である。APEX-Agents のルーブリックは比較的客観的な性質を持つので、この場合もこの方法は妥当に思える。
ベンチマークごとにモデルの進歩の度合いは異なる
本稿執筆時点で、GDPval の最高スコアは GPT-5.2 Pro による勝ち+引き分け率74%(勝ち60%+引き分け14%)で、GPT-5.2 (xhigh) は71%(勝ち50%+引き分け21%)である。さらに、Artificial Analysis による GDPval の第三者実装では、Opus 4.6 が GPT-5.2 (xhigh) を大きく上回っている。このことから、OpenAI の公式評価でも74%よりさらに高いスコアを出す可能性があることがうかがえる。7GDPval は三つの中で飽和に最も近い。
これに対して RLI の最高スコアは、Opus 4.6 の4%である。これはそれほど驚くことではない。タスクに伴う人間の完了時間が長いうえに、テキストだけのタスクと比べてマルチモーダルなタスクに弱いという分野全体の傾向もあるからだ。このベンチマークが飽和するまでには最も時間がかかると予想するのが妥当に思える。ただし、これらの結果がモデルの性能を十分に引き出せていないのではないかという点については、以下の議論を参照してほしい。
APEX-Agents はその中間で、現在の最高スコアは Opus 4.6 の30%である。
選ばれたスキャフォールドは能力を十分に引き出せていないかもしれない
これらのベンチマークはいずれもエージェント型のスキャフォールド(モデルを動かす周辺の仕組み)の上で実行される。つまり、AIシステムが環境と繰り返しやり取りして最終的な成果物を作る。私たちが以前書いたように、スキャフォールドの実装の細部は性能に大きな差をもたらしうる。
RLI はモデルの能力に応じて異なるスキャフォールドを使う。Manus のような統合型のエージェント製品、Scale AI と CAIS がさまざまな標準ツールを備えた Ubuntu デスクトップをもとに開発したコンピュータ操作エージェント(CUA)のスキャフォールド、そして OpenHands CLI をもとにしたCLI環境などである。最後の環境では、画像・動画・音声用のさまざまなマルチモーダルモデルにAPIでアクセスできる。
RLI のタスクでは、Autodesk/CADや Photoshop のファイル、3Dモデルなど、さまざまな種類の成果物ファイルをモデルが作る必要がある。使われているスキャフォールドはどれも、これにあまり適していない。Ubuntu ベースのCUAスキャフォールドでは、Photoshop や Fusion360 のような人気のアプリケーションは Linux に対応していないため動かず、モデルは GIMP や FreeCAD のような機能の劣る代替品に頼らざるをえない。一方、CLIのスキャフォールドは、特に組み込まれているマルチモーダルツールを優遇しており、モデルがそれらのツールに頼るよう強く促している。たとえば実際には、動画の生成に Veo 3 Preview が使われるので、評価対象のモデルは、テキストを正確に描画できないといった Veo の弱点を引き継ぐことになる。
この二つのスキャフォールドを使った RLI の最初の評価は、とりわけ問題が大きかったかもしれない。モデルには合計1時間の制限時間が与えられ、環境には関連するソフトウェアがあまりプリインストールされていなかった。しかし CAIS と Scale AI のチームは、社内のスキャフォールドに大幅な改良を加えたと私たちに伝えてくれた。プリインストールされるソフトウェアの拡充や、タスクごとの制限時間の大幅な延長などである。これらの改良は Opus 4.5 の評価の時点ですでに導入されていたが、そのスコアはわずか4%だった。
APEX-Agents は、79個のツールを備えた単純な ReAct ループに基づく独自のスキャフォールドを使う。ツールは、ファイルの一覧表示からコードの実行、文書のフッターの編集まで多岐にわたる。これらのツールはモデルが管理する。つまりモデルは、ツールをコンテキストに追加(または削除)できる。
ここでも能力を十分に引き出せていないことが問題になっているのではないかと思う。79個のツールの多くは、python-docx や python-pptx のようなよく知られた Python のツールをラップしているだけである。モデルはおそらく、ラッパーの新しい構文を覚えなければならない場合より、これらのツールを直接使うほうが得意だろう。また、ツールの数が多く、エージェント自身がツールを管理しなければならないことも、複雑さを増している。Claude Code のような、コーディングだけで作業するスキャフォールドのほうが良い成績を出すのではないかと思う。
GDPval は、ChatGPT と同様に、ウェブ検索ツールと、さまざまなライブラリがインストールされたコードインタープリタのツールを使って OpenAI のモデルを評価している。Claude のモデルはウェブUI(つまり claude.ai)を使って評価された。ウェブアプリの利用者の体験に合わせるのは妥当に思えるが、やはり Codex や Claude Code のような他のスキャフォールドのほうが良い成績を出す可能性はありそうだ。Gemini や Grok のモデルがどのように評価されたかについては、詳細は示されていない。第三者実装の GDPval-AA は、すべてのモデルで同じ独自のスキャフォールドを使っている。
結論
これらのベンチマークは、幅広い人間の専門知識を必要とし、人間なら数時間から数日かかる、切り離されたタスクでの性能を測っている。有用な測定手段だと考えているが、公平を期して言えば、名前に見合うほどのものではない。「リモート労働」は RLI に表れているよりはるかに多く、GDPの源泉も GDPval が捉えているよりはるかに多い。
ふさわしい比較対象は SWE-bench Verified かもしれない。これらのベンチマークは関連する仕事の狭い一部を捉えてはいるが、その全体を捉えてはいない。
これらのベンチマークが飽和すれば、日々の仕事を置き換えはしないとしても、大きく変えることにはなるだろう。これらの職業では、ここ数か月でプログラマーが目にしてきたのと同じように、仕事の一部が相対的に速くなるだろう。タスクの実行は加速し、計画と委任が人間の時間に占める割合が増えていく。検証も決定的に重要になり、働き手はAIの成果物が正しいかどうかの確認に、相対的により多くの時間を費やすようになる。
これらのベンチマークでの進歩は、AIシステムの実際の有用性と相関すると予想している。ただしそれは、仕事全体をそっくり置き換えるものとしてよりも、切り離されたタスクをこなすアシスタントとしての有用性である。その方向にさらに踏み込むには、現実の仕事の雑然とした文脈に置かれた、よりまとまったエンドツーエンドのタスクに取り組むベンチマークが必要になるだろう。
注
-
RLI で使われたプロジェクトを完了した時点で、フリーランサーは全員、Upwork で2,000時間以上の稼働と23,000ドル以上の収入の実績を持っていた。↩
-
あるいは聴覚的に(またはその両方で)。↩
-
これらの職種は、医療、製造、不動産など幅広い産業にまたがっている。仕事のどれだけがデジタルに行われているかは、米国労働統計局の統計を使って判断した。同局の O*NET には、さまざまな職種で行われるタスクについての細かなデータが含まれている。これらのタスクのうちどれがおもに身体的でどれがデジタルかの判断には、LLMが使われている。↩
-
ただし、アーカイブや他の第三者のサイトが同じ内容を再掲載していることもあるので、ブロックリストは万能の解決策ではない。↩
-
これは、すべての公開サンプルからリンクを抜き出し、curl で確かめて判断した。問題のあったサンプル:1、2。もちろん、この方法では、リンクが機能していても必要な情報がまだ手に入るかどうかまでは確かめられない。↩
-
RLI の方法論には、「すべての評価において、主観性を最小限に抑えるため、評価者には分別ある依頼主の視点に立つよう指示している」とあるだけである。↩
-
GDPval-AA は公開タスクだけを使い、Gemini 3 Pro にモデルの成果物を一対一で判定させて、モデルの Elo スコアを報告している。人間の成果物は使っていないので、絶対的な勝ち+引き分けのスコアは出せない。↩