
ニュースレター
ベンチマークの実施はなぜ難しいのか
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
この記事は、AIの進歩をめぐる大きな問いについて、より主張の強い、あるいは非公式な見解を紹介するニュースレター Gradient Updates の一部である。これらの記事はあくまで著者の見解であり、必ずしも Epoch AI 全体の見解を反映するものではない。
ベンチマークは、AIをめぐる状況の中で極めて重要な役割を果たしている。AI研究者から一般の人々まであらゆる人に、能力の現状と全体的な進歩の速さを伝えるからだ。Epoch AI のような第三者機関は、独立にベンチマークを実施し、その結果をベンチマーク・ハブのようなページに集約している。
しかし、ベンチマークの実施は容易ではない。ベンチマークの処理の流れ(パイプライン)のどの段階にも、最終結果に影響しうる可変要素と自由度が数多くある。そのため、二つの評価スコアを比べることは難しい。さらに、どの段階でもバグや誤りが入り込みうるので、結果を得るのに費用がかさんだり、結果が無効になったりする。
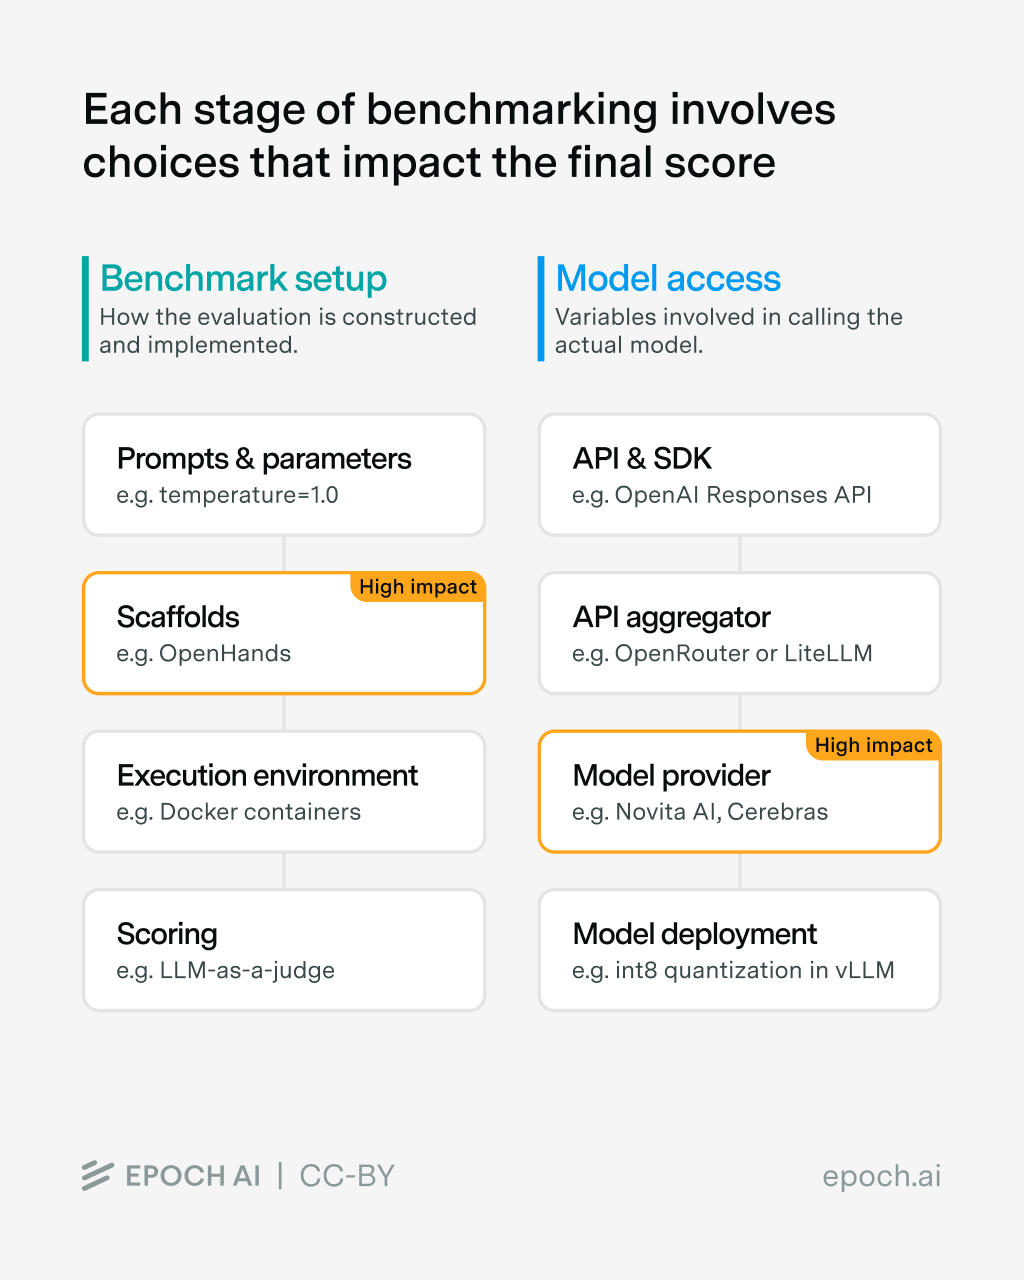
この記事では、ベンチマークの実施工程のさまざまな段階を詳しく見ていく。工程は大きく二つに分けられる。
- ベンチマークの設定:ベンチマークをどう実施するかに関わるすべての段階。たとえば、モデルにタスクを説明して各問題に答えるよう指示するプロンプトや、各サンプルを採点する方法など。
- モデルへのアクセス:評価対象のモデルそのものにアクセスする際のすべての設定。たとえば、どのAPIプロバイダーからモデルを呼び出すかなど。
Epoch AI の最新情報を受け取る 購読する
主なポイント
ベンチマークの設定のしかたとモデルへのアクセスのしかたが異なるため、同じベンチマークでの二つのスコアを比べることは難しい。ベンチマークの設定については、スキャフォールドがエージェント型のベンチマークに非常に大きな影響を与え、特に性能の低いモデルでその影響が大きい。モデルへのアクセスには、APIプロバイダーが一般に使われる。選んだAPIプロバイダーのバグや不安定さが評価の誤りの最大の原因であり、特に新しいモデルがその影響を受ける。
ベンチマークの設定
誰もがベンチマークを同じ名前で呼んでいても、全員が同じバージョンを実施している(バージョン管理があればの話だが)とは限らないし、同じ方法でベンチマークを実装しているとも限らない。これを示すため、この記事では一貫して、定評ある GPQA-Diamond ベンチマークを例として使う。
プロンプトとサンプリングパラメータ
GPQA-Diamond の最初の公開時には、このベンチマークでモデルを評価するコードを収めた分析用リポジトリが付いていた。しかし今日では、ベンチマークの実施にこのリポジトリは使われていない。代わりに、実務者はふつう、複数のモデルを複数のベンチマークで実行するためのより大きな標準化された基盤の一部として、GPQA-Diamond の評価を実装し直している。
他の多くのベンチマークと比べて、GPQA-Diamond は(再)実装が比較的簡単で、可変要素も少ない。実際、構成要素は次のものだけである。
- モデルに問題に答えるよう指示するテンプレート
- 問題と、その問題に対する四つの選択肢
問題と選択肢は固定されている(そしてすべての実装で使い回される)ので、違いが出うる要素はプロンプトのテンプレートである。評価者はまた、モデルを実行する際のサンプリングパラメータ、特に温度と、場合によっては top_p や top_k のパラメータを決めなければならない。いくつかの人気のあるベンチマーク用ライブラリで使われているプロンプトのテンプレートとサンプリングパラメータを見てみよう。
- EleutherAI/lm-evaluation-harness:
What is the correct answer to this question:{{Question}}\nChoices:\n(A) {{choice1}}\n(B) {{choice2}}\n(C) {{choice3}}\n(D) {{choice4}}\nLet's think step by step:- システムメッセージなし
- APIベースのモデルでは温度の既定値は0.0
- 注:評価とモデルの種類に応じて、異なるテンプレートと設定がある。
- OpenAI/simple-evals:
Answer the following multiple choice question. The last line of your response should be of the following format: 'Answer: $LETTER' (without quotes) where LETTER is one of ABCD. Think step by step before answering.\n\n{Question}\n\nA) {A}\nB) {B}\nC) {C}\nD) {D}- システムメッセージはモデルに応じて設定される。GPT-3.5 から GPT-4.1 までは
You are a helpful assistant.、ChatGPT ベースのモデルではこのメッセージ、Claude 3 Opus と Claude 3.7 Sonnet ではこの長いシステムプロンプト。推論モデルではシステムメッセージなし。 - 温度の既定値は0.5
- システムメッセージはモデルに応じて設定される。GPT-3.5 から GPT-4.1 までは
- OpenAI/gpt-oss:
{Question}\n\n(A) {A}\n(B) {B}\n(C) {C}\n(D) {D}\n\nExpress your final answer as the corresponding option 'A', 'B', 'C', or 'D'.- システムメッセージの設定なし
- 温度の既定値は1.0(コマンドラインからスクリプトを呼び出す場合)
- groq/openbench:
Answer the following multiple choice question. The last line of your response should be of the following format: 'Answer: $LETTER' (without quotes) where LETTER is one of ABCD.\n\n{Question}\n\nA) {A}\nB) {B}\nC) {C}\nD) {D}- システムメッセージ:
You are a helpful assistant. - 温度の既定値は0.5
- システムメッセージ:
つまり、簡単な評価の実装でさえ、基本的にみな自己流でやっている。幸い、GPQA-Diamond でAI開発企業が報告するスコアは、独立した実行の結果と一致している。私たちはまた、gpt-oss(推論の度合いは高)で GPQA-Diamond を解かせ、異なるプロンプトと温度を使う影響を検証した。設定によって平均スコアに差は見られた(74%から80%)が、GPQA-Diamond の規模が小さい(わずか198問)ことを考えると、これらの差は統計的に有意ではなかった。同じ実装でさえ、この範囲のばらつきが見られる。
GPQA-Diamond のような簡単なベンチマークでは、今日の推論モデルにとってプロンプトの影響はふつう小さいが、以前は必ずしもそうではなかった。さらに、これから見るように、より複雑なエージェント型の評価では、プロンプトを変えると大きな影響が出ることがある。
スキャフォールドは依然として非常に大きな影響を持つ
SWE-bench Verified や RLI のようなエージェント型の評価が一般的になるにつれて、ある要素がますます重要になっている。スキャフォールド、つまりエージェントを動かすソフトウェアであり、ふつうは Claude Code や OpenHands などのCLIである。
特に、スキャフォールドには上で述べたすべての要素、つまりサンプリングパラメータとプロンプトのテンプレートが含まれる。さらに重要なことに、スキャフォールドはエージェントに一連のツール、つまり特化したアプリケーションや機能へのアクセスも与える。具体的なツールとプロンプトは、どのスキャフォールドを選ぶかによって大きく変わる。
人気のあるエージェント型コーディングのベンチマークである SWE-bench Verified では、スキャフォールドを切り替えるだけで、GPT-5 では最大11%、Kimi K2 Thinking では最大15%の差が生じる。スキャフォールドの影響については、SWE-bench Verified のレビューで取り上げている。全体の性能に最も大きな影響を与える単一の要因は、スキャフォールドの選択である。
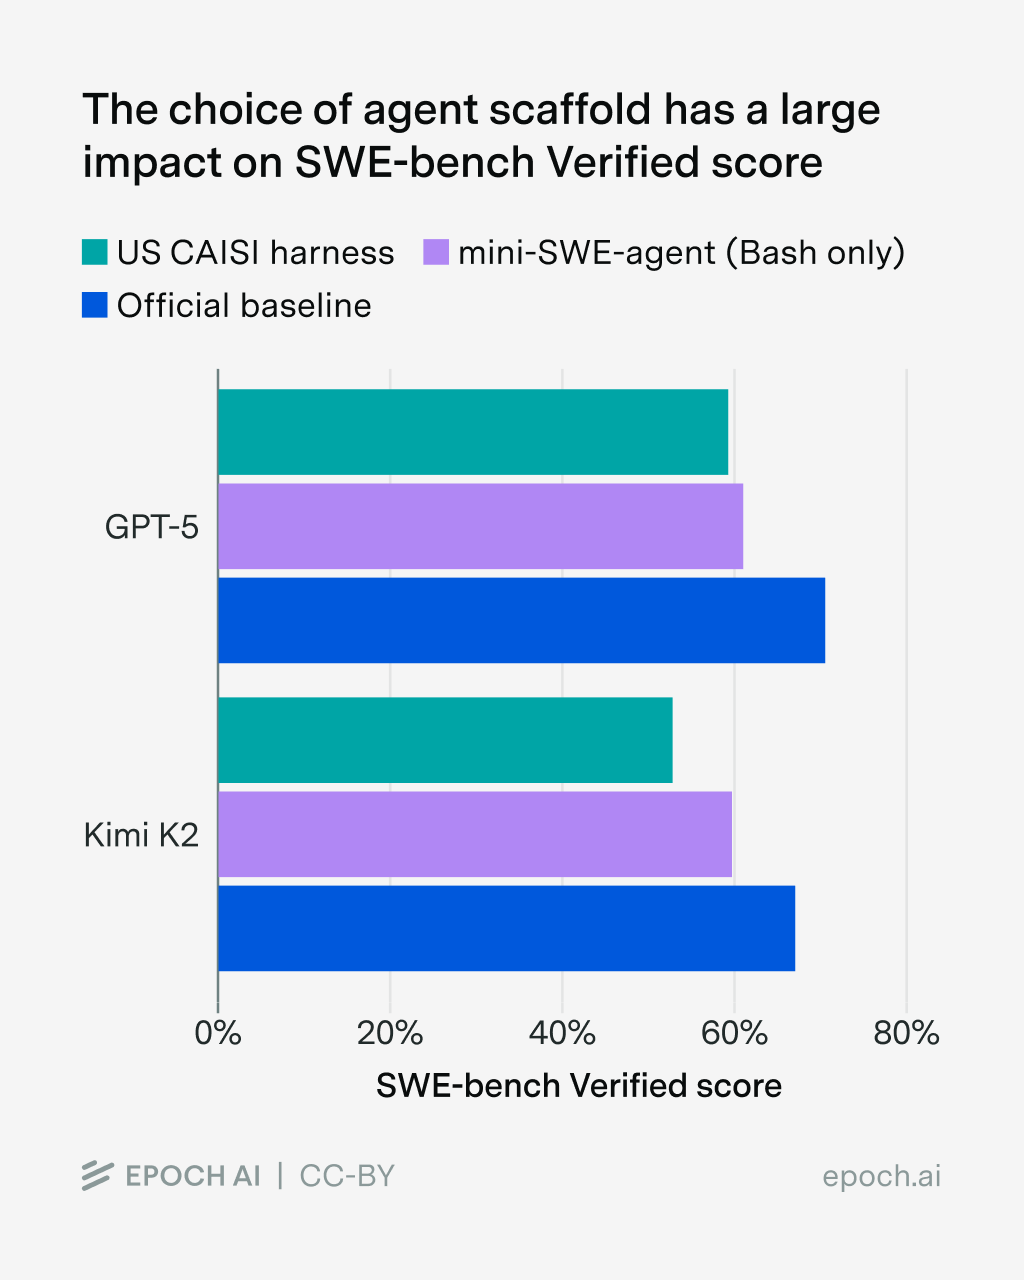
モデルごとにハーネスをカスタマイズすると、評価に合わせた過剰な最適化(ヒルクライミング)に陥るおそれがあり、モデル同士を直接比べることも難しくなる。そのため、エージェント型のベンチマークを評価する方法は二つある。モデルを比べることが目的なら、ふつうは(mini-SWE-agent のような)標準化されたスキャフォールドで十分である。一方、最先端の能力を評価するには、Claude Code のような主要な製品を使う必要がある。どちらの選択にも、特に再現性の点ではっきりとしたトレードオフがあり、追加のエンジニアリング作業も必要になる。
実行環境
LLMは、特にエージェント型の評価では、何らかの実行コンテキストや環境の中で動作しなければならない。具体的には、コンピュータ操作の評価なら仮想マシン、コーディングの評価なら Docker コンテナといったものである。こうした環境を作って維持するのは難しい。OpenAI は o3 と o4-mini の評価で、基盤上の課題のために SWE-bench Verified の500問のうち477問しか実行しなかった。
環境に致命的な誤りが含まれていることもある。その場合、エージェントが評価の抜け穴を突けてしまう(あるいはバグのせいでタスクを達成できない)。これは、エージェントがウェブで情報を検索できる評価で特に当てはまる。最悪の場合、エージェントは元のデータセットや、問題の一部を転載しているサイトを見つけられてしまう。公開ウェブはあまりに広大なので、遮断するドメインのリストを継続的に管理する必要がある。
環境の影響は、スキャフォールドと比べれば中程度である。エージェントがサンプルの大きな割合で抜け穴を突ける場合や、環境が実際に壊れている場合を除けば、ふつう環境が結果に与える影響は小さい。
採点
どの評価でも、最後の段階は与えられたサンプルを採点することである。回答を抽出して採点するために、GPQA-Diamond の実装ではふつう正規表現による解析を使う。これは、ありうる例外的なケースやモデルの回答をすべて拾えるよう調整できる。SWE-bench Verified のようなコーディングのベンチマークは、モデルが生成したコードを実行するテストスイートを使って採点される。
SimpleQA のような他の評価では、2つ目のLLMを使って回答を抽出し、その正誤を判定する。一方、tau-bench のような評価では、2つ目のLLMを使って、評価対象のモデルがやりとりするユーザーを模擬する。この2つ目のLLMの選択は、ベンチマークのスコアにかなりの影響を与えうる。
モデルへのアクセス
ベンチマークを実装する際の選択は評価者が制御できるが、ばらつきの原因はそれだけではない。モデルそのものにも何らかの方法でアクセスしなければならないからだ。
APIとSDK
プロンプトはまず、評価の実行中に呼び出されるSDKとAPIのエンドポイントを経由して送られる。標準的な OpenAI ChatCompletions を使えば、多種多様なモデルを簡単に使える。すべてのサービスとプロバイダーが OpenAI 互換のエンドポイントを提供しているからだ。
しかし、これでは性能を取りこぼすかもしれない。OpenAI は、自社の Responses API を使うことで SWE-bench Verified で最大3%の改善が得られると報告している。また、Anthropic のように、OpenAI ChatCompletions 互換のエンドポイントでは機能の一部しか提供していないプロバイダーもある。Minimax は、標準の ChatCompletions API と比べて自社のAPI実装を使うと、tau-bench での性能に23パーセントポイントという桁外れの差が出ると報告している。したがって、モデルの能力を引き出し損ねないためには、正しいSDKを使うことが重要である。
APIアグリゲーター
もちろん、すべてのプロバイダーに自分で対応するのは手間のかかる作業であり、そのための解決策もある。LiteLLM や Inspect AI は、どのプロバイダーのどのモデルともやりとりできる統一的なインターフェースを提供している。このほか、HuggingFace Inference Providers や OpenRouter のようなサービスを使えば、さまざまなモデルとそのプロバイダーに一つの窓口からアクセスできる。当然ながら、これらはAPIの上に層を一枚かぶせる必要があり、それが新たなバグを生むことがある1。
モデルのプロバイダー
しかし、評価結果のばらつきの最大の要因は、特にオープンなモデルの場合、モデルそのもののプロバイダーである。どのプロバイダーを選ぶかは、どのサンプリングパラメータに対応しているかと、実際のタスクでの性能の両方に影響する。
APIプロバイダーの影響を自分たちで検証するため、いくつかの人気のあるオープンなモデルで GPQA-Diamond を実行し、4回の実行のスコアを平均した2。エラーが出た場合は各サンプルを最大3回まで再試行し、(APIの)エラーは失敗したサンプルとして採点した3。
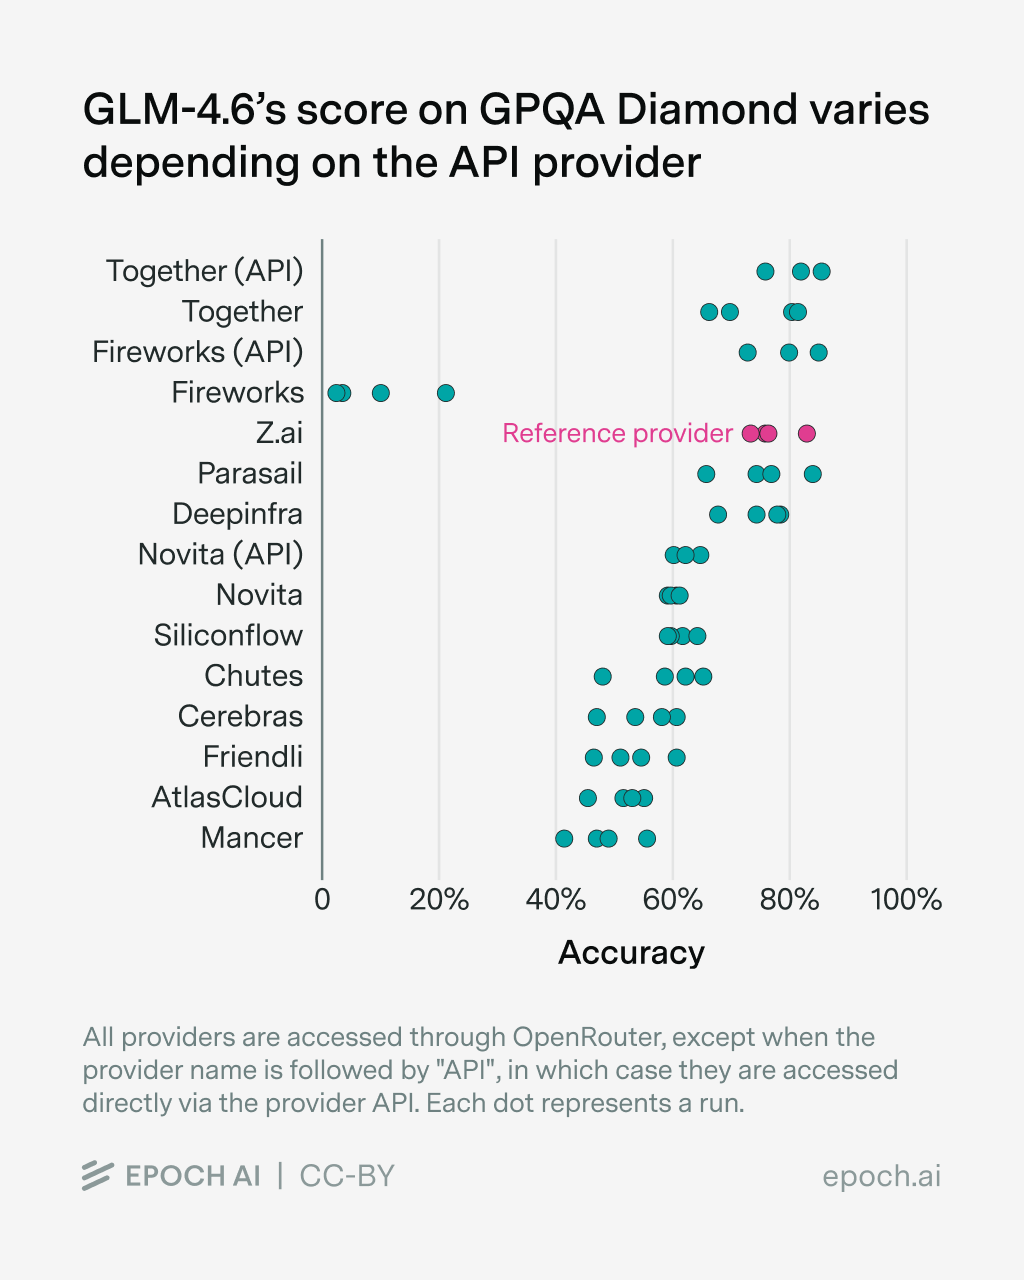
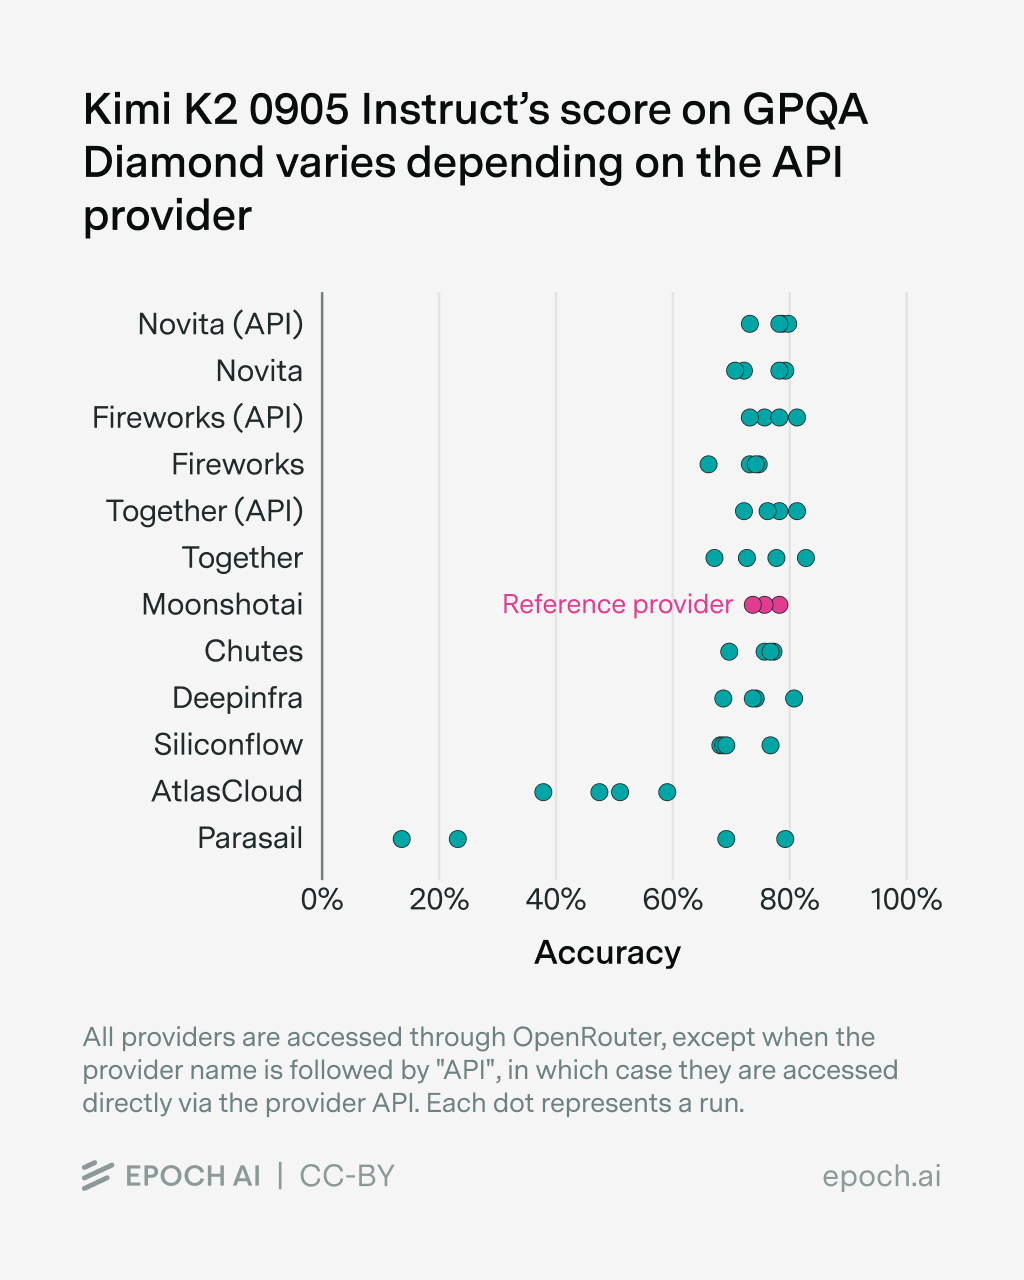
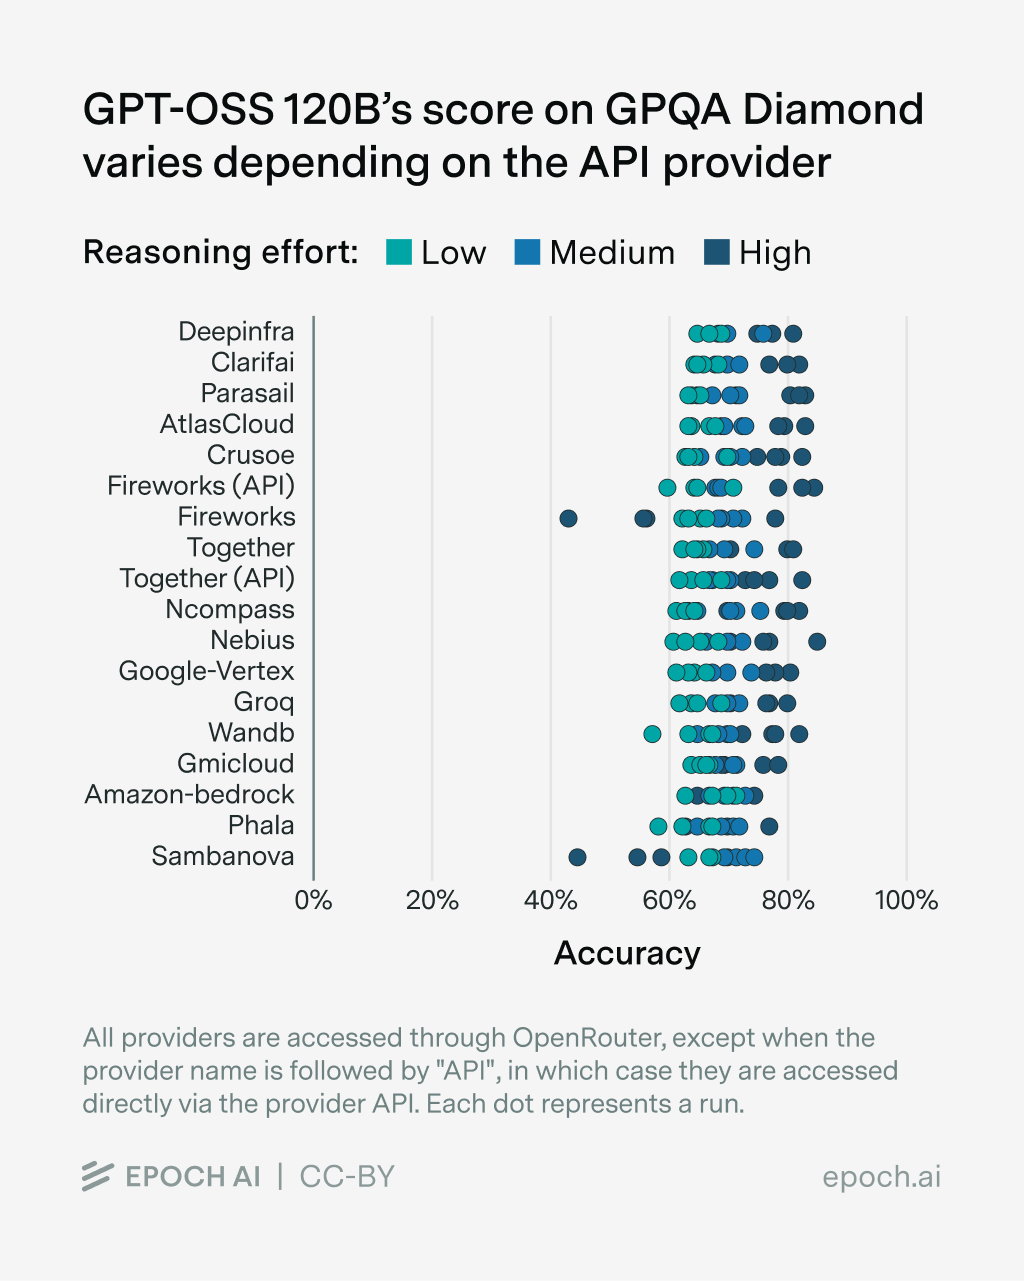
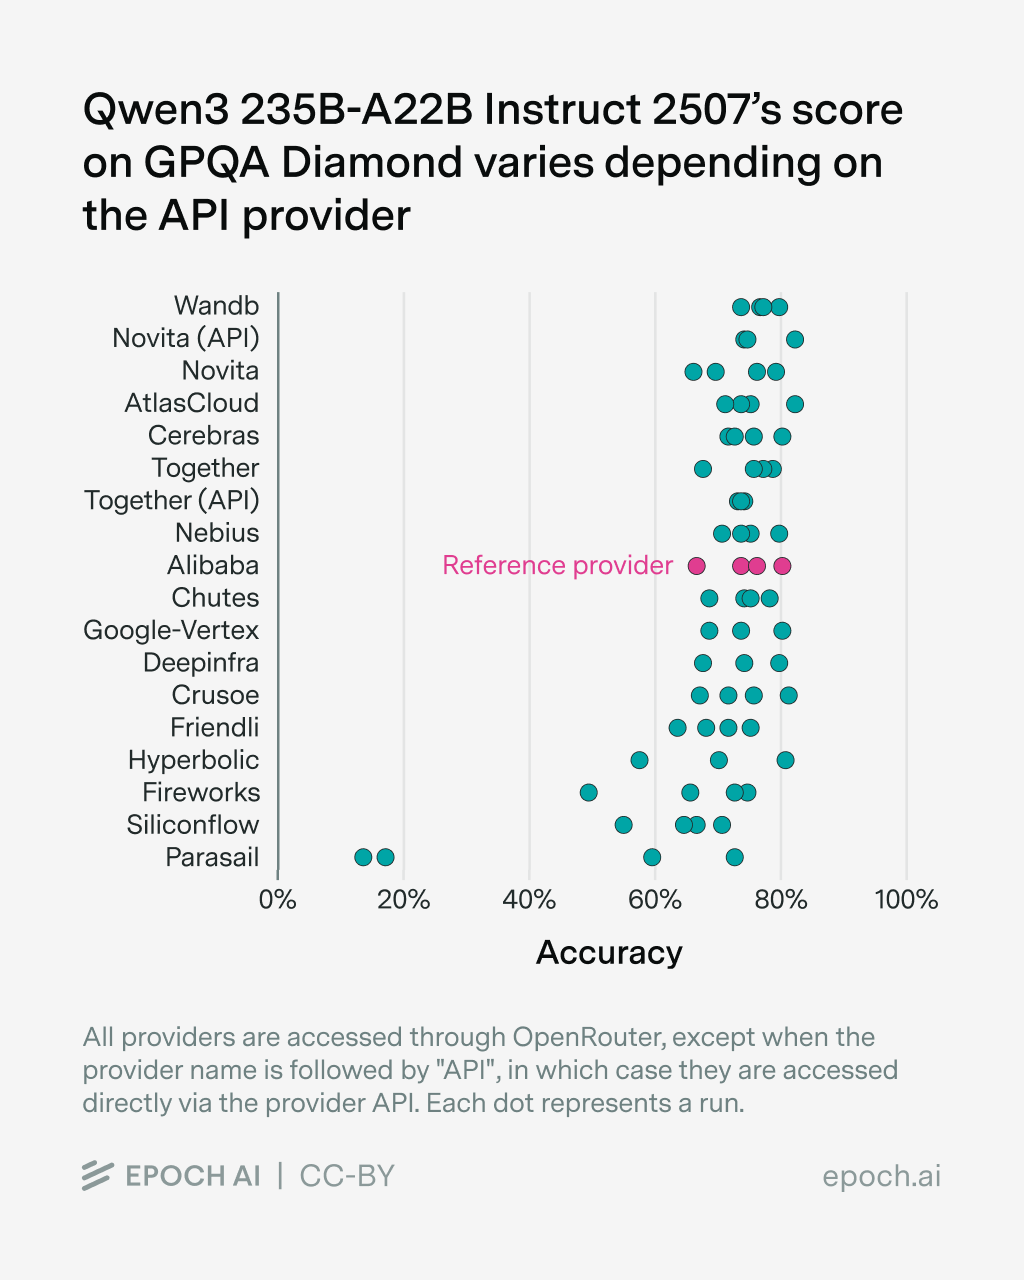
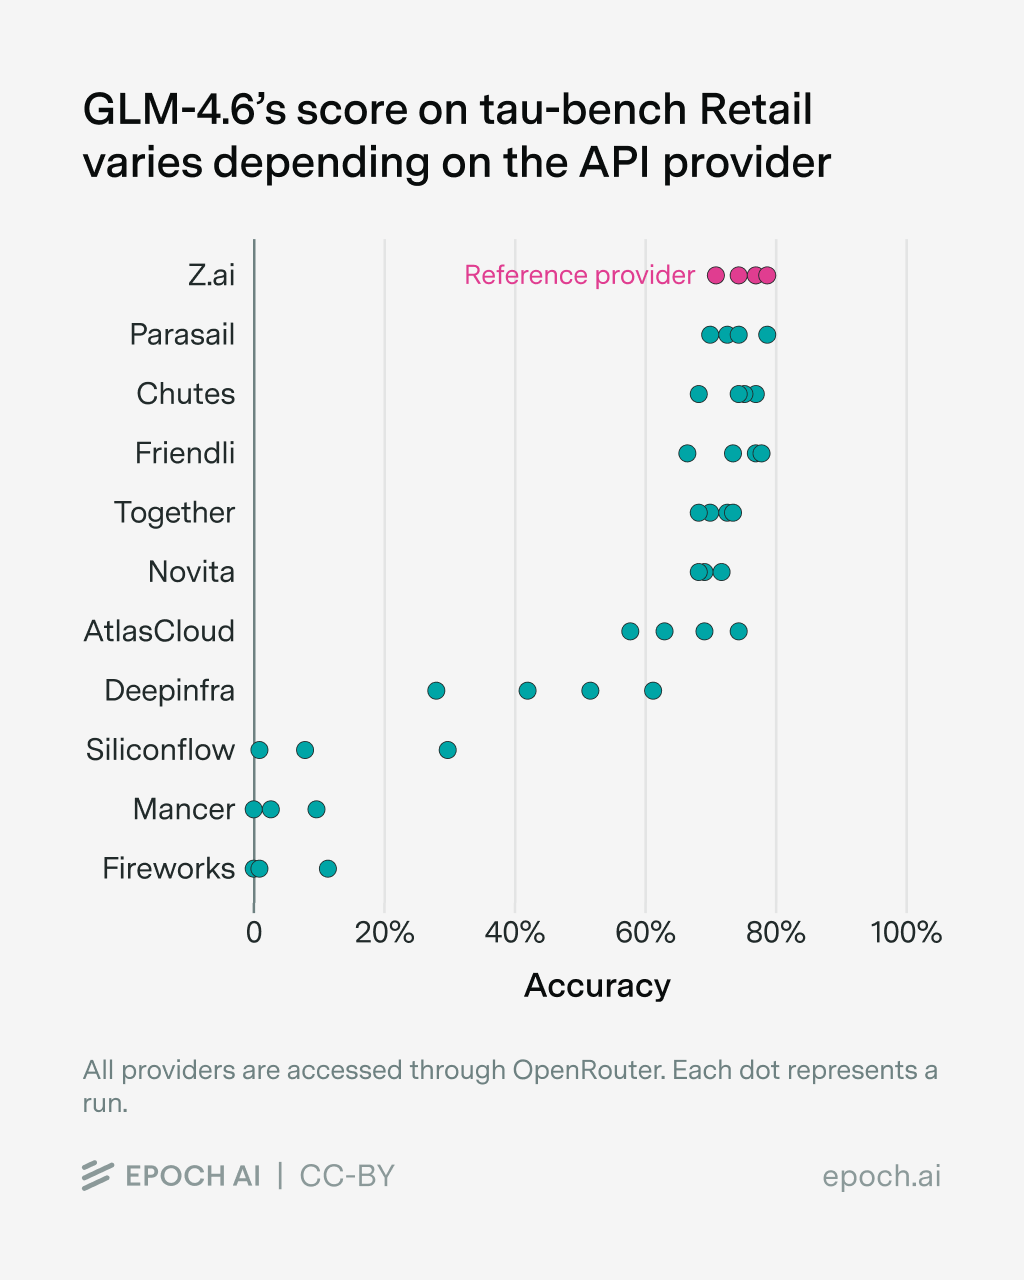
検証したすべてのモデルで、モデルのプロバイダーによってベンチマークのスコアに差が見られた。ただし、影響の大きさはモデルによって異なる。さらなる結果は付録にある4。観察されたエラーの原因はさまざまだった。
- 一部のプロバイダーは、特に OpenRouter 経由で GLM-4.6 にアクセスする場合に、RateLimitError を返す。主に影響を受けるプロバイダーは、Fireworks(OpenRouter 経由)、GMICloud、Mancer、Parasail、DeepInfra、SiliconFlow である。これらのサンプルは失敗として採点されるので、該当するプロバイダーのスコアは大きく影響を受ける。
- 一部のプロバイダーは、
max_tokensに達していないのに、空の応答や途中で切れた応答を返す。AtlasCloud、Mancer、Fireworks(OpenRouter 経由)がこれに当たる。 - 一部のプロバイダーは、
max_tokensが公称より低く、APIリクエストでより高い上限を設定しても、応答が途中で切れる。SiliconFlow、Friendly、Cerebras がこれに当たる。 - 一部のプロバイダーは、
max_tokensの上限が、該当するモデルの評価に必要な値より低い。これらのプロバイダーは、その評価から完全に外した。例として gpt-oss 120B がある。GPQA-Diamond を適切に評価するには3万2,000トークンを超える長さが必要だが、Novita、SiliconFlow、Cerebras などのプロバイダーの上限はそれより低い。 - ごく一部の応答はタイムアウトに達する。タイムアウトは既定で10分に設定されている。
- まれに、モデルの応答が「破滅ループ」に陥る。つまり、モデルが応答の一部を延々と生成し直し、
max_tokensの上限に達してしまう。 - GPT-OSS では、あるプロバイダー(Amazon Bedrock)が OpenRouter から正しい
reasoning_effortを受け取れず、推論の度合いの三つの水準すべてで同じ性能になる。
これらのエラーとは別に、プロバイダーは、Qwen3 のような定着したモデルと比べて、新しいモデル(今回の場合は GLM-4.6)の提供が目に見えて下手であることもわかった。これは他のモデルのリリースとも一致している。そうしたリリースはバグを伴い、それが時間をかけて修正される。しかし、独立したベンチマーク機関は新しいモデルをできるだけ早く評価したいと考えている。
モデルの性能を最も大きく左右するのは、適切なプロバイダーを選ぶことである。モデルの開発者はふつう自前のAPIを提供しており、それを基準にすることもできる。しかし、こうした自前のAPIは、第三者のAPIよりもデータセキュリティの保証が弱いことが多いため、評価者は非公開のベンチマークにはそれを使わないほうを選ぶかもしれない。
実際には、ベンチマークを実施する側は、第三者のAPIで既知のスコアを再現しようと何度も試み5、正しく実装されていることを願うしかない。これは手間と費用のかかる作業であり、(オープンなモデルの)評価に多くの時間がかかる主な理由の一つである。
モデルのデプロイ
内部に目を向けると、モデルの性能が報告されたスコアと異なったり、モデルのプロバイダーの間で異なったりする理由は複数ある。その範囲は、異なる推論実行エンジン(vLLM、SGLang、非公開のフォーク)、参照実装のバグ、古いチャットテンプレートといったソフトウェアから、使われるハードウェアとそれに応じたデプロイにまで及ぶ。そう、異なる並列化の設定、つまりモデルを複数のGPUにどう分散・分割するかでさえ、小さいながらも測定可能な影響を与えるのである。
結論
ベンチマークの実施は容易ではなく、グラフや表で目にする見出しの数字には多くの変数が影響している。これらの変数の多くは、単独では重要でないように見える。しかし、スタック全体ではすぐに積み重なり、モデルの開発者が報告するスコアと大きく異なる数字につながりうる。
これらの変数のうち、使うプロンプトやスキャフォールドなどは、ベンチマークを作成・再実装・実施する側が制御できるが、そうでないものもある。これは特に、(第三者の)APIを使ったモデルへのアクセスに当てはまり、趣味で取り組む人や学術研究者のような資源の乏しい主体の足を引っ張る。評価の誤りはまた、AI研究者から意思決定者、一般の人々に至るまで、他の人々が能力の進歩の現状を正確に評価することも難しくする。
OpenRouter には、同社のプラットフォームでの実験に使うクレジットを快くご提供いただいた。成果物の編集権は私たちが完全に保持した。
付録
GPT-OSS 120B(推論の度合いの三つの水準すべて)、GLM-4.6、Qwen3 235B-A22B Instruct 2507、Kimi K2 Thinking、Kimi K2 0905 Instruct を、APIプロバイダーだけを変え、他のすべてを一定に保って GPQA-Diamond で評価した。
GLM-4.6(エージェントとユーザーの両方のモデルとして)を、APIプロバイダーを変え(エージェントとユーザーには同じプロバイダーを使う)、他のすべてを同じに保って tau-bench Retail で評価した。
GPQA-Diamond にはこの実装を、tau-bench にはこの再実装を使っている。分析に用いたデータもすべてこのリンクで公開している。
GPT-OSS 120B
Kimi K2 Thinking

Qwen3 235B-A22B Instruct 2507
GLM-4.6
注
-
このバグはその後(ほぼ)修正された。 ↩
-
通常、GPQA-Diamond のようなベンチマークは8〜32回実行して平均をとる。私たちは費用の理由から4回の実行とした。GPQA-Diamond にはこの実装を、tau-bench にはこの再実装を使っている。 ↩
-
もちろん、これは Epoch AI ベンチマーク・ハブでモデルを評価するときの方針ではない。ハブでは、異常な事例を除き、エラーがなくなったことを確かめてからスコアを報告している。しかし、プロバイダーと、それがベンチマークの実施をどう複雑にするかを評価するという目的には、この取り決めが理にかなっていると考える。 ↩
-
量子化の程度や、場合によってはデプロイのバグを検出する手法もあるが、それには正しく構築されたローカル環境へのデプロイ、プロバイダーの推論実行エンジンについての知識、そしてシード値のようなサンプリングパラメータが公開されていること(すべてのプロバイダーが提供しているわけではない)が必要である。 ↩