
レポート
ニューラルネットワークの逆伝播/順伝播 FLOP 比はどれくらいか?
原題:What’s the backward-forward FLOP ratio for neural networks?
要約
- 典型的な設定、すなわち畳み込み層を持ち、バッチサイズが大きい深いネットワークでは、逆伝播/順伝播の FLOP 比はほぼ常に 2:1 に近い。
- 次の条件によっては、1:1 から 3:1 の間の比になることがある。
- 層の種類:線形層では、伝播にかかる FLOP と重みの更新にかかる FLOP が同じである。畳み込み層では、伝播の FLOP が重みの更新の FLOP よりはるかに多い。したがって CNN では、重みの更新の FLOP は基本的に何の役割も果たさない。
- バッチサイズ:重みは、バッチの勾配を集約した後に更新される。そのため、伝播の FLOP はバッチサイズとともに増えるが、重みの更新の FLOP は一定のままである。
- 深さ:最初の層の逆伝播/順伝播比は 1:1 だが、それ以外の層はすべて 2:1 である。したがって全体の比は、最初の層の FLOP とそれ以外の層の FLOP の割合に左右される。
- ネットワークは確率的勾配降下法(w += ɑ⋅dw)で最適化されていると仮定し、重みの更新を逆伝播の一部として数える。ほかのオプティマイザを使えば FLOP の数は変わり、特殊な設定では 3:1 より大きい比になることもありうる(付録Bを参照)。ただし、典型的な設定での 2:1 という比(第1項を参照)は、モメンタムや Adam を使っても成り立つはずである。
重みの更新の計算負荷 | 最も計算負荷の大きい層 | 逆伝播/順伝播比 |
|---|---|---|
大きいバッチサイズ、または計算負荷の大きい畳み込み層がある | 最初の層 | 1:1 |
それ以外の層 | 2:1 | |
小さいバッチサイズ、かつ計算負荷の大きい畳み込み層がない | 最初の層 | |
それ以外の層 | 3:1 |
はじめに
ニューラルネットワークで逆伝播を計算するには、順伝播と比べてどれだけ多くの浮動小数点演算(FLOP)が必要なのだろうか。この比を、逆伝播/順伝播 FLOP 比と呼ぶ。
この比は、順伝播の計算量から学習計算量の総量を推定するのに役立つ。私たちは、Parameter, Compute and Data Trends in Machine Learning(機械学習におけるパラメータ・計算量・データのトレンド)の研究でこの点に関心を持っている。
本稿ではまずこの比を理論的に分析し、次にその結果を実験で裏づける。
理論
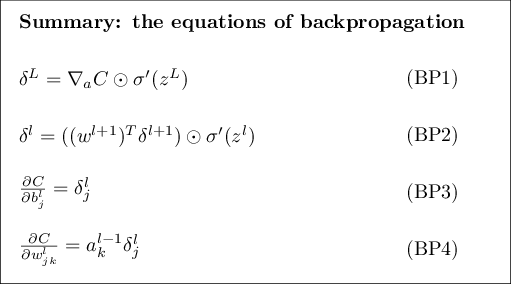
比の違いがどこから来るのかを理解するには、古典的な誤差逆伝播法の方程式を見る必要がある。
単純な例として、隠れ層が2つあるニューラルネットワークから始めよう。
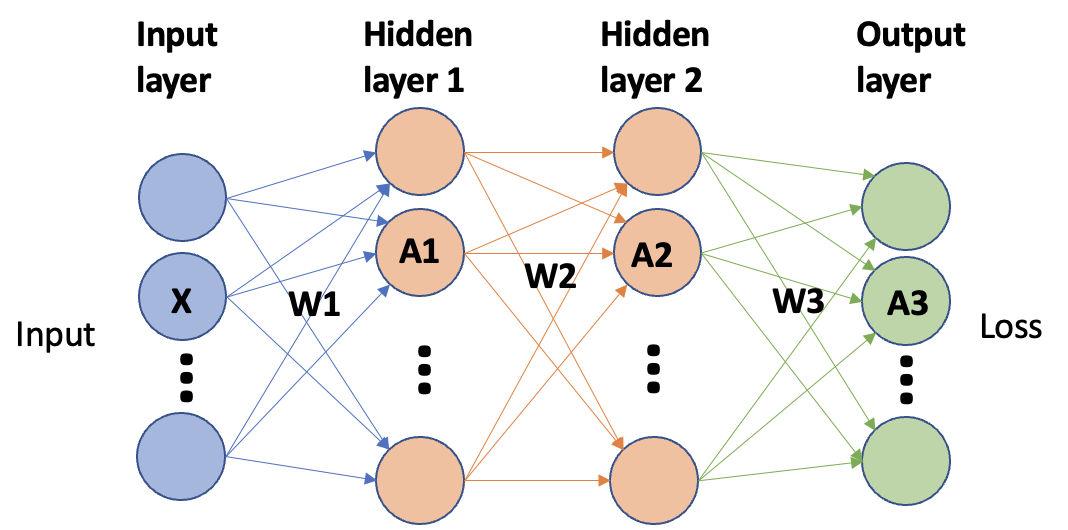
この例で、活性化関数に ReLU を使う線形層を仮定すると、順伝播と逆伝播の計算は次のようになる。「@」記号は行列の積を表す。
演算 | 計算 | 順伝播の FLOP | 計算 | 逆伝播の FLOP |
| 入力 | A1=W1@X | 2*#input*#hidden1*#batch | dL/dW1 = δ1@X | 2*#input*#hidden1*#batch |
| ReLU | A1R=ReLU(A1) | #hidden1*#batch | δ1 = dδ1R/dA1 | #hidden1*#batch |
| 微分 | δ1R=dL/dA2 =W2@δ2 | 2*#hidden1*#hidden2*#batch | ||
| Hidden1 | A2=W2@A1R | 2*#hidden1*#hidden2*#batch | dL/dW2 =δ2@A1R | 2*#hidden1*#hidden2*#batch |
| ReLU | A2R=ReLU(A2) | #hidden2*#batch | δ2 = dδ2R/dA2 | #hidden2*#batch |
| 微分 | δ2R=dL/dA3 =W3@δ3 | 2*#hidden2*#output*#batch | ||
| Hidden2 | A3=W3@A2R | 2*#hidden2*#output*#batch | dL/dW3 =δ3@A2R | 2*#hidden2*#output*#batch |
| ReLU | A3R=ReLU(A3) | #output*#batch | δ3 = dδ3R/dA3 | #output*#batch |
| 損失 | L=loss(A3R,Y) | #output*#batch | δ3R = dL/dA3R | #output*#batch |
| 更新 | W+=lr*δW | 2*#weights |
重みの更新は個々の層から切り離して扱う。更新は集約の後に行われるからである。つまり、まず異なるバッチから来るすべての勾配を足し合わせ、それから学習率を掛ける。
この表から次のことが分かる。
- ReLU と損失関数が寄与する FLOP は、層に比べて無視できるほど小さい。
- 最初の層では、逆伝播/順伝播 FLOP 比は 1:1 である。
- それ以外のすべての層では、逆伝播/順伝播 FLOP 比は 2:1 である(ReLU を無視した場合)。
式で表すと、逆伝播/順伝播 FLOP 比は次のようになる。
逆伝播 / 順伝播 =
(最初の層の順伝播 FLOP + 2*それ以外の層の順伝播 FLOP + 重みの更新)/(最初の層の順伝播 FLOP + それ以外の層の順伝播 FLOP)
この式でどの項が支配的になるかを見るには、次の2点を考えればよい。
- 計算のうちどれだけが最初の層で行われるか。
- 重みの更新にかかる演算は、層での計算と比べてどれくらいか。バッチサイズが大きいか、多くのパラメータが共有されていれば、この項は無視できる。そうでなければ、重みの更新 ≈ 最初の層の順伝播 FLOP + それ以外の層の順伝播 FLOP と近似できる。
ここから、考えられる4つの場合が導かれる。
重みの更新が大きい | 重みの更新が小さい | |
最初の層が支配的 | 2*最初の層の順伝播 FLOP / 最初の層の順伝播 FLOP = 2:1 | 最初の層の順伝播 FLOP / 最初の層の順伝播 FLOP = 1:1 |
それ以外の層が支配的 | 3*それ以外の層の順伝播 FLOP / それ以外の層の順伝播 FLOP = 3:1 | 2*それ以外の層の順伝播 FLOP / それ以外の層の順伝播 FLOP = 2:1 |
現代の機械学習では、バッチサイズの大きい深いネットワークが標準であり、その場合この分析は 2:1 に近い比を予測する。
要するに、理論的な分析からは、逆伝播/順伝播 FLOP 比は 1:1 から 3:1 の間になり、2:1 が典型的な場合だと予測される。
実験結果
分析を裏づけるため、NVIDIA の pyprof プロファイラを使って、逆伝播と順伝播で各層の FLOP 数を調べる。
この節では次の点を調べる。
- 最初の層とそれ以外の層での、逆伝播/順伝播比の違い。
- 畳み込み層と線形層での、重みの更新の違い。
- 大きいバッチサイズが重みの更新に与える影響。
- 深さが逆伝播/順伝播比に与える影響。
- バッチサイズ、畳み込み層、深さを組み合わせた影響。
要するに、実験結果は理論的な結論を裏づけている。
以前の記事では、利用率の推定を試みた。そこで詳しく述べたように、このプロファイラには数え漏れと数えすぎがある。そのため、推定値のいくつかはわずかにずれていると考えている。
これはできるかぎり補正しようとした。具体的には、二重に数えられていると思われる演算をいくつか除き、確率的勾配降下法で数えられていないと思われる、学習率を掛ける演算を加えた。
最初の層とそれ以外の層での逆伝播と順伝播の FLOP
これは単純な線形ネットワークを見ることで実験的に調べられる(コードは付録)。
その結果、FLOP 数は次のようになる。
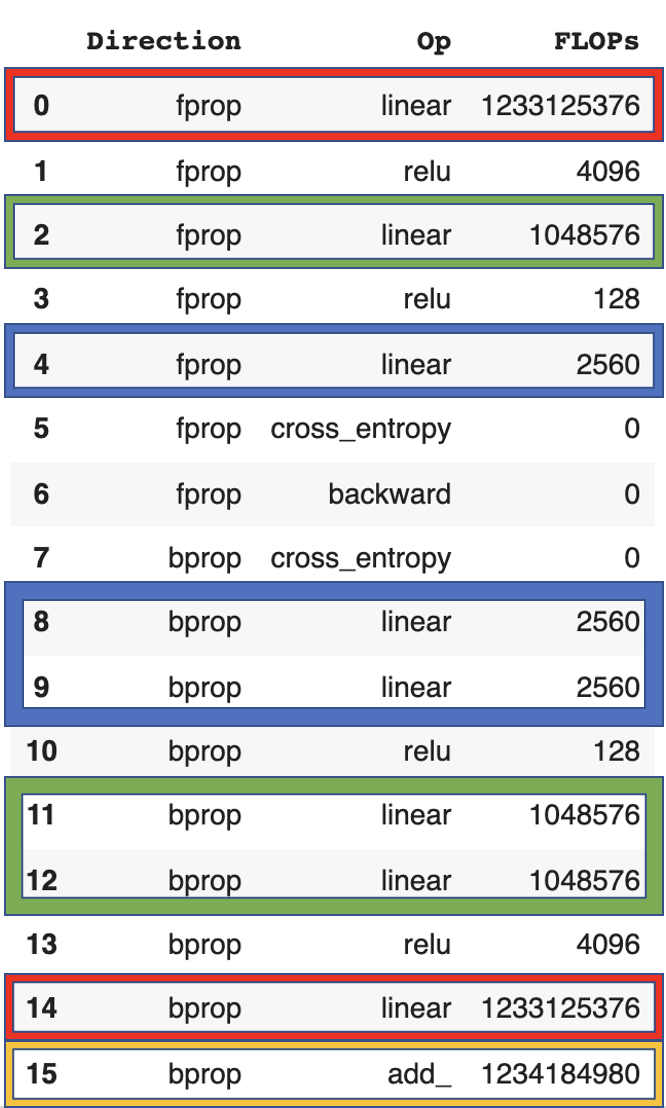
最初の層(赤)は順伝播と逆伝播の FLOP 数が同じであるのに対し、それ以外の層(青、緑)の比は 2:1 であることが分かる。最後の重みの更新(黄)は、ネットワークのパラメータ数の2倍である。
層の種類
FLOP 数は層の種類によって異なる。
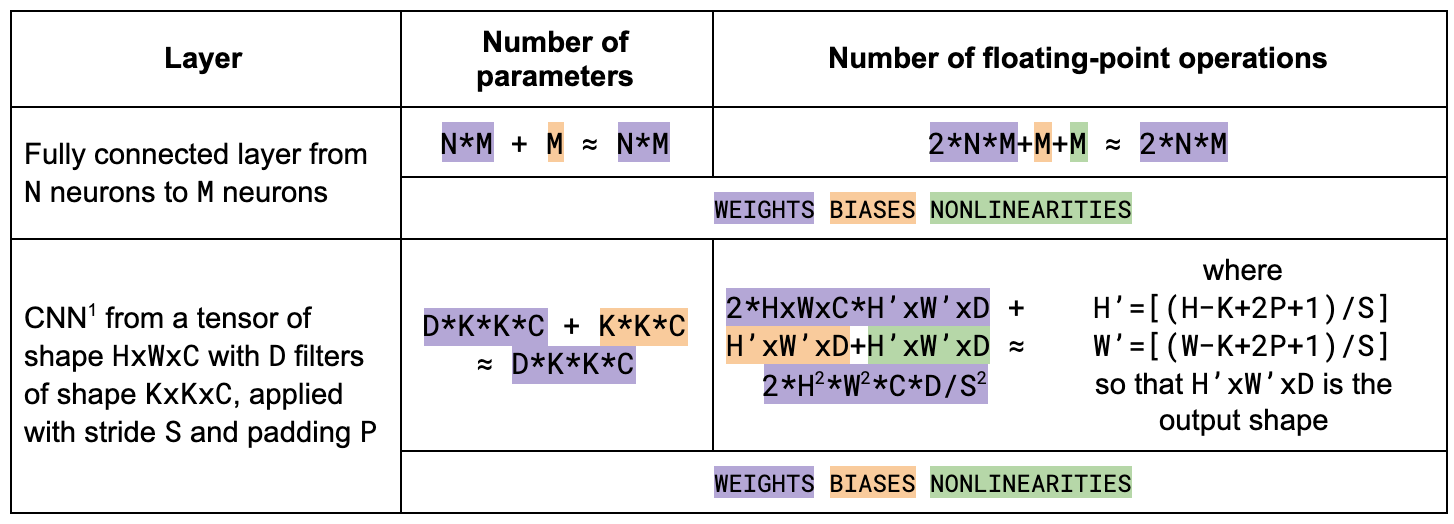
見てのとおり、線形層の FLOP 数はパラメータ数の2倍である。CNN では、FLOP 数はパラメータ数よりはるかに多い。つまり、最後の重みの更新は、CNN では基本的に無視できるが、線形ネットワークでは無視できない。
これを実験で示すため、小さな CNN についてプロファイラが数えた FLOP 数を見る(コードは付録)。
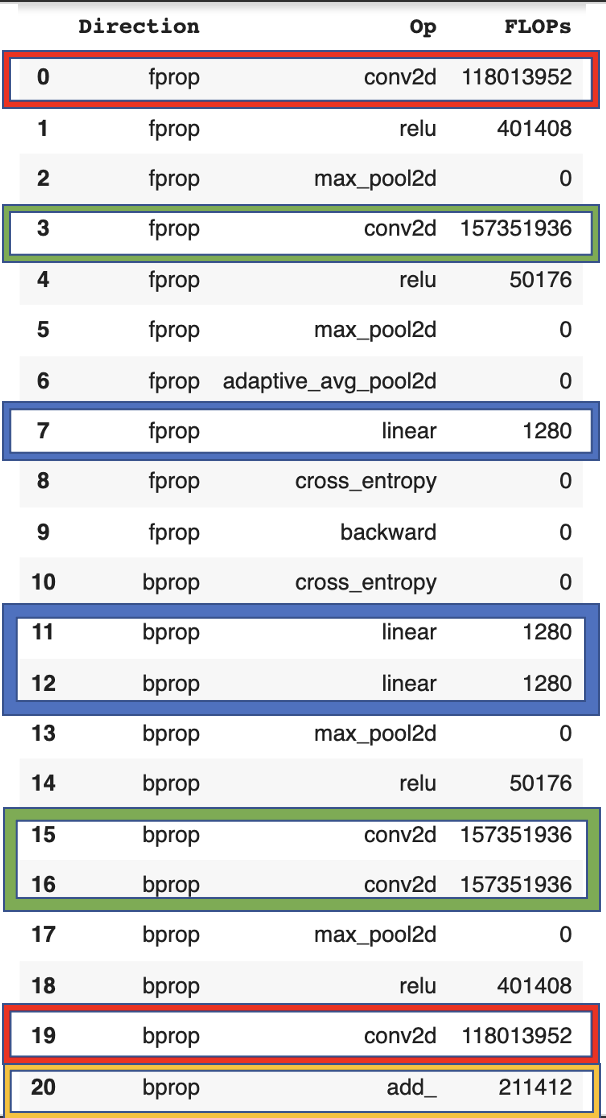
線形ネットワークと同様に、最初の層の逆伝播/順伝播比は 1:1、それ以外の層はすべて 2:1 であることが確認できる。ただし、層(赤、青、緑)の FLOP 数は、重みの更新(黄)よりはるかに大きい。
バッチサイズ
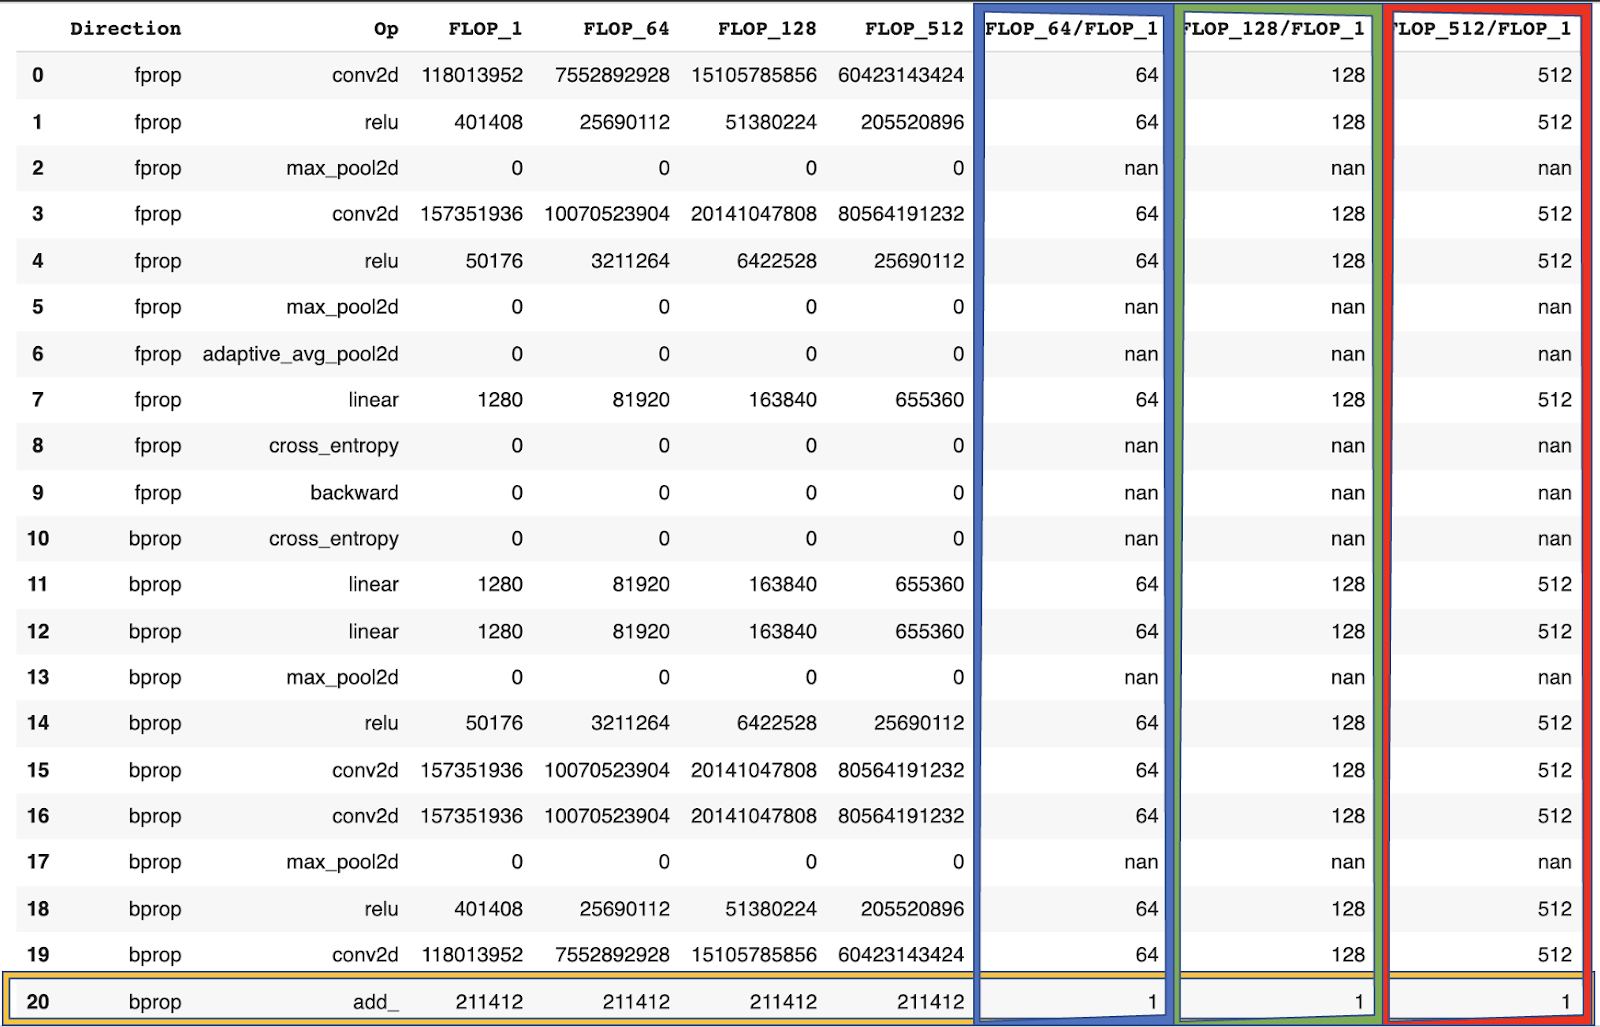
勾配は重みの更新の前に集約される。そのため、重みの更新の FLOP はバッチサイズが変わっても同じままである(黄)一方、それ以外のすべての演算の FLOP はバッチサイズに比例して増える(青、緑、赤)。その結果、バッチサイズが大きくなると、重みの更新による FLOP は無視できるほど小さくなる。
深さ
深さ、つまり層の数は、間接的な影響しか持たない。これは、最初の層の比が 1:1 であるのに対し、その先の層の比が 2:1 であることによる。したがって、実際に効いてくるのは、最初の層の FLOP とそれ以外の各層の FLOP の比である。
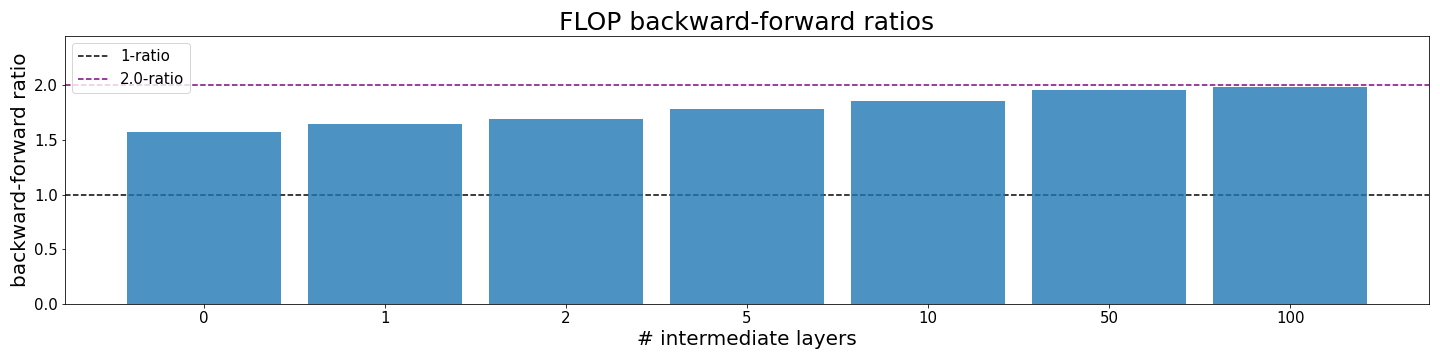
この効果を示すため、中間の畳み込み層の数を変えた CNN を定義する(コードは付録)。
中間層が0のときは逆伝播/順伝播比が 2:1 を大きく下回るところから始まり、中間層の数を増やすにつれて 2:1 に収束していくことが分かった。
深層学習でよく使われる CNN のアーキテクチャの多くは十分に深いので、最初の層が全体の FLOP 数に強く影響することはなく、比は 2:1 に近くなるはずである。このことを、さまざまな種類の ResNet とバッチサイズについて実験で確かめた。期待される 2:1 の比からいくらかずれることもあったが、これはプロファイラが一部の演算を数え漏らしている結果だと考えている。プロファイラの問題については以前の記事で説明した。
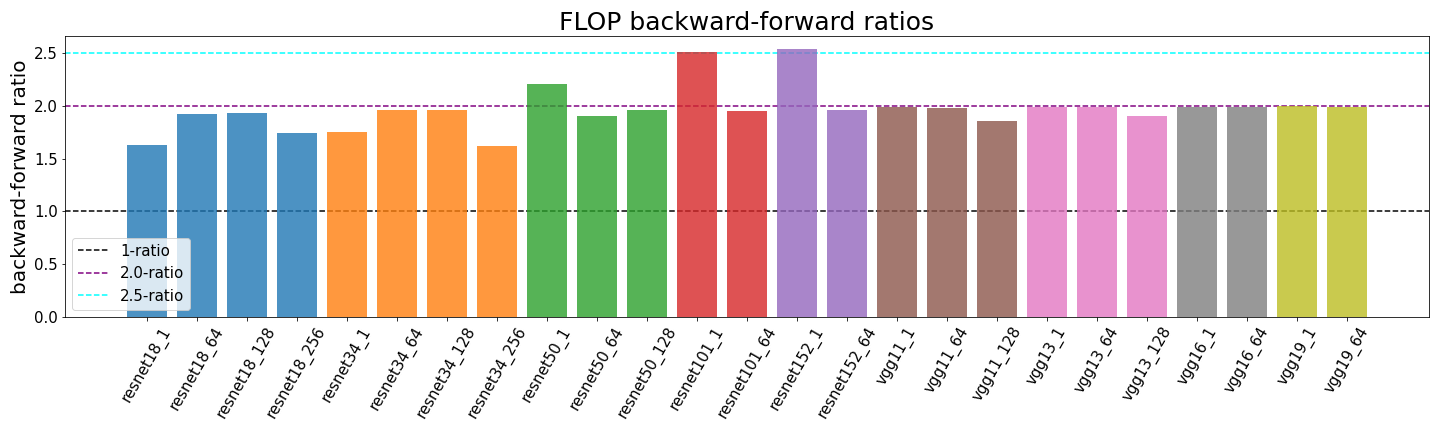
さまざまなアーキテクチャにおける逆伝播/順伝播 FLOP 比。ラベルは「アーキテクチャ_バッチサイズ」と読む。
以上をすべて組み合わせる
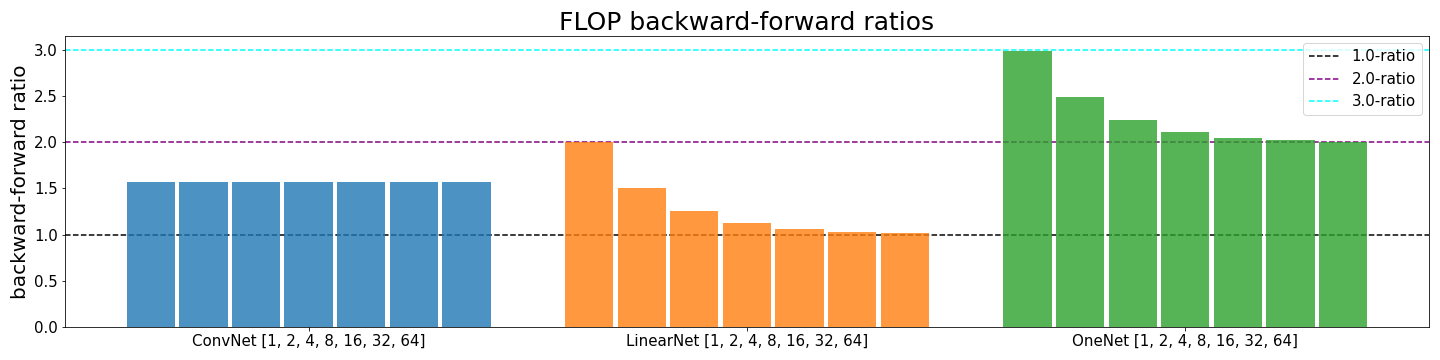
バッチサイズ、層の種類、深さは互いに影響し合う。以下ではその関係を調べたい。これまでに使った小さな CNN と線形ネットワークを、OneNet と呼ぶネットワークと比較する(コードは付録)。OneNet は入力ニューロンが1つしかなく、2番目と3番目の層が大きい。そのため最初の層とそれ以外の層の比は非常に小さく、逆伝播/順伝播比の理論上の最大値である 3:1 が実際に観測できることが分かる。
さらに、3つのアーキテクチャすべてについて、バッチサイズを指数的に増やしていく。線形ネットワーク、すなわち LinearNet と OneNet の場合は、重みの更新の影響が小さくなるので、バッチサイズが大きくなるにつれて比は下がる。CNN の場合は、FLOP 数は層に完全に支配され、重みの更新は無視できる。この効果は非常に強く、図には何の変化も見られない。
バッチサイズが大きくなると、LinearNet は逆伝播/順伝播比 1:1 に、OneNet は 2:1 に収束することが分かる。これは、LinearNet の重みのほぼすべてが最初の層にあり、OneNet の重みのほぼすべてがそれ以外の層にあるためである。
結論
ニューラルネットワークの逆伝播/順伝播 FLOP 比は、通常は 1:1 から 3:1 の間で、多くの場合 2:1 に近いことを論じた。
この比は、バッチサイズ、最初の層とそれ以外の層でどれだけ計算が行われるか、パラメータ共有の程度、そしてバッチサイズに依存する。
このことは実験でも確かめた。ただし、いくつか問題のあるプロファイラを使ったため、誤りの可能性を完全には排除できない。
謝辞
実験は Marius Hobbhahn が行った。本文は Marius Hobbhahn と Jaime Sevilla が執筆した。
Lennart Heim には議論と支援で大いに助けてもらった。議論に付き合ってくれた Danny Hernandez と Girish Sastry にも感謝する。
付録A:すべてのネットワークのコード
### linear network with large first layer and small later layers
class LinearNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(224*224*3, 4096)
        self.fc2 = nn.Linear(4096, 128)
        self.fc3 = nn.Linear(128, 10)

    def forward(self, x):
        x = torch.flatten(x, 1) # flatten all dimensions except batch
        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        x = self.fc3(x)
        return x

### linear network with just one input but larger intermediate layers
class OneNet(nn.Module):
    def __init__(self):
        super().__init__()
        self.fc1 = nn.Linear(1, 4096)
        self.fc2 = nn.Linear(4096, 128)
        self.fc3 = nn.Linear(128, 10)

    def forward(self, x):
        x = torch.flatten(x, 1) # flatten all dimensions except batch
        x = F.relu(self.fc1(x))
        x = F.relu(self.fc2(x))
        x = self.fc3(x)
        return x

### small conv net
class ConvNet(nn.Module):

    def __init__(self):
        super(ConvNet, self).__init__()
        self.conv1 = nn.Conv2d(3, 32, kernel_size=7, stride=2, padding=3, bias=False)
        self.relu = nn.ReLU(inplace=True)
        self.maxpool = nn.MaxPool2d(kernel_size=3, stride=2, padding=1)
        self.conv2 = nn.Conv2d(32, 64, kernel_size=7, stride=2, padding=3, bias=False)
        self.avgpool = nn.AdaptiveAvgPool2d((1, 1))
        self.fc1 = nn.Linear(64, 10)

    def forward(self, x):
        x = self.maxpool(self.relu(self.conv1(x)))
        x = self.maxpool(self.relu(self.conv2(x)))
        x = self.avgpool(x)
        x = torch.flatten(x, 1) # flatten all dimensions except batch
        x = self.fc1(x)
        return x

### conv net with different sizes for intermediate layers
class DeeperConvNet(nn.Module):

    def __init__(self):
        super(DeeperConvNet, self).__init__()
        self.first_layer = nn.Sequential(
            nn.Conv2d(3, 32, kernel_size=7, stride=2, padding=3, bias=False),
            nn.ReLU(inplace=True),
            nn.MaxPool2d(kernel_size=3, stride=2)
        )
        self.conv_layer = nn.Sequential(
            nn.Conv2d(32, 32, kernel_size=3, stride=1, padding=1, bias=False),
            nn.ReLU(inplace=True)
        )
        self.relu = nn.ReLU(inplace=True)
        self.maxpool = nn.MaxPool2d(kernel_size=3, stride=2, padding=1)
        self.convN = nn.Conv2d(32, 64, kernel_size=7, stride=2, padding=3, bias=False)
        self.avgpool = nn.AdaptiveAvgPool2d((1, 1))
        self.fc1 = nn.Linear(64, 10)

    def forward(self, x):
        x = self.first_layer(x)
        for i in range(100):
            x = self.conv_layer(x)
        x = self.relu(self.convN(x))
        x = self.avgpool(x)
        x = torch.flatten(x, 1) # flatten all dimensions except batch
        x = self.fc1(x)
        return x
付録B:ほかのオプティマイザを使う場合
本稿を通じて、重みの更新には確率的勾配降下法(SGD)を仮定してきた。SGD では、勾配に学習率を掛け、その結果を現在の重みに足す。つまり、パラメータ1つあたり 2 FLOP が必要になる。
ほかのオプティマイザでは、追加の計算が必要になる。たとえば、適応的モーメント推定(Adam)を考えよう。Adam のパラメータ更新は次の式で与えられる。
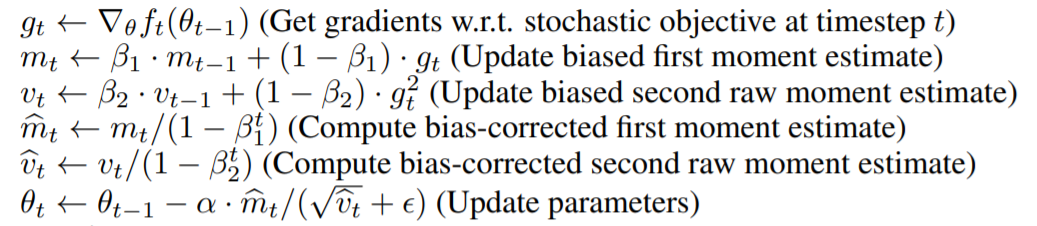
合計で、パラメータ1つあたり約 3 + 4 + 3 + 3 + 5 = 18 FLOP となる。
いずれにせよ、オプティマイザの選択が影響するのは重みの更新だけであり、その FLOP 数はパラメータ数に比例する。バッチサイズは通常大きいので、その差は小さく、逆伝播/順伝播比にはあまり影響しない。