レポート
ニューラルネットワークのFLOPを実測するには?
原題:How to measure FLOP for neural networks empirically?
実験と執筆はMarius Hobbhahnによる。意見と支援をくださったJaime Sevilla、Jean-Stanislas Denain、Tamay Besiroglu、Lennart Heim、Anson Hoに感謝する。
要約
さまざまな機械学習モデルの学習について、Tesla P100 GPUの利用率を測定する。ほとんどのアーキテクチャと手法では、利用率は0.3〜0.75の範囲になる。しかし、2つのアーキテクチャでは、利用率が0.04未満という、ありえないほど低い値になる。こうした外れ値の最もありそうな説明は、逆ボトルネック層のFLOPがプロファイラーで正しく数えられていないことである。全般に、使用したプロファイラーには数えすぎと数え漏れの兆候が見られる。私たち自身が誤りを犯した可能性もある。
分かったこと
- 順伝播のFLOPを数えるのはとても簡単で、多くのパッケージが正しい答えを出す。
- 逆伝播のFLOPを数えるのはより難しく、私たちが選んだ推定ツールは、数えすぎや数え漏れといった奇妙な誤りを起こす。
- 誤りを取り除くと、逆伝播と順伝播の比は(少なくとも私たちの設定では)2:1である可能性が非常に高い。
- 数えすぎの問題を補正すると、ほとんどのアーキテクチャで、実測の利用率は0.3〜0.75になる。バッチサイズが大きい場合、理論上の予測と実測値はよく一致するようである。
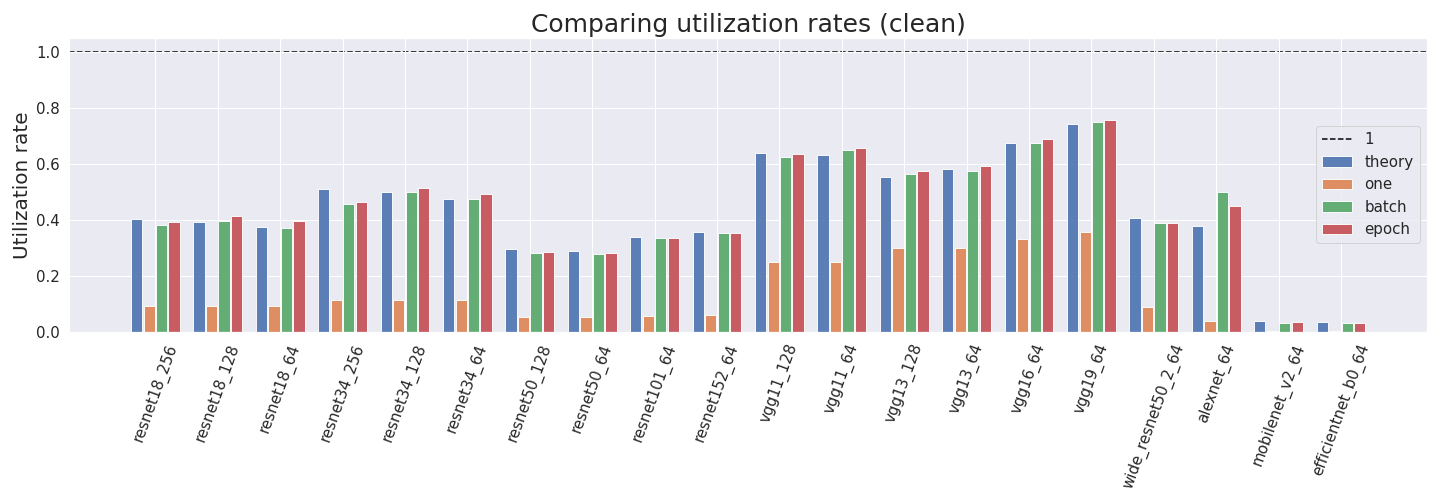
4つの異なる推定方法を使った、さまざまなアーキテクチャにおけるGPU利用率の推定値。
はじめに
「機械学習におけるパラメータ・計算量・データの傾向(Parameter, Compute and Data Trends in Machine Learning)」プロジェクトでは、さまざまなニューラルネットワークとGPUについて、GPUの利用率を推定しようとした。理論上はとても簡単に聞こえるが、実際にやってみると難しかった。
利用率 = 実測性能 / ピーク性能
この記事には専門用語が多く含まれている。結果だけを知りたい場合は、分析の節まで読み飛ばしてほしい。
私にはFLOPを推定した経験がまったくない。初歩的な誤りを犯している可能性は十分にある。助言や提案をいただけるとありがたい。
FLOPの計算と測定に関するその他の研究としては、Lennart Heimの連載Transformative AI and Computeがある。とても良い連載である。
FLOPを数える方法
この記事では、FLOPは浮動小数点演算の回数を、FLOP/sは1秒あたりのFLOPを表す。
どのGPUでも、ピーク時のFLOP/s性能はデータシートで調べられる(たとえばNVIDIAのTesla P100を参照)。実測の性能を理論上の最大値と比べるには、1回の学習実行のFLOP数と時間を測る必要がある。ここで話がややこしくなる。
PyTorch向けのfvcore、ptflops、pthflopsといったパッケージは、モデルにフックをかけて、与えられた入力に対する1回の順伝播のFLOPを計算する。しかし、逆伝播のFLOPは推定できない。私たちは学習全体の利用率を計算したいので、逆伝播のFLOPの正確な推定値が重要になる。
PyTorchには、プロファイラーと呼ばれる一連のパッケージもあり、たとえば本体のパッケージやautogradに含まれている。プロファイラーはモデルにフックをかけ、CPU時間、GPU時間、FLOPなど、実行時の特定の量を測定する。プロファイラーは、集計した統計量も、学習期間中の個々の演算ごとの統計量も返せる。残念ながら、この2つのプロファイラーも逆伝播は数えないようである。
NVIDIAは、プロファイラーをNsight Systemsと組み合わせて使う別の方法を提供しており、これは順伝播と逆伝播のFLOPを正確に推定するとされている。これで目的はすべて果たせるはずだった。残念ながら、この方法による推定値には問題があった。演算を数えすぎたり数え漏らしたりする兆候が見られるのである。こうした問題は事後的に部分的には修正できたが、得られた推定値にはまだ誤りの余地がある。
NVIDIAはdlprofというプロファイラーも提供している。しかし、Google Colabでは実行できなかった(付録を参照)。
実験の設定
13種類の一般的なニューラルネットワークの分類アーキテクチャ(resnet18、resnet34、resnet50、resnet101、resnet152、vgg11、vgg13、vgg16、vgg19、wide_resnet50_2、alexnet、mobilenet_v2、efficientnet_b0)について、一部はバッチサイズを変えて、実測の利用率を推定する。すべての実験で、Google Colabの標準と思われるTesla P100 GPUを使う。すべての実験はGoogle Colabで行っており、こちらで再現できる。
順伝播のFLOPは、fvcore、ptflops、pthflops、PyTorchのプロファイラーで推定する。さらに、それらを、プロファイラー+Nsight Systemsの方法(profiler_nvtxと呼ぶ)で推定した順伝播と逆伝播のFLOPと比べる。比較のため、すべての計算の時間を、プロファイラーで1回、さらにprofiler_nvtxでも測定する。
FLOPの推定で問題になることの一つは、数え方の違いである。fvcore、ptflops、pthflopsは積和演算(Fused Multiply Add、FMA)を1演算として数えるようだが、プロファイラーの方法では2演算として数える。ニューラルネットワークの演算は基本的にすべてFMAなので、プロファイラーの推定値はすべて2で割ればよいことになる。この割り算はすでにすべての推定値に適用してあるので、読者が頭の中で割る必要はない。ただし、FMAでない演算もありうるので、これは誤りの潜在的な原因の一つである。
さらに、ピーク性能にどちらのFMAの数え方が使われたのかも、100パーセント明らかではない。NVIDIAはウェブサイトで、「CUDAデバイスの単精度浮動小数点のピーク性能は、CUDAコア数にグラフィックスクロック周波数を掛け、さらに2を掛けたものと定義される。2倍という係数は、積和演算(FFMA)命令を使って2つの演算を一度に実行できることに由来する」と述べている。
私たちはこの記述を、NVIDIAがFMA=2FLOPという前提を使ったという意味に解釈する。しかしPyTorchは、学習中にすべての単精度テンソルを自動的に半精度に変換する。したがって、2倍の高速化が得られる(これがFMA=2FLOPと相殺される)。
すべての実験で、サイズ3x224x224、10クラスの入力データを使う。これは一般的な画像分類の設定の多くと似ている。測定は、さまざまなサイズのランダムなバッチ1つに対して行うか、10000枚の画像を含むCIFAR10のテストセットに対して行う。
分析
profiler_nvtxには何か怪しいところがある
profiler_nvtxの推定値をよりよく理解するため、バッチサイズを変えて、順伝播と逆伝播を1回だけ実行する。サイズ1のランダムなバッチに対する1回の順伝播について、profiler_nvtxのFLOP推定値を比べると、ほかのすべての推定値と一致しないことがある。
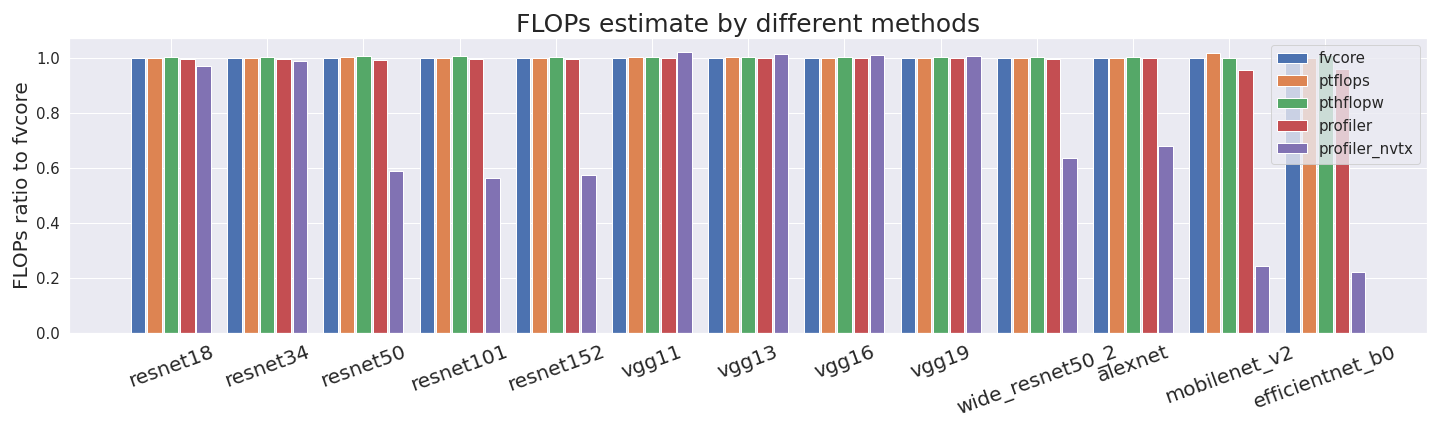
最初の4つの方法は基本的に常によく似た推定値を出し、profiler_nvtxだけがときにかなり大幅に数え漏らす。
しかし、事態はさらに悪い。profiler_nvtxは数え方に一貫性がないのである。私たちは、バッチサイズ64のFLOP数はバッチサイズ1の64倍、バッチサイズ128のFLOP数はバッチサイズ1の128倍になると予想していた。しかし、順伝播でも逆伝播でもそうはならない。
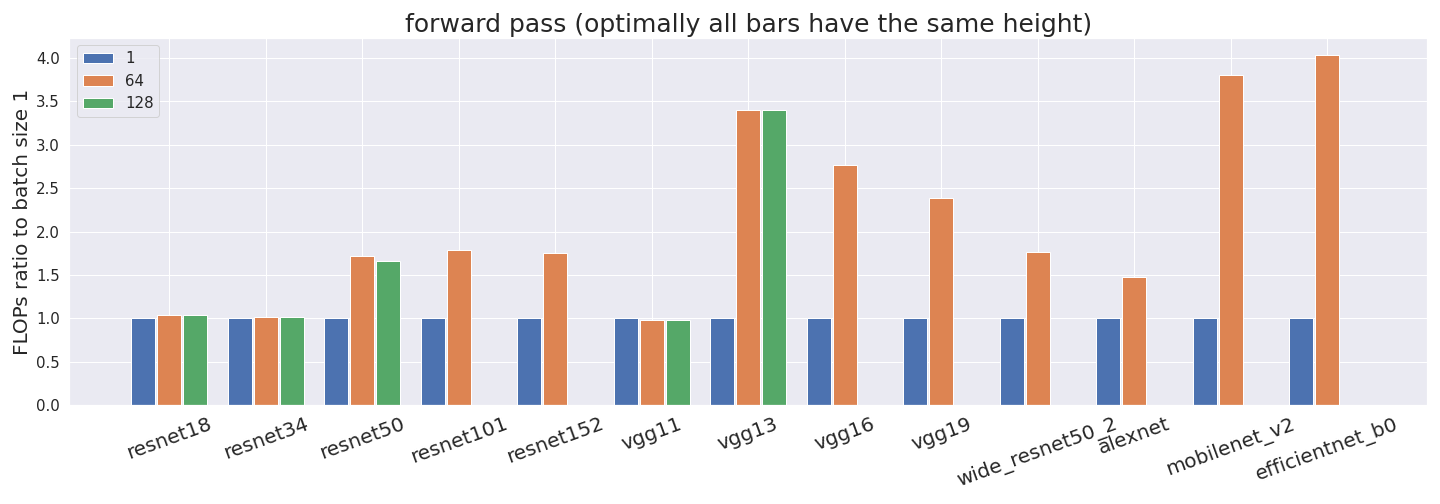
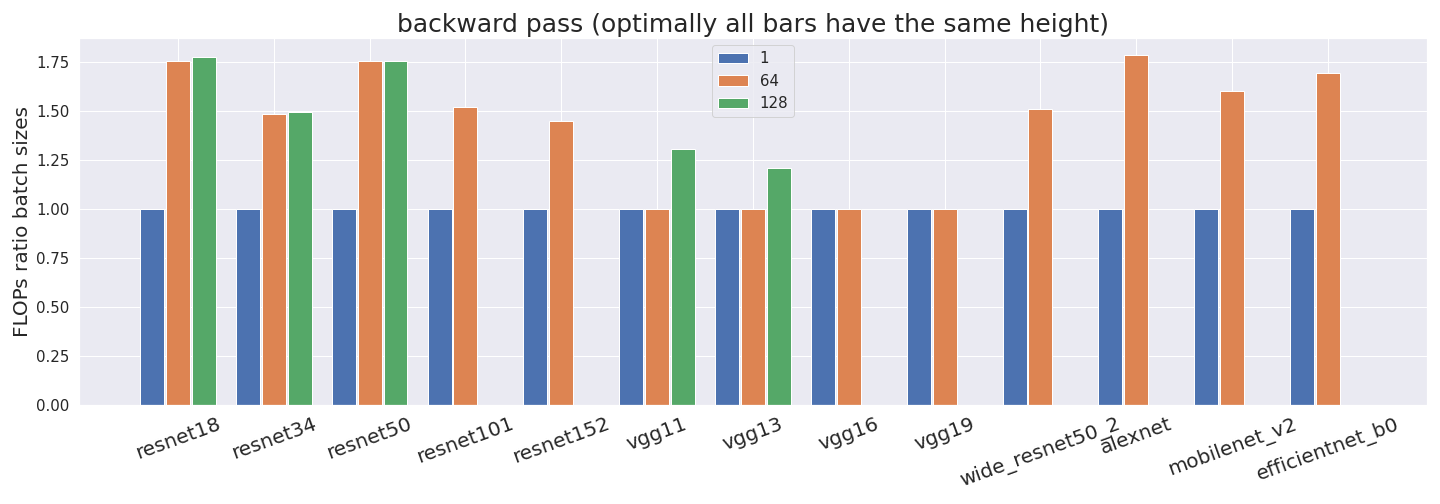
FLOPの推定値はすべてバッチサイズで正規化している。したがって、プロファイラーが正しく数えていれば、すべての棒はまったく同じ高さになるはずである。一部のネットワークではそうなっておらず、何かがおかしいと考えられる。一部のネットワークにバッチサイズ128の推定値がないのは、GPUのメモリに収まらなかったからである。
profiler_nvtxが数えすぎているのか数え漏らしているのかを確かめるため、さらに詳しく調べる。
profiler_nvtxをさらに調べる
上の問題のせいで、すべての分析が非常に不確かになっている。そこで次の節では、正確に何がおかしいのか、それを修正できるのかを突き止めようとする。それに関心がなければ、結果の節まで読み飛ばしてほしい。
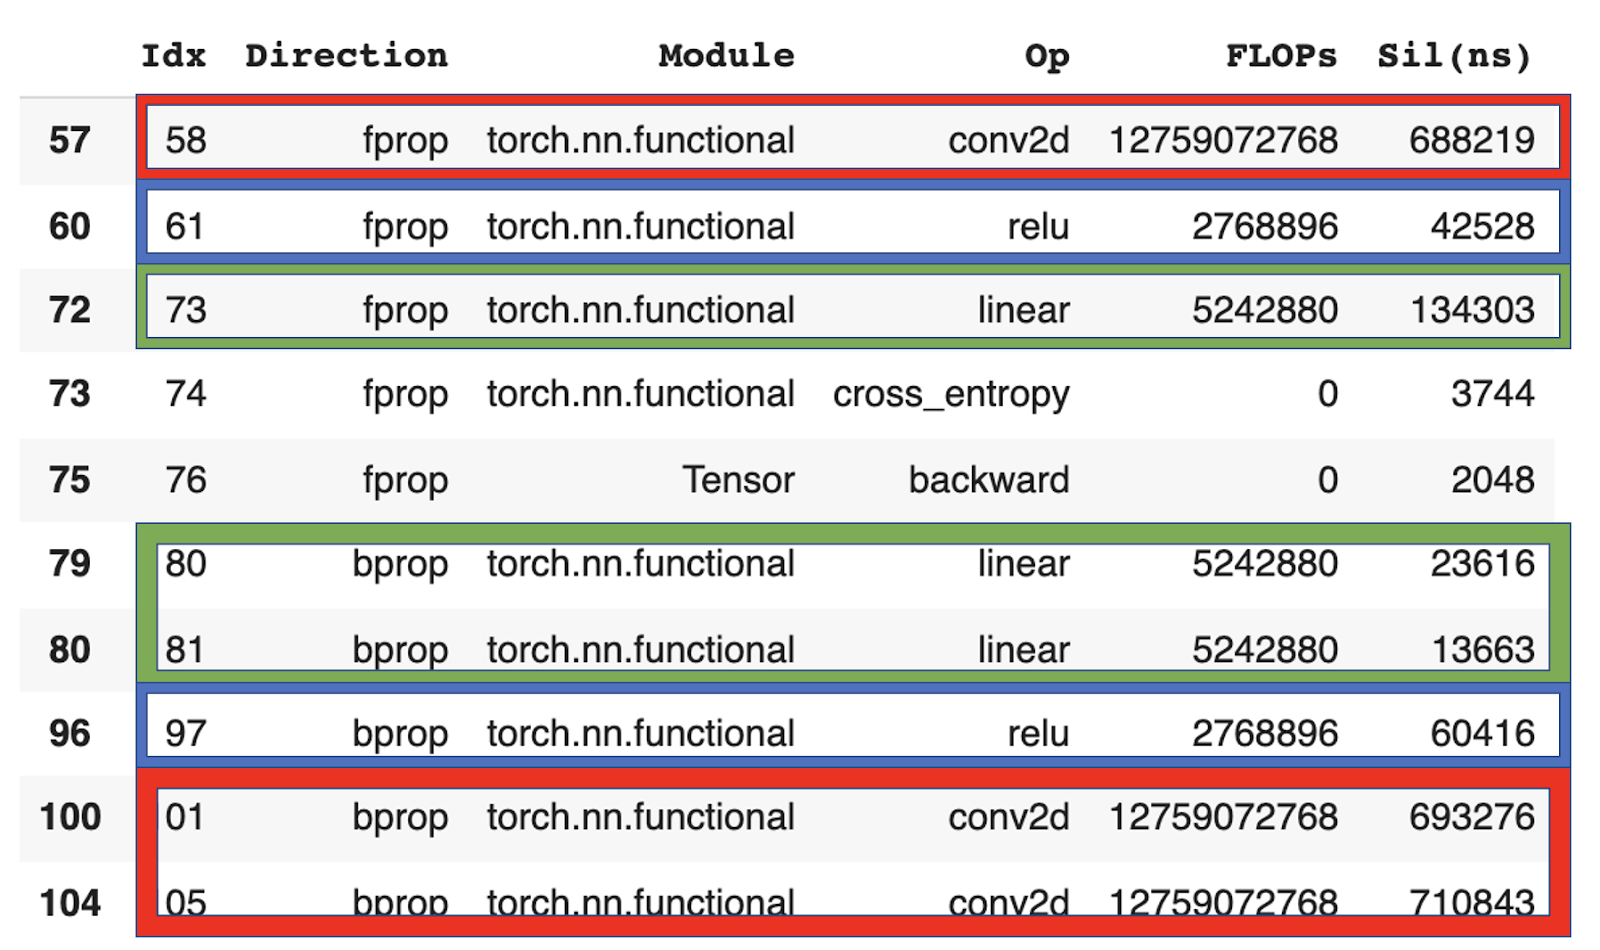
たとえばalexnetで、演算ごとに数えられたFLOPを比べると、いくつかのことが分かる。
- FMA:profiler_nvtxはFMAを2 FLOP、fvcoreは1 FLOPとして数えるので、profiler_nvtxはfvcoreのちょうど2倍のFLOPを数える(表の赤)。同じ理由で、バッチサイズ64を使うと、profiler_nvtxは128倍の演算を数える(表の青)。
- 数え漏れ:場合によっては(表の緑)、profiler_nvtxが演算をまったく記録せず、そのため0 FLOPと数える。
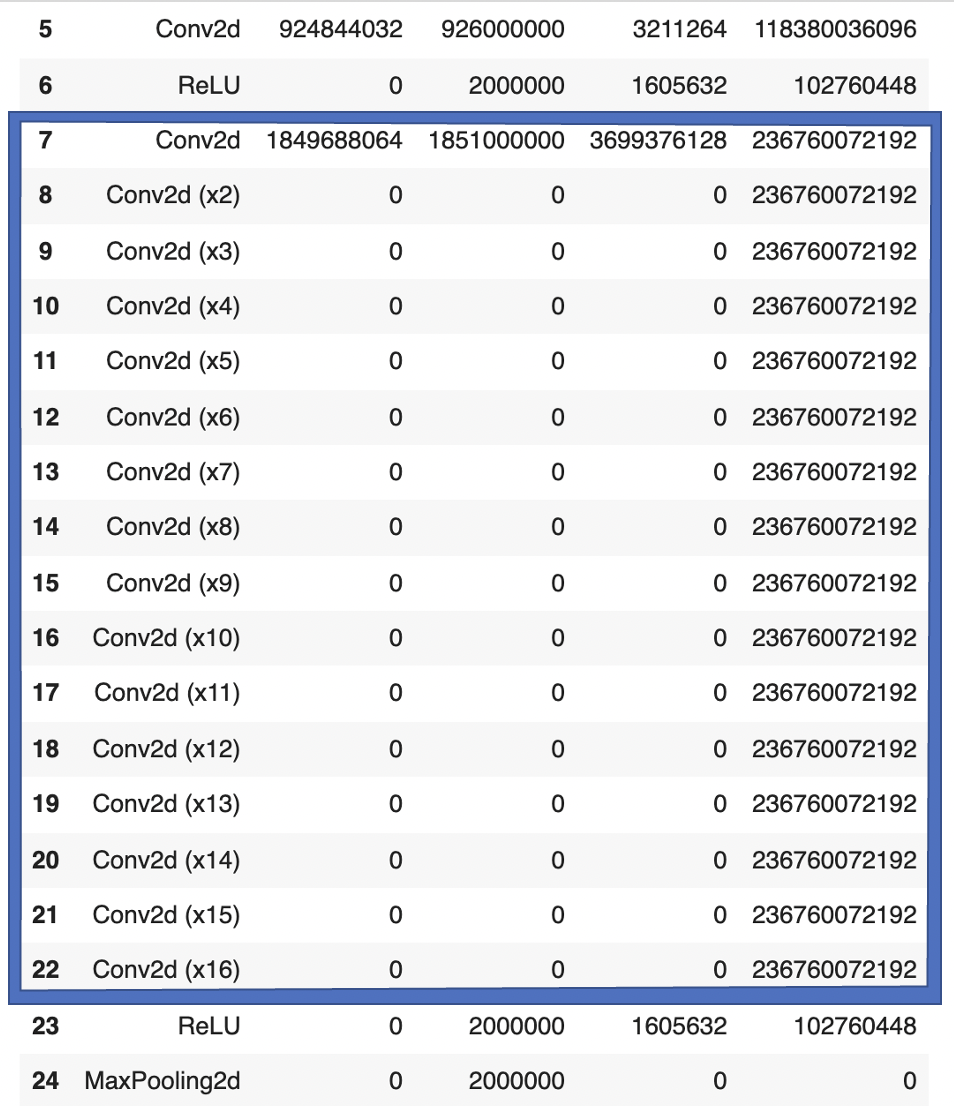
- 数えすぎ:別の場合には(表の黄)、profiler_nvtxは、はっきりした理由もなく同じ演算を何度も数える。
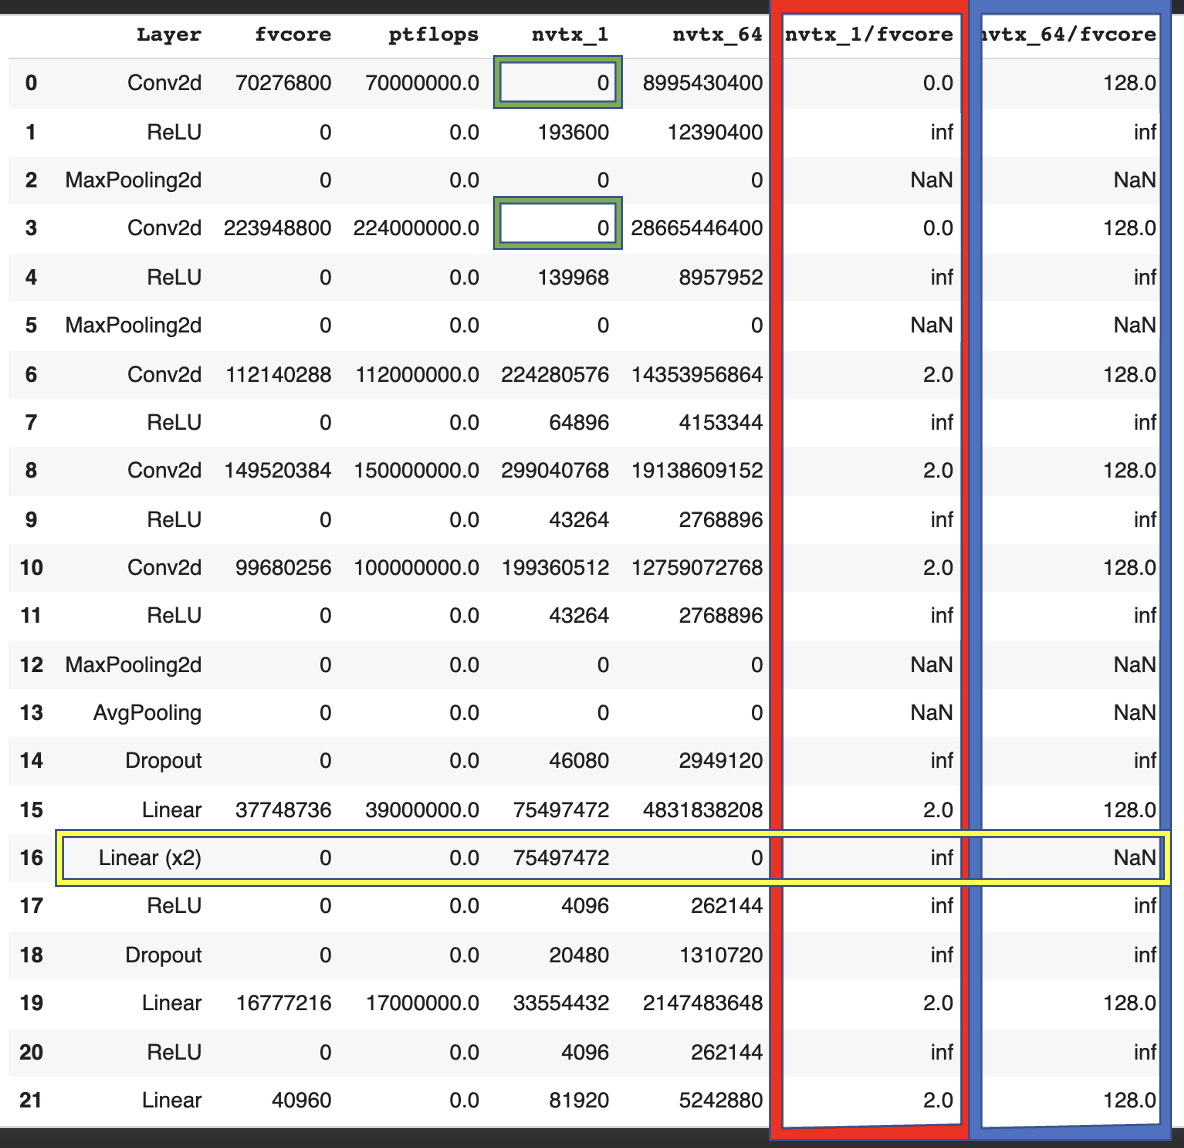
この二重計上は、さらに極端な形で起こることもある。たとえばVGG13の順伝播では、profiler_nvtxは1つの演算を16回数えている。15回も多すぎる。当然、これは結果をゆがめる。
さらに、profiler_nvtxによる実測の逆伝播/順伝播比を詳しく調べることができる。分かったのは次のことである。
- conv2dやlinearのような演算では、逆伝播/順伝播比は2:1である。
- relu、dropout、maxpooling、avgpoolingのような演算では、逆伝播/順伝播比は1:1である。
学習中の演算の大部分はconv2d層とlinear層によるものなので、全体の比は2:1に非常に近くなる。
上で見た二重計上の誤りに対処するため、元のファイルを整理し、演算を誤って二重に数えた項目をすべて削除した。数え漏れの問題は修正できなかったので、以下の数字にはまだ数え漏れが含まれる場合があることに注意してほしい。
二重計上の問題を修正すると、バッチサイズが異なっても、やや一貫した結果が得られる。
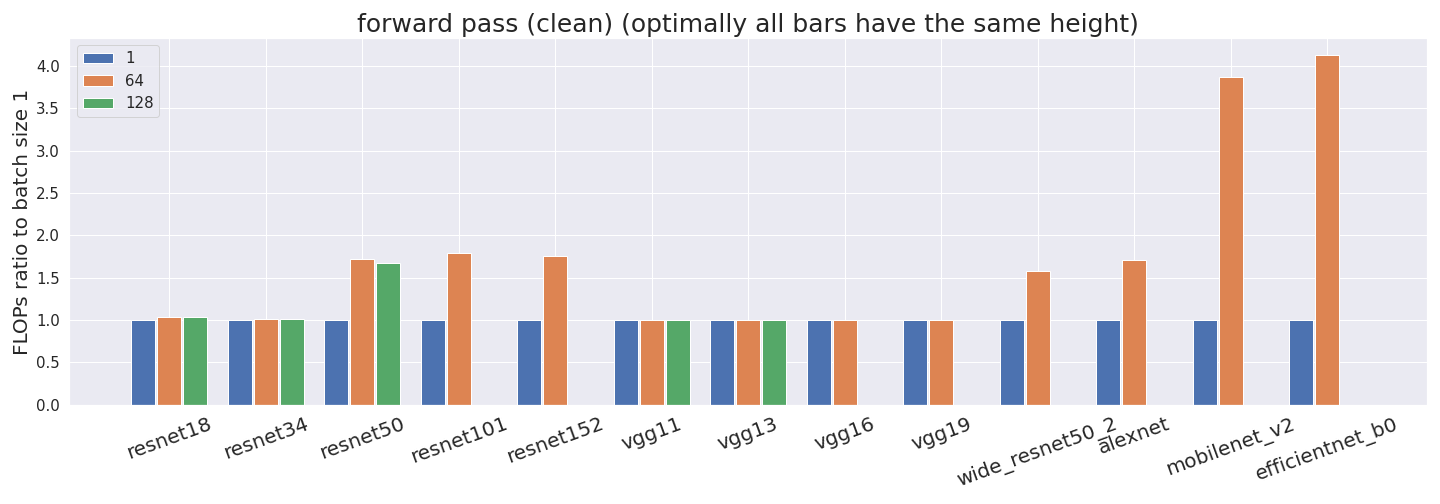
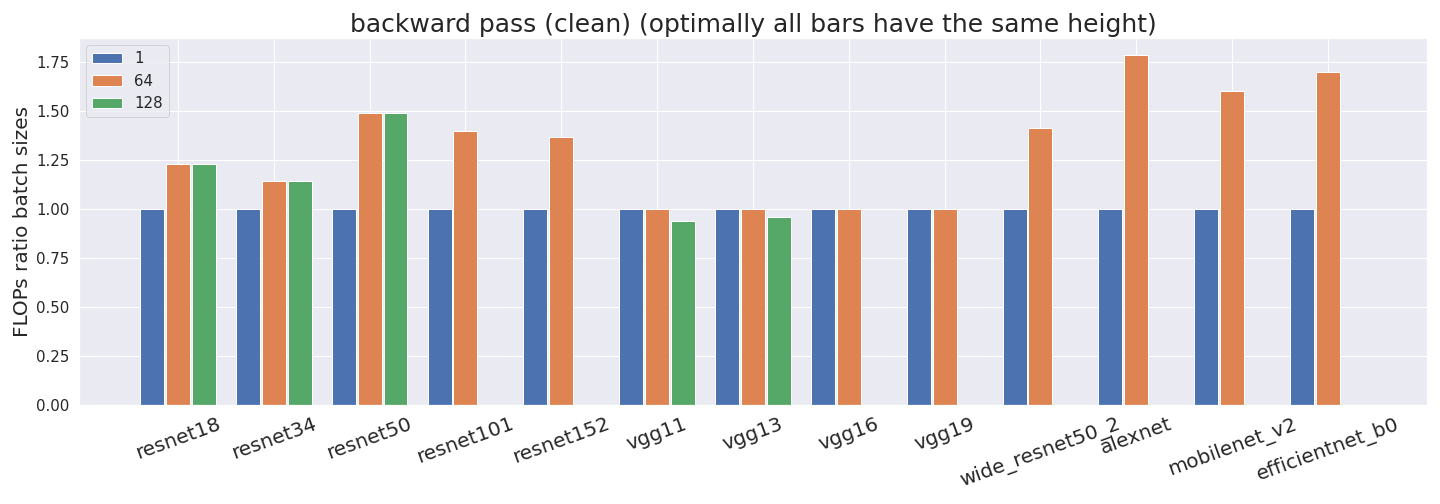
残っている不一致はすべて数え漏れによるものである。
結果
以下の結果は、プロファイラーのデータを整理したもの、つまり二重計上は取り除いたが数え漏れはまだ問題として残っているものに基づく。
元の(整理していない)データに対する同じ分析は付録にある。
バッチサイズの比較
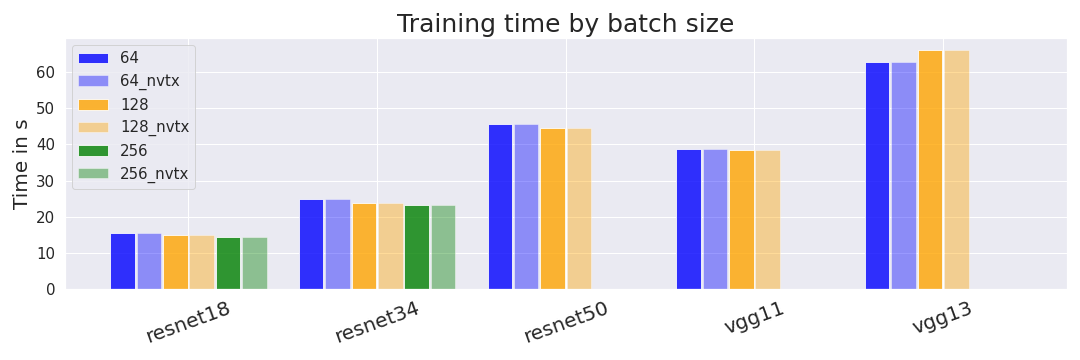
一部のモデルは、バッチサイズを変えて学習させた。バッチサイズの違いがモデルの学習にかかる時間に影響するかどうかに関心がある。さらに、従来のプロファイラーとprofiler_nvtxで測った時間を比べる。
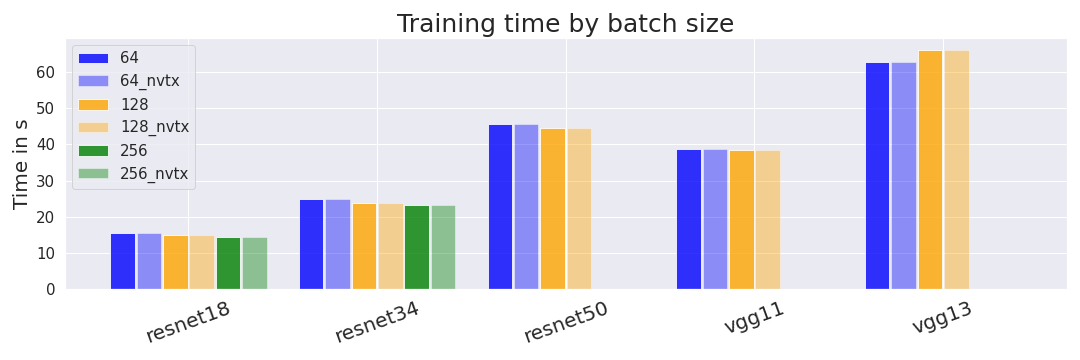
予想どおり、5つのモデルのうち4つで、バッチサイズを大きくすると学習時間がわずかに短くなった。VGG13がなぜ例外なのかは分からない。バッチサイズによる差はもっと大きいと予想していたが、観察された差についてはっきりした説明はない。考えられる仮説の一つは、(実時間ではなく)GPU時間で測定しているために、通常はバッチサイズを大きくすると減るオーバーヘッドが見えなくなっているというものである。
学習時間は分母の一部なので、学習時間が短くなれば、そのまま利用率が高くなる。
逆伝播と順伝播の比
profiler_nvtxの詳しい分析(上記を参照)から、逆伝播は順伝播の2倍のFLOPを使うと推定する(逆伝播/順伝播比をより詳しく比べる2本目の記事を出す予定である)。OpenAIも過去に2という比を使っている。
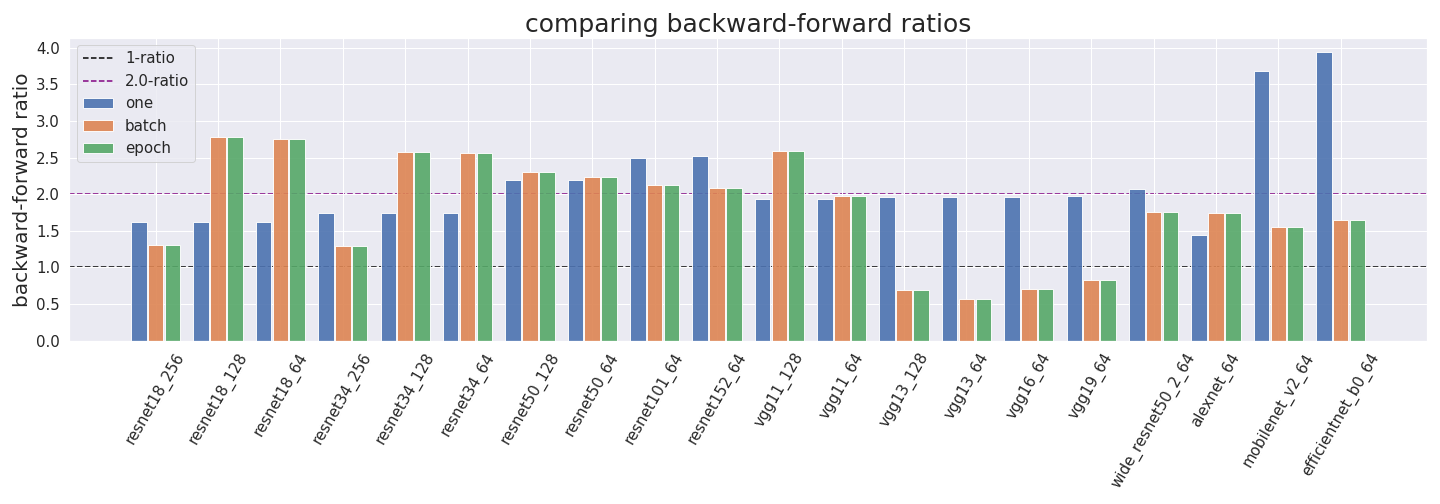
私たちはこの比をさらに実測で確かめたかった。一貫性を確認するため、バッチサイズ1での1回の順伝播(one)、バッチ全体(batch)、エポック全体(epoch)について、この比を調べた。
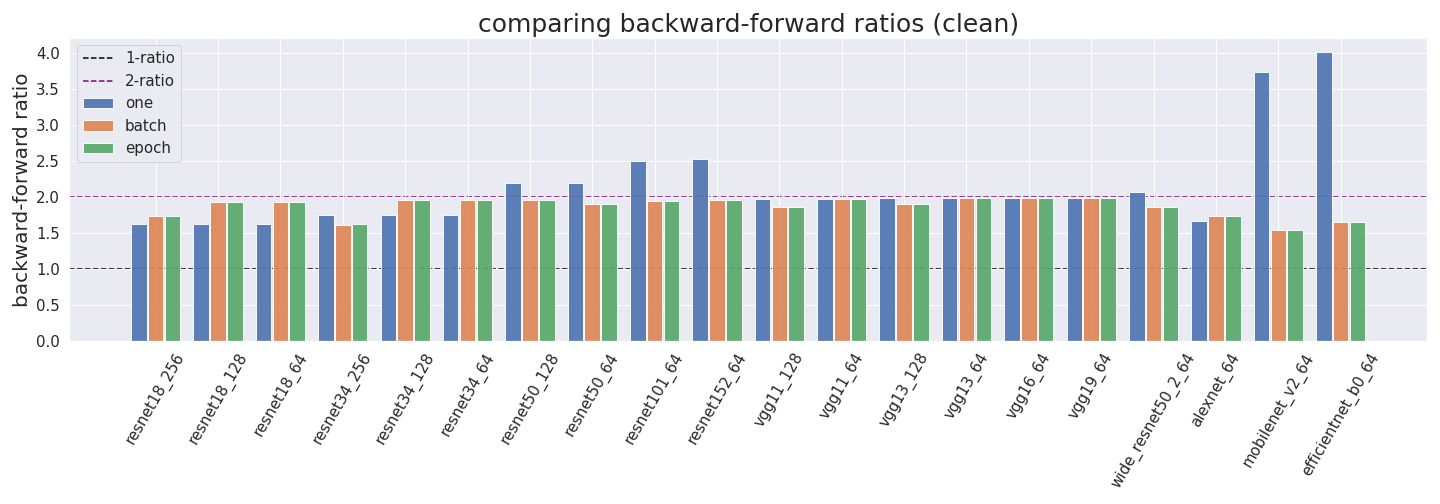
実測の逆伝播/順伝播比は、ほとんどが2:1前後であることが分かった。例外のいくつかは数え漏れ、つまり上で論じたようにprofiler_nvtxが演算を記録していないことによるものだろう。
mobilenetとefficientnetの外れ値は、プロファイラーが逆ボトルネック層のFLOPを正しく測定していないことによるものと考えている。
利用率
最終的に推定したいのは利用率である。利用率は、4つの異なる方法で計算する。
- 理論による方法:fvcoreによる順伝播のFLOP推定値を取り、逆伝播の分を考慮して3.0を掛ける。それを、GPUの学習時間とTesla P100のGPUのピーク性能の積で割る。
- 1サンプルによる方法(one):profiler_nvtxによる順伝播と逆伝播の推定値を取り、学習時間とGPUの最大性能の積で割る。
- バッチによる方法(batch):同じ手順を1バッチについて行う。
- エポックによる方法(epoch):同じ手順を1エポックについて行う。
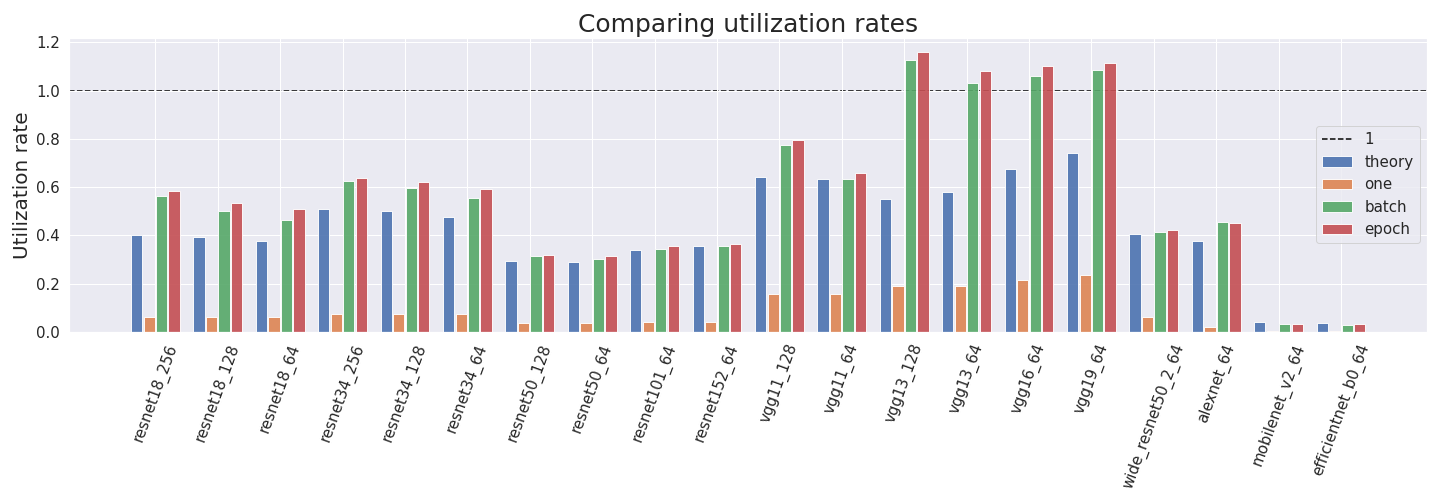
理論から予測される利用率は、バッチとエポックの実測値に近いことが多い。また、バッチ版とエポック版はたいていよく似ているのに対し、1サンプルだけで順伝播と逆伝播を行うのははるかに効率が悪いことも分かる。バッチサイズを大きくする理由はGPUをより効率的に利用できることにあるので、これは予想どおりである。
現実的な利用率の大半は0.3〜0.75である。興味深いことに(そして皮肉なことに)、最も効率の悪い利用率は、すべての方法で低い値を示したefficientnetとmobilenetのものだった。この外れ値は、プロファイラーが逆ボトルネック層のFLOPを正しく測定していないことによるものと考えている。
結論
さまざまな方法を使って、複数のニューラルネットワークのアーキテクチャの利用率を計算した。ほとんどの値は0.3〜0.75の範囲にあり、方法の間で一貫していることが分かった。mobilenetとefficientnetはこの規則の2つの外れ値で、利用率は0.04前後と低い。この外れ値は、プロファイラーが逆ボトルネック層のFLOPを正しく測定していないことによるものと考えている。
付録
現在使っているプロファイラーの問題を解決できそうな方法の一つとして、dlprofを実行してみた。しかし、(手順書で推奨されているとおり)pipでdlprofをインストールしようとすると、Colabでは毎回エラーが出たため、インストールできなかった。別のコンピュータにdlprofをインストールしてみたが、FLOPの情報を得ることはできなかった。
主な図の元の版
これらの版は、二重計上を考慮せずに作成したものである。したがって、結果は誤っている。整理した版と比べられるよう、読者のために示しておく。