
レポート
Grok 4 の数学能力を評価する
原題:Evaluating Grok 4’s math capabilities
はじめに
xAI は Epoch AI に Grok 4 の数学能力の評価を依頼した。その強みと弱みは、絶対的に見て、また他のモデルと比べてどうなのか。本レポートは表に出る数字の先へ踏み込み、Grok 4 が数学の課題にどう取り組むのかを描き出すことを目指す。こうした定性的な調査は、進歩をより広く理解する助けになる。新しい能力の兆しを、表に出る数字に現れる前に見つけやすくなり、今後役立つ追加のベンチマークも見えてくる。
注:この作業は有償で行ったが、成果物の編集権はすべて Epoch が保持している。また、モデル開発者向けのサービスとして、迅速かつ詳細な評価を行っている。詳しくは info@epoch.ai までメールでお問い合わせいただきたい。
要旨
- Grok 4 は、中〜高難度の高校数学コンテストの問題を「力業で解き切る」ことにかけて最高水準にある。(該当節)
- Grok 4 は、難しい高校数学コンテストの証明問題を解くことにかけても最高水準に近い。ただし、証明全般にはまだ大きな伸びしろが残っている。(該当節)
- プロの数学者によれば、Grok 4 は数学の文献探索に使えるモデルとして現時点で最良かもしれない。(該当節)
- Grok 4 には、自分の誤りの一部(すべてではない)に自ら気づくという興味深い傾向がある。(該当節)
- あらゆる LLM と同様に、Grok 4 の考え方はあまり人間らしくない。低レベルな計算を好み、空間的な直観を欠き、人間が創造性と呼ぶようなものはあまり見せない。(該当節)
また、Grok 4 の発表ブログ記事に載った性能のグラフのいくつかは誤解を招くものだったと考える。ただし、以下の点は全体の結論を損なうものではない。
- AIME と HMMT の二つのコンテストについては、Python ツールを使える設定を含めるべきではなかった。これらのコンテストは「手で」解くことを前提としているからである。(該当節)
- xAI は別のコンテストである USAMO を社内で採点したが、その透明性は高くなかった。こうした慣行はよくあることだが、比較を難しくする。(該当節)
本稿の残りでは、これらの結論を肉付けし、その根拠を示す。
方法
データ。本稿は主に三つのデータ源に基づく。第一に、標準的なベンチマークを参照し、Grok 4 が全体のなかでどこに位置するかを捉える。また、ベンチマークの具体的な問題例にも踏み込み、Grok 4 が問題をどう解き、どう解けないのかをより具体的に示す。第二に、私が個人ブログで集めてきた問題をいくつか使う。これらはベンチマークの問題を補うものである。第三に、2人のプロの数学者、Greta Panova と Bartosz Naskręcki のコメントを取り入れる。2人には Epoch が契約して、Grok 4 を使った感想を寄せてもらった。1
モデル。xAI は Grok 4 を2種類提供している。標準モデルと Grok 4 Heavy である。xAI は Grok 4 Heavy を「複数の独立したエージェントを並列に動かしてタスクを処理し、その出力を相互に評価する」ものと説明している。私は両方を調べたが、Grok 4 Heavy へのアクセスはやや限られていた。API がなく、grok.com で使えるモデルはウェブ検索をしたがる傾向が強い。そのため、「自力で」解けるかを見たい問題について、解説記事を見つけてしまうことが多い。xAI からは、API 経由で Grok 4 から何度かサンプリングし、最良の解答を見れば、Grok 4 Heavy の能力のおおまかな近似になるとの提案があった。結局のところ、この制約が調査の大きな妨げになったとは思わない。
限界。この分析は、手元のデータで有意義に評価できると私が考える数学能力だけを扱う。一般に、AI の評価が人間の複雑な営みの関連する側面をすべて捉えられるようになるまでには、まだ道のりがある。数学も例外ではない。たとえば、面白い予想を立てる、既存の結果を一般化する、ある分野の手法を表面上は無関係な別の分野に応用する、といった数学にとって決定的に重要な活動に取り組む能力は測れない。
Grok 4 は中〜高難度の高校数学コンテストを「力業で解き切る」ことにかけて最高水準にある
この節では、現在 AI のベンチマークとして使われている三つの高校数学コンテスト、AIME、HMMT、OTIS Mock AIME を取り上げる。
1が易しい文章題、10がこれまでに高校数学コンテストで出題された最難問という、おおまかな1〜10の難易度尺度で見ると、これらのコンテストの問題は2〜6の範囲にあり、その上の方に集まっている。そこで、これらを「中〜高難度」と呼ぶことにする。データには、MathArena と Epoch が行った独立した評価の結果を使う。2
| コンテスト | 年 | 評価者 | 難易度(1〜10) |
|---|---|---|---|
| AIME | 2025 | MathArena | 2-6 |
| HMMT | 20253 | MathArena | 5-6 |
| OTIS Mock AIME | 2024, 2025 | Epoch AI | 2-6(難しい側に偏る) |
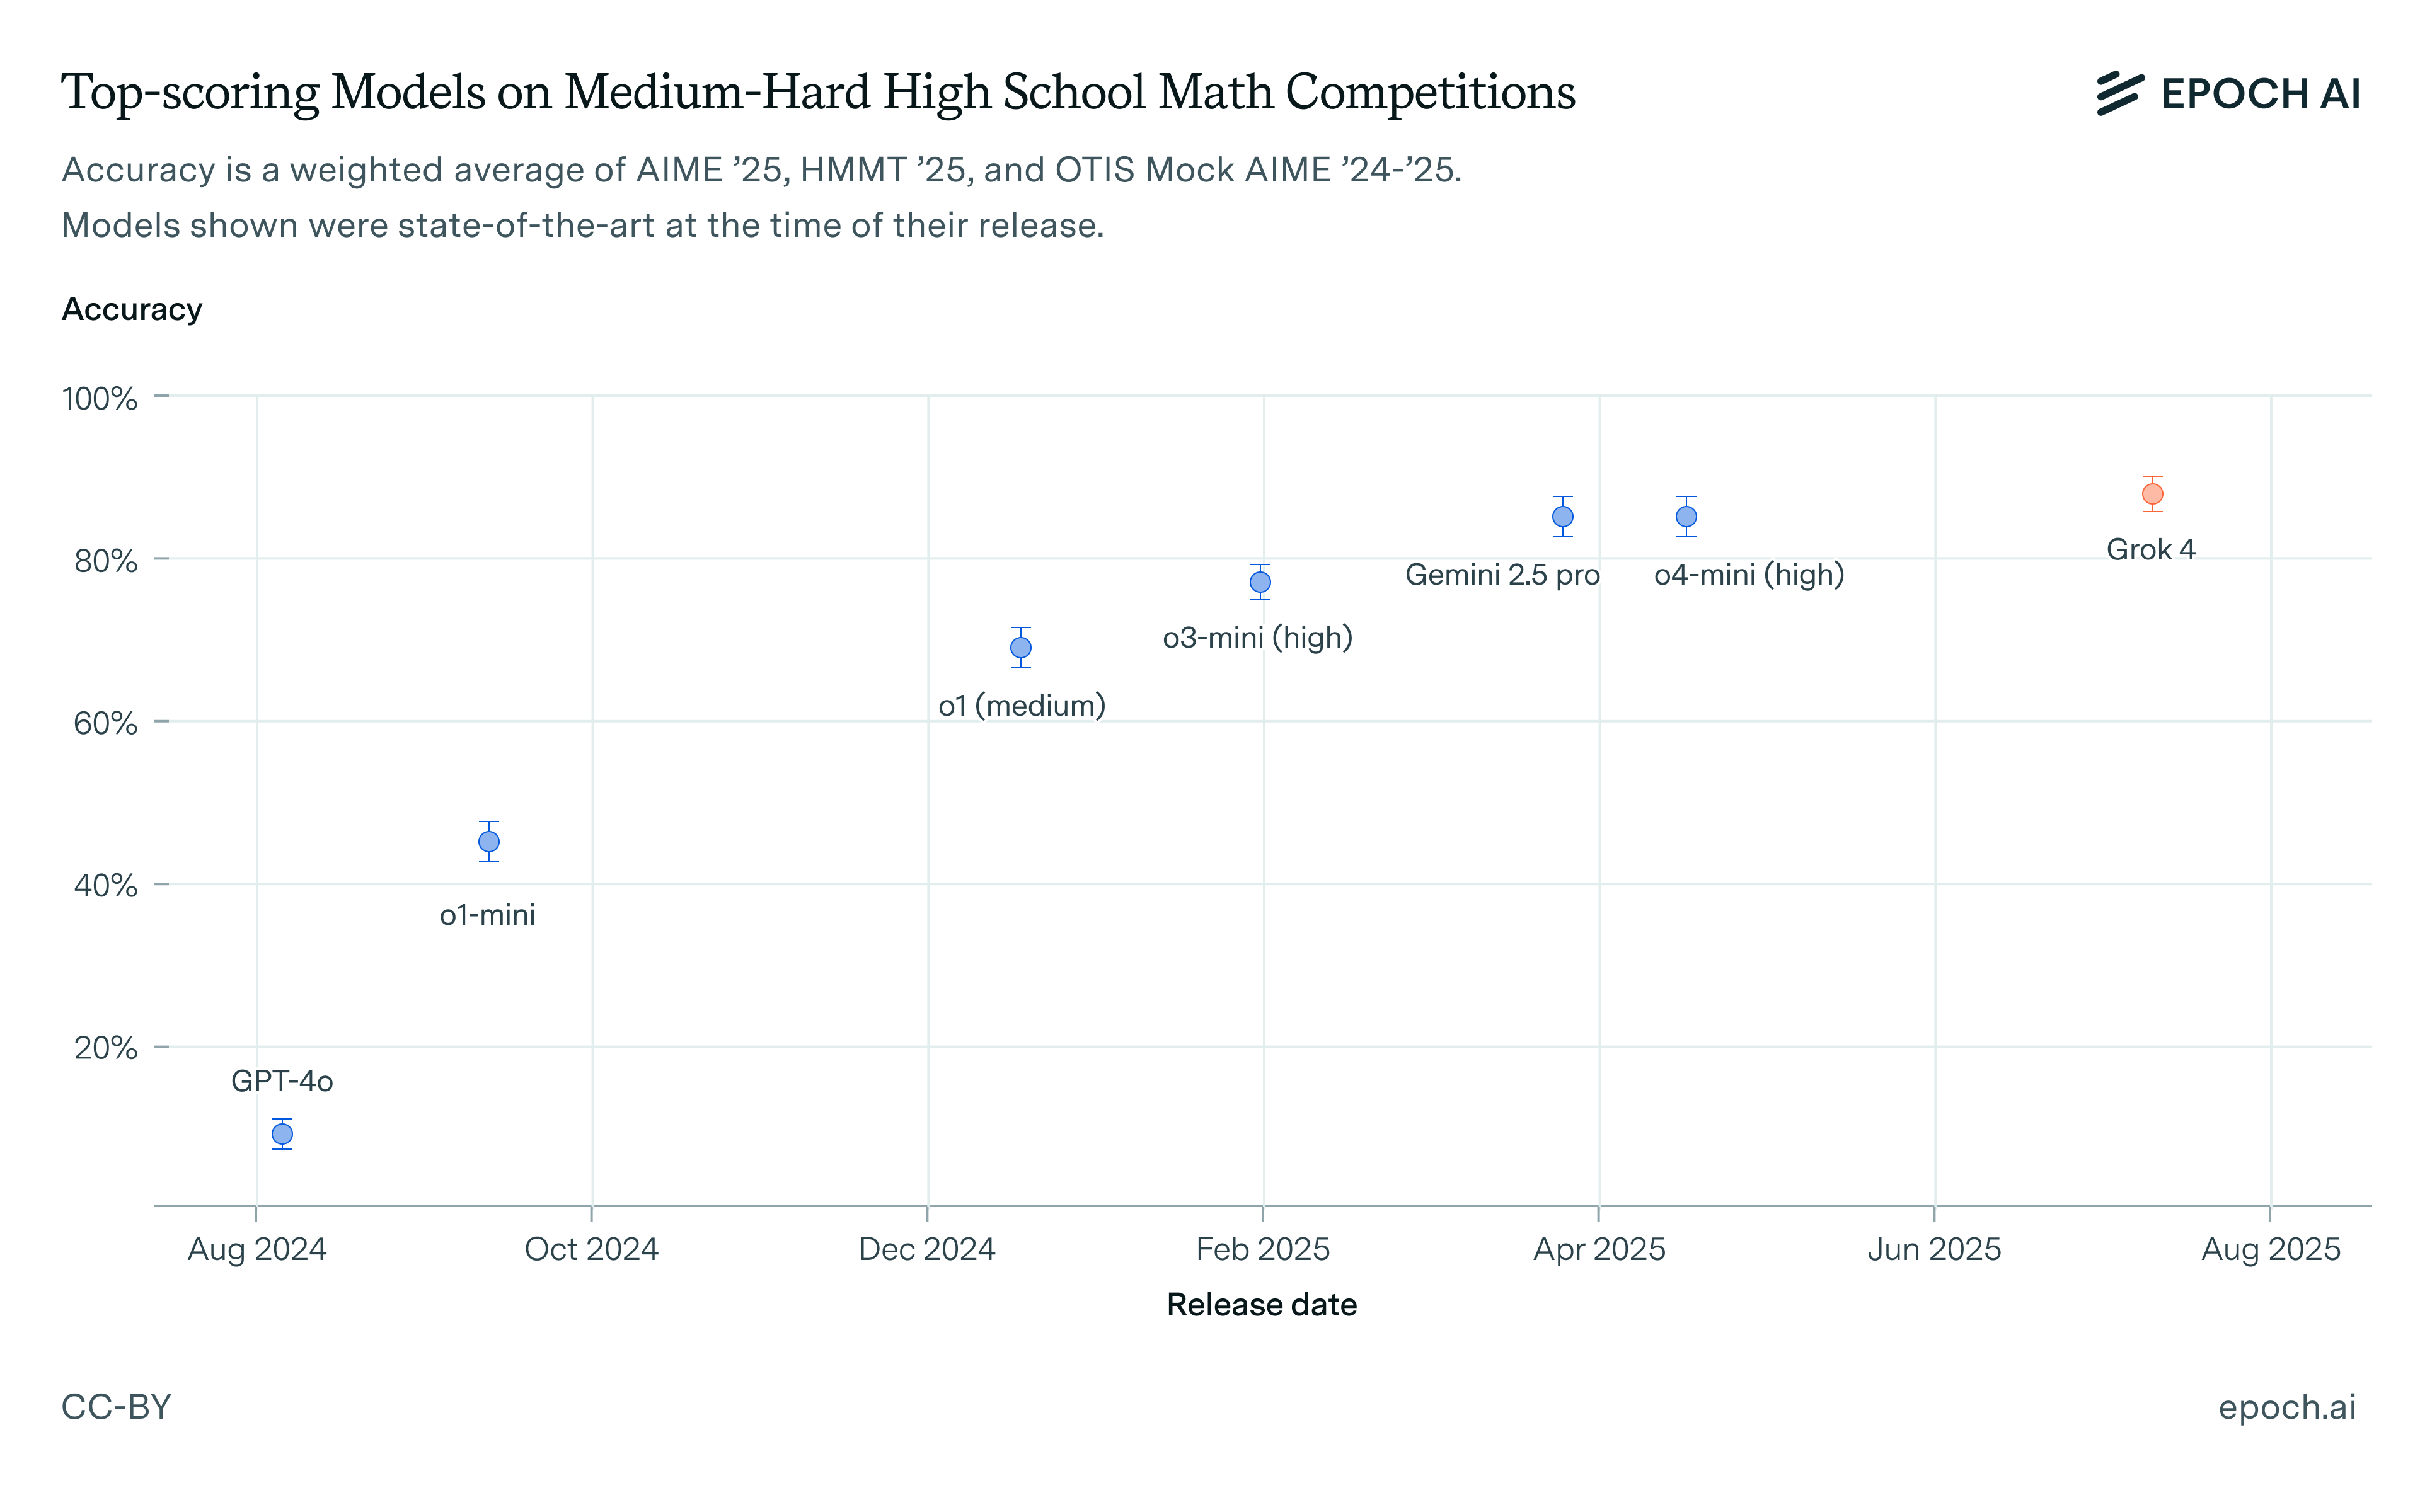
1年前、LLM はこれらの問題のうち最も易しいものしか解けなかった。それ以来、推論モデルは急速に進歩した。下のグラフは、公開時点で最高水準だったモデルについて、これらのベンチマークの総合スコアを示している。それまでの最高水準は Gemini 2.5 Pro と o4-mini (high) の85%で並んでいた。Grok 4 のスコアは88%で、小さな前進である。
ここからは、これらの問題を解くには何が必要で、LLM がどう解いているのかを定性的に示す。最先端モデルの大半が解ける問題、(今のところ)Grok 4 だけが解いた問題、まだどのモデルも解いていない問題を、それぞれ1問ずつ取り上げて解答を検討する。
これらの問題を解くには、ほどほどの知識と高い勤勉さが要る
これらのコンテストでは、高校の発展的な数学カリキュラムに精通していることと、かなり込み入った計算をやり遂げる力が求められる。人間にとっては、コンテストの制限時間がとりわけ厳しい制約になる。成否は、正しい方針をすばやく見抜き、それを一度で正しく実行できるかにかかっている。
最高得点を取る人間は、うまい近道を見つけ、方程式をひたすら計算し続けるのにそれほど時間をかけずに問題を解くことができる。これらのコンテストで創造性、機転、新しさが果たす役割はそれだけである。
これまでのところ、LLM は一様に「力業で解き切る」やり方をとる傾向があり、Grok 4 も例外ではない。4これらのベンチマークで Grok 4 が他のモデルを上回ったのは、より込み入った力業をより確実にやり遂げられるようになったことの表れである。
問題を「力業で解き切る」とはどういうことか
次に示すのは2025年の AIME の第9問で、Grok 4 を含むすべての最先端モデルが確実に解ける。読みやすさのために少し書き換えている。
方程式 y = x² – 4 で表される放物線を、原点を中心に反時計回りに 60° 回転させる。元の放物線と回転後の放物線が交わる点のうち、第4象限にある点の座標を求めよ。
下のグラフは、二つの放物線と求める点を示している。
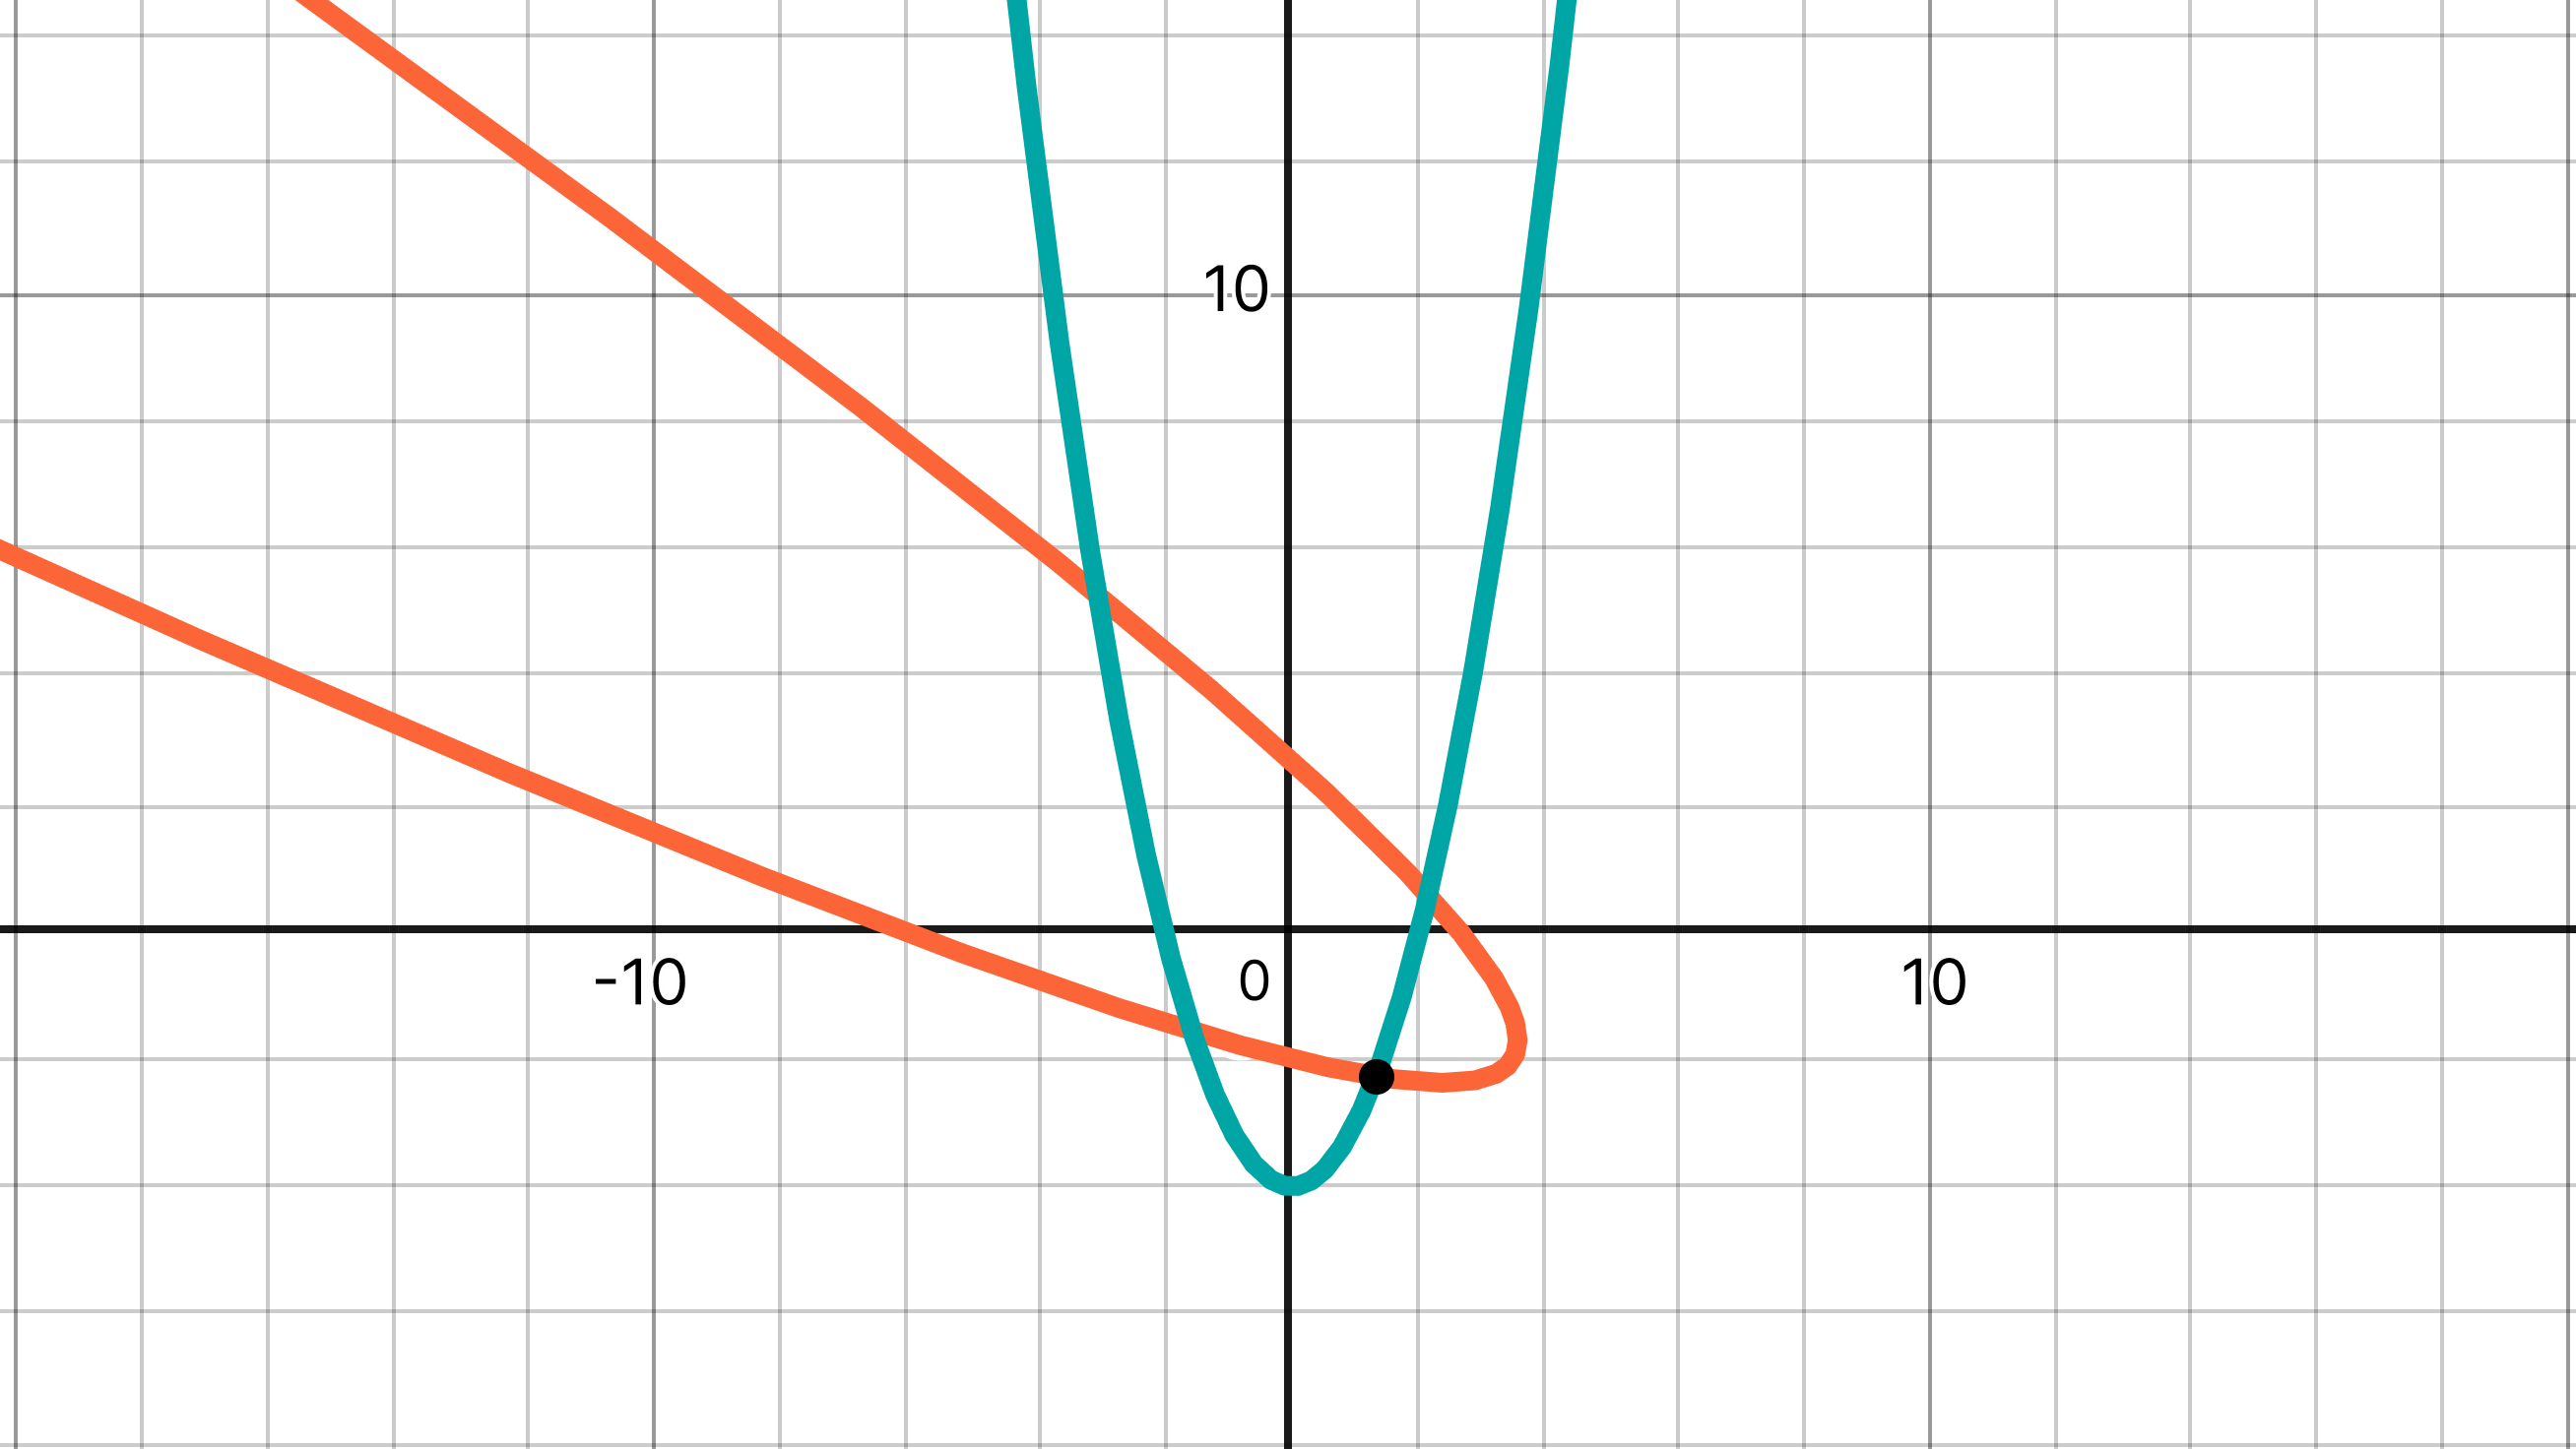
Grok 4 を含む LLM がこの問題を解く流れの概略は次のとおりである。
- y = x² – 4(ティールの放物線)に回転の公式を当てはめる。
- すると x² + 2√3 xy + 3y² + 2√3 x – 2y – 16 = 0(オレンジの放物線)が得られる。
- これに y = x² – 4 を代入すると、3x⁴ + 2√3 x³ – 25x² – 6√3 x + 40 = 0 が得られる。
- この4次方程式を解く。
LLM はシリコンの腕まくりをして、やり遂げる。だが、機転の利く人間なら、もっとよい方法を見つけられる。
- この場合、60°の回転は直線 x = -y/√3 に関する鏡映と同じ結果になる。
- したがって、実はこの直線と y = x² – 4 の交点を求めるだけでよい。
この問題では、「力業」の解法と「うまい」解法の差はそれほど大きくない。しかし、ほんの少し難しい問題になるだけで、この差は大きく開きうる。
Grok 4 は「力業で解き切る」ことの最先端にいる
全体として、この分野での Grok 4 の進歩は、より多くの問題をより確実に力業で解き切れるようになったことの表れである。たとえば次に示すのは HMMT の C9 問題である。MathArena が評価したモデルのなかで、この問題を解いたのは Grok 4 が初めてだった。
正六角形の内部から、2点を独立かつ一様にランダムに選ぶ。両方の点を通る直線が、六角形の向かい合う一組の辺と交わる確率を求めよ。
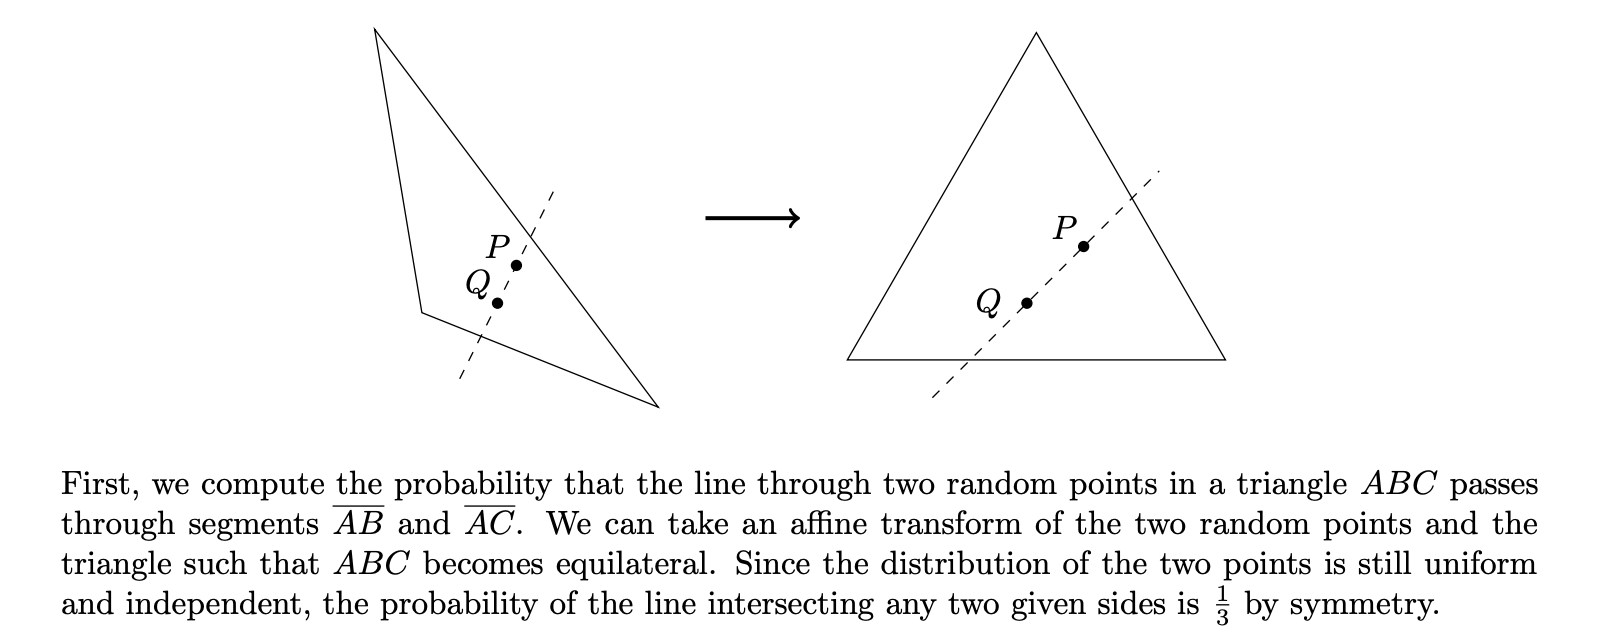
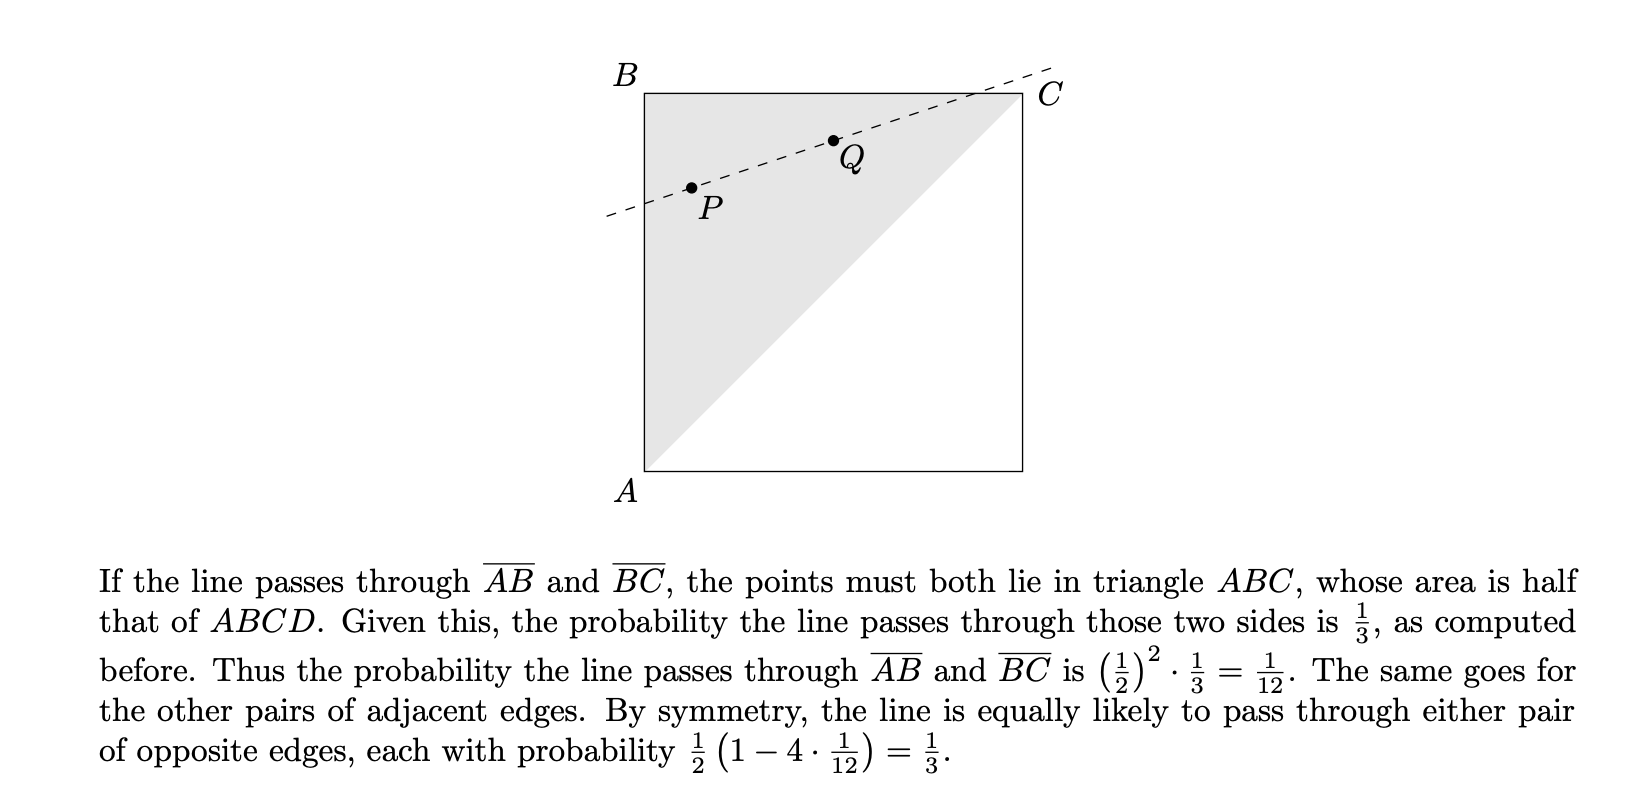
この問題の人間による模範解答はなかなか美しい。大部分を画像で載せるが、各画像の前に添えた短いコメントを読むだけでも要点はつかめる。
まず、三角形について同様の問題を解く。答えは三角形の形によらない!
次に、これを使って長方形について同様の問題を解く。ここでも答えは長方形の縦横の長さによらない。
最後に、これを求めたい六角形の場合へ拡張する。
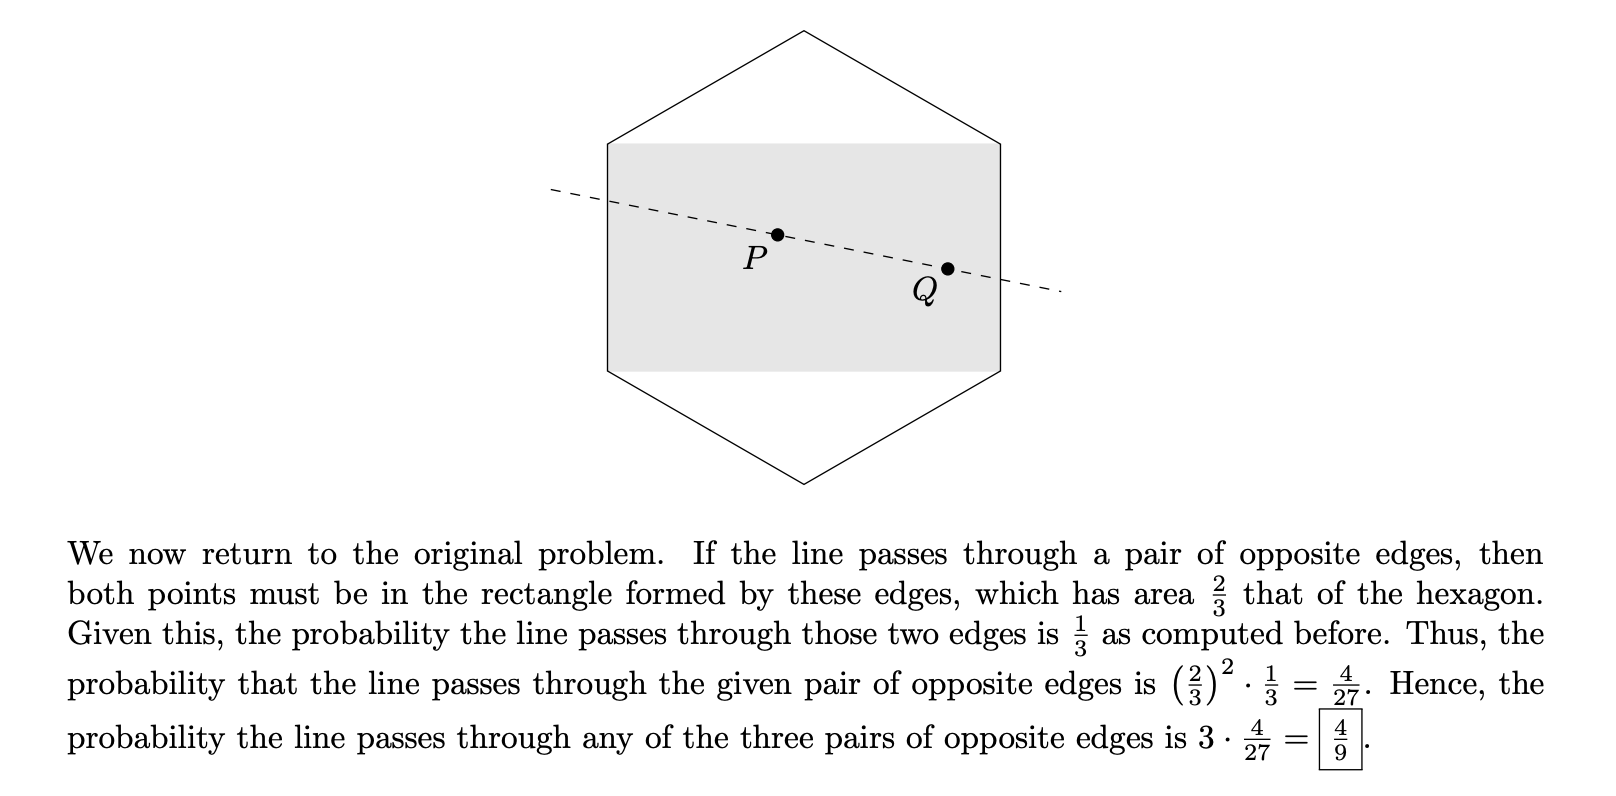
人間がこれを思いつくのは容易ではないが、確かに「エレガント」である。簡潔なだけでなく、この特定の問題を超えて、もっと深いところで何が起きているのかを感じ取らせてくれる。
Grok 4 はこの問題を別のやり方で解く。代表的な出力例を示すが、ざっと目を通すだけでよい。要するに Grok 4 は、六角形を直交座標平面に置き、直線全体の空間を4次元空間でパラメータ表示し(各直線について座標が2つずつ)、4重積分を使って最終的な答えにあたる(超)体積を求めている。
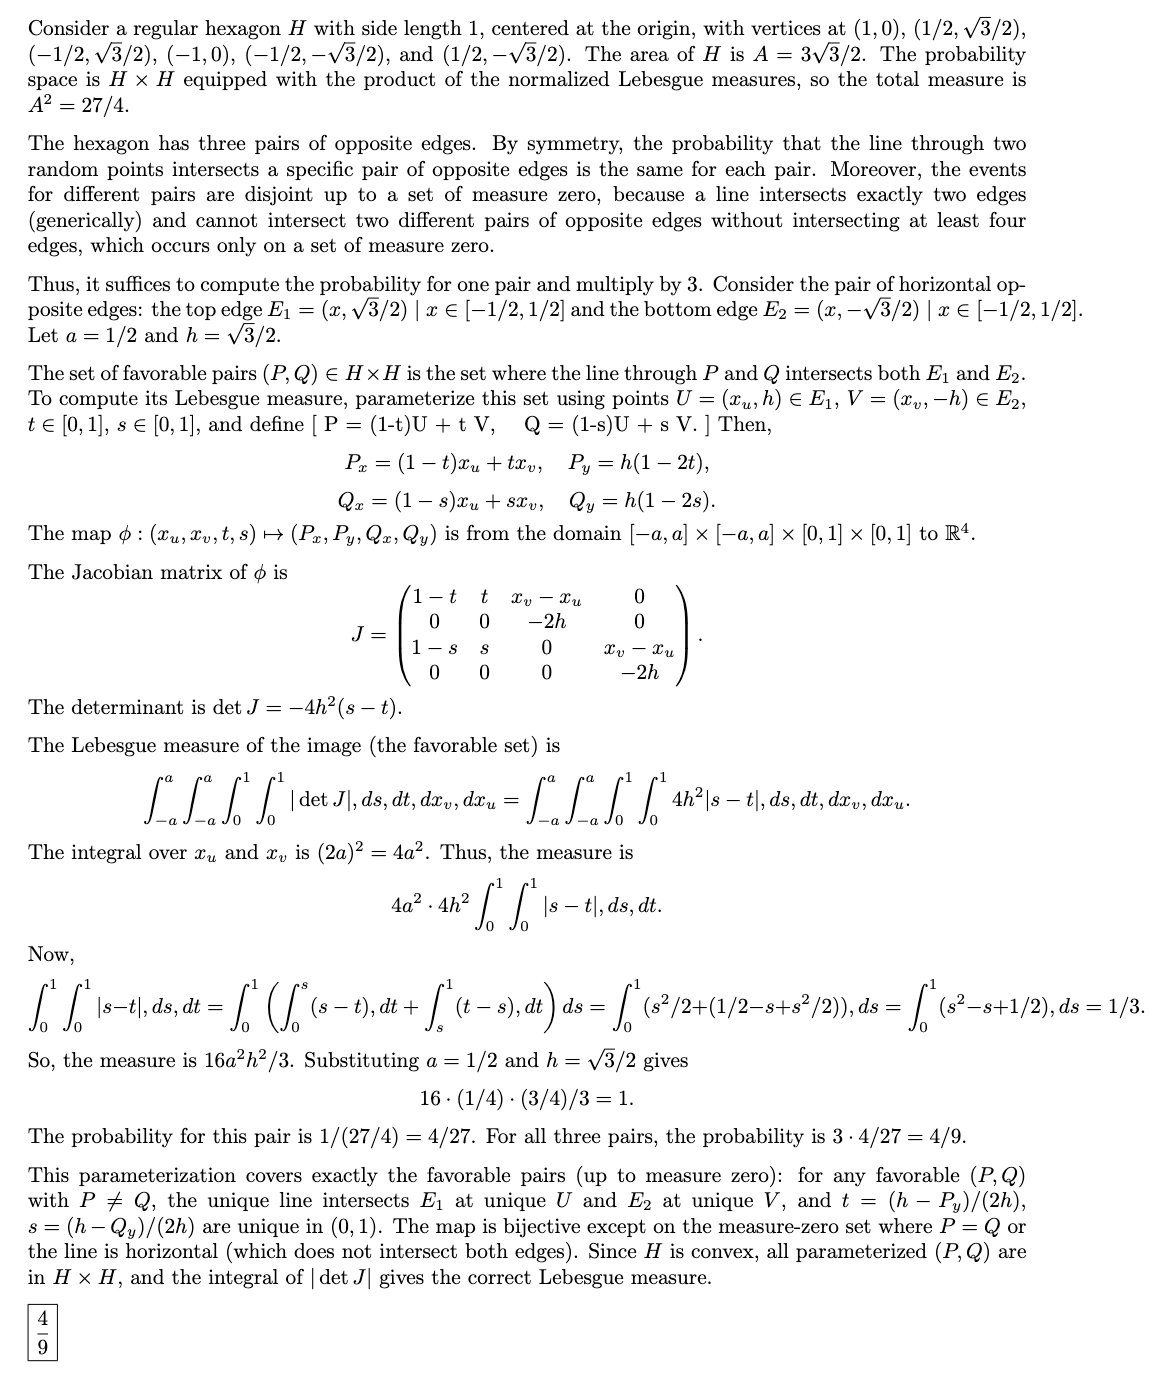
これは悪い解法ではない! そもそも直交座標と微積分の要点は、古典幾何学に見られる繊細で概念的な議論を、より厳密で再現しやすいもので補うことにある。実際の HMMT に臨む人間には、ここでの Grok 4 の解法をやり遂げる時間はおそらくないだろう。しかし、ある意味では Grok 4 の解法のほうが確実である。力業は、やり遂げられるなら良いものだ。そしてこの種の問題なら、たいていやり遂げられる。
これらのコンテストには AI が解いていない問題がまだいくつか残るが、その状態はおそらく長くは続かない
この三つのベンチマークの問題は合わせて105問ある。MathArena と Epoch のデータによれば、どのモデルにも一度も解かれていないのはそのうち4問だけである。その一つ、OTIS Mock AIME 2024 の第14問を例に挙げる。
カワウソの Ritwin は段ボールの正三角形を持っている。彼はこの三角形を、中心を通って互いに 120° の角をなす、長さ x の合同な3本の線分で切り、六つの断片を得る。合同な三角形三つと合同な四角形三つである。次に三つの三角形をすべて裏返し、六つの断片をすべて並べ替えて、下図のように、内部に等角六角形の穴があいた別の正三角形を作る。穴の辺の長さが順に 3、2、3、2、3、2 であるとき、 x を求めよ。
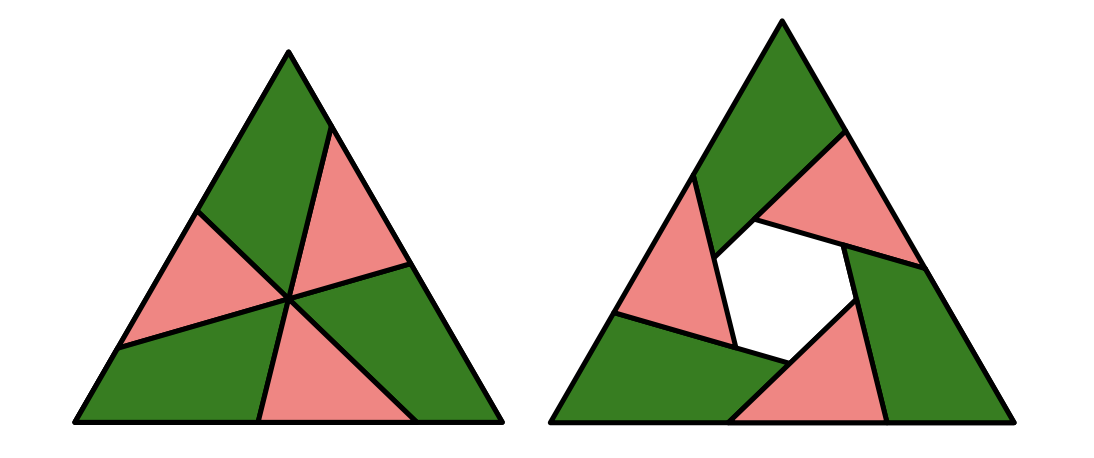
人間による模範解答は、それほど概念的なものではない。下図のように図に記号を振り、標準的な幾何の事実を使って a、b、c、d、e の間に成り立つ五つの関係を導く。あとは、得られた連立方程式を解くだけである。
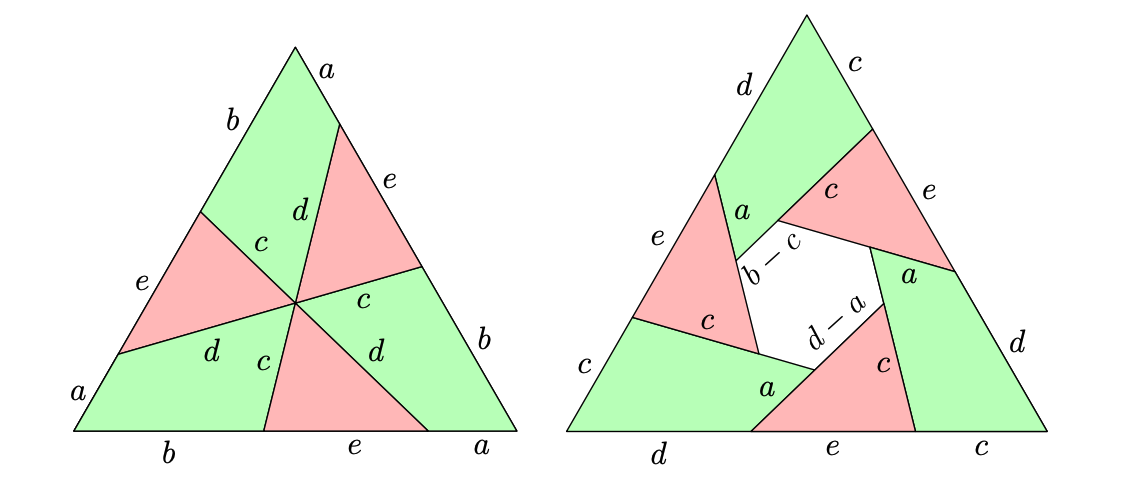
LLM にとってこの問題が難しいのは、力業で解ける形に落とし込むのに、座標を使ったかなり入り組んだ作業が要るからだと思われる。つまり、三角形を裏返してすべてを並べ替えたあとの二つ目の図形について、頂点の座標を求めるには非常に長い計算が必要になる。とはいえ、LLM がすでにやっていることと質的には似ているので、いずれかのモデルがこれを解くのは規模の問題にすぎないと予想している。
この種の問題は、ほぼ飽和しかけている。今後こうしたベンチマークから学べる最も興味深いことは、モデルがより概念的なやり方で問題を解き始めるかどうかである。
コーディングツールを使う設定は無視すべきである
xAI のブログ記事は、Grok 4 に Python ツールを使わせると AIME と HMMT のスコアが上がると報告している。これはこれらのコンテストにふさわしい設定ではない。問題は「手で」解くことを前提に作られており、コーディングが許される場合にも難しいままであるようには意図されていない。
たとえば次に示すのは2025年の AIME の第15問で、まだどのモデルも解いていない4問のうちの一つである。
a, b, c ≤ 3⁶ であり、かつ a³ + b³ + c³ が 3⁷ の倍数となるような正の整数の順序付き三つ組 (a, b, c) の個数を求めよ。
これは Python のスクリプトを使えば簡単に解けるが、使わなければはるかに難しい。5
Grok 4 は証明問題を解くことにかけて最先端に近いが、大きな伸びしろが残っている
この節では、さらに難しい二つの高校数学コンテストと、プロの数学者のコメントを見ていく。
まず、難易度も形式も似た二つのコンテスト、USAMO と IMO を取り上げる。どちらも高校数学コンテストとしてはこれ以上ないほど難しい。先ほどと同じ1〜10の難易度尺度で、その問題は7〜9の範囲にある。具体的には、毎年どちらのコンテストでも、たいてい7が2問、8が2問、9が2問出題される。6これらをそれぞれ「易しい」「中程度」「難しい」問題と呼ぶことにする。7
| コンテスト | 年 | 評価者 | 難易度(1〜10) |
|---|---|---|---|
| USAMO | 2025 | MathArena、各企業 | 7–9 |
| IMO | 2025 | MathArena、各企業 | 7–9 |
先に取り上げたベンチマークの問題は答えが短い形で求まるのに対し、USAMO と IMO の問題では厳密な証明が求められる。コンテストでは、解答は人間の専門家によって0〜7点で採点される。0点はまったく進展がないこと、7点は完全な解答を意味する。部分点はめったに与えられない。たいていは、意味のある手順を踏んだがまだ解答にはほど遠いものに1〜2点、小さな欠陥しかないほぼ完全な解答に5〜6点である。
自己申告の採点は解釈を難しくする
こうしたコンテストでの理想的な採点のかたちは、第三者の採点者が標準化された採点基準を使い、「ブラインド」で、つまりどのモデルがどの解答を書いたかを知らずに採点することである。MathArena がやっているのはまさにこれである。しかし、企業が社内で採点した結果を自己申告すると、比較は難しくなる。とりわけ、社内の採点者は異なる採点基準を使っているかもしれず、部分点を与える基準も違うかもしれない。第三者による採点がないなら、せめて企業が採点の指針を事前登録し、そのうえでモデルの解答とスコアを公開すれば、もっと多くのことが分かるだろう。
xAI は USAMO の結果を自己申告したので、その結果を解釈する際には上のことを念頭に置かなければならない。これは xAI だけを非難するものではない。現在、上の基準を満たしている企業は一つもない。8むしろ、こうしたやり方を最初に始める提供者には、他社と差をつける絶好の機会がある!
これらの問題を解くには、より深い数学の力が要る
これらのコンテストでも、先に述べたのと同じ高校の発展的な数学カリキュラムへの精通が求められる。それに加えて厳密な議論が求められる。証明は、論理の飛躍がないよう注意深く組み立てなければならない。
易しめの問題では、それ以上のものはあまり要らない。難しめの問題については、抽象化、創造性、深さという三つの要素が加わると私は考えている。抽象化とは、公式をひたすら計算するだけでなく、問題の対象について一般的な真理を導く必要があることを指す。創造性とは、背景知識をそのまま当てはめるだけでなく、何か新しいものを考え出す必要があることを指す。深さとは、解答をやり遂げるのに必要な手順の数を指す。もちろん、これらの要素は組み合わさることもある。最も難しい問題では、多くの手順が必要で、そのそれぞれに新しい抽象化が伴う。
これまでのところ、LLM はこうした問題のうち難しめのものではあまり成績がよくない。答えを簡単に検証できない問題で強化学習(RL)をどう行えばよいかがあまりはっきりせず、しかも自然言語で書かれた証明は簡単には検証できないからだと考えられる。
Grok 4 Heavy は難しい USAMO の問題でこれまでにない進展を見せた。その一因は背景知識にある
xAI の主張のうち最も注目に値するのは、Grok 4 Heavy が2025年の USAMO で62%を得点したというものだった。xAI のチームが Epoch に伝えたところでは、これは「易しい」2問と「中程度」の問題のうち1問を確実に解き、「難しい」2問ではときどき部分点(5〜6点の範囲)を得たことに相当する。それまで、一般に公開されているモデルが解いたのは「易しい」2問だけで、Google のまだ公開されていない Gemini 2.5 Pro Deep Think システムが同じ「中程度」の問題を解いていた。910
xAI はまた、この中程度の問題と二つの難しい問題について、評価の最も高かった解答を私たちに提供した。中程度の問題の解答は、Deep Think の解答と実質的に似ている。この問題を解いたモデルはそれまで Deep Think だけだったので、これだけでも注目に値する。
しかし、新しい能力を示しているかという点では、二つの難しい問題のほうが興味深い。
次に示すのは二つの難しい問題の一つ目である。ただし、ここからの議論は問題を深く理解していなくても追えるので、ざっと目を通すだけでかまわない。
建築家の Alice と建設業者の Bob がゲームをする。まず Alice が平面上の2点 P、Q と平面の部分集合 S を選び、Bob に知らせる。次に Bob は平面上に無限個の点を打ち、それぞれを都市とする。ただし、距離1単位以内に二つの都市を置いてはならず、置いた都市のうちどの三つも同一直線上にあってはならない。最後に、都市の間に次のように道路を建設する。都市の各組 A、B について、次の条件が成り立つとき、かつそのときに限り、線分 AB に沿って道路で結ぶ。条件:A とも B とも異なるすべての都市 C について、△PQR が △ABC または △BAC のいずれかと順相似になるような R が S の中に存在する。(i) できた道路を有限回たどることで任意の2都市間を行き来でき、かつ (ii) どの2本の道路も交差しないとき、Alice の勝ちとする。そうでなければ Bob の勝ちとする。どちらのプレイヤーに必勝戦略があるかを、証明をつけて決定せよ。
注:U を X に、V を Y に、W を Z に移す回転・平行移動・拡大縮小の列が存在するとき、△UVW は △XYZ と順相似であるという。
以前指摘したように、この問題は数学の確立したいくつかの分野を下敷きにしている。Alice の必勝戦略は、都市からできるグラフがガブリエルグラフと呼ばれるものになるように S を選ぶことである。この問題を解くのにガブリエルグラフを知っている必要はなく、おそらくこの知識を持っていた参加者はいなかった。しかし、LLM は間違いなく知っている! 実際、この問題に対するこれまでの LLM の解答は、ガブリエルグラフについての既知の事実を利用しようとしていた。ただし、うまくはいかなかった。
Grok 4 Heavy の解答もガブリエルグラフを使っており、他のモデルより先まで進んでいる。論理的に完全ではない。少なくとも一つ誤りが見つかる。Bob が置く都市が無限個ではなく有限個の場合にしか成り立たない推論をしている箇所である。しかし、解答全体が部分点に値するとしても、その点数は新しい解き方を見つける能力よりも、背景知識を使いこなす力を反映したものだと思う。
二つ目の問題に対する Grok 4 Heavy の解答は、それより弱いと思う。問題は次のとおりである。
m と n を m ≥ n を満たす正の整数とする。味の異なる m 個のカップケーキが円形に並んでおり、カップケーキが好きな人が n 人いる。各人は、カップケーキをどれだけ好きかに応じて、各カップケーキに非負の実数のスコアをつける。各人 P について、m 個のカップケーキの円を、連続するカップケーキからなる n 個のグループに分けて、どのグループでも P がつけたスコアの合計が 1 以上になるようにできるとする。このとき、m 個のカップケーキを n 人に配って、各人 P が受け取るカップケーキの P によるスコアの合計が 1 以上になるようにできることを証明せよ。
Grok 4 Heavy はこれを幾何の文脈に置き換える。空間内の点が、カップケーキの人への割り当てを表す。そこから先へ進めるなかで、幾何学の定理を誤って当てはめてしまう。実際に証明できているのは、望む性質を満たすようにカップケーキを分割して人に割り当てる方法がある、ということである。しかし問題はカップケーキを丸ごと割り当てることを求めており、Grok 4 Heavy の解答を修正する方法があるかどうかは私には分からない。繰り返すが、私は USAMO の部分点の基準に詳しいわけではない。それでも、この解答にはもっと厳しい点をつけたくなる。
私の結論としては、USAMO での Grok 4 Heavy の進展は、少なくとも Gemini 2.5 Pro Deep Think に匹敵する証明記述能力の向上に、そうした証明で背景知識を使いこなす能力の向上を加えたものだといえる。
Grok 4 は2025年の IMO では振るわなかった
ここでは、MathArena による、標準化された採点基準に沿った第三者のブラインド採点の結果を使える。残念ながら、これにはかなり多くの但し書きがつく。私の暫定的な結論は、Grok 4 は手を加えない状態では成績がよくなかったが、能力の引き出し方(エリシテーション)の影響が非常に大きいようなので、近いうちに急速な改善が見られても驚かない、というものである。
第一の但し書きは、MathArena が評価できるのは Grok 4 だけで、Grok 4 Heavy は評価できないことである。後者にはまだ API がないからだ。しかし、2025年の USAMO で証明問題について最も興味深い結果を主張していたのは Grok 4 Heavy だった。
これはそれほど厄介な問題ではないと思う。MathArena は best-of-n という引き出し方を使っており、これは Grok 4 Heavy の仕組みをある程度近似するはずだからである。MathArena のブログ記事から引用する。
先行研究に基づく手法を用いて、best-of-32 の選択戦略を適用した。私たちの以前の研究では、この手法が証明生成タスクで非常にうまく機能し、手元のデータでモデルの性能をほぼ2倍にすることが分かっている。具体的には、モデルの各解答について、まず32個の応答を生成した。これらの応答を、LLM を審査員とする仕組み(LLM-as-a-judge)を用いたトーナメント方式で評価し、一対一の比較で勝者を選んだ。ここでは、モデル自身に自らの応答を評価させた。モデルは各組を審査し、より優れた応答を選んだ。この過程を最良の応答が一つだけ残るまで繰り返し、残った応答を人間の審査員に提示して評価を受けた。
それでも、Grok 4 の成績は振るわなかった。ただし、意外な形で。MathArena は次のように述べている。
Grok-4 は予想を大きく下回った。最初の応答の多くは極端に短く、説明のない最終的な答えだけのことも多かった。best-of-n の選択はよりよい応答を選び出すのに役立ったが、(選ばれなかった)答えの大半は、追加の根拠を示さず最終的な答えを述べているだけだったことを指摘しておく。
xAI のチームは、Grok 4 の学習で使われていた短いプロンプトを与えると、はるかに長い答えが返ってくることを見つけた。その答えは、少なくとも表面的には、より証明らしいものだった。MathArena は、このプロンプトを使って Grok 4 の2回目の評価を行うことにした。もちろん、これはもはや同じ条件での比較ではない。しかし MathArena は、透明性を保ったうえでなら、研究コミュニティと共有する価値のある情報だと考えた。その判断の理由の全文はこちらで読める。
下の表は、Grok 4 の2回の評価の結果と、他のモデルの最初の評価の結果を示している。
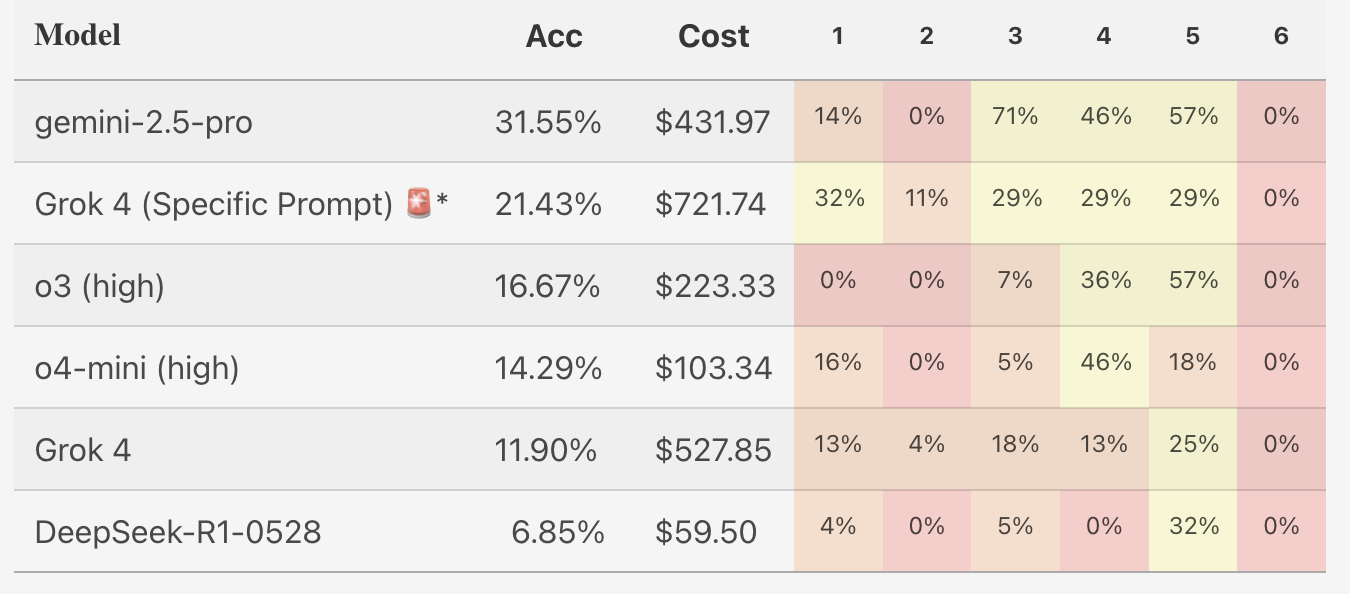
これも結論をそれほど複雑にはしないと思う。スコアが12%であれ21%であれ、この設定では Grok 4 の IMO での成績はよくないといえる。さらに、Grok 4 の得点は、プロンプトを変えた場合でも、すべて部分点によるものである。1回のサンプルでの最高点は3/7だった。人間がこのような点数を取ったら、その人は問題を最後まで解く方法を本当には分かっていなかったのだと私は受け取る。これは Grok 4 にとって悪い兆候である。もっとも、この指標ではたいていのモデルの成績が悪い。ここでいずれかの問題で7/7を取ったモデルは Gemini 2.5 Pro だけで、第3問の4回のサンプルのうち2回で満点だった。
最後に、MathArena が評価していない結果の注目すべき発表もいくつかあった。Google と OpenAI は、未公開の実験的なシステムで2025年の IMO ではるかに高い成績を上げたと発表した。上の表に当てはめれば83.33%に相当する。さらに、UCLA の教授である Lin Yang は、一般に公開されている Gemini 2.5 Pro から、プロンプトと足場(スキャフォールド)だけで同じ成績を引き出したと主張した。実験的な学習は必要なかったという。
Yang の結果を詳しく検証したわけではないが、私には十分ありそうなことに思える。その理由の一つは、AI の評価という目的からするとやや残念なことに、少なくとも人間の専門家による難易度評価によれば、今年の IMO の最初の5問が異例に易しかったことである。この評価によれば、Gemini 2.5 Pro Deep Think と Grok 4 Heavy がともに解いた2025年の USAMO の問題は、今年の IMO の最初の5問のどれよりも難しかった。
では、結局どういうことになるのか。確実に言えることが二つあると思う。
第一に、手を加えない状態では、Grok 4 は IMO で振るわなかった。他のモデルと比べてひどく劣るわけではないが、能力の上限はうかがえる。
第二に、引き出し方は重要である。LLM は全般に、証明問題を解くための素材の一部を明らかに持っているが、それらをまとめ上げるのにまだ苦労している。(少なくともこれはまったく新しい話ではない。私は3月からこのことについて書いてきた。)そう考えると、こうした潜在的な能力は近いうちにおそらく固まっていき、そうなればモデルはオリンピックの易しい〜中程度の問題をより確実に解けるようになるかもしれない。この点で Grok が先行するのか後れをとるのかは、まだ分からない。
数学者によれば、Grok 4 の証明を書く力には当たり外れがある
Grok 4 が証明で進歩したとしても、それは少しずつのものにすぎない。私たちが意見を求めた2人の数学者は、Grok 4 が Gemini 2.5 Pro や o4-mini-high といった他の主要モデルと同程度だと見たが、全体としては、Grok 4 の証明を扱う力は研究レベルの数学には不十分だと判断した。
Panova は、Grok 4 が彼女の専門である代数的組合せ論でとりわけ弱いと感じた。Grok 4 は、現役の数学者が証明に求める「詳しさの水準を理解していないようだった」という。Naskręcki は、Grok 4 が非常に短い答えを好むことを指摘した。ある結論の根拠を示すよう促しても、その推論は「穴だらけ」であることが多いという。
Panova はまた、Grok 4 があらゆる LLM と同様に、厳密だが「ソフトな」議論が必要な証明を、ごまかしながら済ませてしまうと報告した。ソフトな議論とは、数式による形式的な表現ではなく大部分が自然言語で書かれていても、数学者が納得できるような議論のことである。彼女はさらに、やや Grok 4 特有の癖として、適切な手法かどうかにかかわらず、しばしば数学的帰納法で証明しようとすることも指摘した。
Naskręcki は、Grok 4 がいかにも正しそうに見えるのに実は誤っている証明をひねり出すことがあり、これは現役の数学者にとって深刻な回り道になりうると感じた。Panova も同じ意見で、人間なら正しい答えを持っていないときにはそれを率直に認めることが多いと述べた。
これらのコメントはベンチマークの結果と矛盾しないと思う。あのコンテストは難しく、Grok 4 は(どのモデルとも同じく)まだそれすら制していない。しかし、本物の研究数学はまったく別次元のものである。
妥当性の確認:Grok 4 は FrontierMath でまずまずの成績だった
Epoch の FrontierMath ベンチマークは、Grok 4 の数学能力全般について独立したデータ点を与えてくれる。公開ベンチマークには過学習やデータ汚染の懸念がつきまとうかもしれないが、非公開の FrontierMath の問題ならその心配はないはずである。
FrontierMath は、数学の背景知識、創造的な問題解決、込み入った計算の遂行を試すように作られている。他の数学ベンチマークとの主な違いは難易度で、学部上級から駆け出しの研究者レベルの問題を対象としている。こうした問題が高校数学コンテストに出ることはない。
これまでに、全問を最後まで実行できる API 設定を探りながら、FrontierMath の Tier 1〜3 の問題で Grok 4 を2回実行した。Grok 4 のスコアはそれぞれ14%と12%で、統計的には区別できないと考えている。これにより Grok 4 は、私たちが実行したモデルのうち o4-mini を除くすべてを上回った。11
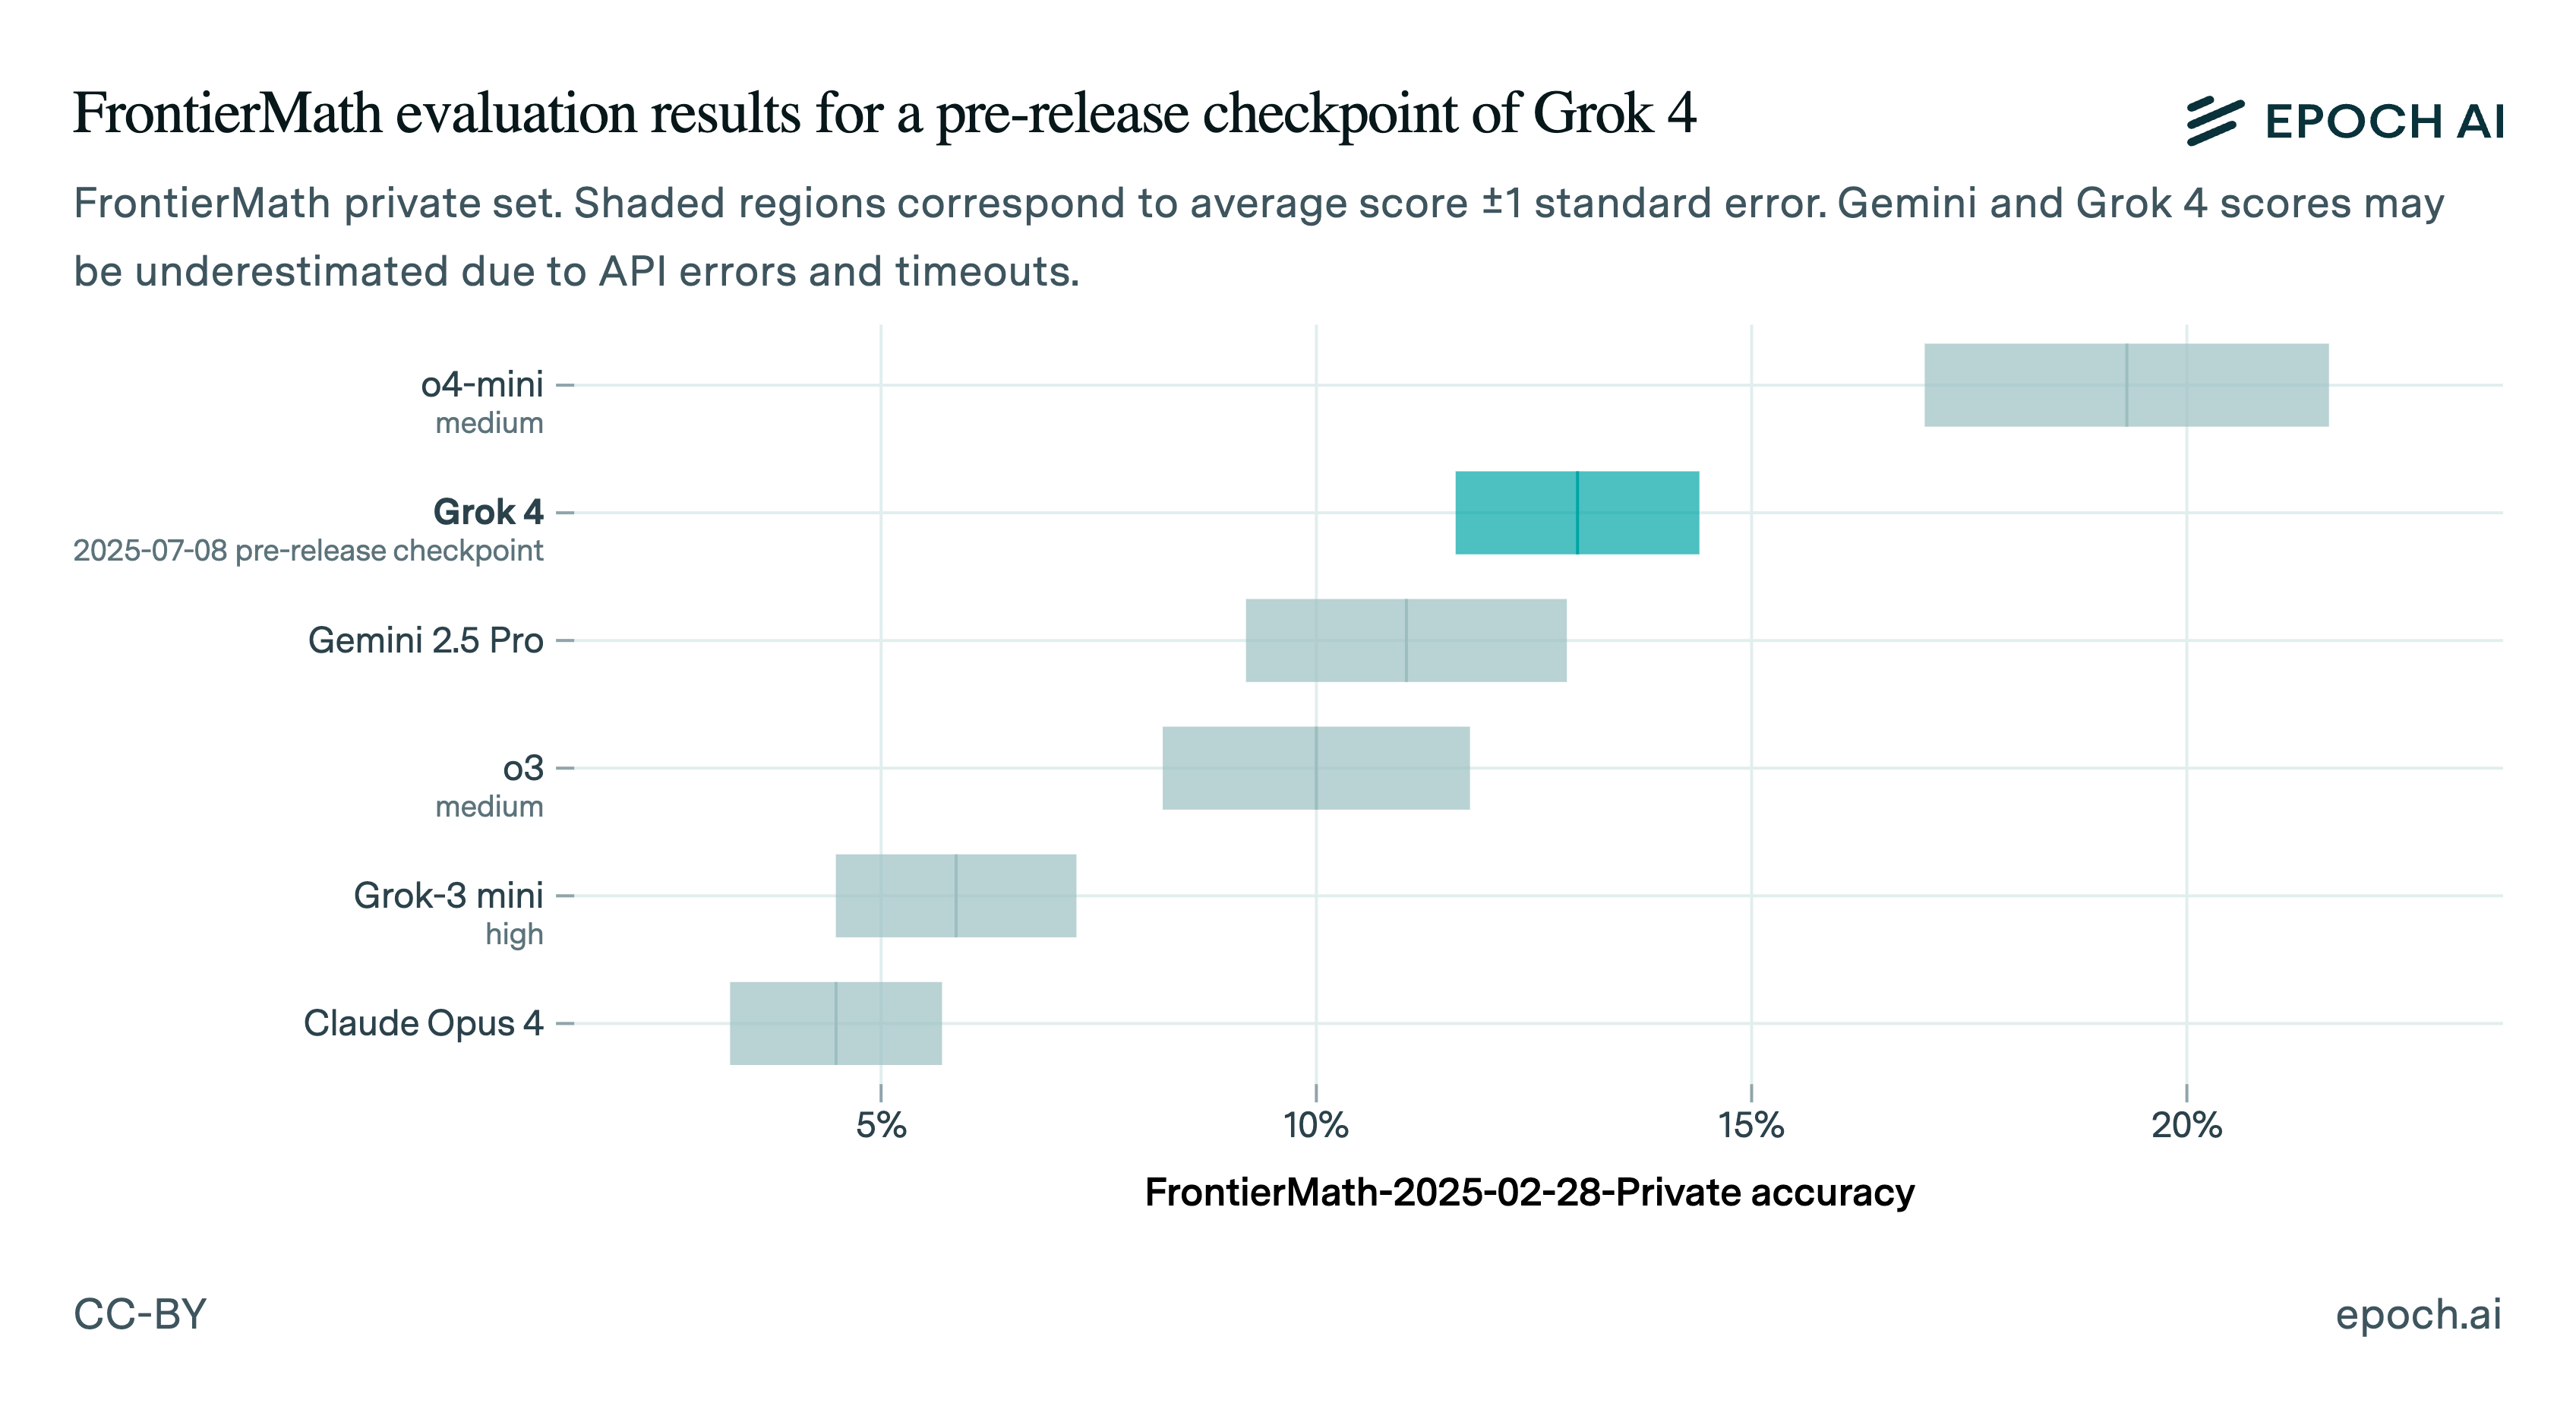
全体として、スキャフォールドの総トークン上限である10万トークンに達するモデルが増えていることにも気づいた。上限を引き上げて最先端モデルのいくつかを再実行する予定である。また、数学者たちが Grok 4 の文献を使いこなす力に感心していたことを踏まえると、ウェブ検索を有効にして実行してみるのも面白いだろう。私たちのスキャフォールドはまだそれに対応していないが、追加する予定である。
この2回の実行で、Grok 4 は、私たちが実行したどのモデルもこれまで解いていなかった問題を6問解いた。このうちどれだけが単なるノイズによるものかは何とも言えないが、Grok 4 には独自の問題解決上の強みがあり、少なくとも問題ごとに見て Grok 4 を完全に上回るモデルはない、という大まかな傾向には納得している。
より難しい Tier 4 の48問のうち、Grok 4 が解いたのは1問だけだった。この問題は他のモデルがすでに解いていた。全体として、いずれかのモデルが解いた Tier 4 の問題は3問しかない。
Grok 4 は数学の文献探索が得意である
数学者たちは、Grok 4 が数学の文献を探す力に非常に感心した。USAMO の二つの難しい問題の一つ目で見たのと同じく、Grok 4 の議論は文献に頼れるときに改善し、関連する文献を見つけるのもかなり得意だった。
Naskręcki は、これを Grok 4 の最大の強みの一つだと評した。Grok 4 は「ウェブ検索と情報源の比較に優れている」と述べ、この点では他のモデルと比べて製品としての完成度が高いようだと考えた。Grok 4 は、彼にとって「その分野で最初の検索をするときに頼るモデル」になるかもしれないという。「関連文献の非常に網羅的な一覧をすばやく見つけてくれる」からだ。
たとえば Naskręcki は、曲線のエタールコホモロジーの計算方法を説明するよう Grok 4 に求めた。Grok 4 は関連する手順をすべて文献から引き出すことができ、彼の考えでは、これから追いつこうとする駆け出しの研究者にとって格好の出発点になるものだった。
さらに、文献探索と組み合わせたとき、Naskręcki は Grok 4 の計算のいくつかにも感心した。トーラスのチェックコホモロジーを計算するよう求めたところ、これは「それほど難しくはないが、とりわけ込み入っている」計算だが、Grok 4 はウェブで関連資料を調べ、最終的に計算をまとめ上げることができた。また、関数体上の楕円曲線のモーデル・ヴェイユ群を計算するための関連文献を整理する作業でも、よい働きをすると感じた。これは非常に手の込んだ作業である。こうした理論的な計算の見取り図を示してもらえれば、理論の試作や検証をしようとする研究者の役に立つだろう。Gemini 2.5 Pro や o4-mini-high と比べて、Grok 4 は結果に含める関連文献がはるかに多い点が際立っていた。Naskręcki はまた、Grok 4 が自分の考えを、ウェブ検索を繰り返すだけでなく、小さな Python スクリプトを書くことでも探ろうとする傾向にも感心した。
Naskręcki は次のようにまとめた。
文献探索では、Grok 4 は関連する論文や数学の分野をまたぐつながりをすばやく見つけ出すことで真価を発揮し、見落としていたかもしれないアイデアや文献を見つける手助けをしてくれる。
Panova の報告もほぼ同じだった。彼女は、Grok 4 が他のモデルと比べて、いろいろ試してみる傾向が際立っていると感じた。小さな例を実際に計算してみたり、使える定理をウェブで探したりする。かなり知られていないが正しい文献を見つけてくることもあった。計算能力については、もう少し当たり外れがあると感じた。彼女の研究に関わるある問題では、Grok 4 は「専門家でさえ知らないかもしれない」知られていないが関連のある公式をウェブから見つけてきたが、最終的な答えの計算を誤った。
Panova は次のようにまとめた。
Grok4 は、ありとあらゆる方向に答えを探すのに長い時間をかけ、できる限り短い応答を返すが、細部は省いてしまう。ごまかしと「威圧による証明」の達人である。考えすぎて自分で混乱することもあるが、その探索はインターネットのあらゆる石をひっくり返し、よく隠れた文献を見つけ出す。
全体として、2人とも Grok 4 は非常に探索的だと感じた。それと関係があるのかもしれないが、2人とも Grok 4 は他の主要モデルより応答に時間がかかるとも指摘した。
Panova はまた、多くの方向に探索する Grok 4 の傾向が、かえって道を誤らせることもあると感じた。とりわけ、問題の設定が根本的な主題を見えにくくしている「カモフラージュされた」問題では、Grok 4 は「あらゆる方向に意味と手がかりを探して」、行き止まりにいくつも入り込んだ。Naskręcki もほぼ同じことを感じており、問題が非常に難しくなると、Grok 4 は多くの方向に多くの検索を始めるものの「明確な方針や戦略がない」と指摘した。Naskręcki は、ユーザーが探索に介入して指針を与えられる機能があれば役立つだろうと考えた。
Grok 4 には自分の誤りに気づく傾向がある
ここでは、以前私のブログで取り上げた初等的な問題を二つ検討する。単純な問題なのに多くの最先端モデルが間違える、という点で注目に値する。
Grok 4 は私のお気に入りの「ひっかけ」問題に正解する
GSM8K は、小学校レベルの簡単な文章題からなるベンチマークで、ずいぶん前からほぼ飽和しているが、100%には一度も届いていない。PlatinumBench のおかげで、GSM8K のどの問題を最先端モデルがいまだに間違えるのかが分かる。その多くは問題文のあいまいさによるものだと思うが、1問だけ毛色の違うものが目に留まった。
造園会社が顧客の庭に敷石を配達する。敷石は1枚75ポンドである。配達トラックが合計2000ポンドまで積めるとすると、80枚の敷石を1回で運ぶには何台のトラックが必要か。
以前論じたように、ほぼすべての最先端モデルがこれを間違える。私自身も最初は間違えた。80枚に75ポンドを掛ければ総重量は6000ポンドになる。トラック3台にちょうど収まりそうに思える。だが待ってほしい。トラック1台に実際には何枚載るだろうか。26枚なら 26 x 75 = 1950 ポンドになる。トラックの積載量が2000ポンドなら、27枚目を載せる余地はない。しかし3台のトラックがそれぞれ26枚を運んでも、3 x 26 = 78 枚にしかならない。2枚が残る。トラックがもう1台必要になる。正解は4台である。
この問題を見ると、『ファスト&スロー』(Thinking, Fast and Slow)で紹介された認知反射テストの問題を思い出す。このテストの問題は、「直観的で魅力的だが間違っている」答えが出るように作られている。もちろん LLM は元の認知反射テストの問題をよく知っている。だから、GSM8K に(おそらく意図せずに)同じ型のあまり知られていない問題が含まれていたのは、私たちにとって幸運だった。この問題を使えば、LLM がこの種のひっかけ問題にはまるのか、それとも見かけ以上のものがあることに気づけるのかが分かる。
これまでのモデルで、この問題に確実に正解していたのは Grok 3 (Think) だけだった。私が API で試したところ、o4-mini-high は10回中0回、Gemini 2.5 Pro は10回中3回、Grok 4 は10回中10回正解した。ウェブアプリの Grok 4 は半分ほど間違えた。そこで何が起きているのかは分からない。この能力は Grok 3 (Think) の時点ですでに注目に値したが、Grok 4 が最先端に躍り出た今、その意味はさらに大きいと思う。
ウェブアプリの Grok 4 Heavy は正解する。ただし、ウェブを検索しがちではある。12並列に動くインスタンスのうち一つが正しい答えにたどり着けば、比べることで他のインスタンスが間違っていることに気づけるのだろうと推測している。だから、ウェブから切り離しても確実に正解するだろうと思う。
Grok 4 は直観に反する幾何の問題にもたいてい正解する
次の例は、下の写真の子ども向けおもちゃから着想を得たものである。
四面体で、二つの面が1辺の長さ1の正三角形、二つの面が直角を挟む2辺の長さが1の45-45-90の直角三角形であるものを考える。このような四面体を二つ、直角三角形の面どうしで貼り合わせる。できる多面体を説明せよ。
人間がこの問題を解くいちばん簡単な方法は、実際に模型を作ってみることで、そうすれば答えは一目瞭然である。正方形を底面とする四角錐になる。元の二つの四面体は、この四角錐を、頂点と底面の向かい合う2頂点を通る鉛直な平面で、下の写真の赤いタイルに沿って切ったときにできるものである。
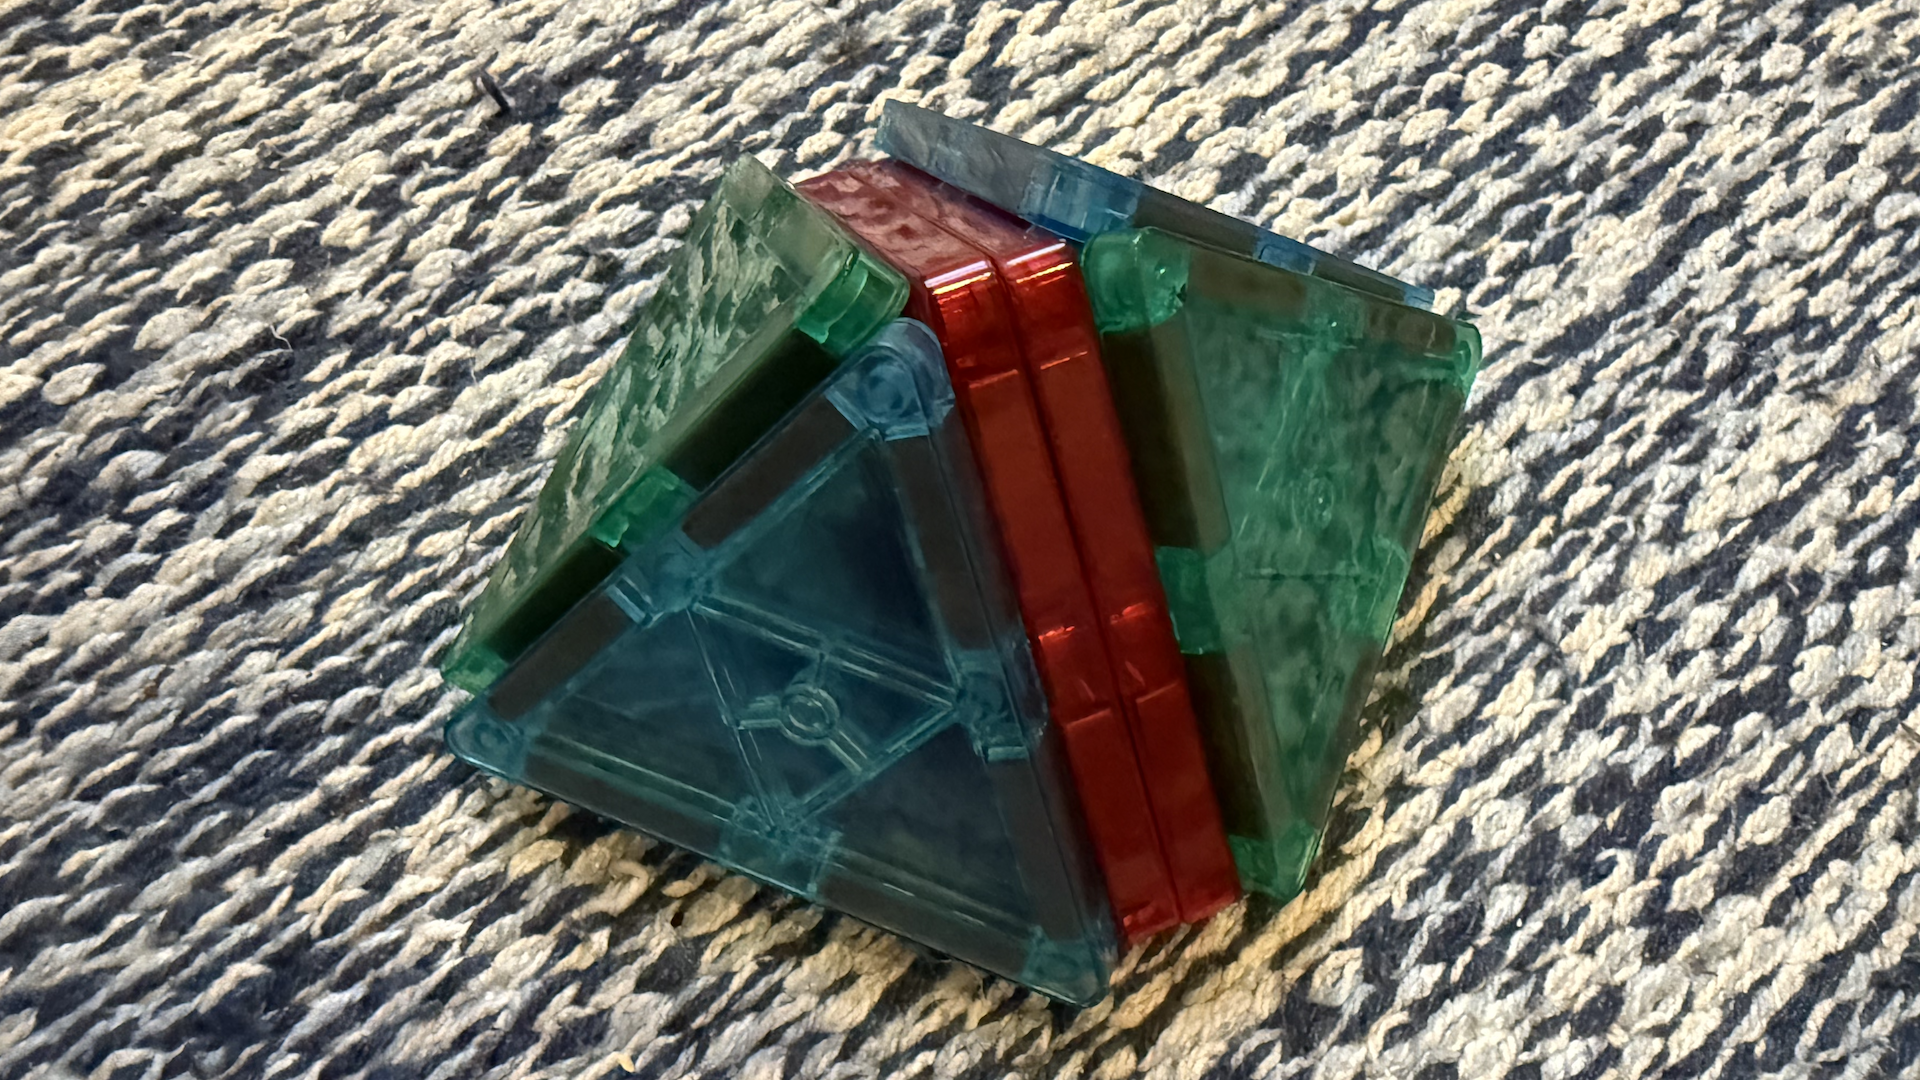
これが直観に反するのは、一般に二つの四面体を貼り合わせると面が6つの立体ができるからである。各四面体には面が4つあって合計8つになり、貼り合わせた2面を引くと6面が残る。ところがこの場合は、その6面のうち2面がたまたま同じ平面上に並ぶ。つまり、45-45-90の三角形二つが四角錐の正方形の底面になる。できる立体である四角錐の面は5つしかない。したがって、敷石の問題と少し似て、間違っている「既定の」答えがある。人間にとっては、実物を見て触れることがこれに気づくいちばん簡単な道である。
この問題が好きなのは、二つの問いに答える助けになるからである。モデルはこの場合が例外的であることに気づくのか。そして気づくとしたら、それは私たちが空間的直観と呼べるようなものによるのか。
API 経由で試すと、Grok 4 は10回中6回、正しい説明をした。残りの4回は、面が6つの三角両錐という、誤った一般的な場合を説明した。Gemini 2.5 Pro は10回中3回正解し、o3 と o4-mini-high は10回中0回だった。
解き方については、Grok 4 はいつも座標を使う。これは新しい空間的直観を示すものではないにせよ、敷石の問題で分かったことを裏づけている。Grok 4 は「慎重」だといえるかもしれない。どちらの場合も、最初の推測を十分に念入りに確かめ、少なくとも時には、話がそれだけでは終わらないことに気づく。
ここでも Grok 4 Heavy はよい成績を上げるだろうと予想する。
とはいえ、Grok 4 はまだ単純な誤りもする
Grok 3 (Think) が間違えた他の数少ない GSM8K の問題でも Grok 4 を試したところ、ごく単純な誤りが1件見つかった。下に、ウェブ UI に表示された要約版の思考の連鎖(chain of thought)で示す。
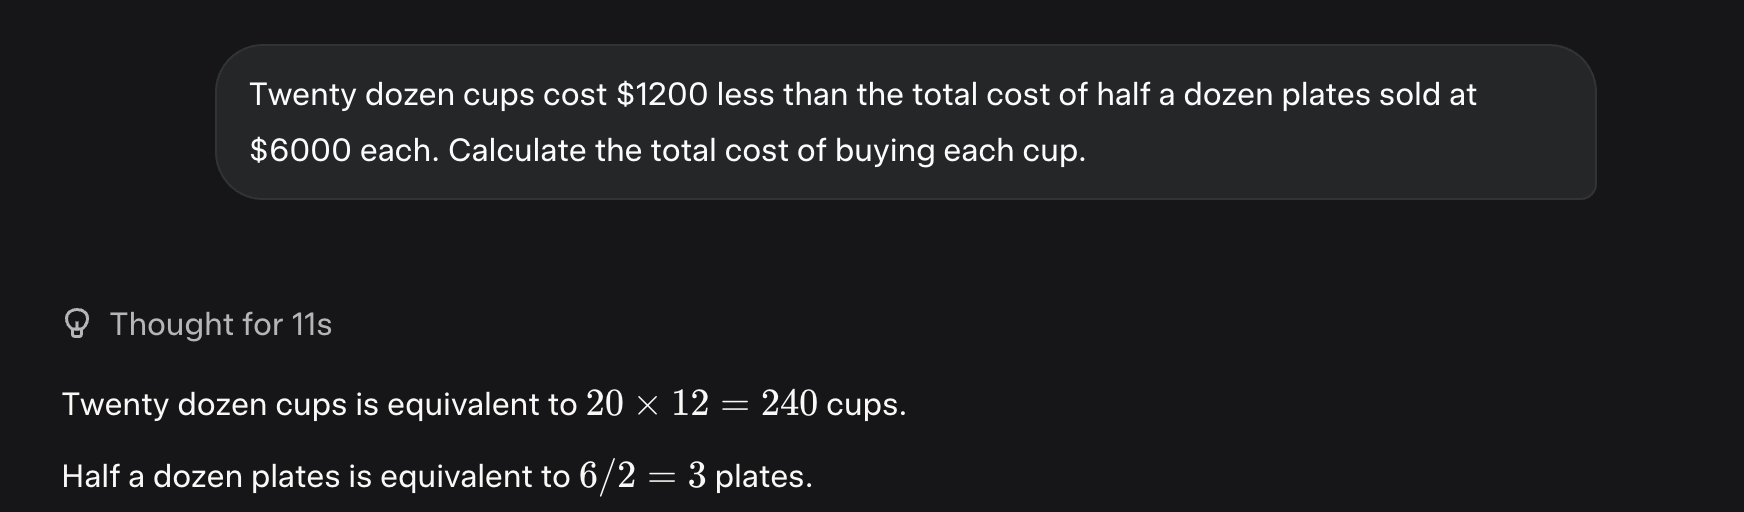
ある行で「ダース」の意味を正しく述べたばかりなら、すぐ次の行でそれを取り違えたりはしないだろうと思うところだが、そうはいかない。はっきりさせておくと、この種の誤りは決して Grok 4 に特有のものではない。また、おそらくかなりまれでもあるはずだ。そうでなければ、ベンチマークであれほどのスコアは取れないだろう。それでも、Grok 4 が基本的な信頼性の問題を完全には解決していないことは分かる。
API 経由で標準の Grok 4 でこれを試したところ、10回中6回正解した。ここでも、Grok 4 Heavy ならウェブに接続していなくても正解するだろうと推測する。
Grok 4 の数学的な推論はあまり人間らしくない
このことを示す証拠はすでにたくさん見てきた。たとえば、より概念的な議論ではなく「力業で解き切る」計算を使うことである。この節では、こうした種類の具体的な観察をまとめ、さらにいくつか例を挙げる。
なお、私が見た限り、この大まかな結論は現在のすべての LLM に当てはまる。
人間なら空間的直観を使う場面で、Grok 4 は直交座標に頼る
さまざまなコンテストの問題でも、上の四面体を貼り合わせる問題でも、Grok 4 は、人間がより高次の幾何学的直観と認めるようなものより、座標を使うやり方を好んだ。
幾何についての見方を補うために、簡単な例として2025年の AIME の第2問も見てみた。
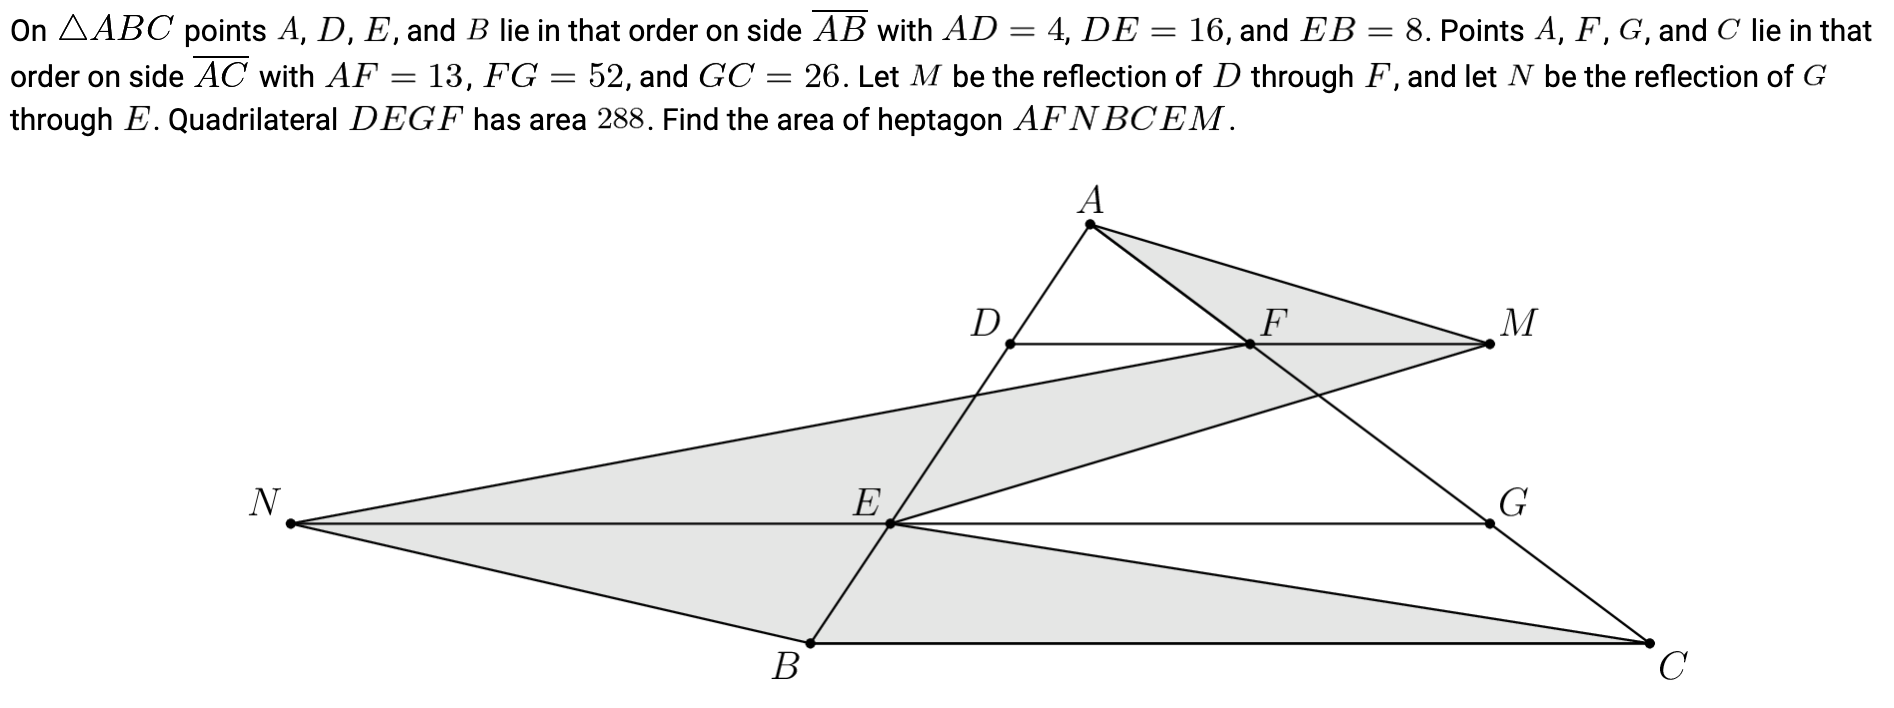
この問題は理解するのに少し時間がかかるが、簡単な解法がある。灰色の領域の下の部分は、三角形の下の部分と面積が等しい。真ん中と上の部分についても同じである。したがって七角形は無視して、三角形の面積を求めればよい。それは基本的な幾何の定理を使えば簡単にできる。
最先端モデルはどれもこの問題に正解するが、Grok 4 を含めて、どれもこのやり方では解かない。どのモデルも、与えられた情報を使って、塗られた領域の頂点を xy 平面上に置く。そのうえで、頂点の座標から多角形の面積を計算できる靴ひも公式を使う。まったく正当な解き方だが、幾何学的な洞察はまるでない。
今のところ、空間的直観は人間に固有のもののようだ。
Grok 4 は定石から外れた発想で問題を解くことはない
これについても、すでにいくつか例を見てきた。たとえば、Grok 4 の最も見事な解答のいくつかが背景知識に大きく頼っていたことである。ここでもう一つ、私の個人的なお気に入りの例を加える。この問題は2024年の IMO で出題されたものである。私の知る限り、「力業」や背景知識に頼る解法は存在しない。
カタツムリの Turbo が、2024行2023列の盤面でゲームをする。2022個のマスに怪物が隠れている。最初、Turbo はどの怪物の位置も知らないが、最初の行と最後の行を除く各行にちょうど1体ずつ怪物がいること、そして各列にいる怪物は高々1体であることは知っている。
Turbo は、最初の行から最後の行へ行こうと何度も挑戦する。各挑戦では、最初の行の好きなマスから出発し、辺を共有する隣のマスへの移動を繰り返す。(一度訪れたマスに戻ってもよい。)怪物のいるマスに着くと、その挑戦は終わり、Turbo は最初の行に戻されて新しい挑戦を始める。怪物は動かず、Turbo は訪れた各マスに怪物がいたかどうかを覚えている。最後の行のいずれかのマスに着くと、その挑戦は終わり、ゲームも終了する。
怪物の位置にかかわらず、n 回目以内の挑戦で最後の行に到達することを保証する戦略が Turbo にあるような、n の最小値を求めよ。
一番上と一番下の行には怪物がいない。残りの2022行にはそれぞれ1体ずつ怪物がいる。列は2023あるので、「各列に怪物は高々1体」ということは、安全な列がちょうど一つあり、それ以外の各列に怪物が1体ずついることを意味する。問われているのは、Turbo が(たとえば)一番上の行から一番下の行へたどり着くのに必要な挑戦回数の最小値である。
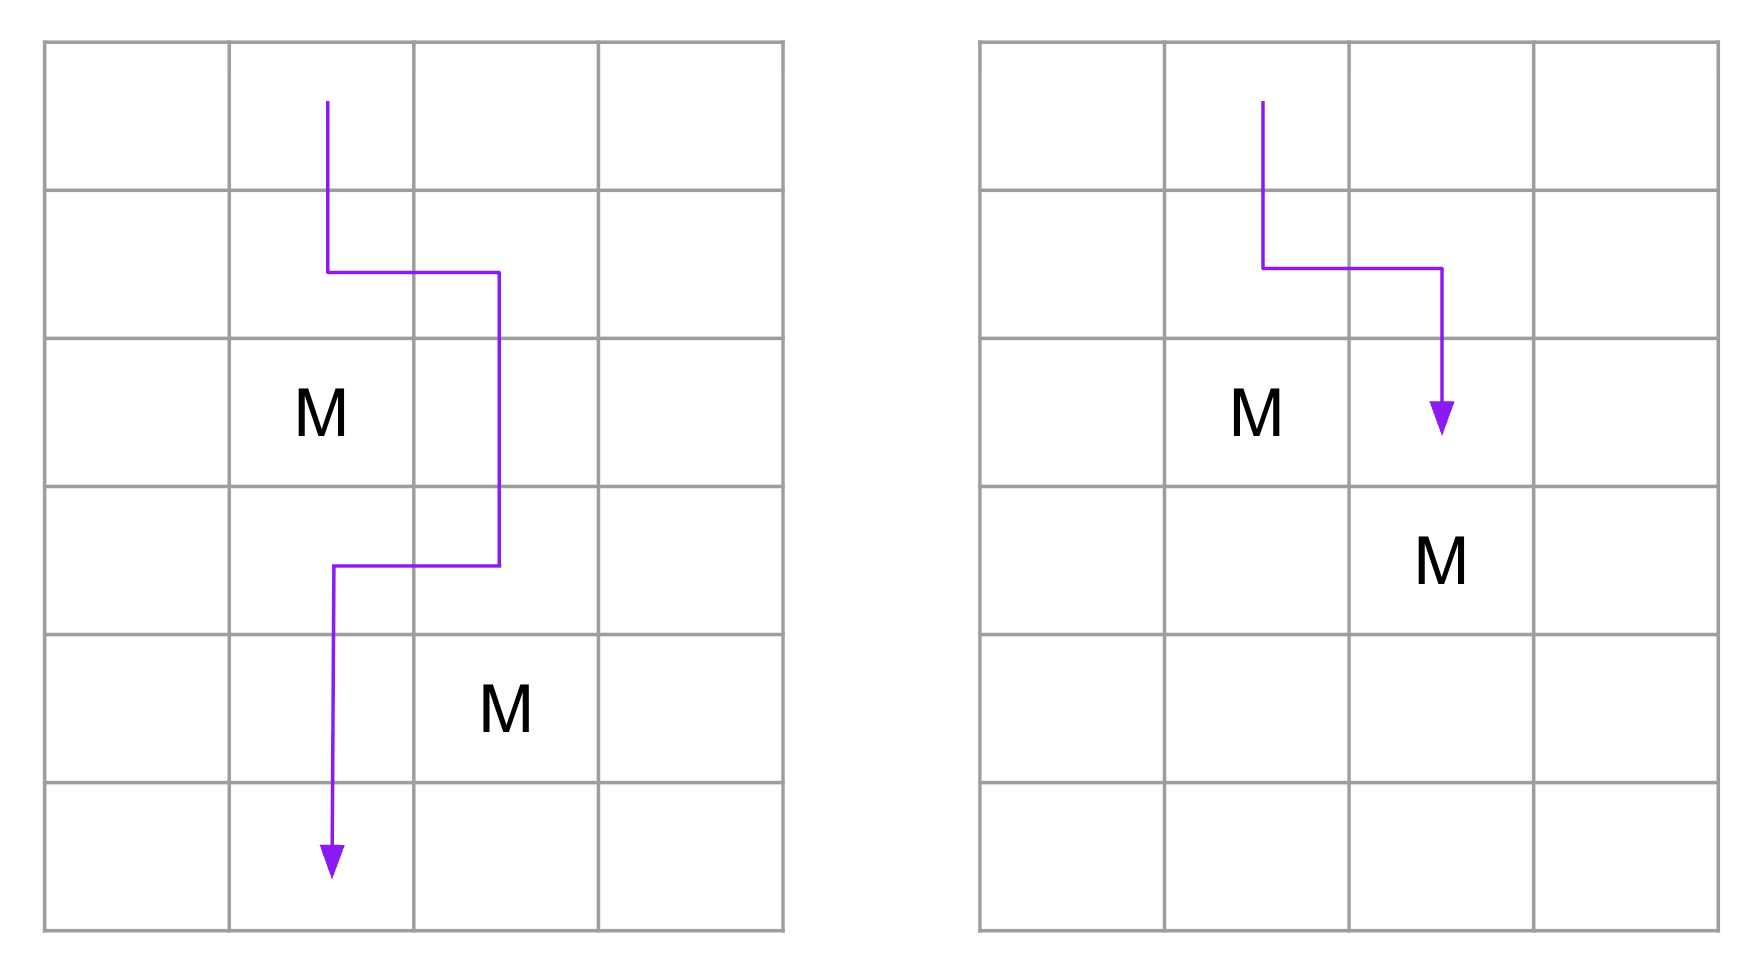
2023回あれば十分である。各列をまっすぐ下っていけば、いずれ安全な列が見つかる。ただし運が悪ければ、最後に試した列がそれかもしれない。もっとうまくやれるだろうか。この種の問題では、もっとうまくやる巧妙な方法があるか、もっとうまくやるのは不可能だと示す巧妙な方法があるかのどちらかである。いろいろ試してみると、有望なパターンがいくつか見えてくる。たとえば、隣り合う列で、斜めに隣接していないマスにいる怪物を2体見つけられれば、下図の左のようにジグザグに迂回できる。しかし怪物が斜めに隣接するマスにいると、下図の右のようにこの方法は使えない。実際、怪物が盤面全体を横切る1本の大きな対角線上に並んでいれば、左のパターンは一度も現れない。もちろん、これを逆手に取る戦略があるのかもしれないが……。
これはほんの入り口にすぎないが、求められる考え方の雰囲気は伝わるだろう。また、最終的な答えはやや直観に反する。成功を保証するのに必要な挑戦はわずか3回で、これは他の同様の盤面、たとえば1000行999列で怪物が998体の場合でも同じである。その戦略は見つけるのが容易ではなく、主観的に言えばかなり巧妙である。13
大局的に見てこの問題が好きなのは、より難しい研究上の問題(実用的な問題でさえ)で進歩のボトルネックになっていると私が想像するのと同じ技能の一部が、この問題には必要だと考えるからである。AI がこうした問題を解き始めたら、私個人としては、数学や科学で新しい飛躍がもっと見られるようになると予想する。
しかし今のところ、この問題で少しでも進展を見せた LLM はない。API 経由で10回サンプリングしたところ、Grok 4 は10回とも間違えた。面白いことに、実は何度か正しい最終的な答えを出していたが、戦略はまったく成り立たないものだった。2回の挑戦で隣り合う2列の怪物の位置を突き止め、3回目の挑戦でその間をジグザグに進む、というのである。もちろん、上の図の右半分のように2体の怪物がたまたま互いに斜めに隣接していれば、これはうまくいかない。Grok 4 はこのことに気づいていないようだった。
結論
Grok 4 は AI の数学能力の最先端に達した。設立から2年足らずの企業としては見事な成果である。私はこれを、資本を別にすれば、LLM の数学能力の周りにそれほど大きな堀(参入障壁)はないことの証拠と受け止めている。
次はどうなるのか。xAI は、Grok 4 を以前のモデルよりはるかに多くの強化学習(RL)で学習させたと報告している。その努力によって得られたのは、明確な、しかし少しずつの前進だと私は考える。収穫はこれまでも常に逓減してきた。入力を指数関数的に増やしても、出力は線形にしか伸びない。しかし定性的に見て、このことから私は、今日の RL を最先端の計算資源の水準まで拡大しても、数学者の仕事をこなせる AI システムがすぐに得られるわけではないことを痛感した。それには、さらなる規模の拡大(見たところかなりの規模)か、別の手法が必要になるだろう。
Grok 4 の出力の一部について助言をくれた Jasper Dekoninck と Ivo Petrov に感謝する。
注
-
注:2人は Grok 4 Heavy は使っていない。Grok 4 Heavy は応答が返るまでにかかる時間が予測しにくいため、Grok 4 に絞ることにした。最高品質ではないかもしれないが、より多くのやり取りができるほうを選んだのである。2人とも、数学で他の LLM を使った経験が豊富である。↩
-
AIME と HMMT については、xAI の結果は MathArena の結果と統計的に区別できない。xAI は OTIS Mock AIME の数値は報告していない。↩
-
HMMT は毎年2月と11月の2回開かれる。これは2月のものである。↩
-
これは主観的な主張だが、複数の主要な LLM の解答を何十件も検討した経験に基づいている。たとえばこちらやこちらを参照。↩
-
なぜこの問題は解かれていないのか。これは AIME の難しめの問題によくある型で、少しの背景知識と、そのあとのかなり長い場合分けの計算を必要とする。前の問題と同様に、現在の LLM にとってはほんの少しだけ力業の量が多すぎるようだ。API 経由で Grok 4 にこの問題を100回解かせたところ、正しい答えを出したのは2回だった。将来のモデルはもっと確実に正解すると予想する。↩
-
これは年によっていくらか変わる。たとえば2025年の IMO はやや例外的で、易しい問題が3問、中程度が2問、難しい問題が1問といった構成だった。↩
-
ここでの「易しい」はあくまで相対的なものである! ほとんどの高校生は、これらの問題を1問も解けないだろう。↩
-
一部のモデル開発者は、2025年の IMO の主催者と協力し、人間の解答を採点したのと同じ採点者にモデルの解答も採点してもらった。これは正しい方向への一歩だが、まだ足りないと思う。何より、採点基準も解答ごとの詳しい評価も公開されていない。そのため、他のモデルの解答に同じ基準の判断を当てはめることが難しい。この協力がすべてのモデル開発者に開かれていたのかがはっきりしない以上、この点はなおさら重要である。↩
-
Google は5月に、「Gemini 2.5 Pro Deep Think」というシステムを初めて発表した。本文で触れたのはこのシステムで、Google は社内の採点に基づき、2025年の USAMO で当時の最高水準だとしていた。その後7月に、Google は単に「Gemini Deep Think」と呼ばれるシステムを発表し、このシステムは2025年の IMO で金メダルを獲得した。どちらのシステムも一般には公開されていない。↩
-
これには、OpenAI が社内で実施した FrontierMath の実行は含まれない。たとえば、こちらで取り上げた ChatGPT agent の結果などである。OpenAI は FrontierMath の問題に独占的にアクセスできる。↩
-
そう、簡単な文章題でさえ検索するのである!↩