
ニュースレター
IMOから学べたことは多くなかった
原題:We didn’t learn much from the IMO
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
数週間前、私は IMO(国際数学オリンピック)がAIの数学能力について何を教えてくれそうかを論じた。IMO はすでに終わり、Google と OpenAI がともに、6問中同じ5問を解いた実験的なLLMを発表した。ちょうど金メダルに届く成績である。そこから何がわかったのか。
金メダルに大きな興奮が起きたのは当然だが、よく見ると、この成果は能力の進歩についてほとんど何も教えてくれないと私は考える。原因は運の悪さにある。解かれた5問はたまたま、AIシステムがすでに解けていた問題と比べて難しくなく、解かれなかった1問は、これまでどのシステムが解いた問題よりもはるかに難しかった。
本稿では、IMO から学べたことは多くなかったという主張を述べる。問題についての統計と過去のAIシステムの成績を使う「外側」からの見方と、個々の問題とAIの解答を詳しく見る「内側」からの見方の両方をとる。
Epoch AI の最新情報を受け取る 購読する
外側から見ると、今回の問題からは得られる情報が少ない
主な問題は、今年の問題の難易度分布が異例なほど偏っていたことである。米国IMOチームのコーチ Evan Chen が判定した難易度評価 MOHS をプロットすると、それがはっきりわかる。
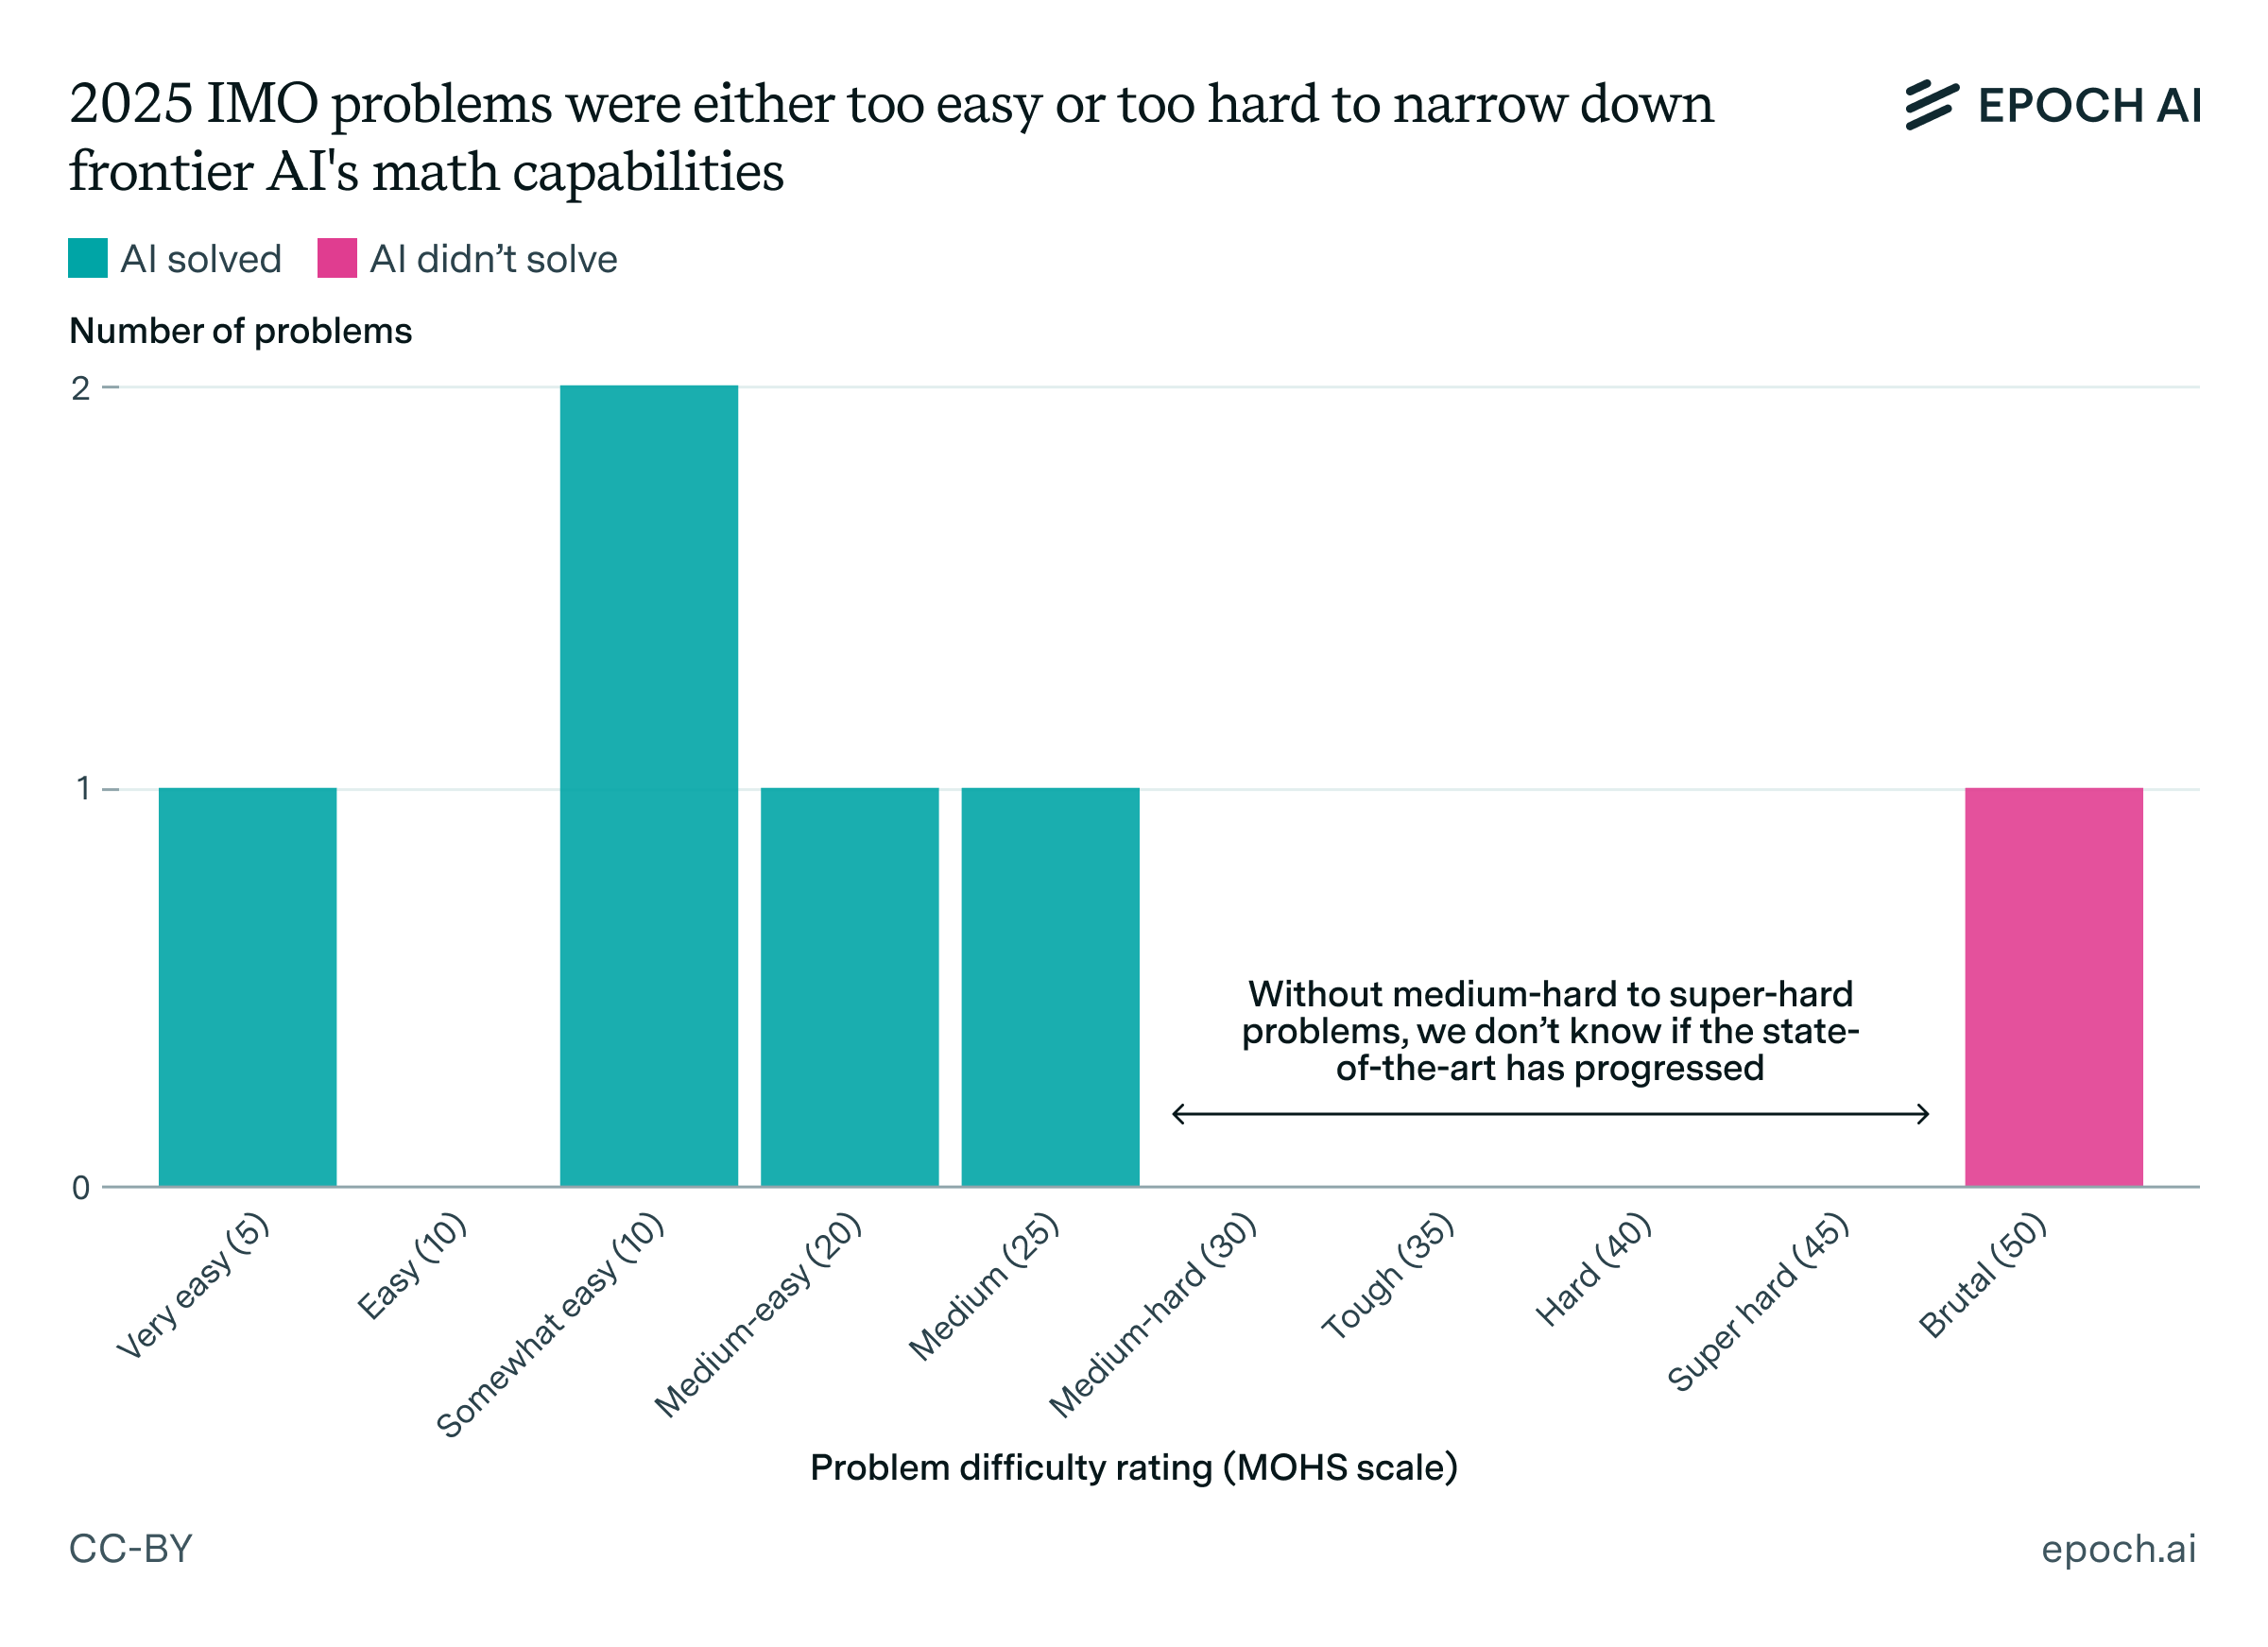
一般的な受け止め方でも、Chen のより細かいデータでも、IMO には通常、易しい問題が2問、中程度の問題が2問、難しい問題が2問ある。1 2025年は、難しい問題が1問しかなかった点で異例だった。Chen のデータが始まる2000年以降で、5問以上が MOHS 25以下だったのは、ほかに1回しかない。さらに悪いことに、今年の唯一の難問は非常に難しかった。Chen によれば、2000年以降の IMO でこのような「残酷な」(MOHS 50の)問題は、ほかに2問しかない。2
額面どおりに受け取れば、AIの数学能力は「中程度」と「残酷」の間のどこかにあることになる。以下で私は、易しい〜中程度のこれらの問題を解いたことは漸進的な進歩にすぎず、主に信頼性の面での前進であって、新しい能力が現れた兆しではないと論じる。同様に、「残酷な」問題を解けなかったことから除外できるのは、きわめて急速な進歩だけである。これらの新しいモデルに新しい能力がまったくないと言うのではない。今年の IMO からはそれが判断できない、ということだ。
AIシステムはすでにこの水準に達していた
トップレベルの高校生向け数学コンテストで、易しい〜中程度の問題をAIシステムが解けることを知らなかったなら、この金メダルの結果で認識を改めるべきなのは確かだ。しかし、過去1年のさまざまなAIシステムの成績をよく見ると、この能力は新しいものではない。
IMO 以前に Deep Think はすでに「中〜難」の問題を解いており、それ以前のモデルも解けるところまで来ていた
5月、Google は Gemini 2.5 Pro Deep Think が2025年の USAMO3 の MOHS 30の問題(「中〜難」)を解いたと発表した。前回の記事で書いたように、この問題には背景知識の慎重な適用とある程度の深さが必要だったが、とりたてて意表を突く発想は必要なかった。つまり、Deep Think の手の届く範囲に、ある種の中程度の難易度の IMO 問題があることは、すでにわかっていた。2025年の IMO の MOHS 5〜25の問題を解いたからといって、それ以上に目覚ましい能力がただちにうかがえるわけではない。
公平を期せば、これは単に5月の時点で Deep Think がすでに目覚ましかったということかもしれない。しかし、USAMO での成績でさえ驚きではなかった。今年3月に USAMO が行われたとき、当初はどのモデルも良い成績を挙げられなかった。しかし私は当時、次のように書いた。o3-mini のような入手可能なモデルは、のちに Deep Think が解くことになるまさにその MOHS 30の USAMO 問題も含め、多くの問題を解くのに必要な材料の多くをすでに持っているようだ。わずかな改善でおそらく解けるようになるだろう、と。だから私は、USAMO と IMO での Deep Think の成績は、この潜在能力が単に現実になったものだと見ている。
現在入手できるモデルにも、IMO でそこそこの成績を挙げたものがある
MathArena は、IMO 以前に公開されていたモデルを IMO の問題で評価した。結果は悪くなかった。最高得点は Gemini 2.5 Pro で、4回中の最良をとる設定で MOHS 25の問題を解き、MOHS 15の2問でかなりの部分点を得た。後者の2問について MathArena は、満点との差はそれほど大きくないようだと指摘し、「こうした比較的小さな論理上の問題が解決されれば、近い将来モデルは大きく向上しうる」と述べている。
現在入手できるモデルが中程度の難易度の IMO 問題をときに解けるというのは、多少目新しい。汚染されていない(学習データに含まれていない)問題で、これほどはっきり見えたことはなかった。しかしこのことで、実験的なモデルが漸進的な進歩を示すために達成しなければならない水準の下限が上がる。最難問を解けなかった以上、残された余地はあまりない。4
LLMが AlphaProof に追いついたとさえ結論できない
前回の記事で私は、LLMが、AIによる IMO の前記録保持者である Google の特化型システム AlphaProof の成績に並べるかどうかが興味深いと書いた。AlphaProof は2024年の IMO で6問中4問を解いた。とくに注目すべき成果は、MOHS 40の「難しい」問題を解いたことだった。その解答はあまり洞察に富むものではなかったが、ともかく証明できたこと自体が興味深かった。
ここでも難易度分布が不利に働いた。今年の IMO で解かれた5問はいずれも AlphaProof が解いた最難問よりかなり易しく、唯一の難問はそれよりかなり難しかった。5 実験的なLLMには、直接競う機会がなかったのである。
内側から見ても、易しい〜中程度の問題に新しい能力は必要なかった
実際、これらはどんな問題なのか。実験的なシステムの証明に、何か驚くような点はあるのか。私はとくに、人間が創造性や概念的思考と見なすものを必要としつつ、人間の基準ではそれほど難しくない問題が出ることを期待していた。残念ながら、易しいほうの5問はどれも、既存のモデルがまだ示していないものを必要としないと思う。どれも多少なりとも「当たり前のことをやれば解ける」タイプの問題だった。6 一方、唯一の難問は、IMO の問題が求めるほぼすべての技能を、一度にすべて要求する。
問題とAIの解答について、私の評価を簡単にまとめると次のようになる。7
| 問題(MOHS) | 分野 | 人間から見た評価 | AIの出来 |
|---|---|---|---|
| 1 (5) | 組合せ論/幾何 | かなり易しい。一つの気づきで解ける。 | 幾何的な側面に苦戦したが、大量の代数計算で乗り越えた。 |
| 2 (20) | 幾何 | ひたすら計算するだけ。あまり面白い問題ではない。 | 計算で押し切った。 |
| 3 (25) | 整数論 | 意外なほど素直。「当たり前のことをやる」で解ける。 | 人間もとる素直な方針に沿って解いている。 |
| 4 (15) | 整数論 | 素直。場合分けによる分析がそれなりに多い。 | 人間もとる素直な方針に沿って解いている。 |
| 5 (15) | 代数 | 素直。「当たり前のことをやる」で解ける。 | 人間もとる素直な方針に沿って解いている。 |
| 6 (50) | 組合せ論 | 非常に難しい。創造性と抽象化が必要で、解答は長い。 | 正しい最終的な答えにたどり着けず、証明などなおさらだった。 |
とくに注目に値すると思った問題から、いくつか例を挙げる。
おかしなことに、最も興味深いのは第1問かもしれない。人間にとっては最も易しい問題である。幾何的な性格を帯びた組合せ論の問題で、LLMは全般に空間的な直観を欠くため、この種の問題に苦戦する傾向があった。MathArena では、一般に公開されているモデルはどれもこの問題を解けなかった。実験的なモデルはどう解いたのか。問題は次のとおりである。
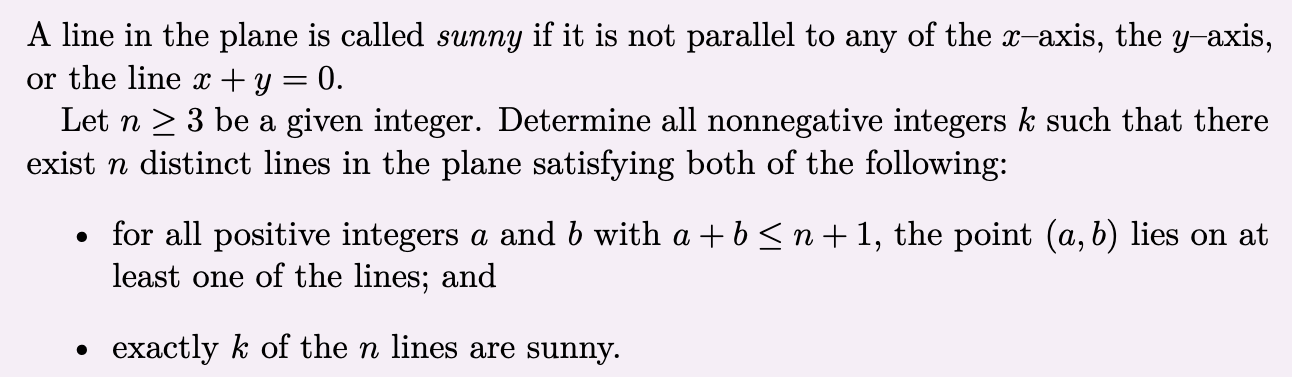
下の図は、n=4 の場合で、sunny な直線が1本ある配置の例である。
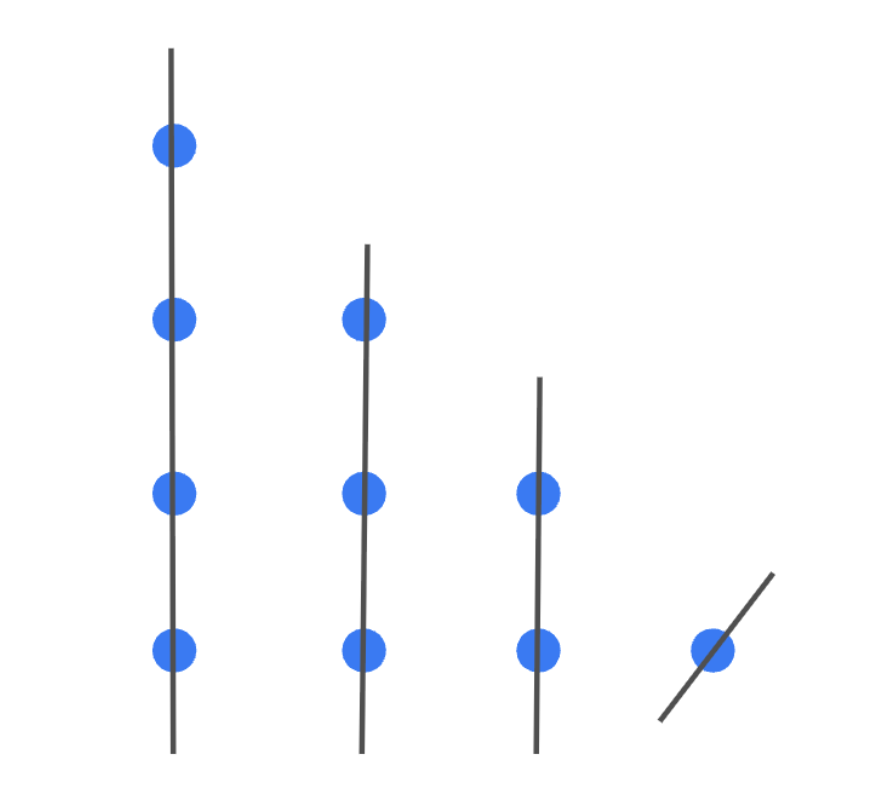
人間にとって鍵となる観察は、n≥4 のとき、直線のどれかが三角形の辺の一つを覆わなければならないということだ。これに気づけば、問題は n=3 の場合の分析に帰着できる。Chen の模範解答は、この帰着を次のように表現している。
したがって帰納法により、sunny な直線の本数を変えずに[辺の]直線を繰り返し取り除いて n = 3 まで減らせる (逆に、より小さい n の構成が与えられれば、 n を1増やして[辺の]直線を加えればよい)。
LLMはこのステップに苦労しているようだ。証明はするものの、Chen のような一文の議論ではなく、何段落もの代数計算を使う。Google の解答は次のとおりで、OpenAI の解答も論理的には同様である。
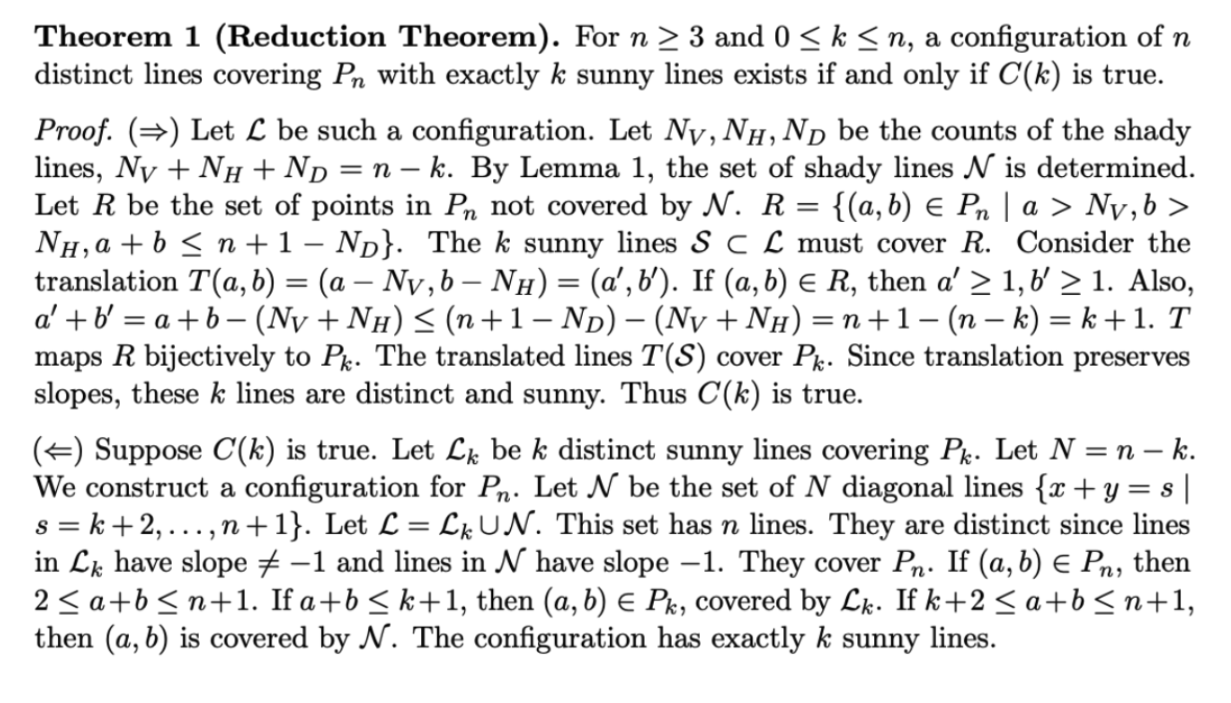
ここで起きているのは、LLMが人間の空間的な直観のようなものを使えず、辺の直線を取り除いたり加えたりしても相似な三角形になることが見て取れないため、同じ結論にたどり着くのにより記号的な方法をとらざるをえない、ということだと思う。LLMに空間的な直観が欠けていることは以前にも観察しており、最近では Grok 4 の数学能力の分析で、それ以前にも個人ブログで取り上げた。LLMは、この代数的な回り道を見つけるのに、単に「考える時間」がもっと必要だっただけだろうと私は推測している。
では、AIシステムが解いた問題のうち、人間にとって最も難しい問題はどうだろうか。それがこれである。
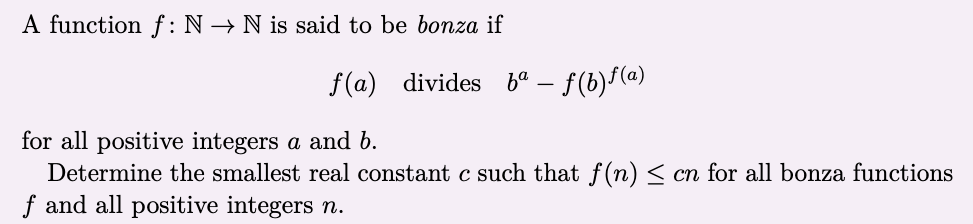
あいにく、この問題は「当たり前のことをやる」だけで解けてしまう。そしてLLMはしばらく前からそれが得意である。ある数学系 YouTuber は、この問題について次のように述べている。
ふだん私の動画には「動機づけ」のパートがあるのですが、この問題は実のところかなり素直で、調べてみようという動機に従って手を動かしていくと、そのまま解答にたどり着いてしまうんです。
この問題では、与えられた整除性の条件から非常に多くを引き出せる。すべての正の整数 a と b について成り立つので、a と b にさまざまな値を代入して多くの情報を得られるからだ。さらに、与えられた性質は整数の整除性についてのものなので、自然な発想として素数をいくつか代入してみると、それで全体が解けてしまう。
Chen の模範解答の概略は次のとおりである。
- すべての n について、f(n) は nⁿ を割り切る。
- f(n)=n であるか、すべての奇素数 p について f(p)=1 であるかのどちらかである。
- すべての n について、f(n) は2の累乗である。
- f(n) は、n を割り切る2の最大の累乗の4倍未満である。つまり f(n)≤4n である。
- ある n について f(n)=4n となる例を構成する。
実験的なLLMの証明は、細かな違いはあるものの、この道筋に沿っている。たとえば、上に挙げた第3ステップの一部についての OpenAI の証明は次のとおりである。
4. Structure in non-identity case.

First, show no odd prime can divide any value.

Suppose n with odd prime r | f(n). Obs O: f(n)|n^n -> r|n. Now P_f(n,r): modulus f(n) divisible by r.
So r | r^n - f(r)^{f(n)}. But f(r)=1 (r odd). So need r| r^n - 1. r^n divisible by r, difference -1 mod r, impossible. So cannot. So indeed:

(**) In non-identity case: for all n, f(n) has no odd prime factors. So f(n) is power of 2 always.
ちなみに、このモデルの言葉づかいが妙に電報のように切り詰められていることに気づくだろう。最終的な出力というより、生の思考過程(chain-of-thought)に近いのかもしれない。理由はわからないが、たいした意味はないのではないかと思う。言い回しは変わっていても、論理はまったく人間らしい。
最後に、難問は本当に難しかったことに触れておく。ただし、問題文を理解するのはかなり簡単である。
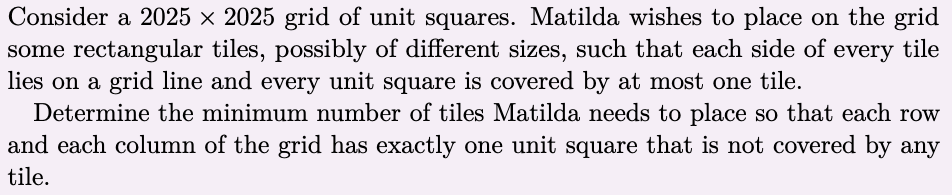
素朴に予想される4048よりずっと良い値にできるが、正しい答えを見つけることさえ難しい。どのLLMも見つけられなかった。8 さらに、この自明でない答えが実際に最良であることを証明するのは、まったく別の話である。私は以前、難しい IMO 問題には抽象化、創造性、深さが必要だと特徴づけた。抽象化とは一般的な真理を導く必要があること、創造性とは何か新しいものを思いつく必要があること、深さとは解答を最後までやり遂げるのに必要なステップ数のことである。この問題は、その3つすべてを大いに必要とする。全体として同じ性格を持ちながら、もう少し易しい問題が出ていれば、もっと多くのことがわかっただろう。
少なくとも IMO は、検証の難しい領域での信頼性を考える興味深い事例だった
金メダルには何かしらの意味があるのではないか。確かに本物の成果はあると思うが、それはむしろ信頼性にかかわるものである。つまり、実験的なモデルには1回の提出しか許されていなかったのに、論理の穴を一つも残さずにこの5問を解ききった。
これがいっそう興味深いのは、自然言語による証明が、自動検証はできないが、何をもって証明が妥当とするかについて人間がきわめてよく練られた基準を持っている、という絶妙な位置にあるからだ。LLMにそうした基準を高い精度で理解させることはできるのか。これは数学をはるかに超えて、出力の検証は難しいが人間が一般に「見ればわかる」あらゆる領域にかかわる問題である。
少なくとも IMO は、性能を最大限に引き上げたLLMが、そうした領域の一つで、必要な推論がそれほど難しくない限りは、確かに信頼できる結果を出せることを示した。しかし、中程度の難易度の IMO 問題を超える推論能力の出現を見極めるには、他の評価に目を向ける必要がある。
注
-
一般的な受け止め方については、たとえばこちらを参照。もちろん「易しい」は相対的なもので、ほとんどの高校生は IMO の易しいほうの問題さえ解けない。 ↩
-
「外側」からの見方では MOHS の評価に大きく頼る。主観的なものであるのは確かだが、Chen はオリンピックの世界で非常に尊敬されており、これは得られる限りで最も権威ある専門家の意見に近い。 ↩
-
USAMO は米国の全国大会で、IMO と同じ形式、同程度の難易度である。 ↩
-
MathArena は、この4回の試行のそれぞれについて、LLMが自分の解答をトーナメント(勝ち抜き戦)形式で審査する、32回中の最良を選ぶ足場(スキャフォールド)を使った点に注意。これはテスト時の計算量を1〜2桁増やすことにあたり、MathArena によれば、これで成績が大きく上がったという(逸話的な報告である)。したがって、これは完全に「そのままの状態」での成績ではないが、昔ながらのテスト時の計算量の拡大だけでも金メダルにかなり近づけることがうかがえる。実際、UCLA のある教授は、追加の学習を一切せず、足場だけで Gemini 2.5 Pro から金メダル相当の成績を完全に引き出したと主張している。この結果は事前登録も独立した検証もされていないが、他のすべてと同じ方向を指していると思う。 ↩
-
これは AI企業 Harmonic にとっては残念なことだ。同社のモデルは AlphaProof と同じく形式的証明を生成し、2025年の IMO の易しいほうの5問を解いた。しかし同社は、AlphaProof が解いたものより難しい汚染されていない IMO 問題を解いたとは主張できない。 ↩
-
このことは MOHS の評価だけからも推測できるかもしれない。私のお気に入りの IMO 問題は、AlphaProof が解けず、一般に公開されているどのモデルも解けず、創造性のようなものが必要だと私が考える問題だが、それでも MOHS 35だった。現在一般に公開されている版の Deep Think でさえ、私が6回試したすべてでこの問題を誤答した。ただし、これは IMO で金メダルを獲った版ではない。 ↩
-
OpenAI のある研究者は、同社のモデルは少なくとも、第6問の正しい答えがわからないことは自覚していたと述べている。LLMは証明問題形式のコンテスト問題の解答の正しさをそれなりに判定できるので、これはありそうなことである。 ↩
-
これは、(a) この問題でどのAIシステムも部分点を得ていないこと、(b) MathArena の採点基準では正しい最終的な答えを達成する構成を見つければ1点が与えられること、の2点から推測している。 ↩