
ニュースレター
ベンチマークのスコア=汎用能力+Claudeらしさ
原題:Benchmark Scores = General Capability + Claudiness
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
Gemini 3 の公開時には、このモデルが多様な19のベンチマークで最高水準だったことを示す巨大な表が添えられていた。こうした表は今ではありふれているが、積み重なると統計的に奇妙な状況が生まれる。ベンチマークは表向きはそれぞれ別のものを測っている。ところがモデルは多くのベンチマークで同時に伸びる傾向があるので、ベンチマークのスコアのデータセットは、単一の「汎用能力」の次元に支配されているのだ。
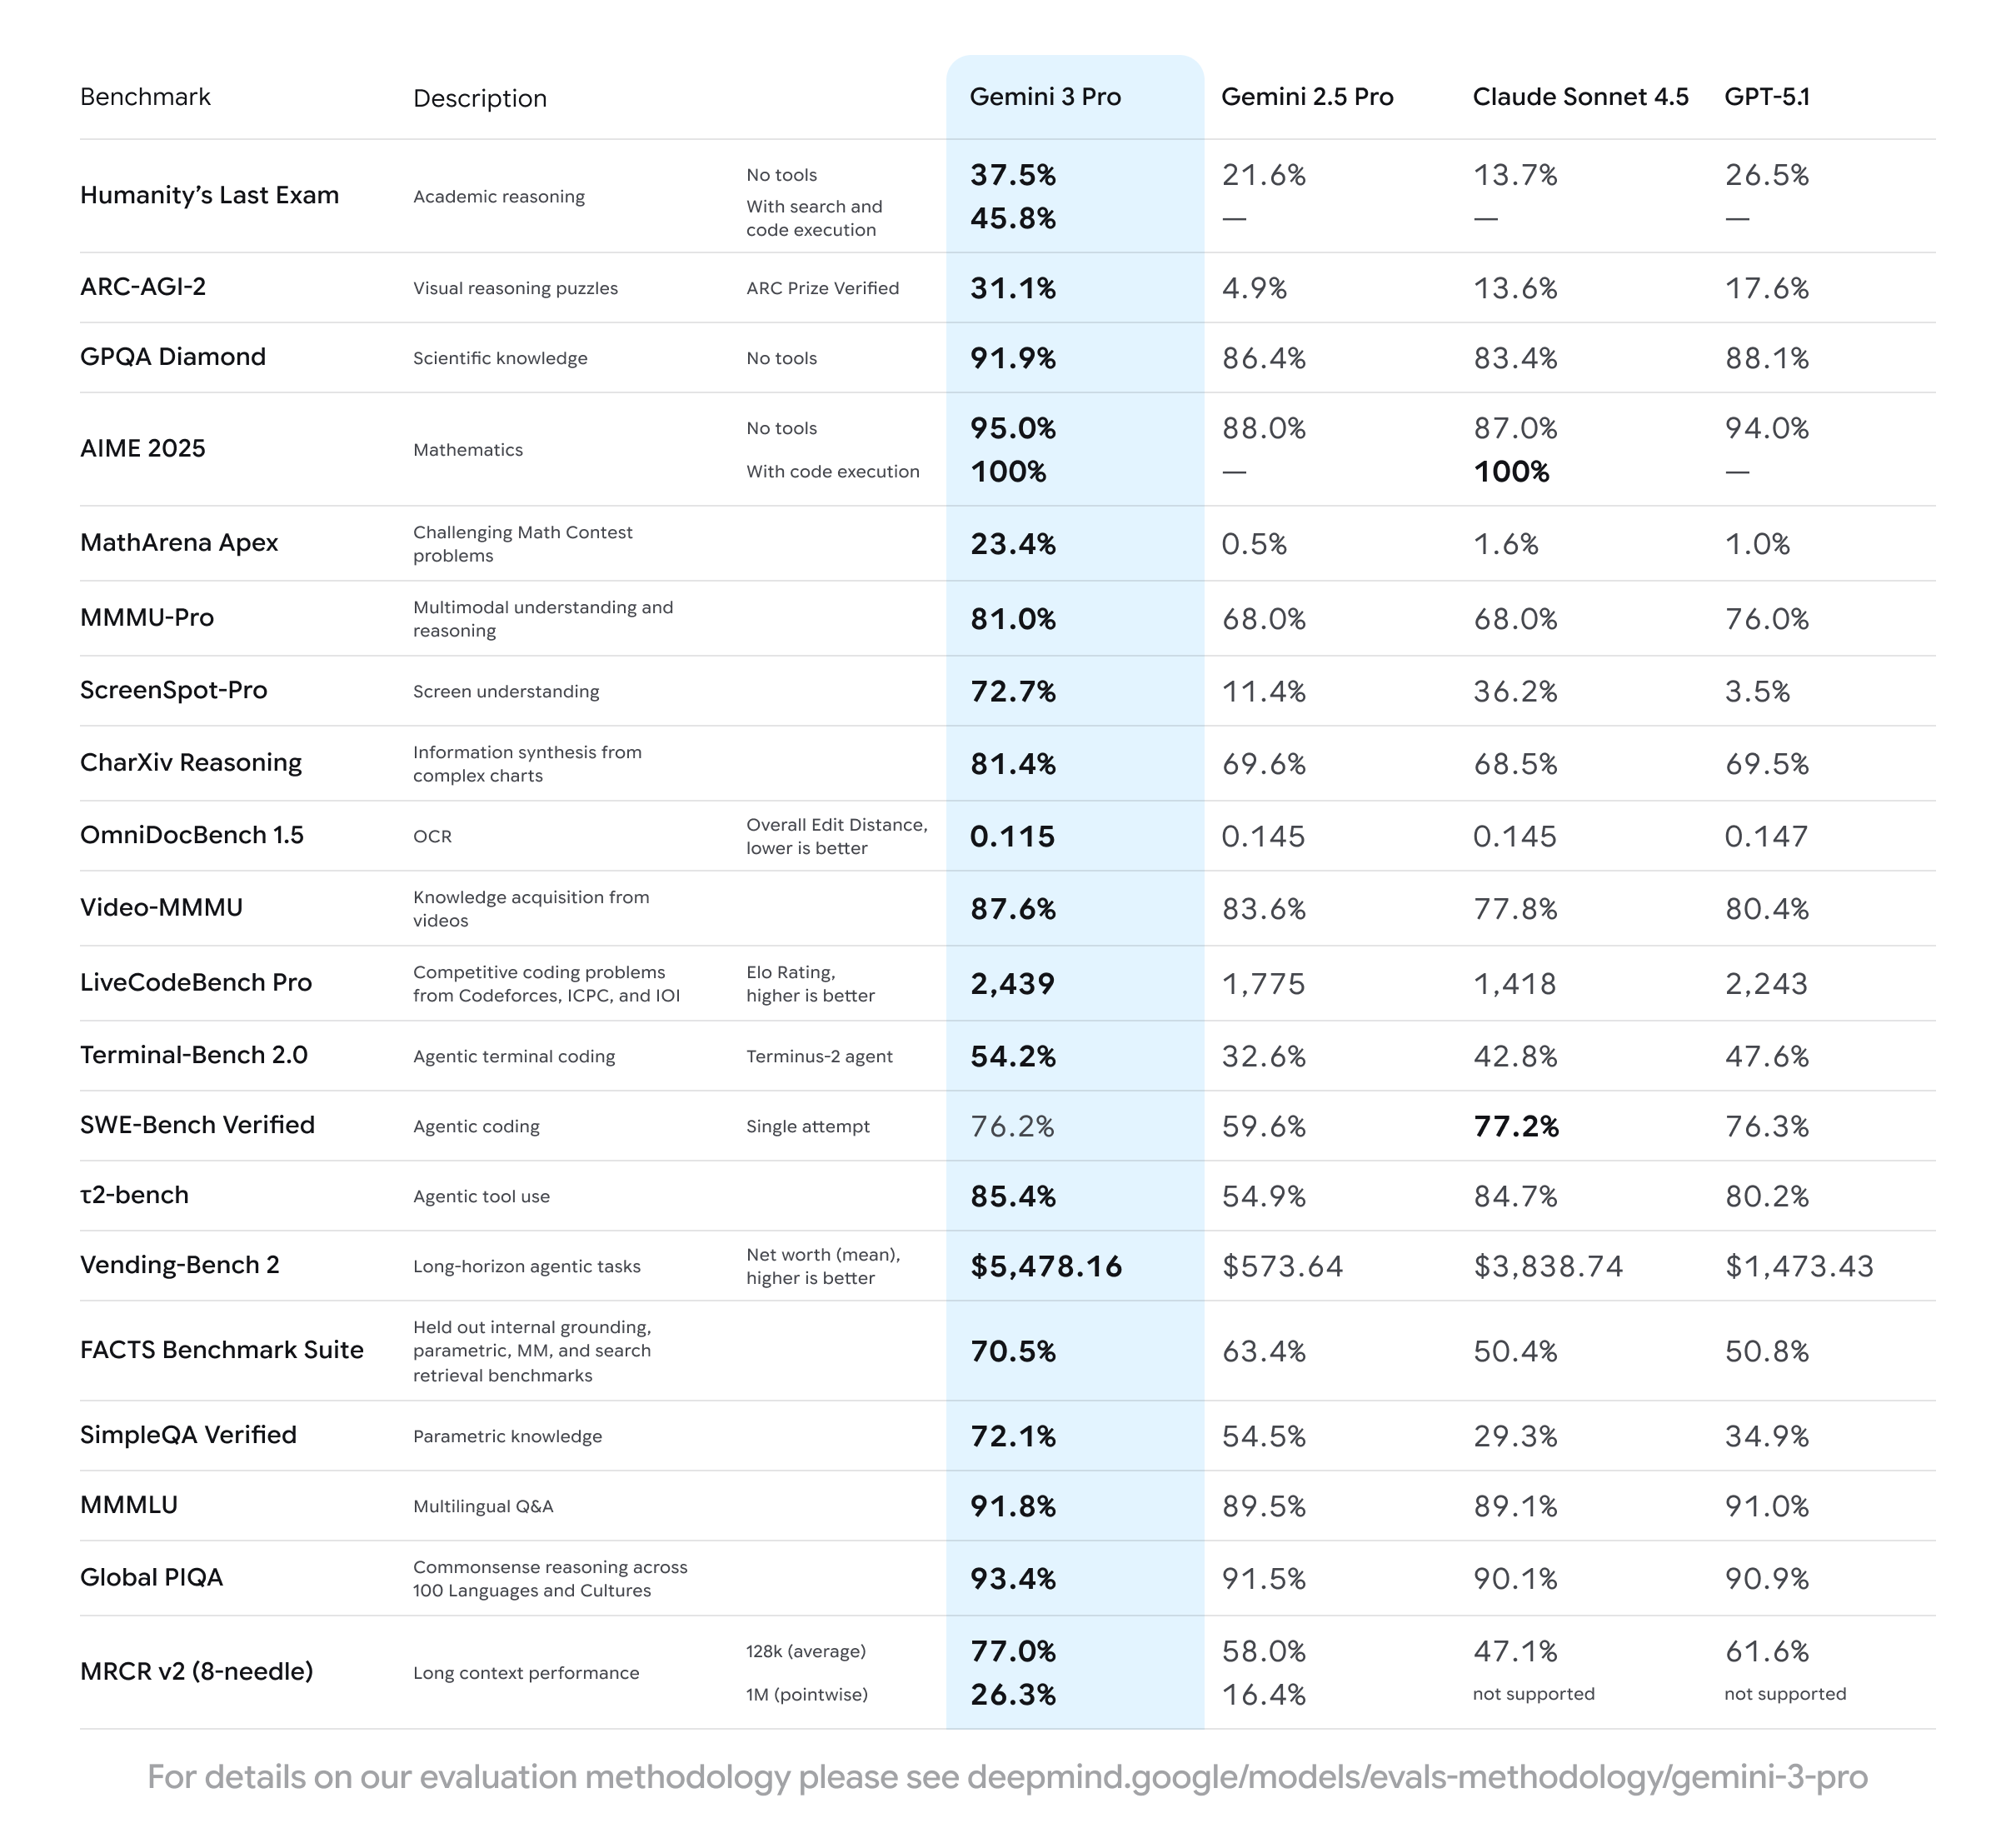
この記事では、このデータセットの統計的な性質を説明し、この支配的な次元を除いたあとに何が残るか(ヒント:「Claudeらしさ」である)を調べ、それがタスク間の汎化についての重要な問いとどう関わるかを論じる。
Epoch AI の最新情報を受け取る 購読する
ベンチマークのデータは、根底にある単一の次元に支配されている
これは、39のベンチマークを単一の能力スコアにまとめるEpoch能力指数(ECI)についての最近の研究から得られた教訓の一つである。もしベンチマーク同士がおおむね無相関なら、大きな残差が見られるはずだ。つまり、モデルのECIの数値から予測されるベンチマークのスコアが、そのモデルの実際のスコアと一致しないはずである。ところが実際には、非常によく一致する。言い換えれば、名目上は高次元の私たちのデータセットが、たった一つの次元でよく近似できるのだ。

この次元の先を見るには、主成分分析(PCA)を行えばよい。これは要するに次のように問う。さまざまなベンチマークのスコアの重み付き和をとって合成の「成分」を作るとしたら、できるだけ少ない成分で、データセットの分散をどれだけ多く説明できるか。
ECIの基になっている生データでこれを行うと、第1成分がデータセットの分散の約半分をとらえる。1, 2下の表は、この成分での各ベンチマークの重みのうち、重みの合計の80%を占めるものを示している。重みがすべて正で、あまりばらついていないことに注目してほしい。つまり、PCAでも単一の「汎用能力」の成分が見つかるのである。
| ベンチマーク | 第1主成分の重み |
|---|---|
| GPQA diamond | 0.30 |
| Aider polyglot | 0.29 |
| OTIS Mock AIME 2024-2025 | 0.28 |
| LiveBench | 0.27 |
| SimpleBench | 0.27 |
| Balrog | 0.27 |
| WeirdML | 0.26 |
| FrontierMath Tiers 1–3 | 0.25 |
| CadEval | 0.24 |
| SWE-bench Verified | 0.23 |
| GSO-Bench | 0.22 |
| FrontierMath Tier 4 | 0.19 |
第1主成分の先に進もう。下のグラフは、すべての主成分の大きさを、同じ形のランダムに生成したデータで見つかる成分の大きさと比べて示したものである(つまり平行分析)。上で述べた大きな成分が一つあり、有意かどうかぎりぎりの第2成分があり、残りはノイズと矛盾しない小さな大きさである。

ベンチマークのデータには、より小さな「Claudeらしさ」の次元がある
この第2成分は何なのか。この成分が各ベンチマークに割り当てる重みのうち、絶対値の大きいものを示す。これも重みの合計の80%超を占める。この成分は、作り方からして、主要な「汎用能力」の成分と直交している。初めてこれを見たとき、私は「エージェント的なタスクは得意だが、視覚は苦手……それに数学も苦手?」といった感じに見えると言った。
| ベンチマーク | 第2主成分の重み |
|---|---|
| The Agent Company | 0.42 |
| OSUniverse | 0.37 |
| VideoMME | -0.35 |
| OSWorld | 0.35 |
| Factorio Learning Environment | 0.33 |
| VPCT | -0.28 |
| FrontierMath Tier 4 | -0.26 |
ところが同僚に見せると、彼はただ「これは Claude だね」と言った。彼の言うとおりだった。この成分で上位の5モデルと下位の5モデルを示す。
| 最もClaudeらしい | 最もClaudeらしくない |
|---|---|
| Claude Sonnet 3.5 (Oct ‘24) | GPT-5 |
| Claude Sonnet 3.5 (Jun ‘24) | GPT-4o-mini |
| Claude Sonnet 3.7 | GPT-4o (Nov ‘24) |
| Claude Sonnet 4 | GPT-4o (Aug ‘24) |
| Claude Opus 4 | o4-mini |
この第2成分は、ベンチマークが完全に「汎用能力」と「ノイズ」の和だけでできているわけではないことを示していると思う。それがかなり良い近似だとしてもである。この第2成分は統計的にはそれほど有意ではないが、Anthropic の優先事項について世間が一般に抱いている印象と一致していると言ってよいだろう。つまり、Anthropic は意図的に Claude をこのように作っているようだ。次に説明するように、このことで、より大きな問いについての私の考えが少し変わった。
「汎用能力」の次元は根源的なものか、偶発的なものか?
大きな問いは、なぜ単一の次元がベンチマークのスコアの分散をこれほど多くとらえるのか、である。考えられる理由は二つあり、それぞれ私たちがいるかもしれない二つの世界に対応する。これらの世界を「根源的」な世界と「偶発的」な世界と呼ぼう。
「根源的」な世界では、表面上は無関係なタスクでモデルがどれだけうまくやれるかを左右する、根底にある単一の能力がある。この世界でモデル開発者にできるのは、この能力を高めることだけだ。それに成功すれば、モデルはあらゆることが得意になる。
「偶発的」な世界では、モデルがもちうる互いに直交した能力がたくさんある。直交しているというのは、各能力でモデルを向上させるのに、モデル開発者がまったく無関係な作業をしなければならないという意味である。それでも、私が想定している世界では、顧客が多くの能力をもつモデルを求めるので、開発者はそれを実現するための作業をする。
私たちの世界はどちらにより近いのだろうか。AIの歴史のなかでは、偶発的な世界のように見えた時期もある。AlphaGo は囲碁では人間を超えていたが、ほかのことをさせようとするのはナンセンスだった。根源的な世界のように見えた時期もある。LLMが勢いを増していた頃、比較的選別されていないWebテキストでの次トークン予測が、それまで専用モデルが支配していた自然言語処理のタスクを次々と制していった。3
一次近似では、ベンチマークのスコアはどちらの世界でも同じように見える。だが、Claudeらしさの次元が存在することは、「偶発的」な世界を支持する小さな証拠のように私には感じられる。Anthropic は、エージェント的なコーディングで最高水準のモデルを作ることに注力してきた。追加で集中的に投資しなければ、モデルは高度な数学では際立った成績を出さないことが分かる。タスク間の汎化はきっといくらかあるが、これはその限界の表れなのかもしれない。
1兆ドルの問い
Claudeらしさの次元は、偶発的な見方を支持するそれほど強い証拠ではない。より強い証拠になりうるのは、モデル開発者が、業界別の強化学習(RL)環境のような専門的なデータの収集に多額の投資をしていることだろう。それでも、開発者がそうしているうえに、RLがタスク間でとてもよく汎化する、ということもありうる。
これを検証する方法の一つは、何か変わったものを測る、汚染されていないベンチマークを見つけ、それが「汎用能力」の次元と相関するかを調べることだろう。残念ながら、モデルが学習で何を見たかが分からないので、モデルにとって何が「変わった」ものに当たるのかも分からない。また、トップクラスのモデルの成績が悪いことを示すベンチマークほど注目を集めやすいという選択効果もあるのではないかと思う。それでも、これは追求する価値がありそうだ。
ベンチマークのデータに見られることの説明が、モデル開発者が「すべてを一度に」という戦略をとっていることだとしても、彼らにはそれを続けるのに必要な資源とスケーラブルなアーキテクチャがある。言い換えれば、適切な学習データと、それを活用するのに十分な計算資源を得られる限り、すべてのベンチマークを押し上げ続けられるのだ。
これは将来にとって何を意味するのか。Steve Newman が最近うまく言い表していた。「途方もない数のものを単に分布内に入れることで、どこまで行けるか」は、1兆ドル規模の問いの一つである。
あらゆるものを分布内に入れることに原理的な限界があるとは思わない。だが、私たちが偶発的な世界により近いのなら、汎化による追い風もあまり期待すべきではない。あらゆるベンチマークでの1パーセントポイントごとの向上に、代価を払わなければならないのだ。私の考えでは、能力はかなり全般的に向上し続けると予想すべきだ。ただしそれは、成長と投資の好循環が続き、開発者がそれを積極的に実現するために資源を注ぎ込める限りでの話である。