
ニュースレター
10分のタスクをこなすAGIはどこにあるのか?
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
最近、METRが論文を発表し、AIがこなせるタスクの長さは7か月ごとに倍増していると論じた。
次のグラフにそれが表れている。最も優れたAIシステム1は、およそ1時間かかるタスクを平均50%の成功率でこなせる。
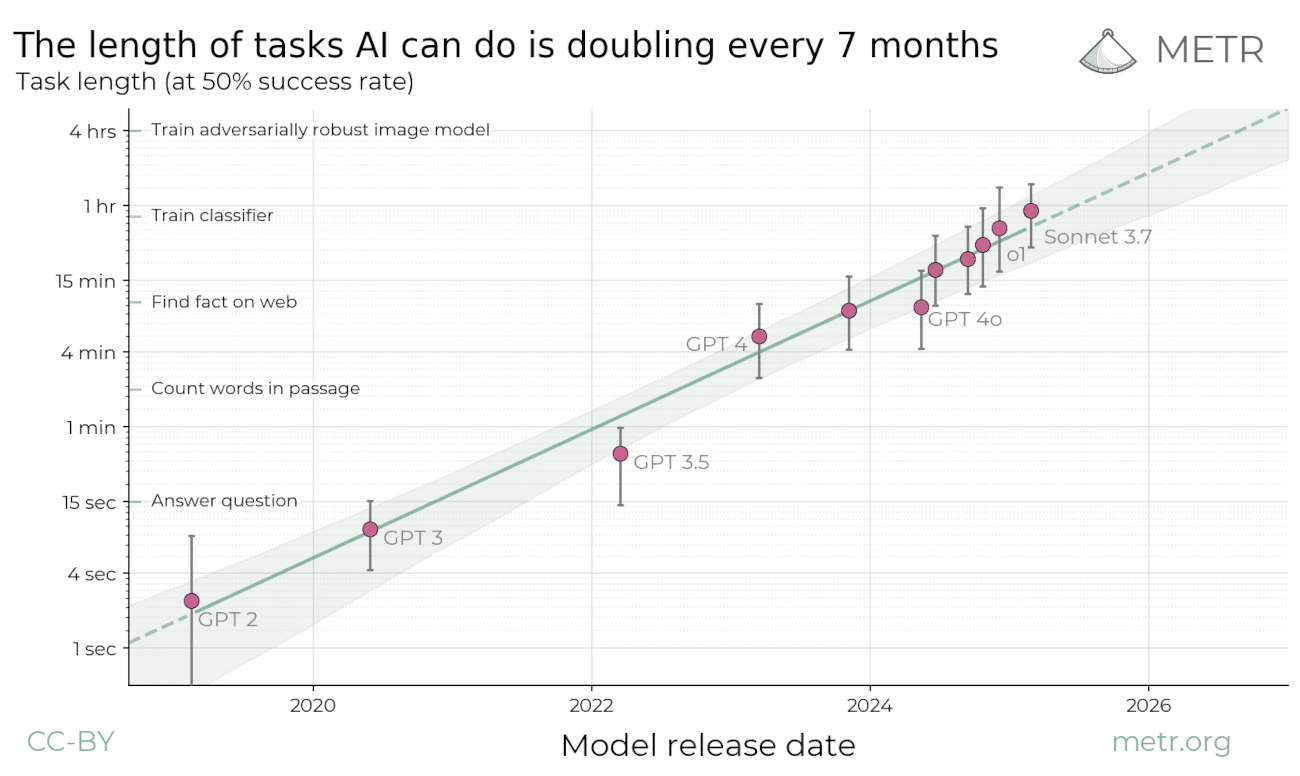
METRの研究によれば、AIはますます長いタスクを急速にこなせるようになっている。ここでのタスクの長さは、必要な専門知識をもつ人間がそのタスクをこなすのにかかる時間で測っている。
だが、ここには大きな問題がある。AIが実際に、1時間のタイムホライズンでほとんどのタスクをこなせるのなら、なぜ現実世界のタスクの自動化がもっと進んでいないのだろうか。たとえば、たいていのメールは書くのに1時間もかからない。それなのに、メールを書くことは今も毎日、何十億もの人々の生活の重要な一部であり続けている。
その一部は、人々がAIシステムを十分に使っていないせいかもしれない。2 だがこの記事では、AIシステムの能力に関わる、より根本的な理由を取り上げたい。具体的には、そうした理由のうち最も重要なのは次の三つだと私は考えている。
- タイムホライズンの推定値は、分野にきわめて大きく依存する
- タスクの信頼性は、タイムホライズンに強く影響する
- タスクは互いに強く結びついていて、切り離すのが難しい
それぞれの理由がどれほど重要かを定量的に示すのは難しいが、どれも、1時間や10分のタイムホライズンのタスクでさえ多くが自動化されないままである理由を説明できるほど強力である。
Epoch AI の最新情報を受け取る 購読する
1. タイムホライズンの推定値は、分野にきわめて大きく依存する
おそらく最も重要な理由は、こうしたタイムホライズンの推定値が分野にきわめて大きく依存しており、それがより広いタスクの自動化にどこまで一般化できるのかがまったくはっきりしないことである。
具体的には、タイムホライズンの推定値は三つのタスク群(HCAST、RE-Bench、SWAA Suite)に基づいており、どれもソフトウェアとの関わりが強い。しかし、とくにほかの分野に目を向ければ、タイムホライズンがはるかに短い(あるいは長い)例を見つけるのは難しくない。
たとえばTamay Besirogluは、対象のタスク分野にチェスを選んでいたら、同様の分析によって、1990年代初めのAIシステムは数時間から数日のタイムホライズンで動けると予測されていただろうと指摘している。3
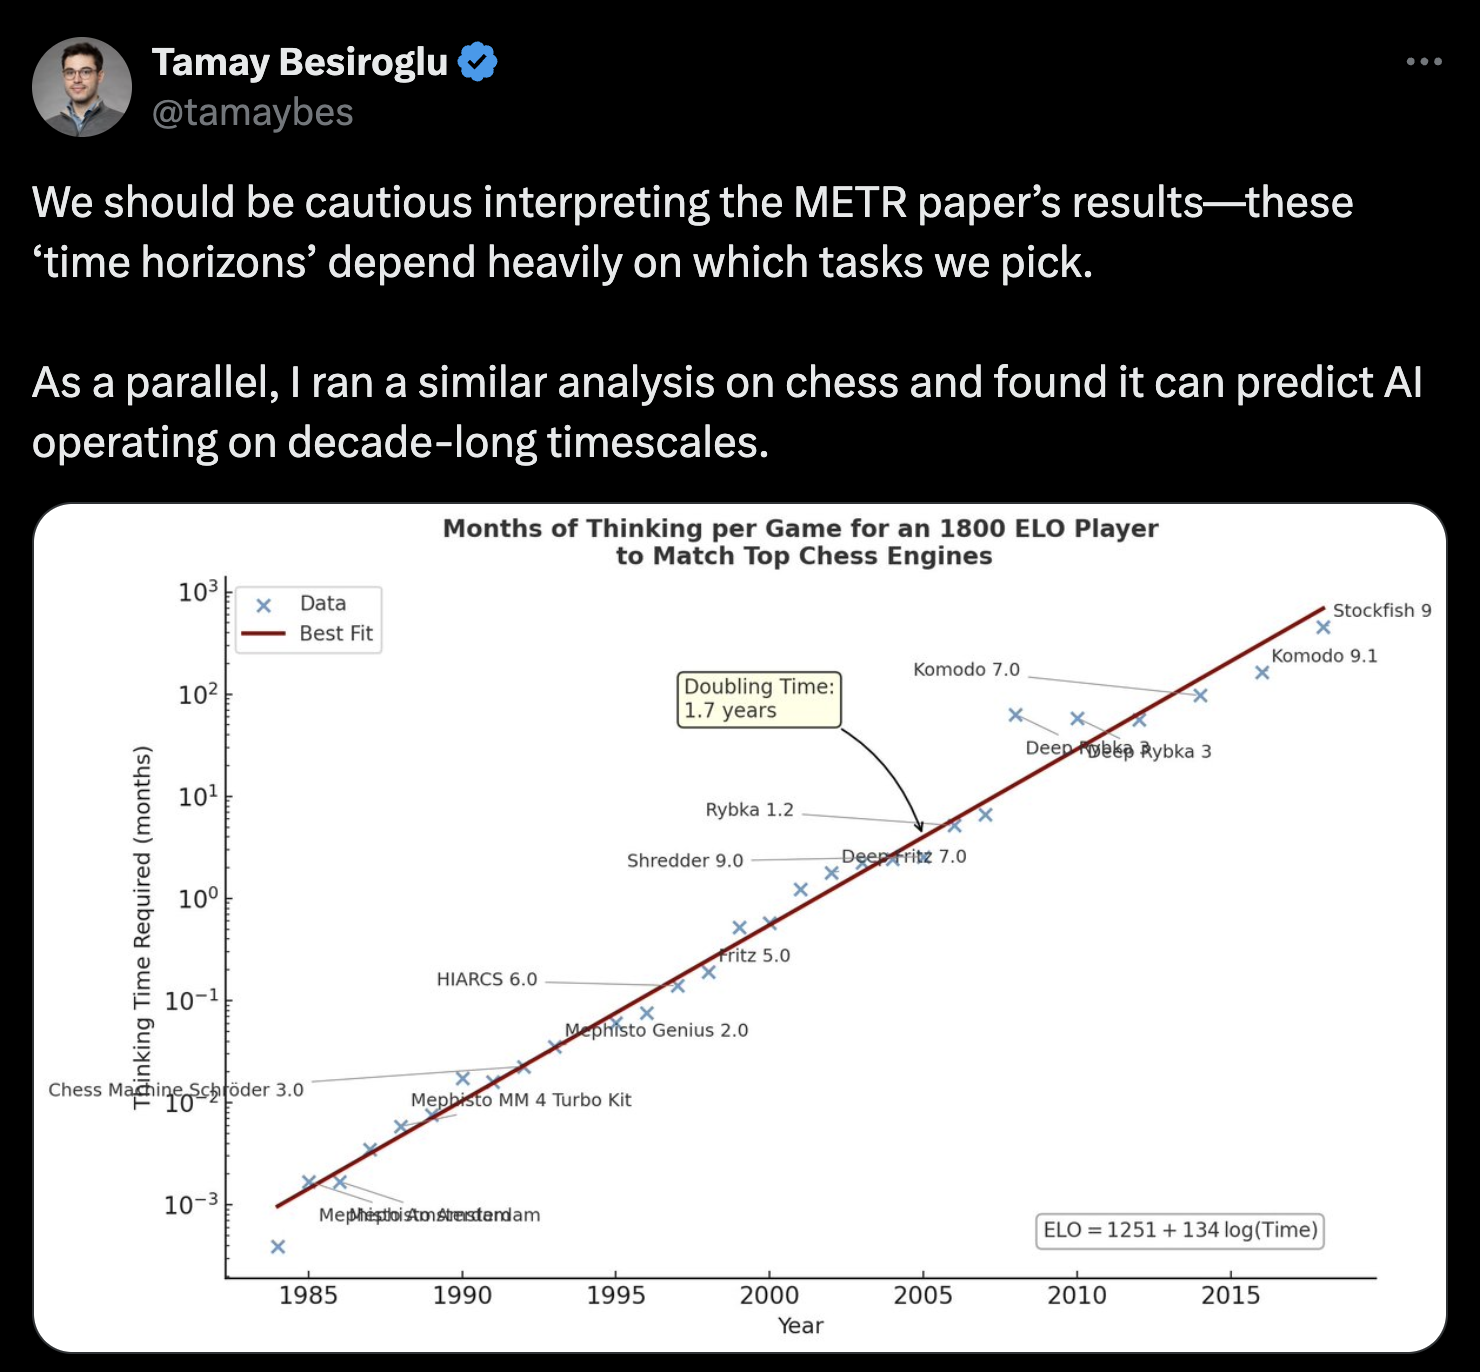
タイムホライズンの推定値は、測定に使うタスクに大きく左右される。たとえば対象のタスクにチェスを使うと、1990年代のAIシステムのタイムホライズンについて、ばかげた予測が導かれてしまう。現代のシステムについては数十年規模の時間尺度が予測されるが、これはおそらく誤りである。ただし、そこまでの長い時間をかけた場合に人間がチェスでどれほどの成績を出すかについて、経験的な証拠はない。
そして、自動化の影響を正確に予測するうえで、この分野への依存がどれほど決定的かを過小評価すべきではない。たとえば、リモートワークのタスクは、ある尺度では米国経済のタスクのおよそ35%を占めることがわかっており、とくにソフトウェアに関わるものに限ればその割合はさらに小さい。このことだけでも、タイムホライズンの推定値が経済の大半のタスクを代表していないかもしれないことを意味する。
同様の問題は、ソフトウェア関連のタスクの内部にさえ残る。たとえばOSWorldベンチマークは単純なコンピュータ操作のタスクで構成されているが、人間が中央値約112秒で約73%のスコアを出すのに対し、現在の最高水準のシステムのスコアは40%を少し超える程度である。4 逆方向の例もある。AIシステムは今や、たいていの人間なら読むのに何日もかかる長い文章から、すばやく情報を取り出せる。5
要するに、タスクによって、推定されるタイムホライズンは何桁も変わりうるのだ! したがって、タイムホライズンが1時間よりかなり短いのにまだ自動化されていない現実世界のタスクがあっても、それほど驚くには当たらない。
2. タスクの信頼性は、タイムホライズンに強く影響する
もう一つの問題は信頼性である。METRのグラフの但し書きを読むと、今日の最も優れたAIシステムは、(ソフトウェア関連の)1時間程度のタスクを平均50%の成功率でこなせる、ということになる。では、成功率の基準を変えるとどうなるだろうか。
それを確かめるには、この論文の方法論をもっと詳しく見る必要がある。著者らは各AIモデルについて、あるタスクでのモデルの成功率と、人間がそのタスクを終えるのにかかる時間とを結びつけるシグモイド型の関係を当てはめる。そのうえで特定の成功率(つまり50%)を選び、現在の最先端モデルについて、それに対応する約1時間というタイムホライズンを得ている。
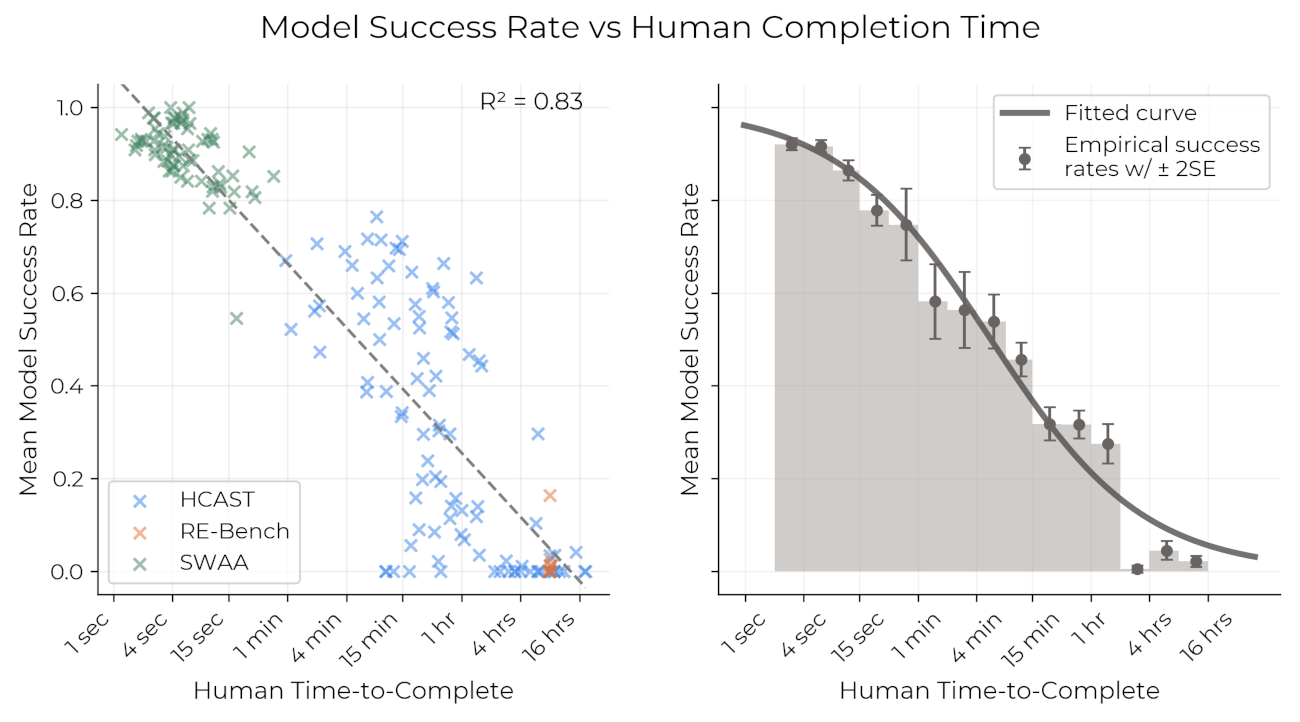
タイムホライズンは、人間がタスクを終えるのにかかった時間とモデルの成功率のデータを集め、曲線を当てはめて推定した。これは、すべてのタスクにわたる人間の所要時間の最小値を表すものではない。
著者らは80%の信頼性も検討し、その場合はタイムホライズンが1時間から約15分に下がることを見いだしている。だが、おそらくさらに先まで考えたほうがよい。現実世界のタスクではしばしば95%以上の成功率が求められ、そうなるとタイムホライズンはさらに短くなる(典型的な例は自動運転車だが、全体として、一般に「適切な」正確さがどれくらいであるべきかは私にははっきりしないので、この議論の説得力はいくらか弱まる)。たとえば、シグモイド型のモデルを素朴に外挿すると、99%の成功率は1分未満のタイムホライズンに相当する。6
とはいえ著者らは、そうした極端な成功率でのタイムホライズンの推定は、その正確さの水準で質の高いデータが足りないため、信頼できないと注記している。さらに、AIシステムの成功率だけを見るのではなく、人間の成功率とも比べなければならない、という反論もありうる! これには確かに一理ある。論文の付録B.1.1によれば、人間の成功確率も、長いタスクではかなり下がる。たとえば、比較基準となった人間の参加者のあいだでは、4秒のタスクの成功率は約100%だが、1時間のタスクでは約50%である。
しかし同じ付録には、こうした反論を退ける重要な理由も挙げられている。最も重要なのは、人間の失敗のかなりの部分が、専門知識の不足や、中断や退屈によってタスクを放棄したことなど、AIモデルには当てはまらない理由によるものだったらしいことである。これは一つには、比較基準となった人間の参加者への報酬の払い方のせいだったとみられる。その払い方では、期待収入がより高いタスクに移るために、すばやく当て推量で答えたり、早めに諦めたりする誘因が働いていた。
すべてを考え合わせると、ここでの私の議論が成り立つだけの十分に強い証拠があると思う。つまり、タスクの信頼性は対応するタイムホライズンに強く影響し、その影響は1時間のタイムホライズンを10分の1未満に縮めるほど大きい。
3. 現実世界のタスクは互いに結びついていて、切り離すのが難しい
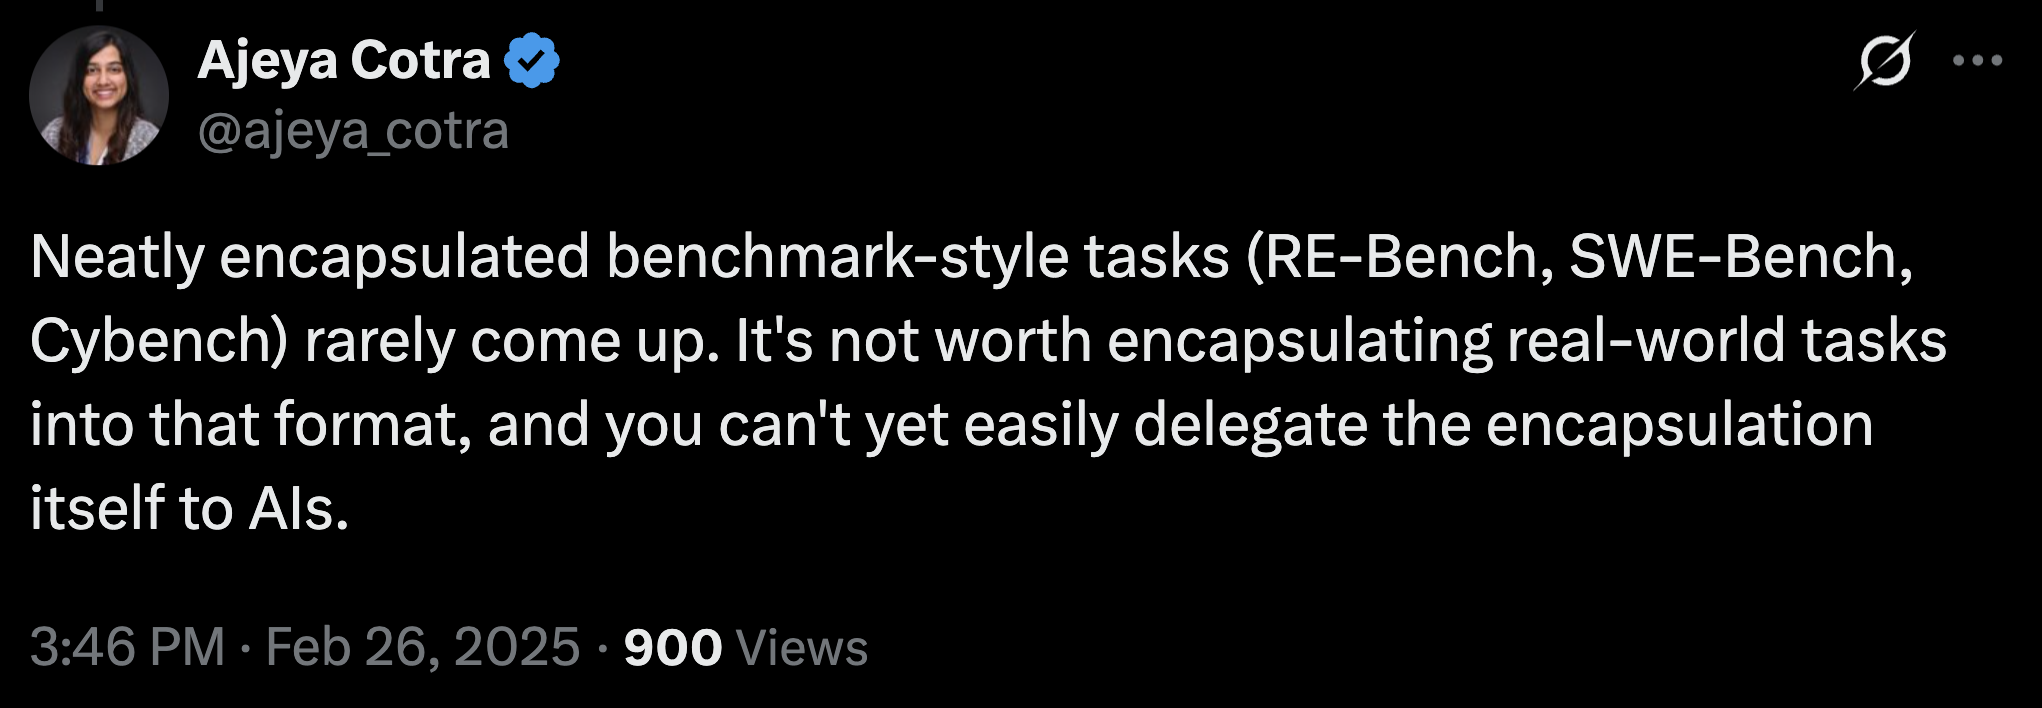
METRの論文で検討されたタスクは、タスクの種類に偏っているだけでなく、答えが決まっていて、追加の文脈を必要としないものが多い。だがそれは、ソフトウェアの範囲に限ったとしても、現実世界のタスクの性質とは大きく異なる。7
Ajeya Cotraは、AI研究者へのインタビューに基づいて、この問題を実に簡潔に言い表している。
これがタスクの自動化にとってなぜそれほど重要なのかを見るために、メールの例に戻ろう。なぜメールはまだ完全に自動化されていないのか。現在のLLMは、もっともらしいメールを書く能力を十分にもっているように見えるし、最も筆の速い人間よりもはるかに速く書ける。
では、何が問題なのか。メールを書くことに何がともなうのかを具体的に考えると、答えはずっとはっきりする。そこで説明のために、私がこの1年に受け取ったメールの一部と、それらのメールへの対応が自動化されなかったと私が考える理由を挙げてみよう。
| 受け取ったメールの種類 | 自動化のボトルネック |
|---|---|
| 仕事の誘いについてのメール+それについての打ち合わせ |
|
| あるプロジェクトについての以前の会話のフォローアップ |
|
| 成果物へのフィードバックの依頼 |
|
| Epochのような仕事に関心のある人への助言 |
|
これらの例に共通するパターンは、(1)AIが何らかのデータや文脈を欠いていること、(2)私の好みについての文脈を欠いていること、であるように思える。そのうえ、AIシステムは、たとえ必要なデータや文脈をもっていても、タスクをうまく実行できないかもしれない。ただ、この追加の複雑さを考えなくても、議論は成り立つと思う。
だが、本当にメールを完全に自動化したいとしたら、何が必要になるだろうか。簡単に解決できることもある(AIシステムに私の予定へのアクセスを許可する、など)が、ほかのことはずっと複雑で、厄介な問題を次々と引き起こす。対面での会話を日常的に記録するために多くのインフラを整える必要があるかもしれず、同時に、セキュリティやプライバシーの数多くの潜在的な問題や、社会規範の変化(たとえば、人々の日常生活の多くが記録されることをめぐって)にも対処しなければならない。AIはまた、利用者のコミュニケーションの流儀の好みや、どんな機会に関心があるかなどについて、十分な文脈をもつ必要もある。
これは孤立した例ではない。こうした文脈への依存は、経済のいたるところにある。歴史的に、タスクの自動化に業務の流れの大幅な再編が必要だった重要な理由の一つはこれである。
考察
私の考えでは、ここまで述べたことはすべて、AIのベンチマークをめぐるより大きな問題の一部にすぎない。つまり、AIのベンチマークはなぜ現実世界のタスクの自動化を反映しないのか、という問題である。私は以前、これまでなぜそうだったのかについて書いたが、今回は、現在と将来にも当てはまる三つの根本的な理由を論じた。
こうした理由から、METRの論文を「人間が1時間でできるタスクのほとんどをAIはこなせる」と言っているものとして解釈すべきではないと私は考える。METRの研究者たちもこの主張を信じてはいないだろうが、残念ながらTwitterではそのように解釈している人を見かけた。とはいえ、ソフトウェア関連のベンチマークでふつう扱われる種類のタスクについて、METRが指数関数的な向上の証拠を見つけたことは確かだと思う。先にほのめかしたように、重視すべきは7か月という倍増期間のほうであり、AIが現在こなせるタスクのタイムホライズンではない。
将来のAIの能力の予測について語るときには、上で述べたベンチマークの限界と、現実世界のタスクでのAIの現在のタイムホライズンを理解しておくことが重要である。たとえば、タスクのタイムホライズンが伸びていくと考えるアプローチは、最近のAI 2027レポートで示された「タイムホライズンの延長」による到来時期(タイムライン)の予測の土台になっている。8 こうした限界は、一部の研究者がAI 2027の著者らより到来時期をかなり遅く見積もっている理由の一端を説明する。だが、すべてを説明するわけではない。もう一つの決定的な要因は、AIの研究開発の進歩が実験用の計算資源によってどこまでボトルネックを受けるかである(ただし、それはまた別の記事のテーマである)。
この理解は、タスクの自動化そのものを考えるうえでも重要である。たとえば、より大きなタスクは原理的にはタイムホライズンの短いサブタスクに分割できるので、1秒のタスクをすべて自動化できれば経済全体を自動化できる、と素朴に論じる人もいるかもしれない。もちろんこれはばかげているように思える。こうしたタスクの分解は、文脈への依存と、どの部分が成果に寄与したかを割り当てる難しさを大量にもたらすからである。
だが、このことは興味深い経験的な問いを投げかける。さまざまなタスクはどれほど文脈に依存しているのか、そしてそれはタイムホライズンによってどう変わるのか。より一般的には、AIシステムに必要なデータや文脈へのアクセスをもたせるのはどれほど難しいのか。人々はどれくらいの頻度で、AIシステムを使って「1分のタスク」「10分のタスク」などをこなしているのか。9
こうした問いへの答えが、この記事で概説したボトルネックの重要性を明らかにしてくれることを願っている。そのためには、手に入れにくいかもしれない良質な経験的証拠が必要になる。だがそれは、ベンチマークでのタイムホライズンと現実世界のタスクの自動化のあいだのギャップを、よりよく理解する助けにもなるだろう。
注
-
ここでは最も優れたAIシステムとしてClaude 3.7 Sonnetを示しているが、より最近の評価では、OpenAIのo3がトレンドを上回っている可能性があることがわかっている。o3のタイムホライズンも、おおむね1〜2時間である。 ↩
-
たとえば、AIシステムの能力について、人間の見積もりが大きくずれていることが原因かもしれない。わかりやすい例として、Nicholas CarliniのGPT-4の能力予測チャレンジの結果がある。そこでは、参加者の中央値の成績は、「どのタスクも成功確率50%と当て推量する」戦略より悪かったようだ。ただ、調査データから得られる(弱い)証拠に照らすと、これが本当に主な要因なのかどうか、私には確信がない。たとえばLockey et al. 2025では、仕事で意図的にAIを使ったことが一度もないと答えた回答者27%のうち、過半数(58%)が、その理由を「AIツールは自分の仕事に役立たない、必要とされない、または使われていない」からだとした。これに対し、「AIツールの使い方がわからない」「AIツールを信頼していない」といった理由を挙げたのは、それぞれ14%と12%だった。 ↩
-
今から振り返れば、チェスからほかの分野へタイムホライズンを一般化するのはばかげているように見えるかもしれないが、一部の研究者は、チェスを解くことはAGIの構築に大いに関係があり、したがって最適化の目標とするのに適した代理指標だと考えていた。少なくとも、答えの決まったソフトウェア関連のタスクを重視することが、同じ現象の一例になっていないかという疑問は生じる。なお、Tamayのツイートの分析は、チェスのELOレーティングとタイムホライズンのあいだの推測的な関係に基づいているが、より大きな論点は成り立つと私は考えている。 ↩
-
執筆時点で、OS-worldのリーダーボードの首位は、スコア42.5%のUI-TARS-1.5である。なお、この例は、ベンチマークのタスクへの依存が大きいことを示すためのものにすぎない。OS-worldは年末までにほぼ飽和する(85%超)と私たちは予想している。 ↩
-
たとえばGemini 2.5 Proは、MRCRという長い文脈のベンチマークで83.1%のスコアを出している。このベンチマークでは、合成的に生成された会話にわたって文脈を保つことが求められ、その会話は原理的にはいくらでも長くできる。 ↩
-
50%から80%に上げると、オッズは4倍になり、タイムホライズンは4分の1になる。99%の正確さを達成するには、タイムホライズンが1時間からおよそ100分の1に下がるはずである。シグモイド型のモデルが正しければ、タイムホライズンは1分未満になる。 ↩
-
METRの論文の著者らは、もちろんこうした問題を十分に認識しており、それに対処しようとした方法の一つが、タスクの「雑然さ(messiness)」の指標を定めることだった。これは、現実世界のタスクをベンチマークのタスクと系統的に異なるものにしうる、AIの成績に関係する16の要因(たとえば「純粋な自動採点ではない」「動的な環境」)を特定するものである。雑然さの総合スコアは、そうした要因のうちいくつが当てはまるかを合計して決める。 ↩
-
これは具体的には、幅広いタスクの自動化ではなく、「超人的なコーダー」、つまり「AGI企業で最も優秀なエンジニアがこなすどんなコーディングタスクもこなせ、しかもはるかに速く安いAIシステム」に到達するまでの時期の予測である。 ↩