
ニュースレター
AI研究開発のためのO*NETに向けて
Gradient Updates は著者個人の見解を述べるニュースレターで、Epoch AI 全体の見解とは限りません。
専門家がAIの到来時期(タイムライン)を予測するよくある方法は、信じがたいほど単純である。トレンドの外挿だ。もちろん、暴走するフィードバックループのような要素を組み込んだ数値モデルも使われる。しかしAI予測の基本は、グラフに線を引き、思い切れるところまで延ばすことである。どういうわけか、これが最高水準の手法と言えるほどうまく機能している。ただし、外挿されるトレンドには共通の弱点がある。測りやすいものに大きく頼っていて、私たちが直接知りたいこと、つまりAIがAI研究そのものをこなせるところまでどれだけ近づいているかを測っていないのである。
多くの専門家は、AI研究が完全に自動化されるのはいつかを知りたがっている。そうなればAIの進歩は大幅に加速し、「知能爆発」が始まるからである。1それが正しいなら、私たちがそこにどれだけ近づいているかを知ることはきわめて重要だ。しかしこれまでは、AIの研究開発(R&D)の完全な自動化を測るのがあまりに難しかったため、直接の証拠として示せるものはあまりなかった。代わりに研究者は、代理指標に頼らざるをえなかった。
そうした代理指標の一つが、計算資源、データ、エネルギーといったAIの主要な投入要素である。Situational Awarenessを例にとると、AI研究が自動化されるところまで、「実効計算量」の伸びを5年先まで延ばしている。
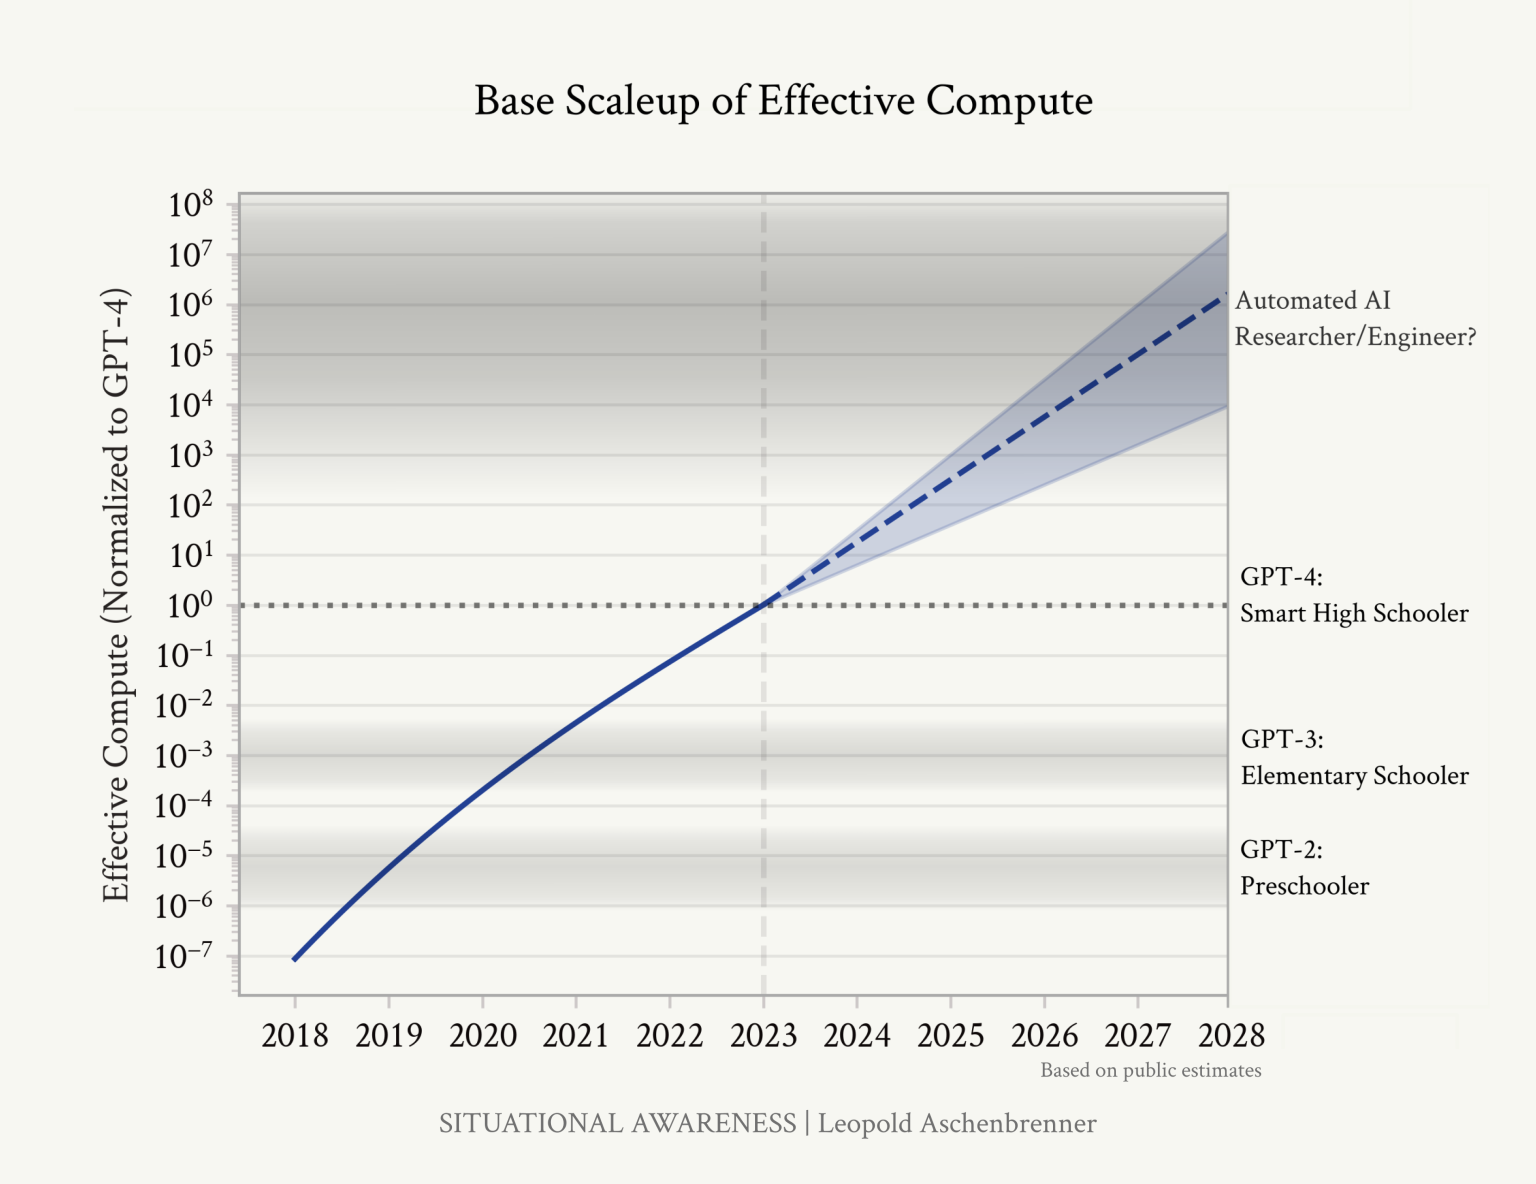
しかし、こうした投入要素は能力の大まかな代理指標にすぎず、世界トップのAI研究者に匹敵するにはどれだけの計算資源が必要なのかは、「雰囲気」で言うしかない。
二つ目の手法は、AIがこなせるタスクの長さを追跡するものである。ここで「長さ」とは、熟練した人間がかかる時間を指す。METRが「タイムホライズン」という指標で行ったのがこれである。この指標は有名なシナリオ AI 2027 で外挿され、AIがAIの研究開発を自動化する前段階として「超人的なコーダー」になる時期の予測に使われた。
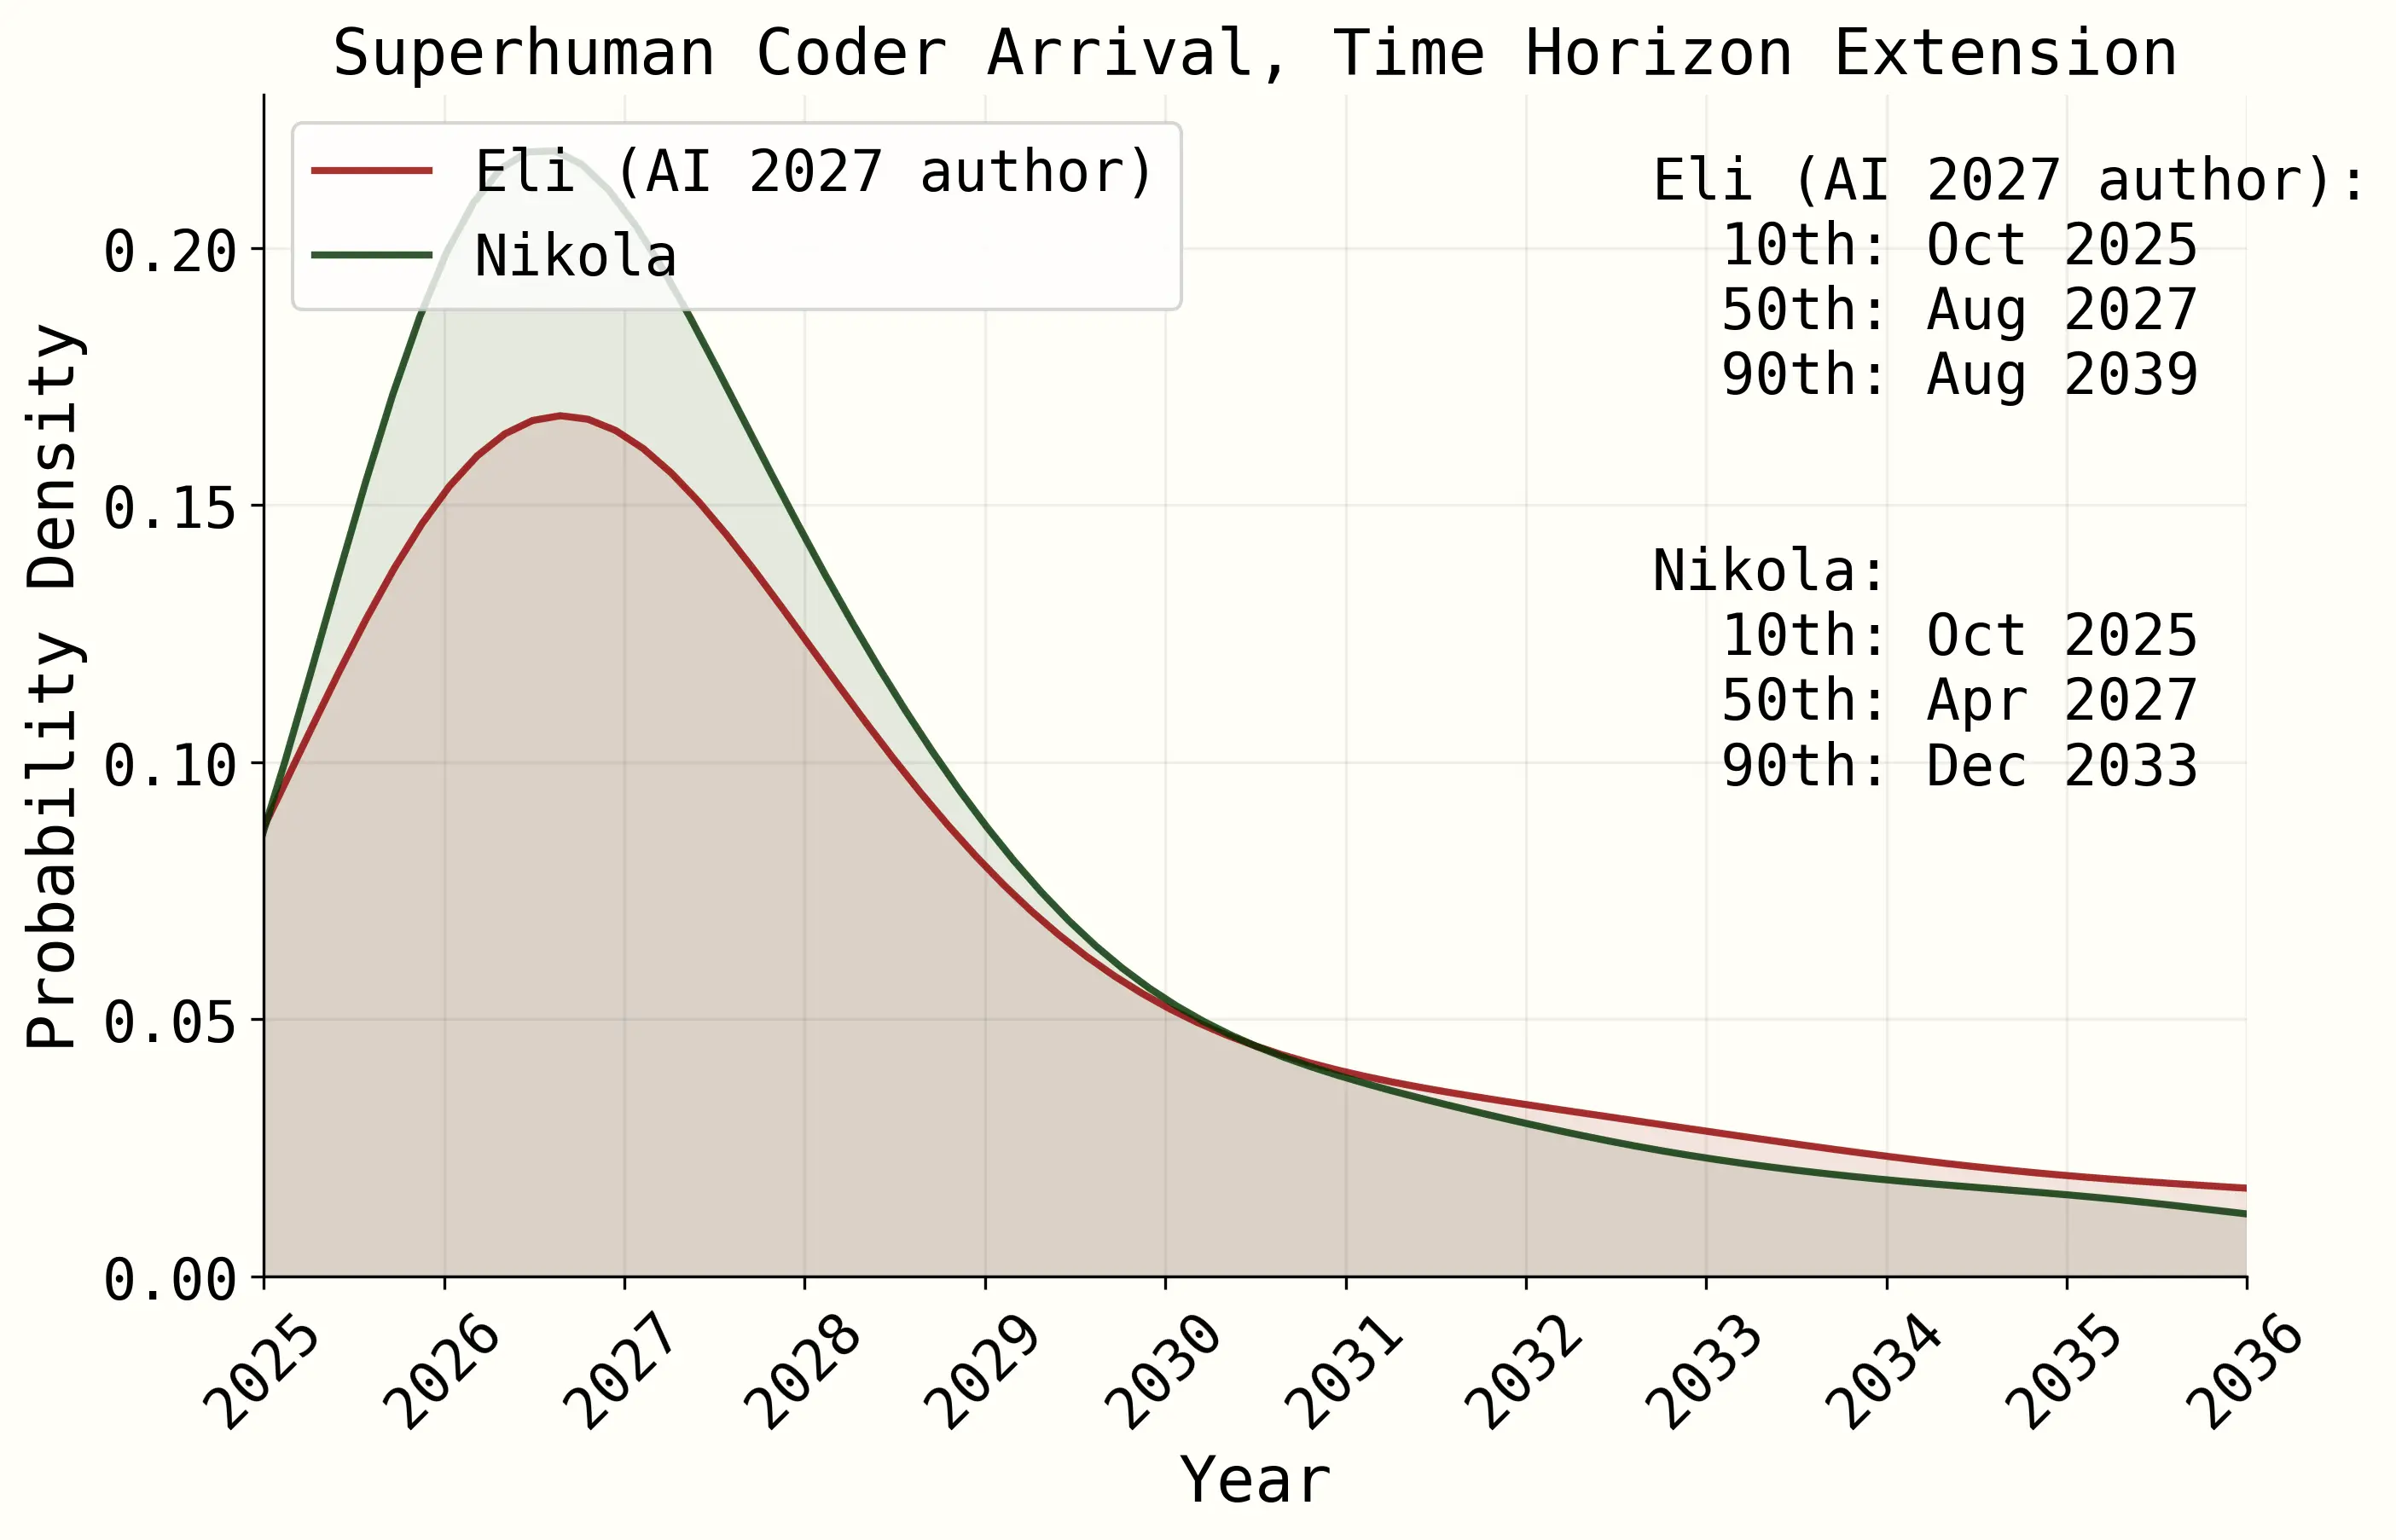
しかし、METRのタイムホライズンを組み立てるのに使われたベンチマークは、研究のタスクと複雑さの多くを取りこぼしている。小さなGPT-2モデルをファインチューニングできることと、成功か失敗かの明確な基準もないまま、100万行のコードを相手に五つのプロジェクトを同時に取りまとめられることとは、まったく別の話である。
だから、AIの研究開発が実際に何から成り立っているのかを、すべて知っておけるとよい。そうでなければ、街灯効果(たまたま最も測りやすいものを外挿してしまうこと)に陥る危険がつねにある。AIの研究開発に含まれるタスクの一覧があれば、何を把握していて何を調べていないのかを追跡でき、この危険をよりうまく避けられる。
そうした一覧があれば、すでにある外挿もよりよく解釈できる。ベンチマークのスコアが上がったとき、タスクの一覧を見れば、その向上が仕事のどの部分に及び、どの部分には触れていないのかが分かる。また、自動化されたタスクの割合や、各タスクで研究者がどれだけの効率向上を得ているかといった、外挿に使える新しいトレンドを作ることもできる。
この記事では、文献調査とブレインストーミングに基づいて、最先端のAI企業の研究ワークフローにまたがる六つの分類からなる、こうした分類体系の最初の版を示す。分類は60を超えるタスクに分かれ、それぞれについて、現在のAIがどれだけ自動化していると私たちが考えるかを0〜5で評価している。分類体系の全体は付属のドキュメントにあり、これがこの取り組みの主な成果物である。
これは、AIの研究開発の自動化をより確かに理解し予測するために、AIの研究開発に寄与するタスクの包括的な分類体系を作ろうとした、私たちなりの最善の最初の試みだと考えている。タスクの説明が間違っていたり、まったく抜け落ちているタスクがあったりしたら、ぜひ知らせてフィードバックをいただきたい。
Epoch AI の最新情報を受け取る 購読する
AI研究開発のためのO*NETこうしたタスクの一覧を求めるのは、私たちが初めてではない。仕事をタスクに分解するのは、経済学者が経済における自動化を追跡するときの常套手段である。その標準的な道具がO*NETで、米国経済の約1,000の職業と、それをこなすのに必要なタスクとスキルを記述している。
O*NETがあれば、経済学者はAIの経済的影響について、さまざまな実証研究や予測を行える。たとえば次のようなものである。
- LLMによって仕事が大きな影響を受けうる米国の労働者の割合を調べる
- 今後10年間にAIがGDP成長にどう影響しうるかを(精度のほどはさておき)推定する
- 幅広い知識労働を網羅するAIベンチマークを設計する
- 人々が最先端のAIモデルをどう使っているかを分類する
- リモートワークの自動化がもたらす帰結を予測する
しかし、O*NETは広く使われている情報源ではあるものの、AI研究の自動化を追跡するにはあまり役に立たない。データセットのタスクが、あまりに広く、抽象的すぎるのである。「コンピュータ・情報研究科学者」という職業を考えてみよう。O*NETのなかでは、おそらくこれが「最先端ラボのAI研究者」に最も近い。この職業の業務タスクは次のようになっている。
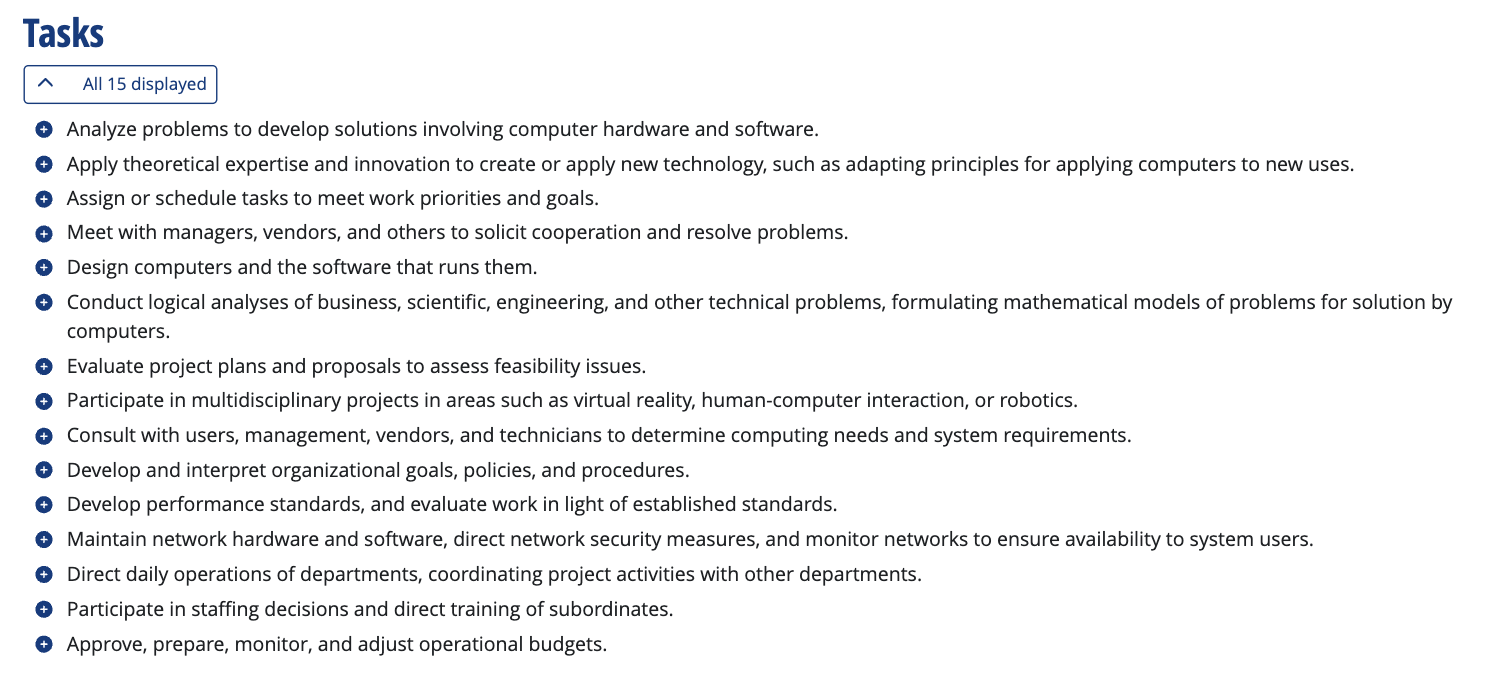
最初に挙げられているタスクは「問題を分析して、コンピュータのハードウェアとソフトウェアに関わる解決策を開発する」である。しかし、これは実にあいまいだ。どのような問題や解決策なのか。厳密には何が「コンピュータのハードウェアとソフトウェアに関わる」に入り、何が入らないのか。AIエンジニアの仕事のほぼすべてはコンピュータのソフトウェアに関わると言うこともできるのだから、控えめに言っても、あまり細かい記述とは言えない。それなのに、O*NETで見つかる最も細かいタスクの記述がこれであり、ほかのほぼすべてのタスクにも同じ問題がある。
問題の一端は実際的な実現可能性にある。O*NETは、LLMが登場する前の時代に、米国経済全体のタスクを網羅するという野心的な取り組みのために設計された。だから、「最先端ラボのAI研究」のように新しくニッチなものについてまで、ここまで細かいタスクを求めるのは、おそらく無理な注文である。
そこで私たちは、AIの研究開発に特化したO*NETを作ることを提案する。焦点を絞れば、AI研究者の仕事を細かく分解するのにずっと有利な立場に立てる。これがうまくいけば、自動化されたタスクの割合の推移を見ることができる。ベンチマークの結果と、それがどれだけ重要なのかを解釈する助けにもなりうる。AIのベンチマークが現実世界の複雑さを十分に反映してこなかったという現象は以前から続いているので、ベンチマークの結果を現場で起きていることと並べて見ることが重要である。
これは、AIの影響についての追加の研究の枠組みとしても役立ちうる。たとえば、AI研究者を対象に、さまざまな業務タスクで得ている効率向上を調査することが考えられる。社内のAI利用ログを、「実験コードを書く」や「次にどの実験を行うかを決める」といった用途に分類することも考えられる。これは、Anthropic のClioシステムが、人々のプライバシーを守りながら現実世界でのAIの利用を研究するのに役立っているのと似ている。
より広く言えば、AI研究開発のためのO*NETは、たとえば最先端ラボのモデルカードなどで、研究者のあいだに共通の語彙を確立するのに役立つだろう。モデルの開発者が、AIがどこで役立ち、どこで役立たないのかをより細かく要約したり、METRの最新のFrontier Risk Reportのように、さまざまな情報源の情報を標準化したりするのに役立つかもしれない。
とはいえ、自動化への進捗を監視し予測するのに「AI研究開発のためのO*NETさえあればよい」と言っているわけではない。たとえ完全に包括的なタスクのデータセットがあっても、たとえば各タスクでAIがどれだけの性能を発揮するかは、やはり測る必要がある。それでもタスクのデータセットがあれば、AIがAI研究に実際に与える影響をめぐる議論に足場ができ、ほかの情報源からの証拠を補いつつ、知能爆発にどれだけ近づいているかについての「状況認識(situational awareness)」を得られるだろう。
最初の提案では、この「AI研究開発のためのO*NET」は実際にはどのようなものになるのか。もちろん、答えるのは簡単ではない。AIの研究開発はきわめて雑然としていて、変化も速い。それでも、ひとまず最初の試みをしてみて、読者の皆さんからフィードバックを浴びせてもらうことにした。そのために、最先端のAIラボの代表的なタスクを60以上、説明と具体例を添えてまとめた。全文はこちらにある。
最初のステップは、現在AIの研究開発に含まれるすべてのタスクの大きな一覧を作ることだった。私たちは以前の研究に着想を得て、それらを六つの分類にまとめた。2これらの分類は、AI研究のサイクルのさまざまな部分に対応している。
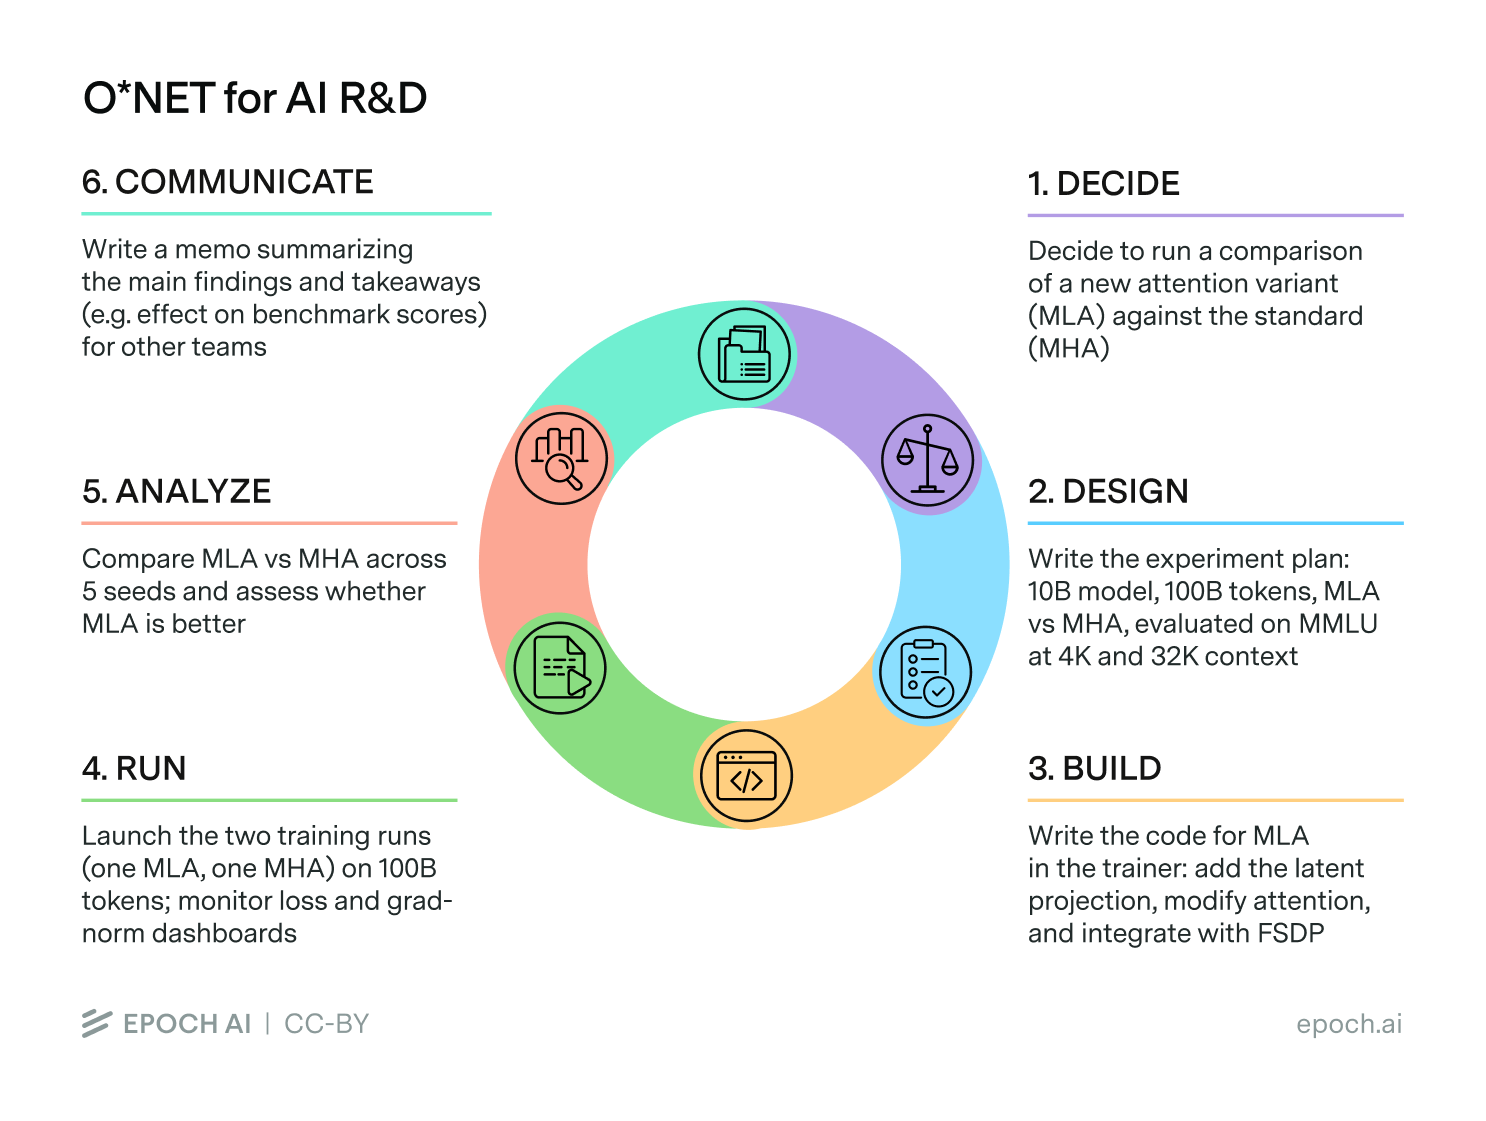
各分類には、それぞれの入力と出力がある。たとえば分類4(「実行」)を考えてみよう。名前のとおり、これは物事を「実行」することに関わる。学習実行を行ったり、AIシステムを一般に展開したりすることを思い浮かべてほしい。入力はたとえば、それを支えるすべての足場(スキャフォールド)と関連するインフラを備えたベンチマークのようなものであり、出力は一連の最終結果である。
各分類は、さらにいくつかの小分類に分かれる。分類4は三つに分かれ、それぞれに独自の入力と出力がある。
-
4.1 実行の監視:進行中の学習、強化学習、評価の実行を見守り、問題が生じたらすぐに見つけ、実行を健全な軌道に戻す
-
4.2 ハードウェアインフラの運用:大規模なクラスターを健全に保ち、稼働率を高く維持し、すばやく復旧できるようにする
-
4.3 推論実行の信頼性エンジニアリング:本番環境での提供を安定させ、高い性能を保ち、復旧できるようにする
そして最後に、小分類にはさまざまなタスクの詳細な一覧が含まれる。たとえば「4.1 実行の監視」のタスクは次のとおりである。
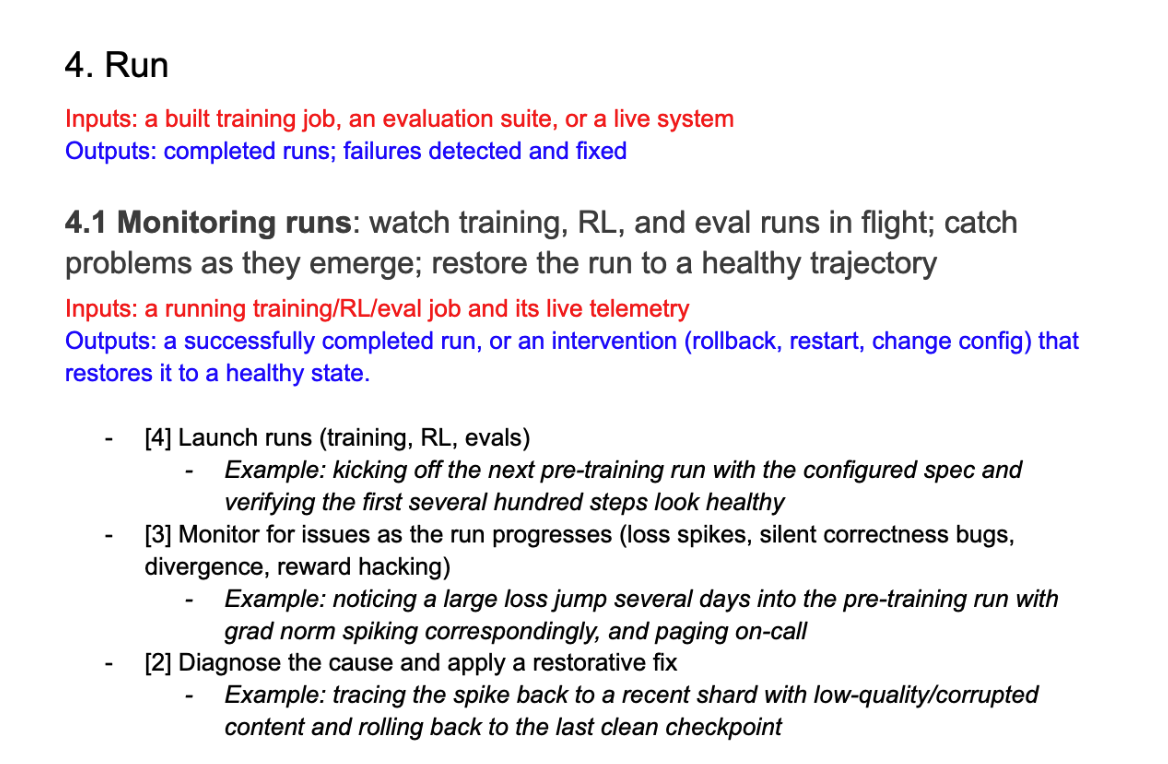
このように、「コンピュータのハードウェアとソフトウェアに関わる解決策」を開発する、という記述よりはるかに細かいことが分かるだろう。私たちのタスクの記述は、実行を監視し、潜在的な問題が生じたときに見つける、という水準にまで踏み込んでいる。
各タスクの横に数字が付いていることにお気づきだろう。これは、タスクごとの自動化の影響を見積もるための、私たちの最初の手法を反映している。具体的には、現在のAIが各タスクをどれだけ自動化していると考えるかを、次の基準に基づいて0〜5の尺度で評価している。
| 評価 | AIによる自動化 |
|---|---|
| 0 | 使われていない。AIは何も付け加えない |
| 1 | わずか。調べもの、ブレインストーミング、文書の仕上げにときどき便利だが、仕事のやり方や担い手は変わらない |
| 2 | 補助する。タスクの一部を意味のある程度に速めたり改善したりする。主導するのはおおむね人間で、すべてを人間が確認する |
| 3 | 協働する。人間の綿密な指示のもとで、AIが大きな部分を担う。判断を下し、全体をまとめるのはまだ人間である |
| 4 | 主導する。大まかな依頼から、タスクの大半を最初から最後までこなす。人間は監督し、軌道を修正し、出力を承認する。 |
| 5 | 自律的。人間がほとんど、あるいはまったく関与せずに、最初から最後までこなす |
それぞれの例は、提案の全文に示している。
もちろん、これはかなり主観的であり、たとえば社内のベンチマークなどを通じて、これを評価するよりよい方法を開発する余地は大いにある。楽観的に言えば、これを改良した版を使って、時間とともに外挿できる指標を作れるかもしれない。ただ、これはかなり難しいかもしれない。知能爆発を引き起こすにはどのタスクが自動化される必要があるのかを知る必要があるうえ、新しいタスクが生まれるかもしれないからである。たとえば、AIが他のAIと意思疎通する別の手段を持っているなら、AIは(人間の研究者と違って)「主な要点をまとめたメモを書く」必要はないかもしれない。
しかし私たちの全体的な願いは単純で、私たちのタスク集の全体が、各時点でAIが何を自動化でき、何を自動化できないのかについての追加の手がかりとなり、ベンチマークやMETRのタイムホライズンなどから得られる既存の証拠を補うことである。
次は何か?言うまでもないが、念には念を入れて明言しておくと、これはAI研究のためのO*NETの最初の試みである。最も自然な次のステップは、ここにあるものを土台に、見落としたタスクを加え、説明をより精密で正確なものに磨き、互いに重複がなく全体として漏れがないように分類し直し、AIの進歩に合わせて一覧を評価し直すことである。
さらに一歩進めるなら、分類体系の別の組み立て方を探ることになる。たとえば私たちは、すべてのタスクを、モデル開発の通常の段階、つまり事前学習、事後学習、推論実行に沿って整理することも考えた。しかしこれは見送った。いくつかの問題にぶつかるからである。(1)「実験用のコードを書く」のような多くのタスクが、複数の段階で繰り返し現れる。(2)一部のタスクはこれらの分類に自然には収まらない。何より、学習プロセスは実際にはとても複雑に見えることがある。ただし、私たちがこの分類を採らなかったからといって、それが使えないというわけではない。
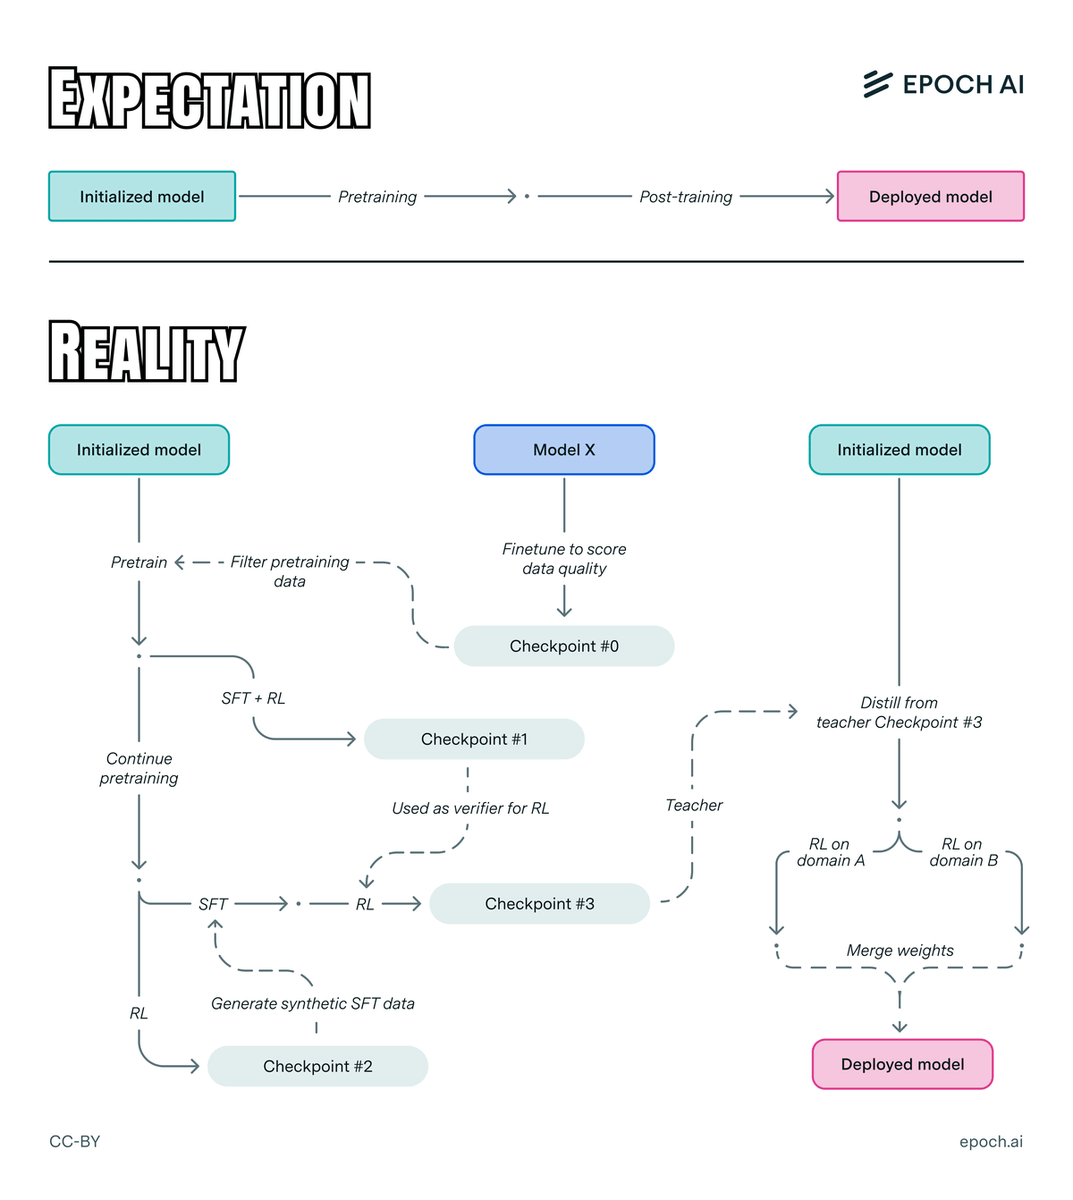
学習は単なる「事前学習+事後学習」ではなく、それよりはるかに複雑である。
タスクの分け方についても同様のことが言える。私たちは、あるタスクを、自動化される時期が大きく異なりそうなサブタスクに分けられるかどうかを問い、分けられるなら分けた。また、ある程度の「センス」が必要なタスク(特定の事後学習のレシピをスケールアップするかどうか、など)については、より細かく分けるよう努めた。この点については人によって意見が分かれるようだからである。しかし、細かさの水準を別の形で選ぶことももちろんできる。
全般に、私たちの最初の試みを改善するために、皆さんと協力できればとてもうれしい。AI研究者の方で、私たちの分類やタスクの記述に間違いがあると思ったら、ぜひフィードバックを共有するか、連絡してほしい。あるいは、AI研究開発のためのO*NETのようなものを仕事で使いそうな方がいれば、ぜひお話をうかがい、ニーズに合わせてどう改善できるかを理解したい。
このプロジェクトがうまくいけば、AIの研究開発の自動化をより直接的に追跡するための足がかりとなり、AIの予測者がトレンドラインをさらに先まで外挿する助けになることを願っている。そして願わくは、知能爆発が目前に迫っているかどうかも教えてくれるとよい。
フィードバックと支援をくれた David Owen、Stefania Guerra、Robert Sandler、Elliot Stewart に感謝する。
私たちの最初の試みと、付属のフィードバックフォームもぜひご覧いただきたい。直接の訂正や具体的な問い合わせは、js@epoch.aiまでメールでどうぞ。